TechCrunch scraper













ปลดล็อกข้อมูล TechCrunch ได้ในสองคลิก
ดึงข้อมูล TechCrunch ง่าย ๆ ในสองคลิก
การคัดลอกชื่อบทความ ผู้เขียน วันที่เผยแพร่ หรือเนื้อหาบทความเต็มจาก TechCrunch ด้วยมือเป็นงานที่น่าเบื่อ Thunderbit ช่วยให้คุณข้ามขั้นตอนยุ่งยากนี้ไปได้เลย แค่ชี้ไปที่ข้อมูลที่ต้องการ แล้ว AI จะจัดการส่วนที่เหลือให้เอง สองคลิก คุณก็ได้ข้อมูลที่มีโครงสร้างโดยไม่ต้องเขียนโค้ดแม้แต่บรรทัดเดียว หรือเสียเวลากับการตั้งค่าที่ซับซ้อน
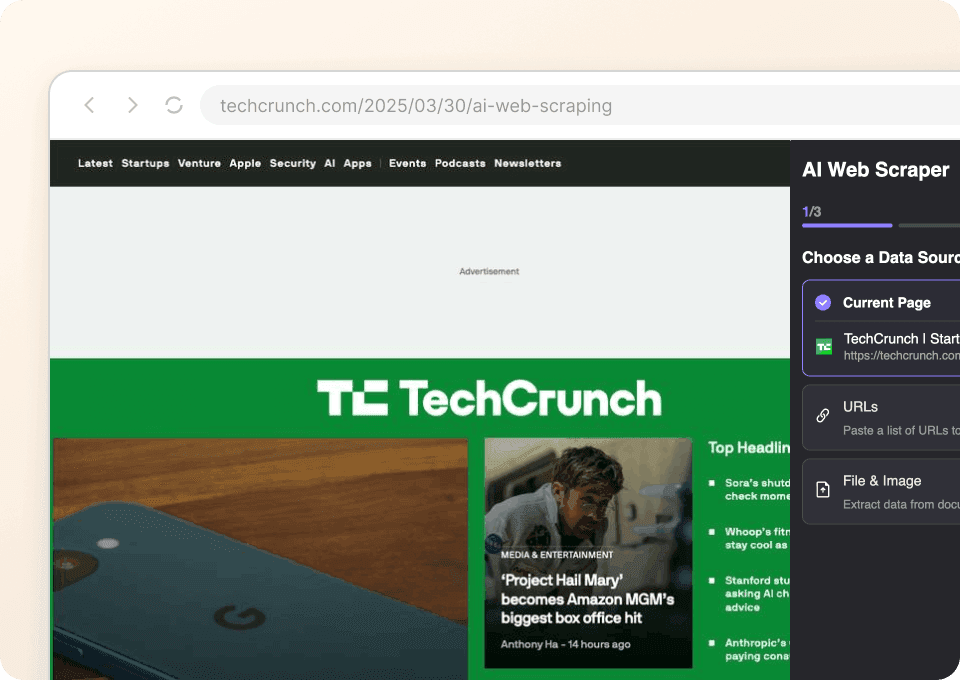
ได้ข้อมูล TechCrunch ที่สะอาด พร้อมใช้งานทันที
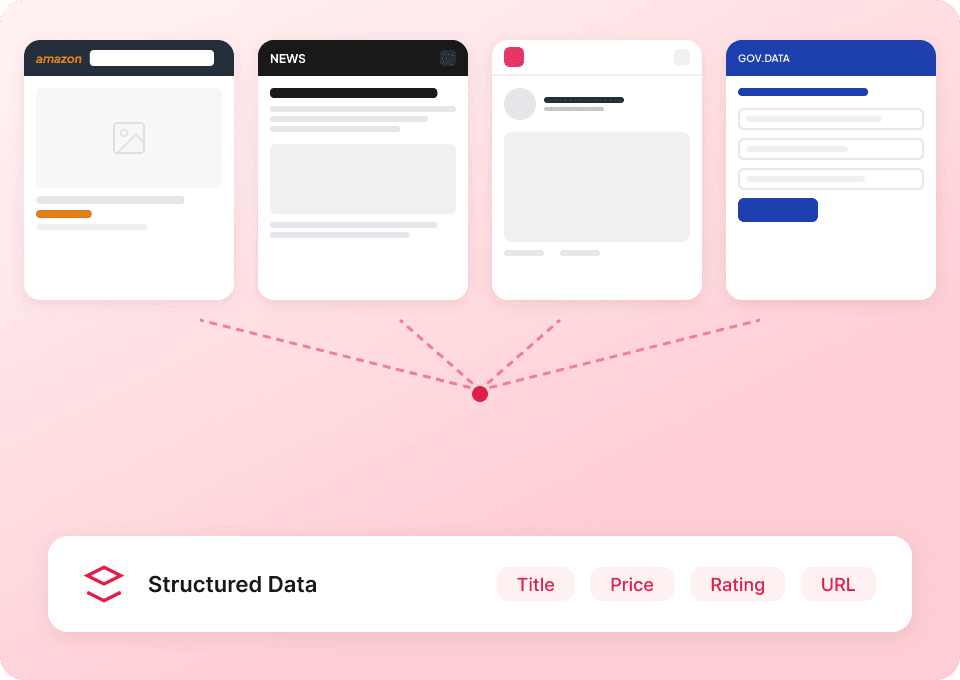
การสแครป HTML ดิบจาก TechCrunch ไม่ได้ช่วยให้คุณไปต่อได้ง่าย ๆ เพราะสิ่งที่คุณต้องการคือข้อมูลที่สะอาดและมีโครงสร้าง Thunderbit จะทำความสะอาดและจัดรูปแบบข้อมูลให้อัตโนมัติระหว่างการดึงข้อมูล คุณจึงนำไปวิเคราะห์หมวดหมู่บทความ ติดตามผู้เขียน หรือเปรียบเทียบวันที่เผยแพร่ได้ทันที Export ตรงไปยัง Google Sheets, Notion หรือ Airtable แล้วเริ่มใช้งานข้อมูลที่จัดระเบียบแล้วได้เลย — ไม่ต้องเสียเวลาทำความสะอาดข้อมูลเอง

ดึงข้อมูลได้ทุกเว็บไซต์ ไม่ใช่แค่ TechCrunch
ทำไมต้องเรียนรู้เครื่องมือใหม่ทุกครั้งที่เจอเว็บไซต์ต่างกัน? Thunderbit ใช้ได้แทบทุกเว็บไซต์ รวมถึง TechCrunch ด้วย และยังมีเทมเพลตสำเร็จรูปกว่า 50 แบบให้เริ่มต้นได้เร็วขึ้น ไม่ว่าคุณจะเก็บเนื้อหาบทความ โปรไฟล์ผู้เขียน หรือแท็กของบทความ Thunderbit คือโซลูชันเดียวสำหรับการดึงข้อมูลเว็บทั่วทั้งอินเทอร์เน็ต
กำลังดึงข้อมูล TechCrunch ได้ไม่เต็มประสิทธิภาพใช่ไหม?
ดูว่า Thunderbit ช่วยให้การดึงข้อมูล TechCrunch ง่ายกว่าวิธีแบบดั้งเดิมอย่างไร
Traditional scrapers
วิธีแบบเดิมThunderbit
วิธีที่ชาญฉลาดกว่า
คำถามที่พบบ่อย
ที่เกี่ยวข้อง กรณีใช้งาน
สำรวจกรณีใช้งานเพิ่มเติมของ web scraper จาก Thunderbit

Substack Scraper
ดึงจำนวนผู้ติดตาม Substack, ชื่อบทความ และรายละเอียดของสำนักพิมพ์ได้ใน 2 คลิก — จากนั้นส่งออกไปยัง Excel, Google Sheets หรือ Notion ได้ทันที ไม่ต้องเขียนโค้ด เพราะ Thunderbit ใช้ AI จัดโครงสร้างข้อมูลให้คุณเอง
เรียนรู้เพิ่มเติม ->
ESPN Scraper ใช้งานง่าย
ติดตามชื่อผู้เล่น วันที่แข่งขัน และคะแนนจาก ESPN ได้ใน 2 คลิกด้วย AI ของ Thunderbit — ไม่ต้องเขียนโค้ด ไม่ต้องตั้งค่าใดๆ ส่งออกไปยัง Excel, Google Sheets หรือ Notion ได้โดยตรง แล้วนำข้อมูลกีฬาไปใช้งานต่อได้ทันที
เรียนรู้เพิ่มเติม ->
PubMed Scraper
Thunderbit’s PubMed Scraper ช่วยให้คุณดึงข้อมูลที่มีโครงสร้างจากหน้าค้นหาและหน้าบทความของ PubMed ด้วย AI ได้อย่างง่ายดาย ไม่ว่าจะเป็นงานวิจัยทางการแพทย์ที่กำลังมาแรง หลักฐานจากการทดลองทางคลินิก บทคัดย่อ ผู้เขียน สังกัดหน่วยงาน วันที่เผยแพร่ และลิงก์ต่าง ๆ แล้วส่งออกไปยัง Excel, Google Sheets, Airtable หรือ Notion ได้ทันที
เรียนรู้เพิ่มเติม ->
เครื่องมือดึงข้อมูลบทความสำหรับข้อความ ผู้เขียน และวันที่
รวบรวมพาดหัว ชื่อผู้เขียน วันที่ สรุป เนื้อหาบทความ ลิงก์ และสื่อจากหน้าบทความสาธารณะ จัดรายละเอียดของแต่ละบทความให้อยู่ในแถวเดียวกันอย่างชัดเจน แม้เว็บไซต์ข่าวจะมีรูปแบบหน้าแตกต่างกันก็ตาม
เรียนรู้เพิ่มเติม ->
เครื่องมือดึงข่าว: เชื่อมหัวข้อข่าวไปยังรายละเอียดบทความฉบับเต็ม
รวบรวมหัวข้อข่าวจากหน้าหมวดหมู่ หน้าเซ็กชัน หรือหน้าค้นหา จากนั้นเปิดลิงก์บทความเพื่อดึงชื่อผู้เขียน วันที่เผยแพร่ บทสรุป หมวดหมู่ และ URL ต้นทางที่มองเห็นได้ บอก Thunderbit เป็นภาษาเข้าใจง่ายได้เลยว่าคุณต้องการรายละเอียดบทความอะไร ก่อนเริ่มรัน
เรียนรู้เพิ่มเติม ->พร้อมเร่งพลังการดึงข้อมูลของคุณหรือยัง?
เข้าร่วมกับมืออาชีพกว่า 200,000+ คนที่ใช้ Thunderbit เพื่อทำเวิร์กโฟลว์การดึงข้อมูลเว็บให้อัตโนมัติ
ทดลองใช้ฟรีพร้อมเครดิตไม่จำกัดสำหรับ 8 หน้าเว็บ



