
โลกธุรกิจในปี 2026 คือยุคแย่งชิงขุมทรัพย์ข้อมูล—เพียงแต่แทนที่จะใช้พลั่ว เราใช้งาน API, AI และ Chrome extension กันแทน ทุกทีมขาย ทีมปฏิบัติการ และทีมอีคอมเมิร์ซที่ผมคุยด้วยต่างต้องการข้อมูลที่มีโครงสร้างและอัปเดตล่าสุด เพื่อช่วยตัดสินใจได้ฉลาดขึ้น สร้างลีด และเอาชนะคู่แข่ง แต่ประเด็นคือ: เมื่อมีบริษัทด้านการดึงข้อมูลผุดขึ้นมามากมาย การเลือกเจ้าให้เหมาะกับงานอาจให้ความรู้สึกเหมือนกำลังเลือกโดนัทที่ดีที่สุดจากร้านที่มีรสชาติเป็นร้อยแบบ (สารภาพเลยว่า ผมมักเลือกชิ้นที่มีสปริงเคิลเสมอ แต่ธุรกิจของคุณอาจต้องการอะไรที่…หนักแน่นกว่านั้น)
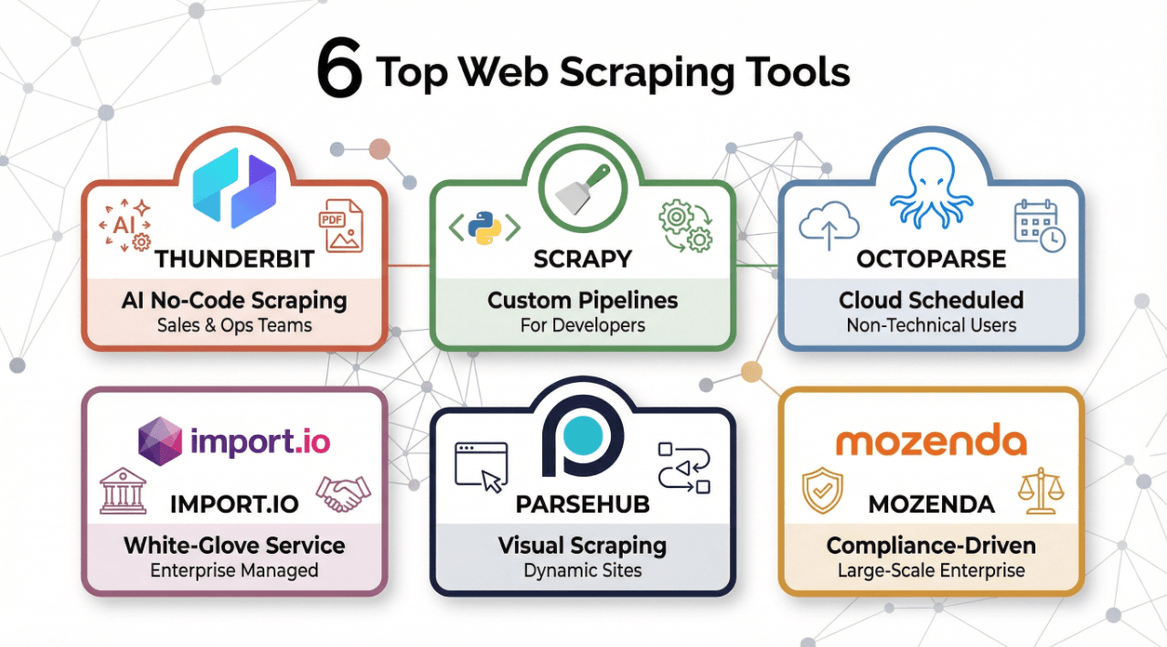
ในคู่มือนี้ ผมจะพาไล่ดู 6 บริษัทด้านการดึงข้อมูลชั้นนำในปี 2026—แต่ละเจ้ามีสไตล์ จุดแข็ง และข้อจำกัดต่างกัน ไม่ว่าคุณจะเป็นนักการตลาดที่ไม่สายเทคนิค นักพัฒนาที่กำลังสร้าง pipeline แบบกำหนดเอง หรือองค์กรใหญ่ที่มีข้อกำหนดด้านคอมพลายแอนซ์เข้มงวด ผมจะช่วยคุณสำรวจตัวเลือก เปรียบเทียบฟีเจอร์ และหาตัวที่เหมาะกับเป้าหมายทางธุรกิจของคุณที่สุด
ทำไมการเลือกบริษัทดึงข้อมูลที่เหมาะสมจึงสำคัญต่อธุรกิจ
Data Scraping คืออะไร และทำอย่างไรในปี 2025 Get Started Free
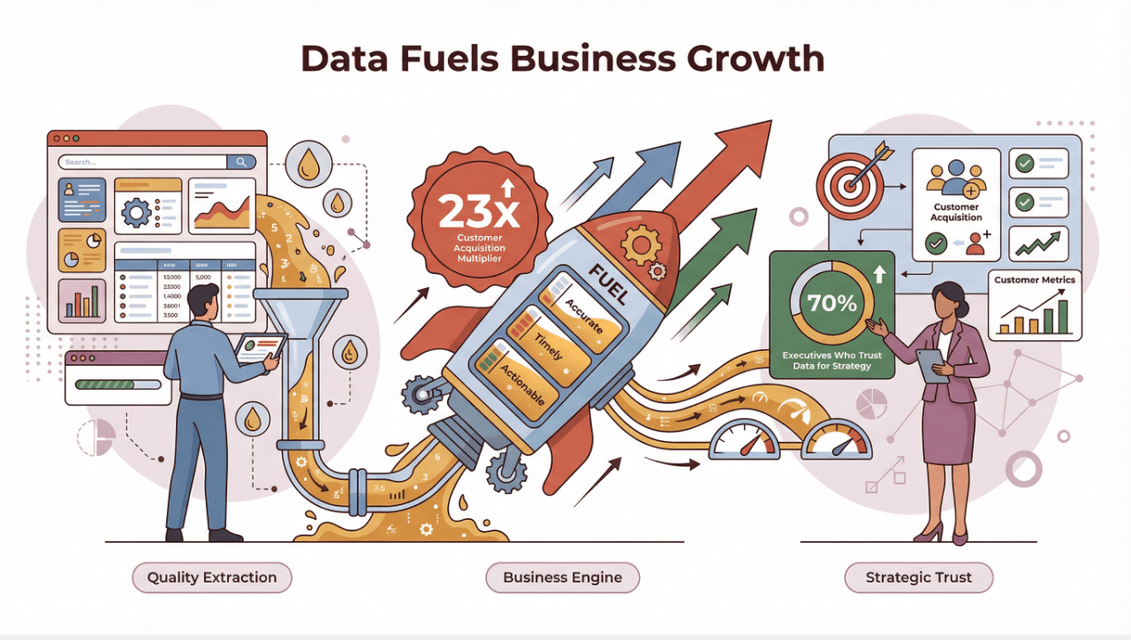
พูดกันตามตรง: การดึงข้อมูลไม่ได้มีแค่การคัดตัวเลขจากเว็บไซต์ แต่มันคือการเติมเชื้อเพลิงให้เครื่องยนต์ธุรกิจของคุณด้วยข้อมูลที่ถูกต้อง ทันเวลา และนำไปใช้ต่อได้จริง บริษัทที่ขับเคลื่อนด้วยข้อมูลมีโอกาส ดึงลูกค้าได้มากขึ้นถึง 23 เท่า และ 70% ของผู้บริหาร มองว่าข้อมูลที่เชื่อถือได้คือหัวใจสำคัญของกลยุทธ์องค์กร
แต่จุดที่ต้องระวังคือ: ถ้าเลือกผู้ให้บริการดึงข้อมูลผิดเจ้า คุณอาจต้องเจอกับคุณภาพข้อมูลต่ำ ปัญหาด้านคอมพลายแอนซ์ การเสียทรัพยากรโดยใช่เหตุ และโอกาสทางธุรกิจที่หลุดลอยไป ผมเคยเห็นทีมต่าง ๆ ใช้เวลาหลายสัปดาห์ไปกับการแก้ไฟล์ส่งออกที่ยุ่งเหยิง หรือแย่กว่านั้นคือไปขัดกับกฎความเป็นส่วนตัวเพราะผู้ให้บริการลดขั้นตอนเกินไป ความเสี่ยงจึงสูงมาก และพาร์ตเนอร์ที่เหมาะสมสามารถเป็นตัวตัดสินว่าแผนงานที่ขับเคลื่อนด้วยข้อมูลจะสำเร็จหรือไม่
เราเลือกบริษัทดึงข้อมูลชั้นนำเหล่านี้อย่างไร
ผมไม่ได้สุ่มปาเป้าเข้ากระดานเล่น ๆ นะ (แม้จะน่าสนใจก็ตาม) เพื่อทำลิสต์นี้ ผมพิจารณาจาก:
- ความแม่นยำและคุณภาพของข้อมูล: เครื่องมือดึงข้อมูลได้เชื่อถือได้และเป็นโครงสร้างจริงไหม แม้จากเว็บที่ซับซ้อนหรือเปลี่ยนบ่อย?
- คอมพลายแอนซ์และความเป็นส่วนตัว: บริษัทจัดการเรื่องข้อมูลส่วนบุคคล ความปลอดภัย และข้อกำหนดทางกฎหมายอย่างไร?
- ความสามารถในการขยายงาน: รองรับได้ทั้งงานดึงข้อมูลครั้งเดียวและโปรเจกต์ขนาดใหญ่ที่ทำต่อเนื่องไหม?
- ใช้งานง่ายแค่ไหน: ออกแบบมาสำหรับคนไม่เขียนโค้ด นักพัฒนา หรือทั้งสองแบบ?
- AI และระบบอัตโนมัติ: จัดการข้อมูลที่ไม่เป็นโครงสร้าง PDF รูปภาพ และเลย์เอาต์ซับซ้อนได้ฉลาดแค่ไหน?
- ราคาและความคุ้มค่า: ราคาโปร่งใส และสมเหตุสมผลเมื่อเทียบกับฟีเจอร์หรือไม่?
- เหมาะกับธุรกิจแบบไหน: รองรับ SMB, องค์กรใหญ่ หรือครอบคลุมทุกระดับ?
ผมยังเจาะดูรีวิวผู้ใช้ ความเห็นจากผู้เชี่ยวชาญ และกรณีศึกษาในโลกจริง เพื่อให้มั่นใจว่าทุกเจ้าที่เลือกมานั้นคู่ควรกับตำแหน่งนี้
1. Thunderbit
Thunderbit คือ Chrome Extension สำหรับดึงข้อมูลเว็บด้วย AI ที่ผมกับทีมสร้างขึ้นมาเพื่อผู้ใช้งานธุรกิจที่อยากเปลี่ยนข้อมูลบนเว็บให้กลายเป็นข้อมูลที่มีโครงสร้าง โดยไม่ต้องเขียนโค้ดแม้แต่บรรทัดเดียว ผมอาจมีอคติบ้าง แต่ขออธิบายก่อน: Thunderbit ออกแบบมาสำหรับทีมขาย ทีมอีคอมเมิร์ซ และทีมปฏิบัติการที่ต้องการข้อมูลเร็ว แม่นยำ และเอาไปใช้ต่อได้จากทุกเว็บไซต์ PDF หรือรูปภาพ
ฟีเจอร์เด่นของ Thunderbit
- AI Suggest Fields: แค่คลิก “AI Suggest Fields” แล้ว AI ของ Thunderbit จะอ่านหน้าเว็บ แนะนำคอลัมน์ และยังช่วยสร้าง prompt สำหรับการดึงข้อมูลแบบกำหนดเองได้ด้วย ไม่ต้องเดาอีกต่อไปว่าจะได้ข้อมูลอะไร
- ดึงข้อมูลจากหลายหน้าและหน้าถัดไปอัตโนมัติ: ต้องการข้อมูลจากทุกหน้าสินค้า หรือไล่ตามลิงก์ไปยังหน้ารายละเอียดใช่ไหม? AI ของ Thunderbit จะนำทางและรวมข้อมูลให้โดยอัตโนมัติ
- เทมเพลตสำเร็จรูปทันที: สำหรับเว็บยอดนิยมอย่าง Amazon, Zillow หรือ Shopify ใช้เทมเพลตที่เตรียมไว้ล่วงหน้าเพื่อดึงข้อมูลได้ในคลิกเดียว ไม่ต้องตั้งค่า
- ส่งออกข้ามแพลตฟอร์ม: ส่งข้อมูลออกไปยัง Excel, Google Sheets, Airtable, Notion หรือดาวน์โหลดเป็น CSV/JSON ได้โดยตรง และแน่นอนว่า export ฟรี
- AI Data Processing: แปล จัดหมวดหมู่ สรุป หรือใส่ป้ายกำกับข้อมูลได้ตั้งแต่ตอนดึง เหมาะมากกับแหล่งข้อมูลที่ยุ่งและไม่เป็นโครงสร้าง
- ดึงข้อมูลบนคลาวด์และในเบราว์เซอร์: เลือกใช้ cloud scraping ที่รวดเร็วสำหรับเว็บสาธารณะ หรือโหมดเบราว์เซอร์สำหรับหน้าที่ต้องล็อกอิน
- Scheduled Scraping: ตั้งให้งานทำซ้ำตามรอบด้วยภาษาธรรมชาติ เช่น “ทุกวันจันทร์ตอน 8 โมงเช้า” เพื่อให้ข้อมูลอัปเดตเสมอ
- Free Data Extractors: ดึงอีเมล เบอร์โทร และรูปภาพจากเว็บไซต์ใดก็ได้ในคลิกเดียว
Thunderbit ได้รับความไว้วางใจจากผู้ใช้มากกว่า 200,000 คนทั่วโลก และ ราคา ก็เข้าใจง่าย: ใช้ฟรีได้ถึง 6 หน้า และแพ็กเกจแบบชำระเงินเริ่มต้นที่ $15/เดือน สำหรับ 500 credits (1 credit = 1 แถวผลลัพธ์)
ทำไม Thunderbit ถึงโดดเด่น
Thunderbit โดดเด่นเมื่อคุณต้องการ:
- ดึงข้อมูลจากเว็บที่ซับซ้อน ไม่เป็นมาตรฐาน หรือเป็น long-tail ซึ่งเทมเพลตทั่วไปเอาไม่อยู่
- ดึงข้อมูลเป็นโครงสร้างจาก PDF หรือรูปภาพ เช่น ใบแจ้งหนี้ สเปกสินค้า หรือโบรชัวร์อสังหาฯ
- เปิดทางให้ทีมที่ไม่ถนัดเทคนิคสร้าง scraper ตั้งเวลางาน และส่งออกข้อมูลได้ โดยไม่ต้องติดคอขวดที่ฝ่าย IT
- ทำงานอย่างสอดคล้องกับคอมพลายแอนซ์: Thunderbit สนับสนุนการดึงข้อมูลอย่างรับผิดชอบ เคารพ robots.txt และรองรับเวิร์กโฟลว์ที่ปลอดภัยและผู้ใช้ควบคุมได้เอง
ลองใช้ Thunderbit AI Web Scraper ฟรี
2. Scrapy
Scrapy คือขุมพลังแบบโอเพนซอร์สที่นักพัฒนาและ data engineer ชื่นชอบ ถ้าคุณต้องการการควบคุมเต็มรูปแบบ pipeline แบบกำหนดเอง และความสามารถในการขยายการดึงข้อมูลไปยังเว็บไซต์นับพัน Scrapy คือตัวเลือกหลักที่นึกถึง
จุดแข็งทางเทคนิคของ Scrapy
- ขยายต่อได้สูง: สร้าง spider, pipeline และ middleware แบบกำหนดเองได้สำหรับทุกสถานการณ์ของการดึงข้อมูล
- รองรับงานขนาดใหญ่: crawl และดึงข้อมูลจากเว็บขนาดมหึมาได้อย่างมีประสิทธิภาพ พร้อมรองรับ distributed crawling ในตัว
- คอมมูนิตี้แข็งแรง: ชุมชนโอเพนซอร์สคึกคัก มีปลั๊กอินจำนวนมาก และมีการพัฒนาอย่างต่อเนื่อง (มากกว่า 55,000 stars บน GitHub)
- ผสานการทำงานได้ดี: เชื่อมเข้ากับ Python data pipeline, workflow ด้าน machine learning และ cloud infrastructure ได้อย่างลื่นไหล
Scrapy เหมาะกับงานแบบไหน
- โปรเจกต์แบบกำหนดเองขนาดใหญ่ ที่มีตรรกะซับซ้อนหรือมีความต้องการด้าน integration
- ทีมที่มีทักษะ Python สูงและอยากเป็นเจ้าของกระบวนการดึงข้อมูลทั้งหมด
- องค์กรที่สร้าง data pipeline เฉพาะของตัวเอง หรือเชื่อมกับระบบภายใน
ข้อจำกัด: Scrapy ไม่ได้เหมาะกับทุกคน—มีช่วงเรียนรู้พอสมควร ต้องดูแลต่อเนื่อง และไม่มี UI สำเร็จรูปสำหรับคนไม่เขียนโค้ด แต่สำหรับทีมสายเทคนิค มันคือเครื่องมือทรงพลังมาก (Scrapfly)
3. Octoparse
Octoparse คือแพลตฟอร์ม SaaS แบบ no-code ที่ทำให้การดึงข้อมูลเว็บเข้าถึงคนทั่วไปได้ง่ายขึ้น อินเทอร์เฟซแบบลากวาง การตั้งเวลาบนคลาวด์ และเทมเพลตสำเร็จรูป ทำให้เป็นที่นิยมในหมู่ผู้ใช้งานธุรกิจที่อยากได้ความสามารถสูงโดยไม่ต้องเขียนโปรแกรม
ฟีเจอร์ที่เน้นธุรกิจของ Octoparse
- ดึงข้อมูลแบบ Point-and-Click: เลือกองค์ประกอบบนหน้าเว็บด้วยภาพ ตั้งค่า workflow และดูผลลัพธ์แบบเรียลไทม์
- Cloud Scraping และ Scheduling: รันงานบนคลาวด์ ตั้งงานให้ทำซ้ำ และไม่ต้องกังวลข้อจำกัดของเครื่องในเครื่อง
- เทมเพลตสำเร็จรูป: ดึงข้อมูลจากเว็บยอดนิยมด้วยเทมเพลตพร้อมใช้ เหมาะกับอีคอมเมิร์ซ เว็บหางาน และโซเชียลมีเดีย
- ส่งออกข้อมูล: ดาวน์โหลดผลลัพธ์เป็น CSV, Excel หรือส่งเข้า database และ API ได้โดยตรง
Octoparse เหมาะกับงานแบบไหน
- ผู้ใช้ที่ไม่ถนัดเทคนิค แต่ต้องการดึงข้อมูลจากเว็บที่มีโครงสร้างมาตรฐานหรือซับซ้อนไม่มาก
- ทีมที่ต้องการดึงข้อมูลแบบอัตโนมัติเป็นรอบ ๆ โดยไม่ต้องพึ่ง IT
- SMB และทีมการตลาดที่ต้องการสมดุลระหว่างพลังการใช้งานกับความง่าย
เสียงจากผู้ใช้: บางคนบอกว่าฟีเจอร์ขั้นสูงมี ช่วงเรียนรู้ที่ต้องใช้เวลา แต่โดยรวม Octoparse ได้คำชมว่า ทำให้ข้อมูลเว็บเข้าถึงได้สำหรับทุกคน
ราคา: มีแพ็กเกจฟรี และแพ็กเกจแบบชำระเงินเริ่มราว $69/เดือน (Octoparse Pricing)
4. Import.io
Import.io คือบริการดึงข้อมูลแบบ managed ครบวงจรระดับองค์กร ถ้าคุณอยากให้คนอื่นจัดการงานหนักทั้งหมด ตั้งแต่เริ่มโปรเจกต์จนถึงส่งมอบ Import.io พร้อมทีมผู้เชี่ยวชาญที่ดูแลคุณอยู่
โซลูชันสำหรับองค์กรของ Import.io
- Managed Services: ทีมของ Import.io ช่วยสร้าง ดูแล และขยาย data pipeline ให้คุณ เหมาะกับโปรเจกต์ซับซ้อน ปริมาณมาก หรือเป็นภารกิจสำคัญขององค์กร
- ส่งมอบข้อมูลแบบกำหนดเอง: รับข้อมูลในรูปแบบที่คุณต้องการ ตามตารางเวลาที่ต้องการ และเชื่อมเข้ากับ BI tools หรือฐานข้อมูลที่มีอยู่
- คอมพลายแอนซ์และความปลอดภัย: ให้ความสำคัญสูงกับข้อกฎหมาย จริยธรรม และข้อกำหนดด้านกฎระเบียบ (Import.io Compliance)
- การสนับสนุน: มี account manager เฉพาะ SLA และผู้เชี่ยวชาญช่วยแก้ปัญหา
ใครควรใช้ Import.io?
- องค์กรขนาดใหญ่ที่ต้องการข้อมูลต่อเนื่อง ซับซ้อน และมีกฎคอมพลายแอนซ์เข้มงวด
- ทีมที่ต้องการโซลูชันแบบ “ทำให้ครบ” โดยไม่ต้องใช้ทรัพยากรเทคนิคภายในมาก
- องค์กรที่ต้องการการส่งมอบที่เชื่อถือได้ การซัพพอร์ต และการเชื่อมต่อระบบ
ราคา: คิดราคาตามขอบเขตงานแบบเสนอราคาเฉพาะ โปรดคาดหวังราคาสำหรับระดับองค์กร (Import.io Pricing)
5. ParseHub
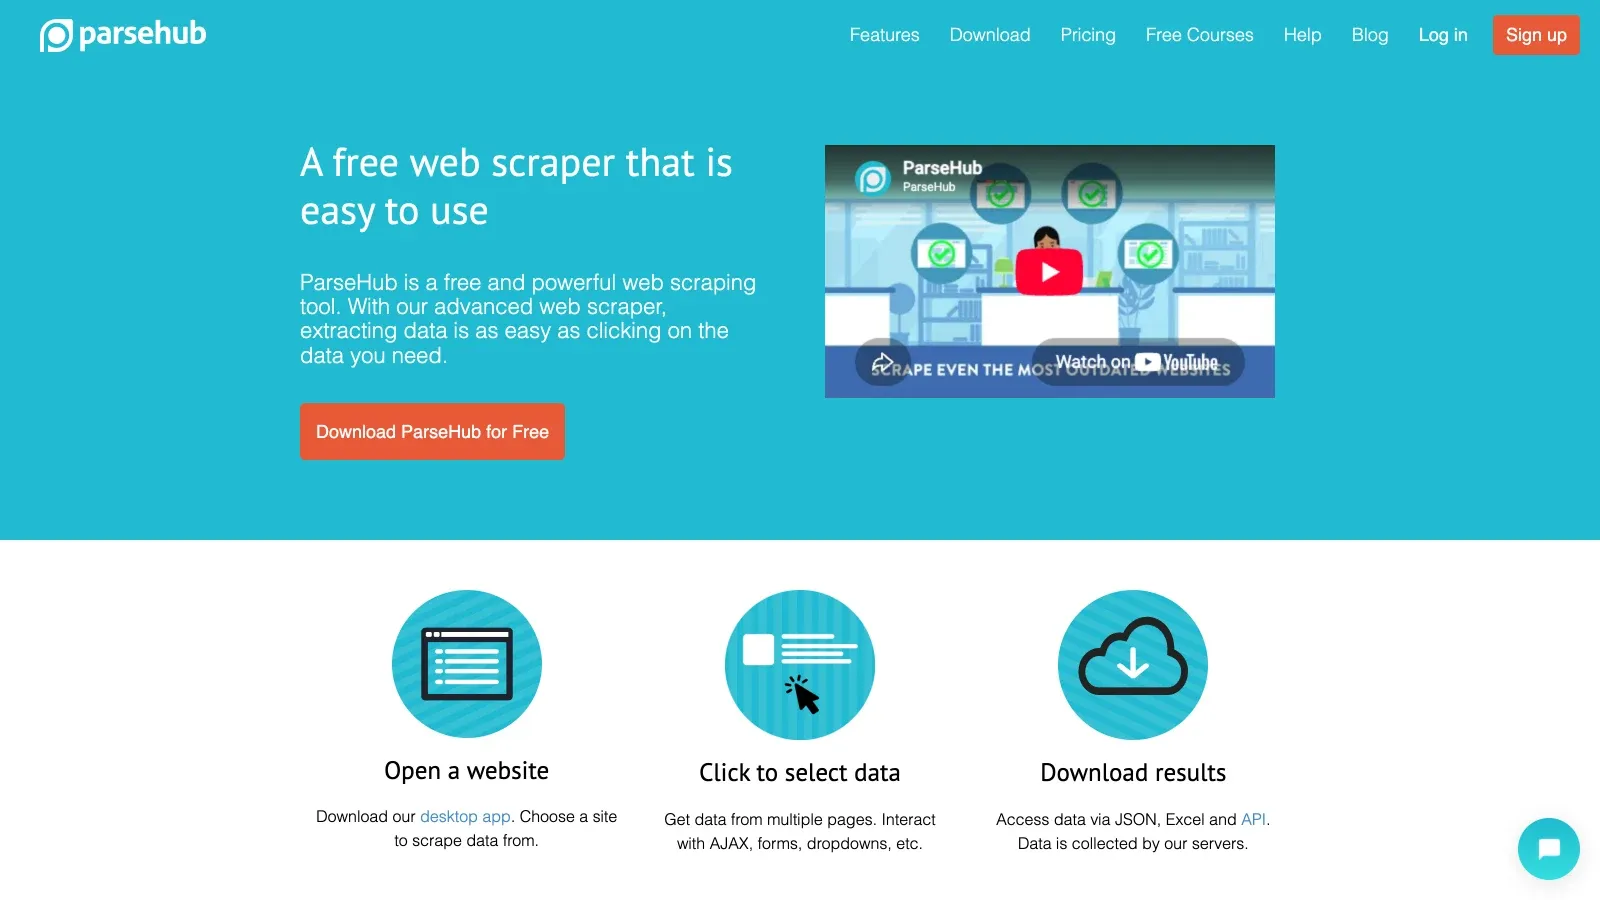
ParseHub คือเครื่องมือดึงข้อมูลเว็บแบบเห็นภาพ ที่ช่วยเชื่อมช่องว่างระหว่างความง่ายแบบ no-code กับพลังการดึงข้อมูลขั้นสูง โดยเฉพาะเก่งกับเว็บที่ใช้ JavaScript หนัก ๆ หรือมีโครงสร้างไม่เป็นระเบียบ
ความยืดหยุ่นของ ParseHub สำหรับผู้ใช้ที่ไม่ใช่สายเทคนิค
- Visual Workflow Builder: คลิกเลือกองค์ประกอบ ตั้งค่าการนำทาง และจัดการ AJAX หรือ infinite scroll ได้
- นำทางหลายหน้า: crawl หมวดหมู่ หน้าย่อย และหน้ารายละเอียดได้อย่างง่าย
- แปลงข้อมูล: ทำความสะอาด กรอง และปรับรูปแบบข้อมูลไปพร้อมกับการดึง
- ตัวเลือกส่งออก: ดาวน์โหลดเป็น CSV, Excel หรือ JSON; และมี API สำหรับอัตโนมัติ
ParseHub เหมาะกับงานแบบไหน
- การดึงข้อมูลจากเว็บที่มีเลย์เอาต์ซับซ้อน เนื้อหาเปลี่ยนแบบไดนามิก หรือมีองค์ประกอบอินเทอร์แอ็กทีฟ
- ผู้ใช้ที่ไม่ถนัดเทคนิค แต่ต้องการพลังมากกว่าเครื่องมือ no-code ทั่วไป
- ทีมที่ต้องการตั้งเวลายืดหยุ่นและรันบนคลาวด์
ราคา: มีแพ็กเกจฟรี และแพ็กเกจแบบชำระเงินเริ่มที่ $189/เดือน (ParseHub Pricing)
รีวิวผู้ใช้: ได้รับคำชมเรื่องความอเนกประสงค์ แต่บางคนบอกว่าโปรเจกต์ขั้นสูงมีช่วงเรียนรู้ที่ค่อนข้างชัน (G2)
6. Mozenda
Mozenda คือบริษัทดึงข้อมูลที่ยึดคอมพลายแอนซ์เป็นหลัก สร้างมาเพื่อองค์กรที่ไม่อาจเสี่ยงกับเรื่องความเป็นส่วนตัวหรือความปลอดภัยได้ หากอุตสาหกรรมของคุณมีการกำกับดูแลเข้มงวด หรือบอร์ดของคุณไม่ชอบพื้นที่สีเทาทางกฎหมาย Mozenda ควรอยู่ในลิสต์ที่ต้องพิจารณา
แนวทางของ Mozenda ต่อความเป็นส่วนตัวและความปลอดภัยของข้อมูล
- ผ่านมาตรฐานคอมพลายแอนซ์: ปฏิบัติตาม GDPR, CCPA และมาตรฐานความเป็นส่วนตัวระดับโลกอื่น ๆ (Mozenda Terms)
- Audit Trail และความปลอดภัย: มีบันทึกการทำงานละเอียด ระบบควบคุมสิทธิ์ และความปลอดภัยระดับองค์กร
- Managed และ Self-Service: เลือกได้ว่าจะสร้าง agent เองหรือให้ทีมของ Mozenda ดูแลทั้งหมด
- รองรับโปรเจกต์ขนาดใหญ่: ออกแบบมาสำหรับการดึงข้อมูลซ้ำ ๆ ในวงกว้าง ครอบคลุมอุตสาหกรรมอย่างการเงิน สุขภาพ และค้าปลีก
เมื่อไหร่ควรเลือก Mozenda
- องค์กรที่มีข้อกำหนดเข้มงวดด้านคอมพลายแอนซ์ การตรวจสอบ หรือกฎระเบียบ
- ทีมที่ต้องการทั้งความยืดหยุ่นแบบ self-service และตัวเลือกแบบ managed ระดับพรีเมียม
- องค์กรที่ให้ความสำคัญกับความเป็นส่วนตัวของข้อมูลแบบต่อรองไม่ได้
ราคา: ทดลองฟรี 14 วัน; แพ็กเกจ Pilot $500/เดือน; องค์กรติดต่อขอราคา (Mozenda Pricing)
เปรียบเทียบบริษัทดึงข้อมูลชั้นนำ: ฟีเจอร์และราคา
นี่คือตารางเปรียบเทียบแบบเร็ว ๆ เพื่อช่วยให้คุณตัดสินใจ:
| บริษัท | เหมาะที่สุดสำหรับ | ต้องมีทักษะเทคนิคระดับไหน | AI/No-Code | โฟกัสด้านคอมพลายแอนซ์ | ตัวเลือกการส่งออก | ราคาเริ่มต้น |
|---|---|---|---|---|---|---|
| Thunderbit | ฝ่ายขาย, ops, อีคอมเมิร์ซ, SMB | ไม่มี | ใช่ | แข็งแรง | Excel, Sheets, Notion, CSV | ฟรี, $15/เดือน+ |
| Scrapy | นักพัฒนา, custom pipeline | สูง (Python) | ไม่ | ผู้ใช้ดูแลเอง | ได้ทุกแบบ (กำหนดเอง) | ฟรี, โอเพนซอร์ส |
| Octoparse | no-code, SMBs, นักการตลาด | ต่ำ | ใช่ | ปานกลาง | CSV, Excel, DB, API | ฟรี, $69/เดือน+ |
| Import.io | องค์กร, บริการแบบ managed | ไม่มี | ใช่ (ทีม) | สูงมาก | แบบกำหนดเอง, API, DB | ใบเสนอราคาเฉพาะ |
| ParseHub | เว็บแบบภาพ, เว็บไดนามิก, SMBs | ต่ำ | ใช่ | ปานกลาง | CSV, Excel, JSON, API | ฟรี, $189/เดือน+ |
| Mozenda | องค์กร, คอมพลายแอนซ์ | ต่ำ/ไม่มี | ใช่ | สูงมาก | CSV, Excel, API, DB | ใบเสนอราคาเฉพาะ |
- Thunderbit: เหมาะที่สุดสำหรับการดึงข้อมูลด้วย AI แบบ no-code จากทุกเว็บไซต์ PDF หรือรูปภาพ โดยเฉพาะสำหรับทีมขายและทีมปฏิบัติการ
- Scrapy: เหมาะที่สุดสำหรับนักพัฒนาที่กำลังสร้าง pipeline แบบกำหนดเองและขยายได้
- Octoparse: เหมาะที่สุดสำหรับผู้ใช้ที่ไม่ถนัดเทคนิค แต่ต้องการดึงข้อมูลแบบตั้งเวลาและรันบนคลาวด์
- Import.io: เหมาะที่สุดสำหรับองค์กรที่ต้องการการดึงข้อมูลแบบดูแลให้ครบ
- ParseHub: เหมาะที่สุดสำหรับการดึงข้อมูลแบบเห็นภาพจากเว็บไดนามิกหรือเว็บที่ซับซ้อน
- Mozenda: เหมาะที่สุดสำหรับโปรเจกต์องค์กรขนาดใหญ่ที่ขับเคลื่อนด้วยคอมพลายแอนซ์
แนวทางที่ดีที่สุดในการเลือกและใช้บริษัทดึงข้อมูล
ดึงข้อมูลจากทุกเว็บไซต์ด้วย AI ได้อย่างไร Get Started Free
1. เลือกเครื่องมือให้ตรงกับทักษะเทคนิคและความต้องการของธุรกิจคุณ
ถ้าทีมคุณไม่ได้เขียนโค้ด ให้ให้ความสำคัญกับเครื่องมือ no-code หรือ AI อย่าง Thunderbit, Octoparse หรือ ParseHub ส่วนทีมพัฒนาอาจชอบ Scrapy เพราะควบคุมได้เองมากกว่า
2. คิดเรื่องคอมพลายแอนซ์และความเป็นส่วนตัวตั้งแต่วันแรก
ถ้าคุณอยู่ในอุตสาหกรรมที่มีกฎเข้มงวด ให้เลือกผู้ให้บริการที่มีประวัติด้านคอมพลายแอนซ์แข็งแรง เช่น Mozenda หรือ Import.io และอย่าลืมตรวจสอบข้อกำหนดการใช้งานและนโยบายความเป็นส่วนตัวเสมอ
3. คิดถึงแหล่งข้อมูลและรูปแบบข้อมูล
ต้องดึงจาก PDF, รูปภาพ หรือเว็บแอปแบบไดนามิกใช่ไหม? ตรวจสอบให้แน่ใจว่าเครื่องมือรองรับรูปแบบเหล่านี้โดยตรง
4. วางแผนเรื่องการขยายงานและระบบอัตโนมัติ
ถ้าต้องใช้ข้อมูลเป็นประจำ ให้มองหาฟีเจอร์ตั้งเวลา cloud scraping และการเชื่อม API Thunderbit และ Octoparse ต่างก็มีระบบตั้งเวลาที่แข็งแรง
5. ทดลองก่อนตัดสินใจ
เครื่องมือส่วนใหญ่มีทดลองใช้ฟรี—ลองทำโปรเจกต์นำร่อง ตรวจสอบคุณภาพข้อมูล และดูว่าเครื่องมือผสานเข้ากับเวิร์กโฟลว์ของคุณได้ดีแค่ไหน
6. เชื่อมกับระบบธุรกิจของคุณ
ส่งออกตรงไปยัง CRM, BI tool หรือสเปรดชีต เพื่อให้ได้คุณค่ามากที่สุดและลดงานมือ
7. จัดการข้อมูลอย่างเป็นระบบและมีจริยธรรม
ติดป้ายกำกับข้อมูล เคารพเงื่อนไขของเว็บไซต์ และหลีกเลี่ยงการดึงข้อมูลที่ละเอียดอ่อนหรือเป็นข้อมูลส่วนบุคคล เว้นแต่คุณมีความยินยอมที่เหมาะสม
สรุป: ใช้ประโยชน์จากการดึงข้อมูลให้คุ้มที่สุดในปี 2026
บริษัทดึงข้อมูลที่ใช่สามารถยกระดับธุรกิจคุณได้แบบก้าวกระโดด—ช่วยให้ตัดสินใจดีขึ้น สร้างลีดได้คมขึ้น และขยับตามตลาดได้เร็วขึ้น แต่ภาพรวมของตลาดกำลังเปลี่ยนไว ทั้ง AI คอมพลายแอนซ์ และโมเดล SaaS ต่างก็ยกระดับมาตรฐานขึ้นเรื่อย ๆ
- Thunderbit คืออันดับหนึ่งในใจผมสำหรับทีมที่ต้องการการดึงข้อมูลด้วย AI แบบ no-code จากทุกแหล่งบนเว็บ—เร็ว แม่นยำ และเข้าถึงได้สำหรับทุกคน
- Scrapy และ Octoparse ให้ทั้งพลังและความยืดหยุ่นสำหรับนักพัฒนาและผู้ใช้งานธุรกิจตามลำดับ
- Import.io และ Mozenda คือคำตอบสำหรับองค์กรที่มีงานซับซ้อนและภาระด้านคอมพลายแอนซ์สูง
- ParseHub เหมาะมากสำหรับการดึงข้อมูลแบบเห็นภาพจากเว็บที่ใช้ JavaScript หนัก ๆ หรือมีความไดนามิกสูง
คำแนะนำของผม? ลองหลายตัว คุยกับผู้ให้บริการเกี่ยวกับความต้องการเฉพาะของคุณ และอย่ากลัวที่จะขอสาธิตหรือทำ proof of concept ในปี 2026 ข้อมูลที่มีโครงสร้างไม่ใช่ของแถมอีกต่อไป—แต่มันคือแต้มต่อในการแข่งขันของคุณ
อยากเห็น Thunderbit ทำงานจริงไหม? ดาวน์โหลด Chrome extension แล้วลองดึงข้อมูลจากเว็บแรกของคุณได้ภายในไม่กี่นาที และสำหรับเคล็ดลับเพิ่มเติม ดูได้ที่ Thunderbit Blog
สำรวจ AI Web Scraper ของ Thunderbit
คำถามที่พบบ่อย
1. บริษัทดึงข้อมูลคืออะไร และทำไมธุรกิจถึงต้องใช้?
บริษัทดึงข้อมูลคือผู้ให้บริการเครื่องมือหรือบริการที่ช่วยเก็บ จัดโครงสร้าง และส่งมอบข้อมูลจากเว็บไซต์ เอกสาร หรือแหล่งข้อมูลดิจิทัลอื่น ๆ ธุรกิจใช้สิ่งเหล่านี้เพื่อสนับสนุนการตัดสินใจ การสร้างลีด การวิจัยตลาด และการวิเคราะห์คู่แข่ง
2. จะเลือกอย่างไรระหว่างเครื่องมือ no-code กับโซลูชันสำหรับนักพัฒนา?
ถ้าทีมของคุณไม่มีทักษะเขียนโค้ด ให้เลือกเครื่องมือ no-code หรือ AI อย่าง Thunderbit หรือ Octoparse แต่ถ้าคุณมีนักพัฒนาในทีมและต้องการ pipeline แบบกำหนดเอง Scrapy เป็นตัวเลือกที่ยอดเยี่ยม
3. ความเสี่ยงด้านคอมพลายแอนซ์ที่ควรพิจารณาเมื่อดึงข้อมูลมีอะไรบ้าง?
ควรตรวจสอบเสมอว่าผู้ให้บริการปฏิบัติตามกฎหมายความเป็นส่วนตัว เช่น GDPR, CCPA เคารพเงื่อนไขของเว็บไซต์ และมีการจัดการข้อมูลที่ปลอดภัย Mozenda และ Import.io เป็นผู้นำด้านการดึงข้อมูลที่เน้นคอมพลายแอนซ์
4. เครื่องมือเหล่านี้ดึงข้อมูลจาก PDF หรือรูปภาพได้ไหม?
ได้—เช่น Thunderbit สามารถดึงข้อมูลแบบมีโครงสร้างจาก PDF และรูปภาพด้วย AI ได้ แต่ควรตรวจสอบเสมอว่าเครื่องมือที่คุณเลือก รองรับรูปแบบที่ต้องการหรือไม่
5. การดึงข้อมูลมีค่าใช้จ่ายเท่าไหร่?
ราคาแตกต่างกันไป: Thunderbit เริ่มใช้ฟรี และแพ็กเกจชำระเงินเริ่มที่ $15/เดือน; Octoparse และ ParseHub มีทั้งแพ็กเกจฟรีและเสียเงิน; Import.io และ Mozenda มีราคาองค์กรแบบกำหนดเอง ควรคำนึงถึงปริมาณข้อมูล ความถี่ และความต้องการด้านซัพพอร์ตด้วย
พร้อมปลดล็อกพลังของข้อมูลหรือยัง? พาร์ตเนอร์ด้านการดึงข้อมูลที่ใช่ อยู่ห่างออกไปเพียงคลิกเดียว
ลองใช้ Thunderbit AI Web Scraper วันนี้ Get Started Free
เรียนรู้เพิ่มเติม
- Top 5 Best Web Data Scraping Software in 2026
- Top 6 Essential Web Scraper Tools for 2025 Success
- 7 Most Popular Web Scraping Tools to Use in 2026
- Top 6 Business Data Providers for Smart Decision-Making
- The 6 Best Data Collection Software Tools to Try
- The Best Web Scraping Tools & Software in 2025
- Top 15 AI Scrapers for Data Extraction in 2025
- Top 12 Best Data Extractors to Use for Maximum Efficiency



