
ถ้าเคยใช้ Glassdoor scraper ได้ดีในปี 2022 แต่ตอนนี้กลับได้แต่ 403 เต็มไปหมด คุณไม่ได้เจอปัญหานี้คนเดียว ฟอรัมแทบทุกที่เต็มไปด้วยคำถามเดิม ๆ ว่า "มีใครรู้ไหมว่าทำไม scraper ตัวนี้ถึงใช้ไม่ได้แล้ว?"
คำตอบสั้น ๆ คือ Glassdoor เปลี่ยนระบบไปมากแล้ว Recruit Holdings ได้นำ Glassdoor ไปรวมกับ Indeed ในเดือนกรกฎาคม 2025 ปลดพนักงานไป 1,300 คน และอัปเกรดระบบป้องกันบอทจนการใช้ Selenium แบบทั่วไปหรือ scraper ที่พึ่ง requests ถูกบล็อกตั้งแต่ยังไม่ทันโหลด HTML ไบต์แรก ด้วยสถานะล่าสุดในเดือนกุมภาพันธ์ 2026 การล็อกอินของ Glassdoor ถูกย้ายไปใช้ Indeed Login แบบเต็มรูปแบบแล้ว — ดังนั้นบทความสอนที่ยังอ้างฟอร์มล็อกอินเฉพาะของ Glassdoor จึงพังตั้งแต่ต้นทาง ขณะเดียวกันแพลตฟอร์มนี้ยังมีข้อมูลรวมกว่า 180 ล้านรีวิว เงินเดือน และ insight จาก 2.5 ล้านนายจ้าง ข้อมูลชุดนี้มีค่ามากสำหรับการเทียบค่าตอบแทน HR, วิเคราะห์คู่แข่ง และหาลูกค้าเป้าหมาย — ถ้าคุณเข้าถึงมันได้จริง คู่มือนี้คือเวอร์ชันที่ใช้ได้ หลัง การเปลี่ยนแปลงทั้งหมด และครอบคลุมข้อมูล Glassdoor ทั้ง 3 ประเภท (งาน, รีวิว และเงินเดือน) ไว้ในที่เดียว ผมจะพาคุณไล่ตั้งแต่วิธีใช้ Python พร้อมโค้ดที่ใช้งานได้ในปี 2025 อธิบายว่าอะไรเป็นตัวบล็อกและจะผ่านมันอย่างไร และแถมทางลัดแบบไม่เขียนโค้ดสำหรับคนที่อยากข้ามงานวิศวกรรมไปเลย
ทำไมต้องดึงข้อมูล Glassdoor ด้วย Python ในปี 2025?
Glassdoor ไม่ใช่แค่เว็บหางาน แต่มันคือแหล่งข้อมูลเชิงลึกด้านนายจ้างที่เข้มข้นที่สุดแห่งหนึ่งบนเว็บ — ถูกใช้โดยราว ๆ หนึ่งในสามของบริษัท Fortune 500 และมีผู้เข้าชมไม่ซ้ำประมาณ 55 ล้านคนต่อเดือน ข้อมูลที่อยู่เบื้องหลังหน้าเหล่านี้ถูกนำไปใช้ตัดสินใจจริงในหลายทีม
ตัวอย่างการใช้งานข้อมูล Glassdoor ของแต่ละทีมมีดังนี้:
| กรณีใช้งาน | ข้อมูลที่ต้องใช้ | ผู้ได้ประโยชน์ |
|---|---|---|
| เทียบค่าตอบแทน | การกระจายของเงินเดือน, จำนวนตัวอย่าง | HR, Total Rewards, Operations |
| ติดตามการจ้างงานของคู่แข่ง | รายการงาน, ความถี่การประกาศ | Sales, Strategy, VC/Corp Dev |
| เฝ้าระวังภาพลักษณ์นายจ้าง | เนื้อหารีวิว, แนวโน้มคะแนน, อัตราอนุมัติ CEO | HR, Marketing, Comms |
| หา lead บริษัทที่กำลังโต | รายการงาน + ข้อมูลบริษัท | ทีมขาย, SDRs |
| งานวิจัยตลาด/วิชาการ | ทั้งสามประเภท | นักวิเคราะห์, ที่ปรึกษา, นักวิจัย |
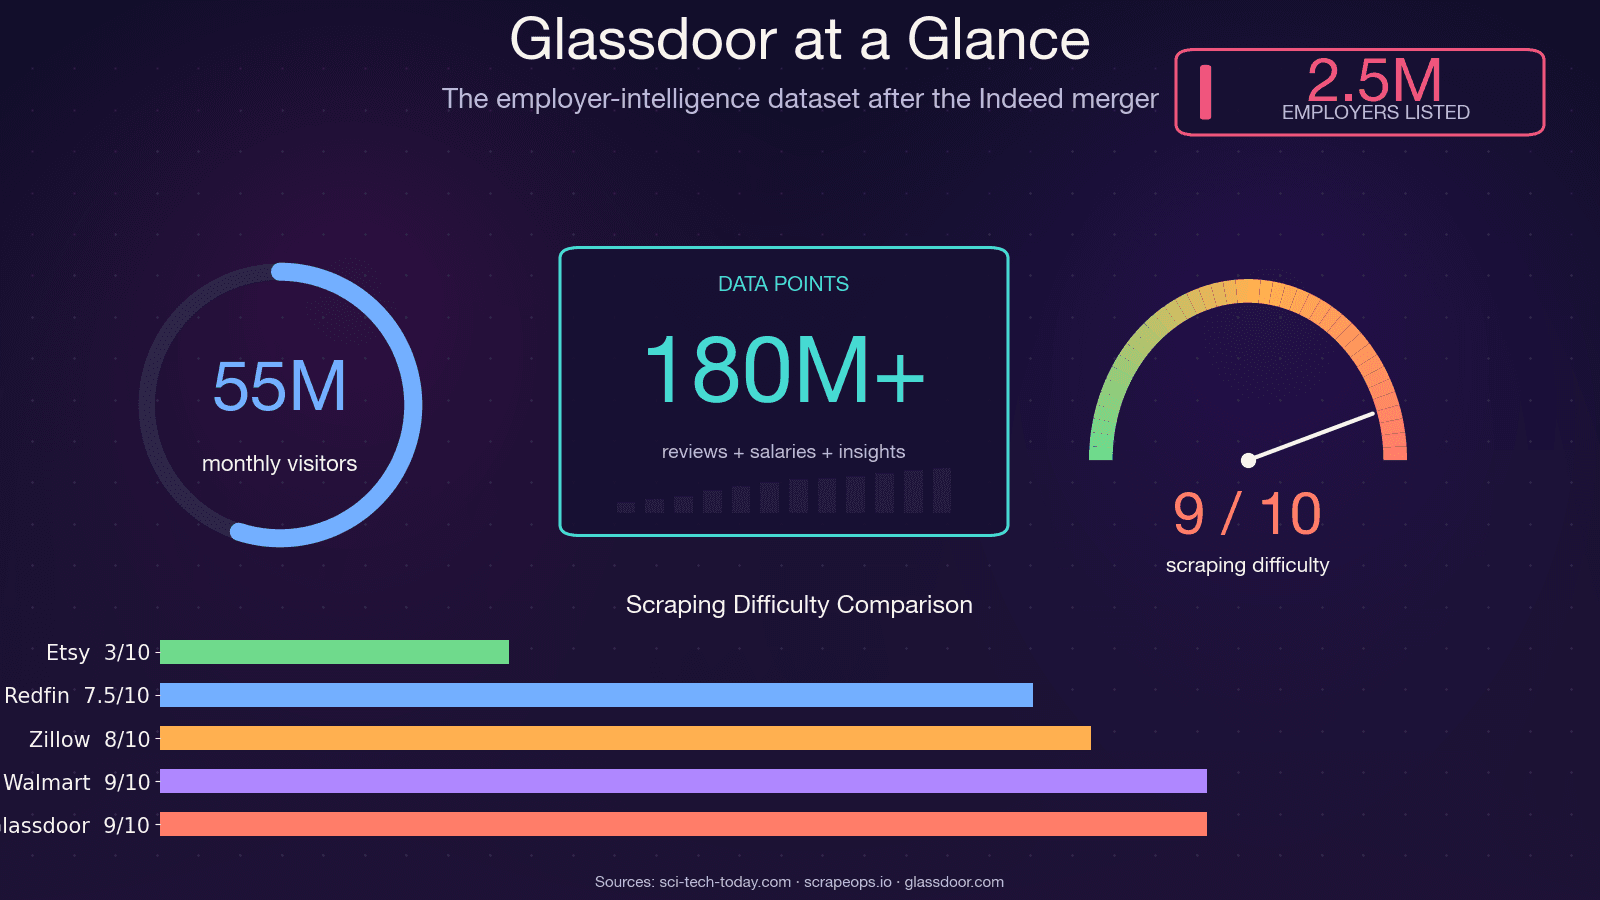
ตอนที่ BLS ไม่สามารถเผยแพร่ข้อมูลตลาดแรงงานในช่วง government shutdown เดือนตุลาคม 2025 ทีม Economic Research ของ Glassdoor เองก็ ออก jobs report ทางเลือก จากชุดข้อมูลของพวกเขา นั่นแสดงให้เห็นว่าบริษัทและนักวิเคราะห์ระดับสถาบันมองข้อมูลชุดนี้สำคัญแค่ไหน
Python ยังเป็นภาษาหลักที่คนเลือกใช้ เพราะ ecosystem แข็งแรงมาก — ทั้ง Playwright สำหรับ automation เบราว์เซอร์, parsel/lxml สำหรับ parsing, curl_cffi สำหรับหลบ TLS fingerprint และชุมชนขนาดใหญ่ที่แชร์แพตเทิร์นใช้งานได้จริง ปัญหาไม่ใช่ Python ปัญหาคือ Glassdoor แคะยากขึ้นมาก
ดึงข้อมูล Glassdoor ด้วย AI Get Started Free
ถ้าคุณอยากมีตัวเลือกแบบไม่เขียนโค้ดสำหรับดึงข้อมูล Glassdoor Thunderbit ช่วยคุณเก็บข้อมูลงาน รีวิว และหน้ารายได้ได้ โดยไม่ต้องสร้างและดูแล Python stack เอง
ข้อมูล Glassdoor แบบไหนที่ดึงได้จริง?
บทความสอนส่วนใหญ่มักพูดถึงแค่รายการงาน แต่จากความต้องการของผู้ใช้ที่ผมติดตามผ่านฟอรัม GitHub issue และคำถามใน Reddit สิ่งที่คนอยากได้มากที่สุดกลับเป็นข้อมูลสองประเภทที่แทบไม่มีใครสอนจริงจัง: รีวิว และ เงินเดือน ด้านล่างคือภาพรวมทั้งหมดว่าข้อมูลในแต่ละหมวดดึงอะไรได้บ้าง
รายการงาน
เป็นประเภทข้อมูลที่เข้าถึงง่ายที่สุด คุณดึงได้ เช่น ชื่อตำแหน่ง, ชื่อบริษัท, สถานที่, ช่วงเงินเดือนโดยประมาณ, คะแนนบริษัท, วันที่โพสต์, ป้าย easy-apply และลิงก์งาน รายการงานบางส่วนดูได้โดยไม่ต้องล็อกอิน แต่ Glassdoor อาจเด้งหน้าล็อกอินขึ้นมาหลังผ่านไปหลายหน้า
รีวิวบริษัท
ตรงนี้จะเริ่มน่าสนใจสำหรับการวิเคราะห์ employer brand ข้อมูลที่ดึงได้ประกอบด้วย: คะแนนรวม, คะแนนย่อย (work-life balance, culture & values, diversity & inclusion, career opportunities, comp & benefits, senior management), ข้อดี, ข้อเสีย, ตำแหน่งงานของผู้รีวิว, วันที่รีวิว และสถานะการจ้างงาน ข้อความรีวิวฉบับเต็มถูกล็อกไว้หลังล็อกอิน — คุณจะเห็นได้แค่บางส่วน แต่เนื้อหาข้อดี/ข้อเสียเต็ม ๆ ต้องยืนยันตัวตนก่อน
ข้อมูลเงินเดือน
เป็นประเภทข้อมูลที่คนต้องการมากที่สุดและน่าหงุดหงิดที่สุดเช่นกัน คุณดึงได้ เช่น ชื่อตำแหน่ง, ช่วงฐานเงินเดือน, ช่วงค่าตอบแทนรวม, จำนวนรายงานเงินเดือน และสถานที่ แต่หน้ารายได้ถูกล็อกหลังล็อกอินแบบเต็มตัว และบางครั้ง Glassdoor ยังเพิ่มขั้นตอน "contribute to unlock" ให้คุณต้องส่งข้อมูลเงินเดือนของตัวเองก่อนถึงจะเห็นข้อมูลคนอื่น ไม่มีบทความคู่แข่งไหนให้โค้ดที่ใช้ได้จริงสำหรับส่วนนี้ — เราจะจัดการให้
อะไรต้องล็อกอิน และอะไรไม่ต้อง
ตารางนี้ช่วยให้คุณไม่ต้องเสียเวลาลองผิดลองถูกกับหน้าที่จะคืนข้อมูลว่าง ๆ:
| ประเภทข้อมูล | ดูได้โดยไม่ล็อกอินไหม? | หมายเหตุ |
|---|---|---|
| ชื่อตำแหน่งงานและข้อมูลพื้นฐาน | ส่วนใหญ่ได้ | อาจมี popup ขึ้นหลังหลายหน้า |
| รายละเอียดงานฉบับเต็ม | ได้บางส่วน | มักถูกล็อกหลังดู 2–3 ครั้ง |
| รีวิวบริษัท (ข้อความเต็ม) | ไม่ได้ — ต้องล็อกอิน | เห็น snippet ได้ แต่ข้อความเต็มถูกล็อก |
| ข้อมูลเงินเดือน | ไม่ได้ — ต้องล็อกอิน | อาจต้องผ่าน "contribute to unlock" ด้วย |
ทำไม Glassdoor scraper เดิมของคุณถึงพังแล้ว
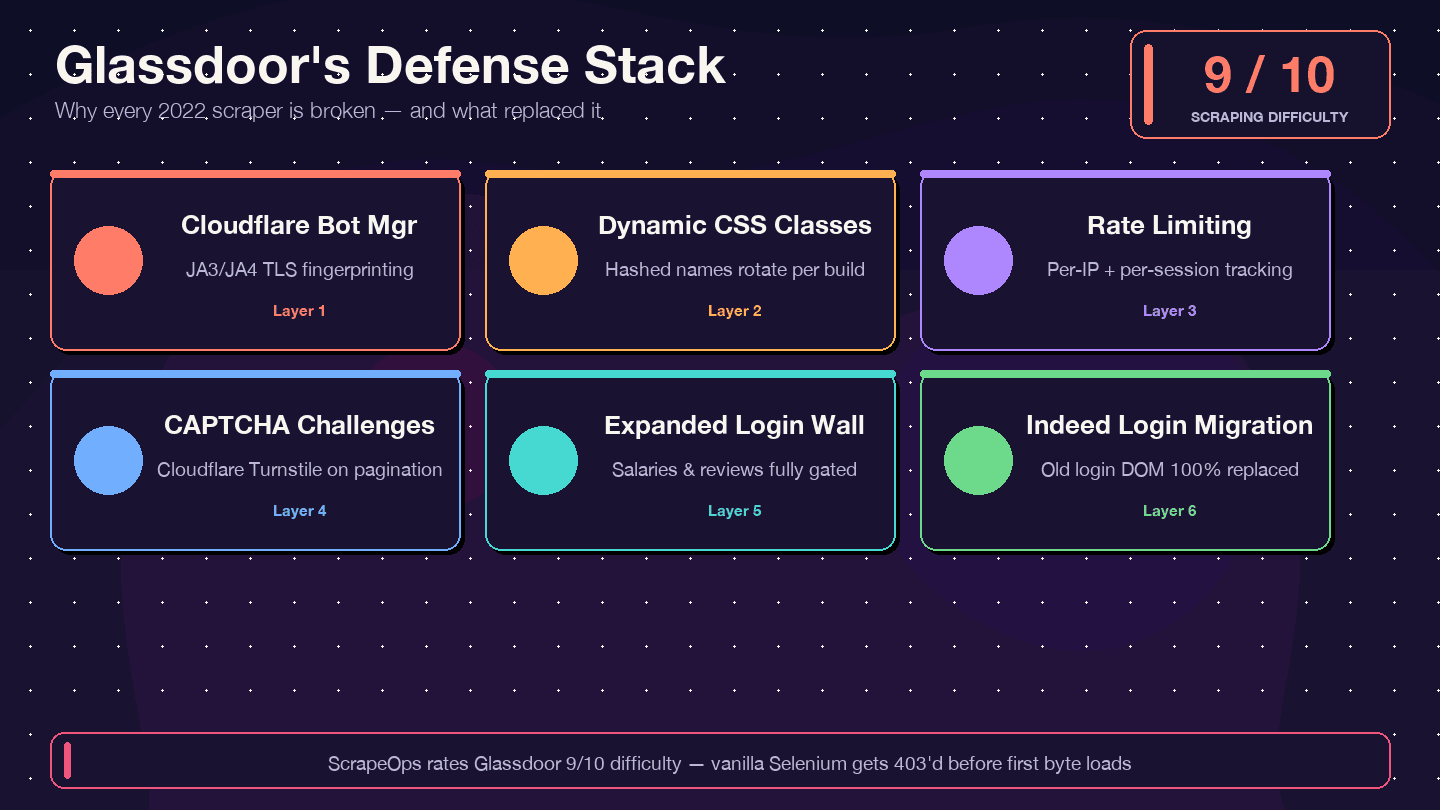
ขอพูดตรง ๆ เลย: ถ้าคุณกำลังคัดลอกโค้ดจากบทความสอนปี 2021–2023 มันจะใช้ไม่ได้แล้ว GitHub repo ของ Glassdoor Selenium scraper ตัวเก่าที่ได้ดาวมากที่สุด (MatthewChatham/glassdoor-review-scraper, ประมาณ 1.4k ดาว) มี issue เปิดค้างอยู่กว่า 12 รายการ — รวมถึง "Glassdoor new UI design", "Cloudflare anti-bot protection" และ "NoSuchElementException" ตัว repo แทบถือว่าถูกทิ้งแล้ว Apify glassdoor-jobs-scraper actor ถูกระบุว่า DEPRECATED และ ScrapeOps ให้คะแนนความยากในการสแครป Glassdoor ไว้ที่ 9/10 ส่วนความยากในการ bypass อยู่ที่ 8/10
สิ่งที่เปลี่ยนไปและทำให้โค้ดเก่าพังมีดังนี้:
| ชั้นการป้องกัน | สิ่งที่เปลี่ยนไป | ผลกับ scraper แบบเดิม |
|---|---|---|
| Cloudflare Bot Management | การตรวจ JA3/JA4 เข้มขึ้นตั้งแต่ปี 2024 | requests/Selenium พื้นฐานโดน 403 ทันที |
| ชื่อ CSS class แบบไดนามิก | ชื่อ class สุ่มใหม่ทุกครั้งที่ build | selector จากบทความเก่าพังแบบเงียบ ๆ |
| จำกัดอัตราและติดตาม session | จำกัดต่อ IP และต่อ session เข้มขึ้น | scraper ถูกบล็อกหลังไม่กี่หน้า |
| CAPTCHA challenges (น่าจะเป็น Cloudflare Turnstile) | เจอบ่อยขึ้น โดยเฉพาะตอน paginate | เบราว์เซอร์แบบ headless โดนทดสอบ |
| เพิ่มกำแพงล็อกอิน | ประเภทหน้าที่ต้องยืนยันตัวตนเพิ่มขึ้น | หน้ารายได้และรีวิวคืนค่าว่าง |
| ย้ายไป Indeed Login (ก.พ. 2026) | ฟอร์มล็อกอินของ Glassdoor ถูกแทนทั้งหมด | โค้ดที่ชี้ไป DOM เดิมใช้ไม่ได้แล้ว |
คู่มือปี 2026 ของ Scrapfly เตือนชัดเจนว่า: "Glassdoor is known for its high blocking rate, so if you get None values while running the Python code, it's likely you're getting blocked." และ โพสต์ใน DEV.to เดือนมีนาคม 2026 ก็พูดตรง ๆ ว่า: "Simple HTTP requests with requests or httpx get blocked instantly."
วิธีรับมือที่ผมจะสาธิตให้ดู — Patchright (Playwright fork แบบ stealth), การใช้ตัวเลือก selector จาก data-test, rotating residential proxies และ persistent session ที่ยืนยันตัวตนแล้ว — ถูกออกแบบมาให้รับมือกับแต่ละชั้นป้องกันนี้โดยเฉพาะ
Glassdoor API เทียบกับ Python scraping: เลือกวิธีที่เหมาะก่อน
ในฟอรัมมีคนถามกันบ่อยว่า "งั้นใช้ Glassdoor API ไปเลยได้ไหม?" — คำตอบคือ: ไม่ได้
Legacy Glassdoor Partner API ปิดรับผู้สมัครใหม่แล้ว Developer portal ยังเปิดอยู่ในเชิงเทคนิค แต่ ตอบกลับด้วย HTTP 403 จริง ๆ ไม่มี public reviews endpoint ตั้งแต่แรก — MatthewChatham สร้าง scraper ขึ้นมาเพราะ "Glassdoor ไม่มี API สำหรับรีวิว" และภายใต้ Indeed Publisher API ก็ไม่มีเส้นทาง migration สำหรับรีวิวหรือเงินเดือน
นี่คือการเทียบแบบตรงไปตรงมา:
| ปัจจัย | Glassdoor Partner API v1 | Python Scraping | Thunderbit (ไม่เขียนโค้ด) |
|---|---|---|---|
| การเข้าถึง | ปิดรับผู้สมัครใหม่ | เปิดให้ทำเอง | Chrome extension |
| รายการงาน | จำกัด/กำลังยุติ | ทำได้ถ้าเขียนเอง | ทำได้ |
| รีวิวบริษัท | ไม่เคยมีให้ใช้งานสาธารณะ | ได้ (ต้องล็อกอิน) | ได้ (ผ่าน Browser Mode) |
| ข้อมูลเงินเดือน | ไม่เคยมีให้ใช้งานสาธารณะ | ได้ (ต้องล็อกอิน) | ได้ |
| Rate limit | ไม่ได้ระบุ | คุณกำหนดเอง | คิดตามเครดิต |
| ความยุ่งยากในการตั้งค่า | สมัครแอปใหม่ไม่ได้แล้ว | หลายชั่วโมงถึงหลายวัน | ประมาณ 2 นาที |
| ภาระการดูแล | ไม่มี | สูง (HTML เปลี่ยนโค้ดพัง) | ต่ำ (AI ช่วยแนะนำฟิลด์ใหม่) |
ถ้าคุณต้องการข้อมูลรีวิวหรือเงินเดือน — ซึ่งคนอ่านส่วนใหญ่ต้องการ — ทางเลือกที่ใช้งานได้จริงมีแค่ Python scraping หรือเครื่องมือ no-code เท่านั้น
ก่อนเริ่ม
- ระดับความยาก: ปานกลาง (ควรใช้ Python และ terminal ได้คล่อง)
- เวลาที่ต้องใช้: ประมาณ 30–60 นาทีสำหรับตั้งค่าครั้งแรก; หลังจากนั้นประมาณ 10 นาทีต่อประเภทข้อมูล
- สิ่งที่ต้องมี:
- Python 3.10+ (แนะนำ 3.11 หรือ 3.12)
- ติดตั้ง Chrome ไว้แล้ว
- บัญชี Glassdoor (ฟรี — ต้องใช้กับข้อมูลเงินเดือนและรีวิว)
- Rotating residential proxies (ถ้าจะสแครปเกินไม่กี่หน้า)
- ตัวเลือกเสริม: Thunderbit Chrome Extension ถ้าอยากใช้เส้นทาง no-code
เครื่องมือและไลบรารีสำหรับสแครป Glassdoor ด้วย Python ในปี 2025
ภูมิทัศน์ของเครื่องมือเปลี่ยนไปมาก นี่คือสิ่งที่ใช้ได้จริงกับระบบป้องกันปัจจุบันของ Glassdoor
ทำไม Patchright ถึงเป็นตัวเลือกที่ดีที่สุดสำหรับ Glassdoor
Patchright คือ stealth fork ของ Playwright ที่แก้ช่องโหว่ Runtime.Enable CDP leak — สาเหตุเชิงเทคนิคที่ทำให้ Playwright แบบปกติแพ้เว็บไซต์ที่มี Cloudflare ป้องกันอยู่ มันใช้ API ชุดเดียวกับ Playwright เป๊ะ ๆ ดังนั้นถ้าคุณใช้ Playwright เป็น คุณก็ใช้ Patchright ได้ Version 1.58.2 (มีนาคม 2026) คือเวอร์ชันปัจจุบันและยังดูแลต่อเนื่อง
เทียบกับทางเลือกอื่น:
- Vanilla Playwright: ถูกตรวจจับได้บนหน้า login ของ Glassdoor เพราะ Runtime.Enable leak
- Selenium + undetected-chromedriver: เวอร์ชันล่าสุดของ undetected-chromedriver ออกเมื่อกุมภาพันธ์ 2024 — ถือว่าเกือบเป็น legacy แล้ว benchmark ของ Scrapfly พบว่ามัน "failed on every domain in our test"
- requests + BeautifulSoup: ไม่สามารถเรนเดอร์ JavaScript และถูก Cloudflare TLS fingerprint บล็อกทันที
- curl_cffi: ดีมากสำหรับ fast path (เร็วกว่าเบราว์เซอร์ 10–20 เท่า) ในกรณีที่หน้าเว็บส่ง
__NEXT_DATA__มาใน HTML ตั้งต้น แต่ใช้กับหน้า login หรือ challenge ระหว่างทางไม่ได้
ไลบรารีเสริม
- parsel (1.11.0) หรือ lxml (6.0.4): parsing HTML/XPath ได้เร็ว
- csv หรือ pandas: ส่งออกข้อมูล
- asyncio: ใช้สแครปแบบ async ให้ paginate ได้เร็วขึ้น
Proxy: ต้องเป็นแบบ Residential เท่านั้น
Cloudflare ของ Glassdoor ชอบทดสอบ ASN ของดาต้าเซ็นเตอร์อย่างหนัก Residential proxy รายงานว่าช่วยลดอัตราถูกบล็อกจาก 20–30% ลงเหลือต่ำกว่า 5% ราคาเริ่มต้นอยู่ราว ๆ $1.75/GB จาก IPRoyal (ช่วงโปรโมชัน) หรือ $3.00/GB จาก Decodo สำหรับงาน production ควรเผื่องบประมาณ $3–8/GB ตามปริมาณใช้งาน
การหน่วงเวลาแบบสุ่มระหว่าง request (อย่างน้อย 3–8 วินาที และ 5–15 วินาทีสำหรับรันยาว ๆ) สำคัญมากไม่ว่าคุณจะใช้ proxy คุณภาพไหนก็ตาม
ขั้นที่ 1: ตั้งค่า Python environment
สร้างโฟลเดอร์โปรเจกต์และติดตั้งชุดเครื่องมือที่แนะนำ:
mkdir glassdoor-scraper && cd glassdoor-scraper
python3.11 -m venv .venv
source .venv/bin/activate
pip install --upgrade pip

# Core stack
pip install patchright==1.58.2 parsel==1.11.0

# Install browser binaries
patchright install chromium

# Optional: fast path for __NEXT_DATA__ extraction
pip install "curl_cffi==0.15.0"
คุณควรเห็น Patchright ดาวน์โหลด Chromium binary ถ้า patchright install chromium ล้มเหลว ให้ตรวจสอบว่าพื้นที่ดิสก์พอหรือไม่ (ประมาณ 300MB) และเวอร์ชัน Python เป็น 3.10+ หรือเปล่า
ขั้นที่ 2: เปิด Patchright และเข้า Glassdoor
นี่คือแพตเทิร์นการเปิดเบราว์เซอร์พื้นฐานที่ใช้ได้กับ Cloudflare ของ Glassdoor:
from patchright.sync_api import sync_playwright
import random, time

with sync_playwright() as p:
    browser = p.chromium.launch(
        headless=False,          # headless ยังถูกตรวจจับได้ง่ายกว่า
        channel="chrome",        # ใช้ Chrome จริง ไม่ใช่ Chromium ที่มากับแพ็กเกจ
    )
    context = browser.new_context(
        viewport={"width": 1440, "height": 900},
        locale="en-US",
        timezone_id="America/New_York",
        user_agent=(
            "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) "
            "AppleWebKit/537.36 (KHTML, like Gecko) "
            "Chrome/134.0.0.0 Safari/537.36"
        ),
    )
    page = context.new_page()
    page.goto(
        "https://www.glassdoor.com/Job/new-york-data-engineer-jobs-"
        "SRCH_IL.0,8_IC1132348_KO9,22.htm"
    )

    # ปิด overlay ล็อกอิน — เนื้อหายังอยู่ใน DOM
    page.add_style_tag(content="""
        #HardsellOverlay, .LoginModal { display: none !important; }
        body { overflow: auto !important; position: initial !important; }
    """)

    page.wait_for_selector("[data-test='jobListing']")
    print("หน้าโหลดแล้ว — เห็นรายการงานแล้ว")
มีจุดสำคัญสองสามอย่างในนี้ channel="chrome" บอก Patchright ให้ใช้ Chrome ที่ติดตั้งอยู่จริงแทน Chromium ที่มาพร้อมแพ็กเกจ — ทำให้ fingerprint ของเบราว์เซอร์ดูสมจริงมากขึ้น เทคนิค add_style_tag ใช้ซ่อนหน้าล็อกอินของ Glassdoor (ชื่อ #HardsellOverlay) โดยไม่ต้องคลิกอะไรเลย Scrapfly ยืนยัน ว่า "all of the content is still there, it's just covered up by the overlay" — HTML มีข้อมูลอยู่แล้วไม่ว่า modal จะโชว์อยู่หรือไม่
คุณควรเห็นหน้าต่าง Chrome เปิดขึ้น ไปยังหน้าค้นหางานของ Glassdoor และแสดงการ์ดรายการงานได้โดยไม่มี popup ล็อกอินมาบัง
ขั้นที่ 3: ดึงรายการงานจาก Glassdoor
หา selector ที่เสถียร
Glassdoor เปลี่ยนชื่อ CSS class ทุกครั้งที่ build ดังนั้น selector อย่าง .jobCard_xyz123 จากบทความปี 2023 จะคืนค่าว่างแบบเงียบ ๆ ในตอนนี้ ให้ใช้ data-test attributes แทน เพราะนี่คือ convention ภายในของ Glassdoor สำหรับ QA และมักคงที่ข้ามการ deploy
นี่คือ selector อ้างอิงสำหรับฟิลด์ของรายการงาน:
| ฟิลด์ | Selector |
|---|---|
| กล่องการ์ดงาน | [data-test="jobListing"] |
| ชื่อตำแหน่งงาน | [data-test="job-title"] |
| ลิงก์งาน | a[data-test="job-link"] |
| ชื่อบริษัท | [data-test="employer-name"] |
| สถานที่ | [data-test="emp-location"] |
| ช่วงเงินเดือน | [data-test="detailSalary"] |
| คะแนนบริษัท | [data-test="rating"] |
| วันที่โพสต์ | [data-test="job-age"] |
| ปุ่มหน้าถัดไป | [data-test="pagination-next"] |
ดึงข้อมูลงาน
from parsel import Selector
import csv, random, time

def scrape_jobs(page, max_pages=5):
    all_jobs = []

    for page_num in range(1, max_pages + 1):
        html = page.content()
        sel = Selector(text=html)
        cards = sel.css('[data-test="jobListing"]')

        if not cards:
            print(f"Page {page_num}: ไม่พบการ์ดงาน — อาจโดนบล็อกหรือ selector เปลี่ยน")
            break

        for card in cards:
            job = {
                "title": card.css('[data-test="job-title"]::text').get("").strip(),
                "company": card.css('[data-test="employer-name"]::text').get("").strip(),
                "location": card.css('[data-test="emp-location"]::text').get("").strip(),
                "salary": card.css('[data-test="detailSalary"]::text').get("").strip(),
                "rating": card.css('[data-test="rating"]::text').get("").strip(),
                "link": card.css('a[data-test="job-link"]::attr(href)').get(""),
                "posted": card.css('[data-test="job-age"]::text').get("").strip(),
            }
            if job["link"] and not job["link"].startswith("http"):
                job["link"] = "https://www.glassdoor.com" + job["link"]
            all_jobs.append(job)

        print(f"Page {page_num}: ดึงงานได้ {len(cards)} รายการ")

        # Pagination
        next_btn = page.query_selector('[data-test="pagination-next"]')
        if next_btn and page_num < max_pages:
            next_btn.click()
            time.sleep(random.uniform(3, 8))
            page.wait_for_selector("[data-test='jobListing']")
        else:
            break

    return all_jobs
บันทึกเป็น CSV
def save_to_csv(jobs, filename="glassdoor_jobs.csv"):
    if not jobs:
        print("ไม่มีข้อมูลงานให้บันทึก")
        return
    keys = jobs[0].keys()
    with open(filename, "w", newline="", encoding="utf-8") as f:
        writer = csv.DictWriter(f, fieldnames=keys)
        writer.writeheader()
        writer.writerows(jobs)
    print(f"บันทึกงาน {len(jobs)} รายการลงใน {filename}")
ข้อควรรู้เรื่องข้อจำกัดของ pagination: Glassdoor จำกัดผลการค้นหาประมาณ 30 หน้าไม่ว่าจำนวนทั้งหมดจะมากแค่ไหน ถ้าคุณต้องการครอบคลุมมากกว่านี้ ให้ใช้ตัวกรอง (สถานที่, ประเภทงาน, ช่วงเงินเดือน) เพื่อแยกการค้นหาแต่ละชุด แทนการพยายามไล่หน้าต่อไปเกินลิมิต
จากการทดสอบของผม การดึงงาน 5 หน้า (ประมาณ 75 งาน) ใช้เวลาราว 45 วินาทีเมื่อมีการหน่วงแบบสุ่ม ถ้าทำด้วยมือแบบคัดลอกวาง งานเดียวกันอาจกินเวลาอย่างน้อย 20 นาที
ขั้นที่ 4: ดึงรีวิวบริษัทจาก Glassdoor
นี่คือส่วนที่บทความสอนอื่น ๆ แทบไม่มีโค้ดใช้งานได้จริงให้ดู รีวิวคือที่เก็บข้อมูลเชิงลึกของนายจ้างตัวจริง — sentiment analysis, สัญญาณเรื่องวัฒนธรรมองค์กร, และ red flag เกี่ยวกับผู้บริหาร
ไปยังหน้ารวมรีวิว
URL ของรีวิวใช้รูปแบบนี้: /Reviews/{Company}-Reviews-E{id}.htm คุณหาค่า employer ID ได้จากการค้นหาบริษัทใน Glassdoor แล้วดูจาก URL
def navigate_to_reviews(page, company_reviews_url):
    page.goto(company_reviews_url)
    page.add_style_tag(content="""
        #HardsellOverlay, .LoginModal { display: none !important; }
        body { overflow: auto !important; position: initial !important; }
    """)
    page.wait_for_selector('[data-test="review"]', timeout=15000)
BFF endpoint ที่ซ่อนอยู่ (ทางที่สะอาดที่สุด)
นี่คือการค้นพบสำคัญที่สุดจากการวิจัยของผม: รีวิวของ Glassdoor มี internal JSON API ที่ใช้งานได้จริง ซึ่งข้ามการ parse HTML ไปเลย repo ของ Scrapfly scrapers มีการอธิบาย endpoint นี้ไว้ และมันเชื่อถือได้มากกว่า scraping จาก DOM มาก
import json, re, requests

def get_review_ids(page):
    """ดึง employerId และ dynamicProfileId จาก HTML ของหน้ารวมรีวิว"""
    html = page.content()
    sel = Selector(text=html)
    script_text = sel.xpath(
        "//script[contains(text(), 'profileId')]/text()"
    ).get("")
    employer_match = re.search(r'"employer"\s*:\s*(\{[^}]+\})', script_text)
    if employer_match:
        meta = json.loads(employer_match.group(1))
        return meta.get("id"), meta.get("profileId")
    return None, None

def fetch_reviews_bff(page, employer_id, profile_id, max_pages=5):
    """เรียก internal BFF endpoint ของ Glassdoor เพื่อดึงข้อมูลรีวิวแบบมีโครงสร้าง"""
    all_reviews = []
    cookies = {c["name"]: c["value"] for c in page.context.cookies()}

    for pg in range(1, max_pages + 1):
        payload = {
            "applyDefaultCriteria": True,
            "employerId": employer_id,
            "dynamicProfileId": profile_id,
            "employmentStatuses": ["REGULAR", "PART_TIME"],
            "language": "eng",
            "onlyCurrentEmployees": False,
            "page": pg,
            "pageSize": 10,
            "sort": "DATE",
            "textSearch": "",
        }
        resp = requests.post(
            "https://www.glassdoor.com/bff/employer-profile-mono/employer-reviews",
            json=payload,
            cookies=cookies,
            headers={"Content-Type": "application/json"},
        )
        if resp.status_code != 200:
            print(f"BFF ส่งกลับ {resp.status_code} ในหน้า {pg}")
            break

        data = resp.json()
        reviews = data.get("data", {}).get("employerReviews", {}).get("reviews", [])
        total_pages = data.get("data", {}).get("employerReviews", {}).get("numberOfPages", 1)

        for r in reviews:
            all_reviews.append({
                "title": r.get("summary", ""),
                "rating": r.get("ratingOverall"),
                "pros": r.get("pros", ""),
                "cons": r.get("cons", ""),
                "author_role": r.get("jobTitle", {}).get("text", ""),
                "date": r.get("reviewDateTime", ""),
                "recommend": r.get("isRecommend"),
            })

        print(f"Reviews page {pg}/{total_pages}: ได้รีวิว {len(reviews)} รายการ")
        if pg >= total_pages:
            break
        time.sleep(random.uniform(3, 6))

    return all_reviews
BFF endpoint จะให้ JSON ที่สะอาดพร้อมฟิลด์รีวิวครบถ้วน — ไม่ต้อง parse HTML และไม่ต้องกลัว selector พัง คุณต้องใช้ session cookies จาก Playwright context ที่ล็อกอินแล้ว (อธิบายในขั้นที่ 6 ด้านล่าง) และต้องดึง employerId กับ dynamicProfileId จาก HTML ของหน้ารวมรีวิวก่อน
selector สำรองแบบ HTML สำหรับรีวิว
ถ้า BFF endpoint เปลี่ยน หรือคุณอยาก parse จาก DOM เอง นี่คือ data-test selectors ที่ค่อนข้างเสถียร:
| ฟิลด์ | Selector |
|---|---|
| กล่องรีวิว | [data-test="review"] |
| หัวข้อ | [data-test="review-title"] |
| คะแนนรวม | [data-test="overall-rating"] |
| ข้อดี | [data-test="pros"] |
| ข้อเสีย | [data-test="cons"] |
| วันที่ | [data-test="review-date"] |
| ตำแหน่งของผู้เขียนรีวิว | [data-test="author-jobTitle"] |
ขั้นที่ 5: ดึงข้อมูลเงินเดือนจาก Glassdoor
หน้ารายได้ถูกล็อกหลังล็อกอินทั้งหมด คุณต้องมี session ที่ยืนยันตัวตนแล้ว (ขั้นที่ 6) ก่อนโค้ดส่วนนี้จะคืนข้อมูลจริง
ไปยังหน้ารายได้
URL ของเงินเดือนใช้รูปแบบ: /Salary/{Company}-Salaries-E{id}.htm และแบ่งหน้าเป็น _P{n}.htm
def scrape_salaries(page, salary_url, max_pages=3):
    all_salaries = []

    for pg in range(1, max_pages + 1):
        url = salary_url if pg == 1 else salary_url.replace(".htm", f"_P{pg}.htm")
        page.goto(url)
        page.add_style_tag(content="""
            #HardsellOverlay { display: none !important; }
            body { overflow: auto !important; position: initial !important; }
        """)
        time.sleep(random.uniform(3, 7))

        html = page.content()
        sel = Selector(text=html)
        items = sel.css('[data-test="salary-item"]')

        if not items:
            print(f"Salary page {pg}: ไม่พบรายการ — อาจติดล็อกอินหรือถูกบล็อก")
            break

        for item in items:
            salary = {
                "job_title": item.css('[class*="SalaryItem_jobTitle__"]::text').get("").strip(),
                "salary_range": item.css('[class*="SalaryItem_salaryRange__"]::text').get("").strip(),
                "count": item.css('[class*="SalaryItem_salaryCount__"]::text').get("").strip(),
            }
            all_salaries.append(salary)

        print(f"Salary page {pg}: ดึงข้อมูลได้ {len(items)} รายการ")

    return all_salaries
สังเกตแพตเทิร์น [class*="SalaryItem_jobTitle__"] ที่ใช้จับ prefix ของ class เพราะหน้ารายได้ของ Glassdoor ใช้ class แบบ CSS-module-hashed (เช่น SalaryItem_jobTitle__XWGpT) โดย suffix ที่เป็น hash จะเปลี่ยนทุกครั้งที่ deploy แต่ prefix ยังเหมือนเดิม อย่า hardcode ชื่อ class เต็ม ๆ
ขั้นที่ 6: ข้ามกำแพงล็อกอินของ Glassdoor
นี่คือจุดสำคัญที่สุดที่จะปลดล็อกทั้งข้อมูลเงินเดือนและข้อความรีวิวเต็ม วิธีการคือ: ล็อกอินด้วยตัวเองครั้งเดียวในเบราว์เซอร์ที่มองเห็นได้ เซฟสถานะ session ที่ล็อกอินไว้ แล้วนำกลับมาใช้ซ้ำกับรอบสแครปถัดไปทั้งหมด
บันทึก session ที่ยืนยันตัวตนแล้ว
รันสคริปต์นี้ครั้งเดียว มันจะเปิดหน้าต่าง Chrome ไปยังหน้า login ของ Glassdoor (ซึ่งตอนนี้ redirect ไปที่ Indeed Login) และรอให้คุณล็อกอินเอง:
import asyncio
from pathlib import Path
from patchright.async_api import async_playwright

STATE_FILE = Path("glassdoor_state.json")

async def login_and_save():
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=False, channel="chrome")
        context = await browser.new_context(
            viewport={"width": 1366, "height": 800},
            locale="en-US",
        )
        page = await context.new_page()
        await page.goto("https://www.glassdoor.com/profile/login_input.htm")
        print("ล็อกอินในหน้าต่างเบราว์เซอร์ แล้วกด Enter ที่นี่...")
        input()
        await context.storage_state(path=str(STATE_FILE))
        print(f"บันทึก session ไว้ที่ {STATE_FILE}")
        await browser.close()

asyncio.run(login_and_save())
หลังจากล็อกอินและกด Enter แล้ว Patchright จะเซฟ cookies และ local storage ทั้งหมดลงใน glassdoor_state.json ไฟล์นี้จะเก็บ gdId, GSESSIONID, cf_clearance และ auth tokens ของคุณไว้
นำ session กลับมาใช้ตอนสแครป
การรันสแครปทุกครั้งหลังจากนั้นจะโหลด state ที่บันทึกไว้ — ไม่ต้องล็อกอินเองอีก:
async def scrape_with_auth(target_url):
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True, channel="chrome")
        context = await browser.new_context(
            storage_state="glassdoor_state.json"
        )
        page = await context.new_page()
        await page.goto(target_url)
        await page.add_style_tag(
            content="#HardsellOverlay{display:none!important}"
        )
        await page.wait_for_load_state("networkidle")
        html = await page.content()
        await browser.close()
        return html
Session ที่บันทึกไว้โดยปกติมีอายุการใช้งานราว 20–30 นาทีของการใช้งานจริงก่อน Glassdoor จะทดสอบซ้ำ สำหรับการสแครปที่ยาวนาน ให้ใส่เงื่อนไขตรวจสอบไว้ว่า ถ้าหน้าใดหน้าหนึ่งที่ควรมีข้อมูลกลับได้ศูนย์รายการ ให้รันสคริปต์ล็อกอินใหม่เพื่อรีเฟรช state file
ตรวจจับและปิด popup ล็อกอิน
สำหรับหน้าที่ถูกล็อกบางส่วน (เช่นหน้ารายการงานที่เห็นข้อมูลได้แต่มี modal บัง) เทคนิคฉีด CSS ที่ใช้ก่อนหน้านี้ยังใช้ได้:
page.add_style_tag(content="""
    #HardsellOverlay, .LoginModal { display: none !important; }
    body { overflow: auto !important; position: initial !important; }
""")
วิธีนี้ใช้ได้เฉพาะเมื่อ HTML ด้านล่าง overlay มีข้อมูลอยู่แล้วจริง ๆ ถ้าเป็นหน้าที่ล็อกฝั่งเซิร์ฟเวอร์เต็มรูปแบบ (เงินเดือน, หน้ารีวิวลึก ๆ) session ที่ยืนยันแล้วจากขั้นที่ 6 คือทางเดียว
เทคนิคช่วยให้ Glassdoor scraper ของคุณอยู่รอด
Glassdoor อัปเดต frontend บ่อยมาก นี่คือวิธีทำให้ scraper ทนทานขึ้น
ใช้ data-test attributes แทน class name
Glassdoor สุ่มชื่อ CSS class แต่ data-test attributes มักคงเดิมเสมอ ให้ใช้ [data-test="jobListing"] แทน .jobCard_abc123 ทุกครั้งที่ทำได้ และเมื่อ data-test ไม่มี (อย่างฟิลด์ในหน้ารายได้) ให้ใช้ prefix-match pattern: [class*="SalaryItem_jobTitle__"]
หมุน proxy และสุ่มดีเลย์
ใช้ rotating residential proxies — IP จากดาต้าเซ็นเตอร์มักโดนทดสอบแทบจะทันที เพิ่มการหน่วงแบบสุ่ม 3–8 วินาทีระหว่างโหลดหน้า (5–15 วินาทีสำหรับรันยาว) และถ้าทำได้ให้หลีกเลี่ยงช่วงเวลาทำงานของสหรัฐ เพราะระบบ behavioral detection ของ Cloudflare มักเข้มที่สุด
เฝ้าระวังเมื่อโค้ดเริ่มพัง
ใส่เช็กง่าย ๆ ใน scraper ของคุณ: ถ้าหน้าใดหน้าหนึ่งที่ควรมีข้อมูลกลับดึงได้ศูนย์รายการ ให้ถือว่าเป็น selector พัง ไม่ใช่ข้อมูลไม่มี แล้วแจ้งเตือนตัวเอง ควรรัน test scrape เล็ก ๆ ทุกสัปดาห์เพื่อจับปัญหาแต่เนิ่น ๆ — Glassdoor deploy การเปลี่ยนแปลง frontend โดยไม่ประกาศล่วงหน้า
ใช้ทางลัด __NEXT_DATA__ เมื่อเป็นไปได้
Glassdoor เป็นแอป Next.js + Apollo GraphQL หลายหน้าจะส่ง <script id="__NEXT_DATA__"> ที่มี GraphQL cache ทั้งชุดมาเป็น JSON การ parse วิธีนี้ทนทานกว่า scraping จาก DOM มาก และ ข้าม Hardsell overlay ได้ทั้งหมด:
import json

def extract_next_data(html):
    sel = Selector(text=html)
    raw = sel.css("script#__NEXT_DATA__::text").get()
    if raw:
        return json.loads(raw)["props"]["pageProps"].get("apolloCache", {})
    return None
ฟังก์ชันนี้จะคืน Apollo cache ที่มีโครงสร้างพร้อมฟิลด์งาน รีวิว และเงินเดือนครบ ไม่ต้องใช้ CSS selector เลย เป็นวิธีดึงข้อมูลที่ทนทานที่สุดที่มีอยู่ เพราะเป็นข้อมูลเดียวกับที่ขับเคลื่อน frontend แบบ React ของ Glassdoor
ข้ามโค้ดไปเลย: ดึง Glassdoor ด้วย Thunderbit (ไม่ต้องใช้ Python)
ไม่ใช่ทุกคนที่อ่านบทความนี้จะเป็นนักพัฒนา ทีม HR, recruiters, sales ops analysts และนักวิจัยตลาดก็ต้องใช้ข้อมูล Glassdoor เหมือนกัน — และไม่ควรต้องมานั่งจัดการ Playwright contexts กับ proxy rotation เพื่อให้ได้ข้อมูล
Thunderbit คือ AI Web Scraper Chrome Extension ที่ดึงข้อมูลงาน รีวิว และเงินเดือนได้เหมือนกันโดยไม่ต้องเขียนโค้ดแม้แต่บรรทัดเดียว ผมทำงานอยู่ในทีม Thunderbit ดังนั้นขอพูดตรงไปตรงมาว่ามีส่วนเกี่ยวข้องอยู่ — แต่เหตุผลที่ผมใส่มันไว้ที่นี่คือ มันแก้สองปัญหายากที่สุดของการสแครป Glassdoor ได้จริง
Thunderbit ทำงานกับ Glassdoor อย่างไร
ขั้นตอนมีแค่สองคลิก:
- เปิดหน้า Glassdoor ใดก็ได้ใน Chrome (หน้าค้นหางาน, หน้ารวมรีวิวบริษัท, หน้ารายได้)
- คลิก AI Suggest Fields ใน sidebar ของ Thunderbit — AI จะอ่าน DOM ของหน้าและเสนอคอลัมน์ให้ (job title, company, rating, salary range, pros, cons ฯลฯ)
- คลิก Scrape — ระบบจะดึงข้อมูลออกมาเป็นตาราง โดยไม่ต้องใช้ CSS selector หรือโค้ด automation เบราว์เซอร์
Thunderbit มี Glassdoor company scraper template สำเร็จรูปที่ดึงข้อมูลได้มากกว่า 23 ฟิลด์ต่อบริษัทในรันเดียว สำหรับรายการงาน รีวิว หรือเงินเดือน โฟลว์ AI Suggest Fields แบบทั่วไปก็รองรับ URL ของ Glassdoor ได้ทุกแบบ
จัดการกำแพงล็อกอินโดยไม่ต้องเขียนโค้ด
นี่คือข้อได้เปรียบเชิงโครงสร้างของ Thunderbit สำหรับ Glassdoor โดยเฉพาะ Browser Mode ทำงานอยู่ใน session Chrome ของคุณเอง — ถ้าคุณล็อกอิน Glassdoor ไว้ใน Chrome อยู่แล้ว Thunderbit จะใช้ cookies ชุดนั้นอัตโนมัติ กำแพงล็อกอินของ salary และ review ที่ขวาง scraper ฝั่ง server-side จึงไม่เป็นปัญหาอีกต่อไป ไม่ต้องจัดการ cookies ไม่ต้องเก็บ persistent context และไม่ต้องเขียนโค้ด session
สแครปหน้าย่อยเพื่อเพิ่มข้อมูล
เริ่มจากหน้ารายการ (เช่น 30 บริษัทจากการค้นหา) ให้ Thunderbit ไล่แถวออกมาก่อน แล้วเปิด subpage scraping เพื่อเข้าไปยังหน้ารวมรีวิวหรือรายได้ของแต่ละบริษัท และเติมข้อมูลคำอธิบาย รีวิว หรือรายละเอียดเงินเดือนลงในตาราง
ส่งออกไปยังเครื่องมือธุรกิจ
ต่างจากสคริปต์ Python ที่มักออกมาเป็น CSV หรือ JSON Thunderbit ส่งออกตรงไปยัง Google Sheets, Airtable, Notion หรือ Excel ได้ฟรีในทุกแพลน เหมาะมากสำหรับทีมที่ต้องแชร์และวิเคราะห์ข้อมูลร่วมกัน
Python เทียบกับ Thunderbit: ควรใช้เมื่อไร
| สถานการณ์ | แนวทางที่แนะนำ |
|---|---|
| สร้าง data pipeline ที่รันประจำ | Python + Patchright |
| งานวิจัยครั้งเดียวหรือโปรเจกต์ทีมเล็ก | Thunderbit |
| ต้องควบคุมทุกฟิลด์แบบ programmatic | Python |
| คนที่ไม่ใช่นักพัฒนาแต่ต้องการข้อมูล Glassdoor วันนี้ | Thunderbit |
| สแครป 1,000+ หน้าในรันเดียว | Python + proxies |
| สแครป 30 บริษัทพร้อมข้อมูลเสริม | ใช้ได้ทั้งคู่ — Thunderbit ตั้งค่าเร็วกว่า |
ราคา Thunderbit เริ่มต้นที่ฟรี (6 หน้า/เดือน) โดย แพลน Pro ราคา $38/เดือน ให้ 3,000 credits ถ้าใช้ 1 credit ต่อแถวผลลัพธ์ (และ 2 credits สำหรับ subpage scraping) ก็เพียงพอสำหรับประมาณ 33 รอบของการดึงข้อมูลบริษัทแบบเสริมครบ 30 บริษัทต่อเดือน
ลองใช้ Thunderbit สำหรับสแครป Glassdoor
สแครป Glassdoor ถูกกฎหมายไหม?
ขอสรุปสั้น ๆ แบบตรงประเด็น Glassdoor Terms of Service ระบุชัดเจนว่าห้ามสแครปอัตโนมัติ: "You may not use any robot, spider, scraper... to access the Services for any purpose without our express written permission."
แต่ภาพทางกฎหมายนั้นซับซ้อนกว่าการอ้าง ToS ข้อเดียว:
- Meta v. Bright Data (N.D. Cal., ม.ค. 2024): ศาลวินิจฉัยว่าถ้าคุณไม่เคยล็อกอิน คุณก็ไม่เคยยอมรับ ToS และการสแครปข้อมูลสาธารณะตอนล็อกเอาต์ไม่ถือว่าละเมิด
- hiQ Labs v. LinkedIn (9th Cir.): CFAA ไม่ครอบคลุมการเก็บข้อมูลสาธารณะที่เข้าถึงได้ — แต่บัญชีปลอมและการสแครปในสถานะล็อกอินเป็นอีกเรื่องหนึ่ง
- Van Buren v. United States (ศาลสูงสหรัฐ, 2021): จำกัดความหมายของ "exceeds authorized access" ภายใต้ CFAA
ข้อสรุปเชิงปฏิบัติ: การสแครปรายการงานที่เปิดสาธารณะโดยไม่ล็อกอินอยู่ในโซนที่ปลอดภัยกว่าพอสมควร ส่วนการสแครปด้วย session ที่ล็อกอินแล้วหมายความว่าคุณยอมรับ ToS ตั้งแต่สมัคร และข้อห้ามนี้ระบุชัดเจน ทั้งกับสคริปต์ Python และ Browser Mode ของ Thunderbit
แนวปฏิบัติด้านจริยธรรมที่ควรยึด:
- จำกัดอัตราให้ช้ากว่าการท่องเว็บของคนจริงพอสมควร
- อย่าสแครปหรือขายต่อข้อมูลที่ระบุตัวบุคคลของผู้รีวิว
- เคารพ robots.txt
- ดึงเฉพาะฟิลด์ที่จำเป็นจริง ๆ
บทสรุป: วิธีไหนเหมาะกับคุณ?
คู่มือนี้ครอบคลุมข้อมูล Glassdoor ทั้งสามประเภท — งาน, รีวิว และเงินเดือน — พร้อมโค้ดที่ใช้ได้ในปี 2025 ซึ่งคำนึงถึงการย้ายไป Indeed Login, Cloudflare Bot Management และการเปลี่ยนชื่อ class แบบ CSS-module ที่ทำให้บทความเก่าทั้งหมดใช้ไม่ได้
นี่คือกรอบตัดสินใจ:
| สถานการณ์ของคุณ | ทางเลือกที่ดีที่สุด |
|---|---|
| นักพัฒนาที่กำลังสร้าง data pipeline | Python + Patchright (ทำตามขั้นตอนด้านบน) |
| งานวิจัยครั้งเดียวหรือดึงข้อมูลย่อยเป็นประจำ | Thunderbit (ไม่ต้องเขียนโค้ด, ใช้ผ่านเบราว์เซอร์) |
| ต้องการแค่รายการงานพื้นฐานในปริมาณไม่มาก | ตรวจสอบก่อนว่า Glassdoor API ยังใช้ได้หรือไม่ (ส่วนใหญ่ไม่น่าได้) |
| ต้องการข้อมูลเงินเดือนหรือรีวิวโดยเฉพาะ | ต้องใช้ Python scraping หรือ Thunderbit — API ไม่เคยครอบคลุมส่วนนี้ |
| ทีมที่ไม่ใช่นักพัฒนาแต่ต้องแชร์ข้อมูลร่วมกัน | Thunderbit → ส่งออกไป Google Sheets |
ระบบป้องกันของ Glassdoor จะพัฒนาต่อไปเรื่อย ๆ selector จะพัง และ challenge ใหม่ ๆ จะโผล่มาเรื่อย ๆ บุ๊กมาร์กคู่มือนี้ไว้ — และถ้าอยากเจาะลึกเครื่องมือกับเทคนิค web scraping มากขึ้น ลองอ่านบทความของเราเกี่ยวกับ best automated web scraping tools, how to scrape data from a website with Python และ best job scraping tools ได้ด้วย หรือจะดูวิดีโอสาธิตใน Thunderbit YouTube Channel ก็ได้
ลองใช้ Thunderbit สำหรับดึงข้อมูล Glassdoor Get Started Free
คำถามที่พบบ่อย
1. ดึงข้อมูล Glassdoor โดยไม่ล็อกอินได้ไหม?
ได้ สำหรับข้อมูลรายการงานส่วนใหญ่และคะแนนบริษัทระดับบนสุด แต่ไม่ได้สำหรับการแยกรายได้ละเอียดหรือข้อความเต็มของรีวิวที่ลึกกว่ากลุ่มหน้าแรก ๆ #HardsellOverlay เป็น modal แบบ CSS-only — HTML ข้างใต้ยังมีข้อมูลของหน้าแรกอยู่จริง — แต่เนื้อหาที่ลึกกว่านั้นถูกล็อกฝั่งเซิร์ฟเวอร์หลัง wall แบบ "give-to-get"
2. ไลบรารี Python ตัวไหนเหมาะที่สุดสำหรับสแครป Glassdoor ในปี 2025?
Patchright (Playwright fork แบบ stealth) คือคำแนะนำเริ่มต้น มันแก้ Runtime.Enable CDP leak ที่ vanilla Playwright มี และ Cloudflare ตรวจจับตรงจุดนี้อยู่ สำหรับหน้ารายการที่ส่ง __NEXT_DATA__ มาใน HTML ตั้งต้น curl_cffi ที่ตั้ง impersonate="chrome124" จะเร็วกว่า 10–20 เท่า แต่ใช้กับหน้าที่ต้องล็อกอินไม่ได้
3. จะหลีกเลี่ยงการถูกบล็อกตอนสแครป Glassdoor ได้อย่างไร?
ใช้ Patchright หรือ rebrowser-playwright (ไม่ใช่ vanilla Playwright หรือ Selenium) หมุน residential proxy — IP ของดาต้าเซ็นเตอร์จะถูกทดสอบทันที ใส่การหน่วงแบบสุ่ม 3–8 วินาทีระหว่างหน้า เก็บ cookie (gdId, cf_clearance, GSESSIONID) ไว้ใช้ต่อเนื่อง คาดว่าหนึ่ง session จะใช้งานได้ราว 20–30 นาทีก่อนโดนทดสอบใหม่
4. มี Glassdoor API ให้ใช้แทนการสแครปไหม?
แทบไม่มีแล้ว Legacy Partner API ปิดรับผู้สมัครใหม่ ไปแล้ว endpoint รีวิวแบบสาธารณะก็ไม่เคยมี และไม่มีเส้นทาง migration ภายใต้ Indeed Publisher API ดังนั้นการสแครปหรือใช้เครื่องมือ no-code อย่าง Thunderbit คือทางเลือกที่ใช้งานได้จริงสำหรับรีวิวและข้อมูลเงินเดือน
5. scraper ของ Glassdoor พังบ่อยแค่ไหน?
บ่อยมาก Glassdoor deploy การเปลี่ยนแปลง frontend โดยไม่ประกาศ และ hash ของ class แบบ CSS-module ก็หมุนใหม่ทุก build วิธีดึงที่เสถียรที่สุดคือ: (1) selector จาก data-test, (2) blob JSON __NEXT_DATA__, และ (3) internal BFF reviews endpoint ควรมีการเช็กผลลัพธ์เป็นศูนย์และรัน test scrape เล็ก ๆ ทุกสัปดาห์เพื่อจับปัญหาตั้งแต่เนิ่น ๆ
เรียนรู้เพิ่มเติม



