
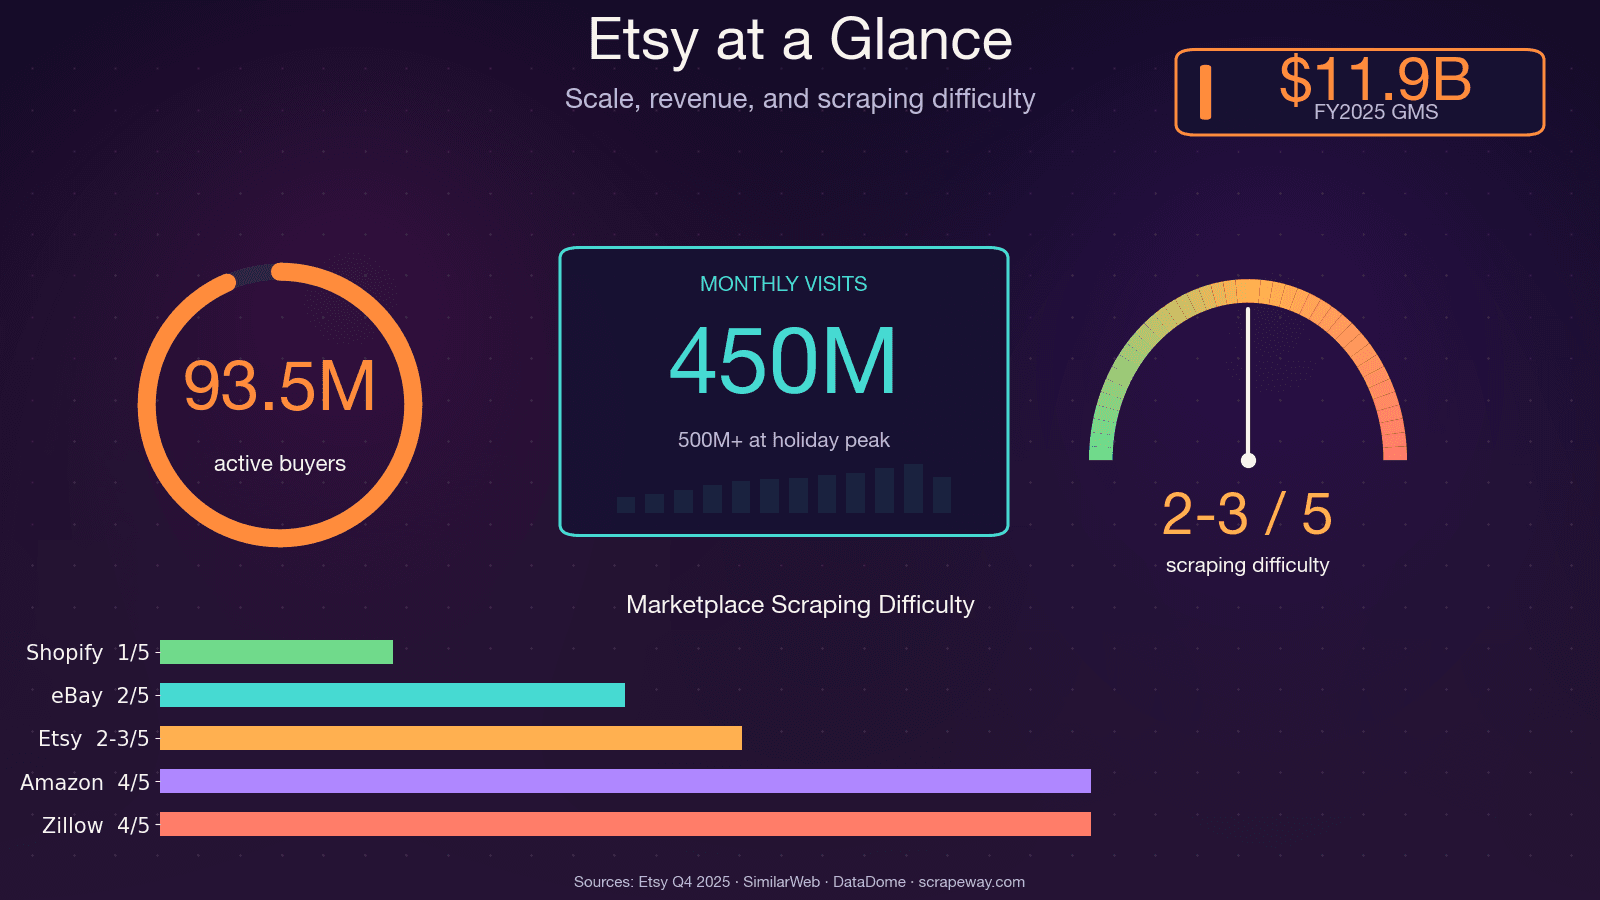
Etsy มีรายการสินค้าใช้งานจริงมากกว่า 100 ล้านรายการ ผู้ขาย 5.6 ล้านราย และมียอดเข้าชมราว 450 ล้านครั้งต่อเดือน นั่นคือขุมข้อมูลสาธารณะขนาดมหาศาลเกี่ยวกับราคา เทรนด์ รีวิว และคู่แข่ง — และถ้าเคยลองเก็บด้วยมือ คุณคงรู้ดีว่ามันเหนื่อยแค่ไหน
ผมเคยนั่งรวบรวมข้อมูลสินค้าของคู่แข่งด้วยมือทั้งสุดสัปดาห์สำหรับโปรเจกต์วิจัยตลาด พอถึงสินค้าชิ้นที่ 30 ผมเริ่มตั้งคำถามกับทุกการตัดสินใจในชีวิตที่พาตัวเองมานั่งกับสเปรดชีตแบบนั้น เรื่องคือ ข้อมูล Etsy มีค่ามากสำหรับการวิเคราะห์ราคา การพัฒนาสินค้า การหานิชใหม่ ๆ และการเทียบมาตรฐานผู้ขาย — แต่จะมีประโยชน์จริงก็ต่อเมื่อดึงมาได้ในสเกลที่ใช้งานได้จริง นี่แหละคือเป้าหมายของคู่มือนี้: บทเรียนเดียวที่ครอบคลุมวิธีดึงข้อมูล Etsy ด้วย Python ครบทั้ง 4 ประเภทหน้าหลัก (หน้าผลการค้นหา หน้าสินค้า หน้าร้านค้า และหน้ารีวิว) พร้อมคำแนะนำตรงไปตรงมาเกี่ยวกับระบบป้องกันบอตของ Etsy และทางเลือกแบบไม่ต้องเขียนโค้ดสำหรับคนที่อยากข้ามขั้นตอนสคริปต์ไปเลย
การดึงข้อมูล Etsy ด้วย Python คืออะไร?
พูดแบบง่ายที่สุด การทำเว็บสแครปปิงคือการเขียนโค้ดให้เข้าไปยังหน้าเว็บแล้วดึงข้อมูลที่สนใจออกมาอัตโนมัติ — เช่น ชื่อสินค้า ราคา คำอธิบาย รูปภาพ คะแนน รีวิว รายละเอียดร้าน — แล้วจัดให้อยู่ในรูปแบบมีโครงสร้างอย่างสเปรดชีตหรือฐานข้อมูล
Python คือภาษาหลักที่คนมักใช้กับงานประเภทนี้ เพราะเริ่มต้นได้ไม่ยาก มีคอมมูนิตี้ใหญ่ และมีไลบรารีสำหรับงานดึงข้อมูลโดยเฉพาะมากมาย: Requests สำหรับดึงหน้าเว็บ, BeautifulSoup สำหรับแยกวิเคราะห์ HTML, Selenium และ Playwright สำหรับควบคุมเบราว์เซอร์, และ pandas สำหรับจัดระเบียบและส่งออกข้อมูล Python ติดอันดับภาษายอดนิยม 3 อันดับแรกอย่างสม่ำเสมอในผลสำรวจนักพัฒนาประจำปีของ Stack Overflow และไลบรารีด้านสแครปปิงของมันก็เป็นกลุ่มที่ถูกดาวน์โหลดมากที่สุดกลุ่มหนึ่งบน PyPI
เวลาเราดึงข้อมูล Etsy เรากำลังเก็บข้อมูลจาก HTML (และบางครั้งก็เป็น JSON ที่ซ่อนอยู่) ที่ Etsy ส่งมาให้เบราว์เซอร์ของคุณ ข้อมูลที่ดึงได้มักจะรวมถึง:
- ชื่อสินค้า ราคา คำอธิบาย รูปภาพ และตัวเลือกสินค้า
- ข้อมูลผู้ขาย/ร้านค้า (ชื่อ จำนวนยอดขาย ที่ตั้ง คะแนน)
- คะแนนและข้อความรีวิวแบบเต็ม
- รายการผลการค้นหา หมวดหมู่ และสัญญาณเทรนด์
ทำไมต้องดึงข้อมูล Etsy? ตัวอย่างการใช้งานจริงที่สร้าง ROI
การดึงข้อมูล Etsy ไม่ใช่แค่การทดลองทางเทคนิค — แต่มันคือความได้เปรียบทางการแข่งขัน ไม่ว่าคุณจะเป็นผู้ขาย ผู้จัดการผลิตภัณฑ์ หรือ data analyst การมีข้อมูล Etsy แบบมีโครงสร้างอยู่ในมือสามารถส่งผลต่อรายได้โดยตรง
| กรณีใช้งาน | สิ่งที่ดึงมา | ใครได้ประโยชน์ | ผลกระทบต่อธุรกิจ |
|---|---|---|---|
| วิเคราะห์ราคาคู่แข่ง | ผลการค้นหา + ราคาสินค้า | ทีมปฏิบัติการอีคอมเมิร์ซ, ผู้ขาย | การตั้งราคาแบบไดนามิกช่วยเพิ่มรายได้เฉลี่ย 5–22% |
| หา niche และเทรนด์ | ผลการค้นหา, รายการสินค้ากำลังมาแรง | ผู้ก่อตั้ง, นักวิเคราะห์ | มองเห็น niche ที่กำลังโตได้เร็วขึ้น (เช่น “preppy pajamas” มียอดค้นหาเพิ่มขึ้น +1,112%) |
| พัฒนาและปรับปรุงสินค้า | รีวิว, รายละเอียดสินค้า | ทีมผลิตภัณฑ์ | แบรนด์เครื่องครัวแบรนด์หนึ่งกลับมาครองอันดับ #1 Best Seller ได้ภายใน 60 วันจากข้อมูล sentiment ของรีวิว |
| SEO และวิจัยคีย์เวิร์ด | ผลการค้นหา, ชื่อ/แท็กสินค้า | ทีมการตลาด | หา keyword ที่มีความต้องการสูงแต่การแข่งขันต่ำ |
| เทียบมาตรฐานผู้ขาย | หน้าร้านค้า, จำนวนยอดขาย | ทีมขาย, นักวิเคราะห์ | สร้างรายชื่อลีดที่มีคุณภาพได้ในต้นทุน $0.01–0.10 ต่อเรคคอร์ด แทนการซื้อรายชื่อ |
| ติดตามสต็อกและสินค้าในคลัง | ความพร้อมจำหน่ายสินค้า | ทีมปฏิบัติการอีคอมเมิร์ซ | ตอบสนองต่อการเปลี่ยนแปลงสต็อกของคู่แข่งได้เร็วขึ้น |
แต่ละกรณีใช้งานเหล่านี้ต้องใช้ข้อมูลจากหน้า Etsy คนละประเภท — และนั่นคือเหตุผลว่าทำไมบทเรียนนี้จึงครอบคลุมครบทั้ง 4 แบบ
ประหยัดเวลา: ทำมือ vs. อัตโนมัติ
- วิจัย Etsy แบบทำมือ: 30–45 นาทีต่อสินค้า (50–75 ชั่วโมงสำหรับ 100 สินค้า)
- ดึงข้อมูลอัตโนมัติ: 100 รายการใน 2–5 นาที
- การดึงข้อมูลด้วย AI เร็วกว่า 30–40% และมีความแม่นยำสูงสุดถึง 99.5%
Etsy API vs. เว็บสแครปปิง: ควรเลือกอะไร?
ก่อนจะเขียนโค้ดสักบรรทัด ควรถามตัวเองก่อนว่า: ควรใช้ Etsy API อย่างเป็นทางการ หรือดึงข้อมูลจากเว็บโดยตรงดี? ผมเห็นคำถามนี้ถูกถามในฟอรั่มอยู่บ่อยมาก และคำตอบขึ้นอยู่กับว่าคุณต้องการข้อมูลแบบไหน
Etsy API ทำอะไรได้และทำอะไรไม่ได้
Etsy มี API v3 พร้อมการยืนยันตัวตนด้วย OAuth 2.0 ใช้เข้าถึงข้อมูลร้านของคุณเองได้ — รายการสินค้า คำสั่งซื้อ ใบเสร็จ แต่ก็มีข้อจำกัดจริงจัง:
- ข้อมูลคู่แข่ง: API ส่วนใหญ่จำกัดไว้ที่ร้านของคุณเอง ไม่สามารถดึงราคา ยอดขาย หรือรายการสินค้าของผู้ขายรายอื่นได้
- รีวิว: ไม่มี endpoint ที่ดีพอสำหรับดึงข้อความรีวิวแบบเต็มเป็นจำนวนมาก
- ข้อจำกัดอัตราเรียก: 10 requests/วินาที, 10,000 requests/วันตามค่าเริ่มต้น และจำกัด offset ที่ 12,000 เรคคอร์ด
- การใช้กับ AI/ML: ถูกปฏิเสธอย่างชัดเจนในขั้นตอนรีวิวแอป
- เอกสารประกอบ: มีเสียงบ่นจากคอมมูนิตี้จำนวนมาก — ตัวอย่างไม่ดี endpoint เลิกใช้ การซัพพอร์ตช้า
เมื่อไรเว็บสแครปปิงเหมาะกว่า
ถ้าคุณต้องการข้อมูลเชิงแข่งขัน ความรู้สึกจากรีวิว การวิเคราะห์ข้ามร้าน หรือข้อมูลที่ API ไม่เปิดให้ นั่นคือทางของการสแครป แต่ต้องแลกกับการเจอกำแพงป้องกันบอตของ Etsy (จะอธิบายด้านล่าง) และต้องลงทุนกับการตั้งค่ามากขึ้น
ตารางเปรียบเทียบ: API vs. สแครปปิง vs. ไม่ต้องเขียนโค้ด
| เกณฑ์ | Etsy Official API | Python Web Scraping | Thunderbit (ไม่ต้องเขียนโค้ด) |
|---|---|---|---|
| เข้าถึงราคาสินค้า | ✅ (ฟิลด์จำกัด) | ✅ HTML/JSON-LD แบบเต็ม | ✅ AI ดึงทุกฟิลด์ที่มองเห็นได้ |
| ข้อมูลรีวิว | ❌ ไม่พร้อมใช้งานเป็นชุดใหญ่ | ✅ ผ่าน endpoint/HTML ของรีวิว | ✅ สแครปจากหน้าย่อย |
| ข้อมูลร้านคู่แข่ง | ❌ เฉพาะร้านตัวเอง | ✅ ร้านสาธารณะใดก็ได้ | ✅ ร้านสาธารณะใดก็ได้ |
| ต้องยืนยันตัวตน | ✅ OAuth 2.0 | ⚠️ คุกกี้สำหรับข้อมูลที่ล็อกอิน | ⚠️ สแครปผ่านเบราว์เซอร์สำหรับล็อกอิน |
| ความเสี่ยงโดนบอตบล็อก | ไม่มี | สูงมาก (DataDome) | จัดการให้แล้ว (ระดับเบราว์เซอร์) |
| เวลาเริ่มต้น | ปานกลาง (API key, OAuth) | สูง (โค้ด + proxy) | ประมาณ 2 นาที |
ถ้าคุณต้องการข้อมูลคู่แข่ง รีวิว หรือการวิเคราะห์ข้ามร้าน API ก็ยังไม่ครอบคลุมพอ นั่นคือภาพจริงแบบตรงไปตรงมา
เลือกแนวทางสแครปด้วย Python ให้ได้ก่อนเขียนโค้ด
คำถามที่เจอใน Reddit และ Stack Overflow ตลอดเวลา: "ควรใช้ Requests + BeautifulSoup, Selenium, proxy API หรืออย่างอื่นดี?" คำตอบที่ถูกต้องขึ้นกับระดับทักษะ งบประมาณ และกรณีใช้งานของคุณ
| แนวทาง | เหมาะกับ | ความยากในการเรียนรู้ | รองรับ JS ไหม? | การรับมือบอต | ค่าใช้จ่าย |
|---|---|---|---|---|---|
| Requests + BeautifulSoup | นักพัฒนาที่อยากคุมทุกอย่างเอง | ปานกลาง | ❌ | ทำเอง (headers, proxies) | ฟรี + ค่า proxy |
| Selenium / Playwright | หน้าที่ใช้ JS หนัก, flow สำหรับล็อกอิน | สูง | ✅ | บางส่วน (browser fingerprint) | ฟรี + ค่า proxy |
| บริการ Proxy API | ต้องการสเกล + เลี่ยงบอต | ปานกลาง | ✅ (ผ่าน API) | ✅ มีมาในตัว | $49+/เดือน |
| Thunderbit (ไม่ต้องเขียนโค้ด) | คนไม่เขียนโค้ด, ดึงข้อมูลเร็ว | ต่ำมาก | ✅ (ระดับเบราว์เซอร์) | ✅ (เซสชันเบราว์เซอร์) | มีแพ็กเกจฟรี |
ถ้าคุณอยากคุมทุกอย่างเองและถนัด Python อยู่แล้ว ให้ใช้ Requests + BeautifulSoup ถ้าต้องเรนเดอร์ JS หรือมี flow ล็อกอิน ให้ใช้ Selenium ถ้าต้องการหลบระบบป้องกันบอตในระดับสเกล ให้พิจารณาบริการ proxy และถ้าคุณต้องการข้อมูล Etsy โดยไม่ต้องเขียนหรือดูแลโค้ด Thunderbit ก็น่าสนใจมาก — เดี๋ยวจะเล่าต่อ
Etsy สู้กลับอย่างไร: ทำความเข้าใจระบบป้องกันบอต DataDome
คู่มือสแครปส่วนใหญ่มักบอกว่า “แค่ใช้ proxy ก็พอ” แล้วจบ แต่สำหรับ Etsy นั่นยังไม่พอ Etsy ใช้ DataDome ซึ่งเป็นหนึ่งในระบบป้องกันบอตที่ดุที่สุดบนเว็บ กรณีศึกษาของ DataDome เอง ยังยก Etsy เป็นเรื่องความสำเร็จ โดยระบุว่าสคริปต์สแครปเคยคิดเป็นราว 1% ของต้นทุนคอมพิวติงของ Etsy

DataDome คืออะไร และทำงานอย่างไร?
DataDome ไม่ได้เช็กแค่ IP address เท่านั้น แต่มันใช้การตรวจจับหลายชั้น:
- TLS fingerprinting (JA3): ไลบรารี
requestsของ Python มีลายเซ็น TLS ที่จำแนกได้ชัด และ DataDome ตรวจเจอได้ทันที - ตรวจสอบ HTTP header/protocol: เช็กว่ามี header ของเบราว์เซอร์ครบและสอดคล้องกันหรือไม่ — header ที่หายไปหรือเรียงผิดลำดับคือสัญญาณเตือน
- JavaScript fingerprinting (Picasso protocol): รัน challenge ผ่าน JS ในเบราว์เซอร์เพื่อยืนยันว่าคุณเป็นผู้ใช้จริง
- Behavioral ML: วิเคราะห์สัญญาณมากกว่า 35 แบบต่อ request พร้อมโมเดลเฉพาะแต่ละไซต์กว่า 85,000 โมเดล
- การประเมินชื่อเสียง IP: IP จากดาต้าเซ็นเตอร์จะถูกตั้งธงทันที
- การตรวจคุกกี้: คุกกี้
datadomeต้องมีอยู่และใช้งานได้
สัญญาณว่าโดนบล็อกแล้ว (และวิธีเช็ก)
กับดักที่เจอบ่อยที่สุดอย่างหนึ่งคือ คุณได้ response แบบ 200 OK แต่ HTML จริง ๆ เป็นหน้า CAPTCHA ไม่ใช่ข้อมูลที่ต้องการ สัญญาณอื่น ๆ ได้แก่:
- ข้อผิดพลาด 403 Forbidden
- วน redirect ซ้ำ ๆ
- เนื้อหา response มีอ็อบเจ็กต์ JavaScript
ddหรือ HTML ของ slider CAPTCHA
อย่าเช็กแค่ status code ให้ตรวจ body ของ response เสมอ วิธีเช็กเร็ว ๆ:
if "captcha" in resp.text.lower() or "datadome" in resp.text.lower():
    print("ถูกบล็อก! ได้หน้า CAPTCHA แทนข้อมูล")
Headers และคุกกี้ที่ช่วยลดการตรวจจับ
เราไม่อาจรับประกันได้ว่าจะไม่โดนบล็อก แต่การตั้ง headers ให้สมจริงและจัดการคุกกี้ดี ๆ ช่วยได้มาก:
session = requests.Session()
session.headers.update({
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 Chrome/133.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8",
    "Accept-Language": "en-US,en;q=0.9",
    "Accept-Encoding": "gzip, deflate, br",
    "Sec-Ch-Ua": '"Chromium";v="133", "Not-A.Brand";v="99", "Google Chrome";v="133"',
    "Sec-Ch-Ua-Mobile": "?0",
    "Sec-Ch-Ua-Platform": '"Windows"',
    "Sec-Fetch-Dest": "document",
    "Sec-Fetch-Mode": "navigate",
    "Sec-Fetch-Site": "none",
    "Upgrade-Insecure-Requests": "1",
})
สิ่งสำคัญเพิ่มเติม:
- เก็บคุกกี้เดิมไว้ ข้ามหลาย request ด้วย
requests.Session() - หน่วงเวลาแบบสุ่ม 2–7 วินาทีระหว่าง request
- จำลองลำดับการเข้าชม: เข้าโฮมเพจก่อน แล้วค่อยค้นหา แล้วไปหน้าสินค้า
- เมื่อสเกลใหญ่ ต้องใช้ residential proxy rotation เพราะ IP จากดาต้าเซ็นเตอร์จะถูกตั้งธงแทบจะทันที
เทคนิคเหล่านี้ช่วยลดการตรวจจับได้ แต่ไม่ใช่การแก้ให้หายขาด ถ้าต้องสแครปปริมาณมาก คุณน่าจะต้องใช้บริการ proxy หรือแนวทางผ่านเบราว์เซอร์
ตั้งค่าสภาพแวดล้อม Python เพื่อดึงข้อมูล Etsy
ก่อนเริ่ม:
- ระดับความยาก: ปานกลาง
- เวลาที่ต้องใช้: ประมาณ 30–60 นาที (ตั้งค่า + สแครปครั้งแรก)
- สิ่งที่ต้องมี: Python 3.8+, pip, โปรแกรมแก้ไขโค้ด, เบราว์เซอร์ Chrome (สำหรับตรวจ DevTools)
ติดตั้ง Dependencies
สร้างโฟลเดอร์โปรเจกต์ ตั้งค่า virtual environment แล้วติดตั้งไลบรารีที่ต้องใช้:
mkdir etsy-scraper && cd etsy-scraper
python -m venv venv
source venv/bin/activate  # บน Windows: venv\Scripts\activate

pip install requests beautifulsoup4 lxml pandas
- requests — ดึงหน้าเว็บ
- beautifulsoup4 — แยกวิเคราะห์ HTML
- lxml — ตัวแยกวิเคราะห์ HTML ที่เร็วกว่า (ไม่บังคับแต่แนะนำ)
- pandas — จัดโครงสร้างและส่งออกข้อมูลเป็น CSV/Excel
ถ้าต้องใช้การควบคุมเบราว์เซอร์ในภายหลัง (สำหรับล็อกอินหรือหน้าที่ใช้ JS หนัก) ให้ติดตั้งเพิ่มด้วย:
pip install selenium
ทำความเข้าใจโครงสร้างหน้าของ Etsy ก่อนเขียนโค้ด
ทิปที่ช่วยประหยัดเวลาได้มาก: Etsy ฝังข้อมูลสินค้าแบบมีโครงสร้างไว้ในแท็ก <script type="application/ld+json"> บนหน้าส่วนใหญ่ ข้อมูล JSON-LD นี้จัดระเบียบมาแล้ว — ชื่อสินค้า ราคา คะแนน รูปภาพ — ดังนั้นคุณไม่จำเป็นต้องต่อสู้กับ CSS selector ที่เปลี่ยนง่ายในทุกฟิลด์
เปิดหน้าสินค้าของ Etsy สักหน้า คลิกขวา เลือก “View Page Source” แล้วค้นหา application/ld+json คุณจะพบบล็อกที่มี @type: Product ซึ่งมีข้อมูลส่วนใหญ่ที่ต้องใช้ ส่วนหน้าผลการค้นหาจะมี @type: ItemList
CSS selector ยังมีประโยชน์เป็นตัวสำรองอยู่ (สำหรับข้อมูลที่ไม่มีใน JSON-LD เช่น รายละเอียดการจัดส่งหรือข้อความรีวิว) แต่ JSON-LD ควรเป็นจุดเริ่มต้นเสมอ
ขั้นตอนที่ 1: ดึงผลการค้นหา Etsy ด้วย Python
หน้าผลการค้นหาคือจุดเริ่มต้นของโปรเจกต์สแครป Etsy ส่วนใหญ่ — ไม่ว่าคุณจะติดตาม niche, เฝ้าดูราคาคู่แข่ง หรือสร้างฐานข้อมูลสินค้า
สร้าง URL สำหรับค้นหา
URL การค้นหาของ Etsy มีรูปแบบนี้:
https://www.etsy.com/search?q={keyword}&ref=pagination&page={page_number}
สำหรับคำค้นหลายคำ ให้เข้ารหัสช่องว่างใน URL (เช่น handmade+jewelry หรือ handmade%20jewelry) พารามิเตอร์ ref=pagination ทำให้ request ดูคล้ายการนำทางด้วยเบราว์เซอร์จริงมากขึ้น
พารามิเตอร์ที่มีประโยชน์เพิ่มเติม: order (most_relevant, price_asc, price_desc, date_desc), min_price, max_price, ship_to, free_shipping=true แต่ละหน้าจะมี 48 รายการ
ส่ง request และแยกวิเคราะห์ HTML
import requests
from bs4 import BeautifulSoup
import json
import time
import random

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 Chrome/124.0.0.0 Safari/537.36",
    "Accept-Language": "en-US,en;q=0.9",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
}

def scrape_etsy_search(query, max_pages=3):
    all_products = []
    for page in range(1, max_pages + 1):
        url = f"https://www.etsy.com/search?q={query}&ref=pagination&page={page}"
        resp = requests.get(url, headers=headers, timeout=30)
        if "captcha" in resp.text.lower():
            print(f"ถูกบล็อกที่หน้า {page} ลองเพิ่มการหน่วงเวลา หรือใช้ proxy")
            break
        soup = BeautifulSoup(resp.text, "lxml")
        for script in soup.find_all("script", type="application/ld+json"):
            data = json.loads(script.string)
            if data.get("@type") == "ItemList":
                for item in data.get("itemListElement", []):
                    all_products.append({
                        "name": item.get("name"),
                        "url": item.get("url"),
                        "image": item.get("image"),
                        "price": item.get("offers", {}).get("price"),
                        "currency": item.get("offers", {}).get("priceCurrency"),
                        "position": item.get("position"),
                    })
        time.sleep(random.uniform(2, 5))
    return all_products
ดึงข้อมูลรายการจาก JSON-LD
อาร์เรย์ itemListElement จะให้ชื่อสินค้า URL รูปภาพ ราคา และสกุลเงินของแต่ละรายการ ถ้าต้องการคะแนนดาวหรือจำนวนผลลัพธ์เพิ่มเติม (ซึ่งไม่ได้อยู่ใน JSON-LD เสมอไป) ให้ใช้ CSS selector เป็นตัวสำรอง:
- การ์ดรายการ:
.v2-listing-card - ชื่อเรื่อง:
h3.v2-listing-card__title - ราคา:
span.currency-value - ลิงก์:
a.listing-link(href)
จัดการ pagination
วนลูปผ่านหลายหน้าและใส่การหน่วงแบบสุ่มระหว่างแต่ละ request Etsy มักคืนผลได้สูงสุดประมาณ 20–250 หน้า ขึ้นอยู่กับคำค้น
results = scrape_etsy_search("handmade+jewelry", max_pages=5)
print(f"ดึงข้อมูลได้ {len(results)} สินค้า")
สำหรับการสแครป 5 หน้า ผมใช้เวลาประมาณ 20 วินาทีในการทดสอบ — เทียบกับการคัดลอกวางเองที่ใช้เวลากว่า 30 นาที
ขั้นตอนที่ 2: ดึงข้อมูลหน้าสินค้า Etsy ด้วย Python
เมื่อได้รายชื่อ URL สินค้าจากหน้าค้นหาแล้ว ขั้นต่อไปคือดึงข้อมูลรายละเอียดจากแต่ละหน้ารายการสินค้า
ดึงหน้าสินค้า
def scrape_etsy_product(url):
    resp = requests.get(url, headers=headers, timeout=30)
    soup = BeautifulSoup(resp.text, "lxml")
    for script in soup.find_all("script", type="application/ld+json"):
        data = json.loads(script.string)
        if data.get("@type") == "Product":
            offers = data.get("offers", {})
            price = offers.get("price") or offers.get("lowPrice")
            rating_data = data.get("aggregateRating", {})
            return {
                "name": data.get("name"),
                "description": data.get("description", "")[:500],
                "brand": data.get("brand", {}).get("name") if isinstance(data.get("brand"), dict) else data.get("brand"),
                "category": data.get("category"),
                "price": price,
                "currency": offers.get("priceCurrency"),
                "availability": offers.get("availability"),
                "rating": rating_data.get("ratingValue"),
                "review_count": rating_data.get("reviewCount"),
                "images": data.get("image", []),
                "sku": data.get("sku"),
                "material": data.get("material"),
            }
    return None
จัดการความแปรผันของราคา
สินค้าบางรายการมี offers.price เพียงค่าเดียว บางรายการที่มีตัวเลือก เช่น ขนาดหรือสี จะใช้ offers.lowPrice และ offers.highPrice โค้ดด้านบนรองรับทั้งสองแบบโดยไล่จาก price ไป lowPrice
ดึงฟิลด์เพิ่มด้วย CSS selector
สำหรับข้อมูลที่ไม่ได้อยู่ใน JSON-LD — ข้อมูลการจัดส่ง ตัวเลือกสินค้า รายละเอียดผู้ขายแบบเต็ม — คุณจะต้องใช้ CSS selector:
- ชื่อเรื่อง:
h1[data-buy-box-listing-title] - ตัวเลือกสินค้า:
select[data-selector-id]หรือdiv[data-option-set] - การจัดส่ง:
div.wt-text-captionบริเวณใกล้ส่วนจัดส่ง
ข้อแลกเปลี่ยนคือ JSON-LD สะอาดและเสถียรกว่าเมื่อเลย์เอาต์เปลี่ยน ส่วน CSS selector เปราะบางกว่าแต่ครอบคลุมฟิลด์ได้มากกว่า
ขั้นตอนที่ 3: ดึงข้อมูลหน้าร้าน Etsy ด้วย Python
นี่คือส่วนที่คู่มือของคู่แข่งมักข้ามไป — และจริง ๆ แล้วอาจเป็นส่วนที่มีค่าที่สุดสำหรับทีมขายและนักวิเคราะห์คู่แข่ง
สร้าง URL ร้านค้าและดึงหน้าเว็บ
def scrape_etsy_shop(shop_name):
    url = f"https://www.etsy.com/shop/{shop_name}"
    resp = requests.get(url, headers=headers, timeout=30)
    soup = BeautifulSoup(resp.text, "lxml")

    # เมตาดาต้าของร้านจาก HTML (ไม่อยู่ใน JSON-LD)
    sales_el = soup.select_one("div.shop-sales-reviews a")
    rating_el = soup.find("input", {"name": "initial-rating"})
    location_el = soup.select_one("div.shop-location")

    shop_data = {
        "name": shop_name,
        "sales": sales_el.text.strip() if sales_el else None,
        "rating": rating_el["value"] if rating_el else None,
        "location": location_el.text.strip() if location_el else None,
    }

    # รายการสินค้าจาก JSON-LD
    listings = []
    for script in soup.find_all("script", type="application/ld+json"):
        data = json.loads(script.string)
        if data.get("@type") == "ItemList":
            for item in data.get("itemListElement", []):
                listings.append({
                    "name": item.get("name"),
                    "url": item.get("url"),
                    "price": item.get("offers", {}).get("price"),
                })
    shop_data["listings"] = listings
    return shop_data
สิ่งที่ดึงได้จากหน้าร้านค้า
JSON-LD บนหน้าร้านจะเป็น @type: ItemList — ครอบคลุมรายการสินค้า แต่ ไม่ครอบคลุม เมตาดาต้าระดับร้านอย่างจำนวนยอดขาย ที่ตั้ง หรือคะแนน สำหรับสิ่งเหล่านี้ต้องใช้ CSS selector:
| จุดข้อมูล | ตัวเลือก (selector) | หมายเหตุ |
|---|---|---|
| ชื่อร้าน | h1 หรือ meta title | มักอยู่ในชื่อหน้า |
| ยอดขายรวม | div.shop-sales-reviews a | ข้อความเช่น "12,345 sales" |
| คะแนนดาว | ค่าใน input[name="initial-rating"] | ค่า 1–5 แบบตัวเลข |
| ที่ตั้ง | div.shop-location | เมือง, ประเทศ |
| เป็นสมาชิกตั้งแต่ | div.shop-info | ข้อความวันที่ |
ข้อมูลร้านมีคุณค่ามากสำหรับการสร้างรายชื่อลีด การเทียบคู่แข่ง หรือการระบุผู้ขายที่ดีที่สุดใน niche ใด niche หนึ่ง
ขั้นตอนที่ 4: ดึงรีวิว Etsy ด้วย Python
รีวิวเป็นหนึ่งในข้อมูลที่มีค่าที่สุด — และก็ยากที่สุด — บน Etsy ข้อความรีวิว คะแนน และวันที่ไม่ได้อยู่ใน HTML แรกเริ่มของหน้า แต่ถูกโหลดผ่าน internal API endpoint
แนวทางที่ 1: ค้นหา internal reviews API endpoint ของ Etsy
เปิดหน้าสินค้าใน Chrome เปิด DevTools (F12) ไปที่แท็บ Network แล้วเลื่อนลงไปยังส่วนรีวิว คุณจะเห็นคำขอ POST ไปยัง URL ประมาณนี้:
https://www.etsy.com/api/v3/ajax/bespoke/member/neu/specs/deep_dive_reviews
endpoint นี้จะคืน HTML fragment ที่มีการ์ดรีวิวอยู่ หากจะใช้งาน คุณต้องมี:
- listing_id — รหัสตัวเลขจาก URL สินค้า
- shop_id — ดึงจาก HTML ของหน้าสินค้าด้วย regex
- csrf_nonce — ดึงจากแท็ก
<meta>บนหน้า
ดึง ID และ CSRF Token
import re

def get_review_params(product_url):
    resp = requests.get(product_url, headers=headers)
    html = resp.text
    listing_id = product_url.split("/")[-1].split("?")[0]
    shop_id_match = re.search(r'"shopId"\s*:\s*(\d+)', html)
    shop_id = shop_id_match.group(1) if shop_id_match else None
    soup = BeautifulSoup(html, "lxml")
    csrf_meta = soup.find("meta", {"name": "csrf_nonce"})
    csrf = csrf_meta["content"] if csrf_meta else None
    return listing_id, shop_id, csrf
ดึงรีวิวพร้อม pagination
def scrape_reviews(listing_id, shop_id, csrf, max_pages=5):
    session = requests.Session()
    session.headers.update(headers)
    all_reviews = []
    for page in range(1, max_pages + 1):
        payload = {
            "specs": {
                "deep_dive_reviews": {
                    "module_path": "neu/specs/deep_dive_reviews",
                    "listing_id": listing_id,
                    "shop_id": shop_id,
                    "page": page,
                }
            }
        }
        resp = session.post(
            "https://www.etsy.com/api/v3/ajax/bespoke/member/neu/specs/deep_dive_reviews",
            json=payload,
            headers={"x-csrf-token": csrf, "Content-Type": "application/json"},
        )
        data = resp.json()
        html_fragment = data.get("output", {}).get("deep_dive_reviews", "")
        review_soup = BeautifulSoup(html_fragment, "lxml")
        for card in review_soup.select("div.review-card"):
            rating_el = card.find("input", {"name": "rating"})
            text_el = card.select_one("div.wt-text-body")
            user_el = card.select_one("a[data-review-username]")
            date_el = card.select_one("p.wt-text-body-small")
            all_reviews.append({
                "rating": rating_el["value"] if rating_el else None,
                "text": text_el.text.strip() if text_el else None,
                "reviewer": user_el.text.strip() if user_el else None,
                "date": date_el.text.strip() if date_el else None,
            })
        time.sleep(random.uniform(2, 5))
    return all_reviews
แนวทางที่ 2: แยกวิเคราะห์รีวิวจาก HTML (ทางเลือกสำรอง)
ถ้าวิธี API ใช้งานไม่ได้ (เช่น มีปัญหาเรื่อง CSRF token) คุณสามารถแยกวิเคราะห์รีวิวชุดแรกจาก HTML ของหน้าสินค้าได้โดยตรง ข้อจำกัดคือรีวิวที่อยู่ใน HTML แบบสแตติกมีเพียงบางส่วนเท่านั้น ถ้าต้องการมากกว่านั้น คุณจะต้องใช้ API หรือเครื่องมือควบคุมเบราว์เซอร์อย่าง Selenium
การดึงข้อมูลที่ต้องล็อกอิน: สแครป Etsy shop ของคุณเอง
นี่คือช่องว่างที่คู่มืออื่น ๆ ไม่ค่อยพูดถึง แต่เป็นความต้องการจริง โดยเฉพาะสำหรับผู้ขาย Etsy ที่อยากดึงคำสั่งซื้อ รายได้ และสถิติของตัวเอง
ปัญหาคือ requests อย่างเดียวเข้า Etsy dashboard ของคุณไม่ได้ เพราะมันไม่มาพร้อมคุกกี้เซสชันล็อกอิน
ทางเลือกที่ 1: Selenium กับการล็อกอินด้วยตนเองและดึงคุกกี้
ใช้ Selenium เปิดเบราว์เซอร์ ล็อกอินด้วยตนเอง (หรือจะสคริปต์ล็อกอินก็ได้) แล้วค่อยสแครปต่อในสถานะที่ผ่านการยืนยันตัวตนแล้ว:
from selenium import webdriver

driver = webdriver.Chrome()
driver.get("https://www.etsy.com/signin")
# ล็อกอินด้วยตนเองในหน้าต่างเบราว์เซอร์ แล้วค่อย:
input("กด Enter หลังจากล็อกอินเสร็จ...")

cookies = driver.get_cookies()
# จากนั้นใช้ driver.get() ไปยังหน้า dashboard และสแครปต่อ
คุณยังสามารถบันทึกคุกกี้จากเซสชัน Selenium แล้วนำกลับมาใช้กับ requests.Session() เพื่อให้สแครปได้เร็วและเบาขึ้นหลังล็อกอินครั้งแรก
ทางเลือกที่ 2: ส่งออกคุกกี้เบราว์เซอร์มาใช้กับ Requests
ใช้ส่วนขยายเบราว์เซอร์ (เช่น "EditThisCookie") เพื่อส่งออกคุกกี้เซสชัน Etsy ที่ใช้อยู่ แล้วโหลดเข้า Requests session:
import requests

session = requests.Session()
# เพิ่มคุกกี้ที่ส่งออกมาจากเบราว์เซอร์
session.cookies.set("uaid", "YOUR_UAID_VALUE", domain=".etsy.com")
session.cookies.set("user_prefs", "YOUR_USER_PREFS_VALUE", domain=".etsy.com")
# ... เพิ่มคุกกี้เซสชันอื่น ๆ ตามต้องการ

resp = session.get("https://www.etsy.com/your/orders", headers=headers)
ทางง่ายกว่า: โหมด Browser Scraping ของ Thunderbit
เพราะ Thunderbit ทำงานอยู่ภายใน Chrome ของคุณ มันจึงใช้เซสชัน Etsy ที่ล็อกอินอยู่แล้วโดยอัตโนมัติ ไม่ต้องเขียนโค้ดยืนยันตัวตน ไม่ต้องส่งออกคุกกี้ — แค่เข้าไปที่ dashboard ของ Etsy แล้วสแครปได้เลย วิธีนี้มีประโยชน์จริงสำหรับการดึงคำสั่งซื้อ รายได้ สถิติ และข้อมูลเฉพาะผู้ขายอื่น ๆ โดยไม่ต้องเขียนสคริปต์เลย
ดึงข้อมูล Etsy Dashboard ของคุณด้วย AI
ส่งออกและใช้งานข้อมูล Etsy ที่ดึงมา
บันทึกเป็น CSV หรือ JSON
import pandas as pd

df = pd.DataFrame(results)
df.to_csv("etsy_products.csv", index=False, encoding="utf-8")
df.to_json("etsy_products.json", orient="records", indent=2)
แนวทางที่ดี: ใส่เวลาประทับในชื่อไฟล์ ใช้การเข้ารหัส UTF-8 และจัดการอักขระพิเศษในชื่อสินค้า (ผู้ขาย Etsy ชอบใช้อีโมจิและอักขระมีวรรณยุกต์)
ส่งออกไปยัง Google Sheets, Airtable หรือ Notion
สำหรับผู้ใช้ Python ไลบรารีอย่าง gspread (Google Sheets) หรือ Airtable API ช่วยให้ส่งข้อมูลแบบโปรแกรมได้ แต่ถ้าใช้ Thunderbit การส่งออกทั้งหมด — ไปยัง Google Sheets, Excel, Airtable และ Notion — ฟรีและกดครั้งเดียวจบ ไม่ต้องใช้ API key ไม่ต้องตั้งค่า OAuth
ข้ามโค้ดไปเลย: วิธีดึงข้อมูล Etsy ด้วย Thunderbit (ทางเลือกไม่ต้องเขียนโค้ด)
ไม่ใช่ทุกคนที่อยากเขียน Python ดูแล config ของ proxy หรือไล่แก้ CSS selector ตอนตี 2 ถ้าคุณเป็นแบบนั้น นี่คือวิธีเอาข้อมูล Etsy ด้วย Thunderbit
ติดตั้งส่วนขยาย Chrome ของ Thunderbit
ไปที่ Chrome Web Store แล้วติดตั้ง Thunderbit สร้างบัญชีฟรี — แพ็กเกจฟรีให้คุณได้ 6 หน้า/เดือน และการส่งออกทั้งหมดฟรี
ใช้ AI Suggest Fields บนหน้า Etsy ได้ทุกหน้า
เปิดหน้า Etsy แบบค้นหา สินค้า หรือร้านค้า แล้วคลิก "AI Suggest Fields" ในแถบด้านข้างของ Thunderbit AI จะสแกนหน้าและแนะนำคอลัมน์ — ชื่อสินค้า ราคา คะแนน รูปภาพ ชื่อร้าน แท็ก ข้อมูลการจัดส่ง ปรับหรือเพิ่มคอลัมน์ตามต้องการ
คลิก Scrape แล้วส่งออก
คลิก "Scrape" เพื่อดึงข้อมูลจากหน้าปัจจุบัน ถ้าเป็นผลลัพธ์หลายหน้า ให้ใช้การสแครป pagination ของ Thunderbit ถ้าต้องการเพิ่มรายละเอียดจากแต่ละหน้าสินค้าให้กับรายชื่อ URL สินค้า (เช่น คำอธิบาย รีวิว การจัดส่ง) ให้ใช้ subpage scraping — Thunderbit จะเข้าแต่ละลิงก์และดึงข้อมูลเพิ่มเติมให้อัตโนมัติ
ส่งออกไปยัง Excel, Google Sheets, Airtable หรือ Notion — ฟรีทั้งหมด
เมื่อ Thunderbit เหนือกว่า Python สำหรับการสแครป Etsy
- ไม่ต้องตั้งค่า proxy หรือเขียนโค้ดหลบระบบป้องกันบอต Thunderbit ทำงานใน Chrome จริงของคุณ จึงใช้เซสชันของคุณและดูเหมือนผู้ใช้ปกติสำหรับ DataDome
- AI ปรับตามการเปลี่ยนเลย์เอาต์อัตโนมัติ ไม่ต้องมานั่งแก้ selector ที่พังทุกครั้งที่ Etsy อัปเดต frontend
- เหมาะมากสำหรับงานวิจัยครั้งเดียว การวิเคราะห์คู่แข่ง หรือสมาชิกทีมที่ไม่ใช่สายเทคนิค ถ้าคุณแค่ต้องการชุดข้อมูลเร็ว ๆ ก็ไม่จำเป็นต้องตั้งสภาพแวดล้อม Python
- การสแครปหน้าย่อย ช่วยเพิ่มรายละเอียดให้รายชื่อ URL สินค้าได้โดยไม่ต้องเขียนลูปซ้อนหลายชั้น
สำหรับวิธีใช้งานแบบทีละขั้น ดูได้ที่ ช่อง YouTube ของ Thunderbit
เปรียบเทียบค่าใช้จ่าย 6 เดือน: Python vs. Thunderbit
| ปัจจัย | Python ทำเอง | Thunderbit |
|---|---|---|
| เวลาในการตั้งค่า | 8–20 ชั่วโมง | ไม่ถึง 5 นาที |
| ค่าใช้จ่าย 6 เดือน (รวมแรงงาน, proxy) | $2,720–9,450 | $90–228 |
| การดูแลรายเดือน | 4–10+ ชั่วโมง (อัปเดต selector = ภาระงานเพิ่ม 80%+) | 0–1 ชั่วโมง |
| การรับมือบอต | residential proxy ค่าเครดิตแพงกว่าปกติ 85 เท่า | ทำงานผ่านเบราว์เซอร์ เลี่ยง DataDome ได้โดยธรรมชาติ |
| คุณภาพข้อมูล | สูง (ถ้าลงแรง) | สูง (ขับเคลื่อนด้วย AI) |
ผมไม่ได้บอกว่า Python เป็นตัวเลือกที่ผิด — ถ้าคุณต้องการคุมได้เต็มที่ มีตรรกะเฉพาะทาง หรือเชื่อมเข้ากับ pipeline ใหญ่ ๆ โค้ดคือคำตอบ แต่สำหรับผู้ใช้ธุรกิจส่วนใหญ่ที่แค่ต้องการข้อมูล Etsy อย่างเดียว ตัวเลข ROI มักเอียงไปทางเครื่องมือไม่ต้องเขียนโค้ด
เคล็ดลับด้านกฎหมายและจริยธรรมสำหรับการสแครป Etsy
ผมถูกถามเรื่องความถูกต้องตามกฎหมายแทบทุกโพสต์เกี่ยวกับสแครป ดังนั้นขอสรุปสั้น ๆ:
- เงื่อนไขการใช้งานของ Etsy ระบุชัดว่าไม่อนุญาตให้เข้าถึงแบบอัตโนมัติ อย่างไรก็ตาม Etsy มักใช้การบังคับทางเทคนิค (DataDome) มากกว่าการฟ้องร้อง — ยังไม่มีคดีที่ทราบกันซึ่งเจาะจงไปที่สแครปเปอร์ของ Etsy โดยตรง
- สแครปเฉพาะข้อมูลสาธารณะที่เปิดให้เข้าถึงได้ อย่าหลีกเลี่ยงการยืนยันตัวตนหรือเข้า dashboard ส่วนตัวของผู้ขายที่คุณไม่ได้เป็นเจ้าของ
- ใช้อัตราการเรียกที่เหมาะสม หน่วง 2–7 วินาทีระหว่าง request และอย่ากระหน่ำเซิร์ฟเวอร์ของ Etsy
- เคารพ
robots.txtEtsy อนุญาตหน้าค้นหาแต่จำกัดบาง path - จัดการข้อมูลส่วนบุคคลอย่างรับผิดชอบ ภายใต้กฎหมายความเป็นส่วนตัวอย่าง GDPR
- ปรึกษาที่ปรึกษากฎหมาย สำหรับโปรเจกต์สแครปในระดับเชิงพาณิชย์
สำหรับข้อมูลพื้นหลังเพิ่มเติม ดูโพสต์ของเราเกี่ยวกับ ผลทางกฎหมายของการสแครปเว็บ — รวมถึงคดี Meta v. Bright Data (2024) ที่ศาลยืนยันสิทธิ์ในการสแครปข้อมูลสาธารณะ
สรุป: ประเด็นสำคัญที่ควรจำ
เราครอบคลุมหลายอย่างมากในบทความนี้ นี่คือสิ่งที่ผมอยากให้คุณเอากลับไป:
- ข้อมูลมีโครงสร้างแบบ JSON-LD ของ Etsy ทำให้การดึงข้อมูลง่ายและสะอาดกว่า parsing HTML ดิบสำหรับฟิลด์ส่วนใหญ่
- DataDome เป็นอุปสรรคจริง — ใช้ headers ที่เหมาะสม การหน่วงเวลา การจัดการคุกกี้ และ residential proxy หากสแครปด้วย Python ในสเกลใหญ่
- Etsy API มีข้อจำกัด ถ้าคุณต้องการรีวิว ร้านคู่แข่ง หรือการวิเคราะห์ข้ามผู้ขาย การสแครปคือทางที่ใช้งานได้จริง
- Thunderbit เป็นทางเลือกไม่ต้องเขียนโค้ด ที่จัดการระบบป้องกันบอตและการยืนยันตัวตนได้แบบเนทีฟ — คุ้มค่าที่จะลองถ้าคุณอยากได้ข้อมูล Etsy โดยไม่ต้องดูแลสคริปต์
- สแครปอย่างรับผิดชอบเสมอ และเคารพเงื่อนไขของ Etsy
ถ้าคุณอยากเริ่มแบบไม่ต้องเขียนโค้ด ลอง Thunderbit ฟรี หรือใช้โค้ด Python จากบทความนี้เพื่อสร้างสแครปเปอร์ของคุณเอง — และขอให้ selector ของคุณไม่เคยพังตอนบ่ายวันศุกร์
สำหรับคู่มือสแครปเพิ่มเติม ดู คู่มือ Etsy scraper และรวม AI web scraper ที่ดีที่สุด
ลอง Thunderbit เพื่อดึงข้อมูล Etsy ให้เร็วขึ้น Get Started Free
คำถามที่พบบ่อย
1. การสแครป Etsy ด้วย Python ถูกกฎหมายไหม?
การสแครปข้อมูลสาธารณะที่เปิดให้เข้าถึงได้โดยทั่วไปมักทำได้ตามบรรทัดฐานทางกฎหมายล่าสุด (เช่น Meta v. Bright Data, hiQ v. LinkedIn) อย่างไรก็ตาม เงื่อนไขการใช้งานของ Etsy ห้ามการเข้าถึงแบบอัตโนมัติ ดังนั้นควรตรวจ ToS และ robots.txt ของเขาก่อนเสมอ สำหรับการใช้งานระดับใหญ่หรือเชิงพาณิชย์ ควรปรึกษาที่ปรึกษากฎหมาย
2. ฉันจะสแครป Etsy โดยไม่โดนบล็อกได้ไหม?
Etsy ใช้ DataDome ซึ่งเป็นหนึ่งในระบบป้องกันบอตที่แข็งแกร่งที่สุด การตั้ง headers ให้สมจริง การหน่วงคำขอ การเก็บคุกกี้ต่อเนื่อง และการหมุน residential proxy ช่วยลดการโดนบล็อกได้ Thunderbit ใช้แนวทางผ่านเบราว์เซอร์จริง จึงหลีกเลี่ยงการตรวจจับส่วนใหญ่ได้เพราะทำงานในเซสชัน Chrome จริงของคุณ
3. Etsy มี API ให้ใช้แทนการสแครปไหม?
มี — Etsy มี API v3 แต่ส่วนใหญ่จำกัดเฉพาะข้อมูลร้านของคุณเอง และไม่มีการเข้าถึงรีวิวที่แข็งแรงพอ งานด้าน competitive intelligence และการวิเคราะห์ข้ามร้านส่วนใหญ่จึงยังต้องสแครป
4. ต้องใช้ไลบรารี Python อะไรบ้างเพื่อสแครป Etsy?
อย่างน้อย: requests, beautifulsoup4, pandas (สำหรับส่งออก) และ json (มีมาในตัว) ถ้าเป็นหน้าที่ใช้ JS หนักหรือจำเป็นต้องล็อกอิน ให้เพิ่ม selenium ถ้าต้องการ parse HTML ให้เร็วขึ้น ใช้ lxml
5. จะสแครปรีวิว Etsy โดยเฉพาะได้อย่างไร?
รีวิวของ Etsy โหลดผ่าน internal API endpoint (/api/v3/ajax/bespoke/member/neu/specs/deep_dive_reviews) คุณต้องดึง listing ID, shop ID และ CSRF token จากหน้าสินค้า แล้ว POST ไปยัง endpoint พร้อม pagination เป็นทางสำรอง คุณสามารถ parse รีวิวชุดแรกจาก HTML ของหน้าสินค้าได้เช่นกัน — ทั้งสองวิธีอธิบายไว้ทีละขั้นในบทเรียนนี้
อ่านเพิ่มเติม



