
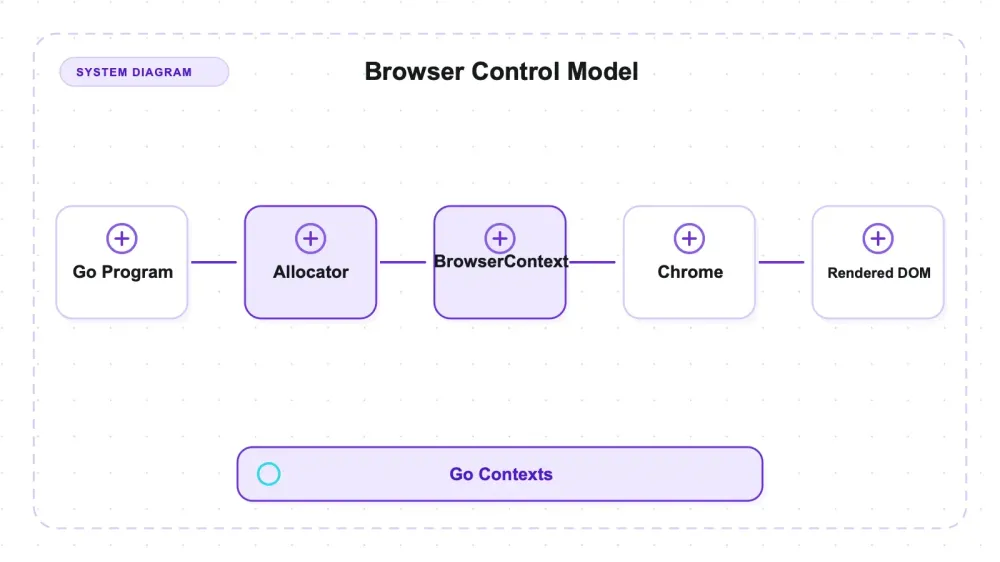
chromedp คือไลบรารี pure Go ภายใต้สัญญาอนุญาต MIT ที่สั่งงาน Chrome ตัวจริงผ่าน Chrome DevTools Protocol มันอ่าน DOM หลังจาก JavaScript ของหน้าเว็บทำงานเสร็จได้ภายในโปรแกรม Go โดยไม่ต้องพึ่ง WebDriver แยกต่างหากหรือ Node runtime โมดูล Go จะถูกคอมไพล์รวมเข้าไปในแอป แต่ตอนรันจริงยังต้องมีไฟล์เรียกใช้งาน Chrome อยู่ข้างนอก และอายุการทำงานของมันก็ถูกคุมด้วย Go context
การติดตั้งทำได้ด้วย go get แค่ครั้งเดียว แต่ Chrome ต้องเตรียมเอง ผมต้องสร้าง allocator, สร้าง context ที่สืบทอดจากมัน แล้วส่งรายการ action ให้ Run บนเครื่อง macOS arm64 เครื่องนี้ พอใช้ shell แบบ headless ที่อุ่นอยู่บนดิสก์แล้ว ตั้งแต่เริ่มโปรเซสใหม่จนได้ผลลัพธ์จากสคริปต์แรก ค่ากลางอยู่ที่ 102 ms นี่เป็นแค่ baseline บนเครื่อง local ไม่ใช่ข้อสรุปทั่วไปว่าการสตาร์ทอัปไม่เคยเป็นคอขวด บน fixture ที่ฉีดลิงก์เข้ามาหลังโหลด 800 มิลลิวินาที วิธีอ่าน 2 จาก 4 แบบกลับทำงานก่อนที่ลิงก์จะมีอยู่จริง
เบราว์เซอร์เป็นของจริง เนื้อหาก็มีอยู่จริง แต่โค้ดแค่ไม่ได้รอมันให้ทัน ช่องว่างตรงนี้แหละคือสิ่งที่ chromedp สอนผมได้ดีที่สุด และมันไม่ใช่บั๊ก — แต่มันคือความต่างระหว่าง "ฉันเรนเดอร์หน้าแล้ว" กับ "ฉันรอสิ่งที่ต้องการจริง ๆ แล้ว" ซึ่งเป็นความต่างที่ตำนานเกี่ยวกับ headless browser มักเหมารวมจนหายไปทั้งหมด กลยุทธ์การรอ ไม่ใช่ตัวเบราว์เซอร์ ต่างหากที่เป็นตัวตัดสินว่าคุณจะได้ข้อมูลหรือไม่ ตัวเลขทั้งหมดในที่นี้มาจาก fixture local ที่ผมควบคุมได้ โดยมีการลงทะเบียน ground truth ไว้ก่อนรันทุกครั้ง และสรุปข้อมูลดิบอยู่ใน โฟลเดอร์ chromedp ของ repo benchmark ของเรา
chromedp คืออะไรกันแน่
สแต็กของ chromedp ถูกออกแบบให้สั้นและตรงไปตรงมา ไม่มี Selenium server ไม่มีชั้น WebDriver คั่นกลาง ไม่มี Node runtime ซ่อนอยู่ข้างใต้ โปรแกรม Go ของคุณเปิด WebSocket ไปยัง Chrome instance แล้วคุย CDP กับมันโดยตรง ซึ่งโดยหลักการแล้วก็เป็นโปรโตคอลบนสายส่งเดียวกับที่ Puppeteer ใช้ เพียงแต่ไม่มี JavaScript คั่นกลาง
ตอนที่ผมเช็กเมื่อ 27 กรกฎาคม 2026 รีโปนี้มี 13,212 ดาว และ 178 issue ที่ยังเปิดอยู่ ภายใต้สัญญาอนุญาต MIT เวอร์ชันที่ผมทดสอบคือ v0.16.0 ซึ่งเป็นแท็กล่าสุดในรีโปนี้ มีจุดที่ควรระวังไว้ก่อนจะสับสน: หน้า Releases ของ GitHub ยังแสดง v0.15.1 (เผยแพร่ 2026-04-01) เป็น release object ล่าสุด แต่ go get github.com/chromedp/chromedp@latest กลับไปที่ v0.16.0 ตัว Go modules กับ release object บน GitHub คลาดเคลื่อนกันตรงนี้ ไม่ได้พัง แค่ชวนหงุดหงิดเวลาพยายามดูว่าตัวเองกำลังรันอะไรอยู่
ภาพจำที่ควรมีคือ context ของ Go ทำงานตั้งแต่ต้นจนจบ คุณสร้าง allocator context ก่อน ซึ่งรู้วิธีสตาร์ท Chrome จากนั้นสร้าง browser context ที่สืบทอดจากมัน แล้วเรียก chromedp.Run(ctx, actions...) พร้อมรายการ Actions บราว์เซอร์ context ที่เป็นลูกคือแท็บใหม่ ยกเลิก context เมื่อไร สิ่งที่มันแทนอยู่ก็หายไปทันที ถ้าคุณเคยทำงาน concurrency ใน Go มาก่อน วิธีนี้จะคุ้นมาก แต่ถ้ายังไม่เคย คู่มือ เริ่มต้นเว็บสแครปปิ้งด้วย Go ของเราจะเข้าใจง่ายกว่า godoc ของ chromedp เยอะ
มีขอบเขตหนึ่งที่ควรกำหนดตั้งแต่ต้น: chromedp ส่งมอบ DOM ที่ผ่านการเรนเดอร์แล้วให้คุณ แต่มันไม่ได้ส่งมอบข้อมูลที่เป็นโครงสร้างมาให้ คุณจะดึงฟิลด์ ตาราง ราคา หรืออะไรก็ตามออกจาก DOM นั้นด้วยโค้ดของตัวเอง และต้องดูแลโค้ดนั้นต่อไป มันเป็น driver ไม่ใช่ scraper framework
กลไกภายในทำงานอย่างไร
ทุกอย่างใน chromedp คือ Action และ Run จะรัน slice ของ Actions เหล่านั้นตามลำดับกับ target เดียวกัน Navigate, Click, Evaluate, OuterHTML, WaitVisible — ล้วนใช้อินเทอร์เฟซเดียวกัน ประกอบเข้าด้วยกันได้ทั้งหมด และเป็นแค่คำสั่ง CDP ที่ห่อด้วยชนิดของ Go ความสม่ำเสมอนี้คือจุดแข็งที่สุดของดีไซน์ เพราะทำให้ส่วนใช้ง่ายกับโปรโตคอลดิบอยู่บนชั้นเดียวกัน
ซึ่งสำคัญมาก เพราะชั้นใช้ง่ายตั้งใจทำให้บางอยู่แล้ว chromedp สร้างอยู่บน cdproto ซึ่งเป็นชุด binding ของ Go แบบ typed ที่สร้างอัตโนมัติ ครอบคลุมพื้นที่ทั้งหมดของ DevTools Protocol และ chromedp godoc ก็อธิบายทั้งสองชั้นวางคู่กันไว้ ถ้าไม่มี convenience action ที่ต้องการ คุณก็ลงไปเรียก domain call ตรง ๆ — network.Enable(), page.CaptureScreenshot(), runtime.Evaluate() — ภายใน Run เดิม ไม่มีผนังกั้นระหว่าง "API ที่ใช้ง่าย" กับ "API จริง" ซึ่งไม่ใช่ว่า browser driver ทุกตัวจะเป็นแบบนี้
จุดที่ต้องใช้ดุลยพินิจในงานประจำวันอยู่ที่ wait action และตัวเลือกมีมากกว่าที่คนส่วนใหญ่ใช้:
| Wait action | สิ่งที่รอให้เกิดขึ้น |
|---|---|
WaitReady(sel) | จน node ถูก แนบ เข้า DOM |
WaitVisible(sel) | จน node มองเห็นได้จริง |
WaitNotPresent(sel) / WaitNotVisible(sel) | แบบกลับด้าน ใช้ดีกับ spinner |
Poll(js, res) | ประเมิน predicate ของ JavaScript เป็นช่วง ๆ จนกว่าจะเป็นจริง |
อีกชิ้นหนึ่งของกลไกที่ควรรู้คือการจัดการโปรเซส เพราะมันเป็นตัวตัดสินว่าโปรแกรมของคุณจะทิ้งเบราว์เซอร์ไว้เบื้องหลังหรือไม่ chromedp สตาร์ท Chrome ผ่าน exec.CommandContext ของ Go และถ้า cancel context นั้น โปรเซสก็จะถูกฆ่าทิ้ง รายละเอียดการทำงานจุดเดียวนี้อธิบายได้ทั้งพฤติกรรมที่ดี และมุมคมที่ผมเจอระหว่างทดสอบ
การติดตั้งคือ Go binary บวกกับ Chrome ที่ต้องหาเอง
go get github.com/chromedp/chromedp ลงได้เรียบร้อยเป็น v0.16.0 แบบไม่มีดราม่า และ dependency tree ก็ไม่มี cgo import ดังนั้นข้อความแนว "pure Go, ไม่มี dependency ภายนอก" ที่มักพูดกันนั้นจริง — แต่จริงกับตัว Go module เท่านั้น
มันไม่จริงในระดับ runtime chromedp ต้องขับ Chrome ภายนอก และถ้าในเครื่องไม่มี Chrome อยู่ การรันจะล้มทันที ทุกการวัดที่ผมทำระบุ executable โดยตรงผ่าน chromedp.ExecPath ชี้ไปยัง Chrome for Testing 151.0.7922.10 แบบ headless shell นี่ไม่ใช่ข้อเสีย — การขับเบราว์เซอร์ย่อมต้องมีเบราว์เซอร์ — แต่คำว่า "ไม่มี external dependency" กับคำว่า "คุณต้อง ship Chrome 155 MB ไปพร้อมไบนารีของคุณ" คือภาพ deployment สองแบบที่ต่างกันมาก และมีแค่แบบหนึ่งเท่านั้นที่มักเห็นใน README
กับดักการตั้งค่าอีกอย่างหนึ่งที่ทำให้ผมเสียเวลา และควรรู้ก่อนเริ่มเขียนโค้ดคือ issue #1591 ของ chromedp รายงานว่า go test บน Go 1.25+ จะ cancel NewExecAllocator ระหว่างเริ่มต้น ทั้งที่โค้ดเดียวกันกลับรันได้ปกติเมื่อคอมไพล์เป็นไบนารี ผมสร้าง probe binary ด้วย go build แล้วใช้มันกับทุกการวัด แทนที่จะขับผ่าน go test ตรง ๆ ผมใช้ Go 1.26.5 บน macOS arm64 ถ้าประสบการณ์แรกของคุณกับ chromedp คือไฟล์ทดสอบที่ตายระหว่าง Chrome เริ่มทำงาน ให้อ่าน issue นี้ก่อนจะไปโทษโค้ดตัวเอง
ลงมือจริง: สี่วิธีอ่านหน้าเดียวกัน แต่สองวิธีได้ค่าว่าง
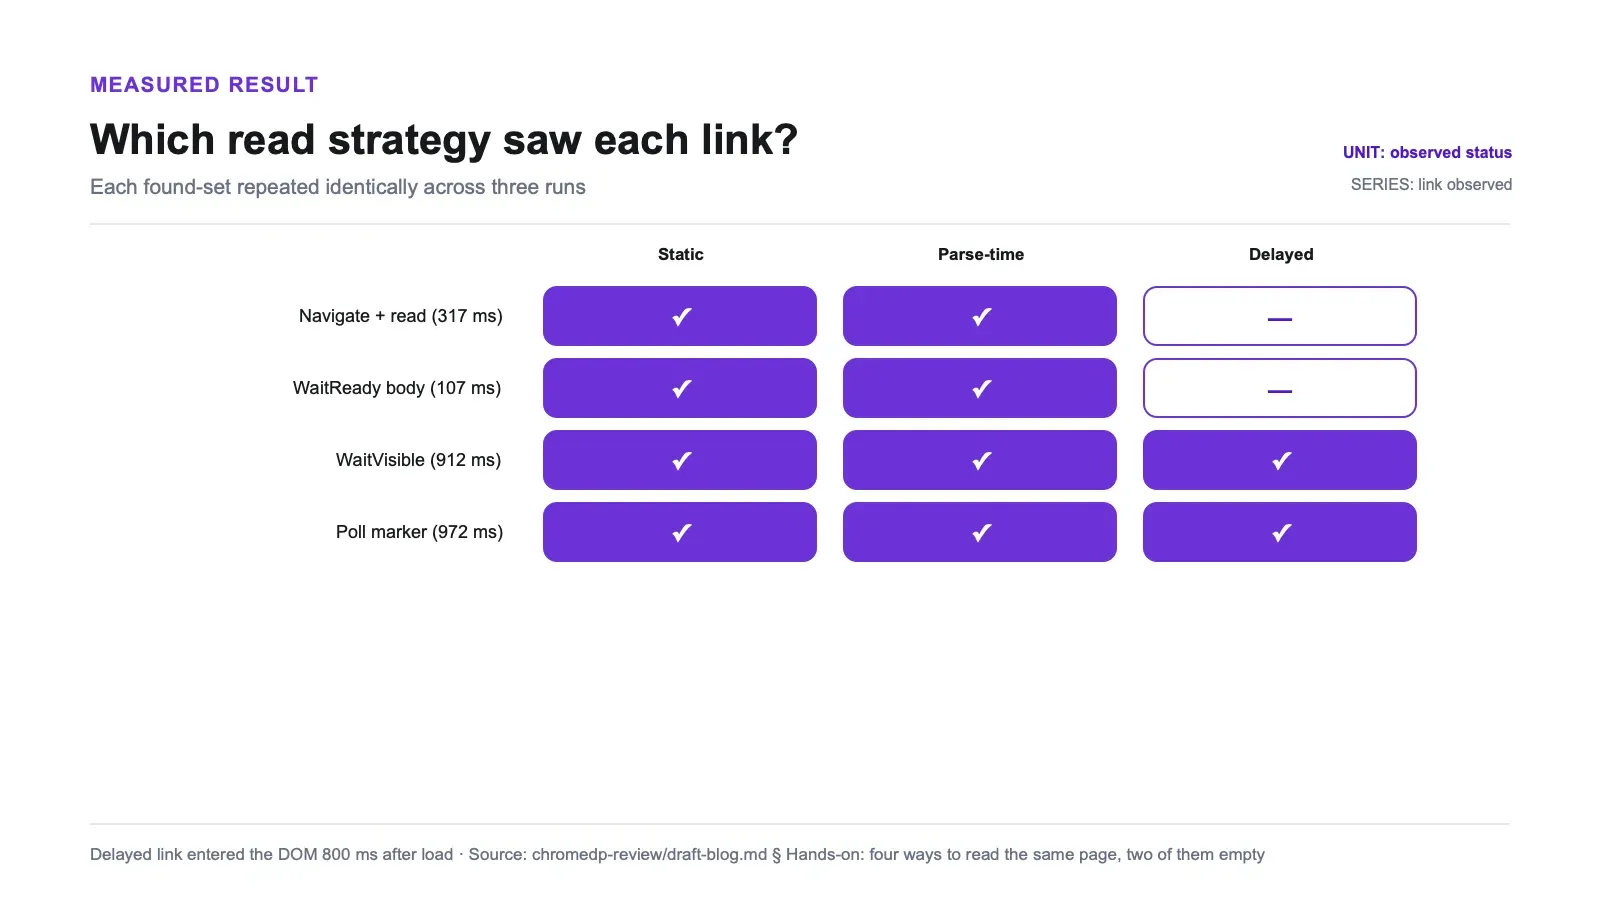
fixture นี้คือเซิร์ฟเวอร์ local บน 127.0.0.1 ที่เสิร์ฟเนื้อหา 3 แบบ ซึ่งต่างกันแค่ เวลา ที่มันเข้าสู่ DOM: <a> แบบคงที่ที่อยู่ใน bytes ที่เสิร์ฟมา, <a> ที่ถูกสร้างโดย <script> แบบ inline ระหว่าง parse แรก, และ <a> ที่ถูกสร้างโดย setTimeout หลังเหตุการณ์ load ผ่านไปตามจำนวนมิลลิวินาทีที่กำหนด marker และ href ของลิงก์ที่สร้างด้วยสคริปต์ทั้งสองตัวถูกประกอบจากชิ้นส่วน string ใน JavaScript ดังนั้นใน bytes ที่เสิร์ฟมา จะไม่มี literal ที่ติดกันอยู่เลย ถ้าพบลิงก์ จึงยืนยันว่า Chrome รัน JavaScript จริง ไม่ใช่ว่าแค่มีอะไรมาอ่าน HTML
Recall ถูกคำนวณใน Python เทียบกับ ground truth marker ที่ลงทะเบียนไว้ล่วงหน้า ไม่ได้คำนวณใน Go probe ดังนั้น probe จะโกงโดยรู้คำตอบไม่ได้ แต่ละ strategy รัน 3 ครั้ง และชุดผลที่พบเหมือนกันทั้ง 3 ครั้ง
| กลยุทธ์การอ่าน | ลิงก์ใน HTML แบบคงที่ | ฉีดตอน parse | ฉีดหลังโหลด 800 ms | เวลาใช้ |
|---|---|---|---|---|
Navigate + อ่านเลย ไม่รอ | พบ | พบ | ไม่พบ | 317 ms |
WaitReady("body") | พบ | พบ | ไม่พบ | 107 ms |
WaitVisible("#delayed-injected") | พบ | พบ | พบ | 912 ms |
| Poll จนกว่า marker จะปรากฏ | พบ | พบ | พบ | 972 ms |
สองแถวแรกได้มาแค่ 2 ลิงก์จาก 3 ลิงก์ การอ่านแบบตรง ๆ พลาดเพราะ Navigate จบรอบเมื่อถึง load event และลิงก์ตัวที่สามยังไม่เกิด ส่วน WaitReady("body") พลาดด้วยเหตุผลที่ละเอียดกว่า และแย่กว่าสำหรับการใช้งานจริง: body ถูกแนบตั้งแต่ตอน load ดังนั้นการรอจบลงทันที และคุณจะรู้สึกเหมือนทำสิ่งที่ถูกต้องแล้ว มันกลับมาใน 107 ms เร็วกว่าทางที่ไม่รอเสียอีก แต่ให้หน้าเดียวกันที่ยังไม่ครบ
เพื่อยืนยันกลไกแทนที่จะเดา ผมไล่ sweep เวลาหน่วงการฉีด แล้วรันสองปลายทางอีกครั้ง (recall-summary.json):
| เวลาหน่วงหลังโหลด | อ่านแบบไม่รอเห็นไหม | WaitVisible เห็นไหม | เวลา WaitVisible |
|---|---|---|---|
| 0 ms | ใช่ (แข่งกันอยู่) | ใช่ | 109 ms |
| 100 ms | ไม่ | ใช่ | 208 ms |
| 400 ms | ไม่ | ใช่ | 519 ms |
| 800 ms | ไม่ | ใช่ | 911 ms |
| 1500 ms | ไม่ | ใช่ | 1625 ms |
เวลาในการจบของ WaitVisible ใน fixture นี้ไล่ตามเวลาหน่วงการฉีด — 100 ไป 208, 400 ไป 519, 800 ไป 911, 1500 ไป 1625 — ซึ่งเป็นหลักฐานว่ามันบล็อกจน node ปรากฏจริง ไม่ได้อ่านก่อนเวลา แถว 0 ms คือเส้นแบ่ง: setTimeout(…, 0) อาจทำงานก่อนการอ่านทันที ดังนั้นทางไม่รอจึงอาจจับได้ แต่ตั้งแต่ 100 ms ขึ้นไปในการ sweep นี้ ทางไม่รอพลาดทุกครั้ง
ใน production ความผิดพลาดเรื่องเวลาแบบเดียวกันอาจให้ HTML ที่ถูกต้อง แต่แยกข้อมูลออกมาได้ศูนย์แถว แล้วออกจากโปรแกรมด้วยสถานะ 0 ถ้าท่อประมวลผลไม่ตรวจ cardinality ของผลลัพธ์ นี่เป็น failure mode ที่เป็นไปได้และสอดคล้องกับพฤติกรรมของ fixture แต่ไม่ได้เป็นเหตุการณ์ที่ผมวัดตรงนี้ การเรนเดอร์เป็นแค่ครึ่งเดียวของข้อกำหนด การอ่านต้องรอเงื่อนไขระดับแอปที่ผูกกับข้อมูลที่ต้องการด้วย
WaitReady กับ WaitVisible ไม่ได้แข่งกัน — พวกมันตอบคนละคำถาม
คำอธิบายที่ได้ยินบ่อยคือ WaitVisible "เชื่อถือได้กว่า" WaitReady คำนี้คลุมเครือมากพอจะทำให้พังได้ บนหน้าที่ node ถูกแนบเข้า DOM แล้วแต่ถูกตั้งค่า display: none ทั้งสองตัวจะแยกทางกันชัดเจน (waitsem-summary.json, รัน 3 ครั้งเหมือนกัน):
| node เป้าหมาย | Action | ผลลัพธ์ | เวลา |
|---|---|---|---|
แนบอยู่, display:none | WaitReady | กลับค่า | ~6 ms |
แนบอยู่, display:none | WaitVisible | หมดเวลา, context deadline exceeded | 4000 ms |
| node ที่มองเห็นได้ | WaitVisible, query ปกติ | กลับค่า | 4–12 ms |
| node ที่มองเห็นได้ | WaitVisible, ByID | กลับค่า | 1–2 ms |
| node ที่มองเห็นได้ | WaitVisible, ByQuery | กลับค่า | 1 ms |
WaitReady หมายถึงแนบแล้ว WaitVisible หมายถึงมองเห็นแล้ว ถ้าถามผิดตัว คุณจะอ่านข้ามเนื้อหาที่ไม่เคยเรนเดอร์ หรือไม่ก็ถูกบล็อกจนหมด timeout กับ node ที่ไม่มีทางมองเห็นอยู่ดี พฤติกรรมเมื่อครบ deadline เองก็เรียบร้อย — ได้ context deadline exceeded แบบตรงเวลา 4 วินาทีพอดี ไม่มี hang ไม่มี zombie state ซึ่งดีกว่าที่ driver บางตัวทำได้
กับดักที่มีคนรายงานไว้อย่างหนึ่งไม่โผล่ขึ้นมา issue #440 รายงานว่า WaitVisible("#id") ค้างเมื่อใช้ default query แต่ใน v0.16.0 ผมไม่เจอปัญหานั้น — default query, ByID, และ ByQuery ล้วนกลับมาจาก node ที่มองเห็นได้ทุกครั้งในการรันที่ทำไว้ แต่การไม่ reproduce ไม่ได้แปลว่าแก้แล้ว นี่เป็นแค่ selector รูปแบบหนึ่งบนหน้าเว็บหนึ่งหน้า ซึ่งยังไม่พอจะล้าง issue ออกไป
defer cancel() ที่คุณข้ามไปคือของค้ำหลังคา
นับจำนวนโปรเซส ไม่ใช่นับ return value ทุกการทดสอบ lifecycle ใช้ --user-data-dir ที่ไม่ซ้ำกัน และนับโปรเซส Chrome browser จริงด้วย pgrep โดยตัด renderer child ออก ทุกเส้นทางรัน 3 ครั้ง (lifecycle-summary.json)
| เส้นทางออก (macOS, อย่างละ 3 รัน) | เกิดอะไรกับ chrome-headless-shell ที่ถูกสตาร์ท | เวลา |
|---|---|---|
| cancel context และ allocator | หายไป | 13, 13 และ 12 มิลลิวินาที |
| ออกจาก Go process โดยไม่ cancel | อยู่รอดหลังโปรแกรมคุณจบ — ก่อน probe ออกมี 0 browser process หลังจากออกมี 1; กลายเป็น orphan ทั้ง 3/3 รอบ | — |
การ cancel ทำงานสะอาดและเร็ว ตรงกับที่ exec.CommandContext สัญญาไว้ทุกประการ (orphan ทุกตัวถูก harness ฆ่าทิ้งภายหลังเพื่อให้โฮสต์สะอาด)
นี่เป็นพฤติกรรมที่รู้กันดี มีเอกสารรองรับ และขึ้นกับแพลตฟอร์ม — สิ่งที่ผมวัดคือผลลัพธ์ ไม่ใช่การค้นพบต้นเรื่อง tracker ของ chromedp ครอบคลุมประเด็นนี้หลายมุม: #774 อธิบายการไม่ exit แบบเดียวกันบน FreeBSD, #752 รายงาน Chromium process ที่ค้างบน macOS และ #562 กับ #1566 อธิบายกลไกไว้ชัดเจน สิ่งที่ผมเพิ่มเข้ามาคือจำนวนโปรเซสและเวลาในสองฝั่งของการเปรียบเทียบ ซึ่งรายงานเชิงคุณภาพเหล่านั้นไม่มีให้
ตัวกลไกเองเกี่ยวข้องกับ build tag ซึ่งควรรู้ไว้ ในซอร์สของ v0.16.0 allocate_linux.go ตั้งค่า Pdeathsig = SIGKILL ให้ child process ดังนั้น Linux จึงได้สัญญาณระดับ kernel เมื่อ parent ตาย ส่วน allocate_other.go ซึ่งเป็นไฟล์ที่ macOS คอมไพล์เข้าไป จะทำให้คำสั่งนั้นไม่มีผล ไม่มีสัญญาณเทียบเท่าบน darwin ดังนั้นไม่มีอะไรไปฆ่า Chrome เมื่อโปรแกรมคุณจบ ขณะเดียวกันข้อความใน godoc อ่านเหมือนเป็นสัญญาทั่วไป — command เริ่มต้น "ส่ง SIGKILL ไปยังเบราว์เซอร์ที่ยังเปิดอยู่เมื่อโปรแกรม Go จบ" — แต่รายละเอียดที่จำกัดเฉพาะ Linux ถูกซ่อนไว้ในซอร์สที่ติด build tag และต้องไล่อ่านเอง การบอกว่าเอกสารนี้สื่อเกินจริงจึงเป็นเรื่องยุติธรรม แต่จะเรียกว่าเป็นบั๊กของ chromedp ก็ไม่ยุติธรรม
ไม่ว่าจะมองอย่างไร ผลลัพธ์เชิงปฏิบัติก็ยังเหมือนเดิม: บน macOS, defer cancel() เป็นสิ่งจำเป็นอย่างยิ่ง ถ้าข้ามมันไป ทุกครั้งที่รันจะมี browser process หลุดค้าง ผม ไม่ได้ทดสอบ Linux ดังนั้นจะไม่เหมารวมผล orphan ไปที่นั่น — ซอร์สบอกเป็นนัยว่า Linux ทำงานต่างออกไป แต่คำใบ้ไม่ใช่การวัดจริง
cold start, concurrency และเรื่องพื้น ๆ ที่กำหนดการ deploy ของคุณ
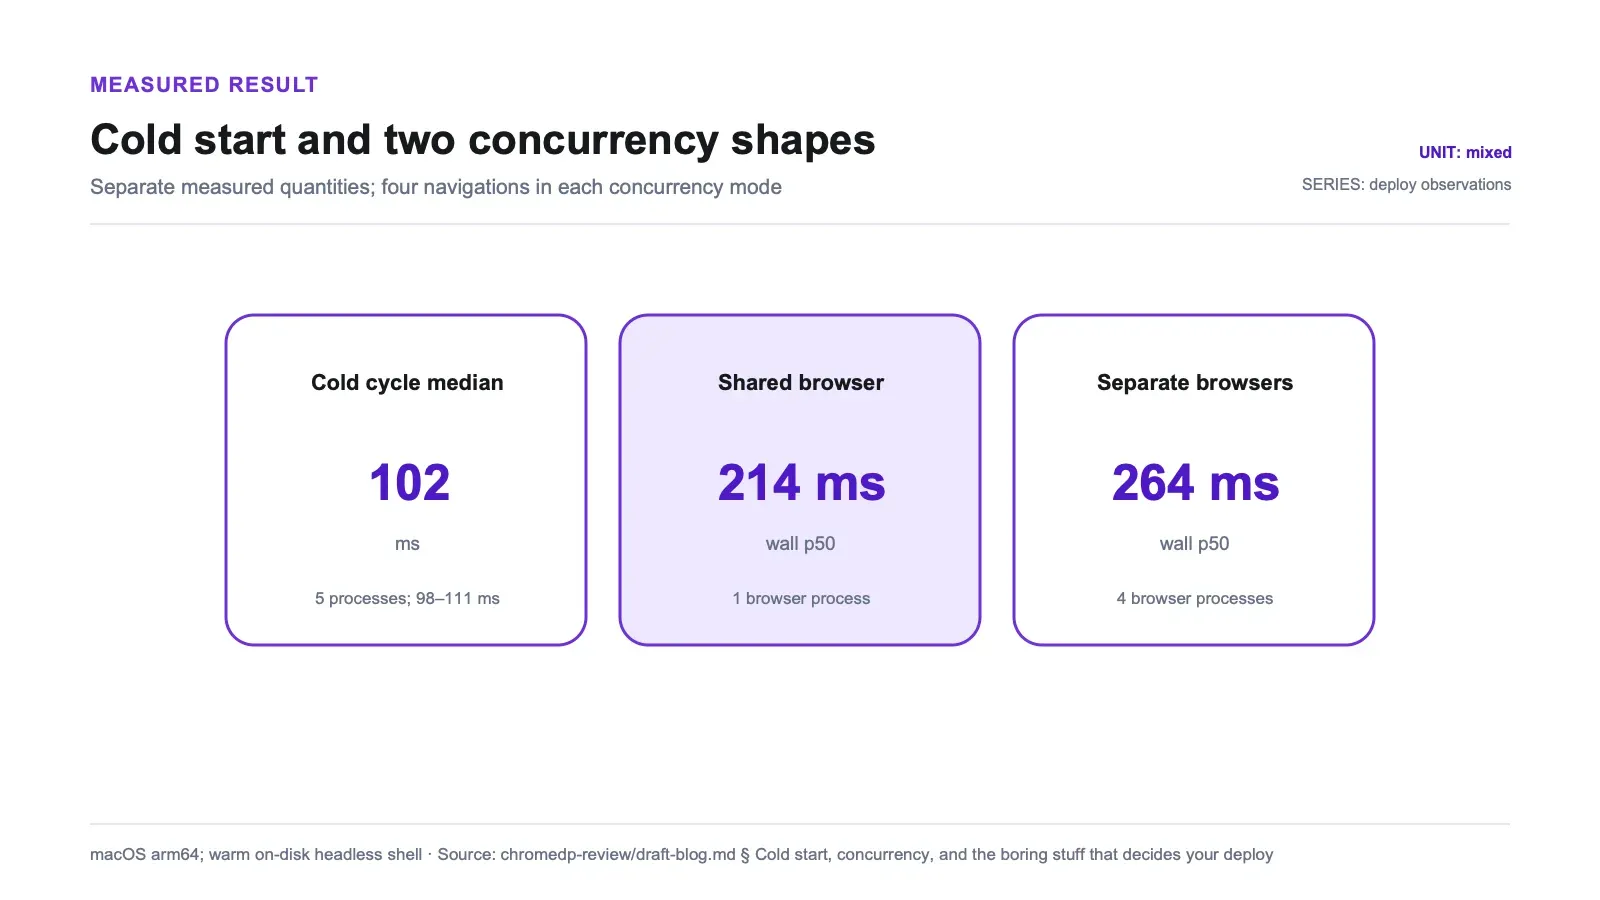
102 ms คือค่ากลางจาก fresh process, allocator, context, localhost navigation และ Evaluate ครั้งแรก รวม 5 โปรเซส โดยช่วงอยู่ที่ 98 ถึง 111 ms (coldstart-summary.json) บน fixture macOS arm64 นี้ที่มี headless shell อุ่นอยู่บนดิสก์ การเริ่มต้นใช้เวลาน้อยเมื่อเทียบกับการรอเนื้อหาที่หน่วงไว้ Container, filesystem ที่ยังเย็น, CI, serverless environment และการนำทางใน production ไม่ได้อยู่ในการวัดครั้งนี้
ด้าน concurrency chromedp ให้คุณเลือกได้ 2 แบบ — เบราว์เซอร์ตัวเดียวแล้วมี child context หลายตัว (แท็บหลายแท็บ) หรือเบราว์เซอร์หลายตัวแยกกัน 4 navigation อย่างละ 3 รอบ (concurrency-summary.json):
| โหมด | เวลารวม (p50) | ช่วง | จำนวน Chrome browser process สูงสุด |
|---|---|---|---|
| ใช้ browser ร่วมกัน, 4 child contexts | 214 ms | 209–219 | 1 |
| 4 browser แยกกัน | 264 ms | 261–278 | 4 |
ข้อค้นพบที่วัดได้คือจำนวน process: Chrome browser process หนึ่งตัวเทียบกับสี่ตัวสำหรับการนำทาง local แบบง่าย ๆ สี่ครั้งนี้ ช่วงเวลารวมไม่ทับซ้อนกัน แต่ยังถือว่าเป็นทิศทางมากกว่าจะเป็น benchmark ด้าน throughput ยังไม่ได้วัด RSS หรือ PSS ดังนั้นการทดสอบนี้ยังยืนยันเรื่องประหยัดหน่วยความจำไม่ได้
การ probe เส้นทาง error แบบสั้น ๆ ยังไม่ละเอียดพอจะอ้างความทนทานได้: ฉบับร่างนี้ไม่ได้ระบุว่า HTTP status, navigation error, event หรือ logic ของ harness เป็นตัวทำให้เงื่อนไขนั้นโผล่มา ดังนั้นให้ถือว่าการจัดการ 500/ลิงก์เสียยังไม่ถูกรายงาน จนกว่าจะเผยผล API จริงและ artifact ดิบออกมา
สิ่งที่ไม่ได้ทดสอบ และจึงอยู่นอกขอบเขตของตัวเลขชุดนี้: พฤติกรรม lifecycle บน Linux, concurrency มากกว่า N=4 หรือมีงานจริงต่อหน้า, ความต่างด้าน memory (ผมนับ process ได้นับ RSS), network interception และ request capture, รวมถึงรายงาน timeout ของ WaitReady ที่ยังเปิดอยู่ใน #168 และ #1593 — อันนั้นพูดถึง timeout แบบเป็นบางครั้ง ส่วนที่ผมวัดคือความหมายเชิง semantics ของการรอ ซึ่งเป็นคนละคำถาม เครื่องเดียว Chrome build เดียว
chromedp ไม่ใช่ Go CDP driver ตัวเดียวที่อยู่บนโต๊ะทดสอบนี้: rod ผ่าน fixture, harness, host และ Chrome build เดียวกันในรอบเดียวกัน และมีบทวิเคราะห์ของมันแยกต่างหาก
ข้อดีและข้อเสีย
ข้อดี:
- เข้าถึง CDP ได้จริง — ทั้ง action ที่ใช้ง่ายและคำสั่ง domain ดิบของ
cdprotoใช้ร่วมกันในRunเดียว จึงไม่ชนเพดาน API - ค่า baseline แบบ cold cycle บนเครื่อง local อยู่ที่ p50 102 ms โดยช่วง 98–111 ms ใน fixture macOS ที่ทดสอบ
- ยกเลิก context แล้ว Chrome ถูกเก็บกลับภายในราว 13 ms อย่างสม่ำเสมอทุกครั้ง
- child context ใช้ browser process ร่วมกันสำหรับ N แท็บได้ (1 process เทียบกับ 4 ถ้าแยก browser)
- ให้ผลคงที่ในการทดสอบ — ชุด recall, semantics ของ wait และผลด้าน lifecycle เหมือนกันทั้ง 3 รอบที่รัน
- จัดการ deadline ได้สะอาด:
WaitVisibleบนเงื่อนไขที่ไม่มีวันเกิดขึ้นคืนcontext deadline exceededตรงเวลา 4 วินาที ไม่ค้าง - โมดูล pure Go (ไม่มี cgo) ภายใต้ MIT license แต่ตอนรันยังต้องมี Chrome executable ภายนอก
ข้อเสีย:
- ต้องมี Chrome ภายนอกตอนรันจริง; ชื่อเสียงเรื่อง "ไม่มี dependency" หมายถึงเฉพาะตัว Go module
WaitReady("body")คือกับดักที่ ดูเหมือน ถูก แต่กลับพลาดเนื้อหาหลังโหลดแบบเงียบ ๆ — มันกลับมาใน 107 ms พร้อมหน้าที่ไม่ครบ- เส้นทาง
Navigateแล้วอ่านเลยจะพลาดทุกอย่างที่ถูกฉีดเข้าหลังโหลดตั้งแต่ ~100 ms ขึ้นไปอย่างแน่นอน และไม่มี error - บน macOS ถ้าออกโดยไม่
cancel()จะทิ้ง browser ไว้เป็น orphan (3/3 รอบ) เป็นพฤติกรรมที่รู้กันดีและจำกัดเฉพาะแพลตฟอร์ม แต่ก็พลาดได้ง่าย - ข้อความใน godoc เรื่อง SIGKILL ตอน exit ฟังเหมือนเป็นสากล ทั้งที่กลไกจริงอยู่ในซอร์สที่ใช้ build tag เฉพาะ Linux
go testบน Go 1.25+ อาจ cancel การเริ่ม allocator (#1591); ควร build เป็น binary แทน- มันคืน DOM ไม่ใช่ข้อมูลที่มีโครงสร้าง — ทุกฟิลด์ที่ต้องการคือโค้ด parse ที่คุณต้องเขียนและดูแลเอง
- แท็กล่าสุด (v0.16.0) ใหม่กว่าตัว GitHub Release ล่าสุด (v0.15.1) ทำให้การเช็กเวอร์ชันชวนงงอยู่พักหนึ่ง
chromedp เหมาะกับใคร และใครควรข้าม
ถ้า service ของคุณเขียนด้วย Go อยู่แล้ว และคุณต้องการเบราว์เซอร์จริงภายในมัน chromedp คือคำตอบที่ใกล้จะชัดเจนที่สุด ไม่มี process ของ Node ให้ต้องดูแล ไม่มี WebDriver server ให้ต้องค้างอยู่ และมีแค่ไบนารีที่คอมไพล์แล้วหนึ่งตัวกับ Chrome ที่คุณ ship หรือ install เพิ่ม โมเดล context ก็สอดคล้องกับ concurrency primitive ของ Go ตรงไปตรงมามากจน lifecycle ของเบราว์เซอร์ถูกกำกับด้วยระเบียบ defer แบบเดียวกับส่วนอื่น ๆ ของโค้ด และถ้าคุณต้องการอย่างที่ convenience API ไม่มี — เช่น CDP network events, hook ใน page lifecycle แบบละเอียด หรือเทคนิคระดับ protocol — คุณก็สามารถลงไปใช้ cdproto ได้โดยไม่ต้องออกจากไลบรารี
มันยังเหมาะเมื่อคุณต้องการควบคุมการรออย่างชัดเจนด้วย wait actions ซึ่งเป็น primitive ไม่ใช่ heuristic มันทำตรงตามที่บอก และนั่นเป็นข้อดีเมื่อคุณยอมรับว่า งานเลือกเงื่อนไขที่ถูกต้องตอนนี้อยู่ในมือคุณแล้ว
ข้ามไปเลยถ้าในทีมไม่มีใครเขียน Go — ภาระที่แท้จริงคือภาษาที่ต้องใช้ ไม่ใช่ตัวไลบรารี ข้ามไปถ้าคุณต้องการความสะดวกแบบ auto-waiting ที่เดาให้ถูกแทนคุณ เพราะ chromedp จะไม่เดา มันจะทำแค่สิ่งที่คุณสั่ง และคืนสิ่งที่หน้าเว็บมีอยู่ในจังหวะนั้น ข้ามไป หรือเตรียมงบให้พอจริง ๆ ถ้าสิ่งที่คุณต้องการคือ record ที่มีโครงสร้าง ไม่ใช่ DOM: ทุกฟิลด์คือ selector ที่คุณต้องเขียน ทดสอบ และซ่อมเมื่อเว็บเปลี่ยน และถ้าความต้องการของคุณมีแค่ "ช่วยเอาข้อมูลจาก 500 URLs นี้มาให้หน่อย" การตั้ง orchestration ของเบราว์เซอร์ใน Go อาจเป็นกลไกที่เยอะเกินไปสำหรับโจทย์นั้น คู่มือ browser automation guide ของเราจะพาไปดูว่าตอนไหนเครื่องจักรแบบนี้คุ้ม และตอนไหนไม่คุ้ม
ทางเลือกอื่น รวมถึงจุดที่สแต็กของเราเองเหมาะ
ในกลุ่ม browser driver rod ก็เป็น Go CDP driver อีกตัว ส่วน Playwright และ Puppeteer เป็นตัวเลือกฝั่ง Node ที่เราพูดถึงไว้ใน บทเปรียบเทียบ Playwright กับ Puppeteer ของเรา เงื่อนไขการรอของแต่ละตัวไม่สามารถเอามาแทนกันได้ Playwright auto-wait สำหรับ actionability ก่อนหลาย action แต่นั่นก็ยังไม่บอกว่าข้อมูลระดับแอปโหลดเสร็จเมื่อไร chromedp ให้ primitive การรอระดับต่ำกว่า แล้วโยนทั้งเรื่อง actionability และ readiness ของข้อมูลระดับแอปกลับไปให้ผู้เรียก ถ้าคุณกำลังกวาดดูภาพรวมของตลาด คู่มือ สรุป open-source scraper ที่เราทดสอบ ของเราครอบคลุมทั้ง crawler แบบ static และไลบรารี extraction ฝั่งอื่นที่อยู่คนละด้านของเส้นนี้
รีวิวที่เกี่ยวข้อง: รีวิว Browserless
บริการ extraction แบบจัดการให้เป็นอีกหมวดหนึ่ง มันแลกการควบคุม browser และ selector กับการ render และการกำหนด schema ที่ outsource ไป ข้อนี้มีประโยชน์เมื่อสิ่งที่ต้องส่งมอบคือ record ที่มีโครงสร้าง ไม่ใช่ DOM ในขณะที่ chromedp เหมาะกว่าเมื่อ browser ต้องอยู่ภายใต้การควบคุมของ Go service ของคุณเอง เราสร้าง Thunderbit ซึ่งเป็นบริการประเภทนี้ขึ้นมา แต่ไม่ได้เอามาทดลองกับ fixture นี้ ดังนั้นการทดสอบนี้จึงไม่ได้สนับสนุนการเทียบเท่า latency, คุณภาพการดึงข้อมูล หรือค่าใช้จ่ายกับ chromedp แต่อย่างใด
ลองใช้ Thunderbit เพื่อดึงข้อมูลเว็บ
บทสรุป
ควรใช้ chromedp ไหม? ควร ถ้าคุณเขียน Go และต้องการเบราว์เซอร์จริงที่อยู่ภายใต้การควบคุมของคุณ บน fixture local นี้ มันได้ผลลัพธ์จากสคริปต์แรกใน 102 ms p50, เก็บ Chrome กลับภายในประมาณ 13 ms หลัง cancel และใช้ browser process เพียงตัวเดียวสำหรับ 4 แท็บพร้อมกัน สิ่งเหล่านี้คือข้อสังเกตที่มีขอบเขต ไม่ใช่คำสัญญาด้านประสิทธิภาพแบบสากล จุดที่ยังน่าดึงดูดในระยะยาวคือการเข้าถึง CDP โดยตรงจาก Go เมื่อชั้น convenience ใช้ต่อไปไม่ไหว
แค่ต้องตีกรอบคำโฆษณาให้ถูก เพราะชื่อเสียงของมันชอบพูดเกินจริงอยู่ 2 เรื่อง "pure Go, ไม่มี dependency" หมายถึงตัวโมดูล แต่ตอนรันคุณยังต้อง ship และจัดการ Chrome binary เอง และ "ใช้ headless browser แล้วจะได้ dynamic content" จะจริงก็ต่อเมื่อ wait ของคุณผูกกับ node ที่ต้องการเท่านั้น — การอ่านแบบไม่รอและ WaitReady("body") ต่างก็ให้หน้าที่ขาดเนื้อหาซึ่งถูกฉีดเข้าหลังโหลด 800 ms มาอย่างเงียบ ๆ ทุกครั้ง บน macOS, defer cancel() ไม่ใช่เรื่องของสไตล์ แต่เป็นสิ่งจำเป็น; ถ้าไม่ใส่ คุณจะรั่ว browser หนึ่งตัวต่อการรันหนึ่งครั้ง ซึ่งเป็นพฤติกรรมเฉพาะแพลตฟอร์มที่รู้กันอยู่ แต่ก็ยังเป็นปัญหาของคุณอยู่ดี ถ้าจัดการ 3 เรื่องนี้ให้ถูก chromedp คือหนึ่งใน browser driver ที่คาดเดาได้มากที่สุดตัวหนึ่งที่ผมเคยวัด ถ้าจัดการผิด มันจะล้มแบบเงียบ ๆ ซึ่งเป็นวิธีที่แย่ที่สุดสำหรับ scraper
ลองใช้ Thunderbit เพื่อดึงข้อมูลเว็บ Get Started Free
คำถามที่พบบ่อย
chromedp มองเห็นเนื้อหาที่ JavaScript เรนเดอร์ได้จริงไหม?
ได้ — แต่ต้องมี wait ที่ผูกกับ node ที่คุณต้องการด้วย บน fixture ที่มีการฉีดลิงก์เข้ามาหลัง load event 800 ms, Navigate แล้วอ่านเลยพลาด และ WaitReady("body") ก็พลาดเหมือนกัน แต่ WaitVisible บน node นั้น และการ poll ด้วย JavaScript กลับเก็บมันได้ ทั้ง 3 รอบที่รัน ลอง sweep เวลาหน่วงดูแล้ว การอ่านแบบไม่รอพลาด node ตั้งแต่ค่า 100 ms ขึ้นไป การเรนเดอร์เป็นสิ่งจำเป็น แต่การรอให้ถูกคือสิ่งที่ทำให้มันพอ
WaitReady กับ WaitVisible ต่างกันยังไง?
WaitReady จะบล็อกจน node ถูกแนบเข้า DOM ส่วน WaitVisible จะบล็อกจนมันมองเห็นได้จริง บน node ที่แนบอยู่แต่ถูกตั้ง display: none, WaitReady กลับมาในราว 6 ms ในขณะที่ WaitVisible บล็อกจนถึง deadline 4 วินาทีแล้วคืน context deadline exceeded แบบสะอาด ๆ ไม่มีตัวไหน "เชื่อถือได้กว่า" กันจริง ๆ — พวกมันตอบคนละคำถาม และการเลือกผิดคือตัวดักที่แท้จริง
ผมจำเป็นต้องใช้ defer cancel() กับ chromedp จริงไหม?
บน macOS จำเป็น ต้อง cancel context และ allocator แล้ว Chrome ที่ถูกสตาร์ทจะถูกเก็บกลับภายใน 12–13 ms ทุกครั้ง แต่ถ้าออกจาก Go process โดยไม่ cancel จะเหลือ browser process ค้างเป็น orphan ทุกครั้งที่ทดสอบ 3/3 รอบ นี่เป็นพฤติกรรมที่รู้กันและขึ้นกับแพลตฟอร์ม — tracker ของ chromedp มีเอกสารรูปแบบ non-exit เดียวกันบนระบบที่ไม่ใช่ Linux และการฆ่าด้วย parent-death ที่รองรับเคสนี้อยู่ในซอร์สที่ใช้ build tag เฉพาะ Linux ผมไม่ได้ทดสอบ Linux ดังนั้นให้ถือว่าผล orphan นี้จำกัดอยู่ที่ macOS
chromedp ต้องติดตั้ง Chrome แยกต่างหากไหม?
ต้อง ตัว Go module เองเป็น pure Go ไม่มี cgo แต่เมื่อตอนรันมันต้องขับเบราว์เซอร์ภายนอก และถ้าไม่มี Chrome ก็ล้มทันที ผมระบุ Chrome for Testing 151.0.7922.10 headless shell ผ่าน chromedp.ExecPath โดยตรง ข้อดีคือค่า startup ต่ำ: cold cycle เต็มจนถึงผลจากสคริปต์แรกมีค่ากลาง 102 ms จาก 5 โปรเซสใหม่ โดยอยู่ในช่วง 98–111 ms
ควรใช้ browser ร่วมกันหลายแท็บ หรือแยก browser หลายตัวดี? ถ้าจุดประสงค์คือให้จำนวน browser process ต่ำที่สุด ให้ใช้ child context ดีกว่า การนำทาง localhost 4 ครั้งผ่าน browser ตัวเดียวใช้ Chrome browser process แค่ 1 ตัว ส่วนการแยก 4 browser ใช้ 4 ตัว เวลาโดยรวมก็เอนเอียงไปทางแบบแชร์ด้วย (214 ms เทียบกับ 264 ms median) แต่หน้า local ง่าย ๆ 4 หน้าไม่ใช่ benchmark ของ throughput อยู่แล้ว และไม่ได้วัด memory ด้วย ถ้าคุณต้องการ session isolation ที่เข้มกว่า, proxy ต่างกัน, หรืออยากลด blast radius ของ crash แบบแยกกัน browser หลายตัวก็ยังอาจเป็นคำตอบที่ถูก แต่ trade-off เหล่านั้นอยู่นอกการทดสอบนี้




