
ทุก ๆ ไม่กี่เดือน จะมีคนบน Reddit โพสต์บ่นแนวเดิมซ้ำ ๆ ว่า: "ฉันเอา Yellow Pages ไปสแครปได้ข้อมูลมา 500 แถว ทั้งเบอร์โทรและที่อยู่… แต่อีเมลเป็นศูนย์" นี่คือปัญหาที่ผมเจอบ่อยที่สุดในคอมมูนิตี้สาย lead generation และหลังจากทำเครื่องมืออัตโนมัติมาหลายปีที่ Thunderbit ผมบอกได้เลยว่าเรื่องนี้เกิดจากโครงสร้างของหน้าเว็บ ไม่ใช่เรื่องบังเอิญ
Scraper ส่วนใหญ่ของ Yellow Pages จะดึงได้แค่ข้อมูลที่เห็นอยู่บนหน้าผลการค้นหา — ชื่อธุรกิจ เบอร์โทร ที่อยู่ และบางครั้งก็ลิงก์เว็บไซต์ แต่เรื่องอีเมลนั้น แทบไม่เคยโผล่อยู่บนการ์ดรายการหลัก มักจะซ่อนอยู่ในหน้าโปรไฟล์ธุรกิจแต่ละรายการ หรือบางทีก็ไม่มีอยู่ใน Yellow Pages เลยด้วยซ้ำ
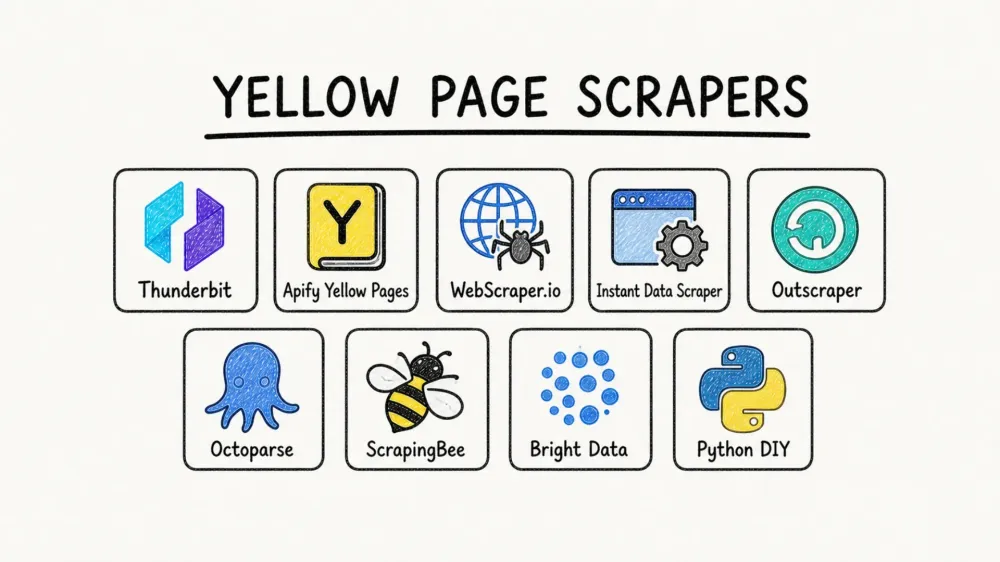
ดังนั้นถ้าเครื่องมือของคุณไม่เข้าไปดูหน้าย่อยพวกนั้น คุณก็พลาดข้อมูลติดต่อที่มีค่าที่สุดไปเต็ม ๆ บทความนี้จะแนะนำ 9 เครื่องมือที่ผมค้นคว้าและประเมินมา โดยโฟกัสว่ามันดึงอีเมลจาก Yellow Pages ได้จริงไหม — ไม่ใช่แค่เบอร์โทรกับรหัสไปรษณีย์ นอกจากนี้ผมจะพูดถึงความสามารถในการรับมือกับบอท ราคา และเครื่องมือไหนเหมาะกับผู้ใช้แบบใด
ทำไม Yellow Page Scraper ส่วนใหญ่ถึงดึงอีเมลไม่เจอ
ก่อนจะไปดูตัวเครื่องมือ เราควรเข้าใจสาเหตุของปัญหานี้ก่อน
หน้ารายการของ Yellow Pages ถูกออกแบบมาเพื่อโชว์เบอร์โทร ที่อยู่ เวลาทำการ และลิงก์เว็บไซต์เป็นหลัก อีเมลไม่ใช่ฟิลด์มาตรฐานบนการ์ดผลการค้นหา เอกสารและตัวอย่างการใช้งานของ scraper หลายแห่งก็ยืนยันตรงกันว่า: อีเมลมักไม่ปรากฏบนการ์ดรายการ และต้องไปหาในหน้าโปรไฟล์ธุรกิจแต่ละราย หรือบนเว็บไซต์ของธุรกิจนั้นเอง
ParseBird Yellow Pages Scraper ของ Apify อธิบายเรื่องนี้ได้ชัดเจนกว่าที่อื่น โดยแยก "listing mode" ออกจาก "detail mode" และระบุว่า อัตราการเจออีเมลโดยทั่วไปอยู่ที่เพียง 15–25% ของรายการ แม้จะเปิดใช้การดึงข้อมูลจากหน้า detail แล้วก็ตาม นั่นหมายความว่าแม้ในกรณีที่ดีที่สุด การกู้คืนอีเมลจาก Yellow Pages ก็ยังได้ไม่มากนัก — และเครื่องมือส่วนใหญ่ก็ไม่ได้พยายามทำถึงขั้นนั้นเลย
ความล้มเหลวที่พบบ่อยมีอยู่ 3 แบบ:
- Scraper อ่านแค่หน้าผลการค้นหา ไม่มีการเข้า subpage ก็ไม่มีอีเมล
- Scraper เข้า detail page แต่ไม่ได้ parse ฟิลด์อีเมล ก็ยังไม่ได้อีเมลอยู่ดี
- ธุรกิจนั้นไม่เคยลงอีเมลบน Yellow Pages ตั้งแต่แรก ไม่มีเครื่องมือไหนดึงข้อมูลที่ไม่มีอยู่จริงได้
อีกกรณีหนึ่งคือบางธุรกิจใช้ฟอร์มติดต่อ หรือปุ่ม "Email Business" แทนการแสดงอีเมลแบบตัวอักษรตรง ๆ ดังนั้น scraper อาจทำงานได้ตามปกติ แต่ผลลัพธ์ที่ได้ยังเป็นข้อมูลเบอร์โทรกับที่อยู่เกือบทั้งหมด
สรุปคือ ถ้าคุณให้ความสำคัญกับการดึงอีเมล ฟีเจอร์ที่ต้องมีคือ subpage scraping — ความสามารถในการเข้าไปดู detail page ของแต่ละธุรกิจและดึงข้อมูลที่ไม่ได้แสดงบนหน้ารายการหลัก
วิธีเลือก Yellow Page Scraper ที่ดีที่สุด
ผมประเมินทั้ง 9 เครื่องมือตาม 7 เกณฑ์ โดยอิงจาก pain point จริง ๆ ที่เจอในกระทู้ Reddit ฟอรัมสาย scraping และคอมมูนิตี้ lead gen
ความน่าเชื่อถือในการดึงอีเมล
นี่คือเหตุผลหลักที่บทความนี้มีอยู่เลย เครื่องมือดึงอีเมลได้จริงไหม หรือแค่ชื่อกับเบอร์โทร? ความสามารถสำคัญคือ subpage scraping — เข้าไปยังหน้าโปรไฟล์ของแต่ละธุรกิจเพื่อหาอีเมลที่ซ่อนอยู่จากการ์ดรายการ
การรับมือกับบอทและการบล็อก
Yellow Pages ใช้ Cloudflare Bot Management รวมถึงข้อกำหนดเรื่อง JavaScript rendering, browser fingerprinting, rate limiting และ CAPTCHA จากการทดสอบแบบ live ที่ผมลองเมื่อวันที่ 27 เมษายน 2026 คำขอแรกก็ถูกบล็อกด้วยหน้า Cloudflare ทันทีภายในไม่กี่วินาที เครื่องมือที่รับมือเรื่องนี้ไม่ได้ตั้งแต่ต้นจะทำให้คุณเจอแต่หน้า error
ราคาและแผนฟรี
ผู้ใช้ Reddit หลายคนถามตรง ๆ ว่าอยากได้ "free or cheap scrapers ideally." ตลาดนี้แบ่งค่อนข้างชัดระหว่าง extension ฟรีบนเบราว์เซอร์, cloud tools ที่ให้เครดิตเริ่มต้น และแพลตฟอร์มระดับองค์กรที่คิดราคาตามดีล
การรองรับ Pagination
Yellow Pages แสดงผลราว 30 รายการต่อหน้า และคำค้นกว้าง ๆ อาจให้ผล 500–2,000+ รายการ ถ้า scraper ไม่มี auto-pagination ก็จะดึงข้อมูลได้แค่เศษเสี้ยวเดียว
รูปแบบการส่งออกข้อมูล
ทีมขายต้องการไฟล์ที่พร้อมใช้กับ CRM เช่น CSV, Excel, Google Sheets, Airtable บางเครื่องมือส่งออกได้แค่ JSON หรือ raw HTML ซึ่งต้องนำไปประมวลผลต่อก่อนจะใช้งานได้
ระดับทักษะที่ต้องใช้
กลุ่มผู้ใช้มีทั้งฝ่ายขายกับเจ้าของเอเจนซีที่อยากได้เครื่องมือคลิกไม่กี่ครั้ง และนักพัฒนาที่ต้องการ API กับความยืดหยุ่นแบบ Python ผมจึงให้คะแนนแต่ละเครื่องมือจาก Beginner ถึง Expert
Lead Scoring และ Data Enrichment
อย่างที่ผู้ใช้ Reddit คนหนึ่งพูดไว้ว่า "raw data without scoring is just a spreadsheet." เครื่องมือที่ติดป้าย กำหนดหมวดหมู่ หรือเพิ่มข้อมูลระหว่างการสแครปได้ จะช่วยประหยัดเวลาหลังบ้านไปได้มาก
ภาพรวม Yellow Page Scraper ที่ดีที่สุด
ด้านล่างคือการเปรียบเทียบครบทั้ง 9 เครื่องมือ ดูสัญลักษณ์สั้น ๆ ก่อน: ✅ หมายถึงเครื่องมือนั้นทำได้ดีตั้งแต่แกะกล่อง, ⚠️ หมายถึงทำได้แต่ต้องตั้งค่าเพิ่มหรือมีข้อจำกัด, และ ❌ หมายถึงไม่มีฟังก์ชันนั้นมาให้โดยตรง
| Tool | Type | Free Tier | Emails? | Anti-Bot | Pagination | Skill Level | Export Formats | Best For |
|---|---|---|---|---|---|---|---|---|
| Thunderbit | Chrome ext. + cloud | ✅ (6 pages/mo) | ✅ (subpage + email extractor) | ✅ Cloud/browser toggle | ✅ Auto | Beginner | Excel, CSV, JSON, Sheets, Airtable, Notion | ทีมขายและ ops ที่ไม่ใช่สายเทคนิค |
| Apify YP Scraper | Cloud actor | ✅ ($5 credits) | ⚠️ 15–25% with detail pages | ✅ Proxy pool | ✅ Built-in | Intermediate | JSON, CSV, Excel, XML | สแครปบนคลาวด์ขนาดใหญ่ |
| WebScraper.io | Chrome ext. + cloud | ✅ (free ext.) | ⚠️ Manual config | ✅ Cloud plans | ✅ Selector-based | Intermediate | CSV, XLSX, JSON, Sheets | คนที่ชอบ visual scraper |
| Instant Data Scraper | Chrome ext. | ✅ Fully free | ❌ Unreliable | ❌ None | ⚠️ Manual | Beginner | CSV, XLSX | สแครปเร็ว ๆ แบบครั้งเดียว |
| Outscraper | API/Cloud | ✅ (500 businesses) | ⚠️ Enrichment needed | ✅ Managed | ✅ Auto | Beginner–Intermediate | CSV, JSON, XLSX | งาน directory แบบประหยัดงบ |
| Octoparse | Desktop app + cloud | ✅ (10 tasks, 50K/mo) | ⚠️ Template-based | ✅ Built-in | ✅ Auto-detect | Intermediate | CSV, Excel, JSON, DBs | สแครปแบบ visual บนเดสก์ท็อป |
| ScrapingBee | API | ✅ (1,000 calls) | ❌ Raw HTML only | ✅ Managed proxies | ❌ Manual | Advanced | JSON, HTML | นักพัฒนาที่ต้องการ HTML ที่เรนเดอร์แล้ว |
| Bright Data | Platform | ✅ (5K records/mo) | ✅ Data products | ✅ Enterprise-grade | ✅ Built-in | Advanced | JSON, CSV, NDJSON, S3, more | งานระดับองค์กร |
| Python DIY | Code | ✅ Free (OSS) | ⚠️ Manual parsing | ❌ Self-managed | ❌ Manual | Expert | Any | วิศวกรที่ต้องการความเฉพาะทาง |
1. Thunderbit — Yellow Page Scraper ที่ดีที่สุดสำหรับทีมที่ไม่ใช่สายเทคนิค

ลองใช้ Thunderbit สำหรับสแครป Yellow Pages
Thunderbit คือ Chrome extension ที่ขับเคลื่อนด้วย AI ซึ่งผมกับทีมพัฒนาขึ้นมาเพื่อทำให้การสแครปเว็บเป็นเรื่องที่คนทั่วไปที่ไม่ใช่นักพัฒนาก็ใช้ได้ แทนที่จะต้องตั้งค่า CSS selector หรือเขียนโค้ด คุณแค่คลิกครั้งเดียว แล้ว AI จะอ่านหน้าเว็บ วิเคราะห์ว่ามีข้อมูลอะไรให้ดึงได้บ้าง และดึงออกมาให้เลย หรือถ้าคุณรู้แล้วว่าต้องการอะไร ก็พิมพ์บอก AI ตรง ๆ แล้วให้มันทำตามคำสั่งนั้นได้เช่นกัน แค่นี้ — คลิกเดียวก็ได้ข้อมูลแบบมีโครงสร้าง
สำหรับ Yellow Pages โดยเฉพาะ เวิร์กโฟลว์นี้แก้ปัญหาเรื่องอีเมลได้ตรงจุด หลังจากสแครปหน้ารายการแล้ว คุณสามารถขยายการสแครปไปยัง subpage เพื่อให้ Thunderbit เข้าไปดู detail page ของแต่ละธุรกิจและหาอีเมล URL เว็บไซต์ เวลาทำการ รีวิว และฟิลด์อื่น ๆ ที่ไม่แสดงบนการ์ดรายการหลัก นอกจากนี้เรายังสร้าง Email Extractor และ Phone Number Extractor แบบเครื่องมือแยกเดี่ยวไว้ด้วย เพื่อให้คุณใช้คลิกเดียวบนหน้าเว็บใดก็ได้
Thunderbit รับมือการดึงอีเมลจาก Yellow Pages อย่างไร
จุดต่างหลักคือ subpage scraping Scraper ส่วนใหญ่หยุดแค่หน้าผลการค้นหาแล้วคืนข้อมูลที่มองเห็นได้ ซึ่งสำหรับ Yellow Pages นั่นแปลว่าไม่มีอีเมล Thunderbit ใช้ฟีเจอร์ subpage เข้าไปยังโปรไฟล์ของแต่ละธุรกิจแล้วดึงข้อมูลจากชั้นลึกนั้นออกมาได้ คุณยังใช้ Field AI Prompt เพื่อเพิ่มคำสั่งอย่าง "ดึงอีเมลจากส่วน contact" หรือ "ทำเครื่องหมายธุรกิจที่ไม่มีเว็บไซต์" เพื่อเพิ่มความแม่นยำและใส่บริบทระหว่างการสแครปได้
จากโครงสร้างหน้าเว็บและเอกสาร scraper ในปัจจุบัน อีเมลบนการ์ดรายการของ Yellow Pages แทบเป็นศูนย์อยู่แล้ว ดังนั้น detail-page scraper อย่างฟีเจอร์ subpage ของ Thunderbit จึงกู้คืนอีเมลได้ราว 15–25% ของธุรกิจ ซึ่งเป็นเพดานที่สมจริงสำหรับการดึงอีเมลจาก Yellow Pages ในปี 2026 และนี่ไม่ใช่ข้อจำกัดของ Thunderbit แต่เป็นข้อจำกัดของข้อมูลใน Yellow Pages เอง
การรับมือกับบอทและ Pagination
Thunderbit มีโหมดสแครป 2 แบบ: cloud scraping (วิ่งผ่านเซิร์ฟเวอร์ US/EU/Asia พร้อมหมุน proxy อัตโนมัติ) และ browser scraping (ใช้ session เบราว์เซอร์บนเครื่องของคุณ) ถ้าโหมดคลาวด์โดน Cloudflare บล็อก คุณสามารถสลับไปใช้ browser mode เป็นทางสำรองได้ — session ที่ล็อกอินอยู่ของคุณมักจะช่วยผ่านการป้องกันบางส่วนที่บล็อกคำขอจาก cloud แบบ headless
Pagination ทำงานอัตโนมัติเต็มรูปแบบ Thunderbit รองรับทั้งปุ่ม "Next" แบบคลิกไปทีละหน้าและ infinite scroll โดยไม่ต้องตั้งค่าอะไรเพิ่ม
ราคาและการส่งออกข้อมูล
- แผนฟรี: 6 หน้า/เดือน
- ทดลองใช้ฟรี: 10 หน้า
- Starter plan: เริ่มราว ~$9/เดือนเมื่อจ่ายรายปี สำหรับ 500 credits (1 credit = 1 แถว)
- Export: Excel, CSV, JSON ใช้ได้ในแผนฟรี; Google Sheets, Airtable และ Notion ใช้ได้ในแผนเสียเงิน
คุณตรวจสอบรายละเอียดล่าสุดได้ที่ หน้าราคา
เหมาะที่สุดสำหรับ: ฝ่ายขาย เอเจนซี และทีม ops ที่ต้องการข้อมูลลีดอย่างรวดเร็วโดยไม่ต้องเขียนโค้ดหรือจัดการ proxy เอง
2. Apify Yellow Pages Scraper — ดีที่สุดสำหรับการสแครปบนคลาวด์ในระดับขยายใหญ่
 Apify คือแพลตฟอร์มสแครปแบบคลาวด์ที่มี marketplace ของ actor สำเร็จรูปจำนวนมาก — รวมถึงหลายตัวที่ทำมาเพื่อ Yellow Pages โดยเฉพาะ คุณตั้งค่าการสแครปใน Apify console (คำค้น ตำแหน่ง จำนวนผลลัพธ์) แล้วระบบจะรันบนคลาวด์ โดยไม่ต้องใช้เบราว์เซอร์หรือเครื่องของคุณ
ParseBird Yellow Pages actor เป็นตัวที่อธิบายเรื่องการดึงอีเมลได้ตรงไปตรงมาที่สุดเท่าที่ผมเจอ มันแยก listing mode ออกจาก detail mode อย่างชัดเจน และระบุว่าอัตราการได้อีเมลโดยทั่วไปอยู่ที่ 15–25% ของรายการ เมื่อเปิดการดึง detail page แล้ว การสแครปแบบ detail mode มีต้นทุนประมาณ $6 ต่อ 1,000 ธุรกิจ เทียบกับ $1 ต่อ 1,000 ใน listing mode ซึ่งสะท้อนต้นทุนคอมพิวต์ที่เพิ่มขึ้นจากการต้องเข้า subpage ของแต่ละรายการ
- มี proxy pool ให้พร้อม พร้อมรองรับ residential proxy
- มี built-in pagination สำหรับชุดผลลัพธ์หลายหน้า
- Export: JSON, CSV, Excel, XML, HTML, RSS, JSONL
- ราคา: แผนฟรีพร้อม เครดิต $5; แผนเสียเงิน $29, $199 และ $999/เดือน
เหมาะที่สุดสำหรับ: ผู้ใช้ระดับกลางถึงขั้นสูงที่ทำแคมเปญ lead gen ขนาดใหญ่หลายเมืองหรือหลายหมวดหมู่
3. WebScraper.io — ดีที่สุดสำหรับการสร้าง sitemap แบบกำหนดเองของ Yellow Pages
 WebScraper.io มี Chrome extension พร้อมตัวช่วยสร้าง "Sitemap Wizard" แบบ visual ที่ตรวจจับโครงสร้างรายการบน Yellow Pages ได้อัตโนมัติ นี่คือเครื่องมือเบื้องหลังหนึ่งในบทแนะนำสแครป Yellow Pages ที่ติดอันดับต้น ๆ และก็มีเหตุผล — เพราะมันให้คุณควบคุมได้ละเอียดว่าจะดึงอะไรและดึงอย่างไร
แต่ข้อแลกเปลี่ยนคือ ถ้าอยากได้ความยืดหยุ่น คุณต้องตั้งค่าเอง การดึงอีเมลไม่ได้ทำให้อัตโนมัติ คุณต้อง ตั้ง selectors ด้วยตัวเอง เพื่อชี้ไปยังฟิลด์อีเมล และกำหนดให้ scraper ตามลิงก์ไปยัง detail page ของธุรกิจ ถ้าตั้งดี มันก็ใช้งานได้ แต่ถ้าตั้งไม่ดี คุณก็จะได้ผลลัพธ์แบบเบอร์โทรกับที่อยู่เหมือนเครื่องมืออื่น ๆ
โน้ตใน marketplace ของ WebScraper.io ก็ซื่อสัตย์เกินคาดเกี่ยวกับการป้องกันของ Yellow Pages โดยระบุชัดถึง Cloudflare bot management, JavaScript rendering requirements และ browser fingerprinting ว่าเป็นอุปสรรคที่เจอจริง
- Pagination: จัดการผ่าน การตั้งค่า selector สำหรับปุ่ม "Next"
- Export: CSV, XLSX, JSON; เวอร์ชัน cloud เพิ่ม Google Sheets, Dropbox, S3, Azure, API และ webhooks
- ราคา: Chrome extension ฟรี; แผนคลาวด์เริ่มที่ 50 ดอลลาร์/เดือน
เหมาะที่สุดสำหรับ: ผู้ใช้ที่คุ้นกับเครื่องมือแบบ point-and-click และอยากปรับแต่งโครงสร้างการสแครปได้ตามต้องการ
4. Instant Data Scraper — Yellow Page Scraper ฟรีที่น่าใช้ที่สุด (แต่มีข้อจำกัด)
 Instant Data Scraper คือคำตอบสำหรับคำถามว่า "มีอะไรให้ลองฟรีเดี๋ยวนี้ได้บ้าง?" มันเป็น Chrome extension ที่ใช้ฟรีแบบเต็มรูปแบบ — ไม่ต้องสมัครบัญชี ไม่ต้องมีเครดิต ไม่มีลิมิต — และตรวจจับข้อมูลแบบตารางบนหน้าเว็บได้อัตโนมัติ เปิดหน้าผลลัพธ์ของ Yellow Pages กดไอคอน extension แล้วมันก็จะจับข้อมูลรายการให้
ปัญหาคือสิ่งที่มันทำไม่ได้ มันดึงเฉพาะข้อมูลที่มองเห็นบนหน้า จึงไม่มีการเข้า subpage และส่วนใหญ่จะดึงอีเมลไม่ได้ใน workflow จริง นอกจากนี้มัน ไม่มีการรับมือกับ anti-bot ถ้า Yellow Pages ส่ง CAPTCHA หรือบล็อก IP ของคุณ คุณก็ไปต่อไม่ได้ การรองรับ pagination ก็พื้นฐานมาก — บางครั้งต้องกด "Next" เอง หรือหวังพึ่ง auto-scroll แบบจำกัด
- Export: CSV, XLSX
- ราคา: ฟรีตลอดไป
เหมาะที่สุดสำหรับ: มือใหม่ที่อยากสแครปหน้าผลลัพธ์หน้าเดียวแบบเร็ว ๆ ฟรี ๆ และไม่ต้องใช้อีเมล ไม่เหมาะกับแคมเปญที่โฟกัสอีเมลหรือ lead gen ขนาดใหญ่
5. Outscraper — API แบบจัดการให้ดีที่สุดสำหรับ Yellow Pages และ Google Maps
 Outscraper คือแพลตฟอร์มบนคลาวด์/API ที่มีโครงสร้างพื้นฐานพร้อมจัดการให้สำหรับการสแครป directory อย่าง Yellow Pages และ Google Maps จุดขายคือความง่าย: คุณไม่ต้องดูแล proxies, logic รับมือบอท หรือ pagination เอง
สำหรับ Yellow Pages, 500 ธุรกิจแรกใช้ฟรี จากนั้นราคาประมาณ $1 ต่อ 1,000 ธุรกิจ การดึงอีเมลจาก Yellow Pages เองจะจำกัดเฉพาะสิ่งที่มีอยู่ในหน้าเว็บ ส่วนการ enrich อีเมลเชิงลึก Outscraper มี ฟีเจอร์ enrichment แยกต่างหาก ที่นำมาใช้ร่วมกับการสแครปพื้นฐานได้
จุดที่ Outscraper เด่นคือการรองรับหลาย directory ถ้าคุณสแครป Yellow Pages กับ Google Maps ในแคมเปญเดียวกัน คุณสามารถใช้แพลตฟอร์มเดียวจบ
- มี auto-pagination ให้
- Export: CSV, JSON, XLSX, API
- ราคา: แผนฟรี (500 ธุรกิจ); เกินจากนั้นคิดแบบจ่ายตามผลลัพธ์
เหมาะที่สุดสำหรับ: ทีม sales ops ที่ต้องการสแครปแบบเชื่อถือได้ ไม่ต้องลงแรงดูแล infrastructure เอง และอาจต้องใช้หลาย directory
6. Octoparse — เดสก์ท็อปแอปที่ดีที่สุดสำหรับการสแครป Yellow Pages แบบ visual
 Octoparse เป็นโปรแกรมเดสก์ท็อป (Windows/Mac) ที่มี workflow builder แบบ visual ให้ลาก-คลิกใช้งานได้ มันมีเทมเพลตสำเร็จรูปสำหรับ Yellow Pages และเว็บ directory คล้ายกัน พร้อมฟีเจอร์ anti-bot ในตัว เช่น การหมุน IP, residential proxy และการแก้ CAPTCHA อัตโนมัติ
การดึงอีเมลขึ้นอยู่กับเทมเพลต ถ้าเทมเพลตถูกตั้งให้เข้า detail page ของธุรกิจหรือเว็บไซต์ที่ลิงก์ไว้ ก็สามารถดึงอีเมลได้ แต่เทมเพลตอาจพังเมื่อ Yellow Pages ปรับ layout และผู้ใช้รายงานผลลัพธ์ที่ต่างกันไปตามหมวดหมู่และพื้นที่
- แผนฟรี: 10 tasks, ส่งออกได้ 50,000 ครั้งต่อเดือน
- ตรวจจับ pagination อัตโนมัติ
- Export: CSV, Excel, JSON, HTML, XML, databases, Google Sheets, API
- ราคา: มีแผนฟรี; แผนเสียเงินสำหรับการรันบนคลาวด์
เหมาะที่สุดสำหรับ: ผู้ใช้ระดับกลางที่ชอบแอปเดสก์ท็อปพร้อม workflow builder แบบ visual และไม่ติดเรื่องต้องจูนเทมเพลตบ้าง
7. ScrapingBee — API ที่ดีที่สุดสำหรับนักพัฒนาที่ต้องการ HTML ที่เรนเดอร์แล้ว
 ScrapingBee เป็นบริการสแครปเว็บแบบ API-first มันจัดการ JavaScript rendering, proxy rotation และ CAPTCHA solving แล้วคืนค่าเป็น raw HTML, JSON หรือ Markdown แต่ไม่ได้ดึงอีเมลหรือฟิลด์แบบมีโครงสร้างมาให้โดยอัตโนมัติ คุณต้องทำส่วนนี้เอง
บทแนะนำ Yellow Pages ของ ScrapingBee เอง แสดงการแบ่งหน้าแบบ manual ด้วยการต่อ &page=n เข้าไปใน URL ซึ่งยิ่งตอกย้ำว่านี่คือเครื่องมือสำหรับนักพัฒนา ไม่ใช่โซลูชันแบบคลิกใช้งาน
- แผนฟรี: 1,000 API credits
- ไม่มี built-in pagination หรือ field extraction
- Export: JSON, HTML
- ราคา: เริ่มที่ $49/เดือน
เหมาะที่สุดสำหรับ: นักพัฒนาที่ต้องการ HTML ที่เรนเดอร์แล้วอย่างเสถียร พร้อมการรับมือบอท และยินดีเขียน parsing logic เอง
8. Bright Data — แพลตฟอร์มระดับองค์กรที่ดีที่สุดสำหรับการสแครปขนาดใหญ่
 Bright Data ดูแลเครือข่าย proxy ที่ใหญ่ที่สุดในอุตสาหกรรม และมีชุดเครื่องมือสแครปครบถ้วน ทั้ง scraping APIs, browser tools และชุดข้อมูลสำเร็จรูป มันถูกสร้างมาเพื่อองค์กรที่ต้องการเก็บข้อมูลขนาดใหญ่พร้อมความสามารถด้าน compliance
สำหรับ Yellow Pages โดยเฉพาะ จุดแข็งของ Bright Data คือ infrastructure — residential proxies, CAPTCHA solving, browser fingerprinting defense และการส่งต่อข้อมูลไปยัง JSON, CSV, NDJSON, S3, Snowflake, GCS, Azure และ SFTP ผมไม่พบเทมเพลต Yellow Pages เฉพาะที่มีเอกสารอยู่ในปัจจุบัน ดังนั้นตำแหน่งของเครื่องมือนี้จึงเป็นแพลตฟอร์มระดับองค์กร ไม่ใช่ product สำหรับดึงอีเมลจาก YP โดยเฉพาะ
- ราคา: Web Scraper API มี แผนฟรี 5,000 records/เดือน จากนั้น $1.50 ต่อ 1K records แบบ pay-as-you-go; และ $499/เดือนเมื่อใช้งานในสเกลใหญ่
- มี built-in pagination สำหรับเครื่องมือสแครปทั้งหมด
เหมาะที่สุดสำหรับ: องค์กรใหญ่หรือเอเจนซีที่มีงบข้อมูลสูงและต้องการสเกล ความสอดคล้องด้าน compliance และโครงสร้าง proxy
9. Python DIY (BeautifulSoup + Playwright) — ดีที่สุดสำหรับคนที่ต้องการควบคุมทุกอย่างเอง
 นี่คือแนวทางโอเพนซอร์ส: ใช้ BeautifulSoup สำหรับ parse HTML และ Playwright สำหรับ automation ผ่านเบราว์เซอร์ เป็นไลบรารีฟรีที่ยืดหยุ่นสูงสุด แต่ก็มีระดับความยากทางเทคนิคสูงที่สุดในลิสต์นี้
การดึงอีเมลต้องเขียน logic เองเพื่อเข้าไปยัง detail page ของแต่ละธุรกิจและหา field อีเมล การหมุน proxy, การจัดการ CAPTCHA, rate limiting และ pagination ต้องสร้างเองหรือซื้อแยกต่างหาก อย่างที่ผู้ใช้ Reddit คนหนึ่งพูดไว้ว่า: "Once you try Playwright, you will never go back to Selenium" — แต่คุณก็จะยังต้องไล่แก้ปัญหา proxy setup ต่อไปเหมือนเดิม
- ราคา: ฟรี (ไลบรารีโอเพนซอร์ส); ค่า infrastructure คิดแยก
- Export: ได้ทุกฟอร์แมตที่คุณเขียนโค้ดรองรับ
- ไม่มีฟังก์ชันสำเร็จรูปใด ๆ — คุณต้องสร้างทุกชิ้นเอง
เหมาะที่สุดสำหรับ: นักพัฒนาระดับ expert ที่มีข้อกำหนดเฉพาะมาก ๆ และไม่มีเครื่องมือสำเร็จรูปตัวไหนตอบโจทย์ พร้อมดูแลทุกอย่างตั้งแต่ต้นจนจบ
เมื่อ Yellow Pages บล็อกคุณจริง ๆ จะเกิดอะไรขึ้น (เช็กความจริงเรื่อง Anti-Bot)
ผมอยากหยุดพูดเรื่องนี้สักครู่ เพราะมันคือ pain point อันดับ 1 จากจำนวนการถูกพูดถึง ในคอมมูนิตี้สาย scraping และบทความส่วนใหญ่ก็มักพูดผ่าน ๆ แค่ว่า "ใช้ proxy สิ"
ตอนที่ผมทดสอบการยิง request แบบสคริปต์พื้นฐานไปยัง URL ค้นหาของ Yellow Pages เมื่อวันที่ 27 เมษายน 2026 ผลลัพธ์ที่กลับมาคือหน้า Cloudflare block: "Sorry, you have been blocked. This website is using a security service to protect itself from online attacks." และเกิดขึ้นตั้งแต่ request แรก ไม่มีเตือน ไม่มี throttle แบบค่อยเป็นค่อยไป — มีแค่กำแพงทันที
ชุดป้องกันบอทของ Yellow Pages ประกอบด้วย Cloudflare Bot Management, ข้อกำหนดด้าน JavaScript rendering, browser fingerprinting, rate limiting และ reCAPTCHA คู่มือสแครปของ IPRoyal ยังเสริมอีกว่าความผิดปกติที่เจออาจมีตั้งแต่การบล็อกแบบแข็ง, soft ban, CAPTCHA, redirect ไป splash page, session tracking ไปจนถึง rate limit
เมื่อดูบริบทกว้างขึ้น สถานการณ์นี้ไม่ได้ดีขึ้นเลย รายงานปี 2025 ของ Imperva พบว่า automated traffic คิดเป็น 51% ของทราฟฟิกอินเทอร์เน็ตทั้งหมด ในปี 2024 และรายงานปี 2025 ของ DataDome ที่ครอบคลุมเกือบ 17,000 เว็บไซต์ พบว่ามีเพียง 2.8% ที่ได้รับการป้องกันอย่างสมบูรณ์ เว็บไซต์อย่าง Yellow Pages ที่ลงทุนด้านการป้องกันจริงจัง กำลังเก่งขึ้นเรื่อย ๆ ในการจับ scraper ไม่ใช่แย่ลง
ภาพรวมการรับมือของแต่ละเครื่องมือเป็นแบบนี้:
| Tool | Proxy Rotation | CAPTCHA Handling | Rate-Limit Resilience | Fallback When Blocked |
|---|---|---|---|---|
| Thunderbit | ✅ Cloud mode with US/EU/Asia servers | ✅ Managed via cloud | ✅ Auto-throttle | Switch to browser scraping |
| Apify | ✅ Including residential proxies | ✅ Via actor/browser infra | ✅ Configurable | Retry with new proxy |
| WebScraper.io | ✅ Cloud plans + proxy add-on | ✅ Cloud plans | ✅ Strong | Use cloud execution |
| Instant Data Scraper | ❌ None | ❌ None | ❌ Weak | Manual retry or stop |
| Outscraper | ✅ Managed backend | ⚠️ Limited documentation | ✅ Moderate | Managed service handles it |
| Octoparse | ✅ Including residential | ✅ Automatic CAPTCHA solving | ✅ Strong | Cloud templates + anti-block |
| ScrapingBee | ✅ Managed proxies | ✅ Built-in | ✅ Strong | Tune code, premium proxies |
| Bright Data | ✅ Enterprise-grade | ✅ Built-in | ✅ Very strong | Full infra tuning |
| Python DIY | ❌ Self-managed only | ❌ Self-managed only | ❌ Variable | Whatever you build |
ไม่ใช่แค่ข้อมูลดิบ: เปลี่ยนข้อมูล Yellow Pages ให้กลายเป็นลีดพร้อมใช้ใน CRM
แพตเทิร์นที่ผมเห็นบ่อยมากคือ: มีคนสแครป Yellow Pages มา 500 รายการ เอาออกเป็นสเปรดชีต แล้วต้องเสียเวลาอีก 3 ชั่วโมงไปไล่ค้นใน Google ทีละธุรกิจเพื่อหาอีเมล เช็กเว็บไซต์ และดูว่าอันไหนน่าติดต่อจริง การสแครปใช้เวลา 10 นาที แต่การ enrich ข้อมูลกินทั้งบ่าย
นี่คือที่มาของคำบ่นว่า "raw data without scoring is just a spreadsheet." การ export ดิบจาก Yellow Pages จะหน้าตาประมาณนี้:
| Business Name | Phone | Address | Website | Category |
|---|---|---|---|---|
| Example Plumbing Co. | 555-0199 | 123 Main St | exampleplumbing.com | Plumbers |
| NoSite HVAC | 555-0112 | 456 Oak Ave | None | HVAC |
แต่ตารางลีดที่ enrich แล้ว — แบบที่เอาไปใช้ติดต่อจริงได้ — จะประมาณนี้:
| Business Name | Phone | Address | Website | Reviews | Has Website? | Prospect Note | |
|---|---|---|---|---|---|---|---|
| Example Plumbing Co. | 555-0199 | 123 Main St | exampleplumbing.com | info@exampleplumbing.com | 42 | Yes | มีหน้า contact |
| NoSite HVAC | 555-0112 | 456 Oak Ave | None | None | 8 | No | น่าจะเป็นโปรเจกต์ที่เอเจนซีสนใจได้ |
ใช้ Subpage Scraping เพื่อเพิ่มข้อมูลให้ลีด
Subpage scraping ของ Thunderbit จะเข้าไปยัง detail page ของแต่ละธุรกิจแล้วเติมฟิลด์อย่างอีเมล, URL เว็บไซต์, เวลาทำการ, รีวิว และหมวดหมู่ ให้ครบ สำหรับงานสแครป 500 รายการ ความต่างคือจากงานอัตโนมัติ 10 นาที ไปเป็นงานค้นคว้ามืออีก 3 ชั่วโมงขึ้นไป
Apify แบบ detail-mode ก็ทำอะไรคล้ายกัน แต่มีต้นทุนต่อเรคอร์ดสูงกว่า (ราว $6 ต่อ 1,000 ธุรกิจ เทียบกับ $1 ต่อ 1,000 ใน listing mode)
ติดป้ายและจัดหมวดลีดระหว่างการสแครป
Field AI Prompt ของ Thunderbit ช่วยให้คุณใส่คำสั่งระหว่างสแครปได้ เช่น "ทำเครื่องหมายธุรกิจที่ไม่มีเว็บไซต์" หรือ "จัดหมวดตามขนาดธุรกิจ" AI จะประมวลผลป้ายเหล่านี้ไปพร้อมกับการดึงข้อมูล ทำให้คุณได้รายชื่อที่คัดกรองเบื้องต้นแล้ว แทนที่จะเป็นข้อมูลดิบล้วน ๆ
ข้อควรระวังจากงานวิจัยที่น่าจดไว้คือ การไม่มีเว็บไซต์ไม่ได้แปลว่าธุรกิจนั้นเป็น prospect ที่ดีเสมอไป มันเป็นสัญญาณที่มีประโยชน์สำหรับ outreach ของเอเจนซี แต่ไม่ควรใช้เป็นเกณฑ์คัดเลือกเพียงอย่างเดียว
เวิร์กโฟลว์ Export ไปยัง CRM
เวิร์กโฟลว์ที่ผมเห็นบ่อยที่สุดจากผู้ใช้ของเราคือ:
- Thunderbit → Google Sheets หรือ Airtable → CRM (export ตรง ไม่ต้องผ่านขั้นกลาง)
- Apify → Webhook → CRM (ต้องตั้งค่าบางส่วน)
- Outscraper → ดาวน์โหลด CSV → นำเข้า CRM (ทำมือแต่ตรงไปตรงมา)
ถ้า CRM ของคุณเชื่อมกับ Google Sheets หรือ Airtable ได้ การ export ตรงของ Thunderbit จะตัดขั้นตอนดาวน์โหลดไฟล์ออกไปได้ทั้งหมด คุณอ่านเพิ่มเติมเกี่ยวกับ web scraping without coding ได้ในบล็อกของเรา
Yellow Page Scraper ที่เหมาะที่สุดตาม Use Case: คู่มือแนะนำแบบเร็ว
ไม่ใช่ทุกเครื่องมือจะเหมาะกับผู้ใช้ทุกแบบ คำแนะนำของผมแบ่งตามประเภทผู้ใช้มีดังนี้:
เหมาะที่สุดสำหรับฝ่ายขายและเจ้าของเอเจนซีที่ไม่ใช่สายเทคนิค: Thunderbit (สแครป AI 1 คลิก, มี email extractor ฟรี, subpage scraping) และ Instant Data Scraper (ฟรี ใช้ง่าย — แต่ไม่มีอีเมล)
เหมาะที่สุดสำหรับงาน lead generation ขนาดใหญ่: Apify (cloud actors, งานหลายเมือง, ดึงอีเมลจาก detail page) และ Outscraper (managed API, รองรับหลาย directory)
ตัวเลือกฟรีที่ดีที่สุด: Instant Data Scraper (ฟรีตลอดไป) และ Thunderbit แผนฟรี (6 หน้า/เดือน พร้อมฟีเจอร์ AI)
เหมาะที่สุดสำหรับนักพัฒนา: Python DIY กับ Playwright (คุมได้เต็มที่) และ ScrapingBee API (เรนเดอร์ + proxy แบบจัดการให้)
เหมาะที่สุดสำหรับองค์กร / งานสเกลใหญ่: Bright Data (เครือข่าย proxy ใหญ่ที่สุด, ฟีเจอร์ compliance, ราคาองค์กร)
เรายังเขียนสรุป best AI web scrapers และคู่มือเจาะลึกเรื่อง AI lead generation ไว้ให้ถ้าคุณอยากไปต่อ
Yellow Pages เทียบกับ Google Maps และไดเรกทอรีอื่น: ควรใช้เมื่อไร
มืออาชีพสาย lead gen ส่วนใหญ่ไม่ได้สแครป Yellow Pages แบบเดี่ยว ๆ พวกเขามักดึงจากหลาย directory แล้วเอามา cross-reference กัน ต่อไปนี้คือการเปรียบเทียบแบบเร็วจากความพร้อมของข้อมูลในปัจจุบัน:
| Factor | Yellow Pages | Google Maps | Facebook Business |
|---|---|---|---|
| Email availability | ต่ำ (มีเฉพาะ detail page) | ต่ำมาก (ไม่ใช่ฟิลด์มาตรฐาน) | ปานกลาง (เพจอาจมีอีเมล) |
| Phone numbers | ✅ แสดงสม่ำเสมอ | ✅ แสดงสม่ำเสมอ | ⚠️ บางครั้งซ่อนอยู่ |
| Reviews/ratings | ✅ มี | ✅ ข้อมูลแน่นกว่า | ✅ มี |
| Categories/niches | ✅ เด่นในตลาดเฉพาะท้องถิ่น | ✅ กว้างและอุดมข้อมูล | ⚠️ ไม่สม่ำเสมอ |
| Best scraper tool | Thunderbit, Apify YP actor | Outscraper, Apify Maps actor | Thunderbit (AI ช่วยแยกฟิลด์ได้ทุกเว็บ) |
Yellow Pages เด่นที่สุดในเรื่อง ความครอบคลุมหมวดหมู่เฉพาะท้องถิ่น — ถ้าคุณต้องการรายชื่อช่างประปาทั้งหมดในเมืองหนึ่ง มันยากจะหาอะไรมาแทนได้ Google Maps ให้ ข้อมูลรีวิวที่ละเอียดกว่าและสัญญาณความใหม่ของข้อมูล ส่วน Facebook Business Pages บางครั้งชนะทั้งสองแพลตฟอร์มในเรื่อง การเห็นอีเมลโดยตรง เพราะเจ้าของเพจมักลงอีเมลไว้เอง
Thunderbit ใช้ AI แยกฟิลด์จากทุกเว็บไซต์ได้ ดังนั้นคุณจึงสแครป Yellow Pages, Google Maps และ Facebook ด้วย extension เดียวได้ ความยืดหยุ่นแบบนี้สำคัญมากเมื่อคุณกำลังสร้างลีดลิสต์จากหลายแหล่ง คู่มือของเราเรื่อง what is web scraping มีพื้นฐานให้ถ้าคุณเพิ่งเริ่ม
ข้อพิจารณาด้านกฎหมายและจริยธรรมในการสแครป Yellow Pages
ส่วนนี้สั้น แต่สำคัญ
ข้อมูลจาก Yellow Pages เข้าถึงได้แบบสาธารณะ แต่ Terms of Service ของ YP.com ระบุชัดว่าการเข้าถึงมีไว้เพื่อ "individual, non-commercial, informational purposes" และห้ามใช้ "bots, scrapers, crawlers, spiders" เพื่อดึงข้อมูล กรอบกฎหมายในสหรัฐเกี่ยวกับ web scraping ยังมีรายละเอียดซับซ้อน — การมองเห็นข้อมูลแบบสาธารณะอาจลดความเสี่ยงเรื่อง CFAA เมื่อเทียบกับหน้าที่ต้องล็อกอิน แต่ก็ยังมีเรื่องสัญญา, กฎหมายความเป็นส่วนตัว (CCPA) และการทำการตลาดที่ต้องปฏิบัติตาม
FTC เคยส่ง warning letters ไปยังนักการตลาดแผนประกันสุขภาพและ lead generator 21 ราย ในเดือนธันวาคม 2024 เกี่ยวกับวิธีใช้ข้อมูลผู้บริโภคใน workflow lead gen ข้อคิดคือ: ควรสแครปอย่างรับผิดชอบ เคารพ rate limit อย่านำ raw data ไปขายต่อโดยไม่เข้าใจกรอบกฎหมาย และใช้ข้อมูลที่สแครปมาเพื่อวัตถุประสงค์ทางธุรกิจที่ชอบธรรม
บทความนี้ให้ข้อมูลเชิงสารสนเทศเท่านั้น และไม่ใช่คำแนะนำทางกฎหมาย
สรุป
Scraper ของ Yellow Pages ส่วนใหญ่พลาดอีเมล เพราะหยุดอยู่แค่หน้ารายการหลัก เครื่องมือที่ทำได้ดีกว่าจะต้องเข้าไปยัง detail page ของธุรกิจ ตามลิงก์ไปยังเว็บไซต์ของธุรกิจ หรือทำ enrichment ต่อบนข้อมูลพื้นฐานที่สแครปมาแล้ว และถึงอย่างนั้น ความพร้อมของอีเมลใน Yellow Pages ก็ยังอยู่ราว 15–25% ของรายการเท่านั้น — ดังนั้นการตั้งความคาดหวังให้สมจริงสำคัญพอ ๆ กับการเลือกเครื่องมือที่ใช่
ถ้าคุณเป็นทีมที่ไม่ใช่สายเทคนิคแต่ต้องการลีดที่มีข้อมูลติดต่อจริง ลองใช้ Thunderbit แผนฟรี ดูได้เลย — ฟีเจอร์ subpage scraping และ email extraction ถูกออกแบบมาเพื่อแก้ปัญหานี้โดยตรง ถ้าคุณรันแคมเปญขนาดใหญ่ Apify และ Outscraper ก็มีโครงสร้างคลาวด์ที่แข็งแรง ส่วนถ้าคุณเป็นนักพัฒนาที่อยากคุมทุกอย่างเอง Python กับ Playwright และ ScrapingBee ก็พาไปถึงเป้าหมายได้ แม้คุณจะต้องสร้าง pipeline เองมากขึ้น
เริ่มจากตารางเปรียบเทียบด้านบน เลือกตามระดับทักษะและงบประมาณของคุณ แล้วจำไว้ว่า: scraper ที่ดีที่สุดคือเครื่องมือที่ดึงข้อมูลที่คุณต้องใช้ไปใช้ติดต่อได้จริง ไม่ใช่เครื่องมือที่มีฟีเจอร์ยาวที่สุด
คุณยังสามารถเข้าไปดู Thunderbit Chrome Extension โดยตรง หรือดูบทเรียนใน YouTube channel ของเราได้
คำถามที่พบบ่อย
สแครปอีเมลจาก Yellow Pages ได้จริงไหม?
ได้ แต่ส่วนใหญ่อีเมลจะอยู่ในหน้า detail (subpage) ของธุรกิจ ไม่ได้อยู่บนการ์ดรายการหลัก เอกสารของ scraper ในปัจจุบันบอกว่าโดยทั่วไปมีเพียงประมาณ 15–25% ของธุรกิจที่แสดงอีเมลให้ detail-page scraper ดึงได้ คุณต้องใช้เครื่องมือที่มีความสามารถ subpage scraping — เช่น Thunderbit หรือ actor แบบ detail-mode ของ Apify — ถึงจะได้ผลดีที่สุด
Yellow Pages scraper ฟรีที่ดีที่สุดคืออะไร?
Instant Data Scraper ฟรีแบบเต็ม ไม่ต้องมีบัญชีหรือเครดิต แต่ดึงอีเมลได้ไม่เสถียรและไม่มีการรับมือ anti-bot Thunderbit มีแผนฟรี (6 หน้า/เดือน) พร้อม AI scraping, เข้าถึง subpage และดึงอีเมลได้ — เป็นตัวเลือกที่แข็งแรงกว่าถ้าอีเมลสำคัญกับ workflow ของคุณ
จะหลีกเลี่ยงการถูกบล็อกเวลาสแครป Yellow Pages ได้อย่างไร?
Yellow Pages ใช้ Cloudflare Bot Management, CAPTCHA, rate limiting และ browser fingerprinting ให้ใช้เครื่องมือที่มี proxy rotation และ CAPTCHA handling ในตัว เช่น Thunderbit, Apify, Octoparse, ScrapingBee, Bright Data Thunderbit มีสวิตช์ cloud-to-browser เป็นทางสำรองที่ใช้งานได้จริง — ถ้า cloud scraping โดนบล็อก โหมด browser จะใช้ session ในเครื่องคุณเพื่อช่วยผ่านการป้องกันบางส่วน
Yellow Pages scraper เทียบกับ Google Maps scraper — อันไหนดีกว่าสำหรับลีด?
ขึ้นอยู่กับความต้องการของคุณ Yellow Pages เด่นกว่าในเรื่องหมวดหมู่เฉพาะท้องถิ่นและแสดงเบอร์โทรสม่ำเสมอ Google Maps มีข้อมูลรีวิวที่ลึกกว่าและอัปเดตบ่อยกว่า แต่ทั้งคู่ไม่ค่อยดีนักในเรื่องอีเมล — Facebook Business Pages มักจะมีอีเมลให้เห็นมากกว่า ควร cross-reference หลาย directory เพื่อให้ได้โปรไฟล์ลีดที่ครบที่สุด
สแครป Yellow Pages ถูกกฎหมายไหม?
ข้อมูล Yellow Pages เข้าถึงได้สาธารณะ แต่ Terms of Service ของ YP.com จำกัดการเก็บข้อมูลอัตโนมัติและการใช้ผลการค้นหาในเชิงพาณิชย์ กรอบกฎหมายสหรัฐเกี่ยวกับการสแครปข้อมูลสาธารณะกำลังเปลี่ยนแปลง ผู้ใช้ควรอ่าน Terms of Service ของเว็บไซต์ ปฏิบัติตามกฎหมายความเป็นส่วนตัวที่เกี่ยวข้อง (เช่น CCPA, GDPR หากเกี่ยวข้อง) และใช้ข้อมูลที่สแครปมาอย่างรับผิดชอบ บทความนี้เป็นข้อมูลทั่วไปและไม่ใช่คำแนะนำทางกฎหมาย
ลองใช้ Thunderbit สำหรับสแครป Yellow Pages Get Started Free
เรียนรู้เพิ่มเติม



