
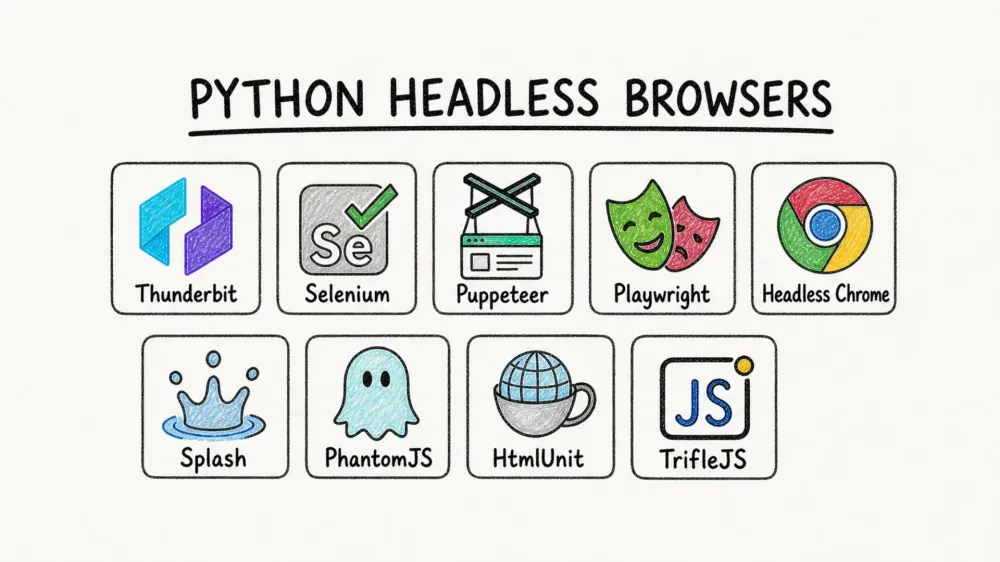
เว็บในปัจจุบันไม่ใช่ “ห้องสมุดดิจิทัล” ที่เป็นระเบียบเรียบร้อยอีกต่อไป แต่กลายเป็นเหมือน “ป่าข้อมูล” ที่เปลี่ยนตลอดเวลา ในปี 2026 ถ้าคุณต้องการสแครปข้อมูลจากเว็บไซต์สมัยใหม่ คุณไม่ได้แค่เจอกำแพง JavaScript แต่กำลังชนกับป้อมปราการทั้งหลัง ผมเห็นกับตาว่าเครื่องมือสแครปแบบเดิม ๆ พังลงเพราะคอนเทนต์แบบไดนามิก การเลื่อนหน้าแบบไม่สิ้นสุด และระบบกันบอท นี่จึงเป็นเหตุผลที่การมาของ python headless browser ไม่ใช่แค่กระแส แต่เป็นการเปลี่ยนเกมครั้งใหญ่สำหรับใครก็ตามที่อยากดึงข้อมูลจากเว็บอย่างมั่นคงและขยายการใช้งานได้จริง
และไม่ใช่แค่นักเทคนิคเท่านั้นที่สนใจ ณ ปี 2025 มี 73% ขององค์กรพึ่งพาการดึงข้อมูลเว็บอัตโนมัติเพื่อใช้ใน business intelligence และเว็บไซต์มากกว่า 94% ในปัจจุบันอาศัยการเรนเดอร์ JavaScript ฝั่ง client-side ไม่ว่าคุณจะทำงานด้าน sales, ecommerce หรือ operations เบราว์เซอร์ Python แบบ headless ที่เหมาะสมคือเส้นแบ่งระหว่าง “ข้อมูลอยู่แค่ปลายนิ้ว” กับ “ข้อมูลเอื้อมไม่ถึง” งั้นมาคัดของที่ไม่จำเป็นออกไปกัน—ผมได้ลอง เปรียบเทียบ และใช้งานเครื่องมือเหล่านี้จริง และจะพาไล่ดู 10 python headless browser ที่ดีที่สุดสำหรับการสแครปยุคใหม่ (พร้อมไฮไลต์พิเศษว่า AI กำลังเปลี่ยนเกมสำหรับคนที่ไม่เขียนโค้ดอย่างไร)
อะไรทำให้ Python Headless Browser กลายเป็นของจำเป็นสำหรับการสแครปยุคใหม่?
สแครปข้อมูลจากทุกเว็บไซต์ได้ด้วย AI Get Started Free
ขออธิบายแบบไม่ต้องลงศัพท์เทคนิคเยอะ: python headless browser ก็คือเว็บเบราว์เซอร์ที่คุณสั่งงานด้วยโค้ด Python ได้ แต่ไม่ต้องมีหน้าต่างเด้งขึ้นมาบนจอ มันโหลดหน้าเว็บ รัน JavaScript คลิกปุ่ม กรอกฟอร์ม และทำทุกอย่างอยู่เบื้องหลังแบบมองไม่เห็น ลองนึกภาพว่าเป็นเบราว์เซอร์ผีที่ทำงานไม่หยุด ในขณะที่คุณนั่งจิบกาแฟสบาย ๆ
ทำไมเรื่องนี้ถึงสำคัญ? เพราะเว็บไซต์สมัยใหม่ถูกออกแบบมาสำหรับคน ไม่ได้ออกแบบมาสำหรับบอท พวกเขาซ่อนข้อมูลไว้หลัง JavaScript บังคับให้ล็อกอิน และคาดหวังให้คุณโต้ตอบเหมือนมนุษย์จริง เครื่องมือสแครปแบบเดิมที่ดึงแค่ HTML จะเห็นเพียงเปลือกว่าง ๆ แต่ headless browser สามารถ จำลองพฤติกรรมผู้ใช้จริง ได้—รอการเรียก AJAX เลื่อนดูฟีดแบบไม่สิ้นสุด และดึงคอนเทนต์ออกมาตามที่คุณเห็นบน Chrome หรือ Firefox (LiveProxies)
แต่ยังมีข้อดีอีก:
- เร็วและประหยัดทรัพยากร: headless browser ไม่ต้องแสดงผลหน้าจอ จึงเร็วกว่าและใช้หน่วยความจำน้อยกว่า เหมาะมากสำหรับการสแครปในระดับใหญ่ (LiveProxies)
- รองรับคอนเทนต์แบบไดนามิก: มันรัน JavaScript ได้ จึงได้ข้อมูลที่ถูกเรนเดอร์จริง ไม่ใช่แค่ HTML ดิบ
- ความสามารถอัตโนมัติขั้นสูง: ต้องล็อกอิน เปลี่ยนหน้า หรือจัดการป๊อปอัปใช่ไหม? Python headless browser ทำได้หมด
- ขยายสเกลได้ง่าย: รันหลายอินสแตนซ์บนคลาวด์ ดึงข้อมูลหลายพันหน้าแบบขนาน และแทบไม่เหนื่อย
สำหรับผู้ใช้ในธุรกิจ สิ่งนี้หมายความว่าคุณสามารถเก็บลีด เฝ้าดูคู่แข่ง หรือเช็กราคาได้จริง แม้เว็บไซต์นั้นจะป้องกันแน่นเหมือน Fort Knox และด้วยเครื่องมือ AI รุ่นใหม่ คุณก็ไม่จำเป็นต้องเป็นโปรแกรมเมอร์ถึงจะใช้งานได้
เราเลือก Python Headless Browser ที่ดีที่สุดอย่างไร
ผมไม่ได้โยนชื่อเครื่องมือใส่หมวกแล้วสุ่มหยิบออกมา นี่คือเกณฑ์ที่ผมใช้:
- ประสิทธิภาพและความเร็ว: รองรับเว็บยุคใหม่ที่หนัก JavaScript ได้เร็วและเสถียรหรือไม่
- รองรับเบราว์เซอร์: ใช้กับ Chrome, Firefox, WebKit หรือแม้แต่เอนจินรุ่นเก่าอย่าง IE ได้ไหม
- ใช้งานง่าย: เป็นมิตรกับคนไม่เขียนโค้ด หรือบังคับให้ต้องมีปริญญาเอกด้าน Python
- ฟีเจอร์ AI และ No-code: ผู้ใช้ธุรกิจสามารถใช้ AI ช่วยสแครปโดยไม่ต้องเขียนสคริปต์ได้หรือไม่
- คอมมูนิตี้และซัพพอร์ต: มีชุมชนที่ active เอกสารดี และมีการพัฒนาต่อเนื่องไหม
- ฟีเจอร์เฉพาะตัว: มีอะไรที่โดดเด่นเป็นพิเศษหรือไม่ เช่น เทมเพลตสำเร็จรูป การสแครปบนคลาวด์ หรือการไล่ข้อมูลจากหน้าย่อย
ผมเคยเห็นทีมงานเสียเวลาหลายสัปดาห์ไปกับการติดตั้ง แล้วสุดท้ายติดกับเมื่อเลย์เอาต์เว็บเปลี่ยน เครื่องมือที่ดีที่สุดไม่ใช่แค่ใช้งานได้ แต่ต้องปรับตัวได้ ขยายได้ และช่วยให้ชีวิตง่ายขึ้นจริง
10 Python Headless Browser ที่ดีที่สุดสำหรับการสแครปยุคใหม่
นี่คือรายชื่อที่ผมคัดมาแบบชัด ๆ พร้อมเจาะลึกว่าแต่ละตัวเด่นหรือสะดุดตรงไหน
1. Thunderbit
 Thunderbit คือ python headless browser ที่ผมอยากมีตั้งแต่หลายปีก่อน มันไม่ใช่แค่เครื่องมืออัตโนมัติเบราว์เซอร์ แต่เป็น AI-powered web scraper Chrome Extension ที่สร้างมาสำหรับผู้ใช้ธุรกิจที่ต้องการผลลัพธ์ ไม่ใช่ปวดหัว
เหตุผลที่ Thunderbit โดดเด่น:
- ตั้งค่าฟิลด์ด้วย AI: แค่เปิดส่วนขยาย—คลิกครั้งเดียว—AI ของ Thunderbit จะเดาโครงสร้างหน้าเว็บ เลือกฟิลด์ และเริ่มสแครปให้เลย (Thunderbit Docs)
- เทมเพลตข้อมูลสำเร็จรูป: สำหรับเว็บไซต์ยอดนิยมอย่าง Amazon, Zillow, LinkedIn และอื่น ๆ มีเทมเพลตให้ใช้แบบคลิกครั้งเดียว ไม่ต้องตั้งค่า
- สแครปหน้าย่อยและหลายหน้าได้: Thunderbit คลิกไปยังหน้าย่อย จัดการ infinite scroll และรวมข้อมูลทั้งหมดลงเป็นตารางเดียว
- สั่งงานด้วยภาษาธรรมชาติ: บอกสิ่งที่ต้องการเป็นภาษาอังกฤษง่าย ๆ แล้วให้ AI จัดการที่เหลือ
- สแครปได้ทั้งบนคลาวด์หรือในเบราว์เซอร์: รันแบบโลคัลหรือบนคลาวด์ได้ (สูงสุด 50 หน้าในคราวเดียวเพื่อความเร็ว)
- ไม่ต้องเขียนโค้ด: พูดตรง ๆ แค่ใช้เบราว์เซอร์เป็น คุณก็ใช้ Thunderbit ได้
- ส่งออกข้อมูลฟรี: Export ไป Excel, Google Sheets, Notion หรือ Airtable ได้ในคลิกเดียว
ผมเคยเห็น Thunderbit ช่วยทีม sales และ ops ประหยัดเวลาได้หลายชั่วโมง—ตั้งแต่สแครปลีด เฝ้าราคาสินค้า ไปจนถึงรวมข้อมูลสินค้า โดยไม่ต้องแตะโค้ดแม้แต่บรรทัดเดียว มีผู้ใช้มากกว่า 200,000 รายทั่วโลก และเสียงตอบรับที่ได้ยินบ่อยคือ “ไม่น่าเชื่อว่ามันง่ายขนาดนี้”
เหมาะสำหรับ: ผู้ใช้ที่ไม่ถนัดเทคนิค ทีมธุรกิจ และใครก็ตามที่อยากให้ AI ช่วยงานหนัก
ลองใช้ Thunderbit AI Web Scraper ฟรี
2. Selenium
 Selenium คือบรรพบุรุษของสาย browser automation ถ้าคุณเคยค้นคำว่า “python headless browser” คุณคงเจอ Selenium WebDriver แน่นอน
ข้อดี:
- รองรับเบราว์เซอร์หลักครบ: Chrome, Firefox, Safari, Edge และแม้แต่ Internet Explorer (สำหรับคนใจกล้า)
- คอมมูนิตี้ขนาดใหญ่: มีบทเรียน ปลั๊กอิน และคำตอบบน Stack Overflow เยอะมาก
- ยืดหยุ่นสูง: สั่งให้ทำอะไรก็ได้ที่ผู้ใช้ทำได้—คลิก กรอกฟอร์ม ไปยังหน้าอื่น
ข้อเสีย:
- ตั้งค่ายากพอสมควร: ต้องจัดการ browser driver และคอยให้เวอร์ชันตรงกัน
- ช้ากว่าเครื่องมือสมัยใหม่: โปรโตคอล WebDriver มี overhead และการขยายไปยังเบราว์เซอร์จำนวนมากค่อนข้างเทอะทะ
- API ค่อนข้างยืดยาว: ต้องเขียนโค้ดมากกว่า Playwright หรือ Puppeteer
เหมาะสำหรับ: ทีมที่มีประสบการณ์ Selenium อยู่แล้ว งานทดสอบข้ามเบราว์เซอร์ หรือเวิร์กโฟลว์อัตโนมัติแบบเก่า
3. Puppeteer
 Puppeteer คือไลบรารี automation ระดับสูงของ Google สำหรับ Chrome/Chromium แม้มันจะเป็นของ Node.js โดยตรง แต่ผู้ใช้ Python ก็เข้าร่วมได้ผ่าน Pyppeteer
ข้อดี:
- ออกแบบมาสำหรับ Chrome โดยเฉพาะ: เร็ว มีประสิทธิภาพ และเชื่อมกับ Chrome DevTools ได้แน่น
- API แบบ async: เหมาะมากกับเว็บยุคใหม่ที่หนัก JavaScript
- ฟีเจอร์ครบ: ตั้งแต่ screenshot, ส่งออก PDF ไปจนถึงดักจับ network
ข้อเสีย:
- รองรับแค่ Chromium: ไม่มี Firefox หรือ Safari
- Native ของ Node.js: คนใช้ Python ต้องพึ่ง Pyppeteer (ซึ่งตอนนี้ไม่ได้ดูแลต่อแล้ว—ดูข้อถัดไป)
เหมาะสำหรับ: นักพัฒนาที่ต้องการ automation บน Chrome ที่เร็วและเสถียร โดยไม่ต้องรองรับหลายเบราว์เซอร์
4. Playwright
 Playwright คือดาวรุ่งที่มาแรง พัฒนาโดย Microsoft และกลายเป็นตัวที่ผมหยิบใช้บ่อยที่สุดสำหรับงานสแครประดับสูง
ข้อดี:
- รองรับหลายเบราว์เซอร์: อัตโนมัติได้ทั้ง Chromium, Firefox และ WebKit ด้วย API เดียว
- Auto-waiting: ไม่ต้องเดาอีกต่อไปว่าเพจพร้อมแล้วหรือยัง—Playwright รอให้เอง
- ทำงานพร้อมกันได้: รัน browser context หลายชุดแบบขนานเพื่อความเร็วสูงมาก
- Python-first: มี bindings สำหรับ Python โดยตรง ทั้งแบบ async และ sync
ข้อเสีย:
- ติดตั้งใหญ่กว่า: เพราะรวมหลายเบราว์เซอร์ จึงตั้งค่าหนักกว่าเล็กน้อย
- ยังต้องเขียนโค้ด: ไม่เป็นมิตรกับผู้ใช้ไม่เชิงเทคนิคเท่า Thunderbit
เหมาะสำหรับ: นักพัฒนาที่ต้องการ automation สมัยใหม่แบบแข็งแรง โดยเฉพาะเว็บแอปที่ซับซ้อนและเปลี่ยนแปลงตลอด
5. Headless Chrome
 Headless Chrome คือเอนจินที่ขับเคลื่อนเครื่องมือหลายตัวด้านบน คุณสามารถควบคุมมันโดยตรงผ่าน Chrome DevTools Protocol (CDP) เพื่อความยืดหยุ่นสูงสุด
ข้อดี:
- รองรับเว็บสมัยใหม่ได้สุดทาง: ถ้ามันทำงานบน Chrome ได้ Headless Chrome ก็ทำได้
- ควบคุมได้ละเอียด: เข้าถึงทุกซอกทุกมุมของเบราว์เซอร์
ข้อเสีย:
- เรียนรู้ยาก: ต้องคุยกับ CDP เป็น หรือใช้ไลบรารีตัวกลาง
- รองรับแค่ Chrome: ไม่มีข้ามเบราว์เซอร์
เหมาะสำหรับ: ผู้เชี่ยวชาญที่กำลังสร้าง pipeline อัตโนมัติแบบกำหนดเอง หรืออยากเชื่อม Chrome ในระดับลึก
6. Pyppeteer
 Pyppeteer คือพอร์ต Python แบบไม่เป็นทางการของ Puppeteer มันนำ automation ของ Chrome แบบ async มาสู่ Python แต่… มีข้อควรรู้
ข้อดี:
- API สไตล์ Puppeteer: ถ้าคุณรู้จัก Puppeteer อยู่แล้ว จะใช้งานได้คุ้นมือ
- เร็วสำหรับ Chrome automation: เหมาะกับเว็บแบบไดนามิก
ข้อเสีย:
- ไม่ได้รับการดูแลแล้ว: โปรเจกต์ต้นฉบับไม่ได้อัปเดตต่อ (ผู้พัฒนาก็แนะนำให้ย้ายไป Playwright)
- รองรับแค่ Chromium: ไม่มี Firefox หรือ Safari
เหมาะสำหรับ: โปรเจกต์เก่าที่ยังใช้ Pyppeteer อยู่ ถ้าเริ่มโปรเจกต์ใหม่ ให้ใช้ Playwright
7. Splash
 Splash คือ headless browser น้ำหนักเบาที่สคริปต์ได้ และมี HTTP API พัฒนาโดยทีม Scrapinghub (ปัจจุบันคือ Zyte)
ข้อดี:
- เบาและประหยัดทรัพยากร: ใช้ QtWebKit จึงกินทรัพยากรน้อยกว่า Chrome
- มี HTTP API: ควบคุมได้จากหลายภาษา ไม่ใช่แค่ Python
- เข้ากับ Scrapy ได้ดีมาก: เชื่อมกับ Scrapy spiders เพื่อเรนเดอร์ JavaScript ได้แบบไร้รอยต่อ
ข้อเสีย:
- ใช้เอนจิน WebKit รุ่นเก่า: อาจมีปัญหากับ JavaScript สมัยใหม่ที่ซับซ้อน
- ต้องเขียน Lua: ถ้าต้องโต้ตอบขั้นสูง คุณต้องเรียน Lua เพิ่ม
เหมาะสำหรับ: ผู้ใช้ Scrapy ที่ต้องเรนเดอร์ JavaScript บ้างเป็นครั้งคราว หรือทำงาน rendering ฝั่งเซิร์ฟเวอร์ที่ไม่หนักมาก
8. PhantomJS
 PhantomJS คือ headless browser แบบสคริปต์ได้ตัวแรก ๆ ที่สร้างบน WebKit ถือเป็นผู้บุกเบิก แต่ตอนนี้แทบจะล้าสมัยไปแล้ว
ข้อดี:
- สคริปต์ง่าย: ทำ automation ด้วย JavaScript ได้ไม่ยาก
- ยังพอใช้กับเว็บเก่า ๆ แบบ static: ใช้กับระบบเดิมบางประเภทได้
ข้อเสีย:
- ไม่ได้รับการดูแลแล้ว: ไม่มีอัปเดตตั้งแต่ปี 2016
- เอนจินล้าสมัย: รับมือเว็บที่หนัก JS แบบปัจจุบันไม่ไหว
- เสี่ยงด้านความปลอดภัย: ไม่มีแพตช์ใหม่
เหมาะสำหรับ: ดูแลสคริปต์เก่า สำหรับโปรเจกต์ใหม่ควรย้ายไป Playwright หรือ Puppeteer
9. HtmlUnit
 HtmlUnit คือ headless browser ที่เขียนด้วย Java และจำลองพฤติกรรมเบราว์เซอร์ได้ มันเร็วและเบา แต่ไม่ใช่ browser engine จริงเต็มรูปแบบ
ข้อดี:
- Java ล้วน: เหมาะกับสภาพแวดล้อมที่ใช้ Java เยอะ
- เร็วกับหน้าแบบ static: ไม่ต้องเปิดเบราว์เซอร์เต็มตัว
ข้อเสีย:
- รองรับ JavaScript จำกัด: เจอเว็บสมัยใหม่ที่ไดนามิกมาก ๆ จะลำบาก
- ไม่ใช่ native ของ Python: ต้องพึ่งชั้นเชื่อม เช่น HtmlUnitDriver ของ Selenium
เหมาะสำหรับ: เวิร์กโฟลว์ที่ใช้ Java การทดสอบแอปเก่า ๆ หรือการสแครปหน้าเว็บที่เรนเดอร์จากเซิร์ฟเวอร์แบบง่าย ๆ
10. TrifleJS
 TrifleJS คือ headless browser สำหรับ Internet Explorer (IE) ที่เน้นงานอัตโนมัติบนเว็บแอปเก่าใน Windows
ข้อดี:
- ทำงานกับ IE ได้: รองรับแอป intranet เก่า ๆ หรือระบบที่ใช้ได้เฉพาะ IE
- API คล้าย PhantomJS: ใช้สคริปต์ PhantomJS เดิมได้โดยปรับนิดหน่อย
ข้อเสีย:
- ใช้ได้เฉพาะ Windows: ไม่มีการรองรับข้ามแพลตฟอร์ม
- ล้าสมัย: IE ถูกปลดระวางแล้ว และ TrifleJS ก็เป็นของเฉพาะกลุ่มและแทบไม่ได้รับการดูแล
เหมาะสำหรับ: เวิร์กโฟลว์ legacy เฉพาะทางที่ยังต้องพึ่ง automation บน IE
ตารางเปรียบเทียบฟีเจอร์: Python Headless Browser แบบดูได้ในภาพรวม
| เครื่องมือ | การรองรับเบราว์เซอร์ | ประสิทธิภาพและสเกล | ใช้งานง่ายแค่ไหน | ฟีเจอร์ AI/No-code | คอมมูนิตี้และซัพพอร์ต | เหมาะกับใคร |
|---|---|---|---|---|---|---|
| Thunderbit | Chrome (Extension/Cloud) | สูง (ทำงานขนานบนคลาวด์) | ง่ายที่สุด—ไม่ต้องเขียนโค้ด | มี (AI, templates) | เติบโตต่อเนื่อง, active | คนไม่เขียนโค้ด, ทีม sales/ops, การดึงข้อมูลเร็ว |
| Selenium | เบราว์เซอร์หลักทุกตัว | ปานกลาง | ปานกลาง (ต้องตั้งค่า) | ไม่มี | ใหญ่และ成熟 | ข้ามเบราว์เซอร์, legacy, test automation |
| Puppeteer | Chromium/Chrome | สูงมาก | สูง (สำหรับ dev) | ไม่มี | ใหญ่ (Node.js) | Chrome-only, นักพัฒนา, automation เร็ว |
| Playwright | Chromium, Firefox, WebKit | สูงมาก (multi-context) | สูง (สำหรับ dev) | ไม่มี | โตเร็วมาก | งานขั้นสูง, หลายเบราว์เซอร์, สแครปแบบ modern |
| Headless Chrome | Chrome/Edge | สูงมาก | ต่ำ (ต้องใช้ CDP เอง) | ไม่มี | N/A (เป็นฐาน) | งาน custom, expert, ควบคุมระดับล่าง |
| Pyppeteer | Chromium/Chrome | สูง | ปานกลาง (async) | ไม่มี | เล็ก, ไม่ได้รับการดูแล | สคริปต์ Pyppeteer แบบเก่า |
| Splash | QtWebKit | ปานกลาง | ปานกลาง (API/Lua) | ไม่มี | เฉพาะกลุ่ม (Scrapy/Zyte) | ผู้ใช้ Scrapy, เรนเดอร์ JS แบบเบา ๆ |
| PhantomJS | WebKit (เก่า) | ต่ำ (ล้าสมัยแล้ว) | ปานกลาง (JS) | ไม่มี | ยุติการพัฒนา | legacy เท่านั้น |
| HtmlUnit | จำลอง (Java) | ปานกลาง/สูง (static) | ต่ำ (Java) | ไม่มี | เล็ก, เน้น Java | เวิร์กโฟลว์ Java, หน้าแบบง่าย/static |
| TrifleJS | Internet Explorer (Trident) | ต่ำ/ปานกลาง | ปานกลาง (JS, Win) | ไม่มี | เล็กมาก, legacy | automation legacy เฉพาะ IE |
จะเลือก Python Headless Browser ที่เหมาะกับธุรกิจของคุณอย่างไร
Data Scraping คืออะไร และทำอย่างไรในปี 2025 Get Started Free
นี่คือชีตสั้น ๆ สำหรับเลือกเครื่องมือให้ตรงงาน:
- อยากได้การสแครปเร็ว แบบไม่ต้องเขียนโค้ด และมี AI ช่วย? เลือก Thunderbit นี่คือวิธีที่ง่ายที่สุดสำหรับคนไม่เขียนโค้ดในการดึงข้อมูลที่เชื่อถือได้ โดยเฉพาะทีม sales, ecommerce หรือ research
- ต้องการควบคุมได้สูงสุดและรองรับหลายเบราว์เซอร์? Playwright คือคำตอบ มันแข็งแรง ทันสมัย และพร้อมสำหรับการขยายสเกล
- ลงทุนกับ Selenium ไว้แล้ว? ใช้ Selenium ต่อไปได้ มันยังเป็นตัวหลักสำหรับงาน legacy และเวิร์กโฟลว์หลายเบราว์เซอร์
- กำลังทำ automation บน Chrome ในฐานะนักพัฒนา? Puppeteer (หรือ Playwright) เร็วและทรงพลัง
- สแครปหน้าเว็บแบบ static ง่าย ๆ ในสภาพแวดล้อม Java? HtmlUnit เบาและเชื่อมต่อได้ง่าย
- ยังดูแลสคริปต์เก่า หรือแอปที่ใช้ IE เท่านั้น? PhantomJS และ TrifleJS คือเพื่อนตัวสุดท้ายในยามจำเป็น
และอย่าลืมว่า: เครื่องมือที่ดีที่สุดคือเครื่องมือที่เข้ากับเวิร์กโฟลว์ ทักษะทีม และความต้องการของธุรกิจคุณ บางครั้งคำตอบคือการผสมกัน—ใช้ Thunderbit สำหรับงานเร็ว ๆ ใช้ Playwright สำหรับงานหนัก และใช้ Selenium กับระบบเก่า
คำถามที่พบบ่อย
1. python headless browser คืออะไร และทำไมต้องใช้กับการสแครป?
python headless browser คือเว็บเบราว์เซอร์ที่คุณควบคุมด้วยโค้ด Python แต่ทำงานแบบไม่แสดงหน้าจอ (ไม่มี GUI) มันจำเป็นมากสำหรับการสแครปเว็บสมัยใหม่ที่หนัก JavaScript เพราะสามารถรันสคริปต์ จัดการการโต้ตอบของผู้ใช้ และดึงข้อมูลที่ถูกเรนเดอร์ครบถ้วนได้ ซึ่งสแครป HTML แบบเดิมทำไม่ได้
2. python headless browser ตัวไหนเหมาะที่สุดสำหรับคนไม่ถนัดเทคนิค?
Thunderbit คือคำตอบอันดับหนึ่งสำหรับคนไม่เขียนโค้ด มันใช้ AI ช่วยตั้งค่า มีเทมเพลตสำเร็จรูป และให้คุณสแครปข้อมูลได้ในคลิกเดียว หรือบอก AI เป็นประโยคสั้น ๆ ว่าต้องการข้อมูลอะไร โดยไม่ต้องเขียนโปรแกรม
3. Playwright กับ Puppeteer ต่างกันอย่างไรสำหรับผู้ใช้ Python?
Playwright รองรับหลายเบราว์เซอร์ (Chromium, Firefox, WebKit) และมี Python bindings ที่แข็งแรง จึงเหมาะกับงาน automation ขั้นสูง ส่วน Puppeteer ใช้กับ Chrome เท่านั้นและเป็น native ของ Node.js แต่ผู้ใช้ Python สามารถใช้ Pyppeteer ได้ (แม้ตอนนี้จะไม่ได้รับการดูแลแล้ว) สำหรับโปรเจกต์ Python ใหม่ ๆ Playwright เป็นตัวเลือกที่ดีกว่า
4. Selenium ยังเหมาะกับการสแครปเว็บสมัยใหม่อยู่ไหม?
ใช่—Selenium ยังถูกใช้อย่างแพร่หลาย โดยเฉพาะงานทดสอบข้ามเบราว์เซอร์และ automation ของระบบเก่า อย่างไรก็ตาม มันช้ากว่าและตั้งค่าซับซ้อนกว่าเครื่องมือใหม่อย่าง Playwright หรือ Thunderbit และไม่ค่อยมีประสิทธิภาพเท่าเมื่อสแครปในสเกลใหญ่
5. ควรใช้เครื่องมือเก่าอย่าง PhantomJS, HtmlUnit หรือ TrifleJS เมื่อไร?
ใช้เฉพาะตอนต้องดูแลหรือย้ายเวิร์กโฟลว์เก่าเท่านั้น PhantomJS และ TrifleJS ล้าสมัยแล้ว ส่วน HtmlUnit เหมาะกับสภาพแวดล้อม Java และหน้าเว็บที่ไม่ซับซ้อน สำหรับโปรเจกต์ใหม่ ควรใช้เครื่องมือสมัยใหม่ที่ยังมีการดูแลอย่างต่อเนื่อง
ถ้าคุณพร้อมดูว่าการสแครปแบบ AI ยุคใหม่หน้าตาเป็นอย่างไร ลอง Thunderbit ได้เลย และถ้าอยากอ่านเรื่อง automation บนเว็บเพิ่มเติม ลองดู Thunderbit Blog ขอให้สแครปสนุก—ขอให้ข้อมูลของคุณสดใหม่เสมอ และขอให้เบราว์เซอร์ของคุณเป็นแบบ headless ตลอดไป
ลองใช้ Thunderbit AI Web Scraper วันนี้ Get Started Free
เรียนรู้เพิ่มเติม



