
คำถามเดิมนั้นง่ายมาก: “ตัวไหนคือ scraper ที่คัดลอกข้อมูลจากเว็บไซต์นี้ได้?”
แต่คำถามที่ดีกว่าสำหรับปี 2026 คือ: “เวิร์กโฟลว์แบบไหนจะเปลี่ยนหน้าเว็บที่รกและวุ่นวายให้กลายเป็นข้อมูลมีโครงสร้างที่เชื่อถือได้ พร้อมการตรวจสอบมากพอให้หยิบกลับมาใช้ใหม่ได้ในสัปดาห์หน้า?”
ประเด็นนี้สำคัญมาก เพราะตอนนี้คำว่า “AI web scraper” ครอบคลุมผลิตภัณฑ์หลายแบบที่ต่างกันสุด ๆ บางเครื่องมือใช้ AI ช่วยแนะนำฟิลด์และดึงข้อมูลโดยไม่ต้องพึ่ง selector บางตัวเป็นเว็บสแครปเปอร์แบบภาพที่มีฟีเจอร์ตรวจจับอัจฉริยะเล็กน้อย บางตัวเป็นแพลตฟอร์มสำหรับนักพัฒนา ที่ AI ช่วยให้คุณสร้างหรือดูแลโค้ดได้ และบางเครื่องมือรุ่นเก่าก็ยังโผล่ในผลการค้นหา ทั้งที่จริง ๆ แล้วไม่ได้เป็น AI-native อีกต่อไป
คู่มือนี้จะเน้นการเปรียบเทียบแบบใช้งานจริง หากคุณทำงานด้านขาย การตลาด อีคอมเมิร์ซ วิจัย ปฏิบัติการ หรือทีมข้อมูล เป้าหมายไม่ใช่การชื่นชม scraper ที่ดูสวย แต่คือการดึงข้อมูลเป็นแถวที่สะอาดจากเว็บไซต์สาธารณะไปยังสเปรดชีต CRM ฐานข้อมูล หรือเวิร์กโฟลว์อัตโนมัติ โดยไม่ต้องเสียเวลาหลายเดือนมานั่งแก้ selector
ดึงข้อมูลจากเว็บไซต์ด้วย AI ใช้ Thunderbit แปลงหน้าเว็บเป็นตารางข้อมูลที่มีโครงสร้าง แล้วส่งออกไปยัง Sheets, Airtable, Notion, CSV หรือ JSON ได้เลย Get Started Free
อะไรนับเป็น Free AI Web Scraper ในปี 2026?
AI web scraper ที่ใช้งานได้จริงควรช่วยงานได้อย่างน้อยหนึ่งข้อจากนี้:
- อ่านหน้าเว็บแล้วแนะนำฟิลด์ที่ควรดึงออกมา
- จัดการรายการหลายหน้า การเลื่อนแบบไม่สิ้นสุด หรือหน้ารายละเอียดต่าง ๆ
- แปลงเนื้อหาหน้าเว็บที่ยุ่งเหยิงให้เป็นแถวข้อมูลมีโครงสร้าง
- ส่งออกข้อมูลไปยังเครื่องมือที่ทีมใช้อยู่แล้ว
- ลดภาระการดูแล selector เมื่อหน้าเว็บเปลี่ยน
- ทำให้เวิร์กโฟลว์ทำซ้ำได้ในระดับทีม ไม่ใช่แค่ในเบราว์เซอร์ของคนคนเดียว
คำว่า “ฟรี” ก็ต้องมองตามความจริงด้วย บางเครื่องมือมี free plan จริง บางตัวมีแค่ free trial บางตัวเป็นโอเพ่นซอร์สแต่ต้องใช้เวลาของทีมวิศวกร บางแพลตฟอร์มระดับองค์กรดีมาก แต่เส้นทางฟรีของมันเป็นเพียงเดโมหรือช่วงทดลองเท่านั้น ซึ่งไม่ได้แปลว่าเครื่องมือเหล่านั้นไม่ดี เพียงแต่หมายความว่าเหมาะกับคนละกลุ่ม
กฎตัดสินใจแบบใช้งานจริงคือ:
- ถ้าคุณต้องการข้อมูลวันนี้และไม่อยากเขียนโค้ด ให้เริ่มจาก no-code AI scraper
- ถ้าคุณต้องการ pipeline แบบกำหนดเองและมีทีมวิศวกร ให้ใช้ developer framework หรือ cloud automation platform
- ถ้าคุณต้องการฟีดข้อมูลขนาดใหญ่ที่มีการกำกับดูแล ให้ดูแพลตฟอร์มข้อมูลระดับองค์กร
- ถ้าเครื่องมือเก่าหรือไม่ได้รับการดูแลแล้ว ให้มองเป็นข้อมูลอ้างอิง ไม่ใช่ตัวเลือกหลัก
เราเลือกเครื่องมือเหล่านี้อย่างไร
ผมทบทวนรายชื่อ 10 เครื่องมือจากบทความเดิม และคงมุมมองการประเมินแบบใช้งานจริงไว้ คำถามสำคัญไม่ได้อยู่ที่ “ผลิตภัณฑ์นี้ scrape ได้ไหม” แต่อยู่ที่ “มันทำให้ workflow แบบไหนง่ายขึ้น”
เกณฑ์ที่ใช้:
- AI assistance: การแนะนำฟิลด์, การตรวจจับอัจฉริยะ, การตั้งค่าด้วยภาษาธรรมชาติ, หรือการ parsing ที่มี AI ช่วย
- Free access: free plan, free trial, โอเพ่นซอร์ส หรือเครดิตสำหรับนักพัฒนา
- Ease of use: ผู้ใช้สายธุรกิจสามารถใช้งานได้เองโดยไม่ต้องพึ่งวิศวกรหรือไม่
- Modern web support: รองรับ pagination, subpages, หน้า JavaScript หนัก ๆ, รูปภาพ และการ export
- Operational fit: ผลลัพธ์สามารถกลายเป็นกระบวนการที่ทำซ้ำได้หรือไม่
- Risk and maintenance: ต้องตั้งค่ามากแค่ไหน ต้องซ่อม selector แค่ไหน ต้องตรวจ compliance และ QA แค่ไหน
อีกเรื่องที่ต้องย้ำ: ก่อนจะ scrape เว็บไซต์ใด ๆ ควรตรวจสอบข้อกำหนดของเว็บไซต์นั้น ๆ, robots.txt, การล็อกอิน และภาระหน้าที่ด้านความเป็นส่วนตัวเสมอ AI ทำให้ดึงข้อมูลง่ายขึ้น แต่ไม่ได้ลบความรับผิดชอบของคุณในการใช้ข้อมูลเว็บอย่างเหมาะสม
ตัวเลือกเร็ว: Free AI Web Scraper ที่เหมาะกับแต่ละงาน
| Use case | Start here | Why |
|---|---|---|
| ดึงข้อมูลแบบ no-code ได้เร็วสำหรับทีมธุรกิจ | Thunderbit | แนะนำฟิลด์ด้วย AI, scrape หน้าย่อยได้, export ได้, ใช้งานผ่าน Chrome |
| ดึงข้อมูลแบบ desktop visual | ParseHub หรือ Octoparse | เหมาะกับคนที่ชอบ workflow แบบคลิกเป็นขั้นตอน |
| ดึงข้อมูลด้วยสูตรบนเบราว์เซอร์ | Data Miner | เด่นสำหรับตารางทั่วไปและงานที่ทำซ้ำด้วย recipe |
| ดึงข้อมูลที่ควบคุมด้วยโค้ด | Scrapy หรือ Apify | เหมาะที่สุดเมื่อโค้ด, API และโครงสร้างพื้นฐานแบบกำหนดเองสำคัญ |
| AI data API และการแยก entity | Diffbot | เหมาะกับ enrichment ที่ขับเคลื่อนด้วย API และข้อมูล entity ที่มีโครงสร้าง |
| การ crawl แบบโอเพ่นซอร์สที่พร้อมสำหรับ AI | Crawl4AI หรือ Scrapling | เฟรมเวิร์กสำหรับนักพัฒนา ใช้กับ LLM pipeline และงาน scraping ที่ดูแลต่อได้ |
1. Thunderbit
Thunderbit เหมาะที่สุดสำหรับผู้ใช้สายธุรกิจที่ต้องการ scrape หน้าเว็บสาธารณะโดยไม่ต้องเขียนโค้ด scraper มันเป็น Chrome extension ที่ออกแบบตามเวิร์กโฟลว์ง่าย ๆ คือ เปิดหน้าเว็บ ให้ AI แนะนำฟิลด์ ปรับตารางถ้าจำเป็น scrape รายการหรือหน้าย่อย แล้วค่อย export ผลลัพธ์
เวิร์กโฟลว์นี้สำคัญมาก เพราะหลายทีมไม่ได้ต้องการ “scraper” แบบแยกตัวออกมา พวกเขาต้องการรายชื่อลีดจากไดเรกทอรี, ข้อมูลสินค้าในมาร์เก็ตเพลส, ราคาจากหน้าคู่แข่ง, รายการอสังหาฯ, รีวิว, ตำแหน่งงาน หรือข้อมูลวิจัยในสเปรดชีต
Thunderbit เด่นเป็นพิเศษเมื่อ:
- แหล่งข้อมูลเป็นเว็บไซต์ ไม่ใช่ PDF หรือฐานข้อมูลภายใน
- ผู้ใช้รู้ว่าต้องการข้อมูลอะไร แต่ไม่รู้ CSS selector
- หน้ามี detail page, pagination หรือการ์ดที่ซ้ำ ๆ กัน
- ผลลัพธ์ต้องส่งไปยัง Google Sheets, Airtable, Notion, CSV หรือ JSON
- workflow นี้อาจต้องให้เพื่อนร่วมทีมที่ไม่ใช่สายเทคนิคทำซ้ำ
มุม AI ที่นี่ใช้งานได้จริง ไม่ใช่แค่ของตกแต่ง AI ช่วยอนุมานฟิลด์ เขียน extraction prompt และทำให้การตั้งค่ายืดหยุ่นน้อยกว่าการคลิกเลือกแบบเดิม ๆ อย่างไรก็ตาม คุณควรตรวจตัวอย่างแถวข้อมูลก่อน export งานใหญ่เสมอ โดยเฉพาะเมื่อหน้าเว็บมีโฆษณา คำแนะนำ หรือรายการที่ได้รับการสนับสนุนปะปนกับผลลัพธ์หลัก
การเข้าถึงแบบฟรี: Thunderbit มีเส้นทางใช้งานฟรีสำหรับงานเล็ก ๆ และมีแพ็กเกจแบบเสียเงินสำหรับงานที่มีปริมาณสูงขึ้น ควรเช็ก หน้าราคา ปัจจุบันก่อนเผยแพร่ตัวเลขเครดิตแบบตายตัว เพราะโครงสร้างเครดิตอาจเปลี่ยนได้
เหมาะสำหรับ: ทีมขาย การตลาด อีคอมเมิร์ซ อสังหาริมทรัพย์ ปฏิบัติการ และวิจัย ที่ต้องการข้อมูลเว็บแบบมีโครงสร้างอย่างรวดเร็ว

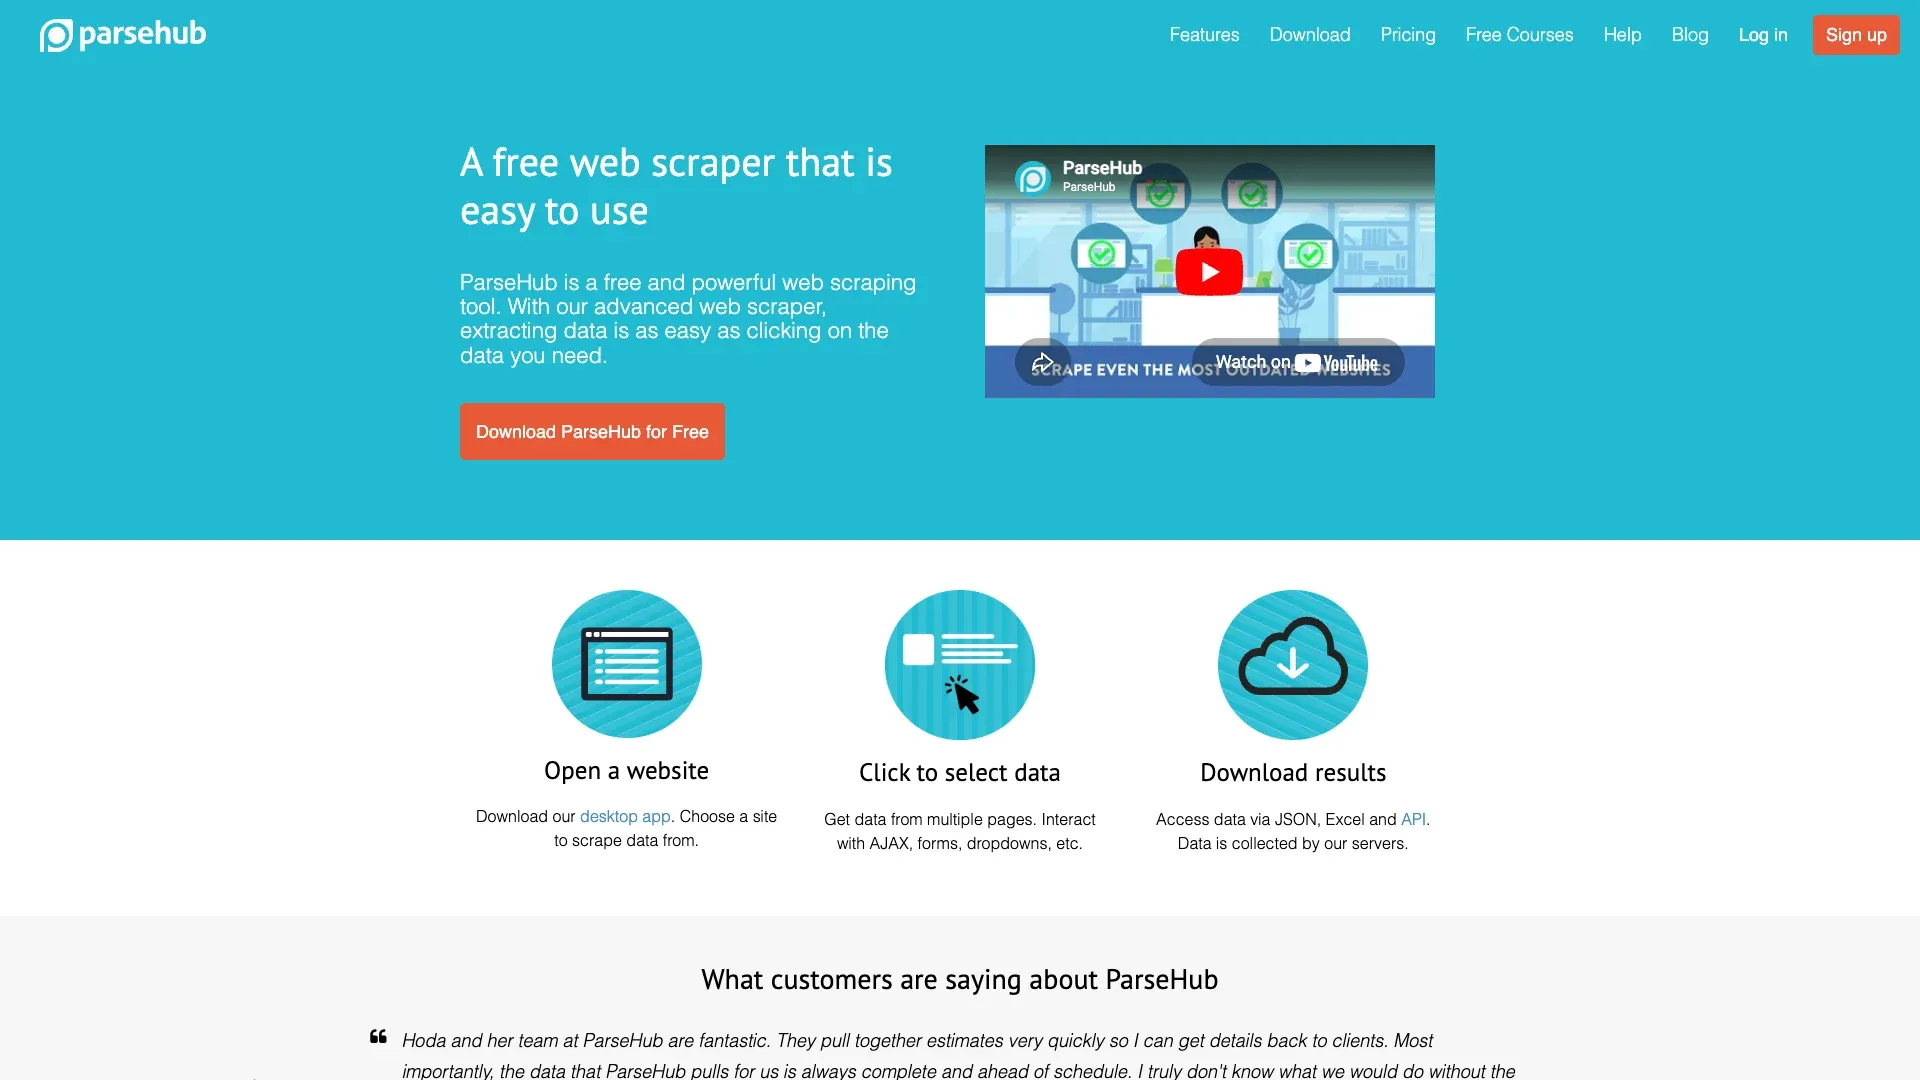
2. ParseHub
ParseHub เป็นเว็บสแครปเปอร์แบบ visual สำหรับผู้ใช้ที่ชอบคลิกไปตามหน้าเว็บแล้วสอนเครื่องมือว่าต้องดึงอะไร มันรองรับหน้าเว็บไดนามิกได้ดีพอสมควร และยังเป็นตัวเลือกที่คุ้นเคยสำหรับทีมที่ต้องการ scraper แบบ desktop หรือ cloud visual
ParseHub เหมาะเมื่อผู้ใช้สบายใจกับการสร้างโปรเจ็กต์ทีละขั้น เช่น เลือก element, ขยายการเลือก, เพิ่ม pagination, ทดสอบการรัน แล้วค่อย export มันไม่ได้เป็นแนว prompt-first เท่าเครื่องมือ AI-native รุ่นใหม่ แต่ก็ยังมีประสิทธิภาพสำหรับรายการที่เป็นโครงสร้าง, บทความ, และคอลเลกชันสินค้า
การเข้าถึงแบบฟรี: ParseHub เคยมี free tier สำหรับโปรเจ็กต์และจำนวนหน้าที่จำกัด โปรดตรวจสอบข้อจำกัดล่าสุดจากเว็บไซต์ทางการก่อนอ้างตัวเลขในคอนเทนต์จริง
เหมาะสำหรับ: โปรเจ็กต์ visual scraping ขนาดเล็ก ที่ผู้ใช้ยอมใช้เวลาเซ็ตอัปเล็กน้อย
3. Octoparse
Octoparse เป็นแพลตฟอร์มเว็บสแครปปิงแบบ no-code ที่ค่อนข้างครบเครื่อง มีเทมเพลต, การสร้าง workflow, การรันบนคลาวด์, การตั้งเวลา และรองรับเว็บไซต์ไดนามิกจำนวนมาก มันมีฟีเจอร์เยอะกว่า Chrome extension เบา ๆ ซึ่งอาจเป็นข้อดีหรือภาระก็ได้ขึ้นอยู่กับผู้ใช้
Octoparse เป็นตัวเลือกที่ดีเมื่อโจทย์การ scrape เกิดซ้ำ ๆ, เว็บไซต์เป้าหมายซับซ้อน หรือทีมต้องการตัวสร้าง workflow แบบ visual ที่มีการตั้งเวลาและรันบนคลาวด์ การตั้งค่าอาจใช้เวลามากกว่าการ scrape แบบ AI ช่วยเร็ว ๆ แต่ให้พลังควบคุมมากกว่าแก่ผู้ใช้ระดับโปร
การเข้าถึงแบบฟรี: Octoparse มี free plan แต่ข้อจำกัดด้านฟีเจอร์และจำนวนเรคคอร์ดเปลี่ยนได้ ควรตรวจสอบข้อจำกัดล่าสุดใน Octoparse pricing page ก่อนเผยแพร่ตัวเลขใด ๆ
เหมาะสำหรับ: ผู้ใช้ระดับโปรและทีมที่ต้องการควบคุม workflow แบบ visual, เทมเพลต, การตั้งเวลา หรือ job ที่ทำซ้ำ

4. Scrapy
Scrapy ไม่ใช่ no-code AI scraper แต่มันคือเฟรมเวิร์ก Python แบบโอเพ่นซอร์สสำหรับสร้าง crawler และ pipeline ดึงข้อมูล ความแตกต่างนี้สำคัญมาก
สำหรับนักพัฒนา Scrapy ยังเป็นหนึ่งในวิธีที่ยืดหยุ่นที่สุดในการสร้าง scraper แบบกำหนดเอง คุณควบคุม request, parsing, retry, pipeline, storage และ deployment ได้หมด คุณยังใช้ LLM ร่วมกับ Scrapy ได้ด้วย เช่น ให้ช่วยร่าง selector, รีวิว parsing logic, สร้าง test หรืออธิบายข้อผิดพลาด แต่ตัว Scrapy เองไม่ได้ตัดภาระงานวิศวกรรมออกไป
การเข้าถึงแบบฟรี: Scrapy เป็นโอเพ่นซอร์ส ซอฟต์แวร์ใช้ฟรี แต่ค่า hosting, proxies, การดูแล, monitoring และเวลาของนักพัฒนาไม่ฟรี
เหมาะสำหรับ: วิศวกรที่สร้างระบบ scraping แบบกำหนดเองและดูแลได้ระยะยาว ซึ่งยอมรับการเป็นเจ้าของโค้ด
5. Data Miner
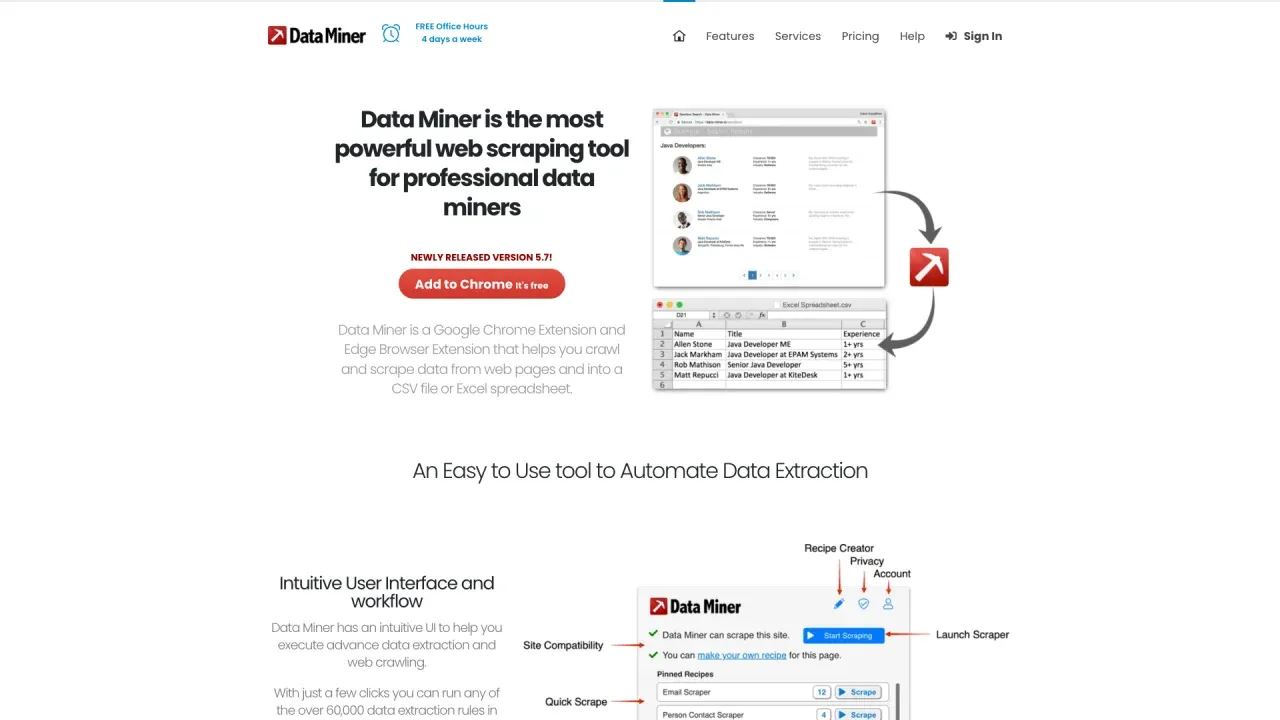
Data Miner เป็น browser extension ที่เน้นการ scrape ตาราง รายการ และรูปแบบหน้าทั่วไป จุดแข็งหลักคือ recipe library ถ้ามี recipe สำหรับแหล่งข้อมูลของคุณอยู่แล้ว การตั้งค่าก็จะเร็วมาก
นี่เหมาะกับผู้ใช้ที่ scrape หน้าประเภทเดิมซ้ำ ๆ และไม่ต้องการแพลตฟอร์มดึงข้อมูลเต็มรูปแบบ แต่จะไม่ค่อยเหมาะกับหน้าที่ยุ่งเหยิง ไดนามิกสูง หรือหน้าที่ต้องใช้ AI เพื่ออนุมานฟิลด์จากคอนเทนต์ที่กำกวม
การเข้าถึงแบบฟรี: Data Miner มีการใช้งานฟรีแบบจำกัด และมีแพ็กเกจเสียเงินสำหรับปริมาณงานสูง ควรตรวจสอบข้อจำกัดด้านหน้าใช้งานหรือเครดิตปัจจุบันก่อนอ้างอิง
เหมาะสำหรับ: การดึงข้อมูลแบบตารางเร็ว ๆ, ไดเรกทอรีทั่วไป, และผู้ใช้ที่ชอบ workflow แบบ browser extension
6. WebHarvy
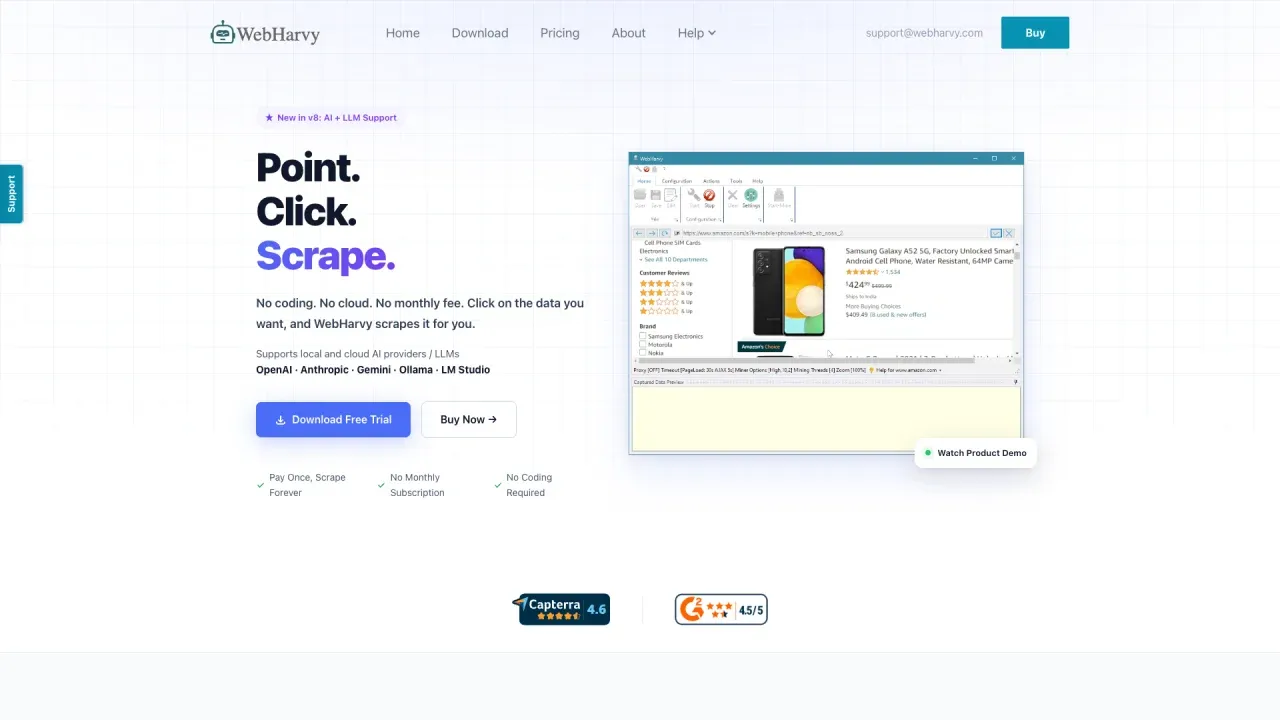
WebHarvy เป็น desktop scraper บน Windows ที่มีอินเทอร์เฟซแบบ visual และฟีเจอร์ตรวจจับรูปแบบ มันมีประโยชน์กับผู้ใช้ที่ต้องการคลิกตัวอย่างบนหน้าเว็บแล้วให้เครื่องมืออนุมานรายการที่คล้ายกัน
WebHarvy เด่นสำหรับหน้าสินค้า, หน้าที่เน้นรูปภาพ, และ workflow แบบ desktop มันอาจไม่ใช่ตัวเลือก AI-native ที่ทันสมัยที่สุด แต่ก็ยังใช้ได้ดีสำหรับคนที่ต้องการไลเซนส์แบบจ่ายครั้งเดียวและซอฟต์แวร์เดสก์ท็อปใช้งานในเครื่อง
การเข้าถึงแบบฟรี: โดยทั่วไป WebHarvy จะเน้นทดลองใช้ฟรีและไลเซนส์แบบเสียเงิน ไม่ใช่ free plan แบบใช้งานต่อเนื่อง ควรตรวจสอบเว็บไซต์ WebHarvy ปัจจุบันก่อนจะเรียกว่าเครื่องมือฟรี
เหมาะสำหรับ: ผู้ใช้ Windows ที่ scrape รายการสินค้า, รูปภาพ และรูปแบบหน้าซ้ำ ๆ
7. Apify
Apify เป็นแพลตฟอร์มคลาวด์ที่เป็นมิตรกับนักพัฒนา สำหรับ web scraping, browser automation และ data extraction จุดขายหลักคือ Actor marketplace แทนที่จะเริ่มจากสคริปต์เปล่า ๆ ทีมสามารถใช้หรือปรับแต่ง actor ที่มีอยู่แล้วสำหรับเว็บไซต์และ workflow ทั่วไป
Apify เป็นหนึ่งในตัวเลือกที่แข็งแรงที่สุดเมื่อการ scrape ต้องกลายเป็นซอฟต์แวร์ มันรองรับ API, scheduling, storage, webhooks และ workflow สำหรับนักพัฒนา AI สามารถช่วยตรงนี้ได้เหมือนกัน แต่ส่วนใหญ่จะเป็นผู้ช่วยในการสร้าง แก้ดีบัก และตรวจความถูกต้องของ actor มากกว่าจะเป็นอินเทอร์เฟซแบบคลิกครั้งเดียวสำหรับผู้ใช้ธุรกิจ
การเข้าถึงแบบฟรี: Apify มีโมเดล free plan/credits ควรตรวจสอบ Apify pricing และเอกสารแพลตฟอร์มล่าสุดก่อนอ้างขอบเขตคอมพิวต์แบบตายตัว
เหมาะสำหรับ: นักพัฒนา ทีมออโตเมชัน และผู้ดูแลระบบสายเทคนิคที่ต้องการโครงสร้างพื้นฐานสำหรับ scraping บนคลาวด์

8. Diffbot
Diffbot คือแพลตฟอร์มข้อมูล AI ที่ขึ้นชื่อเรื่องการแยก entity ที่มีโครงสร้างจากหน้าเว็บ และการดูแล knowledge graph ขนาดใหญ่ มันใกล้เคียงกับ API และแพลตฟอร์ม data intelligence มากกว่า visual scraper
Diffbot มีพลังมากเมื่อโจทย์คือการแยก entity, parsing บทความ/สินค้า, การ enrich ข้อมูล หรือการทำความเข้าใจเว็บแบบมีโครงสร้างในวงกว้าง โดยปกติแล้วมันไม่ใช่เครื่องมือแรกสำหรับผู้ใช้ที่ไม่ใช่สายเทคนิค ซึ่งแค่ต้องการคลิกหน้าเว็บแล้วส่งออกเป็นสเปรดชีต
การเข้าถึงแบบฟรี: Diffbot มี free plan และรูปแบบการเข้าถึงสำหรับนักพัฒนา ควรตรวจสอบ Diffbot pricing ล่าสุดเพื่อดูเครดิตและเงื่อนไขทดลอง
เหมาะสำหรับ: ทีมเทคนิคที่ต้องการ structured extraction ผ่าน API, ข้อมูล knowledge graph หรือ entity intelligence
9. Crawl4AI
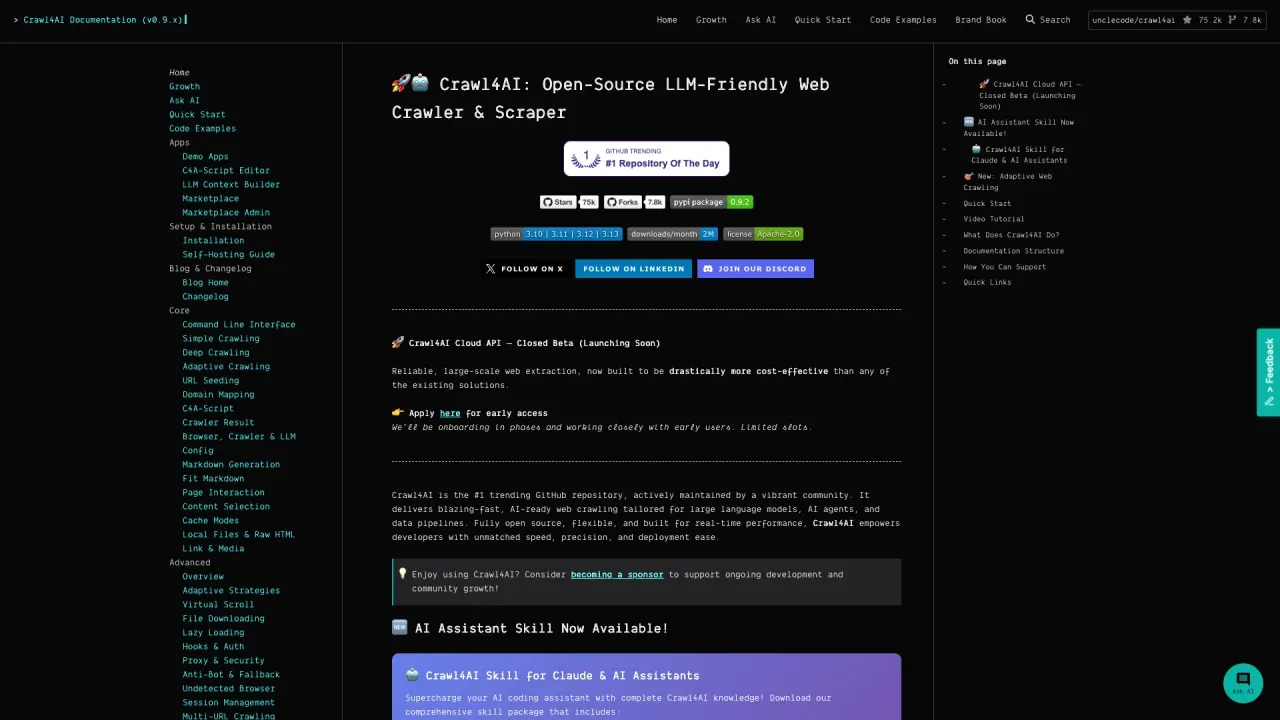
Crawl4AI เป็นเว็บ crawler และ scraper แบบโอเพ่นซอร์สที่รองรับ LLM สำหรับนักพัฒนาที่สร้าง AI agents, RAG pipelines และ workflow ข้อมูลแบบกำหนดเอง มันสามารถสร้าง Markdown ที่สะอาด, ดึง JSON ที่มีโครงสร้างด้วย CSS หรือ XPath และใช้ LLM เพื่อสร้าง schema การดึงข้อมูลที่นำกลับมาใช้ได้เมื่อเหมาะกับงาน
Crawl4AI เป็นตัวเลือกที่ดีเมื่อผลลัพธ์ต้องกลายเป็นส่วนหนึ่งของ workflow ทางวิศวกรรม มากกว่าจะเป็นการ export สเปรดชีตครั้งเดียว มันรองรับการควบคุมเบราว์เซอร์, การ crawl แบบ asynchronous, sessions และตัวเลือกการดึงข้อมูลละเอียด ๆ แต่ก็ยังคงต้องใช้ Python และความรับผิดชอบทางเทคนิค
การเข้าถึงแบบฟรี: โอเพ่นซอร์ส ไม่มีการบังคับใช้ API key หรือ paywall ของแพลตฟอร์ม แต่การดึงข้อมูลด้วย LLM อาจยังต้องใช้ผู้ให้บริการ LLM หรือโมเดลในเครื่อง
เหมาะสำหรับ: นักพัฒนาที่สร้าง crawler ที่พร้อมสำหรับ AI, การ ingest สำหรับ RAG หรือ pipeline ข้อมูลมีโครงสร้างที่ทำซ้ำได้
10. Scrapling
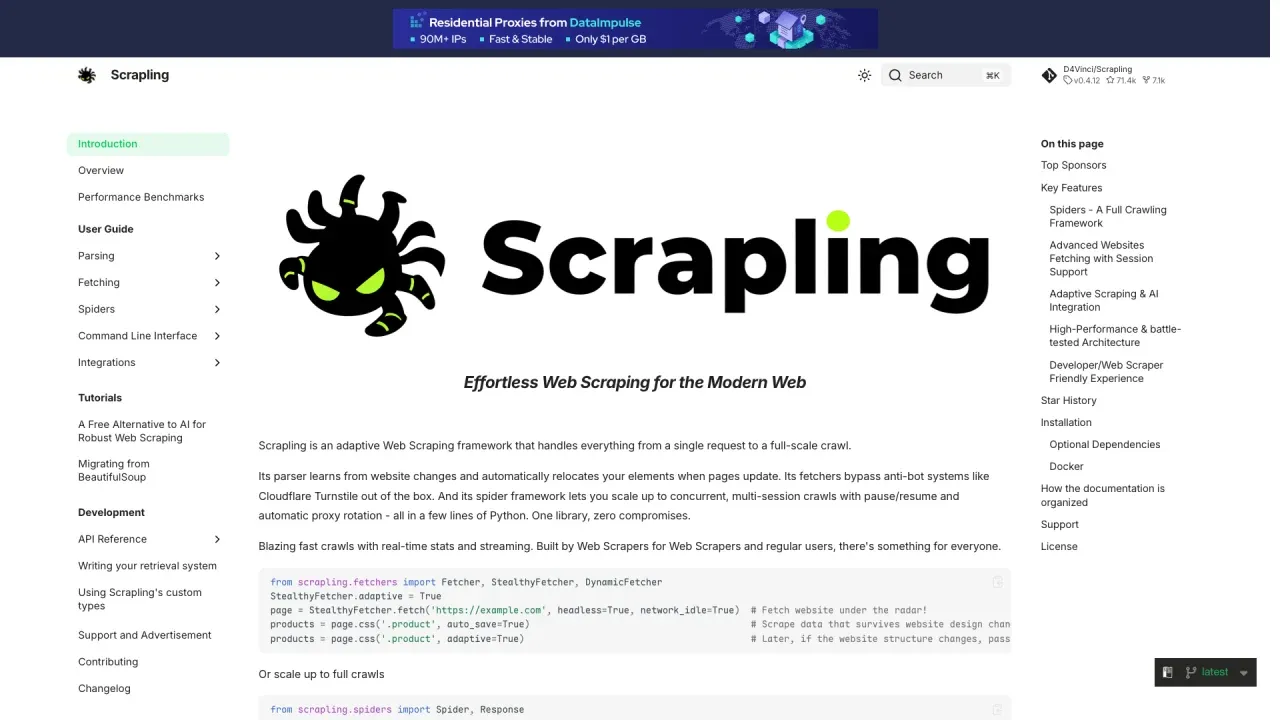
Scrapling คือเฟรมเวิร์ก Python สำหรับ scraping แบบปรับตัวได้ ครอบคลุมตั้งแต่ request เดี่ยว, การดึงข้อมูลด้วยเบราว์เซอร์ ไปจนถึงการ crawl เต็มรูปแบบ การ parsing แบบ adaptive ถูกออกแบบมาเพื่อช่วยย้ายตำแหน่ง element เมื่อเว็บไซต์เปลี่ยน ซึ่งช่วยลดภาระการซ่อม selector ในโปรเจ็กต์ scraping ที่ดูแลด้วยโค้ด
มันไม่ใช่เครื่องมือ AI แบบ no-code ทีมยังต้องกำหนดตรรกะการดึงข้อมูล ทดสอบ และดูแล runtime เอง แต่ในฐานะตัวแทนยุคใหม่สำหรับเครื่องมือ visual scraping รุ่นเก่า มันถือว่าน่าสนใจเพราะมีเอกสารอัปเดตและเหมาะกับสแต็ก scraping ด้วย Python ในปัจจุบันมากกว่า
การเข้าถึงแบบฟรี: โอเพ่นซอร์ส ค่า infrastructure, proxy service, การรันเบราว์เซอร์ และเวลาของวิศวกรยังเป็นต้นทุนแยกต่างหาก
เหมาะสำหรับ: นักพัฒนา Python ที่ต้องการ adaptive scraping และเส้นทางจากการ fetch แบบเดียวไปสู่การ crawl พร้อมกันหลายงาน
ตารางเปรียบเทียบ: เครื่องมือ Free AI Web Scraping
| Use case | Start here | Why |
|---|---|---|
| ดึงข้อมูลแบบ no-code ได้เร็วสำหรับทีมธุรกิจ | Thunderbit | แนะนำฟิลด์ด้วย AI, scrape หน้าย่อยได้, export ได้, ใช้งานผ่าน Chrome |
| ดึงข้อมูลแบบ desktop visual | ParseHub หรือ Octoparse | เหมาะกับคนที่ชอบ workflow แบบคลิกเป็นขั้นตอน |
| ดึงข้อมูลด้วยสูตรบนเบราว์เซอร์ | Data Miner | เด่นสำหรับตารางทั่วไปและงานที่ทำซ้ำด้วย recipe |
| ดึงข้อมูลที่ควบคุมด้วยโค้ด | Scrapy หรือ Apify | เหมาะที่สุดเมื่อโค้ด, API และโครงสร้างพื้นฐานแบบกำหนดเองสำคัญ |
| AI data API และการแยก entity | Diffbot | เหมาะกับ enrichment ที่ขับเคลื่อนด้วย API และข้อมูล entity ที่มีโครงสร้าง |
| การ crawl แบบโอเพ่นซอร์สที่พร้อมสำหรับ AI | Crawl4AI หรือ Scrapling | เฟรมเวิร์กสำหรับนักพัฒนา ใช้กับ LLM pipeline และงาน scraping ที่ดูแลต่อได้ |
วิธีเลือกเครื่องมือให้เหมาะ
เริ่มจาก “แหล่งข้อมูล” และ “ผู้ใช้” ไม่ใช่ชื่อแบรนด์
ถ้าข้อมูลอยู่บนหน้าเว็บสาธารณะและผู้ใช้ไม่ใช่สายเทคนิค ให้เริ่มจาก Thunderbit, ParseHub, Octoparse หรือ Data Miner เครื่องมือเหล่านี้ใกล้กับ workflow ทางธุรกิจจริงมากกว่า คือ เปิดแหล่งข้อมูล กำหนดฟิลด์ ทดสอบ ตรวจแถวข้อมูล แล้ว export
ถ้างานต้องใช้ตรรกะเฉพาะ, การจัดการ authentication, orchestration, API หรือการ deployment ให้ดู Scrapy หรือ Apify ตรงนี้เป็นจุดที่การมีเจ้าของงานฝั่งวิศวกรรมสมเหตุสมผล ใช้ AI ช่วยเร่งการตรวจ selector และสร้าง test ได้ แต่ต้องมีคนตรวจเรื่อง compliance, การรับมือข้อผิดพลาด และคุณภาพข้อมูล
ถ้าองค์กรต้องการการแยก entity, การ enrich ข้อมูล หรือ knowledge graph ที่ขับเคลื่อนด้วย API ให้ประเมิน Diffbot แล้วเปรียบเทียบเงื่อนไขทดลอง, ความครอบคลุมของข้อมูล และความเข้ากันได้ของ API กับความต้องการของคุณ ส่วนฟีดข้อมูลที่จัดการแบบกว้าง ๆ ควรผ่านกระบวนการจัดซื้อโดยเฉพาะ ไม่ควรมองว่าเป็นตัวเลือก scraper ฟรีทั่วไป
ถ้าเว็บไซต์หรือเอกสารของเครื่องมือดูเก่า อย่านำไปใช้กับงานที่อ่อนไหว ทดสอบกับหน้าเว็บสาธารณะที่ไม่มีผลกระทบก่อน ตรวจการ export และยืนยันว่าโปรดักต์ยังได้รับการดูแลอยู่
เช็กลิสต์ตรวจสอบง่าย ๆ ก่อน export
ก่อนจะรันการ scrape ขนาดใหญ่ ให้ทดสอบกับตัวอย่างเล็ก ๆ:
- แต่ละแถวแทน entity ที่ถูกต้องหรือไม่
- มีรายการที่ได้รับการสนับสนุน, ซ้ำ หรือแนะนำปะปนเข้ามาหรือไม่
- pagination หรือ infinite scroll หยุดเร็วเกินไปหรือไม่
- ราคา, วันที่, อีเมล และเบอร์โทรถูก parse อย่างสม่ำเสมอหรือไม่
- ฟิลด์จาก subpage ถูกจับคู่กับแถวหลักถูกต้องหรือไม่
- รูปแบบ export เก็บ schema ที่ต้องการไว้ครบหรือไม่
- คุณมีสิทธิ์เก็บและใช้ข้อมูลนี้เพื่อวัตถุประสงค์ของคุณหรือไม่
AI ทำให้ตั้งค่าได้เร็วขึ้น แต่ก็ทำให้ข้อมูลที่ดึงผิดดูสะอาดได้เหมือนกัน การตรวจ QA ด้วย 20 แถว ยังเป็นวิธีที่คุ้มค่าที่สุดวิธีหนึ่งในการหลีกเลี่ยง dataset ที่เสียหาย
คำแนะนำสุดท้าย
สำหรับผู้ใช้ส่วนใหญ่ ให้เริ่มจาก workflow ที่เร็วและปลอดภัยที่สุด: ใช้ no-code AI scraper ทดสอบกับตัวอย่างเล็ก ๆ ตรวจสอบ schema แล้วค่อย export ไปยังระบบที่งานจะดำเนินต่อ
Thunderbit เหมาะที่สุดเมื่อโจทย์คือข้อมูลเว็บสาธารณะ และผู้ใช้ต้องการ workflow ที่มี AI ช่วยแบบใช้งานจริงในเบราว์เซอร์ ParseHub, Octoparse และ Data Miner น่าลองถ้าคุณชอบตัวสร้างโปรเจ็กต์แบบ visual หรือการ scrape แบบ recipe Scrapy, Crawl4AI, Scrapling และ Apify เหมาะกว่าเมื่อ scraper ต้องกลายเป็นโค้ดหรือโครงสร้างพื้นฐาน Diffbot เป็นตัวเลือกเฉพาะทางเมื่อการแยก entity หรือข้อมูล knowledge graph สำคัญกว่าวิธีใช้ผ่านเบราว์เซอร์
เครื่องมือที่ดีที่สุดไม่ใช่ตัวที่มีฟีเจอร์ยาวที่สุด แต่คือตัวที่พาคุณไปสู่ข้อมูลมีโครงสร้างที่เชื่อถือได้ โดยมีการดูแลต่อเนื่องน้อยที่สุดสำหรับทีมของคุณ
คำถามที่พบบ่อย
AI web scraper คืออะไร?
AI web scraper คือเครื่องมือที่ใช้ machine learning, LLM, computer vision หรือความเข้าใจหน้าเว็บอัจฉริยะ เพื่อช่วยระบุฟิลด์ ดึงข้อมูลที่มีโครงสร้าง หรือปรับตัวกับหน้าเว็บที่ยุ่งเหยิง เครื่องมือที่ดีควรให้คุณตรวจและแก้ผลลัพธ์ได้เสมอ
Free AI web scraper ฟรีจริงไหม?
บางตัวมีการใช้งานฟรีเริ่มต้น บางตัวมี free trial และบางตัวเป็นโอเพ่นซอร์ส คำว่าฟรีไม่ได้แปลว่าฟรีเมื่อใช้งานในสเกลใหญ่เสมอไป ควรตรวจ page limit, credit limit, ข้อจำกัดการ export และว่ามี cloud run รวมอยู่ด้วยหรือไม่
AI web scraper ฟรีตัวไหนเหมาะกับคนไม่ถนัดเทคนิคที่สุด?
Thunderbit เป็นจุดเริ่มต้นที่ดีที่สุดสำหรับทีมที่ไม่ใช่สายเทคนิคและต้องการดึงข้อมูลจากเว็บไซต์สาธารณะเป็นตารางที่มีโครงสร้าง ParseHub, Octoparse และ Data Miner ก็มีประโยชน์เช่นกัน ขึ้นอยู่กับว่าคุณชอบโปรเจ็กต์แบบ visual, เทมเพลต หรือ browser recipe
เมื่อไหร่ควรใช้ Scrapy หรือ Apify แทน no-code scraper?
ใช้ Scrapy หรือ Apify เมื่อคุณต้องการตรรกะเฉพาะ, การควบคุมโดยนักพัฒนา, API, scheduling, monitoring หรือการเชื่อมเข้ากับ workflow ซอฟต์แวร์ที่ใหญ่กว่า เครื่องมือเหล่านี้ทรงพลัง แต่ต้องรับผิดชอบมากขึ้น
AI web scraper จัดการ pagination และ subpages ได้ไหม?
เครื่องมือสมัยใหม่หลายตัวทำได้ แต่ควรทดสอบอย่างรอบคอบ Pagination, infinite scroll และ subpages เป็นจุดที่ scraper มักหยุดก่อนเวลา หรือเอาข้อมูลหน้ารายละเอียดไปจับผิดแถว
การ scrape เว็บไซต์ถูกกฎหมายไหม?
ขึ้นอยู่กับเว็บไซต์ ประเภทข้อมูล เขตอำนาจศาล และกรณีใช้งาน ควรตรวจข้อกำหนดของเว็บไซต์, robots.txt, ข้อจำกัดการล็อกอิน, ภาระหน้าที่ด้านความเป็นส่วนตัว และข้อกำกับการปฏิบัติตามภายในก่อนเก็บหรือใช้ข้อมูลที่ scrape มา
เรียนรู้เพิ่มเติม
- วิธี scrape เว็บไซต์ใดก็ได้ด้วย AI
- 5 อันดับซอฟต์แวร์ดึงข้อมูลเว็บที่ดีที่สุดในปี 2026
- 7 เครื่องมือเว็บสแครปปิงยอดนิยมที่ควรใช้ในปี 2026
- 10 เครื่องมือ AI Web Scraper ที่ช่วยเพิ่มประสิทธิภาพในปี 2025
- 8 AI Web Scraper ที่ดีที่สุดสำหรับการดึงข้อมูลอย่างชาญฉลาด
ลองใช้ AI Web Scraper Get Started Free




