
Varje gång du synkar ditt CRM, hämtar leveransuppdateringar eller kopplar ihop två SaaS-verktyg är det ett REST API som gör grovjobbet i bakgrunden. De flesta tänker aldrig på det — tills något går fel.
Det lustiga är att det till och med bland utvecklare råder ordentlig förvirring kring vad som egentligen gör ett API ”RESTful”. Begreppet används så slarvigt att en tråd på Reddit uttryckte det rakt ut: ”Jag tror inte att jag har byggt ett enda riktigt RESTful API enligt Roy Fieldings definition.” Och det säger ändå en utvecklare, inte en affärsanvändare. Begreppet kommer från Roy Fieldings doktorsavhandling från 2000 vid UC Irvine, där han beskrev REST som en arkitektonisk stil — en uppsättning designbegränsningar — inte ett protokoll, inte en produkt och inte någon specifikation du laddar ner.
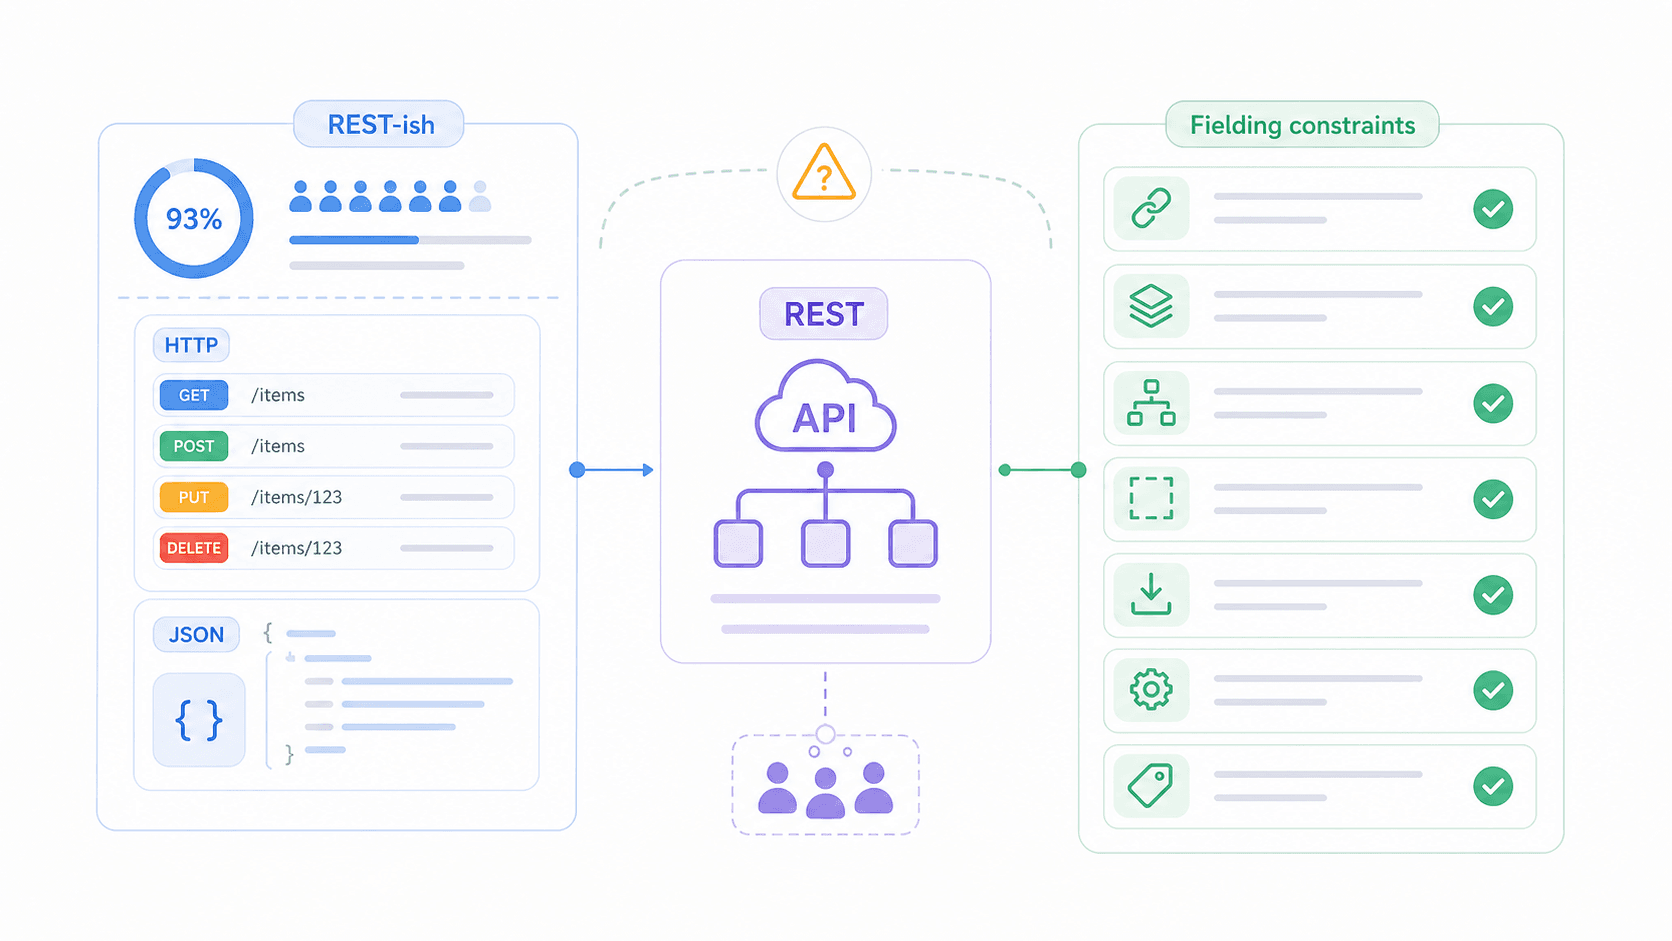
Ändå visar Postmans rapport State of the API 2025 att REST används av 93 % av API-proffs. Så nästan alla använder det, men förvånansvärt många team missförstår vad det faktiskt kräver. I den här artikeln går vi igenom de 6 grundläggande egenskaperna hos REST API:er i klartext, visar vilka som oftast blir fel, introducerar en mognadsmodell du kan använda för att själv utvärdera, och jämför REST med alternativen — SOAP, GraphQL och gRPC.
Vad är ett REST API? (En enkel förklaring)
REST (Representational State Transfer) är en uppsättning designregler för hur mjukvarusystem ska kommunicera över ett nätverk.
Mer exakt är det en arkitektonisk stil som definierar begränsningar — som tillståndslöshet, cachebarhet och ett enhetligt gränssnitt — som styr hur klienter (din webbläsare, mobilapp eller automatiseringsverktyg) interagerar med servrar (där data finns). REST körs vanligtvis över HTTP och returnerar oftast JSON, men REST är i sig inte bundet till något särskilt protokoll eller dataformat.
Tänk på det som etikettregler för en middagsbjudning. REST bestämmer inte vilken mat du serverar eller vilket språk du talar — det definierar hur du skickar runt rätterna, hur du ber om mer och hur du signalerar att du är klar. Två system som följer samma etikett kan kommunicera förutsägbart, även om de aldrig har träffats.
Vad REST INTE är: REST är inte en produkt du installerar. Det är inte ett protokoll som HTTP eller SOAP. Och att kalla ett API ”RESTful” betyder inte att det fullt ut följer Fieldings ursprungliga begränsningar — oftast betyder det bara att API:et använder resurs-URL:er och HTTP-metoder. Glappet mellan ”REST-liknande” och ”verkligt RESTful” är en av de största källorna till förvirring i branschen, och vi går igenom det strax.
De 6 kännetecknen för REST API:er i korthet
Innan vi går på djupet får du här en snabb överblick. Fielding definierade 6 begränsningar som ett API bör följa för att räknas som RESTful. Fem är obligatoriska; en är valfri.
| Begränsning | Grundidé | Viktig fördel | Konkrekt exempel |
|---|---|---|---|
| Klient-server | Separera gränssnitt från datalagring | Frontend och backend kan utvecklas oberoende | React SPA som anropar ett REST API |
| Tillståndslös | Varje begäran innehåller allt som behövs | Horisontell skalning, ingen sessionsbindning | Autentiseringstoken skickas i varje begärans header |
| Cachebar | Svar talar om huruvida de får cachelagras | Lägre latens och mindre belastning på servern | Cache-Control: max-age=3600 i ett GET-svar |
| Enhetligt gränssnitt | Standardiserad interaktion med resurser | Förutsägbart och lätt att lära sig API-gränssnitt | GET /users/42, DELETE /users/42 |
| Skiktat system | Klienten kan inte avgöra om den pratar direkt med servern | Möjliggör CDN, gateway och lastbalanserare | Klient → CDN → API Gateway → Appserver |
| Kod på begäran (valfri) | Servern kan skicka körbar kod för att utöka klienten | Utökad klientfunktionalitet vid behov | API som returnerar ett JavaScript-widgetsnutt |
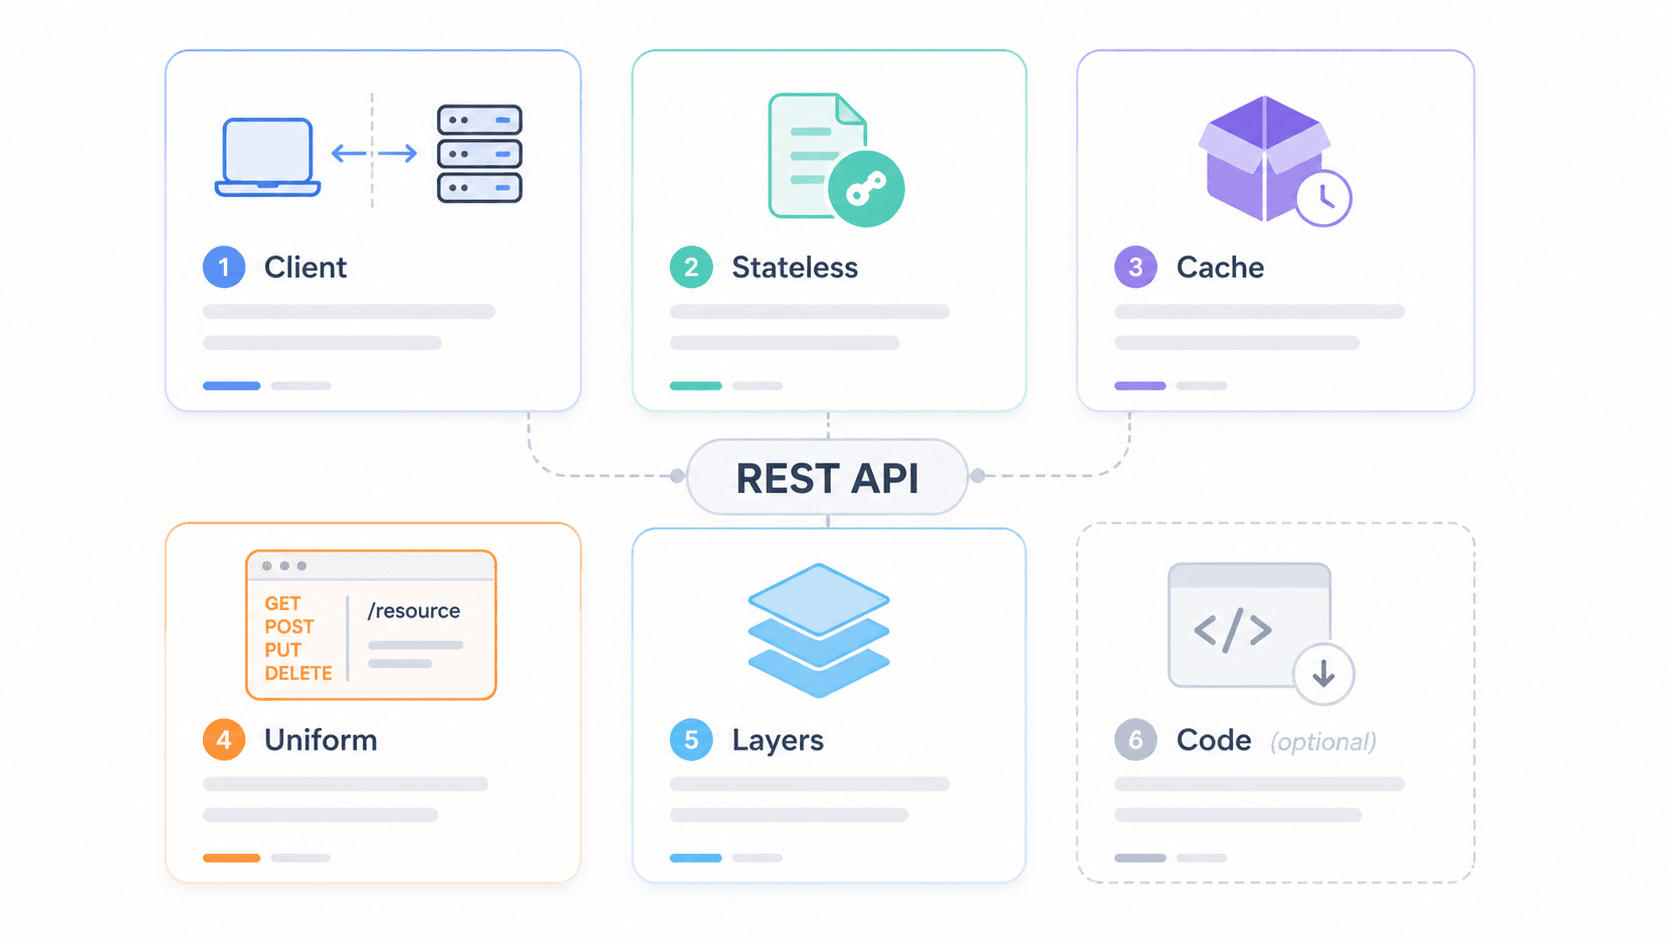
För att visualisera hur dessa begränsningar samverkar i ett verkligt system kan du tänka dig den här skiktade arkitekturen:
Klient / Mobilapp
        ↓
CDN / Edge-cache (t.ex. Cloudflare)
        ↓
API Gateway (rate limiting, auth, CORS)
        ↓
Lastbalanserare
        ↓
Applikationsservrar
        ↓
Databas / interna tjänster
Klienten pratar bara med CDN-lagret. Den har ingen aning om hur många lager som finns bakom. Det är den skiktade systembegränsningen i praktiken — och det är också där säkerhet, cachelagring och skalning sker utan att klienten behöver veta något.
Nu till den mer detaljerade genomgången.
Egenskaper hos REST API:er förklarade, en för en
Klient-server-separation
Fieldings första begränsning: klienten (det användarna interagerar med) och servern (där data finns och logik körs) måste vara separata. Han kallade det separation of concerns.
Varför spelar det någon roll i praktiken? För att det betyder att en mobil bankapp kan få en total visuell omdesign utan att banken rör sin kontodatabas eller transaktionsmotor. Salesforce Marketing Cloud REST API exponerar till exempel kontakter, kampanjer, journeys och pushnotiser via resursendpoints. Oavsett om du bygger en anpassad dashboard, en mobilapp eller kopplar in ett tredjepartsverktyg, förblir backend densamma.
För affärsteam innebär det snabbare iteration. Dina frontend-designers och backend-utvecklare behöver inte följa samma releasecykel. Så länge API-kontraktet är stabilt kan båda sidor röra sig oberoende.
Tillståndslöshet
Inget minne mellan begäranden. Varje anrop från klient till server måste innehålla all information som servern behöver för att behandla det — servern behåller inget från tidigare interaktioner.
Jag brukar se det som att ringa en supportlinje där du måste förklara ditt problem från början varje gång. Irriterande? Absolut. Men fördelen är enorm: vilken som helst tillgänglig handläggare kan hjälpa dig, och callcentret kan lägga till 500 fler handläggare utan att behöva designa om något. Det är horisontell skalning.
Tekniskt sett betyder tillståndslöshet att det inte finns några sticky sessions. En lastbalanserare kan routa din nästa begäran till vilken frisk server som helst. Om en server kraschar tar en annan över utan att tappa tempo. Fieldings avhandling påpekar uttryckligen att tillståndslöshet förbättrar insynen (övervakningsverktyg kan förstå varje begäran isolerat), tillförlitligheten (fel korrumperar inte delat sessionsstate) och skalbarheten (servrar kan frigöra resurser mellan begäranden).
Den praktiska brasklappen: verkliga system har fortfarande autentiseringstoken, kundvagnar och OAuth-flöden. Poängen är inte att inget state finns någonstans — utan att servern inte lagrar klientens sessionsstate i sitt eget minne mellan begäranden. Det hanteras istället av token, databaser och delade cacheminnen.
Cachebarhet
Kan det här svaret återanvändas? Det är frågan som cachebarhet besvarar. Svar bör tydligt ange om de får cachelagras, och i så fall återanvänder klienter och mellanhänder (som CDN:er) dem för motsvarande framtida begäranden — vilket minskar belastningen på servern och förbättrar hastigheten.
HTTP-mekanismen är enkel: headers som Cache-Control, ETag, Last-Modified och Expires berättar för cacheminnen hur länge ett svar är giltigt och när det ska kontrolleras igen. För en affärsläsare kan du tänka på det som en etikett på svaret som säger ”det här svaret duger i en timme” eller ”fråga mig alltid på nytt”.
Prestandaeffekten är verklig. Cloudflares Regional Tiered Cache rapporterade 50–100 ms bättre svarstid i cacheträffar i svansen. Och Fieldings egen avhandling dokumenterar hur webtrafiken ökade från 100 000 begäranden per dag 1994 till 600 000 000 per dag 1999 — där cachelagring var en avgörande designfaktor.
Vanligtvis cachebart: produktkataloger, offentligt blogginnehåll, lands- och valutalistor, API-dokumentation.
Vanligtvis inte cachebart: personliga dashboards, kassasummor, banksaldon, administrativa rapporter.
Enhetligt gränssnitt
Det här är den begränsning som Fielding själv kallade den centrala egenskapen som skiljer REST från andra arkitekturstilar. Den standardiserar hur klienter interagerar med resurser, vilket gör API:er förutsägbara.
Fyra delbegränsningar ingår här:
- Resursidentifiering: Varje resurs får en stabil URI.
/customers/123är en kund./orders/456är en order. - Manipulation genom representationer: Klienter arbetar med representationer (JSON, XML, HTML) av resurser, inte med serverns interna objekt.
- Självbeskrivande meddelanden: Begäranden och svar innehåller tillräckligt med metadata — metod, statuskod, innehållstyp, felinformation — för att alla mellanhänder eller klienter ska kunna förstå dem.
- HATEOAS (Hypermedia as the Engine of Application State): Svar innehåller länkar till relaterade åtgärder och resurser, så att klienter kan upptäcka vad de ska göra härnäst utan att hårdkoda varje endpoint.
Mappningen mellan HTTP-metoder är den mest synliga delen av ett enhetligt gränssnitt:
| HTTP-metod | CRUD-betydelse | Säker? | Idempotent? | Exempel |
|---|---|---|---|---|
| GET | Läsa | Ja | Ja | GET /products/42 |
| POST | Skapa / åtgärd | Nej | Nej | POST /orders |
| PUT | Ersätta hela resursen | Nej | Ja | PUT /users/42 |
| PATCH | Partiell uppdatering | Nej | Inte garanterat | PATCH /users/42 |
| DELETE | Radera | Nej | Ja | DELETE /sessions/abc |
Google Clouds HTTP-riktlinjer säger uttryckligen att GET ska vara säker, och att GET, PUT och DELETE ska vara idempotenta. Välkända API:er från GitHub, Stripe och Spotify följer dessa mönster nära, vilket är anledningen till att utvecklare som lär sig ett lätt kan plocka upp ett annat.
Skiktat system
Din klient har ingen aning om den pratar med origin-servern, en CDN-cache, en API gateway eller en lastbalanserare. Och det är hela poängen — varje komponent ser bara sitt närliggande lager.
Detta gör det möjligt med:
- CDN:er som Cloudflare framför ditt API för att cachelagra och snabba upp svar
- API gateways (AWS API Gateway, Kong, Apigee) som hanterar autentisering, rate limiting och kvoter
- Lastbalanserare som fördelar tillståndslösa begäranden över flera appservrar
Postmans rapport 2025 noterar att 47 % av organisationerna använder AWS API Gateway, 26 % använder Azures gateway och 31 % använder flera gateways samtidigt. Skiktad arkitektur är inte teoretisk — det är så produktionssystem faktiskt fungerar.
Avvägningen: varje lager lägger till lite latens. Men Fielding menade att delad cachelagring i mellanskikten mer än väl kompenserar för den overheaden i de flesta verkliga system.
Kod på begäran (valfritt)
Det här är udda fågeln. Kod på begäran är den enda valfria REST-begränsningen: servern kan skicka körbar kod — som JavaScript — för att utöka klientens funktionalitet dynamiskt.
Det vanligaste verkliga exemplet är helt enkelt att en webbsida laddar JavaScript från en server. Men för typiska JSON-baserade REST API:er som används av mobilappar, backend-jobb eller automatiseringsverktyg används kod på begäran nästan aldrig. API-klienter vill i regel inte köra godtycklig kod från en fjärrserver.
För de flesta läsare är den här begränsningen en fotnot. Den finns i Fieldings modell för fullständighetens skull, men den påverkar inte dina dagliga API-bedömningar särskilt mycket.
Vad de flesta gör fel: Är de flesta REST API:er egentligen RESTful?
Här kommer delen som ingen riktigt vill prata om: de flesta produktions-API:er som kallar sig ”RESTful” är egentligen HTTP-JSON-API:er med REST-liknande konventioner. De använder resurs-URL:er, HTTP-metoder och statuskoder — och det är ungefär det. En tråd på Reddit i r/softwarearchitecture hade utvecklare som medgav att de aldrig byggt ett riktigt Fielding-kompatibelt REST API. En annan diskussion i r/learnprogramming spårade ur i argument om huruvida någon ens kan enas om vad ”RESTful” betyder.
En studie från 2026 som intervjuade 16 experter på REST API:er visade att även om riktlinjer förbättrar användbarheten så visar utvecklare ett tydligt motstånd mot strikta REST-regler — de hänvisar till riktlinjernas omfattning och dåliga passform för den egna organisationen som hinder.
Så var hamnar begränsningarna i praktiken?
| Begränsning | Användning i praktiken | Varför |
|---|---|---|
| Klient-server | ✅ Nästan universell | Grundläggande för webbarkitektur; svår att undvika |
| Tillståndslöshet | ✅ Nästan universell | Krävs för horisontell skalning; standardpraxis |
| Enhetligt gränssnitt (grundnivå) | ✅ Vanligt | Resurs-URI:er + HTTP-verb är standardmönstret |
| Cachebarhet | ⚠️ Inkonsekvent | Många team hoppar helt över Cache-Control-headers |
| Skiktat system | ⚠️ Underförstått | CDN:er och gateways finns, men är inte alltid medvetet designade |
| HATEOAS | ❌ Sällsynt | De flesta klienter hårdkodar endpoints; länkbaserad upptäckt tillför komplexitet |
| Kod på begäran | ❌ Mycket sällsynt | Valfri per definition; implementeras nästan aldrig i JSON API:er |
Varför team hoppar över HATEOAS: Klientutvecklare föredrar att läsa OpenAPI-dokumentation och använda SDK:er framför att dynamiskt följa länkar i runtime. HATEOAS kräver stabila mediatyper, definitioner av länkrelationer och modellering av arbetsflöden — den kortsiktiga kostnaden är hög, och nyttan är oklar för de flesta team.
Det pragmatiska slutsatsen: ett API behöver inte vara 100 % Fielding-kompatibelt för att vara användbart. Men att veta vilka begränsningar du har valt bort — och vad du förlorar genom att välja bort dem — hjälper dig att fatta bättre design- och integrationsbeslut.
Richardson-mognadsmodellen: Hur RESTful är egentligen ditt API?
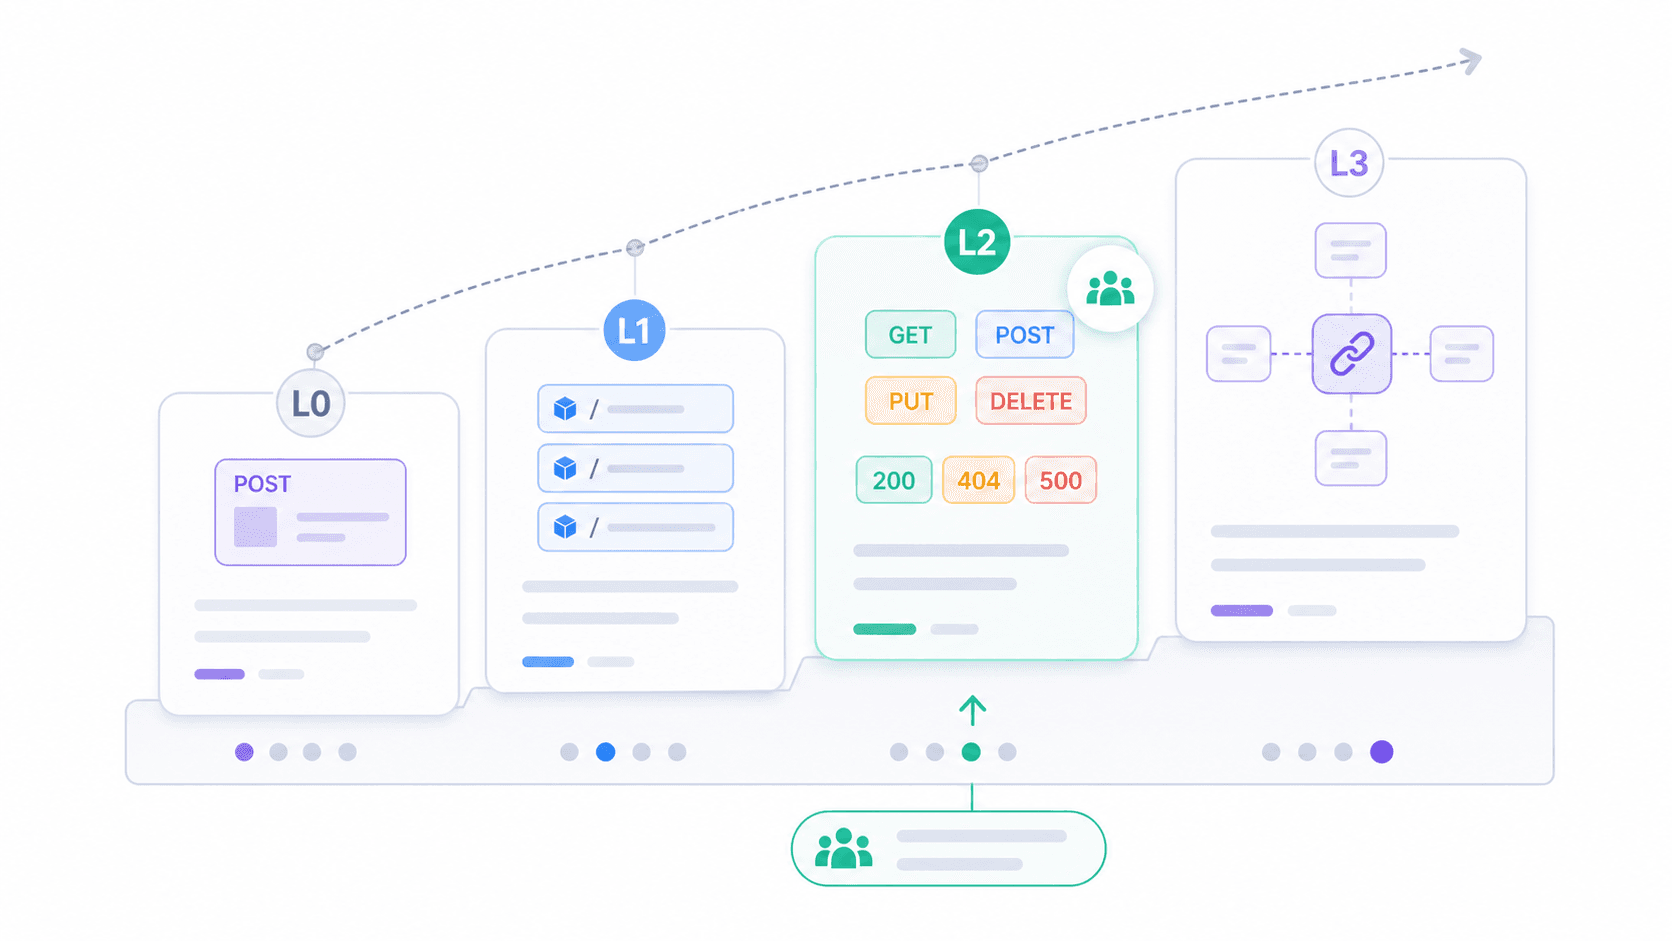
Om den binära frågan ”är det RESTful eller inte?” känns otymplig erbjuder Richardson-mognadsmodellen ett mer praktiskt ramverk. Den föreslogs av Leonard Richardson och förklaras av Martin Fowler, och delar upp REST-användning i fyra nivåer.
| Nivå | Namn | Beskrivning | Exempel från verkligheten |
|---|---|---|---|
| 0 | POX-träsket | En enda URI, ett enda HTTP-verb (vanligtvis POST) | Äldre SOAP-över-HTTP-endpoints; POST /api med { "action": "getUser" } |
| 1 | Resurser | Flera URI:er (en per resurs), men fortfarande mest POST | POST /users/123/getProfile, POST /orders/456/cancel |
| 2 | HTTP-verb | Korrekt användning av GET, POST, PUT, DELETE + rätt statuskoder | De flesta produktions-”REST”-API:er i dag |
| 3 | Hypermedia (HATEOAS) | Svar innehåller länkar till relaterade åtgärder/resurser | Spring Data REST, HAL-baserade API:er; mycket få publika API:er i praktiken |
De flesta API:er du möter i verkligheten ligger på Nivå 2. De använder resurser, verb och statuskoder på rätt sätt. Det räcker för att vara praktiskt, interoperabelt och välstödd av verktyg. Nivå 3 är Fieldings fulla vision, men adoptionen är fortfarande låg.
Var ligger ditt API? Fråga dig själv:
- Har API:et en enda endpoint för allt? (Nivå 0)
- Har varje affärsobjekt sin egen URI? (Nivå 1+)
- Används HTTP-metoder och statuskoder korrekt? (Nivå 2)
- Berättar svaren vad klienten kan göra härnäst, utan att förlita sig på extern dokumentation? (Nivå 3)
Den här modellen är det i särklass mest användbara verktyg jag har hittat för att skära igenom debatten om ”är det REST eller inte”. Den ersätter ett binärt omdöme med ett spektrum.
Vanliga misstag med REST API:er (och hur du undviker dem)
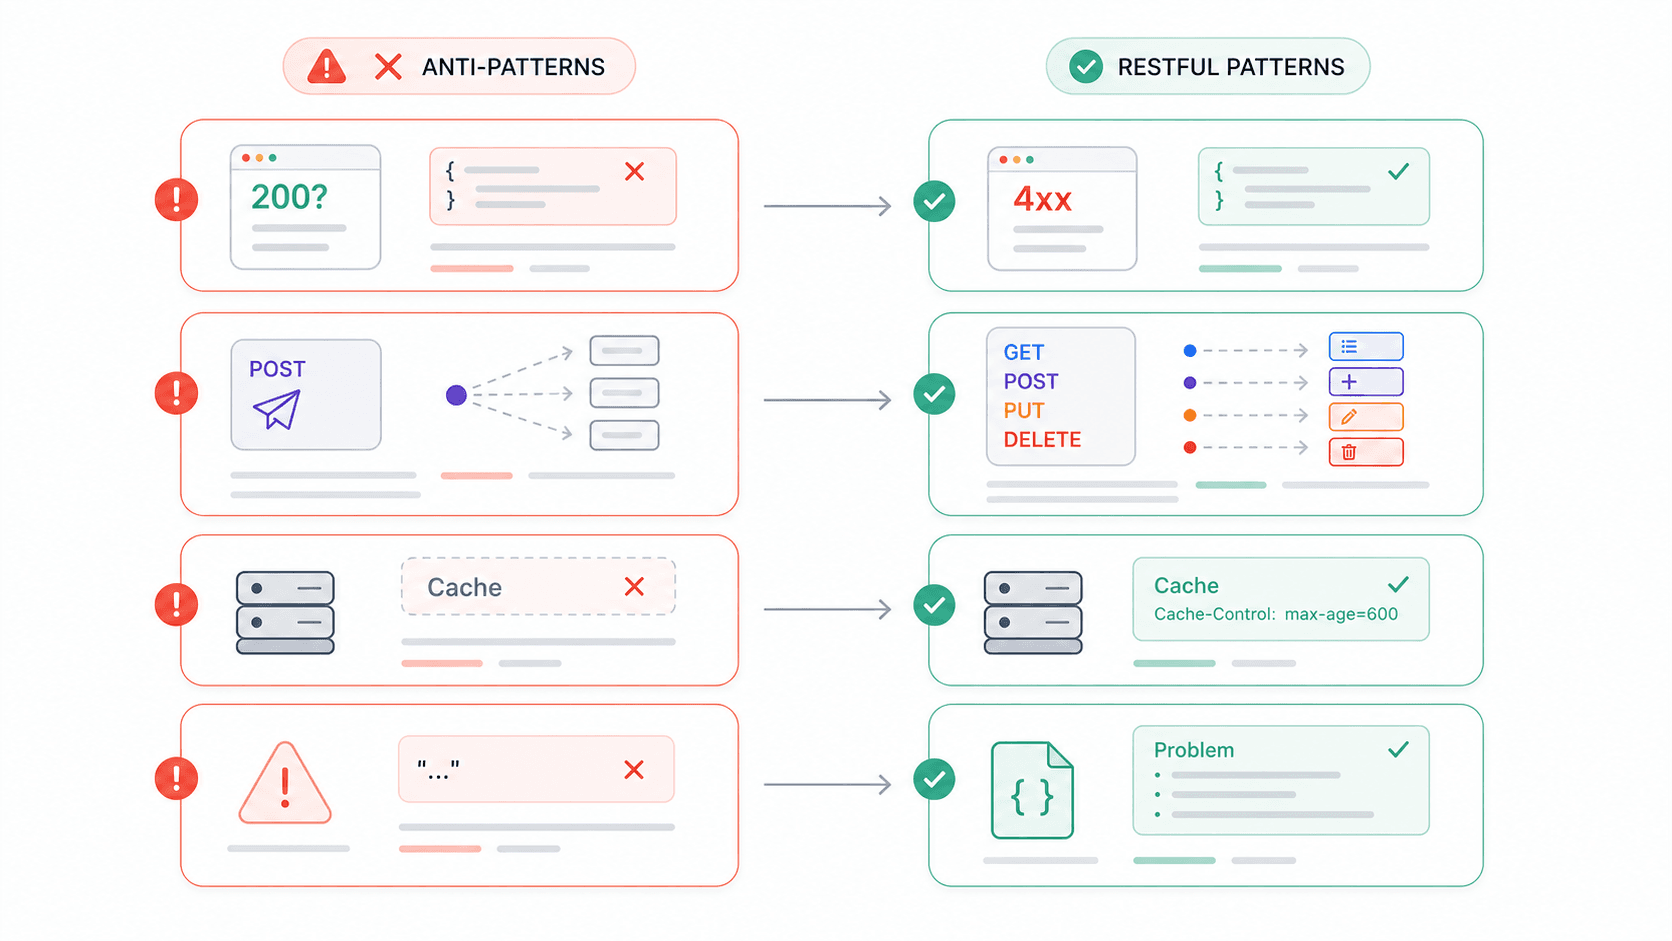
Jag har lagt tillräckligt mycket tid på att integrera tredjeparts-API:er för att ha en lång lista med irritationsmoment. Och utifrån utvecklarforum är jag långt ifrån ensam. Här är de anti-patterns som dyker upp oftast — och varje punkt mappar direkt till ett brott mot en REST-begränsning.
| Anti-pattern | Varför det bryter mot REST | Vad du ska göra istället |
|---|---|---|
HTTP 200 med fel i kroppen ({ "error": "Ogiltigt användarnamn" }) | Bryter mot självbeskrivande meddelanden; klienter kan inte lita på statuskoder | Använd lämpliga 4xx/5xx-koder + ett strukturerat felobjekt (t.ex. application/problem+json) |
| POST för allt | Ignorerar ett enhetligt gränssnitt; förlorar safe/idempotent-semantik | Mappa CRUD till GET/POST/PUT(PATCH)/DELETE |
Inga Cache-Control-headers | Utnyttjar inte cachebarheten alls | Sätt explicita cachedirektiv — även no-store för känslig data |
| Otydliga felmeddelanden (”409 error”) | Människor och maskiner kan inte avgöra vad som gick fel | Inkludera feltyp, läsbart meddelande och en länk till dokumentationen |
| Ingen HTTPS-tvingning | Bearer-token och API-nycklar skickas i klartext | Tvinga TLS överallt; Google APIs är HTTPS-only som standard |
| Versionering i request body | Bryter resursidentifiering; gateways och cacheminnen kan inte routa korrekt | Använd versionering i URI-sökväg (/v1/) eller versionering via Accept-header |
Zalandos RESTful API Guidelines kräver officiella HTTP-statuskoder och rekommenderar Problem JSON för felmeddelanden. Adidas API Guidelines anger att Problem Detail bara ska användas för 4xx/5xx, aldrig blandas med 2xx. Det här är inte akademiska preferenser — det är produktionsstandarder från team som driver API:er i stor skala.
En tråd på Reddit i r/learnprogramming hade en utvecklare som på fullt allvar frågade om det är okej att alltid returnera HTTP 200 för fel. Att den frågan fortfarande dyker upp 2026 visar hur seglivade dessa anti-patterns är.
REST vs SOAP vs GraphQL vs gRPC: Hur REST API-egenskaper jämförs
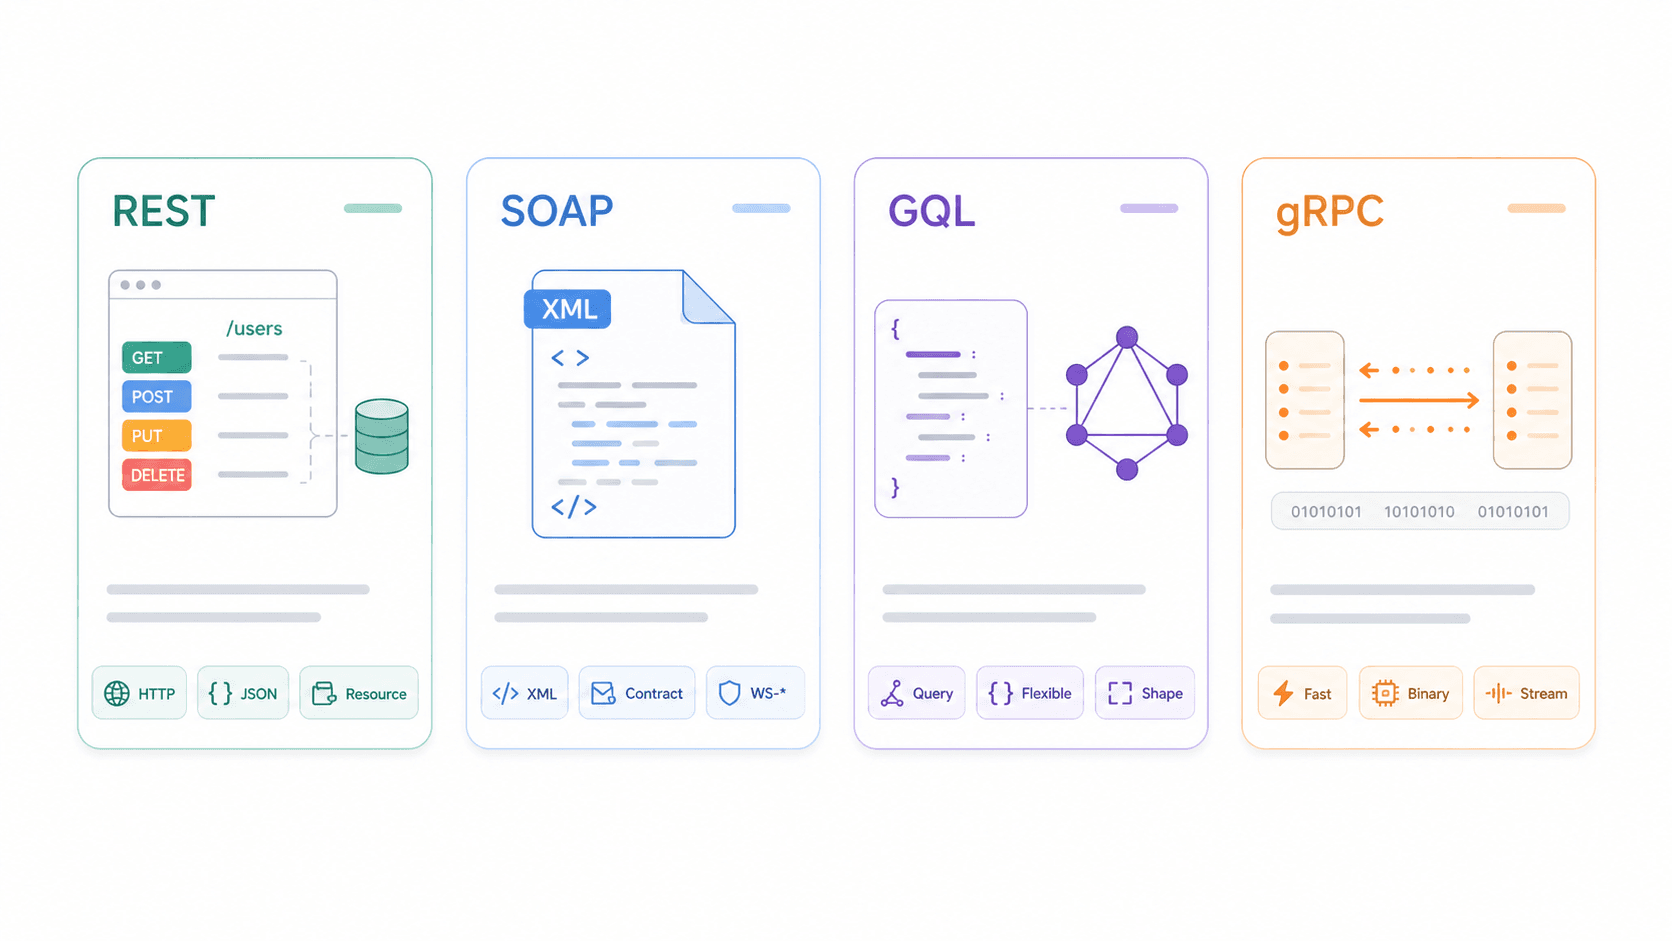
Att förstå REST isolerat är användbart. Att förstå det i relation till alternativen är bättre.
| Dimension | REST | SOAP | GraphQL | gRPC |
|---|---|---|---|---|
| Protokoll / transport | Arkitektonisk stil, vanligtvis HTTP | XML-baserat meddelandeprotokoll; HTTP, SMTP osv. | Frågespråk/runtime, vanligtvis över HTTP | RPC-ramverk över HTTP/2 |
| Dataformat | JSON (vanligtvis), även XML/HTML | Endast XML (WSDL-kontrakt) | JSON som matchar frågans form | Protocol Buffers (binärt) |
| Cachelagring | ✅ Inbyggd HTTP-cachelagring när det designas väl | ❌ Komplex; inte vänligt mot HTTP-cache | ⚠️ Svårare (POST + en endpoint + varierande frågor) | ❌ Inte byggt för HTTP-cache |
| Stöd för realtid | ❌ Polling/webhooks | ❌ Enterprise-meddelandemönster | ✅ Subscriptions | ✅ Streaming, låg latens |
| Inlärningskurva | Låg till medelhög | Hög | Medel | Medel till hög |
| Bäst för | Publika API:er, CRUD, web-/mobilintegrationer | Enterprise/legacy, strikta kontrakt, compliance | Komplexa frågor, flexibla frontend-lösningar, mobilappar | Kommunikation mellan mikrotjänster, intern hög prestanda |
Postmans jämförelse av API-arkitekturstilar rekommenderar att man väljer utifrån kompatibilitet, datamodell, operationer och användarens verktyg.
När du ska välja vad:
- REST vinner när du behöver bred kompatibilitet, enkla CRUD-operationer och HTTP-cachelagring. Det är standardvalet för publika API:er och web-/mobilintegrationer.
- SOAP är fortfarande rimligt för företagsystem med strikta kontrakt, WS-Security-krav eller äldre integrationer som inte försvinner i första taget.
- GraphQL glänser när frontend behöver flexibla, nästlade frågor och du vill undvika att hämta för mycket eller för lite data — vanligt i komplexa mobilappar.
- gRPC är byggt för intern kommunikation mellan mikrotjänster där låg latens och binär serialisering är viktigare än webbläsarkompatibilitet.
Som ett verkligt REST-exempel använder Thundersbids Open API enkla POST-endpoints (/distill och /extract), JSON-baserade request- och response bodies, bearer token-autentisering och standardiserade HTTP-statuskoder (400, 401, 402, 408, 422, 429, 500, 502, 503, 504). Det visar REST-egenskaper i en skarp AI-produkt utan att kräva SOAP-kontrakt eller gRPC-komplexitet. Inte ett HATEOAS-vitrinskåp — men ett praktiskt Level 2-API som är lätt för affärsteam och utvecklare att integrera.
Varför REST API-egenskaper spelar roll för affärsteam
Sälj, drift, e-handel — inget av de här teamen skriver API-kod. Men ni väljer leverantörer, kopplar ihop verktyg och bygger automatiserade arbetsflöden — och kvaliteten på REST API:er påverkar direkt hur smärtsamma de integrationerna blir.
Verktygsintegrationer: När ditt CRM synkas med en marketing automation-plattform avgör designen av REST API:et om synken blir stabil eller skör. Salesforce Marketing Cloud REST API hanterar kontakter, kampanjer, journeys och pushnotiser genom förutsägbara resursendpoints. Om de följer REST-konventioner kan ditt RevOps-team automatisera utan speciallösningar.
E-handelsdrift: Shopifys fulfillment-resurser i REST hanterar leveransordrar, spårningsnummer och leveransstatus. Fraktappar och fulfillment-verktyg är beroende av det lagret. När API:et är väl utformat — rätt statuskoder, cachebar katalogdata, tydliga felmeddelanden — flyter logistikflödet på. När det inte är det får du mystiska fel klockan 02.00.
Utvärdera leverantörer: Att känna till de 6 begränsningarna ger dig en praktisk checklista:
- Använder API:et standardstatuskoder, eller ser varje fel ut som 200 OK?
- Är felen specifika nog för att ditt automationsverktyg ska kunna återhämta sig?
- Finns tydlig dokumentation för rate limits, paginering och autentisering?
- Kan vanliga svar cachelagras för att minska belastningen?
Datautvinning och automation: Verktyg som Thunderbit använder REST-baserad arkitektur för att låta affärsanvändare extrahera strukturerad data från webbplatser, PDF:er och bilder — och sedan exportera till Google Sheets, Airtable, Notion eller Excel. Thundersbits AI Web Scraper Chrome-tillägg hanterar komplexiteten bakom ett gränssnitt med 2 klick, men under huven är det REST-principer — tillståndslösa begäranden, JSON-svar, standardiserade fel — som gör integrationslagret tillförlitligt.
En ytterligare datapunkt som är värd att lyfta: Postmans rapport 2025 visade att bara 24 % av utvecklarna aktivt designar API:er med AI-agenter i åtanke, medan 51 % oroar sig för obehöriga eller för många API-anrop från AI-agenter. När automation och AI-drivna arbetsflöden blir standard i affärsteam är förutsägbara REST-mönster, API-nycklar med minsta möjliga behörighet och rate limits inte bara en utvecklarfråga — det är en operativ riskfaktor.
Hur Thunderbit använder REST-principer för affärsanvändare
Vi byggde Thunderbit med antagandet att de flesta av våra användare aldrig skulle läsa en REST-specifikation — och inte borde behöva det heller. Men de designval som gör Thunderbit enkelt att använda bygger på samma REST-egenskaper som den här artikeln handlar om.
Här är en snabb genomgång av hur det fungerar i praktiken:
- Installera Chrome-tillägget från Chrome Web Store och öppna valfri webbplats, PDF eller bild som du vill extrahera data från.
- Klicka på ”AI Suggest Fields” och Thundersbits AI läser sidan och föreslår en strukturerad tabell med kolumner — produktnamn, priser, mejl, vad som än finns på sidan.
- Justera kolumnerna vid behov, och klicka sedan på ”Scrape”. Thunderbit hanterar paginering, undersidor och dynamiskt innehåll automatiskt.
- Exportera din data till Google Sheets, Airtable, Notion, CSV eller Excel — gratis, utan betalvägg.
För utvecklare och automationsflöden exponerar Thundersbits Open API /distill (ren Markdown-extraktion) och /extract (strukturerad dataextraktion) som REST-liknande POST-endpoints med JSON-bodies och standardiserade HTTP-felkoder. Sett med Richardson-mognadsmodellen är det ett stabilt Level 2 — resurser, rätt metoder, meningsfulla statuskoder.
Om du utforskar web scraping eller dataextraktion mer generellt har vi skrivit fördjupande guider om AI web scraping, web scraping utan kodning och vad web scraping faktiskt är.
Viktiga slutsatser
- REST är en arkitektonisk stil, inte ett protokoll. Den definierar 6 begränsningar — klient-server, tillståndslös, cachebar, enhetligt gränssnitt, skiktat system och valfri kod på begäran — som styr API-design.
- De flesta ”RESTful” API:er är inte fullt RESTful. Majoriteten ligger på Richardson Level 2 (resurser + HTTP-verb + statuskoder). HATEOAS och kod på begäran implementeras sällan.
- Richardson-mognadsmodellen är det bästa verktyget för självbedömning. Den ersätter den binära frågan ”REST eller inte” med ett praktiskt spektrum (nivå 0–3).
- Vanliga misstag — 200 OK för fel, POST för allt, saknade cache-headers — är fortfarande vanliga. Att känna till begränsningarna hjälper dig att upptäcka och rätta till dessa anti-patterns.
- REST vs SOAP vs GraphQL vs gRPC handlar inte om ”bäst” — det handlar om passform. REST dominerar publika API:er och CRUD-integrationer. GraphQL passar komplexa frontend-lösningar. gRPC utmärker sig i interna mikrotjänster. SOAP lever kvar i enterprise- och legacy-miljöer.
- Affärsteam tjänar på att förstå REST-egenskaper när de utvärderar leverantörer, kopplar ihop verktyg och bygger automationsflöden. Verktyg som Thunderbit tillämpar REST-principer för att göra dataextraktion tillgänglig utan teknisk expertis.
Vanliga frågor
Vilka är de 6 egenskaperna hos ett REST API?
De 6 REST-begränsningarna är: (1) klient-server-separation, (2) tillståndslöshet, (3) cachebarhet, (4) enhetligt gränssnitt, (5) skiktat system och (6) kod på begäran (valfritt). De första fem är obligatoriska för att ett API ska räknas som RESTful enligt Fieldings ursprungliga definition.
Vad är skillnaden mellan REST och RESTful?
REST är den arkitektoniska stilen — uppsättningen designbegränsningar som definierats av Roy Fielding. ”RESTful” beskriver ett API som följer de begränsningarna. I praktiken följer många API:er som kallas ”RESTful” bara delar av detta och implementerar vanligtvis resurser, HTTP-metoder och statuskoder, men hoppar över HATEOAS och kod på begäran.
Följer alla REST API:er varje REST-begränsning?
Nej. De flesta produktions-API:er följer klient-server-separation, tillståndslöshet och ett grundläggande enhetligt gränssnitt (resurser + HTTP-verb). Cachebarhet och skiktad systemdesign implementeras inkonsekvent. HATEOAS är sällsynt, och kod på begäran används nästan aldrig i JSON API:er.
Vad är skillnaden mellan REST och GraphQL?
REST exponerar resurser genom flera endpoints med standardiserade HTTP-metoder (GET, POST, PUT, DELETE). GraphQL använder vanligtvis en enda endpoint där klienten anger exakt vilka fält som ska hämtas i en fråga. REST har starkare inbyggd HTTP-cachelagring; GraphQL ger större flexibilitet för komplexa, nästlade databehov och minskar överhämtning.
Vad är HATEOAS, och använder någon det faktiskt?
HATEOAS (Hypermedia as the Engine of Application State) betyder att API-svar innehåller länkar som berättar för klienten vilka åtgärder som finns tillgängliga härnäst — så att klienten kan navigera i API:et utan att hårdkoda varje endpoint. Det är centralt i Fieldings vision av REST (Richardson Level 3), men i praktiken implementerar väldigt få publika API:er det. De flesta team stannar på Level 2 och förlitar sig istället på dokumentation och SDK:er.
Prova Thunderbit för AI-baserad web scraping
Prova Thunderbit för AI-baserad web scraping Get Started Free
Läs mer



