
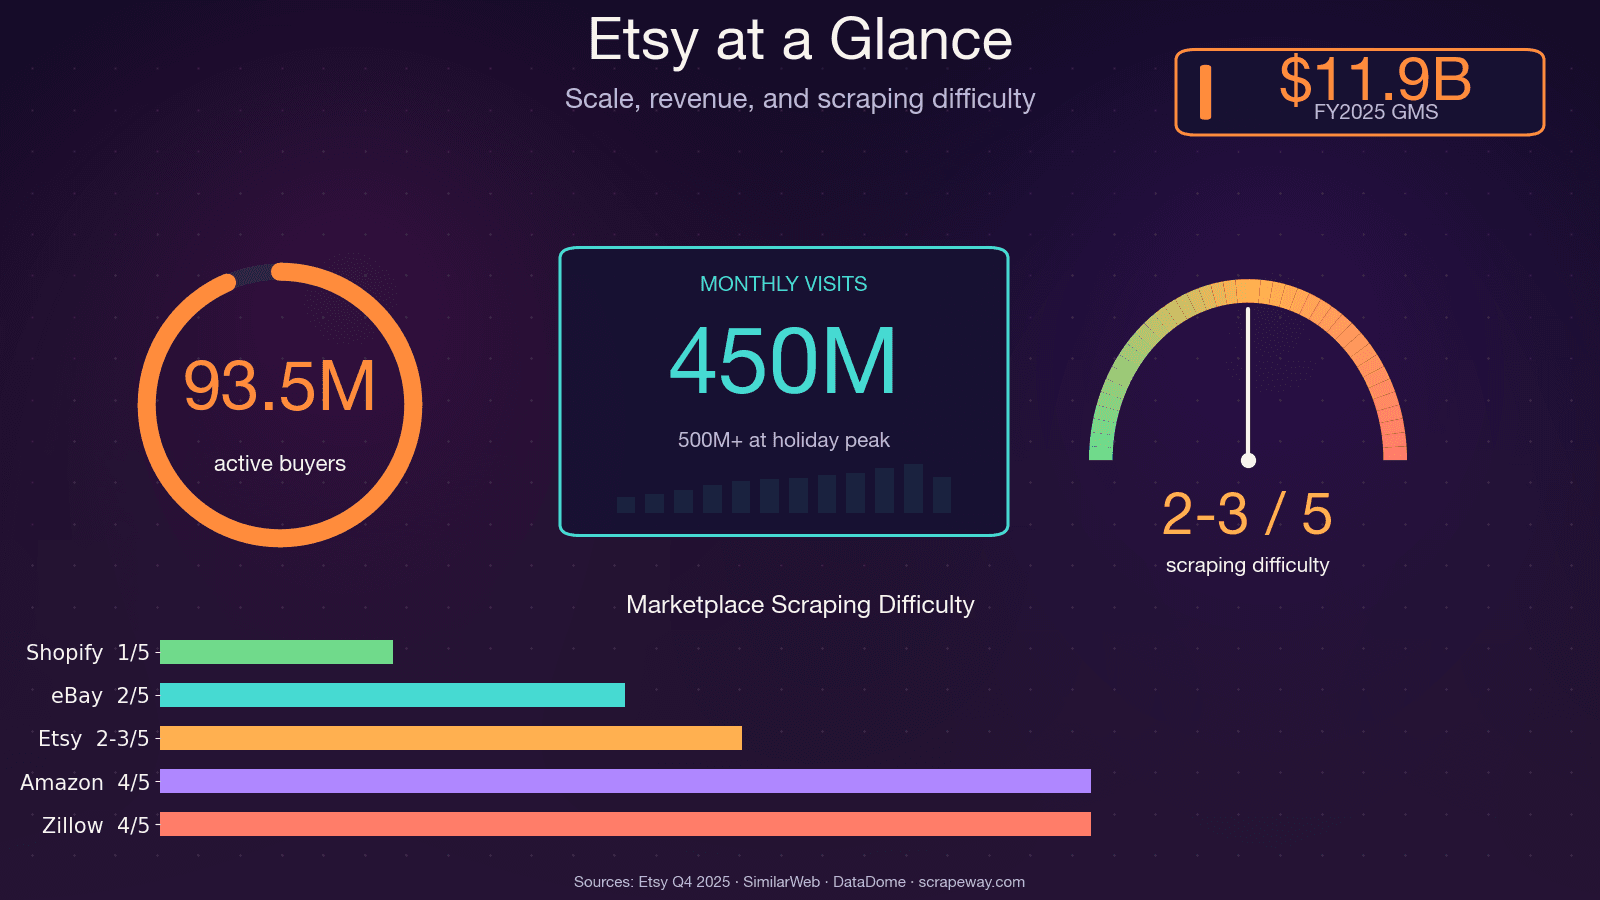
Etsy har över 100 miljoner aktiva listningar, 5,6 miljoner säljare och runt 450 miljoner besök i månaden. Det betyder enorma mängder offentligt tillgänglig data om prissättning, trender, recensioner och konkurrenter — och om du någon gång har försökt samla in den för hand vet du hur segt det är.
Jag har själv suttit en hel helg och manuellt katalogiserat konkurrenters produkter i ett marknadsundersökningsprojekt. Vid produkt nummer 30 började jag ifrågasätta varje livsval som lett mig till det där kalkylbladet. Poängen är att Etsy-data är otroligt värdefull för prisanalys, produktutveckling, nischupptäckt och säljarbenchmarking — men bara om du faktiskt kan hämta den i stor skala. Det är vad den här guiden handlar om: en enda genomgång som visar hur du skrapar Etsy med Python över alla fyra stora sidtyperna (sökresultat, produktsidor, butikssidor och recensioner), plus ärlig vägledning om Etsys anti-bot-skydd och ett kodfritt alternativ för dig som helst vill slippa skript helt.
Vad betyder det att skrapa Etsy med Python?
Webbskrapning betyder, enkelt uttryckt, att skriva kod som besöker webbsidor och automatiskt plockar ut den data du bryr dig om — produktnamn, priser, beskrivningar, bilder, betyg, recensioner, butiksuppgifter — och organiserar allt i ett strukturerat format som ett kalkylblad eller en databas.
Python är förstahandsvalet för just den här typen av arbete. Det är nybörjarvänligt, har en enorm community och erbjuder ett djupt biblioteksekosystem byggt för skrapning: Requests (för att hämta sidor), BeautifulSoup (för att parsa HTML), Selenium och Playwright (för webbläsarautomation) samt pandas (för att organisera och exportera data). Python ligger dessutom stabilt bland de tre mest populära språken i Stack Overflows årliga utvecklarundersökning, och dess skrapbibliotek hör till de mest nedladdade på PyPI.
När du skrapar Etsy hämtar du data från HTML:en (och ibland dold JSON) som Etsy skickar till din webbläsare. Exempel på data du kan extrahera är:
- Produktnamn, priser, beskrivningar, bilder och varianter
- Säljar-/butiksinformation (namn, antal försäljningar, plats, betyg)
- Betyg och fullständig recensionstext
- Listningar i sökresultat, kategorier och trendindikatorer
Varför skrapa Etsy? Verkliga användningsfall som driver ROI
Att skrapa Etsy är inte bara en teknisk övning — det är en konkurrensfördel. Oavsett om du är säljare, produktchef eller dataanalytiker kan strukturerad Etsy-data direkt i händerna påverka resultatet.
| Användningsfall | Vad du skrapar | Vem gynnas | Affärseffekt |
|---|---|---|---|
| Konkurrensanalys av prissättning | Sökresultat + produktpriser | E-handelsdrift, säljare | Dynamisk prissättning kan i snitt öka intäkterna med 5–22% |
| Upptäckt av nischer och trender | Sökresultat, trendande listningar | Grundare, analytiker | Hitta trendande nischer tidigt (t.ex. ökade sökningar för "preppy pajamas" med +1 112 %) |
| Produktutveckling och förbättring | Recensioner, produktdetaljer | Produktteam | Ett köksvarumärke tog tillbaka platsen som #1 bästsäljare på 60 dagar med hjälp av sentimentdata från recensioner |
| SEO och sökordsanalys | Sökresultat, produkttitlar/taggar | Marknadsteam | Identifiera sökord med hög efterfrågan och låg konkurrens |
| Säljarbenchmarking | Butikssidor, antal försäljningar | Säljteam, analytiker | Bygg kvalificerade leadlistor till 0,01–0,10 USD per post jämfört med köpta listor |
| Lager- och tillgänglighetsövervakning | Produkttillgänglighet | E-handelsdrift | Reagera snabbare på konkurrenters lagerförändringar |
Var och en av de här användningarna kräver data från olika Etsy-sidtyper — och just därför täcker den här guiden alla fyra.
Tidsbesparing: manuellt vs. automatiserat
- Manuell Etsy-analys: 30–45 minuter per produkt (50–75 timmar för 100 produkter)
- Automatiserad skrapning: 100 listningar på 2–5 minuter
- AI-driven skrapning är 30–40% snabbare med upp till 99,5% noggrannhet
Etsy API vs. webbskrapning: vilket ska du välja?
Innan du skriver en enda rad kod är det värt att ställa frågan: ska jag använda Etsys officiella API eller skrapa webbplatsen direkt? Det här är en fråga jag ser dyka upp hela tiden i forum, och svaret beror på vilken data du behöver.
Vad Etsy API kan och inte kan göra
Etsy erbjuder API v3 med OAuth 2.0-autentisering. Det fungerar för att komma åt din egen butiks data — listningar, order, kvitton. Men det har tydliga begränsningar:
- Konkurrentdata: API:t är i praktiken begränsat till din egen butik. Du kan inte hämta en annan säljares priser, försäljning eller listningar.
- Recensioner: Det finns ingen robust endpoint för full recensionstext i bulk.
- Hastighetsbegränsningar: 10 förfrågningar/sekund, 10 000 förfrågningar/dag som standard. Offset-gränsen är 12 000 poster.
- AI/ML-användning: Avvisas uttryckligen i appgranskningen.
- Dokumentation: Klagomål från communityn är vanliga — dåliga exempel, föråldrade endpoints, långsam support.
När webbskrapning är bättre
Om du behöver konkurrentinsikter, recensioners sentiment, analys över flera butiker eller data utanför det API:t visar, är skrapning rätt väg. Nackdelen: du möter Etsys anti-bot-skydd (mer om det nedan), och du behöver lägga tid på uppsättning.
Jämförelsetabell: API vs. skrapning vs. kodfritt
| Kriterium | Etsys officiella API | Python-webbskrapning | Thunderbit (kodfritt) |
|---|---|---|---|
| Åtkomst till produktpriser | ✅ (begränsade fält) | ✅ Full HTML/JSON-LD | ✅ AI extraherar alla synliga fält |
| Recensionsdata | ❌ Inte tillgängligt i bulk | ✅ Via reviews-endpoint/HTML | ✅ Skrapning av undersidor |
| Konkurrenters butiksdata | ❌ Endast egen butik | ✅ Alla offentliga butiker | ✅ Alla offentliga butiker |
| Autentisering krävs | ✅ OAuth 2.0 | ⚠️ Cookies för inloggad data | ⚠️ Webbläsarskrapning för inloggning |
| Risk för bot-blockering | Ingen | HÖG (DataDome) | Hanteras (webbläsarnativt) |
| Uppsättningstid | Medel (API-nycklar, OAuth) | Hög (kod + proxies) | ~2 minuter |
Om du behöver konkurrentdata, recensioner eller analys över flera butiker räcker API:t helt enkelt inte till. Det är den ärliga bilden.
Välj din Python-metod för skrapning innan du skriver en rad kod
En fråga jag ser hela tiden på Reddit och Stack Overflow: "Ska jag använda Requests + BeautifulSoup, Selenium, ett proxy-API eller något helt annat?" Rätt svar beror på din kunskapsnivå, budget och användningsfall.
| Metod | Bäst för | Inlärningskurva | Hantera JS? | Anti-bot-hantering | Kostnad |
|---|---|---|---|---|---|
| Requests + BeautifulSoup | Utvecklare som vill ha full kontroll | Medel | ❌ | Manuell (headers, proxies) | Gratis + proxykostnader |
| Selenium / Playwright | JS-tunga sidor, inloggningsflöden | Hög | ✅ | Delvis (webbläsaravtryck) | Gratis + proxykostnader |
| Proxy-API-tjänster | Skala + anti-bot-bypass | Medel | ✅ (via API) | ✅ Inbyggt | Från 49 USD/mån |
| Thunderbit (kodfritt) | Icke-utvecklare, snabb extrahering | Mycket låg | ✅ (webbläsarnativt) | ✅ (webbläsarsession) | Gratis nivå finns |
Om du vill ha full kontroll och är bekväm med Python, välj Requests + BeautifulSoup. Om du behöver JS-rendering eller inloggningsflöden, använd Selenium. Om du vill kringgå anti-bot i stor skala, överväg en proxy-tjänst. Och om du vill ha Etsy-data utan att skriva eller underhålla kod, är Thunderbit värt att titta på — mer om det senare.
Så slår Etsy tillbaka: förstå DataDome-skyddet mot botar
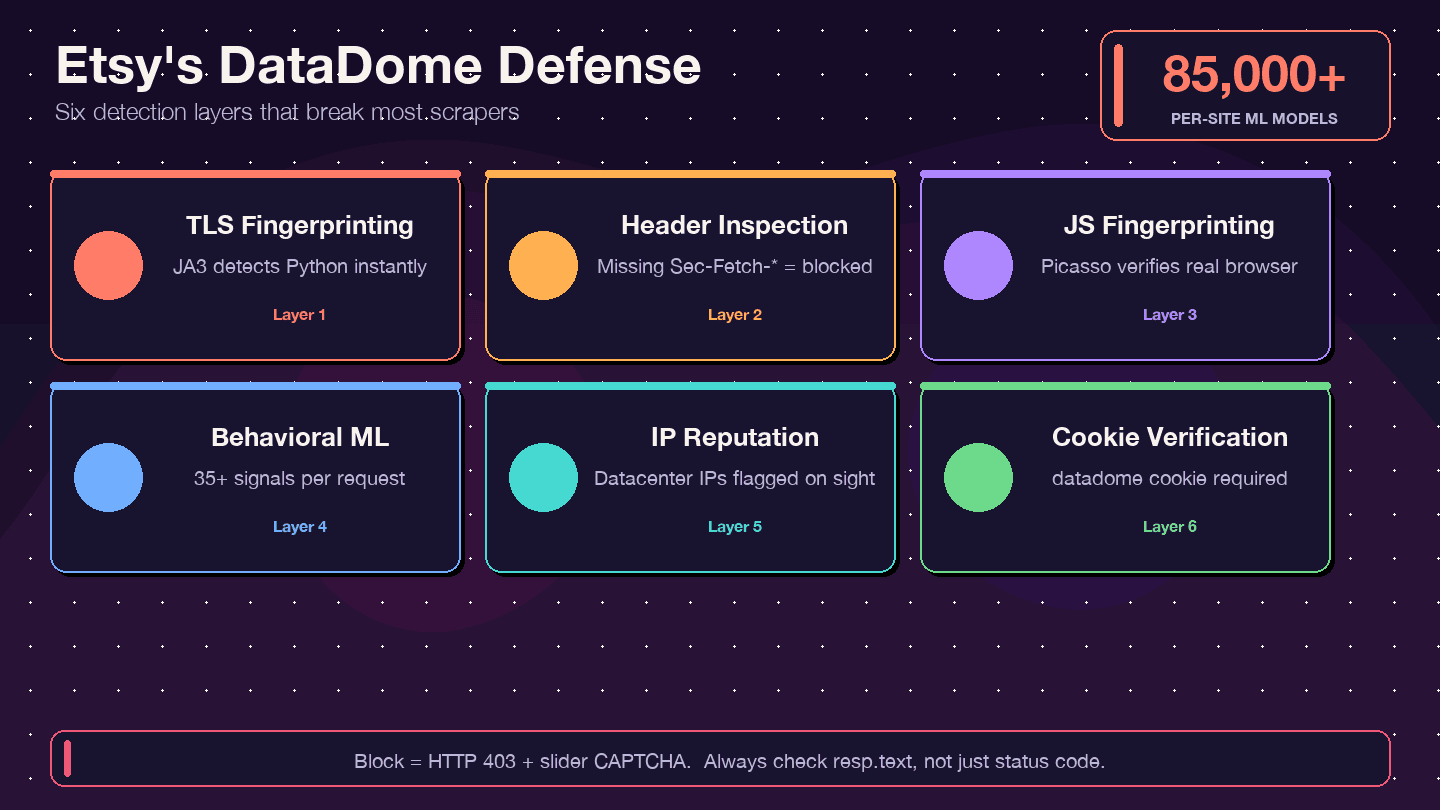
De flesta skrapguider säger bara "använd en proxy" och går vidare. Det räcker inte för Etsy. Etsy använder DataDome, ett av de mest aggressiva anti-bot-systemen på webben. DataDomes egen fallstudie lyfter fram Etsy som en framgångshistoria och noterar att skrapare tidigare stod för cirka 1% av Etsys datorkostnader.
Vad är DataDome och hur fungerar det?
DataDome kontrollerar inte bara din IP-adress. Det kör en detektionsstack i flera lager:
- TLS-fingeravtryck (JA3): Pythons
requests-bibliotek har en distinkt TLS-signatur som DataDome direkt kan känna igen. - Inspektion av HTTP-headers/protokoll: Kontrollerar fullständiga, konsekventa webbläsarheaders — saknade eller felaktigt ordnade headers är en varningssignal.
- JavaScript-fingeravtryck (Picasso-protokollet): Kör JS-utmaningar i webbläsaren för att verifiera att du är en riktig användare.
- Beteendebaserad ML: Analyserar 35+ signaler per begäran, med 85 000+ modeller per webbplats.
- IP-reputationspoäng: Datacenter-IP:er flaggas direkt.
- Cookie-verifiering: Cookien
datadomemåste finnas och vara giltig.
Tecken på att du har blockerats (och hur du kollar)
En av de vanligaste fällorna: du får ett 200 OK-svar, men HTML:en är egentligen en CAPTCHA-sida och inte datan du ville ha. Andra tecken:
- 403 Forbidden-fel
- Omdirigeringsloopar
- Svarstexten innehåller ett
dd-JavaScriptobjekt eller CAPTCHA-HTML med reglage
Granska alltid svarstexten, inte bara statuskoden. En snabb kontroll:
if "captcha" in resp.text.lower() or "datadome" in resp.text.lower():
    print("Blockerad! Fick en CAPTCHA-sida i stället för data.")
Headers och cookies som minskar upptäckt
Du kan inte garantera att du inte blockeras, men realistiska headers och hantering av cookies hjälper långt:
session = requests.Session()
session.headers.update({
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 Chrome/133.0.0.0 Safari/537.36",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8",
    "Accept-Language": "en-US,en;q=0.9",
    "Accept-Encoding": "gzip, deflate, br",
    "Sec-Ch-Ua": '"Chromium";v="133", "Not-A.Brand";v="99", "Google Chrome";v="133"',
    "Sec-Ch-Ua-Mobile": "?0",
    "Sec-Ch-Ua-Platform": '"Windows"',
    "Sec-Fetch-Dest": "document",
    "Sec-Fetch-Mode": "navigate",
    "Sec-Fetch-Site": "none",
    "Upgrade-Insecure-Requests": "1",
})
Viktigt också:
- Behåll cookies mellan förfrågningar med en
requests.Session(). - Lägg in slumpmässiga fördröjningar (2–7 sekunder) mellan förfrågningar.
- Simulera en referenskedja: Besök startsidan först, sedan sök, sedan produktsidor.
- I stor skala är rotation av residential proxies avgörande. Datacenter-IP:er flaggas nästan direkt.
De här teknikerna minskar upptäckten men eliminerar den inte. För skrapning i hög volym behöver du troligen en proxy-tjänst eller ett webbläsarbaserat arbetssätt.
Sätt upp din Python-miljö för att skrapa Etsy
Innan du börjar:
- Svårighetsgrad: Medel
- Tidsåtgång: ~30–60 minuter (uppsättning + första skrapningen)
- Det du behöver: Python 3.8+, pip, en kodredigerare, Chrome-webbläsare (för DevTools-inspektion)
Installera beroenden
Skapa en projektmapp, sätt upp en virtuell miljö och installera de bibliotek du behöver:
mkdir etsy-scraper && cd etsy-scraper
python -m venv venv
source venv/bin/activate  # På Windows: venv\Scripts\activate

pip install requests beautifulsoup4 lxml pandas
- requests — hämtar webbsidor
- beautifulsoup4 — parsar HTML
- lxml — snabbare HTML-parser (valfritt men rekommenderat)
- pandas — strukturerar och exporterar data till CSV/Excel
Om du senare behöver webbläsarautomation (för inloggning eller JS-tunga sidor), installera också:
pip install selenium
Förstå Etsys sidstruktur innan du kodar
Här är ett tips som sparar massor av tid: Etsy bäddar in strukturerad produktdata i <script type="application/ld+json">-taggar på de flesta sidor. Den här JSON-LD-datan är redan organiserad — produktnamn, pris, betyg, bilder — så du slipper brottas med sköra CSS-selektorer för varje fält.
Öppna valfri produktsida på Etsy, högerklicka, välj "Visa sidkälla" och sök efter application/ld+json. Du hittar ett block med @type: Product som innehåller det mesta av datan du behöver. Sökresultatsidor har @type: ItemList.
CSS-selektorer är fortfarande användbara som reservlösning (för data som inte finns i JSON-LD, som fraktuppgifter eller recensionstext), men JSON-LD bör vara din första anhalt.
Steg 1: Skrapa Etsys sökresultat med Python
Sökresultat är startpunkten för de flesta Etsy-skrapningsprojekt — oavsett om du bevakar en nisch, följer konkurrenters prissättning eller bygger en produktdatabas.
Bygg sök-URL:en
Etsys sök-URL:er följer detta mönster:
https://www.etsy.com/search?q={keyword}&ref=pagination&page={page_number}
För sökningar med flera ord, URL-koda mellanslagen (t.ex. handmade+jewelry eller handmade%20jewelry). Parametern ref=pagination gör att begäran ser mer ut som riktig webbläsarnavigering.
Ytterligare användbara parametrar: order (most_relevant, price_asc, price_desc, date_desc), min_price, max_price, ship_to, free_shipping=true. Varje sida returnerar 48 objekt.
Skicka begäran och parsa HTML
import requests
from bs4 import BeautifulSoup
import json
import time
import random

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 Chrome/124.0.0.0 Safari/537.36",
    "Accept-Language": "en-US,en;q=0.9",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8",
}

def scrape_etsy_search(query, max_pages=3):
    all_products = []
    for page in range(1, max_pages + 1):
        url = f"https://www.etsy.com/search?q={query}&ref=pagination&page={page}"
        resp = requests.get(url, headers=headers, timeout=30)
        if "captcha" in resp.text.lower():
            print(f"Blockerad på sida {page}. Försök lägga till fördröjningar eller proxies.")
            break
        soup = BeautifulSoup(resp.text, "lxml")
        for script in soup.find_all("script", type="application/ld+json"):
            data = json.loads(script.string)
            if data.get("@type") == "ItemList":
                for item in data.get("itemListElement", []):
                    all_products.append({
                        "name": item.get("name"),
                        "url": item.get("url"),
                        "image": item.get("image"),
                        "price": item.get("offers", {}).get("price"),
                        "currency": item.get("offers", {}).get("priceCurrency"),
                        "position": item.get("position"),
                    })
        time.sleep(random.uniform(2, 5))
    return all_products
Extrahera listningsdata från JSON-LD
itemListElement-arrayen ger dig varje listnings namn, URL, bild, pris och valuta. Om du också behöver stjärnbetyg eller antal resultat (inte alltid i JSON-LD), använd CSS-selektorer som reserv:
- Listningskort:
.v2-listing-card - Titel:
h3.v2-listing-card__title - Pris:
span.currency-value - Länk:
a.listing-link(href)
Hantera paginering
Loopa igenom sidorna och lägg in en slumpmässig fördröjning mellan varje förfrågan. Etsy returnerar vanligtvis upp till 20–250 sidor beroende på sökningen.
results = scrape_etsy_search("handmade+jewelry", max_pages=5)
print(f"Skrapade {len(results)} produkter.")
För en skrapning på 5 sidor tog detta ungefär 20 sekunder i mina tester — jämfört med 30+ minuter av manuell kopiera-och-klistra.
Steg 2: Skrapa Etsys produktsidor med Python
När du har en lista med produkt-URL:er från sökningen är nästa steg att hämta detaljerad data från varje listningssida.
Hämta produktsidan
def scrape_etsy_product(url):
    resp = requests.get(url, headers=headers, timeout=30)
    soup = BeautifulSoup(resp.text, "lxml")
    for script in soup.find_all("script", type="application/ld+json"):
        data = json.loads(script.string)
        if data.get("@type") == "Product":
            offers = data.get("offers", {})
            price = offers.get("price") or offers.get("lowPrice")
            rating_data = data.get("aggregateRating", {})
            return {
                "name": data.get("name"),
                "description": data.get("description", "")[:500],
                "brand": data.get("brand", {}).get("name") if isinstance(data.get("brand"), dict) else data.get("brand"),
                "category": data.get("category"),
                "price": price,
                "currency": offers.get("priceCurrency"),
                "availability": offers.get("availability"),
                "rating": rating_data.get("ratingValue"),
                "review_count": rating_data.get("reviewCount"),
                "images": data.get("image", []),
                "sku": data.get("sku"),
                "material": data.get("material"),
            }
    return None
Hantera prisvariationer
Vissa produkter har ett enda offers.price. Andra (med varianter som storlek eller färg) använder offers.lowPrice och offers.highPrice. Koden ovan hanterar båda genom att falla tillbaka från price till lowPrice.
Parsning av extra fält via CSS-selektorer
För data som inte finns i JSON-LD — fraktinformation, variantalternativ, fullständiga säljaruppgifter — behöver du CSS-selektorer:
- Titel:
h1[data-buy-box-listing-title] - Varianter:
select[data-selector-id]ellerdiv[data-option-set] - Frakt:
div.wt-text-captionnära fraktsektionen
Avvägningen: JSON-LD är renare och mer stabilt över layoutändringar. CSS-selektorer är skörare men täcker fler fält.
Steg 3: Skrapa Etsys butikssidor med Python
Det här är avsnittet de flesta konkurrentguider hoppar över helt — och det är kanske det mest värdefulla för säljteam och konkurrensanalytiker.
Bygg butik-URL:en och hämta sidan
def scrape_etsy_shop(shop_name):
    url = f"https://www.etsy.com/shop/{shop_name}"
    resp = requests.get(url, headers=headers, timeout=30)
    soup = BeautifulSoup(resp.text, "lxml")

    # Butiksmetadata från HTML (inte i JSON-LD)
    sales_el = soup.select_one("div.shop-sales-reviews a")
    rating_el = soup.find("input", {"name": "initial-rating"})
    location_el = soup.select_one("div.shop-location")

    shop_data = {
        "name": shop_name,
        "sales": sales_el.text.strip() if sales_el else None,
        "rating": rating_el["value"] if rating_el else None,
        "location": location_el.text.strip() if location_el else None,
    }

    # Listningar från JSON-LD
    listings = []
    for script in soup.find_all("script", type="application/ld+json"):
        data = json.loads(script.string)
        if data.get("@type") == "ItemList":
            for item in data.get("itemListElement", []):
                listings.append({
                    "name": item.get("name"),
                    "url": item.get("url"),
                    "price": item.get("offers", {}).get("price"),
                })
    shop_data["listings"] = listings
    return shop_data
Vad du kan extrahera från butikssidor
JSON-LD på butikssidor är @type: ItemList — det täcker produktlistningarna, men inte metadata på butiksnivå som antal försäljningar, plats eller betyg. För det behöver du CSS-selektorer:
| Datapunkt | Selektor | Kommentar |
|---|---|---|
| Butiksnamn | h1 eller metatitel | Vanligtvis i sidtiteln |
| Totalt antal försäljningar | div.shop-sales-reviews a | Text som "12 345 sales" |
| Stjärnbetyg | Värdet i input[name="initial-rating"] | Numeriskt 1–5 |
| Plats | div.shop-location | Stad, land |
| Medlem sedan | div.shop-info | Datumtext |
Butiksdata är särskilt värdefull för att bygga leadlistor, benchmarka konkurrenter eller identifiera toppsäljare i en nisch.
Steg 4: Skrapa Etsy-recensioner med Python
Recensioner är bland de mest värdefulla — och knepigaste — datapunkterna på Etsy. Den fullständiga recensionstexten, betygen och datumen finns inte i den initiala HTML:en på sidan; de laddas via en intern API-endpoint.
Metod 1: Hitta Etsys interna API-endpoint för recensioner
Öppna en produktsida i Chrome, öppna DevTools (F12), gå till fliken Network och scrolla ner till recensionssektionen. Du ser en POST-begäran till något i stil med:
https://www.etsy.com/api/v3/ajax/bespoke/member/neu/specs/deep_dive_reviews
Den här endpointen returnerar HTML-fragment som innehåller recensionskorten. För att använda den behöver du:
- listing_id — det numeriska ID:t från produkt-URL:en
- shop_id — extraheras från produktsidans HTML med regex
- csrf_nonce — extraheras från en
<meta>-tagg på sidan
Extrahera ID:n och CSRF-token
import re

def get_review_params(product_url):
    resp = requests.get(product_url, headers=headers)
    html = resp.text
    listing_id = product_url.split("/")[-1].split("?")[0]
    shop_id_match = re.search(r'"shopId"\s*:\s*(\d+)', html)
    shop_id = shop_id_match.group(1) if shop_id_match else None
    soup = BeautifulSoup(html, "lxml")
    csrf_meta = soup.find("meta", {"name": "csrf_nonce"})
    csrf = csrf_meta["content"] if csrf_meta else None
    return listing_id, shop_id, csrf
Skrapa recensioner med paginering
def scrape_reviews(listing_id, shop_id, csrf, max_pages=5):
    session = requests.Session()
    session.headers.update(headers)
    all_reviews = []
    for page in range(1, max_pages + 1):
        payload = {
            "specs": {
                "deep_dive_reviews": {
                    "module_path": "neu/specs/deep_dive_reviews",
                    "listing_id": listing_id,
                    "shop_id": shop_id,
                    "page": page,
                }
            }
        }
        resp = session.post(
            "https://www.etsy.com/api/v3/ajax/bespoke/member/neu/specs/deep_dive_reviews",
            json=payload,
            headers={"x-csrf-token": csrf, "Content-Type": "application/json"},
        )
        data = resp.json()
        html_fragment = data.get("output", {}).get("deep_dive_reviews", "")
        review_soup = BeautifulSoup(html_fragment, "lxml")
        for card in review_soup.select("div.review-card"):
            rating_el = card.find("input", {"name": "rating"})
            text_el = card.select_one("div.wt-text-body")
            user_el = card.select_one("a[data-review-username]")
            date_el = card.select_one("p.wt-text-body-small")
            all_reviews.append({
                "rating": rating_el["value"] if rating_el else None,
                "text": text_el.text.strip() if text_el else None,
                "reviewer": user_el.text.strip() if user_el else None,
                "date": date_el.text.strip() if date_el else None,
            })
        time.sleep(random.uniform(2, 5))
    return all_reviews
Metod 2: Parsning av recensioner från HTML (reservlösning)
Om API-metoden misslyckas (till exempel på grund av problem med CSRF-token) kan du parsa den första sidan med recensioner direkt från produktsidans HTML. Begränsningen: bara den första omgången recensioner finns i den statiska HTML:en. För fler behöver du API:t eller ett webbläsarautomatiseringsverktyg som Selenium.
Hantera data som kräver inloggning: skrapa din egen Etsy-butik
Det här är ett glapp som ingen annan guide täcker, men det är ett verkligt behov — särskilt för Etsy-säljare som vill extrahera sina egna order, intäkter och statistik.
Problemet: requests ensam kan inte komma åt din Etsy-instrumentpanel eftersom det inte tar med cookies från din inloggningssession.
Alternativ 1: Selenium med manuell inloggning och cookieinsamling
Använd Selenium för att öppna en webbläsare, logga in manuellt (eller automatisera inloggningen) och fortsätt sedan skrapa medan du är autentiserad:
from selenium import webdriver

driver = webdriver.Chrome()
driver.get("https://www.etsy.com/signin")
# Logga in manuellt i webbläsarfönstret, och sedan:
input("Tryck på Enter efter att du loggat in...")

cookies = driver.get_cookies()
# Använd nu driver.get() för att navigera till dina dashboardsidor och skrapa
Du kan också spara cookies från Selenium-sessionen och återanvända dem med requests.Session() för snabbare och lättare skrapning efter den första inloggningen.
Alternativ 2: Exportera webbläsarcookies och använd dem med Requests
Använd ett webbläsartillägg (som "EditThisCookie") för att exportera dina aktiva Etsy-sessioncookies och ladda dem sedan i en Requests-session:
import requests

session = requests.Session()
# Lägg till cookies exporterade från din webbläsare
session.cookies.set("uaid", "YOUR_UAID_VALUE", domain=".etsy.com")
session.cookies.set("user_prefs", "YOUR_USER_PREFS_VALUE", domain=".etsy.com")
# ... lägg till andra sessionscookies efter behov

resp = session.get("https://www.etsy.com/your/orders", headers=headers)
Den enkla vägen: Thunderbits webbläsarbaserade skrapläge
Eftersom Thunderbit körs i din Chrome-webbläsare ärver det automatiskt din aktiva Etsy-session. Ingen autentiseringskod, ingen cookie-export — bara navigera till din Etsy-instrumentpanel och skrapa. Det här är verkligen användbart för att extrahera order, intäkter, statistik och annan säljaronly-data utan något skriptande alls.
Skrapa din Etsy-instrumentpanel med AI
Exportera och använd din skrapade Etsy-data
Spara till CSV eller JSON
import pandas as pd

df = pd.DataFrame(results)
df.to_csv("etsy_products.csv", index=False, encoding="utf-8")
df.to_json("etsy_products.json", orient="records", indent=2)
Bästa praxis: inkludera tidsstämplar i filnamnen, använd UTF-8-kodning och hantera specialtecken i produktnamn (Etsy-säljare älskar emojis och accenttecken).
Exportera till Google Sheets, Airtable eller Notion
För Python-användare låter bibliotek som gspread (Google Sheets) eller Airtable API dig skicka data programmatiskt. Men om du använder Thunderbit är alla exporter — till Google Sheets, Excel, Airtable och Notion — gratis och med ett klick. Inga API-nycklar, ingen OAuth-uppsättning.
Hoppa över koden: så skrapar du Etsy med Thunderbit (kodfritt alternativ)
Alla vill inte skriva Python-skript, underhålla proxykonfigurationer eller felsöka CSS-selektorer klockan 02 på natten. Om det är du, så här får du Etsy-data med Thunderbit.
Installera Thunderbit Chrome-tillägget
Gå till Chrome Web Store och installera Thunderbit. Skapa ett gratis konto — gratisnivån ger dig 6 sidor/månad och alla exporter är gratis.
Använd AI-förslag för fält på vilken Etsy-sida som helst
Navigera till ett Etsy-sökresultat, en produkt- eller butikssida. Klicka på "AI Suggest Fields" i Thunderbits sidofält. AI:n skannar sidan och föreslår kolumner — produktnamn, pris, betyg, bilder, butiksnamn, taggar, fraktinfo. Justera eller lägg till kolumner efter behov.
Klicka på Skrapa och exportera
Klicka på "Scrape" för att extrahera data från den aktuella sidan. För resultat över flera sidor använder du Thunderbits pagineringsskrapning. För att berika en lista med produkt-URL:er med detaljer från varje produktsida (beskrivningar, recensioner, frakt), använder du skrapning av undersidor — Thunderbit besöker varje länk och hämtar extradata automatiskt.
Exportera till Excel, Google Sheets, Airtable eller Notion — helt gratis.
När Thunderbit slår Python för Etsy-skrapning
- Ingen proxyuppsättning eller anti-bot-kod behövs. Thunderbit körs i din riktiga Chrome-webbläsare, så det ärver din session och ser ut som en vanlig användare för DataDome.
- AI anpassar sig automatiskt till layoutändringar. Inga trasiga selektorer att fixa när Etsy uppdaterar sitt gränssnitt.
- Perfekt för engångsresearch, konkurrensanalys eller teammedlemmar utan teknisk bakgrund. Om du bara behöver en snabb datamängd behöver du ingen Python-miljö.
- Skrapning av undersidor låter dig berika en lista med produkt-URL:er med detaljerad data utan att skriva nästlade loopar.
För en genomgång, kolla in Thunderbits YouTube-kanal.
Kostnadsjämförelse Python vs. Thunderbit över 6 månader
| Faktor | Python på egen hand | Thunderbit |
|---|---|---|
| Uppsättningstid | 8–20 timmar | Under 5 minuter |
| Kostnad över 6 månader (inkl. arbete, proxies) | 2 720–9 450 USD | 90–228 USD |
| Månadsunderhåll | 4–10+ timmar (selector-uppdateringar = 80%+ overhead) | 0–1 timmar |
| Anti-bot-hantering | Residential proxies till 85x normal kreditkostnad | Webbläsarbaserat, kringgår DataDome naturligt |
| Datakvalitet | Hög (med insats) | Hög (AI-driven) |
Jag säger inte att Python är fel val — om du behöver full kontroll, egen logik eller integration i en större pipeline, då är kod kung. Men för de flesta affärsanvändare som bara behöver Etsy-data talar ROI-beräkningen för ett kodfritt verktyg.
Juridiska och etiska tips för att skrapa Etsy
Jag får frågor om legalitet i varje inlägg om skrapning, så här är den korta versionen:
- Etsys användarvillkor förbjuder uttryckligen automatiserad åtkomst. Samtidigt förlitar sig Etsy på teknisk enforcement (DataDome) snarare än rättsliga åtgärder — det finns inga kända Etsy-specifika rättsfall riktade mot skrapare.
- Skrapa bara offentligt tillgänglig data. Gå inte runt autentisering och försök inte komma åt privata säljarpaneler du inte äger.
- Använd rimlig begäranstakt. 2–7 sekunders fördröjning mellan förfrågningar, och överbelasta inte Etsys servrar.
- Respektera
robots.txt. Etsy tillåter söksidor men begränsar vissa sökvägar. - Hantera personuppgifter ansvarsfullt enligt integritetslagar som GDPR.
- Rådgör med jurist för skrapningsprojekt i kommersiell skala.
För mer bakgrund, se vårt inlägg om juridiska konsekvenser av webbskrapning — inklusive Meta v. Bright Data (2024), där skrapning av offentliga data bedömdes vara tillåten.
Avslutning: viktiga insikter
Vi gick igenom mycket här. Det här vill jag att du tar med dig:
- Etsys strukturerade JSON-LD-data gör extraheringen renare än rå HTML-parsning för de flesta fält.
- DataDome är ett verkligt hinder — använd korrekta headers, fördröjningar, cookie-hantering och residential proxies för Python-skrapning i stor skala.
- Etsy API är begränsat. Om du behöver recensioner, konkurrentbutiker eller analys mellan säljare är skrapning den praktiska vägen.
- Thunderbit erbjuder ett kodfritt alternativ som hanterar anti-bot och autentisering inbyggt — värt att prova om du vill ha Etsy-data utan att underhålla skript.
- Skrapa alltid ansvarsfullt och respektera Etsys villkor.
Om du vill komma igång utan att skriva kod, prova Thunderbit gratis. Eller använd Python-koden från den här guiden för att bygga din egen anpassade skrapare — och må dina selektorer aldrig gå sönder en fredag eftermiddag.
För fler skrapguider, kolla in vår guide till Etsy-scraper och sammanställningen av de bästa AI-webbskraparna.
Prova Thunderbit för att skrapa Etsy-data snabbare Get Started Free
Vanliga frågor
1. Är det lagligt att skrapa Etsy med Python?
Skrapning av offentligt tillgänglig data är i allmänhet tillåten enligt nyare rättspraxis (t.ex. Meta v. Bright Data, hiQ v. LinkedIn). Etsys användarvillkor förbjuder dock automatiserad åtkomst, så gå alltid igenom deras ToS och robots.txt innan du skrapar. För storskalig eller kommersiell användning, rådgör med jurist.
2. Kan jag skrapa Etsy utan att bli blockerad?
Etsy använder DataDome, ett av de tuffaste anti-bot-systemen som finns. Realistiska headers, fördröjningar mellan förfrågningar, beständiga cookies och rotation av residential proxies hjälper alla till att minska blockeringar. Thunderbits webbläsarnativa metod undviker det mesta av upptäckten eftersom den körs i din riktiga Chrome-session.
3. Har Etsy ett API som jag kan använda i stället för att skrapa?
Ja — Etsy erbjuder API v3, men det är mest begränsat till din egen butiks data och saknar robust åtkomst till recensioner. De flesta användningsfall för konkurrensanalys och analys mellan butiker kräver skrapning.
4. Vilka Python-bibliotek behöver jag för att skrapa Etsy?
Minst: requests, beautifulsoup4, pandas (för export) och json (inbyggt). För sidor med mycket JS eller där inloggning krävs, lägg till selenium. För snabbare HTML-parsning, använd lxml.
5. Hur skrapar jag specifikt Etsy-recensioner?
Etsy-recensioner laddas via en intern API-endpoint (/api/v3/ajax/bespoke/member/neu/specs/deep_dive_reviews). Du behöver extrahera listing-ID, shop-ID och CSRF-token från produktsidan och sedan skicka en POST-begäran till endpointen med paginering. Som reservlösning kan du parsa den första omgången recensioner från produktsidans HTML — båda metoderna gås igenom steg för steg i den här guiden.
Läs mer



