
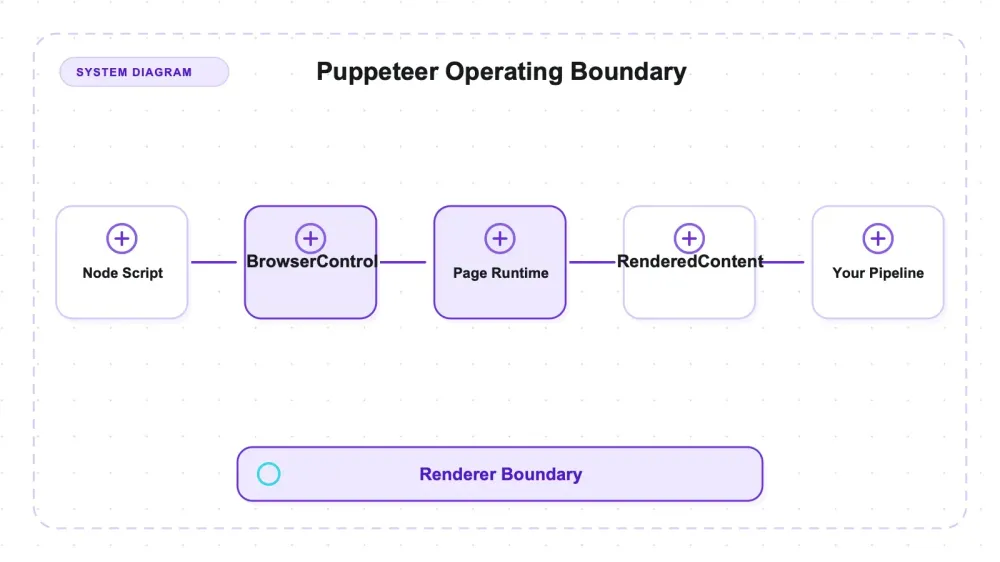
Puppeteer är Googles Node-bibliotek för att styra en riktig Chrome från JavaScript — du skriver automatiseringen, Chrome DevTools Protocol skickar kommandona, och en komplett webbläsare renderar sidan innan du läser en enda byte av den. Det ligger på puppeteer/puppeteer på GitHub: Apache-2.0, skrivet i TypeScript, och med ungefär 95,3k stjärnor (95 307 när jag tog snapshoten). Den officiella positioneringen är medvetet snäv — "ett JavaScript API för att styra Chrome (och experimentellt Firefox)" — vilket säger både vad det är och, lika användbart, vad det inte är.
Jag körde Puppeteer 24.16.0 genom samma fixtureserver och offentliga demos som vi använder för varje bibliotek för webbläsarautomation: en statisk katalog med paginering, en artikel, en JavaScript-renderad katalog, ett JSON-API, en route som returnerar 500, en liten crawl-graf, plus Books to Scrape och Quotes to Scrape. Renderingsjobbet genomfördes snyggt och utan dramatik. Det lämnade också exakt ett jobb på mitt bord — samma jobb som alla headless-browser-bibliotek lämnar — och just ärligheten kring det gapet är det som oftast skiljer en användbar recension från ett pressmeddelande.
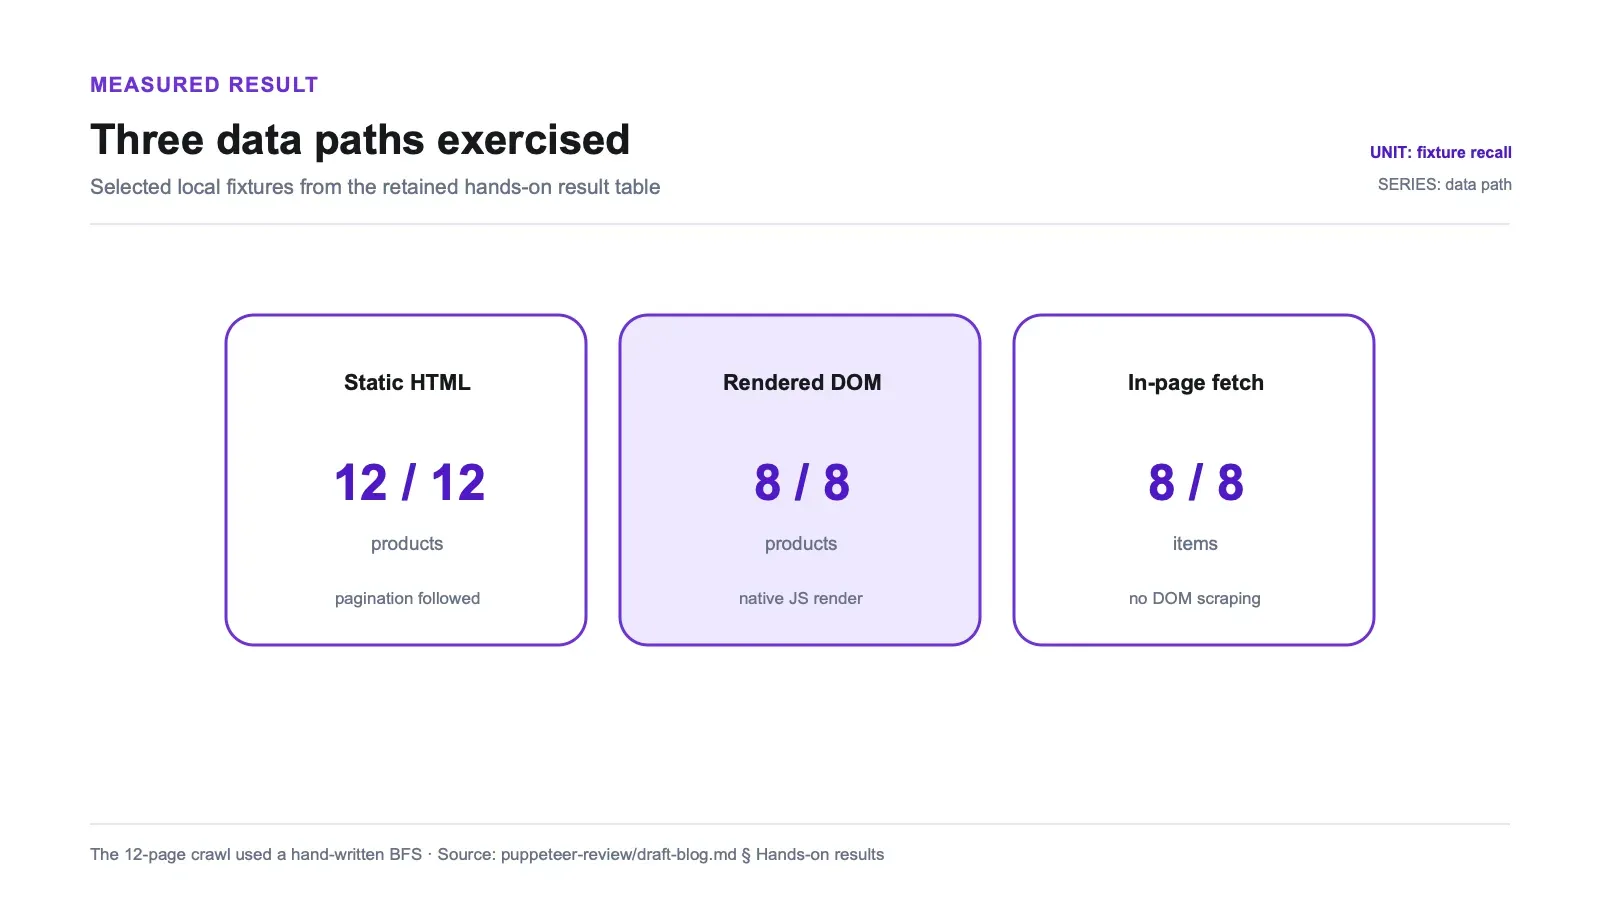
En siffra stack ut mer än återkallningsresultaten. På en sida där datan kommer från en JSON-endpoint hämtade Puppeteer alla 8 poster utan att skrapa DOM alls — den körde fetch inne i sidan och läste responsobjektet direkt. Det, tillsammans med native rendering och fungerande skärmdumpar, beskriver verktyget väl: en mogen Chrome-renderare, inte ett crawler-ramverk, och den skillnaden spelar roll innan du skriver en enda rad kod.
Vad Puppeteer faktiskt är (och vad det konkurrerar med)
Kategorietiketten gör verkligt jobb här, så börja med den. Puppeteer är ett bibliotek för webbläsarautomation. Det startar Chrome, öppnar sidor, låter sidans JavaScript köras och ger dig det renderade resultatet att läsa eller ta skärmdump av. Det är hela anledningen till att du väljer det framför en HTTP-klient plus en HTML-parser: du vill ha sidan efter att skripten körts, inte det tomma skal som servern skickar först.
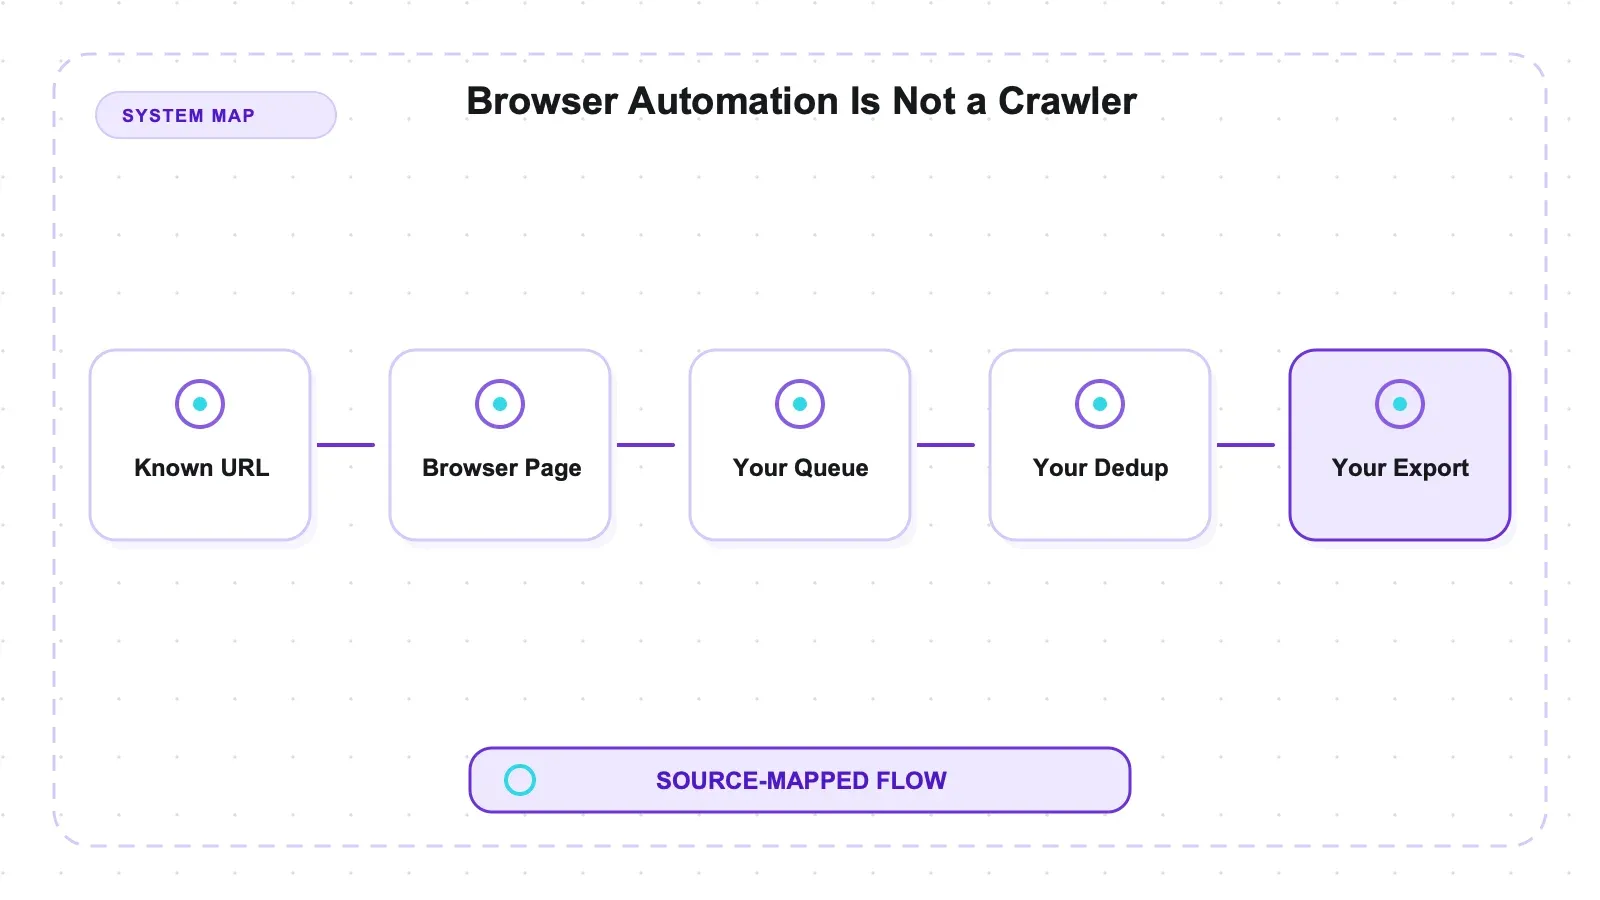
I praktiken konkurrerar det med andra bibliotek för riktiga webbläsare — Playwright och Selenium — inte med crawler-ramverk som Scrapy eller med LLM-Markdown-verktyg. Om du pekar Puppeteer mot tusen URL:er och förväntar dig att det ska köa dem, avduplicera, strypa trafiken artigt och skriva ut ett dataset, då har du tagit med en renderare till ett crawl-problem. Det kommer att rendera varje sida vackert och sköta ingen av orchestreringen. (Det är en gräns för verktygets scope, inte en bugg — jag återkommer till det, eftersom det är det viktigaste att förstå innan man väljer verktyget.)
Puppeteer kommer ur Googles Chrome-team, vilket är varför det är Chrome-fokuserat av design och varför API:t känns som en tunn, välanvänd handske över webbläsarens egna felsökningsprotokoll. Det är tillräckligt gammalt för att vara bra på det tråkiga sättet: metoderna du behöver har varit stabila i flera år, dokumentationen är gedigen och ekosystemet runt omkring är djupt.
Native rendering och ett in-page fetch-mönster
Två beteenden är värda att lyfta ur resultattabellen eftersom de definierar hur du faktiskt skulle använda verktyget.
Först: native rendering. Den JavaScript-renderade katalogen — en sida som bygger sitt produktnät på klientsidan efter laddning — kom tillbaka med 8/8, med en fullständig skärmdump sparad till disk. Upplägget var minimalt men inkluderade väntan på målcontent efter goto. Den offentliga Quotes to Scrape JS-sidan gav tillbaka alla tio citat med samma mönster. Det här är resultat från fixtures, inte ett generellt rendering/recall-betyg.
För det andra: JSON-API-fixturen laddade produkter från /api/dynamic-products. Att köra en same-origin fetch via page.evaluate gav alla åtta poster utan att parsa renderade rader. Det här är ett generellt mönster för webbläsarevaluering, inte en Puppeteer-specifik upptäcktsfunktion. Det kan förenkla extraktion när endpointen och request-kontraktet är kända; autentiseringsheaders, runtime-tokens, credential-policy, CORS/CSP, service workers och paginering kan fortfarande göra att en applikationsrequest beter sig annorlunda.
Det tredje man ska ta med sig är ramen, inte en siffra: Puppeteer är en mogen Chrome-renderare, och det är inte en crawler. Båda delarna är sanna, och det är den andra som ofta utelämnas i genomgångar.
Hur Puppeteer pratar med Chrome
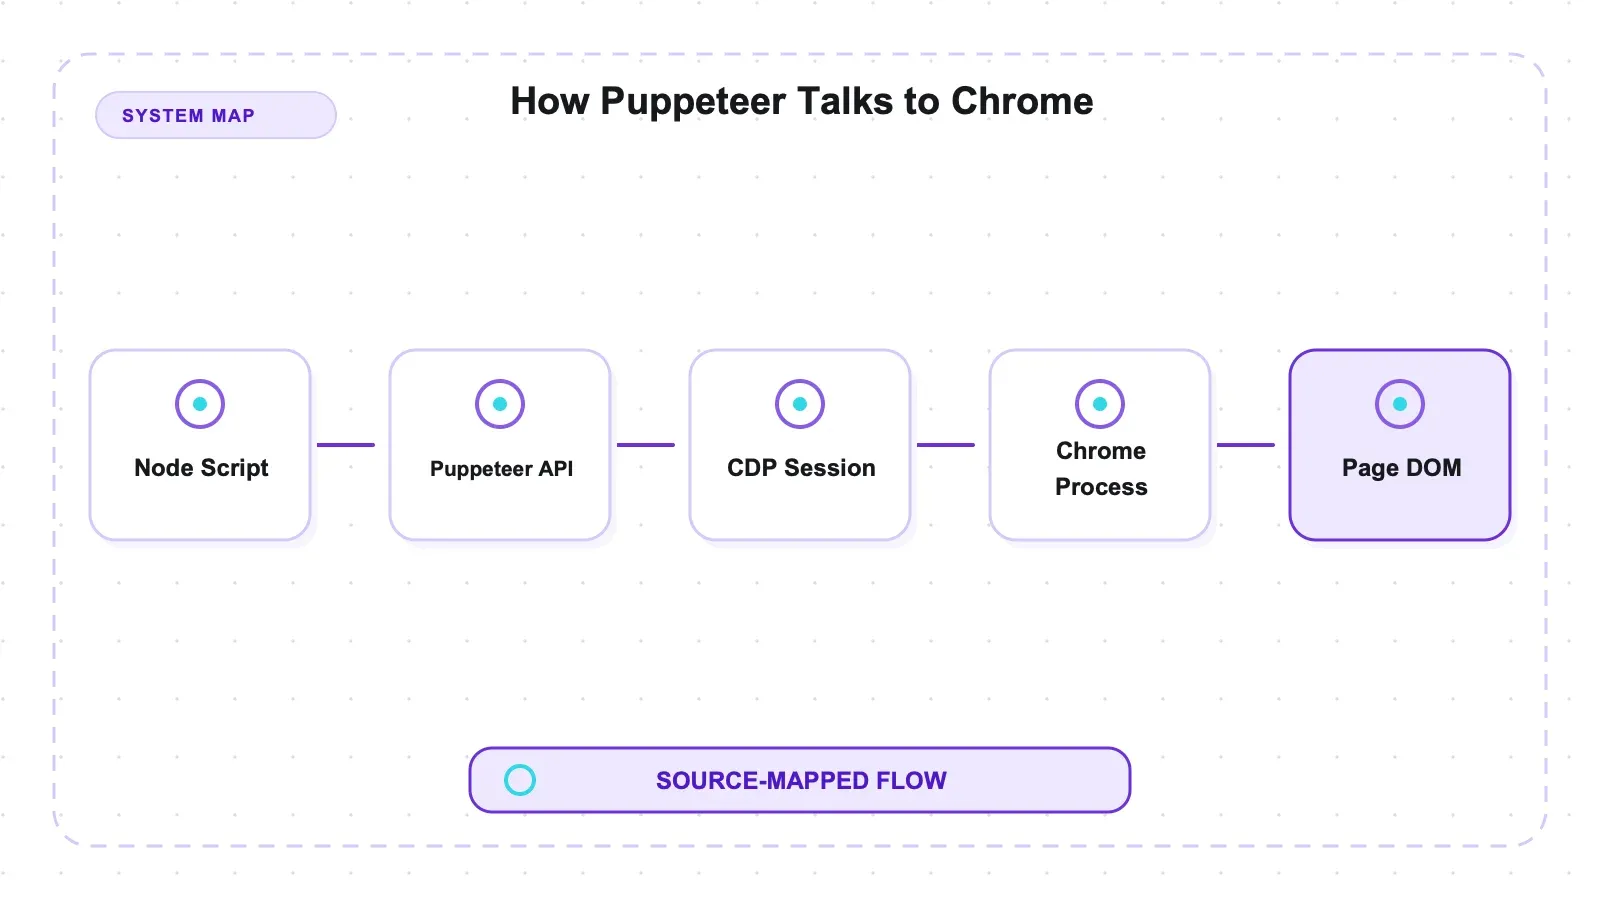
I Chrome använder Puppeteer Chrome DevTools Protocol (CDP), JSON-over-WebSocket-kanalen som används av webbläsarens devtools. puppeteer.launch() startar Chrome och öppnar den protokollkopplingen; anrop som goto, $$eval och screenshot exponerar webbläsarens funktioner via ett högre API. Firefox-stöd följer WebDriver BiDi-spåret som beskrivs nedan, så inte varje Puppeteer-operation är universellt ett CDP-kommando.
page.evaluate kör en funktion i sidans kontext, så en relativ fetch('/api/...') använder sidans origin och kan återanvända cookies och sessionstillstånd om de är tillåtna. Den återskapar inte automatiskt applikationsskapade authorization headers, request-alternativ, tokens eller service worker-beteende. I den här same-origin-fixturen gav det JSON direkt; produktionsrequests behöver inspekteras utifrån sitt faktiska kontrakt.
Det är också därför Puppeteer är tungt. Varje sida är en riktig webbläsarflik med en riktig renderingmotor bakom sig. Det ger korrekthet på JavaScript-tunga sidor och kostar minne och starttid jämfört med ett rent HTTP-fetch. Det finns ingen gratis rendering; CDP gör bara kostnaden tydlig.
Motorns fråga, rakt sagt
Det finns en populär förenkling att Puppeteer är "bara för Chrome". För versionen jag testade är det fel, och att reda ut det förändrar jämförelsen.
| Motor | Hur Puppeteer 24.16.0 styr den | Utnyttjad i dessa tester |
|---|---|---|
| Chrome | Chrome-först via CDP — standardläget, så befintliga automationer fortsätter fungera | ja |
| Firefox | Dokumenterat stöd via WebDriver BiDi sedan v23 | nej |
| WebKit | Styrs inte alls | — |
Både Chrome for Developers och Mozilla lyfte fram Firefox-skiftet när det landade. Bygget jag körde, 24.16.0, ligger långt efter v23, så "bara Chrome" underskattar det som faktiskt följer med. Avsaknaden av WebKit, plus att berättelsen om flera motorer är yngre än Playwrights, är den verkliga skillnaden i bredd — inte "en motor mot tre".
Firefox/BiDi-vägen är dokumenterad och tillgänglig i versionen jag testade, men jag körde inte mina fixtures genom den, så jag rapporterar en kapacitet, inte ett mätresultat. Om Firefox-rendering är avgörande för dina mål bör du verifiera den mot dina egna sidor innan du bestämmer dig. För läsare som vill ha en full jämförelse mellan motorer och språkstöd kör vår Playwright-vs-Puppeteer-jämförelse båda biblioteken genom samma tester och avgör "vilken"-frågan där; här handlar det om Puppeteer ensam.
Installation och setup i praktiken: webbläsaren är den tunga delen
Standardvägen npm install puppeteer laddar ner en kompatibel Chrome for Testing-version. Det beteendet kan hoppas över eller omdirigeras via konfiguration, och användare kan peka Puppeteer mot en annan körbar fil, så versionsmatchningen beror på distributionsvalet. Nedladdningen av webbläsaren var den tyngsta delen av installationen; en audit-snapshot från paket-hanteraren behandlas inte som en varaktig säkerhetsegenskap.
Den automatiska paketeringen är både en verklig ergonomisk vinst och en verklig kostnad i footprint, och det är värt att säga båda sakerna. Vinsten: du behöver inte leta efter en kompatibel webbläsare eller låsa versioner manuellt; npm install ger dig ett fungerande par. Kostnaden: du laddar ner en webbläsare, så planera för disk och bandbredd, särskilt i CI där en kall cache betalar det priset på varje ny runner.
Det är också en tydlig kontrast mot Playwright, som delar upp processen i två steg — du installerar biblioteket och kör sedan npx playwright install separat för att hämta dess webbläsarbyggen. Inget av uppläggen är jobbigt; de misslyckas bara på olika sätt. Puppeteers enda kommando kan överraska dig med sin storlek på en uppkoppling med datatak, medan Playwrights andra steg kan överraska genom att glömmas bort. Vet vilket av dem du kör.
Praktiska resultat
Varje test kördes mot en lokal fixture-server på 127.0.0.1 samt två offentliga övningssajter, på Node v22.22.3, macOS arm64, med Puppeteer 24.16.0 och dess medföljande Chrome. Ground truth för varje fixture skrevs ner före körningen, så recall mäts mot en fast förväntad mängd i stället för vad Puppeteer råkade skriva ut.
Det publika forskningspaketet innehåller fixture-servern, testköraren och ground truth. Dependency-lockfilen och den råa körsammanfattningen utelämnades medvetet från publiceringspaketet eftersom den strikta säkerhetsgranskningen avvisade lockfilsdata och miljöspecifikt endpoint-material. För att reproducera den säkra lokala fixturen, kör npm install och sedan node run_puppeteer_material_tests.mjs i tools/puppeteer/tests, och jämför sedan resultatet med den publicerade ground truth. Offentliga demosidor kan förändras, så den lokala fixturen är den stabila grunden för kontroller av förväntat antal.
För en exakt historisk rekonstruktion av beroenden: skapa och granska en ny lockfil lokalt i stället för att behandla en opublicerad lockfil som offentlig bevisning.
| Test | Mål | Resultat |
|---|---|---|
| Statisk katalog + paginering | lokal fixture | 12/12, recall 1.0 |
| Artikelutdrag | lokal fixture | titel + 3/3 stycken, boilerplate separerad |
| Dynamisk JS-sida (native render) | lokal fixture | 8/8, recall 1.0, fullskärmsscreenshot sparad |
Dynamisk JSON-API (in-page fetch) | lokal fixture | 8/8, recall 1.0, ingen DOM-skrapning |
| Hantering av HTTP 500 | lokal fixture | status 500 gick att inspektera, inget kastat fel |
| Crawl-graf (handskriven BFS) | lokal fixture | 12 sidor, djup {0:1, 1:4, 2:7} |
| Books to Scrape | offentlig demo | 20 produkter |
| Quotes JS | offentlig demo | 10 citat, renderade nativt |
Några av dessa förtjänar en mening utöver tabellen.
Den egenutvecklade pagineringskoden hämtade alla 12 förväntade katalogobjekt. Artikelselektorn hämtade titeln och tre förväntade brödtextstycken; omgivande boilerplate fanns fortfarande kvar i DOM:en. Puppeteer levererade den renderade DOM:en, medan selektorlogiken — inte Puppeteer i sig — avgjorde vad som räknades som artikelinnehåll.
På den testade HTTP 500-routen returnerade goto ett responsobjekt med inspekterbar 500-status och kastade inget fel. Det säger inget om timeouts, DNS-fel, webbläsarkrascher, lossnade frames eller andra navigationsfel, som fortfarande kräver explicit hantering.
Crawl-grafen är den som säger hela sanningen. Att gå igenom fixturens interna länkar till 12 sidor, med djupspårning så att URL:er inte besöktes igen, krävde en handskriven breadth-first search — eftersom Puppeteer inte har någon inbyggd crawl-kö. Den hittade alla 12 sidor över djupen {0:1, 1:4, 2:7}, vilket betyder att min BFS fungerade. Men BFS:en var min. Puppeteer renderade varje sida; logiken för att vandra genom sajten var kod jag själv skrev. För tolv sidor är det ett dussin rader och ingen stor sak. För tusentals URL:er med deduplicering, retries och artiga fördröjningar blir de där dussintalet rader ett projekt.
En brasklapp jag vill upprepa eftersom den är lätt att missbruka: artefakterna innehåller tidsmätningar per test, men de är observationer från en körning på en maskin, inte benchmarkresultat. Jag rankar inte Puppeteers hastighet mot något annat med stöd av en laptop och en körning. Det siffrorna stödjer är recall och beteende över åtta olika sidtyper — inte ett påstående om klocktid.
Vad jag inte testade
Så att resultaten inte läses bredare än de faktiskt är, här är vad som låg utanför testkörningen och därför utanför dessa siffror:
| Utanför testkörningen | Status |
|---|---|
| Firefox via WebDriver BiDi | Dokumenterat, tillgängligt i 24.16.0, men inte testat här |
| Proxy och request-interception | Inte testat; båda är stödda funktioner som jag inte körde |
| Skalning med parallella sidor | Jag körde smått; webbläsarflottans beteende under verklig samtidighet är inte mätt |
| Ny körning på senaste release | Jag testade 24.16.0; npm latest är 25.3.0, en hel majorversion före, per 2026-07-09. API:erna jag använde (launch, goto, $$eval, screenshot, in-page fetch) är stabila mellan 24→25, men det är ärligare att köra om på 25.3.0 innan man satsar exakta siffror på den |
Inget av detta är en anmärkning mot verktyget. Det är bara gränserna för vad en enskild fixture-körning kan hävda med ärlighet.
För- och nackdelar
Fördelar:
- Native JavaScript-rendering med tydlig väntan på innehåll: 8/8 på den dynamiska fixturen och alla tio citat på den offentliga demon, med skärmdumpar.
- Den egenutvecklade pagineringen och artikelselektorerna hämtade de förväntade fixture-objekten.
- In-page
fetchhämtade alla åtta poster från den kända same-origin-endpointen utan DOM-parsning. - Den testade HTTP 500-responsen gick att inspektera utan exception.
- Standardinstallationen laddar ner en kompatibel Chrome for Testing-version; alternativ körbar fil och skip-download-konfigurationer är fortfarande möjliga.
- Mogen, Chrome-fokuserad API-yta över CDP, med djupt ekosystem och gedigen dokumentation. Apache-2.0.
- Mer bred än ryktet: dokumenterat Firefox-stöd via WebDriver BiDi sedan v23.
Nackdelar:
- Ingen inbyggd crawl-kö, dataset-skrivare eller throttling — crawl-skala kräver egen kod eller ett wrapperlager.
- Ingen WebKit-motor, och dess multi-engine-berättelse är yngre än Playwrights.
- Riktig webbläsarvikt: en medföljande Chrome att ladda ner och minneskostnad per sida jämfört med HTTP-only-verktyg.
- Node-baserat; att använda det från ett annat språk betyder att du bygger och underhåller en brygga.
- Versionen jag körde (24.16.0) ligger efter npm latest (25.3.0) med en majorversion — verifiera på aktuell version innan du litar på exakta siffror.
Vem det passar för, och vem som bör hoppa över det
Välj Puppeteer om du lever i Node, dina mål renderas bra i Chrome (det gör de flesta), och du vill ha ett moget, fokuserat bibliotek som gör "sidan efter att dess JavaScript har körts" till något du kan läsa och spara som skärmdump. För att skrapa en uppsättning dynamiska sidor, hämta ett JSON-API med sidans egen session eller fånga renderade skärmdumpar som bevis, är det ett starkt och okomplicerat förstahandsval. Firefox-vägen via BiDi finns om du växer in i den, och ekosystemet gör att de flesta problem du stöter på redan har stötts på tidigare.
Tänk efter en extra gång om ditt problem handlar mer om crawl-orchestrering än rendering. Om du behöver gå igenom hundratals eller tusentals URL:er med deduplicering, retries och rate limits kommer Puppeteer ensam att tvinga dig att bygga en crawler för hand — det är fel nivå för det. Hoppa över en headless browser helt om dina sidor inte faktiskt behöver JavaScript för att avslöja sin data; när en HTTP-request och en parser räcker, är en riktig webbläsare dyr överkurs som bara äter minne och uppstartstid. Och om du behöver WebKit-fidelity eller en klient i ett annat språk än JavaScript, är det här inte rätt verktyg för den dimensionen.
Alternativ och var Thunderbit passar in
Den ärliga ramen först: Puppeteer är gratis, Apache-2.0, self-hosted, och du äger varje del av driften — webbläsarflottan, crawl-koden du kopplar på och den pågående kampen mot antibot-skydd. För många projekt är det precis rätt nivå av ägande, och ingen managed service kommer att rendera en auktoriserad sida billigare än en webbläsare du redan har.
Inom open source är de användbara jämförelserna jobbfokuserade, inte logobaserade. För crawl-skala är Crawlee den naturliga följeslagaren: dess PuppeteerCrawler bygger in request-kön, dataset och throttling som biblioteket medvetet lämnar utanför, så du behåller rendering men får orchestreringen. Om ditt mål är ren Markdown för en LLM-pipeline snarare än en renderad DOM, kör Crawl4AI en riktig webbläsare och producerar just det. Om dina sidor inte behöver någon webbläsare alls är ett HTTP-first-ramverk som Scrapy en annan och lättare kategori. När du väger flera av dessa samtidigt lägger vår översikt över open source-scrapers kategorierna sida vid sida.
En managed tjänst som Thunderbit flyttar webbläsardrift och extraktion bakom ett API. Den kördes inte genom dessa Puppeteer-fixtures, så den här recensionen gör inga jämförbara påståenden om rendering, blockering, extraktionskvalitet eller kostnad. Gränsen för beslut handlar om operationellt ägarskap: sköta webbläsare och crawl-kod själv, eller betala en leverantör för att driva en del av det lagret.
Med Puppeteer finns ingen vendoravgift per användning, men beräkning, bandbredd, webbläsarunderhåll, orchestrering och drift är fortfarande ditt ansvar. En managed väg tar betalt per användning och flyttar en del av ansvaret till leverantören. Det här experimentet jämförde inte resultaten.
Prova Thunderbit för extraktion av webbdata
Slutsats
Puppeteer 24.16.0 är värt att utvärdera om du arbetar i Node och behöver Chrome-fokuserad webbläsarautomation. Den egenutvecklade fixture-koden hämtade 12 statiska objekt, åtta dynamiska objekt och tio publika demo-citat; det kända same-origin-API:et gav åtta poster via page.evaluate; skärmdumpar fungerade; och den testade HTTP 500-responsen gick att inspektera. Dessa resultat gäller de namngivna fixtures och en äldre majorversion, inte extraktionsrecall i allmänhet.
Sätt dock anspråken rätt. Puppeteer är en renderare, inte en crawler: min 12-sidiga genomgång krävde en handskriven BFS eftersom det inte finns någon inbyggd kö, och i stor skala är det gapet verkligt arbete — överlämna det till Crawlee eller bygg mekaniken själv. Det är Chrome-först med dokumenterat Firefox-stöd via BiDi men inget WebKit, så det är inte verktyget för bred cross-engine-täckning. Det bär vikten av en riktig webbläsare. Och jag testade 24.16.0 mot ett senaste 25.3.0, så kör om på aktuell version innan du litar på exakta siffror. Känner du till de här fyra sakerna från början är Puppeteer ett utmärkt bibliotek för Chrome-automation. Förväntar du dig att det ska crawla en sajt åt dig kommer du att skriva den crawler du trodde att du laddade ner.
Prova Thunderbit för extraktion av webbdata Get Started Free
Vanliga frågor
Renderar Puppeteer JavaScript-sidor, eller behöver jag ett plugin?
Det renderar dem nativt, utan plugin. I min dynamiska fixture gav det tillbaka 8 av 8 produkter som byggdes på klientsidan, med recall 1.0 och en fullskärmsbild, och den offentliga Quotes to Scrape JS-sidan gav alla 10 citat på samma sätt — ett vanligt goto, sedan läs den renderade DOM:en. Eftersom Puppeteer styr en riktig Chrome via DevTools Protocol körs sidans skript faktiskt innan du läser något alls.
Kan Puppeteer skrapa ett JSON-API utan att parsa HTML?
Ja, när endpointen och request-kontraktet tillåter det. page.evaluate kan skicka en request från sidans origin och kan återanvända cookies som är giltiga, men den återskapar inte automatiskt applikationens headers, tokens, options eller service worker-beteende. På same-origin-fixturen returnerade det alla åtta poster utan DOM-parsning.
Är Puppeteer en web crawler? Nej — det är ett bibliotek för webbläsarautomation, inte ett crawler-ramverk. Det finns ingen inbyggd request-kö, dataset-skrivare eller throttling, så min crawl på 12 sidor (djup {0:1, 1:4, 2:7}) behövde en handskriven breadth-first search. Det är en gräns för verktygets scope, inte en defekt. För crawl-skala kan du kombinera det med ett wrapperlager som Crawlees PuppeteerCrawler, som lägger till kö- och dataset-mekanismerna som Puppeteer lämnar ute.
Är Puppeteer bara för Chrome? Inte längre. Det är Chrome-först via CDP, men sedan v23 har det dokumenterat Firefox-stöd via WebDriver BiDi, och versionen jag testade (24.16.0) ligger långt efter det. Det den inte styr är WebKit, och dess cross-engine-berättelse är yngre än Playwrights — det är den korrekta begränsningen, inte "bara Chrome". Jag körde bara Chrome här, så jag rapporterar Firefox via BiDi som dokumenterat, inte som något jag själv mätt.
Vad laddar installationen av Puppeteer egentligen ner?
Som standard laddar npm install puppeteer ner en kompatibel Chrome for Testing-version. Nedladdningen kan hoppas över eller omdirigeras, och en annan körbar fil kan konfigureras, så versionsmatchningen beror på deploymentsval. Planera för disk och bandbredd för webbläsaren, särskilt på CI-runner utan cache. Den här recensionen testade 24.16.0; kör om kärnfixtures på den release som är aktuell vid publicering.




