
Nästan varje sammanställning över de “bästa open source-scraprarna” har en tyst svaghet: inga verktyg körs mot exakt samma sidor. Scrapy testas på en nyhetsartikel, Playwright på någon e-handelsdemo, Colly på något som skribenten hade liggande — och sedan ställs de bredvid varandra som om siffrorna faktiskt betydde samma sak. Den sortens ranking säger mer om sidorna än om verktygen.
Så jag gjorde det självklara, men ofta utelämnade, arbetet. Jag byggde en gemensam uppsättning testfall och körde alla nio verktyg mot dem: en statisk katalog, en JavaScript-renderad katalog, en artikel dold bakom navigering och sidfot, ett medvetet trasigt HTTP 500-svar, en liten crawl-graf med interna länkar, plus två publika övningssajter. Samma facit, samma mätvärden, varje gång. Skripten och rådata finns i ett publikt benchmark-repo så att du kan köra om allt själv. Resultatet blev inte den snygga topplista som sammanställningarna brukar lova — det finns ingen ensam vinnare. Det finns tre olika typer av jobb, och de nio verktygen fördelar sig nästan av sig själva mellan dem.
Testa Thunderbit för webbdatainsamling
Så byggdes testet – och den enda begränsning jag säger högt
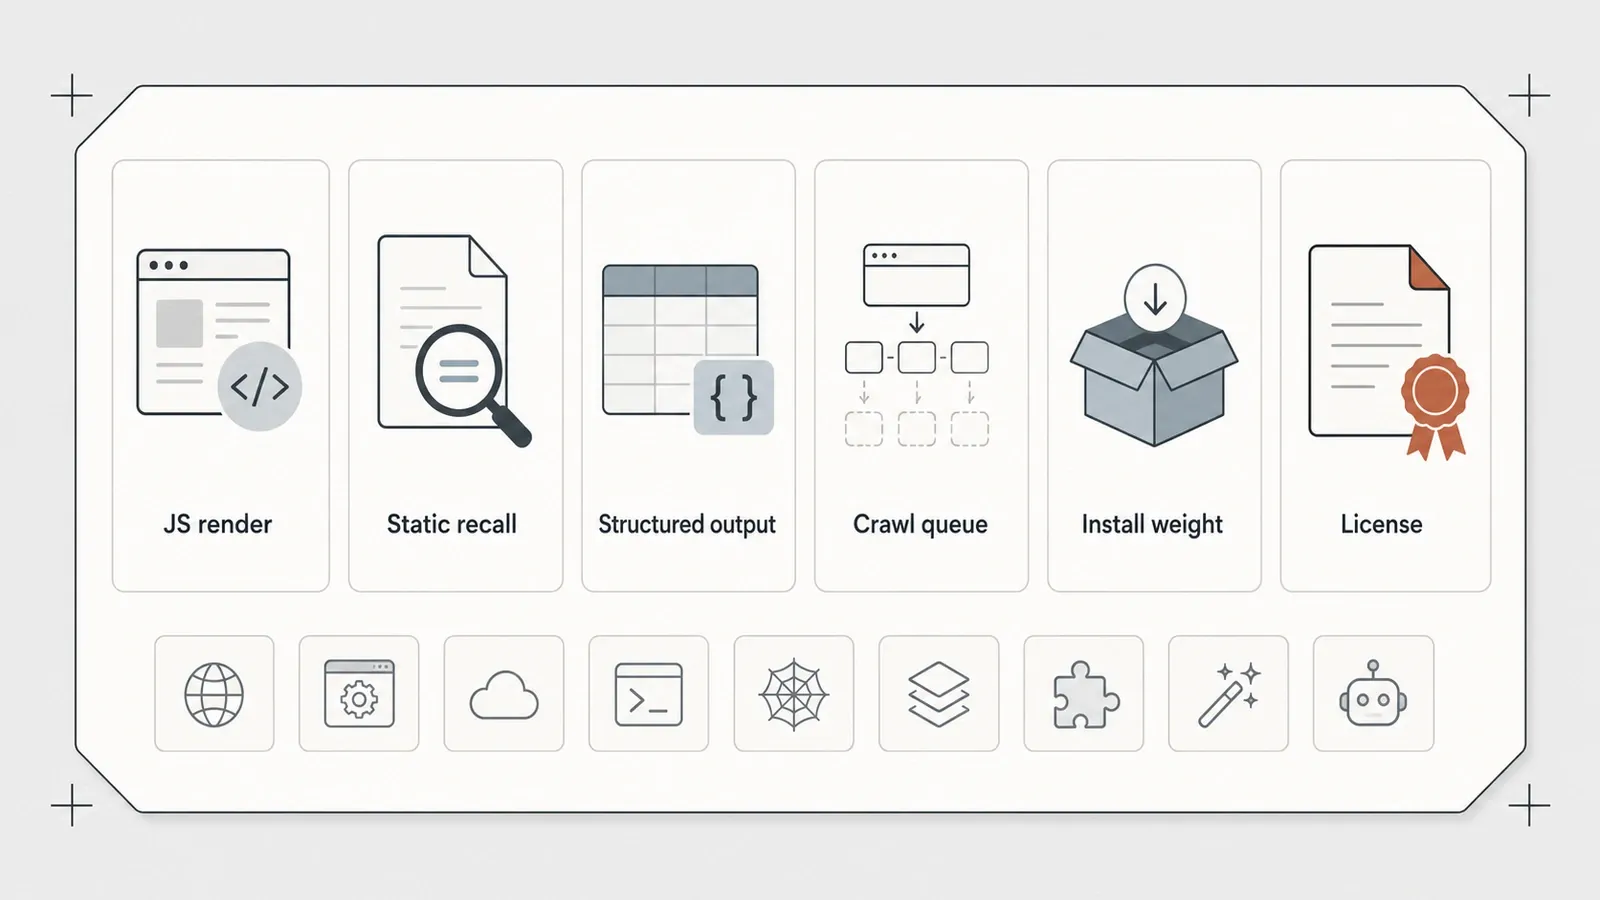
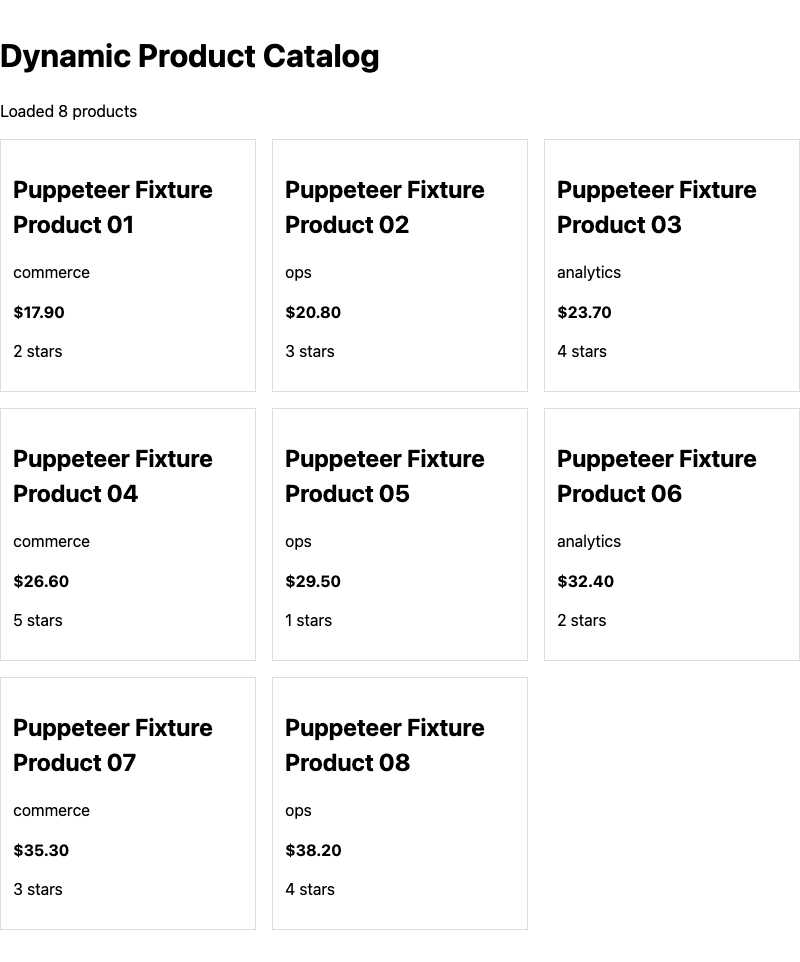
Varje verktyg kördes mot samma typer av testfall: 12 statiska produkter fördelade över två sidor, 8 produkter som lades in av JavaScript efter en fördröjning, en artikel omgiven av nav- och sidfotsinnehåll, ett avsiktligt serverfel på 500, och en graf av interna länkar. Det är just den här designen som gör resultaten jämförbara — “8/8 dynamiska produkter” betyder exakt samma sak oavsett om det var Puppeteer eller Crawlee som tog fram det.
Här finns gränsen som många sammanställningar hoppar över. Varje verktygs paket speglar sina egna kopior av dessa testfall, så absoluta teckenantal är inte strikt jämförbara mellan verktyg — läs dem som signaler inom respektive verktyg, aldrig som en direkt korsjämförelse. De siffror som går att jämföra är träffsäkerhet (tänk på det som en andel), om JavaScript klaras eller faller, och strukturellt beteende. En viktig notering i samma anda: Crawl4AI:s körning på den statiska katalogen omfattade bara första sidan, så dess 6/6 är full träffsäkerhet på ett snävare urval, medan de andra verktygen crawlade båda sidorna för 12/12 — mindre omfattning, inte ett missat delresultat. Den fulla motiveringen, testfall för testfall, finns i metodbeskrivningen.
En sak till innan siffrorna. Varje paket innehåller också en preliminär forskningspoäng, men jag visar dem medvetet inte som en rankad tabell. De var interna hjälpmedel för att kontrollera varje verktyg mot dess egen evidens, inte en liga-tabell — och att publicera dem som en sådan skulle återskapa precis det falska intryck av exakthet som hela övningen försöker undvika. Det här är en sammanvägning av vad testbänken visade, inte en resultattavla.
Hela fältet på en och samma testbänk
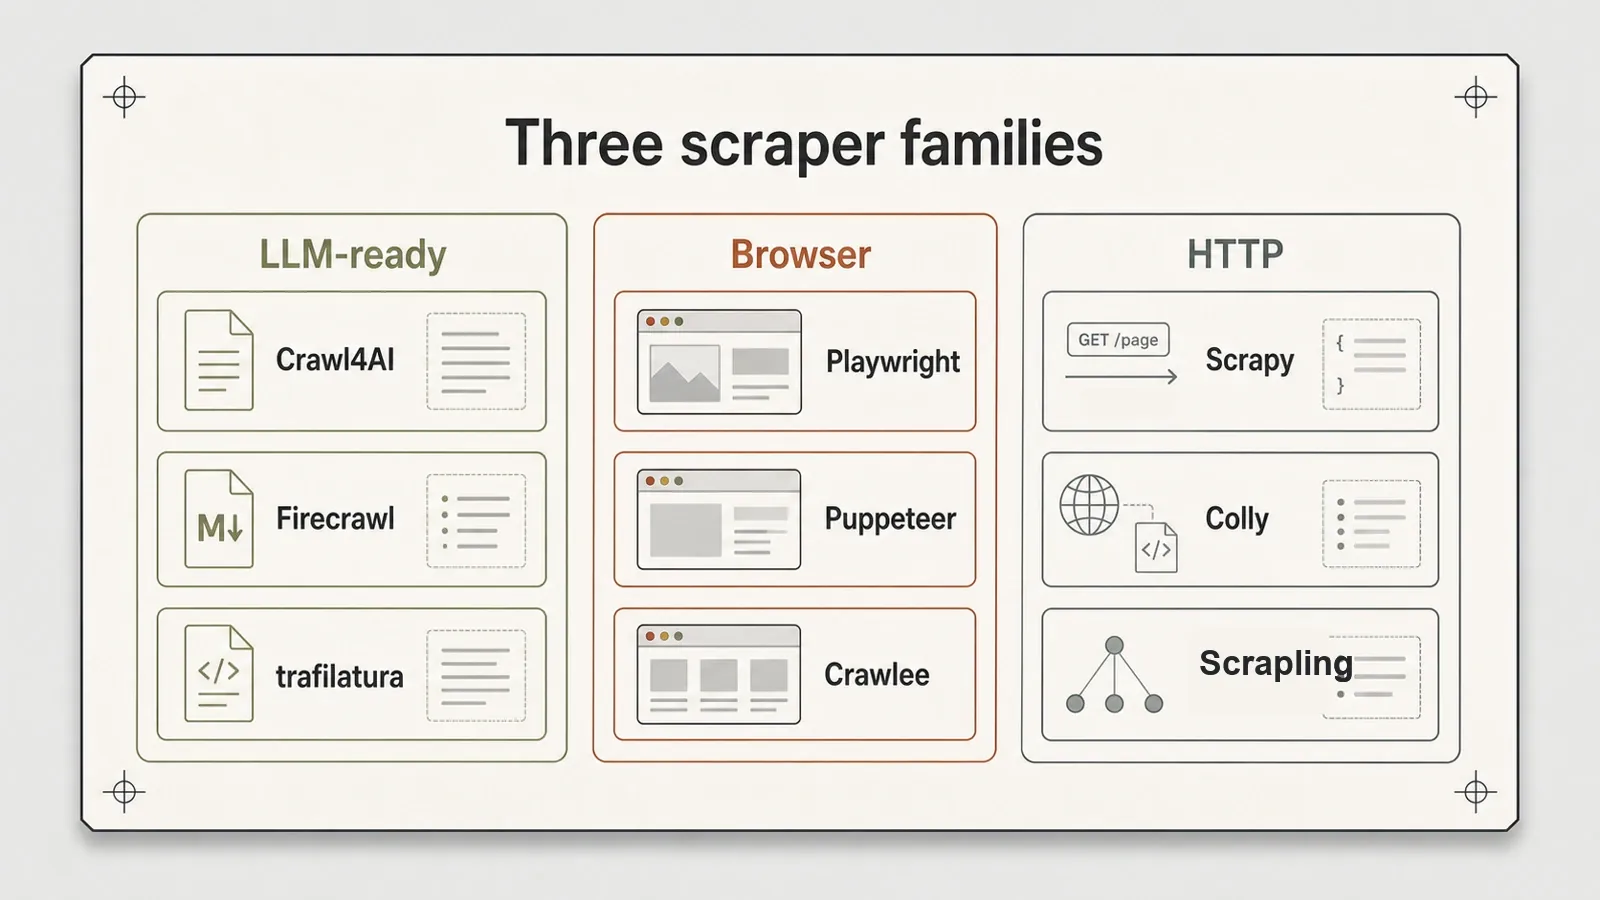
Läs de två kolumnerna i tabellen — “Renders JS?” och “Built-in crawl queue” — så framträder de tre jobben nästan av sig själva.
| Verktyg | Språk | Renderar JS? | Statisk träffsäkerhet | Strukturerad output | Inbyggd crawl-kö | Installationsvikt | Licens |
|---|---|---|---|---|---|---|---|
| Crawl4AI | Python | Ja (browser) | 6/6 (sida 1) | CSS-schema | Inbyggd BFS/DFS | Tung (2 browser-stackar) | Apache-2.0 |
| Firecrawl | Självhostad | Ja (playwright-service) | Full Markdown | Ja | /v1/crawl | Tyngst (6 containrar) | AGPL-3.0 |
| trafilatura | Python | Nej | 3/3 artikel | Nej (endast text) | Nej | Lätt | Apache-2.0 |
| Crawlee | Node/TS | Motorn kan väljas | 12/12 | Via extrahering | Ja (RequestQueue) | Medel (+~80 MiB) | Apache-2.0 |
| Playwright | Node/multi | Ja | 12/12 | Manuellt | Nej (egen BFS skriven för hand) | Medel (browser) | Apache-2.0 |
| Puppeteer | Node | Ja (Chrome) | 12/12 | Manuellt | Nej (egen BFS skriven för hand) | Medel (Chrome) | Apache-2.0 |
| Scrapy | Python | Nej | 12/12 | Feed-export (JSON/CSV/XML) | Ja (inbyggd) | Medel (Twisted-beroenden) | BSD-3 |
| Colly | Go | Nej | 12/12 | Via callbacks | Djupkontroll | Lätt (1 binär + Go) | Apache-2.0 |
| Scrapling | Python | Nej (HTTP-hämtare) | 12/12 | Ja | Nej | Medel ([fetchers]) | BSD-3 |
En notis om metadata i tabellen och längre ned: stjärnantal och versionsnummer fångades i början av juli 2026, och båda ändras snabbt. Kontrollera dem mot varje projekts GitHub- och paket-sida innan du betraktar dem som aktuella.
Översikt över enskilda verktygsdjupdykningar
Varje projekt i den här sammanställningen har en egen fördjupad recension:
- Crawl4AI review
- Firecrawl review
- trafilatura review
- Playwright vs Puppeteer comparison
- Crawlee review
- Scrapy review
- Colly review
- Scrapling review
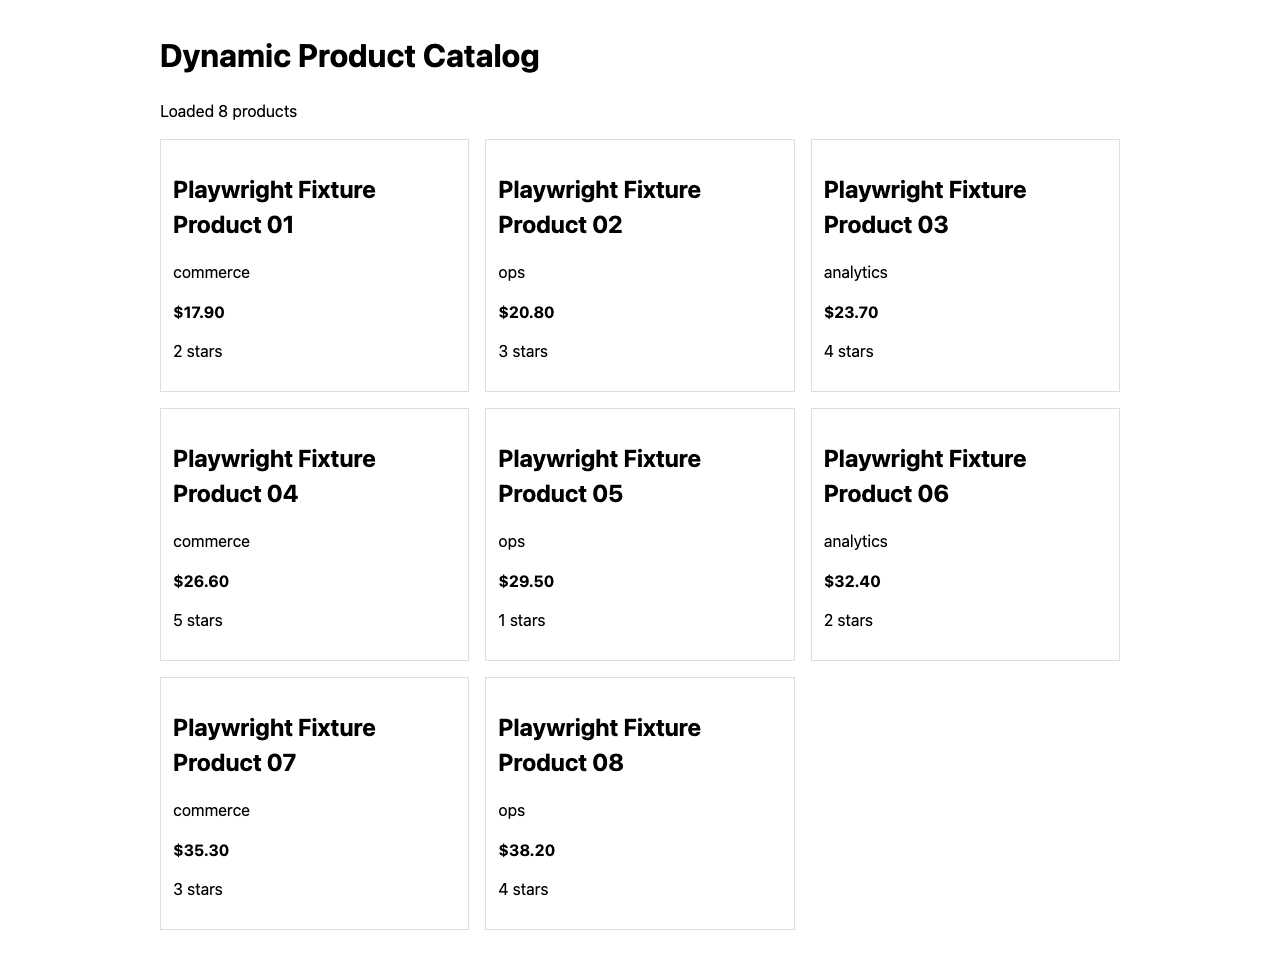
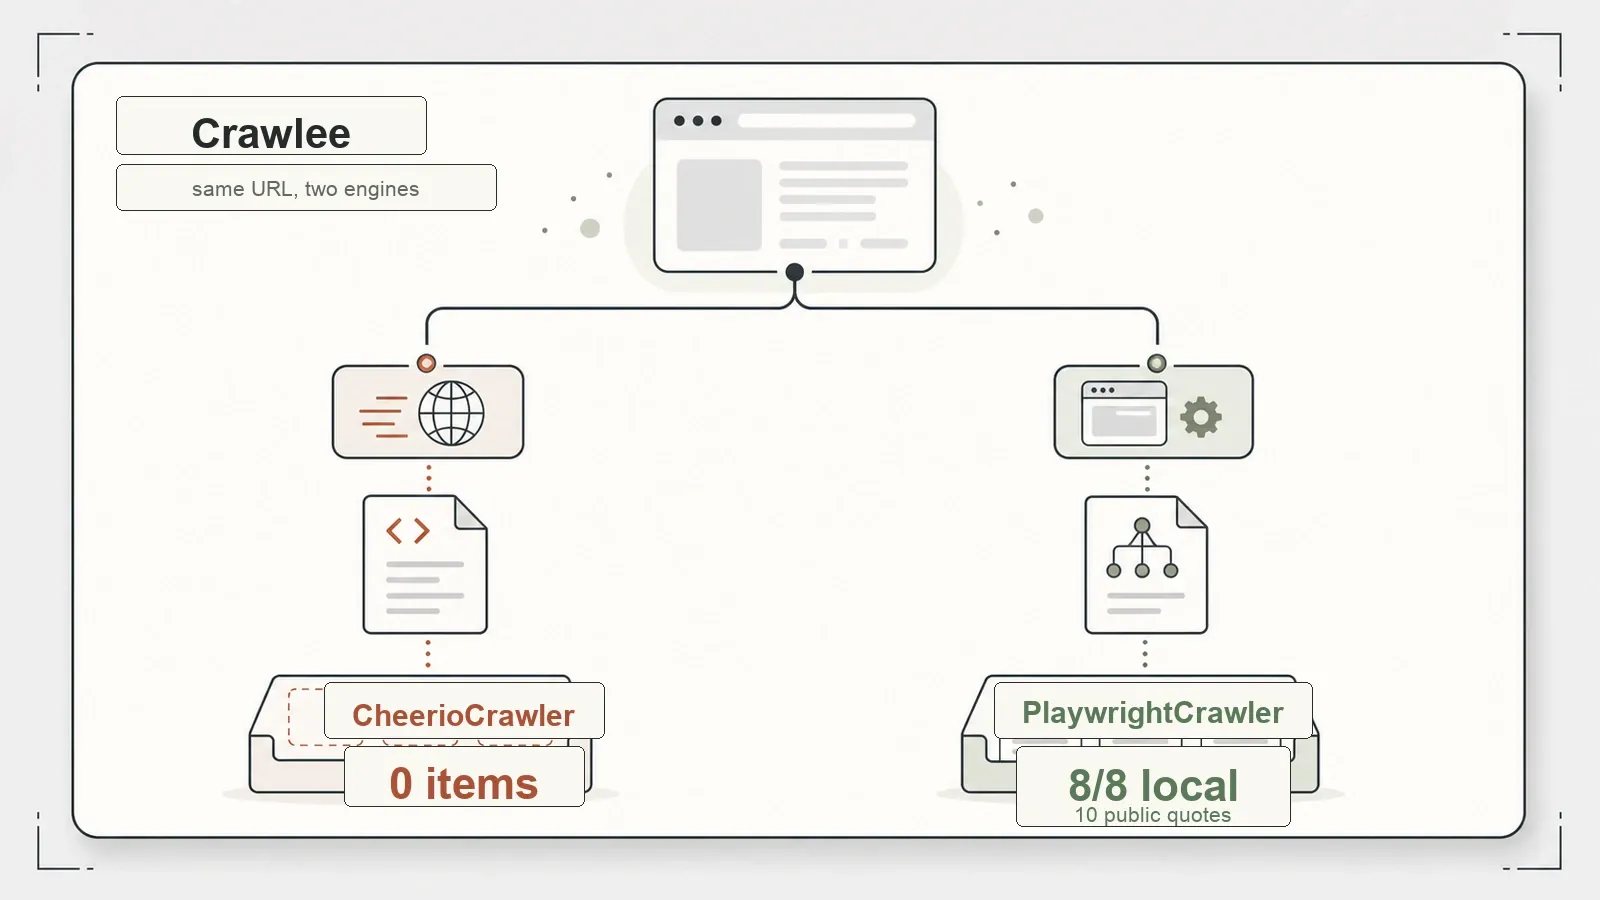
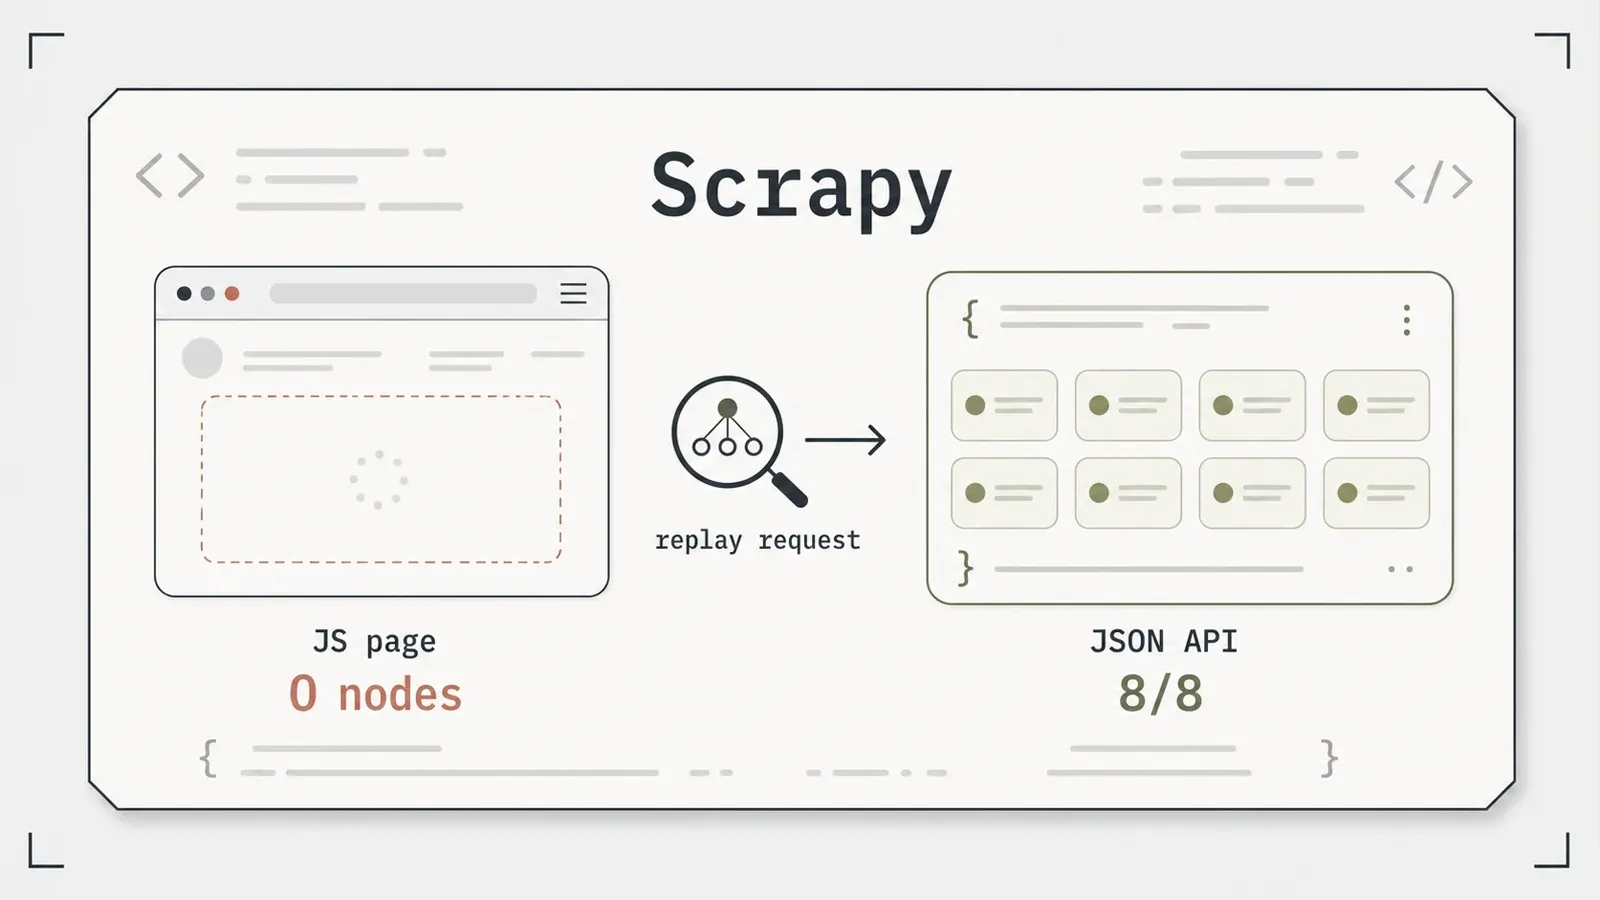
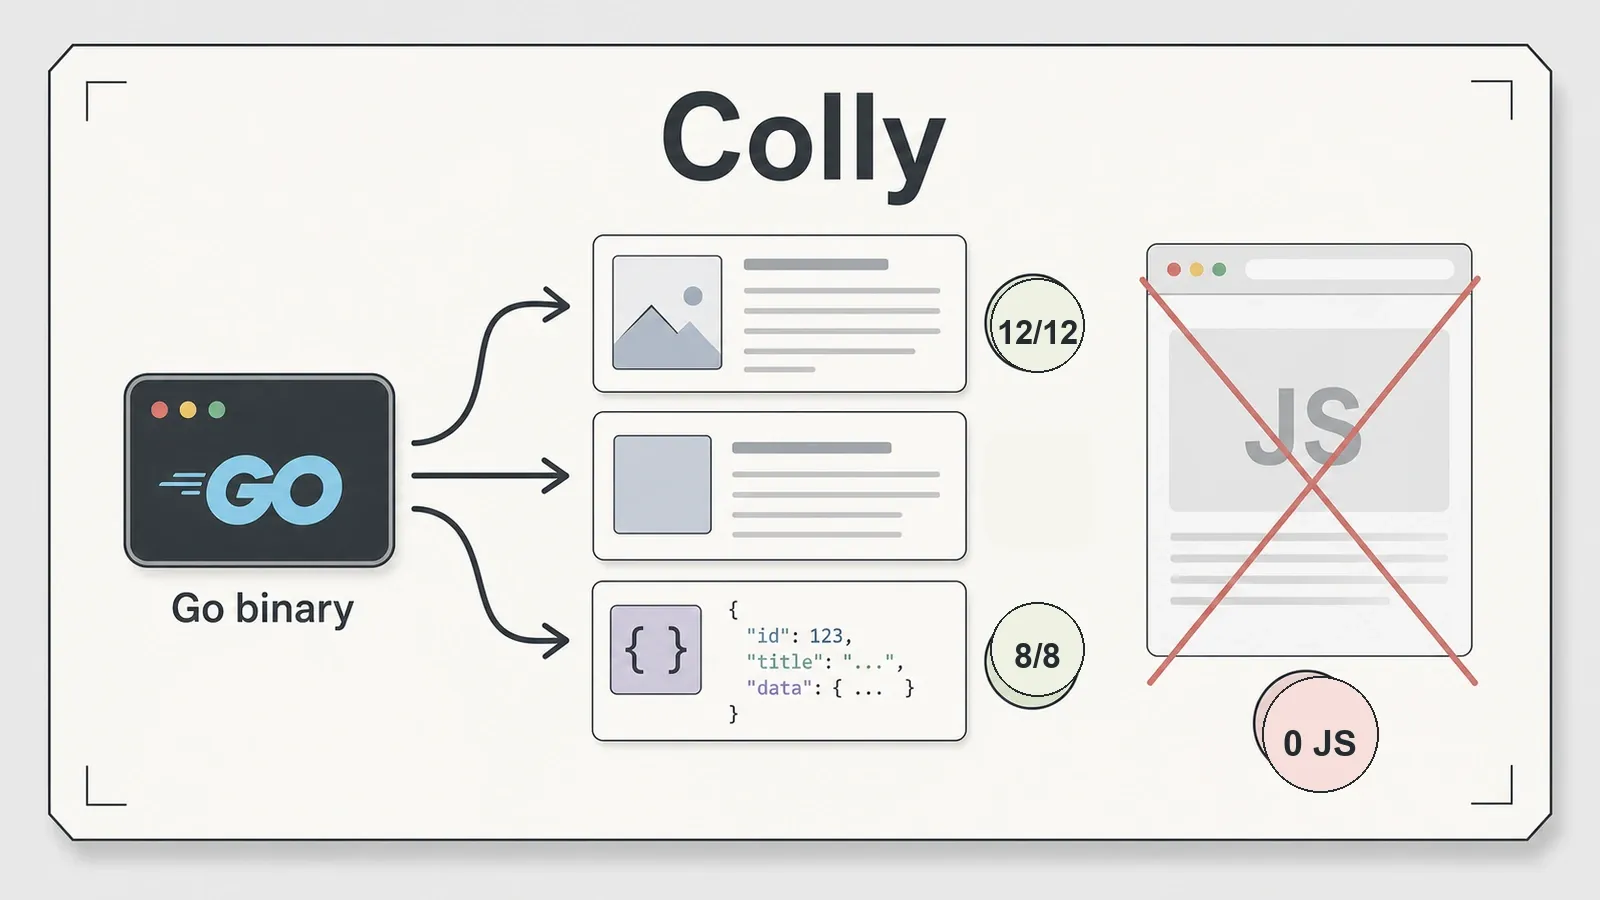
Här är deras omslag — plus två riktiga skärmbilder från testet med JavaScript-rendering, så påståendet om “8/8 dynamiska” inte bara är en siffra på en sida.
Jobb ett: gör om en sida till text som funkar för LLM:er
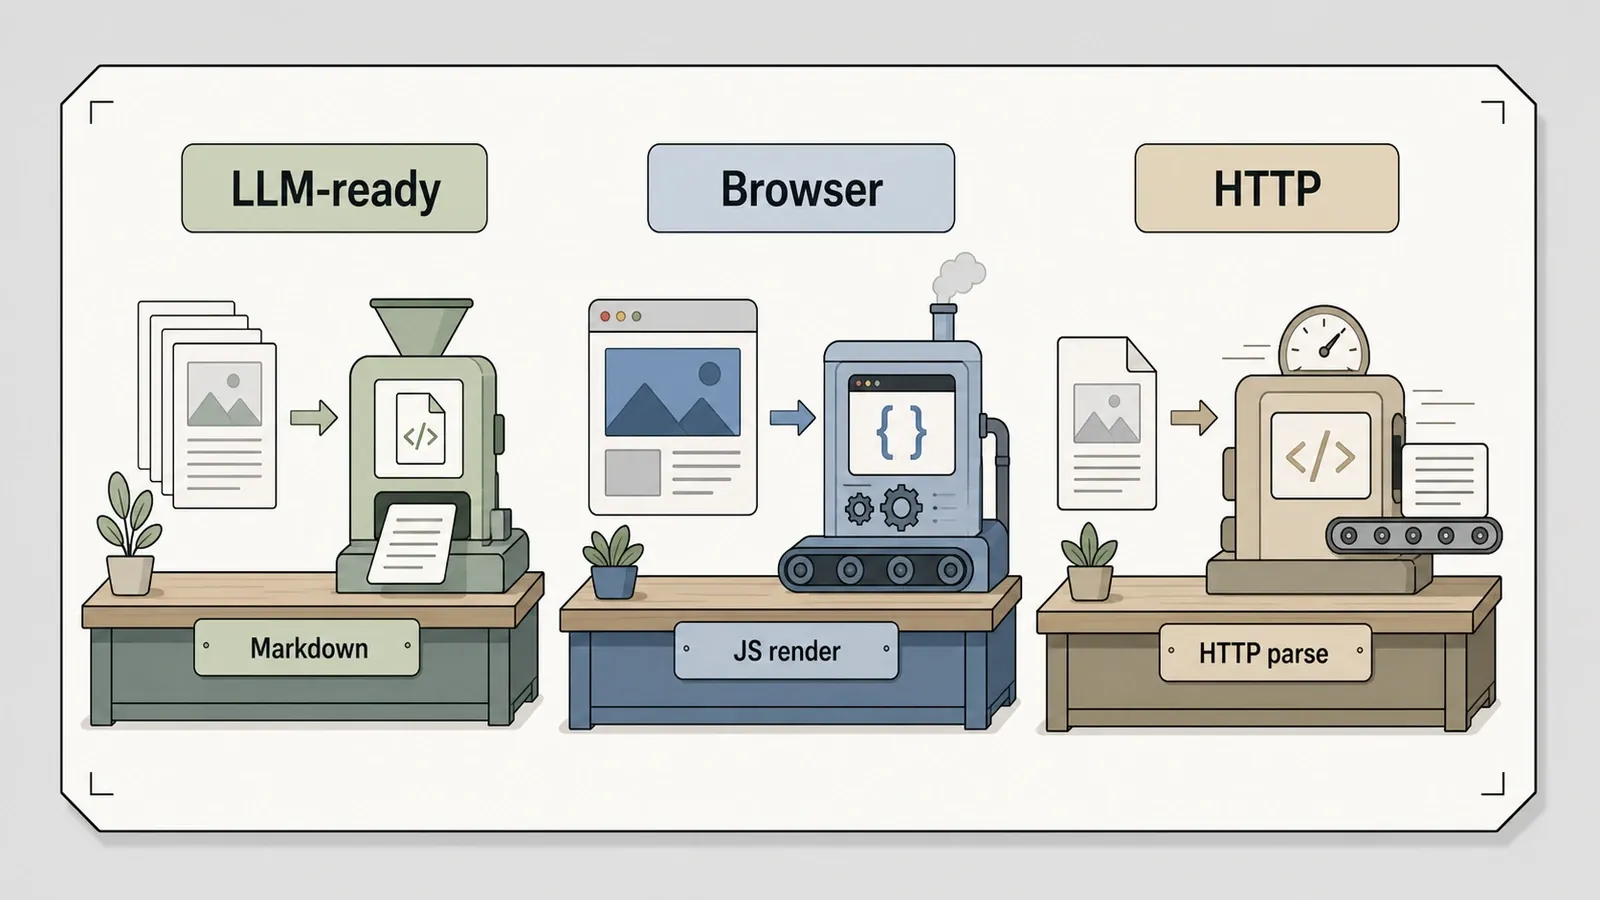
Om du vill ha ren Markdown att mata in i en RAG-pipeline är det tre verktyg som konkurrerar — och de kunde knappast vara mer olika utformade.
Crawl4AI är, bakom marknadsföringen, en browser-baserad Markdown-generator. Det är värt att slå hål på berättelsen om den “adaptiva intelligensen med självlärande selector” som följer med i sökresultaten: den har ingen sådan funktion — det är en annan biblioteks grej helt och hållet (mer om det när vi kommer till Scrapling). Det den faktiskt gör, gör den bra. På övningssajten Books to Scrape gav den 13 476 tecken Markdown, hanterar CSS-schemaextrahering för strukturerade uttag, och den inbyggda BFS-djupcrawlen följde 5 sidor i crawl-grafen samtidigt som den renderade en JavaScript-sida och tog en skärmbild. Två tydliga svagheter finns dock. Rå-MD:n innehåller sidans boilerplate om du inte aktiverar ett innehållsfilter, och det avsiktliga 500-felet kom tillbaka som success=false — inte för att Crawl4AI fångade HTTP-felet snyggt, utan för att dess egen innehållsheuristik tittade på det lilla felmeddelandet och klassade det som minimal_text ... blocked. Och installationen lägger två browser-stackar på disken. Version 0.9.0, Apache-2.0, ungefär 71k stjärnor i början av juli.
Firecrawl är tungvikten, och självhostning fungerar verkligen — jag säger “verkligen” eftersom stacken med sex containrar (api, playwright-service, redis, rabbitmq, nuq-postgres och foundationdb) faktiskt kom igång och gav 9 222 tecken LLM-redo Markdown från samma Books to Scrape-sida. Den renderade en JavaScript-sida via sin inbyggda playwright-service, och Einstein-citatet som lades in efter scriptet dök upp i resultatet, vilket visade att renderingen verkligen hade skett. Två problem jag stötte på berodde på miljön, inte på Firecrawl, och jag vill vara noggrann så att ingen kopierar fel lösning: en byggning från källkod fastnade i en containerd snapshotter-bugg under colima (jag bytte till förbyggda images), och colimas DNS-intervall 198.18.x.x utlöste Firecrawls SSRF-skydd, vilket jag löste med ALLOW_LOCAL_WEBHOOKS=true — en lokal utvecklingsworkaround, inte något man ska stänga av i produktion. Den självhostade kärnan saknar dessutom Fire-engine, molnlagret mot blockeringar, och jag testade inte moln-API:t. Den större varningsflaggan är licensen: Firecrawls självhostade kärna är AGPL-3.0, vilket kräver seriös juridisk genomgång innan kommersiell användning, inte en fotnot. Cirka 148k stjärnor i början av juli.
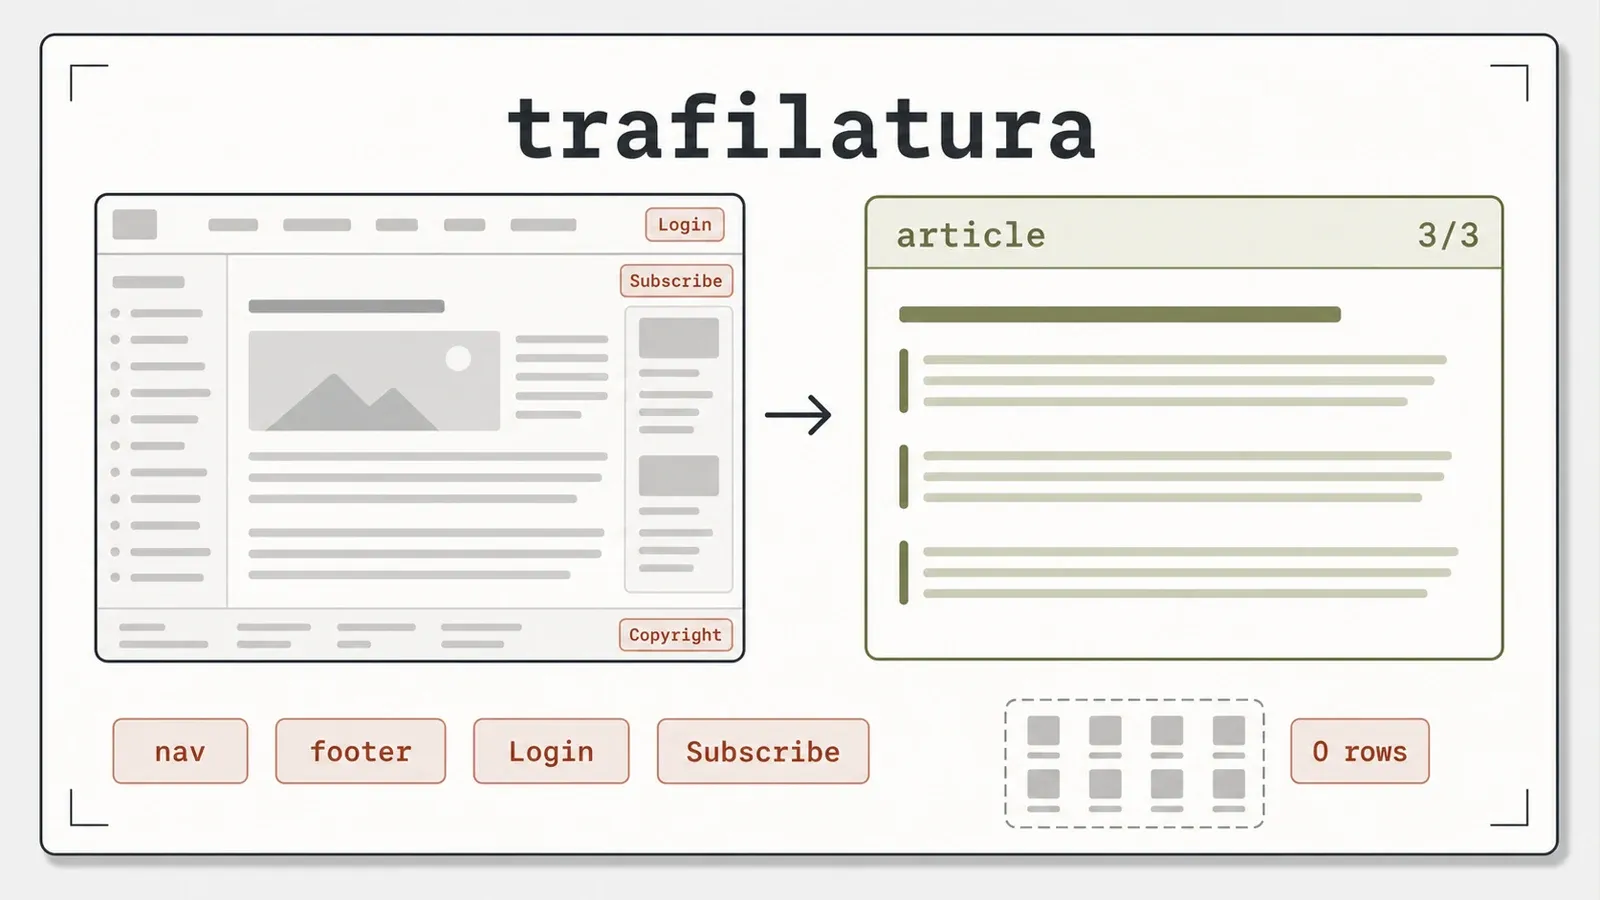
trafilatura är gruppens motvalls alternativ, och det är också det verktyg som AI-hypen ofta glömmer bort. Ingen browser. Inga strukturerade rader. Bara snabb, ren artikeltext i ren Python. På artikel-testfallet plockade det ut rubriken plus alla 3 av de 3 riktiga styckena, tog bort boilerplate helt — inget “Login”, “Subscribe” eller “Copyright” läckte igenom — och hämtade dessutom författare och datum. På en publik produktsida gav det 1 324 tecken ren text. Begränsningen är exakt det som designen antyder: riktar du det mot en katalog får du 12 produktnamn som text men 0 strukturerade rader — texten finns där, strukturen saknas, och inget JavaScript renderas. Version 2.1.0 (nuvarande version), Apache-2.0, omkring 6,2k stjärnor. För ren artikelextraktion är det det första jag skulle välja.
De två Markdown-siffrorna — 13 476 från Crawl4AI, 9 222 från Firecrawl — kom från samma publika sida, men läs dem inte som ett kvalitetsgap. De speglar olika Markdown-strategier (hur mycket sidans “chrome” som behålls), inte ett omdöme om vilket resultat som är bäst. Det är regeln om signaler inom verktyget från tidigare, som nu visar sig i praktiken.
Jobb två: rendera JavaScript på ett pålitligt sätt
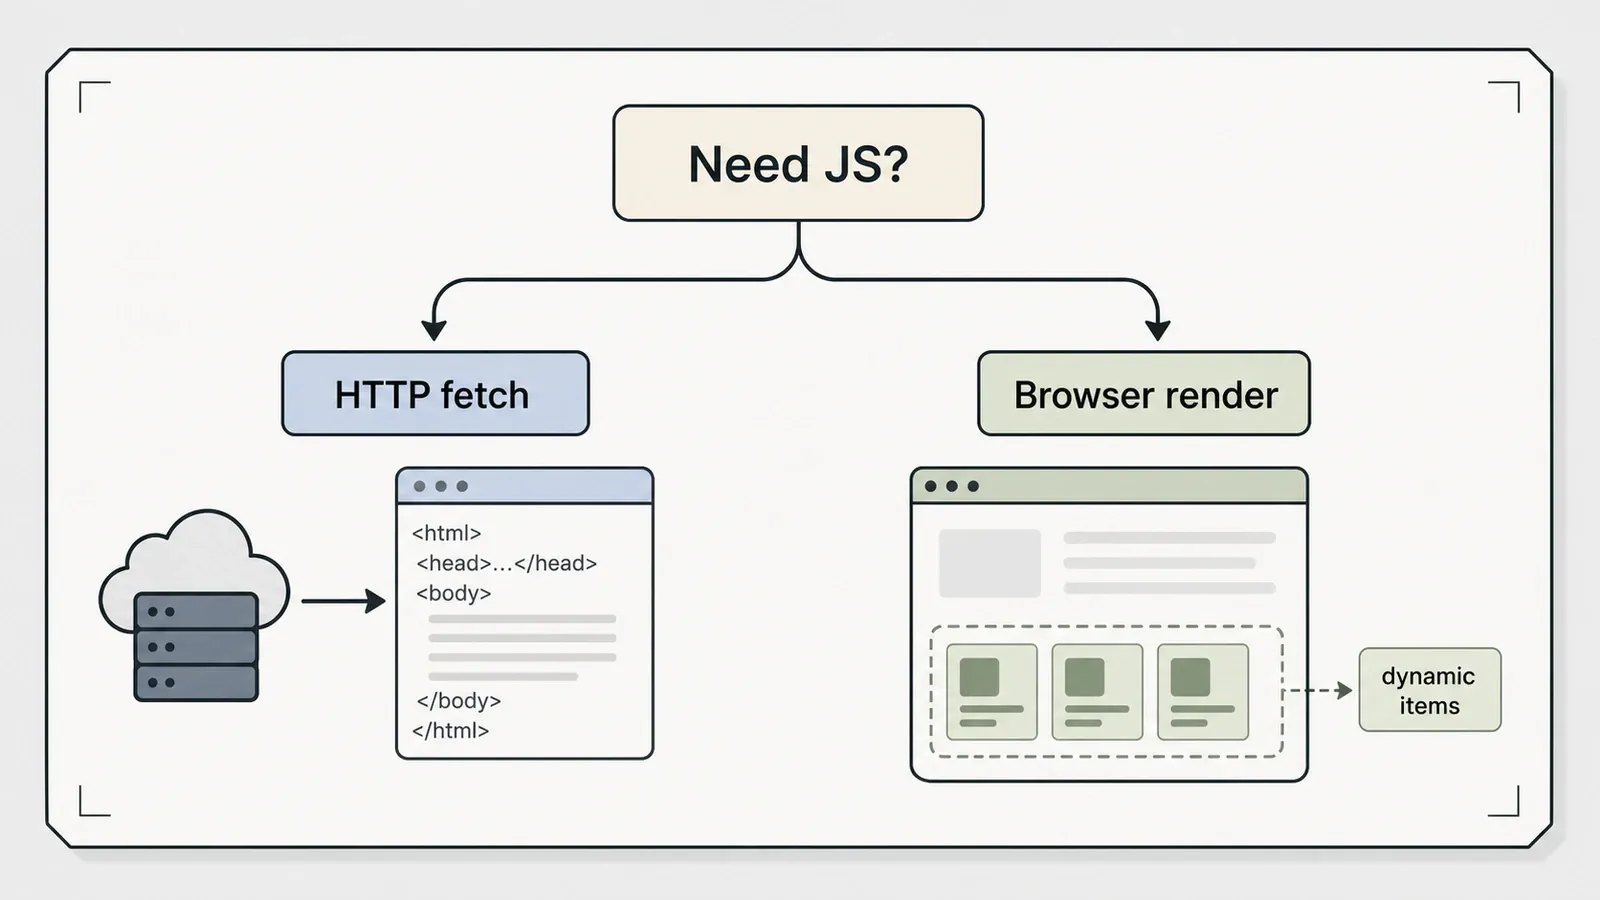
Viss data finns helt enkelt inte i HTML:en förrän skripten har körts, och det är då en riktig browser slutar vara valfri. Tre verktyg tävlar om den här uppgiften — och två av dem visade sig nästan vara samma verktyg.
Playwright och Puppeteer gick jämt upp i varje test jag kastade på dem. Båda renderade 8/8 dynamiska produkter i det lokala testfallet och 10 på den publika Quotes JS-sajten, båda nådde 12/12 i statisk träffsäkerhet, och båda hanterade 500-felet snyggt (Puppeteer returnerar ett response-objekt i stället för att kasta ett fel). Ingen av dem levererar en crawl-kö, så båda krävde BFS skriven för hand, vilket nådde 12 sidor över djup 0–2 i crawl-grafen. Den enda verkliga skillnaden är räckvidd: Playwright styr Chromium, Firefox och WebKit och talar Python och .NET, medan Puppeteer är Chrome-först och endast Node. Två förtydliganden, eftersom versionerna ändras snabbt: jag testade Playwright 1.56.0 mot en aktuell 1.61.1 och använde bara Chromium, samt Puppeteer 24.16.0 mot en aktuell 25.3.0 — kör om eller justera bedömningen därefter. Båda är Apache-2.0; ungefär 92k respektive 95k stjärnor.
Crawlee är verktyget som löser kö-problemet som de andra två lämnar öppet. Det paketerar en Cheerio-motor (HTTP) och en Playwright-motor (browser) bakom ett gemensamt API, och kontrasten på en enda sida är hela poängen: Cheerio-motorn såg 0 JavaScript-injicerade objekt, Playwright-motorn såg alla 8/8 lokalt (och 10 på den publika sajten), och bytet mellan dem är en ändring på en rad. Det ger dig också en riktig RequestQueue, vilket är anledningen till att det hör hemma i just den här uppgiften och inte i jobb tre. Nackdelen som ingen nämner i rubriken: browser-motorn kräver ett separat npx playwright install, ungefär 80 MiB som npm install crawlee inte hämtar åt dig. Version 3.17.0, TypeScript, Apache-2.0, cirka 24,6k stjärnor.
Jobb tre: crawla snabbt utan browser
När sidan inte använder JavaScript är en browser dyr överkurs. Tre HTTP-först-verktyg konkurrerar här, ett per språkfilosofi, och de skiljer sig åt på intressanta sätt.
Scrapy är det mest ingenjörsmässiga ramverket i gruppen — spiders, feed-export till JSON/CSV/XML, AutoThrottle, alltihop. Det nådde 12/12 i statisk träffsäkerhet, hämtade artikelns 3/3 stycken, följde 11 sidor över djup 0–2 i crawl-grafen och fångade 500-felet via handle_httpstatus_list. Det intressanta är dess synsätt: det renderar inte, det återskapar begäran. När det skickades mot JavaScript-sidan fick det 0 noder — och sedan gav JSON-API:t bakom samma sida det 8/8. Det är Scrapy-filosofin i en enda datapunkt: hitta den begäran sidan gör och spela upp den igen, i stället för att styra en browser. Priset är en ganska tung beroendestack (Twisted, lxml, parsel), och jag testade bara mot små testfall. Version 2.17.0, BSD-3-Clause, cirka 63k stjärnor.
Colly är Go-svaret, och det är befriande bokstavligt med vad det är: en ensam statisk binär, callback-driven via OnHTML, OnResponse och OnError, med djupkontroll. Den prickade 12/12 i statisk träffsäkerhet, hämtade 8/8 från JSON-API:t via OnResponse, fångade 500-felet via OnError, och nådde 17 sidor i en crawl på djup 2 — och jag uttrycker det exakt så, eftersom sidantalet kommer från testharnessen egen räknare, inte från någon fullständighetsgaranti från Colly. Det den inte gör är JavaScript: det dynamiska testfallet och Quotes JS-sajten gav båda 0, helt enligt designen. Du behöver Go-toolchain för att bygga den, och modulversionen (v2.3.0) ligger just nu före den taggade releasen (v2.2.0). Apache-2.0, ungefär 25k stjärnor.
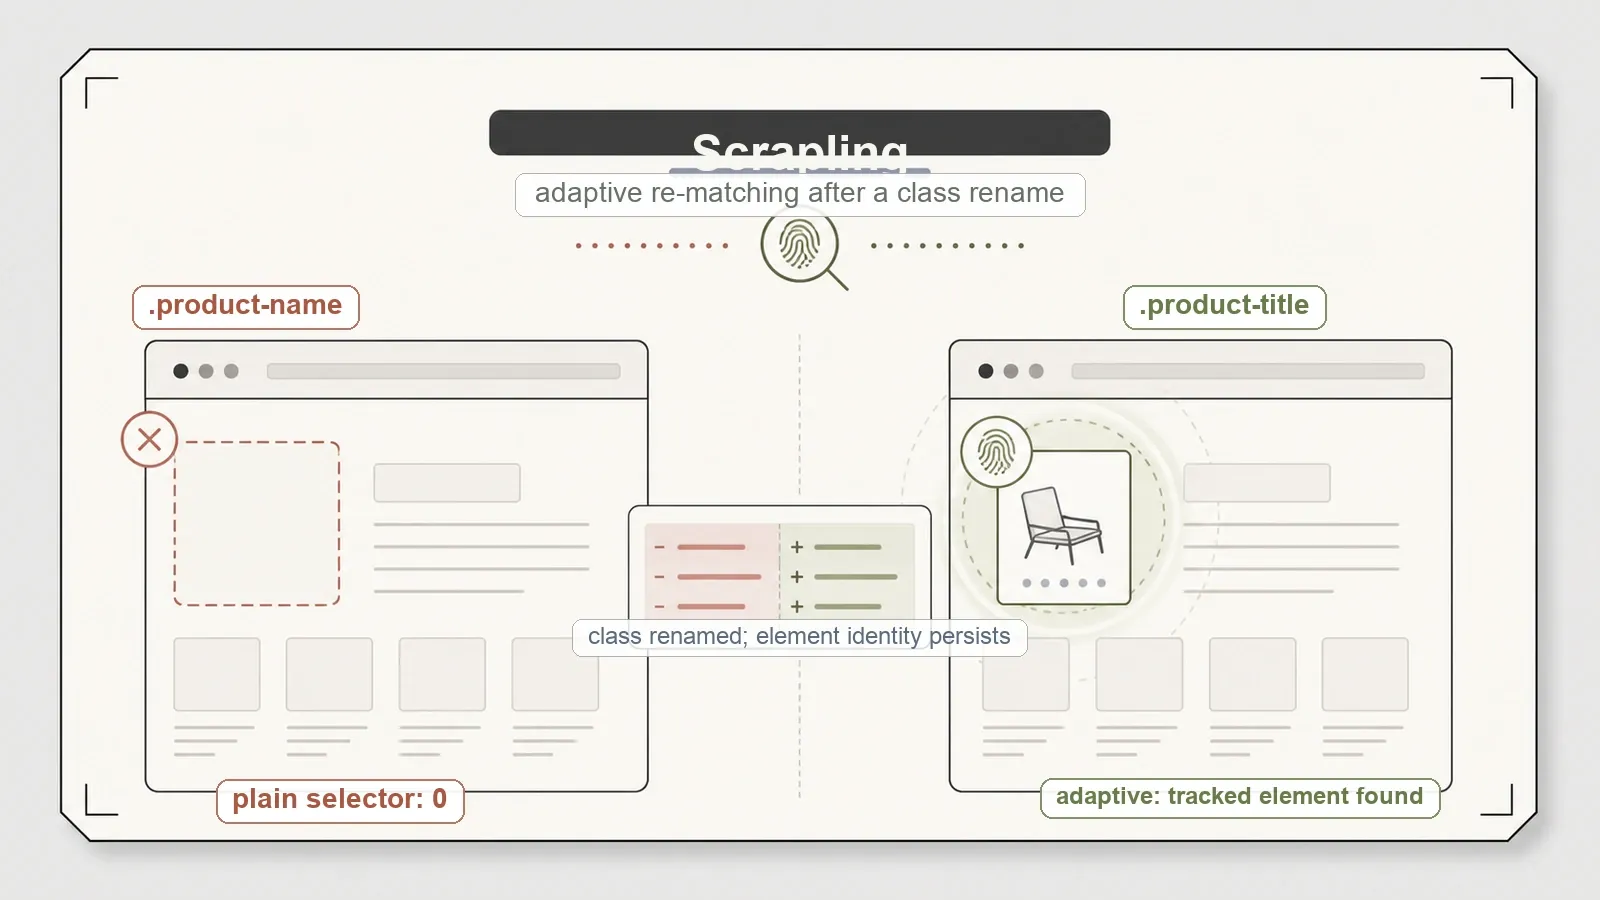
Scrapling är specialisten, och den förtjänar den etiketten. Dess adaptiva selektorer är byggda för att hitta ett element igen efter att markuppstrukturen har ändrats — så när jag bytte en targets HTML-klass från product-name till product-title, gav en vanlig selector 0, medan den adaptiva ommatchningen ändå hittade det spårade elementet. Vid vanlig HTTP-extrahering nådde den 12/12 på statiskt innehåll och 8/8 via JSON-API:t. Det som dess egen dokumentation inte döljer: i ett syntetiskt test med flera element återfann den 1 av 3 — det här är tålig elementspårning, inte total återställning, så översälj det inte för dig själv. Grundinstallationen pip install scrapling behöver dessutom extratillägget [fetchers] för att komma igång, och dess StealthyFetcher är en efterlevnadsfråga, inte en funktion jag skulle sätta på en slide. Version 0.4.10 (nuvarande version), BSD-3-Clause, runt 68,7k stjärnor.
Mönstret bakom de tre jobben
Lägg nio verktyg sida vid sida så framträder ett tydligt mönster. Full statisk träffsäkerhet — ett rent 12/12 — är grundkrav för alla HTTP-först-verktyg; ingen av dem snubblade på det enkla fallet, så där finns ingen differentierande faktor. Browser-verktygen motiverar bara sin extra tyngd när JavaScript faktiskt är med i bilden, och de betalar alla för det i installation: en browser-stack, en extra installation eller en hel containerflotta. Och kolumnen “built-in crawl queue” är egentligen gränsen mellan ramverk och motor — Scrapy och Crawlee ger dig orkestreringen, medan Playwright och Puppeteer låter dig skriva BFS själv. Det är så marknaden ser ut. Ingen vinner totalt eftersom ingen spelar samma spel.
Så vilket ska du faktiskt välja
Testet vägrar kröna en vinnare eftersom rätt svar inte är ett verktyg, utan en fråga — vilket av de tre jobben gör du?
- Behöver du Markdown som är redo för LLM:er? Välj trafilatura när det handlar om ren artikeltext, Crawl4AI när du också vill ha CSS-extrahering och JavaScript-rendering i samma bibliotek, och Firecrawl när du specifikt vill ha en självhostad tjänst och kan hantera både AGPL-3.0-licensen och vikten av sex containrar.
- Behöver du JavaScript-rendering? Välj Playwright eller Puppeteer för själva renderingen — välj efter motor och språk, eftersom de i övrigt är oavgjorda — och Crawlee när du dessutom vill ha crawl-orkestrering levererad i stället för att skriva den själv.
- Crawlar du statiska sidor eller reproducerbara API:er i stor skala? Scrapy för ett fullskaligt Python-ramverk, Colly för rå Go-hastighet i en enda binär, och Scrapling när det du kämpar med är att markupen förändras hela tiden.
Matcha verktyget med uppgiften och vartenda ett av dessa är ett försvarbart val. Väljer du fel kategori — ett browser-verktyg för statiska sidor, eller en HTTP-parser för en JavaScript-app — så hjälper inte ens det högst rankade biblioteket på internet dig.
När en hanterad AI-API i stället passar bättre
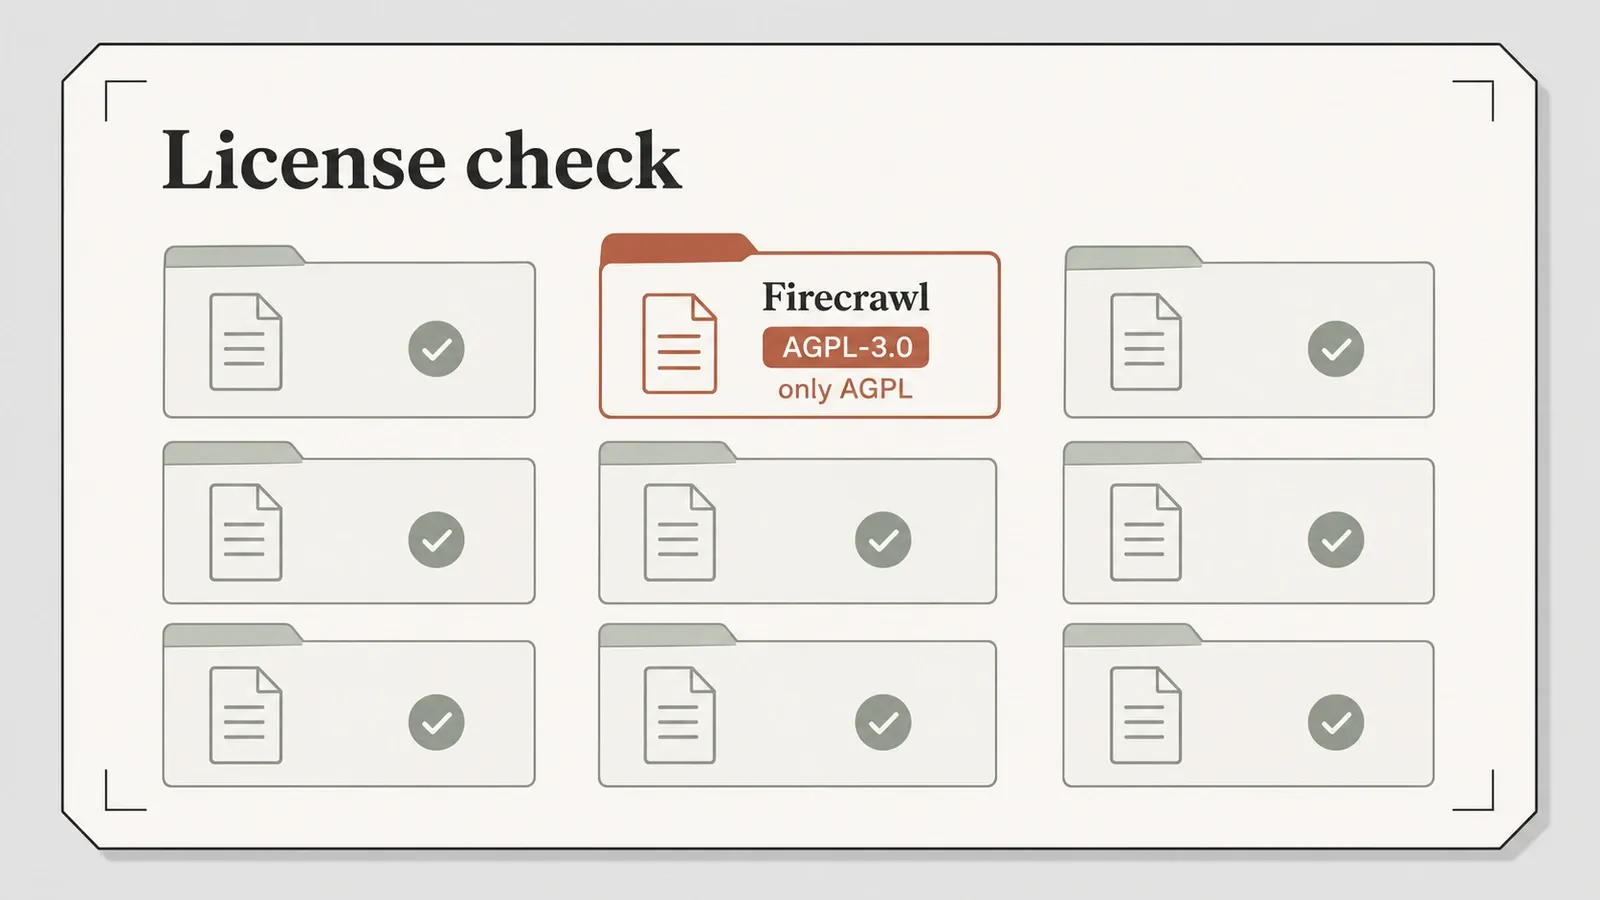
Alla verktyg ovan är fria, open source och dina att köra. Det är också den gemensamma avvägning som testet gång på gång visar: du äger browser-miljön, crawl-koden, kapplöpningen mot bot-skydd och allt underhåll. För många team är just den kontrollen poängen, och licenskartan spelar roll när du tar på dig den — större delen av fältet är permissivt licensierat (Apache-2.0 för Crawl4AI, Crawlee, Playwright, Puppeteer och Colly; BSD-3 för Scrapy och Scrapling), medan Firecrawls självhostade kärna med AGPL-3.0 kräver ordentlig granskning innan kommersiell användning.
Men lägg också märke till vad testet visade att de här verktygen inte gör. Renderar, crawlar, strukturerar och hanterar blockeringar — sällan allt på en gång, och aldrig utan att du själv underhåller det. En hanterad AI-scraping-API kapslar ihop hela stacken till ett enda anrop. Vår egen utvecklar-yta på Thunderbit är ett alternativ där, och för en teknisk publik är det API:t, MCP-servern och CLI:t som spelar roll, inte webbläsartillägget. POST /distill returnerar ren Markdown och POST /extract returnerar schema-definierad JSON, med JavaScript-rendering och bot-skydd hanterat server-side i stället för på din egen maskin. Det finns en officiell MCP-server för agenter och kodassistenter — thunderbit_suggest_fields är gratis och hjälper dig planera en extrahering, sedan gör thunderbit_distill (1 kredit) och thunderbit_extract (20 krediter) jobbet — och ett CLI som du kan köra via npx @thunderbit/thunderbit-cli för terminal och cron-jobb. För de icke-tekniska i teamet finns också ett kodfritt Chrome-tillägg, och prissättningen täcker båda behoven.
Avvägningen är densamma som hela den här testbänken kretsar kring: kör och underhåll upp till nio bibliotek själv utan kostnad per anrop, eller lämna över infrastrukturen och betala per begäran. Inget av valen är fel. Det handlar om hur mycket av stacken du faktiskt vill äga. Om du hellre vill se hur extraheringen fungerar i praktiken visar Thunderbits YouTube-kanal det steg för steg.
Slutsats
Det finns ingen enskilt bästa open source-scraper, och varje lista som självsäkert ger dig en sådan gömmer egentligen den fråga som avgör allt: vilket av de tre jobben gör du? Gör om en sida till text, rendera JavaScript eller crawla snabbt utan browser — fältet delas rent i de tre grupperna, och inom varje grupp handlar valet om språk och installationsvikt, inte om någon universell mästare.
Om du bara tar med dig en vana från detta, ta den här: testa på dina egna sidor innan du bestämmer dig. Varje siffra här går att reproducera i benchmark-repot av just den anledningen — för att verktyget som toppar en generell sammanställning och verktyget som klarar dina verkliga mål inte alltid är samma sak.
Testa Thunderbit för webbdatainsamling Get Started Free
Vanliga frågor
Vilken är den bästa open source-webbscrapern? Det finns ingen enda bästa — det beror på uppgiften. För text redo för LLM:er är trafilatura eller Crawl4AI starkast; för JavaScript-rendering är Playwright, Puppeteer eller Crawlee rätt val; för snabb HTTP-crawling är Scrapy eller Colly mest lämpade. I ett gemensamt testbänkstest var varje verktyg bäst i sin egen kategori och märkbart svagare utanför den, vilket är varför generella topplistor ofta vilseleder.
Vilka open source-scraprar renderar JavaScript? Crawl4AI, Firecrawl, Playwright, Puppeteer och Crawlees Playwright-motor renderar JavaScript. Scrapy, Colly, trafilatura och Scraplings standardiserade HTTP-hämtare gör det inte — de behöver antingen ett reproducerbart API bakom sidan (Scrapys angreppssätt, som fick 8/8 via JSON-endpointen) eller ett separat browser-läge.
Behöver jag en headless browser för att scrapa en sajt? Bara om datan dyker upp först efter att JavaScript har körts. Om ett vanligt HTTP-anrop plus en parser når innehållet är en browser dyr överkurs — då är Scrapy, Colly eller Scrapling mycket lättare och snabbare.
Vilken av dessa har den mest företagsvänliga licensen? De flesta är permissivt licensierade: Apache-2.0 (Crawl4AI, Crawlee, Playwright, Puppeteer, Colly) eller BSD-3-Clause (Scrapy, Scrapling). Undantaget är Firecrawls självhostade kärna, som är AGPL-3.0 och bör granskas ordentligt innan du bygger en kommersiell produkt på den.
Är de här benchmark-siffrorna reproducerbara? Ja. Varje körning, testfall och råresultat finns i ett publikt MIT-licensierat repo. En viktig detalj att komma ihåg: träffsäkerhet och strukturella resultat går att jämföra mellan verktyg, men absoluta teckenantal gäller bara inom respektive verktyg, eftersom varje paket speglar testfallen i stället för att dela en gemensam kanonisk kopia — jämför alltså andelar och pass/fail, inte råa teckensummor.




