
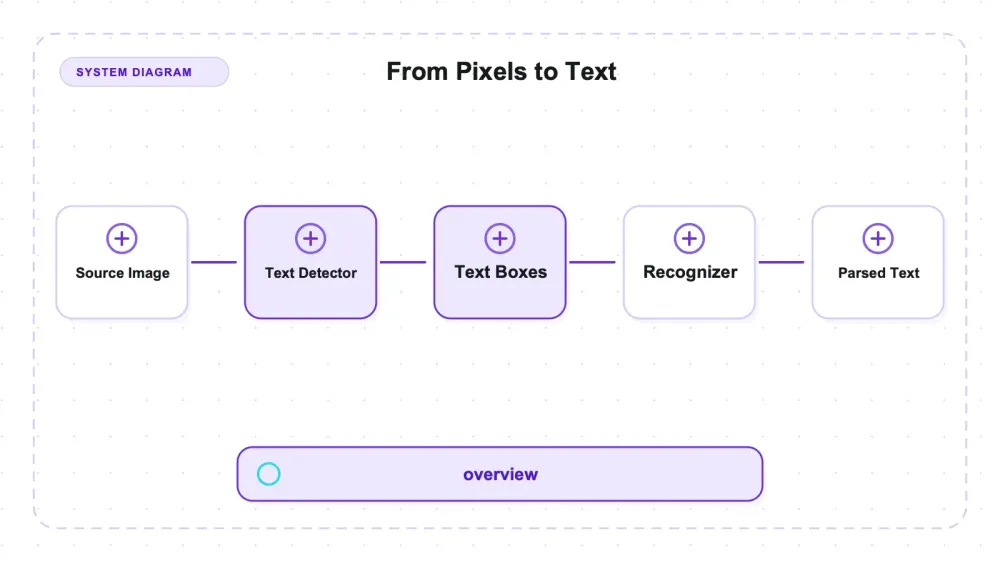
EasyOCR är JaidedAI:s färdiga OCR-bibliotek för Python: pip install easyocr, två rader kod, och texten som är inbäddad i en bild kommer tillbaka som strängar. Det är licensierat under Apache-2.0, stödjer över 80 språk och kör som en pipeline med två PyTorch-modeller — en CRAFT-detektor som ritar rutor runt allt den tror är text, och sedan en igenkännare som läser tecknen i varje ruta. De förtränade vikterna laddas automatiskt första gången du använder det. I praktiken är det ett självhostat alternativ till Tesseract och PaddleOCR, inte ett molnbaserat OCR-API per sida.
Grund-API:et är kort: Reader(['en']), sedan readtext(). Men driftskostnaden är större — ungefär 2 GB PyTorch i den här miljön och omkring en gigabyte i högsta använda minne i den mätta nystartade processen. Jag renderade 36 engelska PNG-fixturer, körde easyocr 1.7.2 på CPU och poängsatte läsningarna tecken för tecken mot genererad facittext. Storlek och orientering stod för de största felen i CER; dashboarden avslöjade också problem med korta tokens och felaktig tolkning av dollartecken.
Det skarpaste av dessa fel gäller den enda parameter som alla rekommenderar. rotation_info har ett rykte i issue-tracket som den fixen för roterade bilder, så den fick tre ortogonalt roterade kopior av samma mening. Vid 270° gjorde den exakt det den lovar och pressade character error rate från 0,83 till 0,10. Vid 180° fungerade den bara delvis: 0,85 till 0,67, med en fras som försvann. Vid 90° gick det bakåt, 0,81 till 0,92, och igenkännaren började returnera spegelvänd text. Samma parameter, samma lista med vinklar, tre olika utfall — att slå på den betyder alltså inte att “rotation är löst”. Samma 36 fixturer visade också en tydlig storleksgräns, ett systematiskt fel på dollartecken och en förutsägelse från min sida som visade sig vara helt fel.
Två modeller i en trenchcoat
EasyOCR är inte en modell. Det är en pipeline med två steg, och att veta vilket steg som misslyckades förändrar hur du felsöker.
Steg ett är CRAFT, alltså detektorn. Dess enda uppgift är lokalisering — att avgöra var i bilden det faktiskt finns text och lämna tillbaka rutor. Den läser aldrig ett enda tecken. Steg två är en CRNN igenkännare — ResNet för feature extraction, sedan en BiLSTM, sedan CTC greedy decoding — som läser tecknen i varje ruta. Båda körs i PyTorch. På CPU körs igenkännaren som standard dynamiskt kvantiserad till int8, vilket är en stor del av varför den är snabbare och lättare än vad den råa parameterstorleken antyder.
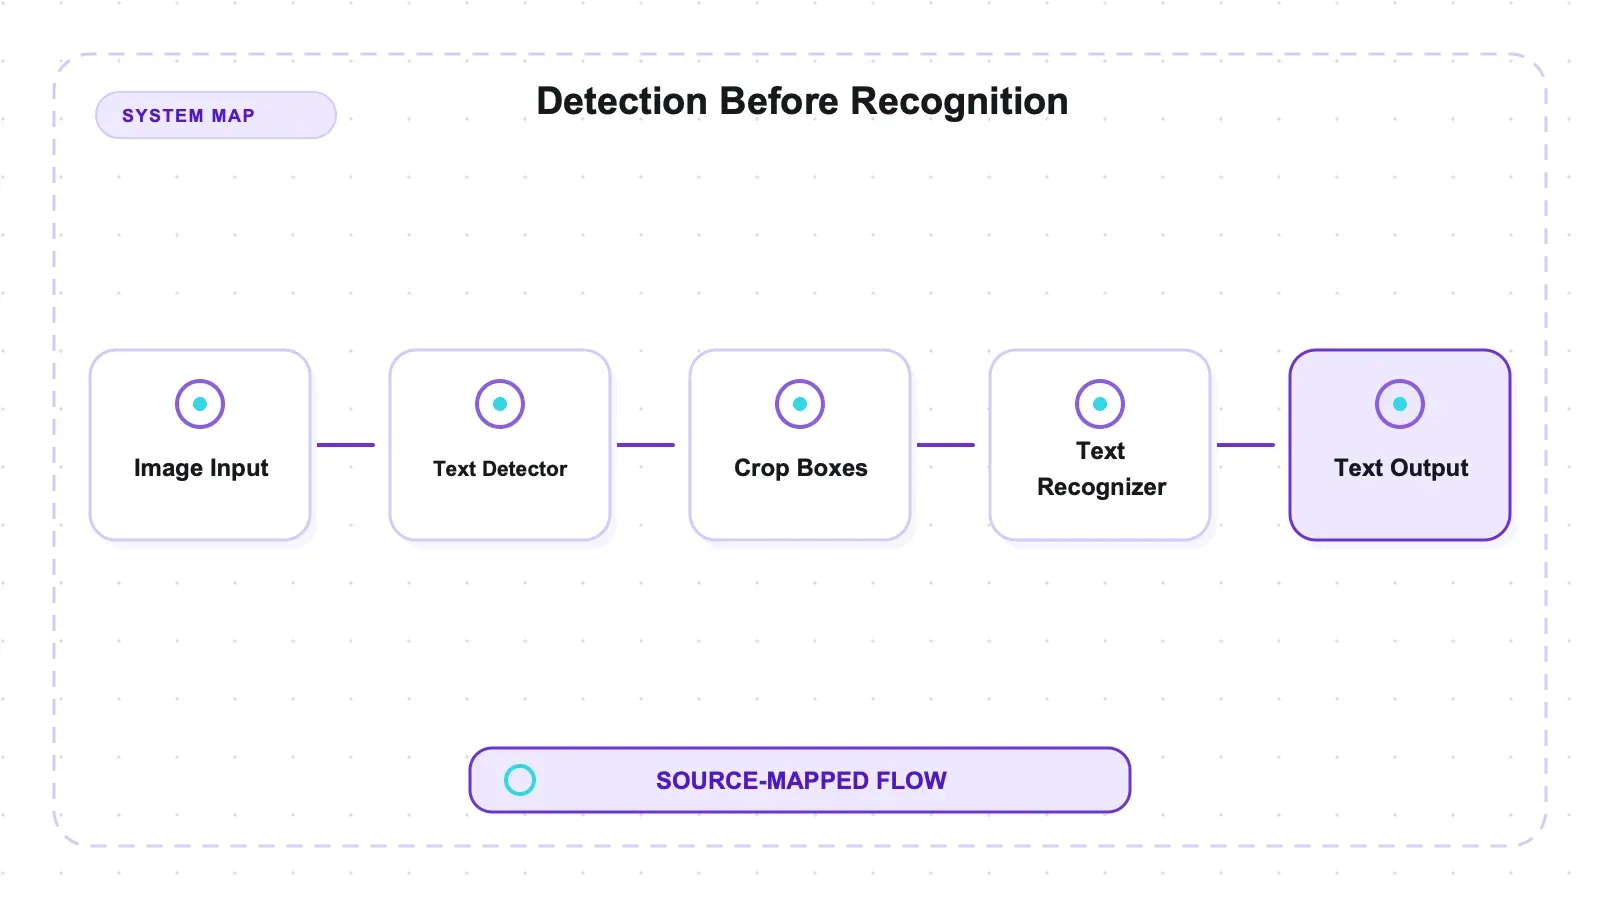
Den praktiska konsekvensen: EasyOCR har två helt olika felmoder, och de kräver olika lösningar. Om detektorn aldrig ritar en ruta hjälper ingen justering av igenkännaren — tecknen fanns aldrig ens i pipelinen. Om rutan finns men strängen blir fel är det ett igenkänningsproblem, och förbehandling kan rädda situationen. Nästan varje tråd om att “EasyOCR missade min text” jag har läst blandar ihop de två.
Nuvarande status för projektet, kontrollerad 27 juli 2026: 29 825 stjärnor, 528 öppna ärenden, Apache-2.0, och v1.7.2 från september 2024, med senaste push till master i december 2025. De datumen bevisar varken arkitektonisk stabilitet eller god underhållshälsa. Innan du väljer det, kontrollera kompatibilitet med din Python-/PyTorch-stack, hur snabbt underhållare svarar på senaste frågor och vilka ärenden som är relevanta för just dina indata.
OCR förknippas ofta med CAPTCHA-lösning, och det är inte användningsfallet här. Inget har testats mot, och inget här stödjer, att kringgå bot-skydd. Uppgiften här är att läsa text ur bilder och skärmdumpar som du faktiskt har rätt att läsa.
Vad jag mätte, och vad siffrorna inte täcker
Testmängden består av 36 PNG-filer som jag renderade själv: 35 bilder med en rad text, över sju typsnitt, åtta storlekar, sju kontrastnivåer, sju skevningsvinklar, tre ortogonala rotationer och tre bakgrunder — plus en syntetisk dashboard-skärmdump med 19 individuellt märkta element. Varje bild genererades från samma fasta sträng (Sphinx of black quartz, judge my vow. 1234567890 — 48 tecken, blandade versaler/gemener, siffror och skiljetecken) i samma pass som skrev facitetiketten, så bild och etikett kan fysiskt inte driva isär.
Noggrannheten mäts som character error rate (CER): Levenshtein-avstånd i tecken delat med facitets längd. CER 0 betyder perfekt läsning. CER 0,10 betyder ungefär att ett av tio tecken är fel. Jag redovisar case-sensitiv CER som huvudmått och case-insensitiv bredvid, eftersom det visar sig att den största delen av “felet” handlar om versaler/gemener.
Gränserna är viktigare än siffrorna:
- Endast engelska. Igenkännaren
english_g2. EasyOCR marknadsför över 80 språk; jag testade ett. Inget här säger något om icke-latinska skriftsystem, vilket är precis där de publicerade akademiska OCR-jämförelserna brukar ligga. - Endast syntetiskt. Renderad text, inte fotografier. Inget kamerabrus, inga JPEG-artefakter, ingen belysning, inget perspektiv.
- Ingen handskrift. Projektet själv anger att handskrift ännu inte stöds.
- Endast CPU. macOS arm64,
gpu=False. MPS fanns på maskinen, men EasyOCR använder CPU på allt som inte är CUDA. GPU-prestanda mättes aldrig, så inga GPU-siffror visas här. - En maskin, en version. easyocr 1.7.2, torch 2.13.0, Python 3.12.
Så: det här är kontrollerade envariabelkurvor som visar exakt var kvaliteten bryts, på ren renderad latinsk text. Det är inte ett verkligt korpusresultat, och det ersätter inte ett.
Bevisen går att granska direkt, inte bara i en notebook. Fixturgeneratorn och exakta strängar finns i tests/build_fixtures.py och tests/fixtures/ground_truth.json; igenkänning, timing och resursmätning finns i tests/run_easyocr.py; och tests/metrics.py räknar fram de rapporterade felfrekvenserna från råresultaten. De resulterande igenkänningsposterna och aggregerade måtten finns bevarade under artifacts/raw/. Att köra kedjan igen är användbart för att kontrollera just den här maskinen och versionen. Men det svarar fortfarande inte på hur EasyOCR beter sig på dina mobilbilder, språk, layouter eller förbehandlingskedja, så en produktionsutvärdering bör lägga till representativa indata i stället för att behandla dessa fixturer som ett certifieringspaket.
En fälla i testupplägget är värd att nämna, eftersom den nästan gav en felaktig huvudpunkt. Min första mätning rapporterade CER 0,375 på ren svart Arial, vilket vore uselt för ett så enkelt indatafall. Problemet var inte EasyOCR. Detektorn hade delat upp en visuell rad i en ruta för ord och en ruta för siffror, och min naiva sortering efter y sedan x satte siffrorna först. När jag fixade det med radmedveten gruppering (gruppera rutor efter vertikal överlappning och läs sedan från vänster till höger) landade rena typsnitt runt 0,04–0,10. Om du bygger din egen OCR-utvärdering väntar samma fälla där också.
Installation: liten install, tungt beroende
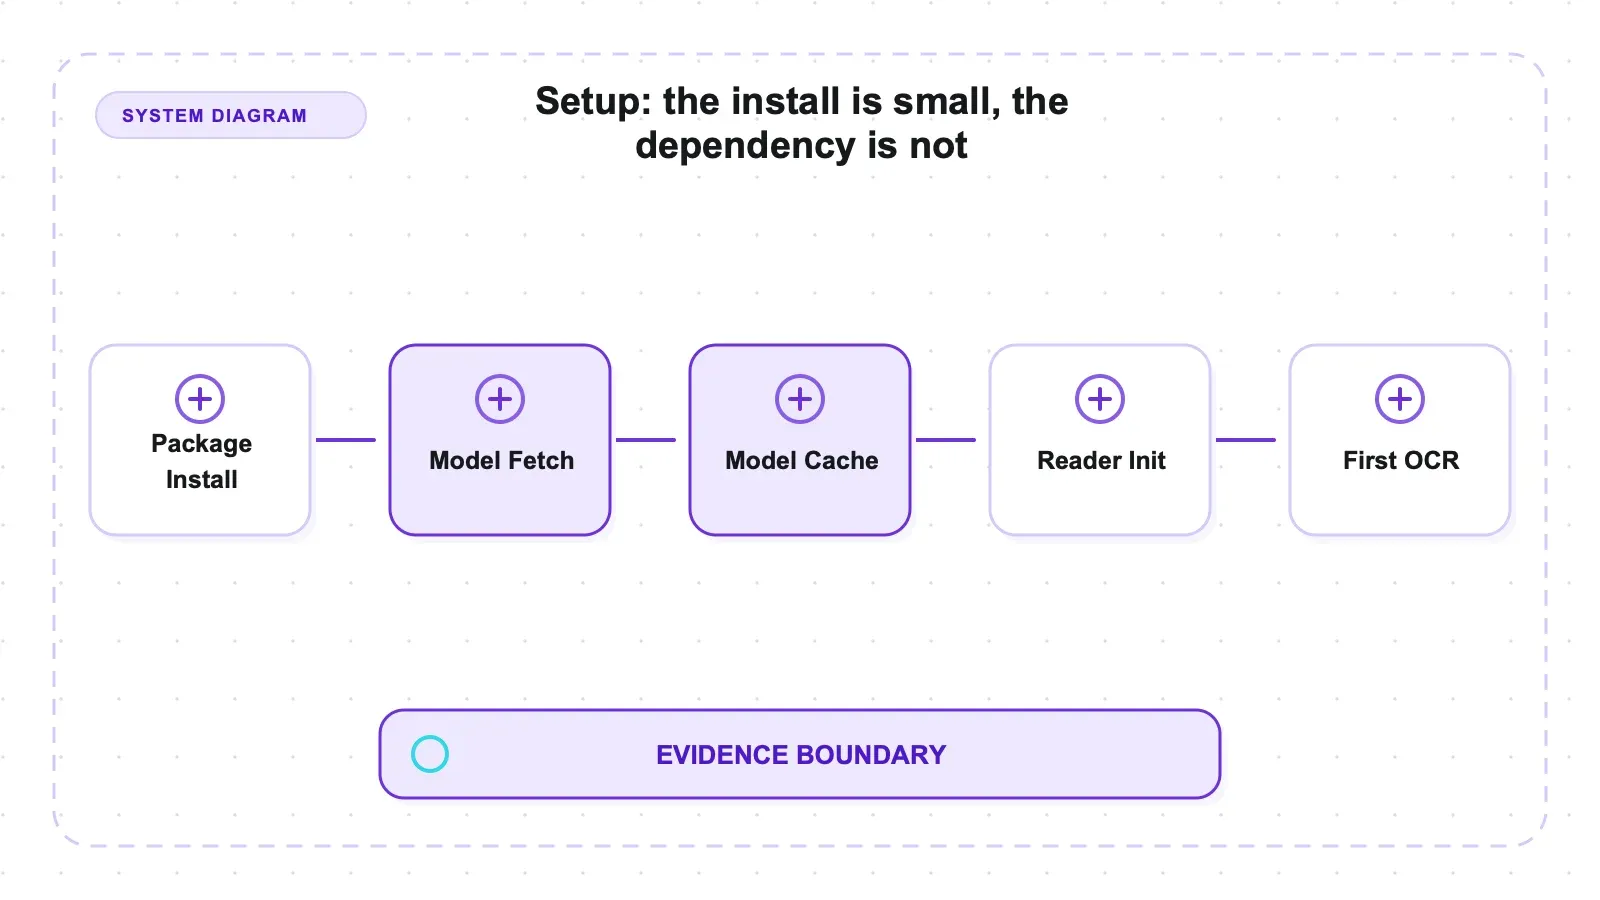
pip install easyocr
Det är hela installationen, och den är ärlig om väldigt lite. Själva paketet är obetydligt; det som följer med är PyTorch, ungefär 2 GB. Första gången du anropar readtext() laddar EasyOCR dessutom tyst ner sina vikter till ~/.EasyOCR/model/ — 93,7 MiB totalt, uppdelat i 79,30 MiB för CRAFT-detektorn (craft_mlt_25k.pth) och 14,44 MiB för den engelska igenkännaren (english_g2.pth).
Det här nämns inte i många guider, så: första körningen kräver nätverksåtkomst och pausar för nedladdningen, och varje containeriserad driftsättning måste antingen baka in vikterna i imagen eller betala för nedladdningen vid kallstart. När de väl är cachade körs allt offline.
Kall Reader()-initiering — modeller från disk till RAM, plus int8-kvantiseringssteget — tog 1,3–1,7 sekunder mellan körningarna. Därefter:
import easyocr
reader = easyocr.Reader(['en'], gpu=False)
result = reader.readtext('screenshot.png')
Och det fungerar. Två rader, inget att konfigurera, ingen checkpoint att jaga efter. “Easy” i namnet är välförtjänt i just det här skedet — friktionen ligger helt i beroendets tyngd, inte i API:et.
Golvet för ren text: nästan perfekta tecken, men inte perfekt versalisering
Sju systemtypsnitt, svart på vitt, 32 px, samma sträng varje gång:
| Typsnitt | CER (case-sensitiv) | CER (case-insensitiv) |
|---|---|---|
| Georgia | 0.0625 | 0.0000 |
| Times | 0.0417 | 0.0417 |
| Comic Sans | 0.0417 | 0.0208 |
| Arial | 0.0833 | 0.0208 |
| Verdana | 0.0833 | 0.0208 |
| Impact | 0.0833 | 0.0208 |
| Courier | 0.1042 | 0.0417 |
| Medel | 0.0714 | 0.0238 |
Medel-CER på 0,071, som sjunker till 0,024 när skiftläget normaliseras. Det är själva fyndet. EasyOCR tappar inte tecken på ren latinsk text — den får formen rätt och skiftläget fel.
Mer konkret återges det gemena ordet vow som VOW i sex av sju typsnitt (Comic Sans kompromissar till Vow). Impact lägger dessutom till of → Of. Det återkommande felet gäller också skiljetecken: punkt i slutet av meningen kommer tillbaka som : eller _ i flera typsnitt. Georgia blir en perfekt läsning så fort du slutar bry dig om versaler/gemener.
Det här är en riktigt användbar insikt. Om nästa steg är fuzzy matching, sökordssökning eller att mata text till en språkmodell kostar ett skiftbytesfel nästan ingenting. Om nästa steg är exakt strängjämförelse mot en databasnyckel kostar det allt. Normalisera skiftläge innan du jämför, så försvinner halva EasyOCR:s skenbara felfrekvens.
Att Courier var sämst (0,1042) stämmer också: monospace-typsnitt har onaturligt bredt mellanrum mellan tecken, vilket är svårare för en CTC-dekodare som tränats på mer typisk bokstavsspacing.
Storleksgränsen ligger precis där dokumentationen säger att den gör det
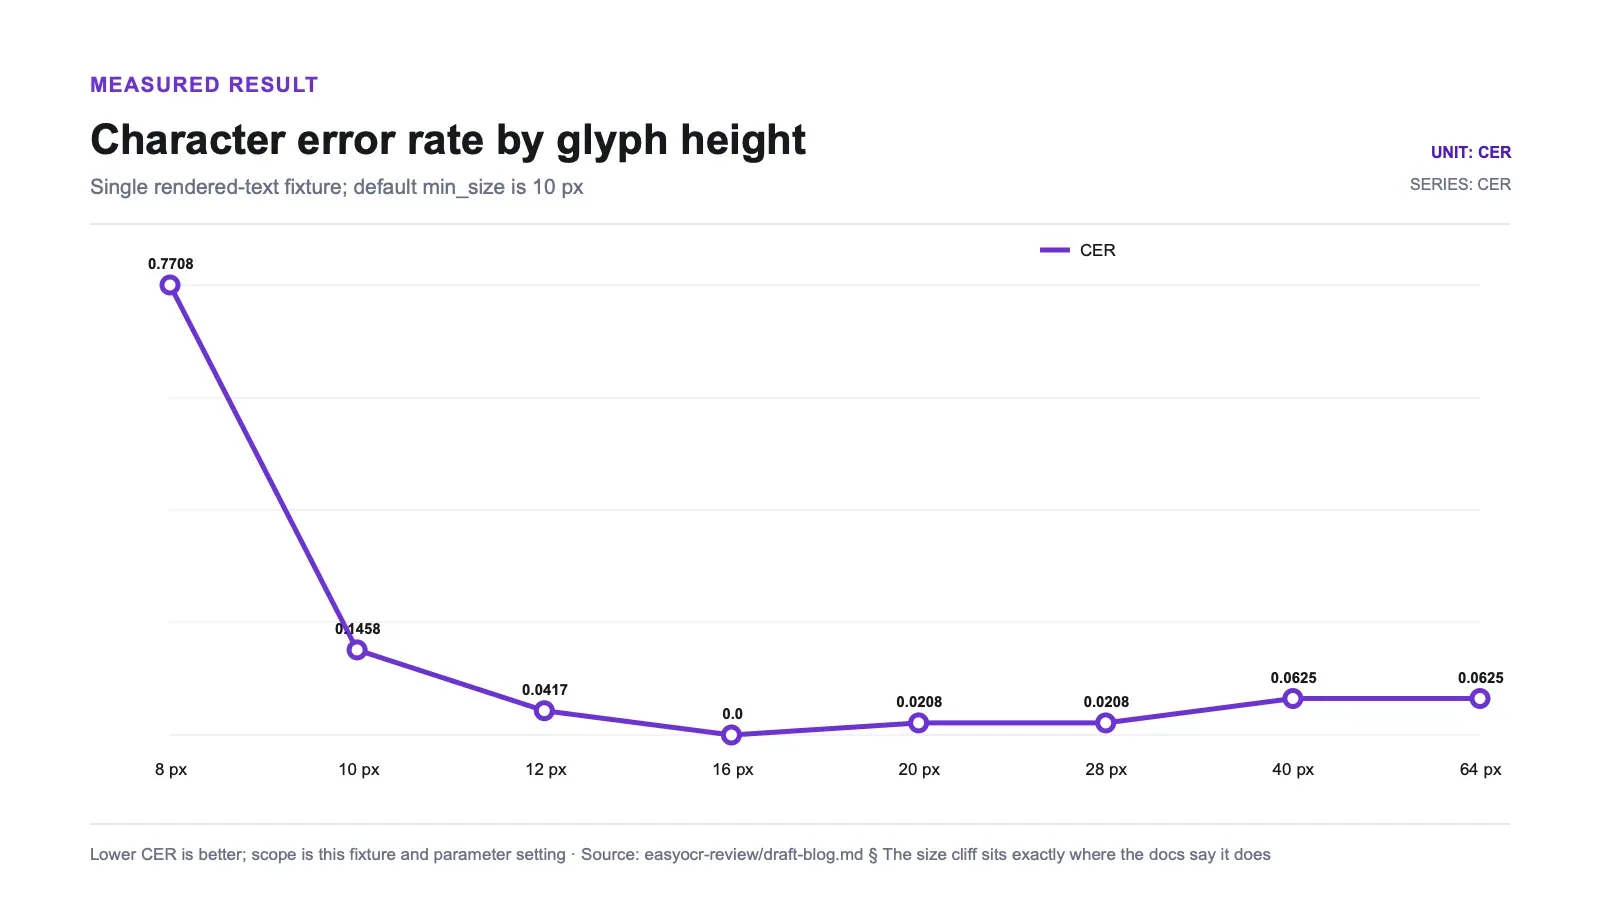
readtext() har en dokumenterad parameter, min_size=10, som kastar bort upptäckta rutor som är kortare än 10 pixlar. De flesta scrollar förbi den. För alla som extraherar från skärmdumpar eller PDF:er är den den enskilt viktigaste siffran i API:et, och här är vad den gör när man sveper över renderad teckenhöjd:
| Renderade px | CER | Vad som hände |
|---|---|---|
| 8 | 0.7708 | Kollapsade — rutor hamnar under min_size-filtret och slängs bort; bara fragment överlever |
| 10 | 0.1458 | Försämrad — precis vid gränsen delar detektorn upp raden i 3 rutor |
| 12 | 0.0417 | Återhämtad |
| 16 | 0.0000 | Perfekt läsning |
| 20 | 0.0208 | Ren |
| 28 | 0.0208 | Ren |
| 40 | 0.0625 | Ren (skiftfelet kommer tillbaka) |
| 64 | 0.0625 | Ren (skiftfelet) |
Språnget från 0,04 till 0,77 mellan 12 px och 8 px är inte gradvis försämring. Det är ett filter som gör exakt vad det är dokumenterat att göra, och resultatet blir att text under ungefär 10 px i praktiken är osynlig för standard-EasyOCR.
Det bästa intervallet är 12–28 px, med full CER på 0 vid 16 px. Över 40 px kryper CER upp igen — inte för att tecken försvinner, utan för att vow → VOW-felet återkommer. Stor text är alltså inte svårare att läsa; den drar bara inte längre nytta av den teckenavståndsstruktur som gjorde 16 px perfekt.
För alla som extraherar text från skärmdumpar: kontrollera renderad teckenhöjd innan du skyller på modellen. En dashboard som fångats i 1× på en HiDPI-skärm, eller en PDF-sida som rasteriserats vid 72 DPI, placerar ofta brödtext under 10 px. Fånga i 2× eller skala upp före OCR, så slipper du hela kategorin “EasyOCR ignorerade halva min sida”-buggrapporter. Om inget av det går, sänk min_size — men räkna med brus, eftersom filtret finns för att stoppa skräpupptäckter.
Rotation: 10° tolerans, och en fix som inte är symmetrisk
Först skevning. Små vinklar, Arial 32 px, standardinställningar kontra rotation_info=[90,180,270]:
| Skevningsvinkel | CER (standard) | CER (med rotation_info) |
|---|---|---|
| 0° | 0.0833 | 0.0833 |
| 5° | 0.0417 | 0.0417 |
| 10° | 0.0208 | 0.0833 |
| 15° | 0.2917 | 0.3750 |
| 20° | 0.7500 | 0.7708 |
| 30° | 0.8958 | 0.8750 |
| 45° | 0.8958 | 0.8750 |
Standard-EasyOCR hanterar skevning upp till ungefär 10° utan problem (CER ≤ 0,083), börjar vackla vid 15° och faller bort vid 20°. rotation_info gör inget för skevning, vilket är logiskt när man vet vad den gör — den provar bara på de vinklar du listar, och en skevning på 15° är inte 90, 180 eller 270. Vid 10° gjorde den faktiskt saker något sämre (0,021 → 0,083), eftersom ett försök med fel vinkel kan vinna i confidence-röstningen.
De ortogonala rotationerna är där det blir märkligt:
| Rotation | CER (standard) | CER (med rotation_info) | Återhämtad? |
|---|---|---|---|
| 90° | 0.8125 | 0.9167 | Nej — sämre |
| 180° | 0.8542 | 0.6667 | Delvis |
| 270° | 0.8333 | 0.1042 | Ja |
Samma parameter. Samma lista med vinklar. Tre olika utfall.
Vid 270° gör rotation_info exakt det ärendetråden lovar: CER faller från 0,83 till 0,10, vilket faktiskt är användbart. Vid 180° fungerar det bara halvt — CER förbättras till 0,67, men frasen my vow. försvinner helt. Vid 90° går det bakåt, från 0,81 till 0,92, och råresultatet förklarar varför: igenkännaren returnerar spegelvända strängar. VOW kommer tillbaka som MOA. quartz kommer tillbaka som zuuenb. Läs dem i en spegel så är de rätt, vilket är en rolig partytrick men en värdelös datapipeline.
Jag kontrollerade detta mot råprediktionerna snarare än de aggregerade måtten, eftersom “sammanfogningsordningen blandade ihop det” var min första misstanke. Det är inget join-artefakt — det var vad EasyOCR faktiskt returnerade.
Mekanismen är en hypotes, inte en mätning; inget experiment om rotationskonvention genomfördes. Pillow renderar positiva vinklar moturs, så bara den bild som renderats vid 270° råkar linjera med en återförsöksorientering som igenkännaren hanterar väl, och 90°-fallet får sin bäst scorande retry på en spegelvänd orientering. Oavsett mekanism är den operativa lärdomen densamma:
Det här visar att rotation_info inte kan antas bete sig symmetriskt över olika orienteringar. Validera de rotationer du faktiskt förväntar dig i dina indata; att normalisera orienteringen uppströms är en möjlig åtgärd, inte ett krav som fastställs av tre renderade exempel.
Förutsägelsen jag hade fel om
Jag gick in med antagandet att låg kontrast skulle vara EasyOCR:s mjuka underliv. Färglös grå text på vitt är den klassiska OCR-historien, och det finns dessutom en dokumenterad räddningsväg: contrast_ths=0.1 med adjust_contrast=0.5, som kör om lågkontrast-rutor med en förstärkt kopia och behåller det mer säkra resultatet.
Den triggas aldrig, eftersom den aldrig behövdes.
| Förgrundsgrå | Weber-kontrast | CER (standard) | CER (adjust_contrast=1.0) |
|---|---|---|---|
| 0 (svart) | 1.000 | 0.0833 | 0.0833 |
| 64 | 0.749 | 0.0833 | 0.0833 |
| 110 | 0.569 | 0.0833 | 0.0833 |
| 150 | 0.412 | 0.1042 | 0.1042 |
| 180 | 0.294 | 0.0625 | 0.0625 |
| 200 | 0.216 | 0.0417 | 0.0417 |
| 220 | 0.137 | 0.0417 | 0.0417 |
CER lämnar aldrig det rena bandet, hela vägen ner till Weber 0,14 — grå 220 på vitt, vilket är så svagt att jag fick kisande läsa fixturen för att bekräfta att texten faktiskt fanns där. Och kolumnen med kontrastförstärkning är identisk med standardkolumnen vid varje steg, eftersom standarden redan lyckades.
Bakgrunderna berättade samma sak. Svart text hela vägen:
| Bakgrund | CER |
|---|---|
| Enfärgad ljusblå panel | 0.083 |
| Vertikal gradient | 0.021 |
| Gaussian noise (μ200, σ22) | 0.000 |
En perfekt läsning på den mest brusiga fixturen i hela uppsättningen.
Omfattningen är smal: det här är enfärgad, brusfri låg kontrast, inte ett fotograferat kvitto med sensorsbrus och JPEG-komprimering. I denna fixturuppsättning stod geometri och korta tokens för de största felen; de testade färg- och syntetbrusvarianterna gjorde det inte.
Ett verkligt scenario: att plocka siffror ur en dashboard-skärmdump
Det här är det vanligaste verkliga OCR-fallet i Python. Någon skickar en skärmdump från en intern dashboard, eller så kör du en Python scraping pipeline mot en analys-sida med mycket diagram där siffrorna bara finns som renderade pixlar, och du vill ha värdena som data.
Jag renderade ett “Sales Dashboard”-fönster — mörk topp med titel och en cirkulär avatar-badge, tre KPI-paneler, tre knappar, en 2×3-tabell — och märkte upp alla 19 textelement med exakta strängar och pixelrutor, för att sedan matcha EasyOCR:s utdata mot dem via ruta-överlappning.
Detektionsåterkallelse: 16 av 19. De tre missarna:
- den ensamma bokstavs-badgen, "A"
- tabellcellen "Q1"
- tabellcellen "Q2"
Och "Q3" upptäcktes. Samma typsnitt, samma storlek, samma kolumn — detektorn behöll en token med två tecken och tappade två andra. Det var inkonsekvent mellan visuellt likartade celler. Eftersom utdata var deterministiska i dessa körningar är det här inte bevis för slumpmässigt “myntkastande” beteende. Ett närliggande problem med skärmdumpskvalitet är spårat i #460.
På de 16 element som faktiskt hittades var texten nära perfekt: medel-CER 0,027, med 13 av 16 helt korrekta. Titlar, etiketter, knappar ("Save", "Cancel", "Export CSV"), kolumnrubriker och tal med tusentalsavgränsare kom tillbaka med CER 0. 1,284 lästes korrekt, kommatecken och allt.
De tre ofullständiga läsningarna är alla samma fel. Dollartecken:
| Facit | EasyOCR läste |
|---|---|
$57,912 | S57,912 |
$18,330 | S18,330 |
$25,178 | S25,178 |
$12,004 | $12,004 (korrekt) |
Tre av fyra dollartecken blev ett versalt S. Visuellt är det förståeligt — men det betyder att varje valuta-fält i din extrahering är ett tecken från skräp, och en naiv float() kommer att kasta fel på dem alla.
Om din screenshot-pipeline innehåller korta etiketter eller valuta, validera möjliga åtgärder som uppskalning, beskurna rutor med marginal, begränsade fältförväntningar eller symbolmedveten efterbehandling. Inget av detta benchmarkades här, och ett regex som skriver om inledande S kan förstöra legitima värden. Korrigera bara där schema och valideringsregler gör det säkert.
Vad det kostar att köra
Siffror på samma maskin (macOS arm64, CPU, en värd, mätt under möjlig samtidig belastning — se detta som form, inte som ett universellt benchmark):
| Metrik | Värde |
|---|---|
| Modellvikter på disk | 93,7 MiB (79,30 detektor + 14,44 igenkännare) |
| Högsta residenta minne, fräsch CPU-process | 984,5 MiB |
Kall Reader()-initiering | 1,3–1,7 s |
| Varm latens, en ren rad med 48 tecken (p50) | ~0,062 s (p25–p75: 0,059–0,067 s, n=20) |
detail=0 vs detail=1 | ~lika (0,062 vs 0,063 s median) |
Den stora kostnaden är inte 94 MB vikter — det är ungefär en gigabyte resident minne per worker-process, ovanpå en PyTorch-installation på cirka 2 GB. Det är den siffran som avgör om detta ryms i din container, och det är den siffran nästan ingen nämner.
Hastigheten är bra för det enkla fallet. Under 0,1 s varm latens för en ren enradig text på CPU är fullt användbart. Men det är det enkla fallet: en kort rad med hög kontrast. De återkommande klagomålen om att "EasyOCR tar tiotals sekunder på CPU" handlar om stora dokument med många regioner över hela canvasen, och det reproducerade jag inte — annan arbetslast, och jag hänvisar till det i stället för att påstå det.
En liten myt att avliva: detail=0 gör inte EasyOCR snabbare. Det tar bara bort boxar och confidence-poäng från returvärdet. Själva beräkningen har redan skett. Medianerna skiljer bara någon millisekund, vilket är brus.
För- och nackdelar
Fördelar
- Teckenåterkallelsen på ren renderad latinsk text är i princip perfekt — medel-CER 0,071 case-sensitivt, 0,024 case-insensitivt, med full CER 0 möjlig vid 16 px.
- Verkligen ett två-raders-API.
Reader(['en'])följt avreadtext(), ingen konfigurering, inget modellval. - Betydligt mer kontrastrobust än ryktet antyder: ingen kollaps ner till Weber 0,14 på ren text, och brusiga/gradient-/färgade bakgrunder försämrade den inte (gaussian-brus-fixturen blev perfekt läst).
- Nära perfekt på de skärmdumpar den faktiskt detekterar: medel-CER 0,027, 13 av 16 helt rätt, inklusive tal med kommatecken.
- Deterministisk. Varje noggrannhetssiffra här var byte-identisk över två helt oberoende processkörningar; bara timing varierade.
- Apache-2.0 och självhostad, utan licensavgift till leverantör; kostnaden ligger i beräkning, minne, lagring och köhantering.
Nackdelar
- Hård kollaps under dokumenterade
min_size=10-gränsen — CER 0,77 vid 8 px. Liten UI-text blir osynlig som standard. - Skevningstoleransen stannar runt 10° och kollapsar vid 20°.
rotation_infoär ingen symmetrisk fix: 270° återhämtar, 180° delvis, 90° blir sämre och ger spegelvänd text.- Detektorn tappar isolerade korta tokens — en ensymbolsbadge och två celler med två tecken, medan en tredje identisk cell klarar sig.
- Systematiskt
$→S-fel på valutavärden (3 av 4). - Cirka 1 GB resident minne per process, plus ett PyTorch-beroende på cirka 2 GB.
- Senaste releasen är från september 2024; projektet är stabilt snarare än aktivt föränderligt.
Vem bör använda det, och vem bör låta bli
Utvärdera EasyOCR när dina indata är rena, upprätta, renderade texter i rimlig storlek — skärmdumpar, UI-captures, rasteriserade PDF:er eller genererade rapporter — och du vill ha en självhostad Python-pipeline utan avgift till leverantör. Resultaten för syntetisk engelsk CPU gäller just den här banan; fotografier, handskrift och andra skriftsystem kräver separat testning.
Låt bli om något av detta beskriver dina indata. Fotografier — mina siffror gäller syntetisk renderad text och säger inget om kamerabrus, perspektiv eller ljus. Handskrift — projektet påstår inte ens det. Icke-latinska skriftsystem — EasyOCR stödjer över 80 språk, men jag testade ett, och de publicerade akademiska jämförelserna är referensen där, inte ett syntetiskt engelsk-svep. Godtyckligt roterade indata — om du inte gör egen orienteringskorrigering först. Minnesbegränsade driftsättningar — en gigabyte per worker blir snabbt mycket.
Innan du väljer OCR bör du inspektera DOM och nätverksresponser. Om de önskade värdena redan finns som strukturerad text är det bättre att extrahera den källan än att använda OCR, eftersom du då undviker både detektions- och igenkänningsfel. OCR hör hemma där pixlar är den enda tillgängliga representationen.
Alternativ, och var vår stack passar in
EasyOCR är Apache-2.0 och självhostad, utan användningsavgift till leverantör men med verklig beräknings- och driftskostnad. PaddleOCR, Tesseract och vision-language-modeller kördes inte genom detta testbänk, så ingen direkt jämförelse dras.
Den mer intressanta jämförelsen är inte OCR mot OCR. Det är om du över huvud taget borde använda OCR.
Det mesta av skärmdumpsutvinningen jag ser är en nödlösning för en webbsida som var svår att skrapa — en JavaScript-renderad tabell, en dashboard bakom inloggning, en sajt som gjorde motstånd. Att ta en skärmdump och köra OCR känns som den enklaste vägen, men du kastar bort perfekt strukturerad text och betalar sedan en dollarteckensskatt för att få tillbaka en sämre version av den.
Författarnotis: Thunderbit är vårt hanterade alternativ för extrahering från webbsidor. Det kördes inte mot dessa bildfixturer. Den relevanta gränsen är källrepresentation: använd DOM-/nätverksutvinning när strukturerad webdata finns, och utvärdera OCR när pixlar är den enda källan.
Relaterad läsning från samma testbänk: den fullständiga jämförelsen av open source-scrapers, Crawl4AI-recensionen och en bredare genomgång av AI-driven extraktion för sidor som motstår selectors.
Prova Thunderbit för webbdataextraktion
Slutsats
Bör du använda EasyOCR? Ja, om dina bilder är upprätta, dina glypher är minst 12 pixlar höga och du läser latinsk skrift. Inom de ramarna är det mycket bra — medel-CER 0,071 på ren text, 0,024 när du normaliserar skiftläge, perfekt läsning vid 16 px och bättre kontrastrobusthet än ryktet antyder. API:et är verkligen två rader långt och utdata är deterministisk, vilket betyder mer än många vill erkänna när man felsöker en pipeline.
Utanför de ramarna faller det på specifika, lärbara sätt. Text under 10 px försvinner i min_size-filtret. Skevning över 20° förstör läsningen. rotation_info fixar en ortogonal orientering, halvlöser en annan och gör den tredje sämre med spegelvänd text. Enstaka bokstäver och tokens med två tecken faller ur detektorn medan grannarna klarar sig. Dollartecken blir bokstaven S.
Fixtur-felen kom från båda stegen: missade eller felorienterade rutor på geometrisidan, och förväxling mellan dollartecken och S på igenkänningssidan. Se uppskalning, orienteringsnormalisering, marginaliserade utsnitt och schema-medveten symbolreparation som kandidater att validera, inte som universellt säkra fixar.
Testa bara inte som jag nästan gjorde, med ett trasigt utvärderingsupplägg och en siffra du inte förstår. Rendera dina egna fixturer, vet exakt vad som är facit och hitta din egen brant.
Prova Thunderbit för webbdataextraktion Get Started Free
Vanliga frågor
Är EasyOCR tillräckligt exakt för textutvinning från skärmdumpar i produktion?
I den syntetiska dashboarden hade matchade element medel-CER 0,027 och 13 av 16 var helt korrekta. Tre av 19 element detekterades inte, och tre av fyra dollartecken blev S. Om det är acceptabelt — och om uppskalning eller schema-medveten reparation hjälper — måste testas på de faktiska layouterna.
Vilken minsta teckenstorlek kan EasyOCR läsa?
I praktiken ungefär 12 pixlar renderad glyphhöjd. Parametern min_size=10 i readtext() kastar bort rutor kortare än 10 px, och effekten är en klippkant snarare än en lutning: CER var 0,77 vid 8 px, 0,15 vid 10 px, 0,04 vid 12 px och 0 vid 16 px. Det rena bandet i mitt svep var 12–28 px. Om din källa är en HiDPI-skärmdump fångad i 1× eller en PDF rasteriserad vid 72 DPI, skala upp före OCR i stället för att sänka min_size, eftersom filtret finns för att stoppa skräpupptäckter.
Fixar rotation_info roterade bilder i EasyOCR?
Inte pålitligt, och inte symmetriskt. Med rotation_info=[90,180,270] på tre ortogonalt roterade kopior av samma mening återhämtade sig 270°-bilden tydligt (CER 0,83 → 0,10), 180°-bilden bara delvis (0,85 → 0,67, med en fras som försvann), och 90°-bilden blev sämre (0,81 → 0,92) samtidigt som den returnerade spegelvänd text som VOW → MOA. Den gör heller inget för små skevningsvinklar, eftersom den bara provar de vinklar du listar. Korrigera orienteringen innan du anropar EasyOCR i stället för att förlita dig på den här parametern.
Hur mycket minne och disk kräver EasyOCR?
Vikterna är 93,7 MiB, och laddas ner till ~/.EasyOCR/model/ vid första användning — 79,30 MiB för detektorn plus 14,44 MiB för den engelska igenkännaren. Högsta residenta minne i den mätta nystartade CPU-processen var 984,5 MiB, ovanpå en PyTorch-installation på ungefär 2 GB. Kall initiering av läsaren tog 1,3–1,7 sekunder; en ren enradig text kördes sedan med p50 runt 0,062 sekunder på den här maskinen. detail=0 ändrade returformatet, inte den uppmätta körtiden.
Är EasyOCR gratis för kommersiell användning, och underhålls det fortfarande? Det är licensierat under Apache-2.0, vilket är tillåtande och kommersiellt vänligt. Per 27 juli 2026 har repositoryt 29 825 stjärnor och 528 öppna ärenden, senaste release är v1.7.2 från september 2024, och senaste push till master var i december 2025. Tolka det som stabilt snarare än övergivet — arkitekturen har inte förändrats på ett tag och aktiviteten har flyttat till issue-tracket. Kontrollera själv aktuell licens och release-status innan du bygger vidare på det.




