
Docling hamnar ofta i samma fack som webbskrapare, men det är det faktiskt inte. Det är ett dokumentkonverteringsverktyg från IBM Research — numera ett projekt inom LF AI & Data Foundation — som tar filer du redan har (PDF, DOCX, PPTX, XLSX, HTML, bilder) och gör om dem till Markdown eller JSON. Deras egen tagline är bokstavligen "Get your documents ready for gen AI."
Det här är alltså en praktisk recension av en konverterare, inte en crawler. Allt nedan är uppmätt på en CPU-only-maskin (macOS arm64, Python 3.14.2, Docling 2.111.0), med poängsättning från scripts och fel loggade som fel. Repo:t är enormt och rör på sig varje dag — 63 069 stars, 4 449 forks och en push samma dag som jag hämtade metadata — så se alla siffror och versioner här som en ögonblicksbild, inte som något statiskt.
Vad Docling faktiskt är (och inte är)
Allt i Docling utgår från DoclingDocument: tolka en fil till den strukturen och exportera sedan Markdown, HTML, DocTags eller förlustfri JSON. Koden är MIT-licensierad (enskilda modelllicenser kan variera), projektet startade på IBM Research Zurich och när detta skrevs var senaste releasen v2.112.0, publicerad två dagar innan jag körde testet.
Den stora styrkan är PDF- och bildflödet. Det är inte vanlig strängparsning — det bygger på en kedja av maskininlärningsmodeller: en RT-DETR-layoutmodell, TableFormer-modellen för tabellstruktur, en valfri vision-language-modell och RapidOCR för skannade dokument. De modellerna återskapar sidlayout, läsordning och tabellstruktur. Det är den delen som är värd att granska, och den delen skulle ett test med enbart HTML aldrig fånga.
En viktig distinktion sparar en veckas förvirring. Docling hämtar ingenting. Den renderar inte JavaScript, den tar sig inte förbi anti-bot-skydd och den crawlar inte. Du står för filen; Docling står för tolkningen. Crawling är ett annat verktygs uppgift, vilket blir viktigt senare när folk undrar om Docling ersätter Firecrawl (det gör den inte — de kompletterar varandra, och jag återkommer till varför).
Första körningen som ingen varnade dig för
pip install docling går igenom utan problem på Python 3.14.2. Sedan tittar du i venv:n och ser att den är 1,3 GB. Docling drar in hela ML-stacken som hårda beroenden, även om du bara tänker konvertera en HTML-fil:
| Beroende | Storlek på disk (MiB, du) |
|---|---|
| torch (2.13.0) | 536 |
| opencv (cv2) | 119 |
| transformers (5.8.1) | 101 |
| scipy | 99 |
| sympy | 76 |
| pandas | 72 |
| rapidocr (+ medföljande modeller) | 72.1 |
| docling_parse | 30 |
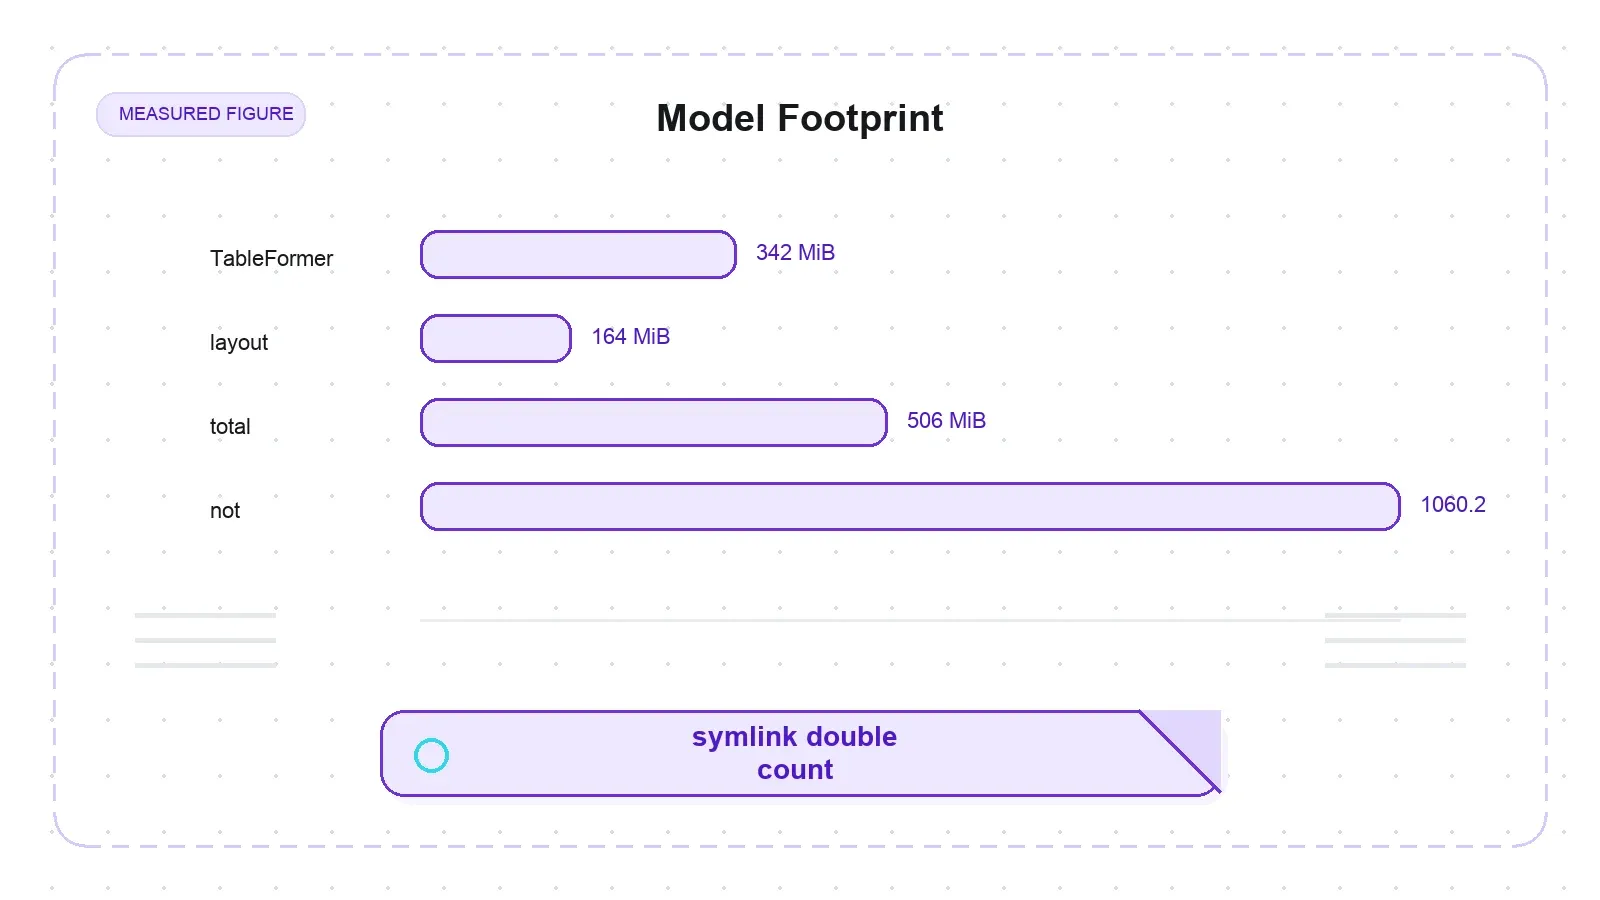
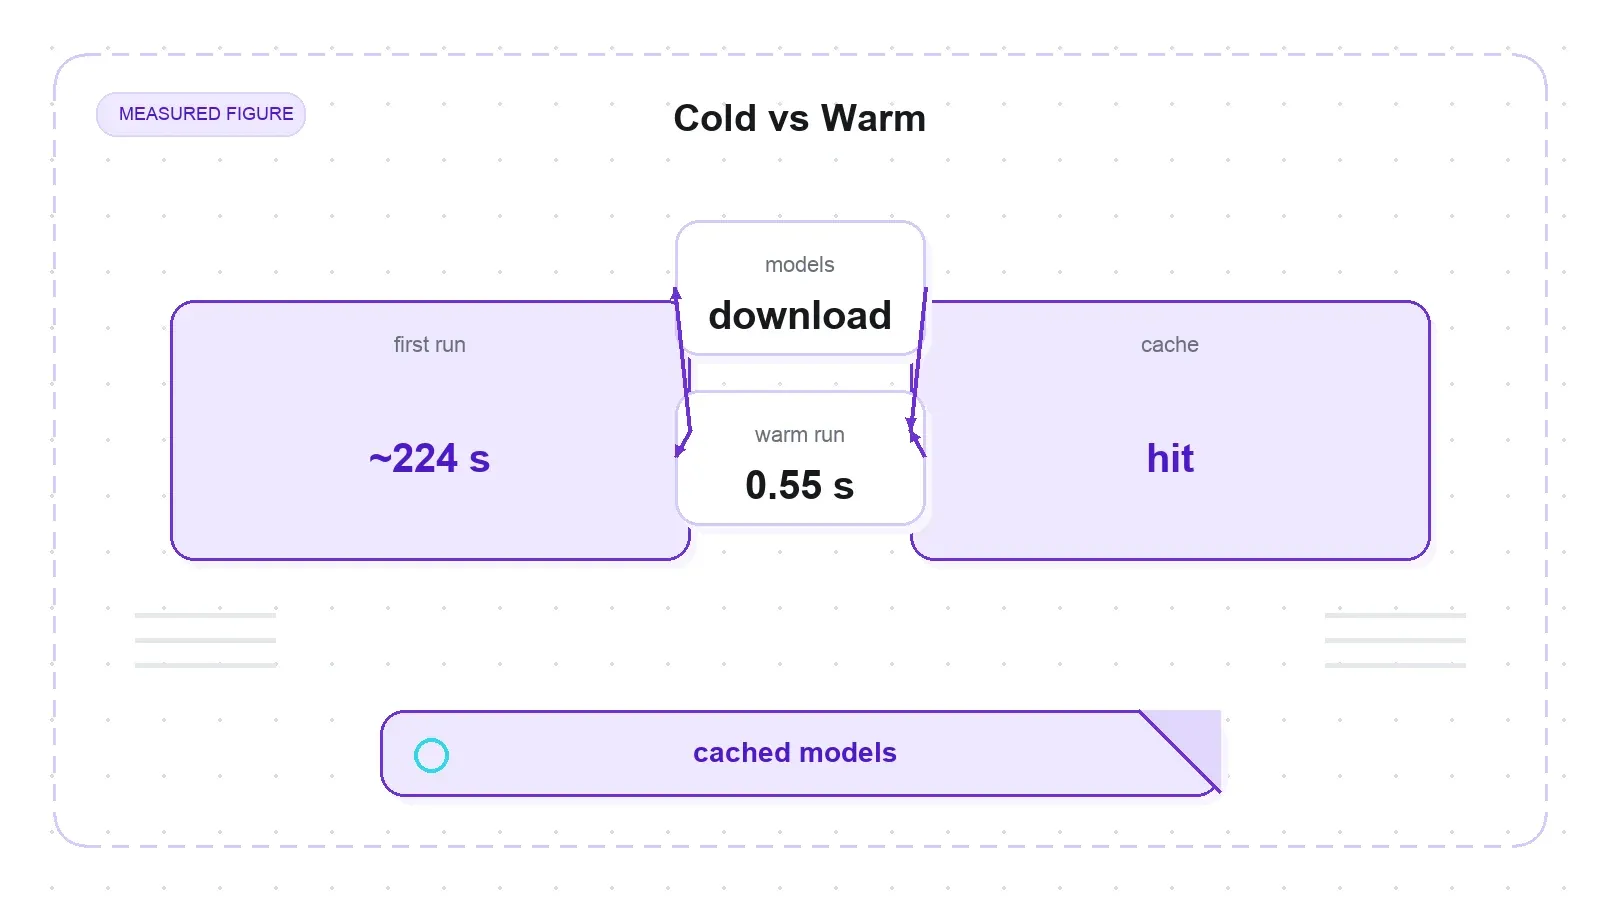
Det här är innan du ens konverterat en enda PDF. Den första PDF-konverteringen är där friktionen verkligen märks, eftersom det är då modellerna laddas ned. I en ny, isolerad HuggingFace-cache tog första PDF-konverteringen ungefär 224 sekunder — och nästan allt var nedladdning, inte beräkning. Layout- och TableFormer-modellerna landar som cirka 506 MiB på disk (342 MiB TableFormer + 164 MiB layout, verifierat med du), och RapidOCR hämtar cirka 40 MB PP-OCRv4-vikter till site-packages. Andra konverteringen av samma fil? 0,55 sekunder. Modellerna cachas; du betalar avgiften en gång.
Ett tal du bör ignorera: coldstart-skriptet skriver ut model_download_mb som 1060,2. Citera inte det som fotavtryck. Det kommer från en os.walk som följer symlänkar, och HuggingFace-cachen lagrar varje modellfil en gång under blobs/ och exponerar den sedan igen som en snapshots/-symlink — så genomgången räknar de 14 modellfilerna två gånger. Det du-matchande, symlink-avduplicerade värdet är cirka 506 MiB (endast blobs: 505,4 MiB). Slutsatsen för den som benchmarkar Docling: rapportera nedladdningsbyte och plats på disk som två olika siffror, för de är det.
Det finns en andra finess som brukar bita den som bygger en Docling-container. Vikterna delas mellan två platser och två tidsplaner. Layout- och TableFormer-modellerna respekterar HF_HOME och laddas ned vid första PDF-konverteringen. RapidOCR:s modeller gör inte det — de hamnar i …/site-packages/rapidocr/models/ och går förbi din cache-konfiguration helt. Om du förpackar en image i förväg eller kör air-gapped måste du hantera båda cachen, och hur mycket du än sätter HF_HOME fångar du inte den andra.
Nu till den rättvisa delen. Sedan tidigare versioner har projektet släppt docling-slim — en kärna på cirka 50 MB som låter dig köra pip install docling-slim[format-html] för HTML utan att dra in torch. Så 1,3 GB är fortfarande verkligt för standardpaketet docling, men det är nu valbart att slippa. Jag testade standardpaketet eftersom det fortfarande är vad pip install docling ger dig, men tyngden är inte längre en olöst brist — den modulära lösningen finns och följs i issue #2393.
Under uppsättningen stötte jag på en liten men irriterande detalj som är värd att nämna: import docling; docling.__version__ ger AttributeError: module 'docling' has no attribute '__version__'. Modulen exponerar helt enkelt inte det attributet. Det som fungerar är importlib.metadata.version("docling"), som returnerar '2.111.0'. En liten DX-promenad, öppen uppströms sedan juli 2026 som issue #3733.
Tabelltrohet: där TableFormer faktiskt förtjänar sin plats
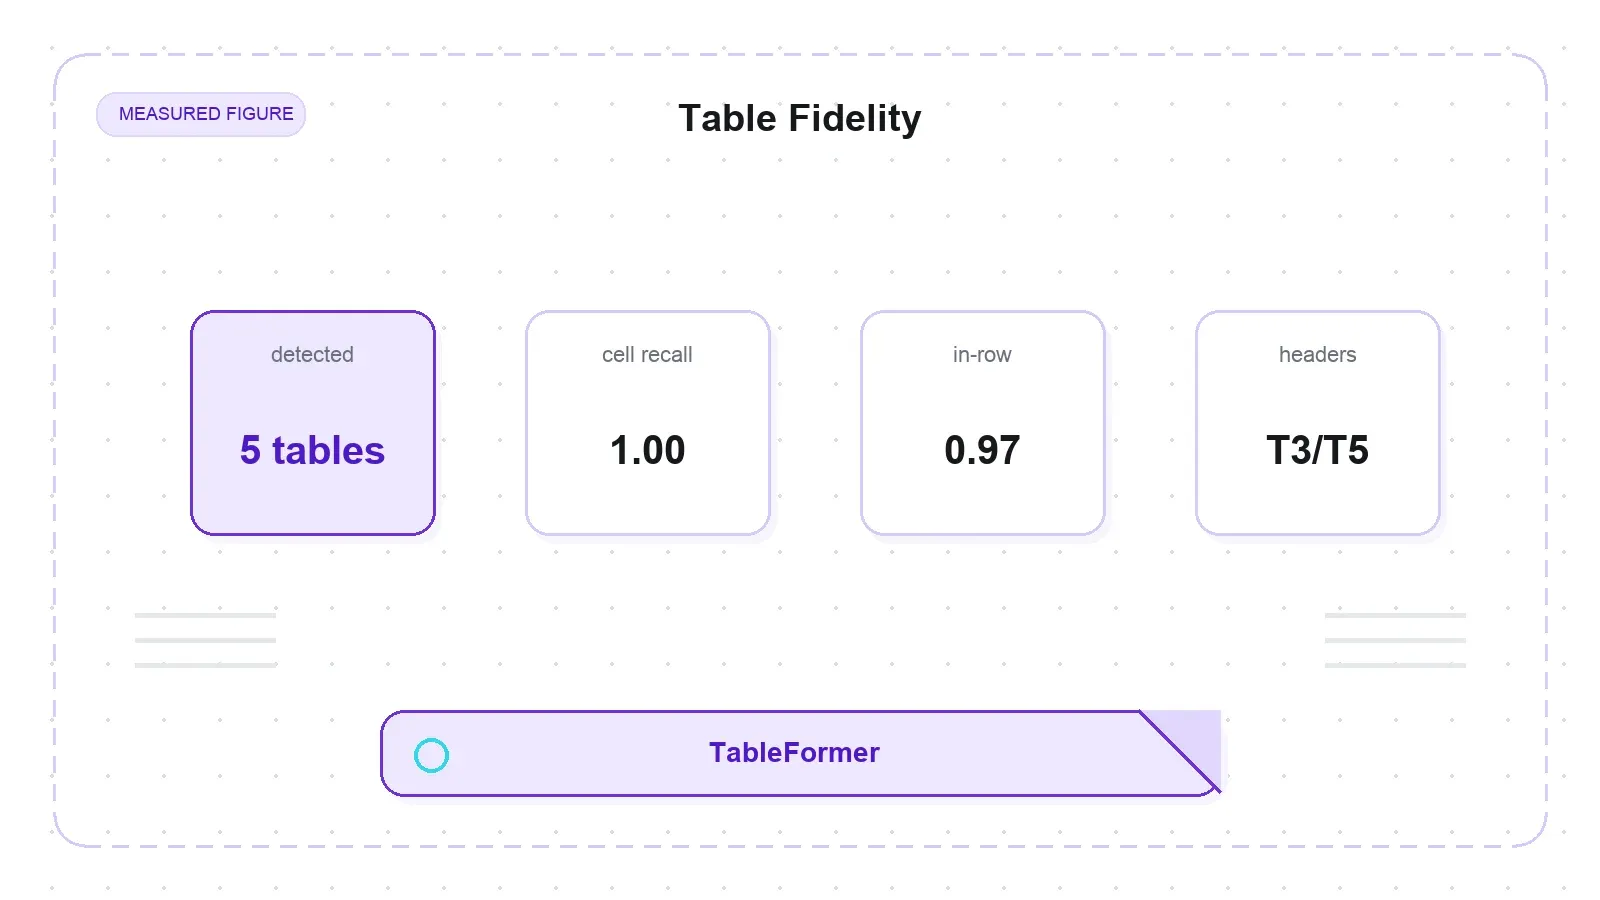
Tabeller är anledningen till att någon väljer Docling framför en vanlig PDF-till-text-dump, så jag genererade sju tabell-PDF:er med maskinläsbar ground truth och bedömde resultatet cell för cell. Två mått spelar roll, och de är inte samma sak: cell recall är andelen ground-truth-värden som finns någonstans i den detekterade tabellen; in-row rate är andelen som hamnar i rätt rad. Blandar man ihop dem blir verktyget snyggare än det är, så här är båda:
| Tabell (stress) | Upptäckt | Cell recall | In-row rate | Notering |
|---|---|---|---|---|
| T1 enkel tabell med kantlinjer (8 rader × 5 kolumner), ensam på sidan | Nej | 0.0 | — | klassad som <!-- image -->, alla celler tappades |
| T2 utan kantlinjer (endast en rubriklinje) | Ja | 1.00 | 1.00 | perfekt, exakt rutnät |
| T3 sammanslagen rubrik med colspan på 2 nivåer | Ja | 1.00 | 0.97 | alla värden hittades; ett rubrikvärde flyttas en rad |
| T4 sammanslagen rowspan-radetikett, ensam på sidan | Nej | 0.0 | — | klassad som <!-- image --> |
| T5 colspan-rubrik + utan kantlinjer | Ja | 1.00 | 0.97 | alla värden hittades; samma förskjutning av rubrikrad som i T3 |
| T6 finansiell tabell, tom kolumn, högerjusterad | Ja | 1.00 | 1.00 | tom kolumn bevarades, inte förskjuten |
| T7 bred tabell med 12 kolumner | Ja | 1.00 | 1.00 | ingen kolumnförskjutning i en bred tabell |
På de fem tabeller Docling faktiskt upptäckte kom varje ground-truth-värde med — cell recall 1,00 rakt igenom. På tre av de fem hamnade varje värde dessutom i rätt rad. På de två fallen med flernivårubriker (T3 och T5) glider ett rubrikvärde av sin ursprungliga rad, vilket drar ner in-row till 0,97 — all data finns där, men radplaceringen wobblar ett steg på en staplad rubrik.
De svårare strukturella fallen höll bättre än jag väntat mig. Den tvånivåiga colspan-rubriken plattades ut korrekt till GitHub-flavored Markdown (etiketten "Q1 2026" upprepades över de två kolumner den spänner över, vilket är rätt sätt att kollapsa ett colspan till GFM). Rutnätet utan kantlinjer men med rubriklinje (T2) kom igenom exakt. Den breda 12-kolumnstabellen (T7) försköts inte. Och en helt tom finansiell kolumn (T6) bevarades som tomma celler i stället för att tappas eller kollapsas. Det ligger i linje med de officiella TableFormer TEDS-poängen — 95,4 enkel, 90,1 komplex, 93,6 alla tabeller — som modellkortet placerar klart över Camelot (73,0) och EDD (88,3).
Lite försiktighet kring sammanslagna celler behövs, eftersom det finns ett öppet ärende som säger motsatsen. Issue #3698 rapporterar att V1 och V2 hanterar sammanslagna rader och kolumner fel. I mina fixtures flattades enkel colspan (T3/T5) och rowspan korrekt, med bara den ovannämnda förskjutningen i flernivårubrikerna. Men #3698:s fall handlar om oregelbundna sammanslagningar över flera rader/kolumner och tabeller över flera sidor — den patologiska ytterkanten. Mina tester ligger i den enkla änden. Den korrekta formuleringen är alltså snäv: enkla colspan- och rowspan-värden återhämtades här (flernivårubriker kan flytta en rad); komplexa och oregelbundna sammanslagningar är fortfarande ett dokumenterat öppet problem. Inte "sammanslagna celler fungerar", inte "sammanslagna celler är trasiga".
Fällan: en tabell ensam på en sida kan försvinna
Titta tillbaka på tabellen — T1 och T4 upptäcktes inte alls. Docling skrev ut <!-- image --> och tappade alla celler utan fel. T1 är ett helt normalt rutnät med kantlinjer, 8 rader och 5 kolumner. Det är tillräckligt oroande för att jag inte ville kalla det en svaghet i tabellparsningen förrän jag isolerat vad som faktiskt utlöste det, så jag byggde ett scriptat A/B-test.
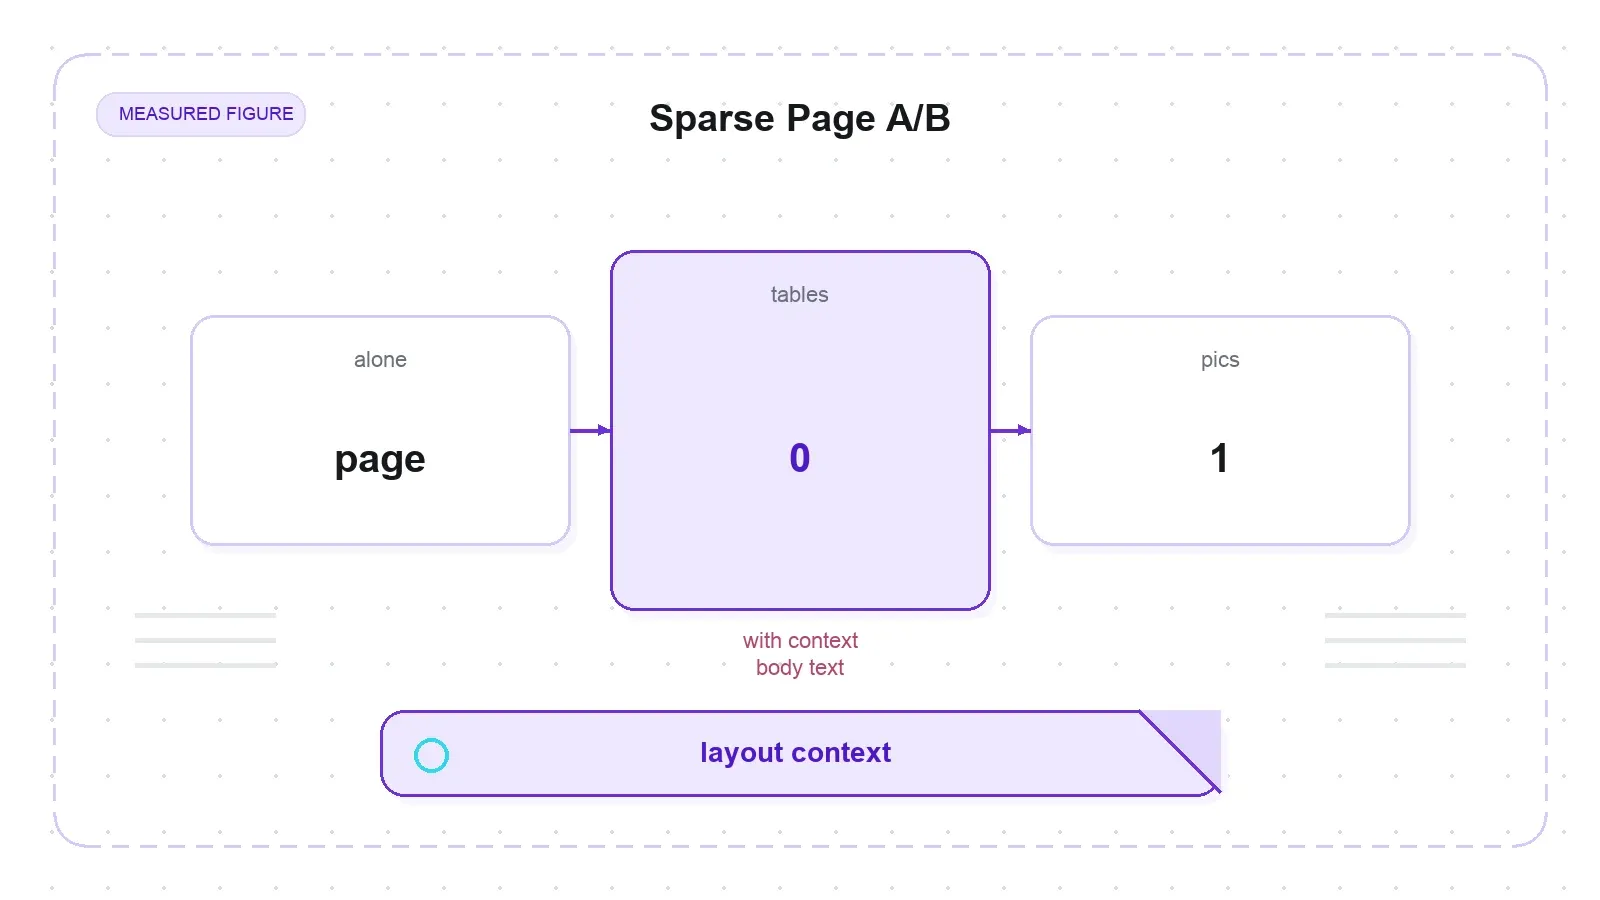
Först uteslöt jag de uppenbara förklaringarna. Textlagret är intakt — pypdfium2 läser 327 tecken från T1 och 221 från T4, så det här är riktiga digitala PDF:er, inte skannade bilder. Att stänga av OCR (do_ocr=False) hjälper inte; tabellerna faller ändå bort. Och när jag tittade direkt i DoclingDocument såg jag att len(doc.tables) == 0 medan len(doc.pictures) == 1 — layoutmodellen hade klassat hela tabellområdet som en Picture.
Sedan det avgörande testet. Jag renderade om exakt samma T1- och T4-tabeller, men den här gången omgivna av några vanliga brödtextstycken, och körde konverteringen igen. Båda kom igenom perfekt: len(doc.tables) == 1, korrekta GFM-tabeller skrevs ut och T4b:s rowspan-etikett "North" upprepades korrekt över sina tre rader. Samma tabell. Det enda som ändrades var om den stod ensam på en gles sida eller var inbäddad i text.
Så den verkliga brasklappen är inte att TableFormer är skör — det är att Doclings RT-DETR-layoutmodell använder sidkontext, och en liten tabell ensam på en nästan tom sida riskerar att läsas som en Picture och tyst tappas. Det här är lätt att stöta på i praktiken, eftersom det är precis så fakturor, specifikationsblad och beskurna exporter ser ut: en tabell per sida, ingen omgivande brödtext. Lösningen är enkel och effektiv — ge layoutmodellen sidkontext, eller efterkontrollera doc.tables efter konvertering och flagga sidor där antalet är noll. Det ligger nära issue #3495 (en tabell detekterad både som Table och Picture), men just sidgleshetsutlösaren — samma tabell faller bort när den är isolerad, konverteras när den bäddas in — kunde jag inte hitta dokumenterad någonstans. Uppmätt, inte tidigare beskrivet; inte en bugg ingen kände till.
OCR på riktiga skanningar: RapidOCR, inte EasyOCR
Skannade PDF:er är där många konverterare diskret faller ihop, så jag matade Docling med två riktiga skanningar med ett uppmätt textlager på 0 tecken — pypdfium2 rapporterar noll återvinningsbara tecken, vilket bekräftar att all output kommer från OCR och inte från något dolt textlager.
Den ensidiga ocr_test.pdf kom tillbaka ren på 14,3 sekunder på CPU: "Docling bundles PDF document conversion to JSON and Markdown in an easy self contained package," återgiven ordagrant. Den fyrsidiga nemotron_multipage.pdf körde OCR på alla fyra sidorna på totalt 70,1 sekunder (17,5 s/sida) och skrev ut testmeningen på varje sida. Standard-OCR kördes automatiskt — inget flaggval, ingen konfiguration.
Här är detaljen som många texter har fel: standardmotorn för OCR är RapidOCR, inte EasyOCR. Jag bekräftade det genom att se PP-OCRv4 .pth-vikterna laddas ned vid första körningen. Många befintliga bloggar och äldre FAQ-texter om Docling säger fortfarande att EasyOCR är standard; det är föråldrat. EasyOCR är numera ett tillval du måste slå på. Brasklappen som fortfarande stämmer: OCR är långsam väg i skala, och allt här är ett CPU-only-tak — en GPU skulle korta tiderna avsevärt.
Riktiga PDF:er, läsordning och tid per sida
Syntetiska testfiler bevisar specifika beteenden; riktiga PDF:er bevisar att saken faktiskt fungerar. Jag körde två born-digitala akademiska artiklar — den 9 sidor långa Docling-rapporten och 15-sidiga "Attention Is All You Need", båda i två kolumner med tabeller och formler.
På 15-sidiga Attention-artikeln ligger alla fem sektionmarkörer — Abstract, Introduction, Background, Conclusion, References — i dokumentordning i den linjäriserade Markdownen, trots tvåkolumnslayouten. Varenda innehållsindikator (Transformer, encoder, BLEU, multi-head) finns där, och de berömda resultattabellerna i flera kolumner registreras som fyra upptäckta tabeller. Det är verklig återställning av läsordning och kolumnsammanfogning, vilket är kärnan i RAG-chunking — du kan inte chunk:a ett dokument vettigt om linjäriseringen blandar ihop en tvåkolumnssida till ett interleaverat kaos.
Tidsmätningen ger en lite oväntad lärdom. Tid per sida styrs av hur mycket struktur som finns på varje sida, inte av antal sidor. Den tätare 9-sidorsrapporten tog 14,95 sekunder per sida — långsammare per sida än 15-sidiga artikeln med 5,99 sekunder per sida — eftersom den har fler tabeller och figurer per sida — 3 tabeller på 9 sidor mot 4 på 15 — och varje sådan trigger mer layout- och TableFormer-inferens. Det är en tunn marginal, och i absoluta tal har det tätare dokumentet färre tabeller, inte fler. Så "sekunder per sida" på CPU är en funktion av strukturell densitet, inte längd. Det här är en enskild CPU-only-körning; det är ett tak, inte ett produktionsvärde.
Flera format och påståendet om förlustfri JSON
Docling marknadsför en enhetlig parsning av flera format, så jag genererade en DOCX, en XLSX och en PPTX med känd innehållsstruktur och ground-truth-indikatorer och kontrollerade sedan två saker: visas indikatorerna i Markdown, och överlever de JSON-roundtrip via export_to_dict().
| Fil | Konvertering s | MD-indikatorer hittade | Tabeller i MD | Indikatorer överlever JSON |
|---|---|---|---|---|
report.docx (rubriker + sammanslagen "Total"-tabell + bullets) | 0,137 | 7/7 | 1 | Ja |
workbook.xlsx (2 blad, tom kolumn) | 0,016 | 6/6 | 2 | Ja |
deck.pptx (3 slides, bullets + tabell) | 0,038 | 6/6 | 1 | Ja |
Alla innehållsindikatorer hamnade i Markdown, tabellerna återställdes (inklusive DOCX:ens sammanslagna "Total"-rad och båda XLSX-bladen), och varje indikator överlevde även export_to_dict()-JSON — vilket är det bevis som spelar roll för påståendet om förlustfri DoclingDocument, åtminstone på rena indata. De här formaten går via formatinterna backends i stället för ML-modellerna, vilket är varför de körs på tiotals millisekunder och fungerar helt offline. Omfattningen är ärlig: en ren fil per format visar bredd, inte ett stresstest av patologiska Office-filer.
HTML: troget, men inte rent
Det här är brasklappen som avgör om Docling hör hemma i din RAG-pipeline, så läs noga. Docling konverterar hela HTML-dokumentet. Den gör inte readability-liknande extrahering av huvudinnehåll. Jag kvantifierade hur mycket sidans chrome som överlever genom att räkna rader med nav-, TOC-, cookie- och footer-markörer i Doclings egen output.
| Sida | Icke-tomma MD-rader | Boilerplate-rader | % boilerplate | Artikeln börjar på rad |
|---|---|---|---|---|
| Wikipedia "Web scraping" | 255 | 34 | 13,3% | 28 |
| scrapethissite/forms | 63 | 1 | 1,6% | — |
| books.toscrape | 65 | 0 | 0,0% | — |
| quotes.toscrape | 35 | 0 | 0,0% | — |
På en chrome-tung sida som Wikipedia är cirka 13% av Markdown-raderna nav/TOC/footer-boilerplate, och den riktiga artikeln börjar inte förrän på rad 28 — outputen öppnar med "move to sidebar / Contents / Toggle the table of contents" och slutar med "CS1 maint… / Search Wikipedia." På rena innehållssidor (books, quotes) ligger det runt 0%, så det här är ett template/chrome-problem, inte en skatt per sida. Docling ger dig trogen Markdown av hela dokumentet, inte ren extraktion av huvudartikeln. Uppströms spåras HTML-möbelproblemet i issue #1865 (stängt) och #1930 (öppet).
Två saker gör detta rättvist. För det första kör Docling inga ML-modeller alls för HTML — det är en BeautifulSoup-backend i en enkel pipeline. Historien om "visionmodeller som läser din sida" gäller bara PDF och bilder; mata Docling med HTML så triggas varken layout- eller TableFormer-maskineriet. För det andra försöker PDF-vägen faktiskt klassificera header- och footer-möbler, så påståendet "ingen borttagning av boilerplate alls" skulle vara för starkt — det är specifikt HTML-backenden som skickar tillbaka chrome.
Hur den står sig — och var Thunderbit passar in
Testa Thunderbit för webbdatautvinning
Det verktyg folk oftast jämför Docling med är Firecrawl, så här är en positioneringstabell. En brasklapp direkt, eftersom den spelar roll: det här är en jämförelse på dokumentationsnivå, inte en benchmark på samma maskin. Jag körde inte Firecrawl på dessa fixtures. Endast Docling-kolumnen är uppmätt här; Firecrawl-kolumnen kommer från deras offentliga dokumentation.
| Dimension | Firecrawl (enligt deras docs) | Docling (uppmätt här) |
|---|---|---|
| Huvudjobb | Crawla + skrapa det levande webben → Markdown | Konvertera ett dokument du redan har → Markdown/JSON |
| Hämtning / JS-rendering / anti-bot | Ja (hostad browser) | Nej — du tillhandahåller filen |
| Extraktion av huvudinnehåll | Ja | Nej — trogen full dokumentstruktur (~13% chrome på Wikipedia) |
| PDF-tabellstruktur (ML) | begränsat | Ja — TableFormer (TEDS 93,6 officiellt; cell recall 1,00, in-row 0,97–1,00 på detekterade fixtures) |
| Skannad PDF / OCR | begränsat | Ja — RapidOCR som standard (återställde en skanning med 0 textlager) |
| Formatbredd | webbsidor | PDF/DOCX/PPTX/XLSX/HTML/EPUB/bilder |
| Driftsättning | hostad API (+ self-host) | lokal pip-bibliotek, offline, ingen API-nyckel |
| Setup-vikt | API-nyckel / lätt klient | 1,3 GB standardinstallation + cirka 506 MiB modeller (eller docling-slim) |
| Licens | kommersiell / source-available | MIT |
Kortversionen: Firecrawl är verktyget när din data finns på det levande webben och behöver crawling, JS-rendering och städning av huvudinnehåll. Docling är verktyget när du redan har dokumentet — särskilt PDF:er, skanningar och Office-filer med mycket tabeller — och vill ha trogen, offline, strukturbevarande konvertering med verklig tabell- och OCR-förståelse. De kompletterar varandra. En realistisk pipeline crawlar med det ena och konverterar dokument med det andra.
Och här vill jag vara helt rak om Thunderbit, eftersom jag jobbar här och du med rätta skulle vara misstänksam om jag låtsades något annat. Thunderbit och Docling gör inte samma sak, och jag tänker inte försöka jämställa dem. För utvecklare är Thunderbit ett AI-scraping-API plus MCP-server plus CLI, och dess arbetsenhet är den levande webbsidan: POST /distill gör om en URL till ren, LLM-redo Markdown (med hantering av JS-rendering, anti-bot och CAPTCHA som Docling uttryckligen inte rör), och POST /extract ger schema-matchad strukturerad JSON via ett JSON Schema du själv definierar. Det är hämta-och-städa-delen av en RAG-pipeline. Docling är den lokala dokumentdelen — PDF:en, skanningen, kalkylbladet som redan ligger på disken. Om din korpus består av webbsidor, använd Thunderbits API, dess MCP-verktyg (thunderbit_suggest_fields, thunderbit_distill, thunderbit_extract) eller CLI (npx @thunderbit/thunderbit-cli). Om det är PDF:er och skanningar, använd Docling. Om det är båda — vilket de flesta riktiga pipelines är — kör du dem ihop, och ingen av dem försöker vara den andra.
Slutsats: preliminär, med hemläxa kvar
Jag tänker inte ge dig ett enda 0–100-betyg, eftersom en viktad totalsumma här skulle blanda in minuspoäng för saker Docling aldrig lovat att göra (som crawling) och låtsas att det är jämförbart. Per dimension, på de fixtures jag testade:
- Setup / första körning: tung — 1,3 GB venv, cirka 506 MiB modeller, cirka 224 s första PDF, cirka 0,55 s varm — men
docling-slimlåter dig slippa vikten. - Tabelltrohet: stark när en tabell väl upptäcks (cell recall 1,00 på 5/5, in-row 0,97–1,00), i linje med den officiella TEDS-historien på dessa fixtures.
- Robusthet i tabelligenkänning: gles-sida-fällan — en isolerad tabell kan falla bort som Picture. Efterkontrollera
doc.tables. - Skannat / OCR: fungerar, RapidOCR som standard; långsamt i skala.
- Flera format: stabilt, med JSON-roundtrip intakt.
- HTML: troget, inte rent — ingen extraktion av huvudinnehåll.
- Developer experience: ren 3-raders API och ett snyggt
DoclingDocument, minus den saknade__version__.
Vem det här är för: team som bygger RAG- eller datapipelines ovanpå PDF:er, skanningar och Office-filer och vill ha offline, strukturbevarande konvertering med verklig tabell- och OCR-förståelse. Vem det inte är för: alla som behöver crawling av levande webben eller ren extraktion av huvudsidans HTML-innehåll — det är ett annat verktyg.
Och eftersom det här är en recension och inte ett pressmeddelande, får begränsningarna stå kvar på etiketten. Det här är ett riktat test — 7 syntetiska tabeller plus 2 riktiga PDF:er på en CPU-only-maskin — inte en TEDS-skala-benchmark. Flera saker testade jag inte, och det bör du göra innan du satsar en pipeline på Docling: den valfria VLM-vägen (GraniteDocling), den faktiska storleken för docling-slim, eventuell GPU-körning, komplexa och oregelbundna sammanslagna celler plus tabeller över flera sidor, trohet i formel-till-LaTeX, och — det som sannolikt överraskar dig i produktion — hållbarhet över tid med batch-minnesväxt, tråd-/GIL-skalning och objektlivscykel över tusentals konverteringar. Docling är stark där den säger sig vara stark, uppmätt snarare än marknadsförd, och den har riktiga kanter du vill kartlägga innan du litar på den med en stor korpus. Känn till brasklappen om glesa sidor, budgetera för nedladdningen vid första körningen och verifiera beteendet i stor skala själv.
Testa Thunderbit för webbdatautvinning Get Started Free
FAQ
Är Docling en webbskrapare eller crawler? Nej. Docling konverterar dokument du redan har — PDF, DOCX, PPTX, XLSX, HTML, bilder — till Markdown eller JSON. Den hämtar inte URL:er, renderar inte JavaScript och hanterar inte anti-bot. Crawling av det levande webben är ett separat jobb som sköts av verktyg som Firecrawl eller Thunderbits webb-API; Docling utgår från filen du skickar in.
Hur stor är installationen av Docling och nedladdningen vid första körningen?
Standardpaketet docling ger en venv på cirka 1,3 GB eftersom det drar in hela ML-stacken som hårda beroenden (bara torch är 536 MiB). Den första PDF-konverteringen laddar ned ungefär 506 MiB layout- och TableFormer-modeller till disk plus cirka 40 MB RapidOCR-vikter, och tar omkring 224 sekunder — nästan helt nedladdningstid. Den andra konverteringen tar cirka 0,55 sekunder. Om du bara behöver lätta format finns docling-slim (cirka 50 MB kärna) som hoppar över den tunga vägen.
Gör Docling OCR, och med vilken motor? Ja. På en skannad PDF utan textlager körs OCR automatiskt, och i mitt test återställdes texten rent. Standardmotorn är RapidOCR, inte EasyOCR — ett vanligt misstag i äldre texter. EasyOCR är numera ett valbart tillägg. OCR är den långsamma vägen i skala, särskilt på CPU.
Varför gjorde Docling min tabell till en bild eller tappade den?
Troligen gles-sida-effekten. Doclings RT-DETR-layoutmodell använder sidkontext, och en liten tabell ensam på en nästan tom sida kan klassas som en Picture och tappas utan fel. Samma tabell fungerar fint om den omges av brödtext. Lösningen är att ge layoutmodellen sidkontext, eller att efterkontrollera doc.tables efter konvertering och flagga sidor där antalet är noll.
Docling vs Firecrawl — vilken ska jag använda? Olika jobb, så oftast är det inte ett antingen/eller. Firecrawl crawlar det levande webben, renderar JavaScript och extraherar huvudinnehåll. Docling konverterar dokument du redan har, med riktig PDF-tabellstruktur och OCR, helt offline. Om din källa är webbsidor, använd ett webbverktyg (Firecrawl, eller Thunderbits API/MCP/CLI). Om det är PDF:er, skanningar eller Office-filer, använd Docling. I de flesta riktiga pipelines använder man båda.




