
Varenda några månader dyker samma klagomål upp på Reddit i olika former: "Jag scrapade Yellow Pages och fick 500 rader med telefonnummer och adresser… men noll mejl." Det är den vanligaste frustrationen jag ser i lead-gen-communityn, och efter år av att bygga automationsverktyg på Thunderbit kan jag säga att problemet är strukturellt, inte en olyckshändelse.
De flesta Yellow Pages-scrapers hämtar det som syns på sökresultatsidan — företagsnamn, telefonnummer, adress och kanske en länk till webbplatsen. Men mejl? De ligger nästan aldrig på själva listningskortet. Ofta finns de gömda på varje företags profilsida, eller så finns de inte på Yellow Pages alls.
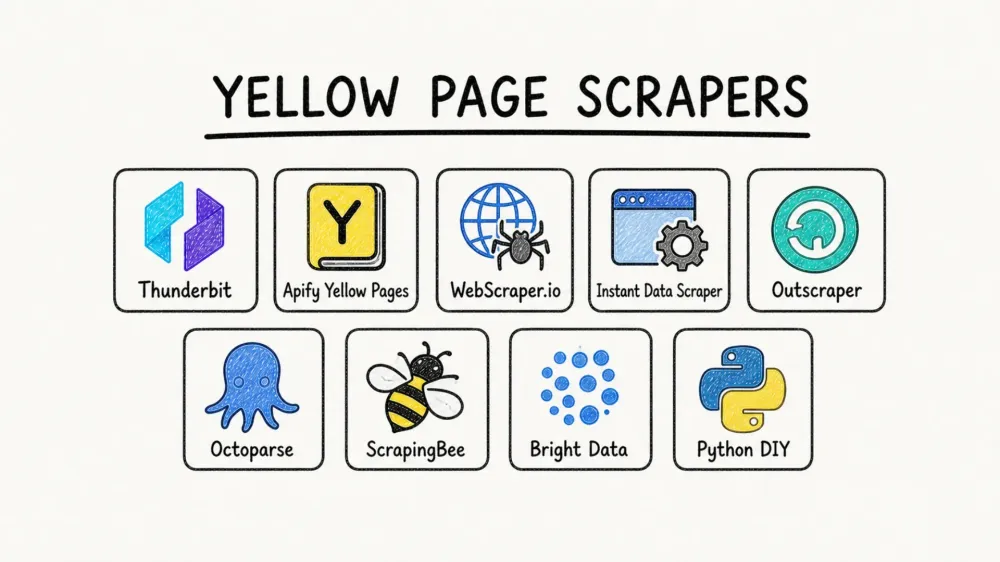
Så om din scraper inte går vidare till de där undersidorna lämnar du den mest värdefulla kontaktinformationen på bordet. I den här artikeln går jag igenom 9 verktyg som jag har undersökt och utvärderat just utifrån om de faktiskt levererar mejladresser från Yellow Pages — inte bara telefonnummer och postnummer. Jag tar också upp anti-bot-hantering, prissättning och vilket verktyg som passar vilken typ av användare.
Varför de flesta Yellow Pages-scrapers misslyckas med att få fram mejl
Innan vi tittar på verktygen är det bra att förstå varför det här problemet finns från början.
Yellow Pages-listningssidor är byggda kring telefonnummer, adresser, öppettider och webbplatslänkar. Mejladress är inget standardfält på sökresultatskortet. Nuvarande dokumentation och exempel från scraper-verktyg bekräftar detta gång på gång: mejl saknas oftast på listningskortet och måste i regel hittas antingen på företagets profilsida eller på företagets egen webbplats.
Apifys ParseBird Yellow Pages Scraper är ovanligt tydlig med detta. Den skiljer mellan "listing mode" och "detail mode" och anger att utbytet av mejl vanligtvis bara ligger på 15–25% av listningarna även när extraktion från detaljsidor är aktiverad. Det betyder att även i bästa fall är mejlskörden från Yellow Pages ganska begränsad — och de flesta verktyg försöker inte ens.
Det finns tre vanliga sätt det faller på:
- Scrapern läser bara sökresultatsidan. Inga besök på undersidor, inga mejl.
- Scrapern går till detaljsidan men parsar inte mejlfält. Fortfarande inga mejl.
- Företaget har aldrig publicerat någon mejladress på Yellow Pages. Inget verktyg kan extrahera något som inte finns.
Vissa företag hänvisar dessutom kontakt via formulär eller knappar som "Email Business" i stället för att visa en riktig mejladress. En scraper kan alltså tekniskt sett fungera och ändå ge en output som till 95% består av telefonnummer och adresser.
Slutsatsen: om mejlextraktion är viktigt för dig är den avgörande funktionen att leta efter undersidescraping — möjligheten att besöka varje företags detaljsida och hämta data som inte visas i huvudlistningen.
Vad du ska leta efter i de bästa Yellow Pages-scrapers
Jag utvärderade alla 9 verktyg utifrån sju kriterier, alla förankrade i verkliga smärtpunkter från Reddit-trådar, scrapingforum och lead-gen-communityn.
Tillförlitlighet i mejlextraktion
Det är hela anledningen till att den här artikeln finns. Ger verktyget faktiskt tillbaka mejladresser, eller bara namn och telefonnummer? Den viktigaste funktionen är undersidescraping — att besöka varje företags profilsida för att hitta mejl som inte syns på listningskortet.
Hantering av anti-bot och blockering
Yellow Pages kör Cloudflare Bot Management, inklusive krav på JavaScript-rendering, browser fingerprinting, rate limiting och CAPTCHA-utmaningar. Ett live-test jag gjorde den 27 april 2026 visade en Cloudflare-blocksida inom några sekunder. Verktyg som inte hanterar detta inbyggt lämnar dig bara stirrande på felsidor.
Prissättning och gratisnivå
Flera Reddit-användare frågar uttryckligen efter "free or cheap scrapers ideally." Det finns en tydlig uppdelning mellan helt fria webbläsartillägg, molnverktyg med startkrediter och företagsplattformar med skräddarsydd prissättning.
Stöd för paginering
Yellow Pages visar ungefär 30 resultat per sida, och bredare sökningar kan ge 500–2 000+ resultat. En scraper utan automatisk paginering fångar bara en bråkdel av all tillgänglig data.
Exportalternativ
Säljteam behöver CRM-redo output: CSV, Excel, Google Sheets, Airtable. Vissa verktyg ger bara JSON eller rå HTML, vilket innebär extra jobb innan datan går att använda.
Tekniska kunskaper som krävs
Målgruppen är blandad. Säljare och byråägare vill ha tvåklicksverktyg. Utvecklare vill ha API-tillgång och flexibilitet med Python. Jag har betygsatt varje verktyg från nybörjare till expert.
Lead scoring och databerikning
Som en Reddit-användare uttryckte det: "raw data without scoring is just a spreadsheet." Verktyg som kan märka, kategorisera eller berika data under scrapingen sparar timmar av efterarbete.
De bästa Yellow Pages-scrapersna i korthet
Den fullständiga jämförelsen mellan alla 9 verktyg finns nedan. En snabb guide till symbolerna: ✅ betyder att verktyget klarar detta bra direkt ur lådan, ⚠️ betyder att det går men kräver extra konfiguration eller har begränsningar, och ❌ betyder att verktyget inte stöder detta nativt.
| Verktyg | Typ | Gratisnivå | Mejl? | Anti-bot | Paginering | Kunskapsnivå | Exportformat | Bäst för |
|---|---|---|---|---|---|---|---|---|
| Thunderbit | Chrome-tillägg + moln | ✅ (6 sidor/mån) | ✅ (undersida + Email Extractor) | ✅ Moln-/webbläsarväxling | ✅ Automatisk | Nybörjare | Excel, CSV, JSON, Sheets, Airtable, Notion | Sälj- och ops-team utan teknisk bakgrund |
| Apify YP Scraper | Moln-aktor | ✅ ($5 i krediter) | ⚠️ 15–25% med detaljsidor | ✅ Proxy-pool | ✅ Inbyggd | Medel | JSON, CSV, Excel, XML | Skrapning i stor skala via molnet |
| WebScraper.io | Chrome-tillägg + moln | ✅ (gratis tillägg) | ⚠️ Manuell konfiguration | ✅ Molnplaner | ✅ Selektorbaserad | Medel | CSV, XLSX, JSON, Sheets | Användare som gillar visuell scraping |
| Instant Data Scraper | Chrome-tillägg | ✅ Helt gratis | ❌ Opålitlig | ❌ Ingen | ⚠️ Manuell | Nybörjare | CSV, XLSX | Snabba engångskörningar |
| Outscraper | API/moln | ✅ (500 företag) | ⚠️ Berikning krävs | ✅ Hanterad | ✅ Automatisk | Nybörjare–medel | CSV, JSON, XLSX | Budgetjobb för kataloger |
| Octoparse | Desktopapp + moln | ✅ (10 uppgifter, 50K/mån) | ⚠️ Mallbaserad | ✅ Inbyggd | ✅ Automatisk upptäckt | Medel | CSV, Excel, JSON, databaser | Visuell scraping på skrivbordet |
| ScrapingBee | API | ✅ (1 000 anrop) | ❌ Endast rå HTML | ✅ Hanterade proxies | ❌ Manuell | Avancerad | JSON, HTML | Utvecklare som behöver renderad HTML |
| Bright Data | Plattform | ✅ (5K poster/mån) | ✅ Dataprodukter | ✅ Företagsklass | ✅ Inbyggd | Avancerad | JSON, CSV, NDJSON, S3 m.m. | Företag i stor skala |
| Python DIY | Kod | ✅ Gratis (OSS) | ⚠️ Manuell parsning | ❌ Självhanterad | ❌ Manuell | Expert | Valfritt | Ingenjörer med specialbehov |
1. Thunderbit — Bästa Yellow Pages-scrapern för team utan teknisk bakgrund

Testa Thunderbit för Yellow Pages-scraping
Thunderbit är ett AI-drivet Chrome-tillägg som mitt team och jag byggde just för att göra web scraping tillgängligt för personer som inte är utvecklare. I stället för att konfigurera CSS-selektorer eller skriva kod klickar du bara en gång, så läser AI:n sidan, förstår vilken data som finns och hämtar den åt dig. Eller, om du redan vet exakt vad du vill ha, skriver du bara det till AI:n så arbetar den utifrån din beskrivning i stället. Så enkelt är det — ett klick till strukturerad data.
För Yellow Pages löser arbetsflödet mejlproblemet direkt. Efter att ha scrapats listningssidan kan du utöka scrapingen till undersidor, och Thunderbit besöker då varje företags detaljsida för att hitta mejl, webbplats-URL:er, öppettider, recensioner och andra fält som inte syns på huvudkortet. Vi har också byggt en dedikerad Email Extractor och Phone Number Extractor som fristående verktyg, så du kan köra dem på vilken sida som helst med ett enda klick.
Hur Thunderbit hanterar mejlextraktion från Yellow Pages
Den viktigaste skillnaden är undersidescraping. De flesta scrapers stannar på sökresultatsidan och returnerar bara det som syns — vilket på Yellow Pages betyder inget mejl. Thunderbits funktion för undersidor besöker varje företagsprofil och hämtar data från det djupare lagret. Du kan också använda Field AI Prompt för att lägga till instruktioner som "extrahera mejl från kontaktsektionen" eller "markera företag utan webbplats" för att förbättra precisionen och lägga till sammanhang redan under scrapingen.
Baserat på nuvarande sidstrukturer och scraper-dokumentation är mejl på själva listningskorten i Yellow Pages i praktiken noll. Detail-page scrapers som Thunderbits undersidesfunktion återhämtar mejl från ungefär 15–25% av företagen — vilket är det realistiska taket för Yellow Pages-mejlextraktion 2026. Det är inte en begränsning i Thunderbit; det är en begränsning i Yellow Pages-data.
Anti-bot-hantering och paginering
Thunderbit erbjuder två scrapinglägen: molnscraping (som går via servrar i USA/EU/Asien med automatisk proxyrotation) och webbläsarscraping (som använder din lokala webbläsarsession). Om molnläget blockeras av Cloudflare kan du växla till webbläsarläge som backup — din autentiserade session kan ofta passera skydd som blockerar headless-förfrågningar i molnet.
Pagineringen är helt automatisk. Thunderbit hanterar både klickbara "Next"-knappar och oändlig scroll utan någon konfiguration.
Prissättning och export
- Gratisnivå: 6 sidor per månad
- Gratis provperiod: 10 sidor
- Startplan: från cirka 9 USD/månad vid årsbetalning för 500 krediter (1 kredit = 1 rad)
- Export: Excel, CSV och JSON finns på gratisnivån; Google Sheets, Airtable och Notion-integration på betalda planer
Du kan se de senaste detaljerna på vår prissida.
Bäst för: Säljare, byråer och ops-team som behöver leaddata snabbt utan att koda eller hantera proxies.
2. Apify Yellow Pages Scraper — Bäst för skalad molnscraping
 Apify är en molnbaserad scrapingplattform med en marknadsplats för färdiga "actors" — inklusive flera som är skapade specifikt för Yellow Pages. Du konfigurerar en scraping i Apifys konsol (sökord, plats, antal resultat), och den körs i molnet utan att du behöver någon webbläsare eller lokal maskin.
ParseBird Yellow Pages-actorn är den mest transparenta jag hittat när det gäller mejlextraktion. Den skiljer tydligt mellan listing mode och detail mode och dokumenterar att mejlutbytet vanligtvis ligger på 15–25% av listningarna när detaljsidor är aktiverade. Scraping i detail mode kostar ungefär 6 USD per 1 000 företag jämfört med 1 USD per 1 000 i listing mode — en direkt spegling av den extra beräkning som krävs för att besöka varje undersida.
- Proxy-pool ingår med stöd för residential proxies
- Inbyggd paginering för flersidiga resultatuppsättningar
- Export: JSON, CSV, Excel, XML, HTML, RSS, JSONL
- Prissättning: Gratis plan med $5 i krediter; betalda planer på 29, 199 och 999 USD/månad
Bäst för: Medel- till avancerade användare som kör större lead-gen-kampanjer över flera städer eller kategorier.
3. WebScraper.io — Bäst för att bygga egna Yellow Pages-sitemaps
 WebScraper.io erbjuder ett Chrome-tillägg med en visuell "Sitemap Wizard" som automatiskt känner igen listningsstrukturen på Yellow Pages. Det är verktyget bakom en av de högst rankade guiderna för Yellow Pages-scraping, och det är lätt att förstå varför — du får mycket fin kontroll över vad som scrapas och hur.
Nackdelen är att kontroll kräver konfiguration. Mejlextraktion är inte automatisk; du måste ställa in selektorer manuellt för att rikta in dig på mejlfält och konfigurera scrapern att följa länkar till företagens detaljsidor. Om du sätter upp det rätt fungerar det. Om inte får du samma telefon-och-adress-output som alla andra verktyg.
WebScraper.io:s marknadsplatsnoteringar är också ovanligt öppna om Yellow Pages skydd: de dokumenterar Cloudflare bot management, krav på JavaScript-rendering och browser fingerprinting som specifika hinder.
- Paginering: Hanteras via selektorbaserad konfiguration av "Next"-knappen
- Export: CSV, XLSX, JSON; molnversionen lägger till Google Sheets, Dropbox, S3, Azure, API och webhooks
- Prissättning: Gratis Chrome-tillägg; molnplaner från 50 USD/månad
Bäst för: Användare som är bekväma med klickbara selektorverktyg och vill kunna anpassa sin scrape-struktur.
4. Instant Data Scraper — Bästa gratis Yellow Pages-scrapern (med brasklappar)
 Instant Data Scraper är svaret på frågan "vad kan jag testa gratis just nu?" Det är ett helt gratis Chrome-tillägg — inget konto, inga krediter, inga begränsningar — som automatiskt upptäcker tabulär data på webbsidor. Öppna en Yellow Pages-resultatsida, klicka på tilläggsikonen, och den känner av listningsdatan.
Problemet är allt det inte gör. Det scrapar bara det som är synligt på sidan, vilket betyder inga besök på undersidor och i de flesta riktiga arbetsflöden ingen mejlextraktion. Det har ingen anti-bot-hantering, så om Yellow Pages visar en CAPTCHA eller blockerar din IP sitter du fast. Stödet för paginering är grundläggande — du kan behöva klicka "Next" manuellt eller förlita dig på begränsad auto-scroll.
- Export: CSV, XLSX
- Prissättning: Gratis för alltid
Bäst för: Nybörjare som behöver en snabb, gratis scrape av en resultatsida och inte behöver mejl. Inte lämpligt för kampanjer som fokuserar på mejl eller för lead-generering i större skala.
5. Outscraper — Bästa hanterade API:t för Yellow Pages och Google Maps
 Outscraper är en moln- och API-baserad plattform med hanterad infrastruktur för att skrapa kataloger som Yellow Pages och Google Maps. Värdeerbjudandet är enkelhet: du behöver inte själv hantera proxies, anti-bot-logik eller paginering.
För Yellow Pages är Outscrapers första 500 företagen gratis, därefter ligger priset ungefär på 1 USD per 1 000 företag. Mejlextraktion från Yellow Pages är begränsad till det som faktiskt finns på sidan; för djupare mejlberikning erbjuder Outscraper separata enrichment-funktioner som kan kombineras med grundscrapingen.
Det som gör Outscraper starkt är stödet för flera kataloger. Om du scrapar Yellow Pages och Google Maps för samma kampanj kan du köra båda från samma plattform.
- Automatisk paginering ingår
- Export: CSV, JSON, XLSX, API
- Prissättning: Gratisnivå (500 företag); därefter betala per resultat
Bäst för: Sales ops-team som vill ha pålitlig, hands-off scraping över flera kataloger utan att hantera infrastruktur.
6. Octoparse — Bästa desktopappen för visuell scraping av Yellow Pages
 Octoparse är en desktopapplikation (Windows/Mac) med en visuell workflow-byggare där du klickar dig fram. Den erbjuder färdiga mallar för Yellow Pages och liknande katalogsidor, plus inbyggda anti-bot-funktioner som IP-rotation, residential proxies och automatisk CAPTCHA-lösning.
Mejlextraktion beror på mallen. När mallen är konfigurerad att besöka företagens detaljsidor eller länkade webbplatser kan den hämta mejl. Men mallar kan gå sönder när Yellow Pages ändrar sitt layout, och användare rapporterar blandade resultat beroende på kategori och geografi.
- Gratis plan: 10 uppgifter, 50 000 exporter per månad
- Automatisk upptäckt av paginering
- Export: CSV, Excel, JSON, HTML, XML, databaser, Google Sheets, API
- Prissättning: Gratisnivå; betalda planer för molnkörning
Bäst för: Medelanvändare som föredrar en desktopapp med visuell workflow-byggare och inte har något emot lite malljustering.
7. ScrapingBee — Bästa API:t för utvecklare som behöver renderad HTML
 ScrapingBee är en API-först-tjänst för web scraping. Den hanterar JavaScript-rendering, proxyrotation och CAPTCHA-lösning — och returnerar sedan rå HTML, JSON eller Markdown. Den extraherar inte mejl eller strukturerade fält direkt ur lådan. Det måste du själv göra.
ScrapingBees egen Yellow Pages-guide visar manuell paginering genom att lägga till &page=n i URL:en, vilket förstärker att detta är ett utvecklarverktyg och inte en klick-och-klart-lösning.
- Gratisnivå: 1 000 API-krediter
- Ingen inbyggd paginering eller fältextraktion
- Export: JSON, HTML
- Prissättning: Från 49 USD/månad
Bäst för: Utvecklare som behöver pålitligt renderad HTML med anti-bot-hantering och som är bekväma med att skriva egen parslogik.
8. Bright Data — Bästa företagsplattformen för scraping i stor skala
 Bright Data driver det största proxynätverket i branschen och erbjuder ett komplett paket av scraping-API:er, webbläsarverktyg och färdiga dataset. Det är byggt för organisationer som behöver datainsamling i mycket stor skala med compliance-funktioner.
För Yellow Pages är Bright Datas styrka infrastrukturen — residential proxies, CAPTCHA-lösning, skydd mot browser fingerprinting och leverans vidare till JSON, CSV, NDJSON, S3, Snowflake, GCS, Azure och SFTP. Jag hittade ingen aktuellt dokumenterad Yellow Pages-specifik mall, så positioneringen här är företagsplattform i toppklass, inte en dedikerad produkt för YP-mejl.
- Prissättning: Web Scraper API har en gratisnivå på 5 000 poster/månad, därefter 1,50 USD per 1K poster vid pay-as-you-go; 499 USD/månad i större skala
- Inbyggd paginering i alla scrapingverktyg
Bäst för: Stora företag eller byråer med betydande databudgetar som behöver skala, compliance och proxyinfrastruktur.
9. Python DIY (BeautifulSoup + Playwright) — Bäst för full kontroll
 Det här är open source-spåret: BeautifulSoup för HTML-parsning och Playwright för webbläsarautomation. Gratis bibliotek, maximal flexibilitet, högst teknisk tröskel i den här listan.
Mejlextraktion kräver att du skriver egen parslogik för att gå till varje företags detaljsida och hitta mejlfält. Proxyrotation, CAPTCHA-hantering, rate limiting och paginering måste du antingen implementera själv eller köpa separat. Som en Reddit-användare uttryckte det: "Once you try Playwright, you will never go back to Selenium" — men du kommer inte heller att sluta felsöka din proxyuppsättning.
- Prissättning: Gratis (open source-bibliotek); infrastrukturkostnader tillkommer
- Export: Valfritt format som du kodar för
- Inget inbyggt alls — du bygger allt själv
Bäst för: Expertutvecklare med specifika scrapingkrav som inga färdiga verktyg klarar, och som är bekväma med att hantera hela kedjan själva.
Vad som faktiskt händer när Yellow Pages blockerar dig (realitetscheck för anti-bot)
Jag vill lägga lite tid på det här eftersom det är det största smärtpunkten sett till antalet omnämnanden i scraping-communityn, och de flesta artiklar sveper förbi det med ett enkelt "använd proxies".
När jag testade en enkel skriptad förfrågan mot en Yellow Pages-sök-URL den 27 april 2026 var svaret en Cloudflare-blocksida: "Sorry, you have been blocked. This website is using a security service to protect itself from online attacks." Det hände redan på första förfrågan. Ingen varning, ingen gradvis strypning — bara en vägg.
Yellow Pages anti-bot-stack inkluderar Cloudflare Bot Management, krav på JavaScript-rendering, browser fingerprinting, rate limiting och reCAPTCHA. IPRoyal:s scrapingguide tillägger att symptomen kan vara hårda blockeringar, mjuka ban, CAPTCHAs, omdirigeringar till splash-sidor, sessionsspårning och rate limits.
Den bredare utvecklingen gör detta värre, inte bättre. Impervas rapport för 2025 visade att automatiserad trafik stod för 51% av all internettrafik under 2024, och DataDomes rapport för 2025 som omfattade nästan 17 000 sajter visade att bara 2,8% var fullt skyddade. Sajter som Yellow Pages som faktiskt satsar på skydd blir bättre på att stoppa scrapers, inte sämre.
En praktisk genomgång av hur varje verktyg hanterar det:
| Verktyg | Proxyrotation | CAPTCHA-hantering | Tålighet mot rate limit | Fallback när blockerat |
|---|---|---|---|---|
| Thunderbit | ✅ Molnläge med servrar i USA/EU/Asien | ✅ Hanteras via molnet | ✅ Automatisk throttling | Växla till webbläsarscraping |
| Apify | ✅ Inklusive residential proxies | ✅ Via actor-/webbläsarinfrastruktur | ✅ Konfigurerbar | Försök igen med ny proxy |
| WebScraper.io | ✅ Molnplaner + proxy-tillägg | ✅ Molnplaner | ✅ Stark | Använd molnkörning |
| Instant Data Scraper | ❌ Ingen | ❌ Ingen | ❌ Svag | Manuell retry eller avbryt |
| Outscraper | ✅ Hanterad backend | ⚠️ Begränsad dokumentation | ✅ Måttlig | Hanterad tjänst sköter det |
| Octoparse | ✅ Inklusive residential | ✅ Automatisk CAPTCHA-lösning | ✅ Stark | Molnmallar + anti-block |
| ScrapingBee | ✅ Hanterade proxies | ✅ Inbyggd | ✅ Stark | Justera kod, premiumproxies |
| Bright Data | ✅ Företagsklass | ✅ Inbyggd | ✅ Mycket stark | Full infrastruktujustering |
| Python DIY | ❌ Endast självhanterat | ❌ Endast självhanterat | ❌ Varierar | Vad du än bygger själv |
Mer än rådata: att göra Yellow Pages-scrapes till CRM-redo leads
Ett mönster jag ser hela tiden: någon scrapar 500 Yellow Pages-listningar, exporterar till ett kalkylark och spenderar sedan tre timmar på att manuellt googla varje företag för att hitta mejl, kolla webbplatser och lista ut vilka som faktiskt är värda att kontakta. Scrapingen tog 10 minuter. Berikningen tog hela eftermiddagen.
Det är här klagomålet om att "raw data without scoring is just a spreadsheet" kommer ifrån. En rå Yellow Pages-export ser ut så här:
| Företagsnamn | Telefon | Adress | Webbplats | Kategori |
|---|---|---|---|---|
| Example Plumbing Co. | 555-0199 | 123 Main St | exampleplumbing.com | Rörmokare |
| NoSite HVAC | 555-0112 | 456 Oak Ave | None | HVAC |
En berikad lead-tabell — den typ som faktiskt är användbar för outreach — ser ut så här:
| Företagsnamn | Telefon | Adress | Webbplats | Mejl | Recensioner | Har webbplats? | Prospektanteckning |
|---|---|---|---|---|---|---|---|
| Example Plumbing Co. | 555-0199 | 123 Main St | exampleplumbing.com | info@exampleplumbing.com | 42 | Ja | Kontaktsida finns |
| NoSite HVAC | 555-0112 | 456 Oak Ave | None | None | 8 | Nej | Möjlig byråkund |
Använd undersidescraping för att berika leads
Thunderbits undersidescraping besöker varje företags detaljsida och lägger till fält som mejl, webbplats-URL, öppettider, recensioner och kategorier. För en scrape på 500 listningar är det skillnaden mellan 10 minuters automatiserat arbete och 3+ timmars manuellt researcharbete.
Apifys detail-mode scraping gör något liknande, men till en högre kostnad per post (ungefär 6 USD per 1 000 företag jämfört med 1 USD per 1 000 i listing mode).
Märka och kategorisera leads under scrapingen
Thunderbits Field AI Prompt låter dig lägga in instruktioner under själva scrapingen — saker som "markera företag utan webbplats" eller "kategorisera efter företagsstorlek." AI:n bearbetar dessa etiketter medan den extraherar data, så du får en förkvalificerad leadlista i stället för en rå dump.
En brasklapp från researchen som är värd att nämna: en saknad webbplats betyder inte alltid att ett företag är en bra prospekt. Det är en användbar signal för byråutskick, men den bör inte vara det enda urvalskriteriet.
Arbetsflöde från export till CRM
Det vanligaste arbetsflödet jag ser från våra användare:
- Thunderbit → Google Sheets eller Airtable → CRM (direkt export, inga mellanled)
- Apify → Webhook → CRM (kräver viss konfiguration)
- Outscraper → CSV-nedladdning → CRM-import (manuellt men rakt på sak)
Om ditt CRM integrerar med Google Sheets eller Airtable tar Thunderbits direkta export bort hela filnedladdningssteget. Du kan läsa mer om web scraping utan kod på vår blogg.
Bästa Yellow Pages-scraper efter användningsområde: snabb rekommendationsguide
Alla verktyg passar inte alla användare. Mina rekommendationer efter användartyp:
Bäst för säljare och byråägare utan teknisk bakgrund: Thunderbit (AI-scraping med ett klick, gratis Email Extractor, undersidescraping) och Instant Data Scraper (gratis, enkelt — men inga mejl)
Bäst för lead-generation i större skala: Apify (cloud actors, jobb över flera städer, mejlextraktion från detaljsidor) och Outscraper (hanterat API, stöd för flera kataloger)
Bästa helt gratis alternativet: Instant Data Scraper (helt gratis för alltid) och Thunderbits gratisnivå (6 sidor/månad med AI-funktioner)
Bäst för utvecklare: Python DIY med Playwright (maximal kontroll) och ScrapingBee API (hanterad rendering + proxies)
Bäst för företag / storskaligt bruk: Bright Data (störst proxynätverk, compliance-funktioner, företagsprissättning)
Vi har också skrivit en sammanfattning av de bästa AI webscrapers och en djupare guide till AI lead generation om du vill gå vidare.
Yellow Pages vs. Google Maps vs. andra kataloger: när ska man använda vad?
De flesta lead-gen-proffs scrapar inte Yellow Pages isolerat. De hämtar från flera kataloger och jämför dem. En snabb jämförelse baserad på aktuell datatillgång:
| Faktor | Yellow Pages | Google Maps | Facebook Business |
|---|---|---|---|
| Tillgång till mejl | Låg (endast detaljsidor) | Mycket låg (inget standardfält) | Medel (sidor kan innehålla mejl) |
| Telefonnummer | ✅ Listas konsekvent | ✅ Listas konsekvent | ⚠️ Ibland dolda |
| Recensioner/betyg | ✅ Finns | ✅ Rikare data | ✅ Finns |
| Kategorier/nischer | ✅ Stark för lokala nischer | ✅ Bred och rik | ⚠️ Ojämn |
| Bästa scraper-verktyg | Thunderbit, Apify YP-actor | Outscraper, Apify Maps-actor | Thunderbit (AI hittar fälten på vilken sajt som helst) |
Yellow Pages är starkast för lokal nisch-täckning — om du behöver varje rörmokare i ett specifikt storstadsområde är det svårt att slå. Google Maps erbjuder rikare recensionsdata och mer färska signaler. Facebook Business Pages kan ibland slå båda när det gäller direkt mejlsynlighet eftersom sidägare ofta publicerar sin mejladress.
Thunderbits AI hittar fälten på vilken webbplats som helst, så du kan scrapas Yellow Pages, Google Maps och Facebook med samma tillägg. Den flexibiliteten spelar stor roll när du bygger en leadlista från flera källor. Vår guide om vad web scraping är går igenom grunderna om du är ny på området.
Juridiska och etiska överväganden vid scraping av Yellow Pages
Den här delen är kort, men viktig.
Yellow Pages-data är offentligt tillgänglig, men YP.coms användarvillkor säger uttryckligen att åtkomsten är för "individuella, icke-kommersiella, informativa ändamål" och att användare inte får använda "bots, scrapers, crawlers, spiders" för att extrahera data. Den nuvarande amerikanska rättsliga bilden kring web scraping är nyanserad — offentlig synlighet kan minska CFAA-risken jämfört med inloggade sidor, men avtalsrätt, integritetsregler (CCPA) och marknadsföringscompliance gäller fortfarande.
FTC skickade varningsbrev till 21 marknadsförare och lead generators inom vårdplaner i december 2024 om hur konsumentinformation används i lead-gen-flöden. Slutsatsen: scrap ansvarsfullt, respektera rate limits, återförsälj inte rådata utan att förstå de juridiska ramarna, och använd scrappad data för legitima affärsändamål.
Den här artikeln är informativ och utgör inte juridisk rådgivning.
Slutsats
De flesta Yellow Pages-scrapers missar mejl eftersom de stannar vid listningssidan. De verktyg som lyckas bättre är de som kan nå företagens detaljsidor, följa länkar till företagens webbplatser eller köra berikningsflöden ovanpå grundscrapingen. Även då ligger tillgången till mejl på Yellow Pages bara på ungefär 15–25% av listningarna — så realistiska förväntningar är minst lika viktiga som rätt verktyg.
Om du är ett icke-tekniskt team som behöver leads med faktisk kontaktdata, testa Thunderbits gratisnivå — funktionerna för undersidescraping och mejlextraktion är byggda just för det här problemet. Om du kör större kampanjer erbjuder Apify och Outscraper stabil molninfrastruktur. Och om du är utvecklare och vill ha full kontroll kommer Python med Playwright och ScrapingBee att ta dig dit, även om du får bygga mer av kedjan själv.
Börja med jämförelsetabellen ovan, välj utifrån din kompetensnivå och budget, och kom ihåg: den bästa scrapern är den som faktiskt ger dig datan du behöver för outreach, inte den med längst funktionslista.
Du kan också utforska vår Thunderbit Chrome Extension direkt, eller kolla in guider på vår YouTube-kanal.
Vanliga frågor
Går det verkligen att scrapa mejladresser från Yellow Pages?
Ja, men de flesta mejladresser finns på företagens detalj- eller undersidor, inte på huvudkortet i listningen. Nuvarande dokumentation för scrapers tyder på att bara cirka 15–25% av företagen exponerar en mejladress som en scraper på detaljsida kan få fram. Du behöver ett verktyg med stöd för undersidescraping — som Thunderbit eller Apifys detail-mode actors — för bästa resultat.
Vilken är den bästa gratis Yellow Pages-scrapern?
Instant Data Scraper är helt gratis utan konto eller krediter, men den extraherar inte mejl pålitligt och har ingen anti-bot-hantering. Thunderbit erbjuder en gratisnivå (6 sidor/månad) med AI-driven scraping, åtkomst till undersidor och mejlextraktion — ett starkare alternativ om mejl är viktigt i ditt arbetsflöde.
Hur undviker jag att bli blockerad när jag scrapar Yellow Pages?
Yellow Pages använder Cloudflare Bot Management, CAPTCHA, rate limiting och browser fingerprinting. Använd verktyg med inbyggd proxyrotation och CAPTCHA-hantering (Thunderbit, Apify, Octoparse, ScrapingBee, Bright Data). Thunderbits växling mellan moln och webbläsare ger en praktisk fallback — om molnscraping blockeras använder webbläsarläget din lokala session för att kringgå vissa skydd.
Yellow Pages-scraper vs. Google Maps-scraper — vilken är bäst för leads?
Det beror på dina behov. Yellow Pages har starkare täckning av lokala nischkategorier och listar telefonnummer konsekvent. Google Maps erbjuder rikare recensionsdata och tätare uppdateringar. Ingen av dem är särskilt bra för mejl — Facebook Business Pages tenderar faktiskt att ha bättre tillgång till mejladresser. Helst bör du jämföra flera kataloger för de mest kompletta leadprofilerna.
Är det lagligt att scrapa Yellow Pages?
Yellow Pages-data är offentligt tillgänglig, men YP.coms användarvillkor begränsar automatiserad datainsamling och kommersiell användning av sökresultat. Den amerikanska rättsliga utvecklingen kring scraping av offentliga data pågår fortfarande. Användare bör granska sajtens användarvillkor, följa tillämpliga integritetsregler (CCPA, GDPR där relevant) och använda scrappad data ansvarsfullt. Den här artikeln är informativ och utgör inte juridisk rådgivning.
Testa Thunderbit för Yellow Pages-scraping Get Started Free
Läs mer



