
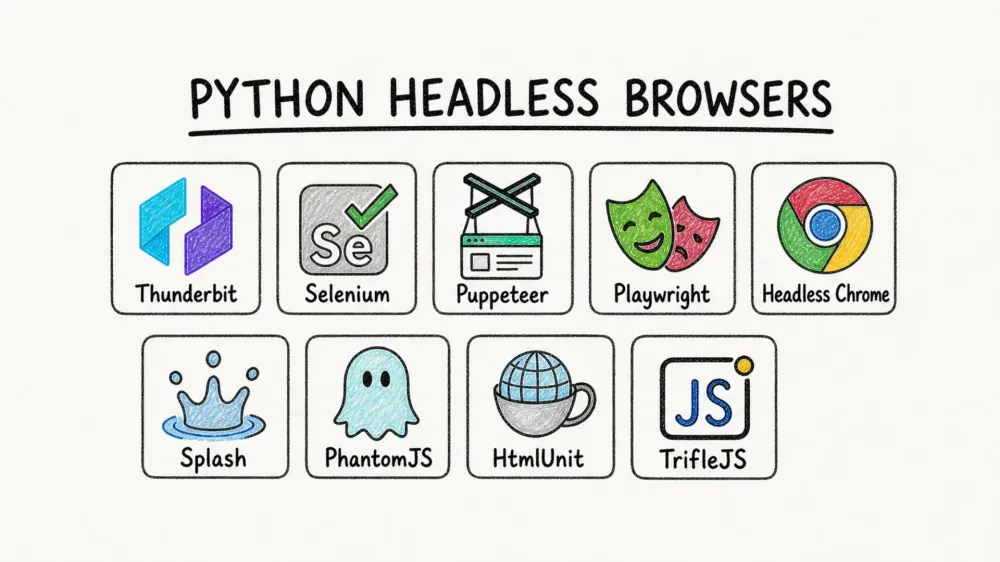
Webben har blivit ett vilt och ständigt föränderligt landskap—tänk mindre “digitalt bibliotek” och mer “datadjungel”. År 2026, om du vill hämta data från moderna sajter, möter du inte bara en vägg av JavaScript—du står inför en fästning. Jag har själv sett hur traditionella scrapingverktyg går på knäna när de möter dynamiskt innehåll, oändlig scroll och anti-bot-skydd. Därför är framväxten av python headless browser inte bara en trend—det är en fullskalig revolution för alla som behöver pålitlig och skalbar extrahering av webdata.
Och det är inte bara tekniker som bryr sig. Per 2025 förlitar sig 73% av företag på automatiserad webdataextrahering för business intelligence, och över 94% av webbplatser använder idag client-side JavaScript-rendering. Oavsett om du jobbar med försäljning, e-handel eller drift är rätt python headless browser skillnaden mellan “data i fingertopparna” och “data utom räckhåll”. Så låt oss skala bort bruset—jag har testat, jämfört och levt med de här verktygen, och här bryter jag ner de 10 bästa python headless browsers för modern scraping (med extra fokus på hur AI förändrar spelplanen för icke-kodare).
Vad gör en Python Headless Browser oumbärlig för modern scraping?
Extrahera data från vilken webbplats som helst med AI Get Started Free
Låt oss reda ut begreppen: en python headless browser är i grunden en webbläsare som du styr med Python-kod, men utan det där stora visuella fönstret på skärmen. Den laddar sidor, kör JavaScript, klickar på knappar, fyller i formulär—allt sker osynligt i bakgrunden. Tänk dig en spökwebbläsare som jobbar på medan du tar en kaffe.
Varför spelar det roll? För att moderna webbplatser är byggda för användare, inte bottar. De gömmer data bakom JavaScript, kräver inloggning och förväntar sig att du interagerar som en riktig person. Traditionella scrapers som bara hämtar HTML sitter då och stirrar på tomma skal. Headless browsers, däremot, simulerar verkligt användarbeteende—de väntar in AJAX-anrop, scrollar igenom oändliga flöden och fångar innehållet exakt som du ser det i Chrome eller Firefox (LiveProxies).
Men det finns mer:
- Hastighet och effektivitet: Headless browsers hoppar över den visuella renderingen, så de går snabbare och använder mindre minne—perfekt för scraping i stor skala (LiveProxies).
- Stöd för dynamiskt innehåll: De kör JavaScript, så du får den verkliga renderade datan—inte bara rå HTML.
- Automatiseringskraft: Behöver du logga in, bläddra mellan sidor eller hantera popup-fönster? Python headless browsers kan automatisera allt det.
- Skalbarhet: Kör hundratals instanser i molnet, hämta tusentals sidor parallellt och gör det utan att svettas.
För affärsanvändare betyder det här att du äntligen kan samla leads, bevaka konkurrenter eller följa priser—even om webbplatsen är byggd som Fort Knox. Och med de senaste AI-drivna verktygen behöver du inte vara kodare för att vara med.
Hur vi valde de bästa Python Headless Browsers
Jag kastade inte bara dartpilar på en lista med webbläsarnamn. Här är vad jag bedömde:
- Prestanda och hastighet: Klarar den moderna, JavaScript-tunga sajter snabbt och stabilt?
- Stöd för olika webbläsare: Fungerar den med Chrome, Firefox, WebKit eller till och med äldre motorer som IE?
- Enkel användning: Är den lätt för icke-kodare, eller kräver den en doktorsexamen i Python?
- AI- och no-code-funktioner: Kan affärsanvändare utnyttja AI för att automatisera scraping utan att skriva skript?
- Community och support: Finns det en aktiv community, bra dokumentation och fortsatt utveckling?
- Unika funktioner: Erbjuder den något speciellt—som färdiga mallar, moln-scraping eller navigation till undersidor?
Jag har sett team förlora veckor på att kämpa med installationer, bara för att köra fast när sidans layout ändras. De bästa verktygen fungerar inte bara—de anpassar sig, skalar och gör livet enklare.
Topp 10 bästa Python Headless Browsers för modern scraping
Här är min definitiva lista, med en djupdykning i vad som gör varje verktyg starkt—eller svagt.
1. Thunderbit
 Thunderbit är den python headless browser jag önskar att jag haft för flera år sedan. Det är inte bara ett verktyg för webbläsarautomatisering—det är en AI-driven web scraper Chrome Extension byggd för affärsanvändare som vill ha resultat, inte huvudvärk.
Därför sticker Thunderbit ut:
- AI-baserad fältkonfiguration: Öppna bara tillägget med ett klick så tolkar Thunderbits AI layouten, väljer fälten och kör extraheringen åt dig (Thunderbit Docs).
- Direkta datamallar: För populära sajter (Amazon, Zillow, LinkedIn med flera) får du mallar med ett klick—ingen installation krävs.
- Scraping av undersidor och paginering: Thunderbit kan klicka sig vidare genom undersidor, hantera oändlig scroll och slå ihop all data i en enda tabell.
- Prompter på naturligt språk: Beskriv vad du vill ha på vanlig svenska; Thunderbits AI fixar resten.
- Scraping i molnet eller i webbläsaren: Kör lokalt eller i molnet (upp till 50 sidor åt gången för högre hastighet).
- Ingen kod krävs: På riktigt—kan du använda en webbläsare, kan du använda Thunderbit.
- Gratis export av data: Exportera till Excel, Google Sheets, Notion eller Airtable med ett klick.
Jag har sett Thunderbit spara timmar för sälj- och driftteam—från att hämta leads och bevaka priser till att samla produktdata, utan att någon behöver röra kod. Verktyget används av över 200 000 användare världen över, och omdömena är konsekvent: “Jag kan inte fatta hur enkelt det här är.”
Bäst för: Icke-tekniska användare, affärsteam och alla som vill låta AI göra grovjobbet.
Testa Thunderbit AI Web Scraper gratis
2. Selenium
 Selenium är urmodern inom webbläsarautomatisering. Om du någonsin googlat “python headless browser” har du sannolikt snubblat över Selenium WebDriver.
Fördelar:
- Stöd för alla stora webbläsare: Chrome, Firefox, Safari, Edge och till och med Internet Explorer (för den modige).
- Enorm community: Massor av guider, plugins och svar på Stack Overflow.
- Mycket flexibelt: Automatisera allt en användare kan göra—klick, formulär, navigering.
Nackdelar:
- Installationen kan vara besvärlig: Du måste hantera webbläsardrivrutiner och hålla versionerna synkade.
- Långsammare än moderna verktyg: WebDriver-protokollet lägger på overhead, och att skala till hundratals webbläsare blir klumpigt.
- Pratigt API: Du kommer ofta att skriva mer kod än med Playwright eller Puppeteer.
Bäst för: Team med befintlig Selenium-erfarenhet, testning över flera webbläsare eller äldre automationsflöden.
3. Puppeteer
 Puppeteer är Googles högre nivåns automationsbibliotek för Chrome/Chromium. Även om det är inbyggt i Node.js kan Python-användare ta del av det via Pyppeteer.
Fördelar:
- Optimerat för Chrome: Snabbt, effektivt och tätt integrerat med Chrome DevTools.
- Asynkront API: Perfekt för moderna, JavaScript-tunga sajter.
- Rika funktioner: Skärmdumpar, PDF-export, nätverksinterception.
Nackdelar:
- Endast Chromium: Stöd saknas för Firefox och Safari.
- Native för Node.js: Python-användare måste använda Pyppeteer (som numera inte längre underhålls—se nedan).
Bäst för: Utvecklare som vill ha snabb och stabil Chrome-automatisering och inte behöver stöd för flera webbläsare.
4. Playwright
 Playwright är den nyare spelaren på banan, byggd av Microsoft—och har snabbt blivit mitt förstahandsval för avancerad scraping.
Fördelar:
- Stöd för flera webbläsare: Automatisera Chromium, Firefox och WebKit med ett enda API.
- Auto-waiting: Sluta gissa när en sida är klar—Playwright väntar åt dig.
- Samtidighet: Kör flera webbläsarkontexter parallellt för riktigt hög hastighet.
- Python först: Native Python-bindningar, både async och sync.
Nackdelar:
- Större installation: Paketerar flera webbläsare, så uppstarten är lite tyngre.
- Kräver fortfarande kod: Inte lika vänligt för icke-tekniska användare som Thunderbit.
Bäst för: Utvecklare som behöver robust, modern automatisering—särskilt för komplexa, dynamiska webbappar.
5. Headless Chrome
 Headless Chrome är motorn som driver många av verktygen ovan. Du kan styra den direkt via Chrome DevTools Protocol (CDP) för maximal flexibilitet.
Fördelar:
- Toppsupport för moderna webbtekniker: Fungerar något i Chrome, så fungerar det i headless Chrome.
- Finkornig kontroll: Du får tillgång till varje liten del av webbläsaren.
Nackdelar:
- Brant inlärningskurva: Du behöver tala CDP eller använda ett wrapper-bibliotek.
- Endast Chrome: Inget stöd för flera webbläsare.
Bäst för: Experter som bygger egna automationspipelines eller integrerar Chrome på låg nivå.
6. Pyppeteer
 Pyppeteer är den inofficiella Python-portningen av Puppeteer. Den tog asynkron Chrome-automatisering till Python, men det finns en hake.
Fördelar:
- Puppeteer-liknande API: Om du kan Puppeteer känner du dig hemma direkt.
- Snabb Chrome-automatisering: Bra för dynamiska sajter.
Nackdelar:
- Inte längre underhålls: Originalprojektet uppdateras inte längre (utvecklarna rekommenderar att du går över till Playwright).
- Endast Chromium: Ingen Firefox eller Safari.
Bäst för: Äldre projekt som redan använder Pyppeteer. För nya projekt: använd Playwright.
7. Splash
 Splash är en lättviktig, skriptbar headless browser med HTTP-API, byggd av teamet bakom Scrapinghub (nu Zyte).
Fördelar:
- Lättviktig: Använder QtWebKit, så den drar mindre resurser än Chrome.
- HTTP-API: Styr den från vilket språk som helst, inte bara Python.
- Bra för Scrapy: Integreras smidigt med Scrapy-spiders för JavaScript-rendering.
Nackdelar:
- Äldre WebKit-motor: Kan ha svårt med den senaste JavaScript-tekniken.
- Lua krävs: För avancerade interaktioner behöver du lära dig lite Lua.
Bäst för: Scrapy-användare som ibland behöver JavaScript-rendering, eller lätta server-side rendering-uppgifter.
8. PhantomJS
 PhantomJS är den ursprungliga skriptbara headless browsern, byggd på WebKit. Den var en pionjär—men är numera till stor del föråldrad.
Fördelar:
- Enkel skriptning: Lätt att automatisera med JavaScript.
- Stöd för äldre system: Fungerar fortfarande för äldre, statiska sajter.
Nackdelar:
- Inte längre underhålls: Inga uppdateringar sedan 2016.
- Föråldrad motor: Klarar inte moderna sajter med mycket JavaScript.
- Säkerhetsrisker: Inga nya patchar.
Bäst för: Underhåll av äldre skript. För nya projekt: migrera till Playwright eller Puppeteer.
9. HtmlUnit
 HtmlUnit är en Java-baserad headless browser som simulerar webbläsarbeteende. Den är snabb och lättviktig, men är inte en riktig webbläsarmotor.
Fördelar:
- Ren Java: Passar utmärkt i Java-tunga miljöer.
- Snabb för statiska sidor: Inget behov av att starta en full webbläsare.
Nackdelar:
- Begränsat JavaScript-stöd: Har svårt med moderna, dynamiska sajter.
- Inte Python-native: Kräver integrationslager (t.ex. Seleniums HtmlUnitDriver).
Bäst för: Java-baserade flöden, testning av äldre appar eller scraping av enkla, server-renderade sidor.
10. TrifleJS
 TrifleJS är en headless browser för Internet Explorer (IE), avsedd för att automatisera äldre webbappar på Windows.
Fördelar:
- IE-automatisering: Klarar gamla intranätappar eller system som bara fungerar i IE.
- PhantomJS-liknande API: Kräver minimala ändringar för PhantomJS-skript.
Nackdelar:
- Endast Windows: Inget stöd för andra plattformar.
- Föråldrad: IE är pensionerat; TrifleJS är nischat och sällan underhållet.
Bäst för: Specialiserade äldre flöden där IE-automatisering fortfarande krävs.
Jämförelsetabell: Python Headless Browsers i korthet
| Verktyg | Stöd för webbläsare | Prestanda och skala | Enkel användning | AI/no-code-funktioner | Community och support | Bäst för |
|---|---|---|---|---|---|---|
| Thunderbit | Chrome (tillägg/moln) | Hög (parallellisering i molnet) | Enklast — ingen kod | Ja (AI, mallar) | Växande, aktiv | Icke-kodare, sälj/drift, snabb dataextrahering |
| Selenium | Alla stora webbläsare | Medel | Medel (installation) | Nej | Mycket stor, mogen | Flera webbläsare, äldre system, testautomation |
| Puppeteer | Chromium/Chrome | Mycket hög | Hög (för utvecklare) | Nej | Stor (Node.js) | Endast Chrome, utvecklare, snabb automatisering |
| Playwright | Chromium, Firefox, WebKit | Mycket hög (flera kontexter) | Hög (för utvecklare) | Nej | Snabbt växande | Avancerad, flera webbläsare, modern scraping |
| Headless Chrome | Chrome/Edge | Mycket hög | Låg (manuell CDP) | Nej | N/A (grundteknik) | Egenutvecklat, expert, låg nivå-kontroll |
| Pyppeteer | Chromium/Chrome | Hög | Medel (async) | Nej | Liten, inte längre underhållen | Äldre Pyppeteer-skript |
| Splash | QtWebKit | Medel | Medel (API/Lua) | Nej | Nischad (Scrapy/Zyte) | Scrapy-användare, lätt JavaScript-rendering |
| PhantomJS | WebKit (gammal) | Låg (föråldrad) | Medel (JS) | Nej | Nedlagt | Endast för äldre lösningar |
| HtmlUnit | Simulerad (Java) | Medel/hög (statiskt) | Låg (Java) | Nej | Liten, Java-inriktad | Java-flöden, enkla/statiska sidor |
| TrifleJS | Internet Explorer (Trident) | Låg/medel | Medel (JS, Win) | Nej | Mycket liten, legacy | Legacy-automatisering endast för IE |
Så väljer du rätt Python Headless Browser för ditt företag
Vad är data scraping och hur gör man det 2025 Get Started Free
Här är mitt snabbtest för att välja rätt verktyg:
- Behöver du snabb scraping utan kod och med AI-hjälp? Välj Thunderbit. Det är det enklaste sättet för icke-kodare att få tillförlitlig data—särskilt för sälj-, e-handels- eller researchteam.
- Vill du ha maximal kontroll och stöd för flera webbläsare? Playwright är det bästa valet. Det är robust, modernt och byggt för skala.
- Har ni redan investerat i Selenium? Håll fast vid Selenium—det är fortfarande kungen för legacy- och multibrowser-flöden.
- Bygger du Chrome-baserad automatisering som utvecklare? Puppeteer (eller Playwright) är snabbt och kraftfullt.
- Scrapar du enkla, statiska sidor i en Java-miljö? HtmlUnit är lättviktigt och enkelt att integrera.
- Underhåller du äldre skript eller IE-only-appar? PhantomJS och TrifleJS är dina sista nödlösningar.
Kom ihåg: det bästa verktyget är det som passar ditt arbetsflöde, ditt teams kompetens och dina affärsbehov. Ibland betyder det att kombinera flera—Thunderbit för snabba jobb, Playwright för tungt arbete och Selenium för äldre system.
Vanliga frågor
1. Vad är en python headless browser, och varför behöver jag en för scraping?
En python headless browser är en webbläsare som du styr med Python-kod, men som körs osynligt (utan GUI). Den är avgörande för att scrapa moderna sajter med mycket JavaScript eftersom den kan köra skript, hantera användarinteraktioner och extrahera fullt renderat innehåll—något traditionella HTML-scrapers inte klarar.
2. Vilken python headless browser är bäst för icke-tekniska användare?
Thunderbit är förstahandsvalet för icke-kodare. Den använder AI för att automatisera installationen, erbjuder färdiga mallar och låter dig extrahera data med ett enda klick—eller genom att beskriva i en mening vilken data du behöver. Ingen programmering krävs.
3. Hur skiljer sig Playwright och Puppeteer för Python-användare?
Playwright stöder flera webbläsare (Chromium, Firefox, WebKit) och har robusta Python-bindningar, vilket gör det idealiskt för avancerad automatisering. Puppeteer är endast för Chrome och native för Node.js, men Python-användare kan använda Pyppeteer (även om det numera inte underhålls). För nya Python-projekt är Playwright det bättre valet.
4. Är Selenium fortfarande relevant för modern web scraping?
Ja—Selenium används fortfarande brett, särskilt för testning över flera webbläsare och äldre automatisering. Men det är långsammare och mer komplext att sätta upp än nyare verktyg som Playwright eller Thunderbit, och det är mindre effektivt för scraping i stor skala.
5. När bör jag använda äldre verktyg som PhantomJS, HtmlUnit eller TrifleJS?
Endast för att underhålla eller migrera gamla arbetsflöden. PhantomJS och TrifleJS är föråldrade, och HtmlUnit passar bäst i Java-baserade miljöer med enkla sidor. För nya projekt: välj moderna verktyg som fortfarande underhålls aktivt.
Om du är redo att se hur modern, AI-driven scraping ser ut, testa Thunderbit. Och för fler fördjupningar om webautomatisering, kolla in Thunderbit Blog. Lycka till med scrapen—må din data alltid vara färsk och dina webbläsare för alltid vara headless.
Testa Thunderbit AI Web Scraper idag Get Started Free
Läs mer



