
Den gamla frågan var enkel: ”Vilken scraper kan kopiera data från den här webbplatsen?”
Den bättre frågan 2026 är mer träffsäker: ”Vilket arbetsflöde kan förvandla en rörig webbsida till tillförlitlig, strukturerad data — med tillräcklig validering för att jag ska kunna använda den igen nästa vecka?”
Det här skiftet spelar roll eftersom ”AI web scraper” nu täcker flera väldigt olika typer av produkter. Vissa verktyg använder AI för att föreslå fält och extrahera data utan selectors. Vissa är visuella scrapers med några smarta detekteringsfunktioner. Vissa är utvecklarplattformar där AI hjälper dig att bygga eller underhålla kod. Och vissa äldre verktyg dyker fortfarande upp i sökresultaten trots att de egentligen inte längre är AI-native.
Den här guiden håller jämförelsen praktisk. Om du arbetar med försäljning, marknadsföring, e-handel, research, drift eller data är målet inte att beundra en scraper. Målet är att få rena rader från publika webbplatser in i ett kalkylark, CRM, databas eller automatiserat arbetsflöde — utan att behöva ägna resten av månaden åt att laga selectors.
Skrapa webbplatser med AI Använd Thunderbit för att omvandla webbsidor till strukturerade tabeller och exportera sedan till Sheets, Airtable, Notion, CSV eller JSON. Get Started Free
Vad räknas som en gratis AI-webbscraper 2026?
En användbar AI-webbscraper bör hjälpa till med minst en av de här uppgifterna:
- läsa sidan och föreslå vilka fält som ska extraheras
- hantera listor, paginering, oändlig scroll eller undersidor
- omvandla rörigt sidinnehåll till strukturerade rader
- exportera data till verktyg som teamet redan använder
- minska mängden selector-underhåll när en sida ändras
- göra arbetsflödet repeterbart för ett team, inte bara för en persons webbläsarsession
”Gratis” behöver också nyanseras. Vissa verktyg har en faktisk gratisplan. Andra har en gratis provperiod. Några är open source men kräver utvecklingstid. Vissa enterprise-verktyg är utmärkta, men den fria vägen är mest en demo eller test. Det gör dem inte till dåliga verktyg, men det påverkar vem som bör välja dem.
Här är den praktiska tumregeln:
- Om du behöver data idag och inte vill koda, börja med en AI-scraper utan kod.
- Om du behöver en skräddarsydd pipeline och har utvecklare, använd ett utvecklarramverk eller en molnbaserad automationsplattform.
- Om du behöver styrda datainflöden i stor skala, titta på enterprise-dataplattformar.
- Om ett verktyg är föråldrat eller inte längre stöds, se det som en referenspunkt — inte som ditt standardval.
Hur vi valde dessa verktyg
Jag gick igenom den aktuella artikelns shortlist med 10 verktyg och behöll samma praktiska utvärderingsmodell. Den viktiga frågan är inte längre ”Kan produkten scrapa?” utan ”Vilken typ av scraping-arbetsflöde gör den här produkten enklare?”
Kriterierna:
- AI-stöd: fältförslag, smart extrahering, naturligt språk för setup eller AI-stödd parsing.
- Fri åtkomst: gratisplan, gratis provperiod, open source-tillgänglighet eller utvecklarkrediter.
- Användarvänlighet: om en affärsanvändare kan köra verktyget utan hjälp från utvecklare.
- Stöd för moderna webbplatser: paginering, undersidor, JavaScript-tunga sidor, bilder och export.
- Operativ passform: om resultatet kan bli en repeterbar process.
- Risk och underhåll: hur mycket setup, selector-reparation, compliance-granskning och QA användaren fortfarande ansvarar för.
En sak till: kontrollera alltid villkoren för målsidan, robots.txt, inloggningskrav och integritetskrav innan du scrapar. AI gör extraktion enklare; den tar inte bort ditt ansvar att använda webdata på ett ansvarsfullt sätt.
Snabba val: bästa gratis AI-webbscrapers efter användningsområde
| Användningsområde | Börja här | Varför |
|---|---|---|
| Snabb no-code scraping för affärsteam | Thunderbit | AI-fältförslag, undersidescraping, export, Chrome-arbetsflöde |
| Visuell scraping i desktop-stil | ParseHub eller Octoparse | Bra för användare som föredrar klickbaserade arbetsflöden |
| Browser recipe-scraping | Data Miner | Starkt för vanliga tabeller och repeterbara receptbaserade jobb |
| Utvecklarstyrd scraping | Scrapy eller Apify | Bäst när kod, API:er och egen infrastruktur är viktigt |
| AI-data-API:er och entity-extraktion | Diffbot | Bättre för API-baserad enrichment och strukturerad entity-data |
| Open source, AI-redo crawling | Crawl4AI eller Scrapling | Utvecklarramverk för LLM-pipelines och underhållbar custom scraping |
1. Thunderbit
Thunderbit passar bäst för affärsanvändare som vill skrapa publika webbsidor utan att skriva scraper-kod. Det är ett Chrome-tillägg byggt kring ett enkelt arbetsflöde: öppna en sida, låt AI föreslå fält, justera tabellen vid behov, scrapa listan eller undersidorna och exportera sedan resultatet.
Det här arbetsflödet spelar roll eftersom många team egentligen inte vill ha ”en scraper”. De vill ha leads från kataloger, produktdata från marknadsplatser, priser från konkurrenters sidor, bostadsannonser, recensioner, jobbannonser eller forskningsdata i ett kalkylark.
Thunderbit är särskilt starkt när:
- källan är en webbplats snarare än en PDF eller intern databas
- användaren vet vilken data som behövs men inte CSS-selectors
- sidan har detaljsidor, paginering eller upprepade kort
- resultatet behöver gå till Google Sheets, Airtable, Notion, CSV eller JSON
- arbetsflödet kan behöva upprepas av en icke-teknisk kollega
AI-delen är praktisk, inte dekorativ. AI hjälper till att tolka fält, skriva extraktionsprompter och göra setup mindre skör än ett rent klickbaserat selector-arbetsflöde. Du bör ändå granska exempelrader innan du exporterar ett stort jobb, särskilt när källsidan blandar in annonser, rekommendationer eller sponsrade listningar i huvudresultaten.
Fri åtkomst: Thunderbit har en gratisväg för mindre jobb, med betalda planer för högre volymer. Kontrollera aktuell prissida innan du publicerar exakta kreditgränser, eftersom kreditpaketeringen kan ändras.
Bäst för: sälj, marknadsföring, e-handel, fastigheter, drift och researchteam som snabbt behöver strukturerad webdata.

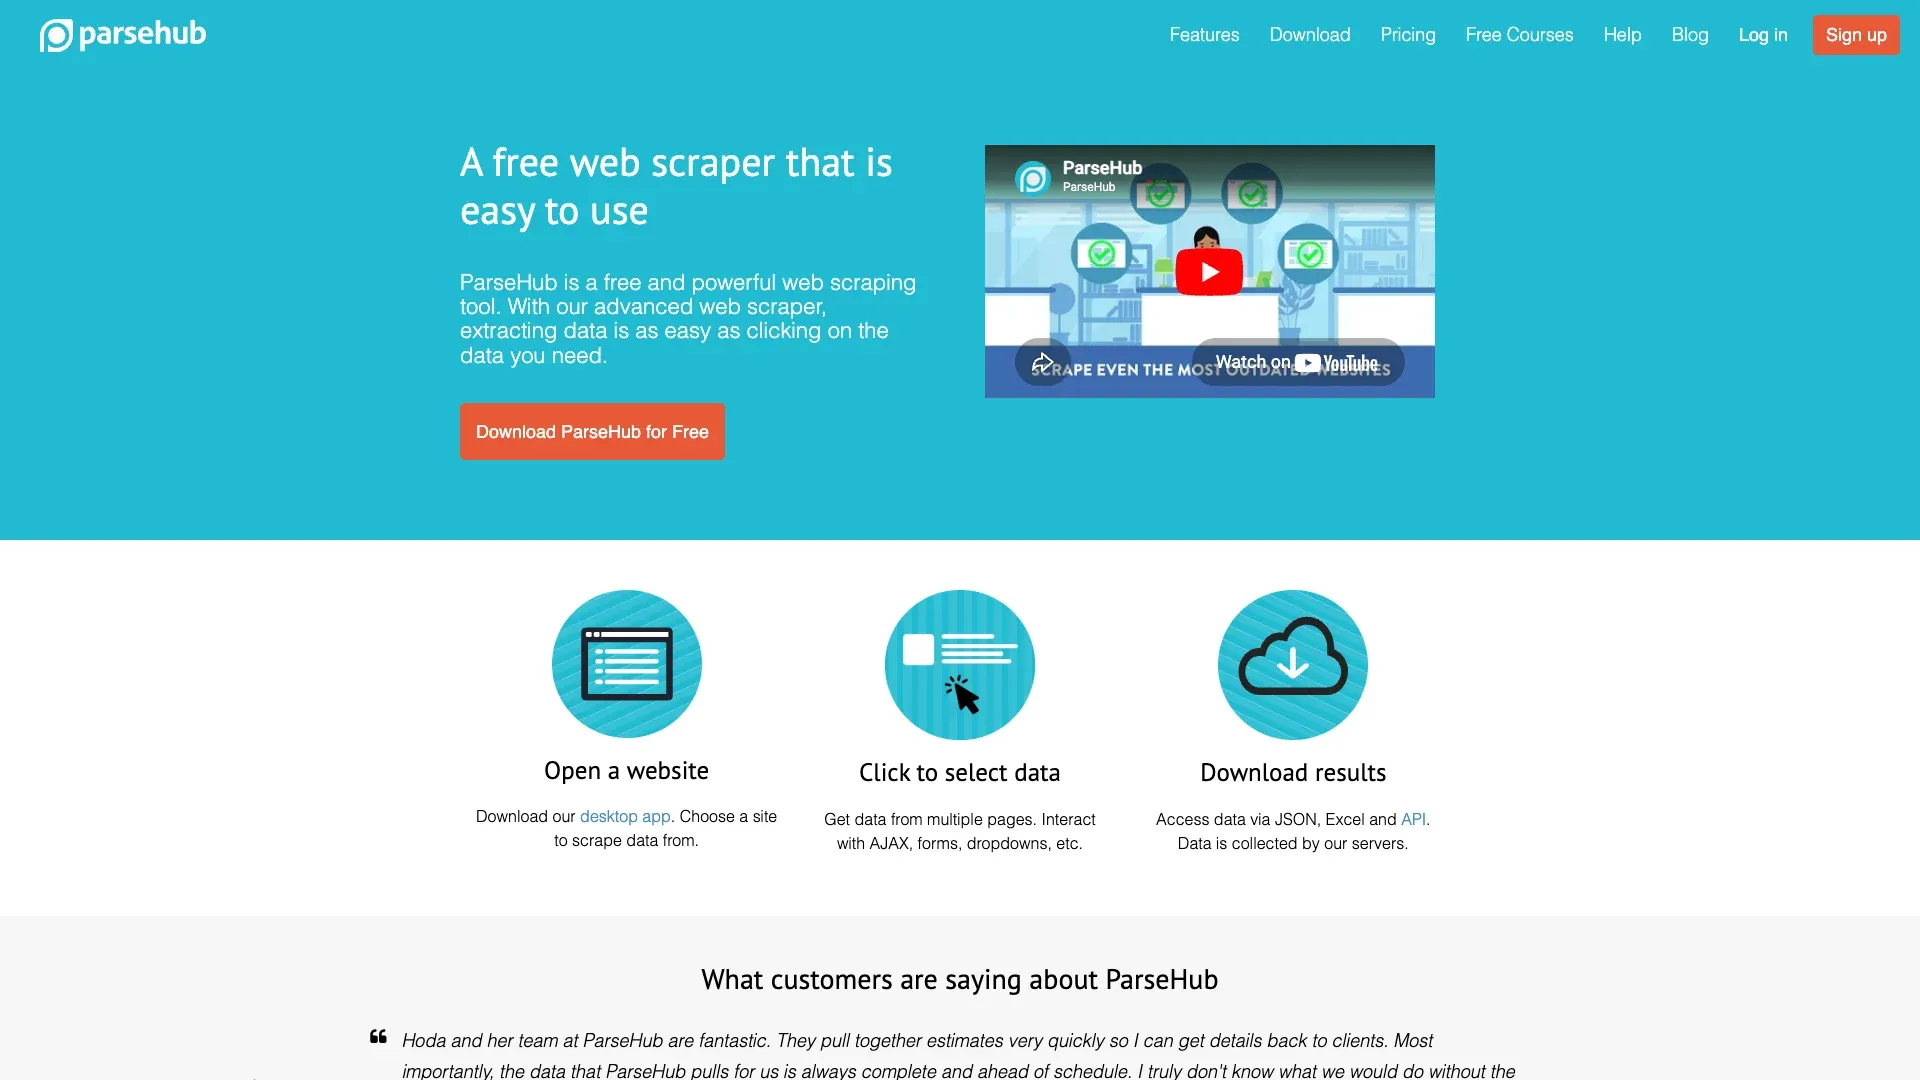
2. ParseHub
ParseHub är en visuell webbscraper för användare som föredrar att klicka sig genom en sida och lära verktyget vad som ska extraheras. Den kan hantera många dynamiska sidor och är fortfarande ett bekant alternativ för team som vill ha en visuell desktop- eller molnbaserad scraper.
ParseHub är användbar när en användare är bekväm med att bygga ett projekt steg för steg: välj ett element, expandera markeringen, lägg till paginering, testa körningen och exportera. Den är inte lika ”prompt-first” som nyare AI-native-verktyg, men den kan fortfarande fungera bra för strukturerade listor, artikelsidor och produktkataloger.
Fri åtkomst: ParseHub har historiskt erbjudit en gratisnivå för begränsade projekt och sidkörningar. Bekräfta aktuella gränser för projekt och sidor på den officiella webbplatsen innan du anger siffror i produktionsmaterial.
Bäst för: mindre visuella scrapingprojekt där användaren är beredd att lägga lite tid på att konfigurera arbetsflödet.
3. Octoparse
Octoparse är en mogen no-code-webbscrapingplattform med mallar, arbetsflödesbyggare, molnkörningar, schemaläggning och stöd för många dynamiska webbplatser. Den är mer funktionsrik än ett lättviktigt Chrome-tillägg, vilket kan vara en fördel eller en belastning beroende på användaren.
Octoparse är ett bra val när scrapingjobbet återkommer, målsidan är komplex eller teamet vill ha en visuell arbetsflödesbyggare med schemaläggning och körning i molnet. Setup kan ta längre tid än en snabb AI-assisterad scrape, men den ger avancerade användare mer kontroll.
Fri åtkomst: Octoparse erbjuder en gratisplan, men begränsningar för funktioner och antal poster ändras. Verifiera aktuella begränsningar på Octoparse prissida innan du publicerar exakta siffror.
Bäst för: avancerade användare och team som behöver visuell kontroll över arbetsflöden, mallar, schemaläggning eller återkommande jobb.

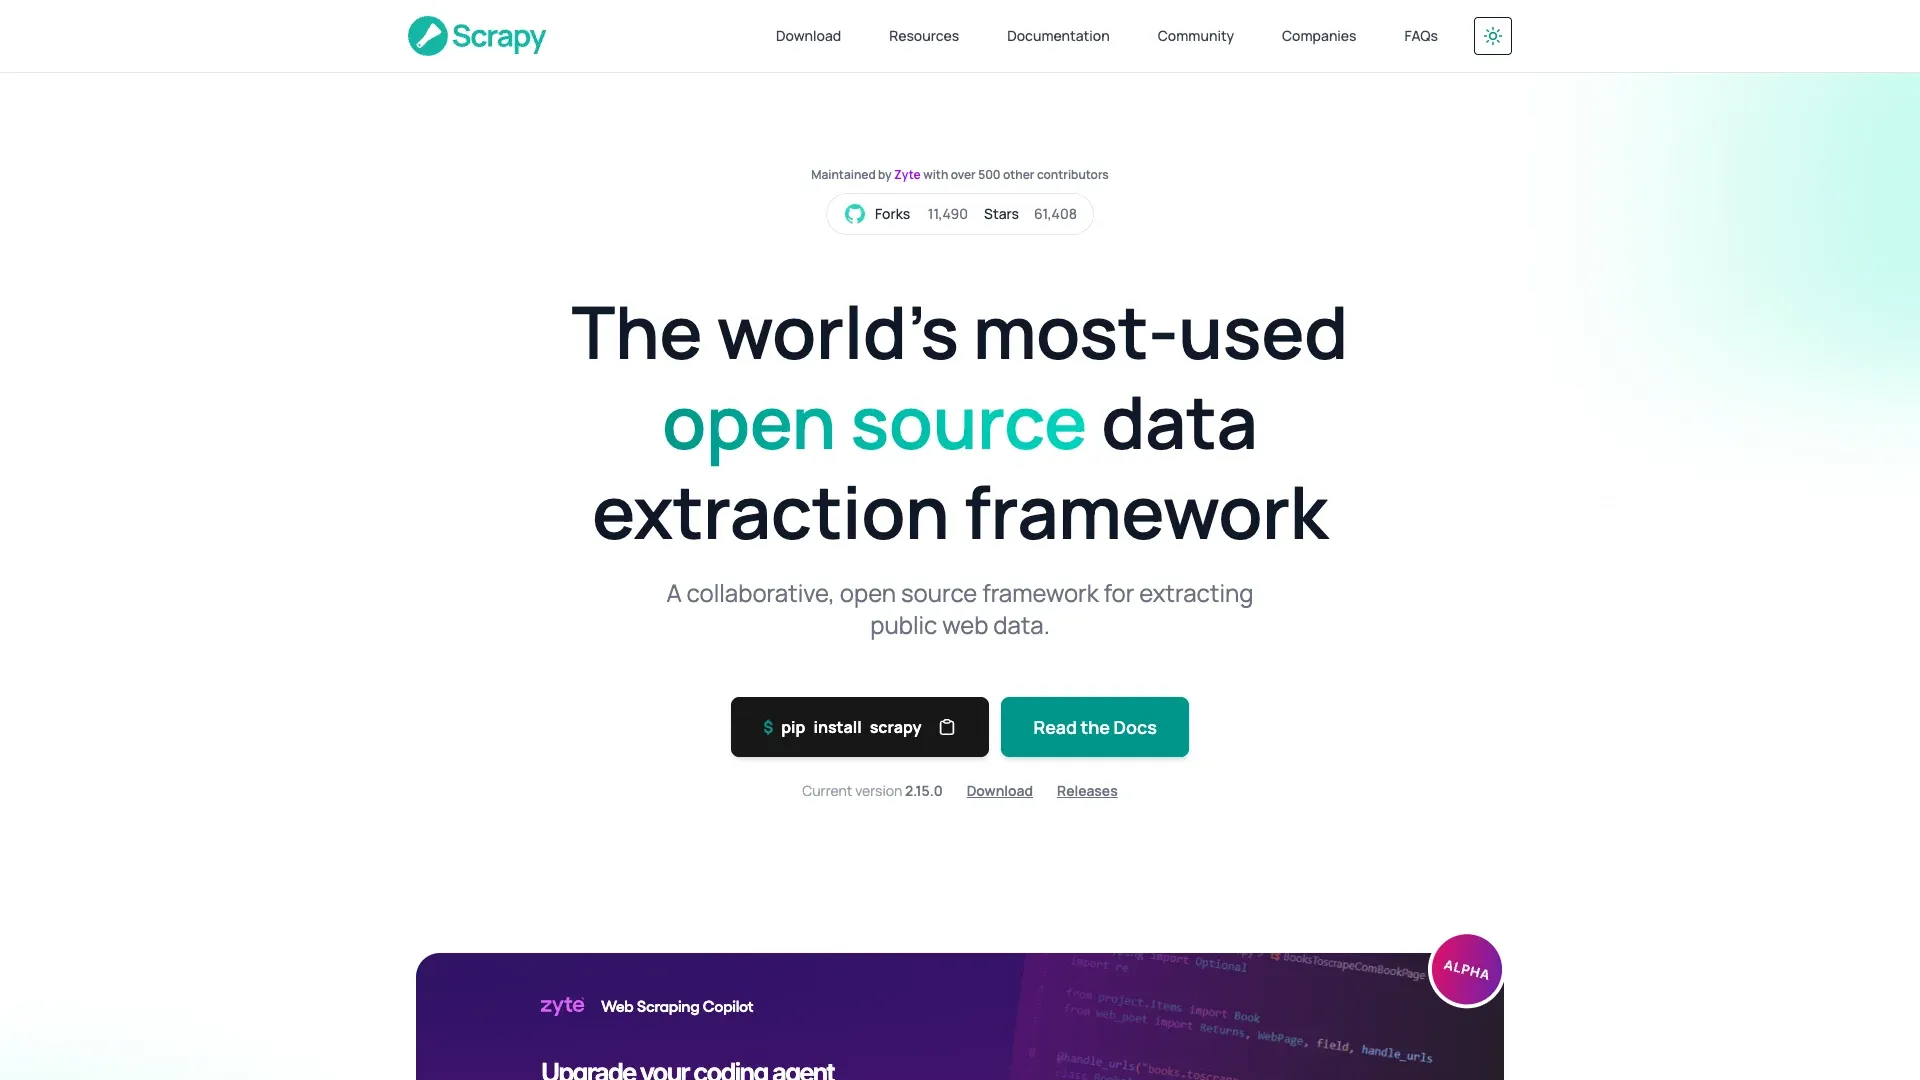
4. Scrapy
Scrapy är inte en no-code AI-scraper. Det är ett open source-Pythonramverk för att bygga crawlers och extraktionspipelines. Den skillnaden är viktig.
För utvecklare är Scrapy fortfarande ett av de mest flexibla sätten att bygga en skräddarsydd scraper. Du kan kontrollera requests, parsing, retries, pipelines, lagring och deployment. Du kan också använda LLM:er runt Scrapy: för att utforma selectors, granska parsinglogik, skapa tester eller förklara fel. Men Scrapy tar inte bort utvecklingsarbetet i sig.
Fri åtkomst: Scrapy är open source. Mjukvaran är gratis, men hosting, proxies, underhåll, övervakning och utvecklingstid är det inte.
Bäst för: utvecklare som bygger anpassade, underhållbara scraping-system där kodägarskap är okej.
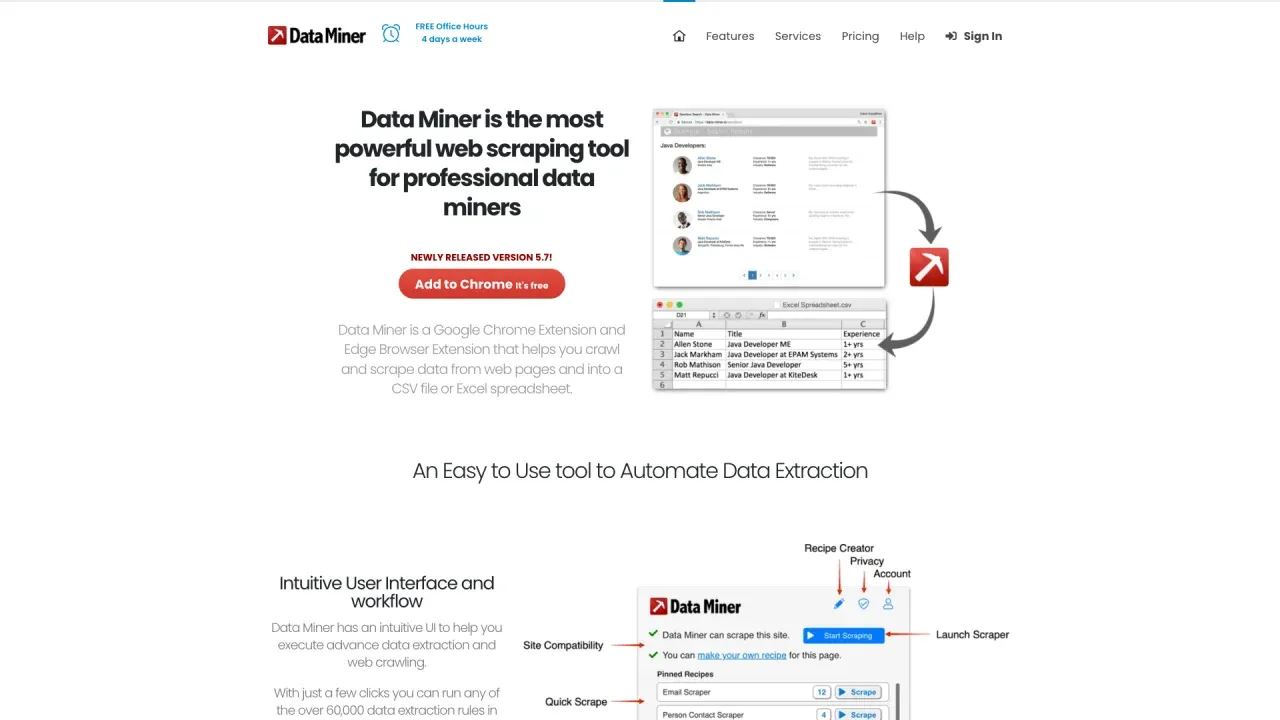
5. Data Miner
Data Miner är ett webbläsartillägg som fokuserar på att skrapa tabeller, listor och vanliga sidmönster. Dess receptbibliotek är den stora fördelen: om ett recept redan finns för din källa kan setup gå snabbt.
Det här är ett bra val för användare som återkommande scrapar bekanta sidtyper och inte behöver en full extraktionsplattform. Det är mindre lämpligt när sidan är rörig, mycket dynamisk eller kräver AI för att tolka fält från tvetydigt innehåll.
Fri åtkomst: Data Miner erbjuder begränsad gratisanvändning med betalda planer för högre volymer. Verifiera aktuella begränsningar för sidor eller krediter innan du anger dem.
Bäst för: snabb tabellextraktion, vanliga kataloger och användare som gillar webbläsartilläggsarbetsflöden.
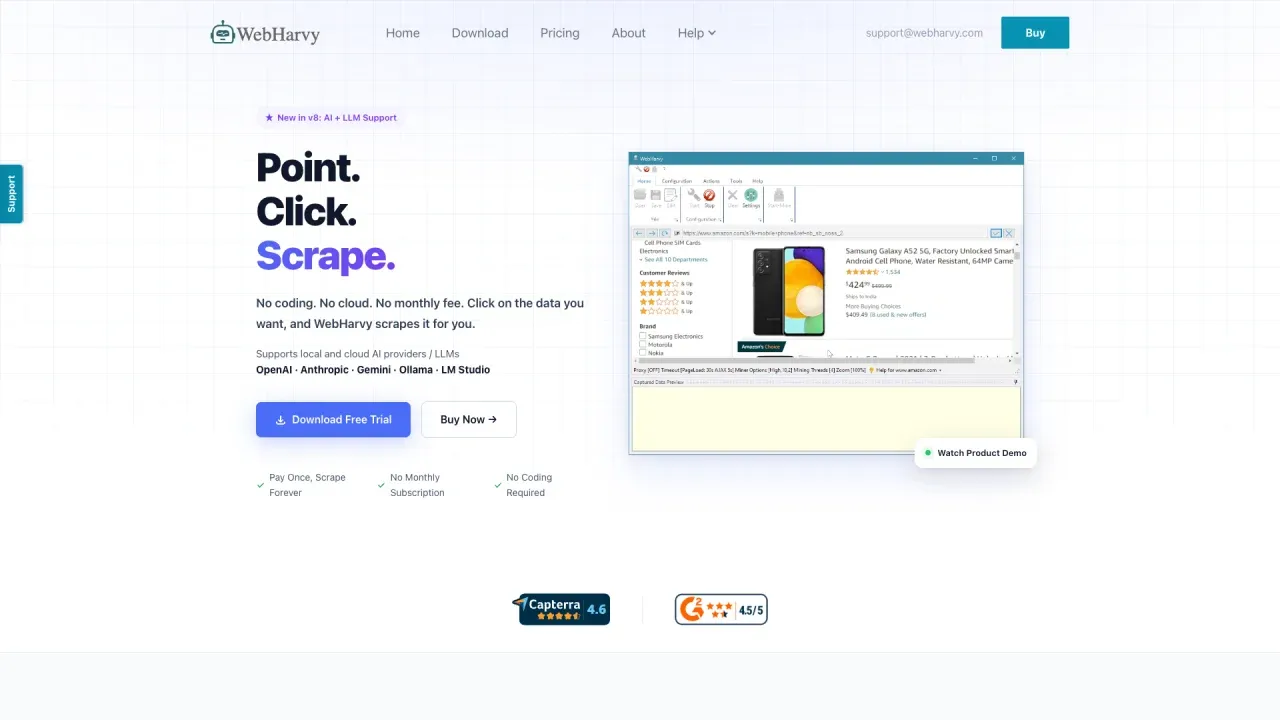
6. WebHarvy
WebHarvy är en Windows-baserad desktop-scraper med visuellt gränssnitt och mönsterdetektering. Den är användbar för användare som vill klicka ut exempel på en sida och låta verktyget hitta liknande objekt.
WebHarvy är som starkast för produktsidor, bildtunga sidor och desktop-lika arbetsflöden. Den är inte det mest moderna AI-native-alternativet, men den kan fortfarande fungera bra för användare som föredrar en engångslicens och lokal desktopmjukvara.
Fri åtkomst: WebHarvy är generellt positionerat med gratis provperiod och betald licens, inte en löpande gratisplan. Kontrollera nuvarande webbplats innan du beskriver det som ett gratisverktyg.
Bäst för: Windows-användare som skrapar produktlistor, bilder och repeterbara sidmönster.
7. Apify
Apify är en utvecklarvänlig molnplattform för webbscraping, webbläsarautomation och dataextraktion. Dess Actor-marknadsplats är den största dragkraften: i stället för att börja från ett tomt skript kan team använda eller anpassa befintliga actors för vanliga webbplatser och arbetsflöden.
Apify är ett av de starkaste alternativen när scraping behöver bli mjukvara. Plattformen stödjer API:er, schemaläggning, lagring, webhooks och utvecklararbetsflöden. AI kan också hjälpa här, men främst som assistent för att bygga, felsöka och validera actors snarare än som ett klickbart gränssnitt för affärsanvändare.
Fri åtkomst: Apify har en gratisplan/kreditmodell. Kontrollera aktuell Apify-prissättning och plattformsdokumentation innan du anger exakta beräkningsgränser.
Bäst för: utvecklare, automations-team och tekniska operatörer som vill ha molninfrastruktur för scraping.

8. Diffbot
Diffbot är en AI-dataplattform känd för att extrahera strukturerade entiteter från webbsidor och för att underhålla en stor kunskapsgraf. Den ligger närmare ett API och en dataintelligensplattform än en visuell scraper.
Diffbot kan vara mycket kraftfullt när uppgiften gäller entity-extraktion, artikel-/produktparsing, enrichment eller strukturerad förståelse av webben i stor skala. Det är vanligtvis inte första valet för en icke-teknisk användare som vill klicka på en sida och exportera till ett kalkylark.
Fri åtkomst: Diffbot har en gratisplan och modeller för utvecklaråtkomst; kontrollera aktuella Diffbot-priser för senaste kredit- och provvillkor.
Bäst för: tekniska team som behöver API-baserad strukturerad extraktion, kunskapsgrafdata eller entity intelligence.
9. Crawl4AI
Crawl4AI är en open source, LLM-vänlig webcrawler och scraper för utvecklare som bygger AI-agenter, RAG-pipelines och skräddarsydda dataflöden. Den kan producera ren Markdown, extrahera strukturerad JSON med CSS eller XPath, och använda en LLM för att skapa ett återanvändbart extraktionsschema när det passar jobbet.
Crawl4AI är ett starkt val när resultatet ska bli en del av ett utvecklingsarbetsflöde snarare än en engångsexport till kalkylark. Den stödjer webbläsarkontroll, asynkron crawling, sessioner och finmaskiga extraktionsalternativ, men kräver fortfarande Python och tekniskt ägarskap.
Fri åtkomst: Open source utan tvingande API-nyckel eller betalvägg för plattformen. LLM-baserad extraktion kan dock fortfarande kräva en LLM-leverantör eller en lokal modell.
Bäst för: utvecklare som bygger AI-redo crawlers, RAG-ingest eller repeterbara strukturerade datapipelines.
10. Scrapling
Scrapling är ett adaptivt Python-ramverk för scraping som spänner från enstaka requests till webbläsarstyrd hämtning och fulla crawls. Dess adaptiva parsing är utformad för att hjälpa till att hitta tillbaka till sid-element när en webbplats ändras, vilket kan minska bördan av att reparera selectors i ett kodägt scrapingprojekt.
Det är inte ett no-code AI-verktyg: team behöver fortfarande definiera extraktionslogiken, testa den och ansvara för körmiljön. Men det är en modern ersättare till ett äldre visuellt scrapingalternativ eftersom det är aktivt dokumenterat och bättre anpassat till dagens Python-baserade scrapingstackar.
Fri åtkomst: Open source. Infrastruktur, proxy-tjänster, webbläsarkörningar och utvecklingstid är fortfarande separata kostnader.
Bäst för: Python-utvecklare som vill ha adaptiv scraping och en väg från en enkel fetch till en samtidig crawl.
Jämförelsetabell: gratis AI-webbscrapingverktyg
| Verktyg | Typ | Fri väg | AI-native? | Bäst för |
|---|---|---|---|---|
| Thunderbit | AI Chrome-scraper | Gratis startanvändning | Ja | Affärsanvändare som behöver snabb strukturerad webdata |
| ParseHub | Visuell scraper | Begränsad gratisnivå | Delvis | Små visuella projekt |
| Octoparse | No-code scrapingplattform | Gratisplan/provperiod | Delvis till starkt | Avancerade användare och återkommande no-code-jobb |
| Scrapy | Python-ramverk | Open source | Nej, men AI-assisterad kodning fungerar | Utvecklare som bygger skräddarsydda scrapers |
| Data Miner | Webbläsartillägg | Begränsad gratisanvändning | Begränsad | Tabeller, listor, receptbaserad scraping |
| WebHarvy | Visuell Windows-scraper | Gratis provperiod | Begränsad | Produkt- och bildscraping på desktop |
| Apify | Molnplattform för automation | Gratis krediter/plan | Utvecklar-AI-nära | Tekniska scrapingpipelines |
| Diffbot | AI-extraktions-API | Gratis krediter/plan | Ja | Entity-extraktion och arbetsflöden med kunskapsgraf |
| Crawl4AI | Open source AI-redo crawler | Open source | Ja/LLM-vänlig | RAG, AI-agenter och utvecklarpipelines |
| Scrapling | Adaptivt Python-scrapingramverk | Open source | AI-nära/adaptivt | Kodägd scraping som behöver robusta selectors |
Hur du väljer rätt verktyg
Börja med källan och användaren, inte med varumärket.
Om datan finns på publika webbsidor och användaren är icke-teknisk, börja med Thunderbit, ParseHub, Octoparse eller Data Miner. De här verktygen ligger närmare det faktiska affärsarbetet: öppna källan, definiera fälten, kör ett test, granska raderna, exportera.
Om jobbet kräver egen logik, hantering av autentisering, orkestrering, API:er eller deployment, titta på Scrapy eller Apify. Det är här utvecklaransvar är rimligt. Använd AI för att snabba upp granskning av selectors och testgenerering, men behåll mänsklig kontroll över compliance, felhantering och datakvalitet.
Om företaget behöver API-baserad entity-extraktion, enrichment eller en strukturerad kunskapsgraf, utvärdera Diffbot och jämför dess provvillkor, datatäckning och API-passform mot dina krav. För bredare hanterade dataflöden bör du använda en särskild upphandlingsprocess i stället för att behandla dem som ett gratis scraper-val.
Om ett verktygs webbplats eller dokumentation ser föråldrad ut, använd det inte för känsligt arbete. Testa på en ofarlig publik sida, verifiera exporterna och kontrollera att produkten fortfarande underhålls.
Enkel valideringschecklista innan du exporterar
Innan du kör en stor scrape, testa ett litet urval:
- Representerar varje rad rätt entitet?
- Blandas sponsrade, duplicerade eller rekommenderade objekt in i datan?
- Stannade paginering eller oändlig scroll för tidigt?
- Tolkas priser, datum, e-postadresser och telefonnummer konsekvent?
- Matchas fält från undersidor till rätt huvudrad?
- Bevarar exportformatet det schema du behöver?
- Får du samla in och använda den här datan för ditt ändamål?
AI kan göra setup snabbare, men den kan också få fel extraktion att se snygg ut. En QA-genomgång på 20 rader är fortfarande ett av de billigaste sätten att undvika en dålig datamängd.
Slutlig rekommendation
För de flesta affärsanvändare är det bäst att börja med det snabbaste säkra arbetsflödet: använd en no-code AI-scraper, testa på ett litet urval, validera schemat och exportera sedan till det system där arbetet fortsätter.
Thunderbit är det starkaste valet när jobbet handlar om publika webdata och användaren vill ha ett praktiskt AI-assisterat arbetsflöde i webbläsaren. ParseHub, Octoparse och Data Miner är värda att testa om du föredrar visuella projektbyggare eller receptbaserad scraping. Scrapy, Crawl4AI, Scrapling och Apify passar bättre när scrapen behöver bli kod eller infrastruktur. Diffbot är ett specialistalternativ när entity-extraktion eller kunskapsgrafdata är viktigare än ett webbläsarbaserat arbetsflöde.
Det bästa verktyget är inte det med längst funktionslista. Det är det som ger dig tillförlitlig, strukturerad data med minst löpande underhåll för ditt team.
Vanliga frågor
Vad är en AI-webbscraper?
En AI-webbscraper använder maskininlärning, LLM:er, datorseende eller smart sidförståelse för att hjälpa till att identifiera fält, extrahera strukturerad data eller anpassa sig till röriga webbsidor. De bästa verktygen låter dig fortfarande granska och korrigera resultatet.
Är gratis AI-webbscrapers verkligen gratis?
Vissa har gratis startanvändning, vissa har gratis provperioder och vissa är open source. Gratis betyder inte alltid gratis i stor skala. Kontrollera sidgränser, kreditgränser, exportbegränsningar och om molnkörningar ingår.
Vilken gratis AI-webbscraper är bäst för icke-tekniska användare?
Thunderbit är den bästa startpunkten för icke-tekniska team som vill skrapa publika webbplatser till strukturerade tabeller. ParseHub, Octoparse och Data Miner är också användbara beroende på om du föredrar visuella projekt, mallar eller browser-recept.
När bör jag använda Scrapy eller Apify i stället för en no-code scraper?
Använd Scrapy eller Apify när du behöver egen logik, kontroll för utvecklare, API:er, schemaläggning, övervakning eller integration i ett större mjukvaruarbetsflöde. De är kraftfulla, men kräver mer ägarskap.
Kan AI-webbscrapers hantera paginering och undersidor?
Många moderna verktyg kan det, men du bör testa noggrant. Paginering, oändlig scroll och undersidor är vanliga ställen där scrapers stannar för tidigt eller kopplar detaljsidesdata till fel rad.
Är det lagligt att scrapa webbplatser?
Det beror på webbplatsen, datatypen, jurisdiktionen och användningsområdet. Gå igenom webbplatsens villkor, robots.txt, inloggningsbegränsningar, integritetskrav och interna compliance-krav innan du samlar in eller använder skrapad data.
Läs mer
- Hur du skrapar vilken webbplats som helst med AI
- Topp 5 bästa programvaror för webbdatascraping 2026
- 7 mest populära verktyg för webbscraping att använda 2026
- Topp 10 AI-webbscraperverktyg för att öka produktiviteten 2025
- Topp 8 bästa AI-webbscrapers för smartare dataextraktion
Testa AI-webbscraper Get Started Free




