
Sex bibliotek, ett annoterat fixtureset, en scorare. I dessa 22 syntetiska fixtures var biblioteket med högst boilerplate-läckage — Mozilla's Readability, på 23,5 % — också det enda som lyckades återställa varje märkt artikel-enhet.
Det är avvägningen i en enda mening, och de flesta texter om ämnet fångar aldrig upp den, eftersom de flesta bara mäter precision och slutar där.
Vad som faktiskt mättes
Varje fixture i det här setet har facit på enhetsnivå. Varje block på sidan — artikelstycken, navigering, annonser, sidofält, kommentarstråd, promo — är märkt som article eller boilerplate och får en unik sentinel-token. Så frågan ”tog extractorn med just den här enheten?” avgörs med exakt substring-matchning, inte med någon likhetsbedömning. En sentinel finns antingen kvar i outputen eller inte.
Tjugotvå fixtures, 91 enheter. Sex extractors: Mozilla Readability 0.6.0 (via jsdom 30.0.1), trafilatura 2.2.0, resiliparse 1.0.9, newspaper4k 0.9.6, goose3 3.1.22 och jusText 3.0.2. Python 3.14.2 och Node 22 kördes på samma maskin. Artikeln bevarar inte operativsystem/CPU, exakta anrop, antal repetitioner eller warm-up-policy, så tidskolumnen är en lokal observation snarare än ett portabelt benchmark.
Två regler satte jag upp för mig själv innan något kördes. Varje Python-bibliotek installerades i sitt eget tomma virtualenv, så att dess footprint bara är dess eget och inte något som följer med från ett syskonpaket. Och ingen runner räknar ut ett mått — alla dumpar rå extraherad text, och en enda scorer producerar varje siffra, så sex verktyg jämförs med identisk aritmetik i stället för sex snarlika definitioner av ”precision”.
Huvudtabellen
| Bibliotek | Artikelrecall (alla 22) | Boilerplate-läckage | Precision för innehållstoken | Svarade precision-fixtures | Förorenande tokens |
|---|---|---|---|---|---|
| Readability | 1.0000 | 0.2353 | 0.9109 | 11/11 | 35 |
| trafilatura | 0.9865 | 0.0588 | 0.9411 | 11/11 | 4 |
| newspaper4k | 0.9865 | 0.0000 | 0.9452 | 11/11 | 0 |
| resiliparse | 0.9054 | 0.0588 | 0.9381 | 11/11 | 7 |
| jusText | 0.8378 | 0.4706 | 0.8760 | 10/11 | 74 |
| goose3 | 0.8243 | 0.0000 | 1.0000 | 10/11 | 0 |
Recall är aggregerat över alla 22 fixtures. Läckagegrad, aggregerad precision för innehållstoken och kontaminering använder de 11 fixtures som innehåller både article- och boilerplate-enheter; ”svarade” visar hur många av dessa som gav output. Fulla siffror per fixture finns i sixway-scores.json.
En rad i tabellen är inte standard. resiliparse:s extract_plain_text har main_content=False som standard, och jag körde den med main_content=True. Skillnaden är inte liten: med standardinställningen läcker den 17 av 17 boilerplate-enheter i setet — varje nav, annons, sidofält, kommentarstråd och promo — mot 1 av 17 med flaggan på. Alla andra bibliotek ovan kördes med sina standardvärden. Så resiliparse:s läckagegrad på 0,0588 är vad det gör när du ber om main content, och extract_plain_text(html) i sig är en annan produkt (default-vs-main-content.json).
Läs första och andra kolumnen tillsammans, för om du bara läser en av dem väljer du fel verktyg.
Readability missar aldrig. Perfekt recall på alla 22 fixtures, och den är ensam om det. Det kostar: 4 av 17 boilerplate-enheter läckte igenom, 35 förorenande tokens, fyra gånger så högt läckage som trafilatura. Tre av de fyra läckorna har samma form — ett neutralt promo-block som ligger som syskon till artikeln och därför slukas av dess syskon-append-heuristik. Om du matar dess output till en modell betalar du för de tokenen, och modellen läser dem som artikel.
newspaper4k är den balanserade. Inget läckage, inga förorenande tokens, 0,9865 recall och output på alla 22 fixtures. Om jag tvingades välja en utan att känna till arbetslasten är det den här, och det är inte den de flesta spontant väljer.
goose3 har perfekt precision och sämst recall i testet. Varje innehållsord den returnerade var artikelinnehåll. Den lyckades också inte hämta något alls i två fixtures och gav ingen output i just de två. Perfekt precision är billigt om man får avstå.
Precisionstalet som smickrade två bibliotek
Den sista punkten är värd att göra konkret, för den är en fälla jag nästan publicerade.
Precision och F1 här är villkorade av att output faktiskt produceras. Ett bibliotek som returnerar en tom sträng på en fixture bidrar med varken täljare eller nämnare — att avstå är gratis, och en försiktig extractor ser därför bättre ut i precision än en mer heltäckande, bara för att den tiger.
goose3:s aggregerade precision var 1.0000 över de 10 scorade fixtures där den returnerade output. jusText:s var 0.8760 över 10 av 11. Readability, trafilatura, resiliparse och newspaper4k svarade på 11 av 11. Tabellen visar nu den nämnaren bredvid precision så att avståndstagande inte kan gömma sig bakom ett smickrande förhållande.
Det fanns en ännu sämre version av detta. Min första scorer tog medelrecall för artikelkvalitet över samma 11-fixture-set — alltså det set som utesluter fixtures utan boilerplate, vilket är korrekt när man mäter läckage. Den rapporterade resiliparse på 1.0000 recall. Över alla 22 fixtures ligger resiliparse på 0.9054, eftersom den på fixturen där artikeln bara finns i <li>-element och aldrig i någon <p> returnerar output men återställer 0 av 6 artikel-enheter. Den fixturen har ingen boilerplate, så den hamnade utanför medelvärdet, och ett riktigt fel dolde sig bakom ett perfekt resultat.
Var och en går sönder på sitt eget sätt
| Fixture | Vad den testar | Vem som återställer ingenting |
|---|---|---|
Artikel helt i <li>, ingen <p> | strukturella antaganden | resiliparse (0/6), goose3 (ingen output) |
| En artikel-enhet på 129 tecken | tröskel för kort innehåll | jusText |
| Tio korta stycken, inget långt | tröskel för kort innehåll | jusText |
| Nästan tomt dokument | den faktiska nollgränsen | goose3, jusText |
Var och en av dessa är ett specifikt, reproducerbart beteende snarare än ett generellt ”sämre på extraktion”:
- resiliparse och goose3 utgår båda från stycken. Pekar du dem mot en sida där brödtexten är en lista — en changelog, en specifikation, en FAQ, ett recept — så ger resiliparse tillbaka text utan listinnehållet, medan goose3 ger tillbaka ingenting. resiliparse är farligare av de två här, eftersom att få tillbaka något ser ut som framgång.
- jusText har en längdtröskel, och den är skarp. Mer om det nedan.
- Det nästan tomma dokumentet är det enda fallet där noll output faktiskt kan vara rätt, så det skulle jag inte hålla emot någon av biblioteken.
jusText: en avgrund, inte en ramp
jusText gav output i 19 av 22 fixtures och läckte 47 % av boilerplate — högst i testet, vilket är motsatsen till dess rykte. Men det intressanta talet är det som fick mig att köra om allt.
jusText klassificerar varje block utifrån stopword-densitet mot en språklista med stoppord, och gör sedan en kontextkänslig passering som uppgraderar ett neargood-block till good bara när det ligger intill ett befintligt good-block. Ett block blir good på egen hand bara om det ligger över length_high, som som standard är 200 tecken. I ett dokument där inget block passerar den linjen finns inget som kan initiera uppgraderingen, och hela sidan faller tillbaka till boilerplate.
Jag körde en sweep på ett dokument där det längsta stycket är 151 tecken:
length_high | Good-stycken | Tecken som returneras |
|---|---|---|
| 200 (standard) | 0 | 0 |
| 150 | 8 | 832 |
| 120 | 8 | 832 |
| 100 | 8 | 832 |
| 80 | 8 | 832 |
Noll till 832 tecken när exakt ett stycke passerar tröskeln, och sedan ändras inget mer hur mycket du än sänker den. Ett stycke över gränsen låser upp hela dokumentet.
Innan jag drog slutsatsen det här svepte jag length_low över fyra värden och max_link_density över två — åtta kombinationer, alla gav noll. Projektets regel är att ett negativt påstående om kapacitet kräver minst tre testade parameterformer eller leverantörens egen feltext som namnger fältet, och en enda oproduktiv parameter är inte en slutsats om biblioteket. Siffrorna finns i justext-length-threshold.json.
Detta säger inte att jusText extraherar dåligt. På en riktig naturlig språk-sida med standardinställningar gav det 1 190 tecken ren artikeltext. Det säger att jusText har en dokumenterad inställning som beter sig som en strömbrytare, och att standardläget för den brytaren är fel för dokument med korta stycken.
Vad du installerar, och vad importen kostar
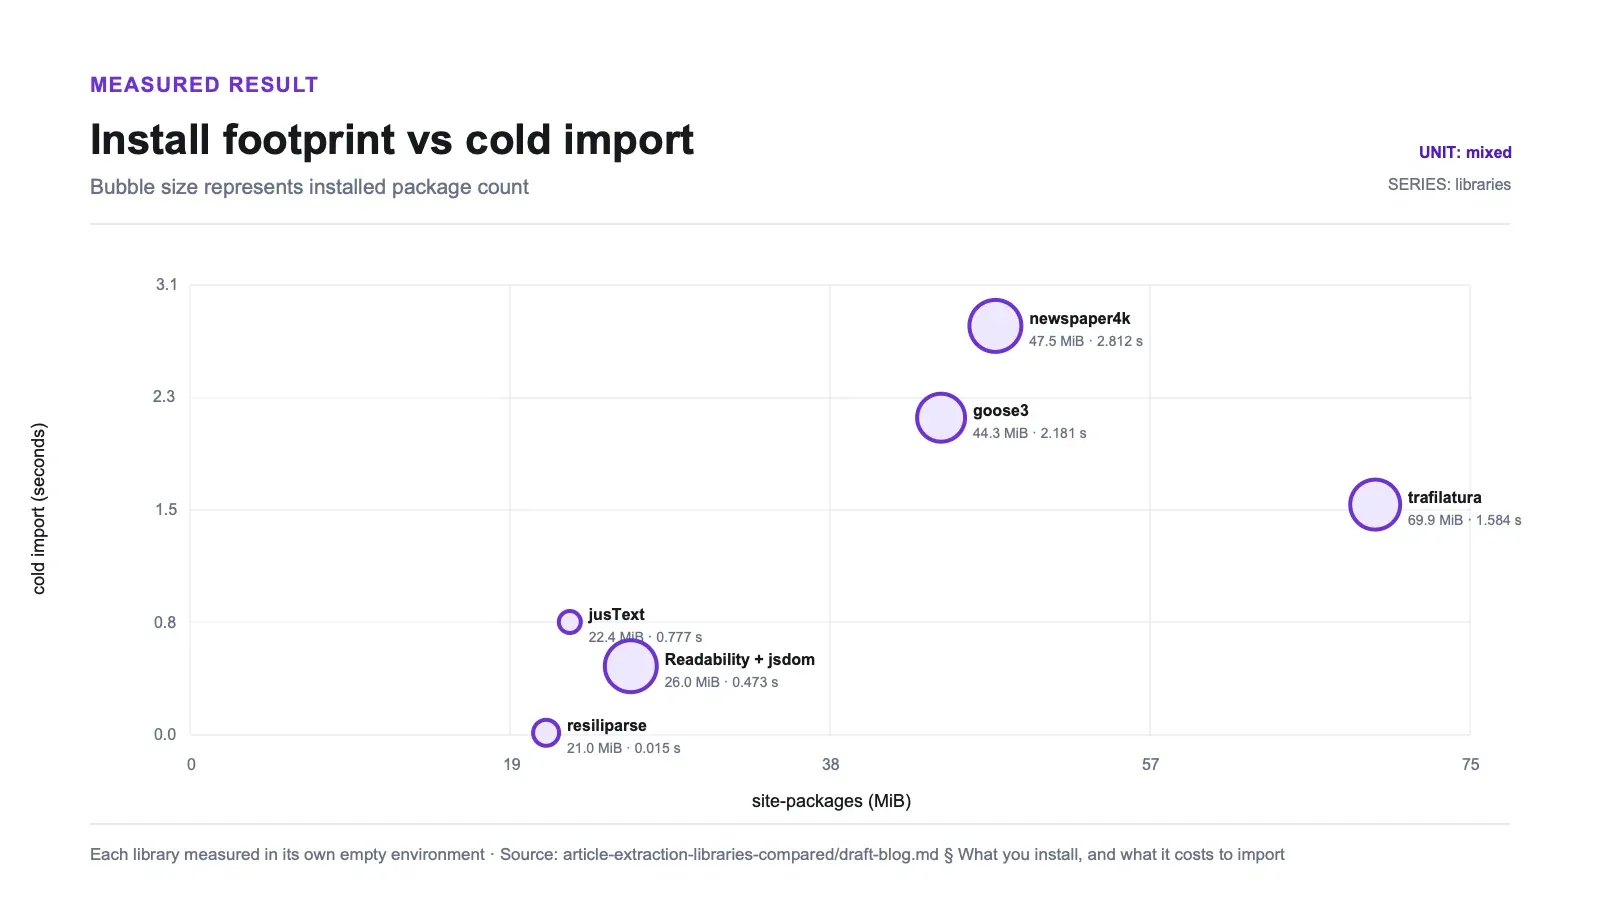
Samma fixtures, samma maskin, varje bibliotek i sitt eget tomma virtualenv.
| Bibliotek | Paket | site-packages | Cold import | Extraction p50 |
|---|---|---|---|---|
| resiliparse | 5 | 21.0 MiB | 0.015 s | 0.06 ms |
| jusText | 3 | 22.4 MiB | 0.777 s | 0.56 ms |
| goose3 | 16 | 44.3 MiB | 2.181 s | 1.85 ms |
| newspaper4k | 22 | 47.5 MiB | 2.812 s | 2.69 ms |
| trafilatura | 17 | 69.9 MiB | 1.584 s | 0.51 ms |
| Readability + jsdom | 32 (npm) | 26 MiB | 0.473 s | 6.37 ms |
I den här körningen hade resiliparse lägst värden för cold import och medianextraktion: 15 ms och 0,06 ms. Exakta förhållanden mellan olika runtime-miljöer skulle överdriva vad det här ofullständiga protokollet kan stödja, särskilt eftersom dess långsammaste enskilda extraktion var 1 098 ms. Separata distributionsmått för startup, första anrop och steady state behövs innan dessa siffror används för serverless-dimensionering.
trafilatura och resiliparse ligger i princip jämsides kvalitetsmässigt — 0,9697 mot 0,9681 i F1 för innehållstoken, identisk läckagegrad på 0,0588 — och jag utser ingen vinnare på en så liten skillnad. I footprint är de däremot inte alls nära: 21,0 MiB mot 69,9 MiB, 5 paket mot 17. Den faktiska avvägningen är resiliparse:s blindhet för listor mot trafilatura:s tre extra beroenden.
Två buggar i mitt eget testbädd, upptäckta innan publicering
Jämförelsen ovan var nära att aldrig bli av, och orsaken är viktigare än någon enskild rad i tabellen.
Fixturesetet kunde inte se två av de sex biblioteken. Det ursprungliga fixturesetet skrev varje enhet som en följd av unika nonsenstokens — zzart01vf64 zzart01v56i — vilket är exakt det som gör recall mätbar på enhetsnivå. Men det betyder också att fixturesen inte innehåller några engelska funktionsord alls. Readability, trafilatura och resiliparse avgör strukturellt, från DOM:en, så de påverkades inte. goose3 och jusText avgör lexikalt, genom att räkna stopwords, och det fanns inga att räkna: båda returnerade tom sträng på alla 22 fixtures.
En tabell med två bibliotek på noll hade sett auktoritativ ut och betydd ingenting. Jag kontrollerade innan jag skrev den, på en riktig sida: goose3 returnerade 1 017 tecken och jusText 1 190. Biblioteken var okej. Testbädden kunde inte representera dem.
Så fixturesen byggdes om med engelsk prosa som bar sentinels — samma struktur, samma klasser, samma DOM-positioner, samma enhetsgränser, samma sentinels, 1 568 tokens byttes ett mot ett. goose3 gick från 0 till 20 av 22.
Sedan gick ombyggnaden sönder på två sätt till, och båda var mina. Ett engelskt ord är ungefär sex tecken; zzart01vf64 är ungefär tolv. Att ersätta ett mot ett halverade varje enhet — 21 646 tecken enhetstext blev 10 986, och den längsta enheten föll från 1 513 till 622. Det skrev tyst om fixtures vars hela syfte är längd. jusText, vars beteende är en längdtröskel, gick från 19 av 22 till 6 av 22 enbart på grund av det. Hade jag publicerat den halverade versionen hade jusText:s siffra varit fel med en faktor tre, i riktningen som får det att se ut som ett sämre bibliotek.
Det andra: att dra varje enhet från en gemensam korpus återställde stopword-densiteten men förstörde den egenskap som token-nivåscoringen bygger på. Artikel- och boilerplate-vokabulär måste vara disjunkta, annars räknas ”extraherade tokens som är boilerplate-tokens” som ordet the. Tio av 22 fixtures fick överlappande vokabulärer, mot noll i originalen. Lösningen var att suffixa innehållsord per enhet och lämna funktionsorden orörda — riktiga stopwords för de lexikala biblioteken att räkna, disjunkt innehållsvokabulär för scorern.
Det är också därför token-nivåkolumnerna här heter content_token_* och inte återanvänder de publicerade Readability-versus-trafilatura-siffrorna. De mäter något annat, endast över innehållsord, och att citera det ena som det andra vore fel.
Under ombyggnaden dök en sak till upp som inte var min: tre link-density-fixtures placerar </a> mitt i ett ord — <a href="/x">zzsibp015qlhf zzsi</a>bp015qbht — eftersom länken placerades med teckenoffset för att träffa ett exakt förhållande. Den renderade texten är oförändrad, så den ursprungliga scoringen märkte inget, men varje extractor som arbetar per element snarare än per textfragment ser två delar där de andra ser ett ord. Fixat, och den länkade teckendeltan dokumenterad i stället för att tyst absorberas.
Vem ska använda vad
Matar du en modell och betalar per token? newspaper4k eller goose3. Båda läckte noll boilerplate-enheter och noll förorenande tokens. newspaper4k om du vill ha svar på varje sida; goose3 om du hellre vill ha tystnad än en gissning, och dina sidor har stycken.
Optimerar du en Python-väg där latency spelar roll? Ta med resiliparse i jämförelsen. Det hade lägst uppmätt import och medianextraktion här och låg nära trafilatura kvalitetsmässigt — men bara med main_content=True, vilket inte är standard. Kontrollera listtunga layouter först, och gör inte om de här lokala tiderna till ett exakt hastighetsförhållande mellan olika runtimes.
Arkivering, eller något där saknat innehåll är värre än extra innehåll? Readability. Det är det enda som återställde varje artikel-enhet i varje fixture, och 35 överflödiga tokens är ett billigt pris om alternativet är att förlora ett stycke.
Flerspråkigt arbete? jusText är en kandidat att ta med eftersom det levererar språklistor med stoppord. Den här studien testade inte flerspråkig extraktion, så den funktionen är en anledning att utvärdera det, inte bevis för att det vinner. Testa length_high mot representativa styckelängder.
Något som inte är en artikel? Ingen av dessa. De bygger alla på antagandet att en sida har en huvudtext i prosa, och en produktlista, en sökresultatsida eller en dashboard bryter det antagandet på sätt som inga parametrar kan laga.
Var en hanterad API passar in
Allt ovan är bibliotek du kör själv: du ger HTML och får text tillbaka. Deras observerade felmönster varierar med sidans form, så validera standardinställningarna mot din egen korpus. Strukturerad fältextraktion och fetch/rendering ligger utanför den här jämförelsen.
Författarnotering: Thunderbit är vår hanterade tjänst för arbetsflöden där URL:er matas in och strukturerad output levereras. Den kördes inte genom dessa fixtures, så ingen kvalitetsjämförelse antyds. Den relevanta gränsen är om du redan har HTML och vill ha en lokal textextractor, eller om du vill att fetching/rendering och drift ska hanteras som en tjänst.
Den ärliga ramen: om du redan har HTML och vill ha text är en av dessa sex gratis och bra, och den här tabellen visar vilken. Om du hämtar sidor i skala, eller vill ha rader i stället för prosa, är det ett annat köp.
Om du i stället väljer mellan hostade fetchers täcker vår översikt över web scraping-API:er det området och vår kostnadsjämförelse av SEO- och data-API:er vad de tar betalt. För den självhostade sidan är open-source scraper pillar den bredare bilden, och om det du faktiskt behöver är Markdown snarare än ren text är att konvertera HTML till Markdown i Python platsen där det mesta av förlusten sker.
Testa Thunderbit för extraktion av webbdata
Slutsats
Det finns ingen vinnare, och en tabell som utser en skulle ljuga om en verklig avvägning.
Bygg en liten acceptanskorpus innan du väljer: inkludera artiklar som bara består av listor, korta stycken, promo-syskon, en nästan tom sida och exempel där det är bättre att returnera ingenting än att förorena outputen. Poängsätt artikelåterställning, boilerplate-läckage och avstående separat. I dessa fixtures favoriserade Readability recall, newspaper4k gav den mest balanserade raden, och resiliparse var en latency-kandidat med en blind fläck för listinnehåll; de etiketterna ska inte användas utanför de testade sidformerna utan ny validering.
Det jag faktiskt skulle säga är snävare än så: kör fixtures mot dina egna sidformer innan du väljer. Två av de sex såg inte testbädden jag började med, och en av dem fick perfekt recall som dolde ett totalt misslyckande. En jämförelsetabell är en startpunkt för det, inte en ersättning.
Testa Thunderbit för extraktion av webbdata Get Started Free
Vanliga frågor
Är de här siffrorna jämförbara med publicerade benchmarks för dessa bibliotek? Nej, och jag skulle inte citera dem så. Det här är kontrollerade fixtures med syntetiska men märkta enheter, så alla sex såg identiska bytes och jämförelsen mellan dem är rättvis. Publicerade siffror som scrapinghub-benchmarken för artikelextraktion använder verkliga korpusar, vilket mäter något annat och svårare. Använd den här tabellen för att jämföra dessa sex med varandra, inte mot ett tal från en artikel eller ett paper.
Varför är Readability:s läckage så mycket högre än trafilatura:s om båda är DOM-baserade? För att de drar gränsen på olika sätt. Tre av Readability:s fyra läckor är neutralt klassade promo-block som ligger som syskon till artikeln, och dess sibling-append-heuristik drar in dem utifrån teorin att angränsande lång innehåll med låg länk-täthet sannolikt hör till berättelsen. Ofta stämmer det. I dessa fixtures är det en promo. trafilatura är strängare med vad den lägger till och läckte en av samma enheter.
Ska jag lita på precisionstalen för goose3 och jusText? Bara tillsammans med antalet exempel. Båda scorerades på 10 av de 11 fixtures som har både artikel- och boilerplate-enheter, eftersom de returnerade ingenting på en av dem, och en fixture utan output bidrar inte till någon sida av kvoten. goose3:s precision på 1.0000 är verklig för de sidor där den svarade; dess recall på 0.8243 över alla 22 fixtures är den andra halvan av samma faktum.
Spelar jusText:s längdtröskel någon roll på riktiga sidor?
Det beror helt på styckenas längd. En nyhetsartikel med 300 tecken långa stycken passerar length_high redan på det första och beter sig normalt — det är därför jusText gav 1 190 rena tecken på en riktig sida med standardinställningar. En sida med korta stycken, listobjekt eller produktteasers kanske aldrig passerar den gränsen, och då returnerar jusText en tom sträng i stället för ett delvis svar. Sätt den explicit i stället för att upptäcka det i produktion.
Vad testades inte här? Verkliga sidor, över huvud taget. Flerspråkig extraktion, trots att jusText:s stoppordslister är dess stora försäljningsargument. Minnesanvändning under belastning. Alla sidor som inte är artiklar — inga produktlistor, inga sökresultat, inga dashboards. Kodningsspecialfall. Och de två Node- och Python-ekosystemen jämfördes i biblioteksbeteende, inte i runtime-prestanda, så millisekundsiffrorna över den gränsen bör läsas som storleksordningar snarare än exakta förhållanden.




