
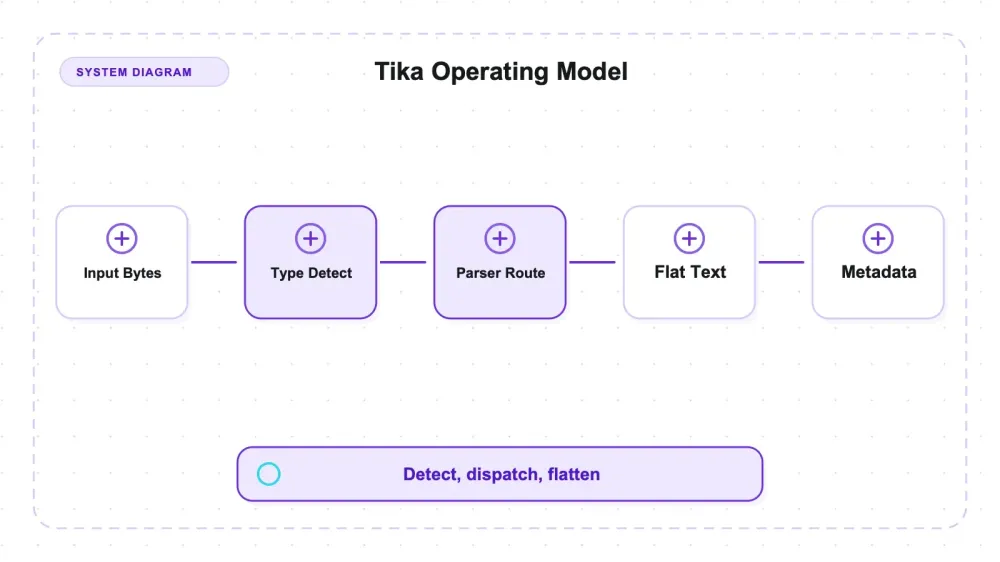
Apache Tika är Apache Software Foundations verktygslåda för dokumenttolkning: ge den i princip vilken fil som helst och få tillbaka ren text plus en normaliserad metadata-dictionary. I projektets README utlovas över tusen filtyper, och Tika når dit genom att paketera in specialbiblioteken själv — PDFBox för PDF-filer, Apache POI för Office-dokument, jsoup för HTML, en ODF-läsare för ODT — så allt levereras som en enda tung jar utan något som behöver hämtas vid analys. I en datapipeline är den den oansenliga första etappen: komponenten framför ett sökindex, en e-discovery-granskning eller en LLM-korpus som gör om en blandad hög filer till något enhetligt. Två uppgifter egentligen — lista ut vad en byte-stream är, och sedan plocka ut texten och metadatan ur den.
Det är det minst krävande verktyg jag satt upp på länge. En jar, java -jar tika-app-3.3.2.jar --text file.pdf, ingen konfigurationsfil, inga modellvikter, inget efterinstallationssteg, och det körde helt rent på en skarp JDK-version i framkant som samma eftermiddag fick annan Java-mjukvara att tvärstanna på samma värd. Katalogpåståendet var dock inte det jag ville testa; den testbara frågan är smalare. När inputen ljuger för dig, vad gör Tika egentligen? Så jag byggde en kontrollerad uppsättning testfiler där varje innehållsblock bär en unik markörtoken, renderade samma logiska dokument till nio olika bärare, och attackerade sedan allt med fel filändelser, saknade filändelser, inga filnamn alls, nollbytesfiler och halvskrivna binärer.
Det är i detektion som det intressanta beteendet finns. Jag bytte namn på en PDF till .txt och frågade Tika vad det var; den svarade application/pdf. Sedan tog jag bort filnamnet helt, matade in råbytes på stdin, och fick samma svar. Över de fem innehållsdetekterbara formaten i min uppsättning stämde det i alla 20 unika logiska tillstånd: tre filnamnstillstånd plus ett filnamnsfritt stream-tillstånd per format. Testharnessen körde stream-fallet tre gånger under olika etiketter och gav 30 lyckade råkörningar, men de upprepningarna är inte oberoende evidens. PDF och RTF exponerar igenkännbara bytes; DOCX exponerar sin container; HTML och XML kan identifieras via markup eller rotinnehåll. Olika mekanismer, samma användbara resultat i den här uppsättningen: filändelsen trumfade inte innehållet. Sedan finns textfamiljens regime, där Markdown faller till text/plain i samma ögonblick som filnamnet är fel eller saknas. Dess identitet vilade här helt på .md.
Två gränser för alla siffror som följer. Jag testade Apache Tika 3.3.2 — kontrollerat den 27 juli 2026, och det var fortfarande senaste stabila versionen; 4.0.0-grenen fanns då bara som alpha- och beta-byggen på Maven Central. Projektet låg på ungefär 3,9k GitHub-stjärnor när jag kollade den 27 juli 2026, och är licensierat under Apache-2.0, vilket är ungefär så kommersiellt okomplicerat en licens kan bli. Och jag testade inte OCR alls. Inte en enda skannad sida, inte en enda bildbaserad PDF. Tesseract och poppler finns inte installerade på maskinen jag körde detta på, så alla OCR-vägar var blockerade innan de ens hann börja. Det finns inga OCR-siffror här eftersom det inte finns några OCR-siffror, punkt slut.
Vad Tika är, när man slutar läsa marknadsföringen på kartongen
Den vanliga uppfattningen är att Apache Tika är en dokumentkonverterare — mata in en DOCX och få tillbaka snygg Markdown med rubriker och tabeller intakta. Det är inte det, och ju tidigare det blir tydligt, desto bättre ser verktyget ut.
Vägen som testades här har tre relevanta steg: en detektor för innehållstyp, en dispatch-komponent som skickar bytes till rätt parser, och CLI:ns --text-utmatning, som skriver ut platt text tillsammans med separat tillgänglig metadata. I det utdataavtalet finns inga Title-objekt, ingen ListItem och inget rekonstruerat tabellnät. Tika exponerar också andra handlare och API:er, inklusive XHTML/SAX-orienterad utmatning; dem testade jag inte. Alla slutsatser om struktur nedan gäller därför tika-app --text, inte ett påstående om att verktygslådan saknar strukturerad event-stream någonstans.
Det låter som en begränsning, och i en dimension är det det. Men det betyder också att Tika inte har något att feltolka, vilket är precis den avvägning som dess mer brusiga kusiner gör åt andra hållet.
Själva detektionen körs i en dokumenterad ordning: signaturbytes först, sedan inspektion av XML-rot, därefter filnamnets glob-mönster, och sist eventuell typ som du själv angav (Tikas egna detektionsdokument beskriver detta). Först när typen är löst skickar dispatchern bytes till den matchande inbyggda parsern — PDFBox, POI, jsoup, TextAndCSVParser för textfamiljen.
Den där uppdelningen mellan detektion och parsing är inte intern kuriosa. Det är därför en fil som är för trasig för att parsas ändå kan typbestämmas korrekt, vilket blir det mest praktiska tricket Tika erbjuder när saker börjar gå sönder.
Uppställning: en jar, ett kommando och en JVM som inte är kinkig
Installationen är en nedladdning. tika-app-3.3.2.jar från Maven Central är ungefär 67 MB — en tung jar med alla parsers inbyggda — och efter det är det java -jar tika-app-3.3.2.jar --text file.pdf. Ingen konfigurationsfil, inga modellvikter, inget efterinstallationssteg, ingen brew install-kedja att vandra igenom.
JDK-historien överraskade mig. Jag körde allt på OpenJDK 26.0.1, en icke-LTS-version i framkant, och --version, --text, --metadata och --detect gav alla exit 0 utan kompatibilitetsklagomål. Det är värt att nämna, eftersom jag körde Apache Nutch på samma värd vid samma tillfälle och dess crawl-cykel vägrade köra alls på JDK 26 — den kräver en LTS på 21 eller lägre, tack vare att SecurityManager tagits bort i nyare JDK:er. Tika brydde sig inte. Om du har undvikit JVM-verktyg på grund av just den sortens problem är det här inte där det biter dig.
Två ärliga slutsatser på uppställningssidan. CLI:n startar en ny JVM per körning, så kallstart är på riktigt — att köra 131 invokationer för mitt harness tog ungefär en minut, mest JVM-uppvärmning. Om du bearbetar filer i volym vill du ha biblioteksläget eller serverläget, inte en shell-loop runt jarn. Och berättelsen om att vara fri från beroenden har en hård kant: utvinning av PDF-textlager kräver inget externt, men OCR kräver tesseract och poppler. PDF-filer med textlager, DOCX, ODT, RTF, HTML, XML, TXT, Markdown och CSV parserades alla på en värd där inget av detta fanns installerat. Skannade dokument skulle inte ha gjort det, och jag låtsades inte något annat.
Kontrasten blir skarpare mot syskonbiblioteket jag testade samma dag, unstructured, vars väg för elektroniska PDF-filer blockerades helt eftersom import av dess PDF-modul drar in inferensstacken (torch med flera) vid laddning — innan strategidispatch, så till och med den "snabba" strategin går inte att importera utan den. Tika parserade samma PDF:s textlager med ett vanligt java -jar.
Testet med den ljugande filändelsen: MIME-typdetektion som struntar i vad du kallade filen
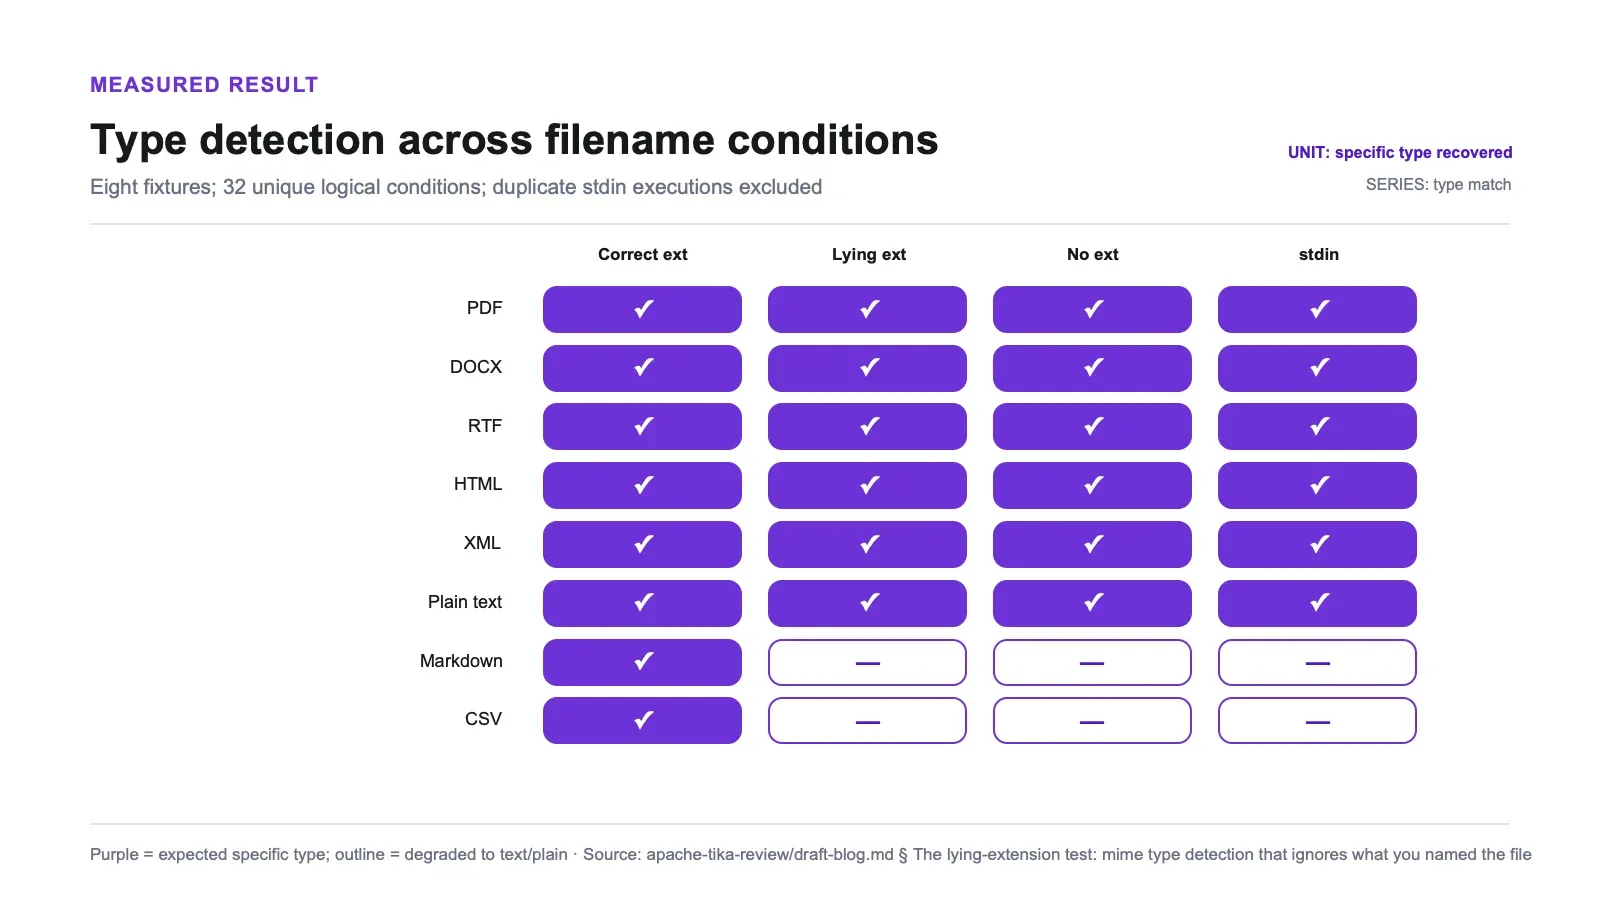
Åtta format, vart och ett presenterat med korrekt filändelse, en medvetet fel filändelse eller ingen filändelse, plus en filnamnsfri byte-stream på stdin. Det är 32 unika logiska tillstånd. Det ursprungliga harnessen körde dessutom samma stream-bytes en gång under varje filnamnsetikett, vilket gav 48 råkörningar; de tre stream-raderna kollapsar till ett tillstånd eftersom stdin saknar filnamn.
| Testfil | Sann typ | Ombytt till | Korrekt ext | Ljugande ext | Ingen ext | Rå stream, inget filnamn |
|---|---|---|---|---|---|---|
application/pdf | .txt | ✅ | ✅ | ✅ | ✅ | |
| DOCX | OOXML wordprocessingml | .jpg | ✅ | ✅ | ✅ | ✅ |
| RTF | application/rtf | .html | ✅ | ✅ | ✅ | ✅ |
| HTML | text/html | .csv | ✅ | ✅ | ✅ | ✅ |
| XML | application/xml | .txt | ✅ | ✅ | ✅ | ✅ |
| Ren text | text/plain | .pdf | ✅ | ✅ | ✅ | ✅ |
| Markdown | text/markdown | .pdf | ✅ | ❌ text/plain | ❌ text/plain | ❌ text/plain |
| CSV | text/csv | .txt | ✅ | ❌ text/plain | ❌ text/plain | ❌ text/plain |
(Stream-kolumnen slår ihop alla tre filändelsestillstånden, eftersom det utan filnamn inte finns något för globen att läsa.)
De fem innehållsdetekterbara formaten — PDF, DOCX, RTF, HTML och XML — träffade rätt typ i 20 av 20 unika tillstånd (och 30 av 30 råa harnesk-körningar, inklusive duplicerade stream-rundor). En PDF som kallades report.txt förblev en PDF. En DOCX som kallades photo.jpg förblev en DOCX. Ingen av dem behövde filnamn. Det betyder inte att alla fem använder fasta bytesignaturer: PDF och RTF har igenkännbara headers, DOCX är en ZIP-baserad container, och HTML/XML identifieras från markup eller rotinnehåll. Olika mekanismer, samma användbara resultat i dessa fixtures: den ljugande filändelsen vann inte.
Sedan textfamiljens regime. Markdown löstes som text/markdown bara när .md-ändelsen fanns där och gick att läsa. Byt namn på den, ta bort ändelsen eller skicka den som en stream, och den sjönk till text/plain i detta test. CSV betedde sig likadant i det här medvetet lilla rutnätet: text/csv kom bara från .csv-globen. Räknat som unika tillstånd identifierades Markdown och CSV var och en som sin specifika typ i ett av fyra tillstånd; ren text var redan text/plain, så det fanns inget för den att “falla ned” från. Det råa 48-körningsharnessen är fortfarande användbart som repetierbarhetslogg, men inte som en större nämnare.
En detalj talar till Tikas fördel här: den ljugande filändelsen vinner inte heller. Min Markdown-fixture som döptes om till .pdf kom tillbaka som text/plain, inte application/pdf. Tika trodde inte på lögnen; den kunde bara inte bekräfta sanningen. Att degradera till överordnad typ är ett mycket bättre misslyckande än att självsäkert hävda en felaktig typ, och att text/markdown är en dokumenterad undertyp till text/plain gör den fallbacken principfast snarare än godtycklig.
Det finns en brasklapp för just CSV. Tika har en statistisk CSV-detektor, och vid parsing — bekräftat av att TextAndCSVParser dök upp i X-TIKA:Parsed-By-kedjan — löstes mitt lilla rutnät på 2 kolumner och 3 rader som text/plain i stället för text/csv. Det är en enda observation på en medvetet minimal fixture. En större eller citerad CSV kan mycket väl trigga detektorn. Jag påstår inte att CSV-innehållsdetektionen är trasig; jag påstår att i det här rutnätet var det filändelsen som gav text/csv.
Varför detta spelar roll i en riktig uppladdningspipeline
Det konkreta scenariot är en uppladdningsrouter. Säg att du tar emot användaruppladdningar och dirigerar dem efter typ: PDF-filer till fakturaparsaren, kalkylblad till bokföringsimportören, allt annat till ett textindex. Om du litar på filändelsen kan någon som laddar upp en PDF med namnet notes.txt hamna i fel gren — och det är det snälla fallet; den fientliga versionen är en polyglot-fil med en vänlig filändelse.
För de binära och markup-baserade testfilerna här dirigerade Tika efter innehåll även efter att filnamnet försvunnit, vilket är användbart när ett blob-store eller en HTTP-body-handler har kastat bort det. Det resultatet täcker inte Tikas långa svans av tvetydiga filer eller polygloter. De testade textfamiljsfilerna betedde sig annorlunda: när pipelinen tog bort filnamnen kom Markdown och CSV in som text/plain, så regler kopplade till deras specifika mediatyper slutade triggas. Bevara det ursprungliga filnamnet som sidovagnsmetadata i stället för att förvänta dig att innehållsdetektionen ska rekonstruera det.
Det planterade innehållet överlevde. --text plattade ut strukturen.
Fidelitet är den andra axeln, och den delar sig tydligt i två. Jag renderade ett kanoniskt dokument (rubriker, två brödtextstycken, en punktlista, en numrerad lista, ett avslutande stycke) till HTML, Markdown, ren text, DOCX, PDF, RTF, ODT och XML, plus ett tabell-dokument till HTML, Markdown, text, DOCX, CSV och XML. Fjorton bärare. Varje block bär en unik token — zztitle1, zzitem3, zztblcell_beta och så vidare — så "överlevde" kontra "föll bort" är en exakt delsträngskontroll, inte en bedömning.
Återfinnandet av markörtoken blev 1.000 i alla fjorton renderingar. Inte en enda planterad token försvann: varje taggad tabellcell, listpunkt och rubrik fanns där. Tre lokala upprepningar per bärare efter uppvärmning gav identiskt byte-för-byte --text-resultat. Det här oraklet säger ingenting om otaggade tecken, ordning, whitespace, Unicode-normalisering, upprepat innehåll, länkar, sidhuvuden, fotnoter eller inbäddade objekt. Det är en kontroll av blocknärvaro, inte ett bevis på fullständig dokumentfidelitet.
Den platta textutmatningen ger upp det mesta av källstrukturens form.
Det här är HTML-tabell-dokumentet som kommer ut via --text:
	Tool	Throughput

	zztblcell_alpha	120

	zztblcell_beta	95
Rader förenade med tabbar. Rubrikraden markeras inte som rubrik. Det finns inget rutnät, inga cellgränser mer än en tabb, inget sätt att veta att det någonsin var en <table>. DOCX-tabellen plattas ut på samma sätt.
Listor är mer subtila, och de delas upp efter vad källan faktiskt innehöll:
| Vad punkten var i källan | Bärare | Vad --text returnerar |
|---|---|---|
Ett bokstavligt tecken — dessa renderingar skrev alla - som faktisk text | ren text, Markdown, RTF, ODT, PDF | - överlever, eftersom Tika bara förmedlar tecken |
Riktig struktur — en HTML <li>, en DOCX-stil List Bullet | HTML, DOCX | markören försvinner helt och du får bara själva item-texten: tabbintryckt i HTML, en vanlig oförsedd rad i DOCX |
Tika återrenderar aldrig en markör som den inte fick som text. Samma innehåll i båda fallen; olika utseende på utmatningen.
Markdown-fallet visar poängen tydligt. Mata Tika med en .md-fil med en pipe-tabell och piparna kommer tillbaka ordagrant, vilket ser ut som strukturbevarande. Det är det inte. Tika tolkade det som text och skickade tillbaka bytesen. Ingenting förstod den tabellen.
Det uppmätta avtalet är alltså smalare: alla planterade markörer överlevde, medan --text inte bevarade typade element eller ett rekonstruerbart tabellrutnät. Att kalla det ett parserfel skulle missa poängen. Platt extraktion undviker medvetet problemet med elementklassificering; den kan också omöjligen uppfylla ett downstream-system som behöver de elementtyperna. Om du behöver typade block eller rekonstruerade tabeller är --text en del av stacken, inte hela stacken. Andra Tika-handlare kan exponera mer struktur, men de låg utanför den här körningen.
Standardbrasklappen för alla fidelitetssiffror här: de kommer från kontrollerade syntetiska fixtures på en maskin, en version, en JDK. De visar att de taggade blocken fanns i utmatningen. De bevisar inte tecken-för-tecken-bevarande eller korrekthet på en stökig verklig korpus.
Metadata: normaliserad och förvånansvärt ovillig att hitta på
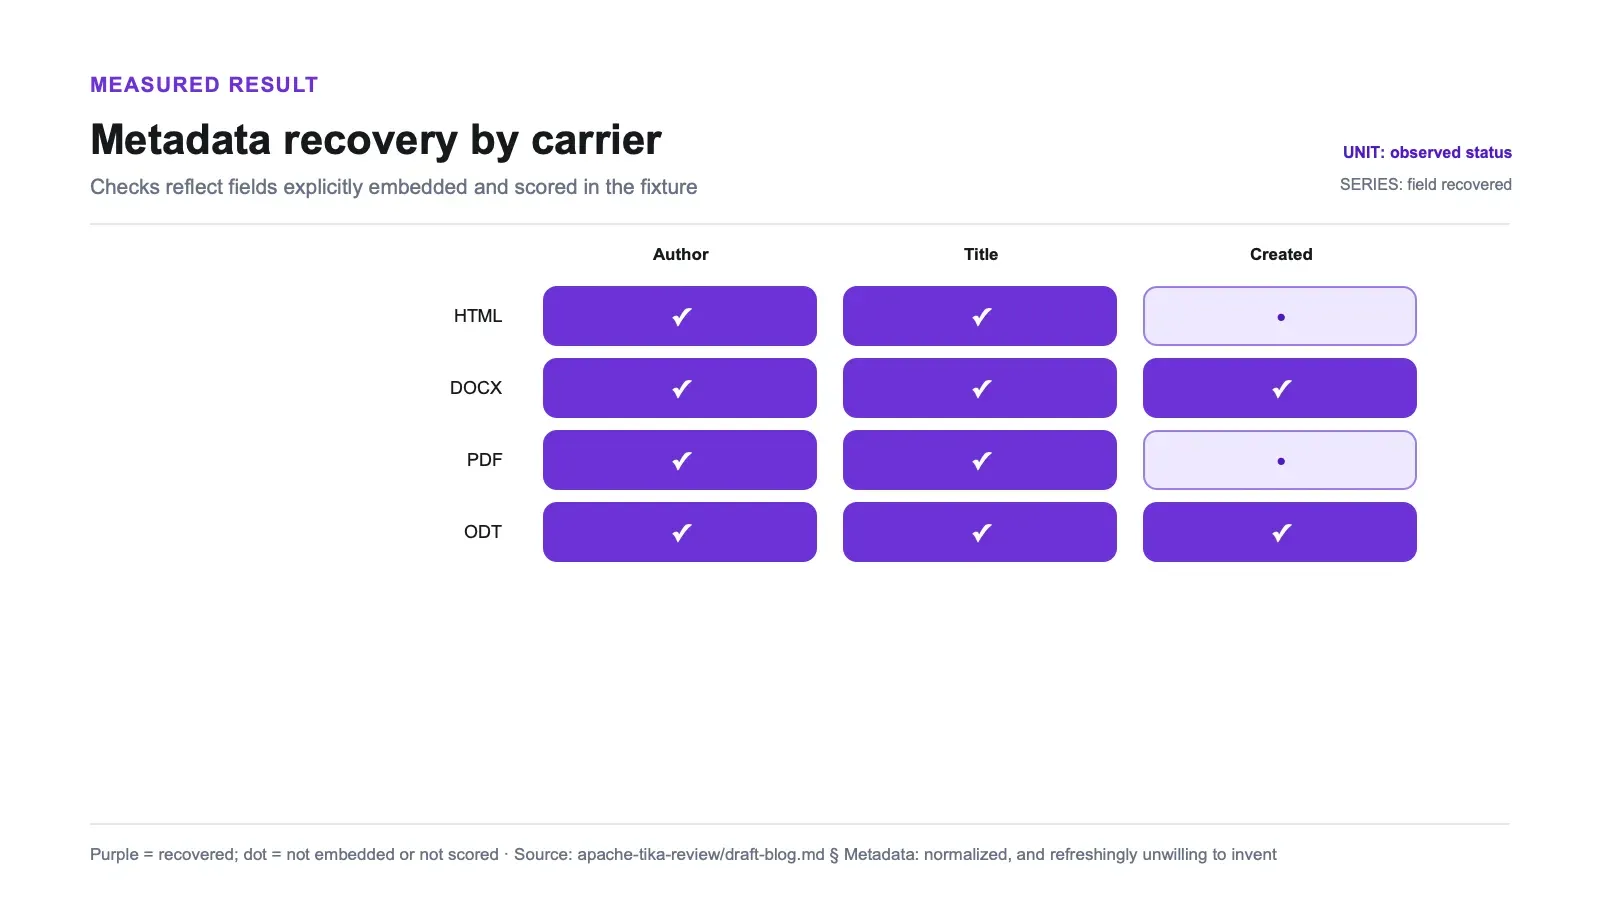
Jag bäddade in kända värden för författare, titel och skapelsedatum i alla bärare som har ett metadata-lager, och kontrollerade sedan vad som kom tillbaka.
| Bärare | author → dc:creator | title → dc:title | created → dcterms:created |
|---|---|---|---|
HTML (<meta name=author>, <title>) | ✅ | ✅ | inte inbäddat |
| DOCX (core properties) | ✅ | ✅ | ✅ exakt 2021-03-15T09:30:00Z |
| PDF (info dict) | ✅ | ✅ | finns, men det var generatorns egen tidsstämpel — inte poängsatt |
ODT (meta.xml) | ✅ | ✅ | ✅ exakt 2021-03-15T09:30:00Z |
| TXT / MD / CSV / RTF / XML | inget metadata-lager | — | — |
Författare och titel återfanns på 4 av 4 metadata-bärande format, och — det här är den delen som är värd att ha — de är normaliserade. Ett HTML <meta name="author">, en DOCX core property, en PDF /Author-post och ett ODT dc:creator-element hamnar alla under samma dc:creator-nyckel. Du skriver en konsument, inte fyra.
created är den ärliga skakningen. DOCX och ODT gav tillbaka min exakta inbäddade 2021-tidsstämpel. PDF:en gav ett skapelsedatum, men det var datumet som min generator-länk stämplade vid byggtid, inte värdet jag menade att bädda in — så jag poängsätter det som närvarande, inte återställt. Och formaten utan metadata-lager visade ingenting alls, vilket är det korrekta svaret. Tika gissar inte fram en författare ur brödtexten.
Att bryta den med flit, och triage-tricket som faller ut
Fyra fientliga inputs. En nollbytesfil. En giltig PDF-header med avhuggen kropp. En trunkerad DOCX-ZIP. Och en UTF-8-fil som innehåller flerbyte-tecken utan BOM och utan encodingsdeklaration. Det här är lokala fixture-former, inte Tika-trösklar.
Det underliggande harnessen, de genererade fixtures, rå JSON, jar-checksumma och miljömanifest är inte offentligt länkade här, så en extern läsare kan inte självständigt reproducera exakt samma nämnare. Betrakta tabellerna som rapporterade observationer snarare än tredje parts-verifierbar evidens.
| Input | --text / --json | Vad den kastade | --detect |
|---|---|---|---|
| 0-byte fil | exit 1, tom stdout | ZeroByteFileException: InputStream must have > 0 bytes | exit 0 → text/plain med filnamn, application/octet-stream från stream |
| Trunkerad PDF | exit 1, tom stdout | TikaException: TIKA-198: Illegal IOException from PDFParser | exit 0 → application/pdf |
| Trunkerad DOCX | exit 1, tom stdout | POI FATAL: "XML document structures must start and end within the same entity" | exit 0 → OOXML-typ |
| UTF-8, ingen BOM, ej deklarerad | exit 0 | inget | exit 0 → text/plain, charset UTF-8 |
Extraktion misslyckas högljutt, och de här felen har samma yttre form. Nollbytesfilen, den trunkerade PDF:en och den trunkerade DOCX:en gav var och en ett undantag, exit 1 och tom stdout. CLI:n sväljer inte felet till ett prydligt tomt resultat. Processt säkert i de här fallen — ingen hängning, ingen segfault — men anroparen måste kontrollera exit-status och stderr i stället för att bara titta efter en tom sträng.
Detektion är frikopplad från parsing. På båda de trunkerade binärerna returnerade --detect exit 0 med förväntad typ från det intakta ledande innehållet; parsern misslyckades sedan på den trasiga kroppen. En pipeline kan därför använda detektion som ett separat triage-signal före eller efter en misslyckad parsing. Om detect-first är ett bra standardval beror på driftsätt: det här testet benchmarkade inte detect-first mot parse-only, och två nya CLI-JVM:er kan vara fel avvägning i volym.
Teckenkodningsdetektion fungerar. Den UTF-8-fil som saknade BOM och deklaration avkodades som UTF-8 och 日本語テスト kom igenom intakt. En liten brasklapp för den som läser metadata-dictionaries: mina rena ASCII-fixtures rapporterar charset=ISO-8859-1, vilket är omöjligt att skilja från UTF-8 på ASCII-bytes. Det är inte ett misslyckande, det är oavgjort.
Tika bredvid unstructured: samma filtyper, olika jobb
Båda användes i samma forskningssession, men det här är en taxonomi över utdataavtal, inte ett symmetriskt benchmark. Verktygen poängsattes på olika resultat.
Relaterad genomgång: Unstructured review.
| Apache Tika | unstructured | |
|---|---|---|
| Vad jag mätte | innehållsfidelitet: försvann något? | elementklassificeringsfidelitet: fick varje block rätt typ? |
| Resultat | alla planterade markörer fanns kvar i fjorton renderingar | i det separata klassificeringstestet gav en ren-text-tabell Table-recall på 0.000, och en rubrik med ett verb klassificerades som narrativ text |
| Typade element som returneras | inga — ingen struktur kom tillbaka heller | Title, NarrativeText, ListItem, Table — exakt det Tika vägrar göra |
| OCR | blockerad på min värd, tesseract saknas | blockerad på min värd, tesseract saknas |
Platt, markörbevarande utmatning kontra typade element med observerade klassificeringsfel. Välj efter vad downstream-konsumenten behöver. Om det är ett sökindex eller ett LLM-kontekstfönster kan platt text räcka. Om det bygger på elementtyp kan Tikas --text-väg inte leverera det avtalet.
Ingen av oss har siffror för skannade dokument.
För- och nackdelar
Fördelar
- Innehållstypdetektionen struntade i ljugande filnamn i 20/20 unika tillstånd över de fem innehållsdetekterbara testfilerna; även duplicerade stream-körningar höll med.
- Varje planterad markör överlevde i alla 14 renderingar, inklusive de taggade tabellcellerna och listpunkterna.
- Reproducerbart i tre lokala omkörningar: varje bärare gav byte-identisk text inom den här miljön.
- Metadata normaliserades över format —
dc:creator/dc:title/dcterms:createdoavsett källformat, återställt på 4/4 metadata-bärande bärare. - Verkligt beroendefritt för de format jag testade: PDF textlager, DOCX, ODT, RTF och HTML parseras från en enda jar utan externa binärer.
- Kör rent på OpenJDK 26 — inget LTS-only-krav.
- Detektionen förblir korrekt (exit 0) på trunkerade binärer, vilket ger dig en pålitlig triagesignal när parsing misslyckas.
- Apache-2.0, moget, aktivt underhållet.
Nackdelar
- Markdown- och CSV-identitet beror helt på filändelsen; 10 av 18 signaturfria celler sjönk till
text/plainnär filnamnet saknades eller var fel. --textreturnerar inte elementtyper; tabellnät plattas ut till rader med tabbar och strukturella listmarkörer försvinner.- Extraktion kastar okontrollerat på tomma och korrupta inputs; de två fallen ser identiska ut från extraktionsanropet ensamt.
- 67 MB jar plus en per-invokation-JVM-kallstart i CLI-läge.
- OCR och skannade bild-PDF:er är helt otestade här — tesseract och poppler saknades, så inget påstående görs om den vägen.
- Varje siffra här är syntetisk ground truth på en maskin, en version. Noggrannhet på verklig korpus, krypterade filer, inbäddade/rekursiva dokument och genomströmning i skala mättes inte.
Vem bör köra det, och vem bör inte
Tika passar när din input är filer du redan har och ditt outputbehov är text plus metadata som en maskin kan indexera. Sökindexering, e-discovery, arkivbearbetning, mata en korpus till en LLM, bygga innehållstypvalideringen i en uppladdningspipeline. Det är användbart som första triage- och normaliseringssteg framför något smartare: detektera de testade typerna, extrahera platt text och skicka vidare med explicita kontroller för det innehåll din pipeline inte har råd att förlora.
Hoppa över det — eller snarare, nöj dig inte med --text — om du behöver typade element, rekonstruerade tabeller eller dokumentlayout. Hoppa över det om dina dokument är skanningar, åtminstone tills du har installerat tesseract och kört egna siffror, eftersom jag inte har några. För volymarbete bör du benchmarka biblioteksläget eller serverläget mot CLI:n på representativa dokument. Processstart var tydlig i det här småfilsharnessen, men genomströmning och resurskostnad mättes inte.
Det som brukar överraska folk: om ditt lagringslager tar bort filnamn och du hanterar Markdown eller CSV, lita inte på att Tika skiljer dem från ren text. Behåll det ursprungliga namnet.
Alternativ, och var Thunderbit passar in
Först en rättvis inramning, eftersom den ärliga jämförelsen här handlar om input, inte kvalitet. Tika är ett gratis, Apache-2.0-licensierat, självhostat verktyg för att tolka filer. Filer du har på disk eller i en bucket. Det hämtar inte sidor, kör inte JavaScript, hanterar inte anti-bot och låtsas inte göra det.
Det är gränsen där en hanterad web-extraktionstjänst, inklusive vår egen Thunderbit, kan komma in i arkitekturen: den hämtar live-sidor, medan Tika tolkar filer du redan har i din ägo. Den här artikeln benchmarkade inte de tjänsterna mot Tika, och de är inte substitut för samma input.
Den rena uppdelningen: Tika för dokument du redan har, ett hanterat extraktions-API för webbsidor du behöver hämta. Många pipelines kör båda — crawl och extraktion på webbsidan, Tika på PDF- och DOCX-bilagorna som kommer tillbaka.
Om du jämför över det bredare open source-fältet har jag skrivit den fulla jämförelsen av open source-scrapers, en genomgång av de mest användbara scraping-projekten på GitHub, en praktisk Crawl4AI-recension som går igenom den webbläsarbaserade Markdown-metoden, och en bredare sammanställning av scrapingverktyg. För den no-code-vägen finns också en genomgång av hur man skrapar en webbplats med AI.
Testa Thunderbit för webbdataextraktion
Slutsats
Bör du använda Apache Tika? Ja, om ditt jobb är att göra om heterogena filer till platt text och normaliserad metadata, och du validerar de fält eller markörer som din egen pipeline inte har råd att förlora.
Detektorn var den starkaste delen av den här körningen. Den gav förväntad typ i 20 av 20 unika tillstånd för de fem innehållsdetekterbara testfilerna, inklusive streamar utan filnamn. Varje planterad markör överlevde över fjorton renderingar, och utmatningen upprepades byte-för-byte i tre lokala omkörningar. Användbar evidens. Fortfarande syntetisk evidens. Att göra det från en enda jar på den här JDK:n, utan externa binärer för de icke-OCR-vägar som testades, gjorde driftsättningen behagligt odramatisk.
Storlekssätt det rätt, dock. Varje tabell du matar in kommer tillbaka som rader förenade med tabbar. Varje strukturell listmarkör försvinner. Markdown och CSV tappar sin identitet i samma ögonblick som filnamnet gör det. Tomma filer och korrupta filer kastar samma typ av fel, och du behöver det separata detect-anropet för att skilja dem åt. Och på OCR, den fråga många Tika-användare bryr sig mest om, har jag inget att erbjuda: jag kunde inte köra det, och jag tänker inte gissa.
Inom de ramarna gör Tika ett oansenligt jobb med ovanligt hög tillförlitlighet. Den läser bytes, inte etiketten på kartongen. Fråga den bara inte vilken form bytesen hade.
Testa Thunderbit för webbdataextraktion Get Started Free
FAQ
Detekterar Apache Tika filtyper korrekt om filändelsen är fel?
För de fem innehållsdetekterbara testfilerna här: ja. PDF, DOCX, RTF, HTML och XML löstes till sin förväntade mediatyp i alla 20 unika logiska tillstånd (30 råkörningar med duplicerade stream-exekveringar), inklusive vilseledande filändelser, ingen filändelse och streamar utan filnamn. En PDF som hette .txt detekterades fortfarande som application/pdf. Markdown och den lilla CSV-testfilen var beroende av filnamnsinformation och degraderade till text/plain när den saknades eller var fel.
Bevarar Tika tabeller och dokumentstruktur?
Inte i det --text-läge som testades här. Tabellrutnät kom tillbaka som rader förenade med tabbar utan cell- eller rubriksemantik, och strukturella listmarkörer (ett HTML <li>, en DOCX-stil List Bullet) försvann. Varje planterad markör överlevde i alla 14 renderingar, men det bevisar inte fullständig innehållsfidelitet, och --text ger ingen elementtypning. För typade element eller rekonstruerade tabeller, testa en annan Tika-utmatningshanterare eller använd ett annat verktyg bredvid det.
Kan Apache Tika göra OCR på skannade PDF-filer? Tika stöder OCR via Tesseract, men jag testade det inte, och inget i resultaten här är ett påstående om det. Tesseract och poppler saknades på min testvärd, så alla OCR- och skannade bildvägar blockerades innan de kördes. Det finns inga OCR-siffror någonstans i den här testningen. Om OCR är ditt use case, installera tesseract och benchmarka själv — behandla den delen av Tika som verifierad först när du gjort det.
Vad gör Tika med tomma eller korrupta filer?
Den misslyckas högljutt i stället för tyst. En 0-byte-fil kastar ZeroByteFileException; en trunkerad PDF kastar en TikaException från PDFParser; en trunkerad DOCX kastar ett POI XML-fel. Alla tre ger exit 1 med tom stdout, så tom och korrupt är omöjliga att skilja åt via extraktionsanropet ensamt. Detektion förblir däremot robust — --detect returnerade exit 0 med rätt typ på båda trunkerade binärerna, vilket gör det till ett pålitligt triage-steg innan du lägger tid på parsing.
Vad täckte Tika-testningen inte? Fyra saker, uttryckligen. OCR och skannade bilder (blockerade, otestade). Noggrannhet på verklig korpus — alla resultat är kontrollerade syntetiska fixtures med planterade markörtokens, vilket mäter fidelitet mot kända etiketter snarare än korrekthet på stökiga verkliga dokument. Resurskostnad, genomströmning och toppminne, som jag inte mätte. Och den långa svansen i påståendet om "tusen filtyper": jag testade nio representativa, beroendefria format, inte hela katalogen. Allt här är Tika 3.3.2 på OpenJDK 26.0.1, macOS arm64, en enda maskin.




