
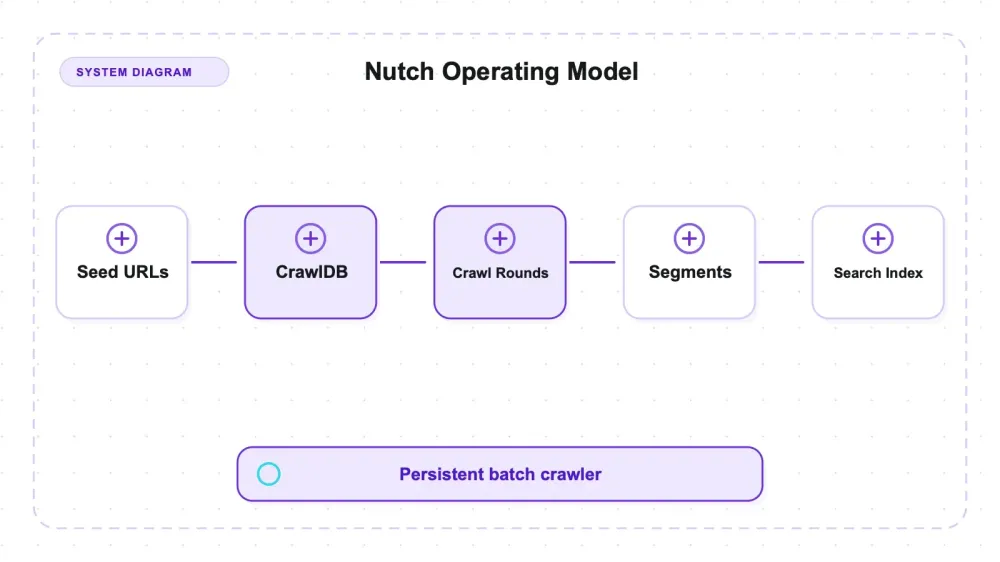
Apache Nutch är en crawler från Apache Software Foundation vars utveckling drog i gång 2004. Det är ett JVM-baserat system byggt på Hadoop, upplagt som en loop snarare än ett enda strömningskommando: seed-URL:er injectas i en beständig databas, följt av rundor av generate → fetch → parse → updatedb, med plugin-platser för protokoll, parser, URL-filter och scoring. Det vanliga resultatet skickas vidare till ett sökindex som Solr eller Elasticsearch, inte till en CSV.
Jag körde Nutch 1.22 mot en kontrollerad lokal testsite — en som loggar varje begäran på serversidan, så resultaten bedöms utifrån vad servern faktiskt såg, inte vad crawlaren själv påstod. Fyra gränser styrde körningen: JDK-versionen, http.agent.name, crawlens scope och om parse-js fanns med i plugin.includes. Hela cykeln kördes om och om igen med den testade konfigurationen; ändra JDK eller lämna agent-identiteten tom och den stannar innan den hämtar användbara sidor.
JDK-gränsen dyker upp innan någon crawl ens kommer i gång. Nutch 1.22 startade inte här på JDK 26.0.1: det första Hadoop-jobbet dog i Subject.getSubject() efter att Java tog bort SecurityManager-vägen. Nutch levererar Hadoop 3.4.2, medan fixen landade i Hadoop 3.4.3 sju dagar efter att Nutch 1.22 släpptes. Separat gjorde parse-js att återhämtningen av två JavaScript-fil-literals gick från 0/2 till 2/2 utan att någon webbläsare kördes.
Vad Nutch är till för, och vad det inte är
Nutch är inte en scraper. Strukturerad extraktion av fält är inte dess uppgift: den hittar och hämtar URL:er i stor skala, håller en beständig databas över dessa URL:er och deras status (crawldb), och skickar sedan segment vidare till något annat som får göra om det till ett index. Pekar du den mot en katalog och väntar dig en tabell med namn och priser får du i stället en crawldb.
Den arkitekturen förklarar det mesta som följer. Nutch kom nästan två decennier före eran med crawler i en enda binärfil, och den är byggd för det problem Hadoop byggdes för: att crawla fler sidor än vad som ryms på en maskin. Att köra den på en laptop mot ett test med 12 sidor är som att hyra ett godståg för att flytta en bokhylla — bra som illustration av tåget, men knappast rättvist om du vill prata cykelergonomi.
Den aktuella versionen är 1.22, annonserad den 17 februari 2026. Den är Apache-2.0, repot låg på 3 272 stjärnor med 8 öppna ärenden när jag kollade den 27 juli 2026, och master hade pushats så sent som fyra dagar tidigare. Det här är ett projekt som underhålls, inte ett övergivet sådant — vilket är precis rätt sätt att läsa JDK-problemet: ett paketfönster som stängdes en vecka för tidigt, inte slarv.
Versionsmatrisen: JDK 24+, Hadoop 3.4.2 och en två-raders fix
Blockeraren är ett trevägsversionsproblem, och den enda delen du faktiskt styr själv är vilken JDK Nutch körs på. Det allra första Hadoop-jobbet, på värdens standard-JDK, dog vid initiering:
java.lang.UnsupportedOperationException: getSubject is not supported
    at java.base/javax.security.auth.Subject.getSubject(Subject.java:277)
    at org.apache.hadoop.security.UserGroupInformation.getCurrentUser(UserGroupInformation.java:588)
    at org.apache.nutch.crawl.Injector.inject(Injector.java:473)
Returkod 255. Noll sidor hämtade. bin/nutch inject når alltså inte ens nätverket — det initierar en Hadoop LocalJobRunner, som frågar vem den aktuella användaren är, vilket kallar Subject.getSubject(), som JEP 486 gjorde till ett ovillkorligt undantag när JDK 24 permanent tog bort SecurityManager. Min värd körde OpenJDK 26.0.1, alltså långt förbi den gränsen.
Den gamla nödlösningen hjälper inte heller. Att lägga till -Djava.security.manager=allow, flaggan som tidigare återaktiverade det gamla beteendet, avvisas av VM:n innan Nutchs kod ens laddas:
Error occurred during initialization of VM
java.lang.Error: A command line option has attempted to allow or enable the Security
Manager. Enabling a Security Manager is not supported.
Det är returkod 1, och en återvändsgränd med avsikt — flaggan försvann tillsammans med funktionen.
Grundorsaken finns i Hadoop-versionen som följer med Nutch 1.22. Problemet med getSubject spåras som HADOOP-19212 och är fixat i Hadoop 3.4.3 och 3.5.0; Nutch 1.22 levereras med hadoop-common-3.4.2. Nutch 1.22 släpptes den 17 februari 2026, och Hadoop 3.4.3 följde ungefär en vecka senare.
Det är heller inte ett beroendeproblem med Solr eller ett Hadoop-kluster. Det finns en vanlig uppfattning att Nutch behöver ett Hadoop-kluster och en körande Solr för att göra något alls. Det stämmer inte. I lokalt läge kör Hadoop sin in-process LocalJobRunner — ingen HDFS-daemon, ingen YARN, inget kluster. Hela cykeln inject → generate → fetch → parse → updatedb körs på en enda maskin utan att något annat behöver vara installerat. JDK-väggen är helt enkelt en versionsfråga i ett inbyggt bibliotek, och den stoppar dig innan någon av de infrastrukturella frågorna ens blir aktuella.
Den praktiska versionsmatrisen, alla tre raderna uppmätta:
| Använd JDK | Kommando | Resultat |
|---|---|---|
| OpenJDK 26.0.1 | bin/nutch inject | Misslyckas, rc=255 — UnsupportedOperationException: getSubject is not supported |
| OpenJDK 26.0.1 | bin/nutch inject + -Djava.security.manager=allow | Misslyckas, rc=1 — VM:n vägrar starta |
| OpenJDK 17.0.20 (LTS) | bin/nutch inject | Fungerar, rc=0 — Total new urls injected: 1 |
Lösningen är två kommandon. Installera en LTS-JDK och peka Nutch mot den:
brew install openjdk@17
export NUTCH_JAVA_HOME=/opt/homebrew/opt/openjdk@17
Keg-only, så det ändrar inte systemets standard-JDK. Nutchs egen CI riktar in sig på Java 17, och projektet har offentligt meddelat att 1.22 är den sista versionen som körs på Java 11 och att 1.23 kommer kräva Java 17. Så en LTS-JDK är inte en workaround — det är den stödda konfigurationen. Mismatchen ligger mellan vad Nutch stöder och vad brew install openjdk ger dig 2026, och det är två olika frågor som råkar krocka i det allra första kommandot.
Allt härifrån och framåt kördes på OpenJDK 17.0.20, där hela cykeln är ren.
Uppställningen, mätt: 396 MB och en egenskap som stoppar allt
"Tung" är det ord alla tar till, men det säger ingenting utan en våg. Så här ser faktiskt den uppackade binärdistributionen av Nutch 1.22 ut:
| Objekt | Nutch 1.22 binärdistribution |
|---|---|
| Uppackad storlek | ≈396 MB |
JAR-filer i lib/ | 188 (≈113 MB) |
| — varav den medföljande Hadoop-stacken | 13 |
| Plugin-kataloger | 78 |
| JAR-filer i dessa plugin-kataloger | 533 |
| Konfigurationsfiler | 35 |
Skript i bin/ | 2 — crawl och nutch |
Som jämförelse levereras en modern Go-crawler som katana som en enda binär på ungefär 50 MB, utan JVM och utan externa JAR:er.
Sedan finns den där spärren ingen varnar dig för. Den medföljande nutch-site.xml är tom, och http.agent.name har som standard en tom sträng. Utan att den sätts hämtade min första crawl inga paths och loggade:
ERROR Fetcher: No agents listed in 'http.agent.name' property.
Att sätta just den egenskapen — inget annat — fick den att börja hämta igen. Med egenskapen tom avslutades kommandot utan att några sidor hämtades, och loggen visade agent-namn-felet ovan; den var alltså inte tyst.
Minimalt fungerande konfiguration visade sig bestå av tre artefakter: conf/nutch-site.xml (agentnamn, plugin-set, scope), conf/regex-urlfilter.txt (host-scope) och en seed-URL-fil. Det är inte särskilt många. Bara tre fler filer än crawler run <url>.
Vad den hittade: plugin-växeln som spelar roll
Testsite hade tre medvetet olika typer av endpoints, och Nutchs beteende delade upp sig tydligt mellan dem:
- Klass A — vanliga HTML-länkar (4 sidor, plus en kedja på 3 länkar djup)
- Klass B — endpoints som bara finns som strängliterals i en länkad JavaScript-fil: en som ett funktionsargument,
fetch('/api/js-endpoint-7'), en som tilldelning,const other = "/api/js-endpoint-8" - Klass C — en endpoint som bara finns efter att JavaScript körs och injicerar den i DOM:en
Resultat, från server-side hitlogs, upprepade tre gånger:
| Plugin-konfiguration | Klass A (HTML-länkar) | Klass B (JS-fil-literals) | Klass C (runtime DOM) |
|---|---|---|---|
Medföljande standard — parse-(html|tika) | 4/4 (recall 1.0) | 0/2 (recall 0.0) | inte nådd |
Med parse-js — parse-(html|tika|js) | 4/4 (recall 1.0) | 2/2 (recall 1.0) | inte nådd |
Identiskt i alla tre upprepningar. Deterministiskt.
Det som ofta underskattas är hoppet i klass B. Nutch hittade båda JavaScript-inbäddade endpoints utan att köra någon webbläsare, med hjälp av parse-js-pluginets regex-baserade genomsökning av JavaScript-innehåll. Själva app.js-filen hämtades i båda konfigurationerna — Nutch behandlar <script src> som en outlink oavsett — så hela skillnaden ligger i om någon läser filens innehåll efter URL-liknande strängar. Slå på pluginet och det fångar båda literal-formerna.
I detta test nådde Nutchs standardläge och katanas standardläge samma klass-A-set, medan Nutch med parse-js och katana med -jc nådde klasserna A och B utan webbläsare. Katana-versionen och hela kommandot finns inte med i artikeln, så det resultatet är kontext snarare än en strikt produktbenchmark.
Klass C är den ärliga gränsen. Ingen statisk plugin-konfiguration nådde dit, vilket är väntat: att återställa en endpoint som bara existerar efter skriptkörning kräver att skriptet faktiskt körs. Jag testade att byta ut protocol-http mot protocol-htmlunit, Nutchs rena Java-protokoll som kör JavaScript. Det laddade och körde utan att krascha, men i samma fyrarundiga harness avslutade det bara en runda, hämtade bara seed-sidan och app.js, nådde ingen av A/B/C, och runda två rapporterade 0 records selected for fetching. Det är en underkonfigurerad avstickare, inte en dom över HtmlUnits kapacitet. Det som etableras är smalare: att byta in ett JS-körande protokoll är inte en drop-in-ändring, och klass C förblev onådd i varje konfiguration jag testade.
Crawl-kontroll och felbeteende
Djup är ingen flagga. Det finns inget --depth 3 i Nutch; djup är så många generate → fetch → parse → updatedb-rundor du själv kör, eftersom runda R hämtar fronten som upptäcktes i runda R-1. Min djupkedja bekräftade det exakt:
| Körda rundor | Djupaste nådda path |
|---|---|
| 2 | /depth/1 |
| 3 | /depth/2 |
| 4 | /depth/3 |
Rent och mekaniskt, men det betyder att djup är en loop-räknare i ditt skript, inte en parameter.
Och så fällan. Nutchs medföljande standard är db.ignore.external.links=false, ihop med ett generöst +.-URL-filter — vilket betyder att en standardkörning av Nutch kommer att följa länkar utanför seed-hostens domän. Jag seedade en sida som länkade till en path inom scope och en länk till ett annat hostname, och crawlen hämtade den främmande hosten. Två oberoende signaler stämde överens: Nutchs egen crawldb markerade den som db_fetched, och den andra hostens serverräknare registrerade träffen.
Att hålla sig inom scope är något man aktivt måste välja, och båda lösningarna fungerar verifierbart:
| Konfiguration | Extern host i crawldb | Extern hosts serverträff | Inom scope? |
|---|---|---|---|
db.ignore.external.links=false (medföljande standard) | db_fetched | +1 | Nej |
db.ignore.external.links=true | saknas | 0 | Ja |
Host-regel i regex-urlfilter.txt (+^http://127.0.0.1: följt av -.) | saknas | 0 | Ja |
Om du crawlar en enda sajt, sätt något av detta innan din första riktiga körning. En metodnot: just det här testet är känsligt för belastning på den lokala servern, så de tre raderna kommer från en körning där inget annat rörde fixturet. Beteendet i sig är mekaniskt tydligt och stöds av två oberoende signaler; de specifika radvärdena är en ren körning, inte ett medelvärde av många.
Sitemaps är ett separat steg. Hövlighet finns där — en normal crawl hämtade /robots.txt — men själva sitemapen kräver ett eget kommando:
| Sätt | Begärdes /sitemap.xml? | Endpoints som bara fanns i sitemapen |
|---|---|---|
| En normal crawl | begärdes aldrig | 0/2 |
bin/nutch sitemap, körd explicit mot crawldb | hämtades | 2/2 poster injicerades, full recall |
katanas inline--kf known-files-läge, samma fixture, på en IP-host | inte registrerat | 0/2 |
Det är en annan modell än crawlers som hämtar kända filer inline, och det kostar dig ett extra kommando, men det gör jobbet fullt ut.
Två mindre beteenden höll dessutom bra.
Felhantering: en crawl över en sida som länkade till en 500 och en 404 avslutade alla rundor snyggt, hämtade fortfarande alla fyra klass-A-sidor och loggade varje fel separat:
| Felaktigt svar som länkades från sidan | registrerad crawldb-status |
|---|---|
| 500 | db_unfetched (kan försöka igen) |
| 404 | db_gone |
Inget spårade ur.
Hövlighet: med en tråd per kö följde gapet mellan hämtningar från samma host inställningen:
fetcher.server.delay | Median-gap mellan hämtningar från samma host |
|---|---|
| 1.0 sekund | 1.009 s (minst 1.006 s) |
| 0.0 | 0.002 s |
Vredet gör exakt det det säger. Den medföljande standarden är 5.0 sekunder, vilket är konservativt och, återigen, sannolikt rätt för ett verktyg som är tänkt att crawla andras servrar.
Batch-skatten, i sekunder
Varje Nutch-kommando är en ny JVM. Den enkla faktorn dominerar tidsprofilen mer än något som har med själva hämtningen att göra.
| Fas (per runda) | Mediansekunder |
|---|---|
inject (en gång) | 1.81 |
generate | 3.93 |
fetch | 2.82 |
parse | 1.78 |
updatedb | 1.81 |
| En hel runda | 12.14 |
Den effektiva golvnivån per jobb — JVM-start plus Hadoop-initiering, mätt som den billigaste fasen med trivialt arbete — ligger runt 1.77 sekunder. Multiplicera det med fyra kommandon per runda, lägg till den inledande inject, och bilden för hela crawlen ser ut så här:
| Verktyg | Crawl på djup 4 av testet med 12 sidor | Processer |
|---|---|---|
| Nutch | ungefär 45 sekunder (jag mätte 45.8 s och 45.0 s över två konfigurationer) | runt 17 JVM-startar, i princip ingen av dem gör nätverksarbete |
katana standard-läge, samma fixture | cirka 13 sekunder | en process |
Det gapet handlar inte om fetch-throughput; båda verktygen begär samma lilla handfull sidor. Det är arkitektur. Nutch betalar en fast processkostnad per fas eftersom de här faserna är designade som MapReduce-jobb. På en liten lokal crawl dominerar uppstarten. Den fasta kostnaden borde bli en mindre del av ett längre jobb, men det här testet mätte inte den skala där Nutch och katana korsar varandra, eller om deras relation vänder.
För- och nackdelar
Fördelar
- Deterministisk statisk discovery: 4/4 i HTML-klassen, 3/3 i djupkedjan, identiskt över tre upprepade körningar.
parse-jsåterställer endpoints som bara finns som strängliterals i JavaScript-filer (2/2) utan någon webbläsare, och fångar både funktionsargument och tilldelningsformer.- Två verifierade scope-kontroller som helt kan avgränsa en crawl (
db.ignore.external.linksoch host-regel iregex-urlfilter). - Sitemap-inläsning via
bin/nutch sitemapgav full 2/2-recall på endpoints som en normal crawl missade helt. - Robust vid fel: 500 och 404 hanteras med olika crawldb-statusar, crawlen fortsätter.
- I denna lokala körning stämde det observerade intervallet mellan samma-host-hämtningar med den konfigurerade fördröjningen på 1.0 sekund; den medföljande standarden är 5.0 sekunder.
- Apache-2.0, aktivt underhållet, 78 plugins och en beständig crawldb som följer URL-status mellan rundor.
- Körs i lokalt läge utan kluster, utan HDFS och utan krav på Solr.
Nackdelar
- Körs inte på JDK 24 eller senare, där borttagningen av SecurityManager slår till (jag mätte felet på 26.0.1) — den medföljande Hadoop 3.4.2 föregår upstream-fixen och escape-flaggan är borta, så en låst LTS-JDK är ett hårt krav snarare än en preferens.
- ≈396 MB uppackat, 188 bibliotek-JAR:er, 78 plugin-kataloger, 35 konfigurationsfiler.
- Ny JVM per kommando innebär ~1.77 s fast overhead per fas; ~45 s för en crawl på djup 4 av 12 sidor jämfört med ~13 s för en crawler i en enda binärfil på samma underlag.
- Medföljande standard följer länkar till externa hostar; att hålla sig på en sajt är något du måste slå på själv.
http.agent.namelevereras tomt och fetchern vägrar köra tills du sätter det.- Ingen djupflagga — djup är en loop-räknare du själv hanterar.
- Endpoints i runtime-DOM nåddes inte i någon konfiguration jag testade, och att byta in ett JS-körande protokoll var inte en drop-in-ändring.
- Jag testade lokalt läge på en enda host med ett litet fixture. Distribuerat/HDFS-läge, Solr-indexering, hostdb, resume och inkrementell omcrawling låg utanför den här genomgången — se dem som otestade här, inte som rekommenderade.
Vem bör använda det, och vem bör gå vidare
Nutch är värd mödan när själva crawlen är den svåra delen. Om du bygger ett sökindex, kör en bred crawl över många domäner, behöver en beständig URL-databas med status per URL och retry-semantik, eller förväntar dig att så småningom fördela arbetet över flera maskiner, då är detta infrastruktur som har gjort just det jobbet sedan innan de flesta alternativ fanns. Plugin-systemet gör att du kan ändra beteende för protokoll, parser, filter och scoring utan att forka något. Hövlighetsstandarderna är konservativa på ett sätt som antyder att underhållarna har tänkt noggrant på att vara en god internetmedborgare.
Gå vidare om du vill ha strukturerad data från ett fåtal sidor. Nutch hämtar och parser dem, men lämnar sedan över en crawldb och segment och förväntar sig att du själv tar med en indexerare. Gå vidare om dina mål är client-renderade single-page-appar — klass C förblev onådd i allt jag körde. Gå vidare om ditt team inte kör JVM, eftersom du då lägger till en Java-toolchain, en låst LTS-JDK och 396 MB JAR:er i en stack som i dag saknar allt detta. Och om arbetsuppgiften är "crawla en sajt, fyra nivåer djupt, en gång i veckan", kommer du att lägga mer tid på rundloopen och konfigurationsfilerna än crawlen förtjänar.
För de flesta som letar efter en scraper är det faktiskt det sista scenariot som gäller. Vilket inte är en kritik av Nutch — det är en mismatch mellan verktyget och ärendet. Om du vill få en känsla för det bredare fältet täcker vår genomgång av open source-scrapers och bästa GitHub-projekten för web scraping den lättare delen av spektrumet mer i detalj.
Alternativ, inklusive var vår egen stack passar in
Den rättvisa inramningen först: Nutch är gratis, Apache-licensierat, självvärvat och ditt att köra för alltid utan kostnad per begäran. Det är en verklig fördel, och inget nedan tar bort den.
Relaterad recension: Browsertrix Crawler-recension.
Inom open source-världen beror jämförelsen på vad du optimerar för. Om du vill ha ett Python-ramverk med crawl-kontroll och en request-first-filosofi är Scrapy en närmare analogi för många projekt; den här artikeln mätte inte dess installationsfotavtryck på samma sätt. Om du vill ha en kompakt Go-crawler utan webbläsare är Colly en annan form att utvärdera. Om ditt problem är att göra om sidor till LLM-klart innehåll snarare än att hitta URL:er är Crawl4AI byggt för ett annat lager.
En hanterad tjänst som Thunderbit flyttar hämtning, rendering och extraktion bakom ett API, medan Nutch behåller crawl-status och infrastruktur under din kontroll. Thunderbit kördes inte på detta fixture, så detta är en jämförelse av ägarmodell snarare än ett påstående om matchad recall eller prestanda på dynamiska sidor.
Avvägningen är ägande mot overhead, och den är inte subtil. Nutch ger dig total kontroll, en beständig crawldb, designad klusterskalning och noll marginalkostnad — i utbyte mot en JVM, en låst LTS-JDK, 396 MB JAR:er, en rundloop och ditt eget indexeringslager. Ett hanterat API ger dig strukturerad output redan vid första anropet och ingen infrastruktur — i utbyte mot pris per anrop och mindre kontroll över crawl-fronten. Om uppgiften är "indexera 50 miljoner sidor" är Nutchs modell rätt och ett API skulle vara absurt. Om uppgiften är "hämta strukturerade poster från 200 produktsidor till torsdag" är det tvärtom.
Testa Thunderbit för webbdataledning
Slutsats
Apache Nutch är värd att utvärdera om du kör en pågående crawl över flera domäner och redan har JVM-infrastruktur. I detta test var dess statiska discovery deterministisk över upprepningar, parse-js hittade båda de litterala JavaScript-endpointsen, fel förblev representerade i crawldb:n och det observerade begäringsintervallet stämde med den konfigurerade fördröjningen.
Sätt startkostnaden ärligt. Nutch 1.22 misslyckades här på JDK 26.0.1; OpenJDK 17.0.20 är den LTS-konfiguration som faktiskt verifierades i denna recension, medan Java 21 inte testades. Sätt sedan http.agent.name, bestäm scope uttryckligen och räkna med den observerade fasta golvnivån på cirka 1.77 sekunder per fas i denna lilla lokala körning. Om den avvägningen är rimlig beror på crawlens längd, bredd och behov av beständigt tillstånd.
Testa Thunderbit för webbdataledning Get Started Free
Vanliga frågor
Varför misslyckas Apache Nutch med "getSubject is not supported"?
På JDK 24 eller senare gjorde JEP 486 att Subject.getSubject() alltid kastar undantag, medan den medföljande Hadoop 3.4.2 fortfarande anropade den. Det första Hadoop-jobbet dör därför innan någon sida hämtas, och den gamla nödlösningen -Djava.security.manager=allow startar inte längre VM:n. Använd den verifierade Java 17-konfigurationen och sätt NUTCH_JAVA_HOME; Java 21 kan vara stödd, men den här recensionen körde inte hela cykeln på den.
Vilken Java-version ska jag köra Nutch 1.22 på?
Java 17 är det säkraste svaret — Nutchs egen CI riktar in sig på den, och den fungerade rent i mina tester på OpenJDK 17.0.20. Java 11 stöds också fortfarande för 1.22, även om projektet har meddelat att 1.23 kommer kräva Java 17. Allt från JDK 24 och uppåt kommer inte att köras. En keg-only-installation via Homebrew (brew install openjdk@17) plus NUTCH_JAVA_HOME låter dig låta systemets standard-JDK vara orörd.
Kan Nutch crawla JavaScript-tunga sajter?
Delvis, och den skillnaden är viktig. Med parse-js-pluginet aktiverat hittade Nutch båda endpoints som bara existerade som strängliterals i en länkad JavaScript-fil — 2/2, utan någon webbläsare inblandad. Med standard-plugin-setet hittade den ingen av dem. Men en endpoint som bara dyker upp efter att JavaScript körs och ändrar DOM:en förblev oåtkomlig i varje statisk konfiguration jag testade, och att byta in HtmlUnit-protokollet var inte en drop-in-ändring i min körning. För client-renderade appar bör du planera för ett JS-körande protokoll plus verkligt konfigurationsarbete, eller ett annat verktyg.
Behöver Nutch Hadoop och Solr installerat?
Nej. I lokalt läge kör Hadoop sin in-process LocalJobRunner — inget kluster, ingen HDFS-daemon, ingen YARN — och hela cykeln inject → generate → fetch → parse → updatedb fungerar på en maskin utan att något annat behöver vara installerat. Solr är den vanliga destinationen för indexering, men själva crawlen kräver det inte. Däremot är Hadoop-JAR:erna buntade (13 stycken, version 3.4.2), vilket är exakt varför JDK-kompatibilitetsproblemet finns över huvud taget.
Hur stoppar jag Nutch från att crawla andra webbplatser?
Sätt det uttryckligen, eftersom den medföljande standarden inte gör det. Nutch 1.22 levereras med db.ignore.external.links=false och ett generöst URL-filter, och i mitt test följde standardcrawlen en länk till en annan host och hämtade den. Antingen sätter du db.ignore.external.links=true i nutch-site.xml, eller så lägger du till en host-regel i conf/regex-urlfilter.txt (till exempel +^https://example\.com/ följt av -.). Båda höll crawlen helt inom scope i test, verifierat både via Nutchs egen crawldb och via den andra serverns requestlogg.




