
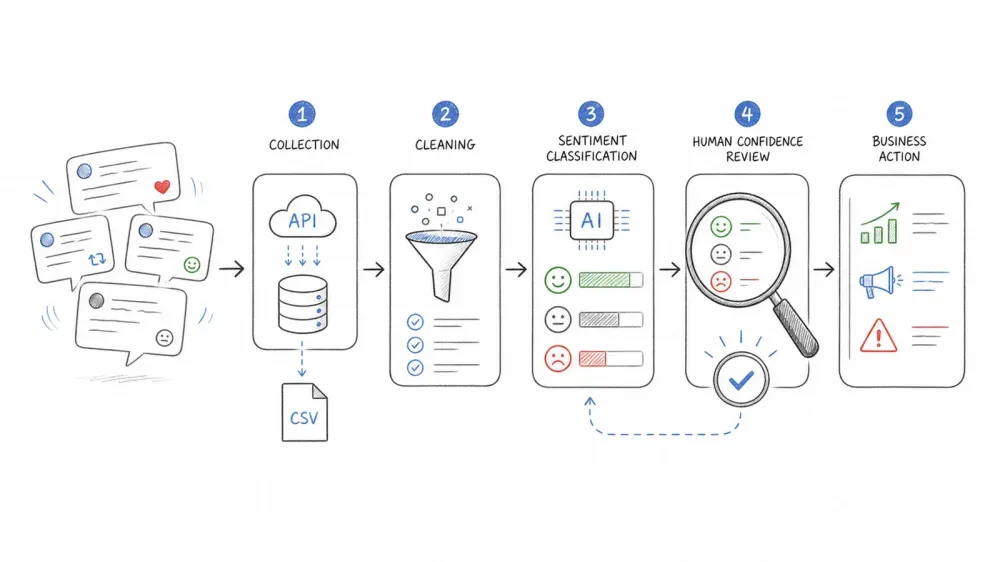
Откройте таблицу с 300 сырыми публикациями — и проблема становится очевидной почти сразу: копировать, вставить, прочитать, прищуриться, догадаться, повторить… и при этом вы всё равно можете так и не понять, понравился людям запускаемый продукт или нет.
Именно для этого и нужен анализ тональности. Но вот в чём беда: большинство туториалов на эту тему застряли в 2022 году. Они исходят из того, что бесплатный доступ к API всё ещё существует, советуют модели, которые спотыкаются о сарказм и эмодзи, и пропускают этапы предобработки, от которых на самом деле и зависит, будут ли ваши результаты вообще что-то значить. Я много времени провёл в мире SaaS и автоматизации (в том числе создавая Thunderbit), и видел, как рынок анализа тональности сильно менялся. Честный, актуальный путь сегодня включает и Python, и no-code сценарии — с методами сбора данных и моделями, которые соответствуют реальности 2026 года.
Что такое анализ тональности Twitter?
Анализ тональности Twitter — это автоматическое определение, является ли публикация в X позитивной, негативной или нейтральной, на основе текста, эмодзи и контекста. Проще говоря, мы учим машину читать твит и отвечать: «Этот человек доволен, недоволен или где-то посередине?»
При этом анализ тональности — это не то же самое, что общий social listening. Social listening — это отслеживание того, о чём говорят люди: темы, тренды, объём обсуждений. Анализ тональности — это следующий слой поверх этого: он показывает, как люди относятся к тому, о чём говорят. У этой идеи есть корни в вычислительной лингвистике и исследованиях opinion mining, которым уже десятки лет, но по-настоящему массовым бизнес-инструментом она стала лишь в последние несколько лет.
Обычно используют несколько уровней классификации:
- Бинарная: позитивно или негативно (самый простой вариант, но без нюансов)
- Трёхклассовая: позитивно, нейтрально или негативно (самый распространённый стандарт)
- Более детальная: от очень позитивного до очень негативного (полезно для исследований и глубокого мониторинга бренда)
Есть и связанные, но отдельные задачи: определение эмоций (злость, грусть, радость), определение позиции (за или против утверждения), анализ тональности на уровне аспекта (что человек думает о цене по сравнению с качеством), а также распознавание сарказма и иронии. В бенчмарке TweetEval эти задачи рассматриваются отдельно — и не случайно: один общий показатель тональности не может ответить на все бизнес-вопросы. Если вы отслеживаете запуск продукта, вам, скорее всего, нужен аспектный анализ тональности («камера отличная, батарея ужасная»). Если вы мониторите кризис, вам важнее эмоции и объём упоминаний, а не просто знак оценки.
Почему анализ тональности Twitter важен для бизнеса
X построен вокруг разговоров в реальном времени, поэтому реакция на запуск продукта, прямой эфир или новостной повод накапливается очень быстро. Для бизнеса именно в этом и ценность. Анализ тональности превращает поток неструктурированного текста в структурированные данные, которые команда может просматривать и использовать в работе.
Чаще всего сценарии применения выглядят так:
| Сценарий | Команда | Бизнес-результат |
|---|---|---|
| Мониторинг репутации бренда | PR, маркетинг | Замечать негативные всплески до того, как они станут вирусными |
| Обратная связь по запуску продукта | Продукт, маркетинг | В реальном времени понимать, что работает, а что нет |
| Сравнение с конкурентами | Стратегия, маркетинг | Сопоставлять восприятие бренда и конкурентов на одинаковых промежутках |
| Обнаружение кризисов | PR, операции | Подключать человека к проверке, когда резко растёт негативный объём |
| Эффективность кампаний | Маркетинг | Измерять изменение тональности по креативу, каналу или времени |
| Рыночные и фондовые настроения | Финансы, исследования | Отслеживать общественное настроение вокруг отчётности, событий или политики |
| Политические и policy-исследования | Исследования, госструктуры | Оценивать общественное мнение по крупным выборкам |
Чтобы сделать это более наглядно: в подборке X к Супербоулу 2026 было зафиксировано 16 миллионов публикаций от 4 миллионов авторов, 5 миллиардов показов и 605 миллионов просмотров видео вокруг одного события — причём половина обсуждений происходила в реальном времени. На таком масштабе ручное чтение просто невозможно, и автоматическая оценка тональности становится необходимостью.
И дело не только в объёме. Собственная методология X BrandRanx объединяет объём, вовлечённость и тональность — это подтверждает, что тональность особенно полезна в связке с другими сигналами, а не сама по себе.
Вывод простой: если ваша команда принимает решения на основе общественного восприятия — будь то продукт, бренд, кампания или кризис — анализ тональности по данным X даёт один из самых быстрых циклов обратной связи.
Реалии X API в 2026 году: как на самом деле получать данные твитов
Вот где большинство руководств ломается. Если вы когда-либо следовали гайду на базе Tweepy, вставляли код и натыкались на paywall или загадочную ошибку, вы не одиноки. Старых уровней Free / Basic / Pro больше нет. Теперь API X работает по модели оплаты за использование с предоплаченными кредитами, с оплатой по каждому endpoint и отслеживанием использования в реальном времени.
Честное сравнение всех актуальных способов сбора данных:
| Метод | Стоимость (2026) | Объём | Уровень навыков | Примечания |
|---|---|---|---|---|
| X API v2 (pay-per-use) | $0.005 за чтение Post | До 2 млн чтений Post в месяц (self-serve) | Средний (Python) | Официально, воспроизводимо, соответствует правилам |
| Full-Archive Search | $0.005 за возвращённый Post; $0.010 за запрос подсчёта full-archive | Исторически до марта 2006 года | Средний–продвинутый | Доступно для pay-per-use и Enterprise |
| Filtered Stream | Чтения Post тарифицируются по доставке | В реальном времени, непрерывно | Средний–продвинутый | Лучший вариант для live-сбора |
| Готовые датасеты (Kaggle, Sentiment140) | $0 | Только статические исторические данные | Начальный | Отлично подходит для обучения, но не для live-анализа |
| snscrape, Twint, Twikit и т. д. | $0 | Ненадёжно / часто ломается | Продвинутый | snscrape не работает для поиска по X с 2023 года; Twint архивирован; Twikit использует неофициальные методы |
| Ваш собственный архив X | $0 | Только ваши публикации | Начальный | Полезно для личного анализа |
Несколько важных моментов:
- Старых уровней Free/Basic/Pro больше нет. Не следуйте туториалам, где они описаны как актуальные.
- snscrape для X фактически мёртв. Его сопровождающий подтвердил в 2024 году, что поиск по Twitter/X больше не работает. Twint архивирован. Twikit использует неофициальный скрейпинг и cookies — активность не означает разрешение.
- Правила X запрещают браузерный скрейпинг без предварительного письменного согласия. Это значит, что Selenium, Playwright и расширения для браузера не являются легальными обходными путями для доступа к API X.
X API v2: что вы реально получаете
Обычное чтение Post стоит $0.005 за одну возвращённую публикацию. Чтение данных о пользователях — $0.010 за каждый запрос. То есть 10 000 уникальных чтений Post обойдутся примерно в $50, не считая других расходов на ресурсы. Лимит self-serve — 2 миллиона чтений Post в месяц. Тарифы могут меняться — всегда проверяйте Developer Console.
Для работы с тональностью вам нужно больше, чем просто id и text. Полезный минимальный набор полей включает created_at, lang, author_id, conversation_id, referenced_tweets, entities, context_annotations и public_metrics. Сохраняйте и сырой ответ, и неизменяемую запись о вашем запросе, endpoint, UTC-окне и токенах пагинации. Без этого корпус нельзя будет воспроизвести.
Есть ещё один нюанс: миграция поискового индекса 4 мая 2026 года изменила наблюдаемый корпус. Keyword REST search больше не возвращает репосты, тогда как Filtered Stream не изменился. Если вы сравниваете результаты до и после этой даты, вы можете считать разные множества данных.
Готовые датасеты: полезны для обучения, но не для live-анализа
Sentiment140 (1,6 млн твитов, разметка по distant supervision) и различные датасеты на Kaggle бесплатны и отлично подходят для обучения и бенчмаркинга. Но Sentiment140 собран в 2009 году. Подмножество sentiment в TweetEval использует данные SemEval 2013–2016 годов. Они не докажут, что ваша модель работает на языке, сленге и событиях 2026 года.
Несколько слов про Thunderbit и данные X
Скажу прямо, раз мы делаем Thunderbit: Thunderbit — это инструмент AI-скрейпинга и автоматизации, который работает на многих совместимых сайтах. Но текущие правила X запрещают браузерный скрейпинг без согласия. Поэтому я не буду подавать Thunderbit как способ обойти стоимость X API или ограничения доступа — это было бы неверно. Для данных X используйте официальный API, авторизованного провайдера или собственный архив аккаунта. Где Thunderbit действительно полезен в рабочем процессе анализа тональности — это следующий этап: структурирование, разметка и экспорт уже собранных данных, полученных разрешённым способом. Об этом позже.
Как выбрать модель тональности: VADER, TextBlob или RoBERTa
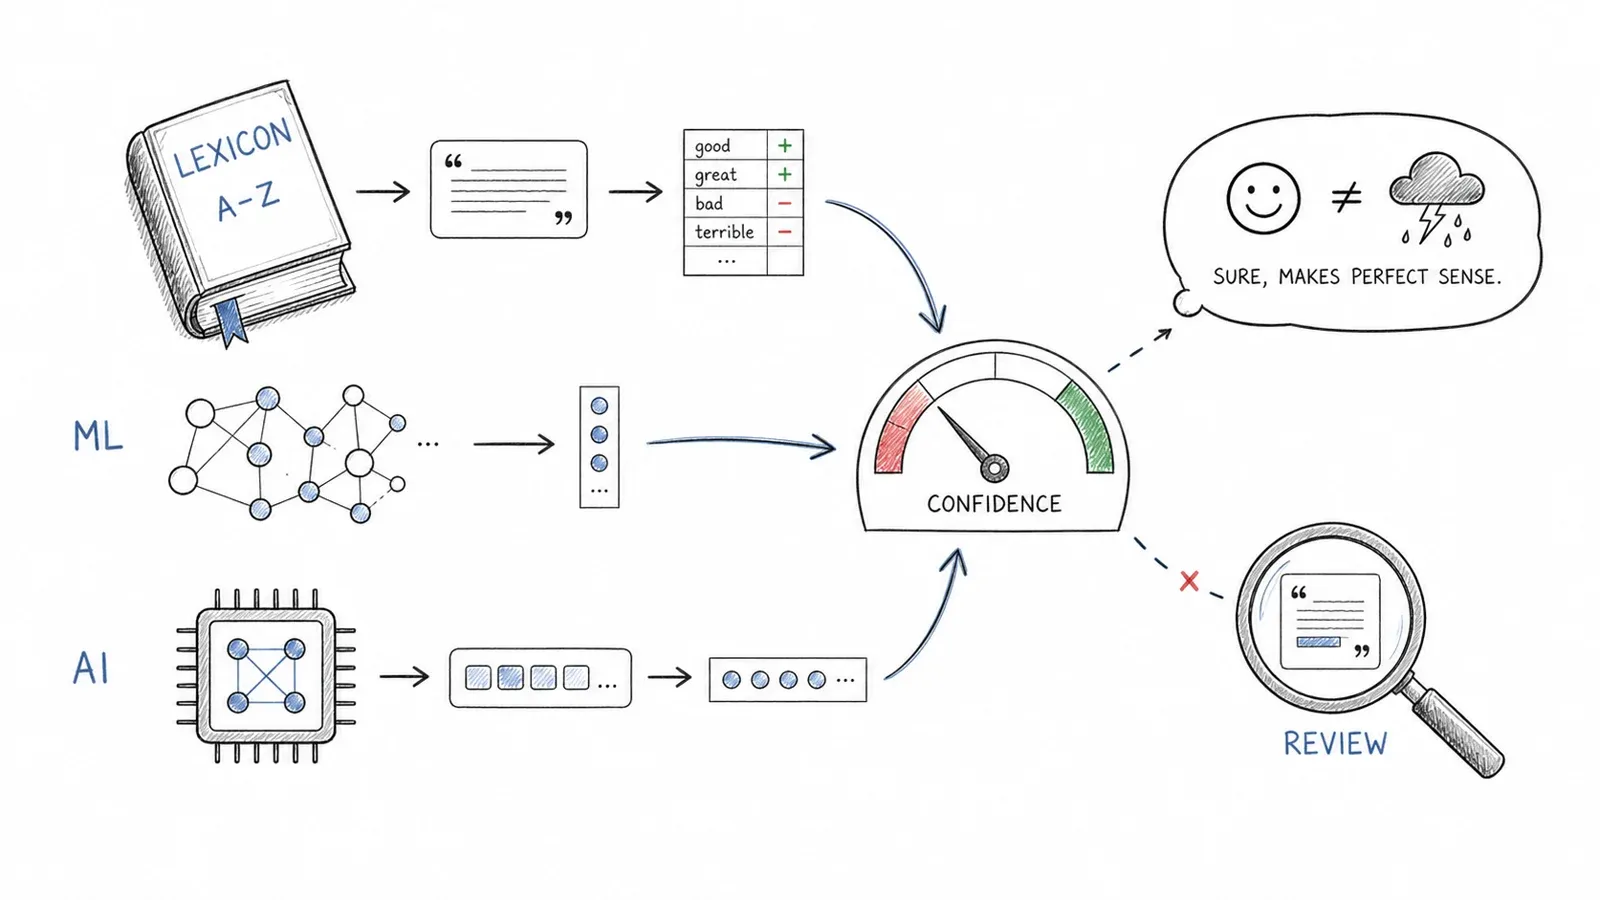
Выбор модели важнее, чем обычно говорят в туториалах. И главный пробел в большинстве сравнительных гайдов в том, что почти никто не рассматривает transformer-модели, дообученные на твитах, — а ведь именно там сейчас находятся одни из самых сильных практических базовых решений.
Ниже — сравнение в лоб. Я намеренно не привожу универсальные F1-значения в таблице, потому что результаты зависят от датасета, разбиения, определения классов, временного периода и метрики. Вместо этого я опишу относительную эффективность и покажу бенчмарки, где можно всё проверить.
| Модель / библиотека | Подход | Понимает сарказм? | Понимает сленг/эмодзи? | Относительная точность на твитах | Сложность настройки |
|---|---|---|---|---|---|
| VADER (NLTK) | Правила + лексикон | Слабо | Частичная поддержка эмодзи | Самая низкая | Очень низкая |
| TextBlob | Шаблонный подход | Слабо | Нет | Ниже | Очень низкая |
| Naive Bayes / Logistic Regression (TF-IDF) | Классический ML | Нет | Нет | Средняя | Средняя |
| CardiffNLP RoBERTa | Transformer (дообучен на твитах) | Лучше (но не идеально) | Да | Наивысшая среди этих вариантов | Средняя (HuggingFace pipeline) |
VADER: быстро и просто, но с ограничениями
VADER — это rule-based подход на базе лексикона, созданный специально для социальных текстов. Он быстрый, интерпретируемый, не требует обучающих данных и умеет работать с некоторыми эмодзи и смайлами. Он учитывает отрицание, усилители, пунктуацию и заглавные буквы. Для быстрого базового варианта или когда важны прозрачность и низкая нагрузка, VADER полезен. Где он сдаёт позиции: сарказм, сленг, зависимость смысла от контекста и вообще всё, что требует понимания шире, чем отдельные слова. Его стандартные пороги compound score (≥0.05 = positive, ≤-0.05 = negative) — это именно стандартные значения, а не универсальные бизнес-пороги. Настройте их на собственной валидационной выборке.
TextBlob: ещё проще, но ещё более ограничен
TextBlob — это небольшой учебный baseline. Его стандартный PatternAnalyzer не обучен на тексте в стиле твитов. Он полезен для первого эксперимента в NLP, но не для production-анализа твитов.
Классический ML: Naive Bayes, Logistic Regression, SVM
Пайплайн на основе TF-IDF по словам и символам вместе с логистической регрессией или LinearSVC остаётся полезным supervised baseline. Он недорогой, интерпретируемый и часто помогает понять, даёт ли transformer достаточно ценности, чтобы оправдать свою сложность. Главное правило: обучайте векторизатор только после разбиения на train/validation, чтобы избежать утечки словаря и IDF.
Такие модели обычно лучше rule-based подходов на больших размеченных датасетах, но всё равно плохо понимают контекст, сарказм и сленг.
CardiffNLP RoBERTa: стандарт 2026 года для анализа тональности твитов
cardiffnlp/twitter-roberta-base-sentiment-latest — это поддерживаемая трёхклассовая модель, ориентированная на твиты, и вполне разумный сильный baseline на 2026 год. Она предварительно обучалась на большом корпусе твитов и дообучалась под задачу sentiment, поэтому намного лучше справляется с эмодзи, сленгом и разговорным языком, чем rule-based или классические ML-подходы.
Вот минимальный пример на HuggingFace:
from transformers import pipeline

classifier = pipeline(
    "text-classification",
    model="cardiffnlp/twitter-roberta-base-sentiment-latest",
    top_k=None,
)
scores = classifier("@user Love waiting three hours for support 😒 http")
print(scores)
Несколько оговорок:
- Выход модели — это score модели, а не откалиброванная бизнес-вероятность. Лучше калибровать его или добавлять порог отказа на свежей размеченной выборке.
- Контекстные модели обычно лучше rule-based систем справляются со многими задачами на твитах, но сарказм, смешанные цели, отсутствие контекста ветки, диалекты и закодированный язык всё равно остаются системными источниками ошибок. Не обещайте, что модель «понимает сарказм» — точнее говорить, что она справляется с ним лучше, но не идеально.
- Альтернативы включают BERTweet, TimeLMs и multilingual Twitter-XLM-R, в зависимости от языка и задачи.
Так можно ли вообще сделать анализ тональности Twitter точным? Да — если модель, предобработка, определение классов и оценочная выборка соответствуют задаче. Generic VADER-скрипт, скопированный из туториала 2019 года, — это baseline, а не доказательство качества для production.
Реальный pipeline предобработки твитов, а не просто text.lower()
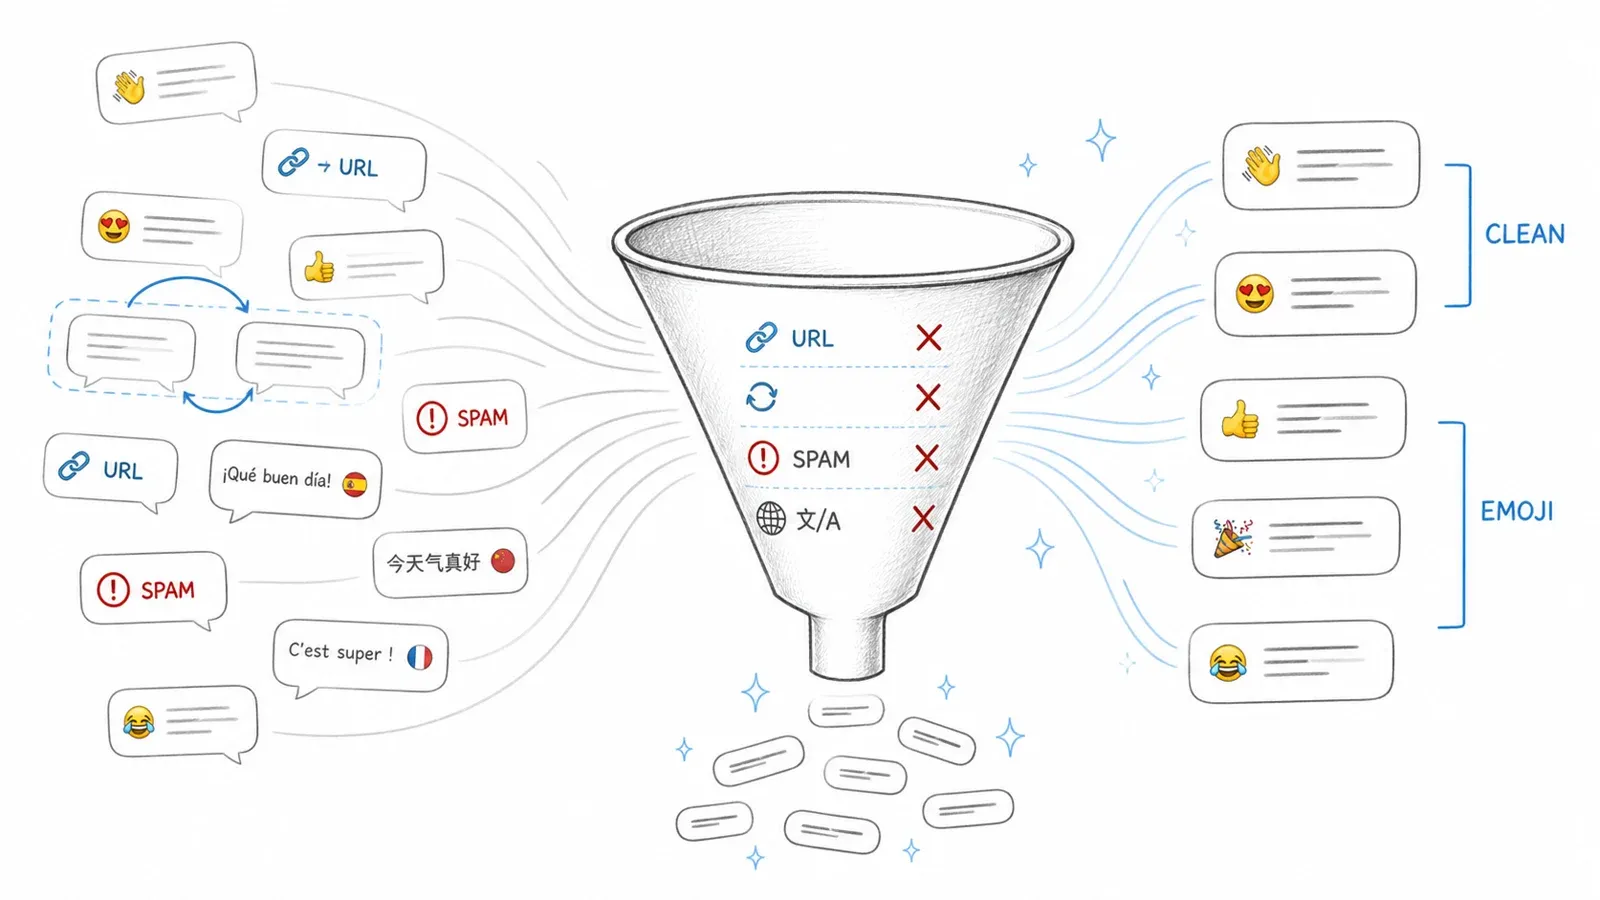
Если подать модели тональности сырые URL, @mentions и HTML-entities, даже неплохая модель может вернуть мусор. Большинство туториалов (включая самые верхние в выдаче) перед подачей в модель просто переводят текст в нижний регистр. Это тихо убивает точность — особенно в классическом ML, где качество предобработки может быть не менее важным, чем сам выбор модели.
Что чистить и почему это важно
| Элемент | Что делать | Почему |
|---|---|---|
| URLs | Заменять на плейсхолдер вроде http | Ссылки — шум для тональности; а удаление соседнего текста может сломать контекст |
| @mentions | Заменять хэндлы на @user | Сохраняет структуру и убирает утечку личности автора |
| Emoji/emoticons | Сохранять для современных токенизаторов; для sparse-моделей тестировать преобразование в текст | Эмодзи несут сильный сигнал тональности — удалять их значит выбрасывать данные |
| Hashtags | Оставлять токен; при желании добавлять сегментированную копию (например, #ClimateChangeIsReal → Climate Change Is Real) | Часто именно хэштег содержит мнение |
| Отрицание | Сохранять not, no, never, сокращения и слова противопоставления | Общие списки stop words часто удаляют их, переворачивая тональность |
| Регистр/пунктуация | Сохранять для VADER и совместимых моделей | VADER использует заглавные буквы и пунктуацию как признаки |
| Префикс RT | Удалять маркер RT | Это метаданные, а не тональность |
| Репосты/дубликаты | Выявлять точные и близкие дубликаты до split | Дубликаты в train и test приводят к утечке |
До и после: что предобработка реально делает с твитом
Вот конкретный пример:
| Этап | Текст |
|---|---|
| Сырой твит | RT @BrandX: Wow, #CustomerServiceFail 😡😡 https://t.co/abc123 I've been waiting 3 hrs ngl this is awful |
| После удаления URL | RT @BrandX: Wow, #CustomerServiceFail 😡😡 http I've been waiting 3 hrs ngl this is awful |
| После нормализации mention | RT @user: Wow, #CustomerServiceFail 😡😡 http I've been waiting 3 hrs ngl this is awful |
| После удаления RT | @user: Wow, #CustomerServiceFail 😡😡 http I've been waiting 3 hrs ngl this is awful |
| После сегментации хэштега | @user: Wow, #CustomerServiceFail Customer Service Fail 😡😡 http I've been waiting 3 hrs ngl this is awful |
| После emoji-to-text (для sparse-моделей) | @user: Wow, #CustomerServiceFail Customer Service Fail angry_face angry_face http I've been waiting 3 hrs ngl this is awful |
| Итог (для CardiffNLP RoBERTa) | @user Wow, #CustomerServiceFail Customer Service Fail 😡😡 http I've been waiting 3 hrs ngl this is awful |
Обратите внимание: для transformer вроде CardiffNLP RoBERTa вы сохраняете эмодзи, пунктуацию и регистр — модель обучалась на тексте, который выглядит именно так. Для TF-IDF-модели, наоборот, может быть уместно преобразовать эмодзи в текст, привести всё к нижнему регистру и лемматизировать.
Готовый Python-код для предобработки
Чистая, модульная функция для transformer-совместимой предобработки:
import html
import re
import unicodedata

URL_RE = re.compile(r"https?://\S+|www\.\S+", re.I)
MENTION_RE = re.compile(r"(?<!\w)@[A-Za-z0-9_]+")

def normalize_social_text(text: str) -> str:
    """Нормализует твит для transformer-моделей анализа тональности."""
    text = html.unescape(text)
    text = unicodedata.normalize("NFC", text)
    text = URL_RE.sub("http", text)
    text = MENTION_RE.sub("@user", text)
    text = re.sub(r"\bRT\b", "", text)
    return " ".join(text.split())
Для классических ML-пайплайнов вы бы расширили это lowercasing’ом, преобразованием emoji в текст (через emoji или demoji), сегментацией хэштегов (через wordninja или ekphrasis), нормализацией сленга, удалением stop words и лемматизацией (через spaCy или NLTK). Главный принцип: подбирайте предобработку под модель. Например, BERTweet использует свою документированную схему нормализации — не нужно пропускать каждую модель через один и тот же конвейер.
Пошагово: анализ тональности Twitter на Python
Это полный рабочий процесс, который соединяет всё описанное выше. Вы можете пройти его от начала до конца.
Перед началом:
- Сложность: средняя (предполагается базовое знание Python)
- Время: около 30–60 минут на полный pipeline; около 10 минут на быстрый transformer-вариант
- Что понадобится: Python 3.8+, бесплатный Google Colab или локальная среда,
pandas,transformers,scikit-learn,matplotlib,seabornи, опционально,wordcloud
Шаг 1: Соберите данные твитов
Для этого туториала я использую датасет Sentiment140 (бесплатный, 1,6 млн твитов, доступен на Kaggle). Он отлично подходит для обучения и бенчмаркинга, хотя и является историческим.
Если вам нужны живые данные, используйте платный по использованию уровень X API v2. Обычное чтение Post стоит $0.005. Для 10 000 публикаций это примерно $50.
Загрузите датасет:
import pandas as pd

columns = ["target", "id", "date", "flag", "user", "text"]
df = pd.read_csv(
    "training.1600000.processed.noemoticon.csv",
    encoding="latin-1",
    names=columns,
)
# Метки: в Sentiment140 0 = negative, 4 = positive
df["label"] = df["target"].map({0: "negative", 4: "positive"})
print(df[["text", "label"]].head())
Вы должны увидеть DataFrame с сырым текстом твитов и колонкой label.
Шаг 2: Очистите и предобработайте твиты
Примените функцию предобработки из предыдущего раздела:
df["clean_text"] = df["text"].apply(normalize_social_text)
print(df[["text", "clean_text"]].head())
Проверьте несколько строк, чтобы убедиться, что URL заменены, mention-нормализация работает, а префиксы RT удалены.
Шаг 3: Выберите модель и классифицируйте тональность
Путь A: Классический ML с TF-IDF + Logistic Regression
Это путь «понять основы». Разделите данные, обучайте векторизатор только на train и натренируйте классификатор логистической регрессии:
from sklearn.model_selection import train_test_split
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report

X_train, X_test, y_train, y_test = train_test_split(
    df["clean_text"], df["label"], test_size=0.2, random_state=42
)
vectorizer = TfidfVectorizer(max_features=50000, ngram_range=(1, 2))
X_train_tfidf = vectorizer.fit_transform(X_train)
X_test_tfidf = vectorizer.transform(X_test)

clf = LogisticRegression(max_iter=1000)
clf.fit(X_train_tfidf, y_train)
y_pred = clf.predict(X_test_tfidf)
print(classification_report(y_test, y_pred))
Вы должны увидеть отчёт классификации с precision, recall и F1 для каждого класса. На Sentiment140 логистическая регрессия с TF-IDF обычно показывает достойный результат — но помните, что этот датасет датируется 2009 годом и использует distant supervision (эмотиконы как метки), так что не принимайте эти цифры за производственный бенчмарк.
Путь B: CardiffNLP RoBERTa через HuggingFace
Для лучшей точности на тексте твитов используйте предобученный transformer:
from transformers import pipeline

classifier = pipeline(
    "text-classification",
    model="cardiffnlp/twitter-roberta-base-sentiment-latest",
    top_k=None,
)

sample_tweets = [
    "@user Love waiting three hours for support 😒 http",
    "@user This new update is absolutely fantastic, best one yet!",
    "@user The event was okay, nothing special.",
]
for tweet in sample_tweets:
    result = classifier(tweet)
    print(f"Tweet: {tweet}\nScores: {result}\n")
Вы увидите список score по меткам (negative, neutral, positive) для каждого твита. Саркастичный твит («Love waiting three hours…») должен получить более высокий negative-score, чем предсказал бы rule-based подход — хотя и здесь ни одна модель не идеальна.
Шаг 4: Оцените результаты
Теперь постройте тепловую карту confusion matrix для классического ML-пути:
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.metrics import confusion_matrix

cm = confusion_matrix(y_test, y_pred, labels=["negative", "positive"])
sns.heatmap(cm, annot=True, fmt="d", xticklabels=["negative", "positive"],
            yticklabels=["negative", "positive"], cmap="Blues")
plt.xlabel("Predicted")
plt.ylabel("Actual")
plt.title("Confusion Matrix: Logistic Regression on Sentiment140")
plt.show()
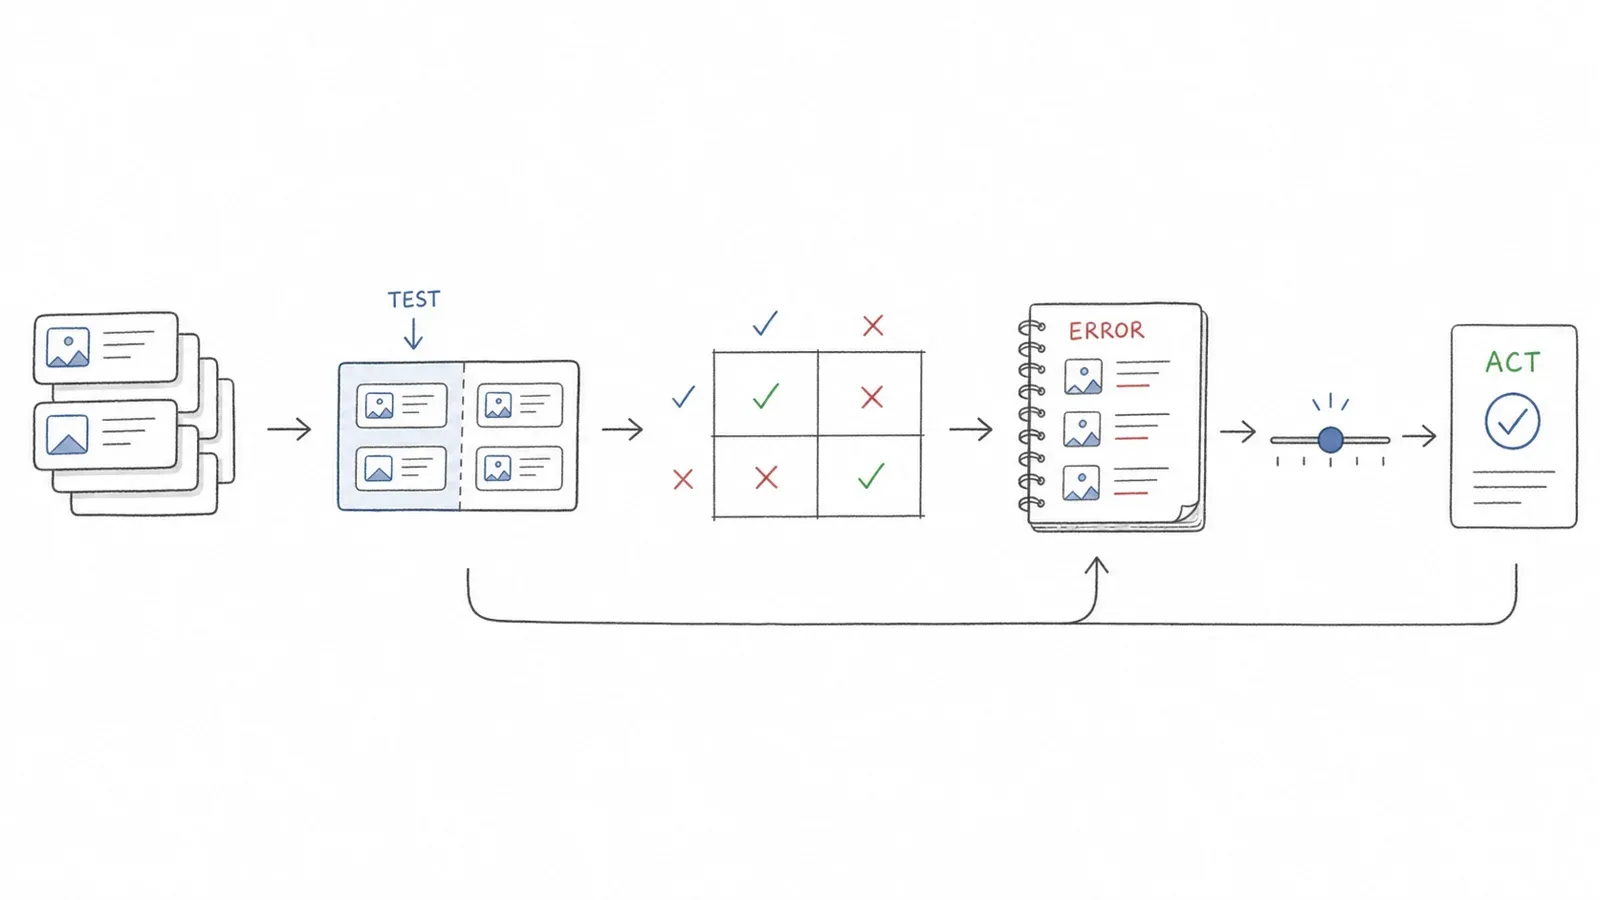
Для transformer-пути вручную разметьте небольшую свежую выборку (50–100 твитов), прогоните модель и сравните. Считайте macro F1, precision и recall по каждому классу, а также confusion matrix. Если это реальный проект, дополнительно проверьте калибровку и задайте порог отказа для неоднозначных случаев.
Шаг 5: Проверьте на крайних случаях
Попробуйте несколько твитов, которые проверяют сарказм, эмодзи и сленг:
edge_cases = [
    "Oh great, another update that breaks everything 🙄",
    "ngl this product slaps 🔥🔥🔥",
    "The camera is amazing but the battery life is trash",
    "Just got my order. It's... fine. I guess.",
]
for tweet in edge_cases:
    clean = normalize_social_text(tweet)
    result = classifier(clean)
    print(f"Tweet: {tweet}\nScores: {result}\n")
Посмотрите, где модель справляется, а где начинает ошибаться. Твиты с несколькими объектами оценки («камера отличная, но батарея ужасная») — известная проблема; аспектный анализ тональности здесь является отдельной задачей.
Анализ тональности Twitter без написания кода
Не всем хочется писать Python — и это нормально. Если вы маркетолог, бренд-менеджер или руководитель операционной функции и вам нужны инсайты по тональности без кода, вот ваш путь.
Но есть честная оговорка: no-code инструменты меняют гибкость на скорость. Они идеальны для быстрого мониторинга бренда, но не для исследования уровня научной статьи или обучения собственной модели.
No-code варианты в одном взгляде
| Инструмент | Для чего лучше всего | Есть встроенная тональность? | Диапазон цен |
|---|---|---|---|
| AWS Comprehend | Анализ текста на уровне enterprise | Да | Оплата за использование |
| Brandwatch / Sprinklr | Полный набор social listening | Да | Enterprise-тарифы |
| Google Sheets + NLP-надстройки | Быстрый и лёгкий анализ | Через надстройку | Бесплатно — недорого |
| Thunderbit + таблица | Структурирование и разметка данных со совместимых страниц | AI Field Prompt для exploratory labels | Есть бесплатный тариф |
No-code workflow: соберите данные и классифицируйте их в таблице
Практический сценарий для тех, у кого уже есть данные твитов (полученные через официальный X API, авторизованного провайдера или собственный архив):
- Экспортируйте данные твитов в таблицу. Если вы использовали X API, выгрузите JSON в CSV или воспользуйтесь инструментом вроде Thunderbit, чтобы структурировать и экспортировать данные со совместимых страниц, где у вас есть разрешение на автоматизацию.
- Откройте Google Sheets. Вставьте или импортируйте текст твитов в отдельную колонку.
- Примените классификатор тональности. Используйте NLP-надстройку для Google Sheets (актуальные варианты проверяйте в marketplace) или сервис вроде AWS Comprehend. Некоторые надстройки позволяют классифицировать тональность прямо формулой в ячейке.
- Проверьте и визуализируйте. Используйте встроенные инструменты Google Sheets, чтобы построить столбчатую диаграмму распределения тональности или линейный график тональности во времени.
AI Field Prompt в Thunderbit также может добавлять prompt-based метку тональности во время извлечения данных на совместимых страницах — это удобно для exploratory monitoring. Но для аудируемых или критически важных решений обязательно проверяйте выборку и используйте задокументированную модель.
Когда выбирать no-code, а когда Python
| Сценарий | Рекомендуемый путь |
|---|---|
| Быстрая проверка бренда, небольшой объём | No-code (таблица + надстройка) |
| Дашборд для команды, еженедельные отчёты | No-code или low-code |
| Анализ на больших объёмах, собственные модели | Python |
| Академическое исследование, воспроизводимость | Python |
| Мониторинг в реальном времени на масштабе | Python + API + плановый pipeline |
Визуализация результатов анализа тональности Twitter
Большинство туториалов останавливаются на отчёте классификации. Но если вы хотите донести выводы до команды или принять решение, вам нужны визуализации.
Столбчатая диаграмма распределения тональности
Самый базовый, но при этом универсально полезный результат:
import matplotlib.pyplot as plt
import seaborn as sns

sentiment_counts = df["label"].value_counts()
sns.barplot(x=sentiment_counts.index, y=sentiment_counts.values, palette="coolwarm")
plt.xlabel("Sentiment")
plt.ylabel("Tweet Count")
plt.title("Sentiment Distribution")
plt.show()
Облако слов по классам тональности
Отдельные word cloud для позитивных и негативных твитов показывают, что именно люди говорят:
from wordcloud import WordCloud

for sentiment in ["positive", "negative"]:
    text = " ".join(df[df["label"] == sentiment]["clean_text"])
    wc = WordCloud(width=800, height=400, background_color="white").generate(text)
    plt.figure(figsize=(10, 5))
    plt.imshow(wc, interpolation="bilinear")
    plt.axis("off")
    plt.title(f"Word Cloud: {sentiment.capitalize()} Tweets")
    plt.show()
Тональность во времени: график, который почти никто не показывает
Именно эта визуализация превращает сырые данные в историю. Если у вас есть временные метки, вы можете отслеживать, как меняется тональность во время события, запуска или кризиса:
df["date"] = pd.to_datetime(df["date"])
df["day"] = df["date"].dt.date
sentiment_map = {"positive": 1, "neutral": 0, "negative": -1}
df["score"] = df["label"].map(sentiment_map)
daily = df.groupby("day")["score"].mean()

plt.figure(figsize=(12, 5))
daily.plot()
plt.xlabel("Date")
plt.ylabel("Average Sentiment Score")
plt.title("Sentiment Over Time")
plt.axhline(0, color="gray", linestyle="--")
plt.show()
Резкое падение в день запуска? Это сигнал копнуть в негативные твиты и понять, что пошло не так.
Heatmap confusion matrix
Её мы уже показали в шаге оценки выше. Смысл в том, чтобы увидеть, где модель путает позитив с негативом (или наоборот). Именно такие твиты стоит читать вручную.
Для тех, кто не пишет код: графики в Google Sheets или Notion
Если вы экспортировали данные с метками тональности в таблицу, вы можете строить распределение и тренды прямо в Google Sheets, Notion или любом BI-инструменте. Python не нужен.
Типичные ошибки в анализе тональности Twitter и как их избежать
В реальных рабочих процессах повторяются одни и те же ошибки.
Сарказм и ирония
Самый большой убийца точности. «Love waiting three hours for support 😒» выглядит позитивно для rule-based модели. Transformer-модели работают лучше, но сарказм остаётся структурно сложной задачей — особенно если сама публикация лишена контекста (ветка, история автора, событие). Для критически важных сценариев комбинируйте вывод модели с ручной проверкой.
Слепые зоны по эмодзи и сленгу
Если предобработка просто удаляет эмодзи вместо того, чтобы преобразовывать их в текст (для sparse-моделей) или сохранять (для transformers), вы выбрасываете одни из самых сильных сигналов тональности. То же касается сленга — «ngl this slaps» означает позитив, но модель, обученная на формальном английском, этого не поймёт.
Устаревшие туториалы по API и сломанные скрейперы
Если туториал использует Tweepy с API v1.1 — он устарел. Если там советуют snscrape, для поиска по X это не работает с 2023 года. Всегда проверяйте дату публикации и версию API в любом руководстве, которым пользуетесь.
Переобучение на одном датасете
Sentiment140 отлично подходит для обучения, но он из 2009 года. Аудит 20 датасетов для социальных медиа в EMNLP 2024 показал, что удаление дубликатов снижало F1 в 14 из 19 протестированных наборов и меняло ранжирование моделей в 17 из 19. Используйте временные, непересекающиеся по событиям и, по возможности, непересекающиеся по авторам разбиения. Проверяйте модель на свежих твитах, чтобы понять, как она обобщает данные.
Восприятие score модели как истины
Score модели — это не откалиброванная вероятность. Не запускайте автоматические ответы или публичные решения, опираясь только на метку тональности. Для решений, затрагивающих людей или кризисные ситуации, всегда нужна проверка человеком.
Приватность, политика платформы и ответственное использование
Этот раздел не является опциональным.
В Developer Policy X подчёркивает приватность, контроль пользователя, удаление контента и ограничения на сопоставление вне X. Практические правила такие:
- Собирайте только необходимые поля.
- Публикуйте агрегированные результаты, а не сырые хэндлы.
- Сохраняйте Post ID и временные метки получения для соответствия требованиям.
- Удаляйте или обновляйте сохранённый контент после удаления, изменения статуса защиты или обоснованных запросов.
- Не делайте выводов о чувствительных характеристиках людей.
- Не связывайте score тональности с идентичностями в CRM без законного основания и согласия.
- Не обучайте и не дообучайте foundation model на контенте X там, где это запрещено ограничениями на использование.
- Документируйте размер выборки, поисковые запросы, временное окно, языковые фильтры и исключения.
- Никогда не автоматизируйте публичный ответ только на основе score тональности.
Анализ тональности — мощный инструмент, но вместе с ним приходят и реальные обязанности. Относитесь к нему соответственно.
Выводы и ключевые рекомендации
Анализ тональности Twitter в 2026 году действительно работает — но только если вы обновили подход под текущие реалии. Старый рецепт (бесплатный API, предобработка только в lower case, VADER или Naive Bayes, отсутствие оценки качества) больше не годится. Что реально работает:
- Получайте данные разрешённым способом. Используйте X API v2 (pay-per-use), авторизованного провайдера или прозрачный датасет. Не полагайтесь на сломанные скрейперы и браузерные обходы.
- Предобрабатывайте под модель, а не ради галочки. Для transformers сохраняйте эмодзи, отрицание и регистр. Нормализуйте URL и mention. Подгоняйте pipeline под обучающие данные модели.
- Сравнивайте дешёвый baseline с transformer, заточенным под твиты. TF-IDF + логистическая регрессия всё ещё отлично подходит как sanity check. CardiffNLP RoBERTa — актуальный сильный стандарт для тональности твитов.
- Оценивайте честно. Публикуйте macro F1, метрики по классам и confusion matrix. Используйте свежую выборку с ручной разметкой. Для неоднозначных случаев задайте порог отказа.
- Визуализируйте для решений, а не просто для красоты. Графики тональности во времени и облака слов расскажут историю, которую не покажет classification report.
- Оставляйте человека в контуре. Ни одна модель не идеальна в сарказме, смешанных объектах или зависимом от контекста смысле. Для критически важных сценариев сочетайте вывод модели с ручной проверкой.
Если вы только начинаете, возьмите бесплатный датасет, откройте Google Colab и запустите HuggingFace pipeline. Рабочие показатели тональности можно получить меньше чем за десять минут. Если же вам нужно собирать и структурировать веб-данные без кода для других частей процесса, Thunderbit поможет на совместимых страницах, где у вас есть разрешение на автоматизацию.
И если вы делаете это для портфолио или собеседования, то добавление сравнения transformer-моделей, реального pipeline предобработки и графика тональности во времени мгновенно выделит ваш проект среди типовых работ после буткемпа.
Узнать больше
- Как освоить автоматический сбор данных с помощью Thunderbit
- 6 лучших скрейперов Twitter (x.com) в 2026 году
- Как собирать твиты из Twitter с помощью Python в 2025 году
- Как использовать AI-скрейпинг Twitter для более глубоких инсайтов по данным
- Статистика Twitter (X) 2026: пользователи, демография и реклама
FAQ
Точен ли анализ тональности Twitter?
Это зависит от модели и способа оценки. Rule-based инструменты вроде VADER показывают более слабые результаты на данных твитов. Transformer-модели вроде CardiffNLP RoBERTa работают заметно лучше — но точные цифры зависят от датасета, разбиения, определения классов и метрики. Качество предобработки тоже важно. Всегда оценивайте модель на свежей выборке с ручной разметкой, а не верьте одному числу из бенчмарка.
Можно ли сделать анализ тональности Twitter бесплатно?
Да. Используйте бесплатный датасет (Sentiment140 на Kaggle), бесплатную среду Python (Google Colab) и предобученную модель HuggingFace. Для живых данных X API взимает $0.005 за чтение Post, так что небольшой сбор данных вполне доступен. Thunderbit предлагает бесплатный тариф для структурирования данных на совместимых страницах.
Какая Python-библиотека лучше всего подходит для анализа тональности Twitter?
Для быстрого прототипа — VADER через NLTK. Для лучшей точности на твитах — библиотека HuggingFace transformers с моделью CardiffNLP RoBERTa. Для классического baseline — scikit-learn с TF-IDF. Правильный выбор зависит от объёма, требований к точности и бюджета на вычисления.
Как обрабатывать сарказм в анализе тональности Twitter?
Transformer-модели справляются с сарказмом лучше, чем rule-based или классические ML-модели, потому что анализируют контекст, а не только отдельные слова. Но идеальной модели сарказма не существует — исследования показывают, что даже люди-annotators не всегда сходятся в интерпретации сарказма. Для критически важных сценариев сочетайте вывод модели с ручной проверкой и рассмотрите саркастические датасеты для оценки.
Можно ли анализировать тональность Twitter без кода?
Да. Получите данные разрешённым способом (X API, авторизованный провайдер или собственный архив), экспортируйте их в Google Sheets и примените no-code классификатор тональности через NLP-надстройку для Sheets или сервис вроде AWS Comprehend. Thunderbit также может добавлять prompt-based метки тональности во время структурирования данных на совместимых страницах. Подробнее о no-code потоках данных читайте в нашем гиде по AI-инструментам для Google Sheets.



