
Веб растёт с такой скоростью, что мой утренний кофе на его фоне кажется черепахой — а я, между прочим, пью его очень быстро. В 2026 году извлечение данных из веба — это уже не просто «приятный бонус» для технарей, а секретный ингредиент, который помогает в поиске лидов для продаж, отслеживании цен в e-commerce, исследовании рынка и даже анализе недвижимости. С учётом того, что сейчас более 49% компаний еженедельно используют инструменты для веб-скрейпинга, правильная библиотека или инструмент могут стать разницей между часами рутинной работы и таблицей с полезными инсайтами — причём всё это будет готово ещё до того, как ваши конкуренты успеют пообедать.
Но вот что интересно: библиотеки для веб-скрейпинга в 2026 году бывают самыми разными — от AI-расширений для Chrome без единой строчки кода до серьёзных фреймворков для разработчиков. Неважно, вы менеджер по продажам, которому нужны лиды в Excel, операционный специалист, отслеживающий 500 SKU, или Python-гуру, создающий кастомный краулер, — инструмент найдётся под любую задачу. Я много лет работал в SaaS и автоматизации (и, честно говоря, провёл в этом больше ночей, чем хотелось бы признавать), изучая эти библиотеки. Поэтому давайте разберём топ-10 библиотек для веб-скрейпинга, которые стоит знать в этом году, и посмотрим, как выбрать ту, что реально облегчит вам жизнь.
Что делает библиотеку для веб-скрейпинга мощной в 2026 году?
Извлекайте данные с любого сайта с помощью AI Get Started Free
Прежде чем перейти к списку, давайте поговорим о том, что на самом деле важно при выборе библиотеки для веб-скрейпинга. По моему опыту, лучшие инструменты в 2026 году объединяет несколько вещей:
- Простота использования: может ли человек без навыков программирования получить результат за минуты? Или нужен чуть ли не PhD по Python?
- Работа с динамическим контентом: умеет ли инструмент скрейпить современные сайты с тяжёлым JavaScript? Или спотыкается о всё, что сложнее статического HTML?
- Поддержка языков и платформ: работает ли он на вашем любимом языке — Python, JavaScript, Java — или прямо в браузере?
- Масштабируемость: способен ли он обрабатывать сотни (или тысячи) страниц без проблем?
- Интеграция и экспорт: дружит ли он с Excel, Google Sheets, Notion или вашим data pipeline?
- AI и автоматизация: в 2026 году инструменты на базе AI, которые «просто работают» по текстовому запросу, — огромный плюс, особенно для бизнес-пользователей, которые не хотят лезть в код.
На практике бизнес-командам нужны скорость, точность и минимум настройки. Чем меньше времени уходит на починку сломанных скрейперов и борьбу с кодом, тем быстрее вы начинаете использовать данные. А благодаря росту AI и браузерной автоматизации даже нетехнические пользователи теперь могут собирать данные, для которых раньше требовалась помощь разработчика (PromptCloud).
Ладно — переходим к самому интересному.
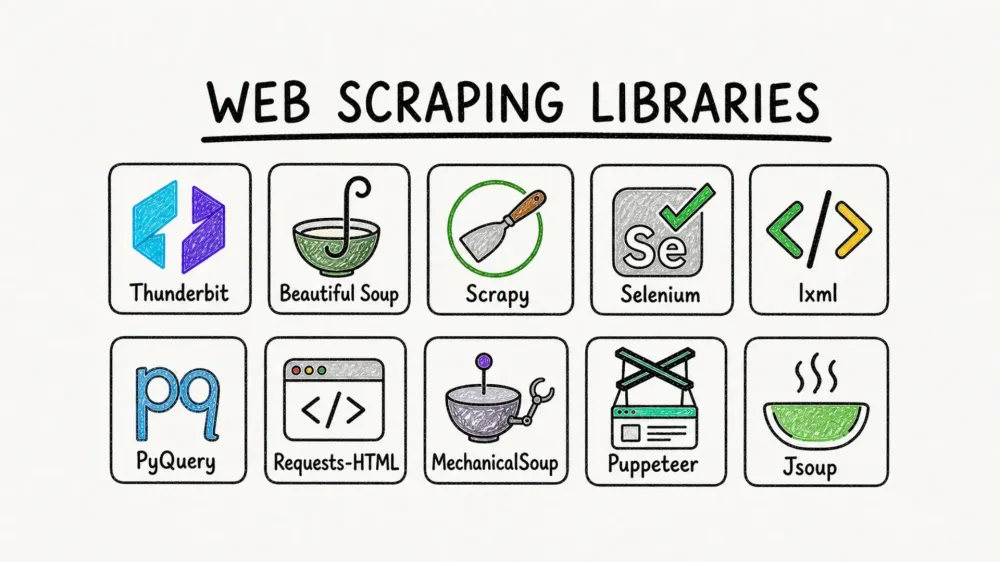
Топ-10 мощных библиотек для веб-скрейпинга, которые стоит использовать в 2026 году
- Thunderbit — no-code и AI-скрейпинг прямо в браузере
- Beautiful Soup — удобный парсинг HTML и очистка данных в Python
- Scrapy — для масштабного и быстрого краулинга с пайплайнами
- Selenium — автоматизация браузера и сбор данных с динамических сайтов
- lxml — сверхбыстрый парсинг XML/HTML в Python
- PyQuery — выборка HTML в стиле jQuery для Python
- Requests-HTML — всё в одном: HTTP, парсинг HTML и рендеринг JS в Python
- MechanicalSoup — автоматизация форм и простых задач в браузере на Python
- Puppeteer — управление headless Chrome в Node.js
- Jsoup — надёжный HTML-парсинг в Java
1. Thunderbit

Thunderbit — мой главный вариант для тех, кто хочет собирать веб-данные без единой строчки кода. Это AI-расширение для Chrome позволяет просто описать, что вам нужно («получи названия товаров, цены и изображения с этой страницы»), а AI уже сам разберётся с остальным. Никаких шаблонов, никакой подготовки — просто нажмите один раз, при желании подправьте столбцы, и извлечение выполнится, даже если вы вообще не будете ничего трогать.
Почему Thunderbit особенно выделяется в 2026 году:
- No-code и интерфейс на естественном языке: подойдёт всем — продажам, операционным командам, маркетингу, недвижимости. Python не нужен.
- Автоматическое определение полей: AI сам формирует набор колонок на основе структуры страницы.
- Скрейпинг подстраниц: нужны дополнительные детали? Thunderbit может заходить на каждую подстраницу (например, карточку товара или профиль) и автоматически обогащать таблицу (Thunderbit Blog).
- Готовые шаблоны для популярных сайтов: Amazon, Zillow, Shopify и другие — сбор данных в один клик.
- Экспорт в Excel, Google Sheets, Notion, Airtable: данные сразу попадают туда, где они нужны команде.
- Поддержка 34 языков: отлично подходит для международных команд.
- Облачный или браузерный режим скрейпинга: выбирайте то, что подходит вашему процессу — облако работает очень быстро на публичных сайтах, а браузерный режим помогает там, где нужен логин.
Thunderbit доверяют более 200 000 пользователей по всему миру, а бесплатный тариф позволяет собрать до 6 страниц (или 10 с пробным бонусом). Если вы хотите понять, как выглядит современный веб-скрейпинг, я бы начал именно отсюда.
Попробуйте Thunderbit AI Web Scraper бесплатно
2. Beautiful Soup
Beautiful Soup — классическая библиотека Python, которую любят дата-сайентисты и аналитики за простоту и мощные возможности парсинга «грязного» HTML. Если вам когда-либо приходилось вытаскивать данные со страницы с битой разметкой или странным форматированием, Beautiful Soup — ваш надёжный помощник.
Чем хорош Beautiful Soup:
- Умеет работать с неаккуратным HTML: отлично подходит для очистки и извлечения данных с «некрасивых» страниц (Beautiful Soup Docs).
- Легко осваивается: даже новичок в Python быстро начнёт получать результат.
- Гибкий: хорошо работает с HTTP-клиентами вроде Requests и может сочетаться с lxml ради скорости.
- Типичные сценарии: быстрое извлечение данных, очистка веб-данных, использование в небольших скриптах.
Если вы работаете со статическими страницами или вам нужно привести в порядок кривую разметку, Beautiful Soup — очень надёжный выбор.
3. Scrapy
Scrapy — тяжёлая артиллерия среди Python-инструментов для веб-скрейпинга. Это полноценный фреймворк для создания масштабируемых краулеров и data pipeline. Если вам нужно собрать тысячи страниц, ходить по ссылкам и обрабатывать данные в больших объёмах, Scrapy создан именно для этого.
Почему Scrapy — один из лучших вариантов:
- Высокая модульность: можно строить сложные spider’ы, pipeline’ы и middleware (Scrapy Docs).
- Подходит для больших проектов: идеально для маркетинговых исследований, конкурентного анализа и любых задач, где нужно сканировать и извлекать данные с множества сайтов.
- Асинхронность и скорость: создан для быстроты и эффективности.
- Большое сообщество: множество плагинов, туториалов и поддержки.
У Scrapy есть порог входа, но для больших задач это настоящий комбайн.
4. Selenium
Selenium — один из самых популярных инструментов для автоматизации браузера. Его используют для всего: от тестирования веб-приложений до скрейпинга сайтов с логинами, кликами и всплывающими окнами. Если вам нужно взаимодействовать с сайтом на JavaScript или с очень динамичным интерфейсом, Selenium может вести себя как настоящий пользователь (ScrapingBee Selenium Guide).
Сильные стороны Selenium:
- Автоматизирует реальные браузеры: Chrome, Firefox, Safari, Edge — что угодно.
- Работает с логинами, pop-up и действиями пользователя: отлично подходит для скрейпинга после авторизации или при многошаговых сценариях.
- Поддерживает несколько языков: Python, Java, C# и другие.
- Лучше всего подходит для: сайтов, которые блокируют простые скрейперы, или задач, где нужно имитировать поведение реального пользователя.
Это решение тяжелее, чем HTTP-библиотеки, но иногда без настоящего браузера просто не обойтись.
5. lxml
lxml — высокопроизводительный парсер XML и HTML для Python. Если для вас в приоритете скорость (например, при парсинге тысяч больших документов), lxml очень сложно превзойти (Python HTML Parser Performance).
Почему lxml так любят:
- Очень быстро работает: опережает большинство других Python-парсеров, особенно на больших файлах.
- Надёжный: поддерживает и XML, и HTML, а также хорошо встраивается в другие инструменты.
- Хорош для: обработки больших массивов данных, а также в связке с Beautiful Soup или Scrapy для дополнительной мощности.
Если вы скрейпите в больших масштабах или обрабатываете очень крупные файлы, lxml должен быть в вашем наборе инструментов.
6. PyQuery
PyQuery переносит мощь синтаксиса селекторов jQuery в Python. Если вам нравится, как просто выбирать элементы через $('.class') в jQuery, PyQuery позволяет делать то же самое в ваших скриптах для скрейпинга (PyQuery Docs).
Главные плюсы PyQuery:
- Селекторы в стиле jQuery: интуитивно понятно тем, кто знаком с фронтенд-разработкой.
- Короткий и читаемый код: делает сложные выборки проще.
- Интеграция с lxml: под капотом всё быстро и эффективно.
- Лучше всего для: проектов, где нужен быстрый HTML-манифест в стиле jQuery на Python.
Это отличный мостик для тех, кто переходит от веб-разработки к извлечению данных.
7. Requests-HTML
Requests-HTML — это Python-библиотека, которая сочетает простоту Requests (для HTTP) с встроенным HTML-парсингом и даже рендерингом JavaScript.
Чем Requests-HTML отличается:
- Всё в одном: получение страниц, парсинг HTML и даже рендеринг JavaScript в одном пакете.
- Подходит новичкам: отличный вариант для небольших и средних проектов по скрейпингу.
- Хорош для: быстрых скриптов, сайтов с умеренно динамичным контентом и пользователей, которым важна простота.
Если вы только начинаете или вам нужен гибкий инструмент для небольших задач, Requests-HTML — очень удачный вариант.
8. MechanicalSoup
MechanicalSoup — Python-библиотека для автоматизации веб-форм и простых взаимодействий с браузером. Она построена на базе Beautiful Soup и Requests, поэтому с её помощью легко входить в аккаунты, заполнять формы и проходить простые сценарии (ScrapingBee MechanicalSoup Guide).
Почему MechanicalSoup удобен:
- Автоматизирует формы и логины: отлично подходит для сбора данных за авторизацией.
- Простой API: легко освоить даже новичкам.
- Лучше всего для: повторяющихся браузерных задач, простых сценариев и сайтов, где полноценная браузерная автоматизация избыточна.
По мощности он уступает Selenium на сложных сайтах, но зато заметно легче и проще для базовых задач.
9. Puppeteer
Puppeteer — это библиотека Node.js для управления headless Chrome или Chromium. Это любимый инструмент для скрейпинга сайтов с тяжёлым JavaScript и очень интерактивных страниц (Scrape.do Puppeteer Guide).
Суперсилы Puppeteer:
- Полная автоматизация браузера: клики, прокрутка, заполнение форм и другие действия, как у настоящего пользователя.
- Работа с динамическим контентом: идеально для сайтов, где данные подгружаются через JavaScript.
- Отлично подходит для: e-commerce, соцсетей и любых сайтов, где обычные скрейперы бессильны.
Если вы JavaScript-разработчик или вам нужно скрейпить «современный веб», Puppeteer — обязательный инструмент.
10. Jsoup
Jsoup — это золотой стандарт HTML-парсинга в Java. По сути, это Beautiful Soup, но для Java-разработчиков (Baeldung Jsoup Guide).
Почему команды Java любят Jsoup:
- Простой и мощный API: извлекайте и обрабатывайте данные всего несколькими строками кода.
- Умеет работать с грязным HTML: очищает и парсит даже плохо сформированную разметку.
- Лучше всего для: встроения скрейпинга в Java-приложения или backend-воркфлоу.
Если ваш стек — Java, Jsoup станет очевидным выбором.
Сравнительная таблица библиотек для веб-скрейпинга
Вот краткое сравнение всех 10 библиотек:
| Библиотека | Язык | Простота использования | Динамический контент | AI / No-code | Типичные сценарии | Лучше всего подходит для |
|---|---|---|---|---|---|---|
| Thunderbit | Расширение Chrome | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | Да | Продажи, операции, исследования, недвижимость | Нетехнических пользователей, бизнеса |
| Beautiful Soup | Python | ⭐⭐⭐⭐ | ⭐ | Нет | Парсинг HTML, очистка данных | Начинающих Python-разработчиков, аналитиков |
| Scrapy | Python | ⭐⭐⭐ | ⭐⭐ | Нет | Масштабный краулинг, пайплайны | Разработчиков, крупных data-проектов |
| Selenium | Мульти | ⭐⭐ | ⭐⭐⭐⭐⭐ | Нет | Автоматизация браузера, логины | QA, скрейпинга динамических сайтов |
| lxml | Python | ⭐⭐⭐ | ⭐ | Нет | Быстрый парсинг, большие файлы | Продвинутых пользователей, больших наборов данных |
| PyQuery | Python | ⭐⭐⭐⭐ | ⭐ | Нет | Выборка в стиле jQuery | Веб-разработчиков, коротких скриптов |
| Requests-HTML | Python | ⭐⭐⭐⭐ | ⭐⭐ | Нет | Быстрые скрипты, рендеринг JS | Новичков, небольших проектов |
| MechanicalSoup | Python | ⭐⭐⭐⭐ | ⭐⭐ | Нет | Автоматизация форм, логины | Простых браузерных задач |
| Puppeteer | Node.js | ⭐⭐⭐ | ⭐⭐⭐⭐⭐ | Нет | Сайты с тяжёлым JS, автоматизация | JS-разработчиков, динамического веб-скрейпинга |
| Jsoup | Java | ⭐⭐⭐⭐ | ⭐ | Нет | HTML-парсинг в Java | Java-команд, backend-воркфлоу |
Как выбрать подходящую библиотеку для веб-скрейпинга в вашем бизнесе
Что такое data scraping и как это делать в 2025 году Get Started Free
Итак, какую библиотеку выбрать? Вот мой совет, основанный на годах проб, ошибок и слишком большом количестве ночных дебаг-сессий:
- Нетехнические пользователи или бизнес-команды: начните с Thunderbit. Подход AI/no-code позволяет получить результат за минуты, а не за дни. Если вашей команде просто нужны данные в Excel или Sheets, не усложняйте процесс.
- Python-разработчики: Beautiful Soup и Requests-HTML отлично подходят для небольших задач. Для крупных проектов ваш друг — Scrapy. При необходимости комбинируйте его с lxml или PyQuery для дополнительной мощности.
- Нужно работать с логинами или динамическим контентом? Selenium (мульти-языковый) или Puppeteer (Node.js) — лучшие варианты.
- Команды на Java: Jsoup — очевидный победитель для интеграции скрейпинга в Java-приложения.
- Нужно автоматизировать формы или простые сценарии? MechanicalSoup лёгкий и удобный в использовании.
Ключевые факторы, которые стоит учитывать:
- Уровень технической подготовки: no-code инструменты вроде Thunderbit идеально подходят для нетехнических команд. Разработчики, наоборот, часто предпочитают гибкость библиотек на коде.
- Сложность данных: для простых статических страниц отлично подойдут Beautiful Soup или Jsoup. Для динамических сайтов с JavaScript выбирайте Selenium или Puppeteer.
- Масштаб: Scrapy и lxml особенно хороши для крупных и быстрых задач.
- Интеграция: прямой экспорт Thunderbit в Sheets, Notion и Airtable экономит массу времени в бизнес-процессах.
Больше о выборе подходящего инструмента можно прочитать в гиде PromptCloud).
Посмотреть цены Thunderbit и бесплатный тариф
Заключение: открывайте веб-данные с правильными инструментами
В 2026 году веб-скрейпинг — это уже не только для программистов и дата-сайентистов. На фоне роста AI-инструментов и решений без кода каждая команда — от продаж до исследований — может использовать веб как источник ценных данных. Правильно выбранная библиотека способна сэкономить вам сотни часов в год (Browsercat), повысить точность и дать вашему бизнесу реальное конкурентное преимущество.
Мой совет? Начните с ваших задач — скорость, масштаб, уровень технического комфорта — и протестируйте несколько вариантов. Бесплатный тариф Thunderbit — отличный способ начать, а open-source библиотеки вроде Beautiful Soup или Scrapy всегда подойдут, если хочется погрузиться глубже и всё настроить вручную.
Хотите узнать больше? Загляните в блог Thunderbit за дополнительными гайдами или подпишитесь на наш YouTube-канал с практическими туториалами.
Удачного скрейпинга — и пусть ваши данные всегда будут чистыми, структурированными и готовыми к работе.
Попробуйте Thunderbit AI Web Scraper бесплатно Get Started Free
FAQ
1. Какая библиотека для веб-скрейпинга в 2026 году самая простая для нетехнических пользователей?
Thunderbit — лучший выбор для тех, кто не пишет код. Его AI-расширение для Chrome позволяет собирать данные с помощью запросов на естественном языке — без программирования.
2. Какая библиотека лучше всего подходит для сайтов с тяжёлым JavaScript или динамическим контентом?
Puppeteer (Node.js) и Selenium (мульти-языковый) лучше всего подходят для динамических сайтов, где контент рендерится JavaScript. Они автоматизируют реальные браузеры и справляются со сложными взаимодействиями.
3. В чём разница между Beautiful Soup и Scrapy?
Beautiful Soup отлично подходит для парсинга и извлечения данных с отдельных страниц или небольших проектов, особенно если HTML неаккуратный. Scrapy — это полноценный фреймворк для создания масштабируемых краулеров и обработки больших массивов данных.
4. Можно ли напрямую экспортировать собранные данные в Google Sheets или Notion?
Да — Thunderbit поддерживает прямой экспорт в Google Sheets, Notion, Airtable и Excel. В большинстве кодовых библиотек экспорт нужно реализовывать вручную.
5. Как выбрать подходящую библиотеку для веб-скрейпинга для моего бизнеса?
Учитывайте уровень технической подготовки, сложность сайтов, объём данных и требования к интеграции. No-code инструменты вроде Thunderbit идеальны для бизнес-команд, а разработчики часто выбирают Scrapy, Beautiful Soup или Puppeteer ради большего контроля.
Узнать больше
- Топ-10 Python-библиотек для веб-скрейпинга и альтернатива на базе AI
- 7 самых популярных инструментов для веб-скрейпинга в 2026 году
- Топ-5 лучших программ для сбора веб-данных в 2026 году
- Лучшие инструменты и софт для веб-скрейпинга в 2025 году
- Как эффективно собирать данные с сайтов с помощью лучших инструментов



