
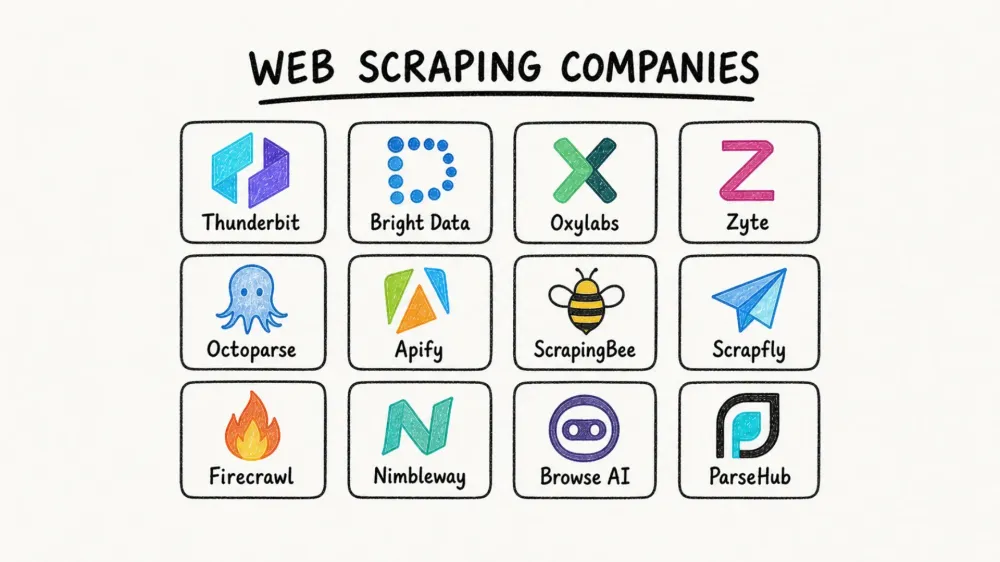
Рынок веб-скрейпинга достиг $754 млн в 2024 году и, по прогнозам, вырастет до $2,87 млрд к 2034 году. Но большинство покупателей по-прежнему с первой попытки выбирают не того поставщика.
Это неудивительно. «Компания по веб-скрейпингу» — слишком широкий термин: под ним может скрываться как Chrome Extension, который ты ставишь за 10 секунд, так и многомиллионный корпоративный конвейер данных. Если добавить к этому непрозрачные страницы с ценами, постоянные поломки парсеров (один пользователь Reddit сообщил, что 10–15% скрейперов ломаются каждую неделю), а также сотни поставщиков, каждый из которых утверждает, что «собирает данные с любого сайта», путаница становится вполне объяснимой.
Я работаю в команде Thunderbit Official Website, поэтому каждый день вижу, какие вопросы задают покупатели перед тем, как принять решение, и какое разочарование они приносят из прошлых инструментов, которые переставали работать сразу после обновления структуры сайта. Это руководство — тот самый материал, которого мне не хватало, когда я только начинал изучать рынок: 12 компаний, три чёткие категории, реальные цены на 2026 год, единая сравнительная таблица и практичная схема выбора.
Почему в 2026 году так важно выбрать правильную компанию по веб-скрейпингу
Веб-скрейпинг давно перестал быть побочным проектом для разработчиков. Сегодня это бизнес-инструмент для ценовой аналитики, лидогенерации, маркетинговых исследований, агрегации контента и всё чаще — для AI- и LLM-конвейеров. Market.us относит 25,8% рынка веб-скрейпинга только к мониторингу цен и динамическому ценообразованию. Mordor Intelligence оценивает рынок в 2026 году в $1,17 млрд, при этом сегмент мониторинга цен и конкурентов растёт с CAGR 19,23%. У этих двух аналитических компаний разные методики, поэтому цифры не совпадают — воспринимай их как ориентир масштаба, а не как точное значение.
Преимущества можно измерить. В кейсах поставщиков приводятся конкретные цифры: Zyte сообщает об экономии 25% времени разработки на одного spider для одного глобального ритейлера. В кейсе Apify по лидогенерации говорится о сокращении более чем на 40 часов ручной работы на каждый цикл кампании.
Но проблемы тоже повторяются одинаково:
- Скрейперы постоянно ломаются, когда целевые сайты меняют дизайн или добавляют антибот-защиту.
- Стоимость становится непредсказуемой на больших объёмах, особенно в моделях с оплатой за использование.
- Многие инструменты по-прежнему предполагают наличие времени у разработчиков, которого у большинства бизнес-команд просто нет.
Самая дорогая ошибка — выбрать не только не того поставщика, но и не тот класс решения. Команда продаж, которая подпишется на API, рассчитанный на разработчиков, потеряет недели, прежде чем поймёт, что ей нужен no-code-инструмент. Инженерная команда, выбравшая конструктор с интерфейсом «кликни и готово», упрётся в лимиты по объёму уже через месяц. Сначала выбирают категорию. Потом — поставщика.
Три типа компаний по веб-скрейпингу и почему это важно
Прежде чем сравнивать отдельные сервисы, нужно понять три модели работы, которые скрываются под одним названием «компания по веб-скрейпингу». Путаница между ними — главная причина разочарования покупателей.
| Категория | Что вы получаете | Для кого подходит | Примеры из этого списка |
|---|---|---|---|
| Полный сервис / managed scraping | Поставщик сам строит и поддерживает скрейперы; вы получаете чистые структурированные данные | Команды без разработчиков или со сложными, крупными по объёму задачами | Bright Data (datasets), Zyte, Nimbleway |
| Scraping API и инфраструктура | Вы отправляете запрос в API; поставщик берёт на себя прокси, рендеринг и антибот-защиту | Разработчики, которым нужен контроль без управления инфраструктурой | ScrapingBee, Scrapfly, Oxylabs, Firecrawl, Apify |
| No-code / браузерные инструменты | Интерфейс с кликами мышью; минимум кода или вообще без кода | Бизнес-пользователи в продажах, e-commerce, маркетинге, недвижимости | Thunderbit, Octoparse, Browse AI, ParseHub |
Компании полного цикла / Managed Web Scraping
Эти поставщики берут на себя весь пайплайн. Вы описываете, какие данные вам нужны, а они занимаются извлечением, антибот-защитой, рендерингом, поддержкой и доставкой результата. Компромисс простой: меньше всего забот с вашей стороны, но самая высокая цена. Если у вашей команды нет времени разработчиков и нужны данные с сильно защищённых сайтов на больших объёмах, это та категория, с которой стоит начать.
Поставщики Scraping API и инфраструктуры
Вы отправляете URL или задачу в конечную точку API. В ответ получаете отрендеренный HTML, структурированные данные или скриншоты — а прокси, браузерный рендеринг, повторные попытки и обход CAPTCHA остаются на стороне сервиса. Но интеграционный код, логика парсинга и последующие рабочие процессы по-прежнему остаются вашей ответственностью. Компромисс: средняя стоимость, средняя или высокая сложность поддержки и полный контроль над пайплайном.
No-Code / браузерные инструменты для веб-скрейпинга
Эти инструменты создаются для операционных команд, а не для инженеров. Обычно это расширение для браузера, визуальный конструктор сценариев или интерфейс с AI-подсказками, который быстро выдаёт структурированные данные. Компромисс: старт максимально быстрый, но по объёму такие решения обычно уступают API-first-поставщикам.
Thunderbit уверенно относится именно к этой третьей категории. Вы открываете страницу, нажимаете один раз, и AI сам понимает, что нужно извлечь, после чего заполняет таблицу без дополнительных действий. Смысл в том, чтобы за пару минут провести менеджера по продажам или e-commerce-аналитику от страницы до таблицы — с бесплатным экспортом в Excel, Google Sheets, Airtable и Notion.
Попробовать AI Web Scraper от Thunderbit
Как мы оценивали лучшие компании по веб-скрейпингу
Мы применили одни и те же семь критериев ко всем 12 поставщикам.
| Критерий | Почему это важно |
|---|---|
| Тип компании (full-service / API / no-code / extension) | Определяет, кто на самом деле выполняет работу |
| Антибот-защита и работа с прокси | Главная техническая боль: блокировки обычно отнимают больше времени, чем сам парсинг |
| Сложность поддержки | Скрейперы ломаются; ключевой вопрос — кто их чинит |
| Прозрачность цен (реальная стоимость тарифов 2026 года, наличие free tier) | «Свяжитесь с отделом продаж» — это не ответ |
| Удобство no-code | Большая часть покупателей — не технари |
| Форматы экспорта и интеграции | Совместимость результата определяет весь последующий workflow |
| Метка best-for use case | Помогает быстро сопоставить поставщика с задачей |
Эти критерии напрямую отражают то, на что жалуются пользователи в открытых сообществах. В обсуждении на Hacker News в 2025 году спорили о том, что API — это контракт, а скрейпинг по своей природе хрупок. На GitHub в треде Firecrawl с названием «All scraping engines failed!» наглядно показано, что даже современные AI-friendly инструменты всё равно сталкиваются с пограничными случаями.
1. Thunderbit
 Thunderbit — это AI-ориентированное Chrome Extension для пользователей без технической подготовки, которым нужны структурированные данные с сайтов, PDF и изображений без написания кода и без ручного управления селекторами.
Категория: no-code / браузерный инструмент с опциональным API
Основной сценарий работы: откройте любую страницу → нажмите один раз → AI сам определит, какие поля извлечь, и доведёт процесс до готовой таблицы. Если вам нужны конкретные поля, опишите их простыми словами — и он использует именно их. Для большинства задач этого достаточно.
Ключевые возможности:
- Автоопределение полей: распознаёт столбцы данных на странице и извлекает их без какой-либо настройки с вашей стороны.
- Скрейпинг подстраниц: переходит на каждую страницу детали и обогащает основную таблицу — без ручной настройки.
- Плановый скрейпинг: просто опишите интервал обычным языком; система будет запускаться по расписанию в облаке.
- Режим браузера и облака: браузерный режим подходит для страниц с авторизацией, облачный — для скорости (по 50 страниц за раз).
- Бесплатные извлекатели email, телефонов и изображений: полезно для лидогенерации без дополнительных инструментов.
- Бесплатный экспорт: Excel, Google Sheets, Airtable, Notion, CSV, JSON — без доплаты за выгрузку.
Антибот-защита и поддержка: AI каждый раз заново читает страницу при новом запуске, автоматически подстраиваясь под изменения вёрстки. Это убирает самый частый источник поломок для бизнес-пользователей, работающих с разными и нестабильными сайтами. Это не «совсем без поддержки» (такого не бывает), но именно тот сценарий отказа, который больше всего раздражает нетехнические команды.
Цены: бесплатный план (6 страниц в месяц) плюс 7-дневный доступ к Pro-функциям. Starter — $15 в месяц или $9 в месяц при оплате за год. Pro — $38 в месяц или $24 в месяц при годовой оплате. Business — по запросу. Web Scraper API от Thunderbit оплачивается отдельно: от $29 в месяц ($16 в месяц при годовой оплате), при этом на старте даётся 600 бесплатных юнитов. Кредиты считаются по строкам результата: 1 за строку, 2, если строка получена со подстраницы, и 30 за каждый запрос на обогащение персональных данных. Актуальные детали см. на странице Thunderbit Pricing.
Вариант для разработчиков: Thunderbit Open API включает Distill endpoint (веб-страница → Markdown) и Extract endpoint (веб-страница → структурированный JSON по схеме).
Лучше всего подходит для: отделов продаж (лидогенерация из каталогов), e-commerce-операций (мониторинг цен, скрейпинг SKU конкурентов), риелторов (данные по объявлениям), маркетологов и операционных команд, которым нужны структурированные веб-данные без помощи инженеров.
Ограничения: не лучший выбор для enterprise-мониторинга SERP на 100K+ страниц и для сайтов с жёсткой антибот-защитой — для этого в списке есть прокси- и API-поставщики. Потолок по объёму ниже, чем у специализированных API-инфраструктурных решений.
2. Bright Data
 Bright Data — одна из самых широких платформ веб-данных в мире: она объединяет огромную proxy-сеть, scraper API, Web Scraper IDE и готовые наборы данных.
Категория: гибрид — managed service + API-инфраструктура
Ключевые возможности:
- Сеть из 400M+ IP-прокси (residential, datacenter, mobile, ISP)
- Web Scraper API, Web Unlocker, браузерная IDE для скрейпинга
- 350+ datasets и 437+ готовых скрейперов
- Инфраструктура для enterprise-доставки и compliance
Антибот-защита и поддержка: справляется с Cloudflare, CAPTCHA и JS-рендерингом на больших объёмах. Управляемые datasets полностью снимают необходимость в поддержке.
Цены: Web Scraper API — $1.5 за 1K records по модели pay-as-you-go, тариф Scale — $499 в месяц. Стоимость прокси на больших объёмах может быстро расти — бюджет нужно контролировать очень внимательно.
Лучше всего подходит для: крупных компаний со сложными и объёмными задачами по сбору данных и соответствующим бюджетом.
Ограничения: высокий порог входа для нетехнических пользователей. Сложная структура цен и риск резкого роста расходов при масштабировании.
3. Oxylabs
 Oxylabs — это премиальный поставщик прокси и scraping-инфраструктуры с одной из крупнейших IP-баз в индустрии.
Категория: Scraping API + proxy-инфраструктура
Ключевые возможности:
- Residential и datacenter-прокси с расширенным геотаргетингом
- Web Scraper API, SERP Scraper API, E-commerce Scraper API
- AI Web Scraping API / OxyCopilot для более качественного парсинга
- Бесплатный тест до 2,000 результатов
Антибот-защита и поддержка: надёжный обход блокировок для высокообъёмного, сильно завязанного на IP скрейпинга. Хорошо подходит для повторяющегося извлечения данных на масштабе.
Цены: Web Scraper API — от $49 в месяц. Пакеты прокси и дополнительные IP-пулы могут заметно увеличить общую стоимость.
Лучше всего подходит для: команд разработчиков, которым нужна надёжная proxy-инфраструктура для регулярного извлечения больших объёмов данных — особенно SERP и продуктовой аналитики.
Ограничения: нет по-настоящему no-code-сценария для бизнес-пользователей. Общая стоимость растёт, когда добавляются прокси и более сложные сценарии.
4. Zyte
 Zyte был основан создателями open-source-фреймворка Scrapy и сочетает AI-помогающие scraping API с хостингом Scrapy Cloud и managed extraction-сервисами.
Категория: гибрид — API + managed service
Ключевые возможности:
- Zyte API с AI-поддержкой автоматического извлечения
- Scrapy Cloud для развёртывания и управления spiders
- Умное управление прокси и встроенный браузерный рендеринг
- Управляемое извлечение Zyte Data для корпоративных клиентов
Антибот-защита и поддержка: встроенная умная ротация прокси и AI-функции помогают уменьшить необходимость ручного обслуживания селекторов.
Цены: стартовый кредит $5. Цены Zyte API зависят от использования. Scrapy Cloud — от $9 за unit в месяц.
Лучше всего подходит для: команд на Python/Scrapy, которым нужен управляемый облачный окружение с AI-поддержкой извлечения.
Ограничения: выше порог входа для неразработчиков. История с no-code заметно слабее, чем у браузерных инструментов.
5. Octoparse
 Octoparse — один из самых известных no-code-брендов в веб-скрейпинге, построенный вокруг визуального конструктора с интерфейсом «кликни и готово».
Категория: no-code-инструмент
Ключевые возможности:
- Визуальный конструктор рабочих процессов с drag-and-drop логикой
- Desktop-приложение плюс облачное плановое выполнение
- Поддержка пагинации, бесконечной прокрутки и страниц с авторизацией
- Готовые шаблоны для популярных сайтов
- Экспорт в CSV, Excel, JSON, HTML и XML
Антибот-защита и поддержка: встроенная обработка CAPTCHA и облачный скрейпинг с ротацией IP. Но при изменении структуры сайта пользователю всё равно приходится обновлять workflow.
Цены: бесплатный forever-план (10 задач, 50,000 экспортированных строк в месяц). Standard — $83 в месяц или $69 в месяц при годовой оплате. Professional — $299 в месяц или $249 в месяц при годовой оплате. Enterprise — по запросу.
Лучше всего подходит для: маркетологов, исследователей и e-commerce-команд, которым нужен визуальный скрейпинг без кода.
Ограничения: нужно устанавливать desktop-приложение. Поддержка workflow по-прежнему ложится на пользователя, когда сайт меняет структуру, потому что сценарий работает на сохранённых селекторах, а не заново перечитывает страницу каждый раз.
6. Apify
 Apify — это не просто скрейпер, а целая платформа плюс маркетплейс. Именно поэтому он особенно силён там, где для нужного сайта уже существует готовый скрейпер.
Категория: API / платформа для разработчиков с маркетплейсом
Ключевые возможности:
- Actor marketplace с примерно 59,000 готовых скрейперов и автоматизаций (Apify Store, август 2026)
- Apify SDK для кастомных crawlers
- Интеграции с Zapier, Google Sheets, webhooks и API
- Управление прокси включено в тарифы платформы
Антибот-защита и поддержка: зависит от качества конкретного Actor. Официальные Actors поддерживаются хорошо; community Actors могут ломаться без предупреждения.
Цены: бесплатный план с кредитом $5. Starter — от $29 в месяц. Дополнительно оплачиваются compute credits по модели usage-based.
Лучше всего подходит для: команд, которым нужен готовый скрейпер для конкретного популярного сайта (Google Maps, Amazon, Instagram) без разработки с нуля.
Ограничения: качество community Actors сильно различается. Сложные или нишевые сайты всё равно требуют кастомной разработки. Для собственных скрейперов это не совсем no-code.
7. ScrapingBee
 ScrapingBee — один из самых аккуратных developer API в этой категории: он делает получение страницы, рендеринг и ротацию прокси настолько простыми, насколько это возможно для одного API-запроса. Сейчас он входит в группу Oxylabs и при этом остаётся отдельным продуктом — это полезно помнить, если ты сравниваешь оба решения.
Категория: Scraping API
Ключевые возможности:
- REST API с одним запросом (отправляешь URL, получаешь HTML или JSON)
- Встроенный рендеринг через headless Chrome
- Ротация residential и datacenter-прокси
- Google Search API и screenshot API
- Более новые опции для Markdown и AI-извлечения
Антибот-защита и поддержка: автоматически обрабатывает JS-рендеринг и ротацию прокси. Логика парсинга и проектирование схемы — на твоей стороне.
Цены: 1,000 бесплатных кредитов на trial. Тарифы — от $49 в месяц.
Лучше всего подходит для: разработчиков, которым нужен чистый и простой API для рендеринга и получения страниц, а затем они сами парсят данные.
Ограничения: основной продукт всё ещё ориентирован на получение страниц. Извлечение, структурирование и надёжность downstream-процессов остаются твоей задачей.
8. Scrapfly
 Scrapfly — самый явно антибот-ориентированный API в этом списке, созданный для разработчиков, которые работают с сильно защищёнными сайтами.
Категория: Scraping API
Ключевые возможности:
- Обход антибот-защиты для Cloudflare, DataDome, PerimeterX и похожих систем
- Рендеринг через headless browser
- Ротация residential-прокси
- Доставка через webhook, автоматические повторные попытки и снятие скриншотов
Антибот-защита и поддержка: специализируется на самых сложных для скрейпинга целях. Берёт на себя большую часть антибот-сложности. Но парсинг всё равно делаешь ты.
Цены: бесплатный тариф с 1,000 кредитов. Платные планы — от $30 в месяц.
Лучше всего подходит для: разработчиков, которые собирают данные с сайтов с агрессивной антибот-защитой и хотят высокий процент успешных запросов без собственного стека прокси и обхода блокировок.
Ограничения: сфокусирован на получении и рендеринге страниц — структурированное извлечение остаётся твоей ответственностью. Экосистема меньше, чем у Bright Data или Oxylabs.
9. Firecrawl
 Firecrawl создан для разработчиков, которым нужен чистый веб-контент для AI-рабочих процессов, а не просто сырой HTML.
Категория: Scraping API для AI / LLM-конвейеров
Ключевые возможности:
- Scrape и crawl endpoints
- Вывод в Markdown-first формате (специально для RAG и загрузки в LLM)
- Структурированное извлечение данных через LLM
- Режимы JS-рендеринга и прокси
- Удобный для batch-процессов workflow для agent-систем
Антибот-защита и поддержка: обрабатывает рендеринг и базовую антибот-защиту. Оптимизирован скорее под качество контента, чем под чистый объём.
Цены: 1,000 бесплатных кредитов в месяц. Hobby — $19 в месяц или $16 в месяц при годовой оплате. Standard — $99 в месяц или $83 в месяц при годовой оплате.
Лучше всего подходит для: AI/ML-команд и разработчиков, строящих RAG-конвейеры, базы знаний или приложения на базе LLM, которым нужен чистый веб-контент.
Ограничения: более новый продукт с меньшим набором функций, чем у enterprise-поставщиков. Не предназначен для высокообъёмного мониторинга e-commerce. Только для разработчиков — no-code-опции нет.
10. Nimbleway
 Nimbleway больше позиционируется как платформа доставки структурированных данных, чем как self-serve-инструмент для малого и среднего бизнеса.
Категория: Full-service / managed scraping с API-слоем
Ключевые возможности:
- Nimble Browser (облачный браузер для скрейпинга)
- API для структурированных данных в реальном времени для поиска, e-commerce и карт
- AI-парсинг и инфраструктура обхода блокировок
- Managed delivery pipeline
Антибот-защита и поддержка: полностью управляемый сервис. Nimbleway берёт на себя поддержку пайплайна, антибот-защиту и доставку данных.
Цены: pay-as-you-go — от $1 за 1,000 запросов для extract, crawl и map, и $3 за 1,000 для готовых шаблонов извлечения. Managed Data Services — от $2,500 в месяц при годовой оплате.
Лучше всего подходит для: средних и крупных компаний, которым нужны чистые структурированные данные без самостоятельного управления скрейперами.
Ограничения: для многих SMB-сценариев цена слишком высокая. Избыточно для простых или разовых задач по сбору данных.
11. Browse AI
 Browse AI особенно силён там, где workflow больше связан не с разовым извлечением, а с регулярным мониторингом и уведомлениями.
Категория: no-code-инструмент
Ключевые возможности:
- Обучение роботов через point-and-click
- Обнаружение изменений и мониторинг с алертами
- Интеграции с Google Sheets, Airtable, Zapier, webhook и API
- Массовое извлечение и повторяющиеся запуски по расписанию
Антибот-защита и поддержка: справляется с базовой антибот-защитой. При серьёзных изменениях структуры сайта роботов может потребоваться переобучить.
Цены: бесплатный forever-план (50 кредитов в месяц). Personal — $48 в месяц или $19 в месяц при годовой оплате. Professional — $87 в месяц или $69 в месяц при годовой оплате.
Лучше всего подходит для: бизнес-пользователей, которые отслеживают цены конкурентов, вакансии или наличие товаров с течением времени.
Ограничения: может испытывать трудности с сильно динамичными или JS-нагруженными сайтами. При изменении вёрстки требуется переобучение робота.
12. ParseHub
 ParseHub по-прежнему полезен для небольших проектов, студентов и команд, которые только начинают пробовать веб-скрейпинг.
Категория: no-code-инструмент
Ключевые возможности:
- Визуальное извлечение с помощью point-and-click
- Поддержка страниц с JS-рендерингом
- Вывод в CSV, JSON, Excel, API и webhook
- Понятный бесплатный тариф (5 проектов, 200 страниц за запуск)
Антибот-защита и поддержка: базовая обработка. Продвинутой proxy-инфраструктуры нет. Workflow может ломаться при изменении сайта.
Цены: бесплатный план доступен. Платные тарифы — от $189 в месяц.
Лучше всего подходит для: небольших бюджетных проектов или пользователей, которые хотят попробовать скрейпинг без вложений в инфраструктуру.
Ограничения: платная цена высока относительно глубины функциональности. Ощущается как более старый продукт по сравнению с AI-native-конкурентами. Медленнее и менее гибкий, чем современные cloud-first-решения.
Сравнение лучших компаний по веб-скрейпингу: сводная таблица
Все важное — в одном месте. Стартовые цены указаны как помесячная стоимость, а в скобках — годовая, если она доступна. В колонке «Free Tier?» значение «Yes» означает, что лимит обновляется или не истекает; «Trial» — это разовый лимит.
| Компания | Категория | Лучше всего для | Free Tier? | Стартовая цена | Модель оплаты | Антибот-защита | Нагрузка на поддержку | No-code? | Основные форматы экспорта |
|---|---|---|---|---|---|---|---|---|---|
| Thunderbit | No-code + API | Бизнес-команды, разные сайты | Yes (6 pages/mo) | $15/mo ($9/mo annual) | Кредиты за строку; API units | Средняя | 🟡 | Yes | Excel, Sheets, Airtable, Notion, CSV, JSON |
| Bright Data | Гибрид: managed + API | Корпоративный сбор данных на масштабе | Yes (5K records/mo) | $1.5/1K records or $499/mo | За результат, за запрос, dataset | Очень сильная | 🟢 datasets / 🟠 API | Частично | API outputs, dataset delivery |
| Oxylabs | API + proxy infra | Регулярное извлечение с активным использованием прокси | Trial | $49/mo | За результат + пакеты прокси | Очень сильная | 🟠 | No | API / user-defined |
| Zyte | Гибрид: managed + API | Команды на Scrapy/Python | Yes ($5 credit) | Usage-based; cloud $9/unit/mo | API по использованию + cloud | Сильная | 🟢 Zyte Data / 🟠 Zyte API | Ограниченно | CSV, JSON, XML, storage |
| Octoparse | No-code | Визуальные workflow для скрейпинга | Yes (10 tasks) | $83/mo ($69/mo annual) | Подписка + доп. опции | Средняя | 🟡 | Yes | CSV, Excel, JSON, HTML, XML |
| Apify | Платформа + маркетплейс | Готовые скрейперы под конкретные сайты | Yes | $29/mo | Подписка + usage + Actor | Хорошая (зависит от Actor) | 🟠 | Частично | Datasets, API, integrations |
| ScrapingBee | API | Простое рендеринг-извлечение и обход блокировок | Trial | $49/mo | Ежемесячные кредиты | Хорошая | 🟠 | No | HTML, Markdown, JSON |
| Scrapfly | API | Сложные цели с жёсткой антибот-защитой | Yes | $30/mo | Кредиты в месяц | Очень сильная | 🟠 | No | HTML, screenshots, JSON |
| Firecrawl | AI/LLM scraping API | Markdown и AI-конвейеры данных | Yes (1K credits/mo) | $19/mo ($16/mo annual) | По кредитам | Средняя-сильная | 🟠 | No | Markdown, HTML, JSON |
| Nimbleway | Managed + API | Структурированные корпоративные данные | Yes (5K requests/mo) | $1/1K requests or $2,500/mo managed | PAYG API + annual plans | Сильная | 🟢 managed / 🟠 API | No | Structured feeds, APIs |
| Browse AI | No-code | Мониторинг и оповещения об изменениях | Yes (50 credits/mo) | $48/mo ($19/mo annual) | Кредиты + лимиты | Базовая-средняя | 🟡 | Yes | Sheets, Airtable, Zapier, API |
| ParseHub | No-code | Небольшие бесплатные проекты | Yes (200 pages/run) | $189/mo | Тарифы по подписке | Базовая | 🟡 | Yes | CSV, JSON, Excel, API |
Шкала нагрузки на поддержку:
- 🟢 Минимальная: поставщик берёт на себя большую часть поддержки
- 🟡 Низкая-средняя: поставщик делает получение и парсинг, пользователь запускает workflow и чинит его, когда сайт меняется
- 🟠 Средне-высокая: поставщик отвечает за получение и обход блокировок, пользователь — за парсинг и интеграцию
- 🔴 Максимальная: пользователь отвечает почти за всё
Надёжность и поддержка: что ломается и кто это чинит
Этот раздел важнее любого сравнения функций.
Главная причина, по которой покупатели разочаровываются в поставщиках скрейпинга, — не то, что первый запуск не удался. Проблема в том, что ломается пятый, пятидесятый или пятисотый запуск — и кто-то из команды должен разбираться с последствиями.
| Уровень поддержки | Тип поставщика | Что делаете вы | Что делает поставщик |
|---|---|---|---|
| 🟢 Минимальный | Full-service (Bright Data datasets, Zyte managed, Nimbleway) | Требования и проверка результата | Скрейпинг, антибот-защита, изменения вёрстки, QA, доставка |
| 🟡 Низко-средний | No-code-инструменты (Thunderbit, Octoparse, Browse AI, ParseHub) | Запуск workflow, проверка результата и его перестройка, если инструмент опирается на сохранённые селекторы | Получение страниц, парсинг, хостинг, расписание |
| 🟠 Средне-высокий | Scraping APIs (ScrapingBee, Scrapfly, Oxylabs, Apify, Firecrawl) | Интеграционный код, парсинг, повторные попытки, проверка схемы | Прокси, рендеринг, часть слоя обхода блокировок |
| 🔴 Максимальный | DIY / open-source frameworks | Всё | Ничего |
No-code-инструменты находятся посередине. Ни один из них не убирает все возможные точки отказа, а решения, основанные на сохранённых селекторах, всё равно ломаются, когда страница полностью перестраивается. Именно с этой проблемой борется AI-first-подход: Thunderbit каждый раз заново читает страницу вместо того, чтобы опираться на фиксированные селекторы, которые пользователь должен поддерживать вручную. Для бизнес-пользователей, работающих с длинным хвостом нестабильных сайтов, это заметно проще в эксплуатации, чем традиционный визуальный конструктор.
Поставщики full-service всё ещё снимают с тебя больше всего операционной нагрузки. Но и стоят они дороже всех. Бесплатного обеда не бывает — ты всегда выбираешь, кто возьмёт на себя эту боль.
Реальные цены 2026 года: прозрачное сравнение стоимости
Большинство обзорных статей обходят этот раздел стороной. «Свяжитесь с отделом продаж» — это не прайс-лист. Ниже — реальные цифры. Те же принципы, что и в основной таблице, плюс колонка с затратами, которые не видны в рекламной цене.
| Компания | Free Tier? | Стартовая цена | Модель оплаты | Риски скрытых расходов |
|---|---|---|---|---|
| Thunderbit | Yes (6 pages/mo) | $15/mo ($9/mo annual) | Кредиты за строку | Строки со подстраниц стоят 2 кредита, enrichment-запросы — 30 |
| Bright Data | Yes (5K records/mo) | $1.5/1K records, or $499/mo on the Scale plan | За результат или за запрос | Стоимость прокси растёт на больших объёмах |
| Oxylabs | Trial (2,000 results) | $49/mo | За запрос + пакеты прокси | Доплаты за IP pool |
| Zyte | Yes ($5 credit) | Usage-based | API-использование + cloud units | Рендеринг и уровни сложности |
| Octoparse | Yes (10 tasks) | $83/mo ($69/mo annual) | Подписка + доплаты | Прокси, CAPTCHA и service add-ons |
| Apify | Yes ($5 credit) | $29/mo | Подписка + compute + Actor fees | Разброс по Actor и usage |
| ScrapingBee | Trial (1,000 credits) | $49/mo | По кредитам | Опции рендеринга расходуют больше кредитов |
| Scrapfly | Yes (1,000 credits) | $30/mo | По кредитам | Residential и расширенные режимы дороже |
| Firecrawl | Yes (1,000 credits/mo) | $19/mo ($16/mo annual) | По кредитам | Улучшенные прокси и более богатые режимы извлечения |
| Nimbleway | Yes (5K requests/mo) | $1/1K requests or $2,500/mo managed | API + annual plans | Managed-планы оплачиваются ежегодно |
| Browse AI | Yes (50 credits/mo) | $48/mo ($19/mo annual) | Кредиты + лимиты | Премиальные сайты и ограничения по сайтам |
| ParseHub | Yes (200 pages/run) | $189/mo | Тарифы по подписке | Цена понятна, но ценность на платных тарифах слабее |
Среди инструментов с фиксированной ежемесячной ценой самый дешёвый вход — у Thunderbit ($15) и Firecrawl ($19), следом идут Apify ($29) и Scrapfly ($30); Octoparse ($83) и ParseHub ($189) — самые дорогие варианты входа в no-code. Bright Data и Zyte считают по факту использования, поэтому небольшой пилотный проект может обойтись дешевле всех остальных. Bright Data, Oxylabs и Nimbleway имеют больше смысла, когда объём, сложность цели и enterprise-требования важнее простого бюджета.
Какая компания по веб-скрейпингу подойдёт именно вам: схема принятия решения
Используй этот порядок, чтобы быстро сузить выбор.
1. Какой у вас объём данных?
- Меньше 1,000 страниц в месяц → no-code-инструменты (Thunderbit, Browse AI, Octoparse, ParseHub)
- От 10K+ страниц в месяц → API-решения (Oxylabs, ScrapingBee, Apify, Scrapfly, Firecrawl)
- 100K+ страниц в месяц → enterprise managed (Bright Data, Nimbleway, Zyte Data)
2. Есть ли у вас разработчики в команде?
- Да → API-инструменты дадут больше контроля (Oxylabs, ScrapingBee, Apify, Scrapfly, Firecrawl, Zyte API)
- Нет → no-code (Thunderbit, Browse AI, Octoparse) или full-service (Bright Data datasets, Nimbleway)
3. Сколько у вас целевых сайтов?
- Несколько известных и стабильных сайтов → шаблоны и готовые Actors подойдут отлично
- Разные, длиннохвостые сайты, которые часто меняются → важна AI-адаптивность (здесь Thunderbit особенно силён)
4. Какой у вас потолок бюджета?
- До $50 в месяц → free tiers (Thunderbit, ParseHub, Apify, Scrapfly, Firecrawl)
- $50–$500 в месяц → mid-tier API и платные no-code-планы
- От $500+ в месяц → enterprise managed services
5. Разовая выгрузка или постоянный мониторинг?
- Постоянно → важна возможность запускать по расписанию (Thunderbit, Browse AI, Bright Data datasets)
- Разово → почти любой инструмент подойдёт; выбирай по скорости настройки
Краткий итог:
- Нетехническая команда, разные сайты, нет разработчиков → Thunderbit
- Разработчик строит data pipeline на масштабе → Oxylabs, ScrapingBee или Apify
- Хотите, чтобы всё сделали за вас → managed-сервисы Bright Data или Zyte
- Строите AI/LLM-конвейеры данных → Firecrawl или Thunderbit API
Реальные сценарии: какая компания по веб-скрейпингу подходит под какую задачу
Мониторинг цен в e-commerce
Для операционной команды, которая отслеживает цены конкурентов в Shopify-магазине, Thunderbit — самый быстрый путь. Открой страницу категории и нажми один раз. AI сам определит, какие поля нужно извлечь — обычно это название товара, цена, наличие и URL — и заполнит таблицу автоматически. Если нужны другие поля, просто опиши их одним предложением, и он использует их вместо стандартных. Затем запусти сбор по расписанию в cloud mode. Если нужно проверять ещё и страницы товаров, скрейпинг подстраниц автоматически обогатит таблицу. Экспортируй результат в Google Sheets и строй ценовой процесс уже там.
Bright Data решает ту же задачу с другой стороны. Вместо того чтобы самим запускать workflow, вы можете купить управляемый dataset по e-commerce или использовать enterprise-стек. Это более «hands-off» подход, но и профиль затрат у него совсем другой.
B2B-лидогенерация (email и телефонные номера)
Для небольших и средних проектов по поиску клиентов бесплатные извлекатели email и телефонов от Thunderbit полезны для публичных каталогов, локальных листингов и нишевых бизнес-сайтов. Главное преимущество — скорость: собрали список, экспортировали, загрузили в CRM без технической настройки.
Apify сильнее, когда источник — крупная популярная платформа с развитой экосистемой Actor. Если вам нужны лид-листы из Google Maps в большом объёме, готовый Actor позволит начать быстрее, чем разработка с нуля.
Мониторинг SERP на большом масштабе
Здесь важна честность. Thunderbit — не лучший вариант для 100K+ ежедневных SERP-запросов. На таком масштабе стоит смотреть в сторону Oxylabs SERP APIs, Bright Data SERP-продуктов или аналогичной enterprise-инфраструктуры, где важнее процент успешных запросов, качество IP и управление лимитами, чем простота интерфейса.
Передача scraped data в AI / LLM-конвейеры
Если ваша цель — превращать публичные страницы в чистый контент для RAG или agent-workflow, Firecrawl — очевидный кандидат в shortlist благодаря markdown-first-дизайну. Но Thunderbit тоже стоит сравнить: его Distill API преобразует веб-страницы в Markdown, а Extract API превращает страницы в структурированный JSON по схеме — то есть одна платформа может обслуживать и бизнес-скрейпинг через Chrome Extension, и developer-facing AI-конвейеры через API-слой. Подробнее о том, как Thunderbit помогает с AI data extraction for business, можно прочитать в нашем отдельном разборе.
Советы, как получить максимум от любой компании по веб-скрейпингу
- Начинай с free tier или trial, прежде чем выделять бюджет. У каждого поставщика из этого списка он есть.
- Сначала определите схему данных, потом собирайте. Сначала реши, какие поля, форматы и направления экспорта тебе нужны. Этот один шаг избавляет от большей части дальнейших проблем.
- Проверь на 50–100 страницах, чтобы оценить качество данных и процент успешных запусков до расчёта стоимости на масштабе.
- Заранее подтверди формат экспорта. Не каждый инструмент одинаково хорошо поддерживает все направления выгрузки. Если тебе нужен Airtable или Notion, проверь это до старта.
- Для повторяющихся задач планируй запуски по расписанию, а не полагайся на ручной ad-hoc-скрейпинг. Thunderbit, Browse AI, Octoparse и Bright Data это поддерживают.
- Следи за ухудшением качества со временем. Даже managed-сервисы могут деградировать, когда меняются целевые сайты.
- Разберись с расходом кредитов и лимитами, прежде чем масштабировать процесс. Модели с оплатой за использование могут резко подорожать, если не отслеживать потребление.
Ошибка новичков обычно не техническая. Она операционная. Команды начинают скрейпинг до того, как решат, каким должен быть итоговый формат и как будут использовать данные дальше. Если хочешь глубже разобраться в том, что такое data scraping и как это делать, у нас есть понятное руководство для начинающих.
Заключение
Правильный способ покупать в этом рынке такой: сначала выбери категорию, потом — конкретного поставщика.
Если тебе нужен кто-то, кто возьмёт на себя весь пайплайн, начни с managed-поставщиков вроде Bright Data, Zyte Data или Nimbleway. Если у тебя есть разработчики и тебе нужен прямой контроль над инфраструктурой, лучше подойдут API-решения вроде Oxylabs, ScrapingBee, Scrapfly, Apify и Firecrawl. Если тебе нужен быстрый путь для операторов и бизнес-пользователей, которые не пишут код, именно no-code-слой даёт наибольший эффект — и именно для этого Thunderbit и создавался.
Самые сильные варианты по сценариям:
- Самый быстрый старт для нетехнических команд: Thunderbit
- Самая мощная enterprise-инфраструктура: Bright Data или Oxylabs
- Лучший developer API по простоте: ScrapingBee
- Лучший вариант для AI/LLM-конвейеров: Firecrawl или Thunderbit API
- Лучшая бесплатная опция для небольших проектов: ParseHub или free tier Apify
Для большинства нетехнических команд, которые собирают данные с разных сайтов, Thunderbit — самое практичное место для старта. Бесплатный план снижает риск, настройка минимальна, а AI-first workflow лучше соответствует реалиям поддержки в 2026 году, чем старые визуальные конструкторы скрейпинга. Попробуй Thunderbit Chrome Extension и посмотри, как далеко может завести один клик. А если хочешь сначала увидеть инструмент в работе, не устанавливая ничего, на Thunderbit YouTube Channel есть пошаговые разборы самых популярных сценариев.
Попробовать Thunderbit AI Web Scraper Get Started Free
FAQ
1. В чём разница между компанией по веб-скрейпингу и инструментом для веб-скрейпинга?
Компания по веб-скрейпингу может предоставлять полный сервис — инфраструктуру, поддержку, обслуживание и доставку данных. Инструмент для веб-скрейпинга — это софт, которым ты управляешь сам. Некоторые поставщики (например, Bright Data и Zyte) работают в обеих моделях. Другие, например Thunderbit, в первую очередь являются инструментами, но с опциональным API-слоем для разработчиков.
2. Законно ли пользоваться компаниями по веб-скрейпингу?
Сбор общедоступных данных во многих юрисдикциях в целом законен, но детали зависят от сайта, типа собираемых данных и местного законодательства. Всегда соблюдай Terms of Service, robots.txt и законы о защите данных, такие как GDPR и CCPA. Надёжные поставщики закладывают вопросы комплаенса в свои платформы. Подробнее см. наше руководство о юридических аспектах веб-скрейпинга.
3. Сколько стоят компании по веб-скрейпингу в 2026 году?
Рынок охватывает всё: от бесплатных планов и стартовых тарифов дешевле $50 в месяц до enterprise-managed-сервисов, которые начинаются примерно с $500 в месяц и могут стоить значительно дороже. Thunderbit, ParseHub и Apify предлагают бесплатные тарифы. Mid-range API вроде ScrapingBee и Scrapfly стартуют с $30–$49 в месяц. Enterprise-поставщики начинаются выше: Scale plan у Bright Data стоит $499 в месяц, а managed-планы Nimbleway — от $2,500 в месяц.
4. Можно ли пользоваться компанией по веб-скрейпингу без кода?
Да. No-code-инструменты вроде Thunderbit, Octoparse, Browse AI и ParseHub созданы для нетехнических пользователей. Thunderbit вообще не требует программирования: установи Chrome Extension, открой страницу и нажми один раз — AI сам поймёт, какие поля извлечь, и закончит работу. Можно даже просто описать нужные данные обычным языком. Данные сразу попадут в твою таблицу или базу.
5. Какая компания по веб-скрейпингу лучше всего подходит для малого бизнеса?
Thunderbit — самый сильный базовый выбор для малого бизнеса, которому нужны структурированные данные с разных сайтов без помощи разработчиков. Бесплатный план и модель оплаты по строкам позволяют легко начать и несложно прогнозировать расходы, когда ты примерно понимаешь, сколько строк тебе нужно. Apify тоже хорош, если для нужного сайта уже есть готовый Actor, а ParseHub подходит для небольших проектов на бесплатном тарифе с низким объёмом.
Подробнее



