
В прошлом месяце у знакомого Stripe-интеграция тихо начала отдавать 503 в 11 вечера в пятницу. Никто этого не заметил до утра субботы — а к тому моменту в саппорт уже прилетело больше 200 злых писем от клиентов, у которых не прошли оплаты.
Такая история — совсем не редкость. По широко цитируемой оценке средний простой обходится в $5,600 в минуту, а крупные инциденты могут приносить убытки в миллионы в час. Точная сумма зависит от трафика, конверсии, среднего чека, SLA и стоимости восстановления, но вывод тут простой: неотслеживаемые API — это уже не просто головная боль для инженеров, а прямой бизнес-риск. И если сейчас компании в среднем используют 131 сторонний API, а только 16% говорят, что хорошо умеют снижать риски третьих сторон, то мониторинг уже давно не опция. В этом гайде я хотел сделать то, чего обычно не хватает в других обзорах: сгруппировать инструменты по вашему сценарию, оценить качество алертов, а не просто их наличие, показать реальные цены на 2026 год и сравнить, как быстро можно стартовать. Не просто очередной сухой список логотипов.
И ещё один важный момент: если ваша работа с API связана со сбором веб-данных, подачей их в LLM, построением RAG-систем, мониторингом страниц конкурентов или извлечением цен и карточек товаров с сайтов, разговор про "API-инструменты" не должен ограничиваться только uptime-мониторингом. Вам нужен надёжный способ превращать неструктурированные веб-страницы в структурированные данные. Именно здесь Thunderbit Open API вписывается в этот гайд: это не мониторинг доступности, зато один из самых быстрых способов превращать сайты в чистый Markdown или JSON по схеме через API.
Что такое мониторинг API и почему он важен для команды?
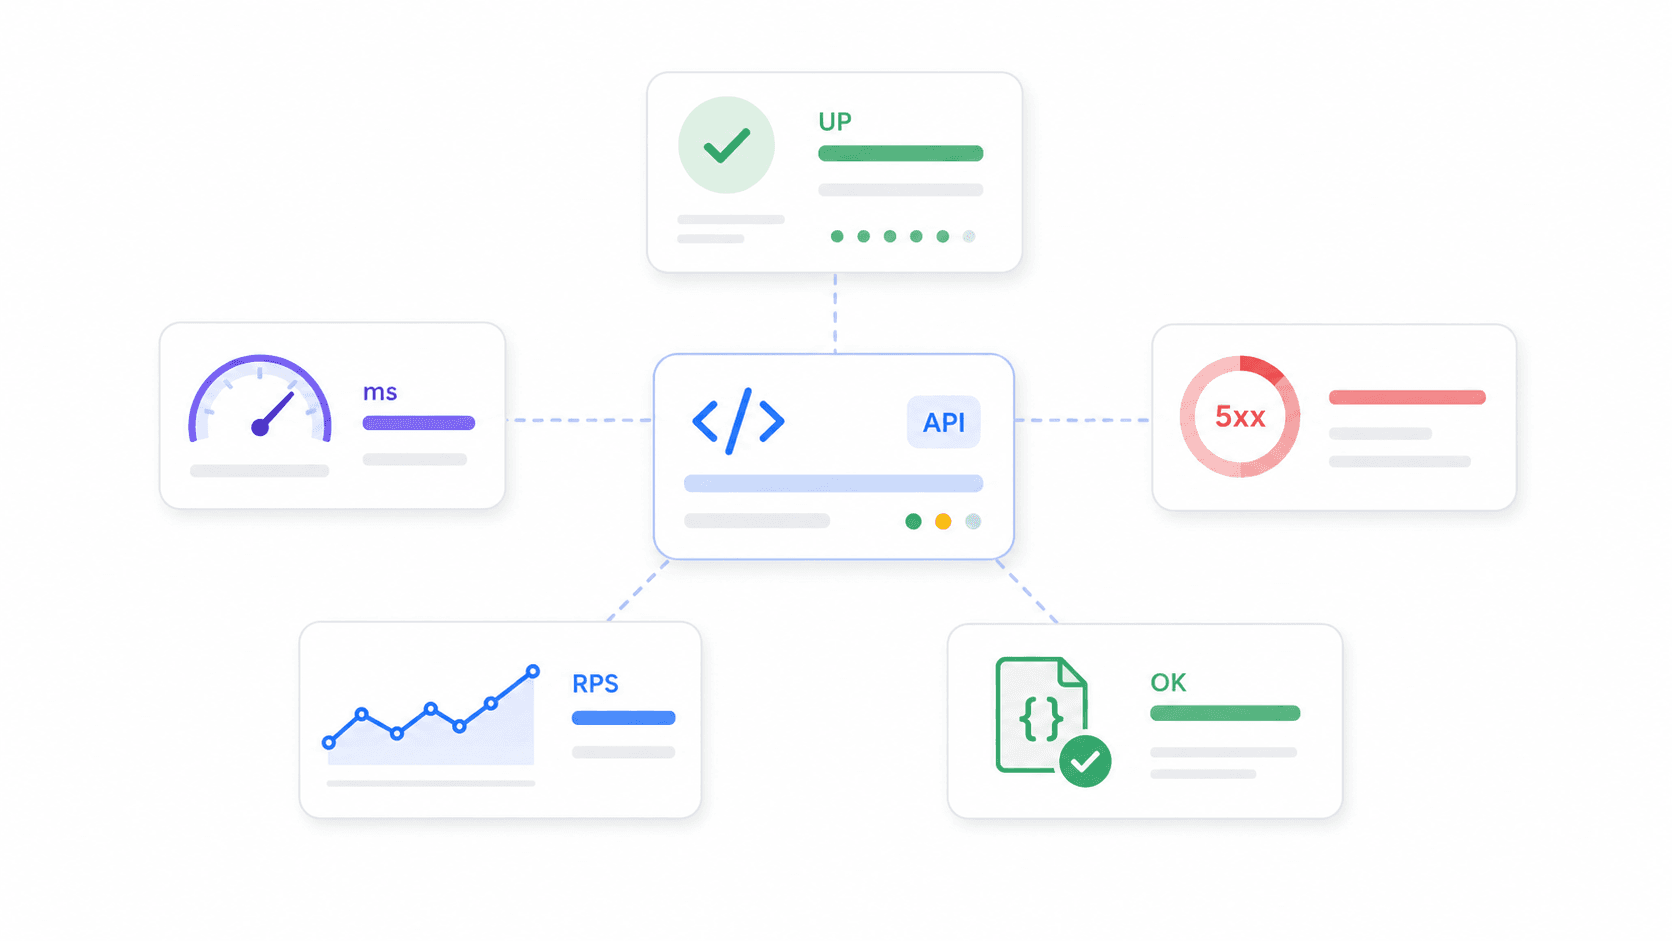
Мониторинг API — это постоянная проверка того, что ваши endpoint'ы доступны, отвечают быстро и возвращают корректные данные. Причём не только в духе "сервер жив или нет". Хороший мониторинг проверяет HTTP-коды, содержимое ответа, задержку, SSL-сертификаты, многошаговые сценарии вроде login → search → checkout и даже корректность схемы данных.
Это не то же самое, что общий мониторинг сайта, который просто проверяет загрузку страницы, и не совсем APM (Application Performance Monitoring), который уходит глубже — в трассировки кода, запросы к базе и внутренности runtime. Мониторинг API находится на границе: он проверяет то, что реально видят пользователи, партнёры и интеграции, когда обращаются к вашим endpoint'ам.
Есть и смежная категория, которую тоже стоит выделить: API для веб-данных. Они не мониторят здоровье вашего собственного API, а помогают продукту или процессу стабильно собирать внешние данные из интернета. Например, Thunderbit Open API может преобразовать веб-страницу в чистый Markdown, извлечь структурированные поля в JSON и прогонять пакетные задания по множеству URL. Если ваш "API"-проект зависит от свежих данных поставщиков, карточек товаров, публичных каталогов, страниц документации или исследовательских источников, такой API для извлечения данных может быть не менее важным, чем сам uptime-чек.
Почему это должно волновать не только инженеров? Потому что на API приходится 71% динамического веб-трафика и 62% специалистов по API говорят, что API напрямую приносят доход. Когда падает платёжный шлюз, сервис авторизации или API доставки, это не абстрактная инфраструктурная проблема — это потерянная выручка, сорванные партнёрские обязательства, рост обращений в поддержку и подорванное доверие. В игре участвуют продакты, продажи, операционные команды и customer success.
Ключевые метрики, за которыми стоит следить:
- Uptime percentage: доля времени, когда endpoint доступен
- Response time / latency: сколько времени endpoint отвечает (среднее, p95, p99)
- Error rate: доля запросов с 5xx, таймаутами или проваленными проверками
- Throughput: число запросов в секунду или в минуту
- Correctness: возвращает ли API ожидаемые данные, а не просто 200 OK
Как мы выбирали лучшие инструменты мониторинга API на 2026 год
Большинство статей про "лучшие инструменты для мониторинга API" просто перечисляют названия и фичи. Я хотел подойти к отбору более вдумчиво — в том числе потому, что провёл немало времени, читая форумы разработчиков, а ещё потому, что команда Thunderbit помогла мне массово извлечь данные о ценах и возможностях с сайтов вендоров, чтобы собрать по-настоящему сравнимую таблицу (об этом пайплайне позже).
Вот какие критерии мы взвешивали:
| Критерий | Почему это важно |
|---|---|
| Простота запуска / время до первого алерта | Маленьким командам нужно покрытие уже сегодня, а не после запуска большого платформенного проекта |
| Интеллект алертов и снижение шума | Если алерты шумные, команды их игнорируют и пропускают реальные инциденты |
| Щедрость free tier | Пет-проекты и ранние стартапы часто стартуют бесплатно |
| Прозрачность цен | Счета за observability легко раздуваются за счёт хостов, пользователей, логов, synthetic-run'ов и ingest'а данных |
| Ширина интеграций | Алерты должны приходить туда, где команда уже работает (Slack, PagerDuty и т. д.) |
| Масштабируемость и глубина данных | Зрелым командам нужны traces, логи, APM, RBAC, SSO, хранение истории |
| Качество сообщества и поддержки | Open-source-командам важна частота релизов; enterprise-командам — SLA |
| Возможность извлечения веб-данных | AI-приложения, RAG-процессы и инструменты для исследования рынка часто нуждаются не просто в uptime, а в чистых внешних данных |
Мы также разделили рекомендации по сценариям — solo dev, стартап, e-commerce/SaaS, enterprise, open-source-пурист, команда продукта с API и команда веб-данных/AI-приложений — чтобы вы могли сразу перейти к своему контексту, а не читать 14 обзоров и гадать, что из этого вам подходит. Исследование Grafana за 2025 год показало, что 46% респондентов называют важной совместимость с другими системами и 35% — простоту будущего перехода на другую платформу, так что это не просто "приятные плюшки".
Лучшие инструменты мониторинга API по сценариям: таблица для быстрого выбора
Это короткий путь. Найдите свой сценарий, а затем переходите к разделам с инструментами ниже за подробностями.
| Сценарий | Рекомендуемые инструменты | Ключевое отличие |
|---|---|---|
| Команды веб-данных / AI-приложений | Thunderbit Open API, Moesif, Apitally | Превращают сайты в чистый Markdown или структурированный JSON для LLM, RAG, ценовых и исследовательских сценариев |
| Solo dev / pet project | UptimeRobot, Uptime Kuma, Gatus | Бесплатно или self-hosted, минимум настроек, быстрый запуск |
| Стартап (команда 5–15 человек) | Checkly, Better Stack, Postman | Умные алерты, быстрый старт, доступная цена, status pages |
| E-commerce / SaaS | Datadog, New Relic, Moesif, Checkly | Бизнес-метрики, APM/tracing, глубокие SDK, многошаговые synthetics |
| Enterprise / multi-cloud | Datadog, New Relic, Splunk, Grafana Cloud | Распределённые трассировки, compliance, hybrid, RBAC/SSO |
| Open-source-пуристы | Prometheus + Grafana, Uptime Kuma, Gatus, Uptrace | Полный контроль, native OpenTelemetry, отсутствие vendor lock-in |
| Команды API-продуктов | Moesif, Apitally, New Relic | Использование по клиентам, тренды endpoint'ов, алерты по аномалиям |
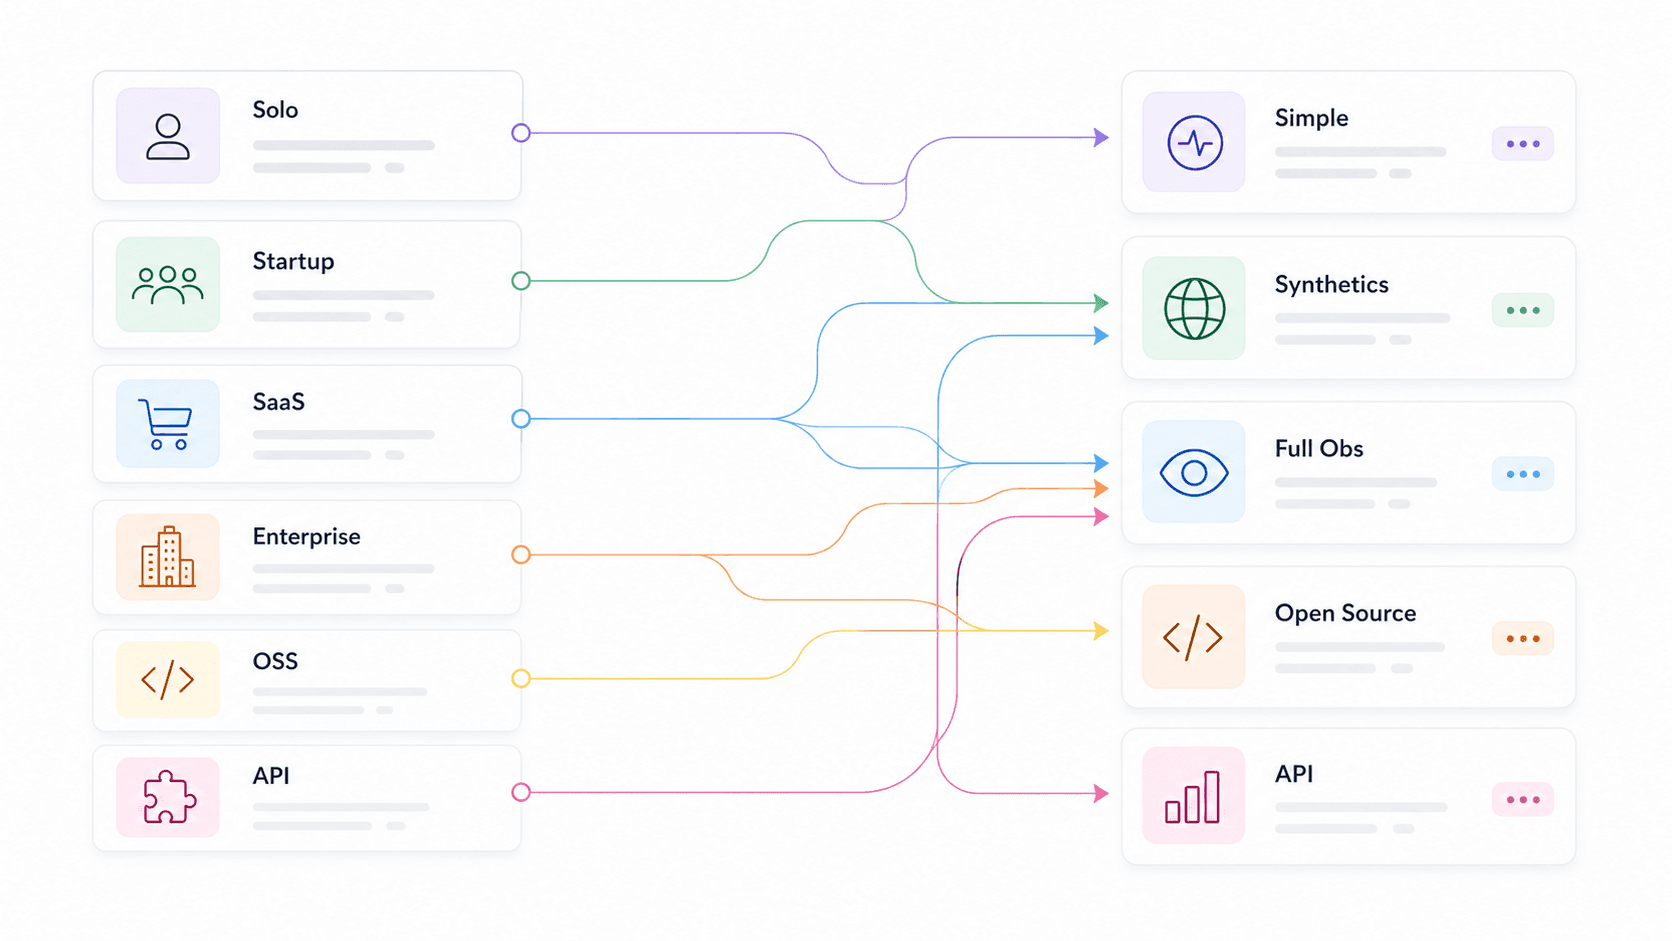
Главный паттерн такой: самые быстрые в запуске инструменты обычно слабее в аналитике, а самые глубокие платформы требуют больше настройки и дисциплины в расходах. Это не недостаток, а компромисс, который важно понимать. Thunderbit находится немного в другой категории: он особенно хорош тогда, когда задача — превратить веб-страницы в данные, готовые для API, а не поднимать инженеров среди ночи из-за простоя.
Thunderbit Open API: лучший вариант для превращения сайтов в структурированные API-данные
Начните разработку с Thunderbit Open API Преобразуйте страницы в Markdown, извлекайте структурированный JSON и обрабатывайте URL пакетно без поддержки собственной scraping-инфраструктуры. Get Started Free
Thunderbit Open API — это API, который я бы поставил первым для команд, чьи процессы мониторинга или исследования завязаны на внешние веб-данные. Это не классический uptime-мониторинг вроде Checkly или UptimeRobot. Вместо этого Thunderbit превращает любую веб-страницу в чистые, структурированные данные, которые реально можно использовать в приложениях, агентах, дашбордах и LLM-пайплайнах.
У API есть три базовых сценария. Distill превращает страницу в аккуратный Markdown, готовый для LLM. Extract получает схему и возвращает структурированный JSON с полями вроде названия товара, цены, наличия, размера компании, стадии раунда или рейтинга отзывов. Batch позволяет асинхронно обработать до 100 URL с помощью webhooks — это удобно, если вы мониторите страницы с ценами, каталоги конкурентов, документацию поставщиков, новостные источники или большие исследовательские списки.
Почему он вообще попал в гайд по API-инструментам? Потому что команды часто недооценивают, сколько инфраструктуры требует задача "просто вытащи данные со страницы". Сайты на тяжёлом JavaScript требуют рендеринга. Некоторые страницы нуждаются в гео-рутировании. HTML нужно очистить от меню, рекламы, модалок и шаблонного мусора, прежде чем он станет полезен для LLM. Селекторы ломаются, когда меняется верстка. Ротация прокси, антибот-защита, ретраи, очереди и опрос результатов могут превратить небольшой workflow в полноценный проект по поддержке инфраструктуры. Thunderbit берёт на себя большую часть этой работы через один API.
Лучше всего подходит для: создателей AI-приложений, RAG-команд, e-commerce ops, sales ops, growth-команд, market research и разработчиков, которым нужны веб-данные через API без сборки и сопровождения scraping-стека.
Цена: Бесплатно: 600 одноразовых API units, включая до 600 Distill-страниц или 30 Extract-страниц, с 2 одновременными запросами. Starter — $16/мес при годовой оплате, включает 60,000 API units в год и 30 одновременных запросов. Pro — $40/мес при годовой оплате, включает 600,000 API units в год и 50 одновременных запросов.
Скорость запуска: около 5–15 минут, чтобы получить API-ключ и отправить первый Distill или Extract запрос через cURL, SDK или Thunderbit CLI.
Минусы: Thunderbit не заменит Datadog, New Relic, Better Stack или Checkly для uptime-проверок, эскалации инцидентов, traces, логов или on-call маршрутизации. Думайте о нём как об API для сбора и структурирования веб-данных — включая цены вендоров, документацию, страницы конкурентов, карточки товаров или открытые датасеты — а не как о системе, которая будит on-call-инженера.
Datadog: лучший вариант для полной observability-системы
Datadog — это инструмент, который я постоянно вижу в enterprise- и mid-market SaaS-стеке, и это неудивительно. Это не просто мониторинг API, а полноценная observability-платформа, которая связывает synthetic API-тесты, распределённые трассировки, логи, метрики инфраструктуры и RUM в едином окне.
Если говорить именно про API-мониторинг, Datadog поддерживает HTTP, SSL, DNS, WebSocket, TCP, UDP, ICMP, gRPC и многошаговые API-тесты. Его мониторы аномалий обучаются на ожидаемых паттернах и сигналят об отклонениях, а не просто о статическом пороге — это заметно лучше, чем "алерт, если latency > 500ms". Есть ещё forecast-мониторы, которые прогнозируют, когда метрика пересечёт порог, и composite-мониторы, комбинирующие несколько условий.
Лучше всего подходит для: e-commerce, SaaS и enterprise-команд, которым нужен единый обзор API, инфраструктуры, логов и трассировок.
Цена: детали free tier зависят от продукта. Infrastructure Pro начинается с $15/host/мес; synthetic API-тесты — $5 за 10,000 запусков. 800+ интеграций.
Скорость запуска: около 15–30 минут на установку агента и базовый synthetic-тест.
Минусы: при масштабе может стать дорогим — "bill shock" регулярно обсуждают на Hacker News и Reddit. Огромное количество SKU (хосты, логи, кастомные метрики, synthetics, пользователи) означает, что за счетом должен кто-то следить не меньше, чем за дашбордами. У всей платформы ощутимая кривая обучения.
Checkly: лучший вариант для разработчиков, которым нужны synthetic-проверки
Checkly — это инструмент, который я бы отдал стартап-команде, если им важно держать API-проверки рядом с кодом. Его основная идея — "мониторинг как код": вы описываете API- и browser-check'и программно, запускаете их из глобальных локаций, интегрируете с CI/CD и управляете всем через Git.
Сильная сторона здесь — качество алертов. Логика повторных попыток в Checkly прямо описана как "первая линия защиты" от ложных срабатываний: можно настроить фиксированные, линейные или экспоненциальные повторы, повторные попытки из той же или другой локации, а также максимальную длительность ретраев до срабатывания алерта. Платформа также различает состояния degraded, failed и recovered, что помогает уменьшить шум от лишних уведомлений.
Лучше всего подходит для: стартапов и dev-команд, которым нужны программируемые API-check'и, browser-check'и на базе Playwright, CI/CD-интеграция и быстрый старт.
Цена: по свежим публичным данным есть free plan с 10 uptime monitors, 1,000 browser checks и 10,000 API checks. Starter — примерно $24/мес при годовой оплате, но перед покупкой проверьте актуальную страницу цен.
Скорость запуска: около 10–20 минут до первого API-check и канала алертов.
Минусы: инструмент сфокусирован на synthetic-проверках. Он не заменяет глубокий APM, аналитику логов или распределённые трассировки. Если нужно сопоставить падение API с узким местом в базе данных, понадобится ещё один инструмент рядом.
UptimeRobot: лучший вариант для простого и недорогого отслеживания доступности
UptimeRobot — это Honda Civic в мире API-мониторинга. Он делает одну вещь хорошо: вы создаёте HTTP, keyword, ping, port, SSL или heartbeat-монитор, задаёте интервал и получаете уведомление, когда что-то ломается. И всё.
Лучше всего подходит для: solo dev, маленьких команд, агентств и всех, кому нужен базовый контроль доступности и задержки без лишней сложности.
Цена: Бесплатно: 50 monitors, интервалы 5 минут. Платный Solo — около $7/мес при годовой оплате. Для бесплатного плана карта не нужна. Скорость запуска: около 2–5 минут — самый быстрый вариант в этом списке.
Минусы: ограниченный интеллект алертов. Есть только базовые пороги, нет детекции аномалий, распределённых трассировок и глубокой аналитики. Если вам важно понять почему endpoint тормозит, а не только что он тормозит, UptimeRobot этого не даст.
Uptime Kuma: лучший бесплатный self-hosted инструмент для мониторинга API
Uptime Kuma — любимец сообщества self-hosting, и цифры GitHub это подтверждают: 86,637 звёзд, 7,831 fork'ов, 1,060 контрибьюторов, а к маю 2026 актуален релиз 2.3.2. Проект под лицензией MIT, поддерживает HTTP(s), keyword, JSON query, WebSocket, TCP, ping, DNS, push, Docker, несколько status pages и более 90 сервисов уведомлений.
Лучше всего подходит для: solo dev и команд, которым нужен полный контроль, приватность и нулевые регулярные SaaS-расходы — если у вас есть сервер.
Цена: бесплатно. Реальная стоимость — это ваш VM/контейнер, бэкапы, обновления и забота о том, чтобы сам монитор был доступен. Скорость запуска: около 5–15 минут с Docker для базовой проверки; 15–30 минут для доводки уведомлений и status page.
Минусы: обслуживать всё придётся вам. И здесь есть критический подвох: если вы хостите Uptime Kuma на той же инфраструктуре, которую он мониторит, сбой облака или DNS уронит и приложение, и сам монитор. Размещайте его внешне или используйте вместе с SaaS-проверкой.
Better Stack: лучший вариант для быстрого реагирования на инциденты
Better Stack (пользователи по-прежнему часто называют его Better Uptime) объединяет мониторинг доступности, incident management, on-call расписание, policies эскалации и status pages в одной платформе. Сильнее всего он не как аналитический инструмент, а как инструмент рабочего процесса инцидентов, встроенный поверх мониторинга.
Политики эскалации определяют, кого и в каком порядке уведомлять, с какими задержками, пока инцидент не будет подтверждён. Маршрутизация по метаданным отправляет инциденты в зависимости от критичности или владельца. Есть интеграции со Slack, Teams, webhooks и Zapier.
Лучше всего подходит для: стартапов и команд среднего размера, которым нужен мониторинг + реагирование на инциденты + status pages без сборки трёх отдельных инструментов.
Цена: бесплатный план: 10 monitors/heartbeats, 1 status page. Team — около $29/мес при годовой оплате. Скорость запуска: около 5–10 минут через GUI-мастер.
Минусы: меньше глубины в аналитике API-пэйлоадов, распределённых трассировках и анализе бизнес-KPI по сравнению с Datadog, New Relic или Moesif.
Prometheus + Grafana: лучший open-source стек для мониторинга API
Это индустриальный стандарт среди open-source-комбинаций. Prometheus собирает и хранит временные ряды метрик. Grafana (73,705 звёзд на GitHub, 3,010 контрибьюторов) отвечает за дашборды и алерты. Alertmanager управляет маршрутизацией, группировкой, дедупликацией, тишиной уведомлений и подавлением. Для проверок endpoint'ов API команды добавляют Blackbox Exporter для HTTP, HTTPS, DNS, TCP, ICMP и gRPC-проверок.
Лучше всего подходит для: open-source-пуристов, Kubernetes/SRE-команд и организаций, которые уже стандартизировались на метриках Prometheus.
Цена: бесплатно при self-hosting. Grafana Cloud предлагает free tier (100k API test executions в месяц) и платные планы по usage-based модели.
Скорость запуска: 1–4 часа для базовой связки Blackbox + Prometheus + Grafana + Alertmanager. Дни — для production HA и тонкой настройки алертов.
Минусы: PromQL, YAML, relabeling, дизайн дашбордов, хранение, storage, HA и настройка алертов — это реальная операционная работа. Типичный компромисс: меньше интерфейса, больше YAML. Это стек для команд, которые уже мыслят метриками и хотят единый control plane, а не для тех, кто хочет поднять мониторинг до обеда.
New Relic: лучший вариант для SaaS application performance
New Relic объединяет APM, мониторинг инфраструктуры, логи, распределённые трассировки, synthetic-мониторинг, алерты, дашборды и AI-помощь в анализе инцидентов. Его free tier — 100 GB ingest'а данных в месяц и 1 full platform user — действительно щедрый для небольших команд.
Сильнее всего New Relic проявляет себя в части интеллектуальных алертов и борьбы с fatigue. Его incident intelligence включает корреляцию событий, детекцию аномалий, predictive alerts, root-cause analysis и подавление flapping'а. New Relic приводил пример, где 97.2% эффективности подавления flapping означает только 28 всплывающих проблем на 1,000 flapping-инцидентов — это уже конкретная цифра по снижению шума.
Лучше всего подходит для: SaaS-команд и e-commerce-платформ, которым нужен API-мониторинг, тесно связанный с трассировками на уровне приложения, ошибками, throughput и влиянием на пользователей.
Цена: бесплатно: 100 GB/мес, 1 full user. Платные планы используют тарификацию по пользователям и объёму данных.
Скорость запуска: около 15–30 минут на установку агента и guided setup.
Минусы: на масштабе ценообразование становится сложным. Настройка алертов требует привыкания — платформа мощная, но не сразу очевидная.
Moesif: лучший вариант для API-аналитики и бизнес-метрик
Moesif — это не классический uptime-монитор. Это API-аналитика и product intelligence: понимание того, как API используют клиенты, endpoint'ы, когорты, компании, география, SDK, тарифы и поведение. Если ваш вопрос звучит как "какой клиент пострадал?", а не "упал ли endpoint?", Moesif как раз для этого.
Он поддерживает статические пороговые алерты и динамические алерты на аномалии для метрик API вроде всплесков/падений трафика, задержек и изменений поведения. Динамическим алертам нужно несколько дней истории API-поведения, чтобы построить модель, но после обучения они ловят изменения, которые статические правила часто пропускают.
Лучше всего подходит для: команд API-продуктов, SaaS-компаний и e-commerce-платформ, которым важно связать производительность API с выручкой, вовлечённостью и удержанием.
Цена: есть бесплатный/триальный вариант; платные планы масштабируются по объёму API events. Точные self-service-цены в моём исследовании не удалось полностью вытащить — проверьте актуальную страницу.
Скорость запуска: около 20–45 минут (интеграция через SDK/proxy/gateway глубже, чем внешний ping).
Минусы: больше ориентирован на аналитику, чем на классический uptime-мониторинг. Скорее всего, его стоит сочетать с Checkly, UptimeRobot или Datadog synthetics для внешней проверки доступности.
Splunk: лучший вариант для enterprise-анализа логов и compliance
Splunk — это инструмент, к которому обращаются, когда агрегация логов, поиск, корреляция, auditability уровня compliance и поддержка hybrid/multi-cloud являются обязательными. Splunk Observability Cloud охватывает инфраструктуру, APM, synthetics, RUM, логи и реагирование на инциденты. ITSI/Event Analytics может группировать значимые события в эпизоды и уменьшать шум между разными мониторинговыми островками.
Собственное исследование Splunk по observability за 2025 год звучит тревожно: 73% специалистов ITOps/engineering сообщили о простоях из-за проигнорированных или подавленных алертов, 59% столкнулись с проблемой слишком большого числа разрозненных инструментов, а 52% — с ложными алертами.
Лучше всего подходит для: enterprise- и multi-cloud-команд с жёсткими требованиями к compliance, безопасности, аудиту и поиску по логам.
Цена: usage-based и обычно по запросу. Простого бесплатного production-плана нет.
Скорость запуска: облачный онбординг может быть быстрее, но enterprise-внедрение часто занимает от нескольких дней до нескольких недель.
Минусы: дорого на масштабе. Сложная настройка. Избыточен для solo dev и маленьких стартапов.
Postman: лучший вариант для команд, которые уже тестируют API
Postman — прежде всего платформа для разработки и тестирования API, но его продукт мониторинга позволяет командам планировать запуск Postman collections из облачных локаций. Самый сильный аргумент — переиспользование: если у QA или dev-команды уже есть collections с assertions, превратить их в мониторинги — логичный следующий шаг.
Лучше всего подходит для: dev- и QA-команд, которые уже используют Postman collections и хотят плановые проверки без покупки отдельного synthetic-инструмента.
Цена: free tier есть. Перерасход по monitoring — $0.75 за 1,000 вызовов; доп. пакет на 50,000 вызовов — $20/мес. Проверьте актуальную страницу тарифов — упаковка планов у Postman меняется.
Скорость запуска: около 10 минут, если collections уже готовы.
Минусы: monitoring-сценарии проще, чем у специализированных инструментов вроде Checkly, Datadog или New Relic. Настройки алертов базовые.
Другие инструменты мониторинга API, на которые стоит обратить внимание
Gatus: лёгкий, self-hosted, конфиг-ориентированный health dashboard. 10,906 звёзд на GitHub, поддерживает HTTP, ICMP, TCP, DNS, метрики, дружелюбные к Prometheus, и uptime-badges. Отличный вариант для solo dev, которым нужно что-то проще Prometheus, но больше по духу configuration-as-code, чем UI Uptime Kuma.
Apitally: более новый инструмент, ориентированный на аналитику трафика API и контроль качества для стартапов. Заявляет настройку менее чем за 5 минут и кастомные алерты по 14 метрикам. Хорош для лёгкой API-аналитики без перехода на полноценную observability-платформу.
Sematext: full-stack мониторинг с логами, synthetics и видимостью инфраструктуры. Synthetics стоят примерно $2 за HTTP-monitor, $7 за browser-monitor, минимум $5/мес. Более бюджетная альтернатива Datadog для команд среднего рынка.
Uptrace: OpenTelemetry-native backend для APM, tracing, metrics и logs. 4,198 звёзд на GitHub. Это не чистый uptime-чекер, но отличный выбор для команд, которые стандартизируются на OTel и хотят open-source-friendly backend для трассировок.
Build vs. Buy: стоит ли делать мониторинг API своими руками?
"Может, просто написать скрипт, который пингует endpoint'ы, вместо того чтобы брать отдельный инструмент?"
Этот вопрос постоянно всплывает на форумах разработчиков. Я прочитал достаточно тредов на Reddit, чтобы увидеть закономерность: команды начинают с curl + cron, какое-то время это работает, а потом переходят на отдельный инструмент, когда им нужны дашборды, история, проверки из нескольких регионов, надёжная маршрутизация алертов или видимость между командами.
Честная матрица выбора:
| Фактор | Свой скрипт | Специализированный инструмент |
|---|---|---|
| Время на запуск | 1–4 часа (базово); дни (если делать надёжно) | 5–30 минут |
| Поддержка | Вы отвечаете за всё навсегда | Поставщик поддерживает обновления |
| Качество алертов | Базовое (up/down) | Умное (тренды latency, аномалии, ретраи) |
| Стоимость | Бесплатно (если не считать ваше время) | $0–$500+/мес |
| Дашборд | Делать с нуля | Готовый, настраиваемый |
| Лучше всего, когда… | ≤3 endpoint'ов, команда технарей, хобби-проект | 5+ endpoint'ов, ops/product-команда, на кону выручка |
Главный вывод из форумов такой: многие, кто делает всё сам, потом жалеют, когда им нужны дашборды, история или видимость между командами. Есть и мета-проблема — "мониторинг нужен ещё и для самого мониторинга". Self-hosted монитор, база данных, бэкапы, сеть и провайдер алертов тоже должны быть надёжными.
Делайте сами, если у вас 2 endpoint'а и вам нравится возиться с настройками. Покупайте готовое решение, если вам нужно выпускать продукт.
Та же логика работает и для извлечения веб-данных. Да, вы можете написать скрейпер, запускать headless-браузеры, ротировать прокси, поддерживать селекторы, чистить HTML и строить очередь. Но если задача — стабильно подавать веб-данные в API-продукт, AI-агента или исследовательский workflow, использовать Thunderbit Open API обычно быстрее, чем собирать собственную scraping-инфраструктуру.
Усталость от алертов: почему качество алертов важнее их количества
Пожалуй, это один из самых недооценённых критериев при выборе инструмента для мониторинга API. Alert fatigue возникает тогда, когда команды получают так много шумных, дублирующихся или бесполезных уведомлений, что перестают реагировать на них вообще — и потом пропускают реальные инциденты.
Цифры впечатляют. Отчёт BigPanda за 2025 год показывает, что медианная организация генерирует 2,350 алертов в день и 803,406 алертов в год. Медианная доля действительно actionable-инцидентов составляет лишь 18% — то есть менее одного из пяти инцидентов, пришедших из алертов, реально можно использовать. Исследование NeuBird за 2026 год показало, что 77% on-call команд получают минимум 10 алертов в день, а 80% считают, что половина или меньше из них — actionable.
Лучший инструмент мониторинга — тот, чьим алертам вы действительно доверяете. Вот как разные инструменты справляются с интеллектуальностью алертов:
| Инструмент | Тип алертов | Метод снижения шума | Каналы уведомлений |
|---|---|---|---|
| Datadog | ML anomaly, forecast, composite | Исторические bands аномалий, динамические baseline'ы, Watchdog AI | Slack, PagerDuty, Opsgenie, Teams, 20+ |
| Checkly | Threshold + based on degradation | Повторы до срабатывания, ретраи из той же/другой локации | Slack, PagerDuty, Opsgenie, Teams, incident.io |
| New Relic | AI-группировка проблем, anomaly, predictive | Корреляция событий, подавление flapping, контекст root cause | Slack, PagerDuty, Teams, webhooks |
| Moesif | Поведенческие аномалии | Динамические модели после нескольких дней поведения | Slack, PagerDuty, email, SMS |
| Better Stack | Uptime / incident / on-call | Политики эскалации, маршрутизация по владельцу, задержки | Slack, Teams, webhooks, Zapier |
| Prometheus + Alertmanager | Правила PromQL | Группировка, дедупликация, silencing, inhibition | Email, PagerDuty, Opsgenie, webhooks |
| Splunk | События, эпизоды, здоровье сервиса | ITSI Event Analytics, группировка эпизодов, тикетинг | Splunk On-Call, ServiceNow, webhooks |
| Thunderbit Open API | Не платформа для алертов | Используйте со своим scheduler, workflow-инструментом или мониторинг-стеком | Webhooks для batch-задач; алерты — через внешние системы |
Практический совет: начинайте с меньшего числа, но более надёжных алертов. Используйте повторы перед срабатыванием, подтверждение из нескольких регионов, SLO burn-rate alerts, дедупликацию и маршрутизацию по владельцам. Сигнализируйте о влиянии на пользователя и критических бизнес-процессах — сбой checkout, auth, payment 5xx — а не о каждом внутреннем симптоме.
Free tier и цены в 2026: что вы реально заплатите
Страницы с тарифами меняются. Free tier'ы сдвигаются. Скрытые расходы — хосты, seat'ы, логи, synthetic-run'ы, ingest данных — могут неприятно удивить. Это тот раздел, который, как мне кажется, должен быть в каждой статье про "лучшие инструменты". Срез на 2026 год:
| Инструмент | Free tier | Платно от | Нужна карта? | Лучший бесплатный сценарий |
|---|---|---|---|---|
| Thunderbit Open API | 600 одноразовых API units | ~$16/мес при годовой оплате | Нет | Извлечение веб-данных для LLM, RAG, цен и исследований |
| Uptime Kuma | Без ограничений (self-host) | — | Нет | Полноценный мониторинг на своём сервере |
| UptimeRobot | 50 monitors, интервалы 5 минут | ~$7/мес | Нет | Базовые uptime-проверки |
| Better Stack | 10 monitors, 1 status page | ~$29/мес | Нет | Uptime + status page для стартапа |
| Checkly | 10 uptime, 10k API checks | ~$24/мес | Да | Synthetic API-check'и |
| Postman | Бесплатный аккаунт + лимит на monitoring | ~$14/польз./мес | Нет | Переиспользование существующих collections |
| Prometheus + Grafana | Без ограничений (self-host) | — | Нет | Метрики + визуализация |
| Grafana Cloud | 100k API test executions/мес | $29/мес платформа + usage | Проверить | Managed synthetics для теста |
| New Relic | 100 GB/мес, 1 full user | По пользователям + данным | Для некоторых планов | APM + базовая observability |
| Datadog | Trial / зависит от продукта | $15/host/мес (Infra Pro) | Часто да | Оценка full-stack |
| Moesif | Есть free/trial | По объёму | Проверить | Оценка API-аналитики |
| Splunk | Есть trial | По запросу | Через sales | Enterprise proof of concept |
| Gatus | Без ограничений (self-host) | — | Нет | YAML-driven status dashboard |
| Apitally | Есть free/trial | Проверить | Проверить | Лёгкая API-аналитика |
| Sematext | Trial/free — зависит от продукта | ~$2 за HTTP-monitor | Проверить | Дешёвые synthetics и логи |
| Uptrace | Бесплатно при self-hosted | Облачные планы зависят | Проверить | Оценка OTel APM |
О скрытых расходах: self-hosted-инструменты (Uptime Kuma, Prometheus, Gatus) бесплатны по лицензии, но небольшой VM, бэкапы, время на поддержку и внешнее резервирование могут быстро стать реальной стоимостью. Для API для веб-данных скрытые расходы обычно другие: поддержка headless-браузеров, сломанные селекторы, пулы прокси, обход антибот-защиты и очистка HTML.
Оценка для небольшой команды: для 10 API endpoint'ов и 3 участников команды самый дешёвый SaaS-путь — это обычно UptimeRobot free или недорогой paid, Better Stack free/Team либо Checkly, если укладываетесь в объём выполнения. Datadog и New Relic могут быть вполне доступными для оценки, но реальный счёт зависит от хостов, пользователей, логов, traces и количества synthetic-запусков. Если вашему проекту нужны веб-данные через API, бесплатных API units в Thunderbit обычно достаточно, чтобы протестировать рабочий процесс до перехода на платный план.
Сравнение сложности настройки: как быстро получить первый алерт
Я не нашёл ни одной статьи у конкурентов, которая честно сравнивала бы time-to-value — то есть сколько времени проходит от регистрации до первого значимого алерта. Для небольших команд это часто важнее, чем глубина функций.
| Инструмент | Время до первого алерта | Нужный уровень навыка | Подход к настройке |
|---|---|---|---|
| Thunderbit Open API | ~5–15 минут | Низкий–средний | API-ключ, cURL/SDK/CLI |
| UptimeRobot | ~2–5 минут | Низкий | GUI, добавление в пару кликов |
| Better Stack | ~5–10 минут | Низкий | GUI-мастер |
| Checkly | ~10–20 минут | Низкий–средний | Код или GUI |
| Postman | ~10 минут (если collections уже есть) | Низкий–средний | Планировщик collections |
| Uptime Kuma | ~5–30 минут | Средний | Docker + GUI |
| Gatus | ~15–45 минут | Средний | YAML + Docker |
| Datadog | ~15–30 минут | Средний | Установка агента + GUI |
| New Relic | ~15–30 минут | Средний | Агент + guided setup |
| Moesif | ~20–45 минут | Средний | SDK/proxy-интеграция |
| Grafana Cloud Synthetics | ~15–45 минут | Средний | GUI, Terraform опционально |
| Prometheus + Grafana | 1–4 часа | Средний–высокий | YAML, PromQL |
| Uptrace | 30–90 минут | Средний–высокий | Интеграция OTel SDK |
| Splunk | От часов до недель | Высокий | Enterprise onboarding |
Если мониторинг должен заработать к концу дня, начинайте с верхней половины таблицы. Если цель — надёжная observability-платформа, закладывайте отдельный проект для нижней половины. А если ваша первая задача — "получить чистые данные со 100 веб-страниц в приложение", начните с Thunderbit до того, как строить собственную scraping-инфраструктуру.
Сравнение лучших инструментов мониторинга API: полный side-by-side
Одна таблица для быстрого просмотра перед решением:
| Инструмент | Лучший сценарий | Free tier | Интеллект алертов | Время настройки | Хостинг | Главная фича |
|---|---|---|---|---|---|---|
| Thunderbit Open API | Извлечение веб-данных / API data pipelines | 600 API units | Не инструмент алертов | 5–15 мин | Cloud | Превращает страницы в Markdown или извлекает JSON по схеме |
| Datadog | Full-stack для enterprise/SaaS | Trial/зависит | Anomaly, forecast, AI | 15–30 мин | Cloud | Связывает synthetics с логами/трассировками/инфрой |
| Checkly | Dev-first synthetics | Щедрый, по числу checks | Ретрай, degraded-сигналы | 10–20 мин | Cloud | Monitoring as code + Playwright |
| UptimeRobot | Простой uptime | 50 monitors | Базовые пороги | 2–5 мин | Cloud | Самый быстрый дешёвый базовый монитор |
| Uptime Kuma | Бесплатный self-hosted | Без ограничений | Базовый status/threshold | 5–30 мин | Self-hosted | Чистый UI, без SaaS-платы |
| Better Stack | Реагирование на инциденты / status pages | 10 monitors | Эскалации, маршрутизация | 5–10 мин | Cloud | Мониторинг + on-call + status page |
| Prometheus + Grafana | Open-source метрики | Без ограничений (self-host) | Группировка Alertmanager | 1–4 ч | Self-hosted/cloud | Глубина экосистемы PromQL |
| New Relic | SaaS APM + API checks | 100 GB/мес, 1 user | AI grouping, suppression flapping'а | 15–30 мин | Cloud | Сильная связка APM + synthetics |
| Moesif | API-аналитика / бизнес-метрики | Free/trial | Поведенческие аномалии | 20–45 мин | Cloud | Аналитика поведения API по клиентам |
| Splunk | Enterprise-логи / compliance | Trial | ITSI episodes, AIOps | От дней | Cloud/self-managed | Поиск по enterprise-логам и governance |
| Postman | Команды, которые уже тестируют API | Бесплатный аккаунт | Базовые alerts | 10 мин | Cloud | Переиспользование API test collections |
Как Thunderbit может ускорить оценку API-инструментов
Полное раскрытие: Thunderbit — это не инструмент мониторинга API. Это агентный веб-скрейпер и Open API для превращения веб-страниц в чистый Markdown или структурированный JSON. Но именно поэтому он полезен на другой стадии выбора monitoring-инструмента: когда вам нужно собрать цены вендоров, лимиты тарифов, обещания по функциям, детали документации и список интеграций ещё до выбора платформы.
Вместо того чтобы вручную открывать 10+ страниц с тарифами, копировать названия планов, лимиты monitors, интервалы проверок, интеграции и требования к карте в таблицу, мы использовали Thunderbit Chrome Extension, чтобы извлечь структурированные данные со страниц цен и возможностей каждого инструмента. AI Thunderbit читает страницу, предлагает поля — название плана, детали free tier, цену, поддерживаемые интеграции — и затем структурирует результат в таблицу для экспорта.
Для developer-workflow у Thunderbit Open API та же идея, но программно. Используйте Distill, когда нужен чистый Markdown для LLM или RAG. Используйте Extract, когда требуются конкретные поля в JSON. Используйте Batch, когда нужно обработать список страниц с тарифами, документации, карточек продукта или страниц конкурентов и получить результаты асинхронно.
Пайплайн выглядит так:
- Откройте страницу с тарифами вендора (Datadog, Checkly, UptimeRobot и т. д.)
- Нажмите "One Click Extract" — AI Thunderbit считывает страницу, понимает её структуру и заполняет таблицу за один проход
- Используйте subpage scraping, чтобы пройтись по страницам тарифов, возможностей и документации
- Экспортируйте в Google Sheets, Excel, Airtable, Notion или CSV
Для API-first команд workflow ещё прямее:
- Получите бесплатный API-ключ в Thunderbit
- Вызовите endpoint Distill, чтобы получить чистый Markdown из любой публичной страницы
- Вызовите endpoint Extract со схемой, чтобы получить структурированный JSON
- Используйте Batch endpoints и webhooks для больших списков URL
- Отправьте результат в приложение, таблицу, warehouse, vector database или monitoring-workflow
Для сравнения 10+ вендоров ручной copy-paste легко занимает 2–3 часа, если учитывать подстраницы с тарифами, документацию и страницы интеграций. Thunderbit сократил первую фазу извлечения примерно до 15–30 минут, а остальное время ушло на проверку и принятие решений. Если ваша ops-, procurement-, research- или AI-продуктовая команда выбирает инструменты под давлением сроков, это очень практичный shortcut. Подробнее об этом подходе можно посмотреть в нашем гайде web scraping without coding, изучить цены Thunderbit API или заглянуть на наш YouTube-канал за walkthrough'ами.
Как выбрать лучший инструмент мониторинга API для своей команды
"Лучший" инструмент мониторинга API зависит от размера команды, технической глубины, бюджета и того, как выглядит сбой в вашем продукте.
Solo dev не нужен Splunk. Регулируемому enterprise нельзя полагаться на cron-job. Команде API-продукта может быть нужнее клиентская аналитика в стиле Moesif, чем простые uptime-пинги. E-commerce-команде стоит в первую очередь проверять критические сценарии: login, search, add-to-cart, checkout и авторизацию платежа. Команде AI- или data-продукта может сначала понадобиться веб-извлечение в стиле Thunderbit, а уже потом полноценная observability.
Три принципа, которые подтвердились во всех моих исследованиях:
- Подбирайте инструмент под конкретный сценарий. Таблица быстрого выбора в начале — именно для этого.
- Ставьте качество алертов выше их количества. Если команда игнорирует уведомления, у вас нет мониторинга. У вас шум.
- Не недооценивайте скорость запуска. Монитор, который уже сегодня даёт надёжные алерты, лучше, чем идеальный план платформы, из-за которого checkout ещё месяц остаётся без контроля.
Если вы сравниваете несколько инструментов одновременно и хотите ускорить исследование, попробуйте Thunderbit для массового извлечения данных в одну таблицу. Если вы строите API-продукт, RAG-пайплайн, AI-агента или market intelligence workflow, которому нужны чистые веб-данные, начните с Thunderbit Open API. Он не выберет за вас инструмент мониторинга — но поможет прийти к решению быстрее и заодно даст вашему собственному продукту надёжный слой веб-данных.
FAQ о лучших инструментах мониторинга API
Какой бесплатный инструмент мониторинга API лучший в 2026 году?
Если нужна простота SaaS, UptimeRobot предлагает 50 бесплатных мониторов с интервалом 5 минут и без необходимости вводить карту. Если нужен self-hosted-контроль, Uptime Kuma — open-source, без лимитов и с понятным UI плюс 90+ сервисов уведомлений. Для команд, которым важна глубина метрик и у которых уже есть техническая экспертиза, лучший open-source-стек — Prometheus + Grafana + Alertmanager, хотя настройка займёт часы, а не минуты.
Если ваша задача — не uptime-мониторинг, а извлечение веб-данных через API, Thunderbit Open API предлагает бесплатный tier с 600 одноразовых API units, чего достаточно, чтобы протестировать превращение страницы в Markdown или извлечение JSON по схеме до масштабирования.
В чём разница между мониторингом API и APM?
Мониторинг API проверяет доступность endpoint'ов, время ответа, ошибки и корректность снаружи — то есть моделирует то, что видит пользователь или интеграция. APM (Application Performance Monitoring) идёт глубже внутрь приложения: трассировки уровня кода, запросы к базе данных, ошибки runtime, задержки очередей и зависимости сервисов. Такие инструменты, как Datadog и New Relic, предлагают и то и другое; UptimeRobot и Uptime Kuma сосредоточены на внешних uptime-проверках.
Thunderbit Open API отличается и от того, и от другого: это API для извлечения веб-данных. Он помогает превращать внешние сайты в Markdown или структурированный JSON, что полезно для LLM-приложений, исследовательских процессов, pricing intelligence и data pipelines.
Как часто нужно мониторить API?
Production-API, которые напрямую влияют на выручку (checkout, auth, payments), обычно стоит проверять каждую минуту. Внутренние или малонагруженные API часто можно проверять раз в 5 минут. Но частота — не всё: используйте ретраи, несколько регионов и содержательные assertions, чтобы каждая проверка была и быстрой, и надёжной. Минутный чек, который даёт ложные тревоги, хуже, чем пятиминутный, которому можно доверять.
Для сценариев извлечения веб-данных частота зависит от того, как часто меняется источник. Страницы с ценами могут требовать ежедневного или еженедельного обновления. Быстро меняющиеся данные по наличию, travel или marketplace могут нуждаться в почасовом или более частом обновлении. Batch API и webhooks Thunderbit полезны, когда нужно регулярно обрабатывать много URL.
Можно ли мониторить API без кода?
Да. UptimeRobot, Better Stack и Uptime Kuma можно использовать полностью через GUI. Checkly поддерживает и GUI, и настройку через код. Postman работает через интерфейс collections. Prometheus/Grafana обычно требует YAML и PromQL. Datadog и New Relic можно начать через guided setup, но по-настоящему сильными они становятся при глубокой инструментализации.
Если вы хотите извлекать данные с сайтов без кода, Chrome Extension Thunderbit — это no-code-путь. Если вы хотите автоматизировать тот же процесс из приложения, Thunderbit Open API даёт разработчикам endpoints Distill, Extract и Batch.
Как уменьшить усталость от алертов при мониторинге API?
Выбирайте инструменты с умными алертами: детекция аномалий (Datadog, New Relic), retry-before-firing (Checkly), поведенческие аномалии (Moesif) или группировка/подавление (Prometheus Alertmanager). Начинайте с меньшего числа, но более надёжных алертов, сосредоточенных на влиянии на пользователя. Используйте SLO burn-rate alerts вместо статических порогов, устраняйте дубли между сервисами, маршрутизируйте по владельцам и измеряйте actionable-ценность — если меньше 20% алертов приводят к реальному действию, сначала снижайте шум.
Попробуйте Thunderbit Open API для извлечения веб-данных Get Started Free
Узнать больше



