O tráfego automatizado de bots já representa mais de 53% de todo o tráfego da web — mais do que o gerado por humanos. Se você faz scraping de dados, gerencia contas ou confere anúncios em várias regiões, está trabalhando num ambiente em que os sistemas anti-bot foram desenhados justamente para te identificar.
Mesmo assim, a maior parte dos guias sobre "proxies estáticos vs rotativos" reduz tudo a uma tabela de duas colunas e encerra o assunto por aí. Eles deixam de lado o terceiro conceito (sessões sticky), ignoram os mecanismos reais de detecção e nunca fazem a conta do custo em escala. Eu passei bastante tempo pesquisando provedores de proxy e APIs de scraping com IA para o nosso trabalho na Thunderbit, e a realidade é bem mais confusa — e bem mais interessante — do que esses artigos genéricos costumam mostrar. Este guia cobre a diferença real entre os três tipos, como os sistemas anti-bot detectam tráfego de proxy na prática, quanto custa processar 50 mil páginas por dia com diferentes tipos de proxy e 9 ferramentas que eu, sinceramente, consideraria usar. Algumas são provedores de proxy puros, outras são APIs de scraping, e uma delas (a nossa) dispensa totalmente o gerenciamento de proxies.
Experimente Thunderbit para scraping com IA
Proxies estáticos, rotativos e sticky: a diferença em três vias que a maioria dos guias ignora
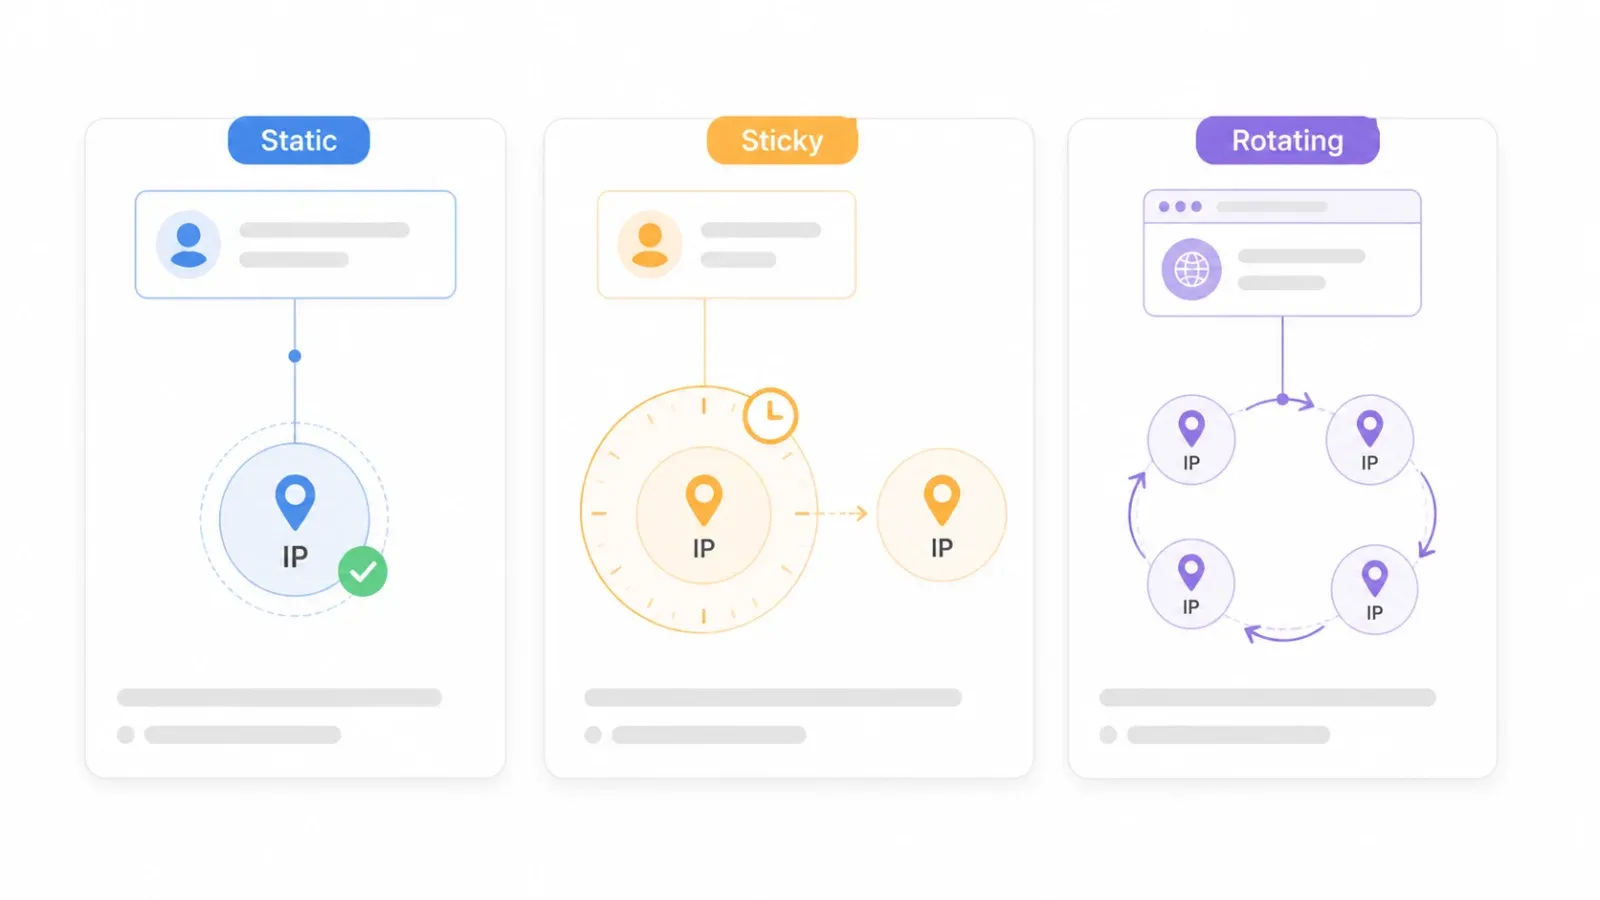
A maioria dos artigos que compara proxies trata o tema como algo binário: estático ou rotativo. Esse recorte é incompleto — e leva a decisões de compra ruins. Na prática, existem três comportamentos distintos de proxy, e cada um serve para um tipo de tarefa.
Proxy estático: o mesmo endereço IP, sem mudar, até você trocar manualmente ou o contrato vencer. Pense nisso como sua internet de casa — o mesmo endereço todo dia. É útil quando a plataforma espera ver a mesma identidade ao longo do tempo (gestão de contas, conteúdo com bloqueio geográfico, acompanhamento de ranking).
Sessão sticky: o mesmo IP por um período configurável — talvez 10 minutos, talvez 30, talvez até 24 horas, dependendo do provedor — e depois ele troca para outro. Uma sessão sticky é continuidade temporária; um proxy estático é continuidade permanente. A Decodo (antiga Smartproxy) descreve sessões sticky como a manutenção de um IP por 1, 10, 30, 60 minutos ou intervalos personalizados de até 24 horas.
Proxy rotativo: um novo IP a cada requisição, ou a cada poucos segundos. Máximo anonimato para trabalhos de alto volume, mas sem continuidade de sessão — a menos que você coloque sessões sticky por cima.
A diferença em formato de tabela:
| Atributo | Proxy Estático | Sessão Sticky | Proxy Rotativo |
|---|---|---|---|
| O IP muda? | Nunca (mesmo IP indefinidamente) | Depois de um período definido (ex.: 10–30 min) | A cada requisição ou a cada poucos segundos |
| Persistência da sessão | Permanente | Temporária (TTL configurável) | Nenhuma |
| Caso de uso típico | Gestão de contas, conteúdo com bloqueio geográfico | Scraping em várias etapas (login → navegação → extração) | Scraping em alto volume, verificação de anúncios |
| Risco de detecção | Maior ao longo do tempo (a mesma fingerprint acumula histórico) | Moderado | Menor para detecção baseada em IP (se residencial) |
| Modelo de custo | Geralmente por IP/mês | Parte de planos residencial/móvel cobrados por GB | Por GB, por requisição ou tarifa fixa |
Por que isso importa na hora de escolher uma ferramenta? Se você faz login numa plataforma, adiciona itens ao carrinho ou preenche um formulário em várias etapas, você precisa de sessões sticky — não de rotação pura (que quebraria a sessão) e nem necessariamente de um IP estático permanente (que seria exagerado e caro). Usuários do fórum r/proxies frequentemente confundem essas categorias, perguntando se sessões sticky se comportam como "proxies residenciais rotativos comuns" ou como IPs estáticos. A resposta: nenhum dos dois. Elas são uma terceira coisa.
Como os sistemas anti-bot realmente detectam proxies estáticos vs rotativos
Todo artigo comparando proxies menciona "risco de detecção" em uma célula de tabela. Quase nenhum explica como a detecção funciona de verdade. Isso importa, porque o método de detecção determina se trocar IPs realmente ajuda.
Os sistemas anti-bot modernos usam pelo menos quatro camadas, e rotacionar o IP só resolve uma delas.
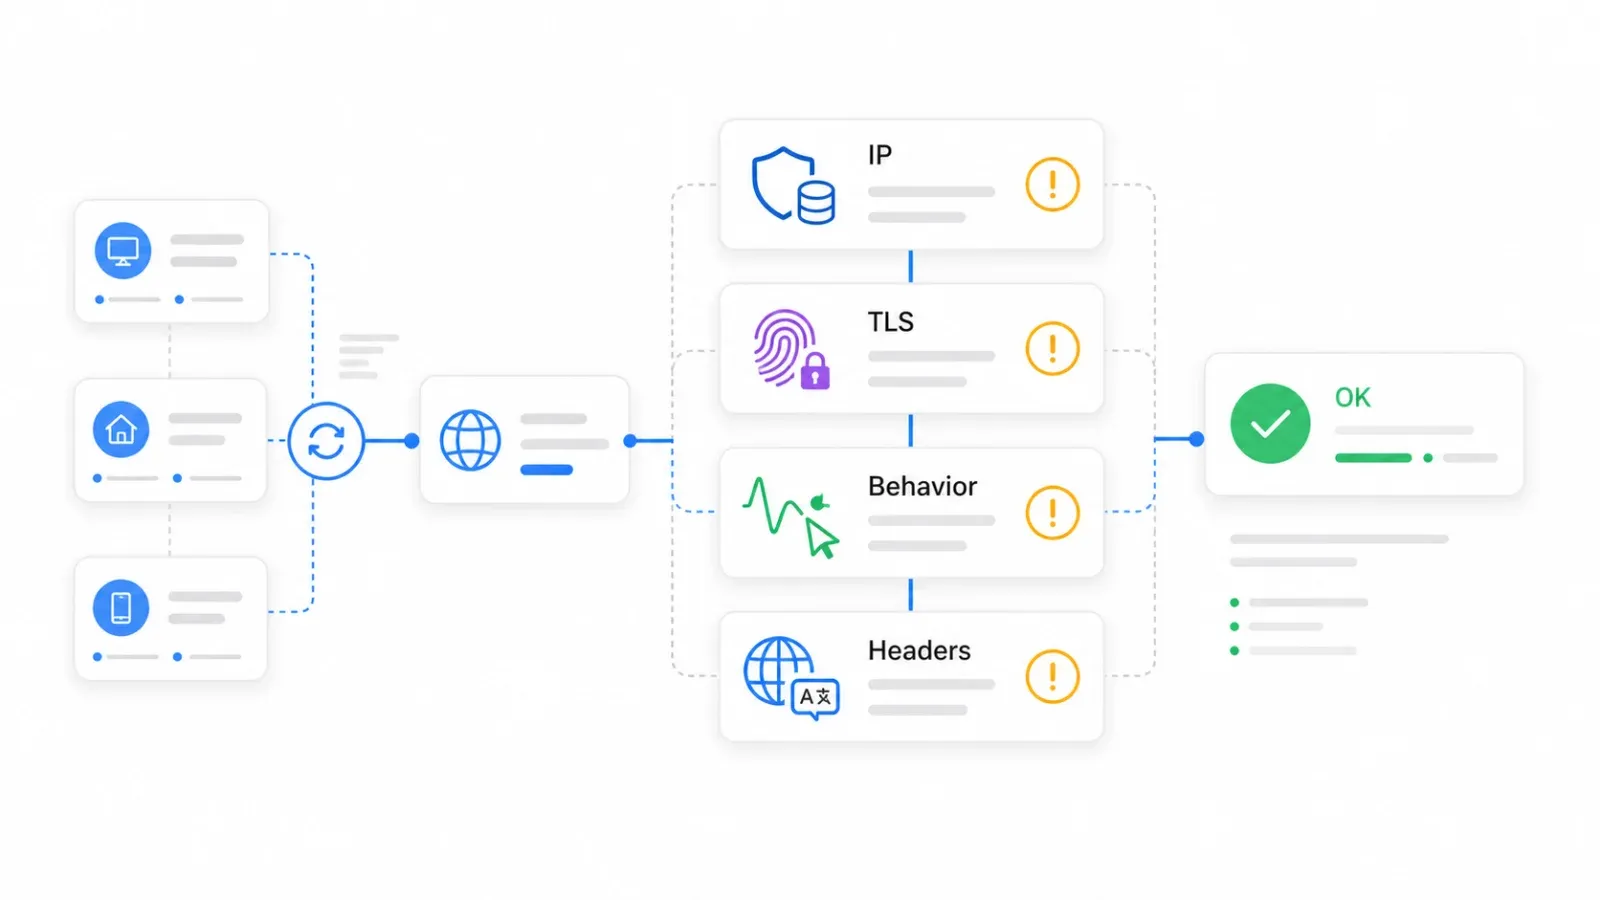
Camada 1: Bancos de dados de reputação de IP
Faixas de IP de datacenter vêm de cloud e provedores de hospedagem — Amazon, Google, DigitalOcean etc. Empresas de anti-bot mantêm bases que já classificam essas faixas como suspeitas. IPs residenciais e móveis começam com mais confiança porque parecem tráfego normal de consumidores. A documentação de bot da Cloudflare aborda isso por meio de pontuações de bot de 1 a 99, em que notas baixas indicam alta probabilidade de automação. Se o seu IP vem de uma faixa conhecida de datacenter, você já começa com uma nota de confiança baixa antes mesmo da primeira requisição.
Camada 2: Fingerprinting TLS/JA3/JA4
Essa é a camada que a maior parte de quem compra proxy nem conhece. Quando seu cliente inicia uma conexão HTTPS, o handshake TLS revela características do software que está fazendo a requisição. A documentação de JA3/JA4 da Cloudflare explica que essas fingerprints identificam clientes TLS com base nas características da conexão e funcionam como identificadores estáveis entre diferentes IPs de destino. Em linguagem simples: se sua requisição diz ser o Chrome no macOS, mas o handshake TLS parece uma biblioteca Python requests, trocar o IP não resolve essa divergência. A fingerprint continua te seguindo.
Camada 3: Sinais comportamentais
Frequência das requisições, ordem de navegação, movimento do mouse (ou a falta dele), padrões de login e se a sessão evolui como um usuário humano navegaria. A documentação de detecção da DataDome descreve modelos comportamentais que identificam padrões anormais, como tentativas demais de login ou velocidade de navegação desumana. Um estudo de 2026 no arXiv sobre agentes de navegação com IA constatou que fingerprints comportamentais foram mais discriminantes do que fingerprints de navegador para diferenciar agentes de IA de humanos.
Camada 4: Consistência de cabeçalhos e do ambiente
Um estudo acadêmico de medição de 2026 com 10 mil websites mostrou que 75% dos bloqueios aplicados apenas ao Chromium headless foram causados só por sinais em nível de cabeçalho. Se o cabeçalho Accept-Language diz en-US, mas o IP aparece geolocalizado em São Paulo, isso já é um sinal. Se o seu user agent não bate com a fingerprint TLS, esse é outro sinal.
A principal lição: trocar IPs reduz bloqueios por reputação e por taxa baseados no endereço IP. Mas não resolve incompatibilidades de fingerprint TLS, anomalias comportamentais nem inconsistências de cabeçalhos. É justamente por isso que ferramentas de scraping com foco em API — que cuidam de renderização, consistência de fingerprint e CAPTCHA na camada de infraestrutura — viraram uma alternativa prática a gerenciar todas as quatro camadas sozinho.
Elimine o gerenciamento de proxies com scraping por IA Get Started Free
O custo real de proxies estáticos vs rotativos em escala
Preço é a parte que a maioria dos guias de proxy ignora ou trata de forma vaga com palavras como "acessível". Mas modelo de cobrança + peso da página + taxa de bloqueio mudam o custo total de forma drástica.
O Web Almanac 2025 do HTTP Archive informa que a página inicial mediana pesa 2,86 MB no desktop. Se você estiver renderizando páginas completas por meio de um proxy residencial cobrado por tráfego, a 50 mil páginas por dia isso representa cerca de 143 GB/dia, ou aproximadamente 4,29 TB/mês. Com custos de US$ 5–US$ 15/GB para largura de banda residencial rotativa, você está falando de US$ 21.450–US$ 64.350/mês antes de considerar novas tentativas e requisições bloqueadas.
Esse número assusta quase todo mundo na primeira vez que vê.
É também por isso que scrapers experientes bloqueiam imagens, fontes, vídeos e scripts desnecessários em navegadores headless — uma otimização prática que pode reduzir o tráfego em 60–80%. Mesmo com essa redução, você ainda ficaria em torno de 858 GB–1,72 TB/mês, o que, nas tarifas residenciais, dá algo entre US$ 4.290 e US$ 25.740 por mês.
Scrapes diretos por HTTP ou em nível de API são muito mais leves. Uma estimativa de profissionais do setor coloca requisições HTTP diretas em 50–200 KB por página, contra 1,5–8 MB para renderização headless completa. A 200 KB/página, 50 mil páginas por dia equivalem a apenas cerca de 300 GB/mês.
| Tipo de Proxy | Modelo de Cobrança | Faixa de Custo Típica | Custo Estimado para 50 mil Páginas/Dia (renderização completa) | Observações |
|---|---|---|---|---|
| Datacenter (estático) | Por IP/mês | ~US$ 0,50–US$ 2/IP | Baixo (tarifa fixa, sem cobrança por GB) | Alto risco de bloqueio em alvos protegidos |
| ISP / Residencial estático | Por IP ou por GB | ~US$ 3–US$ 8/GB | Médio-alto | Melhor para continuidade + alvos mais difíceis |
| Residencial rotativo | Por GB | ~US$ 5–US$ 15/GB | Muito alto, a menos que a banda seja otimizada | Padrão-ouro em anonimato; o custo explode em volume |
| Datacenter rotativo | Por requisição ou por GB | ~US$ 0,50–US$ 3/GB | Baixo-moderado | Útil para alvos mais permissivos |
| API de scraping com IA (ex.: Thunderbit) | Por requisição / créditos | Varia conforme o plano | Previsível (sem cobrança de banda) | Retorna dados estruturados, não HTML bruto |
É exatamente por isso que usuários de fóruns perguntam sobre rotacionar manualmente proxies ISP estáticos como alternativa mais barata à largura de banda residencial cobrada por tráfego. O trade-off entre anonimato e custo é real, e a resposta certa depende da sofisticação anti-bot do seu alvo e do seu volume.
Escolha seu tipo de proxy em menos de 60 segundos
Nenhum dos seis artigos concorrentes mais bem posicionados traz um fluxo de decisão. Aqui está a lógica em formato de árvore de decisão, passo a passo:
-
Você precisa do mesmo IP durante sessões longas? → Sim → Proxy estático (ISP/residencial estático para alvos difíceis, datacenter para os mais fáceis)
-
Não → Você vai fazer scraping de mais de 10 mil páginas? → Sim → Proxy rotativo (residencial para alvos difíceis, datacenter para os mais permissivos)
-
Você precisa de persistência de sessão para tarefas em várias etapas (login, carrinho, formulários)? → Sim → Sessão sticky (residencial, com TTL configurável)
-
Você quer eliminar totalmente o gerenciamento de proxies? → Sim → API de scraping com IA (ex.: Thunderbit API/MCP)
A mesma lógica em formato de tabela por cenário:
| Sua situação | Melhor abordagem |
|---|---|
| Precisa de acesso bruto a IP (gestão de contas, testes geográficos) | Proxies estáticos ou rotativos gerenciados por você |
| Extração de dados estruturados de sites pesados em JS | API de scraping com IA (ex.: Thunderbit /extract) |
| Rastreamento em alto volume para RAG/indexação | API de distill com IA (ex.: Thunderbit /distill) + processamento em lote |
| Scraping em várias etapas com login | Proxies de navegador com sessões sticky |
| Orçamento limitado, alvos menos protegidos | Proxies de datacenter (mais baratos) |
A maioria dos leitores se encaixa em um desses cinco grupos. Descubra qual é o seu antes de ir para a lista de ferramentas.
O que avaliamos nestas 9 ferramentas
Cada ferramenta desta lista foi avaliada com base em sete critérios:
- Tipos de proxy oferecidos: cobre estático, rotativo, ISP, residencial, móvel — ou abstrai totalmente a camada de proxy?
- Tamanho do pool de IPs: pools maiores tendem a oferecer rotação mais eficiente e menor risco de reutilização. Mas números de pool são marketing, não métricas auditadas de forma independente.
- Modelo de preços: por IP, por GB, por requisição, tarifa fixa ou créditos. O modelo de cobrança importa tanto quanto o preço unitário.
- Tratamento de anti-bot / detecção: solução nativa de CAPTCHA, gerenciamento de fingerprint ou nada além de diversidade de IP.
- Suporte a sessão sticky: TTL configurável, duração máxima, confiabilidade.
- Melhor encaixe de uso: scraping, gestão de contas, SEO, verificação de anúncios — cada ferramenta tem seu ponto forte.
- Facilidade de integração: qualidade da API, disponibilidade de SDK, usabilidade do painel, opções no-code, suporte a MCP/CLI.
A lista começa com Thunderbit (nossa abordagem de API de scraping com IA) e depois cobre nove provedores de proxy em ordem aproximada de escala e profundidade de recursos.
1. Thunderbit: pule o gerenciamento de proxies com uma API de scraping com IA
Thunderbit não é um provedor de proxy. É a escolha para quando você percebe que proxies são só um meio para um fim — e o que você realmente quer são dados estruturados.
Nós criamos a Thunderbit como uma API de scraping com IA que lida com proxies, mecanismos anti-bot, CAPTCHAs e renderização JavaScript na camada de infraestrutura. Você descreve que dados quer; recebe um resultado limpo e estruturado. Sem configurar pool de proxy, sem lógica de rotação, sem mascaramento de fingerprint.
Para desenvolvedores (o principal caso de uso):
- API aberta:
POST /distillconverte uma página em Markdown limpo.POST /extractrecebe um schema JSON e devolve campos estruturados. Ambos suportam opçõesrenderModee jobs em lote (até 100 URLs de forma assíncrona com webhooks). - Servidor MCP: Claude, Cursor e outros agentes de IA podem chamar
thunderbit_extractethunderbit_distilldurante a tarefa. A camada de proxy fica invisível — o agente só recebe os dados. - CLI:
npx @thunderbit/thunderbit-cli extract <url> --schema <json>para terminal, CI e fluxos com cron. O processamento em lote suporta até 100 URLs para distill / 50 para extract. - Preço em créditos: Distill = 1 crédito/URL. Extract = 20 créditos/URL. Sem cobrança por largura de banda em GB. O plano Starter começa em US$ 15/mês com 500 créditos.
Para usuários não técnicos, a extensão do Chrome oferece scraping em 2 cliques com sugestão de campos por IA e exportação para Excel, Google Sheets, Airtable ou Notion. Sem precisar configurar proxy — o scraping em nuvem da Thunderbit cuida da rotação de IP e da renderização.
Melhor para: extração de dados estruturados em sites pesados em JS, pipelines de RAG/indexação, fluxos com agentes de IA e qualquer pessoa que prefira gastar tempo com análise em vez de infraestrutura de proxy.
Limitações: não é um provedor de proxy bruto. Se você precisa de acesso direto a IP para gestão de contas, teste geográfico ou bots de sneakers, um proxy tradicional é a ferramenta certa.
Preço: há plano grátis; Starter a partir de cerca de US$ 15/mês. Consulte Thunderbit Pricing para ver os planos atuais.
Para saber mais sobre como funciona o web scraping com IA por dentro, veja nosso guia de web scraping com IA.
2. Bright Data: o maior pool de IPs para proxies estáticos e rotativos

Bright Data é uma das suítes de proxy mais antigas e completas do mercado. O número principal da empresa é mais de 400 milhões de IPs residenciais rotativos em 195 países, com segmentação por cidade/estado/CEP/ASN, além de mais de 1,3 milhão de proxies ISP estáticos.
- Tipos de proxy: residencial (rotativo), ISP/residencial estático, datacenter (estático e rotativo), móvel
- Pool de IPs: mais de 400 milhões residenciais, mais de 1,3 milhão de ISP — o maior pool divulgado publicamente
- Tratamento anti-bot: produto Web Unlocker com CAPTCHA e gerenciamento de fingerprint; Browser API para renderização headless
- Sessões sticky: sim, configuráveis (normalmente 10–30 min para residencial)
Preço: residencial PAYG regular a US$ 8/GB, com valores promocionais por volta de US$ 4/GB para compromissos maiores. Datacenter a partir de cerca de US$ 0,90/IP. ISP a partir de cerca de US$ 1,30/IP. A estrutura é flexível, mas pode ficar cara rapidamente em escala.
Melhor para: empresas que precisam de enorme diversidade de IP, geotargeting preciso e uma suíte completa de produtos. Times com orçamento e equipe técnica para navegar em um painel complexo.
Desvantagens: o painel tem curva de aprendizado. O preço pode pesar para equipes menores — se você fizer scraping de 50 mil páginas por dia via proxies residenciais, a conta de banda sobe rápido. Usuários em sites de avaliação frequentemente citam a complexidade da precificação.
3. Oxylabs: proxies premium rotativos e estáticos para scraping em larga escala
Oxylabs é outro fornecedor de nível enterprise com foco forte em infraestrutura de web scraping. Eles oferecem produtos residencial, residencial estático/ISP, datacenter, móvel, Web Unblocker e Scraper API.
- Tipos de proxy: residencial (rotativo), ISP/residencial estático, datacenter (estático e rotativo), móvel
- Pool de IPs: grande pool enterprise (o número exato atual varia por produto)
- Tratamento anti-bot: Web Unblocker e Scraper APIs com renderização e suporte a CAPTCHA
- Sessões sticky: o tempo padrão de sessão residencial é 10 minutos, com outras configurações disponíveis; algumas opções suportam até 24 horas
Preço: residencial a partir de US$ 6/GB, caindo para US$ 3,50/GB em 1 TB de volume. Proxies ISP cobrados por IP/mês. Posicionamento premium.
Melhor para: grandes empresas com necessidade pesada de coleta de dados, times que querem soluções gerenciadas além do acesso bruto a proxies.
Desvantagens: preço mais alto que alternativas de médio porte. Pode ser exagerado para projetos pequenos ou médios.
4. Smartproxy (Decodo): proxies rotativos com bom custo-benefício e configuração simples
Smartproxy, agora com a marca Decodo, é um provedor popular de médio porte conhecido por preços competitivos e um painel amigável. Muita gente ainda pesquisa "Smartproxy", então os dois nomes continuam aparecendo no mercado.
- Tipos de proxy: residencial (rotativo), ISP/residencial estático, datacenter, móvel
- Pool de IPs: mais de 115 milhões de IPs residenciais
- Tratamento anti-bot: produtos Site Unblocker e API de scraping disponíveis
- Sessões sticky: 1, 10, 30, 60 minutos ou intervalos personalizados de até 24 horas em residencial, datacenter, ISP e móvel
Preço: residencial a partir de US$ 2/GB no tier de 3 GB, com redução conforme o volume aumenta. Residencial estático/ISP a partir de cerca de US$ 3,33/IP no plano de entrada. Competitivo para o pacote de recursos que entrega.
Melhor para: equipes pequenas e médias que querem equilíbrio entre preço e recursos, compradores de proxy de primeira viagem que buscam onboarding fácil.
Desvantagens: pool menor que Bright Data ou Oxylabs. Alguns usuários relatam velocidades inconsistentes dependendo do alvo e do pool.
5. IPRoyal: proxies estáticos e rotativos acessíveis com preços flexíveis
IPRoyal achou seu espaço como opção econômica com um diferencial interessante: tráfego residencial que não expira. Compre a banda e use quando quiser.
- Tipos de proxy: residencial (rotativo), ISP/residencial estático, datacenter, móvel, proxies para sneakers
- Pool de IPs: em crescimento; o tamanho exato varia conforme a fonte
- Tratamento anti-bot: básico — depende da qualidade do IP, sem CAPTCHA ou fingerprint management nativos
- Sessões sticky: até 7 dias para residencial
Preço: residencial a partir de US$ 7/GB, com desconto para US$ 1,75/GB em volume. O modelo de tráfego que não expira significa que você não perde banda não usada no fim do mês.
Melhor para: usuários com foco em orçamento, uso sazonal ou variável, casos de uso em sneaker e e-commerce.
Desvantagens: pool menor que provedores premium. Recursos anti-detecção nativos limitados. Menos indicado para alvos muito protegidos.
6. SOAX: proxies rotativos com geotargeting e filtragem granular
SOAX é especialmente forte quando você precisa de segmentação hiperlocal. A filtragem chega a país, região, cidade, ISP e ASN — útil para verificação de anúncios e pesquisa de mercado, em que a precisão de localização faz diferença.
- Tipos de proxy: residencial (rotativo), ISP/estático, datacenter, móvel
- Pool de IPs: mais de 155 milhões de IPs em mais de 195 localidades
- Tratamento anti-bot: pools de IP limpos com baixas taxas de banimento; API de Web Data disponível
- Sessões sticky: sim, com taxas de atualização personalizáveis; suporte a protocolos HTTP(S), SOCKS5, UDP e QUIC
Preço: plano Business a US$ 4,00/GB com 800 GB incluídos (US$ 3.200/mês). Tarifas enterprise começam em US$ 0,32/GB em contratos personalizados de alto volume.
Melhor para: equipes de pesquisa de mercado que precisam de dados hiperlocais, verificação de anúncios em geografias e ISPs específicos.
Desvantagens: pode parecer complexo para casos de uso simples. A duração máxima da sessão sticky varia conforme o produto — confirme antes de contratar.
7. ScraperAPI: proxies rotativos embutidos em uma API focada em scraping
ScraperAPI não é um provedor de proxy tradicional. Assim como a Thunderbit, ela abstrai a camada de proxy — mas devolve HTML bruto em vez de dados estruturados. Envie uma URL e receba o HTML renderizado de volta. A ScraperAPI cuida da seleção de proxy, rotação, retries e anti-bot nos bastidores.
- Como funciona: um único endpoint de API; você anexa a URL de destino e a ScraperAPI administra tudo
- Tratamento anti-bot: CAPTCHA, renderização de JS e geotargeting embutidos
- Sessões sticky: não se aplica no sentido tradicional — a API gerencia as sessões internamente
Preço: 1.000 créditos grátis por mês. Página padrão = 1 crédito. Amazon = 5 créditos. Google/Bing = 25 créditos. LinkedIn = 30 créditos. Sites atrás de Cloudflare/DataDome/PerimeterX adicionam 10 créditos por requisição. Planos pagos a partir de cerca de US$ 49/mês por 100 mil créditos.
Melhor para: desenvolvedores que querem pular a infraestrutura de proxy e apenas receber o HTML. Scraping em pequena e média escala.
Desvantagens: retorna HTML bruto — você ainda precisa analisar e estruturar os dados por conta própria. Pode ficar caro em volumes altíssimos por causa dos multiplicadores de crédito em sites protegidos. Em comparação com a Thunderbit: a ScraperAPI entrega HTML; o /extract da Thunderbit entrega JSON estruturado conforme o schema.
8. Webshare: proxies de datacenter e rotativos sem firulas e de baixo custo
Webshare é a opção sem firulas. Proxies de datacenter extremamente acessíveis, plano gratuito com 10 proxies e ferramentas diretas voltadas a desenvolvedores. (A Webshare foi adquirida pela Oxylabs em 2024, o que pode influenciar a direção futura do produto.)
- Tipos de proxy: datacenter (estático e rotativo), residencial (rotativo), ISP
- Pool de IPs: mais de 80 milhões de residenciais alegados, além de uma grande frota de datacenter
- Tratamento anti-bot: mínimo — sem CAPTCHA nativo; depende da diversidade de IP
- Sessões sticky: sim, para proxies residenciais
Preço: residencial rotativo a partir de US$ 1,40/GB. Residencial estático a partir de US$ 0,23/IP. Plano grátis com 10 proxies. Entre as opções mais baratas disponíveis.
Melhor para: desenvolvedores com orçamento apertado, ferramentas internas, scraping de sites menos protegidos, prototipagem.
Desvantagens: IPs de datacenter são frequentemente bloqueados por grandes sites. Anti-detecção limitado. Qualidade do pool residencial varia.
9. Storm Proxies: proxies rotativos simples com preço fixo
Storm Proxies é um dos poucos provedores que oferece planos rotativos com tarifa fixa e banda ilimitada. O modelo de preço é simples: você paga por porta de proxy por mês e usa a largura de banda que quiser.
- Tipos de proxy: residencial rotativo, datacenter rotativo, datacenter estático dedicado
- Pool de IPs: a página oficial informa mais de 20 milhões de proxies residential reverse backconnect; avaliações de terceiros sugerem que o pool efetivo é menor
- Tratamento anti-bot: mínimo — sem CAPTCHA ou fingerprint management nativos
- Sessões sticky: rotação a cada requisição, ou a cada 3 ou 15 minutos
Preço: tarifa mensal fixa com base no número de portas de proxy. Fontes de terceiros descrevem planos como 5 portas residenciais por cerca de US$ 50/mês com banda ilimitada. Confirme na página de compra antes de assinar.
Melhor para: quem quer custo mensal previsível sem medição de banda. Scraping leve a moderado em que previsibilidade de custo importa mais que o tamanho do pool.
Desvantagens: pool efetivo muito pequeno (alto risco de reutilização). Geotargeting limitado. Painel ultrapassado. Não serve bem para sites muito protegidos.
Proxies estáticos vs rotativos: comparação lado a lado das ferramentas
| Ferramenta | Tipos de Proxy / API | Tamanho Aproximado do Pool | Modelo de Preço | Tratamento Anti-Bot | Suporte a Sessão Sticky | Melhor Caso de Uso |
|---|---|---|---|---|---|---|
| Thunderbit | API de scraping com IA, MCP, CLI, extensão Chrome | Lote de até 100 URLs | Créditos (Distill 1/URL, Extract 20/URL) | Completo: renderização, anti-bot, CAPTCHA | N/A (gerenciado) | Extração de dados estruturados, RAG, agentes de IA |
| Bright Data | Residencial, ISP, datacenter, móvel | Mais de 400 milhões residenciais, mais de 1,3 milhão ISP | Por GB + por IP + por requisição | Web Unlocker, Browser API | Sim (10–30 min) | Escala enterprise, geotargeting |
| Oxylabs | Residencial, ISP, datacenter, móvel | Grande pool enterprise | Residencial US$ 6→US$ 3,50/GB | Web Unblocker, Scraper APIs | Sim (10 min padrão, configurável) | Scraping enterprise, soluções gerenciadas |
| Smartproxy/Decodo | Residencial, ISP, datacenter, móvel | Mais de 115 milhões residenciais | Residencial ~US$ 3,75/GB; ISP ~US$ 3,33/IP | Site Unblocker | Sim (1–60 min, até 24h) | Médio porte, compradores de primeira viagem |
| IPRoyal | Residencial, ISP, datacenter, móvel, sneaker | Pool em crescimento | Residencial US$ 7→US$ 1,75/GB, sem expiração | Básico (qualidade do IP) | Sim (até 7 dias) | Usuários econômicos, uso sazonal |
| SOAX | Residencial, ISP, datacenter, móvel | Mais de 155 milhões, mais de 195 localidades | Business US$ 4/GB; enterprise US$ 0,32/GB | Pools limpos, Web Data API | Sim (atualização personalizada) | Segmentação hiperlocal, pesquisa de mercado |
| ScraperAPI | API de scraping com rotação de proxy | Nível de serviço (não pool bruto) | Por crédito; padrão 1, Amazon 5, Google 25 | CAPTCHA, renderização e geotargeting embutidos | Gerenciado internamente | Desenvolvedores que querem apenas o HTML |
| Webshare | Datacenter, residencial, ISP | Mais de 80 milhões residenciais | Res. rotativo US$ 1,40/GB; estático US$ 0,23/IP | Mínimo | Sim (residencial) | Devs com orçamento baixo, prototipagem |
| Storm Proxies | Residencial rotativo/datacenter, DC estático | Mais de 20 milhões alegados | Mensal fixo por porta, banda ilimitada | Mínimo | A cada requisição / 3 / 15 min | Custo previsível, scraping leve |
O NetNut foi removido desta comparação: em agosto de 2026, o domínio netnut.io exibe um aviso de apreensão do governo federal dos EUA no lugar do site do produto.
As ferramentas se agrupam em três blocos. Infraestrutura de proxy bruta (Bright Data, Oxylabs, Smartproxy, IPRoyal, SOAX, Webshare, Storm Proxies) fornece acesso a IPs e você gerencia o restante. APIs de scraping (ScraperAPI) abstraem a camada de proxy, mas ainda devolvem HTML bruto. APIs de extração com IA (Thunderbit) abstraem tanto a camada de proxy quanto a camada de parsing, entregando dados estruturados diretamente.
Quando proxies não são a resposta: APIs de scraping com IA vs proxies autogerenciados
Esta é a parte que nenhum artigo concorrente aborda: a maioria das pessoas que lê sobre "proxies estáticos vs rotativos" não é fã de proxy. Elas querem extrair dados, e proxy é meio, não fim.
Para muitos casos de uso, gerenciar pools de proxy, lógica de rotação, mascaramento de fingerprint e resolução de CAPTCHA é um trabalho extra que uma ferramenta API-first elimina completamente. Mas nem sempre. Veja quando cada abordagem faz sentido:
Proxies autogerenciados fazem sentido quando você precisa de acesso bruto a IP para gestão de contas, teste geográfico ou bots de sneakers; controle fino sobre ASN, operadora ou comportamento do IP de saída; ou uma stack customizada de navegador/proxy que seu time já mantém.
Extração API-first faz sentido quando você precisa de dados estruturados (listas de produtos, contatos, preços) em vez de HTML bruto, Markdown limpo para pipelines de RAG, fluxos com agentes de IA em que o acesso web no meio da tarefa precisa ser invisível, ou simplesmente menos tempo gasto com infraestrutura de proxy e mais tempo no dado em si.
A API da Thunderbit cuida de renderização, anti-bot e CAPTCHAs no servidor. Desenvolvedores recebem Markdown limpo (/distill) ou JSON compatível com schema (/extract) sem configurar pools de proxy ou consistência de fingerprint. O servidor MCP permite que Claude ou Cursor façam scraping no meio da tarefa via thunderbit_extract — a camada de proxy realmente fica invisível.
Para uma visão mais ampla sobre web scraping sem código, já cobrimos esse tema em outro artigo.
Qual ferramenta de proxy estático vs rotativo é ideal para você?
Recomendações específicas por cenário, porque "depende" é certo, mas não ajuda muito:
- Melhor para empresas que precisam de pools enormes de IPs: Bright Data, Oxylabs
- Melhor para equipes com orçamento limitado: IPRoyal, Webshare, Storm Proxies
- Melhor para configuração fácil no mercado intermediário: Smartproxy/Decodo, SOAX
- Melhor para dispensar gerenciamento de proxy completamente: Thunderbit (dados estruturados), ScraperAPI (HTML bruto)
- Melhor para fluxos com agentes de IA e MCP: Thunderbit
Os sistemas anti-bot continuam ficando mais inteligentes — combinando reputação de IP, fingerprinting TLS, análise comportamental e consistência de cabeçalhos — e o custo de gerenciar proxies por conta própria cresce junto. Para equipes cujo objetivo final é obter dados web limpos e estruturados, ferramentas API-first que abstraem toda a camada de proxy estão cada vez mais se tornando a escolha prática.
Essa mudança não é hipotética. Ela já está acontecendo.
Se você quiser ver isso na prática, a extensão Chrome da Thunderbit é um ótimo ponto de partida para usuários não técnicos, e a documentação da API cobre o fluxo para desenvolvedores. Para mais contexto sobre o panorama geral das ferramentas de scraping, confira nossa comparação dos melhores AI web scrapers. Você também pode assistir a tutoriais no canal da Thunderbit no YouTube.
Experimente o Thunderbit AI Web Scraper Get Started Free
Perguntas frequentes
1. Quando devo usar proxies estáticos em vez de rotativos?
Use proxies estáticos quando você precisar do mesmo IP ao longo das sessões — gestão de contas, acesso a conteúdo com bloqueio geográfico, acompanhamento de ranking ou qualquer plataforma que ache suspeita uma mudança de IP. Se o alvo espera ver a mesma identidade ao longo do tempo, o estático é a escolha certa. Para alvos mais difíceis, IPs residenciais estáticos/ISP são mais seguros que datacenter.
2. Qual é a diferença entre sessão sticky e proxy estático?
Uma sessão sticky mantém o mesmo IP por uma janela de tempo configurável (por exemplo, 10 minutos, 30 minutos, até 24 horas, dependendo do provedor) e depois troca para outro. Um proxy estático mantém o mesmo IP indefinidamente até você trocá-lo manualmente. Não são a mesma coisa, apesar de alguns provedores usarem os termos como se fossem intercambiáveis.
3. Por que proxies rotativos ainda são bloqueados em alguns sites?
Porque os sistemas anti-bot modernos usam detecção em várias camadas, e não só o endereço IP. Fingerprinting TLS/JA3, análise comportamental (padrões de requisição, caminhos de navegação) e checagens de consistência de cabeçalhos podem identificar tráfego automatizado independentemente da rotação de IP. Trocar IPs reduz limites baseados em reputação, mas não resolve essas outras camadas de detecção.
4. Quanto custam proxies residenciais rotativos em escala?
Os preços públicos de autoatendimento vão de cerca de US$ 1,40/GB (Webshare) até US$ 8/GB no PAYG padrão (Bright Data), com descontos enterprise disponíveis. Em volume de renderização de página completa (50 mil páginas/dia a ~2,86 MB/página), só a banda pode passar de 4 TB/mês — potencialmente dezenas de milhares de dólares. APIs por crédito ou por requisição (como Thunderbit ou ScraperAPI) oferecem preços mais previsíveis sem cobrança por banda.
5. Uma API de scraping com IA pode substituir proxies completamente?
Para extração de dados estruturados e web scraping, muitas vezes sim. Ferramentas como a Thunderbit cuidam de rotação de proxy, medidas anti-bot, CAPTCHA e renderização JS na camada de infraestrutura — você recebe os dados limpos sem gerenciar a infraestrutura de proxy. Para casos que exigem acesso bruto a IP (gestão de contas, testes geográficos, bots de sneakers), os proxies tradicionais continuam necessários.
Saiba mais



