
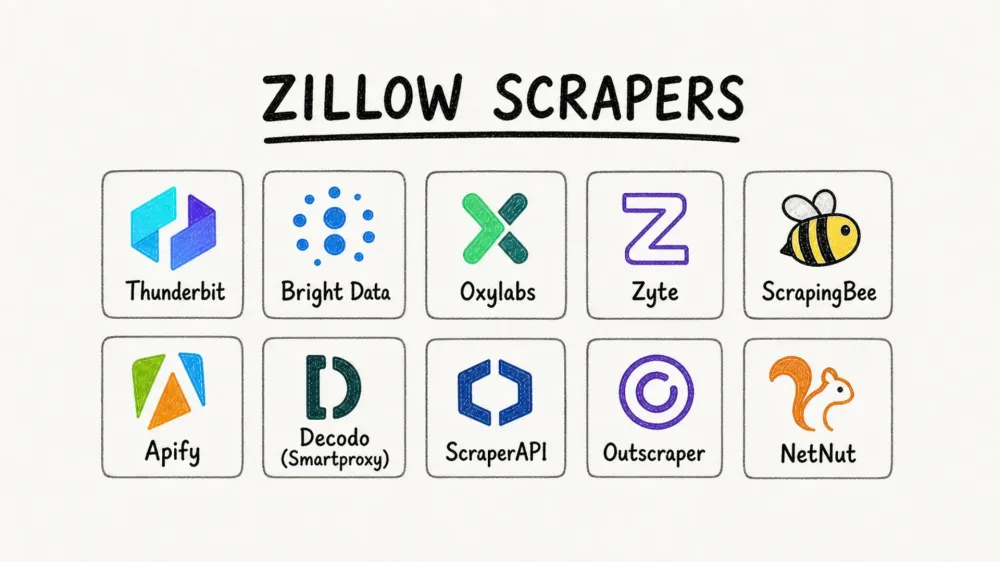
O Zillow acompanha cerca de 173 milhões de imóveis nos Estados Unidos e atrai, em média, mais de 235 milhões de usuários únicos por mês.
Isso significa uma quantidade gigantesca de dados imobiliários concentrada em um único site — preços, Zestimates, contatos de corretores, histórico de impostos, estatísticas de bairros. O problema? Tirar esses dados do Zillow em escala já é outra história.
A maioria dos guias online sobre o “melhor scraper do Zillow” aponta para ferramentas de API e provedores de proxy voltados a desenvolvedores. Isso funciona bem se você vive programando em Python, mas, pelo que vi trabalhando com equipes de imóveis, investidores e profissionais de marketing na Thunderbit, muita gente que busca scrapers do Zillow quer só os dados dos anúncios em uma planilha — rápido, sem código e sem dor de cabeça.
Por isso, montei este guia cobrindo os três tipos de scrapers do Zillow: extensões de navegador para quem não é técnico, APIs em nuvem para desenvolvedores e infraestrutura baseada em proxy para operações de alto volume. Também incluí comparações de plano gratuito, resumo dos fluxos de exportação e recomendações por caso de uso, para você ir direto à ferramenta que faz sentido para a sua realidade.
Experimente o Scraper do Zillow da Thunderbit
O que é um scraper do Zillow e quais dados você realmente consegue extrair?
Um scraper do Zillow é qualquer ferramenta que coleta automaticamente dados estruturados de imóveis no Zillow — para que você não precise copiar e colar os detalhes de cada anúncio em uma planilha, um por um. Seja para puxar dados comparativos em uma análise de investimento ou montar uma lista de leads de imóveis FSBO, o scraper faz o trabalho repetitivo por você.
Veja os dados que normalmente podem ser extraídos das páginas de imóveis do Zillow:
- Dados de anúncio e preço: preço atual, preço de venda, Zestimate, Rent Zestimate, histórico de preços, tempo no mercado
- Detalhes do imóvel: quartos, banheiros, metragem, tamanho do terreno, ano de construção, tipo de imóvel, andares, estacionamento, taxa de HOA
- Informações de localização: endereço completo, CEP, nome do bairro
- Metadados do anúncio: status do anúncio (à venda, pendente, vendido), corretor ou provedor do anúncio, URL do anúncio
- Mídia: fotos do imóvel, descrições
- Histórico e finanças: histórico de vendas, histórico de impostos, valor anual de imposto
- Extras (dependendo da profundidade da ferramenta): Walk Score, Transit Score, escolas próximas, tempos de deslocamento, dados do lote/parcela
Nem todos esses campos são igualmente fáceis de capturar. Dados principais como preço, endereço e quartos/banheiros costumam ser simples. Mas gráficos de histórico do Zestimate, telefones de corretores e detalhes fiscais muitas vezes carregam de forma dinâmica ou ficam atrás de renderização JavaScript — e é exatamente por isso que a arquitetura do scraper faz diferença.
Como avaliamos os melhores scrapers do Zillow
Antes da lista, vale dar uma olhada rápida em como comparei essas ferramentas. Esses critérios importam porque o Zillow não é um site comum para scraping — é um dos sites mais protegidos da web.
Facilidade de uso: sem código vs. exige programação
A diferença é grande. Algumas ferramentas permitem extrair dados do Zillow com um clique no navegador. Outras exigem chaves de API, scripts em Python e configuração de proxy. Como 75% dos agentes usam com frequência o histórico de preços de imóveis comparáveis e muitos deles não são desenvolvedores, facilidade de uso pesa muito mais do que a maioria dos artigos concorrentes reconhece.
Taxa de sucesso contra bots no Zillow
A camada anti-bot do Zillow (mais sobre isso abaixo) é o principal motivo pelo qual scrapers falham. Uma ferramenta barata que só funciona 40% das vezes pode sair mais cara por registro do que uma ferramenta mais cara que funciona sempre.
Modelo de preço e custo por 1.000 registros
Tentei padronizar o custo por 1.000 registros (CPM) sempre que possível. Algumas ferramentas cobram por chamada de API, outras por página, outras por resultado bem-sucedido. O preço exibido pode enganar se você não considerar taxa de sucesso e tentativas repetidas.
Plano gratuito e período de teste
Muitos leitores querem testar uma ferramenta antes de pagar. Incluí uma comparação dedicada de planos gratuitos mais adiante neste artigo — algo que, pelo que notei, quase nenhum guia concorrente faz.
Formatos de exportação e integrações
Profissionais do setor imobiliário querem colocar dados em planilhas e CRMs, não analisar JSON bruto. Ferramentas que exportam direto para Excel, Google Sheets, Airtable ou Notion economizam muito trabalho depois.
Paginação e processamento em massa
Os resultados de busca do Zillow se espalham por várias páginas. Ferramentas que lidam com paginação nativamente evitam que você tenha de criar lógica manual para avançar páginas.
Arquitetura do scraper: extensão, API ou proxy
A maioria dos artigos ignora isso por completo. O tipo de scraper que você usa — extensão de navegador, API em nuvem ou infraestrutura de proxy — muda completamente sua experiência, sua taxa de sucesso e seu fluxo de trabalho. Vou detalhar isso a seguir.
Três tipos de scrapers do Zillow: qual é o ideal para você?
Quando comecei a estudar esse mercado, não encontrei um único artigo que explicasse claramente as diferenças de arquitetura. Todo scraper do Zillow entra em uma das três categorias abaixo, e a escolha certa depende do seu nível técnico, do volume necessário e de como você quer usar os dados.
Scrapers em extensão de navegador (sem código)
Eles rodam dentro do seu próprio Chrome. Você acessa o Zillow, clica em um botão e a extensão extrai os dados da página aberta. Como usam sua sessão real do navegador — cookies reais, fingerprint real, login real — eles contornam naturalmente boa parte da detecção anti-bot sem precisar de proxy.
Melhor para: corretores, investidores fazendo análise comparativa, pequenas equipes de marketing e qualquer pessoa que queira dados em planilha com rapidez.
Exemplo: Thunderbit (fluxo com 1 clique, шаблон do Zillow com 1 clique, exportação direta para Sheets/Excel).
Scrapers via API em nuvem (amigáveis para desenvolvedores)
Você envia uma URL para um endpoint de API e recebe JSON ou CSV estruturado em resposta. Exigem alguma configuração técnica — chave de API, script, talvez uma ferramenta de agendamento — mas escalam bem e se encaixam facilmente em pipelines recorrentes.
Melhor para: desenvolvedores de PropTech, engenheiros de dados, equipes criando produtos SaaS ou pipelines internos.
Exemplos: Bright Data, Zyte, ScraperAPI, ScrapingBee.
Scrapers baseados em proxy (infraestrutura para alto volume)
Essas soluções fornecem rotação de IP e a camada de bypass anti-bot, mas você traz sua própria lógica de scraping. Pense nelas como a tubulação, não como a torneira.
Melhor para: operações em larga escala que já possuem código de scraping e precisam de infraestrutura confiável de IP.
Exemplos: Oxylabs, Decodo/Smartproxy, NetNut.
Aqui vai um atalho para decidir:
- Só precisa dos dados rápido, sem programar? → Extensão de navegador (Thunderbit)
- Está construindo um produto ou pipeline? → Baseado em API (Bright Data, Zyte, ScraperAPI)
- Precisa de rotação de proxy em alto volume? → Foco em proxy (Oxylabs, Decodo, NetNut)
Os melhores scrapers do Zillow em resumo: comparação lado a lado
Antes de entrar ferramenta por ferramenta, aqui está a tabela completa de comparação. Tentei ser o mais específico possível — respostas vagas de “sim/não” não ajudam quando você está escolhendo uma ferramenta para um projeto real.
| Ferramenta | Tipo | Sem código? | Plano gratuito | Template do Zillow | Opções de exportação | Paginação | Enriquecimento de subpáginas |
|---|---|---|---|---|---|---|---|
| Thunderbit | Extensão Chrome | ✅ | ✅ (6 páginas grátis) | ✅ (template com 1 clique) | Excel, Sheets, Airtable, Notion, CSV, JSON | ✅ | ✅ |
| Bright Data | API + marketplace de datasets | ⚠️ Parcial | ✅ 5.000 créditos/mês | ✅ | JSON, NDJSON, CSV, webhooks, S3, GCS, Snowflake | ✅ | ✅ |
| Oxylabs | API + proxy | ❌ | ⚠️ Teste (2.000 resultados) | ⚠️ Parcial (guia, sem template) | JSON, CSV via fluxo de trabalho | ✅ | ✅ |
| Zyte | API + Auto-Extract | ⚠️ Parcial | ✅ (crédito de US$ 5) | ❌ | JSON, CSV | ✅ | Parcial |
| ScrapingBee | API | ❌ | ✅ (1.000 créditos) | ❌ | JSON, HTML | ✅ | Personalizado |
| Apify | Actors em nuvem | ⚠️ Parcial | ✅ (créditos de US$ 5/mês) | ✅ (actor da comunidade) | JSON, CSV, XML, Excel, JSONL | ✅ | ✅ |
| Decodo / Smartproxy | API + proxy | ❌ | ✅ (teste de 7 dias, 1.000 requisições) | ✅ | HTML, JSON, CSV analisado | ✅ | Parcial |
| ScraperAPI | API + pipeline | ❌ | ⚠️ (teste de 7 dias) | ✅ | HTML, JSON, CSV, Markdown | ✅ | ✅ |
| Outscraper | Scraper em nuvem | ⚠️ Parcial | ✅ (gratuito antes de 500 anúncios) | ✅ | CSV, Excel, Parquet, JSON | ✅ | Parcial |
| NetNut | Proxy / Unblocker | ❌ | ⚠️ Apenas teste | ❌ | Nenhum nativo | ❌ | ❌ |
Um padrão salta aos olhos: o Thunderbit é a única ferramenta que combina sem código, template dedicado do Zillow, enriquecimento de subpáginas e exportação gratuita para ferramentas de negócios como Sheets e Airtable. Se você é desenvolvedor, Bright Data e ScraperAPI oferecem a cobertura de API mais profunda e específica para Zillow.
1. Thunderbit
 Thunderbit é a ferramenta que minha equipe e eu criamos especificamente para pessoas que querem dados da web sem escrever código. É uma extensão Chrome com IA que funciona direto no navegador — você acessa uma página, clica em um botão e recebe os dados estruturados exportados para a ferramenta que preferir.
Principais recursos para scraping do Zillow
No Zillow, o Thunderbit oferece um template de scraper do Zillow com 1 clique já pronto para extrair dados de anúncios na hora. Não são necessários créditos de IA para scraping baseado em template — o template já sabe quais campos capturar (endereço, preço, quartos, banheiros, metragem, dados do corretor, Zestimate, URL do anúncio, imagens e mais).
Se você estiver em uma página do Zillow fora do padrão ou quiser campos personalizados, a IA do Thunderbit define os nomes das colunas automaticamente, ou você pode dizer em linguagem natural quais campos quer e ela monta tudo. Você também pode usar scraping de subpáginas: raspe uma página de resultados de busca do Zillow e depois aprofunde cada anúncio para enriquecer com dados detalhados do imóvel, como histórico de preços, histórico de impostos, taxa de HOA, Walk Score e Transit Score.
O tratamento de paginação funciona tanto com layouts de clique quanto com rolagem infinita. Também há extratores gratuitos de e-mail e telefone para capturar contatos de corretores sem custo, além de um scraper agendado que você pode configurar em linguagem simples (por exemplo, “toda segunda-feira às 9h”) para monitoramento contínuo de preços.
Opções de exportação e integração
Aqui é onde o Thunderbit realmente sai na frente para usuários não técnicos. Exportar para Excel, Google Sheets, Airtable, Notion, CSV ou JSON é totalmente gratuito — sem bloqueio pago na exportação. Ao exportar para Airtable ou Notion, as fotos dos imóveis aparecem como campos de imagem de verdade, e não apenas URLs. Isso faz diferença se você mantém um banco de dados imobiliário ou compartilha anúncios com clientes.
Preço e plano gratuito
- Plano gratuito: 6 páginas (10 com teste grátis), além de extratores de e-mail/telefone/imagem e exportação de dados totalmente gratuitos
- Sistema baseado em créditos: 1 crédito = 1 linha de saída; scraping por template não consome créditos de IA
- Planos pagos a partir de cerca de US$ 15/mês no plano mensal ou US$ 9/mês no anual
- O scraping no navegador usa sua sessão de login; o scraping em nuvem processa até 50 páginas por vez para dados publicamente disponíveis
Por que se destaca
Como o Thunderbit roda dentro do seu Chrome real, ele herda cookies reais, fingerprints reais e o estado de login da sua conta — o que ajuda a contornar naturalmente muitas verificações do Zillow sem qualquer configuração de proxy. A IA lê o site “do zero” toda vez, então quando o Zillow muda o layout (o que acontece com frequência), você não precisa refazer o scraper. Um clique: a IA descobre o que capturar → executa → pronto. Se preferir, basta explicar em português simples o que precisa. E ele suporta 34 idiomas, o que é um ótimo bônus para equipes internacionais.
Melhor para: corretores, investidores, equipes de marketing e qualquer pessoa que queira dados do Zillow em uma planilha sem tocar em uma API.
2. Bright Data
 Bright Data é a plataforma de dados mais ampla e robusta desta lista. Se o Thunderbit é o canivete suíço para tarefas do dia a dia, a Bright Data é uma oficina completa para equipes corporativas que constroem pipelines em produção.
Principais recursos para scraping do Zillow
A Bright Data oferece um scraper dedicado para Zillow como parte da sua biblioteca com mais de 437 scrapers. Ele extrai cidade, estado, status do imóvel, cômodos, ano de construção, Zestimate, histórico de preços, dados do corretor, fotos e mais. Há também um produto de dataset do Zillow — registros imobiliários dos EUA já coletados para análise histórica em massa sem você precisar rodar nenhum scraper.
No lado da infraestrutura, a Bright Data conta com um resolvedor dedicado de CAPTCHA do Zillow para desafios PerimeterX, um Scraping Browser (navegador gerenciado em nuvem com desbloqueio embutido), mais de 400 milhões de IPs residenciais em 195 países e um MCP Server para fluxos com agentes de IA/LLM.
Preço
- Pagamento por sucesso: cerca de US$ 1,50 por 1.000 registros bem-sucedidos no web scraper
- Preço de dataset a partir de US$ 250 por 100 mil registros, com descontos por volume
- Proxies residenciais a partir de US$ 8,40/GB
- Plano gratuito com 5.000 créditos por mês, sem necessidade de cartão
Prós e contras
- Prós: maior taxa de sucesso em benchmarks independentes (reportada em 98,44%), ecossistema integrado cobrindo scraper + dataset + proxy + entrega, modelo de pagamento por sucesso
- Contras: custo inicial maior para projetos pequenos, variedade de produtos pode confundir iniciantes, não foi feito para usuários não técnicos que só querem planilhas
Melhor para: equipes corporativas de dados, empresas de PropTech e qualquer pessoa construindo um pipeline de dados do Zillow em grande escala.
3. Oxylabs
 Oxylabs é um fornecedor empresarial de proxy e API de scraping. Não tem uma página de template do Zillow voltada ao consumidor, mas oferece um guia detalhado de scraping do Zillow baseado na Web Scraper API.
Principais recursos
- Web Scraper API com rotação de proxy residencial
- Mais de 100 milhões de proxies residenciais
- Renderização JavaScript para páginas dinâmicas do Zillow
- Gerenciamento dedicado de conta para clientes enterprise
- Extração documentada de campos do Zillow: endereço, preços, fotos, quartos/banheiros/metragem, informações de publicação, tempo no Zillow, visualizações/salvamentos, valor estimado de mercado, histórico de preços, histórico fiscal público
Preço e acesso
- Teste grátis de até 2.000 resultados na Web Scraper API
- Planos a partir de cerca de US$ 49/mês
- Destinos genéricos “Other” com preço de cerca de US$ 1,50 por 1.000 resultados; com renderização JS, cerca de US$ 3,50
- Saída: JSON, CSV via fluxo do cliente
Prós e contras
- Prós: taxas de sucesso muito altas em benchmarks independentes, suporte enterprise, grande pool de proxies
- Contras: exige código, não tem interface de template específica para Zillow, não é adequado para usuários não técnicos
Melhor para: equipes de desenvolvimento corporativas que precisam de infraestrutura robusta de proxy e alta confiabilidade para coleta de dados do Zillow.
4. Zyte
 Zyte foi fundada pelos criadores do Scrapy. Então, se sua equipe já vive no ecossistema Scrapy, Zyte é uma escolha natural. Sua API oferece extração automática com IA, capaz de interpretar dados estruturados de páginas web sem seletores personalizados.
Principais recursos
- Zyte API com extração automática (com IA)
- Rotação inteligente de proxies e tratamento anti-bot
- Integração profunda com Scrapy
- Tempos de resposta rápidos em benchmarks independentes
- Suporte a dados imobiliários para preço, especificações do imóvel, descrições, imagens, localização e disponibilidade
Preço e plano gratuito
- Crédito grátis de US$ 5 por 30 dias
- Preço baseado no uso; CPM competitivo em benchmarks
- Sem template dedicado do Zillow — usa autoextração genérica
Prós e contras
- Prós: tempos de resposta muito rápidos, forte integração com Scrapy, extração por IA reduz manutenção de seletores
- Contras: suporte no-code apenas parcial, sem template específico para Zillow, saída só em JSON, exige configuração técnica
Melhor para: equipes técnicas que já usam Scrapy ou que precisam de autoextração com IA para pipelines duradouros de Zillow.
5. ScrapingBee
 ScrapingBee é uma das APIs de scraping mais simples que existem. Você envia uma URL e recebe HTML renderizado ou JSON de volta. Não é específico do Zillow, mas já inclui renderização JavaScript e rotação de proxy.
Principais recursos
- API REST simples: uma requisição, uma resposta renderizada
- Renderização JavaScript incluída
- Rotação de proxy e tratamento anti-bot embutidos
- Documentação direta — achei a configuração uma das mais rápidas entre as ferramentas de API
Preço e plano gratuito
- 1.000 créditos grátis de API ao se cadastrar (suficiente para cerca de 50–100 páginas do Zillow, dependendo das tentativas)
- Planos pagos a partir de US$ 49/mês
Prós e contras
- Prós: plano gratuito generoso, API simples, boa documentação, confiável para prototipagem
- Contras: exige código, sem template do Zillow, saída em JSON/HTML (você terá que analisar), sem enriquecimento de subpágina, sem exportação nativa para planilhas
Melhor para: desenvolvedores que querem prototipar rapidamente um pipeline de scraping do Zillow sem montar uma infraestrutura pesada.
6. Apify
 Apify é uma plataforma em nuvem com um marketplace de “actors” prontos para scraping. Para Zillow, existem vários actors criados pela comunidade — Search Scraper, Detail Scraper, API Scraper, ZIP Code Scraper — que você pode executar sem escrever sua própria lógica de extração.
Principais recursos
- Mais de 4 actors do Zillow criados pela comunidade com cobertura documentada de campos: zpid, status, preço, Zestimate, Rent Zestimate, quartos, banheiros, metragem, tamanho do terreno, ano de construção, tipo de imóvel, taxa HOA, preço por metro quadrado, dias no Zillow, endereço, corretor, agente, telefone, descrição, fotos, histórico de preços, histórico fiscal, escolas, características
- Agendamento, rotação de proxy e paginação embutidos
- Padrão de scraping em dois passos: o Search Actor coleta URLs, e o Detail Actor enriquece cada anúncio
- Saída em JSON, CSV, XML, Excel ou JSONL
Preço e plano gratuito
- US$ 5 em créditos mensais grátis no plano gratuito da plataforma
- Planos pagos a partir de US$ 29/mês; pagamento conforme uso a US$ 0,25 por Compute Unit
Prós e contras
- Prós: actors do Zillow feitos sob medida com boa profundidade de campos, agendamento integrado, experiência parcial sem código pela interface da plataforma
- Contras: actors da comunidade podem ficar desatualizados se o Zillow mudar o layout, o enriquecimento de subpáginas depende da qualidade do actor, curva de aprendizado maior do que uma extensão de navegador
Melhor para: usuários confortáveis com uma interface de plataforma em nuvem e que querem fluxos prontos do Zillow com agendamento.
7. Decodo (Smartproxy)
 Decodo (antiga Smartproxy) oferece uma página dedicada de Zillow Scraper API — algo que a maioria dos provedores de proxy não entrega. Ela combina funcionalidades de API de scraping com rotação de proxy residencial e mostrou taxas de sucesso quase perfeitas no Zillow no benchmark de 2025 da Proxyway.
Principais recursos
- API de scraper dedicada ao Zillow com foco específico no alvo
- Campos do Zillow documentados: dados de preço, detalhes do imóvel, anúncios de aluguel, localização, imóveis próximos, status do anúncio, impostos, dados do corretor, características e atributos
- Suporte à renderização JavaScript
- Rotação de proxy residencial
Preço e acesso
- Teste grátis de 7 dias com 1.000 requisições
- Planos pagos a partir de US$ 9, US$ 49, US$ 99 e opções personalizadas
- Saída: HTML, JSON, CSV analisado em alguns modos
Prós e contras
- Prós: documentação forte e específica para Zillow, preço competitivo, taxa de sucesso muito alta em benchmarks no Zillow (99,98% segundo testes da Proxyway)
- Contras: exige código, sem opção no-code, enriquecimento de subpágina limitado, sem exportação nativa para planilhas
Melhor para: desenvolvedores que querem uma API gerenciada específica para Zillow, com bom tratamento anti-bot e preço competitivo.
8. ScraperAPI
 ScraperAPI tem uma das páginas de solução mais explícitas para Zillow entre as ferramentas de API. Ela documenta a extração de preços de imóveis, endereços, fotos, Zestimate, metragem, HOA, visualizações/salvamentos, horário da última atualização do anúncio, provedor do anúncio, tempos de deslocamento, características, valor anual de imposto, data em que foi listado e detalhes do lote/parcela.
Principais recursos
- Página dedicada de Zillow Scraper API com documentação detalhada dos campos
- Integração de API em uma linha
- Rotação automática de proxy e tratamento anti-bot
- Renderização JavaScript
- Produto DataPipeline para agendamento (inclusive de hora em hora via cron)
- Saída: HTML, JSON, CSV, Markdown, texto
Preço e plano gratuito
- Teste grátis de 7 dias
- Planos pagos a partir de US$ 49/mês (plano Hobby e acima)
Prós e contras
- Prós: uma das melhores histórias de enriquecimento para Zillow, boas ferramentas de pipeline para tarefas recorrentes, documentação explícita por campo
- Contras: exige código, sem opção no-code, saída focada em API exige parsing para uso em planilhas
Melhor para: desenvolvedores construindo pipelines de dados do Zillow em produção e que querem extração detalhada de campos e agendamento.
9. Outscraper
 Outscraper é um serviço de scraping em nuvem com uma página dedicada ao Zillow Search Scraper. É uma das opções mais simples para quem precisa extrair dados do Zillow de vez em quando, sem uma configuração pesada.
Principais recursos
- Interface em nuvem com foco em Zillow
- Saída estruturada: anúncios, preços, endereços, descrições, fotos
- Exportação para CSV, Excel, Parquet, JSON
- Experiência parcial sem código pela área web
Preço e plano gratuito
- Grátis antes de 500 anúncios
- Cerca de US$ 2 por 1.000 registros depois de 500 anúncios
- Tarifa Business em torno de US$ 1 por 1.000 após 5.000 anúncios
Prós e contras
- Prós: foco no Zillow, experiência parcial sem código, vários formatos de exportação, muito barato em escala
- Contras: cota gratuita pequena, sem enriquecimento de subpágina, documentação mais básica que a das líderes, integrações limitadas em comparação com Thunderbit
Melhor para: extrações pontuais ou ocasionais de dados do Zillow com orçamento enxuto.
10. NetNut
 NetNut é principalmente um fornecedor de proxy e unblocker de sites. Ele não tem um template ou endpoint dedicado ao Zillow — apenas um tutorial no blog sobre como montar você mesmo um scraper do Zillow usando a infraestrutura de proxy deles.
Principais recursos
- Grande rede de proxies residenciais e ISP
- Tempos de resposta rápidos em testes de benchmark
- Produto Website Unblocker para contornar anti-bot
- Acesso via API para integrar com scripts de scraping personalizados
Preço e acesso
- Sem plano gratuito público; teste grátis via formulário disponível
- Website Unblocker a partir de US$ 99/mês
- Sem template do Zillow — requer configuração personalizada
- Saída: nenhuma nativa (você gerencia)
Prós e contras
- Prós: infraestrutura de proxy rápida, rede forte para uso em alto volume
- Contras: exige código, sem opção no-code, sem template do Zillow, sem exportação nativa, sem enriquecimento de subpágina — é infraestrutura, não um scraper pronto
Melhor para: equipes que já têm sua própria lógica de scraping e precisam de infraestrutura confiável de proxy/unblocker para coleta em larga escala de dados do Zillow.
As defesas anti-bot do Zillow: por que a escolha do scraper importa
Essa seção merece destaque próprio porque é a frustração mais comum que ouço de quem tenta fazer scraping no Zillow. Se você entender por que os scrapers falham, fica muito mais fácil escolher a ferramenta certa.
O que a camada anti-bot do Zillow realmente faz
O ScrapeOps classifica o Zillow com dificuldade 8/10 para scraping. Não é erro de digitação. O Zillow usa PerimeterX (hoje HUMAN Security) junto com proteções Cloudflare e AWS WAF Captcha. Esses sistemas:
- Criam fingerprint do comportamento do navegador (movimento do mouse, padrões de renderização, execução JavaScript)
- Detectam padrões de automação (navegadores headless, requisições em alta velocidade)
- Bloqueiam IPs de data center imediatamente
- Usam seletores CSS ofuscados — nomes de classe gerados automaticamente que mudam com frequência e quebram scrapers baseados em DOM
Se você já recebeu um erro 403 ou um CAPTCHA de “pressione e segure” ao tentar raspar o Zillow, é o PerimeterX em ação.
Como os diferentes tipos de scraper lidam com anti-bot
Extensões de navegador (como o Thunderbit) rodam na sessão real do Chrome do usuário. Elas herdam cookies reais, fingerprints reais e o estado de login — o que contorna naturalmente muitas verificações de fingerprint sem precisar de proxy. O Thunderbit também oferece scraping em nuvem com tratamento anti-bot embutido para páginas publicamente disponíveis.
Ferramentas de API e proxy lidam com anti-bot por meio de proxies residenciais rotativos, renderização de navegador no servidor e lógica de retry. Funcionam bem, mas exigem configuração — e você paga por essa infraestrutura.
Scripts Python feitos do zero (usando BeautifulSoup, Selenium etc.) exigem rotação manual de proxy, gerenciamento de headers e manutenção constante sempre que o Zillow atualiza suas defesas. Usuários de fóruns relatam com frequência que esses projetos quebram bastante: “projetos de scraping precisam de manutenção constante por causa das mudanças.”
É por isso que arquitetura não é só um detalhe técnico — ela influencia diretamente se o seu scraper realmente funciona no Zillow.
O confronto dos planos gratuitos: raspar o Zillow com orçamento de US$ 0
Não encontrei um único artigo concorrente cobrindo opções gratuitas em detalhe real — o que é uma falha, porque muita gente quer testar antes de pagar. Veja o que realmente dá para fazer sem gastar nada:
| Ferramenta | Limite grátis | Específico do Zillow? | Basta para um teste? |
|---|---|---|---|
| Thunderbit | 6 páginas (10 com teste) + exportação grátis + extratores grátis de e-mail/telefone | ✅ Template do Zillow incluído | ✅ Suficiente para 1–2 bairros |
| ScrapingBee | 1.000 créditos de API | ❌ Genérico | ⚠️ Cerca de 50–100 páginas, dependendo das tentativas |
| ScraperAPI | Teste de 7 dias | ❌ Genérico | ✅ Volume razoável para teste |
| Apify | US$ 5 em créditos mensais | ⚠️ Actor da comunidade para Zillow | ⚠️ O actor pode estar desatualizado |
| Zyte | Crédito de US$ 5 por 30 dias | ❌ Genérico | ⚠️ Exige configuração |
| Outscraper | Grátis antes de 500 anúncios | ✅ Focado em Zillow | ✅ Bom para testes pequenos |
| Decodo | Teste de 7 dias, 1.000 requisições | ✅ API do Zillow | ✅ Volume razoável para teste |
| Bright Data | 5.000 créditos grátis/mês | ✅ Scraper do Zillow | ✅ Limite mensal recorrente |
| Oxylabs | Teste até 2.000 resultados | ⚠️ Parcial | ⚠️ Apenas teste |
| NetNut | Teste via formulário | ❌ | ⚠️ Apenas infraestrutura |
Um ponto importante: a exportação gratuita do Thunderbit para Excel, Google Sheets, Airtable, Notion, CSV e JSON é totalmente liberada, sem bloqueio. A maioria das ferramentas de API exige que você monte seu próprio pipeline de exportação, mesmo nos planos grátis.
Se você só precisa testar uma ou duas regiões para ver se a ferramenta funciona no seu fluxo, o plano gratuito do Thunderbit e o modelo “grátis antes de 500” do Outscraper são os pontos de partida mais práticos para usuários não técnicos. Para desenvolvedores, os 1.000 créditos do ScrapingBee e o teste de 7 dias da Decodo já dão espaço suficiente para prototipar.
Do scraping à planilha: fluxos de exportação que realmente importam
Eu insisto nesse ponto porque é a lacuna que mais vejo na prática. Ninguém acorda pensando “quero raspar o Zillow”. As pessoas querem os dados do Zillow na planilha, no CRM ou no banco de dados imobiliário para tomar decisões. O scraping é só o meio.
Quais formatos de exportação cada ferramenta oferece
A maioria das ferramentas de API gera JSON bruto. Isso é ótimo para desenvolvedores, mas, para um corretor que precisa de uma análise comparativa no Google Sheets, JSON bruto significa etapas extras — escrever um parser, usar Zapier ou reformatar os dados manualmente. A tabela de comparação acima mostra o panorama completo, mas a versão curta é:
- Thunderbit: exportação direta para Excel, Google Sheets, Airtable, Notion, CSV e JSON — tudo grátis
- Apify: JSON, CSV, XML, Excel, JSONL
- Outscraper: CSV, Excel, Parquet, JSON
- Todos os outros: principalmente JSON/HTML via API, exigindo script adicional para chegar a um formato utilizável
Como levar os dados do Zillow para o Google Sheets ou Excel com o Thunderbit
O fluxo é realmente simples: raspe uma página de resultados do Zillow → clique no botão de exportação → escolha Google Sheets ou Excel → pronto. Sem parsing, sem Zapier, sem ferramentas extras. Se você exportar para Airtable ou Notion, as fotos dos imóveis aparecem como campos de imagem reais — não apenas strings de URL — o que é útil se você mantém um banco de dados visual de imóveis.
Por que isso importa mais do que parece
Para equipes que mantêm bancos de dados imobiliários, fazem importação para CRM ou constroem planilhas de análise de mercado, a “última milha” entre o scraping e o dado útil é onde a maioria das ferramentas falha. Uma ferramenta que entrega dados limpos e estruturados diretamente nos seus sistemas economiza horas de trabalho em cada projeto. Na minha experiência, essa é a diferença entre um scraper que é usado uma vez e outro que vira parte do fluxo diário da equipe.
Qual scraper do Zillow combina com O SEU fluxo? Recomendações por caso de uso
Se você não quiser ler os dez itens, aqui vai o atalho com base no que você realmente quer fazer.
Corretor imobiliário: geração de leads e extração de contatos
Você precisa de contatos de imóveis FSBO ou anúncios expirados, telefones, e-mails e detalhes básicos do imóvel — exportados para uma planilha ou CRM.
Melhor escolha: Thunderbit. A combinação de template do Zillow com 1 clique, extratores gratuitos de e-mail/telefone e exportação direta para Google Sheets foi feita exatamente para esse caso.
Investidor imobiliário: análise de negócios, comparáveis e detalhes do imóvel
Você precisa de dados em massa dos imóveis, mais histórico de preços, histórico de impostos e campos detalhados da página do imóvel para análise de ARV ou modelagem de fluxo de caixa.
Melhores escolhas: Thunderbit (scraping de subpágina para enriquecer detalhes do imóvel) para lotes menores, ou Bright Data (dataset com mais de 173 milhões de registros) para análise histórica grande ou multi-mercado.
Equipe de marketing: relatórios de mercado e instantâneos competitivos
Você precisa de snapshots de anúncios por CEP, scrapes agendados para monitoramento contínuo e exportação para Sheets para relatórios voltados ao cliente.
Melhor escolha: Thunderbit (scraper agendado + exportação para Google Sheets) para equipes que querem um fluxo sem código. Apify é uma boa alternativa se sua equipe se sente confortável com uma plataforma em nuvem e quer agendamento baseado em actors.
Desenvolvedor PropTech: construindo um SaaS ou pipeline de dados
Você precisa de acesso a API em alto volume, uptime confiável, respostas JSON estruturadas e infraestrutura anti-bot forte.
Melhores escolhas: Bright Data, Oxylabs, ScraperAPI ou Zyte — todas oferecem infraestrutura robusta de API com documentação ou endpoints específicos para Zillow.
Conclusão: escolhendo o melhor scraper do Zillow para suas necessidades
O “melhor” scraper do Zillow depende totalmente do seu nível técnico, do seu orçamento e do que você quer conquistar.
Se você é um usuário não técnico e quer os dados do Zillow em uma planilha rapidamente, o Thunderbit é a escolha mais clara. É a única ferramenta desta lista que combina sem código, template dedicado do Zillow, enriquecimento de subpáginas, exportação gratuita para ferramentas de negócios e uma arquitetura baseada em navegador que lida naturalmente com as proteções anti-bot do Zillow. Você pode testar o template grátis do scraper do Zillow da Thunderbit e ver por conta própria — sem cartão de crédito, sem chave de API, sem código.
Se você é desenvolvedor e está construindo pipelines em produção, Bright Data, Oxylabs e Zyte oferecem a infraestrutura mais robusta. ScraperAPI e Decodo são opções intermediárias fortes, com suporte explícito ao Zillow.
Se o orçamento é apertado e você quer testar antes de se comprometer, comece pelos planos gratuitos do Thunderbit, Outscraper ou ScrapingBee.
E se você precisa de infraestrutura de proxy em alto volume, Decodo e NetNut oferecem uma base sólida — só lembre de trazer sua própria lógica de scraping.
Independentemente da escolha, o cenário de dados imobiliários em 2026 muda rápido demais para copiar e colar manualmente. Escolha uma ferramenta, teste em um bairro ou dois e volte ao trabalho que realmente importa — analisar oportunidades, fechar clientes e tomar decisões melhores.
Experimente o Scraper do Zillow da Thunderbit Get Started Free
Perguntas frequentes
É legal fazer scraping no Zillow?
O Zillow exibe publicamente uma grande quantidade de informações sobre imóveis, mas seus Termos de Uso restringem explicitamente scraping automatizado, bots e bypass de CAPTCHA. O cenário legal em torno da extração de dados públicos ainda está mudando. Para uso comercial ou em larga escala, vale revisar os termos do Zillow e consultar orientação jurídica. Este artigo fala sobre ferramentas e tecnologia, não é aconselhamento legal.
Posso fazer scraping no Zillow sem programar?
Sim. Ferramentas de extensão de navegador como Thunderbit permitem scraping com 1 clique e templates prontos para Zillow. Sem chaves de API, sem código, sem precisar de desenvolvedor. Você acessa uma página do Zillow, clica uma vez, deixa a IA ler a página e escolher os dados, ou descreve o que quer com suas próprias palavras, e exporta direto para Excel ou Google Sheets.
Quantos anúncios do Zillow consigo extrair grátis?
Depende da ferramenta. O Thunderbit oferece 6 páginas grátis (10 com teste) além de exportação totalmente gratuita. O Outscraper é grátis antes de 500 anúncios. O ScrapingBee oferece 1.000 créditos de API grátis. O Apify fornece US$ 5 em créditos gratuitos mensais. A Decodo oferece teste de 7 dias com 1.000 requisições. Para a maioria dos usuários, o plano gratuito do Thunderbit já basta para testar uma ou duas regiões.
Qual é o melhor scraper do Zillow para corretores imobiliários?
Thunderbit — ele combina um template do Zillow com 1 clique, extratores gratuitos de e-mail e telefone, exportação direta para Google Sheets, scraping agendado e uma interface sem código feita para usuários não técnicos. Você não precisa configurar APIs, gerenciar proxies nem escrever código.
Por que os scrapers do Zillow são bloqueados?
O Zillow usa PerimeterX (HUMAN Security) e Cloudflare para detectar requisições automatizadas. Esses sistemas criam fingerprint do comportamento do navegador, bloqueiam IPs de data center e usam seletores CSS dinâmicos que quebram scrapers baseados em DOM. Ferramentas que usam IPs de data center ou não gerenciam fingerprint do navegador são bloqueadas rapidamente. Extensões de navegador e ferramentas baseadas em proxies residenciais lidam melhor com isso porque se parecem mais com o comportamento real de um usuário.
Saiba mais



