Czy zdarzyło Ci się utknąć na stronie, która prawie nic nie mówiła, a żeby znaleźć to, czego potrzebujesz, musiałeś klikać przez kolejne linki? To naprawdę męczące, zwłaszcza gdy coraz więcej serwisów chowa ważne dane na podstronach. Taki układ utrudnia pracę każdemu, kto chce zbierać dane na większą skalę. Programiści potem spędzają godziny na pisaniu skryptów, które mają przebić się przez te podstrony, a osoby nietechniczne muszą klikać każdy link ręcznie. Na szczęście są na to rozwiązania: list crawling (znany też jako bulk scraping) oraz subpage scraping.
List Crawling i Subpage Scraping w skrócie
| Narzędzie | Łatwość użycia | Jakość danych | Najlepsze zastosowanie |
|---|---|---|---|
| List Crawling | ★★ | ★★★ | Duże serwisy internetowe |
| Subpage Scraping | ★★★★★ | ★★★★ | Lekkie scrapingowanie, konkretne formaty danych |
Na czym polega List Crawling
Czym jest List Crawling?
List crawling, czyli bulk scraping, to metoda web scrapingu, która pobiera dane z listy adresów URL. Na początek potrzebujesz listy linków, co często oznacza, że wcześniej trzeba użyć innego crawlera, żeby je zebrać. Skuteczność list crawlningu w dużej mierze zależy od jakości tej wyjściowej listy. Jeśli linki prowadzą do stron o różnych układach, wyniki mogą być niespójne, a cały proces zajmie sporo czasu. Ta metoda świetnie sprawdza się w firmach, badaniach i analizie danych, wszędzie tam, gdzie trzeba pobierać ogromne ilości uporządkowanych, spójnych danych z internetu. Trzeba jednak pamiętać, że zebrane informacje często wymagają jeszcze ręcznego czyszczenia i porządkowania, zanim staną się naprawdę użyteczne.
Jak to działa
Proces list crawlningu zwykle składa się z kilku kroków:
- Przygotowanie listy URL-i: Zaczynasz od listy docelowych adresów stron.
- Wysyłanie żądań HTTP: System wysyła zapytania do tych adresów, aby pobrać zawartość HTML.
- Wyodrębnianie danych: Do pobierania potrzebnych informacji, takich jak tekst, obrazy i linki, wykorzystuje się techniki parsowania, np. BeautifulSoup, XPath albo wyrażenia regularne.
- Zapis danych: Wyodrębnione dane są porządkowane i zapisywane w bazie danych lub arkuszu kalkulacyjnym do dalszej analizy.
Zbieraj dane z dowolnej strony internetowej z pomocą AI Get Started Free
Po zebraniu danych warto je oczyścić i przeanalizować, wykorzystując metody takie jak statystyka opisowa, analiza szeregów czasowych, analiza korelacji czy clustering. AI może mocno przyspieszyć ten etap, automatyzując zadania i poprawiając jakość danych.
Sprawdź funkcję Bulk Scraping w Thunderbit AI Web Scraper, aby pracować szybciej i wygodniej.
Polecane narzędzia
- Bulk Scraping w Thunderbit AI Web Scraper
- Zalety: intuicyjne w obsłudze, elastyczne parsowanie, rozbudowane funkcje
- Wady: wymaga uruchomienia lokalnie i zależy od przeglądarki
- Najlepsze dla: wysokiej jakości zbierania danych, gdy ważniejsza jest jakość niż ilość
- Scrapy
- Zalety: wydajny, bardzo elastyczny, wspiera scraping na dużą skalę
- Wady: stroma krzywa nauki, wymaga umiejętności programowania
- Najlepsze dla: dużych projektów pozyskiwania danych
- Beautiful Soup
- Zalety: prosty w użyciu, bogata dokumentacja, elastyczne parsowanie
- Wady: przeciętna wydajność, brak obsługi operacji asynchronicznych
- Najlepsze dla: małych projektów scrapingowych, analizy danych
- Selenium
- Zalety: obsługuje dynamiczne strony, potrafi symulować zachowanie użytkownika
- Wady: wolne działanie, duże zużycie zasobów
- Najlepsze dla: stron renderowanych przez JavaScript
Poznaj Subpage Scraping
Czym jest Subpage Scraping?
Subpage scraping to metoda web scrapingu, która pobiera dane z listy na jednej stronie i łączy informacje z podstron w głównej tabeli. Thunderbit wprowadził ten innowacyjny proces scrapingu, wykorzystując możliwości AI w swoim narzędziu AI Web Scraper. To idealne rozwiązanie dla stron z podstronami, takich jak karty produktów, blogi czy serwisy nawigacyjne. Zaletą subpage scrapingu jest to, że potrafi inteligentnie pobierać i przetwarzać informacje z tych podstron, a następnie scalać je w jedną tabelę.
Na przykład, jeśli czytasz artykuł „Stock Market Today” i chcesz zebrać listę wszystkich notowań giełdowych, możesz skorzystać z Thunderbit AI Web Scraper. Wystarczy zdefiniować tabelę, a narzędzie automatycznie wyciągnie notowania i otworzy ich strony z danymi w czasie rzeczywistym, po czym połączy wszystko w Twojej głównej tabeli. Dzięki temu możesz zapisać dokładne informacje, jednocześnie czytając wiadomości. Thunderbit AI Web Scraper potrafi dopasować się do różnych stron, czego tradycyjne narzędzia scrapingowe zwykle nie potrafią.
Dlaczego warto go używać?
Thunderbit AI Web Scraper oferuje funkcje, które wyraźnie zwiększają efektywność i dokładność pozyskiwania danych.
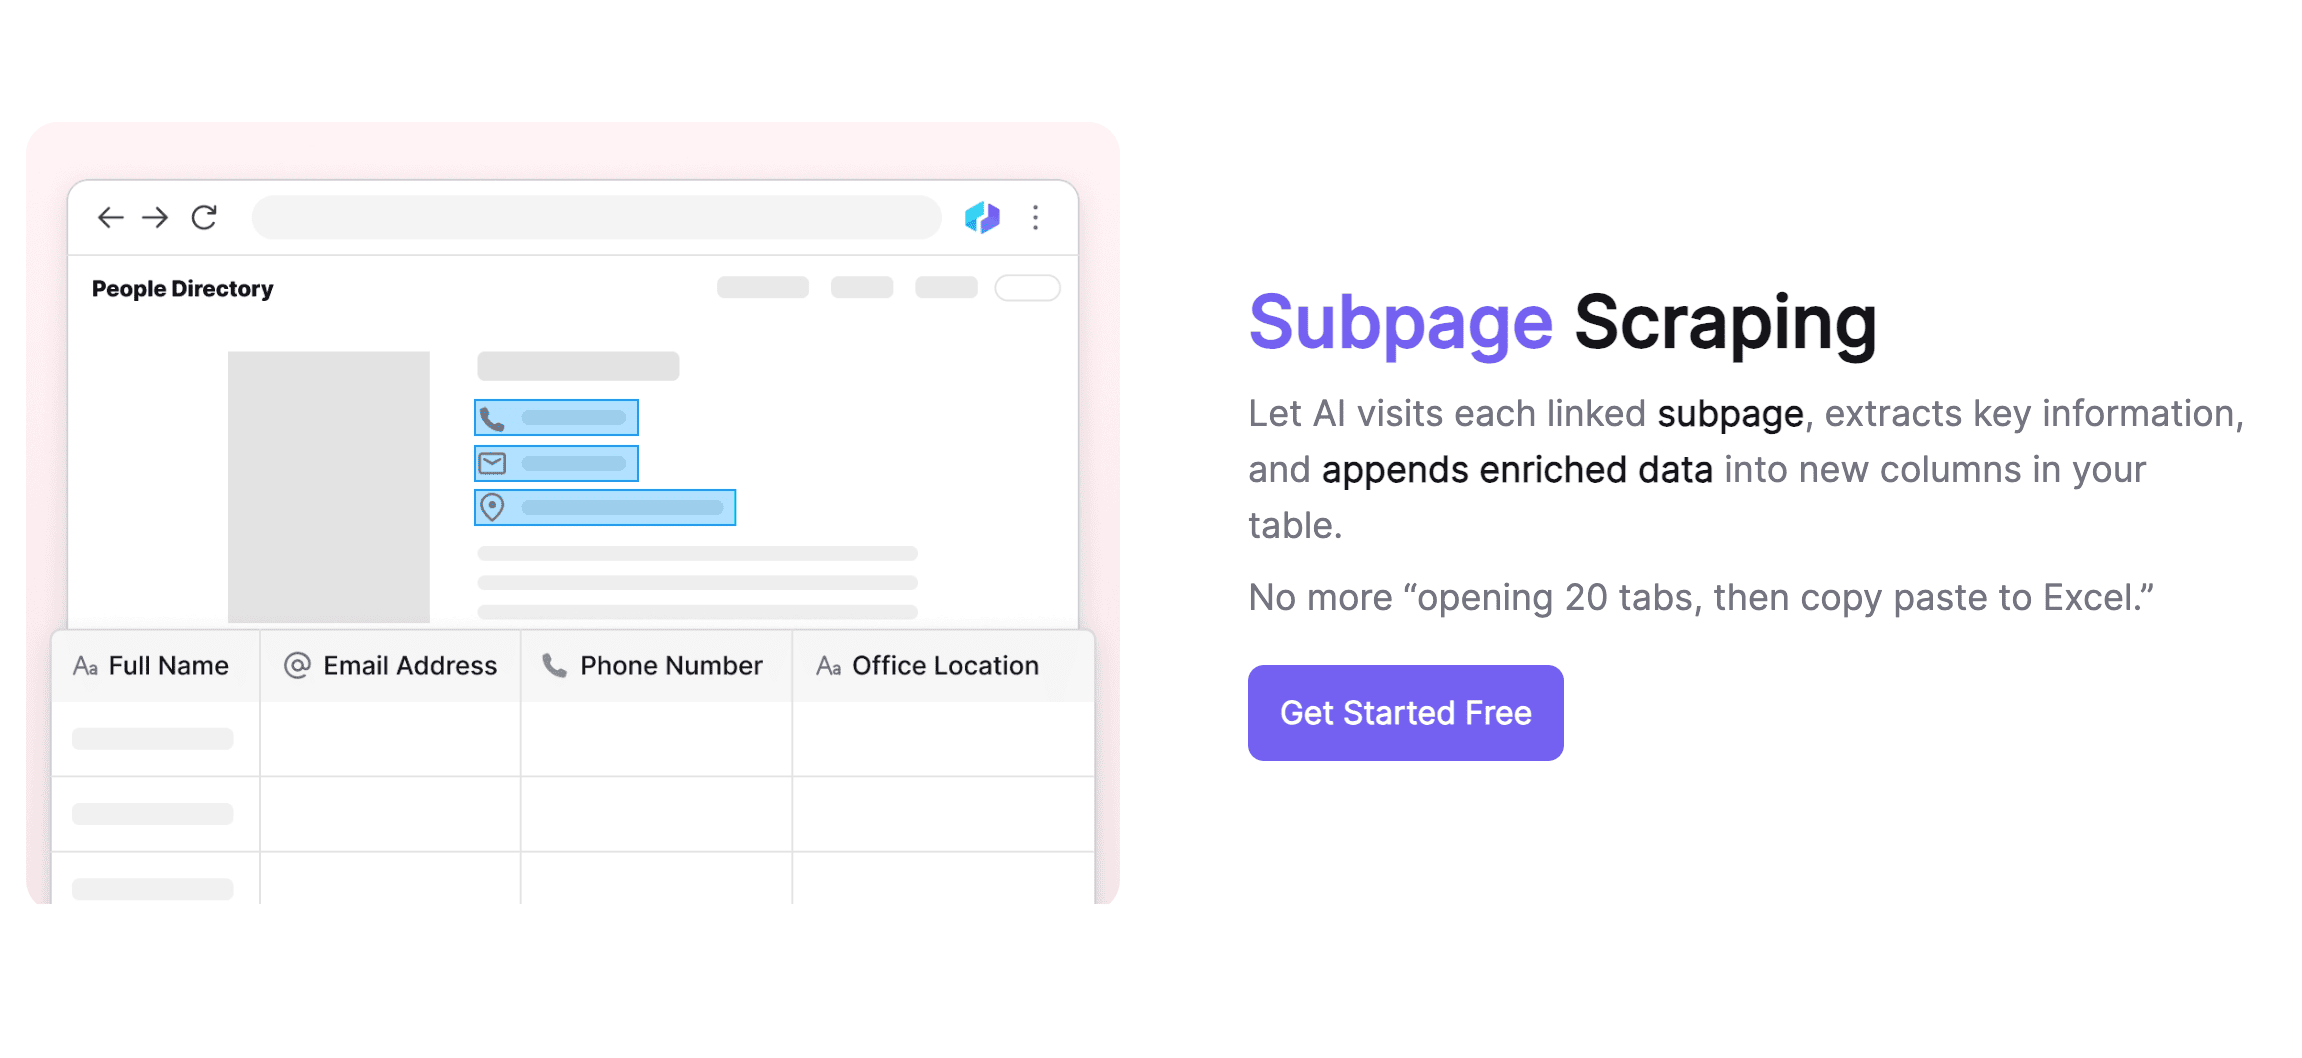
Inteligentne wyodrębnianie danych
Thunderbit AI Web Scraper wykorzystuje AI do inteligentnego pobierania danych i automatycznie dostosowuje się do zmian w strukturze strony. Użytkownik może opisać potrzebne dane prostym językiem, a system sam generuje reguły ekstrakcji. Takie podejście nie tylko poprawia dokładność, ale też obniża próg wejścia, dzięki czemu osoby nietechniczne mogą łatwo zbierać dane. Thunderbit obsługuje różne typy danych, w tym tekst, linki i obrazy, odpowiadając na zróżnicowane potrzeby użytkowników.
Inteligentna obsługa podstron
Thunderbit szczególnie dobrze radzi sobie z przetwarzaniem podstron. Potrafi inteligentnie rozpoznawać podstrony i przechodzić do nich, korzystając z jednego szablonu dla różnych układów. AI dopasowuje się do zmian w strukturze strony, więc użytkownik nie musi martwić się różnymi wersjami podstron. Thunderbit automatycznie łączy zawartość podstron z główną tabelą, pomagając lepiej uporządkować informacje. Świetnie wypada też pod względem jakości danych, działając jak asystent AI, który czyści i formatuje dane oraz wykonuje powtarzalne zadania, takie jak etykietowanie.
Efektywne zarządzanie danymi
Thunderbit oferuje wygodne funkcje zarządzania danymi, wspierając wiele formatów eksportu i integracje z platformami takimi jak Google Sheets, Airtable i Notion. Możesz połączyć szablon scrapera z arkuszem Google, aby zebrać dane w jednym miejscu, albo wysłać je do Notion i uporządkować w bazie danych Notion. Tak elastyczne opcje eksportu pozwalają wybrać sposób przechowywania danych najlepiej dopasowany do potrzeb. Niestandardowe etykietowanie i klasyfikacja danych mogą też automatycznie dostosowywać się do formatów używanych przez platformy zarządzania, co usprawnia późniejszą pracę z danymi.
Praktyczne gotowe szablony
Aby zwiększyć efektywność pracy użytkowników, Thunderbit udostępnia szeroką gamę gotowych szablonów. Obejmują one m.in. zbieranie danych e-commerce (np. Amazon, Amazon Reviews), scraping informacji o nieruchomościach (np. Zillow Properties), analizę danych z mediów społecznościowych (np. TikTok, Twitter) oraz pozyskiwanie informacji biznesowych (np. strony firmowe, katalogi firm). Takie szablony oszczędzają czas i zapewniają spójność oraz dokładność pozyskiwanych danych.
Wdrożenie krok po kroku
Jak wdrożyć Subpage Scraping
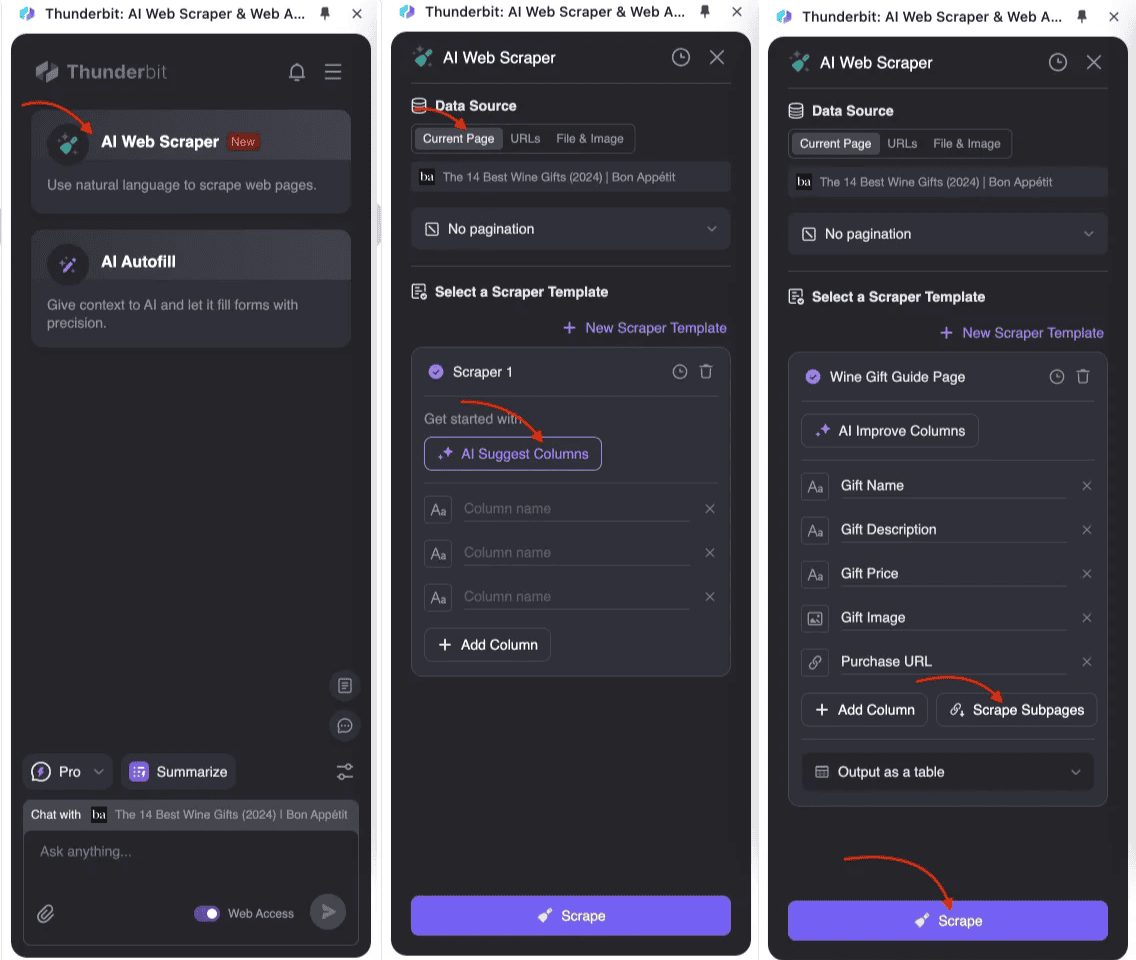
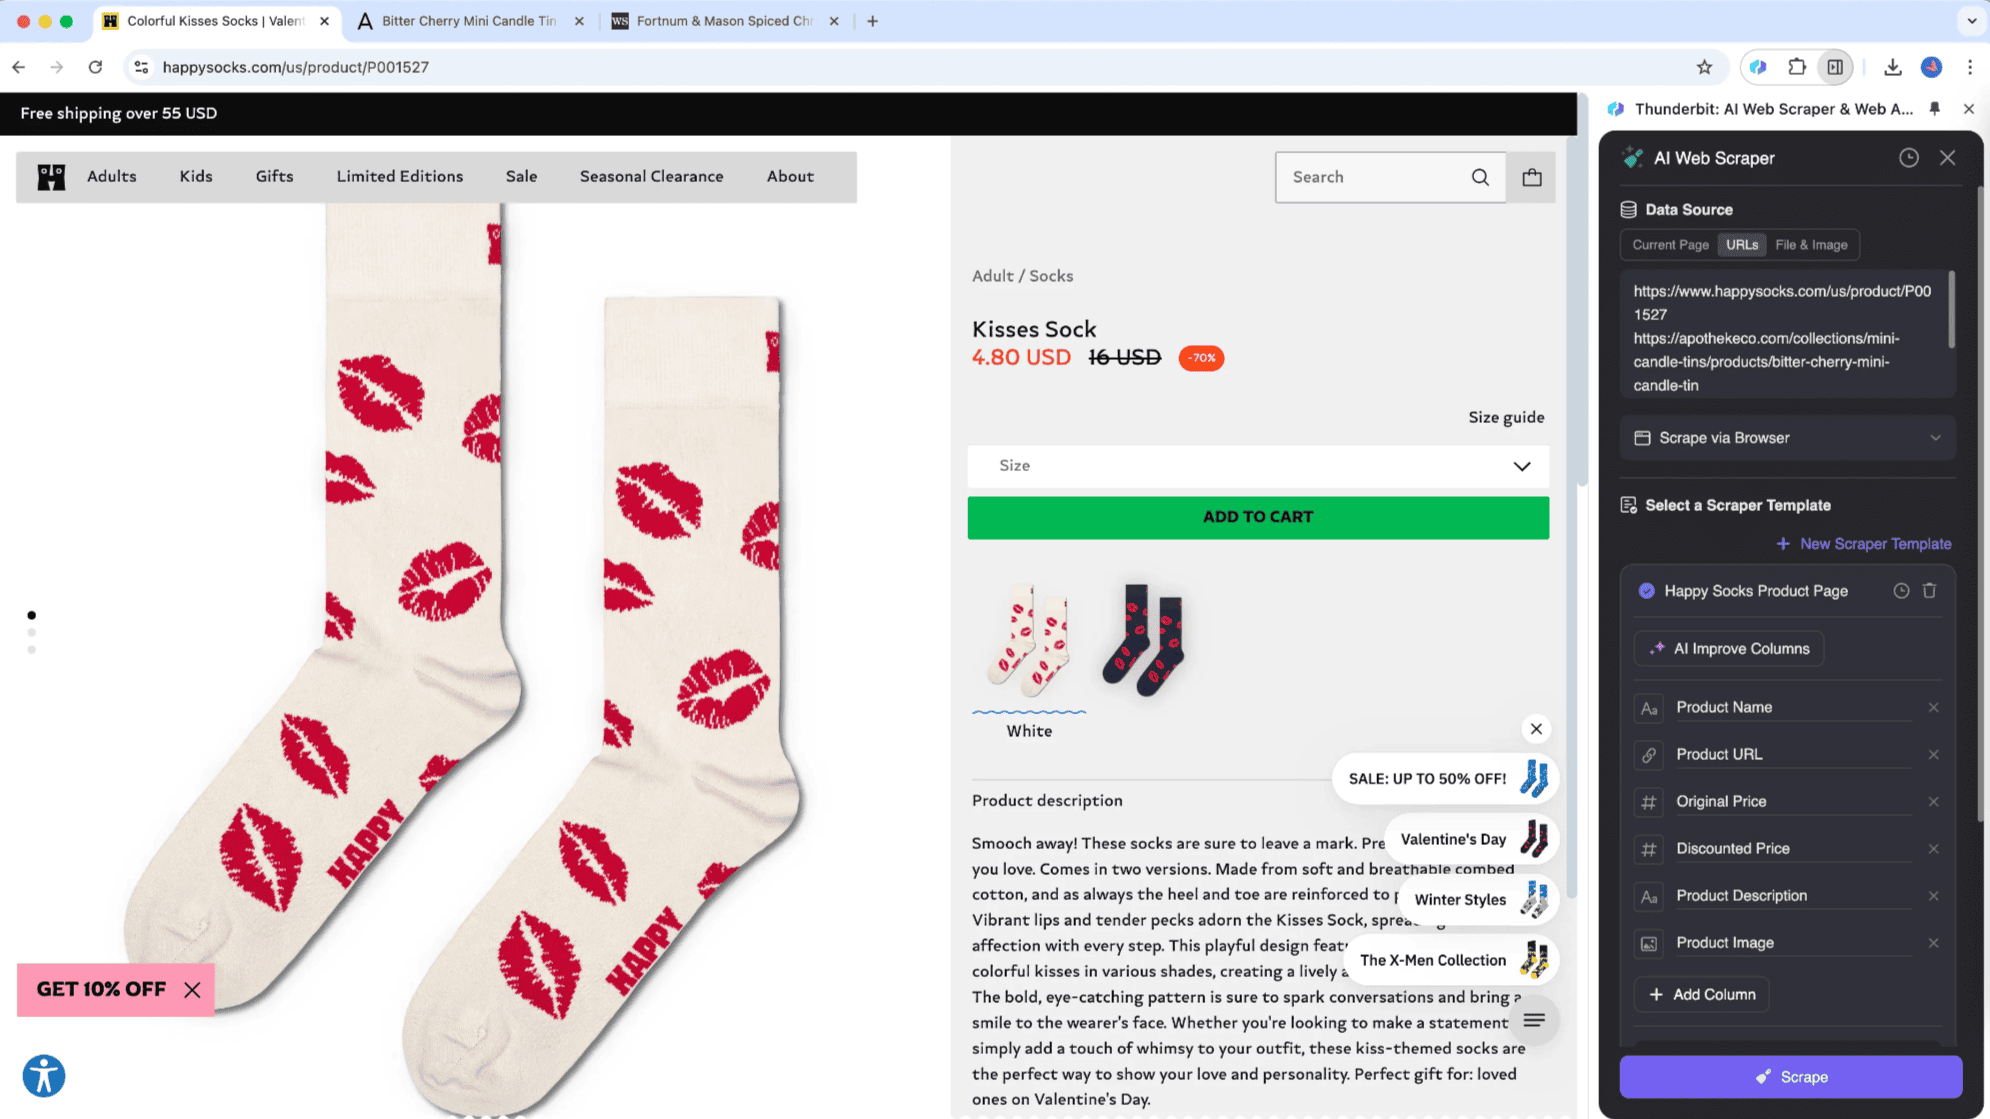
- Zainstaluj rozszerzenie Thunderbit Browser Extension: Otwórz Thunderbit AI Web Scraper i utwórz nowy szablon scrapera.
- Zdefiniuj strukturę głównej tabeli: W ustawieniach tabeli dodaj pola, które chcesz zebrać, np. tytuł, cena i opis. W przypadku danych z podstron utwórz odpowiednie pola i włącz scraping podstron.
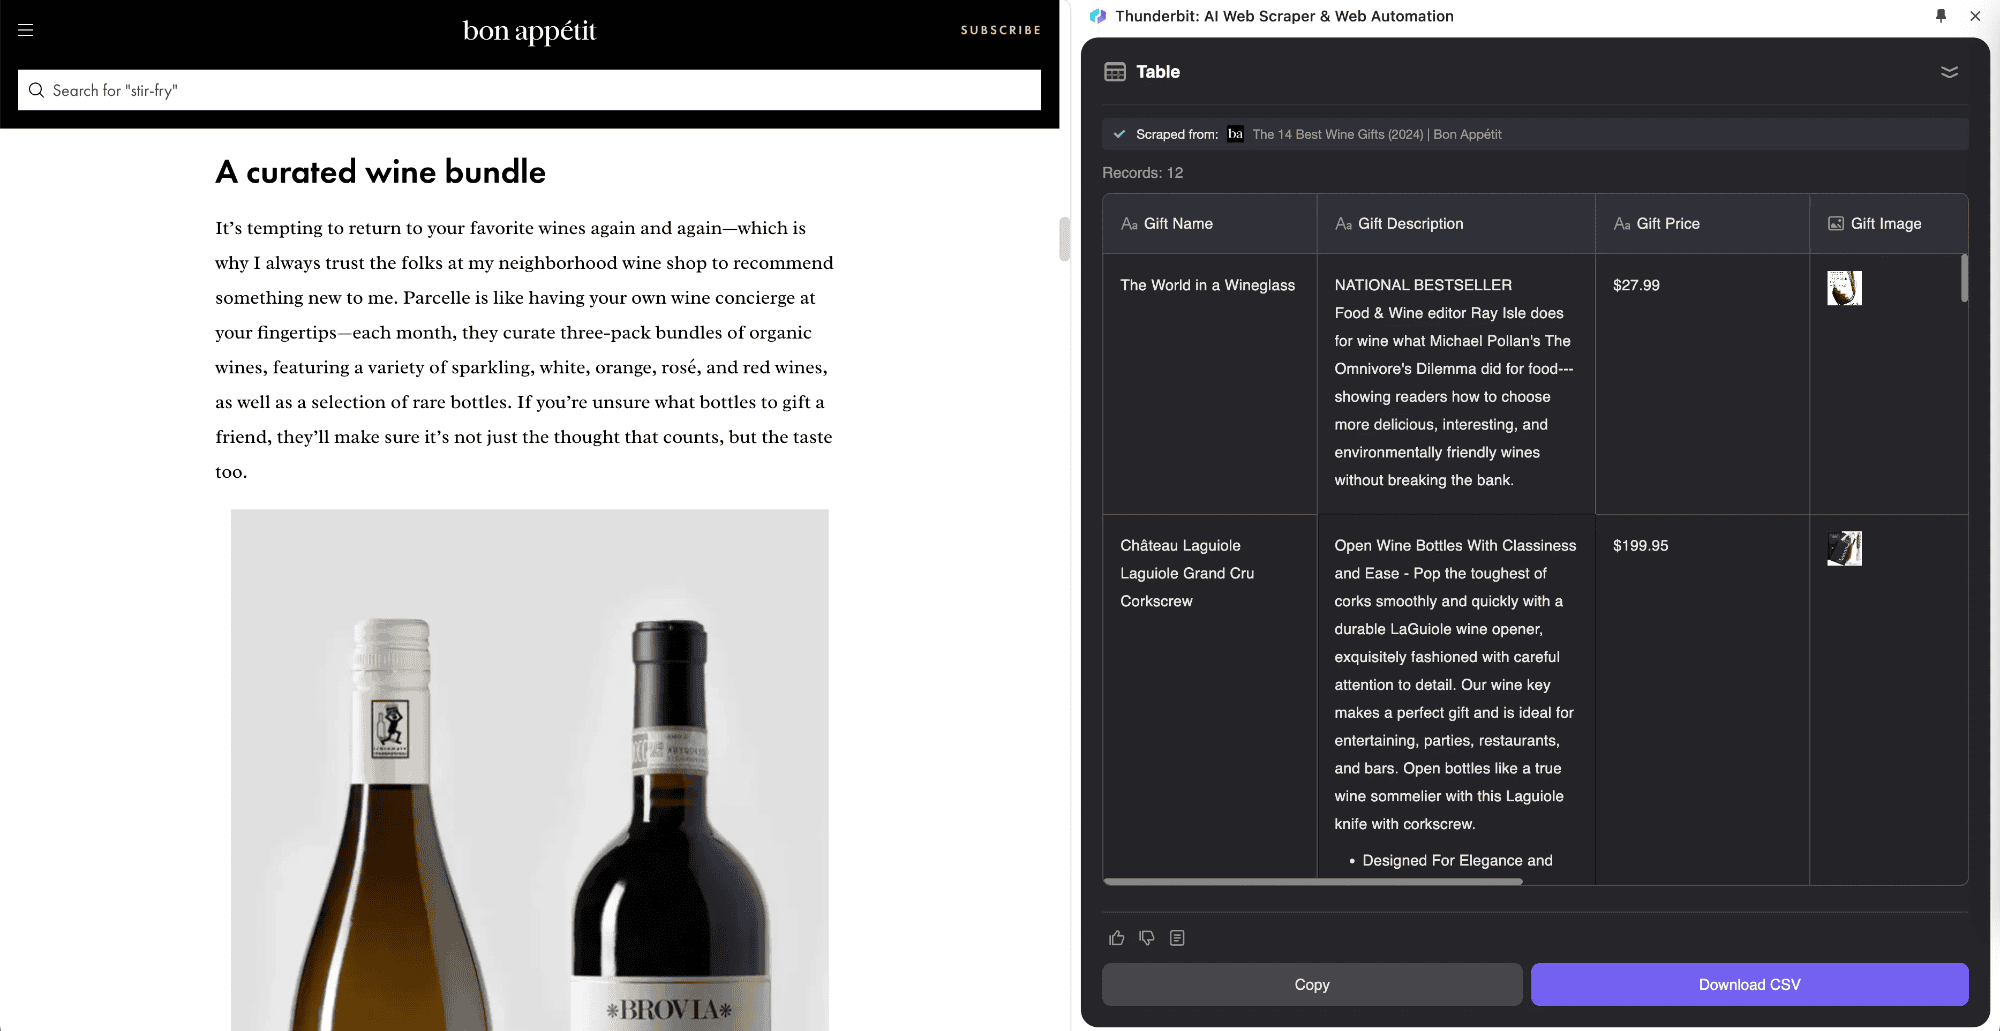
- Uruchom scraper: Thunderbit najpierw wyodrębni dane listy z głównej strony, a następnie automatycznie odwiedzi każdą podstronę, pobierze odpowiednie informacje i scali je w głównej tabeli. Cały proces jest sterowany przez AI, więc nie trzeba pisać skomplikowanego kodu.
Jak wdrożyć List Crawling
Dla programistów istnieje wiele języków i narzędzi, które pozwalają wdrożyć list crawling. Najpopularniejszym wyborem jest Python, głównie ze względu na prostotę i bogaty ekosystem bibliotek. Oto podstawowy przykład w Pythonie, wykorzystujący biblioteki requests i BeautifulSoup do pobierania danych:
import requests
from bs4 import BeautifulSoup
import pandas as pd

def scrape_urls(urls):
    data = []
    for url in urls:
        response = requests.get(url)
        soup = BeautifulSoup(response.text, 'html.parser')
        titles = soup.find_all('h2', class_='product-title')
        prices = soup.find_all('span', class_='product-price')
        for title, price in zip(titles, prices):
            data.append({
                'title': title.get_text(),
                'price': price.get_text()
            })
    return pd.DataFrame(data)

# Example usage
urls = ['<http://example.com/product1>', '<http://example.com/product2>']
data_frame = scrape_urls(urls)
print(data_frame)
Podsumowanie
W dzisiejszym świecie dane są podstawą działania firm. Ci, którzy potrafią skutecznie je zbierać i analizować, zyskują przewagę konkurencyjną. Dane pomagają firmom lepiej rozumieć trendy rynkowe i potrzeby klientów, dostarczając kluczowych informacji do rozwoju produktów oraz strategii marketingowych. Jednocześnie sprawne zbieranie i porządkowanie ogromnych, rozproszonych danych z internetu pozostaje dużym wyzwaniem.
Dzięki narzędziom takim jak Thunderbit firmy nie muszą już martwić się o pozyskiwanie danych. To jak posiadanie niezawodnego asystenta, który pomaga wyłuskiwać wartościowe informacje z ogromnych zbiorów danych i sprawia, że decyzje biznesowe są pewniejsze. Dzięki inteligentnym funkcjom zbierania i przetwarzania danych firmy mogą łatwo uzyskiwać dostęp do informacji o konkurencji, trendach rynkowych, opinii użytkowników i innych kluczowych danych, co prowadzi do trafniejszych decyzji biznesowych.
Thunderbit oferuje nie tylko wygodne funkcje pozyskiwania danych, ale również zaawansowane możliwości ich przetwarzania i analizy. Potrafi automatycznie czyścić i strukturyzować zebrane informacje, generując przejrzyste raporty, które pomagają szybko odkrywać ukryte wnioski. Dla firm, które regularnie muszą monitorować dynamikę rynku, zautomatyzowane zbieranie danych w Thunderbit to oszczędność czasu i duża efektywność.
W erze zdominowanej przez dane posiadanie narzędzia takiego jak Thunderbit jest niezwykle wygodne. Znacząco zwiększa ono efektywność zbierania danych i wspiera cyfrową transformację firm. Wraz ze wzrostem znaczenia danych w podejmowaniu decyzji biznesowych inteligentne narzędzia do ich pozyskiwania, takie jak Thunderbit, staną się dla przedsiębiorstw niezbędnym atutem konkurencyjnym.
FAQ
-
Czym jest Thunderbit? Thunderbit to rozszerzenie do Chrome stworzone z myślą o użytkownikach biznesowych, którzy chcą automatyzować zadania internetowe. Oferuje funkcje takie jak AI Web Scraper, AI Clipboard i AI Web Chat, które pozwalają pobierać dane, wypełniać formularze i podsumowywać strony internetowe z pomocą AI. To narzędzie zwiększające produktywność, które oszczędza czas i upraszcza powtarzalne zadania online.
-
Jak działa AI Web Scraper w Thunderbit? AI Web Scraper w Thunderbit wykorzystuje AI do wyodrębniania uporządkowanych danych ze stron internetowych. Użytkownik może kliknąć „AI Suggest Columns”, aby AI zasugerowało sposób scrapowania bieżącej strony, a następnie kliknąć „Scrape”, by pobrać dane. Narzędzie potrafi obsłużyć dane z dowolnej strony, PDF-a lub obrazu w zaledwie dwóch kliknięciach.
-
Jaka jest różnica między list crawling a subpage scraping? List crawling, czyli bulk scraping, polega na pobieraniu danych z listy adresów URL i jest idealny dla dużych serwisów. Subpage scraping z kolei pobiera dane z jednej strony i jej podstron, a następnie scala informacje w głównej tabeli. AI Web Scraper od Thunderbit świetnie radzi sobie z obiema metodami, oferując inteligentne wyodrębnianie i zarządzanie danymi.
-
Czy z Thunderbit mogą korzystać osoby bez umiejętności programowania? Oczywiście! Thunderbit został zaprojektowany tak, aby był prosty w obsłudze nawet dla osób bez doświadczenia technicznego. Funkcje oparte na AI pozwalają użytkownikom opisać potrzebne dane naturalnym językiem, a system sam generuje reguły ekstrakcji, dzięki czemu narzędzie jest dostępne również dla osób nietechnicznych.
-
Jakie rodzaje danych obsługuje Thunderbit? Thunderbit obsługuje różne typy danych, w tym tekst, linki i obrazy. Dostosowuje się do różnych potrzeb użytkowników, dlatego sprawdza się przy zbieraniu danych e-commerce, scrapingowaniu informacji o nieruchomościach, analizie danych z mediów społecznościowych i pozyskiwaniu informacji biznesowych.
-
Jak zacząć korzystać z Thunderbit? Aby zacząć, pobierz rozszerzenie Thunderbit Chrome z Thunderbit Chrome Extension Download Page. Po instalacji możesz odkrywać jego funkcje, takie jak AI Web Scraper, AI Clipboard i AI Web Chat, aby zwiększyć swoją produktywność w pracy z internetem.
-
Czy Thunderbit oferuje gotowe szablony? Tak, Thunderbit udostępnia różnorodne gotowe szablony, które zwiększają efektywność pracy. Obejmują one obszary takie jak e-commerce, nieruchomości, media społecznościowe i dane biznesowe, oszczędzając czas i zapewniając spójne, dokładne zbieranie informacji.
-
Jak Thunderbit dba o jakość danych? Thunderbit wykorzystuje AI do inteligentnego wyodrębniania i przetwarzania danych, automatycznie dostosowując się do zmian w strukturze strony. Oferuje też funkcje czyszczenia i formatowania danych, działając jak asystent AI, który wykonuje powtarzalne zadania i poprawia jakość informacji.
-
Przykłady zastosowań web scrapingu Jeśli chodzi o narzędzia do web scrapingu, istnieje wiele praktycznych zastosowań. Na przykład możesz pobierać produkty i opinie z Amazon do badań rynkowych albo wyodrębniać dane z PDF-ów do analizy dokumentów. Wiele firm potrzebuje zbierać dane ze stron do Excela na potrzeby analizy. Dzięki narzędziom opartym na AI możesz dziś skutecznie pobierać dane z dowolnej strony bez pisania złożonego kodu. W analizie mediów społecznościowych przydatne mogą być specjalistyczne narzędzia, takie jak email scrapers czy Twitter scrapers, które pomagają zebrać odpowiednie dane do kampanii marketingowych.
Dowiedz się więcej:
- Najlepsze narzędzia i oprogramowanie do web scrapingu w 2025 roku
- Jak pobierać dane z dowolnej strony z pomocą AI
- Jak skonfigurować Thunderbit
Wypróbuj AI Web Scraper Get Started Free




