
Gdzieś właśnie teraz ktoś wpisuje w Google „Thunderbit vs Browserless” i liczy na proste porównanie jeden do jednego. Problem w tym, że to trochę jak zestawianie aplikacji do zamawiania jedzenia z kuchnią przemysłową — oba mają związek z jedzeniem, ale są stworzone dla zupełnie innych ludzi i do zupełnie innych zadań.
Wiem to, bo mój zespół stworzył Thunderbit, a ja od lat działam w świecie SaaS i automatyzacji, obserwując, jak wrzuca się do jednego worka narzędzia, których wcale nie powinno się porównywać. Gdy zobaczyłem, że to zapytanie zyskuje popularność, chciałem napisać uczciwy przewodnik, który naprawdę pomoże Ci podjąć decyzję — nie marketingowy pojedynek, tylko spokojne spojrzenie na to, co robi każde z tych narzędzi, dla kogo jest stworzone i kiedy możesz potrzebować obu. W ostatnich latach narzędzia no-code do danych i automatyzacja przeglądarki nastawiona na deweloperów bardzo przyspieszyły, więc z zewnątrz granice potrafią wyglądać nieostro. Pozwól, że pokażę Ci, czego się nauczyłem.
Najpierw najważniejsze: Thunderbit i Browserless to różne kategorie narzędzi
Zanim porównamy choćby jedną funkcję czy cenę, chcę oszczędzić Ci nieporozumień. Thunderbit i Browserless nie są bezpośrednimi konkurentami w takim samym sensie jak dwie platformy CRM. Leżą na różnych warstwach stosu web data.
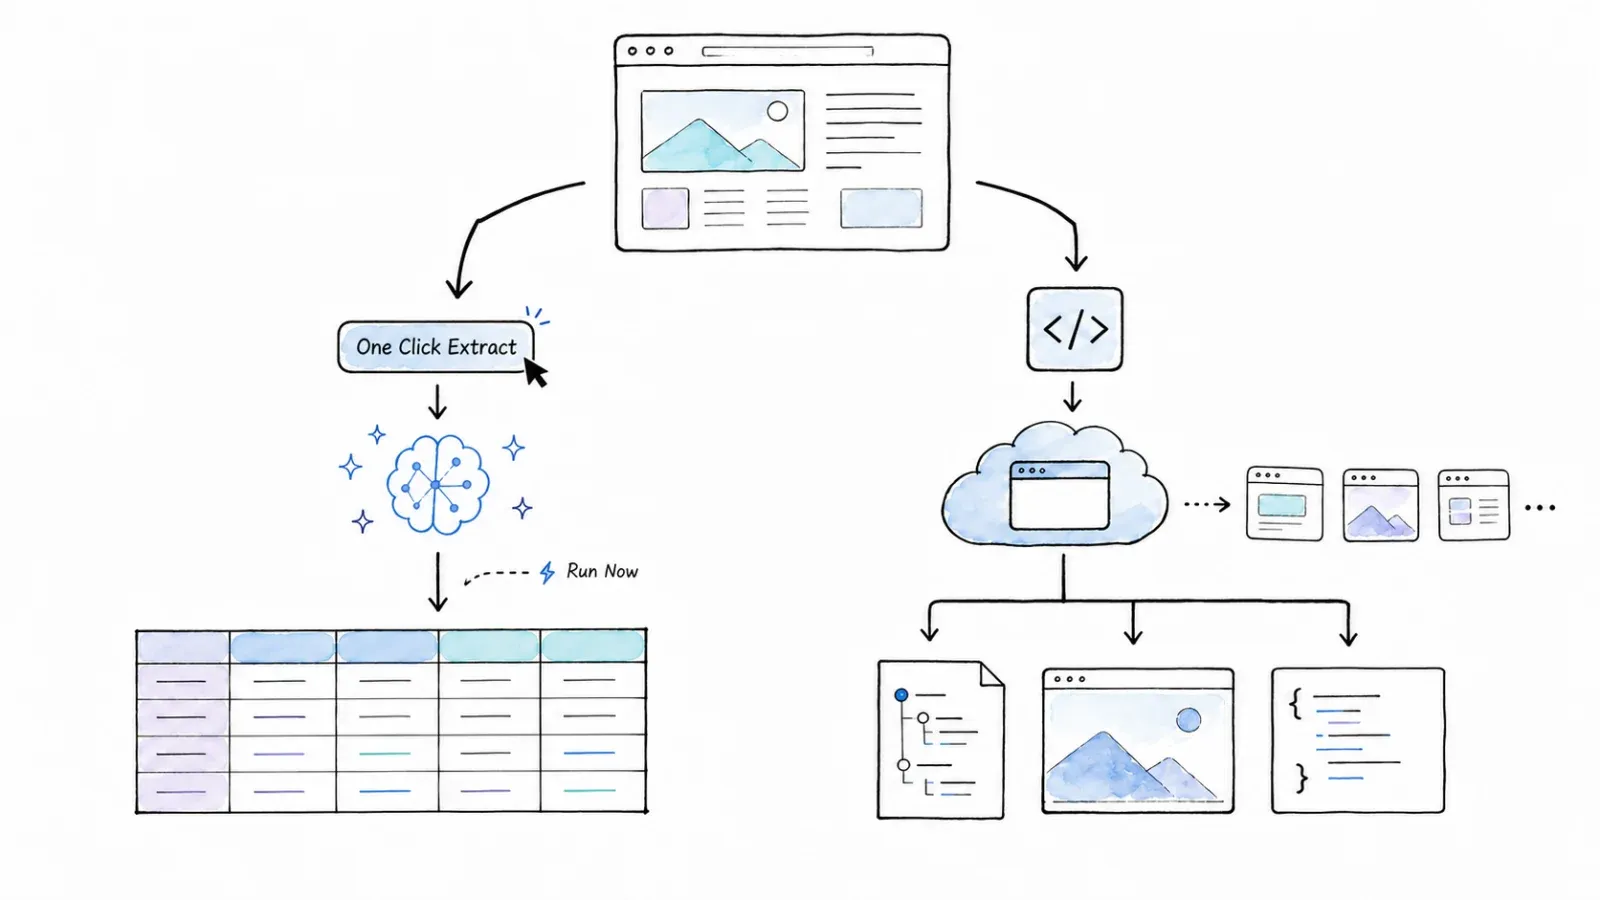
Thunderbit to agentic web scraper i platforma automatyzacji stworzona przede wszystkim dla użytkowników biznesowych. Instalujesz rozszerzenie do Chrome lub Edge, otwierasz stronę, pozwalasz AI zasugerować pola danych, klikasz scrape i eksportujesz uporządkowane dane do Excela, Google Sheets, Airtable albo Notion. Narzędzie ma też Open API, MCP Server oraz CLI dla deweloperów, ale jego główną wartością jest wynik ekstrakcji — czyste, ustrukturyzowane wiersze danych bez pisania kodu.
Thunderbit to agentic web scraper: na zgodnej i autoryzowanej stronie wystarczy kliknąć One Click Extract, a agent wykryje, odczyta i przeanalizuje stronę, by zdecydować, co należy pobrać. Run Now uruchamia proces od razu, ale jeśli nic nie zrobisz, zadanie i tak startuje automatycznie — więc domyślne doświadczenie wymaga tylko jednego świadomego kliknięcia, bez kodu, selektorów czy konfiguracji schematu.
Browserless to zarządzana infrastruktura headless browser stworzona dla deweloperów. Udostępnia chmurowe instancje Chrome, do których kod oparty na Puppeteer, Playwright lub CDP łączy się przez WebSocket albo REST API. Jego główną wartością jest programowalne uruchamianie przeglądarki — prowadzenie sesji browserowych na dużą skalę, robienie zrzutów ekranu, generowanie PDF-ów, obsługa wykrywania botów i dawanie deweloperom pełnej kontroli nad tym, co dzieje się w przeglądarce.
Oto szybka tabela, która jasno pokazuje różnicę:
| Wymiar | Thunderbit | Browserless |
|---|---|---|
| Główny użytkownik | Użytkownik biznesowy, ops, sprzedaż, marketing | Deweloper, DevOps, inżynier QA |
| Interfejs | Rozszerzenie Chrome/Edge, aplikacja webowa, kliknij i działaj | REST/WebSocket API, BrowserQL, narzędzia panelu |
| Główna wartość | Ekstrakcja ustrukturyzowanych danych wspierana przez AI | Zarządzany headless Chrome/Chromium na dużą skalę |
| Czas konfiguracji | Minuty (instalacja rozszerzenia, otwarcie strony) | Minuty do godzin (pisanie skryptów, konfiguracja kluczy API) |
| Wynik | Ustrukturyzowane wiersze → Excel, Google Sheets, Airtable, Notion | Renderowany HTML, uporządkowany JSON, zrzuty ekranu, PDF-y przez API |
| Self-hosting | Nie | Tak (Docker, VPC, air-gapped) |
Dlaczego to ważne? Bo jeśli jesteś marketerem, który potrzebuje listy leadów w arkuszu na lunch, nie musisz uruchamiać floty headless browserów. A jeśli jesteś deweloperem, który odpala 500 sesji przeglądarki w pipeline CI, nie potrzebujesz agentic extraction. Poniższe sekcje nadal porównują te narzędzia pod kątem cen, zastosowań i krzywej uczenia się — bo mimo że to różne kategorie, i tak musisz wybrać właściwe narzędzie (albo oba).
Czym jest Thunderbit?

Thunderbit to oparta na AI platforma do web scrapingu i automatyzacji, zaprojektowana tak, by osoby nietechniczne — handlowcy, menedżerowie operacyjni, marketerzy, badacze — mogły pobierać ustrukturyzowane dane ze stron internetowych bez pisania ani jednej linijki kodu.
Główny proces wygląda tak: instalujesz rozszerzenie Thunderbit do Chrome, przechodzisz na stronę i klikasz „One Click Extract”. Agent odczytuje i analizuje stronę, ustala plan ekstrakcji, a następnie uruchamia się automatycznie, chyba że wybierzesz „Run Now”, aby start był natychmiastowy. Potem eksportujesz dane do Excela, Google Sheets, Airtable lub Notion. Dostępna jest też obsługa paginacji, ekstrakcji podstron, harmonogramów i gotowych szablonów do wielokrotnego użycia.
Thunderbit ma również Open API (z punktami końcowymi Distill i Extract), MCP Server do workflowów z agentami AI oraz CLI. Ale sercem produktu jest doświadczenie no-code w przeglądarce. Jeśli kiedykolwiek marzyłeś, żeby po prostu wskazać stronę i powiedzieć „daj mi te dane w arkuszu”, właśnie o to chodzi.
Czym jest Browserless?
Browserless to zarządzana platforma headless browser, która pozwala deweloperom uruchamiać Chrome w chmurze, bez konieczności samodzielnego utrzymywania infrastruktury przeglądarkowej. „Headless browser” oznacza po prostu przeglądarkę bez widocznego okna — steruje się nią wyłącznie kodem.
Deweloperzy łączą swoje skrypty Puppeteer, Playwright lub kompatybilne z CDP zdalne instancje Browserless przez WebSocket lub REST API. Zamiast uruchamiać lokalny proces Chrome, który zużywa pamięć i CPU, przeglądarka działa na serwerach Browserless. Firma oferuje też BrowserQL — warstwę automatyzacji opartą na GraphQL z gotowymi akcjami do nawigacji, klikania, wpisywania tekstu, przewijania, ekstrakcji, zrzutów ekranu, PDF-ów, obsługi CAPTCHA i nie tylko. Ich REST API wspiera renderowanie treści, strukturę scrapingu opartą na selektorach, Smart Scrape, screenshoty, PDF-y i własne funkcje Puppeteer.
Browserless nie jest jednak wyłącznie „dla kodu”. Ma demo w panelu, generator kodu oparty na AI, integrację MCP oraz połączenia z n8n, Make i Zapier. Jego fundament pozostaje jednak developer-first: to Ty piszesz logikę, a Browserless dostarcza silnik przeglądarki i infrastrukturę. Dostępna jest też opcja self-hosted (Docker, VPC, air-gapped) dla zespołów, które potrzebują lokalizacji danych lub większej kontroli nad infrastrukturą — choć publiczny obraz Docker i komercyjny produkt chmurowy nie są funkcjonalnie identyczne.
Thunderbit vs Browserless w skrócie: porównanie obok siebie
Bardziej szczegółowe porównanie w obszarach, które naprawdę mają znaczenie:
| Wymiar | Thunderbit | Browserless |
|---|---|---|
| Docelowy użytkownik | Użytkownicy biznesowi, osoby bez kodu, ops, sprzedaż, marketing | Deweloperzy, DevOps, inżynierowie QA |
| Interfejs | Rozszerzenie Chrome/Edge, aplikacja webowa, API, MCP, CLI | REST/WebSocket API, BrowserQL, dashboard, MCP, n8n/Make/Zapier |
| Ekstrakcja wspierana przez AI | Tak — One Click Extract, instrukcje na poziomie pól | Brak natywnej agentic extraction; dostępne Smart Scrape i ekstrakcja BrowserQL |
| Czas do pierwszego wyniku | Minuty (instalacja rozszerzenia, otwarcie strony, scrape) | Minuty do godzin (pobranie klucza API, napisanie/skonfigurowanie skryptu, uruchomienie) |
| Wymagane kodowanie | Nie (rozszerzenie/aplikacja webowa); opcjonalnie (API/MCP/CLI) | Tak w podstawowych workflowach; ścieżki low-code przez MCP/integracje |
| Eksport danych | Ustrukturyzowane wiersze → Excel, CSV, Google Sheets, Airtable, Notion | Renderowany HTML, uporządkowany JSON, screenshoty, PDF-y, własne wyjścia przez API |
| Obsługa paginacji/podstron | Wbudowana, konfigurowalna w interfejsie | Definiowana przez użytkownika w kodzie lub BrowserQL |
| Harmonogramy | Obsługiwane w wybranych planach i miejscach działania | Zarządzane przez użytkownika (kod, cron lub zewnętrzna orkiestracja) |
| Ochrona przed botami / stealth | Zarządzane renderowanie na wspieranych stronach; bez gwarancji | BrowserQL stealth, proxy residential/datacenter, obsługa CAPTCHA; bez gwarancji |
| Self-hosting | Nie | Tak (Docker, VPC, air-gapped; podwójna licencja SSPL/komercyjna) |
| Integracje | Bezpośredni eksport do narzędzi biznesowych; API/MCP/CLI dla workflowów dev | Puppeteer/Playwright/CDP, MCP, n8n, Make, Zapier, SDK dla agentów |
| Główne zastosowania | Lead scraping, research rynkowy, ad hoc data collection, ekstrakcja cykliczna | Testy przeglądarkowe, automatyzacja, zrzuty ekranu/PDF-y, scraping odporny na boty, użycie przeglądarki przez agentów |
Jeśli jesteś handlowcem, który do lunchu potrzebuje leadów w arkuszu, Thunderbit został stworzony dla Ciebie. Jeśli jesteś deweloperem, który musi uruchamiać 500 headless browser sessions w pipeline CI, Browserless jest dla Ciebie. Oba rozwiązania dotyczą „pobierania danych ze stron”, ale podejście i doświadczenie są zupełnie inne.
Poziom techniczny i krzywa uczenia się: Thunderbit vs Browserless
Z badań bardzo często przewijało się pytanie: „które narzędzie jest odpowiednie do mojego poziomu umiejętności?”. Chcę więc powiedzieć to wprost.
Co musisz umieć, żeby korzystać z Thunderbit
Nie musisz umieć programować. Rozszerzenie Thunderbit do przeglądarki zostało zaprojektowane tak, byś mógł je zainstalować, otworzyć stronę, kliknąć przycisk i dostać ustrukturyzowane dane. One Click Extract pozwala agentowi odczytać i przeanalizować stronę, ustalić wynik i rozpocząć ekstrakcję automatycznie. Dla większości użytkowników biznesowych cały proces od instalacji do wyeksportowanych danych zajmuje tylko kilka minut.
Bieżąca obsługa jest zwykle mniej wymagająca, bo AI podpowiada schemat i dostosowuje się do wspieranych stron, więc nie utrzymujesz w kodzie selektorów CSS ani wyrażeń XPath. Dokumentacja jest wizualna, z poradnikami i instrukcjami dla użytkowników biznesowych. Przy bardziej złożonych workflowach programistycznych albo ciężkiej logice niestandardowej interfejs no-code ma swoje granice — wtedy przydają się API, MCP albo CLI.
Co musisz umieć, żeby korzystać z Browserless
Browserless zakłada, że dobrze czujesz się z JavaScriptem lub Pythonem, znasz Puppeteer albo Playwright i swobodnie korzystasz z kluczy API oraz połączeń WebSocket. To Ty piszesz skrypty, które mówią przeglądarce, co ma zrobić — przejść na stronę, kliknąć, poczekać, pobrać dane, zrobić zrzut ekranu. Czas od rejestracji do pierwszego rezultatu zależy od doświadczenia, ale nawet dla doświadczonego dewelopera uruchomienie nowego skryptu na realnym celu zwykle zajmuje więcej czasu niż workflow typu kliknij i działaj.
Gdy docelowa strona zmieni strukturę, aktualizujesz selektory i logikę w kodzie. Dokumentacja jest skierowana do deweloperów: przykłady kodu, referencja API, aktywna społeczność na GitHubie (około 13 500+ gwiazdek w połowie 2026 roku). Dla programistów ta elastyczność to zaleta — masz kontrolę nad każdym szczegółem sesji przeglądarki.
Szybka tabela porównawcza: krzywa uczenia się
| Czynnik | Thunderbit | Browserless |
|---|---|---|
| Wymóg techniczny | Brak — rozszerzenie przeglądarki, kliknij i działaj | JavaScript/Python, znajomość API |
| Czas do pierwszego wyniku | Kilka minut (instalacja → AI Suggest → scrape) | Różnie: 15 min do ponad godziny (klucz API → skrypt → uruchomienie) |
| Bieżąca konserwacja | Niższa na wspieranych stronach (schemat wspierany przez AI) | Wyższa (utrzymanie skryptów, aktualizacja selektorów w kodzie) |
| Styl dokumentacji | Wizualne przewodniki, tutoriale dla użytkowników biznesowych | Dokumentacja dla deweloperów, przykłady kodu, referencja API |
| Społeczność/wsparcie | Bezpośrednie kanały wsparcia | Aktywny GitHub, społeczność deweloperów |
W tym obszarze żadne narzędzie nie jest „lepsze” — to zależy od tego, kim jesteś. Osoba nietechniczna uzna Browserless za przesadę. Deweloper, który chce pełnej kontroli, może uznać no-code w Thunderbit za zbyt ograniczające przy złożonej automatyzacji.
Thunderbit vs Browserless: ile kosztują?
Cena to jeden z najczęstszych czynników decyzyjnych — i jeden z najbardziej zmiennych. Nazwy planów, ceny i limity się zmieniają. Podaję najlepsze dostępne informacje na połowę 2026 roku, ale zawsze sprawdź oficjalną stronę cenową każdego narzędzia przed podjęciem decyzji.
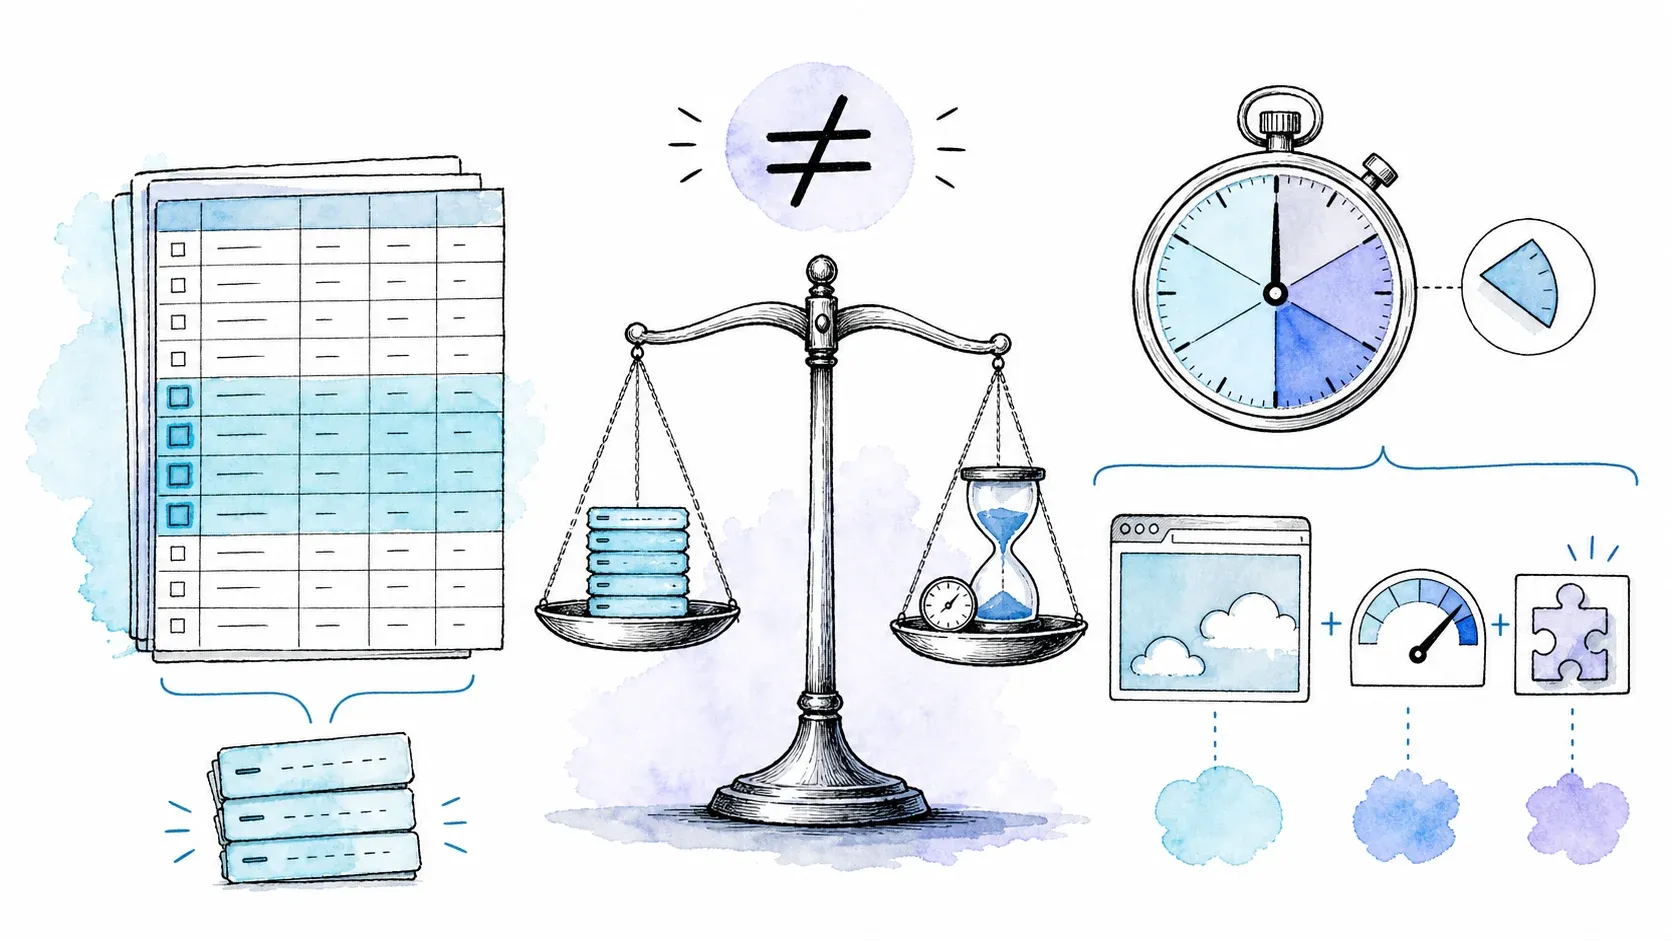
Istotna jest różnica strukturalna: Thunderbit rozlicza się w kredytach na strony (powiązanych z wierszami wynikowymi i operacjami), a Browserless w jednostkach obliczeniowych (powiązanych z czasem sesji przeglądarki i opcjonalnymi opłatami za transfer/CAPTCHA). Te jednostki nie są zamienne, więc bezpośrednie porównanie kosztów wymaga znajomości konkretnego obciążenia.
Przegląd cen Thunderbit
Zrzut z cennika Thunderbit:
| Plan | Miesięcznie | Rocznie (efektywnie) | Kredyty |
|---|---|---|---|
| Free | $0 | $0 | 6 stron/miesiąc |
| Starter | $15/mies. | ~ $9/mies. (rozliczenie roczne) | 500/mies. lub 5 000/rok |
| Pro 1 | $38/mies. | ~ $24/mies. (rozliczenie roczne) | 3 000/mies. lub 30 000/rok |
| Pro 2 | $75/mies. | ~ $48/mies. (rozliczenie roczne) | 6 000/mies. lub 60 000/rok |
| Pro 3 | $125/mies. | ~ $96/mies. (rozliczenie roczne) | 10 000/mies. lub 120 000/rok |
| Pro 4 | $249/mies. | ~ $192/mies. (rozliczenie roczne) | 20 000/mies. lub 240 000/rok |
| Business | Niestandardowy | Niestandardowy | Niestandardowy |
Standardowy wiersz wynikowy kosztuje 1 kredyt; wiersz z podstrony kosztuje 2 kredyty. Thunderbit ma też osobny cennik API dla workflowów deweloperskich (Distill: 1 jednostka API/strona, Extract: 20 jednostek API/strona). Plan Free pozwala przetestować cały proces, choć limit jest niewielki.
Przegląd cen Browserless
Zrzut z cennika chmurowego Browserless:
| Plan | Rocznie (efektywnie miesięcznie) | Miesięcznie | Jednostki/miesiąc | Współbieżność (rocznie/miesięcznie) | Maks. czas sesji |
|---|---|---|---|---|---|
| Free | $0 | $0 | 1 000 | 2 / 2 | 1 min |
| Prototyping | $25/mies. | $35/mies. | 20 000 | 10 / 5 | 15 min |
| Starter | $140/mies. | $200/mies. | 180 000 | 40 / 30 | 30 min |
| Scale | $350/mies. | $500/mies. | 500 000 | 100 / 80 | 60 min |
| Enterprise | Niestandardowy | Niestandardowy | Niestandardowy | Niestandardowy | Niestandardowy |
Jedno połączenie z przeglądarką kosztuje 1 jednostkę za rozpoczęty 30-sekundowy interwał — niepełne interwały są zaokrąglane w górę. Transfer przez proxy residential kosztuje dodatkowo 6 jednostek/MB, a proxy datacenter 2 jednostki/MB. Obsługa CAPTCHA również zużywa dodatkowe jednostki. Płatne plany obejmują dopłaty za przekroczenie limitu w wysokości $0.0015–$0.0020/jednostkę. Obraz Docker dla self-hostingu jest dostępny na licencji SSPL/komercyjnej, ale wersja open-source nie zawiera wszystkich funkcji komercyjnych (BrowserQL, zaawansowany stealth, replay itd.), a za własną infrastrukturę i tak płacisz sam.
Tabela cen obok siebie
| Thunderbit (No-Code) | Browserless (Cloud) | |
|---|---|---|
| Darmowy plan | 6 stron/miesiąc | 1 000 jednostek |
| Najniższy płatny plan | $15/mies. (Starter, 500 kredytów) | $25–$35/mies. (Prototyping, 20 000 jednostek) |
| Średni poziom | $38–$75/mies. (Pro 1–2) | $140–$200/mies. (Starter) |
| Wysoki poziom | $125–$249/mies. (Pro 3–4) | $350–$500/mies. (Scale) |
| Jednostka rozliczeniowa | Kredyty na strony (wiersze wynikowe) | Jednostki obliczeniowe (interwały 30 s + proxy/CAPTCHA) |
| Self-hosting | Nie | Tak (licencja SSPL/komercyjna) |
Cennik Thunderbit jest zaprojektowany z myślą o użytkownikach biznesowych, którzy chcą przewidywalnych kosztów za każdą zescrapowaną stronę. Cennik Browserless jest skierowany do deweloperów, którzy potrzebują czasu obliczeniowego na sesje przeglądarki. Jeśli próbujesz porównać je „za zadanie”, musisz oszacować, ile kredytów albo jednostek pochłonie Twój konkretny workflow — a matematyka będzie inna dla listy leadów z 10 wierszami i dla crawl’a obejmującego 10 000 stron.
Thunderbit vs Browserless: werdykt według zastosowań
To sekcja, której życzyłbym sobie w każdym artykule porównawczym: praktyczny przewodnik „wybierz to, jeśli…”. Dla każdego scenariusza podaję werdykt i krótkie uzasadnienie.
| Zastosowanie | Lepszy wybór | Dlaczego |
|---|---|---|
| Scrapowanie leadów sprzedażowych (katalogi, listy firm) | Thunderbit | No-code, One Click Extract, eksport do Sheets/Excel/Airtable. Handlowiec może pobrać leady w kilka minut. |
| Testy przeglądarkowe CI/CD na dużą skalę | Browserless | Stworzony do programowego uruchamiania Puppeteer/Playwright, wielu równoczesnych sesji i integracji z pipeline’em. |
| Research rynkowy i monitoring konkurencji | Zależy | Thunderbit do bezkodowej ekstrakcji cyklicznej; Browserless + własne skrypty do złożonych, renderowanych stron. |
| Interakcja agenta AI z webem (Claude, LangChain) | Zależy | Thunderbit przez MCP/API do ustrukturyzowanej ekstrakcji; Browserless przez REST/WebSocket do surowej kontroli przeglądarki. |
| Strony z silnym bot detection / CAPTCHA | Browserless | BrowserQL stealth, proxy, obsługa CAPTCHA — choć żadne narzędzie nie gwarantuje dostępu. |
Scrapowanie leadów sprzedażowych
Jeśli pracujesz w sprzedaży, ops lub rekrutacji i potrzebujesz listy imion, adresów e-mail albo danych firm z katalogu czy strony z ogłoszeniami, Thunderbit jest prostszą drogą. Otwierasz stronę, pozwalasz AI zasugerować pola, pobierasz dane i eksportujesz je do Google Sheets albo Airtable. Bez skryptów, bez infrastruktury. Browserless też mógłby to zrobić, ale wymagałoby to napisania i utrzymywania własnego skryptu — a dla większości użytkowników biznesowych to zwyczajnie odpada. (Więcej o tym procesie znajdziesz w naszym przewodniku o AI lead generation.)
Testy przeglądarkowe CI/CD i automatyzacja QA
Browserless został do tego stworzony. Jeśli Twój zespół uruchamia automatyczne testy przeglądarkowe w pipeline CI/CD, potrzebujesz wielu równoczesnych headless browser sessions, a nie interfejsu do ekstrakcji danych. Thunderbit nie jest projektowany pod ten przypadek użycia.
Research rynkowy i monitoring konkurencji
To zależy od zespołu. Jeśli masz analityka nietechnicznego, który ma śledzić ceny konkurencji albo oferty produktowe, w Thunderbit najprościej sprawdzi się ekstrakcja cykliczna (na wspieranych planach) z bezpośrednim eksportem. Jeśli strony są mocno renderowane, wymagają skomplikowanych interakcji albo zaawansowanego stealth, deweloper korzystający z Browserless i własnych skryptów będzie miał większą kontrolę. (Więcej o web scrapingu bez kodowania opisaliśmy w osobnym przewodniku.)
Interakcja agenta AI z webem
Oba narzędzia oferują integracje MCP i interfejsy API do workflowów agentowych. MCP Server i API Thunderbit są nastawione na ustrukturyzowaną ekstrakcję — agent prosi o dane, a Thunderbit zwraca czyste wiersze. MCP i połączenia z agent SDK w Browserless są nastawione na surową kontrolę przeglądarki — agent przechodzi na stronę, klika, wypełnia formularze lub obsługuje złożone interakcje. Wybór zależy od tego, czy agent potrzebuje danych w uporządkowanej formie, czy pełnej kontroli nad przeglądarką.
Strony z silną ochroną anty-bot i CAPTCHA
Browserless oferuje tu bardziej konkretne możliwości: BrowserQL stealth mode, randomizację fingerprintu, proxy residential i datacenter oraz obsługę CAPTCHA. Zarządzane renderowanie Thunderbit radzi sobie z niektórymi wyzwaniami anty-bot na wspieranych stronach, ale nie jest narzędziem ogólnego przeznaczenia do omijania systemów detekcji botów. Własna dokumentacja Browserless przyznaje też, że zaawansowane fingerprinting czy interaktywne CAPTCHA nadal mogą blokować automatyzację — żadne narzędzie nie daje gwarancji sukcesu na każdej stronie.
Kiedy możesz używać obu: workflow komplementarny
Większość artykułów porównawczych całkiem pomija ten punkt, a przecież nie zawsze trzeba wybierać jedno narzędzie.
Wiele organizacji ma jednocześnie potrzeby techniczne i nietechniczne. Deweloper w zespole może używać Browserless do obsługi złożonych renderowanych stron, testów przeglądarkowych albo budowy pipeline’u danych do ekstrakcji na dużą skalę. Tymczasem analityk biznesowy lub handlowiec korzysta z rozszerzenia Thunderbit do przeglądarki do szybkich, jednorazowych ekstrakcji — np. pobrania listy leadów z nowego katalogu, sprawdzenia cen konkurencji czy wyciągnięcia danych uzupełniających z źródła, które nie wymaga całego sprintu deweloperskiego.
Inny scenariusz: deweloper buduje cykliczny crawl w Browserless do stałego monitoringu, a osoba z ops używa Thunderbit, żeby szybko pobrać dane z nowego źródła, które pojawiło się na spotkaniu — bez zgłoszenia, bez czekania, bez code review.
To nie jest wymuszony upsell — tak po prostu pracują mieszane zespoły. Jeśli masz w zespole zarówno osoby techniczne, jak i nietechniczne, które potrzebują danych z webu, korzystanie z obu narzędzi zgodnie z ich mocnymi stronami może oszczędzić wszystkim czas.
Thunderbit vs Browserless: podsumowanie plusów i minusów
Thunderbit: plusy i minusy
Plusy:
- Do podstawowego workflow nie trzeba pisać kodu
- One Click Extract odczytuje stronę i proponuje ustrukturyzowany schemat
- Bardzo szybki czas do pierwszego wyniku dla osób nietechnicznych
- Bezpośredni eksport do przyjaznych narzędzi biznesowych (Excel, Google Sheets, Airtable, Notion)
- Rozszerzenie przeglądarki działa na stronie, którą już masz otwartą
- Niższy koszt utrzymania na wspieranych stronach (schemat podpowiadany przez AI)
- Dostępne API, MCP i CLI dla workflowów deweloperskich
Minusy:
- Nie jest stworzone do programistycznych workflowów CI/CD ani testów przeglądarkowych
- Mniej elastyczne przy bardzo złożonej logice niestandardowej lub wieloetapowej automatyzacji przeglądarki
- Brak opcji self-hostingu
- Agentic extraction może wymagać ręcznych korekt na nietypowych lub bardzo złożonych stronach
- Mniejsza społeczność deweloperska niż w przypadku Browserless
Browserless: plusy i minusy
Plusy:
- Pełna programistyczna kontrola nad sesjami przeglądarki
- Obsługa klientów Puppeteer, Playwright i zgodnych z CDP
- Zaawansowane obchodzenie detekcji botów (BrowserQL stealth, proxy, obsługa CAPTCHA)
- Opcja self-hosted dla lokalizacji danych i kontroli infrastruktury
- Skalowanie współbieżności dla dużych obciążeń (zależnie od planu)
- Silna społeczność deweloperska (~13 500+ gwiazdek na GitHubie)
- Integracje MCP, n8n, Make, Zapier i SDK dla agentów
- Deklarowana zgodność z SOC 2 Type II (Trust Center)
Minusy:
- Wymaga umiejętności programowania w podstawowych workflowach
- Wyższy koszt utrzymania (skrypty psują się, gdy strony docelowe się zmieniają)
- Stroma krzywa uczenia dla osób bez doświadczenia technicznego
- Wynik wymaga dodatkowej logiki, aby go ustrukturyzować i wyeksportować (brak wbudowanej agentic extraction ani trwałej wizualnej tabeli)
- Self-hosting przerzuca odpowiedzialność za infrastrukturę, aktualizacje, monitoring i licencjonowanie na operatora
- Podwójna licencja SSPL/komercyjna dla obrazu open-source — nie jest to licencja open source zatwierdzona przez OSI
Ostateczny werdykt: jak wybrać właściwe narzędzie dla swojego zespołu
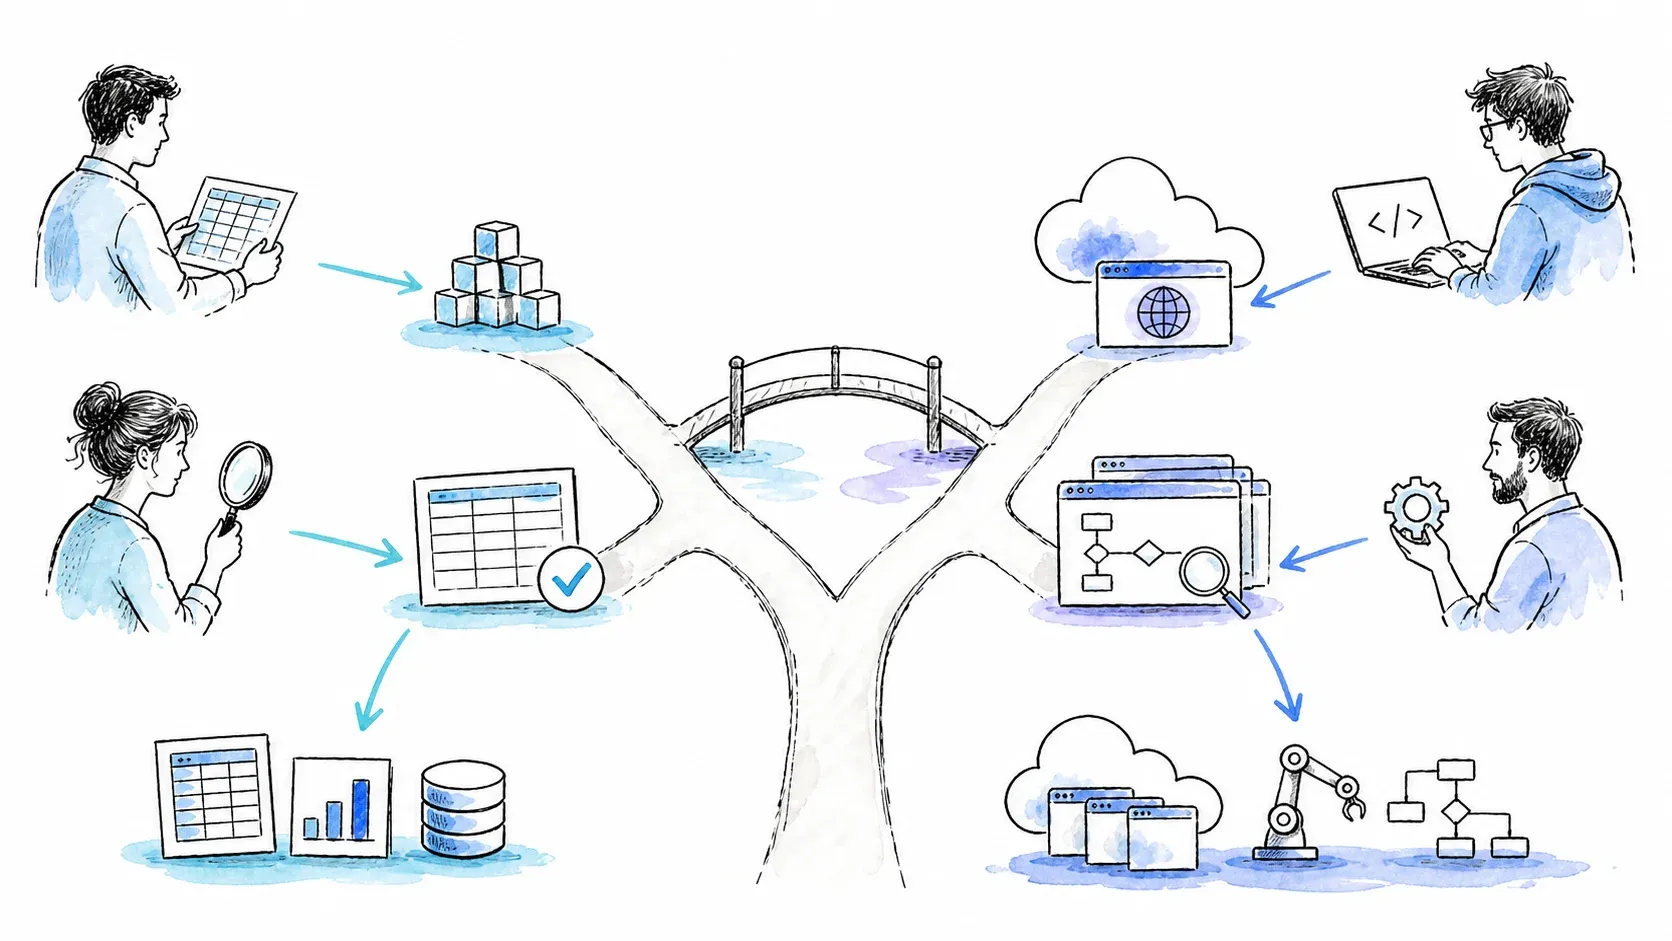
Thunderbit i Browserless rozwiązują różne problemy dla różnych ludzi. Thunderbit jest dla użytkowników biznesowych, którzy chcą szybko otrzymać ustrukturyzowane dane, bez kodu, wyeksportowane do narzędzi, z których już korzystają. Browserless jest dla deweloperów, którzy potrzebują skalowalnej, programowalnej infrastruktury przeglądarkowej z pełną kontrolą nad tym, co dzieje się wewnątrz przeglądarki.
Oto szybki przewodnik decyzyjny:
- Wybierz Thunderbit, jeśli: pracujesz w sprzedaży, ops, marketingu lub researchu; nie programujesz; chcesz mieć dane w arkuszu lub Airtable w kilka minut; potrzebujesz AI do wyboru pól i bezpośredniego eksportu. (Wypróbuj tutaj)
- Wybierz Browserless, jeśli: jesteś deweloperem albo inżynierem DevOps; piszesz skrypty Puppeteer/Playwright; potrzebujesz testów przeglądarkowych, omijania bot detection, screenshotów/PDF-ów albo własnej infrastruktury self-hosted. (Zobacz platformę)
- Rozważ oba narzędzia, jeśli: Twój zespół ma zarówno osoby techniczne, jak i nietechniczne, które potrzebują danych z webu, i chcesz, żeby każda grupa pracowała narzędziem dopasowanym do swojego workflow.
Nie ma tu jednego zwycięzcy dla wszystkich — jest tylko właściwe narzędzie do właściwego zadania.
FAQ: Thunderbit vs Browserless
Czy Thunderbit może zastąpić Browserless (albo odwrotnie)?
Nie bezpośrednio, bo służą różnym odbiorcom i różnym przypadkom użycia. Thunderbit to zarządzana platforma ekstrakcji dla użytkowników biznesowych, którzy chcą danych ustrukturyzowanych bez kodu. Browserless to programowalna infrastruktura przeglądarkowa dla deweloperów potrzebujących niestandardowej kontroli. Obszar wspólny istnieje w podstawowym web scrapingu, ale podejście, interfejs i wynik są zasadniczo różne. Handlowiec nie użyje Browserless do list leadów, a deweloper nie użyje Thunderbit do testów przeglądarkowych CI/CD.
Czy do korzystania z Thunderbit potrzebuję umiejętności programowania?
Nie. Rozszerzenie przeglądarki i Web App są zaprojektowane dla osób nietechnicznych — instalacja, otwarcie strony, kliknięcie One Click Extract, automatyczny start zadania i eksport. Dla deweloperów, którzy chcą dostępu programistycznego, Thunderbit oferuje też Open API, MCP Server i CLI.
Czy Browserless potrafi eksportować dane do Google Sheets albo Excela?
Nie natywnie. Browserless zwraca dane z przeglądarki — renderowany HTML, uporządkowany JSON (przez Smart Scrape, BrowserQL lub własne funkcje), screenshoty, PDF-y. Żeby przenieść te dane do arkusza, trzeba napisać dodatkowy kod albo użyć osobnego narzędzia do ich ustrukturyzowania i eksportu. Thunderbit z kolei ma wbudowany eksport do Excela, Google Sheets, Airtable i Notion.
Czy Browserless jest darmowy?
Browserless oferuje darmowy plan z 1 000 jednostek miesięcznie (to nie jest 1 000 sesji — jedna sesja może zużyć kilka jednostek). Open-source’owy obraz Docker można hostować samodzielnie, ale działa on na licencji SSPL/komercyjnej i nie zawiera wszystkich funkcji komercyjnych. Płatne plany odblokowują więcej jednostek, wyższą współbieżność i dodatkowe możliwości. Aktualne informacje sprawdzaj na oficjalnej stronie cenowej.
Które narzędzie jest lepsze do scrapowania LinkedIn lub podobnych chronionych serwisów?
Żadne narzędzie nie gwarantuje dostępu do konkretnej strony. Zawsze przestrzegaj regulaminu platformy, wymagań autoryzacyjnych i obowiązującego prawa. Funkcje stealth i obsługa CAPTCHA w Browserless są zaprojektowane do radzenia sobie z wyzwaniami bot detection, podczas gdy Browser Mode w Thunderbit może działać w ramach autoryzowanej lokalnej sesji przeglądarki. W przypadku chronionych serwisów najważniejsze jest to, czy masz legalny dostęp i działasz zgodnie z zasadami platformy — a nie samo narzędzie do scrapingu. (Więcej kontekstu znajdziesz w naszym wpisie o scrapowaniu LinkedIn.)
Dowiedz się więcej
- Jak opanować automatyczny web scraping z Thunderbit
- Przewodnik po automatyzacji przeglądarki: jak automatyzować działania na stronach bez pisania kodu
- Przetestowałem Playwright i Puppeteer w tym samym teście scrapingu
- Top 10 no-code web scraperów do automatycznych rozwiązań
- Czym jest web scraping? Wszystko, co warto wiedzieć




