
Sieć rozwija się w tempie, przy którym moja poranna kawa wypada niemal jak żółw — a uwierzcie mi, piję ją szybko. W 2026 roku pozyskiwanie danych z internetu to już nie tylko „miły dodatek” dla technicznych geeków; to tajna broń napędzająca prospecting sprzedażowy, monitoring cen w e-commerce, badania rynku, a nawet analizę nieruchomości. Skoro ponad 49% firm korzysta dziś z narzędzi do web scrapingu co tydzień, wybór odpowiedniej biblioteki lub narzędzia może zadecydować o tym, czy spędzisz godziny na żmudnej pracy, czy dostaniesz arkusz pełen gotowych do działania informacji — zanim konkurencja zdąży skończyć lunch.
Ale najciekawsze jest to, że biblioteki do web scrapingu w 2026 roku występują w naprawdę różnych wersjach: od niewymagających kodowania rozszerzeń AI do Chrome po zaawansowane frameworki dla programistów. Niezależnie od tego, czy jesteś handlowcem, który po prostu chce wyciągnąć leady do Excela, managerem operacyjnym śledzącym 500 SKU, czy magikiem Pythona budującym własnego crawlera, znajdziesz coś dla siebie. Od lat pracuję w SaaS i automatyzacji (i zaliczyłem więcej zarwanych nocy, niż chcę przyznać), testując te rozwiązania — więc rozłóżmy na czynniki pierwsze 10 bibliotek do web scrapingu, które warto znać w tym roku, oraz to, jak wybrać tę, która naprawdę ułatwi Ci życie.
Co sprawia, że biblioteka do web scrapingu jest mocna w 2026 roku?
Pobieraj dane z dowolnej strony z pomocą AI Get Started Free
Zanim przejdziemy do listy, porozmawiajmy o tym, co naprawdę ma znaczenie przy wyborze biblioteki do web scrapingu. Z mojego doświadczenia najlepsze narzędzia w 2026 roku mają kilka cech wspólnych:
- Łatwość użycia: Czy osoba bez umiejętności programowania może uzyskać wynik w kilka minut? A może potrzebny jest doktorat z Pythona?
- Obsługa dynamicznej treści: Czy radzi sobie ze współczesnymi stronami opartymi na JavaScript? Czy może wykłada się na czymkolwiek bardziej złożonym niż statyczny HTML?
- Wsparcie dla języków i platform: Czy działa w Twoim ulubionym języku — Pythonie, JavaScript, Javie — albo bezpośrednio w przeglądarce?
- Skalowalność: Czy poradzi sobie z setkami (albo tysiącami) stron bez zadyszki?
- Integracje i eksport: Czy dobrze współpracuje z Excelem, Google Sheets, Notion lub Twoim data pipeline?
- AI i automatyzacja: W 2026 roku narzędzia oparte na AI, które po prostu działają po wpisaniu prostego promptu, są ogromnym atutem — zwłaszcza dla biznesu, który nie chce dotykać kodu.
Prawda jest taka, że zespoły biznesowe chcą szybkości, dokładności i jak najmniejszej liczby ustawień. Im mniej czasu spędzasz na naprawianiu zepsutych scraperów albo walce z kodem, tym więcej czasu zostaje na wykorzystanie danych. A wraz z rozwojem AI i automatyzacji przeglądarki nawet osoby nietechniczne mogą dziś pobierać dane, które kiedyś wymagały pomocy dewelopera (PromptCloud).
Dobra — czas na konkrety.
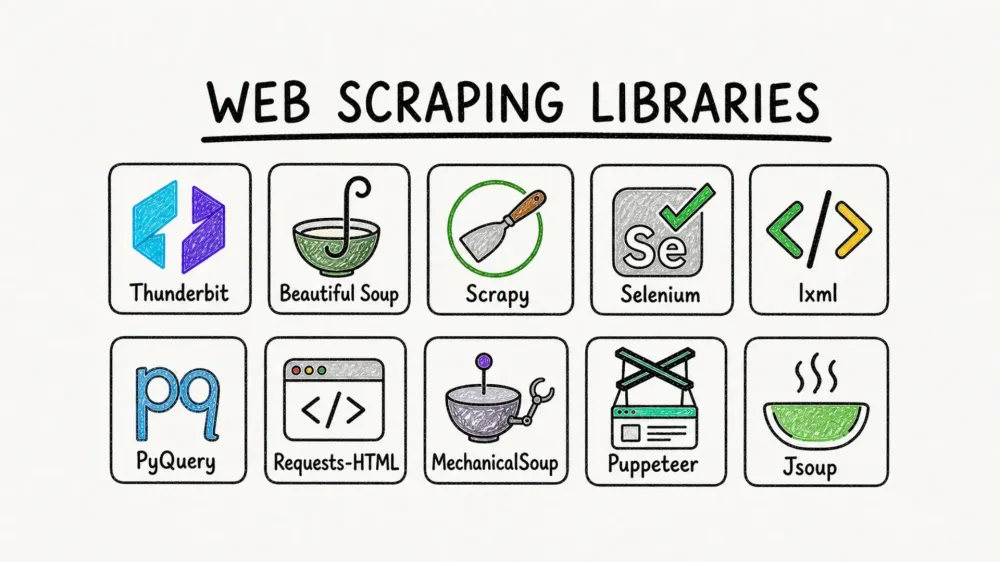
10 najmocniejszych bibliotek do web scrapingu w 2026 roku
- Thunderbit do bezkodowego, opartego na AI scrapingu w przeglądarce
- Beautiful Soup do prostego parsowania HTML i czyszczenia danych w Pythonie
- Scrapy do dużej skali, szybkiego crawlowania i pipeline’ów
- Selenium do automatyzacji przeglądarki i scrapingu stron dynamicznych, mocno opartych na JavaScript
- lxml do błyskawicznego parsowania XML/HTML w Pythonie
- PyQuery do selekcji HTML w Pythonie w stylu jQuery
- Requests-HTML do kompleksowej obsługi HTTP, parsowania HTML i renderowania JS w Pythonie
- MechanicalSoup do automatyzacji formularzy i prostych zadań przeglądarkowych w Pythonie
- Puppeteer do automatyzacji headless Chrome w Node.js
- Jsoup do solidnego parsowania HTML w Javie
1. Thunderbit

Thunderbit to moja pierwsza rekomendacja dla każdego, kto chce pobierać dane z webu bez napisania choćby jednej linijki kodu. To rozszerzenie AI do Chrome pozwala opisać, czego potrzebujesz („Pobierz wszystkie nazwy produktów, ceny i obrazy z tej strony”), a AI zajmuje się resztą. Bez szablonów, bez konfiguracji — po prostu klikasz raz, ewentualnie dopasowujesz kolumny, jeśli chcesz, a ekstrakcja działa niezależnie od tego, czy cokolwiek potem dotkniesz.
Dlaczego Thunderbit wyróżnia się w 2026 roku:
- Interfejs bez kodu, oparty na naturalnym języku: Może z niego korzystać każdy — sprzedaż, operacje, marketing, nieruchomości. Bez Pythona.
- Automatyczne wykrywanie pól: AI samo wyprowadza zestaw kolumn bezpośrednio ze struktury strony.
- Scraping podstron: Potrzebujesz więcej szczegółów? Thunderbit może odwiedzać kolejne podstrony (np. produktowe lub profilowe) i automatycznie wzbogacać tabelę (Thunderbit Blog).
- Gotowe szablony dla popularnych serwisów: Amazon, Zillow, Shopify i wiele innych — scrapowanie jednym kliknięciem.
- Eksport do Excel, Google Sheets, Notion, Airtable: Dane trafiają dokładnie tam, gdzie potrzebuje ich Twój zespół.
- Obsługa 34 języków: Idealne rozwiązanie dla zespołów działających globalnie.
- Scraping w chmurze lub w przeglądarce: Wybierz tryb pasujący do Twojego procesu — chmura jest bardzo szybka dla stron publicznych, a tryb przeglądarkowy obsługuje logowania.
Thunderbit zaufało ponad 200 000 użytkowników na całym świecie, a darmowy plan pozwala pobrać do 6 stron (albo 10 w ramach bonusu próbnego). Jeśli chcesz zobaczyć, jak wygląda nowoczesny web scraping, to właśnie od tego miejsca bym zaczął.
Wypróbuj Thunderbit AI Web Scraper za darmo
2. Beautiful Soup
Beautiful Soup to klasyczna biblioteka Pythona, uwielbiana przez data scientistów i analityków za prostotę i skuteczność w parsowaniu chaotycznego HTML. Jeśli kiedykolwiek próbowałeś wyciągnąć dane ze strony z uszkodzonymi tagami albo dziwnym formatowaniem, Beautiful Soup jest Twoim sprzymierzeńcem.
Dlaczego Beautiful Soup jest tak dobre:
- Radzi sobie z nieregularnym HTML: Świetne do porządkowania i wyciągania danych z „brzydkich” stron (Beautiful Soup Docs).
- Łatwe do nauki: Nawet początkujący w Pythonie szybko ruszą z miejsca.
- Elastyczne: Dobrze współpracuje z klientami HTTP, takimi jak Requests, i można je łączyć z lxml dla większej szybkości.
- Typowe zastosowania: szybka ekstrakcja danych, czyszczenie danych webowych, integracja z małymi skryptami.
Jeśli pracujesz ze statycznymi stronami albo musisz uporządkować niechlujny markup, Beautiful Soup to bardzo solidny wybór.
3. Scrapy
Scrapy to ciężka artyleria wśród narzędzi do web scrapingu w Pythonie. To pełnoprawny framework do budowania skalowalnych crawlerów i pipeline’ów danych. Jeśli musisz pobierać tysiące stron, podążać za linkami i przetwarzać dane na dużą skalę, Scrapy zostało stworzone właśnie do tego.
Dlaczego Scrapy jest jednym z najlepszych wyborów:
- Bardzo modularne: Możesz budować złożone spidery, pipeline’y i middlewares (Scrapy Docs).
- Dobre do dużych projektów: Świetne do badań rynku, analizy konkurencji i wszystkich zadań wymagających crawlowania oraz ekstrakcji z wielu stron.
- Asynchroniczne i szybkie: Zoptymalizowane pod kątem prędkości i wydajności.
- Ogromna społeczność: Mnóstwo wtyczek, poradników i wsparcia.
Scrapy ma swoją krzywą uczenia, ale przy dużych projektach to prawdziwa potęga.
4. Selenium
Selenium to narzędzie pierwszego wyboru do automatyzacji przeglądarek. Używa się go do wszystkiego — od testowania aplikacji webowych po scrapowanie stron wymagających logowania, kliknięć czy obsługi okienek pop-up. Jeśli musisz pracować z serwisami mocno opartymi na JavaScript albo wysoce dynamicznymi, Selenium potrafi zachowywać się jak prawdziwy użytkownik (ScrapingBee Selenium Guide).
Mocne strony Selenium:
- Automatyzuje prawdziwe przeglądarki: Chrome, Firefox, Safari, Edge — co tylko chcesz.
- Obsługuje logowania, pop-upy i działania użytkownika: Świetne do scrapingu po autoryzacji albo przechodzenia przez wieloetapowe procesy.
- Wsparcie dla wielu języków: Python, Java, C# i inne.
- Najlepsze do: stron, które blokują proste scrapery, albo gdy trzeba zasymulować realne zachowanie użytkownika.
Jest trochę cięższe niż biblioteki oparte na HTTP, ale czasem po prostu potrzebujesz prawdziwej przeglądarki.
5. lxml
lxml to wysokowydajny parser XML i HTML dla Pythona. Jeśli priorytetem jest szybkość (np. parsowanie tysięcy dużych dokumentów), lxml naprawdę trudno przebić (Python HTML Parser Performance).
Dlaczego lxml jest tak lubiane:
- Błyskawiczne: Wyprzedza większość innych parserów Pythona, zwłaszcza przy dużych plikach.
- Solidne: Obsługuje zarówno XML, jak i HTML, i dobrze integruje się z innymi narzędziami.
- Świetne do: przetwarzania dużych zbiorów danych, łączenia z Beautiful Soup albo Scrapy dla większej mocy.
Jeśli scrapujesz na dużą skalę albo musisz obrabiać ogromne pliki, lxml to pozycja obowiązkowa w Twoim zestawie.
6. PyQuery
PyQuery przenosi do Pythona wygodę składni selektorów z jQuery. Jeśli lubisz prostotę wybierania elementów przez $('.class') w jQuery, PyQuery pozwala robić to samo w skryptach do scrapingu (PyQuery Docs).
Najważniejsze zalety PyQuery:
- Selektory w stylu jQuery: Intuicyjne dla osób znających frontend.
- Zwięzły, czytelny kod: Ułatwia proste zapisy nawet dla bardziej złożonych selekcji.
- Integracja z lxml: Pod spodem działa szybko i sprawnie.
- Najlepsze do: projektów, w których chcesz szybko manipulować HTML-em w Pythonie w stylu jQuery.
To świetny pomost dla osób przechodzących z web developmentu do ekstrakcji danych.
7. Requests-HTML
Requests-HTML to biblioteka Pythona, która łączy prostotę Requests (dla HTTP) z wbudowanym parsowaniem HTML, a nawet renderowaniem JavaScript.
Co wyróżnia Requests-HTML:
- Wszystko w jednym: pobieranie stron, parsowanie HTML i renderowanie JavaScript w jednym pakiecie.
- Przyjazne dla początkujących: świetne do małych i średnich projektów scrapingowych.
- Dobre do: szybkich skryptów, stron z pewną ilością dynamicznej treści i sytuacji, gdy zależy Ci na prostocie.
Jeśli dopiero zaczynasz albo potrzebujesz elastycznego narzędzia do mniejszych zadań, Requests-HTML to bardzo dobry wybór.
8. MechanicalSoup
MechanicalSoup to biblioteka Pythona do automatyzacji formularzy i prostych interakcji z przeglądarką. Bazuje na Beautiful Soup i Requests, dzięki czemu łatwo nią logować się, wypełniać formularze i przechodzić przez podstawowe procesy (ScrapingBee MechanicalSoup Guide).
Dlaczego MechanicalSoup się przydaje:
- Automatyzuje formularze i logowania: świetne do scrapingu danych ukrytych za autoryzacją.
- Proste API: łatwe do opanowania dla początkujących.
- Najlepsze do: powtarzalnych zadań przeglądarkowych, prostych workflowów i stron, gdzie pełna automatyzacja przeglądarki byłaby przesadą.
Nie jest tak mocne jak Selenium w przypadku złożonych stron, ale jest dużo lżejsze i wygodniejsze do podstawowych potrzeb.
9. Puppeteer
Puppeteer to biblioteka Node.js do kontrolowania headless Chrome lub Chromium. Jest ulubionym narzędziem do scrapingu stron mocno opartych na JavaScript i bardzo interaktywnych serwisów (Scrape.do Puppeteer Guide).
Supermoce Puppeteera:
- Pełna automatyzacja przeglądarki: klikaj, przewijaj, wypełniaj formularze i wchodź w interakcję jak zwykły użytkownik.
- Radzi sobie z dynamiczną treścią: idealne do stron, które ładują dane przez JavaScript.
- Świetne do: e-commerce, social mediów i wszystkich serwisów, gdzie tradycyjne scrapery zawodzą.
Jeśli jesteś deweloperem JavaScript albo chcesz scrapować „nowoczesny web”, Puppeteer to must-have.
10. Jsoup
Jsoup to złoty standard parsowania HTML w Javie. To trochę jak Beautiful Soup, tylko dla programistów Java (Baeldung Jsoup Guide).
Dlaczego zespoły Java lubią Jsoup:
- Proste, ale potężne API: wyciąganie i manipulacja danymi zajmuje tylko kilka linii kodu.
- Radzi sobie z niechlujnym HTML-em: czyści i parsuje nawet słabo sformatowane strony.
- Najlepsze do: wpinania scrapingu w aplikacje biznesowe oparte na Javie lub backendowe workflowy.
Jeśli Twój stack jest oparty na Javie, Jsoup to oczywisty wybór.
Tabela porównawcza bibliotek do web scrapingu
Oto szybkie porównanie wszystkich 10 bibliotek:
| Biblioteka | Język | Łatwość użycia | Dynamiczna treść | AI / bez kodu | Typowe zastosowania | Najlepsze dla |
|---|---|---|---|---|---|---|
| Thunderbit | Rozszerzenie Chrome | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | Tak | sprzedaż, operacje, badania, nieruchomości | osoby nietechniczne, biznes |
| Beautiful Soup | Python | ⭐⭐⭐⭐ | ⭐ | Nie | parsowanie HTML, czyszczenie danych | początkujący w Pythonie, analitycy |
| Scrapy | Python | ⭐⭐⭐ | ⭐⭐ | Nie | crawlowanie na dużą skalę, pipeline’y | deweloperzy, duże projekty danych |
| Selenium | Wiele | ⭐⭐ | ⭐⭐⭐⭐⭐ | Nie | automatyzacja przeglądarki, logowania | QA, strony dynamiczne |
| lxml | Python | ⭐⭐⭐ | ⭐ | Nie | szybkie parsowanie, duże pliki | power userzy, duże zbiory danych |
| PyQuery | Python | ⭐⭐⭐⭐ | ⭐ | Nie | selekcja w stylu jQuery | web deweloperzy, zwięzłe skrypty |
| Requests-HTML | Python | ⭐⭐⭐⭐ | ⭐⭐ | Nie | szybkie skrypty, renderowanie JS | początkujący, małe projekty |
| MechanicalSoup | Python | ⭐⭐⭐⭐ | ⭐⭐ | Nie | automatyzacja formularzy, logowania | proste zadania przeglądarkowe |
| Puppeteer | Node.js | ⭐⭐⭐ | ⭐⭐⭐⭐⭐ | Nie | strony mocno oparte na JS, automatyzacja | deweloperzy JS, dynamiczny web scraping |
| Jsoup | Java | ⭐⭐⭐⭐ | ⭐ | Nie | parsowanie HTML w Javie | zespoły Java, workflowy backendowe |
Jak wybrać odpowiednią bibliotekę do web scrapingu dla Twojej firmy
Czym jest data scraping i jak go robić w 2025 roku Get Started Free
No dobrze, więc której biblioteki powinieneś użyć? Oto moja rada, oparta na latach prób, błędów i kilku zbyt wielu nocnych sesjach debugowania:
- Osoby nietechniczne lub użytkownicy biznesowi: Zacznij od Thunderbit. Podejście AI / no-code pozwala uzyskać wynik w minuty, nie dni. Jeśli Twój zespół po prostu chce dane w Excelu lub Sheets, nie komplikuj tego bardziej niż trzeba.
- Programiści Pythona: Beautiful Soup i Requests-HTML są świetne do mniejszych zadań. Scrapy to Twój przyjaciel przy dużych projektach. Łącz je z lxml lub PyQuery, żeby zyskać więcej mocy.
- Musisz obsłużyć logowania albo dynamiczną treść? Selenium (wielojęzyczne) albo Puppeteer (Node.js) będą najlepszym wyborem.
- Zespoły Java: Jsoup jest zdecydowanym zwycięzcą, jeśli chcesz wpiąć scraping do aplikacji Java.
- Chcesz automatyzować formularze lub proste workflowy? MechanicalSoup jest lekkie i łatwe w użyciu.
Najważniejsze czynniki, które warto wziąć pod uwagę:
- Poziom umiejętności technicznych: narzędzia bez kodu, takie jak Thunderbit, są idealne dla zespołów nietechnicznych. Deweloperzy mogą z kolei preferować elastyczność bibliotek kodowych.
- Złożoność danych: dla prostych, statycznych stron świetnie sprawdzą się Beautiful Soup lub Jsoup. Dla dynamicznych serwisów opartych na JavaScript lepiej wybrać Selenium albo Puppeteer.
- Skala: Scrapy i lxml błyszczą przy dużych, szybkich zadaniach.
- Integracje: bezpośredni eksport Thunderbit do Sheets, Notion i Airtable oszczędza mnóstwo czasu w procesach biznesowych.
Więcej informacji o wyborze odpowiedniego narzędzia znajdziesz w przewodniku PromptCloud.
Zobacz cennik Thunderbit i darmowy plan
Podsumowanie: odblokuj dane z sieci dzięki właściwym narzędziom
Web scraping w 2026 roku nie jest już domeną wyłącznie programistów i data scientistów. Dzięki wysypowi narzędzi opartych na AI i bez kodu, każdy zespół — od sprzedaży po badania — może sięgnąć po internetową kopalnię danych. Odpowiednia biblioteka może oszczędzić Ci setki godzin rocznie (Browsercat), zwiększyć dokładność i dać Twojej firmie realną przewagę.
Moja rada? Zacznij od swoich potrzeb — szybkości, skali i komfortu technicznego — i przetestuj kilka opcji. Darmowy plan Thunderbit to świetny sposób, żeby wejść w temat, a otwarte biblioteki jak Beautiful Soup czy Scrapy zawsze są pod ręką, jeśli chcesz ubrudzić sobie ręce kodem.
Chcesz wejść głębiej? Zajrzyj na blog Thunderbit, aby znaleźć więcej poradników, albo zasubskrybuj nasz kanał YouTube, żeby zobaczyć praktyczne tutoriale.
Udanych scrapów — i oby Twoje dane zawsze były czyste, uporządkowane i gotowe do działania.
Wypróbuj Thunderbit AI Web Scraper za darmo Get Started Free
FAQ
1. Jaka biblioteka do web scrapingu jest najłatwiejsza dla osób nietechnicznych w 2026 roku?
Thunderbit to najlepszy wybór dla osób bez umiejętności programowania. Jego opierające się na AI rozszerzenie do Chrome pozwala pobierać dane za pomocą promptów w naturalnym języku — bez kodowania.
2. Która biblioteka najlepiej sprawdza się przy scrapowaniu stron mocno opartych na JavaScript lub dynamicznych?
Puppeteer (Node.js) i Selenium (wiele języków) są najlepsze do scrapowania dynamicznych stron renderowanych przez JavaScript. Automatyzują prawdziwe przeglądarki i obsługują złożone interakcje.
3. Czym różni się Beautiful Soup od Scrapy?
Beautiful Soup świetnie nadaje się do parsowania i wyciągania danych z pojedynczych stron lub małych projektów, zwłaszcza gdy HTML jest chaotyczny. Scrapy to pełny framework do budowania skalowalnych crawlerów i przetwarzania dużych zbiorów danych.
4. Czy mogę eksportować dane z scrapingu bezpośrednio do Google Sheets lub Notion?
Tak — Thunderbit oferuje bezpośredni eksport do Google Sheets, Notion, Airtable i Excela. Większość bibliotek kodowych wymaga napisania własnej logiki eksportu.
5. Jak wybrać odpowiednią bibliotekę do web scrapingu dla mojej firmy?
Weź pod uwagę swoje umiejętności techniczne, złożoność stron, które chcesz scrapować, ilość danych oraz potrzeby integracyjne. Narzędzia no-code, takie jak Thunderbit, są idealne dla zespołów biznesowych, natomiast deweloperzy mogą preferować biblioteki takie jak Scrapy, Beautiful Soup czy Puppeteer, jeśli zależy im na większej kontroli.
Dowiedz się więcej



