
Każdego roku internet robi się coraz bardziej złożony, a dystans między „potrzebuję tych danych” a „wiem, jak je zdobyć” wcale się nie zmniejsza. Dla osoby początkującej pierwsze pytanie zwykle brzmi prosto: Czy naprawdę muszę uczyć się Pythona tylko po to, żeby pobrać ceny produktów ze strony?
Na szczęście odpowiedź brzmi: nie. Ale kolejne pytanie — którego narzędzia właściwie powinienem użyć? — szybko robi się znacznie trudniejsze. Mamy aplikacje no-code na desktop, rozszerzenia do przeglądarki, frameworki w Pythonie, biblioteki w Go, roboty SEO, zarządzane API i projekty open source, które zacierają granice między tymi kategoriami. Dziesięć wyróżniających się opcji dostępnych w 2026 roku najlepiej odpowiada na pytania, które naprawdę zadają sobie początkujący: ile kodowania potrzeba, jak szybko da się dojść do użytecznych danych, czy narzędzie radzi sobie z witrynami opartymi na JavaScript, co dostaje się za darmo i do jakiego zastosowania pasuje najlepiej. Niezależnie od tego, czy nigdy nie napisałeś ani jednej linijki kodu, czy jesteś młodszym developerem szukającym swojego pierwszego frameworka do crawlowania, znajdziesz tu dobry punkt startowy.
Jak wybraliśmy najlepsze crawlery internetowe dla początkujących
„Początkujący” nie znaczy „nietechniczny”. Chodzi o każdą osobę, która wcześniej nie budowała procesu do crawlowania stron — także taką, która dobrze czuje się w podstawowym Pythonie lub JavaScripcie, ale nigdy nie układała kolejki URL-i ani nie pracowała z plikiem robots.txt.
Każde narzędzie ocenialiśmy w sześciu obszarach, które bezpośrednio odpowiadają na pytania zadawane przez początkujących na forach:
- Wymagany kod — brak, podstawowy Python/JS lub poziom średniozaawansowany+
- Trudność konfiguracji — czas od instalacji do pierwszych użytecznych danych
- Renderowanie JavaScript — czy narzędzie radzi sobie z SPA i stronami ładującymi treść dynamicznie?
- Hołdność darmowego planu — co otrzymujesz, zanim cokolwiek zapłacisz?
- Formaty wyjściowe — CSV, JSON, Excel, Google Sheets itd.
- Najlepsze zastosowanie — konkretny scenariusz, w którym dane narzędzie naprawdę błyszczy dla początkującego
Lista obejmuje trzy poziomy: no-code (bez programowania), średniozaawansowany (podstawowy Python lub JavaScript) oraz zaawansowany początkujący (Go lub głębsza znajomość frameworków). Starałem się uczciwie pokazać, gdzie każde narzędzie wypada najlepiej, a gdzie ma ograniczenia — bo wybór niewłaściwego crawlera do swojego poziomu to jeden z najszybszych sposobów, by zmarnować popołudnie.
Wybierz swojego pierwszego crawlера: szybki schemat decyzyjny
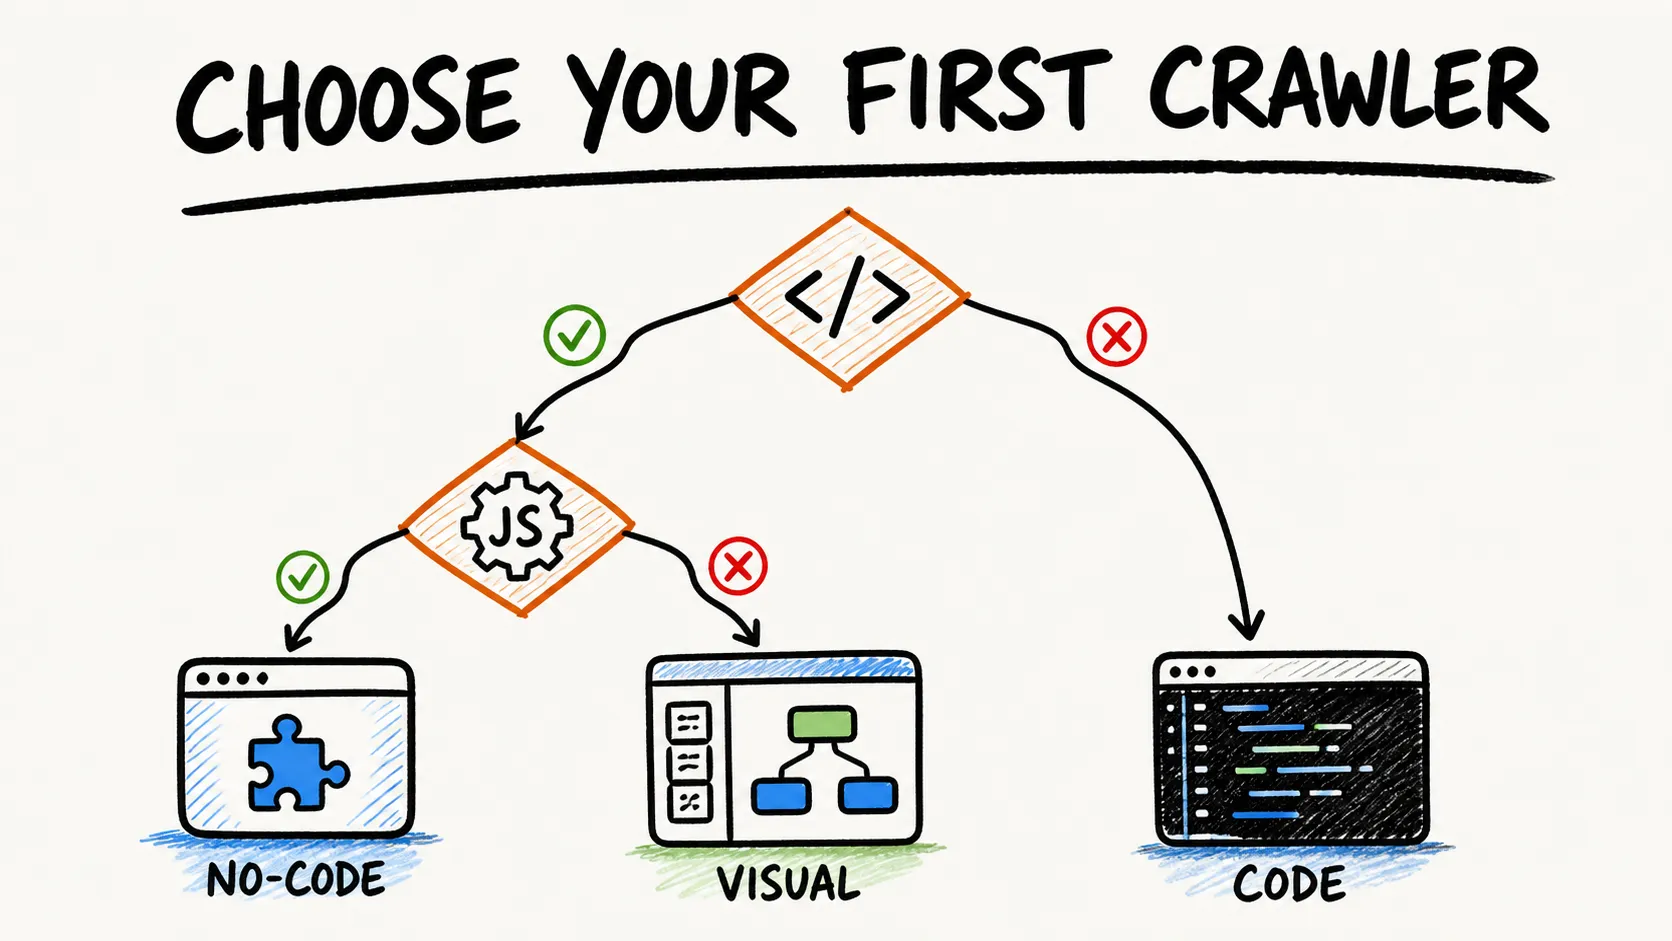
Zanim przejrzysz dziesięć recenzji narzędzi, odpowiedz na trzy pytania. Ich połączenie wskaże jedno lub dwa rozwiązania, które naprawdę pasują.
Pytanie 1: Jak dobrze czujesz się z kodowaniem?
- Wcale → przejdź do pytania 2a
- Podstawowy Python → przejdź do pytania 2b
- JavaScript/TypeScript → przejdź do pytania 2c
- Go → Colly
Pytanie 2a (bez kodu): Jaki jest Twój główny cel?
- Ogólne pozyskiwanie danych (informacje o produktach, listy leadów, research) → Thunderbit lub Octoparse
- Złożone procesy wieloetapowe (logowanie, listy rozwijane, infinite scroll) → ParseHub lub Octoparse
- Audyt SEO → Screaming Frog
Pytanie 2b (Python): Jaki jest Twój główny cel?
- Pipeline AI/LLM (RAG, trening chatbota) → Crawl4AI lub Firecrawl
- Duże, uporządkowane crawlowanie głównie statycznych stron → Scrapy
- Automatyzacja przeglądarki na stronach mocno opartych na JS → Playwright (ale przygotuj się na zbudowanie własnej logiki crawlowania)
Pytanie 2c (JavaScript/TypeScript): Jaki jest Twój główny cel?
- Nowoczesne crawlowanie SPA z ochroną przed blokadami → Crawlee
- Złożona interakcja z przeglądarką (logowanie, kliknięcia, zrzuty ekranu) → Playwright
- Czysty markdown do wykorzystania przez AI → Firecrawl (przez API/SDK)
Filtr budżetowy: jeśli potrzebujesz oprogramowania za 0 zł i możesz hostować je samodzielnie, narzędzia open source tutaj (Scrapy, Crawlee, Crawl4AI, Playwright i Colly) nie mają narzuconego przez dostawcę limitu stron, choć nadal obowiązują koszty obliczeń, przepustowości, magazynu, utrzymania i ograniczenia po stronie docelowej witryny. Jeśli nie możesz hostować samodzielnie, Octoparse, ParseHub, Thunderbit, Firecrawl i Screaming Frog oferują darmową ścieżkę, ale z różnymi limitami.
Sam ten schemat może oszczędzić Ci godzin przełączania kart. Warto go zapisać.
Najlepsze crawlery internetowe dla początkujących w skrócie
Poniżej znajdziesz pełne porównanie w tabeli. „Wymagany kod” mówi, jakiego języka — jeśli w ogóle — potrzebujesz. „JS Rendering” pokazuje, czy narzędzie potrafi obsłużyć strony ładujące treść przez JavaScript. „Free Tier” podsumowuje, co dostajesz za 0 zł. Szczegółowe omówienia znajdziesz niżej.
| Narzędzie | Poziom | Wymagany kod | Renderowanie JS | Darmowy plan | Najlepsze do |
|---|---|---|---|---|---|
| Octoparse | Początkujący | Brak | ✅ Wbudowane | Darmowy plan: 10 zadań, tylko lokalnie, 10 tys. wierszy/eksport | Klikane scrapowanie uporządkowanych stron |
| ParseHub | Początkujący | Brak | ✅ Wbudowane | 5 publicznych projektów, 200 stron/uruchomienie, 14 dni przechowywania | Złożone procesy wielostronicowe bez kodu |
| Thunderbit | Początkujący | Brak | ✅ Przez przeglądarkę | Darmowy plan (sprawdź aktualne limity) | Wsparcie AI przy pobieraniu danych z aktualnie otwartej strony |
| Crawl4AI | Średniozaawansowany | Python | ✅ Chromium | Open source (self-hosted) | Crawlowanie gotowe pod LLM dla pipeline RAG |
| Firecrawl | Średniozaawansowany | API/SDK | ✅ Zarządzane | 1 000 kredytów/miesiąc (cloud) | Czysty markdown do zasilania AI |
| Scrapy | Średniozaawansowany | Python | ⚠️ Wymaga wtyczki | Open source (BSD) | Duże, konfigurowalne projekty HTTP crawl |
| Crawlee | Średniozaawansowany | JS/TS lub Python | ✅ Przez Playwright | Open source (Apache) | Nowoczesne crawlowanie JS z ochroną przed blokadami |
| Playwright | Średniozaawansowany | Python/JS/Java/.NET | ✅ Natywne | Open source (Apache) | Automatyzacja przeglądarki + interakcja ze stronami opartymi na JS |
| Screaming Frog | Początkujący | Brak | ✅ (tylko płatna wersja) | 500 URL-i/crawl (na zawsze za darmo) | Audyt SEO i analiza techniczna strony |
| Colly | Zaawansowany początkujący | Go | ⚠️ Brak wbudowanego | Open source (Apache) | Szybkie, lekkie równoległe crawlowanie HTTP |
Teraz przejdźmy do szczegółów.
1. Octoparse

Octoparse to desktopowy kreator zadań no-code z opcjonalnym płatnym uruchamianiem w chmurze. Wklejasz URL, Auto-detect wykrywa powtarzające się pola danych i wzorce nawigacji, sprawdzasz podgląd, a potem uruchamiasz zadanie lokalnie. Wizualny edytor workflow obsługuje pętle, gałęzie, paginację, infinite scroll, AJAX, formularze i listy rozwijane — choć przy dynamicznych procesach czasem trzeba ręcznie dopasować timing.
Najważniejsze funkcje:
- Auto-detect pól danych i nawigacji po stronach
- Wbudowane renderowanie JavaScript przez wewnętrzną przeglądarkę
- Setki gotowych szablonów dla popularnych serwisów
- Edytowalne workflow z własnymi pętlami, gałęziami i kontrolą selektorów
- Eksport do Excel, CSV, HTML, JSON, XML, Google Sheets i baz danych (zależnie od planu)
Cennik: ograniczony darmowy plan obsługuje uruchomienia lokalne. Uruchamianie w chmurze, harmonogramy, rotacja IP i dostęp API wymagają płatnego planu. Sprawdź aktualne ceny przed decyzją, bo limity planów mogą się zmieniać.
Najlepsze dla: początkujących, którzy chcą regularnie pobierać uporządkowane dane z e-commerce, katalogów lub list — bez pisania kodu. Mniej wygodne, jeśli zależy Ci na prostocie rozszerzenia do przeglądarki albo na outputcie gotowym pod LLM.
2. ParseHub
ParseHub to wizualny extractor do pobrania na Windows, macOS i Linux (przez AppImage). Jego interfejs w formie drzewa poleceń modeluje zaznaczenia, kliknięcia, wpisywanie danych do formularzy, przewijanie i szablony stron. Obsługuje AJAX/JavaScript, listy rozwijane, zakładki, okna pop-up, paginację, formularze logowania i infinite scroll.
Najważniejsze funkcje:
- Wizualne drzewo poleceń do wieloetapowych procesów ekstrakcji
- Obsługa AJAX, JavaScript, list rozwijanych, zakładek i infinite scroll
- Desktopowa aplikacja cross-platform (Windows, macOS, Linux)
- Dostęp API do programowego pobierania danych
- Eksport do CSV i JSON
Cennik: dostępne są plany darmowe i płatne. Płatna „strona” może oznaczać URL lub dynamiczne wczytanie treści wywołane kliknięciem albo przewinięciem, więc limit stron nie zawsze odpowiada tej samej liczbie adresów URL. Przed wyborem planu sprawdź aktualne limity projektów, uruchomień i przechowywania danych.
Uwaga dotycząca prywatności: nie wpisuj produkcyjnych danych logowania do narzędzia firm trzecich, dopóki nie sprawdzisz, jak przechowuje ono dane logowania i dane projektu. Do testów użyj ograniczonego konta próbnego.
Najlepsze dla: początkujących, którzy chcą scrapować dynamiczne, wieloetapowe strony — takie z rozbudowaną nawigacją, dropdownami lub ładowaniem po przewijaniu — bez kodu.
ParseHub vs. Octoparse: najważniejsze różnice
Oba narzędzia są desktopowe, no-code i radzą sobie z JavaScriptem. Model drzewa poleceń w ParseHub daje bardziej precyzyjną kontrolę nad procesami wieloetapowymi — to plus przy złożonej nawigacji, ale też większa bariera wejścia przy prostych zadaniach. Auto-detect w Octoparse jest szybszy dla prostych, uporządkowanych stron i oferuje korzystniejsze limity eksportu w darmowym planie. Jeśli Twoja strona to głównie tabele i listy, zacznij od Octoparse. Jeśli musisz odwzorować serię kliknięć, wypełnianie formularzy i warunkową nawigację, bardziej przejrzyste może być podejście ParseHub.
3. Thunderbit

Thunderbit to agentowe rozszerzenie do przeglądarki do web scrapingu dla Chrome i Edge, stworzone dla nietechnicznych użytkowników biznesowych, którzy chcą wyciągać dane z aktualnie oglądanej strony. (Dla jasności: pracuję w Thunderbit, więc opisuję zarówno mocne strony, jak i ograniczenia.)
Najważniejsze funkcje:
- One Click Extract automatycznie wykrywa kolumny na podstawie zawartości strony
- Prompty AI na poziomie pól do kategoryzacji, tłumaczenia, formatowania i normalizacji podczas ekstrakcji
- Eksport do Excel/CSV, Google Sheets, Airtable i Notion
- Browser Mode działa na renderowanej sesji użytkownika i obsługuje treści ładowane przez JavaScript na zgodnych stronach
- Bez instalacji dodatkowego oprogramowania poza rozszerzeniem do przeglądarki
Cennik: darmowy plan obejmuje obecnie 6 stron miesięcznie przy limicie 30 kredytów na stronę. Starter ($15/mies. lub $9/mies. przy rozliczeniu rocznym) dodaje paginację, scrapowanie podstron, scrapowanie zbiorcze, wzbogacanie danych, gotowe scrapers i harmonogramy. Sprawdź aktualny cennik tutaj.
Ważne ograniczenia: Thunderbit działa na poziomie strony/schematu, a nie jako crawler odkrywający cały serwis. Paginacja i scrapowanie podstron to funkcje Starter, nie Free. Pola sugerowane przez AI zawsze warto sprawdzić przed uruchomieniem — sugestie są dobre, ale nieomylne nie są.
Najlepsze dla: zespołów sprzedaży, operacji i researchu, które potrzebują uporządkowanych danych z aktualnie otwartej strony w przeglądarce, z pomocą AI, żeby pominąć ręczne konfigurowanie pól. Jeśli szukasz szybkiego sposobu na pobranie tabeli, listy lub zestawu rekordów z kompatybilnej strony i eksport do arkusza, to najszybsza droga, jaką znam.
Więcej o tym, jak działa ekstrakcja wspierana przez AI w praktyce, znajdziesz w naszym przewodniku po AI web scraping.
Bez kodu, w jednym kliknięciu Agentowy web scraper Thunderbit odczytuje dowolną stronę i sam wybiera pola — bez kodu, świetny pierwszy crawler dla początkujących. Get Started Free
4. Crawl4AI
Crawl4AI to open-source’owy crawler w Pythonie, działający przede wszystkim w przeglądarce, zaprojektowany tak, aby tworzyć czysty output do workflowów LLM. Generuje surowy i oczyszczony HTML, wiele wariantów markdowna, strukturalnie wyodrębnioną treść, linki, multimedia, tabele, zrzuty ekranu, PDF-y i MHTML.
Najważniejsze funkcje:
- AsyncWebCrawler z Chromium/Playwright pod spodem
- Wiele formatów wyjściowych zoptymalizowanych pod pipeline RAG i workflowy agentowe
- Adaptacyjne crawlowanie, które ocenia zasięg, spójność i nasycenie, aby priorytetyzować istotne linki i zatrzymać się, gdy zebrało już wystarczająco informacji
- Opcjonalna ekstrakcja przez LLM z lokalnymi providerami (Ollama) lub API w chmurze
- Licencja Apache-2.0 z dodatkowym wymogiem atrybucji
Cennik: w pełni open source — bez opłat za stronę. Infrastruktura jest po Twojej stronie, a koszty dotyczą ewentualnego inference LLM (lokalnego lub w chmurze).
Ograniczenia: wymaga znajomości async w Pythonie i zależności przeglądarkowych. Jakość ekstrakcji zależy od używanego LLM (jeśli z niego korzystasz). Adaptacyjny crawler priorytetyzuje linki na podstawie sygnałów wystarczalności informacji — nie uczy się trwale i nie „naprawia” samodzielnie selektorów CSS.
Najlepsze dla: średniozaawansowanych użytkowników Pythona budujących pipeline’y danych dla AI, którzy chcą pełnej kontroli i zerowych kosztów po stronie dostawcy za żądanie.
5. Firecrawl
Firecrawl to zarządzane API do danych webowych (z SDK dla Pythona i Node.js) oraz kod open source self-hosted na licencji AGPL. Usługa w chmurze obsługuje renderowanie JavaScript i zwraca markdown, podsumowania, HTML, linki, obrazy, zrzuty ekranu, JSON oraz śledzenie zmian.
Najważniejsze funkcje:
- Endpoint
/crawlz filtrami ścieżek, głębokością odkrywania, sitemapami, limitami, opóźnieniami i kontrolą współbieżności - Automatyczne renderowanie JavaScript w zarządzanej chmurze
- Wiele formatów wyjściowych, w tym czysty markdown
- Endpoint
/mapdo szybkiego poznawania struktury witryny - Tryby Browser/Interact oraz beta agentowe do wieloetapowej interakcji (osobno od podstawowego crawl)
Cennik: Cloud Free to 1 000 kredytów miesięcznie z dwoma równoległymi żądaniami i niskimi limitami. Płatne plany bazują na kredytach i współbieżności — aktualne wartości znajdziesz na stronie cennika. Self-hosting przenosi na Ciebie infrastrukturę i utrzymanie oraz nie obejmuje wszystkich funkcji zarządzanej chmury.
Ograniczenia: podstawowy /crawl odkrywa URL-e rekursywnie przez linki i sitemapę, ale nie gwarantuje obsługi dowolnej paginacji opartej na klikaniu. Koszt kredytów zależy od typu operacji. Zestawy funkcji self-hosted i cloud różnią się między sobą.
Najlepsze dla: użytkowników średniozaawansowanych, którzy chcą zasilać treścią stron LLM-y, chatboty lub bazy wiedzy i wolą usługę zarządzaną niż samodzielne utrzymywanie stosu przeglądarkowego.
Firecrawl vs. Crawl4AI: które narzędzie do pipeline’ów AI?
Firecrawl błyszczy jako zarządzane narzędzie do konwersji na markdown z przejrzystym API — wysyłasz URL i dostajesz uporządkowany wynik. Crawl4AI lepiej sprawdza się przy lokalnym podejściu, gdzie sam kontrolujesz przeglądarkę i opcjonalny LLM. Jeśli chcesz minimalnej administracji, cloud Firecrawl będzie łatwiejszy. Jeśli zależy Ci na pełnym self-hostingu bez opłat za stronę i dobrze czujesz się w Pythonie async, Crawl4AI daje większą kontrolę.
6. Scrapy
Scrapy to od dawna rozwijany framework do crawlowania i scrapowania w Pythonie na licencji BSD, zbudowany na silniku asynchronicznym Twisted. Oferuje planowanie requestów, podążanie za linkami, deduplikację, middleware, retry, throttling, pipeline’y oraz eksport feedów do JSON, JSON Lines, CSV, XML, pickle i marshal.
Najważniejsze funkcje:
- Asynchroniczna obsługa requestów, odpowiednia dla dużych, dobrze ograniczonych crawlów
- Rozbudowany ekosystem middleware (proxy, retry, throttling, własne nagłówki)
- Struktura pipeline’ów do czyszczenia i przechowywania danych
- Ogromna społeczność, dokumentacja i rozszerzenia firm trzecich
- W pełni open source (licencja BSD)
Ograniczenia: brak natywnego renderowania JavaScript. Oficjalne wytyczne dotyczące dynamicznej treści rekomendują, by tam, gdzie to możliwe, znaleźć źródło danych lub świadomie zintegrować komponent przeglądarkowy/renderujący, np. scrapy-playwright. Architektura — spidery, middleware, item pipeline’y, settings — ma realną krzywą uczenia.
Cennik: darmowy. Hostujesz sam.
Najlepsze dla: średniozaawansowanych użytkowników Pythona, którzy chcą crawlowac duże, głównie statyczne lub renderowane po stronie serwera witryny na dużą skalę.
Pierwsze kroki w Scrapy: szybki start z komentarzem
Oto minimalna ścieżka od instalacji do pierwszych danych:
pip install scrapy
scrapy startproject beginner_crawl
cd beginner_crawl
scrapy genspider example example.com
Otwórz beginner_crawl/spiders/example.py i zmodyfikuj plik:
import scrapy

class ExampleSpider(scrapy.Spider):
    name = "example"
    allowed_domains = ["example.com"]       # Pozostań tylko w tej domenie
    start_urls = ["https://example.com"]    # Adres startowy

    custom_settings = {
        "ROBOTSTXT_OBEY": True,            # Respektuj robots.txt
        "DOWNLOAD_DELAY": 2,               # Czekaj 2 sekundy między requestami
        "CLOSESPIDER_PAGECOUNT": 10,       # Zatrzymaj po 10 stronach (limit bezpieczeństwa)
        "USER_AGENT": "Beginner-Crawl-Bot (+https://yoursite.com/bot-info)",
    }

    def parse(self, response):
        yield {
            "title": response.css("title::text").get(),
            "url": response.url,
        }
        # Przechodź po linkach na stronie (w obrębie allowed_domains)
        for link in response.css("a::attr(href)").getall():
            yield response.follow(link, callback=self.parse)
Uruchom:
scrapy crawl example -o output.json
Najpierw przetestuj selektory w scrapy shell "https://example.com", zanim zaczniesz skalować projekt. Czas konfiguracji zależy od Twojego doświadczenia z Pythonem — jeśli dopiero zaczynasz pracę z wirtualnymi środowiskami i terminalem, nie licz na dziesięć minut.
7. Crawlee
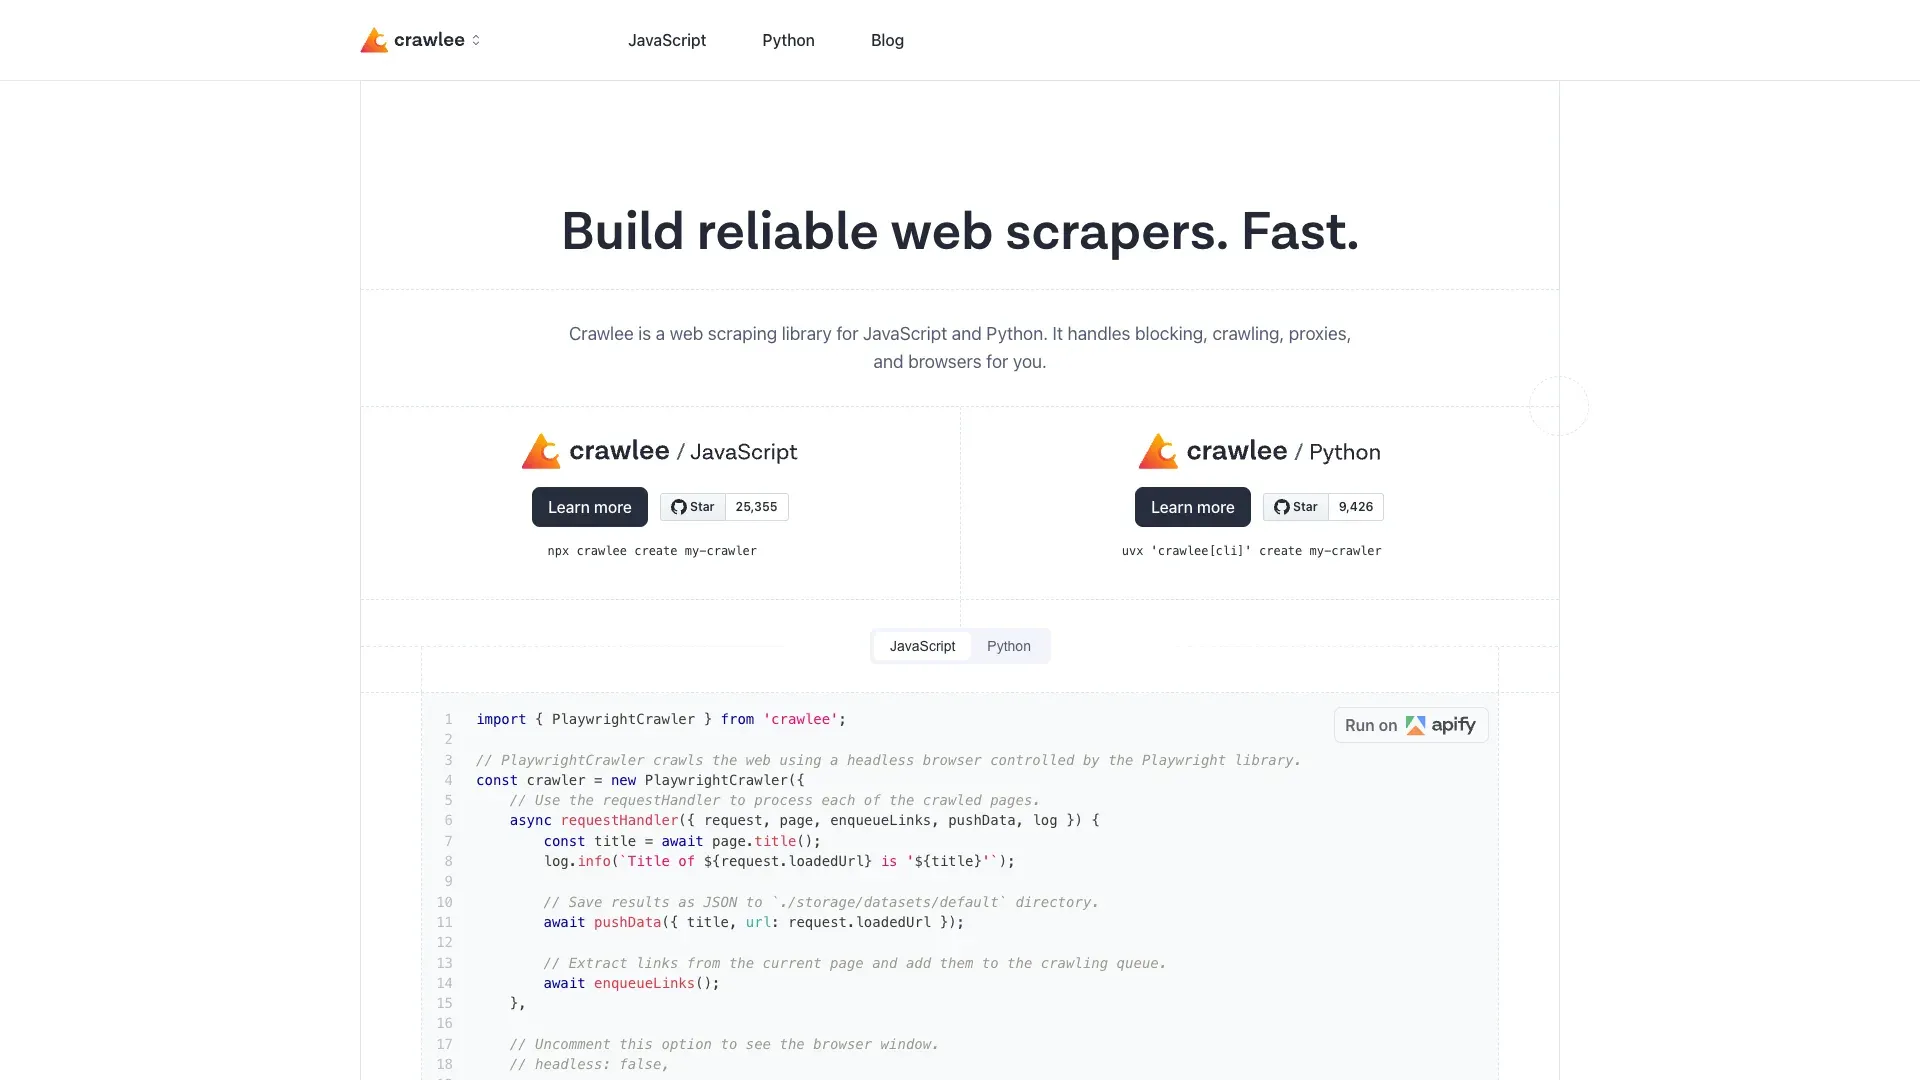
Crawlee to biblioteka crawlerów na licencji Apache dla JavaScript/TypeScript i Pythona, utrzymywana przez Apify. Oferuje klasy HTTP-only (np. CheerioCrawler) oraz crawlery przeglądarkowe Playwright/Puppeteer, kolejki requestów, dataset, obsługę sesji, retry i kontrolę zakresu pracy.
Najważniejsze funkcje:
- Wybór między HTTP-first (CheerioCrawler) a pełną przeglądarką (PlaywrightCrawler) dla każdego projektu
- Wbudowana kolejka requestów, deduplikacja i magazyn datasetów
- Zarządzanie sesjami, fingerprinty przeglądarki, retry i kontrola granic requestów
- TypeScript-first z solidnym wsparciem Pythona
- Oficjalny quickstart zaleca podejście HTTP-first, gdy dane znajdują się w HTML
Cennik: darmowy. Open source, self-hosted.
Ograniczenia: wymaga znajomości JavaScript/TypeScript albo Pythona. Mniej dokumentacji społecznościowej niż w przypadku Scrapy. Funkcje antyblokujące nie dają uprawnień ani nie gwarantują dostępu — zmniejszają ryzyko wykrycia, ale nie czynią niedozwolonego crawlowania legalnym.
Najlepsze dla: średniozaawansowanych developerów JavaScript, którzy chcą crawlowac nowoczesne SPA i strony renderowane w JS, z wbudowanym zarządzaniem kolejką i ochroną przed blokadami.
Szybki start z Crawlee: od instalacji do pierwszych danych
npx crawlee create my-crawler
cd my-crawler
Gdy pojawi się monit konfiguracji, wybierz szablon Playwright.
Edytuj handler w src/routes.ts, aby wyciągnąć potrzebne dane, a następnie:
npm start
Wyniki pojawią się lokalnie w katalogu datasetu jako JSON. Przed skalowaniem poza test koniecznie dodaj maxRequestsPerCrawl, limity głębokości, reguły dla tej samej domeny i rozsądny limit współbieżności.
8. Playwright
Playwright to framework Microsoftu do automatyzacji przeglądarki na licencji Apache, obsługujący Pythona, Node.js, Javę i .NET. Steruje prawdziwymi przeglądarkami Chromium, Firefox i WebKit — dlatego świetnie radzi sobie ze stronami ładującymi treść przez JavaScript, wymagającymi logowania lub złożonych interakcji.
Najważniejsze funkcje:
- Natywne renderowanie w prawdziwej przeglądarce w trzech silnikach
- Obsługa SPA, logowania, kliknięć, wypełniania formularzy, pobierania plików, zrzutów ekranu i PDF-ów
- Wsparcie wielu języków (Python, JS/TS, Java, .NET)
- Bardzo dobra dokumentacja i aktywny rozwój
- Przechwytywanie ruchu sieciowego i mockowanie requestów
Czym Playwright nie jest: kompletnym crawlerem. Nie oferuje natywnego frontiera URL-i, kolejki deduplikacji, polityki uprzejmości, modelu retry ani eksportera feedów. Te elementy musisz zbudować sam — albo połączyć Playwright z frameworkiem takim jak Crawlee, który je zapewnia.
Cennik: darmowy. Open source.
Najlepsze dla: średniozaawansowanych developerów, którzy chcą automatyzować interakcje przeglądarkowe na stronach mocno opartych na JS lub chronionych logowaniem i są gotowi zbudować wokół tego własną logikę crawl.
9. Screaming Frog
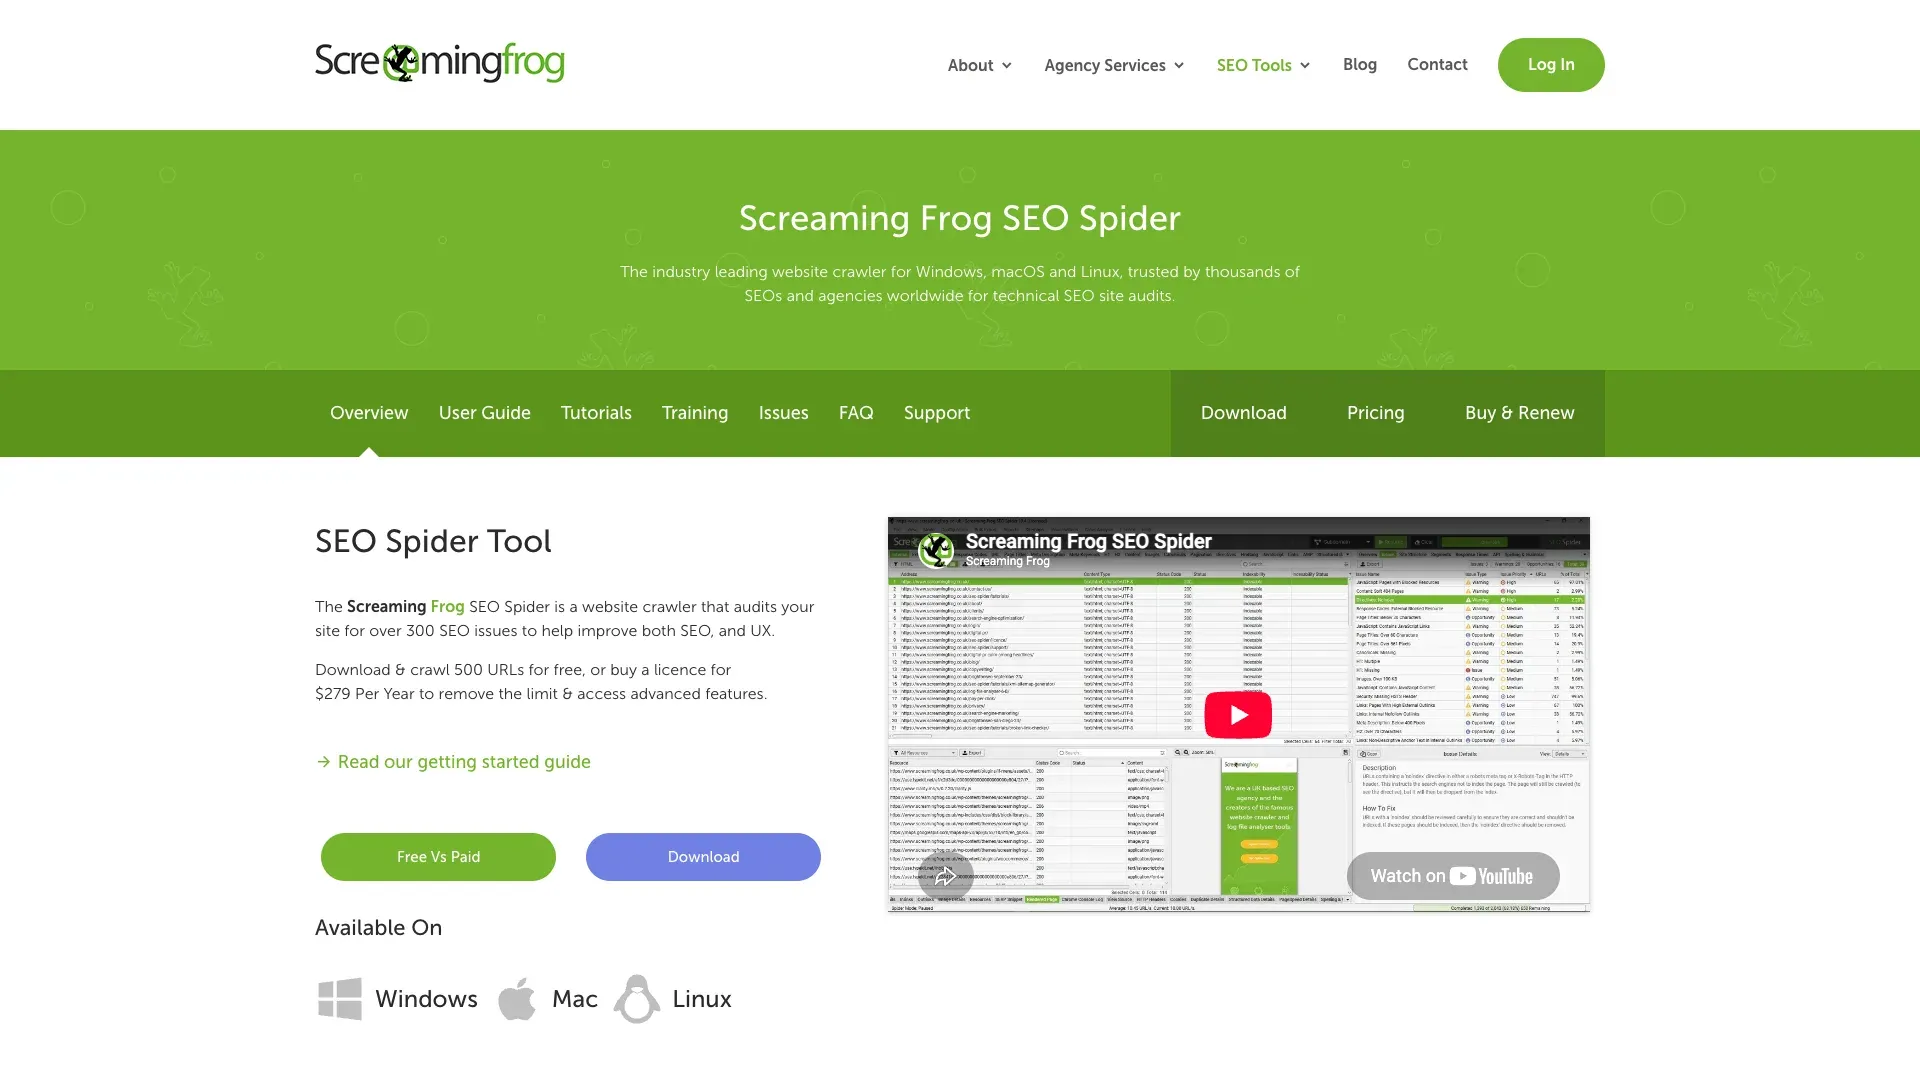
Screaming Frog SEO Spider to desktopowy crawler techniczny SEO dla Windows, macOS i Linux. To nie jest ogólne narzędzie do ekstrakcji danych — to podstawowy crawler do audytów SEO, wykrywania niedziałających linków, łańcuchów przekierowań, duplikatów treści, brakujących metadanych i setek innych problemów technicznych SEO.
Najważniejsze funkcje:
- Crawluje do 500 URL-i za darmo (na stałe, nie jako trial)
- Wykrywa niedziałające linki, łańcuchy przekierowań, duplikaty treści i brakujące metadane
- Szczegółowe zakładki dla tytułów stron, meta description, nagłówków, obrazów i innych elementów
- Wersja płatna dodaje renderowanie JavaScript, zapisywanie crawl, własną ekstrakcję, integrację z GA/GSC oraz integracje AI (OpenAI, Gemini, Anthropic, Ollama)
Cennik: darmowa wersja jest dostępna na stałe i obejmuje 500 URL-i na crawl, ale nie ma renderowania JavaScript, zaawansowanej konfiguracji, własnej ekstrakcji ani integracji. Licencja kosztuje £199 / $279 / €245 za użytkownika rocznie.
Ograniczenia: wysoka krzywa uczenia dla osób spoza SEO. Dużo korzysta z zasobów lokalnego urządzenia (na dużych stronach ogranicza Cię pamięć). Brak opcji planu miesięcznego. Nie jest przeznaczony do ogólnej ekstrakcji danych — to narzędzie audytowe.
Najlepsze dla: początkujących skupionych na audycie SEO i analizie technicznej strony. Jeśli chcesz wyciągać dane o produktach lub budować listy leadów, szukaj gdzie indziej.
10. Colly
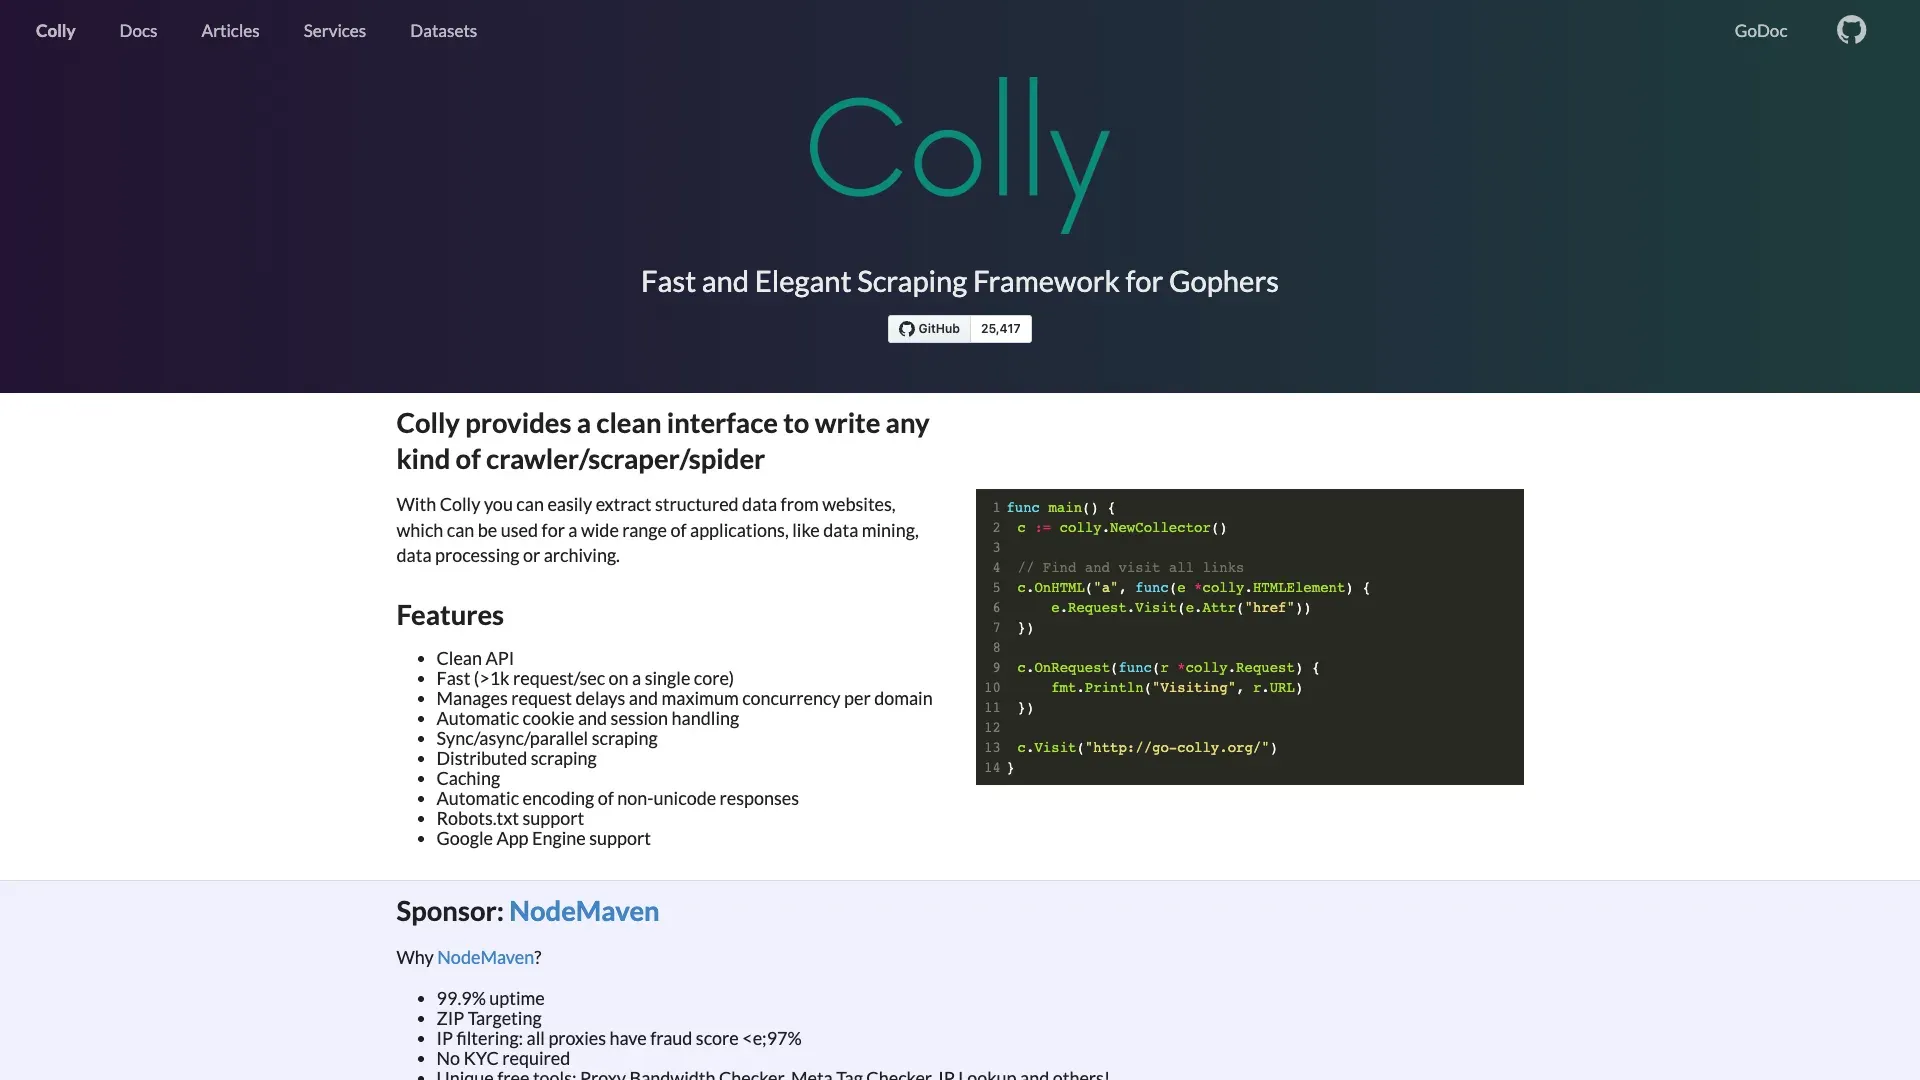
Colly to framework do HTTP crawlowania/scrapowania w Go na licencji Apache, z API opartym na callbackach, kontrolą współbieżności, sesjami/cookies, kolejkami, cache’em i wymienialnymi backendami przechowywania.
Najważniejsze funkcje:
- Szybkie równoległe crawlowanie HTTP przy niskim zużyciu zasobów
- Czyste API oparte na callbackach
- Wbudowana obsługa cookies/sesji i cache
- Ograniczanie prędkości na poziomie domeny przez LimitRule
- Aktualna instalacja:
go get github.com/gocolly/colly/v2
Kluczowa uwaga dla początkujących: aktualne źródło Colly ustawia IgnoreRobotsTxt = true jako domyślne. Musisz jawnie ustawić to na false i skonfigurować LimitRule z odpowiednim opóźnieniem i poziomem równoległości. Bez tego Colly zignoruje robots.txt i może łatwo przeciążyć serwer docelowy.
Cennik: darmowy. Open source.
Ograniczenia: wymaga znajomości programowania w Go. Brak wbudowanego renderera JavaScript i uniwersalnego eksportera feedów — wyjście musisz serializować samodzielnie. Mniejsza społeczność niż w przypadku narzędzi opartych na Pythonie.
Najlepsze dla: zaawansowanych początkujących, którzy znają Go i potrzebują szybkiego, lekkiego crawlера HTTP do statycznych stron lub API — pod warunkiem, że jawnie skonfigurują robots i limity prędkości.
Porównanie darmowych planów: co naprawdę dostajesz, zanim zapłacisz
To tabela dla osób, które liczą koszty. Każde narzędzie poniżej podzielone jest na dwie grupy: produkty freemium (z limitem, ale bez własnej infrastruktury) oraz narzędzia open source (bez limitu stron, ale hostujesz wszystko sam).
Freemium / darmowe plany desktopowe
| Narzędzie | Limit darmowy | Limit projektów/zadań | Ograniczenia eksportu | Ograniczenie czasowe? | Najważniejsze blokady |
|---|---|---|---|---|---|
| Octoparse | Nieograniczona liczba stron/crawl | 10 zadań | 10 tys. wierszy/eksport; 50 tys. wierszy/miesiąc | Nie (na stałe) | Chmura, harmonogramy, rotacja IP, API |
| ParseHub | 200 stron/uruchomienie | 5 publicznych projektów | CSV/JSON | Nie (na stałe) | Projekty/dane mogą być publiczne; przechowywanie przez 14 dni |
| Thunderbit | 6 stron/miesiąc | Brak | Excel/CSV, Sheets, Airtable, Notion | Nie (na stałe) | Paginacja, podstrony, masowe pobieranie i harmonogramy są w Starter |
| Firecrawl | 1 000 kredytów/miesiąc | Brak | Wszystkie formaty | Nie (na stałe) | 2 równoległe żądania; niskie limity |
| Screaming Frog | 500 URL-i/crawl | Nieograniczone uruchomienia | Ograniczony eksport | Nie (na stałe) | Renderowanie JS, zapisywanie crawl, własna ekstrakcja, integracje |
Narzędzia open source (self-hosted)
| Narzędzie | Limit stron | Licencja | Za co płacisz |
|---|---|---|---|
| Scrapy | Brak | BSD | Obliczenia, transfer, magazyn, opcjonalna integracja przeglądarkowa |
| Crawlee | Brak | Apache | Obliczenia, transfer, procesy przeglądarki |
| Crawl4AI | Brak | Apache-2.0 + atrybucja | Obliczenia, procesy przeglądarki, opcjonalny inference LLM |
| Playwright | Brak | Apache | Obliczenia, procesy przeglądarki (duże CPU/pamięć) |
| Colly | Brak | Apache | Obliczenia, transfer |
Jeśli Twój budżet na oprogramowanie wynosi zero i potrafisz programować, narzędzia open source omijają limit stron narzucony przez dostawcę, ale nadal zostają koszty infrastruktury, ograniczenia po stronie docelowej witryny i koszty operacyjne. Nie potrafisz kodować? Octoparse, ParseHub i Thunderbit mają darmową ścieżkę — tylko uważaj na limity i warunki prywatności.
Twoje pierwsze 10 minut: szybkie starty dla 3 poziomów umiejętności
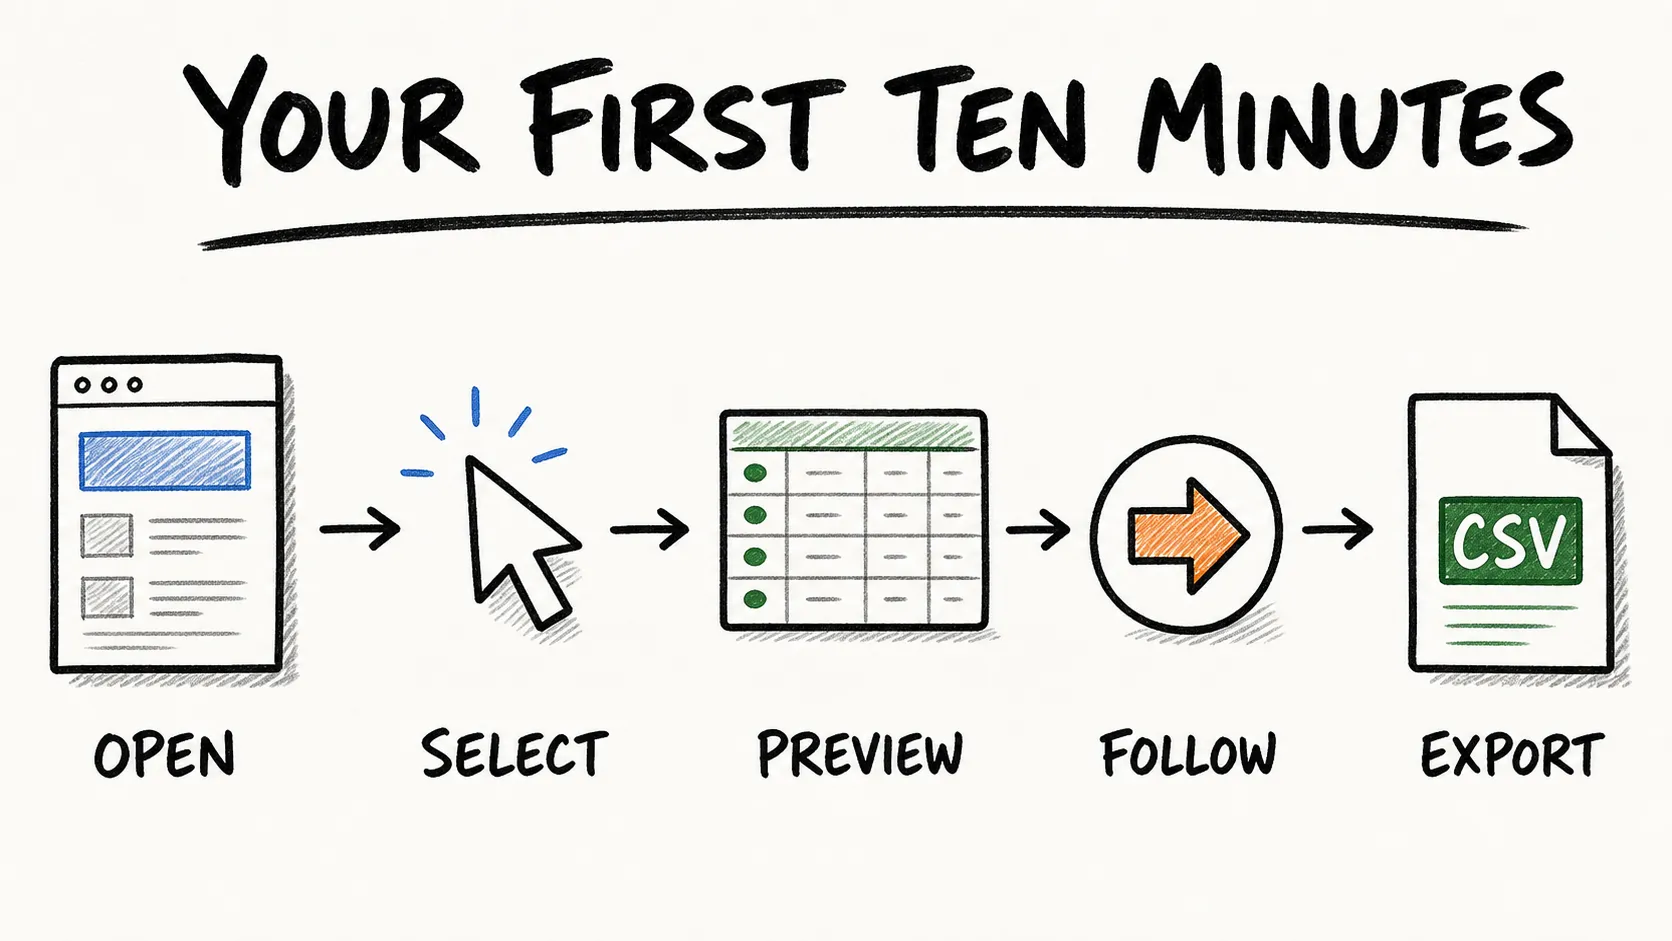
Teoria jest dobra. Praktyka jest lepsza. Oto jak przejść od zera do pierwszego eksportu danych w trzech reprezentatywnych narzędziach — po jednym na każdy poziom.
Ścieżka no-code: start z Thunderbit
- Zainstaluj rozszerzenie Thunderbit do przeglądarki
- Otwórz stronę docelową (np. listing produktów, katalog albo wyniki wyszukiwania)
- Kliknij ikonę Thunderbit i wybierz One Click Extract — AI odczyta stronę, rozpozna jej strukturę, zdecyduje, które kolumny pobrać, i wyciągnie je w jednym przebiegu
- Sprawdź wyniki w rozszerzeniu — zmień nazwy kolumn, usuń lub dodaj nowe oraz dodaj Field AI Prompts, jeśli chcesz coś doprecyzować — a następnie eksportuj do Excel, Google Sheets, Airtable albo Notion
Na zgodnej stronie ma to być krótka konfiguracja, a nie projekt programistyczny.
Bardziej szczegółowy opis znajdziesz w naszym poradniku o wyciąganiu danych ze stron internetowych przy użyciu Thunderbit.
Ścieżka dla początkujących w Pythonie: start z Scrapy
Zobacz opisany wyżej quickstart w sekcji Scrapy. Najważniejsze komendy to pip install scrapy, scrapy startproject, edycja spidera z ROBOTSTXT_OBEY = True i DOWNLOAD_DELAY, a potem scrapy crawl example -o output.json. Zanim skalujesz, testuj selektory w scrapy shell. Czas zależy od Twojego obycia z konfiguracją Pythona.
Ścieżka JavaScript: start z Crawlee
Zobacz quickstart Crawlee wyżej. Uruchom npx crawlee create my-crawler, wybierz szablon Playwright, edytuj handler, a następnie npm start. Wyniki pojawią się jako JSON w lokalnym katalogu datasetu. Zanim zwiększysz skalę, dodaj maxRequestsPerCrawl i ograniczenia domenowe.
Jeśli chcesz dłuższego, opartego na Pythonie walkthrough pokazującego, jak działa cały projekt crawlera, ten kurs będzie dobrym uzupełnieniem:
Wypróbuj za darmo, bez karty kredytowej Darmowy plan obejmuje 6 stron miesięcznie, więc możesz poćwiczyć wyciąganie danych, zanim zdecydujesz się na płatne narzędzie. Get Started Free
5 błędów początkujących, które zabijają pierwszy crawl (i jak ich uniknąć)
Te problemy pojawiają się na forach bez przerwy, a żaden wysoko pozycjonowany artykuł nie omawia ich jako osobnej sekcji.
Błąd 1: użycie crawlера HTTP-only na stronie renderowanej przez JavaScript
Problem: wiele nowoczesnych stron ładuje dane przez JavaScript dopiero po początkowej odpowiedzi HTML. Prosty request HTTP zwraca pusty szkielet strony z pustymi tagami <div> — bez danych.
Rozwiązanie: zanim wybierzesz narzędzie, otwórz stronę docelową, kliknij prawym przyciskiem i wybierz „Pokaż źródło strony”. Jeśli potrzebnych danych nie ma w surowym HTML, potrzebujesz narzędzia z renderowaniem przeglądarkowym: Playwright, PlaywrightCrawler w Crawlee albo narzędzia no-code jak Thunderbit czy Octoparse, które renderują w przeglądarce. Ale nie wybieraj przeglądarki domyślnie, jeśli HTTP wystarczy — dodaje to koszt i złożoność.
Błąd 2: ignorowanie robots.txt i reguł Crawl-Delay
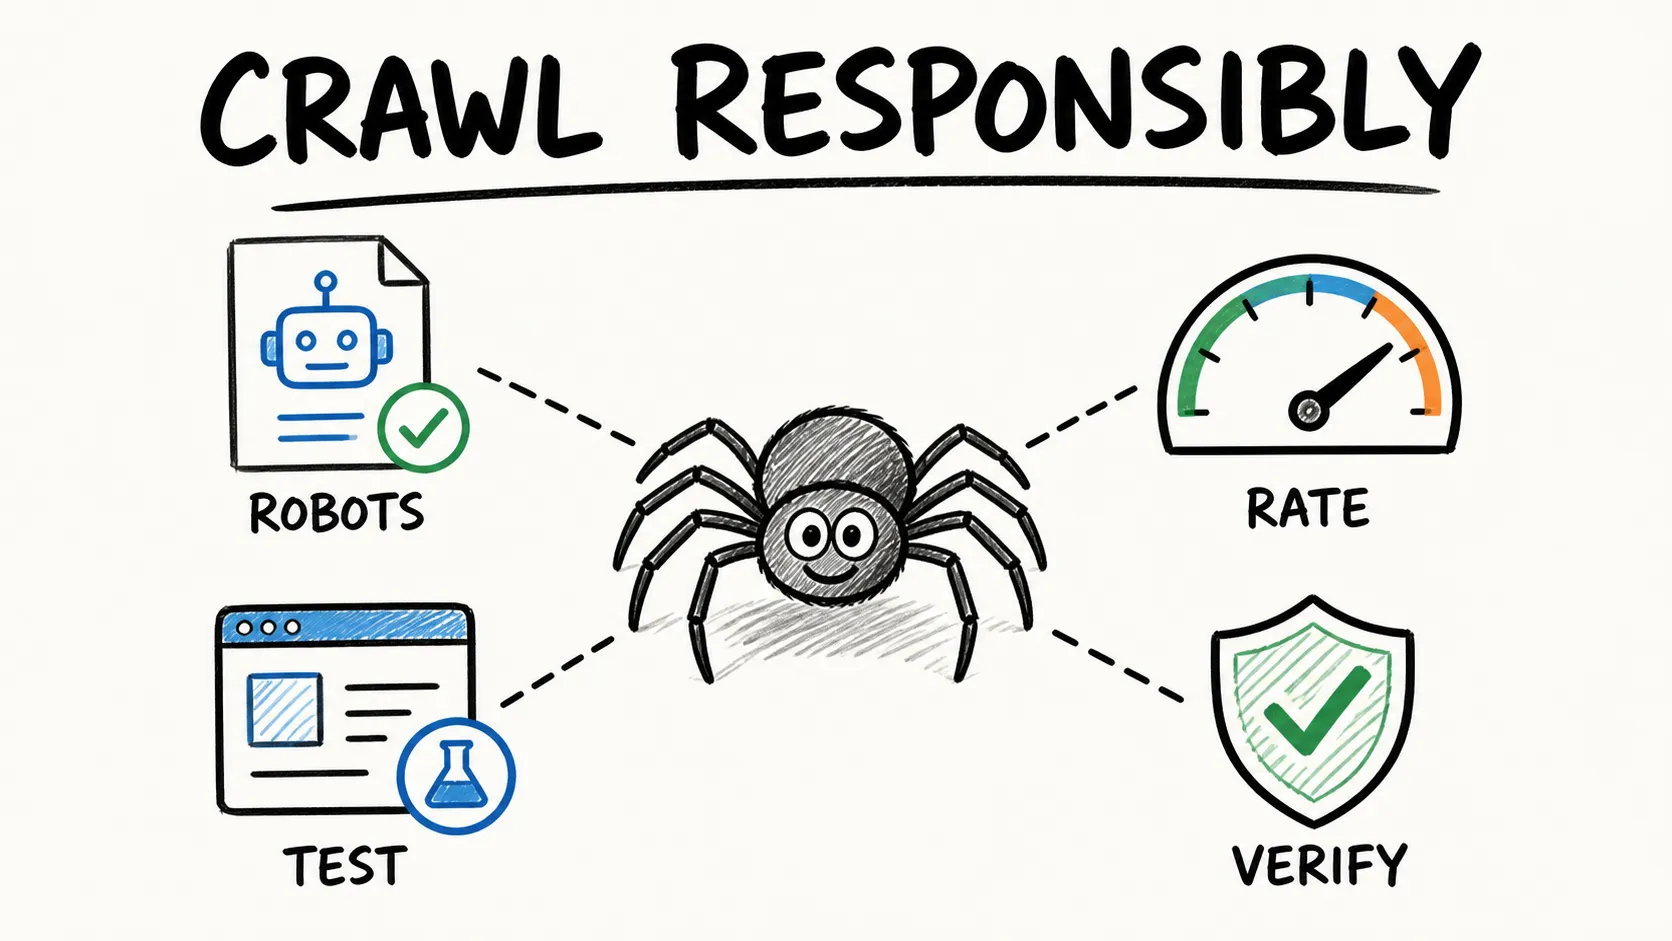
Problem: robots.txt to standard komunikujący, które ścieżki może odwiedzać dany crawler. Ignorowanie polityki crawlowania witryny może prowadzić do blokad, szkód operacyjnych i ryzyka zgodności.
Rozwiązanie: zawsze sprawdź yoursite.com/robots.txt przed crawlowaniem i zweryfikuj rzeczywiste domyślne ustawienia wybranego narzędzia. Domyślne wartości bywają różne: Colly na przykład ustawia IgnoreRobotsTxt = true i wymaga jawnej konfiguracji. Pamiętaj, że robots.txt to sygnał sterujący crawlem, a nie zgoda prawna. Dozwolona ścieżka nie oznacza licencji na zbieranie lub ponowne wykorzystywanie danych w dowolnym celu.
Błąd 3: wysyłanie zbyt wielu requestów bez limitu prędkości
Problem: zasypywanie serwera setkami requestów na sekundę może go przeciążyć, doprowadzić do zablokowania IP i generalnie jest złą praktyką.
Rozwiązanie: ustaw dodatnie opóźnienie. W Scrapy użyj DOWNLOAD_DELAY = 2 i niskiego CONCURRENT_REQUESTS_PER_DOMAIN. W Colly skonfiguruj LimitRule z opóźnieniem i poziomem równoległości. Narzędzia cloud/no-code zwykle robią to automatycznie, ale warto sprawdzić ustawienia. Zacznij od jednego requestu na domenę i zwiększaj skalę tylko wtedy, gdy zachowanie strony i jej warunki na to pozwalają.
Błąd 4: wybór narzędzia na skalę enterprise do małego projektu
Problem: stawianie rozproszonego klastra Scrapy z rotacją proxy i kolejką wiadomości dla projektu na 500 stron to jak wynajmowanie ciężarówki do zakupów spożywczych.
Rozwiązanie: wróć do schematu decyzyjnego. Dopasuj złożoność narzędzia do skali projektu. Przy małych, jednorazowych ekstrakcjach najlepszym wyborem niemal zawsze będzie rozszerzenie do przeglądarki albo prosty skrypt.
Błąd 5: brak walidacji danych wyjściowych
Problem: początkujący często eksportują dane bez sprawdzenia, a potem odkrywają, że połowa wierszy jest pusta, zduplikowana albo uszkodzona.
Rozwiązanie: zawsze sprawdź ręcznie pierwsze 10–20 wierszy, zanim uruchomisz pełny crawl. Zwróć uwagę na puste pola, problemy z kodowaniem znaków (mojibake), zduplikowane rekordy i nieoczekiwane wartości. Zdefiniuj oczekiwany schemat, zanim zaczniesz — jakie kolumny mają istnieć, jakie typy mają mieć i które pola są wymagane. Udane uruchomienie crawla nie oznacza jeszcze poprawnych danych.
Co oznacza „LLM-ready output” i dlaczego ma znaczenie nawet wtedy, gdy nie budujesz AI
„LLM-ready” pojawia się w marketingu crawlerów wszędzie w 2026 roku. Większość wyjaśnień zakłada, że wiesz już, czym jest wektorowa baza danych. Oto wersja po ludzku.
LLM-ready output to czysty, uporządkowany tekst, który model AI (np. GPT lub Claude) może przetworzyć bez ręcznego czyszczenia. To różnica między podaniem komuś starannie uporządkowanego arkusza a wręczeniem stosu wydrukowanych stron z reklamami, menu nawigacyjnym i banerami cookies.
Dlaczego warto się tym interesować, nawet jeśli nie budujesz chatbota? Bo narzędzia projektowane pod output gotowy dla LLM zwykle generują czystsze, bardziej użyteczne dane dla wszystkich. Mniej postprocessingu, mniej śmieciowych kolumn, mniej problemów z kodowaniem. Czyste dane są czyste niezależnie od tego, czy czyta je człowiek, czy maszyna.
Które narzędzia z tej listy natywnie tworzą LLM-ready output?
- Firecrawl → czysty markdown, podsumowania, strukturalny JSON
- Crawl4AI → wiele wariantów markdowna, strukturalne fragmenty, tabele
- Thunderbit → sugerowane przez AI pola strukturalne z normalizacją opartą na promptach
Oto szybkie porównanie przed i po. Surowy HTML z produktu może wyglądać tak:
<div class="product-card">
  <span class="price">$29.99</span>
  <h2 class="title">Wireless Mouse</h2>
  <p class="desc">Ergonomic design, 2.4GHz...</p>
  <a href="/buy" class="btn">Add to Cart</a>
</div>
LLM-ready markdown z Firecrawl:
## Wireless Mouse
- **Cena:** $29.99
- **Opis:** Ergonomic design, 2.4GHz
Strukturalny output z Thunderbit:
| Nazwa produktu | Cena | Opis |
|---|---|---|
| Wireless Mouse | $29.99 | Ergonomic design, 2.4GHz |
Oba formaty nadają się do użycia od razu — bez parsowania HTML, bez usuwania reklam i bez ręcznego mapowania kolumn. Więcej o tym, jak ekstrakcja oparta na AI wypada na tle tradycyjnego scrapingu, znajdziesz w naszym przeglądzie najlepszych AI web scraperów.
Odpowiedzialne crawlowanie stron: szybkie wskazówki dotyczące etyki i zgodności
Etyka i zgodność przy crawlowaniu są zbyt ważne, by je pomijać:
- Sprawdzaj robots.txt przed crawlowaniem każdej strony. To standardowy sygnał kontroli crawla (RFC 9309), ale nie jest ani upoważnieniem prawnym, ani granicą bezpieczeństwa.
- Szanuj limity prędkości i nagłówki Retry-After. Zwalniaj lub zatrzymuj się przy odpowiedziach 429 i 503.
- Korzystaj wyłącznie z publicznie dostępnych lub autoryzowanych danych. Jeśli wystarczy oficjalne API albo eksport, wybierz właśnie to.
- Sprawdź regulamin witryny. Publiczna widoczność ma znaczenie, ale nie jest uniwersalną licencją na zbieranie lub ponowne wykorzystanie danych.
- Uważaj na dane osobowe. Minimalizuj zakres zbierania, ustal zasady retencji/usuwania i zapewnij odpowiedni przegląd zastosowań wrażliwych. GDPR i podobne regulacje obowiązują niezależnie od narzędzia.
Wiele narzędzi oferuje ustawienia wspierające odpowiedzialny crawl, ale sama konfiguracja nie przenosi odpowiedzialności z operatora. Głębsze omówienie procesu znajdziesz w naszym materiale o tym, czym jest web scraping.
Od którego crawlера internetowego zacząć?
Szybkie podsumowanie według poziomu:
- Bez kodu: Thunderbit do ekstrakcji stron wspieranej przez AI, Octoparse do budowania workflowów wizualnych, ParseHub do złożonych procesów wieloetapowych, Screaming Frog do audytów SEO
- Średniozaawansowany Python: Scrapy do dużych crawlów HTTP, Crawl4AI do pipeline’ów LLM
- Średniozaawansowany JavaScript: Crawlee do nowoczesnego crawlowania SPA, Playwright do złożonej automatyzacji przeglądarki
- Go: Colly do szybkiego crawlowania HTTP (z jawnie ustawionymi robots i limitami prędkości)
- Zarządzane API: Firecrawl do czystego markdowna bez self-hostingu
Najlepszy crawler to ten, który pasuje do Twoich danych, uprawnień, poziomu umiejętności i ograniczeń operacyjnych. Zacznij prosto, zweryfikuj mały test i dodawaj złożoność tylko wtedy, gdy projekt tego wymaga. Jeśli chcesz przetestować ekstrakcję wspieraną przez AI, rozszerzenie Thunderbit do przeglądarki daje no-code’ową drogę z kompatybilnej strony do arkusza.
Dowiedz się więcej
- AI Web Scraping
- Web Scraping bez kodowania
- Czym jest web scraping
- Alternatywy dla Instant Data Scraper
- Scraping LinkedIn
Wypróbuj agentowy web scraper Thunderbit Get Started Free
FAQ
1. Czym jest web crawler i czym różni się od web scrapera?
Crawler odkrywa i pobiera strony — podąża za linkami, zarządza kolejką URL-i, obsługuje deduplikację i limity głębokości. Scraper wyciąga z tych stron konkretne, ustrukturyzowane dane — parsuje HTML, wybiera pola i zwraca rekordy. Większość nowoczesnych narzędzi robi jedno i drugie w różnym stopniu, a pojęcia są często używane zamiennie, ale różnica ma znaczenie przy wyborze narzędzia: niektóre, jak Playwright, świetnie renderują strony, ale nie zapewniają infrastruktury crawla, podczas gdy inne, jak Scrapy, dają pełny pipeline crawl, ale wymagają wtyczki do renderowania JavaScript.
2. Który crawler internetowy jest najlepszy dla osoby bez umiejętności kodowania?
Thunderbit, Octoparse i ParseHub to najlepsze opcje no-code do ogólnego pozyskiwania danych. Thunderbit wykorzystuje AI do sugerowania pól i działa jako rozszerzenie przeglądarki; Octoparse oferuje wizualny kreator workflow z Auto-detect; ParseHub świetnie radzi sobie ze złożonymi procesami wieloetapowymi. Dla zastosowań wyłącznie SEO darmowa wersja Screaming Frog crawluje do 500 URL-i bez kodowania.
3. Czy crawlery internetowe są darmowe?
Są dwie grupy. W pełni open-source’owe narzędzia (Scrapy, Crawlee, Crawl4AI, Playwright, Colly) nie pobierają opłat za stronę, ale samodzielnie hostujesz infrastrukturę i płacisz za obliczenia, transfer i magazyn. Narzędzia freemium (Octoparse, ParseHub, Thunderbit, Firecrawl, Screaming Frog) oferują darmowe plany z różnymi limitami stron, projektów, eksportów lub funkcji. Szczegóły znajdziesz w tabeli porównawczej darmowych planów powyżej.
4. Czy crawlery poradzą sobie ze stronami mocno opartymi na JavaScript?
Tak, ale nie wszystkie. Narzędzia z wbudowanym renderowaniem przeglądarkowym — Playwright, Crawlee (PlaywrightCrawler), Octoparse, ParseHub, Crawl4AI oraz Thunderbit (przez Browser Mode) — radzą sobie z treścią ładowaną przez JavaScript. Scrapy i Colly są HTTP-first i do renderowania JS wymagają osobnych integracji z przeglądarką. Screaming Frog obsługuje renderowanie JavaScript tylko w płatnej wersji. Zawsze sprawdź, czy strona naprawdę wymaga przeglądarki, najpierw oglądając surowy HTML źródłowy.
5. Czy web crawling jest legalny?
Nie ma jednej odpowiedzi „tak” lub „nie”. Analiza prawna zależy od danych, sposobu dostępu, planowanego użycia, warunków witryny, umów, zasad własności intelektualnej, obowiązków prywatności, takich jak GDPR, oraz właściwej jurysdykcji. robots.txt to sygnał kontroli crawla, a nie zgoda prawna, a publiczna widoczność nie jest uniwersalną licencją. W konkretnych przypadkach — zwłaszcza gdy chodzi o dane osobowe, treści chronione prawem autorskim, uwierzytelnianie lub komercyjne wykorzystanie — skonsultuj się z wykwalifikowanym prawnikiem.




