
Jeśli w 2023 roku próbowałeś pobierać dane z Twittera za darmo, a w 2026 wróciłeś, zakładając, że wszystko nadal wygląda tak samo, czeka cię niemiła niespodzianka. Darmowe API zniknęło, ścieżka dla badań akademickich została wyłączona, a połowa narzędzi open source, które kiedyś napędzały całe laboratoria badawcze, dziś jest już cyfrowym reliktem.
Zmiany cen w X zmusiły badaczy, zespoły sprzedaży, marketerów i analityków danych do przebudowania procesów, które wcześniej opierały się na darmowym lub tanim dostępie. Na potrzeby analizy z sierpnia 2026 roku działało dwanaście opcji, różniących się kosztami, sposobem pozyskiwania danych i przeznaczeniem. „Nadal działają” oznacza tylko tyle, że można było zweryfikować aktualny produkt lub ofertę — nie że każda z tych opcji jest autoryzowana przez X, kompletna czy gotowa do produkcyjnego użycia.
Dlaczego „dostawcy danych z Twittera” w ogóle stali się wyszukiwanym hasłem
Jeszcze kilka lat temu nikt nie wpisywał w Google „dostawcy danych z Twittera”. Po prostu korzystało się z darmowego API, uruchamiało snscrape albo brało bibliotekę w stylu Tweepy i działało dalej. Potem przyszedł przejęcie przez Muska i efekty domina pojawiły się błyskawicznie:
- Początek 2023: wyłączono darmowy dostęp do API v1.1. Wprowadzono tylko płatne plany.
- Środek 2023: zakończono ścieżkę Academic Research — koło ratunkowe dla tysięcy badaczy zniknęło z dnia na dzień.
- 2023–2024: X używało nazwanych poziomów subskrypcji, w tym Basic i Pro. To już historia, a nie aktualna rekomendacja zakupowa.
- 2025–2026: X przeszło na model przedpłaty i rozliczenia za użycie. Koniec z miesięcznymi abonamentami. Odczyt standardowego posta: $0.005. Odczyt użytkownika: $0.010. Limit samoobsługowy: dwa miliony odczytów postów miesięcznie.
Równolegle osłabła era bibliotek darmowych. Wyszukiwanie w X przez snscrape nie jest już wiarygodne, Twint został zarchiwizowany, a publiczny ekosystem Nitter wielokrotnie był zakłócany zmianami po stronie X. Dlatego „dostawcy danych z Twittera” stali się realnym zapytaniem: zespoły potrzebowały trwałych alternatyw.
Co jest martwe, co uszkodzone: audyt darmowych narzędzi do Twittera na 2026 rok
Zanim przejdziemy do dwunastu aktualnych opcji, warto oddzielić klientów API od metod pozyskiwania danych i skreślić rekomendacje, które nie zapewniają już niezawodnego dostępu.
| Narzędzie | Status (2026) | Uwagi |
|---|---|---|
| snscrape | ⚠️ Uszkodzone / bez utrzymania | Ostatni wiarygodny commit w 2023; zmiany endpointów X je zabiły |
| Twint | ❌ Martwe | Repo archiwalne; nie działa od wycofania API v1.1 |
| Nitter | ⚠️ Niewiarygodny jako warstwa dostępu | Publiczne instancje i metody dostępu były wielokrotnie zakłócane przez zmiany w X |
| Tweepy | ✅ Działa (z płatnym kluczem API) | Utrzymywany, ale wymaga płatnego klucza API X — już nie jest darmowy |
| twarc | ✅ Działa (z płatnym kluczem API) | Utrzymywany przez społeczność akademicką; ten sam wymóg płatnego klucza |
Tweepy i twarc to klienci API, a nie dostawcy danych; są przydatne tylko wtedy, gdy współpracują z aktualnym, ważnym dostępem do API X. snscrape, Twint i Nitter nie powinny być polecane jako trwała warstwa pozyskiwania danych w nowym procesie produkcyjnym.
Istnieją aktualne alternatywy, ale żadna nie odtwarza starego połączenia szerokiego, trwałego i bezpłatnego dostępu przy minimalnej konfiguracji.
Jak dostawcy danych z Twittera faktycznie pozyskują dane
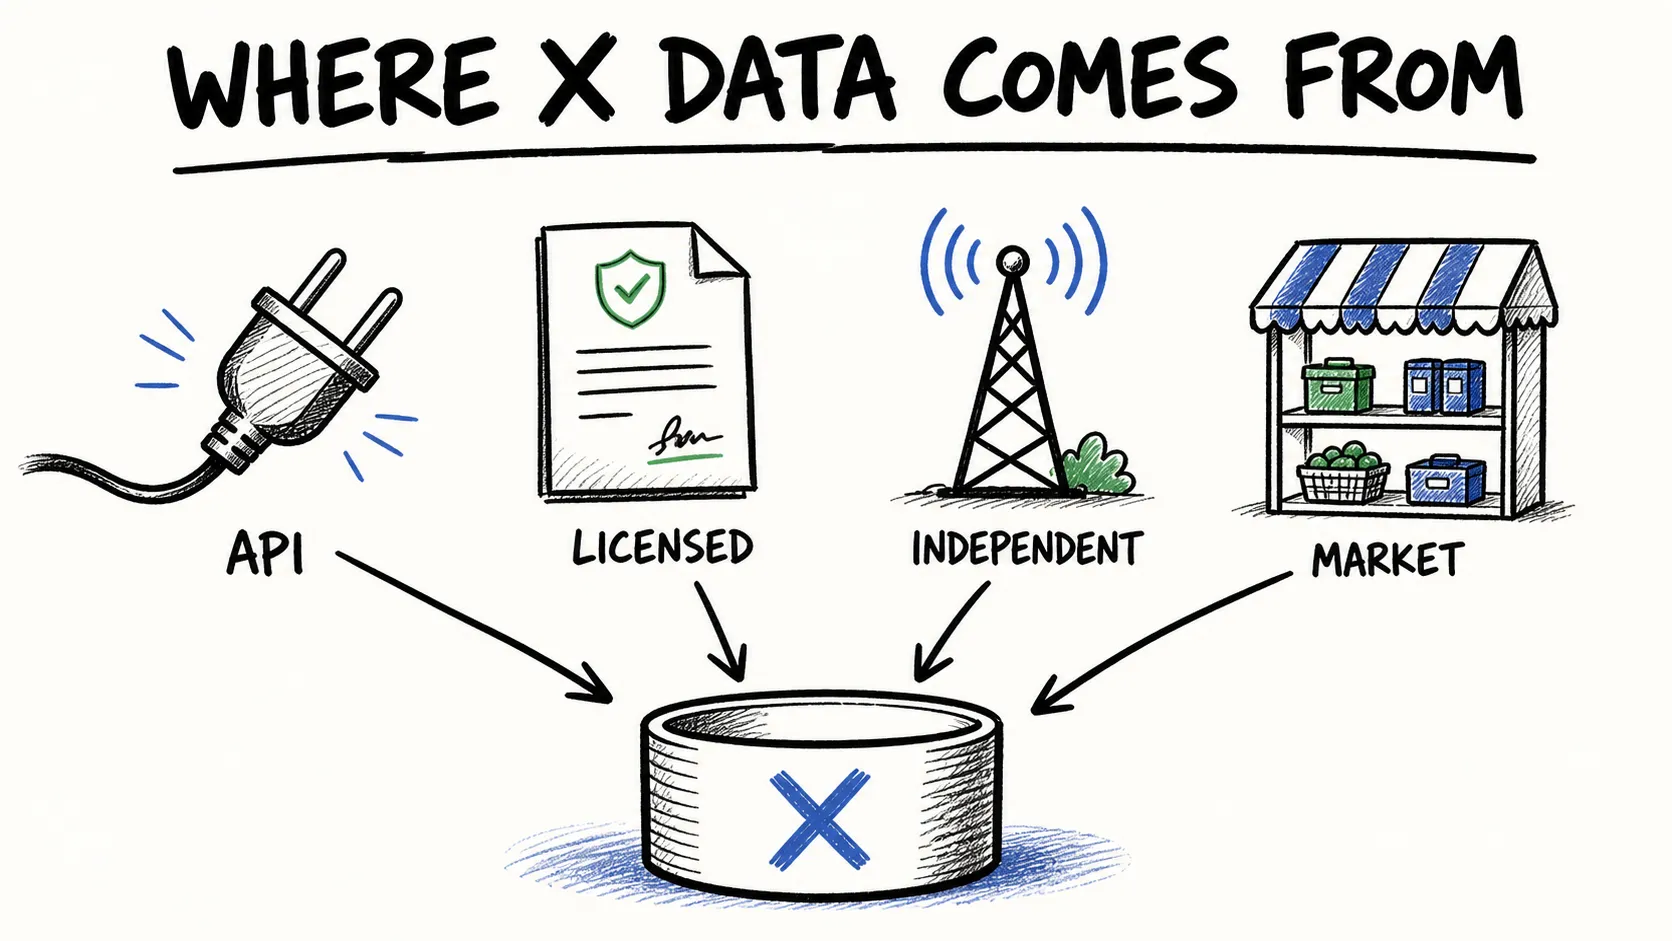
Nie każdy „dostawca danych z Twittera” działa tak samo, a różnice mają znaczenie — dla niezawodności, zgodności i kosztów. Oto klasyfikacja, której używam:
-
Oficjalny dostęp do API — korzystasz z własnego klucza API X, łączysz się bezpośrednio z endpointami X i działasz w ramach limitów oraz polityki dla deweloperów. Tu mieszczą się Tweepy i twarc. Tak samo samo API X.
-
API oparte na scraping'u — dostawca prowadzi automatyczne pobieranie z publicznej sieci (przeglądarki, reverse engineering endpointów itp.) i sprzedaje wynik jako czyste API. Szybsze i często tańsze, ale regulamin X oraz zasady automatyzacji zabraniają crawlowania i scrapingu bez wcześniejszej pisemnej zgody. Bright Data, SocialData.tools i większość Apify Actors trafia do tej kategorii.
-
Licencjonowane platformy social listening — dostawcy klasy enterprise, tacy jak Brandwatch i Meltwater, historycznie mieli umowy na poziomie firehose z Twitterem. Niektórzy nadal mają oficjalne partnerstwa; inni działają na podstawie ewoluujących kontraktów. Zakres danych, prawa eksportu i zasady redakcji różnią się w zależności od pakietu.
-
Narzędzia do ekstrakcji w przeglądarce — narzędzia takie jak Thunderbit mogą uporządkować widoczne dane na zgodnych stronach, jeśli użytkownik ma prawo do automatyzacji. To coś innego niż masowe API czy firehose i nie wolno traktować tego jako obejścia ograniczeń dostępu X.
Zrozumienie, do której kategorii należy dany dostawca, mówi wiele o jego trwałości, sytuacji prawnej i o tym, co stanie się, gdy X coś zmieni.
Na co zwrócić uwagę przy wyborze dostawcy danych z Twittera
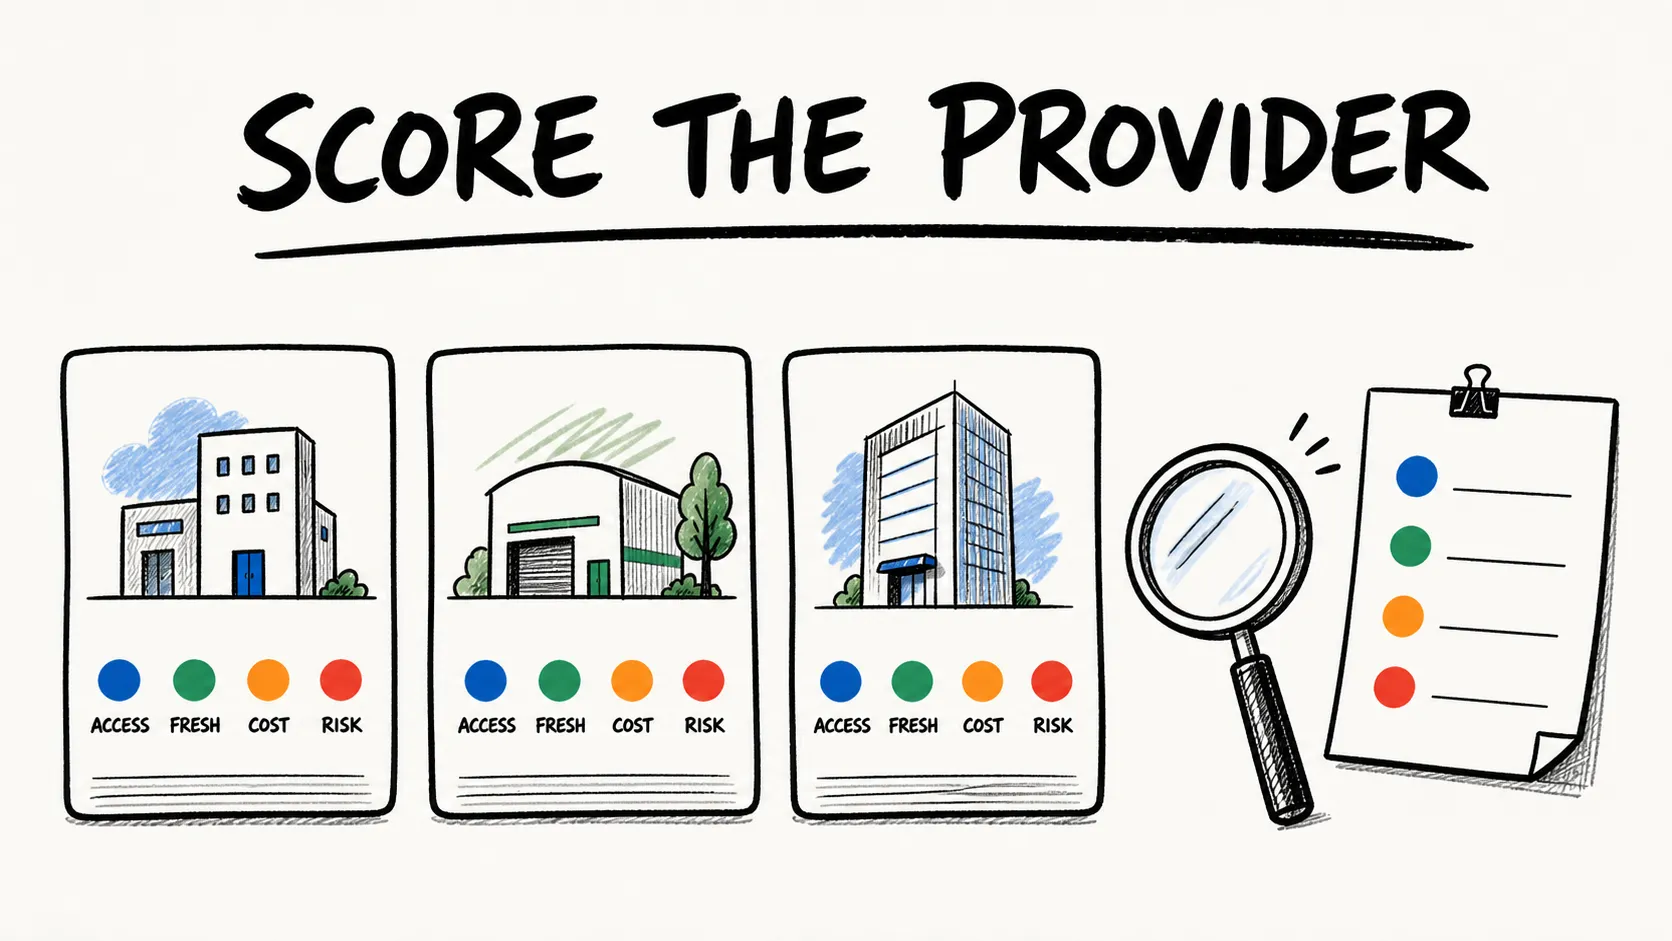
Każda opcja jest oceniana według sześciu praktycznych kryteriów:
- Sposób dostępu do danych — oficjalne API, scraping, licencjonowany listening czy rozwiązanie przeglądarkowe?
- Przejrzystość cen i koszt wejścia — czy ceny są widoczne bez rozmowy ze sprzedażą?
- Rodzaje zwracanych danych — posty, profile, metryki zaangażowania, archiwum historyczne?
- Podejście do zgodności — zgodność z ToS, gotowość pod GDPR/CCPA, obsługa usuwania danych?
- Próg techniczny — tylko dla programistów czy także dla osób nietechnicznych?
- Dowody niezawodności — czy dostawca publikuje SLA, historię statusu, sygnały utrzymania i procedurę informowania o zmianach?
Żaden dostawca nie wygrywa we wszystkich sześciu obszarach. Właściwy wybór zależy od wolumenu, budżetu, umiejętności technicznych i tego, ile utrzymania jesteś w stanie zaakceptować. Mając ten kontekst, przejdźmy do dwunastu opcji.
Porównanie wszystkich 12 dostawców danych z Twittera (2026)
Zanim przejdziemy do szczegółów, poniżej pełne zestawienie. Ceny są aktualne na moment publikacji — zawsze sprawdzaj je na stronie dostawcy, bo ten rynek zmienia się szybko.
| Dostawca | Metoda dostępu | Cena startowa | Dane historyczne | Czas rzeczywisty | Opcja no-code | Najlepsze zastosowanie |
|---|---|---|---|---|---|---|
| X Official API | Bezpośrednie API pierwszej strony | $0.005/odczyt posta (pay-per-use) | Full Archive do marca 2006 | Tak (Filtered Stream) | Nie | Deweloperzy potrzebujący oficjalnych endpointów |
| Bright Data | Zarządzany scraper + datasety | Darmowe 5 tys. rekordów/mies.; PAYG $1.50/1 tys. | Opcje datasetu/okna czasowego; nie znaleziono gwarancji pełnego archiwum | Live scrape na żądanie | Częściowo (panel sterowania) | Zarządzane pozyskiwanie z publicznej sieci |
| SocialData.tools | API oparte na scraping'u | ~$0.20/1 tys. elementów | Zależne od zapytania / kursora | Tak | Nie | Tanie eksperymenty deweloperskie |
| Apify | Marketplace (zależnie od Actora) | Platforma: darmowe $5/mies.; ceny konkretnego Actora | Zależne od Actora | Tak | Częściowo (GUI Actora) | Automatyzacje, prototypowanie |
| Netrows | API wzbogacania danych publicznych | €99/mies. za 10 tys. kredytów | Brak archiwum | Tak (na żywo, bez cache) | Częściowo | Wzbogacanie B2B, prototypowanie |
| PhantomBuster | Automatyzacja sesji/przeglądarki | $56/mies. (efektywna cena roczna w momencie analizy) | Brak gwarantowanego archiwum | Harmonogram / tryb watchera | Tak | Małoskalowe procesy lead generation |
| RapidAPI endpoints | Marketplace (zależnie od oferty) | Free 200 req → $9.99/10 tys. | Zależy od oferty | Zależy od oferty | Nie | Szybkie testy API, prototypowanie |
| Phyllo | Infrastruktura API cross-platform | Wycena indywidualna | Nieznana głębokość dla X | Webhook / real-time claims | Nie | Analityka twórców i influencerów |
| Brandwatch | Enterprise listening (dostawca identyfikuje się jako Official X Partner) | Wycenia indywidualna | Zależne od produktu i pakietu; dostępne oferty z pełnym firehose | Tak, zależnie od produktu | Tak (dashboard) | Monitoring marki, sentyment, badania |
| Meltwater | Enterprise media + social intel | Wycena indywidualna | 15 miesięcy natychmiastowej historii social | Tak | Tak (dashboard) | PR, komunikacja, media intelligence |
| Sprout Social | Zarządzanie social + dodatek Listening | $199/konto/mies. (rocznie) + dodatkowo Listening | Próbkowane; 30-dniowy automatyczny backfill | Tak (próbkowane) | Tak (dashboard) | Zespoły social, publikacja + analityka |
| Thunderbit | Ekstrakcja oparta na przeglądarce | Dostępny plan darmowy | Tylko na poziomie strony | Tylko na poziomie strony | Tak (rozszerzenie) | Użytkownicy nietechniczni wyciągający widoczne dane |
Teraz szczegóły.
1. X (Twitter) Official API

Oficjalne API X to jedyne źródło pierwszej strony na tej liście i jedyna opcja z udokumentowanym pełnym archiwum wyszukiwania sięgającym marca 2006 roku. Jeśli priorytetem są zgodność i pochodzenie danych, to jest punkt wyjścia.
Jak to działa: bezpośrednie endpointy REST i streaming. Rejestrujesz aplikację, otrzymujesz klucze API, uwierzytelniasz się przez OAuth i odpytujesz endpointy dotyczące postów, użytkowników, polubień, list i innych danych.
Najważniejsze funkcje:
- Recent Search obejmuje ostatnie 7 dni (do 100 postów w odpowiedzi)
- Full-Archive Search sięga do marca 2006 (do 500 postów w odpowiedzi, pay-per-use i Enterprise)
- Filtered Stream dostarcza dopasowane publiczne posty niemal w czasie rzeczywistym (~6–7 sekund P99 latency)
- Pełne obiekty postów, profile użytkowników, metryki zaangażowania, endpointy zgodności
Cennik: X przeszło na kredyty przedpłacone bez abonamentu i bez minimalnego zobowiązania. Według stanu z sierpnia 2026: odczyt posta $0.005, odczyt użytkownika $0.010, odczyt polubienia $0.001. Konta self-service mają limit dwóch milionów odczytów postów miesięcznie. Ceny dla Enterprise są ustalane indywidualnie. Przed planowaniem budżetu sprawdź Developer Console, bo X zastrzega, że ceny mogą się zmieniać.
Uwaga: od migracji indeksu wyszukiwania X z 4 maja 2026 r. wyszukiwanie REST po słowach kluczowych nie zwraca już repostów. Filtered Stream nie został tym objęty. To zmienia skład zbioru danych w porównaniu ze starszymi poradnikami.
Najlepsze dla: deweloperów potrzebujących oficjalnych, odtwarzalnych surowych danych. Organizacji, dla których zgodność jest kluczowa. Każdego, kto potrzebuje pełnego archiwum historycznego.
Mniej odpowiednie dla: użytkowników nietechnicznych, zespołów z ograniczonym budżetem oraz każdego, kto potrzebuje danych masowych poza limitem self-service.
2. Bright Data

Bright Data oferuje zarówno zarządzane API do scrapingu X, jak i gotowe datasety. Przeanalizowane strony produktu pokazują aktualne opcje pozyskiwania i dostarczania danych, ale nie potwierdzają oficjalnego partnerstwa z X ani pełnego archiwum historycznego.
Najważniejsze funkcje:
- Profile, posty, URL-e i zadania discovery
- Zadania synchroniczne (do 20 URL-i) i asynchroniczne (do 5 000 URL-i)
- Wynik w JSON, NDJSON lub CSV przez API, webhook, cloud storage albo data warehouse
- 5 000 darmowych rekordów miesięcznie; PAYG $1.50 za 1 000 poprawnych rekordów; plan Scale za $499/mies. z 384 000 rekordów
Uwaga dotycząca zgodności: Bright Data publikuje mechanizmy zgodności i bezpieczeństwa, ale przeanalizowane strony nie deklarują oficjalnej autoryzacji ani partnerstwa z X. To zarządzany scraper publicznej sieci, a nie oficjalny reseller API. Narzędzia operacyjne ograniczają konieczność ręcznego utrzymania collectorów, ale nie zwalniają kupującego z obowiązków wynikających z warunków X, prawa prywatności ani ograniczeń użycia dalej w procesach.
Najlepsze dla: zespołów enterprise potrzebujących dużych, ciągłych pipeline’ów danych z X i gotowych zaakceptować model zgodności typowy dla zbierania opartego na scrapingu.
Dataset Bright Data vs. live scraping
Bright Data oferuje zarówno gotowy produkt datasetowy, jak i live scraping przez swoją infrastrukturę. Dataset sprawdza się w jednorazowych badaniach lub migawkach historycznych, a live scraping pasuje do ciągłego monitoringu. Wybór zależy od tego, czy potrzebujesz statycznego zbioru, czy stałego strumienia.
3. SocialData.tools

SocialData.tools reklamuje ponad 30 endpointów tylko do odczytu dla postów, profili, wyszukiwania, obserwujących, wzmianek, odpowiedzi, cytatów, wątków, list, Communities i Spaces. Typowa cena to $0.20 za 1 000 elementów, a niektóre specjalistyczne endpointy kosztują więcej.
Najważniejsze funkcje:
- API REST/JSON z obsługą serwera MCP
- Model pay-per-request, bez abonamentu
- Szeroki zakres typów danych z X
Zastrzeżenia (i są ważne): własne warunki SocialData.tools wprost opisują usługę jako scraping treści. Źródła danych są wskazywane jedynie jako „różne źródła”. Klient musi potwierdzić, że pobieranie jest dozwolone. Dostawca może zawiesić usługę, jeśli źródło docelowe zgłosi sprzeciw. Dokumentacja wyszukiwania przyznaje, że mogą występować braki i problemy z cursorami. Mimo języka „Try for Free” nie ma opublikowanego darmowego planu — jedynie ewentualne demo udostępniane przez support.
Najlepsze dla: deweloperów szukających tanich danych o postach i profilach, którzy po własnym due diligence akceptują ryzyko pochodzenia i zgodności.
4. Apify

Apify to platforma do scrapingu i automatyzacji, która hostuje tworzone przez społeczność „Actors” — gotowe scraper’y działające w chmurze. Na marketplace istnieje wiele niezależnych X Actors, każdy z inną ceną, jakością i harmonogramem utrzymania.
Najważniejsze funkcje:
- Platforma zaczyna się od $5 darmowego użycia miesięcznie, potem $29/$199/$999 miesięcznie
- Przykładowy Actor: xquik/x-tweet-scraper — od $0.00015 za dostarczony wiersz w planach płatnych; obsługuje posty, odpowiedzi, profile, wyszukiwanie, wątki, cytaty, retweeterów, media i filtry dat
- Integracja z Zapier, Make, webhookami
Krytyczne zastrzeżenie: warunki Apify mówią, że Community Actors nie są sprawdzane, weryfikowane, rekomendowane ani gwarantowane pod względem jakości, bezpieczeństwa, dokładności, zgodności prawnej czy utrzymania. W artykule trzeba nazwać konkretny Actor poddawany ocenie — „Apify kosztuje X” nic nie znaczy bez wskazania konkretnego Actora i jednostki rozliczeniowej.
Najlepsze dla: automatyzacji, jednorazowych projektów zbierania danych i deweloperów, którzy chcą przetestować kilka podejść do scrapingu na jednej platformie.
Jak wybrać właściwy Twitter Actor w Apify
Zanim się zdecydujesz, sprawdź datę ostatniej aktualizacji Actora, oceny użytkowników i status utrzymania. Niektóre Actors są opóźnione o tygodnie względem zmian w X i mogą zwracać nieaktualne lub uszkodzone wyniki. Odznaka aktywności marketplace pomaga w wstępnej ocenie, ale nie gwarantuje niezawodności.
5. Netrows

Netrows to nowsze API do wzbogacania danych publicznych B2B, oferujące endpointy X obok danych z LinkedIn. Lista obejmuje 26 typów endpointów X, w tym profile, obserwujących, posty, odpowiedzi, cytaty, wątki, wyszukiwanie, listy, Communities, trendy i Spaces.
Najważniejsze funkcje:
- €99/mies. za 10 tys. kredytów (50 req/min), €499 za 100 tys., €1 499 za 500 tys.
- Odpowiedzi na żywo, bez cache (deklaracja dostawcy)
- Publiczna strona statusu działała w momencie analizy; nie zweryfikowano publicznego SLA specyficznego dla X
Zastrzeżenia: dokładny koszt kredytowy za endpoint i schemat odpowiedzi wymagają klucza API, by to potwierdzić. Materiały Netrows mówią, że nie oferuje archiwum historycznego. Warunki opisują automatyczne pobieranie z publicznych źródeł, odcinają się od powiązań z X i przenoszą odpowiedzialność za warunki stron trzecich na użytkownika.
Najlepsze dla: prototypowania i zastosowań SMB, zwłaszcza zespołów, które potrzebują też danych z LinkedIn z tego samego API.
6. PhantomBuster

PhantomBuster to zasadniczo inne narzędzie niż powyższe API. To automatyzacja przeglądarki oparta na sesji, przeznaczona do prospectingu, a nie API danych ani licencjonowany strumień. Podkreślam to od razu.
PhantomBuster łączy się z sesją X użytkownika przez rozszerzenie przeglądarki i może eksportować widoczne wyniki wyszukiwania, dane profilu oraz informacje o obserwujących do CSV lub JSON. Może działać według harmonogramu albo w trybie watchera.
Najważniejsze funkcje:
- GUI no-code zaprojektowane dla zespołów sprzedaży i marketingu
- Roczne stawki efektywne: $56/mies. (Start), $128/mies. (Grow), $352/mies. (Scale)
- Skupienie na polach przydatnych w lead generation, nie na pełnych archiwach tweetów
Ważne ryzyko: dokumentacja PhantomBuster ostrzega, że przekroczenie limitów platformy może skutkować ostrzeżeniami, ograniczeniami, flagami albo banem. To automatyzacja działająca w sesji twojego konta X — nie autoryzowany feed danych. Używaj ostrożnie i miej świadomość ryzyka dla konta.
Najlepsze dla: małoskalowych procesów prospectingu sprzedażowego, w których trzeba tworzyć targetowane listy na podstawie profili i obserwujących z X.
7. Endpoints Twitter na RapidAPI

RapidAPI to marketplace hostujący dziesiątki endpointów X od niezależnych twórców. To nie jeden dostawca — to bazar.
Przykładowa oferta: datahungrybeast/twitter154 („The Old Bird”) — darmowy plan Basic z 200 requestami, $9.99 za 10 tys., $49.99 za 100 tys., $299.99 za 1 mln. Oferuje endpointy użytkowników, obserwujących, postów, odpowiedzi, wyszukiwania i list.
Najważniejsze funkcje:
- Ujednolicony interfejs REST dla wielu zewnętrznych API
- Na części ofert dostępne darmowe plany
- Szybki sposób testowania wielu podejść
Ryzyko jest realne: ta oferta nie miała strony produktu, nie miała regulaminu specyficznego dla API, nie miała autoryzacji X, gwarancji archiwum, SLA dla czasu rzeczywistego ani procesu zgodności z usuwaniem danych. Własna dokumentacja RapidAPI potwierdza, że wydawcy kontrolują swoje oferty, ceny, wersje i endpointy. Wiele ofert jest porzuconych albo uszkodzonych.
Jak unikać martwych endpointów na RapidAPI
Sprawdzaj statystyki czasu odpowiedzi, oceny użytkowników, datę ostatniej aktualizacji i zawsze testuj darmowy plan, zanim wejdziesz w płatny. Duża liczba subskrybentów nie oznacza SLA.
Najlepsze dla: szybkich testów API i prototypowania. Nie jest to zalecane jako produkcyjne źródło danych bez dokładnej analizy pochodzenia i aspektów prawnych.
8. Phyllo

Phyllo oferuje ujednolicone API danych publicznych i autoryzowanych z wielu sieci społecznościowych, w tym X. Opisuje wzmianki o słowach kluczowych i konkurencji, strukturalne pobieranie postów, analitykę twórców, zadania asynchroniczne, polling oraz alerty webhook.
Najważniejsze funkcje:
- Infrastruktura API cross-platform (X, Instagram, YouTube, TikTok itd.)
- Model oparty na zgodzie użytkownika dla danych przypisanych do twórców
- Obsługa webhooków i deklaracje działania w czasie rzeczywistym
Zastrzeżenia: przeanalizowane strony pierwszej strony nie publikują dla X SLA dotyczącego opóźnień, procentu kompletności, daty rozpoczęcia historii, deklaracji pełnego firehose ani nazwanego partnerstwa z X. Cennik jest indywidualny (trzeba skontaktować się ze sprzedażą).
Najlepsze dla: deweloperów budujących produkty dla twórców, influencerów lub rozwiązania cross-platform, którzy potrzebują ujednoliconej warstwy API — po bezpośrednim sprawdzeniu szczegółów pokrycia X z Phyllo.
9. Brandwatch

Brandwatch nazywa siebie Official X Partner. Produkt Consumer Research reklamuje pełny firehose X i publiczne posty historyczne; Listen reklamuje pełny dostęp do firehose oraz dwanaście miesięcy historii X.
Najważniejsze funkcje:
- Głęboki archiwum historyczne (jedno z najgłębszych dostępnych komercyjnie)
- Analiza sentymentu, trendów, pulpity analityczne do inteligencji konkurencyjnej
- Dokumentacja zgodności klasy enterprise, gotowość pod GDPR
Haczyk przy eksporcie: dokumentacja developerska Brandwatch mówi, że tekst postów X i większość metadanych jest usuwana z odpowiedzi API ze względów zgodności. Aby uzyskać pełną treść postów, może być konieczne użycie identyfikatorów postów i ich ponowne „rehydratowanie” przez API X. To bardzo ważna różnica między dostępem w dashboardzie a nieograniczonym eksportem surowych danych.
Cennik: indywidualna wycena. Na przeanalizowanej stronie planów Brandwatch nie podano aktualnej ceny liczbowej.
Najlepsze dla: globalnych marek, zespołów badawczych i operacji monitorowania kryzysów, które potrzebują głębokich archiwów X i analityki enterprise.
10. Meltwater

Meltwater łączy social listening z newsami i media intelligence. Prezentacja produktu potwierdza piętnaście miesięcy natychmiastowych danych historycznych social, w tym X, a także alerty w czasie rzeczywistym, wyszukiwanie boolowskie, dashboardy, analitykę konkurencji i raportowanie.
Najważniejsze funkcje:
- Połączenie newsów, PR i social intelligence w jednej platformie
- Alerty i dashboardy w czasie rzeczywistym
- Eksporty oraz API Analytics/Streaming (zależnie od pakietu)
Zastrzeżenia: nie ustalono pełnego archiwum X ani SLA opóźnień specyficznego dla X. Zakres danych może zależeć od pakietu i regionu. Dziennik zmian deweloperskich Meltwater dokumentuje redakcję pól X/Twitter ze względów zgodności. Meltwater deklaruje się jako pełnoprawny partner enterprise X, ale niezależnej, aktualnej certyfikacji w katalogu należącym do X nie potwierdzono w tym badaniu.
Cennik: indywidualna wycena, umowy roczne.
Najlepsze dla: zespołów PR i komunikacji, które chcą mieć dane z X obok monitoringu newsów, media intelligence i cross-channel social analytics.
11. Sprout Social

Sprout Social to przede wszystkim platforma do zarządzania mediami społecznościowymi — publikacja, engagement, obsługa klientów, akceptacje, własna analityka i raportowanie. Płatny dodatek Social Listening może monitorować publiczne posty, odpowiedzi, wzmianki, cytowane reposty i reposty w X.
Najważniejsze funkcje:
- Plany podstawowe: $199/$299/$399 za konto miesięcznie (rozliczane rocznie); Listening to dodatkowo płatny add-on
- Oparte na dashboardzie, zaprojektowane dla social media managerów
- Własna strona biznesowa X opisuje Sprout jako oficjalnego partnera X
Problem próbkowania: centrum pomocy Sprout wprost podaje, że X Listening korzysta z danych próbkowanych, a nie z pełnego firehose. Automatyczny backfill obejmuje 30 dni lub ostatnie 200 000 wiadomości. Public API Sprout wspiera analitykę własnych profili, ale dane tematów z X Listening nie są obecnie dostępne przez to API.
Najlepsze dla: zespołów social media, które już używają Sprout do publikacji i zarządzania społecznością i chcą mieć orientacyjną analitykę X w tym samym dashboardzie. Nie jest to najlepszy wybór, jeśli twoim głównym celem jest masowe pobieranie surowych danych X.
12. Thunderbit

Thunderbit to narzędzie AI do scrapingu i automatyzacji dostępne jako rozszerzenie do przeglądarki Chrome, stworzone dla użytkowników biznesowych, którzy chcą uporządkować dozwolone dane webowe bez pisania kodu.
Jak opisać je tutaj: Thunderbit może proponować pola, przechodzić przez zgodną paginację lub podstrony, dodawać wzbogacanie oparte na promptach i eksportować do Excel, CSV, Google Sheets, Airtable lub Notion. To ogólne możliwości pracy z danymi webowymi. Nie oznaczają one autoryzowanego feedu z X, pełnego pokrycia X ani pozwolenia na automatyzację X.
Najważniejsze funkcje:
- No-code proponowanie pól i uporządkowany eksport
- Wykrywanie pól wspierane przez AI dostosowuje się do zmian układu strony
- Plany i limity użycia należy sprawdzić na thunderbit.com/pricing
- Odpowiednie tylko dla zgodnych stron i zastosowań, w których użytkownik ma zgodę na automatyzację
Czym Thunderbit nie jest: nie jest oficjalnym dostawcą danych X, masowym API X, zamiennikiem firehose ani gotowym datasetem X. Obecne warunki X zabraniają scrapingu przez przeglądarkę bez wcześniejszej pisemnej zgody. W przypadku danych z X zacznij od oficjalnego API, udokumentowanego autoryzowanego dostawcy albo własnego archiwum konta. Thunderbit wykorzystuj do zgodnych i dozwolonych procesów web-data — nie jako obejście dostępu do API X lub jego cennika.
Więcej o tym, jak w praktyce działa ekstrakcja danych z internetu, znajdziesz na naszym blogu: czym jest web scraping, jak robić to bez kodowania oraz praktyczne podejścia do zbierania danych z Twittera.
Jaki dostawca danych z Twittera pasuje do twojego budżetu i zastosowania?
Nie ma jednego zwycięzcy dla wszystkich. Oto ramy decyzyjne uporządkowane według zastosowania i poziomu budżetu:
| Zastosowanie | Wariant budżetowy | Wariant średni | Wariant enterprise |
|---|---|---|---|
| Badania akademickie / archiwizacja | X Official API (pay-per-use) + twarc | Licencjonowany partner danych | X Enterprise / kontraktowy licencjonowany partner |
| Monitoring marki / sentyment | Oficjalne API z ograniczonym zapytaniem | Sprout Social (próbkowany dodatek Listening) | Brandwatch lub Meltwater po analizie umowy |
| Lead gen / prospecting sprzedażowy | Badania oparte na zgodzie / ręczne | Dozwolona automatyzacja po analizie polityk | Autoryzowany dostawca + kontrolowany pipeline CRM |
| Szybka jednorazowa ekstrakcja (bez kodu) | Archiwum konta lub autoryzowany eksport | Dozwolony workflow na zgodnej stronie | Dashboard enterprise / eksport |
| Analityka influencerów / twórców | Phyllo (po weryfikacji pokrycia X) | Phyllo | Brandwatch |
| Pipeline NLP / data science | X Official API (pay-per-use) | Autoryzowany dostawca z prawem eksportu | X Enterprise / licencjonowany feed |
Kilka wzorców od razu się wyróżnia:
- Jeśli zgodność i pochodzenie danych są niepodlegające negocjacjom, X Official API jest twoją bazą odniesienia. Wszystko inne wiąże się z jakimś kompromisem.
- Jeśli potrzebujesz głębokich archiwów historycznych i enterprise dashboardów, Brandwatch i Meltwater to najbardziej ugruntowani gracze — ale licz się z indywidualnymi kontraktami i redagowanym eksportem.
- Jeśli jesteś użytkownikiem nietechnicznym, wybieraj autoryzowane źródło z eksportem do CSV lub Sheets. Automatyzację przeglądarkową stosuj tylko na zgodnych stronach, gdzie zgoda jest jasna; to nie jest zamiennik produkcyjnego pipeline’u danych.
Krótka uwaga o zgodności: ToS, GDPR i co warto zapytać prawników
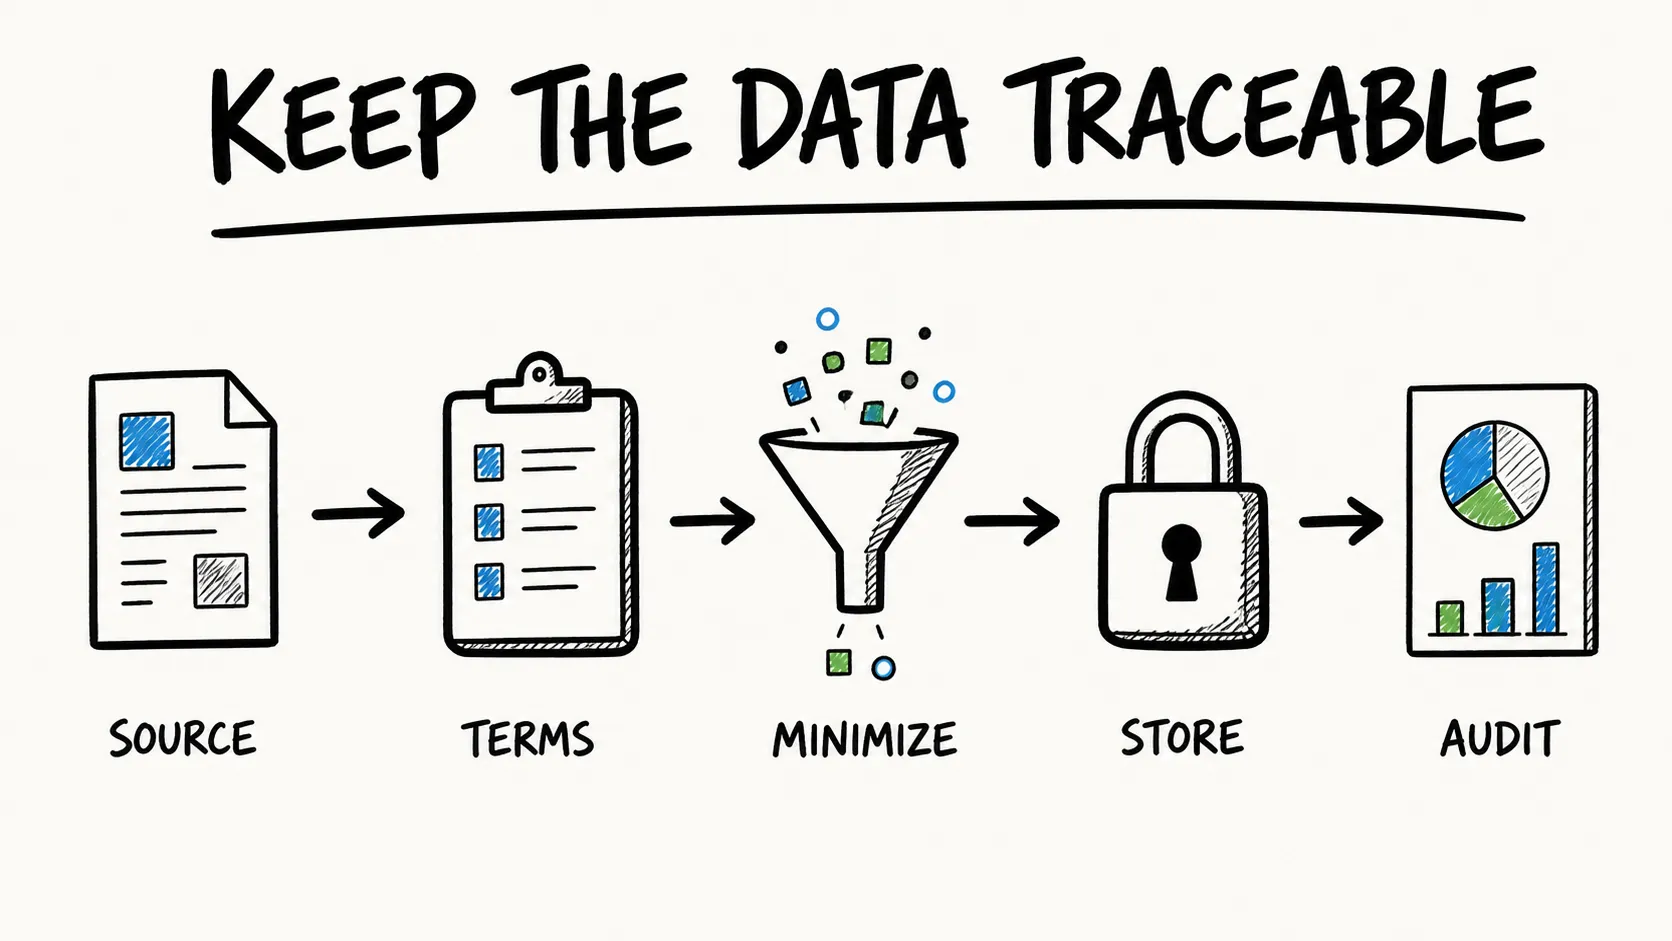
Ta sekcja ma charakter operacyjny, nie stanowi porady prawnej.
Warunki korzystania z X zabraniają crawlowania, scrapingu i skryptowania strony bez wcześniejszej pisemnej zgody. Polityka dla deweloperów dodaje wymagania dotyczące prywatności, przejrzystości, kontroli użytkownika, zgodności z usuwaniem danych oraz ograniczeń dotyczących wnioskowania o danych wrażliwych, dopasowywania, redystrybucji i trenowania modeli. Sama dostępność techniczna nie oznacza zgody.
GDPR, CCPA i inne przepisy o ochronie prywatności mogą mieć zastosowanie przy zbieraniu handle’i, lokalizacji, bio profilu czy tekstów postów. Publiczna widoczność sama w sobie nie przesądza o autoryzacji platformy, prywatności, kontrakcie, prawach autorskich, prawie dostępu do systemu ani o prawach do dalszego wykorzystania. Stosuj minimalizację danych i kontrolę retencji oraz skonsultuj konkretną jurysdykcję i zastosowanie z działem prawnym.
Trzy praktyczne zasady:
- Ogranicz się do danych publicznych, które masz uzasadniony powód zbierać.
- Nie przechowuj nadmiarowo — ustaw limity retencji i respektuj prośby o usunięcie.
- Zanim zbudujesz coś na dużą skalę, skonsultuj to z prawnikami.
Pytania do każdego dostawcy: Czy jesteście oficjalnym partnerem X? Jakie dokładnie metody zasilają produkt? Jak obsługiwane są usunięte posty i konta chronione? Czy można przechowywać pełny tekst, czy tylko identyfikatory i agregaty?
Podsumowanie
Stary model darmowego dostępu już nie istnieje. Te dwanaście pozycji obejmuje oficjalne API, zarządzane usługi public-web, enterprise suite do social listeningu, marketplace’y i narzędzia no-code; nie oferują one jednak tej samej autoryzacji, kompletności ani poziomu ryzyka.
Właściwy wybór zależy od zadania. Jeśli potrzebujesz surowych, odtwarzalnych danych z pierwszej strony źródła, zacznij od API X. Jeśli potrzebujesz enterprise dashboardów i kontrolowanego listeningu, porównaj Brandwatch, Meltwater lub Sprout pod kątem umowy i wymagań eksportowych. Niezależnych collectorów i oferty z marketplace traktuj jako opcje wyższego ryzyka, wymagające testów na żywo, ujawnienia metody pozyskania danych i analizy prawnej. Thunderbit używaj do zgodnych i dozwolonych workflow danych webowych — nie jako feedu z X.
Krajobraz danych X nadal się zmienia. Sprawdzaj ceny na żywo, czytaj odpowiednie warunki, dokumentuj źródło danych i zapytanie oraz poproś o ocenę dział prawny i bezpieczeństwa, zanim zbudujesz proces o dużym wolumenie lub wysokiej wrażliwości.
Dowiedz się więcej:
- Jak analizować sentyment na Twitterze, by podejmować lepsze decyzje
- Jak opanować zbieranie danych z Twittera z użyciem Thunderbit
- Czym jest narzędzie do scrapingu social media i jak działa?
- Czy web scraping jest nielegalny? Zrozumienie konsekwencji prawnych
- Web scraping bez kodowania
FAQ
1. Co stało się z darmowym dostępem do API Twittera?
X zlikwidowało darmowy poziom odczytu na początku 2023 roku. Aktualny model to kredyty przedpłacone, rozliczane za użycie — standardowy odczyt posta kosztuje $0.005, a konta self-service mają limit dwóch milionów odczytów postów miesięcznie. Zakończono też ścieżkę Academic Research, przez co badacze stracili darmowy dostęp masowy, z którego wcześniej korzystali.
2. Jak zewnętrzni dostawcy danych z Twittera pozyskują dane?
Można ich podzielić mniej więcej na trzy grupy: (1) oficjalne wrappery API, które korzystają z twojego własnego klucza API X i podlegają limitom X; (2) API oparte na scrapingu, które zbierają dane przez automatyczne przeglądarki lub reverse-engineered endpointy — tańsze, ale obarczone ryzykiem ToS i ciągłości działania; oraz (3) licencjonowane platformy social listening, takie jak Brandwatch i Meltwater, które mają enterprise agreement z X. Narzędzia przeglądarkowe, takie jak Thunderbit, tworzą czwartą kategorię — wyciągają to, co widoczne na stronie w twojej własnej sesji przeglądarki.
3. Który dostawca danych z Twittera jest najtańszy na start?
Według stanu na sierpień 2026 X Official API podawało $0.005 za standardowy odczyt posta bez minimalnego zobowiązania. Bright Data reklamowało 5 000 darmowych rekordów miesięcznie, Apify obejmowało $5 miesięcznego użycia platformy, konkretna oferta RapidAPI dawała 200 darmowych requestów, a SocialData.tools zwykle liczyło około $0.20 za 1 000 elementów. Te jednostki nie są równoważne, a najtańsza autoryzowana i kompletna opcja dla jednego zastosowania może różnić się od najtańszego pojedynczego żądania. Przed zakupem sprawdź każdą aktualną cenę.
4. Czy mogę pobrać historyczne tweety bez płacenia za X Enterprise API?
Tak. Full-Archive Search w X Official API sięga do marca 2006 roku w modelu pay-per-use i w Enterprise, więc Enterprise nie jest jedyną oficjalną drogą. Brandwatch reklamuje głębokie badania historyczne, przy czym dostęp zależy od produktu i pakietu. Niezależni collectorzy mogą udostępniać okna dat lub datasety utrzymywane przez dostawcę, ale ich zasięg i kompletność nie są równoważne z udokumentowanym pełnym archiwum X.
5. Czy istnieje no-code sposób na pobieranie danych z Twittera?
Tak. Sprout Social i Brandwatch oferują workflow oparte na dashboardach bez kodowania, a autoryzowani dostawcy mogą zapewniać eksport do CSV lub arkuszy. Thunderbit potrafi uporządkować dane na zgodnych stronach, jeśli masz zgodę na automatyzację; nie jest to oficjalny feed X. PhantomBuster oferuje automatyzację opartą na sesji, ale dokumentuje ryzyko dla konta i limitów. Zanim wybierzesz jakąkolwiek ścieżkę no-code, potwierdź zakres danych, autoryzację, próbkowanie i prawa eksportu.



