
W jakiejś redakcji co kilka sekund wpada nowy artykuł, konkurent wrzuca komunikat prasowy o północy, a dokument urzędowy, który naprawdę musisz zobaczyć, właśnie spadł na czwartą stronę serwisu agencji stanowej. Nikt nie ma czasu pilnować tylu kart w przeglądarce. Właśnie dlatego „news scraper” stał się realną kategorią produktu — i właśnie dlatego większość poradników zakupowych na ten temat niewiele pomaga.
Problem, na który trafiałem podczas researchu, jest prosty: większość zestawień typu „najlepszy news scraper” wybiera jedną ścieżkę i trzyma się jej do końca. Jeden artykuł ocenia wyłącznie narzędzia SaaS bez kodu. Inny opisuje tylko biblioteki Pythona, jakby każdy na świecie umiał napisać spidera w Scrapy. Żadna z tych opcji nie pomaga komuś, kto próbuje ustalić, czy potrzebuje rozszerzenia do przeglądarki, klucza API, czy weekendu z pip install. Dlatego ta lista dzieli wszystkie dziesięć narzędzi na trzy grupy — no-code/agentowe, zarządzane API oraz biblioteki do kodowania — i pozwala wybrać rozwiązanie zgodnie z realnym poziomem umiejętności oraz liczbą źródeł do monitorowania, a nie według tego, kto zapłacił za pierwsze miejsce.
Co wyróżnia najlepszy news scraper w 2026 roku?
W praktyce liczy się tu sześć rzeczy i właśnie nimi kieruję się przy każdej pozycji poniżej:
- Dopasowanie do kategorii — czy to narzędzie point-and-click, zarządzane API, które ogarnia infrastrukturę, czy biblioteka, na której sam budujesz rozwiązanie?
- Łatwość użycia dla osób nietechnicznych — to temat, który stale wraca w wątkach pytających o „web data scraper, z którego może korzystać osoba nietechniczna”, i wcale nie jest niszowy.
- Skalowalność — czy poradzi sobie z 20, 100 albo 1 000 źródeł newsowych bez ręcznego przepisywania reguł dla każdego z nich?
- Rzetelna obsługa anty-botów i renderowania JS — nie marketingowe „gwarantowane obejście”, tylko to, co naprawdę się dzieje, gdy serwis rzuci JavaScript, CAPTCHA albo paywall.
- Model cenowy — subskrypcja, kredyty czy opłata za każde żądanie oraz czy ekonomia jednostkowa ma sens przy wolumenie newsowym.
- Opcje eksportu — CSV, JSON, Sheets, Airtable, webhook — cokolwiek, co dostarczy dane tam, gdzie trzeba.
Jeśli narzędzie nie spełnia większości tych kryteriów w kontekście monitorowania wiadomości, nie ma znaczenia, jak ładnie wygląda jego liczba gwiazdek na GitHubie.
No-code, API czy kod: który wariant news scrapera pasuje do Ciebie?
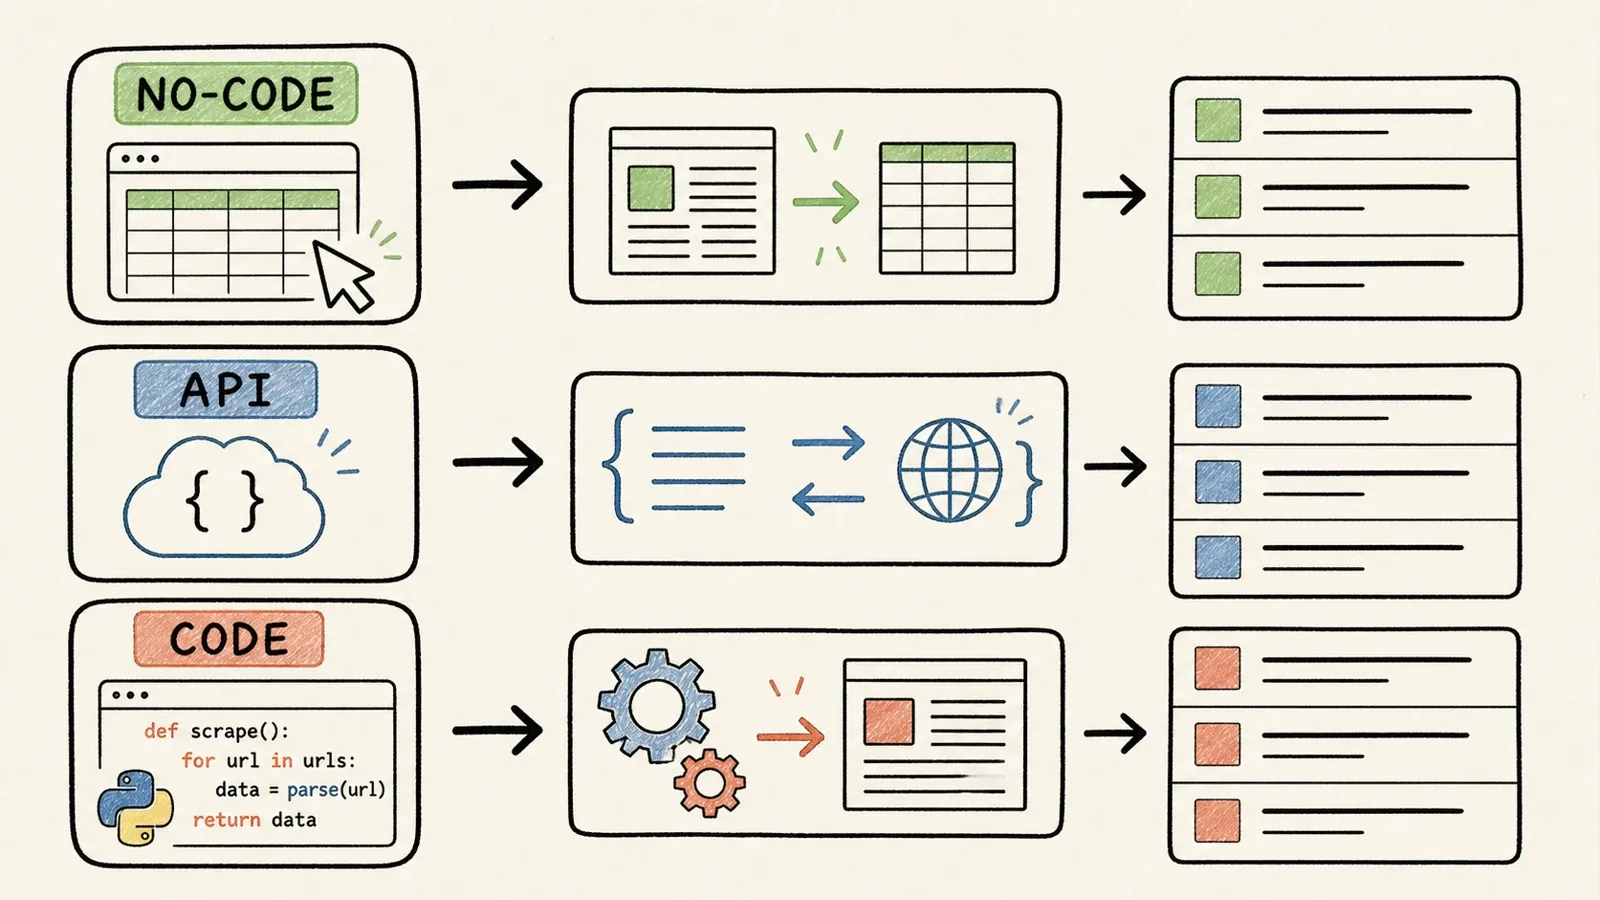
Większość list „top 10” wrzuca te trzy kategorie do jednego worka, jakby konkurowały o to samo stanowisko. Nie konkurują.
Narzędzia no-code/agentowe są dla użytkowników biznesowych — sprzedaży, operacji, researchu, marketingu — którzy potrzebują tabeli z nagłówkami i linkami bez dotykania kodu. Zarządzane API są dla deweloperów, którzy nie chcą samodzielnie utrzymywać proxy ani headless browserów; wysyłają adres URL, dostają HTML albo JSON i budują resztę pipeline’u na tym. Biblioteki i frameworki do kodowania są dla inżynierów, którzy chcą pełnej kontroli nad crawlingiem, parsowaniem, ponawianiem prób i wszystkim innym — kosztem przejęcia całej odpowiedzialności za utrzymanie.
Thunderbit jest dobrym przykładem tego, jak w praktyce wygląda ścieżka no-code. Rozszerzenie Chrome Thunderbit działa w oparciu o przepływ nazwany One Click Extract — klikasz, narzędzie czyta stronę i rozpoznaje, co się na niej znajduje, a potem pokazuje Run Now. Jeśli klikniesz, ekstrakcja startuje od razu. Jeśli nic nie zrobisz, uruchomi się sama po chwili. Nie trzeba pisać selektorów ani najpierw definiować schematu. To bezpośrednia odpowiedź na zarzut o „scraper dla osób nietechnicznych”, który ciągle przewija się na forach — choć, jak w przypadku każdego narzędzia z tej listy, działa ono wyłącznie na stronach, do których masz uprawniony dostęp, i nie służy do obchodzenia paywalla.
Szersze spojrzenie na rozwój tej kategorii znajdziesz w naszym własnym omówieniu AI web scrapingu oraz w wyjaśnieniu, co tak naprawdę oznacza „no-code”, gdy scraper tak się reklamuje.
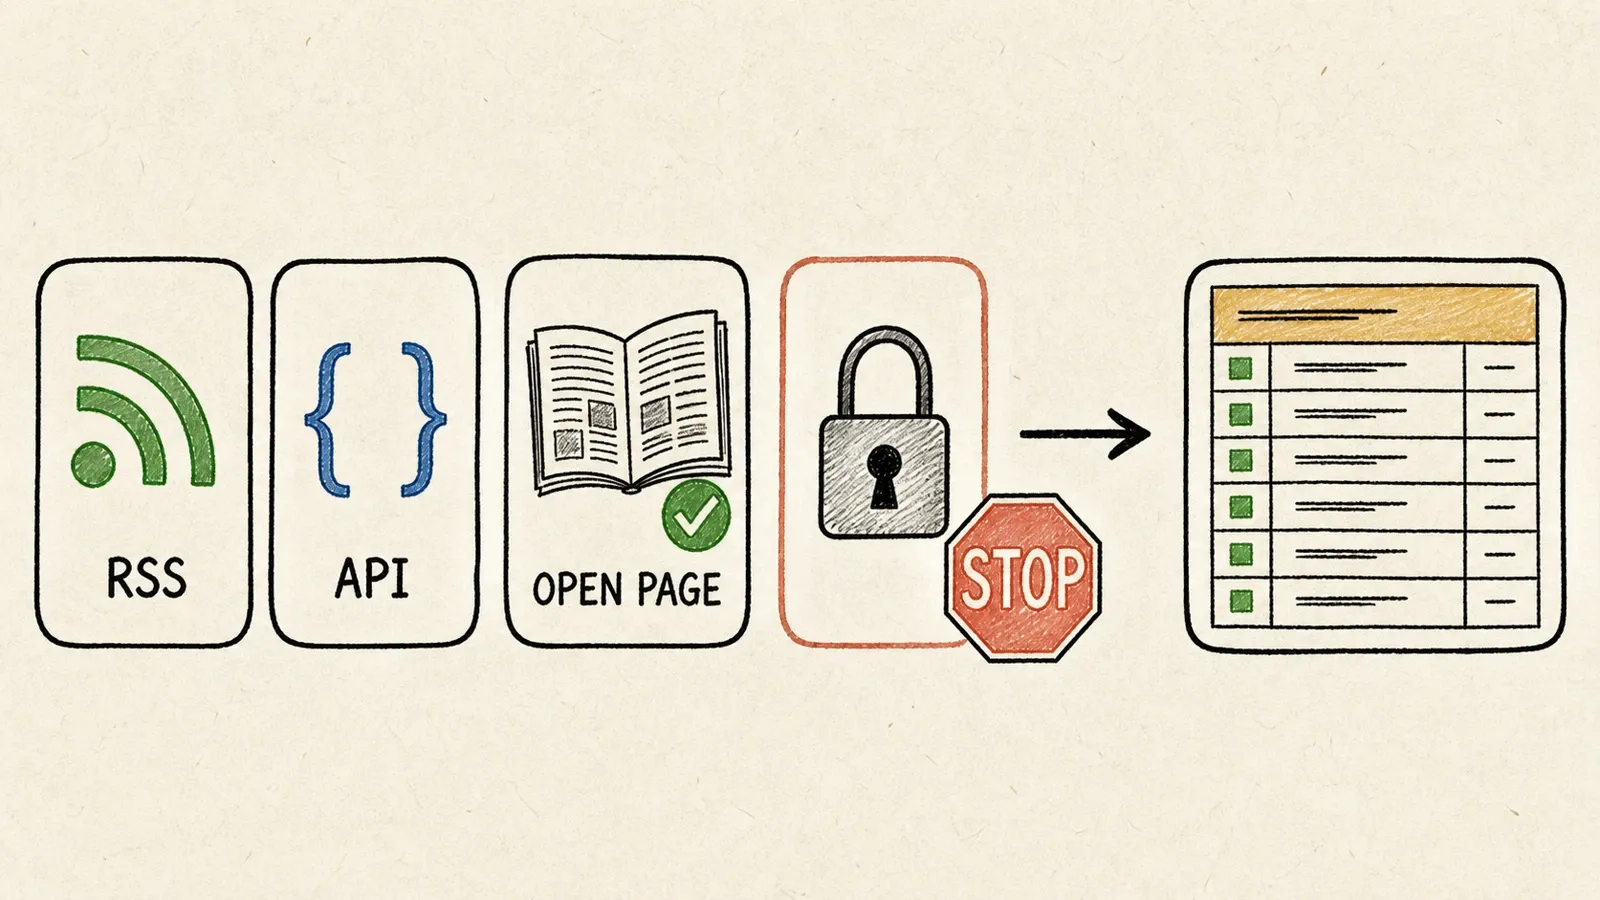
Zanim zaczniesz: sprawdź, czy istnieje RSS albo News API
Zanim cokolwiek zbudujesz albo za coś zapłacisz, sprawdź, czy wydawca nie udostępnia danych za darmo. Brzmi oczywiście. Ludzie jednak nagminnie to pomijają.
Większość serwisów newsowych nadal obsługuje kanały RSS lub Atom, które można wykryć przez standardowe znaczniki <link rel="alternate"> opisane w specyfikacji HTML WHATWG — a sama specyfikacja RSS 2.0 jest już na tyle stara, że w większości krajów byłaby pełnoletnia. sitemap.xml wydawcy, zgodny z protokołem Sitemaps, również może dać Ci uporządkowaną listę adresów artykułów bez klikania po menu.
Poza pojedynczymi wydawcami istnieje też kilka opcji agregujących:
- NewsAPI — komercyjne API do agregacji newsów z darmowym planem deweloperskim i płatnymi planami produkcyjnymi; sprawdź warunki, zanim oprzesz na darmowym planie coś poważnego.
- GDELT — ogromny, darmowy, pierwszorzędowy globalny zbiór danych o newsach i wydarzeniach z API DOC 2.0. To naprawdę przydatne narzędzie do odkrywania treści i analizy trendów, choć sam projekt publikuje wytyczne dotyczące limitów zapytań, więc nie traktuj go jak nieskończonego hydrantu.
Scraping nadal jest dobrym wyborem wtedy, gdy źródło nie ma feedu, feed nie zawiera potrzebnych pól (na przykład pełnej treści), albo gdy monitorujesz tak wiele serwisów, że potrzebujesz jednego wspólnego pipeline’u zamiast dziesięciu różnych formatów. Tylko sprawdź to najpierw. To najtańsze dziesięć minut, jakie poświęcisz całemu projektowi.
Najlepsze news scrapery w skrócie
Jednostki cenowe tutaj nie są porównywalne 1:1 — kredyty, „udane żądania”, jednostki obliczeniowe i stałe subskrypcje oznaczają coś innego. Przed rezerwacją budżetu sprawdź aktualne stawki.
| Narzędzie | Kategoria | Najlepsze do | Obsługa JS / anty-bot | Wymagany kod | Model cenowy |
|---|---|---|---|---|---|
| Thunderbit | No-code / agentowe | Osoby nietechniczne potrzebujące szybkiej ekstrakcji z otwartych stron newsowych | Obsługiwane na zgodnych, autoryzowanych stronach; bez gwarancji przy trudnych paywallach | Brak | Darmowy plan + płatne plany oparte na kredytach, zobacz aktualny cennik |
| Octoparse | Wizualny scraper no-code | Przepływy point-and-click z szablonami | Wbudowana przeglądarka, ręczna konfiguracja AJAX | Brak / niski | Darmowy plan + poziomy subskrypcji |
| Apify | Platforma Actorów | Deweloperzy chcący gotowych i własnych scraperów na dużą skalę | Zależne od Actora (różnie w zależności od Actora) | Niski / średni | Darmowy kredyt startowy + poziomy subskrypcji |
| Bright Data | Managed API / proxy | Scraping na poziomie enterprise w wielu regionach | Web Unlocker + osobne Browser API | Średni | Pay-as-you-go + progi wolumenowe |
| ScraperAPI | Managed API | Proste wywołania API do HTML / renderowania JS | Opcjonalne renderowanie, rotacja proxy | Niski (wywołanie API) | Poziomy subskrypcji oparte na kredytach |
| Oxylabs | Managed API / proxy | Duże wolumeny i potrzeby enterprise w zakresie proxy | Renderowanie + instrukcje przeglądarki | Średni | Cennik oparty na wyniku |
| Crawlbase | Managed API | Serwisy z ciężkim JS, ekstrakcja ukierunkowana na artykuły | Renderowanie JS tokenem + proxy | Niski (wywołanie API) | Darmowy limit + dynamiczne ceny zależne od domeny |
| Scrapy | Framework do kodowania | Własne crawlery Python o wysokim poziomie kontroli | Ręcznie (wymaga middleware / integracji z przeglądarką) | Wysoki | Darmowe, open source |
| Beautiful Soup | Biblioteka do kodowania | Lekkie parsowanie HTML dla statycznych stron | Brak (w połączeniu z Requests) | Wysoki | Darmowe, open source |
| Selenium | Biblioteka do automatyzacji przeglądarki | Strony renderowane przez JS lub wymagające logowania | Realne uruchomienie przeglądarki; bez obejścia CAPTCHA | Wysoki | Darmowe, open source |
1. Thunderbit: najlepszy no-code news scraper dla osób nietechnicznych

Thunderbit to oparte na przeglądarce, agentowe narzędzie do ekstrakcji, stworzone z myślą o użytkownikach biznesowych — zespołach sprzedaży, researchu i operacji — a nie o deweloperach szukających własnego pipeline’u. Przepływ jest celowo prosty: kliknij One Click Extract, pozwól narzędziu odczytać stronę, a potem naciśnij Run Now (albo nic nie rób — i tak uruchomi się samo po kilku sekundach).
Najważniejsze funkcje:
- Bez selektorów, schematów i mapowania pól przed uruchomieniem ekstrakcji
- Obsługa paginacji i wzbogacania danych z podstron na zgodnych stronach, przydatna przy schemacie „strona kategorii → artykuł”
- Eksport do Excela, Google Sheets, Airtable lub Notion
- Osobne Open API dla zespołów, które później wyrosną z workflow przeglądarkowego
Cennik obejmuje darmowy plan oraz płatne plany kredytowe — sprawdź aktualną stronę z cenami, bo limity kredytów i liczba stron zmieniają się z czasem. Osobne API ma własny model cenowy, więc nie zakładaj, że kredyty z rozszerzenia i jednostki API są wymienne.
Najlepsze dla: badacza albo analityka, który dziś potrzebuje czystej tabeli z danymi newsowymi, a nie zarządzanego pipeline’u ingestującego za sześć tygodni.
Zalety i wady
Zalety: brak konieczności kodowania, szybka konfiguracja, elastyczne dopasowanie do układu strony bez ręcznego przepisywania selektorów, eksport bezpośrednio do narzędzi, z których zespoły już korzystają.
Wady: nie jest to narzędzie dla deweloperów, którzy chcą granularnej kontroli nad żądaniami albo własnej logiki crawl. Jak każde narzędzie z tej listy, zatrzyma się na trudnych paywallach i stronach chronionych CAPTCHA — nie ma tu magicznego obejścia i nie powinno go być. Dla zespołów, które porównują to z w pełni ręcznymi rozwiązaniami, nasz materiał o web scrapingu bez kodowania omawia te kompromisy szerzej.
2. Octoparse: najlepszy wizualny news scraper point-and-click

Octoparse daje osobom bez znajomości kodu wizualne płótno do budowania workflowów scrapingowych — kliknięcia, pętle, reguły paginacji i warunki oczekiwania — wewnątrz wbudowanej przeglądarki. Pod względem kontroli ręcznej jest o stopień bardziej zaawansowany niż narzędzia agentowe, ale pod względem złożoności pozostaje wyraźnie prostszy niż frameworki kodowe.
Najważniejsze funkcje:
- Wbudowana przeglądarka uruchamia JavaScript i obsługuje treści ładowane przez AJAX, choć czas oczekiwania często wymaga ręcznej konfiguracji
- Biblioteka szablonów zawierająca kategorię News & Media oraz dedykowany szablon CNN
- Uruchomienia lokalne do testów oraz harmonogramowanie w chmurze dla zadań cyklicznych
- Darmowy plan obsługuje lokalne użycie z limitem do 50 000 wyeksportowanych wierszy miesięcznie w kwalifikujących się zadaniach niestandardowych
Komplikacją jest utrzymanie: ponieważ workflowy zapisują konkretne kliknięcia i selektory, zmiana wyglądu serwisu przez wydawcę może zepsuć pętlę albo pole tak samo, jak zrobiłaby to ręcznie napisana reguła w Scrapy. Cennik obejmuje darmowy plan lokalny, Standard za 83 USD/miesiąc (lub 69 USD/miesiąc przy rozliczeniu rocznym) z trzema równoległymi procesami w chmurze oraz Pro za 299 USD/miesiąc (lub 249 USD/miesiąc rocznie) z 20 równoległymi procesami w chmurze.
Najlepsze dla: osób nietechnicznych, które chcą bardziej świadomej kontroli nad interakcją ze stroną niż daje w pełni automatyczne narzędzie, i nie przeszkadza im okazjonalne utrzymywanie szablonów.
3. Apify: najlepsza platforma oparta na Actorach dla deweloperów

Apify działa w oparciu o to, co nazywa Actorami — spakowanymi, hostowanymi programami do scrapingu z określonym wejściem i wyjściem. Część z nich utrzymuje samo Apify, część pochodzi od społeczności, a własne Actor’y możesz też tworzyć samodzielnie. To sprawia, że produkt jest mniej pojedynczym narzędziem, a bardziej marketplace’em — co ma zarówno plusy, jak i minusy.
Najważniejsze funkcje:
- Utrzymywany Website Content Crawler generuje czysty tekst / Markdown odpowiedni do wyszukiwania lub pipeline’ów LLM
- Istnieją społecznościowe Actor’y do Google News, przydatne do discovery, ale ich niezawodność i ceny zależą od autora — przed wdrożeniem sprawdź konkretny Actor
- Harmonogramy, webhooki i wyzwalacze API dla zadań cyklicznych
- Eksport datasetów do JSON, CSV, XML, Excel, HTML, RSS i JSONL
Pricing zaczyna się od darmowego planu z 5 USD miesięcznego limitu użycia, potem Starter za 29 USD/miesiąc, Scale za 199 USD i Business za 999 USD — do tego dochodzą koszty obliczeniowe zależne od użycia i od konkretnego Actora. Łączny koszt mocno zależy od tego, z jakich Actorów korzystasz i czy działają pod spodem na pełnej przeglądarce.
Najlepsze dla: zespołów technicznych, które wolą oceniać i wymieniać komponenty niż kupować jeden z góry ustalony endpoint.
4. Bright Data: najlepsza enterprise’owa infrastruktura proxy do news scrapingu
Bright Data lepiej rozumieć jako stos narzędzi niż pojedynczy produkt. Zbiory danych do discovery obsługują wyszukiwanie, Web Unlocker obsługuje pobieranie publicznych stron wraz z routingiem i zarządzaniem dostępem, a Browser API zapewnia zdalną przeglądarkę dla stron mocno opartych na JavaScript. Nie ma jednego uniwersalnego „News Scraper API” — łączysz ze sobą kilka elementów.
Najważniejsze funkcje:
- Szerokie targetowanie geograficzne, przydatne do uzyskiwania dostępu do regionalnych wydań
- Osobne produkty do pobierania i pełnej przeglądarki, dzięki czemu zespoły mogą zwiększać koszty tylko tam, gdzie to konieczne
- Dostarczanie przez API i webhooki do integracji z pipeline’em
Cennik Web Unlocker obejmuje 5 000 darmowych requestów miesięcznie, a potem model pay-as-you-go za 1,50 USD za 1 000 udanych requestów (plan za 499 USD/miesiąc obniża to do 1,30 USD/1 000 z 383 000 w pakiecie). Browser API rozliczane jest według transferu — od 8 USD/GB w modelu pay-as-you-go. Warto pamiętać: własne warunki Bright Data definiują „successful” na podstawie statusu odpowiedzi, a nie poprawności artykułu, więc budżet planuj odpowiednio.
Najlepsze dla: zespołów enterprise, które mają już własną logikę ekstrakcji i walidacji, a potrzebują pod spodem solidnej infrastruktury routingu.
5. ScraperAPI: najlepsze proste API do skalowania zapytań newsowych
ScraperAPI to najprostsze zarządzane API do pobierania danych w tej grupie. Wysyłasz adres URL, a otrzymujesz HTML, tekst albo Markdown, z opcjonalnym renderowaniem JavaScript i routingiem geograficznym po drodze.
Najważniejsze funkcje:
render=trueuruchamia headless Chrome dla stron renderowanych po stronie klienta- Istnieją wbudowane parsery dla wybranych celów (na przykład wyników wyszukiwania Google News), ale nie ma uniwersalnego parsera artykułów wydawców
- DataPipeline obsługuje harmonogramowane, low-code’owe zadania przyjmujące do 10 000 URL-i na jedno uruchomienie
- Batch requests obsługują asynchronicznie do 50 000 URL-i
Cennik zaczyna się od darmowego planu z 1 000 kredytów, potem Hobby za 49 USD/miesiąc (100 000 kredytów, 20 równoległych połączeń, tylko USA/UE), a kończy na Business za 299 USD/miesiąc (3 mln kredytów, globalny routing). Warto zwrócić uwagę, że koszt kredytów zależy od typu żądania — zwykła strona kosztuje 1 kredyt, renderowanie JavaScript 10, a żądanie premium z renderowaniem 25. Pula nieudanych 404 potrafi po cichu zjeść miesięczny limit.
Najlepsze dla: deweloperów, którzy chcą zamiennika dla bezpośrednich żądań HTTP, bez samodzielnego utrzymywania proxy czy infrastruktury przeglądarkowej.
6. Oxylabs: najlepsza usługa proxy enterprise o dużej przepustowości
Oxylabs oferuje jeden z najszerszych zestawów możliwości workflow wśród zarządzanych API z tej listy: uniwersalne pobieranie URL-i, opcjonalne renderowanie, instrukcje przeglądarki do kliknięć i oczekiwania, własny parser oraz wbudowany scheduler z cronem.
Najważniejsze funkcje:
- Uniwersalny target źródłowy dla dowolnych publicznych URL-i oraz dedykowany parser wyszukiwania Google News do discovery
- Szczegółowe kody odpowiedzi odróżniające pełny sukces od wyniku częściowego lub pustego — znacznie bardziej użyteczne niż sam status HTTP
- Dostarczanie danych do S3, GCS i innych magazynów obiektowych
- Własny scheduler wyraźnie ostrzega, że nieprzetestowane harmonogramy mogą szybko podbić koszty, co jak na stronę z cennikiem jest zaskakująco uczciwe
Pricing obejmuje darmowy trial (do 2 000 wyników), Micro za 49 USD/miesiąc, Starter za 99 USD/miesiąc oraz Business za 999 USD/miesiąc, z malejącą stawką za wynik wraz ze wzrostem wolumenu. Jeden haczyk: Oxylabs obecnie zalicza odpowiedzi 4xx do płatnych „successful” wyników, więc strona, z której nic sensownego nie da się pobrać, i tak może kosztować.
Najlepsze dla: firm potrzebujących elastycznego geograficznie, wysokowydajnego pobierania i gotowych zarządzać bardziej złożonym API.
7. Crawlbase: najlepsze API do parsowania newsów z ciężkim JavaScriptem
Crawlbase mocniej niż większość zarządzanych API z tej listy stawia na wynik przyjazny dla artykułów. Jego Crawling API oferuje zwykły token dla treści statycznych i token JavaScript dla pełnego renderowania w przeglądarce, a także tryb readability.
Najważniejsze funkcje:
md_readability=truezwraca Markdown, który usuwa typowe menu, sidebary i reklamy, próbując zachować główny artykuł- Generic Extractor do pobierania treści, tytułów i metadanych w sposób niezależny od witryny
- Selektory kliknięć, scroll i kontrola oczekiwania dla interaktywnych stron JS
- Enterprise Crawler dodaje asynchroniczną kolejkę z ponownymi próbami nawet do 48 godzin — dobre do backfilli, mniej dobre do alertów newsowych w czasie rzeczywistym
Pricing obejmuje do 20 000 darmowych requestów, a potem koszt zależy od złożoności domeny docelowej, a nie od jednej stałej stawki — przed budżetowaniem sprawdź kalkulator na swoich realnych źródłach newsowych. Obsługa bezpośredniego async jest obecnie opisana jako specyficzna dla LinkedIn, chyba że wsparcie włączy ją gdzie indziej, więc nie zakładaj, że działa dla dowolnych domen wydawców.
Najlepsze dla: zespołów, które chcą renderowanego, artykułowo zorientowanego wyniku bez pisania własnego parsera readability od zera.
8. Scrapy: najlepszy framework do własnych crawlerów newsowych
Scrapy to najmocniejsza opcja na tej liście dla inżynierów, którzy chcą naprawdę posiadać własny crawler. To framework Pythona, obecnie w wersji 2.17.0, który natywnie obsługuje planowanie żądań, deduplikację, ponawianie prób, ciasteczka i pipeline’y.
Najważniejsze funkcje:
- Selektory CSS i XPath przez Parsel do precyzyjnej ekstrakcji
- AutoThrottle i limity współbieżności per domena dla uprzejmego crawlowania
- Hooki middleware do proxy, nagłówków i własnej logiki retry
- Własny przewodnik po treściach dynamicznych zaleca najpierw sprawdzić osadzone JSON-y lub dane strukturalne, zanim sięgniesz po pełną integrację z przeglądarką
Cennik: darmowy, open source, bez opłat za request. Realny koszt to infrastruktura, wdrożenie i dyżury kogoś z zespołu. Zwykłe requesty Scrapy nie wykonują JavaScriptu, więc strony ciężkie w JS wymagają dodatku typu scrapy-playwright — i warto dodać, że dokumentacja Scrapy odradza uruchamianie headless browsera bezpośrednio wewnątrz spidera, bo może to ominąć middleware i deduplikację.
Najlepsze dla: zespołów inżynieryjnych budujących długowieczny, wielodomenowy crawler, który chcą samodzielnie utrzymywać.
9. Beautiful Soup: najlepsza lekka biblioteka do statycznych stron newsowych
Beautiful Soup to parser, nie crawler — rozróżnienie, które w wielu rankingach „najlepszych scraperów” zostaje spłaszczone. Pobiera HTML lub XML, które inne narzędzie już wcześniej ściągnęło, i buduje z nich drzewo, po którym da się poruszać. Obecnie ma wersję 4.15.0 na PyPI.
Najważniejsze funkcje:
- Obsługa wielu parserów (
html.parser,lxml,html5lib) z różnymi kompromisami między szybkością a tolerancją błędów, zgodnie z oficjalną dokumentacją - Wsparcie selektorów CSS przez Soup Sieve dla znajomej składni
- Zazwyczaj używany razem z biblioteką Requests do właściwego pobierania HTTP
- Świetny do parsowania osadzonego JSON-LD lub metadanych Open Graph, które już znajdują się w początkowym HTML strony
Cennik: darmowy, open source. Nie ma jednak żadnej obsługi sieci, retry, rotacji proxy ani wykonywania JavaScriptu — to nie jest jego zadanie. To dobre narzędzie wtedy, gdy zespół ma już legalnie pobrany markup i po prostu chce wyciągnąć z niego ustrukturyzowane pola.
Najlepsze dla: inżynierów budujących mały lub średni pipeline, w którym inny komponent już obsługuje pobieranie.
10. Selenium: najlepsza automatyzacja przeglądarki dla stron renderowanych w JS lub wymagających logowania
Selenium steruje prawdziwymi przeglądarkami, dlatego jest właściwym wyborem, gdy treść istnieje dopiero po wykonaniu JavaScriptu albo gdy zadanie wymaga autoryzowanej, zalogowanej sesji. Obecnie dostępna wersja to 4.47.0.
Najważniejsze funkcje:
- Selenium Manager automatycznie wykrywa i buforuje zgodne sterowniki przeglądarek, zmniejszając tarcie przy konfiguracji
- Strategie jawnego oczekiwania oparte na warunkach strony zamiast stałych sleepów — bardzo ważne na nowoczesnych serwisach newsowych, które po załadowaniu strony nadal dogrywają treść
- Obsługa headless Chrome przez
--headless=newdo uruchomień po stronie serwera - Możliwość działania w autoryzowanej sesji logowania, jeśli warunki wydawcy pozwalają na automatyzację
Cennik: darmowy, open source — ale koszty obliczeniowe przeglądarki, kontenery i utrzymanie driverów są realnymi wydatkami operacyjnymi, a uruchamianie jednej instancji przeglądarki na każdy artykuł to zła architektura dla czegokolwiek większego niż mała kolejka wyjątków. Sama dokumentacja Selenium wprost odradza automatyzowanie CAPTCHA, co jest miłą dawką szczerości w narzędziu, o którym wielu ludzi zakłada, że wszystko „przepchnie na siłę”.
Najlepsze dla: wąskiej warstwy eskalacyjnej dla stron zależnych od JS lub zalogowanej sesji — nie jako domyślny transport dla setek zwykłych artykułów.
Skalowanie do 100–1 000+ źródeł newsowych: dlaczego stałe selektory zawodzą
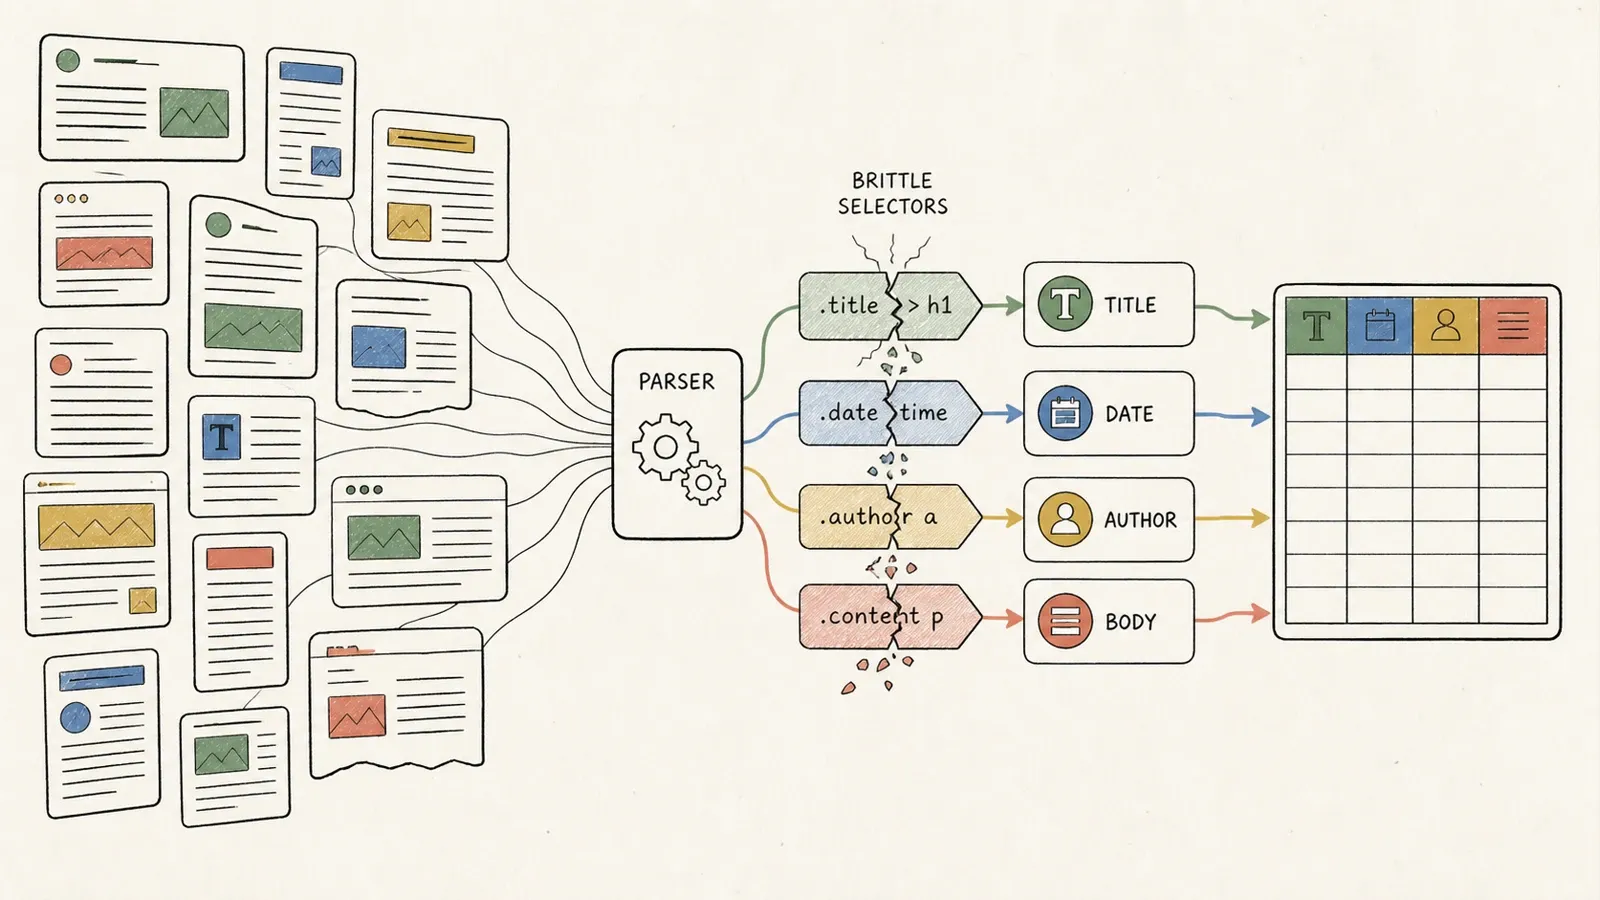
Reguły CSS i XPath kodują założenie: „nagłówek znajduje się w tej klasie”. To założenie działa dokładnie do momentu, gdy wydawca przebuduje serwis, uruchomi test A/B albo zmieni system zarządzania treścią — wtedy reguła po cichu przestaje działać, albo co gorsza, po cichu zwraca coś błędnego. Scraper może zgłosić sukces, a tak naprawdę zassać teaser podobnych artykułów zamiast właściwej treści albo datę aktualizacji zamiast pierwotnej daty publikacji. To znacznie groźniejszy błąd niż pusty wynik, bo nikt go nie zauważa, dopóki ktoś niżej w procesie nie podejmie decyzji na podstawie złych danych.
Narzędzia oparte na statycznych selektorach — Scrapy, Beautiful Soup, szablonowe platformy no-code — wszystkie dziedziczą ten problem. Ekstrakcja oparta na AI lub podejściu agentowym, z którego korzysta Thunderbit i podobne narzędzia, zmniejsza zależność od dokładnych nazw klas, bo przy każdym uruchomieniu analizuje strukturę strony od nowa zamiast opierać się na twardo zakodowanej regule. To realna przewaga przy skali. Nie jest to jednak gwarancja bezobsługowości — zamiast determinizmu wprowadza ocenę probabilistyczną, co zamienia jeden rodzaj błędu na inny.
Przy prawdziwej skali (100 do 1 000+ źródeł) rozwiązaniem nie jest znalezienie jednego magicznego narzędzia. Trzeba zbudować rejestr źródeł: które serwisy mają feedy, które wymagają scrapingu HTML, jakie są oczekiwane pola, limity per domena i ścieżka kwarantanny dla wszystkiego, co zwraca stronę z challenge’em zamiast artykułu. Najpierw feedy, potem metadane strukturalne, następnie ekstrakcja ogólna lub AI, a reguły specyficzne dla źródła tylko dla najcenniejszych wyjątków; renderowanie przeglądarkowe zostaw dla stron, które naprawdę go potrzebują. Dokumentacja Scrapy dotycząca dynamic content mówi właściwie to samo — najpierw sprawdź dane strukturalne, zanim sięgniesz po przeglądarkę.
Anty-bot i renderowanie JS: co każda metoda może, a czego nie może
Marketing w tej branży często miesza pięć zupełnie różnych problemów w jeden: renderowanie po stronie klienta, stany interakcji (kliknięcia, scroll, bannery zgód), limity ruchu, wymagania uwierzytelniania i prawa licencyjne do treści. Tylko pierwsze dwa są naprawdę problemami renderowania. Reszta nie ma nic wspólnego z JavaScriptem.
Poniżej uczciwy podział, narzędzie po narzędziu: rotacja proxy (Bright Data, Oxylabs) zmienia routing i może zmniejszyć tarcie związane z limitowaniem żądań, ale nie tworzy zgody tam, gdzie jej nie było. Zarządzane renderowanie (Crawlbase, ScraperAPI) uruchamia JavaScript, dzięki czemu pojawia się treść renderowana po stronie klienta, ale wyrenderowana strona nadal może zwrócić ekran logowania albo prompt subskrypcji — renderowanie tylko ujawnia przeszkodę, nie omija jej. Automatyzacja prawdziwej przeglądarki (Selenium) pozwala wykonywać rzeczywiste interakcje, ale dokumentacja Selenium jasno stwierdza, że narzędzie nie zostało stworzone do obchodzenia CAPTCHA. Obsługa renderowania i dostępu w Thunderbit działa podobnie — tylko zgodne, autoryzowane strony, bez żadnej pretensji do łamania trudnych paywalli, takich jak te w dużych serwisach subskrypcyjnych.
Żadne z dziesięciu narzędzi opisanych w tym tekście nie gwarantuje dostępu przez CAPTCHA, ekran logowania ani paywall. Każdy, kto mówi inaczej, sprzedaje coś, co nie istnieje. Jeśli ciągle trafiasz na ścianę, właściwym ruchem jest znalezienie oficjalnego feedu, API albo umowy licencyjnej — nie eskalowanie technik scrapingu.
Czy scrapowanie treści newsowych jest legalne? Prawa autorskie i regulamin
To nie jest porada prawna i wyniki naprawdę różnią się w zależności od jurysdykcji oraz zastosowania — ale kilka granic warto znać, zanim cokolwiek zbudujesz.
Fakty zwykle nie podlegają ochronie prawnej; chroniony jest zazwyczaj sposób ich wyrażenia. Circular 33 U.S. Copyright Office oraz 17 U.S.C. §102 wyraźnie wyznaczają tę granicę. Fakt opisany w artykule nie staje się chroniony tylko dlatego, że wydawca opublikował go jako pierwszy — ale sam język, struktura i fotografia zwykle już tak. To ważne rozróżnienie w news scrapingu, ponieważ treści newsowe (w przeciwieństwie do otwartych zbiorów danych czy katalogów firm) są niemal zawsze chronione w swojej wyrażonej formie.
Fair use to test wielu czynników, a nie próg liczby słów, zgodnie z 17 U.S.C. §107. Podsumowanie sprawy Associated Press v. Meltwater opublikowane przez Copyright Office jest tu dobrą przestrogą: komercyjna usługa monitorowania newsów, która kopiowała fragmenty artykułów, nie została uznana za fair use na podstawie tamtych konkretnych faktów. To nie jest ogólna zakazana dla monitoringu — to przypomnienie, że „my tylko to indeksujemy” nie daje automatycznej ochrony.
Jeśli chodzi o prawo dostępu, opinia dziewiątego okręgu w sprawie hiQ Labs v. LinkedIn oraz decyzja Sądu Najwyższego Van Buren zawęziły zakres stosowania Computer Fraud and Abuse Act — ale żadna z nich nie daje ogólnej licencji na ignorowanie regulaminu wydawcy czy obchodzenie technicznych zabezpieczeń dostępu. A robots.txt, ustandaryzowany w RFC 9309, jest wprost opisany jako protokół, nie mechanizm bezpieczeństwa — respektowanie go jest dobrą praktyką, ale nie jest automatycznie ani zgodą, ani zakazem.
Praktyczna najlepsza praktyka: skup się na publicznie dostępnych danych, nie publikuj ponownie pełnych tekstów artykułów, zachowuj atrybucję źródła i linki kanoniczne oraz skonsultuj się z prawnikiem, zanim zaczniesz scrapować treści za paywallem albo budować produkt, który na dużą skalę redystrybuuje pełne artykuły.
Który news scraper wybrać?
Jeśli jesteś osobą nietechniczną i jutro potrzebujesz tabeli z nagłówkami, zacznij
Dowiedz się więcej
- 10 narzędzi do danych z Google News: wybór według workflow zbierania
- 8 najlepszych API do newsów: porównanie cen, limitów i pułapek
- Scraping newsów: najlepsze praktyki dla dokładnych i aktualnych danych
- Web scraping w Pythonie: kompletny przewodnik 2026
- Top 10 no-code web scraperów do automatyzacji procesów




