
W zeszłym miesiącu integracja Stripe u znajomego po cichu zaczęła zwracać błędy 503 dokładnie o 23:00 w piątek. Nikt tego nie zauważył aż do sobotniego poranka — wtedy skrzynka supportu była już zasypana ponad 200 wściekłymi wiadomościami od klientów, którym nie przeszły płatności.
Taka historia wcale nie jest wyjątkiem. Powszechnie cytowany benchmark szacuje średni koszt przestoju na 5 600 USD za minutę, a poważne awarie mogą kosztować miliony na godzinę. Dokładna kwota zależy od ruchu, współczynnika konwersji, wartości zamówień, zapisów w SLA i kosztów naprawy — ale kierunek jest jasny: niekontrolowane API to ryzyko biznesowe, a nie tylko niedogodność dla inżynierów. A skoro organizacje korzystają dziś średnio ze 131 zewnętrznych API, a tylko 16% deklaruje wysoką zdolność ograniczania ryzyka związanego z API stron trzecich, monitoring przestał być opcją. W tym przewodniku chciałem zrobić coś, czego nie widziałem nigdzie indziej: uporządkować narzędzia według Twojego scenariusza, ocenić jakość alertów (a nie tylko ich obecność), pokazać realne ceny na 2026 rok i sprawdzić, jak szybko faktycznie da się zacząć pracę. Nie kolejna płaska lista logotypów.
Jeszcze jedna rzecz: jeśli Twoja praca z API obejmuje zbieranie danych z sieci, zasilanie LLM-ów, budowę systemów RAG, monitorowanie stron konkurencji albo wyciąganie danych o cenach i produktach ze stron internetowych, rozmowa o „narzędziach API” nie powinna kończyć się na monitoringu dostępności. Potrzebujesz też niezawodnego sposobu na zamianę chaotycznych stron WWW w uporządkowane dane. Tu wchodzi Thunderbit Open API: nie jest to monitor dostępności, ale to jeden z najszybszych sposobów na przekształcanie stron w czysty Markdown lub JSON oparty na schemacie, dostępny przez API.
Czym jest monitoring API i dlaczego Twój zespół powinien się nim przejmować?
Monitoring API oznacza ciągłe sprawdzanie, czy endpointy są dostępne, działają szybko i zwracają właściwe dane. Nie chodzi tylko o to, czy serwer „żyje” — dobry monitoring weryfikuje kody HTTP, treść odpowiedzi, opóźnienia, certyfikaty SSL, wieloetapowe przepływy (np. logowanie → wyszukiwanie → checkout), a nawet zgodność ze schematem.
To coś innego niż ogólny monitoring stron WWW (który sprawdza, czy strona się wczytuje) i inne niż APM (Application Performance Monitoring), które zagląda w trace’y kodu, zapytania do bazy i wewnętrzne szczegóły działania runtime. Monitoring API działa na granicy: sprawdza to, co naprawdę widzą użytkownicy, partnerzy i integracje, gdy wywołują endpointy.
Jest też pokrewna kategoria warta wyróżnienia: web data API. Nie monitorują one, czy Twoje własne API działa poprawnie; pomagają produktowi albo workflow niezawodnie zbierać zewnętrzne dane z internetu. Na przykład Thunderbit Open API potrafi zamienić stronę internetową w czysty Markdown, wyciągnąć ustrukturyzowane pola do JSON i uruchamiać zadania wsadowe na wielu adresach URL. Jeśli Twój projekt „API” opiera się na świeżych danych dostawców, stronach produktów, publicznych ogłoszeniach, dokumentacji albo źródłach badawczych, taki interfejs do ekstrakcji danych może być równie ważny operacyjnie jak same testy dostępności.
Dlaczego osoby nietechniczne też powinny się tym interesować? Bo API odpowiadają za 71% dynamicznego ruchu w sieci i 62% specjalistów ds. API twierdzi, że API bezpośrednio generują przychód. Gdy zawiedzie bramka płatności, usługa autoryzacji albo API wysyłki, nie jest to abstrakcyjny problem infrastrukturalny — to utracone przychody, zerwane umowy partnerskie, zalew zgłoszeń do supportu i spadek zaufania. Menedżerowie produktu, sprzedaż, operacje i customer success też mają w tym swój interes.
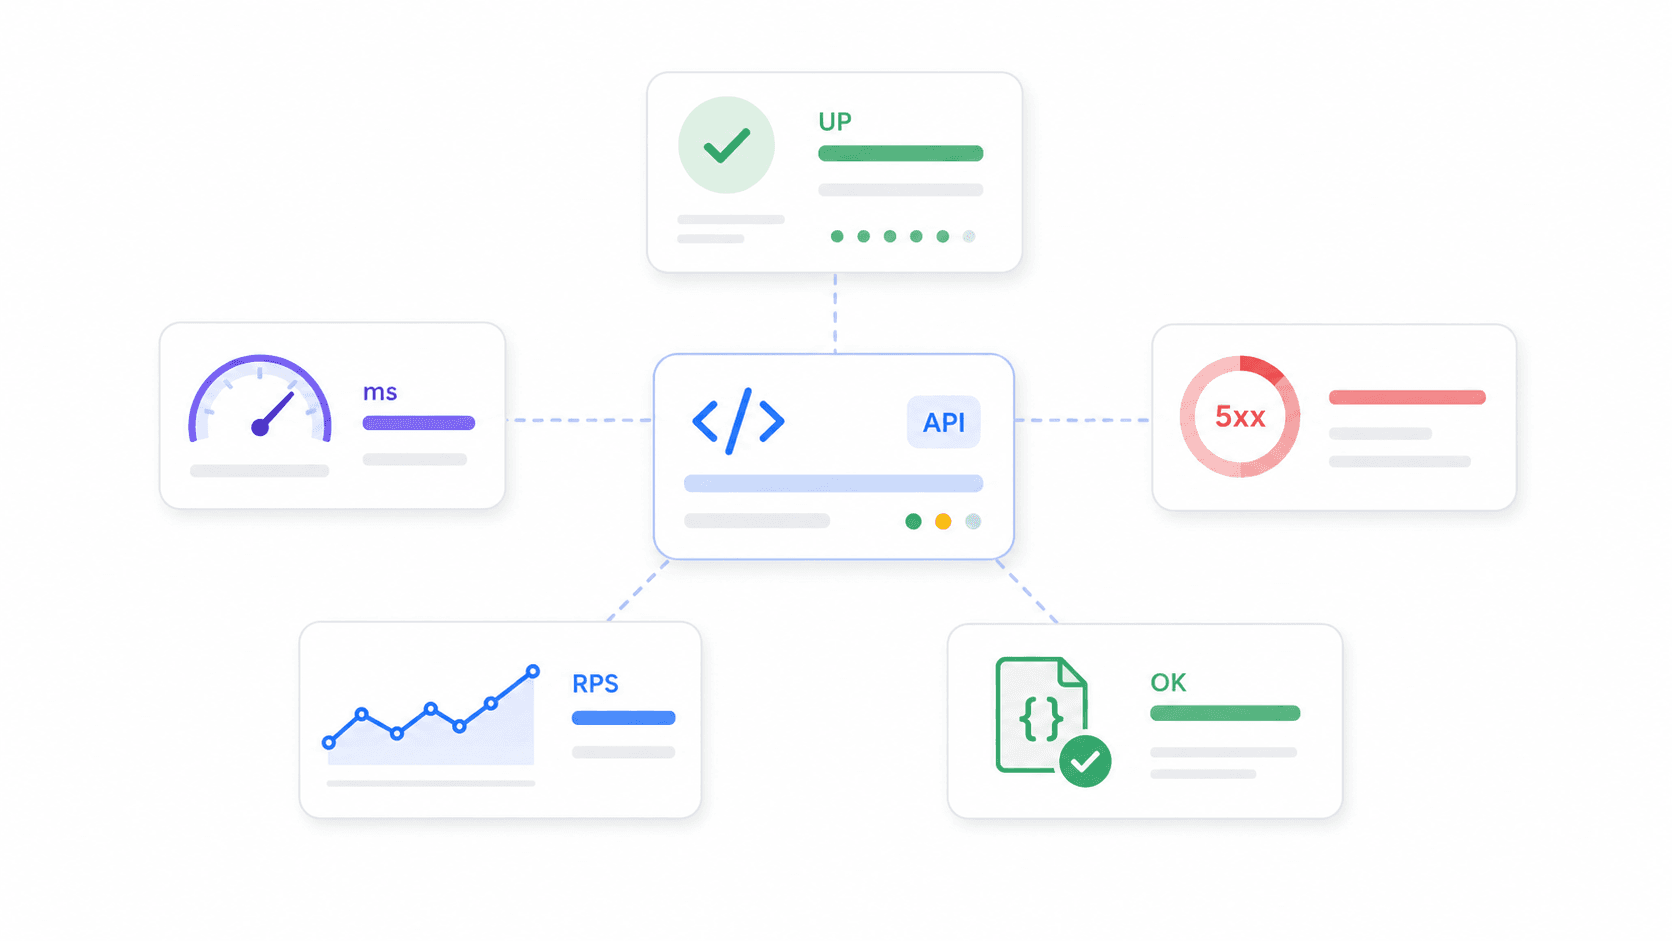
Najważniejsze metryki do śledzenia:
- Uptime: procent czasu, w którym endpoint jest dostępny
- Czas odpowiedzi / opóźnienie: jak długo endpoint odpowiada (średnia, p95, p99)
- Wskaźnik błędów: odsetek żądań kończących się 5xx, timeoutem lub błędem asercji
- Przepustowość: liczba żądań na sekundę / minutę
- Poprawność: czy API zwraca oczekiwane dane, a nie tylko 200 OK
Jak ocenialiśmy najlepsze narzędzia do monitorowania API w 2026 roku
Większość artykułów o „najlepszych narzędziach do monitorowania API” po prostu wrzuca listę nazw i funkcji. Chciałem podejść do tematu bardziej świadomie — częściowo dlatego, że sporo czasu spędziłem na czytaniu forów dla developerów, a częściowo dlatego, że zespół Thunderbit pomógł mi hurtowo wyciągnąć dane o cenach i funkcjach ze stron dostawców, żeby zbudować prawdziwe porównanie (więcej o tym workflow później).
Oto, co ważyliśmy najbardziej:
| Kryterium | Dlaczego ma znaczenie |
|---|---|
| Łatwość konfiguracji / czas do pierwszego alertu | Małe zespoły potrzebują pokrycia teraz, a nie po zakończeniu wielkiego projektu platformowego |
| Inteligencja alertów i redukcja szumu | Jeśli alerty są zbyt głośne, zespół je ignoruje i przegapia prawdziwe incydenty |
| Hojąjność darmowego planu | Projekty poboczne i młode startupy często zaczynają od free |
| Przejrzystość cen | Koszty observability potrafią wystrzelić przez hosty, seaty, logi, testy syntetyczne i ingest danych |
| Szerokość integracji | Alerty muszą trafiać tam, gdzie zespół już pracuje (Slack, PagerDuty itd.) |
| Skalowalność i głębokość danych | Dojrzałe zespoły potrzebują trace’ów, logów, APM, RBAC, SSO i retencji |
| Jakość społeczności i wsparcia | Zespoły open-source potrzebują częstych wydań; enterprise — SLA |
| Możliwość ekstrakcji danych z sieci | Aplikacje AI, workflow RAG i narzędzia do researchu często potrzebują czystych danych zewnętrznych, a nie tylko sprawdzania uptime’u endpointu |
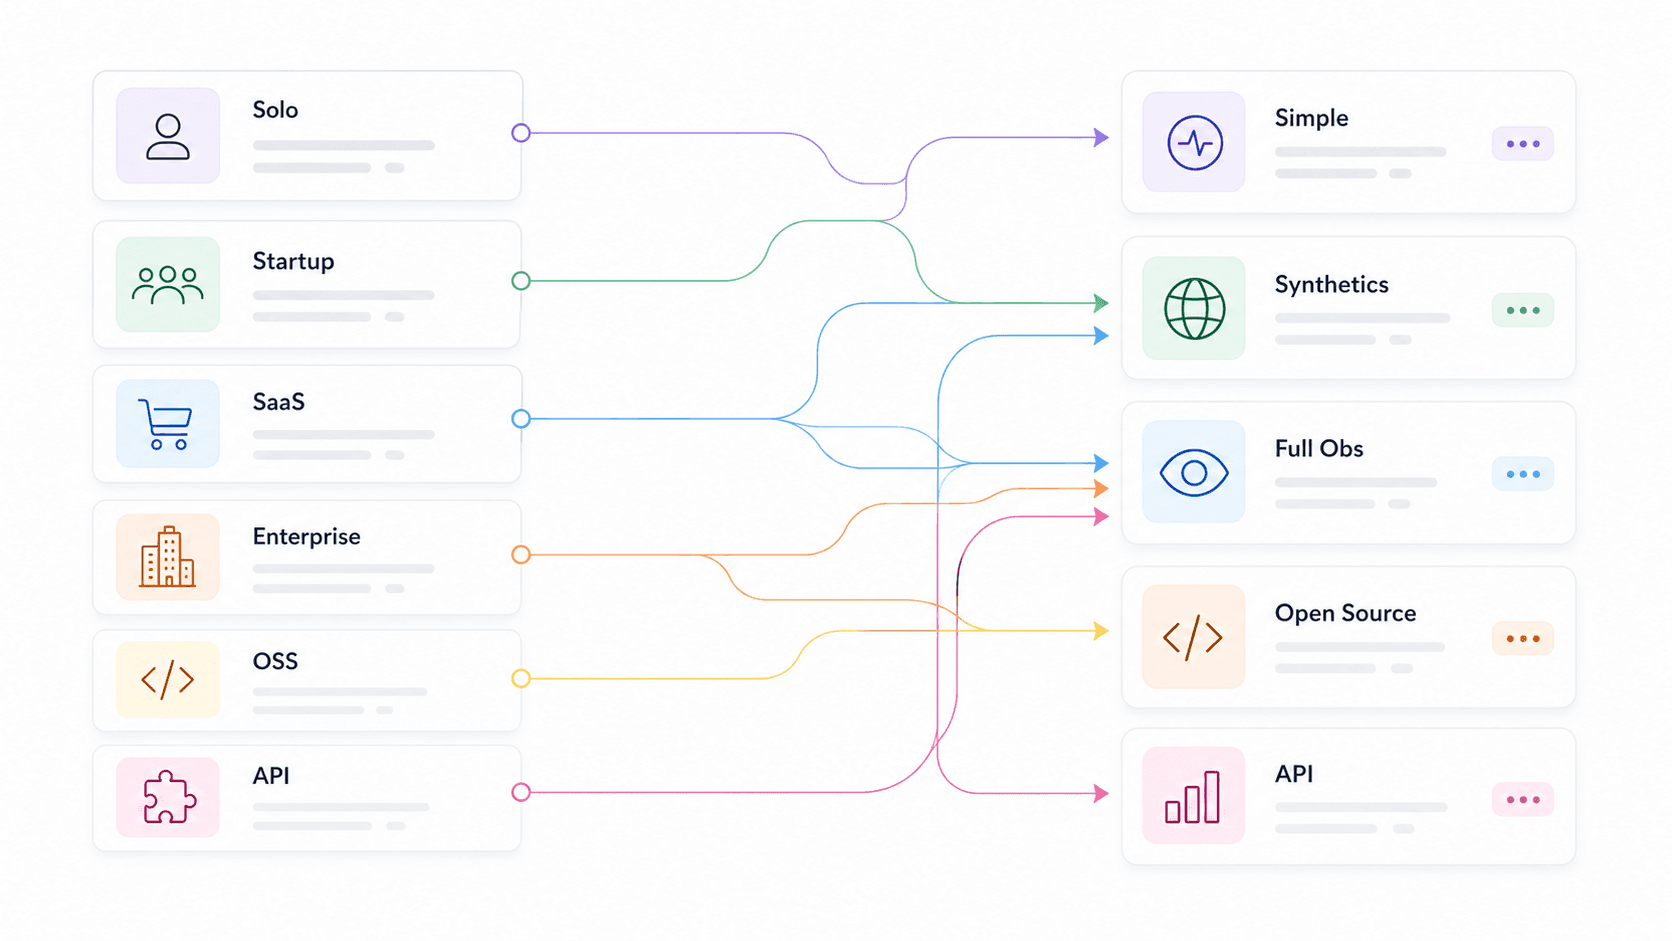
Podzieliliśmy też rekomendacje według scenariuszy użycia — solo dev, startup, e-commerce/SaaS, enterprise, zwolennicy open source, zespoły budujące produkty API oraz zespoły pracujące na danych webowych / aplikacjach AI — żeby można było od razu przejść do swojego kontekstu, zamiast czytać 14 opisów narzędzi i zgadywać, które pasuje. Badanie Grafany z 2025 roku wykazało, że 46% respondentów wskazywało interoperacyjność i 35% łatwość przyszłej migracji jako kryteria wyboru, co potwierdza, że nie są to jedynie „miłe dodatki”.
Najlepsze narzędzia do monitorowania API według zastosowania: szybka tabela wyboru
To jest skrót. Znajdź swój wiersz, a potem przejdź niżej do pełnych opisów narzędzi.
| Scenariusz | Polecane narzędzia | Kluczowa przewaga |
|---|---|---|
| Zespoły working na danych webowych / aplikacjach AI | Thunderbit Open API, Moesif, Apitally | Zamiana stron WWW w czysty Markdown lub ustrukturyzowany JSON dla LLM-ów, RAG, cen i researchu |
| Solo dev / projekt poboczny | UptimeRobot, Uptime Kuma, Gatus | Darmowe albo self-hosted, minimalna konfiguracja, szybki start |
| Startup (zespół 5–15 osób) | Checkly, Better Stack, Postman | Inteligentne alerty, szybka konfiguracja, przystępna cena, status pages |
| E-commerce / SaaS | Datadog, New Relic, Moesif, Checkly | Metryki biznesowe, APM/trace’y, głębokość SDK, testy wieloetapowe |
| Enterprise / multi-cloud | Datadog, New Relic, Splunk, Grafana Cloud | Distributed tracing, zgodność, środowiska hybrydowe, RBAC/SSO |
| Puryści open source | Prometheus + Grafana, Uptime Kuma, Gatus, Uptrace | Pełna kontrola, natywne OTel, brak lock-inu |
| Zespoły produktowe API | Moesif, Apitally, New Relic | Użycie per klient, trendy endpointów, alerty anomalii |
Największy wzorzec: narzędzia najszybsze we wdrożeniu zwykle oferują mniej analityki, a najgłębsze platformy wymagają więcej konfiguracji i dyscypliny kosztowej. To nie wada — to kompromis, który trzeba świadomie zaakceptować. Thunderbit działa trochę w innym obszarze: jest najszybszy tam, gdzie zadanie polega na zamianie stron WWW w dane gotowe do API, a nie na alarmowaniu inżynierów o przestojach.
Thunderbit Open API: najlepszy wybór do zamiany stron WWW w ustrukturyzowane dane API
Zacznij budować z Thunderbit Open API Zamieniaj strony na Markdown, wyciągaj ustrukturyzowany JSON i przetwarzaj wsadowo adresy URL bez utrzymywania własnej infrastruktury do scrapingu. Get Started Free
Thunderbit Open API to API, które postawiłbym na pierwszym miejscu dla zespołów, których monitoring albo research zależy od zewnętrznych danych webowych. Nie jest to klasyczne narzędzie do monitorowania uptime’u jak Checkly czy UptimeRobot. Zamiast tego Thunderbit zamienia dowolną stronę WWW w czyste, ustrukturyzowane dane, z których Twoje aplikacje, agenci, dashboardy i pipeline’y LLM mogą faktycznie korzystać.
API ma trzy główne workflow. Distill przekształca stronę w czysty Markdown gotowy dla LLM-ów. Extract przyjmuje schemat i zwraca ustrukturyzowane pola JSON, takie jak nazwa produktu, cena, dostępność, wielkość firmy, etap finansowania czy ocena z recenzji. Batch pozwala przetwarzać do 100 adresów URL asynchronicznie z użyciem webhooków, co jest przydatne przy monitorowaniu stron z cenami, katalogów konkurencji, dokumentacji dostawców, źródeł newsowych czy dużych list badawczych.
To, dlaczego to narzędzie powinno znaleźć się w przewodniku po API, jest proste: zespoły często nie doceniają, ile infrastruktury wymaga pozornie banalne „po prostu zeskrob tę stronę”. Serwisy mocno oparte na JavaScripcie wymagają renderowania. Część stron potrzebuje routingu geograficznego. HTML trzeba oczyścić z menu, reklam, modalnych okien i powtarzalnych elementów, zanim będzie użyteczny dla LLM-a. Selektory psują się, gdy zmieni się układ strony. Rotacja proxy, ochrona anty-bot, retry, kolejki i sprawdzanie wyników mogą zamienić mały workflow danych w projekt utrzymaniowy. Thunderbit przejmuje dużą część tej pracy za pośrednictwem jednego API.
Najlepsze dla: twórców aplikacji AI, zespołów RAG, e-commerce ops, sales ops, growth, researcherów rynku i developerów, którzy potrzebują danych ze stron WWW przez API bez budowania i pilnowania własnego stosu do scrapingu.
Cennik: Darmowy plan: 600 jednorazowych jednostek API, w tym do 600 stron Distill albo 30 stron Extract, z 2 jednoczesnymi żądaniami. Starter kosztuje 16 USD/mies. przy rozliczeniu rocznym i obejmuje 60 000 jednostek API rocznie oraz 30 równoległych żądań. Pro kosztuje 40 USD/mies. przy rozliczeniu rocznym i obejmuje 600 000 jednostek API rocznie oraz 50 równoległych żądań.
Szybkość startu: około 5–15 minut, aby zdobyć klucz API i wykonać pierwsze żądanie Distill albo Extract przez cURL, SDK lub Thunderbit CLI.
Wady: Thunderbit nie zastąpi Datadog, New Relic, Better Stack ani Checkly w monitoringu uptime’u, eskalacji incydentów, trace’ach, logach czy routingu on-call. Traktuj go jako API do zbierania i porządkowania danych webowych — w tym cen, dokumentacji dostawców, stron konkurencji, listingów produktów czy publicznych zbiorów danych — a nie jako system, który powiadamia dyżurnego inżyniera.
Datadog: najlepszy do pełnej widoczności całego stosu
Datadog to narzędzie, które najczęściej widzę w enterprise i mid-market SaaS, i nie bez powodu. To nie tylko monitoring API — to pełna platforma observability, która łączy syntetyczne testy API z distributed tracingiem, logami, metrykami infrastruktury i monitoringiem realnych użytkowników w jednym widoku.
Jeśli chodzi konkretnie o API monitoring, Datadog obsługuje HTTP, SSL, DNS, WebSocket, TCP, UDP, ICMP, gRPC oraz wieloetapowe testy API. Jego monitory wykrywania anomalii uczą się typowych wzorców i alarmują o odchyleniach zamiast o statycznych progach — to realny krok naprzód względem „alarmuj, gdy latency > 500 ms”. Dostępne są też monitory prognozujące, które przewidują przekroczenie progu, oraz monitory kompozytowe łączące wiele warunków.
Najlepszy dla: zespołów e-commerce, SaaS i enterprise, które potrzebują jednego miejsca do obserwacji API, infrastruktury, logów i trace’ów.
Cennik: szczegóły darmowego planu zależą od produktu. Infrastructure Pro startuje od 15 USD/host/mies.; syntetyczne testy API kosztują 5 USD za 10 000 uruchomień. Ponad 800 integracji.
Szybkość startu: około 15–30 minut na instalację agenta i podstawowy test syntetyczny.
Wady: przy dużej skali bywa drogo — „bill shock” to częsty temat na Hacker News i Reddit. Sama liczba SKU (hosty, logi, metryki niestandardowe, synthetics, użytkownicy) oznacza, że ktoś musi pilnować rachunku, nie tylko dashboardów. Krzywa uczenia się pełnej platformy też jest realna.
Checkly: najlepszy do syntetycznych testów dla developerów
Checkly to narzędzie, które dałbym zespołowi startupowemu, jeśli chce mieć monitoring API blisko kodu. Jego główna idea to „monitoring jako kod”: definiujesz testy API i testy przeglądarkowe programowo, uruchamiasz je z globalnych lokalizacji, integrujesz z CI/CD i zarządzasz wszystkim przez Git.
Mocną stroną jest tu jakość alertów. Logika retry w Checkly jest wprost opisywana jako „pierwsza linia obrony” przed fałszywymi alarmami — możesz ustawić retry stałe, liniowe lub wykładnicze, ponawianie z tej samej lub innej lokalizacji oraz maksymalny czas ponawiania przed wygenerowaniem alertu. Narzędzie rozróżnia też stan pogorszenia, awarii i odzyskania, co pomaga ograniczyć hałas.
Najlepszy dla: startupów i zespołów developerskich, które chcą programowalnych testów API, testów przeglądarkowych opartych o Playwright, integracji z CI/CD i szybkiego wdrożenia.
Cennik: najnowsze publiczne dane mówią o darmowym planie z 10 monitorami uptime, 1 000 testami browser i 10 000 testami API. Starter to około 24 USD/mies. przy rozliczeniu rocznym — sprawdź oficjalną stronę cennika przed zakupem.
Szybkość startu: około 10–20 minut na pierwszy test API i kanał alertów.
Wady: narzędzie skupione na testach syntetycznych. Nie zastąpi głębokiego APM, analityki logów ani distributed tracingu. Jeśli musisz powiązać awarię API z wąskim gardłem bazy danych, będziesz potrzebować dodatkowego narzędzia.
UptimeRobot: najlepszy do prostego i taniego monitoringu uptime
UptimeRobot to Honda Civic świata monitoringu API. Robi jedną rzecz dobrze: tworzysz monitor HTTP, keyword, ping, port, SSL albo heartbeat, ustawiasz interwał i dostajesz alert, gdy coś przestaje działać. Tyle.
Najlepszy dla: solo developerów, małych zespołów, agencji lub każdego, kto potrzebuje podstawowego monitoringu uptime i latency bez komplikacji.
Cennik: Darmowy plan: 50 monitorów, interwał co 5 minut. Płatny plan Solo zaczyna się około 7 USD/mies. przy rozliczeniu rocznym. Do darmowego planu nie trzeba karty. Szybkość startu: około 2–5 minut — najszybciej w tym zestawieniu.
Wady: ograniczona inteligencja alertów. Proste progi, brak wykrywania anomalii, brak distributed tracingu, brak głębokiej analityki. Jeśli chcesz wiedzieć dlaczego endpoint zwalnia, a nie tylko że zwalnia, UptimeRobot tego nie rozwiąże.
Uptime Kuma: najlepsze darmowe, self-hosted narzędzie do monitoringu API
Uptime Kuma to ulubieniec społeczności self-hostingowej, a liczby z GitHuba mówią same za siebie: 86 637 gwiazdek, 7 831 forków, 1 060 współautorów, a w maju 2026 dostępna była wersja 2.3.2. Projekt jest na licencji MIT, obsługuje HTTP(s), keyword, zapytania JSON, WebSocket, TCP, ping, DNS, push, Docker, wiele stron statusu i ponad 90 usług powiadomień.
Najlepszy dla: solo devów i zespołów, które chcą pełnej kontroli, prywatności i zerowych cyklicznych kosztów SaaS — o ile mają własny serwer.
Cennik: darmowy. Realny koszt to VM/kontener, backupy, aktualizacje i dopilnowanie, by sam monitoring też działał. Szybkość startu: około 5–15 minut z Dockerem dla podstawowego checku; 15–30 minut, jeśli chcesz dopracować powiadomienia i stronę statusu.
Wady: utrzymanie jest po Twojej stronie. I ważna pułapka: jeśli hostujesz Uptime Kuma na tej samej infrastrukturze, którą monitoruje, awaria chmury albo DNS wyłączy zarówno aplikację, jak i monitor. Hostuj go zewnętrznie albo połącz z SaaS-owym checkiem.
Better Stack: najlepszy do szybkiego reagowania na incydenty
Better Stack (użytkownicy często nadal mówią Better Uptime) łączy monitoring uptime z zarządzaniem incydentami, dyżurami on-call, politykami eskalacji i stronami statusu w jednej platformie. Najmocniejszy jest nie jako narzędzie analityczne, ale jako narzędzie workflow wokół incydentów.
Polityki eskalacji określają, kto dostaje alert, w jakiej kolejności i z jakimi opóźnieniami, aż do potwierdzenia. Routing oparty na metadanych wysyła incydenty według priorytetu albo odpowiedzialności. Integruje się ze Slackiem, Teams, webhookami i Zapier.
Najlepszy dla: startupów i średnich zespołów, które chcą monitoringu + reakcji na incydenty + stron statusu bez składania trzech osobnych narzędzi.
Cennik: Darmowy plan: 10 monitorów/heartbeatów, 1 strona statusu. Plan Team to około 29 USD/mies. przy rozliczeniu rocznym. Szybkość startu: około 5–10 minut przez kreator GUI.
Wady: mniej głębi w analizie payloadów API, distributed tracingu i analizie KPI biznesowych niż Datadog, New Relic czy Moesif.
Prometheus + Grafana: najlepszy open-source stack do monitorowania API
To standardowy w branży open-source duet. Prometheus zbiera i przechowuje metryki szeregów czasowych. Grafana (73 705 gwiazdek na GitHubie, 3 010 współautorów) zapewnia dashboardy i alerting. Alertmanager odpowiada za routing, grupowanie, deduplikację, wyciszanie i inhibicję. Do sprawdzania endpointów API zespoły dodają Blackbox Exporter dla testów HTTP, HTTPS, DNS, TCP, ICMP i gRPC.
Najlepszy dla: zwolenników open source, zespołów Kubernetes/SRE i organizacji, które już standaryzują metryki w oparciu o Prometheusa.
Cennik: darmowy self-hosted. Grafana Cloud ma darmowy plan (100 tys. uruchomień testów API miesięcznie) oraz płatne plany oparte na użyciu.
Szybkość startu: 1–4 godziny na podstawowy zestaw Blackbox + Prometheus + Grafana + Alertmanager. Dni na produkcyjne HA i dopracowanie alertów.
Wady: PromQL, YAML, relabeling, projektowanie dashboardów, retencja, storage, HA i strojenie alertów to realna praca operacyjna. Częsty kompromis brzmi: „mniej UI, więcej YAML”. To stack dla zespołów, które już myślą metrykami i chcą jednego panelu sterowania — nie dla tych, które chcą mieć monitoring gotowy jeszcze przed lunchem.
New Relic: najlepszy do wydajności aplikacji SaaS
New Relic łączy APM, monitoring infrastruktury, logi, distributed tracing, monitoring syntetyczny, alerty, dashboardy i analizę incydentów wspieraną przez AI. Darmowy plan — 100 GB danych ingestowanych miesięcznie i 1 pełny użytkownik platformy — jest naprawdę hojny dla małych zespołów.
Najmocniejszą stroną New Relic w kontekście zmęczenia alertami jest inteligencja alertowania. Jego funkcje incident intelligence obejmują korelację zdarzeń, wykrywanie anomalii, alerty predykcyjne, analizę przyczyn źródłowych i tłumienie flappingu. New Relic pokazał przykład, w którym skuteczność tłumienia flappingu na poziomie 97,2% oznacza tylko 28 ujawnionych problemów na 1000 zdarzeń flappingowych — to konkretny wynik redukcji szumu.
Najlepszy dla: zespołów SaaS i platform e-commerce, które chcą monitoringu API ściśle połączonego z trace’ami aplikacji, błędami, przepustowością i wpływem na użytkownika.
Cennik: darmowy: 100 GB/mies., 1 pełny użytkownik. Płatne plany liczone są per użytkownik i per ilość danych.
Szybkość startu: około 15–30 minut na instalację agenta i prowadzone wdrożenie.
Wady: cennik może robić się złożony przy większej skali. Konfiguracja alertów wymaga nauki — platforma jest mocna, ale nie od razu intuicyjna.
Moesif: najlepszy do analityki API i metryk biznesowych
Moesif nie jest klasycznym monitorem uptime. To analityka API i intelligence produktowy: zrozumienie użycia API według klienta, endpointu, kohorty, firmy, geografii, SDK, planu i zachowania. Jeśli pytanie brzmi „który klient ma problem?”, a nie „czy endpoint działa?”, Moesif jest właśnie do tego.
Obsługuje statyczne alerty progowe i dynamiczne alerty anomalii dla metryk API, takich jak skoki/spadki ruchu, opóźnienia i zmiany zachowania. Dynamiczne alerty potrzebują kilku dni danych, żeby zbudować model, ale po wytrenowaniu wyłapują zmiany, których reguły statyczne nie widzą.
Najlepszy dla: zespołów produktowych API, firm SaaS i platform e-commerce, które chcą połączyć wydajność API z przychodami, zaangażowaniem i retencją.
Cennik: dostępny plan free/trial; płatne plany skalują się wraz z wolumenem eventów API. Szczegóły cenowe self-service nie były w pełni możliwe do zeskrobania w moich badaniach — sprawdź aktualną stronę.
Szybkość startu: około 20–45 minut (integracja przez SDK/proxy/gateway jest głębsza niż zwykły zewnętrzny ping).
Wady: bardziej nastawione na analitykę niż na klasyczny monitoring uptime. Prawdopodobnie i tak warto połączyć Moesif z Checkly, UptimeRobot albo synthetics w Datadog do zewnętrznych testów dostępności.
Splunk: najlepszy do analizy logów enterprise i zgodności
Splunk to narzędzie, po które sięga się wtedy, gdy agregacja logów, wyszukiwanie, korelacja, audytowalność pod kątem compliance i wsparcie dla środowisk hybrydowych/multi-cloud są nie do negocjacji. Splunk Observability Cloud obejmuje infrastrukturę, APM, synthetics, monitoring rzeczywistych użytkowników, logi i reakcję na incydenty. ITSI/Event Analytics potrafi grupować istotne zdarzenia w epizody i ograniczać szum między silosami monitoringu.
Własne badanie observability z 2025 roku daje do myślenia: 73% osób z ITOps/inżynierii zgłosiło awarie spowodowane zignorowanymi lub wyciszonymi alertami, 59% miało problem z nadmiarem rozproszonych narzędzi, a 52% z fałszywymi alertami.
Najlepszy dla: enterprise i zespołów multi-cloud z ostrymi wymaganiami dotyczącymi zgodności, bezpieczeństwa, audytu i wyszukiwania logów.
Cennik: oparty na użyciu i zwykle wyceniany indywidualnie. Brak prostego darmowego planu produkcyjnego.
Szybkość startu: wdrożenie w chmurze może być szybsze, ale enterprise deployment często trwa od kilku dni do kilku tygodni.
Wady: drogie przy skali. Złożona konfiguracja. Zbyt dużo dla solo deweloperów i małych startupów.
Postman: najlepszy dla zespołów, które już testują API
Postman to przede wszystkim platforma do tworzenia i testowania API, ale jego produkt monitoringu pozwala planować uruchomienia kolekcji Postman i wykonywać je z lokalizacji w chmurze. Najmocniejszy argument to ponowne wykorzystanie: jeśli QA albo dev team już ma kolekcje Postmana z asercjami, zamiana ich w monitory jest naturalnym krokiem.
Najlepszy dla: zespołów dev i QA, które już korzystają z kolekcji Postman i chcą planowanych checków bez kupowania osobnego narzędzia syntetycznego.
Cennik: dostępny darmowy plan. Nadmiarowe wykorzystanie monitoringu kosztuje 0,75 USD za 1 000 wywołań; dodatkowy pakiet 50 000 wywołań kosztuje 20 USD/mies. Sprawdź aktualną stronę planów — pakiety Postmana często się zmieniają.
Szybkość startu: około 10 minut, jeśli kolekcje już istnieją.
Wady: możliwości monitoringu są skromniejsze niż w narzędziach dedykowanych, takich jak Checkly, Datadog czy New Relic. Opcje alertów są podstawowe.
Inne narzędzia do monitorowania API, które warto sprawdzić
Gatus: lekkie, self-hosted, konfigurowalne dashboardy zdrowia usług. 10 906 gwiazdek na GitHubie, obsługuje HTTP, ICMP, TCP, DNS, metryki przyjazne Prometheusowi i badge’e uptime. Świetny dla solo devów, którzy chcą czegoś prostszego niż Prometheus, ale wolą YAML/config-as-code od interfejsu Uptime Kuma.
Apitally: nowsze narzędzie skupione na analizie ruchu API i śledzeniu jakości dla startupów. Deklaruje konfigurację w mniej niż 5 minut oraz własne alerty dla 14 metryk. Dobre do lekkiej analityki API bez wdrażania pełnej platformy observability.
Sematext: pełne monitorowanie stacku z logami, synthetics i widocznością infrastruktury. Synthetics około 2 USD za monitor HTTP, 7 USD za monitor browser, minimum 5 USD/mies. Tańsza alternatywa dla Datadoga dla zespołów mid-market.
Uptrace: backend APM, tracingu, metryk i logów zgodny z OpenTelemetry. 4 198 gwiazdek na GitHubie. Nie jest to czysty checker uptime, ale świetny wybór dla zespołów standaryzujących OTel, które chcą open-source’owego backendu do trace’ów.
Build vs. buy: czy warto samemu pisać monitoring API?
„Czy po prostu napisać skrypt pingujący endpointy, czy użyć dedykowanego narzędzia?”
To pytanie wraca non stop na forach dla developerów. Przeczytałem wystarczająco dużo wątków na Reddicie, żeby zobaczyć schemat: zespoły zaczynają od curl + cron, przez jakiś czas to działa, a potem przechodzą na gotowe rozwiązanie, kiedy potrzebują dashboardów, danych historycznych, testów wieloregionowych, pewnego routingu alertów albo widoczności między zespołami.
Uczciwa macierz decyzji:
| Czynnik | Skrypt własny | Narzędzie specjalistyczne |
|---|---|---|
| Czas wdrożenia | 1–4 godziny (podstawy); dni (porządnie) | 5–30 minut |
| Utrzymanie | Zawsze po Twojej stronie | Dostawca zajmuje się aktualizacjami |
| Jakość alertów | Podstawowa (up/down) | Inteligentna (trendy latency, anomalie, retry) |
| Koszt | Za darmo (Twój czas) | 0–500+ USD/mies. |
| Dashboard | Trzeba zbudować od zera | Gotowy, konfigurowalny |
| Kiedy to ma sens | ≤3 endpointy, zespół techniczny, projekt hobbystyczny | 5+ endpointów, zespół ops/product, stawka biznesowa |
Kluczowy wniosek z forów: osoby, które budują własne rozwiązanie, często żałują tego, gdy potrzebują dashboardów, danych historycznych albo widoczności między zespołami. Jest też problem meta — „monitoring potrzebuje monitoringu”. Self-hosted monitor, baza danych, backup, łącze sieciowe i dostawca alertów też muszą być niezawodne.
Buduj sam, jeśli masz 2 endpointy i lubisz dłubać. Kup, jeśli masz produkt do dostarczenia.
Ta sama logika dotyczy ekstrakcji danych webowych. Możesz napisać scraper, uruchamiać headless browsery, rotować proxy, utrzymywać selektory, czyścić HTML i budować kolejkę. Ale jeśli zadanie polega na niezawodnym dostarczaniu danych webowych do produktu API, agenta AI albo workflow badawczego, skorzystanie z Thunderbit Open API jest zwykle szybsze niż budowanie własnej infrastruktury scrapującej.
Zmęczenie alertami: dlaczego jakość alertów wygrywa z ich liczbą
To chyba najbardziej niedoceniane kryterium przy wyborze narzędzia do monitorowania API. Zmęczenie alertami pojawia się wtedy, gdy zespół dostaje tak wiele szumu, duplikatów i nieprzydatnych powiadomień, że zaczyna ignorować wszystkie — i przez to przegapia realne incydenty.
Liczby są mocne. Raport BigPanda z 2025 roku wykazał, że mediana organizacji generowała 2 350 alertów dziennie i 803 406 alertów rocznie. Mediana użyteczności incydentów wynosiła tylko 18% — czyli mniej niż 1 na 5 alertów prowadził do czegoś faktycznie działaniającego. Badanie NeuBird z 2026 roku wykazało, że 77% zespołów on-call dostaje co najmniej 10 alertów dziennie, a 80% twierdzi, że połowa lub mniej tych alertów jest użyteczna.
Najlepsze narzędzie monitorujące to takie, którego alertom faktycznie ufasz. Oto porównanie sposobu, w jaki poszczególne narzędzia radzą sobie z inteligencją alertów:
| Narzędzie | Typ alertów | Metoda redukcji szumu | Kanały alertów |
|---|---|---|---|
| Datadog | ML anomaly, forecast, composite | Historyczne pasma anomalii, dynamiczne baseline’y, Watchdog AI | Slack, PagerDuty, Opsgenie, Teams, 20+ |
| Checkly | Threshold + degradacja | Retry przed wysłaniem alertu, ponawianie z tej samej lub innej lokalizacji | Slack, PagerDuty, Opsgenie, Teams, incident.io |
| New Relic | AI grouping issue, anomaly, predictive | Korelacja zdarzeń, tłumienie flappingu, kontekst root-cause | Slack, PagerDuty, Teams, webhooki |
| Moesif | Anomalia behawioralna | Dynamiczne modele po kilku dniach zachowania | Slack, PagerDuty, e-mail, SMS |
| Better Stack | Uptime/incydent/on-call | Polityki eskalacji, routing według odpowiedzialności, opóźnienia | Slack, Teams, webhooki, Zapier |
| Prometheus + Alertmanager | Alerty z reguł PromQL | Grupowanie, deduplikacja, wyciszanie, inhibicja | E-mail, PagerDuty, Opsgenie, webhooki |
| Splunk | Zdarzenia, epizody, stan usług | ITSI Event Analytics, grupowanie epizodów, ticketing | Splunk On-Call, ServiceNow, webhooki |
| Thunderbit Open API | Nie jest platformą alertową | Używaj z własnym schedulerem, narzędziem workflow albo stackiem monitoringu | Webhooki dla zadań wsadowych; alerty obsługiwane zewnętrznie |
Praktyczna rada: zacznij od mniejszej liczby alertów o wyższym poziomie zaufania. Używaj retry przed wysłaniem alertu, potwierdzenia z wielu regionów, alertów burn-rate SLO, deduplikacji i routingu według właściciela. Alarmuj o wpływie na użytkownika i krytycznych przepływach biznesowych (błąd checkout, błąd autoryzacji, 5xx płatności), a nie o każdym wewnętrznym objawie.
Ceny i darmowe plany w 2026: ile faktycznie zapłacisz
Strony z cennikiem się zmieniają. Darmowe plany też. Ukryte koszty — hosty, seaty, logi, uruchomienia synthetics, ingest danych — potrafią zaskoczyć. To sekcja, którą chciałbym widzieć w każdym artykule „best tools”. Oto stan na 2026 rok:
| Narzędzie | Darmowy plan | Płatny start od | Wymagana karta? | Najlepszy darmowy use case |
|---|---|---|---|---|
| Thunderbit Open API | 600 jednorazowych jednostek API | ok. 16 USD/mies. rocznie | Nie | Ekstrakcja danych webowych dla LLM, RAG, cen i researchu |
| Uptime Kuma | Bez limitu (self-host) | — | Nie | Pełny monitoring na własnym serwerze |
| UptimeRobot | 50 monitorów, interwał 5 min | ok. 7 USD/mies. | Nie | Podstawowe checki uptime |
| Better Stack | 10 monitorów, 1 strona statusu | ok. 29 USD/mies. | Nie | Uptime + status page dla startupu |
| Checkly | 10 uptime, 10 tys. testów API | ok. 24 USD/mies. | Tak | Syntetyczne testy API |
| Postman | Darmowe konto + limit monitoringu | ok. 14 USD/użytk./mies. | Nie | Ponowne użycie istniejących kolekcji |
| Prometheus + Grafana | Bez limitu (self-host) | — | Nie | Metryki + wizualizacja |
| Grafana Cloud | 100 tys. wykonań testów API/mies. | 29 USD/mies. + użycie | Sprawdź | Zarządzany trial synthetics |
| New Relic | 100 GB/mies., 1 pełny użytkownik | Per user + dane | W niektórych planach | APM + podstawowy observability |
| Datadog | Trial / zależnie od produktu | 15 USD/host/mies. (Infra Pro) | Często tak | Ewaluacja full-stack |
| Moesif | Dostępny free/trial | Na podstawie wolumenu | Sprawdź | Ewaluacja analityki API |
| Splunk | Dostępne triale | Wycena indywidualna | Proces sprzedażowy | Proof of concept dla enterprise |
| Gatus | Bez limitu (self-host) | — | Nie | Dashboard statusu oparty na YAML |
| Apitally | Dostępny free/trial | Sprawdź | Sprawdź | Lekka analityka API |
| Sematext | Trial/free zależnie od oferty | ok. 2 USD/monitor HTTP | Sprawdź | Tańsze synthetics/logi |
| Uptrace | Darmowy self-hosted | Ceny chmurowe różne | Sprawdź | Ewaluacja OTel APM |
Uwaga o ukrytych kosztach: narzędzia self-hosted (Uptime Kuma, Prometheus, Gatus) są „darmowe” w sensie licencji, ale mała VM-ka, backupy, czas na utrzymanie i zewnętrzny failover mogą szybko stać się realnym kosztem. W przypadku web data API ukryty koszt wygląda inaczej: utrzymanie headless browserów, psujących się selektorów, pul proxy, obejść anty-botowych i czyszczenia HTML.
Szacunek dla małego zespołu: przy 10 endpointach API i 3 osobach w zespole najtańsza ścieżka SaaS to zwykle darmowy lub tani UptimeRobot, Better Stack free/Team albo Checkly, jeśli wolumen uruchomień się zgadza. Datadog i New Relic mogą być niedrogie na etapie ewaluacji, ale końcowy rachunek zależy od hostów, użytkowników, logów, trace’ów i liczby uruchomień synthetics. Jeśli Twój projekt potrzebuje danych ze stron WWW w formie API, darmowe jednostki API Thunderbit wystarczą, żeby przetestować workflow przed wejściem na płatny plan.
Ocena złożoności wdrożenia: jak szybko do pierwszego alertu
Nie spotkałem artykułu konkurencji, który oceniałby time-to-value — czyli ile czasu mija od rejestracji do otrzymania pierwszego naprawdę sensownego alertu. Dla mniejszych zespołów to ważniejsze niż głębia funkcji.
| Narzędzie | Czas do pierwszego alertu | Wymagany poziom techniczny | Sposób konfiguracji |
|---|---|---|---|
| Thunderbit Open API | około 5–15 minut | Niski–średni | Klucz API, cURL/SDK/CLI |
| UptimeRobot | około 2–5 minut | Niski | GUI, kliknij i dodaj |
| Better Stack | około 5–10 minut | Niski | Kreator GUI |
| Checkly | około 10–20 minut | Niski–średni | Kod albo GUI |
| Postman | około 10 minut (gdy kolekcje już istnieją) | Niski–średni | Scheduler kolekcji |
| Uptime Kuma | około 5–30 minut | Średni | Docker + GUI |
| Gatus | około 15–45 minut | Średni | YAML + Docker |
| Datadog | około 15–30 minut | Średni | Instalacja agenta + GUI |
| New Relic | około 15–30 minut | Średni | Agent + prowadzone wdrożenie |
| Moesif | około 20–45 minut | Średni | Integracja SDK/proxy |
| Grafana Cloud Synthetics | około 15–45 minut | Średni | GUI, opcjonalnie Terraform |
| Prometheus + Grafana | 1–4 godziny | Średni–wysoki | YAML, PromQL |
| Uptrace | 30–90 minut | Średni–wysoki | Integracja OTel SDK |
| Splunk | od kilku godzin do kilku tygodni | Wysoki | Wdrożenie enterprise |
Jeśli monitoring ma działać jeszcze dziś, zacznij od górnej połowy tabeli. Jeśli celem jest trwały observability platform, zaplanuj osobny projekt dla dolnej połowy. A jeśli Twój pierwszy cel brzmi: „pobierz czyste dane z tych 100 stron WWW do aplikacji”, zacznij od Thunderbit, zanim zbudujesz własną infrastrukturę scrapingu.
Najlepsze narzędzia do monitorowania API w porównaniu: pełne zestawienie obok siebie
Jedna tabela do szybkiego przejrzenia przed podjęciem decyzji:
| Narzędzie | Najlepsze zastosowanie | Darmowy plan | Inteligencja alertów | Czas wdrożenia | Hosting | Najmocniejsza cecha |
|---|---|---|---|---|---|---|
| Thunderbit Open API | Ekstrakcja danych webowych / pipeline’y danych API | 600 jednostek API | Nie jest narzędziem alertowym | 5–15 min | Cloud | Zamiana stron na Markdown albo JSON oparty na schemacie |
| Datadog | Enterprise / SaaS full-stack | Trial / zależnie od produktu | Anomalia, forecast, AI | 15–30 min | Cloud | Koreluje synthetics z logami/trace’ami/infrastrukturą |
| Checkly | Synthetics dla developerów | Hojny, liczony po checkach | Retry, degradacja | 10–20 min | Cloud | Monitoring jako kod + Playwright |
| UptimeRobot | Prosty uptime | 50 monitorów | Podstawowe progi | 2–5 min | Cloud | Najszybszy tani monitor bazowy |
| Uptime Kuma | Darmowy self-hosted | Bez limitu | Podstawowy status/progi | 5–30 min | Self-hosted | Czysty interfejs, bez opłaty SaaS |
| Better Stack | Reakcja na incydenty / status pages | 10 monitorów | Eskalacje, routing | 5–10 min | Cloud | Monitoring + on-call + status page |
| Prometheus + Grafana | Open-source metrics stack | Bez limitu (self-host) | Grupowanie w Alertmanagerze | 1–4 godz. | Self-hosted/cloud | Głębokość ekosystemu PromQL |
| New Relic | SaaS APM + checki API | 100 GB/mies., 1 użytkownik | AI grouping, suppression flappingu | 15–30 min | Cloud | Świetny APM i synthetics razem |
| Moesif | Analityka API / metryki biznesowe | Free/trial | Anomalie behawioralne | 20–45 min | Cloud | Analityka zachowania API per klient |
| Splunk | Enterprise logi / compliance | Trial | Epizody ITSI, AIOps | Od kilku dni | Cloud/self-managed | Enterprise search logów i governance |
| Postman | Zespoły już testujące API | Darmowe konto | Podstawowe alerty monitoringu | 10 min | Cloud | Ponowne użycie kolekcji testów API |
Jak Thunderbit może przyspieszyć ocenę narzędzi API
Pełna transparentność: Thunderbit nie jest narzędziem do monitorowania API — to agentowy web scraper i Open API do zamieniania stron WWW na czysty Markdown albo ustrukturyzowany JSON. To sprawia, że przydaje się w innej części procesu wyboru narzędzia do monitoringu: przy zbieraniu cen, limitów planów, deklaracji funkcji, szczegółów dokumentacji i list integracji, zanim wybierzesz platformę.
Zamiast ręcznie otwierać ponad 10 stron cenników dostawców, kopiować nazwy planów, limity monitorów, interwały sprawdzania, integracje i wymagania dotyczące karty do arkusza, użyliśmy rozszerzenia Thunderbit do Chrome, aby wyciągnąć ustrukturyzowane dane ze stron z cennikiem i funkcjami każdego narzędzia. AI Thunderbit czyta każdą stronę i sugeruje pola — nazwę planu, szczegóły darmowego planu, cenę płatną, obsługiwane integracje — a następnie porządkuje wynik w arkuszu gotowym do eksportu.
Dla workflow deweloperskiego Thunderbit Open API daje dokładnie ten sam pomysł, tylko programowo. Użyj Distill, gdy chcesz czysty Markdown dla LLM-ów albo RAG. Użyj Extract, gdy potrzebujesz konkretnych pól zwróconych jako JSON. Użyj Batch, gdy chcesz przetworzyć listę stron z cennikiem, URL-i dokumentacji, stron produktów albo stron konkurencji i dostać wyniki asynchronicznie.
Workflow wygląda tak:
- Otwórz stronę z cennikiem dostawcy (Datadog, Checkly, UptimeRobot itd.)
- Kliknij „One Click Extract” — AI Thunderbit odczytuje stronę, rozpoznaje jej strukturę i w jednym przebiegu wypełnia tabelę
- Skorzystaj ze scrapingu podstron, aby pobrać strony cennika, funkcji i dokumentacji każdego dostawcy
- Wyeksportuj dane do Google Sheets, Excela, Airtable, Notion albo CSV
Dla zespołów API-first workflow przez API jest równie prosty:
- Pobierz darmowy klucz API z Thunderbit
- Wywołaj endpoint Distill, aby otrzymać czysty Markdown z dowolnej publicznej strony
- Wywołaj endpoint Extract z opisami schematu, aby dostać ustrukturyzowany JSON
- Użyj endpointów Batch i webhooków dla większych list URL-i
- Wyślij wynik do swojej aplikacji, arkusza, data warehouse, vector database albo workflow monitoringu
Przy porównaniu ponad 10 dostawców ręczne kopiuj-wklej potrafi zająć 2–3 godziny, jeśli uwzględnić podstrony z cenami, dokumentację i integracje. Thunderbit skrócił nam pierwszy przebieg ekstrakcji do około 15–30 minut, a resztę czasu pochłonęła weryfikacja i decyzje merytoryczne. Jeśli Twój zespół ops, procurement, researchu albo AI ocenia narzędzia pod presją czasu, to praktyczny skrót. Więcej o takim workflow znajdziesz w naszym poradniku web scraping bez kodowania, sprawdź cennik API Thunderbit albo odwiedź nasz kanał YouTube, gdzie pokazujemy to krok po kroku.
Jak wybrać najlepsze narzędzie do monitorowania API dla Twojego zespołu
„Najlepsze” narzędzie do monitorowania API zależy od wielkości zespołu, poziomu technicznego, budżetu i tego, jak wygląda awaria dla Twojego produktu.
Solo dev nie potrzebuje Splunka. Organizacja regulowana nie powinna polegać na skrypcie cron. Zespół produktowy API może bardziej potrzebować analityki klientów w stylu Moesif niż prostych pingów uptime. Zespół e-commerce powinien priorytetowo traktować krytyczne checki dla logowania, wyszukiwania, dodawania do koszyka, checkoutu i autoryzacji płatności. Zespół tworzący produkt AI lub data może najpierw potrzebować ekstrakcji danych webowych w stylu Thunderbit, zanim w ogóle będzie mu potrzebny pełny observability.
Trzy zasady, które utrzymywały się we wszystkich badaniach:
- Dopasuj narzędzie do scenariusza użycia. Tabela szybkiego wyboru nie jest przypadkowa — zacznij od niej.
- Priorytetyzuj jakość alertów ponad ich liczbę. Jeśli zespół ignoruje alerty, to nie masz monitoringu. Masz szum.
- Nie lekceważ szybkości wdrożenia. Monitor, który działa dziś i wysyła wiarygodne alerty, jest lepszy niż idealna platforma, która zostawia checkout bez nadzoru przez kolejny miesiąc.
Jeśli porównujesz kilka narzędzi równolegle i chcesz przyspieszyć research, przetestuj Thunderbit do hurtowego wyciągania danych dostawców do jednego arkusza. Jeśli budujesz produkt API, pipeline RAG, agenta AI albo workflow intelligence rynkowego, który potrzebuje czystych danych webowych, zacznij od Thunderbit Open API. Nie wybierze za Ciebie narzędzia do monitoringu — ale pomoże szybciej dojść do decyzji i może dać Twojemu własnemu produktowi niezawodną warstwę danych webowych.
FAQ o najlepszych narzędziach do monitorowania API
Jakie jest najlepsze darmowe narzędzie do monitorowania API w 2026 roku?
Jeśli zależy Ci na prostocie SaaS, UptimeRobot oferuje 50 darmowych monitorów z interwałem 5 minut i nie wymaga karty płatniczej. Jeśli wolisz self-hosting i pełną kontrolę, Uptime Kuma jest open-source, bez limitu i ma przejrzysty interfejs z ponad 90 usługami powiadomień. Dla zespołów, które chcą głębszych metryk i mają już kompetencje techniczne, Prometheus + Grafana + Alertmanager to najlepszy open-source stack — choć konfiguracja zajmie godziny, a nie minuty.
Jeśli Twoim celem nie jest monitoring uptime, tylko wyciąganie danych webowych przez API, Thunderbit Open API ma darmowy plan z 600 jednorazowymi jednostkami API, co wystarczy do przetestowania zamiany stron na Markdown albo ekstrakcji JSON opartej na schemacie, zanim zwiększysz skalę.
Jaka jest różnica między monitoringiem API a APM?
Monitoring API sprawdza z zewnątrz dostępność endpointu, czas odpowiedzi, błędy i poprawność — symuluje to, co widzi użytkownik albo integracja. APM (Application Performance Monitoring) zagląda głębiej do aplikacji: trace’y na poziomie kodu, zapytania do bazy, błędy runtime, opóźnienia kolejki i zależności usług. Narzędzia takie jak Datadog i New Relic oferują oba podejścia; UptimeRobot i Uptime Kuma skupiają się na zewnętrznych checkach dostępności.
Thunderbit Open API jest inne od obu tych kategorii: to API do ekstrakcji danych webowych. Pomaga zamieniać zewnętrzne strony WWW w Markdown albo ustrukturyzowany JSON, co jest przydatne w aplikacjach LLM, workflow badawczych, analizie cen i pipeline’ach danych.
Jak często powinienem monitorować swoje API?
Krytyczne dla przychodu API produkcyjne, takie jak checkout, auth i płatności, powinny być zwykle sprawdzane co 1 minutę. Wewnętrzne lub mniej obciążone API często wystarczy sprawdzać co 5 minut. Ale sama częstotliwość to nie wszystko — stosuj retry, wiele regionów i sensowne asercje, żeby każdy test był szybki i wiarygodny. Check co minutę, który generuje fałszywe alarmy, jest gorszy niż check co 5 minut, któremu można zaufać.
W workflow ekstrakcji danych webowych częstotliwość zależy od tego, jak często zmienia się źródło. Strony z cenami mogą wymagać codziennej albo tygodniowej ekstrakcji. Szybko zmieniające się dane o stanach magazynowych, podróżach czy marketplace’ach mogą potrzebować odświeżania co godzinę albo częściej. Batch API i webhooki Thunderbit są przydatne, gdy trzeba przetwarzać wiele URL-i według harmonogramu.
Czy mogę monitorować API bez pisania kodu?
Tak. UptimeRobot, Better Stack i Uptime Kuma można obsługiwać całkowicie przez GUI. Checkly wspiera zarówno GUI, jak i konfigurację kodem. Postman działa w oparciu o kolekcje. Prometheus/Grafana zwykle wymagają YAML i PromQL. Datadog i New Relic można zacząć przez prowadzone wdrożenie, ale stają się dużo mocniejsze przy głębszej instrumentacji.
Jeśli chcesz wyciągać dane ze stron WWW bez pisania kodu, Chrome Extension Thunderbit to ścieżka no-code. Jeśli chcesz zautomatyzować ten sam workflow z poziomu aplikacji, Thunderbit Open API daje developerom endpointy Distill, Extract i Batch.
Jak ograniczyć zmęczenie alertami przy monitoringu API?
Wybieraj narzędzia z inteligentnym alertowaniem: wykrywanie anomalii (Datadog, New Relic), retry przed wysłaniem alertu (Checkly), anomalie behawioralne (Moesif) albo grupowanie i wyciszanie (Prometheus Alertmanager). Zacznij od mniejszej liczby alertów o wyższym poziomie pewności, skupionych na wpływie na użytkownika. Używaj alertów burn-rate SLO zamiast statycznych progów, deduplikuj zdarzenia między usługami, routuj według właściciela i mierz użyteczność — jeśli mniej niż 20% alertów prowadzi do realnego działania, najpierw redukuj szum.
Wypróbuj Thunderbit Open API do ekstrakcji danych webowych Get Started Free
Dowiedz się więcej



