
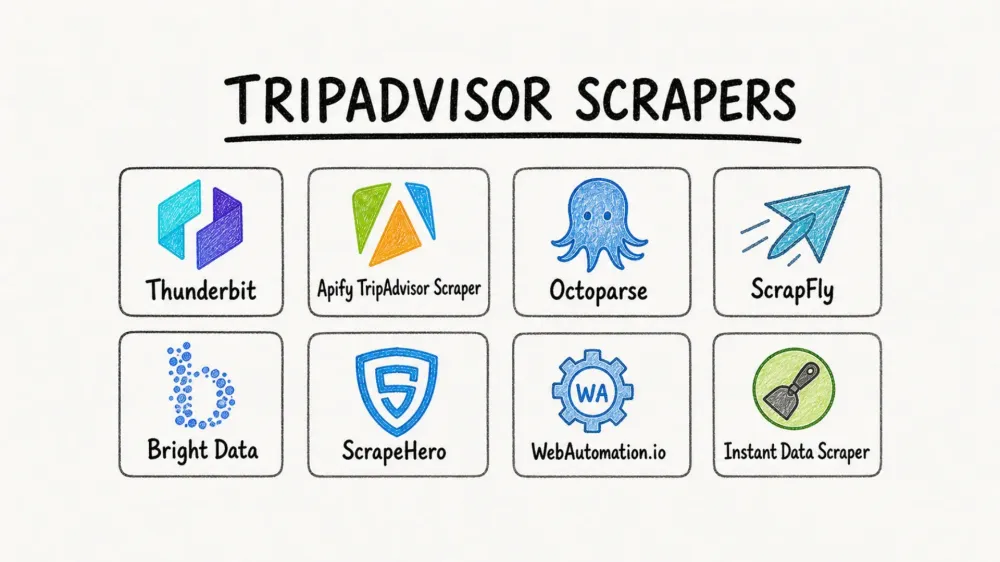
TripAdvisor bevat meer dan een miljard reviews verspreid over miljoenen vermeldingen — hotels, restaurants, attracties, tours — en bijna elk hospitalitybedrijf waarmee ik praat, wil iets met die data doen. Het probleem? TripAdvisor’s DataDome anti-botbeveiliging maakt het een van de lastigste websites op internet om te scrapen.
Ik heb jarenlang tools gebouwd bij Thunderbit waarmee niet-technische teams webdata kunnen ophalen zonder code te schrijven, en TripAdvisor is een van de sites waar onze gebruikers het vaakst naar vragen. De klachten zijn altijd hetzelfde: CAPTCHA’s die na twee pagina’s opduiken, scripts die ’s nachts breken, proxies die budgetten opslokken.
Daarom heb ik deze vergelijking samengesteld van 8 TripAdvisor-scrapers die in 2026 daadwerkelijk resultaat leveren — beoordeeld op gebruiksgemak, anti-botafhandeling, prijs, exportformaten en de datatypes die ze ondersteunen. Of je nu een salesmedewerker bent die een lijst met hotel-leads samenstelt of een data-analist die sentimentanalyse draait op 10.000 reviews, hier zit een tool tussen die past.
Probeer Thunderbit voor TripAdvisor-scraping
Waarom TripAdvisor-data scrapen in 2026?
TripAdvisor is niet alleen een reviewsite. Het is een gestructureerde database van de wereldwijde hospitalitysector, en de data die je er vindt is commercieel waardevol voor verrassend veel toepassingen.
Hotels tonen prijzen, beoordelingen, voorzieningen, kamertypes en categorie-subscores (schoonmaak, service, prijs-kwaliteit, slaapkwaliteit). Restaurants laten keukentype, prijsklasse, menu-items, openingstijden en tags voor maaltijdtypen zien. Attracties tonen ticketprijzen, bezoektips, geschatte duur en — steeds vaker — AI-gegenereerde reviewsamenvattingen die meningen groeperen onder aspectlabels.
In Tripadvisor’s eigen onderzoek onder hotelzoekers gaf 76% aan liever lange reviews te lezen bij het boeken van accommodaties, en het onderdeel van een review dat het belangrijkst was, was de inhoud — goed voor 40%. Dat betekent dat juist de tekst van de review — niet alleen de sterrenbeoordeling — de echte inzichten bevat.
Dit is in het kort waar verschillende teams TripAdvisor-data meestal voor willen gebruiken:
| Toepassing | Benodigde data |
|---|---|
| Concurrentieprijzen monitoren | Hotelprijzen, ratings, voorzieningen |
| Reputatiebewaking van merk | Reviewtekst, sentiment, subscores |
| Leadgeneratie (hospitality sales) | Bedrijfsnaam, e-mail, telefoon, adres |
| Marktonderzoek restaurants | Keukentype, prijsklasse, menu-items, reviews |
| Academisch/reisonderzoek | Attractieratings, bezoektips, ticketprijzen |
| Onderzoek voor marketingcopy | Echte klanttaal uit reviews |
De uitdaging is dat niet elke scraper TripAdvisor even goed aankan. De anti-botdefenses van de site zijn agressief genoeg dat veel tools stilletjes falen — ze leveren onvolledige data, worden na een paar pagina’s geblokkeerd of vereisen zoveel proxyconfiguratie dat de belofte van “no-code” verdwijnt.
Het DataDome-probleem: waarom TripAdvisor een van de moeilijkste sites is om te scrapen
Als je ooit TripAdvisor hebt geprobeerd te scrapen en na twee pagina’s een CAPTCHA-puzzel in beeld kreeg, dan heb je DataDome ontmoet — de anti-botdienst die TripAdvisor gebruikt om geautomatiseerde toegang te detecteren en blokkeren, en die doet zijn werk opvallend goed. Het kijkt niet alleen naar je IP-adres: het analyseert browserfingerprints (browserversie, schermgrootte, geïnstalleerde lettertypen), hardwarefingerprints (GPU- en CPU-kenmerken), hoe je JavaScript-uitdagingen beantwoordt en hoe je je gedraagt (hoe snel je scrolt, of je muis menselijk beweegt), met daarbovenop nog rate limiting. Een simpele Python-script met requests — of zelfs een headless browser — wordt vrijwel direct geblokkeerd.
Elke keer als iemand ons over TripAdvisor vraagt, komen twee vragen terug: waarom de blokkade zo snel optreedt, en of er een manier is om eromheen te werken zonder te betalen voor proxies en een solver.
Het eerlijke antwoord hangt af van de schaal. Voor een handvol pagina’s kan een Chrome-extensie die draait in je echte browsersessie de meeste detectie omzeilen, omdat het eruitziet als normaal gebruikersgedrag. Voor duizenden pagina’s heb je infrastructuur nodig — rotatieproxies, CAPTCHA-solvers of een tool die dit allemaal achter de schermen bundelt.
Zo vergelijken de 8 tools in dit artikel zich op anti-botafhandeling, plus een DIY Python-script ter referentie:
| Anti-botaanpak | Tools | Instelwerk | Doorlopende kosten |
|---|---|---|---|
| Ingebouwd (tool regelt het) | Thunderbit (Cloud), Apify, Bright Data, ScrapFly, ScrapeHero, WebAutomation.io | Laag | Inbegrepen in het plan |
| Ingebouwd, maar met verbruik | Octoparse | Gemiddeld | Standard dekt proxies en CAPTCHA-oplossing; na de extra credits van het plan kosten opwaarderingen $3/GB en $1–1,5 per 1.000 solves |
| Geen ingebouwde bescherming | Instant Data Scraper, DIY Python | Geen voor Instant Data Scraper, hoog voor DIY | $0 totdat je geblokkeerd wordt; DIY voegt proxies en CAPTCHA-solvers toe |
Thunderbit biedt hier specifiek twee modi. Cloud Scraping draait op Thunderbit’s servers met ingebouwde anti-botafhandeling voor publiek toegankelijke pagina’s. Browser Scraping draait in je eigen Chrome-sessie — omdat het een echte browser is met jouw cookies en loginstatus, kan het sommige detectie omzeilen die headless bots wel triggert. Voor de meeste TripAdvisor-toepassingen is Cloud-modus de snelste route.
Waar je op moet letten bij de beste TripAdvisor-scrapers
Voordat we in de tools duiken, eerst het beoordelingskader dat ik heb gebruikt. Dit zijn de criteria die er echt toe doen wanneer je een TripAdvisor-scraper kiest — niet marketingpraat, maar de factoren die bepalen of je bruikbare data krijgt of je een middag verspilt.
- Gebruiksgemak — No-code, low-code of volledige code nodig? Als je op een salesteam zit en morgen data in Google Sheets nodig hebt, kun je geen setup van vier uur veroorloven.
- TripAdvisor anti-botafhandeling — Kan de tool DataDome/CAPTCHA native aan, of moet je je eigen proxies en solvers meebrengen?
- Ondersteunde datatypes — Alleen hotels, of ook restaurants, attracties en tours? Veel tools ondersteunen alleen hotelpagina’s.
- Prijs & gratis tier — Wat kost het echt voor bijvoorbeeld 10.000 reviews? Zijn er gratis credits of een gratis laag?
- Exportformaten — CSV, JSON, Excel, Google Sheets, Airtable, Notion? Hoe minder stappen tussen scrapen en spreadsheet, hoe beter.
- Schaalbaarheid — Maximum aantal reviews of pagina’s per run, ondersteuning voor paginering en of de tool TripAdvisor’s
or10-achtige offsets voor reviewpagina’s aankan. - Subpagina-verrijking — Kan de tool links volgen vanaf een zoekresultatenpagina naar individuele hotel-/restaurantdetailpagina’s voor rijkere data?
- Beste voor — Welke gebruikersgroep bedient deze tool echt goed?
Als je een developer bent die een eigen pipeline bouwt, leg je meer gewicht bij API-flexibiliteit en anti-botinfrastructuur. Als je een zakelijke gebruiker bent die gewoon een spreadsheet wil, tellen exportopties en gebruiksgemak het zwaarst.
8 beste TripAdvisor-scrapers in één oogopslag
Hier staan alle 8 tools naast elkaar. De kolom met kosten geeft weer wat een maand met 10.000 reviews je in de praktijk kost op elke tool — de goedkoopste maandelijkse abonnementsoptie, nadat de gratis ruimte van de aanbieder al is verrekend; de rekensom achter elk bedrag staat verderop.
| Tool | Gebruiksgemak | Anti-botafhandeling | Datatypes | Maandelijkse kosten (10K reviews) | Exportformaten | Schaal | Subpagina-verrijking | Beste voor |
|---|---|---|---|---|---|---|---|---|
| Thunderbit | No-code (1 klik) | ✅ Ingebouwd (Cloud + Browser) | Hotels, restaurants, attracties, tours | €288 eenmalig (30K credits); Business bij maandelijkse inzet | Excel, CSV, Sheets, Airtable, Notion | 200 gepagineerde pagina’s en 2.000 URL’s per run (Pro) | ✅ 1 klik | Niet-technische teams, sales, operations |
| Apify | Low-code (platform-UI) | ✅ Ingebouwd | Hotels, reviews, restaurants, attracties | $29/mnd (Starter, via één actor) | JSON, CSV, Excel, XML, API | Hoog (cloud actors) | ⚠️ Afhankelijk van actor | Data-teams, developers |
| Octoparse | No-code (visuele builder) | ✅ Proxies + CAPTCHA-oplossing in plan | Hotels, reviews | $83/mnd (Standard; gefactureerd op tasks, niet op rijen) | CSV, Excel, JSON, DB | Cloud + lokale uitvoering | ⚠️ Workflow vereist | Liefhebbers van visuele scrapers |
| ScrapFly | Code (Python SDK/API) | ✅ Ingebouwde API | Elke TripAdvisor-pagina | $30/mnd (Discovery, 200K credits) | Ruwe HTML/JSON (gebruiker parseert zelf) | Hoog (API-gebaseerd) | Handmatige code | Python developers |
| Bright Data | Low-code tot code | ✅ Ingebouwd (400M+ proxies) | Hotels, reviews, datasets | $7,50 pay-as-you-go (na 5K gratis records) | CSV, JSON, API | Enterprise-niveau | ✅ Scraper IDE | Enterprise-teams |
| ScrapeHero | Geen setup (managed) | ✅ Volledig beheerd | Hotels, reviews, restaurants | Maatwerkofferte (per site, niet per rij) | CSV, JSON, Excel, API | Beheerde levering | ✅ Beheerd | Kopers die ontzorging willen |
| WebAutomation.io | No-code (vooraf gebouwd) | ✅ In elk plan inbegrepen | Hotels (focus op contactgegevens) | Vanaf $1 (1.000 credits, geen abonnement) | CSV, JSON, XML | Gemiddeld | ⚠️ Beperkt | Leadgeneratie (e-mails, telefoons) |
| Instant Data Scraper | No-code (1 klik) | ❌ Geen | Elke zichtbare tabel | $0 (geblokkeerd na een paar pagina’s) | CSV, Excel | Klein (enkele pagina’s) | ❌ Nee | Snelle eenmalige extractions |
Snelle conclusie: snelst voor niet-technische teams → Thunderbit. Beste voor review-extractie op grote schaal → Apify. Beste gratis optie voor kleine taken → Instant Data Scraper. Beste voor developers → ScrapFly. Beste voor enterprise → Bright Data. Beste voor volledig ontzorgde levering → ScrapeHero.
Nu de details.
1. Thunderbit — beste TripAdvisor-scraper voor niet-technische teams
 Thunderbit is de AI-gedreven Chrome-extensie die mijn team en ik hebben gebouwd om webscraping toegankelijk te maken voor mensen die geen code schrijven. Op TripAdvisor is de workflow echt één klik: open een hotel-, restaurant- of attractiepagina en start de extensie. De AI leest de pagina, bepaalt welke velden moeten worden opgehaald — hotelnaam, rating, prijs, aantal reviews, voorzieningen, alles wat de pagina toont — en begint met verzamelen. Wil je iets anders, zeg het in gewone taal en dan gebruikt hij dat. In beide gevallen kun je het gewoon laten draaien, en krijg je een tabel die je direct naar Google Sheets, Excel, Airtable of Notion kunt sturen.
Waar Thunderbit echt uitblinkt op TripAdvisor is subpagina-scraping. Stel dat je naar een zoekresultatenpagina kijkt met 30 hotels. Thunderbit kan de lijst scrapen en vervolgens automatisch elke hotel-link volgen om detailpagina-velden op te halen — volledige reviewtekst, voorzieningenlijsten, contactinformatie, prijsklassen, categorie-subscores — zonder extra instellingen. Je klikt één knop en krijgt verrijkte data voor elke vermelding.
Het werkt op dezelfde manier voor andere paginatypes. Op een restaurantpagina krijg je keukentype, prijsklasse, openingstijden en menu-items in plaats van hotelvoorzieningen; op een attractiepagina ticketprijzen, duur en bezoektips.
Er zijn geen categoriespecifieke templates die je hoeft te onderhouden — de AI leest gewoon wat er op de pagina staat. Een paar grenzen zijn goed om vooraf te weten: in Pro is een enkele run beperkt tot 200 gepagineerde pagina’s en 2.000 URL’s, elke rij kost een credit (twee als subpagina-scraping aan staat), en Cloud-modus werkt alleen op openbare pagina’s — alles achter een login moet in Browser-modus draaien, en dat is langzamer.
Heb je terugkerende data nodig? Thunderbit’s Scheduled Scraper draait wekelijks of maandelijks — precies wat kleine hospitalitybedrijven nodig hebben voor prijsmonitoring van concurrenten of reputatiebewaking.
Scrape TripAdvisor-data met AI Get Started Free
Belangrijkste functies
- Scraping met 1 klik — de AI benoemt de kolommen zelf, of jij zegt in één zin wat je wilt (past zich aan elk TripAdvisor-paginetype aan)
- Subpagina-verrijking met één klik — scrape een lijst en verrijk daarna elke detailpagina
- Cloud Scraping (snel, ingebouwde anti-botafhandeling) en Browser Scraping (gebruikt je echte Chrome-sessie)
- Gepland scrapen voor geautomatiseerde wekelijkse/maandelijkse monitoring
- Gratis export naar Excel, Google Sheets, Airtable, Notion, CSV, JSON
- Gratis e-mail- en telefoon-extractors voor leadgeneratie
- Ondersteunt 34 talen
Prijs
- Gratis tier: 6 pagina’s per maand (tot 30 credits per pagina)
- Op credits gebaseerde betaalde plannen: 1 credit per outputrij, 2 wanneer de rij uit een subpagina komt. Starter is $15/mnd voor 500 credits; Pro is $38/mnd voor 3.000 credits. Jaarlijkse facturering levert alle credits vooraf — $108/jaar voor 5.000 credits op Starter, $288/jaar ($24/mnd) voor 30.000 op Pro. Boven Pro is er geen grotere self-serve-laag; hogere volumes worden geoffreerd als Business. Zie Thunderbit Pricing voor actuele details.
Beste voor
- Sales- en operations-teams die TripAdvisor-data zonder code in een spreadsheet nodig hebben
- Kleine bedrijven die concurrentiereviews wekelijks volgen
- Marketingteams die echte klanttaal uit reviews halen voor advertentie- en landingspaginacopy
Probeer gratis de Thunderbit Chrome Extension om te zien hoe de 1-klik-flow werkt op je eigen TripAdvisor-pagina’s.
2. Apify TripAdvisor Scraper — beste voor extractie van reviews op grote schaal
 Apify is een cloudgebaseerd scrapingplatform met een marketplace vol kant-en-klare “Actors” — waaronder meerdere speciale TripAdvisor-actors. Met de populairste kun je TripAdvisor-URL’s of zoekopdrachten invoeren, parameters instellen (locatie, type plaats, aantal reviews), de actor starten en de resultaten downloaden als JSON, CSV of Excel.
Apify’s echte kracht is volume. Als je 10.000+ reviews nodig hebt voor een sentimentanalyseproject, zijn Apify’s actors daarop gebouwd. De API Ninja TripAdvisor actor kost ongeveer "$0,50 per 1.000 resultaten" voor hoteldata, terwijl de Crawler Bros actor "$2,00 per 1.000 resultaten" kost maar ook responses van eigenaren, nuttige stemmen en plaatsmetadata bevat. Beide verwerken anti-botmaatregelen en paginering.
De afweging: Apify vraagt wel enige vertrouwdheid met het platform. Het is geen Chrome-extensie — je werkt in een webdashboard, stelt actor-inputs in en wacht tot cloudruns klaar zijn.
Reserveer ongeveer tien minuten voor een eerste run: maak een account aan, kies een actor, plak je URL’s en wacht tot de cloudrun klaar is.
Belangrijkste functies
- Speciale TripAdvisor-Actors met vooraf gebouwde extractielogica
- Ondersteunt paginering en anti-botmaatregelen
- Schaalbaar voor grote datasets (10K+ reviews)
- API-toegang voor automatisering en integratie
- Ondersteunt hotels, reviews, restaurants en attracties (afhankelijk van actor)
Prijs
- Gratis plan: €5 platformgebruik per maand, daarna geen pay-as-you-go meer en geen Apify Store-korting
- Pay-per-result pricing: van ongeveer "$0,50/1.000 resultaten" (API Ninja) tot "$2,00/1.000 resultaten" (Crawler Bros) — beide tarieven vereisen een betaald plan: API Ninja rekent $0,50 op elk betaald plan, terwijl Crawler Bros $2,67 per 1.000 rekent op Starter en pas $2,00 haalt op de hoogste plannen
- Platformplannen vanaf "$29/mnd" (Starter) — die $29 is vooraf betaald verbruik om op te maken, geen extra fee erbovenop, en geeft je wel de Store-korting
Beste voor
- Data-teams die grootschalige reviewdatasets nodig hebben
- Developers die API-gestuurde extractie willen
- Sentimentanalyse- en NLP-projecten
3. Octoparse — beste no-code desktop scraper voor TripAdvisor
 Octoparse is een visuele, no-code desktop scrapingtool met een point-and-click workflow builder. Voor TripAdvisor biedt Octoparse vooraf gebouwde templates — je plakt een URL, laat auto-detect draaien, controleert de voorgestelde velden en exporteert. De TripAdvisor Hotel Reviews-template kost $0,8 per 1.000 regels.
De visuele workflow builder werkt goed als je meer controle wilt dan een Chrome-extensie, maar geen code wilt schrijven. Je kunt voorwaardelijke logica instellen, paginering afhandelen en cloudruns plannen. Er zijn wel twee aandachtspunten. Ten eerste kunnen de TripAdvisor-templates van Octoparse breken wanneer TripAdvisor de paginalay-out verandert — en dat gebeurt vaak. Ten tweede zijn de anti-blokkeringstools inbegrepen, maar het gebruik wordt wel gemeten: het Standard-plan dekt al IP-rotatie, residential proxies en automatische CAPTCHA-oplossing, dus je hoeft niets extra’s aan te schaffen voordat je begint — maar een zwaar DataDome-traject slokt proxybandbreedte en solves op, en boven wat het plan dekt worden die gefactureerd tegen $3/GB en $1–1,5 per 1.000.
Belangrijkste functies
- Point-and-click workflow builder
- Vooraf gebouwde TripAdvisor-templates
- Cloud- en lokale uitvoering
- Gepland scrapen
Prijs
- Gratis plan: 10 tasks, lokale extractie, 50.000 exportregels per maand
- Standard-plan: "$83/mnd bij maandelijkse facturering, of $69/mnd bij jaarlijkse facturering" — de TripAdvisor-template vereist deze laag. Octoparse’s prijspagina noemt een hogere Standard-prijs, $119/mnd, zodra je aangeeft dat je meerdere sites op een frequent schema wilt afdekken; één site blijft echter op $83/$69, hoe vaak je ook vernieuwt
- Templategebruik: "$0,8/1.000 regels" voor TripAdvisor hotelreviews
- Inbegrepen in Standard: IP-rotatie, residential proxies, automatische CAPTCHA-oplossing, plus een maandelijkse add-on credit waarop premium templates, proxies en CAPTCHA-solves allemaal teren — Octoparse publiceert niet hoe groot die credit is. Boven wat het plan dekt, kosten opwaarderingen $3/GB en $1–1,5 per 1.000 solves
Beste voor
- Gebruikers die een visuele scraper willen met meer controle dan een Chrome-extensie
- Teams die meerdere reissites scrapen, niet alleen TripAdvisor
4. ScrapFly — beste TripAdvisor-scraper voor Python developers
 ScrapFly is een webscraping API en SDK voor developers. Je verstuurt HTTP-verzoeken via de infrastructuur van ScrapFly, en die regelt anti-botomzeiling, JavaScript-rendering en proxyrotatie voor je. ScrapFly heeft gedetailleerde TripAdvisor-specifieke tutorials en codevoorbeelden, wat een fijne plus is.
De developer-workflow is rechttoe rechtaan: gebruik ScrapFly’s Python SDK (of gewoon httpx/requests) om TripAdvisor-pagina’s op te halen, terwijl de backend van ScrapFly DataDome, CAPTCHA’s en rendering afhandelt. Je krijgt ruwe HTML of JSON terug en schrijft je eigen parslogica om de velden te extraheren die je nodig hebt.
Wil je fijne controle — aangepaste veldextractie, complexe pagineringslogica, integratie met je eigen datapipeline — dan levert ScrapFly. Maar het is niet bedoeld voor niet-technische gebruikers.
Er is geen visuele interface en geen kant-en-klare export naar een spreadsheet, en de 1.000 gratis credits die je bij aanmelding krijgt, dekken ongeveer 200 TripAdvisor-pagina’s mét anti-botomzeiling — genoeg om te prototypen, niet genoeg om een echte job te draaien.
Belangrijkste functies
- API voor anti-botomzeiling (verwerkt DataDome, CAPTCHA’s)
- JavaScript-rendering
- Ingebouwde roterende proxies
- TripAdvisor-tutorial en codevoorbeelden
Prijs
- Gratis tier: 1.000 credits bij aanmelding, geen creditcard, geen vervaldatum
- Credits worden per request afgerekend: 1 voor een gewone datacenter-fetch, 5 met JavaScript-rendering of anti-botomzeiling, 25 met residential proxies
- Discovery is $30/mnd voor 200.000 vooraf betaalde credits; Pro is $100/mnd voor 1.000.000
Beste voor
- Python developers die aangepaste TripAdvisor-scrapers bouwen
- Teams die zeer precieze controle over de extractielogica nodig hebben
5. Bright Data — beste TripAdvisor-scraper voor enterprise-schaal
 Bright Data is de full-stack optie. Het biedt een Web Scraper IDE voor het bouwen van aangepaste scrapers, kant-en-klare TripAdvisor-datasets en het grootste proxy-netwerk in de sector — 400M+ IP’s verspreid over residential, datacenter- en mobiele categorieën. Ingebouwde CAPTCHA-oplossing is inbegrepen.
Bright Data’s TripAdvisor scraping-gids laat zien hoe je Selenium gebruikt met hun beheerde browserinfrastructuur, gericht op TripAdvisor-zoek-URL’s met parameters zoals q, geo, ssrc en offset. De gids behandelt ook de bekende blokkadeproblemen: JavaScript-challenges, browser fingerprinting en dynamische content.
De afweging is complexiteit, niet prijs. Bright Data’s Web Scraper API kost $1,5/1.000 records pay-as-you-go zonder verplicht plan, wat 10.000 reviews op $15 zet — in de praktijk $7,50, omdat een nieuw account maandelijks 5.000 gratis records krijgt en die eerst worden verbruikt. Het dure deel is het werk eromheen: je kiest een kant-en-klare dataset of koppelt de Scraper IDE aan elkaar, niet gewoon een knop indrukken. En het $499/mnd Scale-plan (384.000 records inbegrepen) verdient zichzelf pas terug wanneer je boven ongeveer 338.000 records per maand zit — enterprise-territorium, waar dezelfde pipeline ook Booking.com en Google Maps ophaalt.
Belangrijkste functies
- Web Scraper IDE (visueel + code)
- 400M+ residential en datacenter proxies
- Kant-en-klare TripAdvisor-datasets
- Ingebouwde CAPTCHA- en anti-botafhandeling
- Compliance op enterprise-niveau
Prijs
- Gratis tier: 5.000 records per maand, maandelijks vernieuwd en eerst verbruikt voordat iets betaald wordt
- Web Scraper API: $1,5/1.000 records PAYG
- Scale-plan: $499/mnd voor 384.000 records
- Maatwerk enterprise-prijzen
Beste voor
- Enterprise-teams die TripAdvisor-data op enorme schaal nodig hebben
- Bedrijven die compliance-proof dataverzameling vereisen
- Cross-platform aggregatie (TripAdvisor + Booking.com + Google Maps)
6. ScrapeHero — beste managed TripAdvisor-scrapingservice
 ScrapeHero is een volledig beheerde scrapingservice. Jij geeft aan welke TripAdvisor-data je nodig hebt — hotels in een regio, reviews voor een set accommodaties, restaurantvermeldingen in een stad — en ScrapeHero bouwt, draait en onderhoudt de scraper voor je. Ze leveren schone, gestructureerde data volgens jouw planning.
Dit is de optie voor wie absoluut niets met een tool wil doen. ScrapeHero regelt anti-botmaatregelen, proxies, onderhoud en dataformattering — jij krijgt levering via CSV, JSON, Excel of API.
Het nadeel is de prijs. Managed services zijn aanzienlijk duurder dan self-service tools, en de doorlooptijd voor maatwerkverzoeken kan een bottleneck zijn.
Belangrijkste functies
- Volledig beheerd scrapen (geen setup door gebruiker)
- Aangepaste dataleveringsschema’s
- Regelt anti-bot, proxies en onderhoud
- Gestructureerde data-output (CSV, JSON, Excel, API)
Prijs
- Maatwerkprijzen op basis van datavolume en complexiteit — de prijspagina noemt de gepubliceerde bedragen een basislijn, geen offerte
- On Demand start vanaf $550 per site per refresh, setup inbegrepen, zonder abonnement
- Business start vanaf $199/mnd per site, met daarbovenop een eenmalige setupfee; beide niveaus zijn bedoeld voor 1–5K pagina’s per site per maand
Beste voor
- Bedrijven die TripAdvisor-data geleverd willen krijgen zonder zelf een tool te beheren
- Organisaties die doorlopende, betrouwbare datastromen voor hospitality intelligence nodig hebben
7. WebAutomation.io — beste voor het extraheren van TripAdvisor-contactgegevens
 WebAutomation.io is een no-code scrapingplatform met vooraf gebouwde TripAdvisor-extractors die focussen op contactgegevens: hotelnamen, adressen, voorzieningen, e-mails, telefoonnummers, prijzen, reviews en ratings. De workflow is eenvoudig — kies de TripAdvisor-extractor, voer URL’s in, start de scrape en download de data.
De kracht van WebAutomation.io zit in de focus op leadgeneratie-velden. Als je een hospitality sales team bent en je primaire doel is een contactlijst opbouwen — namen, e-mails, telefoonnummers, adressen — dan is deze tool hier speciaal voor gemaakt. Het is minder flexibel dan Thunderbit of Octoparse voor algemeen scrapen, maar voor het specifieke gebruiksdoel van contactinformatie uit TripAdvisor-vermeldingen werkt het prima.
Belangrijkste functies
- Vooraf gebouwde TripAdvisor-extractor
- Extraheert contactgegevens (e-mail, telefoon, adres)
- Geen code vereist
- Gepland scrapen beschikbaar
Prijs
- Gratis proef om mee te testen — de plankaart adverteert met 10M credits en de FAQ op dezelfde pagina zegt 500, dus zie het als een proef, niet als volumelaag
- Project is $99/mnd voor 400.000 credits, daarna Start-Up $249, Business $449, Corporate $999; één credit is één geslaagde pagina-extractie, en opwaarderingen zonder abonnement beginnen bij $1 per 1.000 credits
Beste voor
- Sales teams die hotel-/restaurantcontactinformatie extraheren voor outreach
- Leadgeneratie vanuit TripAdvisor-vermeldingen
8. Instant Data Scraper — beste gratis TripAdvisor-scraper voor snelle klussen
 Instant Data Scraper is een gratis Chrome-extensie die automatisch datatabellen op elke webpagina detecteert en je met één klik laat exporteren. Ga naar een TripAdvisor-pagina, klik op het extensie-icoon, de tool herkent de datatabel en je exporteert naar CSV of Excel. Geen account, geen setup, geen kosten.
Ik vind Instant Data Scraper goed voor wat het is: een snelle, gratis manier om een kleine hoeveelheid data op te halen. Als je de top 10 hotels op een zoekresultatenpagina nodig hebt of een handvol reviews voor een snelle analyse, werkt het. Maar er is totaal geen anti-botafhandeling. Na een paar pagina’s blokkeert TripAdvisor’s DataDome je. Er is geen subpagina-verrijking, geen planning, geen AI-aanpassing aan paginawijzigingen en geen mogelijkheid om verder te schalen dan wat zichtbaar is op één enkele paginalading.
Belangrijkste functies
- Gratis Chrome-extensie
- Detecteert automatisch datatabellen
- Eén-klik export naar CSV/Excel
- Geen account of setup nodig
Prijs
- Volledig gratis
Beste voor
- Snelle, eenmalige data-ophaling (een paar pagina’s hotelvermeldingen)
- Academische onderzoekers of studenten zonder budget
- Gebruikers die gewoon een kleine steekproef van TripAdvisor-data nodig hebben
Verder dan hotels: TripAdvisor-restaurants, attracties en tours scrapen
De meeste TripAdvisor-scrapinggidsen stoppen bij hotels.
Maar restaurants en attracties vormen een groot deel van TripAdvisor’s vermeldingen. De data op die pagina’s is net zo waardevol — en voor sommige toepassingen misschien zelfs waardevoller.
Restaurantpagina’s tonen keukentype, prijsklasse, menu-items, maaltijdtypen, kenmerken, openingstijden, adres, telefoon, website en review-subscores voor prijs-kwaliteit, service, eten en sfeer. Attractiepagina’s laten ticketprijzen, openingstijden, geschatte duur, bezoektips en TripAdvisor’s nieuwe AI-gegenereerde reviewsamenvattingen zien met aspectlabels als “Sfeer”, “Duur”, “Beste moment” en “Prijs-kwaliteit”. Tourpagina’s gaan nog verder met routes, groepsgroottes, talen van de gids, inbegrepen onderdelen en productcodes.
Template-gebaseerde scrapers ondersteunen vaak alleen hotel-URL’s. Plak je een restaurant- of attractie-URL in een tool die rond hotelstructuren is gebouwd, dan krijg je kapotte of onvolledige data.
Hier hebben AI-gedreven tools een voordeel. Thunderbit werkt op basis van elke pagina die je open hebt, dus dezelfde extensie die een hotelvermelding aankan, werkt ook voor een restaurantpagina of een attractiepagina. Je hoeft niet te wachten tot een leverancier voor elke categorie een template uitbrengt.
Dat is ook relevant voor onderzoek naar marketingcopy. Reviews van restaurants en attracties staan vol met de exacte woorden die mensen gebruiken om een dinerervaring of museumbezoek te beschrijven. Als je in hospitality marketing zit, wil je juist die taal in je advertenties, landingspagina’s en e-mailcampagnes.
Hoeveel kost TripAdvisor-scraping nu echt?
Kosten zijn de vraag die ik het vaakst hoor: kun je dit doen zonder te betalen voor proxies en CAPTCHA-solvers? Hier is een realistische uitsplitsing voor het scrapen van 10.000 hotelreviews, een veelgebruikte benchmark.
Eerst een normalisatie-opmerking: TripAdvisor toont momenteel 10 reviews per pagina op hoteldetailpagina’s, dus 10.000 reviews ≈ 1.000 reviewpagina’s. Tools die per pagina afrekenen versus per rij hebben heel verschillende kostenprofielen, dus de tweede kolom hieronder laat zien wat je kaart in een maand op dit volume werkelijk belast: gratis maandelijkse ruimte al afgetrokken, en het goedkoopste maandplan van de aanbieder. Verschillende van deze aanbieders zijn goedkoper als je een jaar vooruitbetaalt, maar een jaarlijkse vooruitbetaling is geen maandelijkse rekening, dus die blijft buiten de kolom. Add-ons — proxies, solvers, ontwikkeltijd — blijven buiten het bedrag en worden uitgelegd in de kolom ernaast.
| Tool | Werkelijke maandrekening (10K reviews) | Hoe het wordt afgerekend, wat wordt afgetrokken | Setup & onderhoud |
|---|---|---|---|
| Thunderbit | $288 eenmalig (Business bij maandelijkse inzet) | Reviews die van een detailpagina worden gehaald, tellen als subpaginarijen, dus ze kosten 2 credits per stuk — 10.000 reviews is 20.000 credits. Jaarlijks Pro pre-paid 30.000 credits voor $288, wat een eenmalige run van deze omvang dekt. Doe je dit elke maand, dan zit je boven wat de self-serve-plannen dragen (Pro is 3.000 credits per maand), dus dan wordt het een Business-offerte. De gratis tier, 6 pagina’s per maand, stapelt niet op een betaald plan. Een run stopt bij 200 gepagineerde pagina’s, dus dit zijn vijf runs voor dezelfde credits. | 5 min; laag — de AI leest de pagina opnieuw per run |
| Apify (API Ninja actor) | $29/mnd | De Store-korting van Apify begint op Starter, dus het tarief van "$0,50 per 1.000 resultaten" is een betaaldplantarief — op het gratis plan factureert dezelfde actor tien keer zoveel, en de gratis $5 dekt ongeveer duizend resultaten zonder pay-as-you-go om je verder te helpen. In tegenstelling tot Crawler Bros hieronder rekent deze actor op elk betaald plan hetzelfde tarief van $0,50, dus Starter betaalt het headline-tarief: 10.000 resultaten kosten $5,00 binnen de al vooraf betaalde $29, dus de rekening is $29. | 10 min; laag |
| Apify (Crawler Bros actor) | $29/mnd | Zelfde $29-plan, maar meer ervan wordt verbruikt. Deze actor prijst per planlaag: Starter betaalt $2,67 per 1.000, dus 10.000 resultaten komen uit op $26,70 — nog steeds binnen de vooraf betaalde $29. Het headline-tarief van "$2,00 per 1.000" is wat de topplannen betalen. | 10 min; laag |
| Instant Data Scraper | $0 | Gratis extensie, geen account, geen ruimte om af te trekken — en ook geen manier om de klus af te maken: DataDome blokkeert het na een paar pagina’s. | 2 min; niets te onderhouden |
| Octoparse | $83/mnd | Wordt afgerekend op tasks en cloudconcurrency, niet op rijen, dus het volume bepaalt geen andere laag — de template wel, en die heeft Standard: $83/mnd, of $69/mnd bij jaarlijkse facturering nodig. Eén site blijft op die $83/$69-prijs, hoe vaak je ook vernieuwt. Template-regels kosten "$0,8/1.000", residential proxies kosten $3/GB en CAPTCHA-solves zijn add-ons die betaald worden uit de maandelijkse add-on credit die het plan bevat, maar Octoparse publiceert de omvang van die credit niet. | 30 min; gemiddeld — templates breken als TripAdvisor dingen verplaatst |
| ScrapFly | $30/mnd | TripAdvisor heeft anti-botomzeiling aan staan nodig, en dat kost 5 credits per request, dus 1.000 reviewpagina’s = 5.000 credits. De 1.000 signup-credits zijn eenmalig en dekken ongeveer 200 pagina’s, dus de job draait op Discovery: $30/mnd voor 200.000 vooraf betaalde credits. Quota is hier nooit de beperkende factor — de planprijs is de hele rekening. | 1–2 uur code; gemiddeld — jij bent verantwoordelijk voor de parser |
| Bright Data | $7,50 | Een record is één rij, dus 10.000 reviews = 10.000 records = $15 bij "$1,50/1.000 pay-as-you-go". Een nieuw account krijgt 5.000 gratis records per maand, die eerst worden verbruikt voordat iets betaald wordt, waardoor het bedrag halveert. Geen plan om te kopen, geen minimumverplichting. | 30 min; gemiddeld |
| ScrapeHero | Maatwerkofferte | Wordt per site en per refresh geoffreerd, niet per rij, en de prijspagina noemt de eigen bedragen een basislijn, geen prijs. De minima zijn $550 per site per refresh (On Demand) of $199/mnd per site plus een eenmalige setupfee (Business) — beide bedoeld voor 1–5K pagina’s per site, de band waar 1.000 reviewpagina’s in vallen. | Geen — zij bouwen en draaien het; geen |
| WebAutomation.io | Vanaf $1 | Eén credit is één geslaagde pagina-extractie, dus 1.000 reviewpagina’s zijn ongeveer 1.000 credits, meer wanneer een pagina meerdere verzoeken of JavaScript-rendering nodig heeft. Opwaarderingen hebben geen abonnement nodig en beginnen bij $1 per 1.000 credits; het goedkoopste abonnement, Project voor $99/mnd, koopt 400.000 credits die je hier nooit zou gebruiken. Het gratis plan spreekt zichzelf op de pagina tegen — 10M credits op de kaart, 500 in de FAQ — dus er wordt niets afgetrokken. | No-code, vooraf gebouwde extractor; laag — de leverancier onderhoudt het |
| DIY Python + proxies | Gemeten per gigabyte en per solve | De rekening bestaat uit residential bandbreedte, ongeveer $3/GB — wat Octoparse voor dezelfde add-on rekent — plus $1–1,5 per 1.000 CAPTCHA-solves. Dat omzetten naar een maandbedrag vereist een megabytes-per-reviewpagina-getal dat ik niet goed kan onderbouwen, dus er is geen eerlijk enkel bedrag om hier te zetten. Ontwikkeltijd komt daar nog bovenop. | 4–8 uur; hoog — de code breekt |
De kostenpost die de meeste mensen missen is onderhoud. DIY Python-scrapers breken wanneer TripAdvisor zijn GraphQL-query-IDs verandert, DataDome bijwerkt of paginamodules verschuift. Ik heb teams meer tijd zien besteden aan het debuggen van kapotte scrapers dan aan het bouwen ervan. AI-gedreven tools zoals Thunderbit lezen de pagina opnieuw bij elke run, dus een lay-outwijziging betekent meestal geen werk voor jou — dat maakt je niet immuun voor blokkades, maar je hoeft selectors niet opnieuw te schrijven telkens als TripAdvisor iets verschuift.
Er zijn wel gratis routes, en elk daarvan stopt ergens. Thunderbit’s e-mail- en telefoon-extractors zijn gratis, maar de gratis tier is 6 pagina’s per maand. Apify’s gratis plan geeft je $5 platformgebruik. Instant Data Scraper is gratis en blijft werken totdat DataDome je opmerkt.
Welke TripAdvisor-scraper past bij jouw use case?
Verschillende workflows vragen om verschillende tools. Hier is een beslismatrix op basis van de use cases die ik het vaakst van onze gebruikers hoor:
| Use case | Beste tool(s) | Waarom |
|---|---|---|
| Snelle export van hotelreviews (1 object) | Thunderbit, Instant Data Scraper | 1 klik, geen setup |
| Sentimentanalyse op schaal (10K+ reviews) | Apify, Bright Data | Gebouwd voor volume + API-output |
| Wekelijkse concurrentiemonitoring | Thunderbit (Scheduled Scraper), Apify | Automatische planning |
| Academisch onderzoek (kleine steekproef, geen budget) | Instant Data Scraper, Thunderbit gratis tier | Gratis — en klein: 6 pagina’s per maand op de gratis tier, en Instant Data Scraper stopt zodra DataDome het merkt |
| Cross-platform aggregatie (TA + Booking + Google) | Thunderbit, Bright Data | Multi-site ondersteuning |
| Hospitality leadgeneratie (e-mails, telefoons) | Thunderbit, WebAutomation.io | Extractie van contactgegevens |
| Aangepaste datapipeline (developer) | ScrapFly, Apify | API-first, diepe aanpasbaarheid |
| Volledig ontzorgde datalevering | ScrapeHero | Volledig beheerd |
Een vraag die in forums vaak terugkomt: kun je AI-codeassistenten zoals ChatGPT of Claude gebruiken om TripAdvisor-scrapers te schrijven? In theorie kan een AI een Python-script genereren. In de praktijk breken die scripts op TripAdvisor vrijwel direct, omdat DataDome generieke browserautomatisering verslaat. Een AI-gedreven scrapingtool zoals Thunderbit is fundamenteel anders dan een AI code-assistent — Thunderbit draait in een echte browseromgeving met ingebouwde anti-botafhandeling, terwijl een door ChatGPT gegenereerd script draait in een kale headless browser die DataDome meteen blokkeert.
Als twee tools op die matrix even goed lijken, laat dan het einddoel beslissen: een spreadsheet die iemand morgen opent, of een pipeline die zonder toezicht moet blijven draaien.
No-code vs. code: het voordeel van de 1-klik Chrome-extensie
Het verschil tussen een Chrome-extensie en een Python-script is enorm voor niet-technische gebruikers. Zo vergelijken de drie belangrijkste aanpakken zich bij een eerste TripAdvisor-scrapingtaak:
| Factor | Chrome-extensie (Thunderbit) | No-code platform (Octoparse) | Python DIY |
|---|---|---|---|
| Tijd tot eerste resultaat | ~2 minuten | ~15–30 minuten | ~2–4 uur |
| Codering vereist | Geen | Geen | Intermediaire Python |
| Omgaat met lay-outwijzigingen | ✅ AI leest de pagina bij elke run opnieuw | ⚠️ Opgeslagen template past niet meer bij de pagina | ❌ Handmatige fix nodig |
| Subpagina-verrijking | ✅ 1 klik | ⚠️ Workflow-instelling nodig | Handmatige code |
| Anti-botafhandeling | Ingebouwd (Cloud-modus) | Inbegrepen in Standard-plan | Zelf proxies + CAPTCHA regelen |
Hier is de mini-handleiding voor Thunderbit op TripAdvisor:
- Ga in Chrome naar een TripAdvisor-pagina (hotelvermelding, restaurant, attractie)
- Klik één keer op het Thunderbit-extensie-icoon
- Thunderbit zet de pagina om in kolommen (hotelnaam, rating, prijs, aantal reviews, enz.)
- Het begint vanzelf met ophalen — als een kolom niet is wat je wilde, pas hem aan en draai opnieuw
- Voor rijkere data ga je een niveau dieper — Thunderbit volgt elke vermelding-link om detailpagina-velden op te halen (voorzieningen, volledige reviews, contactinformatie)
- Exporteer direct naar Google Sheets, Excel, Airtable of Notion
Het hele proces duurt ongeveer twee minuten voor een lijstpagina, en de AI handelt paginering automatisch af. Geen selectors configureren, geen XPath-debugging, geen proxies roteren.
Tips voor verantwoord TripAdvisor-scraping
Een paar basisregels om dit op een verantwoorde manier te doen:
- Scrape alleen publiek beschikbare data. Log niet in om privé- of afgeschermde content te scrapen.
- Respecteer rate limits. Als je code-gebaseerde tools gebruikt, voeg dan vertraging tussen verzoeken toe. Tools zoals Thunderbit en Apify regelen dit automatisch.
- Sla geen persoonlijke gegevens onnodig op. Namen van reviewers uit openbare reviews zijn één ding; e-mailadressen uit reviews scrapen en opslaan is iets anders.
- Gebruik data voor legitieme zakelijke doeleinden — concurrentieanalyse, marktonderzoek, leadgeneratie, academisch onderzoek.
- Wees je bewust van TripAdvisor’s gebruiksvoorwaarden rond geautomatiseerde toegang. De juridische context rond webscraping blijft zich ontwikkelen (GDPR, CCPA, platformbeleid), dus blijf op de hoogte.
Voor een diepere duik in de juridische kant, zie ons artikel over juridische implicaties van webscraping.
De beste TripAdvisor-scraper voor jouw behoeften kiezen
De korte versie:
- Thunderbit is de snelste route van een TripAdvisor-pagina naar een bruikbare spreadsheet. Eén klik, geen code, AI die zich aanpast aan hotels, restaurants, attracties en tours. Het beste voor sales-, operations- en marketingteams die nu data nodig hebben.
- Apify is de beste waarde voor reviewextractie op grote schaal als je comfortabel bent met een cloudplatform. Uitstekend voor sentimentanalyse en data science-projecten.
- Instant Data Scraper is de beste gratis optie voor een kleine steekproef — verwacht alleen niet dat het verder schaalt dan een paar pagina’s.
- Octoparse is sterk voor gebruikers die een visuele workflow builder met meer controle willen; proxies en CAPTCHA-oplossing zitten in het plan, dus waar je budget aan opgaat is template-onderhoud en opwaarderingen als je volume de ruimte overstijgt.
- ScrapFly is de keuze van developers — veel maatwerk, sterke anti-bot API, maar je schrijft en onderhoudt zelf je parsingcode.
- Bright Data is gebouwd voor enterprise-schaal, cross-platform dataverzameling met het grootste proxy-netwerk in de sector. Voor kleine teams vaak overkill.
- ScrapeHero is de ontzorgde optie — dien je wensen in, krijg schone data geleverd.
- WebAutomation.io is een nichekeuze voor hospitality leadgeneratie, gericht op het extraheren van contactgegevens uit TripAdvisor-vermeldingen.
Als je wilt zien hoe modern TripAdvisor-scraping eruitziet zonder één regel code te schrijven, begin dan met Thunderbit’s gratis tier en test het op je eigen TripAdvisor-pagina. Ik denk dat je verbaasd zult zijn hoe snel je van “ik heb deze data nodig” naar “het staat al in mijn spreadsheet” gaat.
Welke tool je ook kiest, test hem eerst op één pagina voordat je je vastlegt op een plan — je weet binnen twee minuten of hij DataDome passeert op de pagina’s die er echt toe doen.
Probeer AI TripAdvisor-scraping met Thunderbit Get Started Free
Veelgestelde vragen
Is het legaal om TripAdvisor te scrapen?
Het scrapen van publiek beschikbare data wordt in veel rechtsgebieden doorgaans als legaal beschouwd, maar je moet wel TripAdvisor’s gebruiksvoorwaarden respecteren, privé- of afgeschermde content vermijden en voldoen aan privacyregels zoals GDPR en CCPA. De juridische context verandert, dus het is verstandig om op de hoogte te blijven. Voor meer context, bekijk onze gids over juridische implicaties van webscraping.
Waarom blokkeert TripAdvisor mijn scraper zo snel?
Omdat DataDome niet alleen het IP, maar ook de browser en het gedrag profileert — dus je script langzamer maken of een nieuw adres gebruiken helpt weinig zodra je setup is gefingerprinted. Twee dingen helpen wel: draaien vanuit een echte Chrome-sessie die je al gebruikt, zodat het eruitziet als een persoon die browst, of betalen voor infrastructuur die fingerprints en CAPTCHA’s voor je afhandelt — Apify, Bright Data en ScrapFly bundelen allemaal proxies en solving, en Thunderbit’s Cloud-modus doet dit op zijn eigen servers.
Kan ik TripAdvisor-restaurants en attracties scrapen, niet alleen hotels?
Ja, maar niet alle tools ondersteunen niet-hotelpagina’s. Template-gebaseerde scrapers werken soms alleen met hotel-URL’s. AI-gedreven tools zoals Thunderbit passen zich aan elk TripAdvisor-paginetype aan — restaurants, attracties, tours — omdat ze de pagina-structuur dynamisch lezen in plaats van op vaste templates te vertrouwen. Restaurants, attracties en tours vormen een groot deel van wat er op TripAdvisor staat, dus er is buiten hotels genoeg data te vinden.
Is er een volledig gratis TripAdvisor-scraper?
Instant Data Scraper is 100% gratis en werkt voor kleine, snelle klussen (een paar pagina’s met vermeldingen). Thunderbit biedt een gratis tier met 6 pagina’s, en Apify’s gratis plan bevat $5 platformgebruik per maand. Voor alles buiten een kleine steekproef heb je waarschijnlijk een betaalde tool nodig — maar je kunt absoluut op $0 beginnen om te testen of een tool bij je workflow past.
Kan ik TripAdvisor-reviews scrapen zonder te coderen?
Absoluut. Thunderbit vereist maar 1 klik — open een TripAdvisor-pagina, start de extensie, en de AI neemt het over: hij kiest de kolommen, voert de extractie uit en laat je met een afgeronde tabel achter om te exporteren. Wil je specifieke velden? Zeg het gewoon, dan bouwt hij de tabel daaromheen. Octoparse en WebAutomation.io bieden ook no-code interfaces, al vragen die meer insteltijd. Voor een stap-voor-stap walkthrough, bekijk onze TripAdvisor scraper template of bekijk tutorials op het Thunderbit YouTube-kanaal. Meer lezen



