
בכל פעם שאתם מסנכרנים CRM, מושכים עדכוני משלוחים או מחברים בין שני כלי SaaS, מאחורי הקלעים עובד REST API ועושה את העבודה הכבדה. רוב האנשים בכלל לא חושבים עליו — עד שמשהו נשבר.
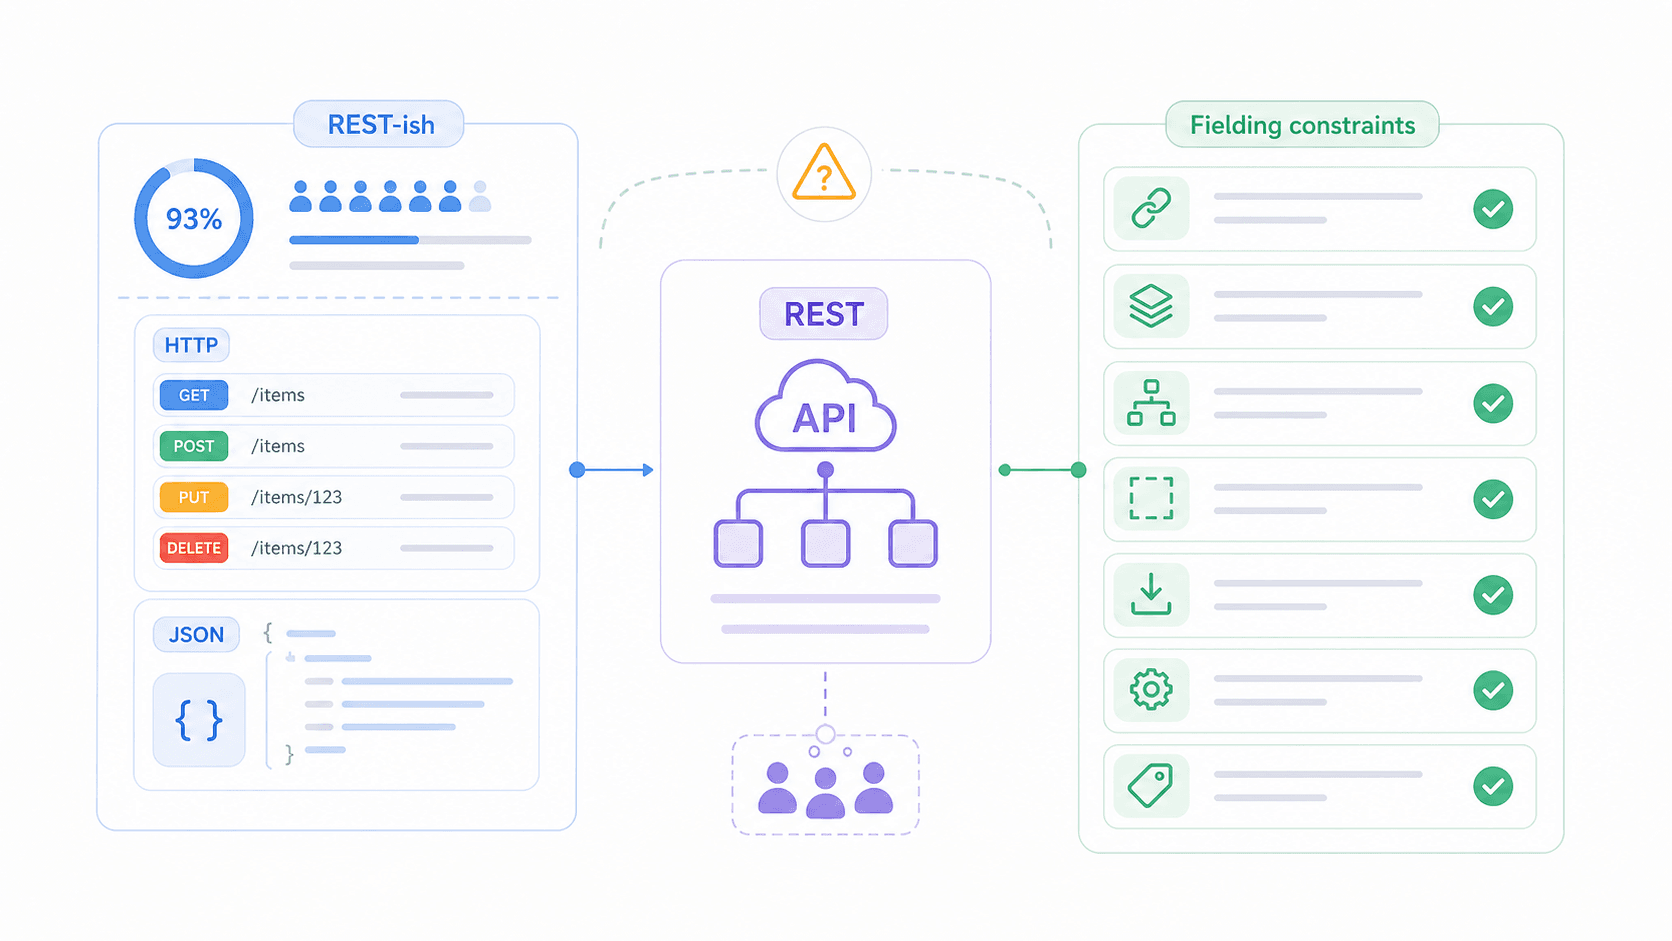
והנה הקטע המעניין: גם אצל מפתחים יש בלבול אמיתי סביב מה בעצם הופך API ל-"RESTful". המונח נזרק לאוויר כל כך בקלות, שאחד הדיונים ב‑Reddit ניסח את זה בחדות: "אני לא חושב שבניתי אפילו RESTful API אחד באמת, לפי ההגדרה של Roy Fielding." וזה כבר מפתח שמדבר, לא משתמש עסקי. המושג נולד בעבודת הדוקטורט של Roy Fielding משנת 2000 באוניברסיטת UC Irvine, שבה הוא תיאר את REST כסגנון ארכיטקטוני — אוסף של אילוצי עיצוב — לא פרוטוקול, לא מוצר ולא מפרט להורדה. ועדיין, לפי דוח Postman State of the API 2025, השימוש ב‑REST עומד על 93% בקרב אנשי API. כלומר, כמעט כולם משתמשים בו, אבל מפתיע כמה צוותים לא באמת מבינים מה הוא דורש. במאמר הזה נעבור על 6 המאפיינים המרכזיים של REST API בשפה פשוטה, נראה אילו מהם רוב הצוותים מפספסים, נציג מודל בשלות שאפשר להשתמש בו להערכה עצמית, ונשווה את REST לחלופות שלו — SOAP, GraphQL ו‑gRPC.
מהו REST API? (הגדרה פשוטה)
REST (Representational State Transfer) הוא אוסף של כללי עיצוב לאופן שבו מערכות תוכנה אמורות לתקשר ברשת.
ליתר דיוק, זהו סגנון ארכיטקטוני שמגדיר אילוצים — כמו חוסר־מצביות, יכולת caching וממשק אחיד — שמנחים איך לקוחות (הדפדפן שלכם, אפליקציית מובייל או כלי אוטומציה) מתקשרים עם שרתים (שם הנתונים נמצאים). REST פועל בדרך כלל מעל HTTP ולרוב מחזיר JSON, אבל REST עצמו לא קשור לפרוטוקול או לפורמט נתונים מסוים.
חשבו על זה כמו על כללי נימוס לארוחת ערב. REST לא קובע איזה אוכל מגישים או באיזו שפה מדברים — הוא מגדיר איך מעבירים מנות, איך מבקשים תוספת, ואיך מסמנים שסיימתם. שתי מערכות שפועלות לפי אותם כללי נימוס יכולות לתקשר בצורה צפויה, גם אם מעולם לא נפגשו.
מה REST אינו: REST הוא לא מוצר שמתקינים. הוא לא פרוטוקול כמו HTTP או SOAP. וגם אם קוראים ל‑API "RESTful", זה לא אומר שהוא עומד במלוא האילוצים המקוריים של Fielding — בדרך כלל זה רק אומר שה‑API משתמש בכתובות משאבים ובשיטות HTTP. הפער בין "REST-ish" לבין "באמת RESTful" הוא אחד ממקורות הבלבול הגדולים בתעשייה, וניגע בו בהמשך.
6 המאפיינים של REST API במבט אחד
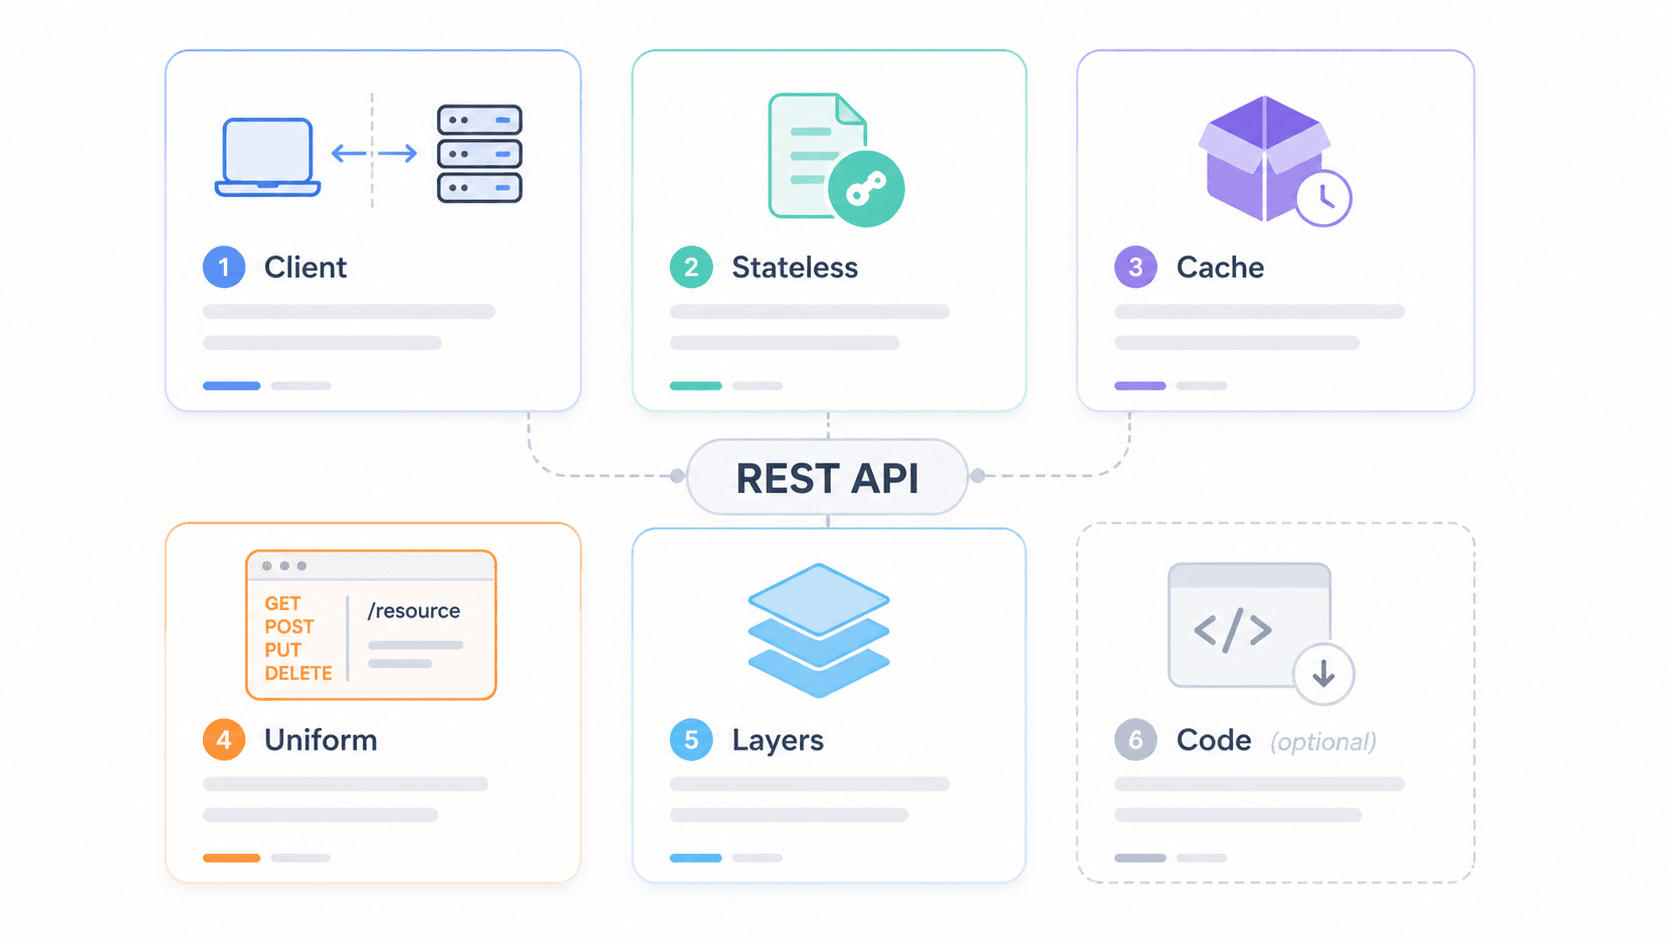
לפני שנצלול לעומק, הנה דף רמזים קצר. Fielding הגדיר 6 אילוצים ש‑API צריך לעמוד בהם כדי להיחשב RESTful. חמישה מהם מחייבים; אחד אופציונלי.
| אילוץ | הרעיון המרכזי | היתרון העיקרי | דוגמה קונקרטית |
|---|---|---|---|
| לקוח־שרת | הפרדה בין הממשק הגרפי לאחסון הנתונים | החזית והשרת מתפתחים באופן עצמאי | React SPA שמתקשר עם REST API |
| חוסר־מצביות | כל בקשה נושאת את כל ההקשר הנדרש | סקיילביליות אופקית, בלי תלות בסשן | אסימון אימות נשלח בכל כותרת בקשה |
| ניתן ל‑cache | התגובה מצהירה אם אפשר לשמור אותה במטמון | פחות השהיה ופחות עומס על השרת | Cache-Control: max-age=3600 בתשובת GET |
| ממשק אחיד | אינטראקציה סטנדרטית עם משאבים | API צפוי שקל ללמוד | GET /users/42, DELETE /users/42 |
| מערכת שכבתית | הלקוח לא יודע אם הוא מדבר ישירות עם השרת | מאפשר CDN, gateway ו‑load balancer | לקוח → CDN → API Gateway → שרת אפליקציה |
| Code-on-Demand (אופציונלי) | השרת יכול לשלוח קוד רץ כדי להרחיב את הלקוח | הרחבת יכולות הלקוח לפי צורך | API שמחזיר קטע JavaScript של widget |
כדי להמחיש איך האילוצים האלה עובדים יחד במערכת אמיתית, דמיינו ארכיטקטורה שכבתית כזו:
לקוח / אפליקציית מובייל
        ↓
CDN / מטמון קצה (למשל Cloudflare)
        ↓
API Gateway (הגבלת קצב, אימות, CORS)
        ↓
מאזן עומסים
        ↓
שרתי אפליקציה
        ↓
מסד נתונים / שירותים פנימיים
הלקוח מדבר רק עם שכבת ה‑CDN. אין לו מושג כמה שכבות יושבות מאחוריה. זהו בפועל אילוץ המערכת השכבתית — וזה גם המקום שבו אבטחה, caching וסקיילינג קורים בלי שהלקוח צריך לדעת.
ועכשיו, לפירוט המלא.
מאפייני REST API מוסברים, אחד אחד
הפרדה בין לקוח לשרת
האילוץ הראשון של Fielding: הלקוח (מה שהמשתמשים עובדים מולו) והשרת (איפה שהנתונים והלוגיקה פועלים) חייבים להיות נפרדים. הוא קרא לזה הפרדת תחומי אחריות.
למה זה חשוב בפועל? כי זה אומר שאפליקציית בנקאות למובייל יכולה לעבור עיצוב מחדש מלא בלי שהבנק ייגע במסד הנתונים של החשבונות או במנוע העסקאות. למשל, Salesforce Marketing Cloud REST API חושף אנשי קשר, קמפיינים, מסעות לקוח והתראות Push דרך נקודות קצה של משאבים. לא משנה אם אתם בונים דשבורד מותאם אישית, אפליקציית מובייל או מחברים כלי צד שלישי — ה‑backend נשאר אותו backend.
עבור צוותים עסקיים, המשמעות היא איטרציה מהירה יותר. מעצבי ה‑front-end ומהנדסי ה‑back-end לא חייבים להיות באותו מחזור גרסה. כל עוד החוזה של ה‑API יציב, שני הצדדים יכולים להתקדם באופן עצמאי.
חוסר־מצביות
אין זיכרון בין בקשות. כל קריאה מהלקוח לשרת חייבת לכלול את כל המידע שהשרת צריך כדי לעבד אותה — השרת לא שומר דבר מאינטראקציות קודמות.
אני אוהב לחשוב על זה כמו שיחת תמיכה, שבה בכל פעם צריך להסביר מחדש את הבעיה. מעצבן? בהחלט. אבל היתרון עצום: כל נציג זמין יכול לעזור לכם, ומוקד השירות יכול להוסיף עוד 500 נציגים בלי לתכנן הכול מחדש. זהו סקיילינג אופקי.
במונחים טכניים, חוסר־מצביות אומר שאין sticky sessions. מאזן עומסים יכול לנתב את הבקשה הבאה שלכם לכל שרת בריא. אם שרת אחד קורס, אחר ממשיך בלי להרגיש. עבודת הדוקטורט של Fielding מציינת במפורש שחוסר־מצביות משפרת נראות (כלי ניטור יכולים להבין כל בקשה בנפרד), אמינות (כשל לא משחית מצב סשן משותף) וסקיילביליות (שרתים יכולים לשחרר משאבים בין בקשות).
הסייג המעשי: במערכות אמיתיות עדיין יש טוקנים של אימות, עגלות קניות וזרימות OAuth. הנקודה היא לא שאין מצב בשום מקום — אלא שהשרת לא שומר מצב סשן של הלקוח בזיכרון שלו בין בקשות. טוקנים, מסדי נתונים ו‑caches משותפים מטפלים בזה במקום.
יכולת caching
האם אפשר להשתמש בתגובה שוב? זו השאלה ש‑cacheability עונה עליה. תגובות צריכות להצהיר במפורש אם אפשר לשמור אותן במטמון, ואם כן — לקוחות ומתווכים (כמו CDNs) עושים בהן שימוש חוזר לבקשות עתידיות מקבילות, וכך מצמצמים עומס ומשפרים מהירות.
מנגנון ה‑HTTP פשוט: כותרות כמו Cache-Control, ETag, Last-Modified ו‑Expires אומרות למטמונים כמה זמן התגובה תקפה ומתי לבדוק שוב. לקורא עסקי, תחשבו על זה כמו על תווית על התשובה שאומרת "התשובה הזאת טובה לשעה הקרובה" או "תמיד תשאל אותי מחדש".
ההשפעה על הביצועים אמיתית. בניסויים של Cloudflare Regional Tiered Cache דווח על שיפור של 50–100ms בזמני תגובה של cache hit בקצה. וגם עבודת הדוקטורט של Fielding עצמה מתעדת איך תעבורת האינטרנט גדלה מ‑100,000 בקשות ביום ב‑1994 ל‑600,000,000 בקשות ביום ב‑1999 — כאשר caching היה גורם תכנוני קריטי.
מה בדרך כלל ניתן ל‑cache: קטלוג מוצרים, תוכן בלוג ציבורי, רשימות מדינות/מטבעות, תיעוד API.
מה בדרך כלל לא ניתן ל‑cache: דשבורדים אישיים, סיכומי checkout, יתרות בנק, דוחות אדמין.
ממשק אחיד
זהו האילוץ ש‑Fielding עצמו כינה המאפיין המרכזי שמבדיל REST מסגנונות ארכיטקטוניים אחרים. הוא מגדיר איך לקוחות מתקשרים עם משאבים בצורה סטנדרטית, וכך הופך את ה‑API לצפוי.
מתחת למטרייה הזו יש ארבעה תתי־אילוצים:
- זיהוי משאבים: לכל משאב יש URI יציב.
/customers/123הוא לקוח./orders/456היא הזמנה. - מניפולציה באמצעות ייצוגים: הלקוחות עובדים עם ייצוגים (JSON, XML, HTML) של משאבים, ולא עם האובייקטים הפנימיים של השרת.
- הודעות המתארות את עצמן: בקשות ותגובות נושאות מספיק מטא־דאטה — שיטה, קוד סטטוס, סוג תוכן, פרטי שגיאה — כדי שכל מתווך או לקוח יוכלו להבין אותן.
- HATEOAS (Hypermedia as the Engine of Application State): תגובות כוללות קישורים לפעולות ולמשאבים קשורים, כך שהלקוחות יכולים לגלות מה לעשות הלאה בלי hardcoding של כל נקודת קצה.
מיפוי שיטות HTTP הוא החלק הבולט ביותר של הממשק האחיד:
| שיטת HTTP | המשמעות ב‑CRUD | בטוחה? | אידמפוטנטית? | דוגמה |
|---|---|---|---|---|
| GET | קריאה | כן | כן | GET /products/42 |
| POST | יצירה / פעולה | לא | לא | POST /orders |
| PUT | החלפה של כל המשאב | לא | כן | PUT /users/42 |
| PATCH | עדכון חלקי | לא | לא מובטח | PATCH /users/42 |
| DELETE | מחיקה | לא | כן | DELETE /sessions/abc |
הנחיות HTTP של Google Cloud קובעות במפורש ש‑GET צריך להיות בטוח, וש‑GET, PUT ו‑DELETE צריכים להיות אידמפוטנטיים. APIs מוכרים של GitHub, Stripe ו‑Spotify עומדים בדפוסים האלה מקרוב, ולכן מפתחים שלומדים אחד יכולים לאמץ אחר במהירות.
מערכת שכבתית
ללקוח שלכם אין מושג אם הוא מדבר עם שרת המקור, מטמון CDN, API gateway או load balancer. וזה בדיוק הרעיון — כל רכיב רואה רק את השכבה הסמוכה אליו.
זה מה שמאפשר:
- CDNs כמו Cloudflare, שיושבים לפני ה‑API שלכם כדי לשמור במטמון ולהאיץ תגובות
- API gateways (AWS API Gateway, Kong, Apigee) שמטפלים באימות, הגבלת קצב ומכסות
- Load balancers שמפזרים בקשות חסרות־מצב בין כמה שרתי אפליקציה
בדוח Postman 2025 מצוין ש‑47% מהארגונים משתמשים ב‑AWS API Gateway, 26% משתמשים ב‑gateway של Azure, ו‑31% משתמשים בכמה gateways במקביל. ארכיטקטורה שכבתית היא לא תיאוריה — ככה מערכות ייצור באמת עובדות.
הפשרה: כל שכבה מוסיפה מעט השהיה. אבל Fielding טען שמטמון משותף בשכבות מתווכות מפצה על התקורה הזו ברוב המערכות בעולם האמיתי.
Code-on-Demand (אופציונלי)
זה החריג שבחבורה. Code-on-Demand הוא האילוץ האופציונלי היחיד ב‑REST: השרת יכול לשלוח קוד רץ — כמו JavaScript — כדי להרחיב את יכולות הלקוח בזמן אמת.
הדוגמה הנפוצה ביותר בעולם האמיתי היא פשוט דף אינטרנט שטוען JavaScript מהשרת. אבל עבור APIs טיפוסיים מסוג JSON שצורכים אפליקציות מובייל, משימות backend או כלי אוטומציה, Code-on-Demand כמעט אף פעם לא בשימוש. בדרך כלל לקוחות API לא רוצים להריץ קוד שרירותי משרת מרוחק.
עבור רוב הקוראים, זהו סעיף שולי. הוא קיים במודל של Fielding לשם שלמות, אבל כנראה לא ישפיע על הערכות ה‑API היומיומיות שלכם.
מה רוב האנשים מפספסים: האם רוב REST APIs באמת RESTful?
הנה החלק שאף אחד לא אוהב לדבר עליו: רוב ה‑APIs שבייצור וקוראים לעצמם "RESTful" הם למעשה HTTP JSON APIs עם מוסכמות דמויות‑REST. הם משתמשים בכתובות משאבים, בשיטות HTTP ובקודי סטטוס — וזהו בערך. דיון ב‑Reddit ב‑r/softwarearchitecture הראה מפתחים שמודים שמעולם לא בנו REST API שבאמת עומד ב‑Fielding. דיון אחר ב‑r/learnprogramming הידרדר לוויכוחים אם בכלל אפשר להסכים מה פירוש "RESTful".
מחקר מ‑2026 שראיין 16 מומחי REST API מצא שלמרות שהנחיות משפרות שימושיות, מפתחים מגלים התנגדות משמעותית לכללי REST נוקשים — בגלל היקף ההנחיות והתאמה חלשה לארגון הספציפי שלהם.
אז איפה האילוצים באמת עומדים בפועל?
| אילוץ | אימוץ בפועל | למה |
|---|---|---|
| לקוח־שרת | ✅ כמעט אוניברסלי | בסיסי לארכיטקטורת web; קשה להימנע ממנו |
| חוסר־מצביות | ✅ כמעט אוניברסלי | נדרש לסקיילינג אופקי; נוהג מקובל |
| ממשק אחיד (בסיסי) | ✅ נפוץ | URI של משאבים + פעלי HTTP הם דפוס ברירת המחדל |
| יכולת caching | ⚠️ לא עקבי | הרבה צוותים מדלגים לגמרי על כותרות Cache-Control |
| מערכת שכבתית | ⚠️ מרומזת | CDNs ו‑gateways קיימים, אבל לא תמיד מתוכננים במכוון |
| HATEOAS | ❌ נדיר | רוב הלקוחות מקבעים נקודות קצה; גילוי מבוסס קישורים מוסיף מורכבות |
| Code-on-Demand | ❌ נדיר מאוד | אופציונלי מעצם ההגדרה; כמעט לא ממומש ב‑JSON APIs |
למה צוותים מדלגים על HATEOAS: מפתחי לקוח מעדיפים לקרוא תיעוד OpenAPI ולהשתמש ב‑SDKs במקום לעקוב בזמן ריצה אחרי קישורים דינמיים. HATEOAS דורש סוגי מדיה יציבים, הגדרות של קשרי קישורים ומידול של תהליכי עבודה — העלות המיידית גבוהה, והרווח לא ברור לרוב הצוותים.
המסקנה הפרקטית: API לא חייב לעמוד ב‑100% ב‑Fielding כדי להיות שימושי. אבל לדעת אילו אילוצים דילגתם עליהם — ומה אתם מפסידים בגלל זה — עוזר לקבל החלטות עיצוב ואינטגרציה טובות יותר.
מודל הבשלות של Richardson: עד כמה ה‑API שלכם באמת RESTful?
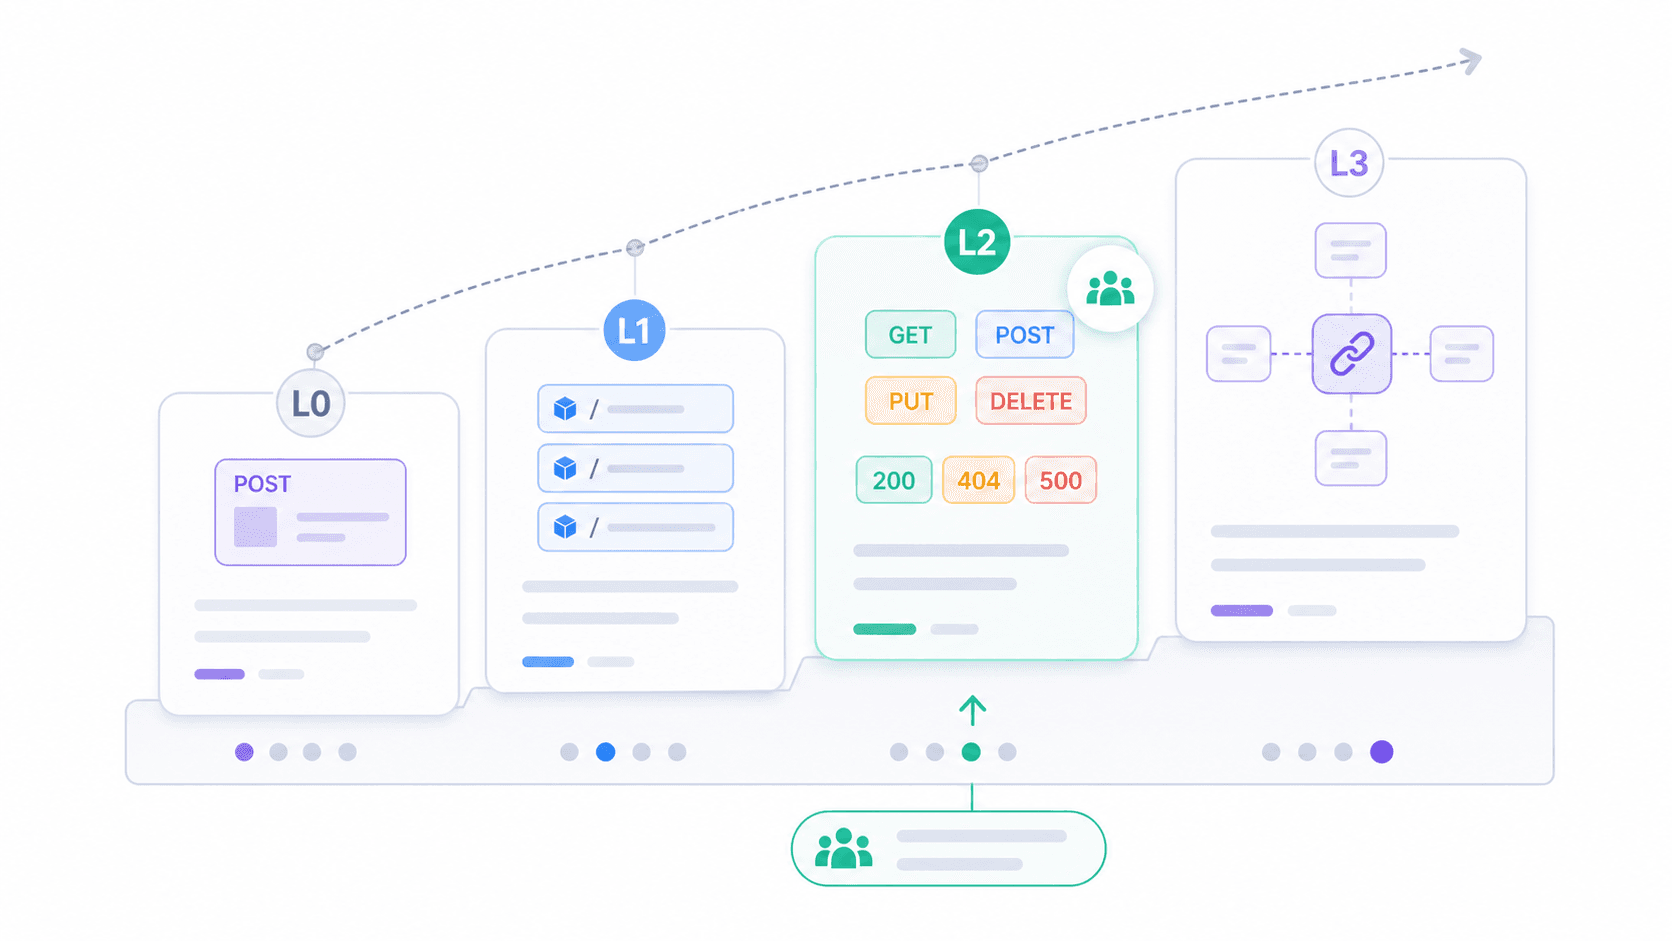
אם השאלה הבינארית "האם זה RESTful או לא?" לא עוזרת לכם, מודל הבשלות של Richardson מציע מסגרת מעשית יותר. המודל, שהוצע על ידי Leonard Richardson והוסבר על ידי Martin Fowler, מחלק את אימוץ REST לארבע רמות.
| רמה | שם | תיאור | דוגמה מהעולם האמיתי |
|---|---|---|---|
| 0 | ביצת הבוץ של POX | URI יחיד, פועל HTTP יחיד (בדרך כלל POST) | נקודות קצה ותיקות של SOAP over HTTP; POST /api עם { "action": "getUser" } |
| 1 | משאבים | כמה URI-ים (אחד לכל משאב), אבל עדיין ברובו POST | POST /users/123/getProfile, POST /orders/456/cancel |
| 2 | פעלי HTTP | שימוש נכון ב‑GET, POST, PUT, DELETE + קודי סטטוס מתאימים | רוב ה‑"REST" APIs בייצור היום |
| 3 | היפרמדיה (HATEOAS) | התגובות כוללות קישורים לפעולות/משאבים קשורים | Spring Data REST, APIs מבוססי HAL; מעט מאוד APIs ציבוריים בפועל |
רוב ה‑APIs שתפגשו בשטח נמצאים ברמה 2. הם משתמשים נכון במשאבים, בפעלים ובקודי סטטוס. זה מספיק כדי להיות פרקטיים, אינטרופרטיביים ונתמכים היטב על ידי כלים. רמה 3 היא החזון המלא של Fielding, אבל האימוץ עדיין דל.
איפה ה‑API שלכם נמצא? שאלו את עצמכם:
- האם יש ל‑API נקודת קצה אחת לכל דבר? (רמה 0)
- האם לכל אובייקט עסקי יש URI משלו? (רמה 1 ומעלה)
- האם שיטות HTTP וקודי סטטוס משמשים נכון? (רמה 2)
- האם התגובות מספרות ללקוח מה אפשר לעשות הלאה, בלי להישען על תיעוד חיצוני? (רמה 3)
המודל הזה הוא הכלי השימושי ביותר שמצאתי כדי לחדור דרך הוויכוח של "זה REST או לא". הוא מחליף שיפוט בינארי בסקאלה רציפה.
טעויות נפוצות ב‑REST API (ואיך להימנע מהן)
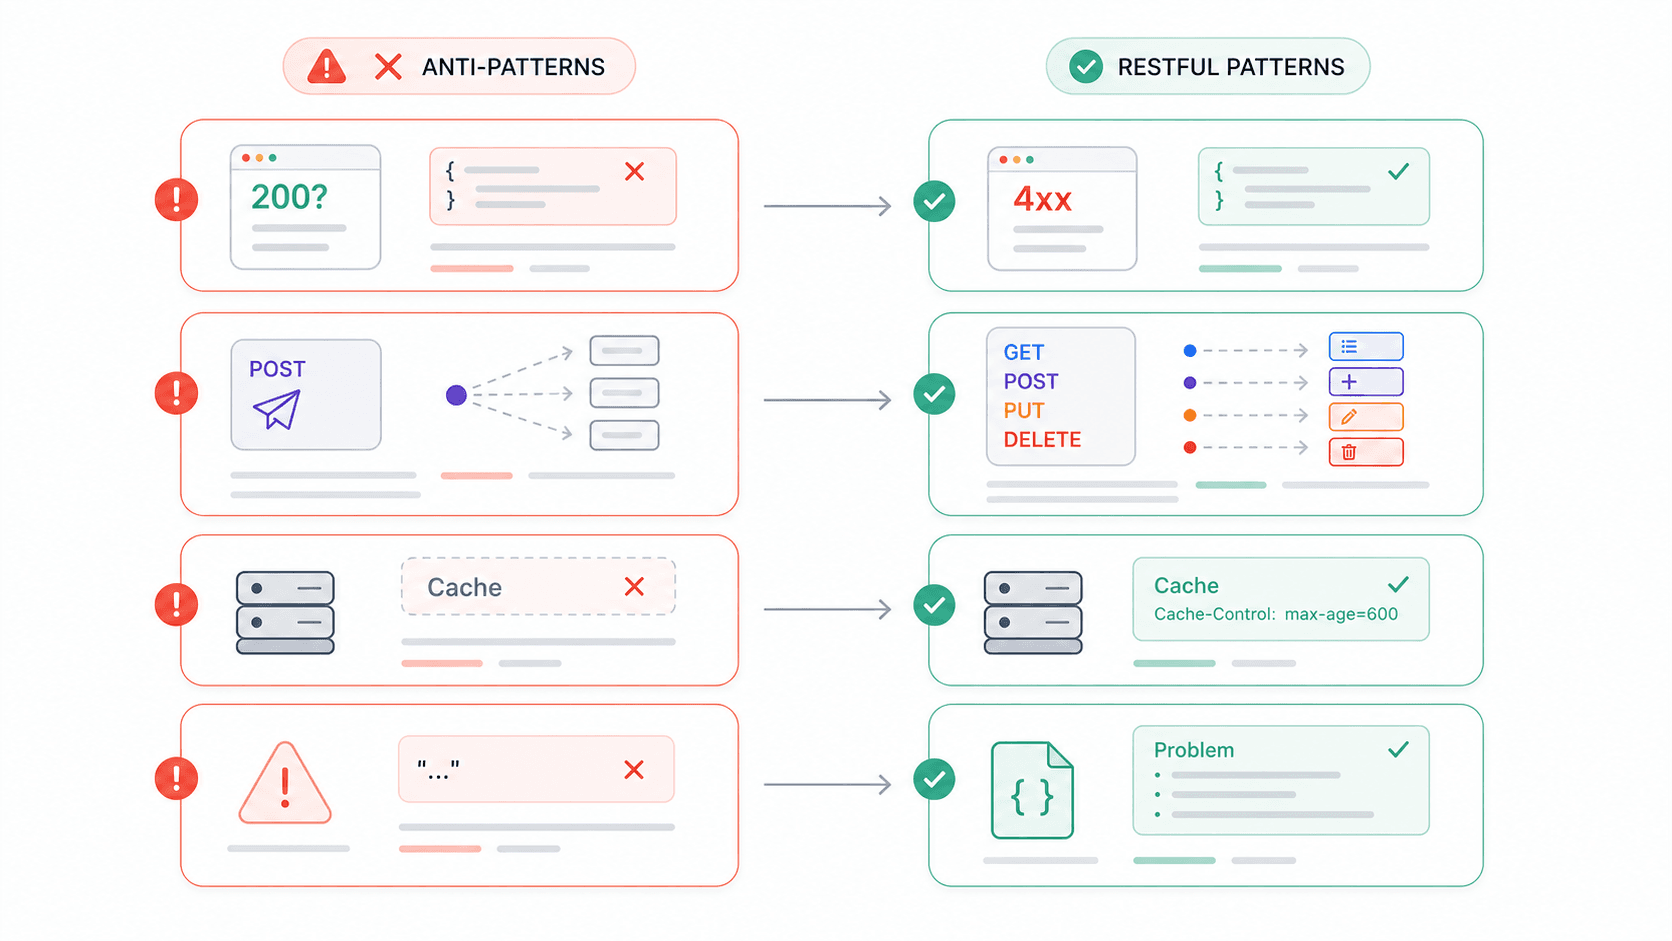
ביליתי מספיק זמן באינטגרציה עם APIs של צד שלישי כדי שתהיה לי רשימת תסכולים קבועה. ועל פי פורומים של מפתחים, אני ממש לא היחיד. הנה ה‑anti-patterns שמופיעים הכי הרבה — וכל אחד מהם ממפה ישירות להפרה של אילוץ REST.
| Anti-Pattern | למה זה שובר את REST | מה לעשות במקום |
|---|---|---|
HTTP 200 עם גוף שגיאה ({ "error": "Invalid username" }) | מפר את ההודעות המתארות את עצמן; לקוחות לא יכולים לסמוך על קודי הסטטוס | להשתמש בקודי 4xx/5xx מתאימים + גוף שגיאה מובנה (למשל application/problem+json) |
| POST לכל דבר | מתעלם מהממשק האחיד; מאבד סמנטיקה של בטיחות/אידמפוטנטיות | למפות CRUD ל‑GET/POST/PUT(PATCH)/DELETE |
אין כותרות Cache-Control | מבזבז לגמרי את אילוץ ה‑cacheability | להגדיר הוראות cache מפורשות — אפילו no-store לנתונים רגישים |
| תגובות שגיאה מעורפלות ("שגיאת 409") | בני אדם ומכונות לא יכולים להבין מה השתבש | לכלול סוג שגיאה, הודעה ברורה וקישור לתיעוד |
| אי־אכיפת HTTPS | טוקנים מסוג Bearer ומפתחות API עוברים בטקסט גלוי | לאכוף TLS בכל מקום; Google APIs כברירת מחדל ב‑HTTPS בלבד |
| Versioning בתוך גוף הבקשה | שובר זיהוי משאבים; gateways ו‑caches לא יכולים לנתב נכון | להשתמש בגרסאות בנתיב ה‑URI (/v1/) או בגרסאות דרך כותרת Accept |
הנחיות ה‑RESTful API של Zalando דורשות קודי HTTP רשמיים וממליצות על Problem JSON לתגובות שגיאה. הנחיות ה‑API של Adidas מגדירות ש‑Problem Detail צריך להיות בשימוש רק עבור 4xx/5xx, ולא מעורבב עם 2xx. אלו לא העדפות אקדמיות — אלו סטנדרטים של ייצור מצוותים שמפעילים APIs בקנה מידה גדול.
דיון ב‑Reddit ב‑r/learnprogramming הראה מפתח ששאל ברצינות אם מותר תמיד להחזיר HTTP 200 עבור שגיאות. העובדה שהשאלה הזו עדיין עולה ב‑2026 אומרת לכם עד כמה ה‑anti-patterns האלה עקשניים.
REST לעומת SOAP לעומת GraphQL לעומת gRPC: איך מאפייני REST API משתווים
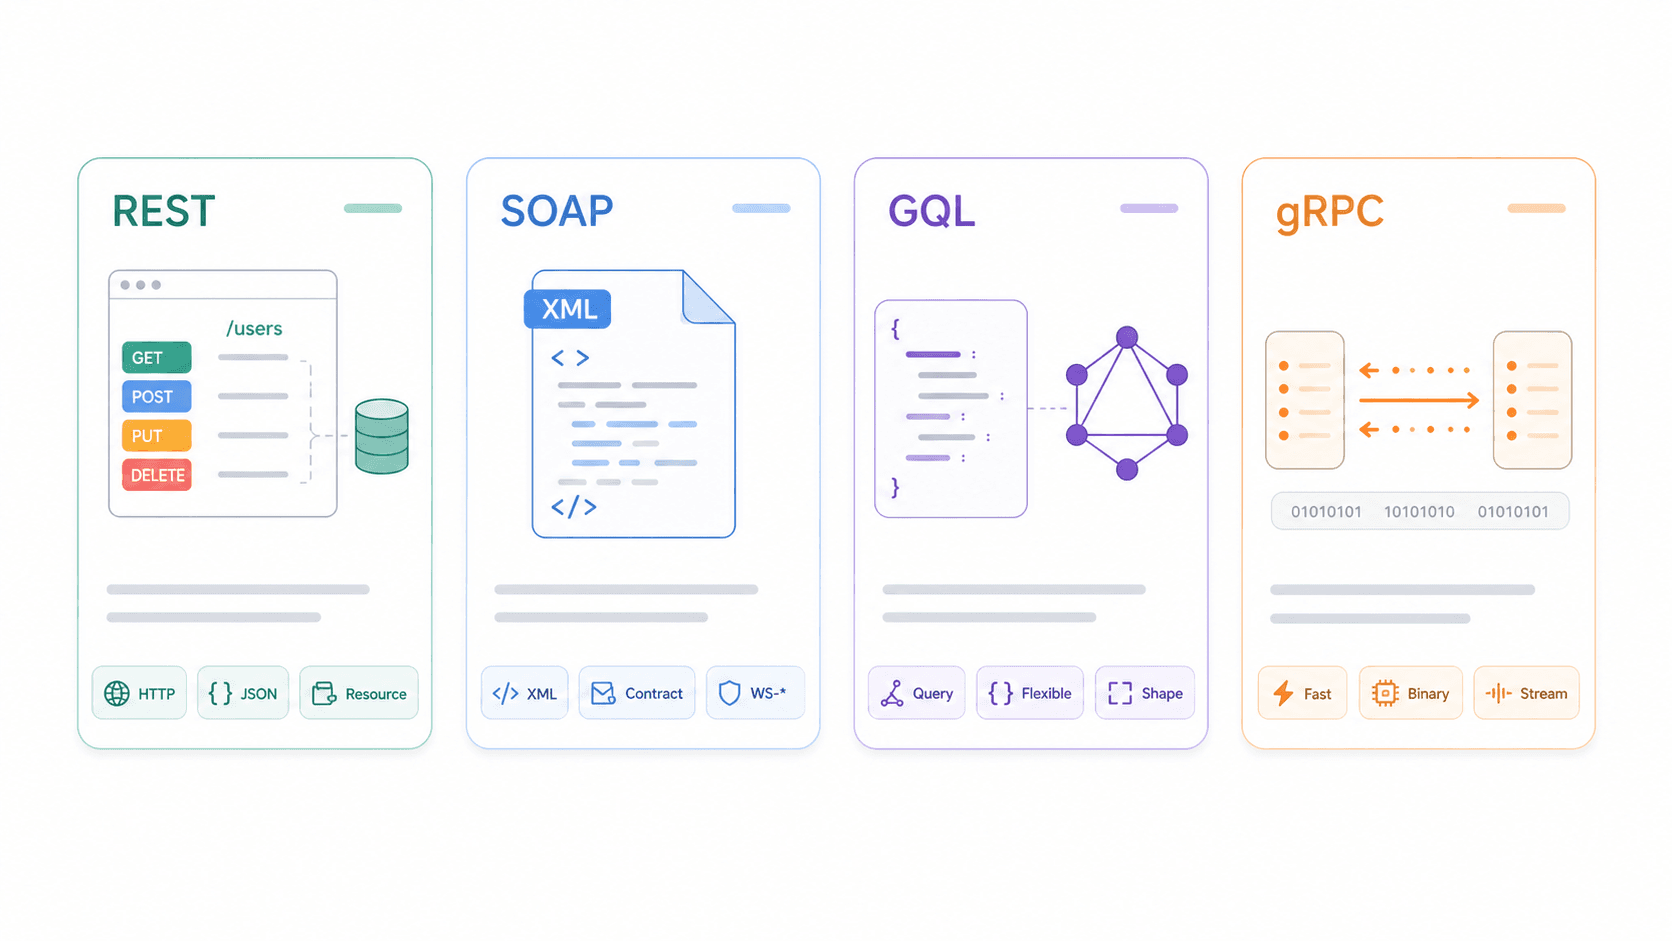
להבין את REST במנותק זה שימושי. להבין אותו ביחס לחלופות — זה טוב יותר.
| ממד | REST | SOAP | GraphQL | gRPC |
|---|---|---|---|---|
| פרוטוקול / תעבורה | סגנון ארכיטקטוני, בדרך כלל HTTP | פרוטוקול הודעות מבוסס XML; HTTP, SMTP וכו' | שפת שאילתות/Runtime, בדרך כלל מעל HTTP | מסגרת RPC מעל HTTP/2 |
| פורמט נתונים | בדרך כלל JSON, וגם XML/HTML | XML בלבד (חוזי WSDL) | JSON התואם לצורת השאילתה | Protocol Buffers (בינרי) |
| caching | ✅ caching מקורי של HTTP כשמתכננים נכון | ❌ מורכב; לא ידידותי ל‑HTTP cache | ⚠️ קשה יותר (POST + נקודת קצה אחת + שונות בשאילתה) | ❌ לא מכוון ל‑HTTP caching |
| תמיכה בזמן אמת | ❌ polling/webhooks | ❌ דפוסי הודעות ארגוניים | ✅ Subscriptions | ✅ Streaming, השהיה נמוכה |
| עקומת למידה | נמוכה עד בינונית | גבוהה | בינונית | בינונית עד גבוהה |
| מתאים ביותר ל | APIs ציבוריים, CRUD, אינטגרציות web/mobile | מערכות ארגוניות/ותיקות, חוזים קשיחים, תאימות רגולטורית | שאילתות מורכבות, חזיתות גמישות, אפליקציות מובייל | תקשורת בין microservices, ביצועים גבוהים פנימיים |
ההשוואה של Postman בין סגנונות ארכיטקטורת API ממליצה לבחור לפי תאימות, צורת הנתונים, הפעולות וכלי העבודה של המשתמשים.
מתי לבחור מה:
- REST מנצח כשצריך תאימות רחבה, פעולות CRUD פשוטות ו‑HTTP caching. זה ברירת המחדל ל‑APIs ציבוריים ולאינטגרציות web/mobile.
- SOAP עדיין הגיוני במערכות ארגוניות עם חוזים נוקשים, דרישות WS-Security או אינטגרציות ותיקות שלא הולכות לשום מקום.
- GraphQL זוהר כשה‑frontend צריך שאילתות גמישות ומקוננות, ורוצים להימנע מ‑over-fetching או under-fetching של נתונים — דבר נפוץ באפליקציות מובייל מורכבות.
- gRPC נבנה לתקשורת פנימית בין microservices, שבה השהיה נמוכה וסריאליזציה בינרית חשובים יותר מתאימות לדפדפן.
כדוגמת REST מהעולם האמיתי: Thunderbit Open API משתמש ב‑POST endpoints פשוטים (/distill ו‑/extract), בגופי בקשה/תגובה ב‑JSON, באימות bearer token, ובקודי HTTP סטנדרטיים (400, 401, 402, 408, 422, 429, 500, 502, 503, 504). זה מדגים מאפייני REST במוצר AI בייצור בלי לדרוש חוזי SOAP או מורכבות של gRPC. לא תצוגת HATEOAS — אבל כן API רמה 2 פרקטי שקל לצוותים עסקיים ולמפתחים לשלב.
למה מאפייני REST API חשובים לצוותים עסקיים
מכירות, תפעול, Ecommerce — אף אחד מהצוותים האלה לא כותב קוד API. אבל אתם כן בוחרים ספקים, מחברים כלים ובונים תהליכי אוטומציה — ואיכות ה‑REST API משפיעה ישירות על כמה האינטגרציות האלה יהיו כואבות או חלקות.
אינטגרציית כלים: כש‑CRM שלכם מסתנכרן עם פלטפורמת אוטומציית שיווק, עיצוב ה‑API קובע אם הסנכרון יהיה אמין או שביר. Salesforce Marketing Cloud REST API מנהל אנשי קשר, קמפיינים, מסעות לקוח והתראות Push דרך נקודות קצה צפויות של משאבים. אם נקודות הקצה האלה פועלות לפי מוסכמות REST, צוות ה‑RevOps שלכם יכול לאוטומט בלי פתרונות עוקפים מותאמים אישית.
תפעול Ecommerce: משאבי ה‑REST של fulfillment ב‑Shopify מנהלים הזמנות fulfillment, מספרי מעקב ומצבי משלוח. אפליקציות משלוח וכלי fulfillment תלויים בשכבה הזו. כשה‑API מתוכנן היטב — קודי סטטוס נכונים, נתוני קטלוג שניתן ל‑cache, הודעות שגיאה ברורות — צינור הלוגיסטיקה רץ חלק. כשלא, מקבלים כשלים מסתוריים ב‑2 בלילה.
הערכת ספקים: ההבנה של 6 האילוצים נותנת לכם צ'ק ליסט מעשי:
- האם ה‑API משתמש בקודי סטטוס סטנדרטיים, או שכל כשל נראה כמו 200 OK?
- האם הודעות השגיאה מספיק ספציפיות כדי שכלי האוטומציה שלכם יוכל להתאושש?
- האם יש תיעוד ברור על rate limits, pagination ואימות?
- האם ניתן ל‑cache תגובות נפוצות כדי להפחית עומס?
חילוץ נתונים ואוטומציה: כלים כמו Thunderbit משתמשים בארכיטקטורה מבוססת REST כדי לאפשר למשתמשים עסקיים לחלץ נתונים מובנים מאתרים, מ‑PDF וממונות — ואז לייצא ל‑Google Sheets, Airtable, Notion או Excel. תוסף Chrome של AI Web Scraper של Thunderbit מטפל במורכבות מאחורי ממשק של 2 קליקים, אבל מתחת למכסה המנוע אלה עקרונות REST — בקשות חסרות־מצב, תגובות JSON ושגיאות סטנדרטיות — שהופכים את שכבת האינטגרציה לאמינה.
עוד נתון שכדאי לשים עליו דגש: דוח Postman 2025 מצא שרק 24% מהמפתחים מתכננים APIs באופן אקטיבי תוך התחשבות בסוכני AI, בעוד 51% חוששים מקריאות API לא מורשות או מוגזמות מצד סוכני AI. ככל שאוטומציה ותהליכי עבודה מונעי AI הופכים לסטנדרט בצוותים עסקיים, דפוסי REST צפויים, מפתחות API עם least privilege ו‑rate limits אינם רק עניין של מפתחים — הם גורמי סיכון תפעוליים.
איך Thunderbit מיישמת עקרונות REST עבור משתמשים עסקיים
בנינו את Thunderbit מתוך הנחה שרוב המשתמשים שלנו לעולם לא יקראו מפרט REST — וגם לא צריכים. אבל הבחירות התכנוניות שהופכות את Thunderbit לקלה לשימוש נשענות על אותם מאפייני REST שהמאמר הזה סוקר.
הנה סקירה קצרה של איך זה עובד בפועל:
- מתקינים את תוסף Chrome מתוך Chrome Web Store ופותחים כל אתר, PDF או תמונה שרוצים לחלץ מהם נתונים.
- לוחצים על "AI Suggest Fields" וה‑AI של Thunderbit קורא את הדף ומציע טבלה מובנית של עמודות — שמות מוצרים, מחירים, אימיילים, מה שהדף כולל.
- מכוונים את העמודות אם צריך, ואז לוחצים על "Scrape". Thunderbit מטפלת אוטומטית ב‑pagination, בתתי־עמודים ובתוכן דינמי.
- מייצאים את הנתונים ל‑Google Sheets, Airtable, Notion, CSV או Excel — בחינם, בלי חומת תשלום.
עבור מפתחים ותהליכי אוטומציה, Thunderbit Open API חושף את /distill (חילוץ Markdown נקי) ואת /extract (חילוץ נתונים מובנים) כ‑POST endpoints בסגנון REST עם גופי JSON וקודי שגיאה סטנדרטיים של HTTP. במונחי מודל הבשלות של Richardson, זו רמה 2 מוצקה — משאבים, שיטות נכונות, וקודי סטטוס משמעותיים.
אם אתם בוחנים web scraping או חילוץ נתונים באופן רחב יותר, כתבנו מדריכים מעמיקים על AI web scraping, web scraping בלי קוד, ומה זה בעצם web scraping.
נקודות עיקריות
- REST הוא סגנון ארכיטקטוני, לא פרוטוקול. הוא מגדיר 6 אילוצים — לקוח־שרת, חוסר־מצביות, ניתן ל‑cache, ממשק אחיד, מערכת שכבתית ו‑code-on-demand אופציונלי — שמנחים את עיצוב ה‑API.
- רוב ה‑APIs ה"RESTful" אינם RESTful לגמרי. רובם נמצאים ברמת Richardson 2 (משאבים + פעלי HTTP + קודי סטטוס). HATEOAS ו‑code-on-demand כמעט לא ממומשים.
- מודל הבשלות של Richardson הוא כלי ההערכה העצמית הטוב ביותר. הוא מחליף את השאלה הבינארית "זה REST או לא" בסקאלה פרקטית (רמות 0–3).
- טעויות נפוצות — 200 OK לשגיאות, POST לכל דבר, חוסר בכותרות cache — עדיין נפוצות מאוד. הבנת האילוצים עוזרת לזהות ולתקן את ה‑anti-patterns האלה.
- REST מול SOAP מול GraphQL מול gRPC הוא לא עניין של "מה הכי טוב" — אלא של התאמה. REST שולט ב‑APIs ציבוריים ואינטגרציות CRUD. GraphQL מתאים לחזיתות מורכבות. gRPC מצטיין ב‑microservices פנימיים. SOAP ממשיך להתקיים בהקשרים ארגוניים/ותיקים.
- צוותים עסקיים מרוויחים מהבנת מאפייני REST כשמעריכים ספקים, מחברים כלים ובונים תהליכי אוטומציה. כלים כמו Thunderbit מיישמים עקרונות REST כדי להפוך חילוץ נתונים לנגיש בלי צורך בידע טכני.
שאלות נפוצות
מהם 6 המאפיינים של REST API?
6 האילוצים של REST הם: (1) הפרדה בין לקוח לשרת, (2) חוסר־מצביות, (3) יכולת caching, (4) ממשק אחיד, (5) מערכת שכבתית, ו‑(6) code-on-demand (אופציונלי). חמשת הראשונים הם מחייבים כדי ש‑API ייחשב RESTful לפי ההגדרה המקורית של Fielding.
מה ההבדל בין REST ל‑RESTful?
REST הוא הסגנון הארכיטקטוני — אוסף אילוצי העיצוב שהוגדרו על ידי Roy Fielding. "RESTful" מתאר API שעומד באילוצים האלה. בפועל, הרבה APIs שמסומנים כ‑"RESTful" עומדים בהם רק חלקית, ובדרך כלל מיישמים משאבים, שיטות HTTP וקודי סטטוס אבל מדלגים על HATEOAS ו‑code-on-demand.
האם כל REST API עומד בכל אילוץ של REST?
לא. רוב ה‑APIs בייצור מקפידים על הפרדה בין לקוח לשרת, חוסר־מצביות, וממשק אחיד בסיסי (משאבים + פעלי HTTP). יכולת caching ועיצוב מערכת שכבתית מיושמים באופן לא עקבי. HATEOAS נדיר, ו‑code-on-demand כמעט אף פעם לא בשימוש ב‑JSON APIs.
מה ההבדל בין REST ל‑GraphQL?
REST חושף משאבים דרך כמה נקודות קצה עם שיטות HTTP סטנדרטיות (GET, POST, PUT, DELETE). GraphQL בדרך כלל משתמש בנקודת קצה אחת, שבה הלקוח מציין בדיוק אילו שדות הוא רוצה בשאילתה. ל‑REST יש caching טבעי חזק יותר ב‑HTTP; GraphQL מציע גמישות רבה יותר לצרכים מורכבים ומקוננים של נתונים ומפחית over-fetching.
מה זה HATEOAS, והאם מישהו באמת משתמש בזה?
HATEOAS (Hypermedia as the Engine of Application State) אומר שתגובות API כוללות קישורים שמראים ללקוחות אילו פעולות זמינות בהמשך — כך שהלקוחות יכולים לנווט ב‑API בלי hardcoding של כל נקודת קצה. זהו חלק מרכזי בחזון של Fielding לגבי REST (רמה 3 במודל Richardson), אבל בפועל מעט מאוד APIs ציבוריים מיישמים אותו. רוב הצוותים נעצרים ברמה 2 ומסתמכים במקום זאת על תיעוד ו‑SDKs.
נסו את Thunderbit לגריפת אתרים עם AI
נסו את Thunderbit לגריפת אתרים עם AI Get Started Free
למדו עוד



