

גריפת אתרים עברה מזמן מלהיות מיומנות נישתית ליכולת חיונית לכל מי שעובד במכירות, תפעול או מחקר שוק. עם נפח נתוני האינטרנט שגדל במהירות—יצירת הנתונים העולמית זינקה כמעט ב-193% מ-2019 עד 2023—לא מפתיע ש-81% מהחברות רואות היום בנתונים את ה“לב” של קבלת ההחלטות שלהן. אבל יש קאץ': 95% מהארגונים אומרים שטיפול בנתונים לא מובנים, כמו HTML מבולגן, הוא אתגר משמעותי. ראיתי לא מעט צוותים טובעים במרתוני העתק-הדבק, מנסים לגרור מידע מאתרי אינטרנט לתוך גיליונות אלקטרוניים—תאמינו לי, זה לא מחזה יפה.
חלץ נתונים מכל אתר בעזרת AI Get Started Free
כאן נכנס לתמונה BeautifulSoup של Python. במדריך המעשי הזה אראה לכם איך להשתמש ב-BeautifulSoup לגריפת אתרים, עם דוגמה פרקטית של Python Beautiful Soup שתוכלו להתאים לצרכים העסקיים שלכם. ומכיוון שאני מאמין בעבודה חכמה יותר, ולא קשה יותר, אראה לכם גם איך לשלב את BeautifulSoup עם Thunderbit, כלי גריפת האתרים שלנו מבוסס ה-AI, כדי לזרז את תהליך העבודה ולקבל נתונים נקיים ומובנים יותר—בלי קשר לרמת התכנות שלכם.
מה זה BeautifulSoup ולמה להשתמש בו לגריפת אתרים?
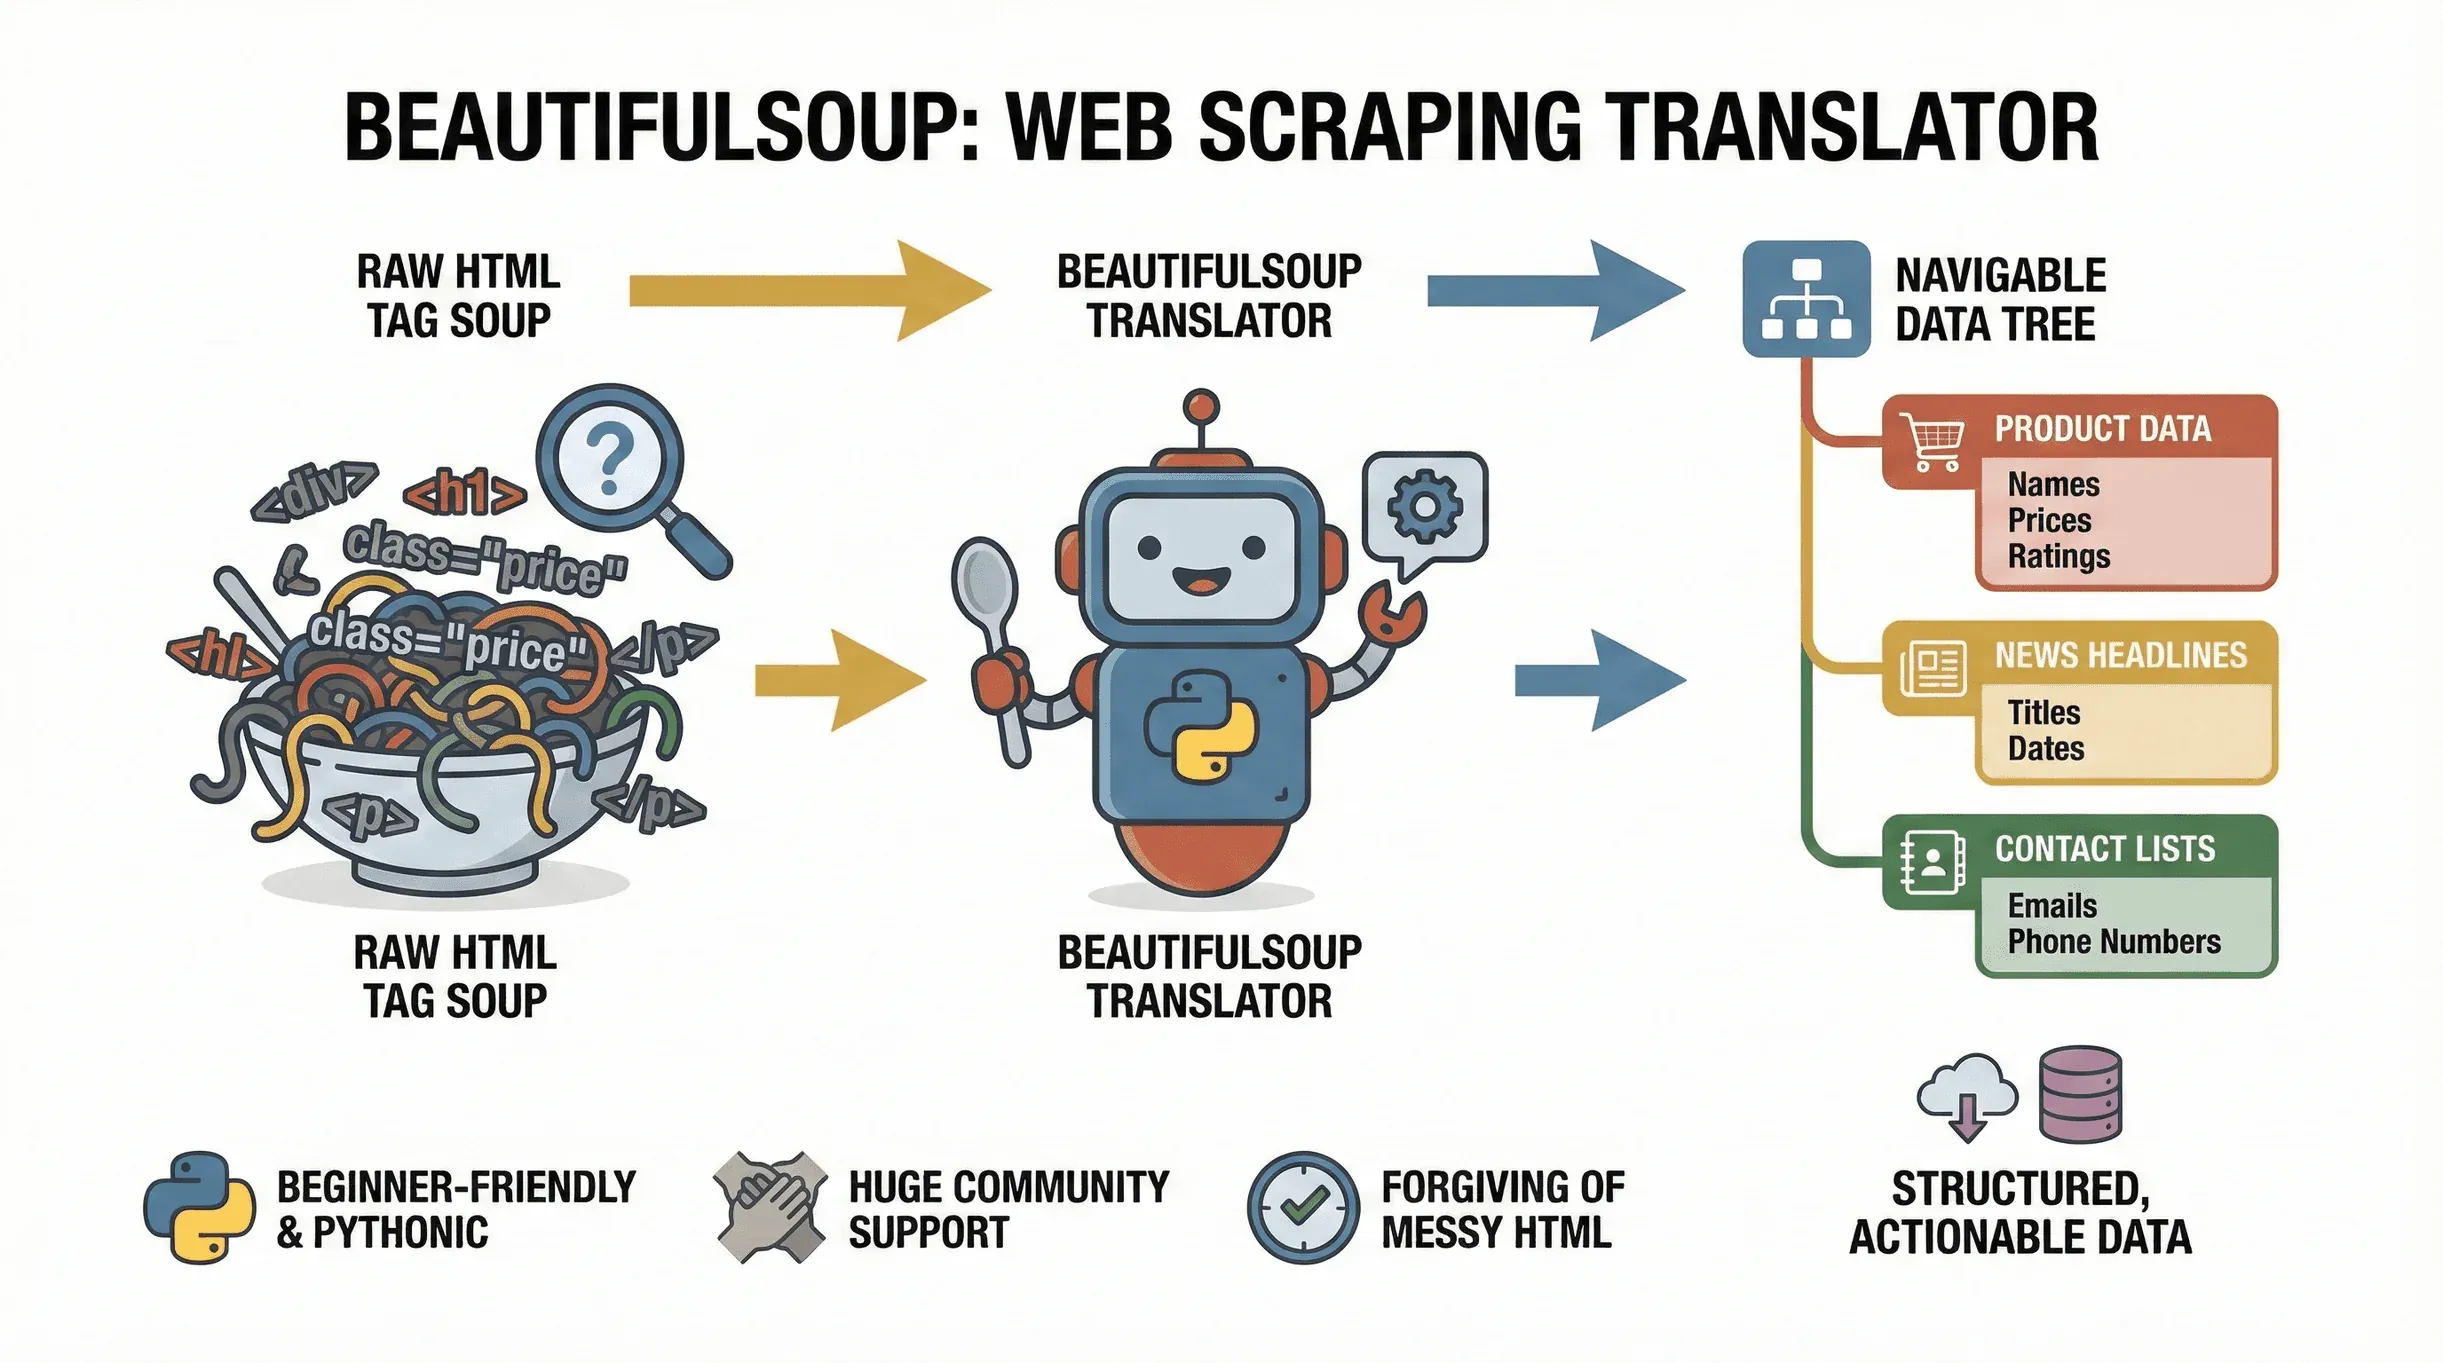 נתחיל מהבסיס. BeautifulSoup היא ספריית Python שמקלה מאוד על ניתוח מסמכי HTML ו-XML. תחשבו עליה כעל מתרגם: היא לוקחת את “מרק התגים” של דף אינטרנט והופכת אותו לעץ שאפשר לנווט בו, כך שאפשר למצוא, לחלץ ולשנות בקלות את הנתונים שאתם צריכים. הפרויקט עדיין מתוחזק באופן פעיל —
beautifulsoup4 4.14.3 שוחררה ב-PyPI בסוף 2025 — כך שכל מה שתלמדו כאן עדיין עדכני. בין אם אתם שולפים מחירי מוצרים מאתר מסחר אלקטרוני, אוספים כותרות חדשות או גורפים ספריות עסקים כדי למצוא לידים, BeautifulSoup הוא כלי מצוין להפיכת דפי אינטרנט לנתונים מובנים ושימושיים.
למה הוא כל כך פופולרי? קודם כול, הוא ידידותי מאוד למתחילים. BeautifulSoup סלחני ל-HTML מבולגן, ובואו נודה באמת — האינטרנט מלא בזה — והתחביר ה-Pythonי שלו מאפשר לכם לעבור מאפס לגריפה בכמה שורות קוד בלבד. הוא גם נתמך היטב, עם מיליוני הורדות וקהילה עצומה, כך שאם נתקעתם, עזרה נמצאת במרחק חיפוש ב-Google.
שימושים נפוצים ב-BeautifulSoup כוללים:
- חילוץ שמות מוצרים, מחירים ודירוגים מדפי מסחר אלקטרוני
- שליפת כותרות חדשות, שמות כותבים ותאריכי פרסום מאתרי חדשות
- ניתוח טבלאות או ספריות, כמו רשימות של חברות או אנשי קשר
- איסוף אימיילים או מספרי טלפון מאתרי מודעות
- ניטור עדכונים, כמו שינויי מחירים או משרות חדשות
אם הנתונים שלכם חיים ב-HTML סטטי, BeautifulSoup הוא החבר הכי טוב שלכם לגריפת אתרים.
היתרונות הייחודיים של BeautifulSoup לגריפת אתרים
יש לא מעט ספריות Python לגריפת אתרים—אז למה לבחור ב-BeautifulSoup? הנה איך הוא עומד מול התחרות:
- פשטות: BeautifulSoup קל משקל וקל ללמידה. אין צורך להקים מסגרת עבודה שלמה או לכתוב הרבה קוד תשתית. הוא מושלם למשימות גריפה מהירות, חד-פעמיות או למתחילים שרק מתחילים.
- סלחנות: הוא יודע להתמודד עם HTML שבור או פגום, וזה נפוץ יותר ממה שנדמה.
- גמישות: לא תיאלצו להיכנס לארכיטקטורת סריקה נוקשה. פשוט מזינים HTML ומחלצים את מה שצריך.
- אינטגרציה: BeautifulSoup משתלב מצוין עם ספריות Python אחרות כמו
requests(לשליפת דפי אינטרנט),csv(לשמירת נתונים) ו-pandas(לניתוח נתונים).
איך הוא בהשוואה לכלים אחרים?
| כלי | הכי מתאים ל- | יתרונות | חסרונות |
|---|---|---|---|
| BeautifulSoup | ניתוח HTML סטטי, מתחילים | פשוט, התקנה מהירה, סלחני, גמיש | לא מתאים לאתרים כבדים ב-JavaScript |
| Scrapy | משימות בקנה מידה גדול, אסינכרוניות | עוצמתי, ניתן להרחבה, סריקה מובנית | עקומת למידה תלולה יותר, יותר הגדרה |
| Selenium | תוכן JavaScript/דינמי | יכול לתקשר עם JS, למלא טפסים, ללחוץ על כפתורים | איטי יותר, כבד יותר, צורך יותר משאבים |
אם אתם רק מתחילים או צריכים לנתח במהירות דפים סטטיים, BeautifulSoup הוא “הסכין השווייצרית” של גריפת האתרים (medium.com). לאתרים מורכבים או דינמיים יותר, אפשר לשלב אותו עם Selenium או Scrapy—אבל BeautifulSoup הוא הדרך הטובה ביותר ללמוד את היסודות.
הגדרת סביבת Python שלכם ל-BeautifulSoup
מוכנים להתחיל? כך תגדירו את הסביבה שלכם:
-
התקנת Python: הורידו את הגרסה העדכנית ביותר מ-python.org.
-
הקמת סביבה וירטואלית (אופציונלי, אבל מומלץ):
python -m venv venv source venv/bin/activate # ב-Windows: venv\Scripts\activate -
התקנת BeautifulSoup והתלויות:
pip install beautifulsoup4 requests lxml html5libbeautifulsoup4: הספרייה הראשיתrequests: לשליפת דפי אינטרנטlxmlאוhtml5lib: מנתחי HTML מהירים/אמינים יותר
-
טיפים לפתרון בעיות:
- אם מתקבלת שגיאת “pip not found”, נסו
pip3אוpy -m pip. - ב-Mac/Linux ייתכן שתזדקקו ל-
sudoלהרשאות. - אם אתם ב-Windows, ודאו ש-Python נוסף ל-PATH.
- אם מתקבלת שגיאת “pip not found”, נסו
כדי לוודא שההגדרה תקינה, הריצו את הבדיקה המהירה הזו:
from bs4 import BeautifulSoup
import requests

html = requests.get("http://example.com").text
soup = BeautifulSoup(html, "html.parser")
print(soup.title)
אם אתם רואים <title>Example Domain</title>, הכול מוכן (Thunderbit Blog).
דוגמה שלב-אחר-שלב ל-Python Beautiful Soup
בואו נצלול לדוגמה מעשית של python beautiful soup. נניח שאתם רוצים לחלץ את כותרות החדשות האחרונות מאתר חדשות ציבורי. כך עושים זאת:
1. שליפת דף האינטרנט
import requests
from bs4 import BeautifulSoup

url = "https://www.bbc.com/news"
response = requests.get(url)
html = response.text
2. ניתוח ה-HTML
soup = BeautifulSoup(html, "html.parser")
3. בדיקת מבנה ה-HTML
פתחו את כלי המפתחים בדפדפן שלכם (קליק ימני → Inspect) וחפשו את התגים שמכילים את הכותרות. בהרבה אתרי חדשות, הכותרות נמצאות בתגי <h3> עם מחלקות מסוימות.
לדוגמה, ייתכן שתראו:
<h3 class="gs-c-promo-heading__title">כותרת</h3>
4. חילוץ הנתונים
headlines = soup.find_all("h3", class_="gs-c-promo-heading__title")
for h in headlines:
    print(h.get_text(strip=True))
זה ידפיס את כל כותרות החדשות בדף.
5. שמירת הנתונים ל-CSV
בואו נשמור את הכותרות האלה לניתוח מאוחר יותר:
import csv

with open("headlines.csv", "w", newline='', encoding="utf-8") as file:
    writer = csv.writer(file)
    writer.writerow(["כותרת"])
    for h in headlines:
        writer.writerow([h.get_text(strip=True)])
עכשיו יש לכם קובץ CSV מוכן ל-Excel או Google Sheets.
הבנת מבנה HTML לחילוץ נתונים יעיל
לפני שאתם כותבים קוד, תמיד בדקו את ה-HTML של הדף. כך עושים זאת:
- פתחו את כלי המפתחים: קליק ימני על הדף ובחרו “Inspect”.
- מצאו את הנתונים: עברו עם העכבר על רכיבים כדי לראות אילו תגים מכילים את המידע שאתם רוצים, למשל כותרות, מחירים או מחברים.
- שימו לב לתגים ולמחלקות: חפשו מזהים ייחודיים כמו
class="product-title"אוid="main-content". - בדקו את הסלקטורים שלכם: השתמשו בשיטות
.find(),.find_all()או.select()של BeautifulSoup כדי לכוון לאותם רכיבים.
טיפ מקצועי: השתמשו ב-soup.prettify() כדי להדפיס גרסה קריאה של ה-HTML בקונסולת Python.
חילוץ וארגון נתונים עם BeautifulSoup
נניח שאתם רוצים לחלץ גם כותרות וגם מחברים מדף בלוג:
articles = soup.find_all("article")
data = []
for article in articles:
    title = article.find("h2").get_text(strip=True)
    author = article.find("span", class_="author").get_text(strip=True)
    data.append({"title": title, "author": author})
עכשיו יש לכם רשימת מילונים—מושלם לייצוא ל-CSV או לניתוח נוסף.
אפשר לחלץ גם קישורים, תמונות או כל מאפיין אחר כך:
for link in soup.find_all("a"):
    print(link.get("href"))
או תמונות:
for img in soup.find_all("img"):
    print(img.get("src"))
שמירת נתונים שחולצו: מ-Python ל-Excel או CSV
אחרי שארגנתם את הנתונים, הייצוא קל. כך עושים זאת עם המודול csv:
import csv

with open("articles.csv", "w", newline='', encoding="utf-8") as file:
    writer = csv.DictWriter(file, fieldnames=["title", "author"])
    writer.writeheader()
    for row in data:
        writer.writerow(row)
או, אם אתם אוהבים pandas:
import pandas as pd

df = pd.DataFrame(data)
df.to_csv("articles.csv", index=False)
df.to_excel("articles.xlsx", index=False)
הקפידו תמיד להשתמש בקידוד UTF-8 כדי להימנע מבעיות תווים מוזרות, במיוחד עם נתונים בינלאומיים.
מקרה בוחן: גריפת נתוני אתר חדשות עם BeautifulSoup
בואו נעבור על דוגמה מעשית של python beautiful soup: גריפת כותרות, מחברים ותאריכי פרסום מאתר חדשות.
נניח שאתם רוצים לגרוף את CNN עבור נתוני כתבות:
import requests
from bs4 import BeautifulSoup
import csv

url = "https://edition.cnn.com/world"
response = requests.get(url)
soup = BeautifulSoup(response.content, "html.parser")

articles = soup.find_all("article")
data = []

for article in articles:
    title_tag = article.find("h3")
    date_tag = article.find("span", class_="date")
    author_tag = article.find("span", class_="author")
    title = title_tag.get_text(strip=True) if title_tag else ""
    date = date_tag.get_text(strip=True) if date_tag else ""
    author = author_tag.get_text(strip=True) if author_tag else ""
    data.append({"title": title, "date": date, "author": author})

with open("cnn_articles.csv", "w", newline='', encoding="utf-8") as file:
    writer = csv.DictWriter(file, fieldnames=["title", "date", "author"])
    writer.writeheader()
    for row in data:
        writer.writerow(row)
הסקריפט הזה ישלוף את הכתבות האחרונות, יחלץ את הכותרת, התאריך והמחבר, וישמור אותן לקובץ CSV — בהנחה שה-Markup הנוכחי של CNN עדיין תואם לתגים שלמעלה. אתרי חדשות גדולים משנים לעיתים קרובות שמות מחלקות ומבנה DOM, לכן כדאי לבדוק את הדף מחדש לפני שמריצים זאת על נתוני production. המבנה (<article> כקונטיינרים, ואז find על תגי הבן) הוא הדפוס העמיד; שמות המחלקות הספציפיים כמו "date" ו-"author" הם מצייני מקום שצריך להתאים למה שהדף החי מציג היום.
שיפור תהליך העבודה שלכם: שילוב BeautifulSoup עם Thunderbit
עכשיו בואו נדבר על איך להפוך את תהליך הגריפה שלכם לחלק אפילו יותר. Thunderbit הוא תוסף Chrome לגריפת אתרים מבוסס AI שמוציא את הניחושים מתהליך חילוץ הנתונים. עם Thunderbit תוכלו:
- להשתמש ב-“AI Suggest Fields”: Thunderbit קורא את הדף ומציע אוטומטית אילו שדות נתונים לחלץ—בלי לחפש ב-HTML או לכוונן סלקטורים.
- לגרוף דפי משנה: Thunderbit יכול לעקוב אחרי קישורים לדפי משנה, כמו דפי מוצרים או כתבות בודדים, ולהעשיר את מערך הנתונים שלכם בפרטים נוספים.
- לייצא מיד: שלחו את הנתונים ישירות ל-Excel, Google Sheets, Airtable או Notion בלחיצה אחת.
- לטפל בעימוד: Thunderbit יכול לגרוף נתונים ממספר דפים, כולל infinite scroll.
- לתזמן גריפות: הגדירו משימות חוזרות כדי לשמור על הנתונים שלכם עדכניים.
הנה תהליך עבודה היברידי שאני אוהב:
- התחילו עם Thunderbit: פתחו את האתר היעד, לחצו על אייקון Thunderbit, ותנו ל-“AI Suggest Fields” לזהות את העמודות הנכונות, כמו כותרת, מחבר ותאריך.
- ייצאו את הנתונים: הורידו את התוצאות כ-CSV או שלחו אותן ל-Google Sheets.
- השתמשו ב-BeautifulSoup לעיבוד מותאם אישית: אם אתם צריכים לבצע ניתוח עמוק יותר, כמו ניקוי טקסט, הסרת כפילויות או שילוב עם מקורות אחרים, טענו את קובץ ה-CSV שהופק לתוך Python והשתמשו ב-BeautifulSoup או pandas לעיבוד לאחר מכן.
השילוב הזה נותן לכם את הטוב משני העולמות: המהירות והזיהוי מבוסס ה-AI של Thunderbit, לצד הגמישות של BeautifulSoup ללוגיקה מותאמת אישית.
נסו את Thunderbit AI Web Scraper בחינם
מהירות ואיכות נתונים: למה להשתמש ב-Thunderbit וב-BeautifulSoup יחד?
 למה בכלל להתאמץ עם שני כלים? הנה מה שמצאתי:
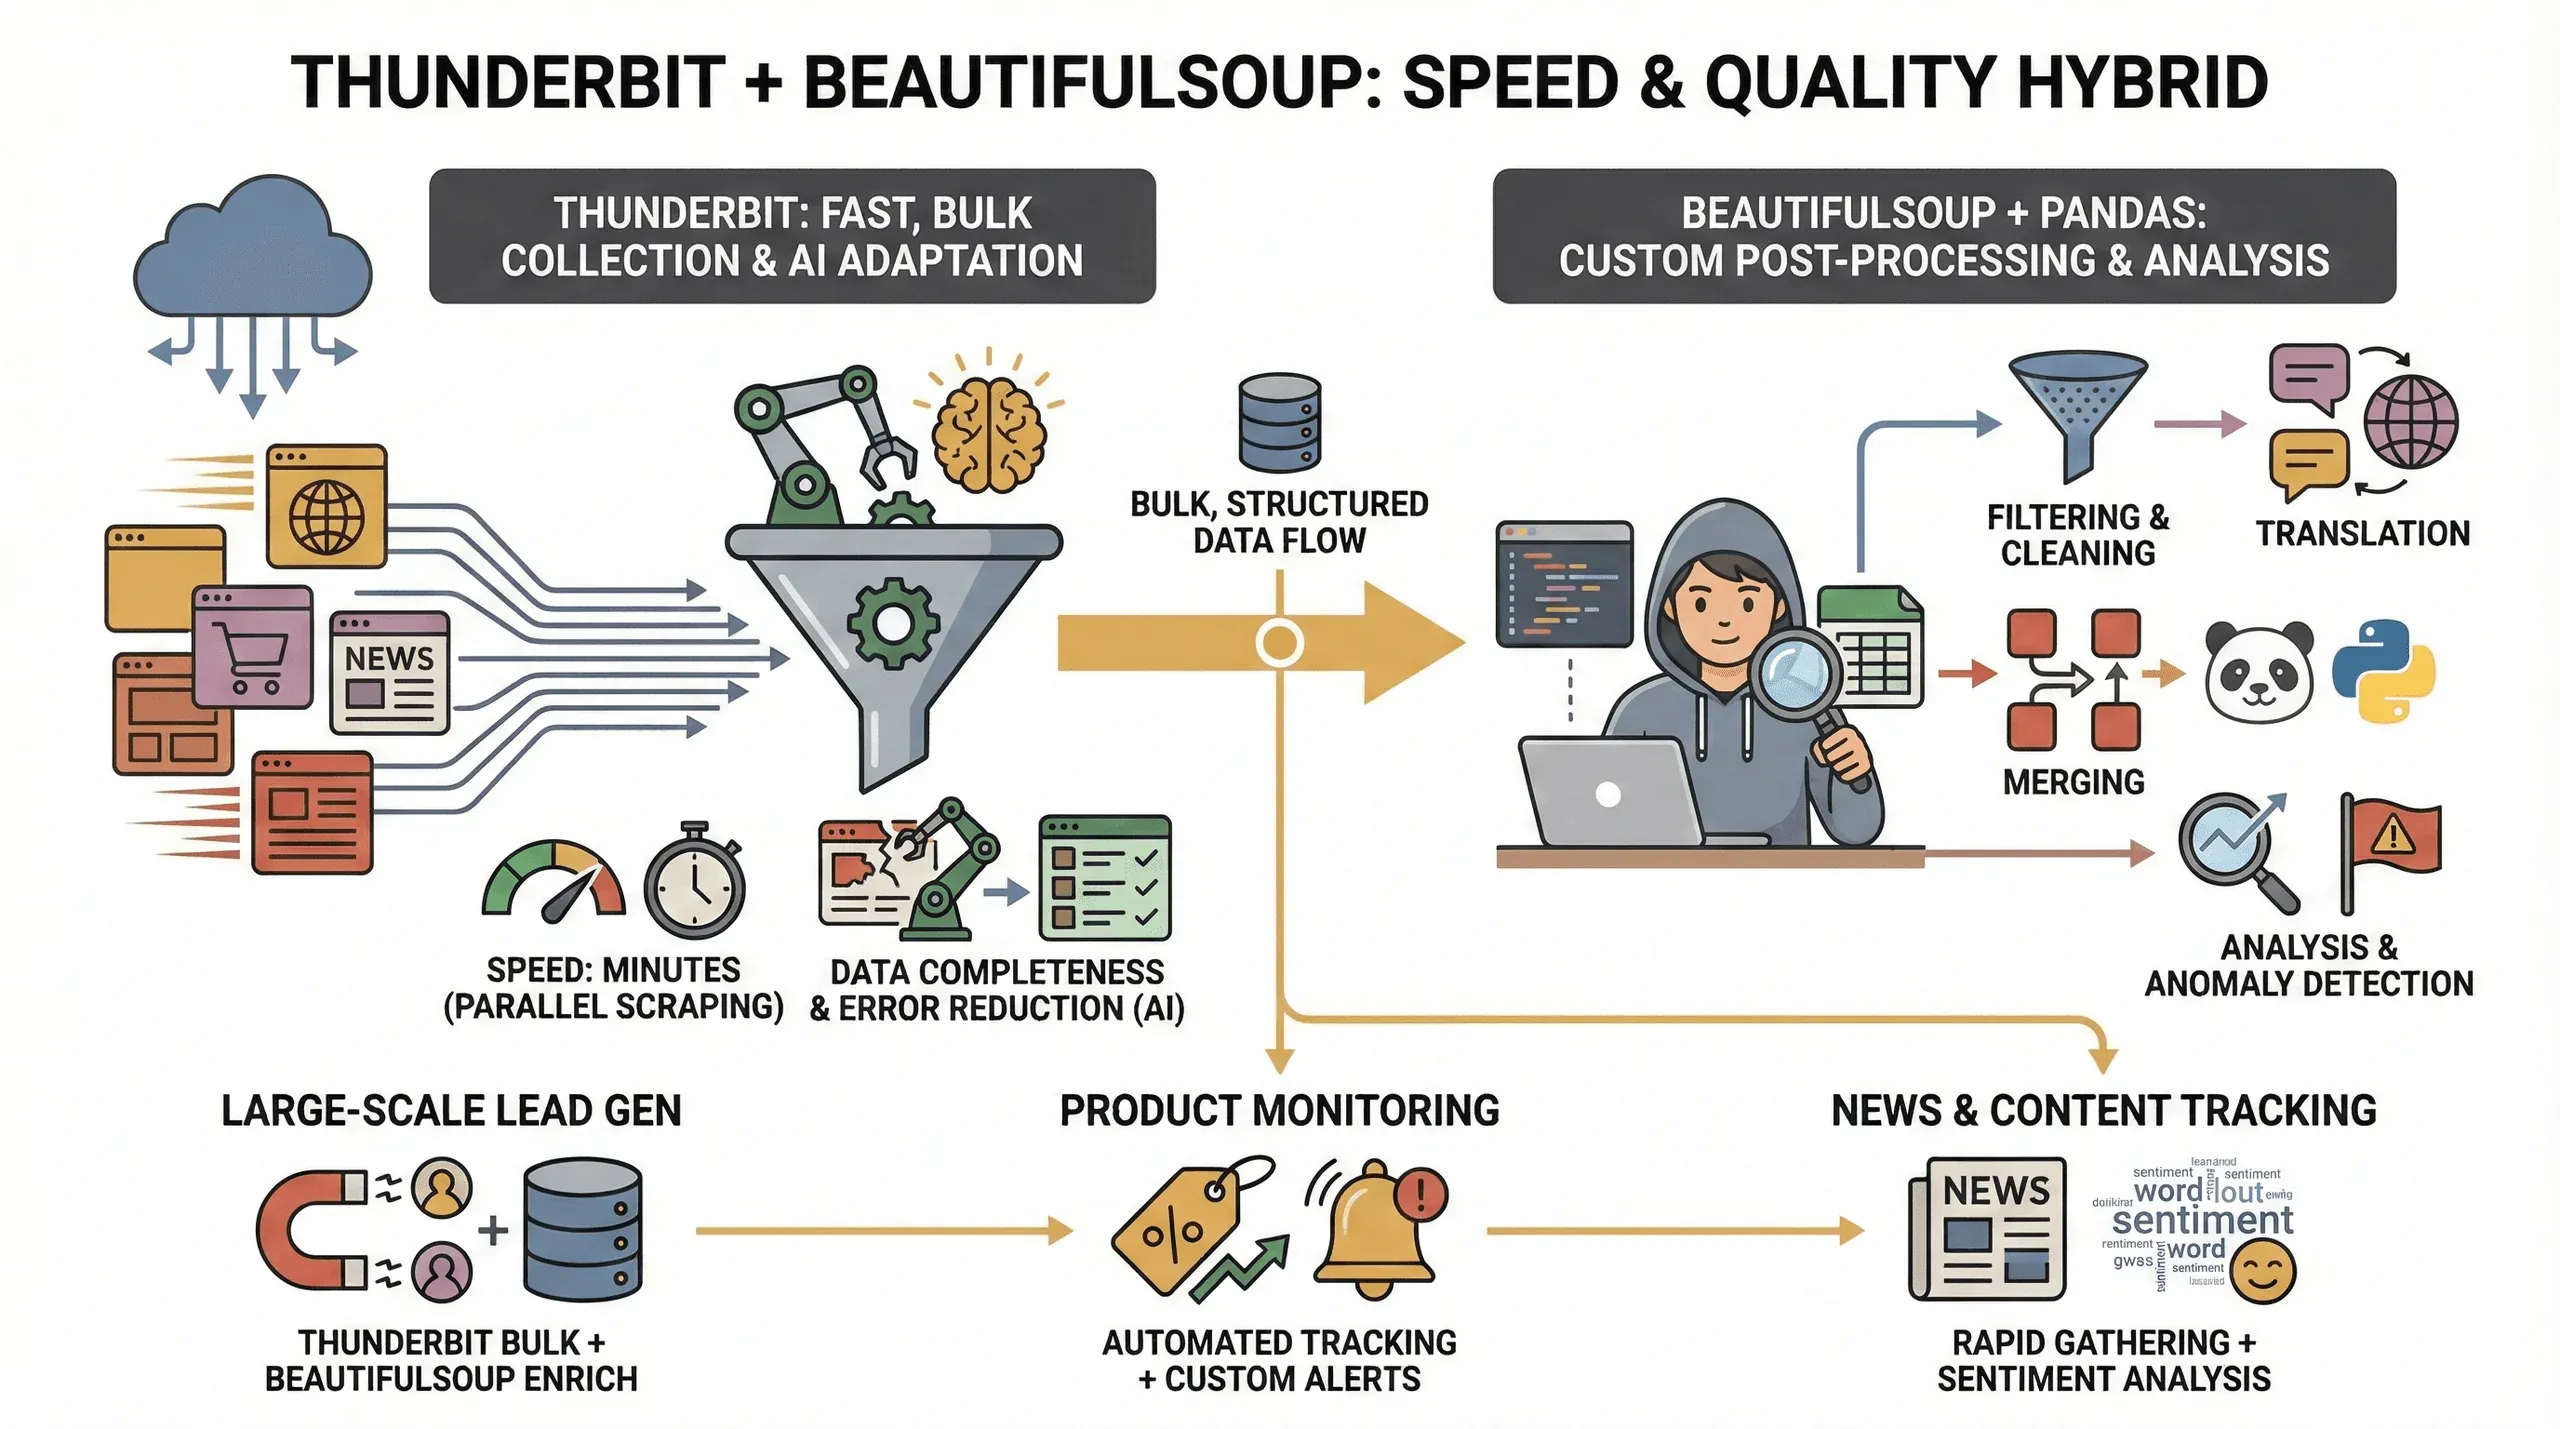
- מהירות: Thunderbit יכול לגרוף עשרות דפים במקביל, עד 50 בכל פעם במצב ענן, כך שתקבלו את הנתונים שלכם בדקות במקום בשעות.
- שלמות נתונים: ה-AI של Thunderbit מתאים את עצמו לשינויים בפריסה ויכול לחלץ נתונים מובנים גם מאתרים מאתגרים, וכך מפחית את הסיכוי להחסרת שדות.
- הפחתת שגיאות: לא עוד סקריפטים שבורים כששם מחלקה משתנה—ה-AI של Thunderbit מעריך את הדף מחדש בכל פעם.
- עיבוד מותאם אישית לאחר מכן: לצרכים מתקדמים, כמו סינון, תרגום או מיזוג מערכי נתונים, BeautifulSoup ו-pandas נותנים לכם שליטה מלאה.
הגישה ההיברידית הזו בעלת ערך מיוחד עבור:
- יצירת לידים בקנה מידה גדול: השתמשו ב-Thunderbit כדי לאסוף את הנתונים בכמות, ואז ב-BeautifulSoup כדי לנקות ולהעשיר אותם.
- ניטור מוצרים: Thunderbit מטפל בגריפה החוזרת, בעוד BeautifulSoup מאפשר לכם לנתח מגמות או לסמן חריגות.
- מעקב אחר חדשות ותוכן: אספו במהירות כתבות עם Thunderbit, ואז השתמשו ב-Python לניתוח סנטימנט או לחילוץ מילות מפתח.
פתרון בעיות נפוצות בגריפת אתרים עם BeautifulSoup
נסו את תוסף Chrome של Thunderbit גרפו כל אתר בעזרת AI ב-2 לחיצות. Get Started Free
גריפת אתרים לא תמיד זורמת חלק—הנה כמה מלכודות נפוצות ואיך לתקן אותן:
- תוכן דינמי: אם אתר טוען נתונים באמצעות JavaScript, כמו infinite scroll או AJAX, BeautifulSoup לבדו לא יראה אותם. השתמשו ב-Selenium או במצב הדפדפן של Thunderbit במקרים כאלה.
- אמצעי אנטי-בוט: חלק מהאתרים חוסמים בקשות אוטומטיות. נסו להגדיר כותרת User-Agent מותאמת, הוסיפו השהיות בין בקשות, או השתמשו בגריפת הענן של Thunderbit כדי לעקוף חסימות פשוטות.
- שינויים במבנה HTML: אם הסקריפט שלכם נשבר פתאום, כנראה שמבנה ה-HTML של האתר השתנה. בדקו את הדף שוב ועדכנו את הסלקטורים. ה-AI של Thunderbit יכול לעזור כאן בכך שהוא מסתגל בזמן אמת.
- נתונים חסרים: בדקו תמיד אם רכיבים קיימים לפני קריאה ל-
.get_text(). השתמשו ב-.get()במקום[]עבור מאפיינים כדי להימנע משגיאות KeyError. - בעיות קידוד: שמרו קבצים בקידוד UTF-8 כדי להתמודד עם תווים מיוחדים.
ובכל מקרה, תמיד כבדו את robots.txt ואת תנאי השימוש של האתר. גרפו באחריות—אף אחד לא אוהב רובוט גס רוח.
מסקנה ותובנות מרכזיות
גריפת אתרים עם BeautifulSoup היא אחת המיומנויות הפרקטיות ביותר שאפשר ללמוד בעולם מונחה הנתונים של היום. הנה מה שסקרנו במדריך גריפת האתרים הזה עם BeautifulSoup:
- BeautifulSoup הוא נקודת ההתחלה האידיאלית לניתוח HTML סטטי וחילוץ נתונים מובנים עם Python.
- ההגדרה פשוטה מאוד—רק מתקינים Python, pip ועוד כמה ספריות.
- בדיקת HTML היא המפתח לטרגוט הנתונים הנכונים.
- ייצוא ל-CSV/Excel הופך את הנתונים לשימושיים מיד לניתוח עסקי.
- שילוב עם Thunderbit נותן זיהוי שדות מבוסס AI, גריפה מהירה יותר וייצוא קל יותר—מושלם למשתמשים עסקיים ולא-מתכנתים.
- תהליכי עבודה היברידיים (Thunderbit לחילוץ בכמות, BeautifulSoup לעיבוד מותאם אישית) מספקים את המהירות, איכות הנתונים והגמישות הטובות ביותר.
אם אתם מוכנים לשדרג את יכולות גריפת האתרים שלכם, נסו את שני הכלים: התנסו בסקריפט BeautifulSoup פשוט, ואז בדקו כמה מהר יותר תוכלו לעבוד עם כלי גריפת האתרים של Thunderbit מבוסס ה-AI. ולמדריכים מעשיים נוספים, בקרו ב-Thunderbit Blog.
גריפה נעימה—ושכל הנתונים שלכם יהיו תמיד נקיים, מובנים ומוכנים לפעולה.
נסו את Thunderbit AI Web Scraper Get Started Free
שאלות נפוצות
1. מה זה BeautifulSoup ולמה הוא משמש?
BeautifulSoup היא ספריית Python לניתוח מסמכי HTML ו-XML. היא עוזרת לכם לחלץ נתונים מדפי אינטרנט ולהפוך אותם לפורמטים מובנים כמו רשימות או טבלאות, מה שהופך אותה לאידיאלית לפרויקטים של גריפת אתרים.
2. איך BeautifulSoup משתווה ל-Selenium ול-Scrapy?
BeautifulSoup קל משקל וקל לשימוש עבור דפי HTML סטטיים. Selenium עדיף לגריפת אתרים דינמיים וכבדים ב-JavaScript, בעוד ש-Scrapy הוא מסגרת עבודה מלאה לגריפה אסינכרונית בקנה מידה גדול. BeautifulSoup הוא הבחירה הטובה ביותר למתחילים ולמשימות מהירות.
3. אפשר להשתמש ב-BeautifulSoup וב-Thunderbit יחד?
בהחלט. Thunderbit יכול לזהות ולחלץ במהירות שדות מדפי אינטרנט בעזרת AI, ואתם יכולים להשתמש ב-BeautifulSoup לעיבוד מותאם אישית לאחר מכן או לניתוח מעמיק יותר של הנתונים שיוצאו.
4. מהן האתגרים הנפוצים בגריפת אתרים עם BeautifulSoup?
בעיות נפוצות כוללות טיפול בתוכן דינמי, התמודדות עם אמצעי אנטי-בוט והסתגלות לשינויים במבנה ה-HTML. שימוש ביכולות ה-AI של Thunderbit או במצב הדפדפן יכול לעזור להתגבר על רבות מהבעיות האלה.
5. איך מייצאים נתונים שנגרפו עם BeautifulSoup ל-Excel או CSV?
אפשר להשתמש במודול csv המובנה של Python או בספריית pandas כדי לכתוב את הנתונים שחילצתם לקבצי CSV או Excel. השתמשו תמיד בקידוד UTF-8 כדי לטפל בתווים מיוחדים ולהבטיח תאימות לכלי גיליונות אלקטרוניים.
מוכנים לנסות בעצמכם? הורידו את תוסף Chrome של Thunderbit והתחילו לגרוף בצורה חכמה יותר כבר היום. לעוד מדריכים וטיפים, בקרו ב-Thunderbit Blog.
למדו עוד




