
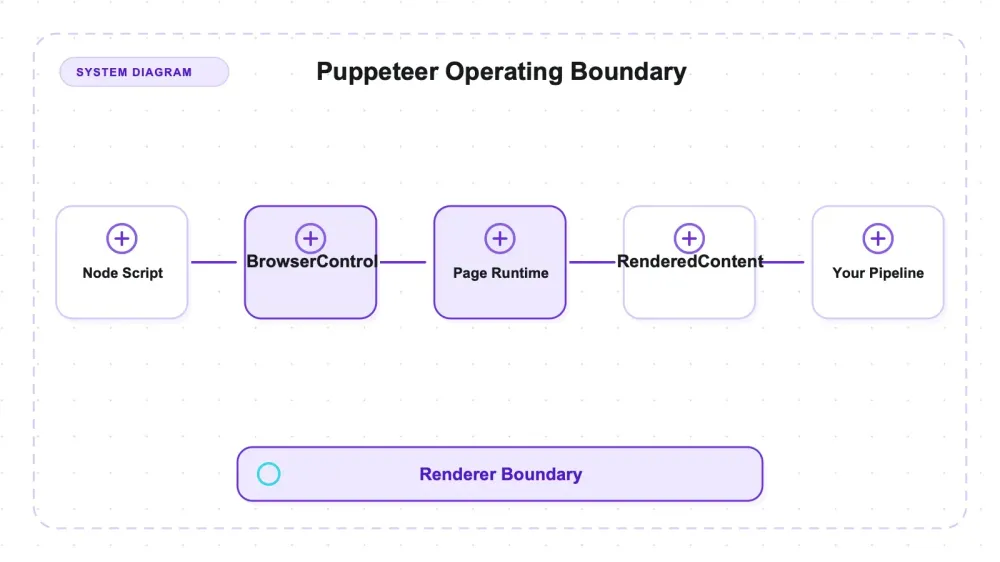
Puppeteer הוא ספריית Node של Google לשליטה ב-Chrome אמיתי מתוך JavaScript — אתם כותבים את האוטומציה, Chrome DevTools Protocol מעביר את הפקודות, ודפדפן מלא מרנדר את הדף לפני שאתם קוראים ממנו אפילו בית אחד. הוא יושב ב-puppeteer/puppeteer ב-GitHub: ברישיון Apache-2.0, כתוב ב-TypeScript, ומחזיק בערך 95.3 אלף כוכבים (95,307 ביום שבו משכתי את ה-snapshot). המיצוב הרשמי שלו מכוון צר במיוחד — "ממשק JavaScript לשליטה ב-Chrome (ובניסוי גם Firefox)" — וזה אומר לכם מה הוא כן, ובאותה מידה מה הוא לא.
הרצתי את Puppeteer 24.16.0 דרך אותו שרת בדיקות ודמוים ציבוריים שאנחנו משתמשים בהם לכל ספריית אוטומציית דפדפן: קטלוג סטטי עם עימוד, כתבה, קטלוג שמרונדר ב-JavaScript, API ב-JSON, מסלול שמחזיר 500, גרף סריקה קטן, וגם את Books to Scrape ו-Quotes to Scrape. הוא ביצע את עבודת הרינדור בצורה נקייה וללא דרמה. אבל הוא גם השאיר על השולחן בדיוק עבודה אחת — אותה עבודה שכל ספריית headless-browser משאירה — וההכרה בכנות בפער הזה היא כמעט כל מה שמבדיל בין סקירה שימושית לבין הודעת יח״צ.
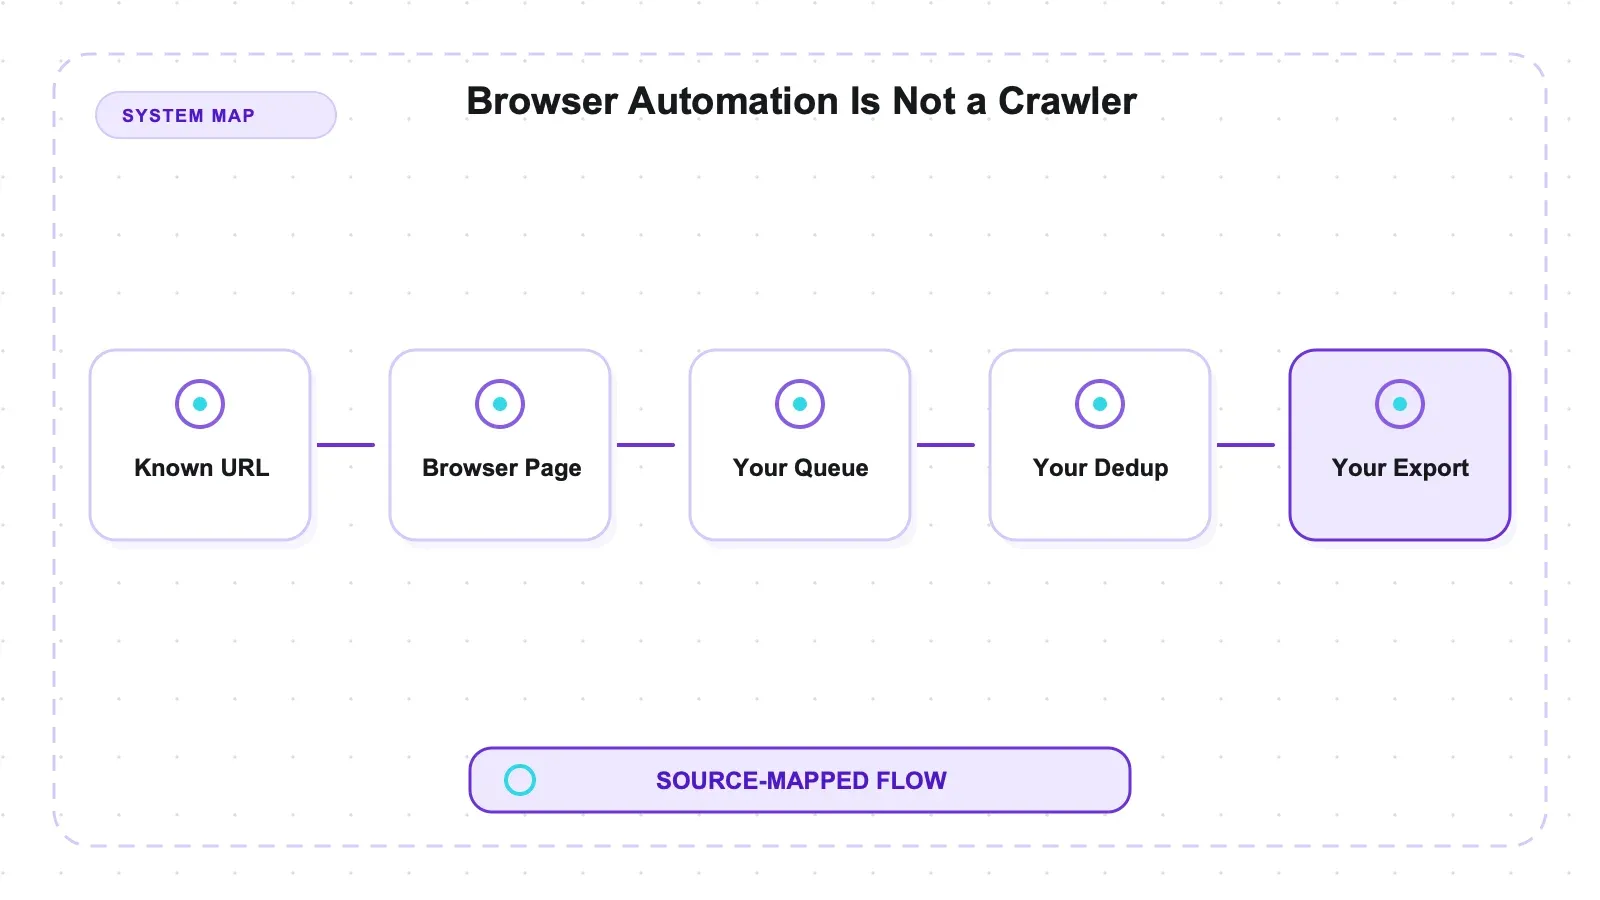
מספר אחד בלט אפילו יותר ממספרי ה-recall. בדף שהמידע שלו מגיע מנקודת קצה JSON, Puppeteer שלף את כל 8 הרשומות בלי לגרד בכלל את ה-DOM — הוא הריץ fetch בתוך הדף וקרא ישירות את אובייקט התגובה. זה, יחד עם רינדור מקורי וצילומי מסך שעובדים, הוא האופי של הכלי: רנדרר Chrome בוגר, לא מסגרת סריקה, וההבדל הזה חשוב עוד לפני שמקלידים שורה אחת.
מה Puppeteer באמת הוא — ומה הוא מתחרה בו
תווית הקטגוריה עושה כאן עבודה אמיתית, אז נתחיל ממנה. Puppeteer הוא ספריית אוטומציית דפדפן. הוא מפעיל את Chrome, פותח דפים, נותן ל-JavaScript של הדף לרוץ, ומחזיר לכם את התוצאה המרונדרת כדי לקרוא אותה או לצלם אותה. זו כל הסיבה לבחור בו במקום בלקוח HTTP יחד עם מנתח HTML: אתם רוצים את הדף אחרי שהסקריפטים שלו רצו, לא את הקליפה הריקה שהשרת שולח קודם.
מבחינת צורה, הוא מתחרה בספריות דפדפן אמיתיות אחרות — Playwright ו-Selenium — ולא במסגרות סריקה כמו Scrapy או בכלי Markdown ל-LLM. אם תפנו את Puppeteer לאלף כתובות ותצפו ממנו לתזמן אותן, למנוע כפילויות, להאט בנימוס ולכתוב סט נתונים, לקחתם רנדרר לבעיית סריקה. הוא ירנדר כל דף יפה, אבל לא ינהל שום תזמור. (זו מגבלת תחום, לא באג — אחזור לזה, כי זה הדבר החשוב ביותר להפנים לפני שמאמצים את הכלי.)
Puppeteer יצא מצוות Chrome של Google, ולכן הוא Chrome-first לפי התכנון, ולמה ה-API שלו מרגיש כמו כפפה דקה ומשומשת היטב מעל פרוטוקול הדיבוג של הדפדפן. הוא ותיק מספיק כדי להיות משעמם במובן הטוב: המתודות שאתם צריכים יציבות כבר שנים, התיעוד מקיף, והמערכת שסביבו עמוקה.
רינדור מקורי ודפוס של fetch בתוך הדף
שתי התנהגויות שוות הדגשה מתוך טבלת התוצאות, כי הן מגדירות איך באמת תשתמשו בכלי.
ראשית, רינדור מקורי. הקטלוג שמרונדר ב-JavaScript — דף שבונה את גריד המוצרים בצד הלקוח אחרי הטעינה — חזר עם 8/8, כולל צילום מסך מלא שנשמר לדיסק. ההגדרה הייתה מינימלית, אבל כן כללה המתנה לתוכן היעד אחרי goto. עמוד Quotes to Scrape JS הציבורי החזיר את כל עשר הציטוטים עם אותו דפוס. אלו תוצאות של fixture, לא ציון recall כללי של רינדור.
שנית, fixture ה-JSON API טען מוצרים מ-/api/dynamic-products. הרצת fetch מאותו origin דרך page.evaluate החזירה את כל שמונה הרשומות בלי לפרש שורות מרונדרות. זהו דפוס כללי של הערכה בתוך דפדפן, לא יכולת גילוי ייחודית ל-Puppeteer. הוא יכול לפשט חילוץ כשנקודת הקצה וחתימת הבקשה ידועות; אבל כותרות אימות, טוקנים בזמן ריצה, מדיניות credentials, CORS/CSP, service workers ועימוד עדיין יכולים לגרום לבקשת האפליקציה להיות שונה.
הדבר השלישי שכדאי לקחת הלאה הוא המסגור, לא מספר: Puppeteer הוא רנדרר Chrome בוגר, והוא לא crawler. שני החצאים נכונים, והחצי השני הוא זה שהרבה כתבות מדלגות עליו.
איך Puppeteer מדבר עם Chrome
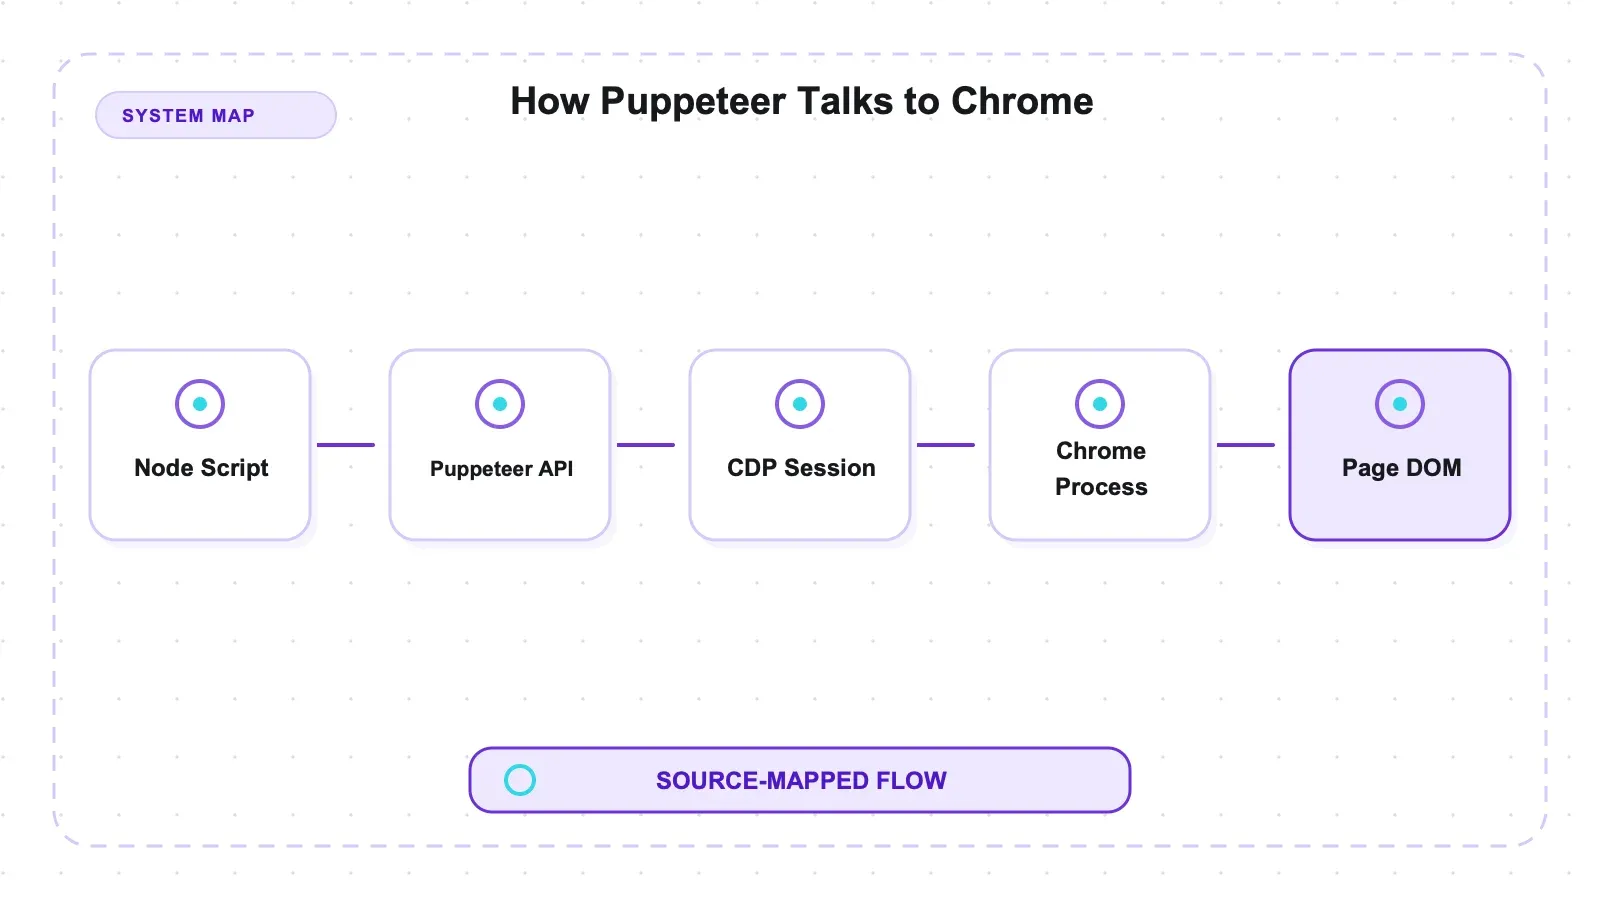
ב-Chrome, Puppeteer משתמש ב-Chrome DevTools Protocol (CDP), ערוץ JSON מעל WebSocket שבו משתמשים כלי ה-DevTools של הדפדפן. puppeteer.launch() מפעיל את Chrome ופותח את חיבור הפרוטוקול הזה; קריאות כמו goto, $$eval ו-screenshot חושפות פעולות דפדפן דרך API ברמה גבוהה יותר. התמיכה ב-Firefox עוברת בנתיב WebDriver BiDi שמוסבר בהמשך, כך שלא כל פעולה של Puppeteer היא בהכרח פקודת CDP אוניברסלית.
page.evaluate מריץ פונקציה בתוך הקשר של דף, ולכן fetch('/api/...') יחסי משתמש ב-origin של אותו דף ועשוי לעשות שימוש חוזר בקוקיז תקפים ובמצב סשן. הוא לא משחזר אוטומטית כותרות הרשאה, אפשרויות בקשה, טוקנים או התנהגות של service-worker שנוצרו על ידי האפליקציה. ב-fixture הזה, מאותו origin, הוא החזיר JSON ישירות; בקשות בייצור צריכות להיבדק מול החוזה האמיתי שלהן.
זו גם הסיבה ש-Puppeteer כבד. כל דף הוא לשונית דפדפן אמיתית עם מנוע רינדור אמיתי מאחוריה. זה קונה דיוק בדפים עתירי JavaScript, אבל עולה בזיכרון ובזמן עלייה לעומת fetch-HTTP בלבד. אין רינדור בחינם; CDP פשוט הופך את החשבון לגלוי.
שאלת המנוע, בלי סיבובים
יש קיצור דרך פופולרי שאומר ש-Puppeteer הוא "רק ל-Chrome". עבור הגרסה שבדקתי, זה לא נכון, והדיוק הזה משנה את ההשוואה.
| מנוע | איך Puppeteer 24.16.0 מפעיל אותו | הופעל בבדיקות האלה |
|---|---|---|
| Chrome | Chrome-first דרך CDP — ברירת המחדל, כך שאוטומציות קיימות ממשיכות לעבוד | כן |
| Firefox | תמיכה מתועדת דרך WebDriver BiDi מאז v23 | לא |
| WebKit | לא מופעל בכלל | — |
גם Chrome for Developers וגם Mozilla כתבו על המעבר ל-Firefox כשהוא נחת. הבילד שהרצתי, 24.16.0, כבר הרבה אחרי v23, כך ש"רק Chrome" ממעיט במה שנשלח בחבילה. היעדר WebKit, יחד עם הגיל הצעיר יחסית של הסיפור הרב-מנועי שלו לעומת Playwright, הוא פער הרוחב האמיתי — לא "מנוע אחד מול שלושה".
הנתיב של Firefox/BiDi מתועד וזמין בגרסה שבדקתי, אבל לא הרצתי את ה-fixtures שלי דרכו, ולכן אני מדווח על יכולת ולא על מדידה. אם תמיכה ב-Firefox היא קריטית למטרות שלכם, בדקו אותה מול הדפים שלכם לפני שמתחייבים. לקוראים שרוצים השוואה מלאה ראש-בראש על מנוע ושפת שימוש, ה-השוואה בין Playwright ל-Puppeteer שלנו מריצה את שתי הספריות דרך אותן בדיקות ומכריעה שם את שאלת ה"מי עדיף"; כאן הנושא הוא Puppeteer בלבד.
התקנה בפועל: הדפדפן הוא החלק הכבד
ברירת המחדל של npm install puppeteer מורידה build תואם של Chrome for Testing. אפשר לדלג על ההתנהגות הזו או להפנות אותה דרך קונפיגורציה, וניתן גם לכוון את Puppeteer לקובץ הרצה אחר, כך שהתאמת הגרסאות תלויה בהחלטת הפריסה. הורדת הדפדפן הייתה החלק הכבד ביותר בהתקנה הזו; snapshot של אודיט חבילות לא נחשב כאן לתכונת אבטחה יציבה לאורך זמן.
האריזה האוטומטית הזו היא גם יתרון אמיתי בקלות שימוש וגם עלות אמיתית בנפח, ושווה לקרוא לשני הצדדים בשמם. היתרון: לא צריך לחפש דפדפן תואם או לנעוץ גרסאות ידנית; npm install נותן זוג שעובד. העלות: אתם מורידים דפדפן, אז צריך לתקצב דיסק ו-bandwidth, במיוחד ב-CI, שבו cache קר מחזיר את המחיר הזה בכל runner חדש.
זו גם נקודת ניגוד אמיתית ל-Playwright, שמפצל את שני השלבים — מתקינים את הספרייה, ואז מריצים npx playwright install נפרד כדי למשוך את ה-builds של הדפדפן. אף אחת מהגישות לא כואבת; הן פשוט נכשלות בצורה אחרת. הפקודה האחת של Puppeteer יכולה להפתיע אתכם בגודל שלה בחיבור מדוד, בעוד שהשלב השני של Playwright יכול להפתיע אתכם כי שכחו להריץ אותו. חשוב לדעת מה אתם מריצים.
תוצאות מעשיות
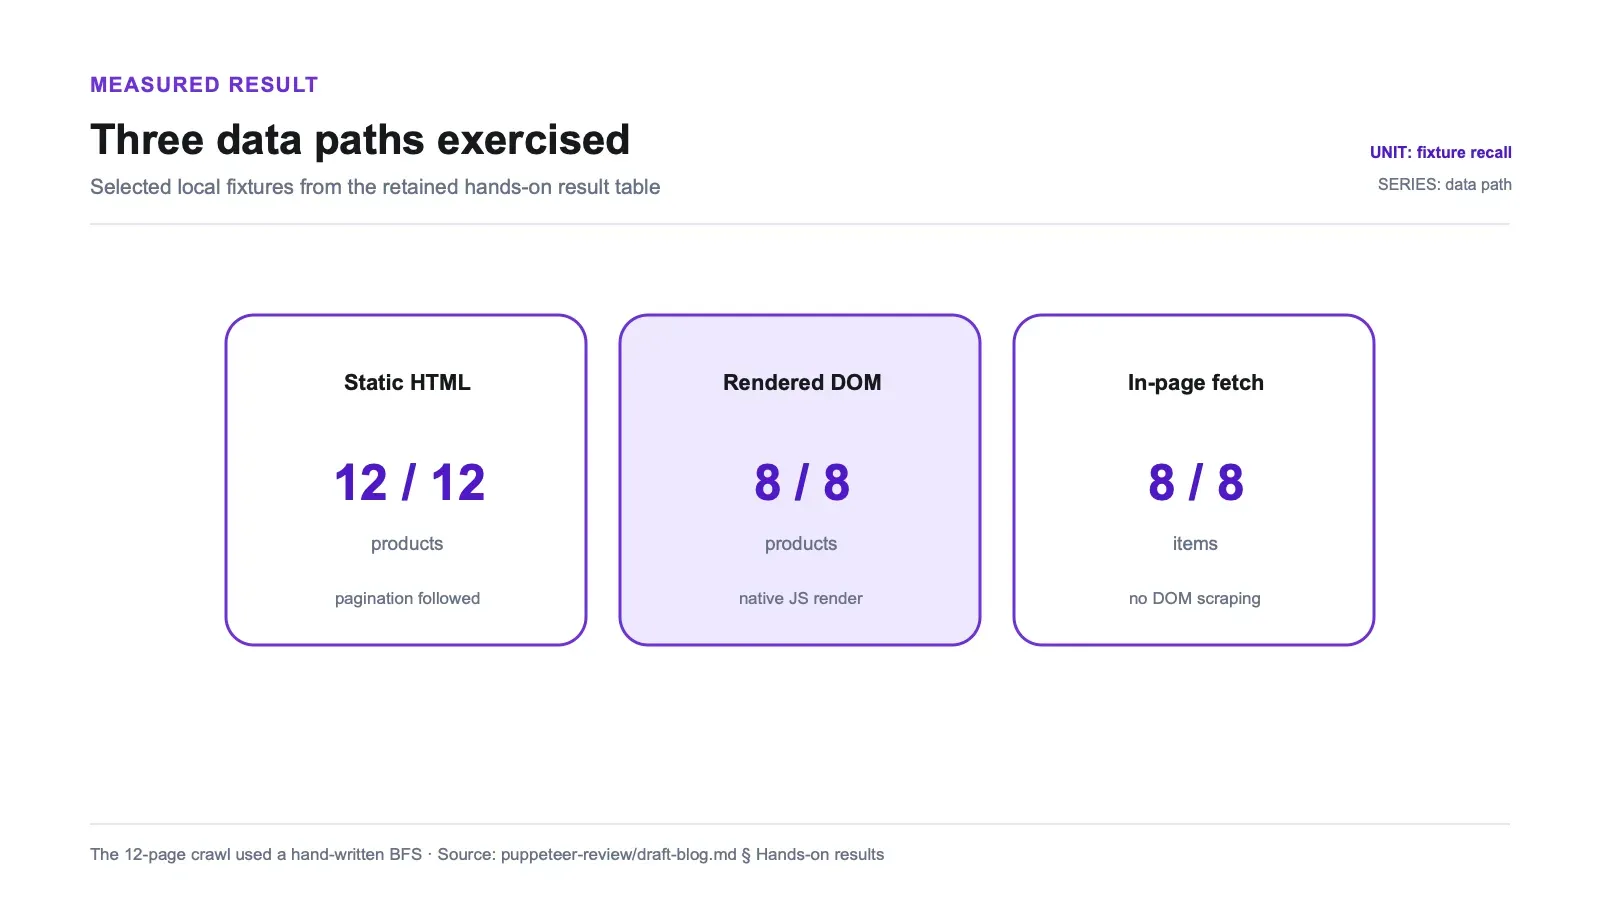
כל בדיקה רצה מול שרת fixture מקומי על 127.0.0.1 יחד עם שני אתרי תרגול ציבוריים, על Node v22.22.3, macOS arm64, עם Puppeteer 24.16.0 ו-Chrome המצורף אליו. ה-ground truth של כל fixture נרשם לפני הריצה, כך שה-recall נמדד מול סט צפוי קבוע ולא מול מה ש-Puppeteer הדפיס במקרה.
חבילת המחקר הציבורית כוללת את שרת ה-fixture, את runner הבדיקות, ואת ה-ground truth. קובץ הנעילה של התלויות וסיכום הריצה הגולמי הושמטו במכוון מחבילת הפרסום, משום שסקרת האבטחה המחמירה דחתה נתוני lockfile וחומר של endpoints תלויי-סביבה. כדי לשחזר את ה-fixture המקומי הבטוח, הריצו npm install ואז node run_puppeteer_material_tests.mjs בתוך tools/puppeteer/tests, ואז השוו את התוצאה ל-ground truth שפורסם. דפי הדמו הציבוריים עשויים להשתנות, ולכן ה-fixture המקומי הוא הבסיס היציב לבדיקות של מספרי הציפייה.
לשחזור היסטורי מדויק של התלויות, צרו ובדקו lockfile חדש מקומית במקום להתייחס ל-lock שלא פורסם כאל ראיה ציבורית.
| בדיקה | יעד | תוצאה |
|---|---|---|
| קטלוג סטטי + עימוד | fixture מקומי | 12/12, recall 1.0 |
| חילוץ כתבה | fixture מקומי | כותרת + 3/3 פסקאות, boilerplate מופרד |
| דף דינמי (רינדור מקורי) | fixture מקומי | 8/8, recall 1.0, נשמר צילום מסך מלא |
API דינמי ב-JSON (fetch בתוך הדף) | fixture מקומי | 8/8, recall 1.0, בלי scraping של DOM |
| טיפול ב-HTTP 500 | fixture מקומי | סטטוס 500 ניתן לבדיקה, בלי חריגה |
| גרף סריקה (BFS שנכתב ידנית) | fixture מקומי | 12 דפים, עומקים {0:1, 1:4, 2:7} |
| Books to Scrape | דמו ציבורי | 20 מוצרים |
| Quotes JS | דמו ציבורי | 10 ציטוטים, מרונדרים באופן מקורי |
כמה מהן ראויות למשפט מעבר לטבלה.
קוד העימוד שנכתב עבור הבדיקה שחזר את כל 12 פריטי הקטלוג הצפויים. בורר הכתבה שחזר את הכותרת ואת שלוש פסקאות הגוף הצפויות; boilerplate מסביב נשאר זמין ב-DOM. Puppeteer סיפק את ה-DOM המרונדר, אבל לוגיקת הסלקטורים — ולא Puppeteer עצמו — הגדירה מה נחשב לתוכן הכתבה.
במסלול HTTP 500 שנבדק, goto החזיר אובייקט תגובה עם סטטוס 500 שניתן לבדיקה ולא זרק חריגה. זה לא אומר דבר על timeouts, כשלי DNS, קריסות דפדפן, frames מנותקים או שגיאות ניווט אחרות, שעדיין דורשות טיפול מפורש.
גרף הסריקה הוא זה שמספר את כל הסיפור. מעבר על הקישורים הפנימיים של ה-fixture עד 12 דפים, תוך מעקב אחרי עומק כדי לא לבקר מחדש בכתובות, דרש חיפוש רוחב (BFS) שנכתב ידנית — כי ל-Puppeteer אין תור סריקה מובנה. הוא מצא את כל 12 הדפים לאורך העומקים {0:1, 1:4, 2:7}, כלומר ה-BFS שלי עבד. אבל ה-BFS היה שלי. Puppeteer רנדר כל דף; ההיגיון של הליכה באתר היה קוד שכתבתי. עבור 12 דפים, זה תריסר שורות ולא עניין גדול. עבור אלפי כתובות עם דה-דופ, ניסיונות חוזרים והשהיות נימוס, תריסר השורות האלה הופכות לפרויקט.
אזהרה אחת אחזור עליה כי קל לנצל אותה לרעה: החומרים כוללים זמני ריצה לכל בדיקה, אבל אלו תצפיות של ריצה אחת, על מכונה אחת, ולא benchmarks. אני לא מדרג את המהירות של Puppeteer מול משהו אחר על סמך לפטופ אחד וריצה אחת. מה שהמספרים כן תומכים בו הוא recall והתנהגות על פני שמונה סוגי דפים שונים — לא טענה של סטופר.
מה לא בדקתי
כדי שהתוצאות לא ייקראו רחבות יותר ממה שהן, הנה מה נשאר מחוץ לריצת הבדיקה, ולכן מחוץ למספרים האלה:
| מחוץ לריצת הבדיקה | סטטוס |
|---|---|
| Firefox דרך WebDriver BiDi | מתועד, זמין ב-24.16.0, לא הופעל כאן |
| פרוקסי ו-interception של בקשות | לא נבדקו; שתיהן יכולות נתמכות שלא הרצתּי |
| סקייל של ריבוי דפים במקביל | הרצתי בהיקף קטן; התנהגות של חוות דפדפנים תחת concurrency אמיתי לא נמדדה |
| הרצה מחדש על הגרסה החדשה ביותר | בדקתי 24.16.0; npm latest הוא 25.3.0, גרסה מלאה קדימה, נכון ל-2026-07-09. ה-APIs שהרצתי (launch, goto, $$eval, screenshot, ו-fetch בתוך הדף) יציבים בין 24 ל-25, אבל המהלך ההגון הוא להריץ שוב על 25.3.0 לפני שסומכים על מספרים מדויקים |
אף אחד מאלה אינו נקודת חובה. אלה פשוט הגבולות של מה שריצה אחת על fixture אחת יכולה לטעון בכנות.
יתרונות וחסרונות
יתרונות:
- רינדור JavaScript מקורי עם המתנה מפורשת לתוכן: 8/8 ב-fixture הדינמי וכל עשר הציטוטים בדמו הציבורי, עם צילומי מסך.
- בורר העימוד והכתבה שנכתבו ידנית שחזרו את פריטי ה-fixture הצפויים.
fetchבתוך הדף החזיר את כל שמונה הרשומות מנקודת קצה ידועה מאותו origin בלי parsing של ה-DOM.- ה-HTTP 500 שנבדק חזר כתשובה שניתן לבדוק, בלי חריגה.
- ההתקנה ברירת המחדל מורידה build תואם של Chrome for Testing; עדיין אפשר להגדיר executable חלופי או לדלג על ההורדה.
- API בוגר וממוקד Chrome מעל CDP, עם אקוסיסטם עמוק ותיעוד מקיף. Apache-2.0.
- רחב יותר מהמוניטין שלו: תמיכה מתועדת ב-Firefox דרך WebDriver BiDi מאז v23.
חסרונות:
- אין תור סריקה מובנה, writer ל-dataset או throttle — סריקה בקנה מידה דורשת קוד משלכם או wrapper.
- אין מנוע WebKit, והסיפור הרב-מנועי שלו צעיר יותר מזה של Playwright.
- משקל של דפדפן אמיתי: Chrome מצורף להורדה ועלות זיכרון לכל דף לעומת כלים של HTTP בלבד.
- מבוסס Node; שימוש בו משפה אחרת דורש לבנות ולתחזק גשר.
- הגרסה שהרצתי (24.16.0) מפגרת אחרי npm latest (25.3.0) בגרסה מלאה — צריך לאמת שוב על העדכנית לפני שסומכים על מספרים מדויקים.
למי זה מתאים, ומי עדיף שיוותר
בחרו ב-Puppeteer אם אתם חיים ב-Node, המטרות שלכם מרונדרות מצוין ב-Chrome (וזה המצב אצל רוב האתרים), ואתם רוצים ספרייה בוגרת וממוקדת שהופכת "הדף אחרי שה-JavaScript שלו רץ" למשהו שאפשר לקרוא ולצלם. כדי לגרד סט דפים דינמיים, או לשלוף API ב-JSON עם הסשן של הדף עצמו, או לתעד צילומי מסך מרונדרים כראיה, זו ברירת מחדל חזקה וללא דרמה. אפשרות Firefox דרך BiDi קיימת אם תצמחו אליה, והאקוסיסטם אומר שרוב הבעיות שתיתקלו בהן כבר נתקלו בהן לפני כן.
חשבו פעמיים אם הבעיה שלכם היא תזמור סריקה ולא רינדור. אם אתם צריכים לעבור על מאות או אלפי כתובות עם מניעת כפילויות, ניסיונות חוזרים ומגבלות קצב, Puppeteer לבדו יגרום לכם לבנות crawler בעצמכם — זו לא הרמה הנכונה עבורו. וותרו על headless browser לגמרי אם הדפים שלכם לא באמת צריכים JavaScript כדי לחשוף את הנתונים; כשבקשת HTTP ומנתח מחזירים את התוכן, דפדפן אמיתי הוא פינוק יקר מדי שבזבז רק זיכרון וזמן הקמה. ואם אתם צריכים נאמנות ל-WebKit או לקוח בשפה שאינה JavaScript, זה לא הכלי לציר הזה.
חלופות, ואיפה Thunderbit נכנס
המסגור ההכני קודם כל: Puppeteer הוא חינמי, Apache-2.0, self-hosted, ואתם אחראים לכל חלק מהרצה שלו — חוות הדפדפנים, קוד הסריקה שאתם מוסיפים מעליו, ומלחמת ה-anti-bot המתמשכת. להרבה פרויקטים, הבעלות הזו היא בדיוק מה שנכון, ושום שירות מנוהל לא ירנדר דף מורשה בזול יותר מדפדפן שכבר יש לכם.
בתוך עולם הקוד הפתוח, ההשוואות השימושיות הן לפי משימה, לא לפי לוגו. עבור סריקה בקנה מידה, Crawlee הוא השותף הטבעי: PuppeteerCrawler שלו עוטף את Puppeteer עם תור בקשות, dataset ו-throttling שהספרייה משאירה במכוון מחוץ לחבילה, כך שאתם שומרים את הרינדור ומקבלים את התזמור. אם יעד הפלט שלכם הוא Markdown נקי ל-pipeline של LLM ולא DOM מרונדר, Crawl4AI מפעיל דפדפן אמיתי ומפיק בדיוק את זה. אם הדפים שלכם לא צריכים דפדפן בכלל, מסגרת HTTP-first כמו Scrapy היא קטגוריה שונה וקלה יותר. כשאתם שוקלים כמה מהאפשרויות האלה יחד, הסיכום שלנו על סקרייפרים בקוד פתוח מציג את הקטגוריות זו לצד זו.
שירות מנוהל כמו Thunderbit מעביר את הפעלת הדפדפן והחילוץ מאחורי API. הוא לא הורץ דרך ה-fixtures של Puppeteer כאן, ולכן הסקירה הזו לא טוענת התאמה זהה לגבי רינדור, חסימות, איכות החילוץ או עלות. קו ההכרעה הוא בעלות תפעולית: לתחזק בעצמכם את קוד הדפדפן והסריקה, או לשלם לספק שיפעיל חלק מהשכבה הזו.
עם Puppeteer אין דמי שימוש לספק, אבל חישוב, רוחב פס, תחזוקת דפדפן, תזמור ותפעול נשארים שלכם. מסלול מנוהל גובה לפי שימוש ומעביר חלק מהאחריות לספק. הניסוי הזה לא השווה בין התוצאות.
נסו את Thunderbit לחילוץ נתוני רשת
פסק דין
Puppeteer 24.16.0 שווה בחינה אם אתם ב-Node וצריכים אוטומציית דפדפן שמבוססת על Chrome. קוד ה-fixture שנכתב ידנית שחזר 12 פריטים סטטיים, שמונה פריטים דינמיים ועשר תשובות מדמו ציבורי; ה-API מאותו origin החזיר שמונה רשומות דרך page.evaluate; צילומי מסך עבדו; וה-HTTP 500 שנבדק נשאר ניתן לבדיקה. התוצאות האלה שייכות ל-fixtures הנקובים ולגרסה ראשית ישנה יותר, לא ל-recall של חילוץ באופן כללי.
אבל צריך למסגר את הטענות נכון. Puppeteer הוא רנדרר, לא crawler: ההליכה שלי על 12 דפים דרשה BFS שנכתב ידנית כי אין תור מובנה, ובקנה מידה זה עבודה אמיתית — תנו אותה ל-Crawlee או כתבו את המנגנון בעצמכם. הוא Chrome-first עם תמיכה מתועדת ב-Firefox דרך BiDi אבל בלי WebKit, כך שהוא לא הכלי לרוחב בין מנועים. הוא נושא איתו את המשקל של דפדפן אמיתי. ובדקתי 24.16.0 מול latest של 25.3.0, אז הריצו שוב על הגרסה הנוכחית לפני שסומכים על מספרים מדויקים. אם מבינים את ארבע הנקודות האלה מראש, Puppeteer הוא ספריית אוטומציית Chrome מצוינת. אם מצפים ממנו לסרוק אתר בשבילכם, תכתבו את ה-crawler שחשבתם שאתם מורידים.
נסו את Thunderbit לחילוץ נתוני רשת Get Started Free
שאלות נפוצות
האם Puppeteer מרנדר דפי JavaScript, או שצריך תוסף?
הוא מרנדר אותם באופן מקורי, בלי תוסף. ב-fixture הדינמי שלי הוא החזיר 8 מתוך 8 מוצרים שנבנו בצד הלקוח עם recall 1.0 וצילום מסך מלא, ועמוד Quotes to Scrape JS הציבורי החזיר את כל 10 הציטוטים באותו אופן — goto פשוט, ואז קריאה ל-DOM המרונדר. מכיוון ש-Puppeteer מפעיל Chrome אמיתי דרך DevTools Protocol, הסקריפטים של הדף באמת רצים לפני שאתם קוראים משהו.
האם Puppeteer יכול לגרד API ב-JSON בלי לפרש את ה-HTML?
כן, כשנקודת הקצה וחוזה הבקשה מאפשרים זאת. page.evaluate יכול לשלוח בקשה מתוך ה-origin של הדף ועשוי לעשות שימוש חוזר בקוקיז מתאימים, אבל הוא לא משחזר אוטומטית כותרות אפליקציה, טוקנים, אפשרויות או התנהגות של service-worker. ב-fixture מאותו origin הוא החזיר את כל שמונה הרשומות בלי parsing של DOM.
האם Puppeteer הוא web crawler? לא — זו ספריית אוטומציית דפדפן, לא מסגרת סריקה. אין בו תור בקשות מובנה, writer ל-dataset או throttle, ולכן הסריקה שלי על 12 דפים (עומקים {0:1, 1:4, 2:7}) דרשה BFS שנכתב ידנית. זו מגבלת תחום, לא פגם. לסריקה בקנה מידה, אפשר לשלב אותו עם wrapper כמו PuppeteerCrawler של Crawlee, שמוסיף את מנגנוני התור וה-dataset ש-Puppeteer משאיר בחוץ.
האם Puppeteer עובד רק עם Chrome? לא יותר. הוא Chrome-first מעל CDP, אבל מאז v23 יש לו תמיכה מתועדת ב-Firefox דרך WebDriver BiDi, והגרסה שבדקתי (24.16.0) כבר הרבה מעבר לזה. מה שהוא לא מפעיל הוא WebKit, והסיפור הרב-מנועי שלו צעיר יותר מזה של Playwright — זו, ולא "רק Chrome", המגבלה המדויקת. כאן הרצתי רק Chrome, אז אני מדווח על Firefox דרך BiDi כמשהו מתועד, לא כמשהו שמדדתי.
מה ההתקנה של Puppeteer באמת מורידה?
ברירת המחדל של npm install puppeteer מורידה build תואם של Chrome for Testing. אפשר לדלג על ההורדה או להפנות אותה, וניתן גם להגדיר executable אחר, כך שהתאמת הגרסאות תלויה בהחלטות הפריסה. כדאי לתקצב דיסק ו-bandwidth עבור הדפדפן, במיוחד על runners של CI ללא cache. הסקירה הזו בדקה 24.16.0; הריצו שוב את ה-fixtures המרכזיים על הגרסה הנוכחית בזמן הפרסום.




