
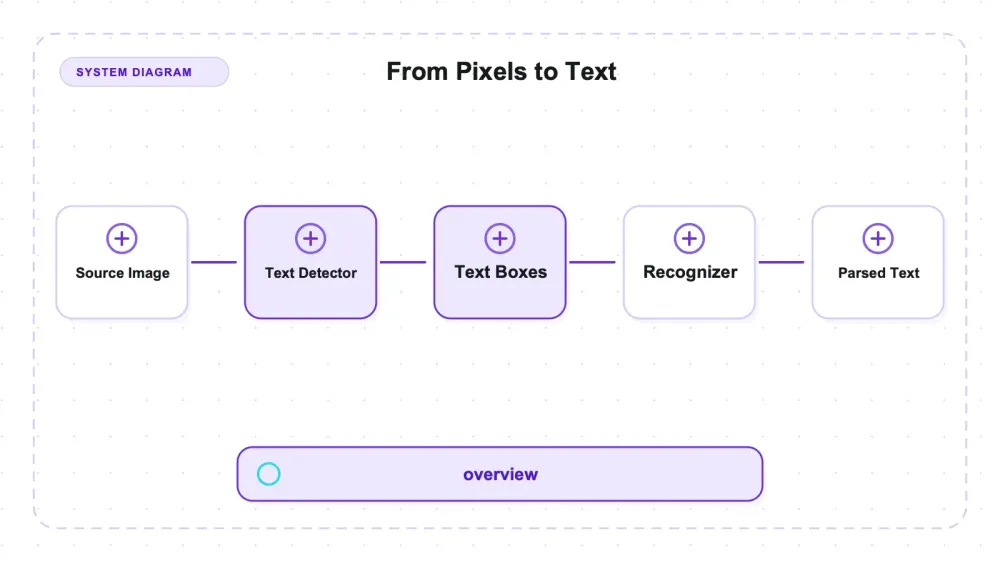
EasyOCR היא ספריית OCR מוכנה לשימוש של JaidedAI ל-Python: pip install easyocr, שתי שורות קוד, והטקסט שמוטמע בתוך תמונה חוזר כמחרוזות. היא מגיעה ברישיון Apache-2.0, תומכת ביותר מ־80 שפות, ופועלת כצינור של שני מודלי PyTorch — גלאי CRAFT שמשרטט תיבות סביב כל מה שהוא מזהה כטקסט, ואז מזהה שקורא את התווים בתוך כל תיבה. המשקולות המאומנות יורדות אוטומטית בפעם הראשונה שמפעילים אותה. מבחינת המבנה, זו אלטרנטיבה מתארחת-עצמית ל-Tesseract ול-PaddleOCR, ולא API ענני של OCR לפי עמוד.
ה-API הבסיסי קצר מאוד: Reader(['en']), ואז readtext(). אבל הפריסה עצמה כבדה יותר — בערך 2 GB של PyTorch בסביבה הזו, וכמיליארד בתים של זיכרון תהליך בשיא במדידת תהליך חדש. רינדּרתי 36 קבצי PNG באנגלית, הרצתי easyocr 1.7.2 על CPU, ודירגתי את הקריאות תו-אחר-תו מול אמת קרקע שנוצרה מראש. גודל וכיוון היו הגורמים שגרמו לקריסות הגדולות ביותר ב-CER; הלוח גם חשף בעיות בזיהוי של טוקנים קצרים ושל סימן דולר.
הכשל הבולט ביותר קשור לפרמטר שרוב האנשים ממליצים עליו. ל-rotation_info יש מוניטין בפורום הבעיות כפתרון ה ליצירות מסתובבות, ולכן בדקתי אותו על שלושה עותקים של אותו משפט, כל אחד מסובב בזווית אורתוגונלית אחרת. ב-270° הוא עשה בדיוק מה שמבטיחים ממנו, והוריד את שגיאת התווים מ-0.83 ל-0.10. ב-180° הוא עבד רק חלקית: מ-0.85 ל-0.67, עם ביטוי שנשמט. ב-90° הוא הלך אחורה, מ-0.81 ל-0.92, והמערכת התחילה להחזיר טקסט משוקף. אותו פרמטר, אותה רשימת זוויות, שלוש תוצאות שונות — ולכן הפעלה שלו לא באמת משמעה ש"הסיבוב מטופל". אותם 36 קבצי בדיקה יצרו גם נפילה חדה לפי גודל פונט, טעות שיטתית בזיהוי של סימן דולר, ותחזית אחת שלי שהתבררה כשגויה לגמרי.
שני מודלים בתחפושת אחת
EasyOCR הוא לא מודל אחד. זהו צינור של שני שלבים, והבנה של איזה שלב נכשל משנה לגמרי את אופן הדיבוג.
השלב הראשון הוא CRAFT, כלומר הגלאי. כל התפקיד שלו הוא לוקליזציה — להחליט איפה בתמונה יש בכלל טקסט, ולהחזיר תיבות. הוא לא קורא אף תו. השלב השני הוא CRNN מזהה — חילוץ מאפיינים עם ResNet, אחר כך BiLSTM, ואז פענוח חמדני ב-CTC — שקורא את התווים שבתוך כל תיבה. שניהם רצים על PyTorch. על CPU, המזהה רץ כברירת מחדל עם quantization דינמי ל-int8, ולכן הוא מהיר וקל יותר מכפי שספירת הפרמטרים הגולמית מרמזת.
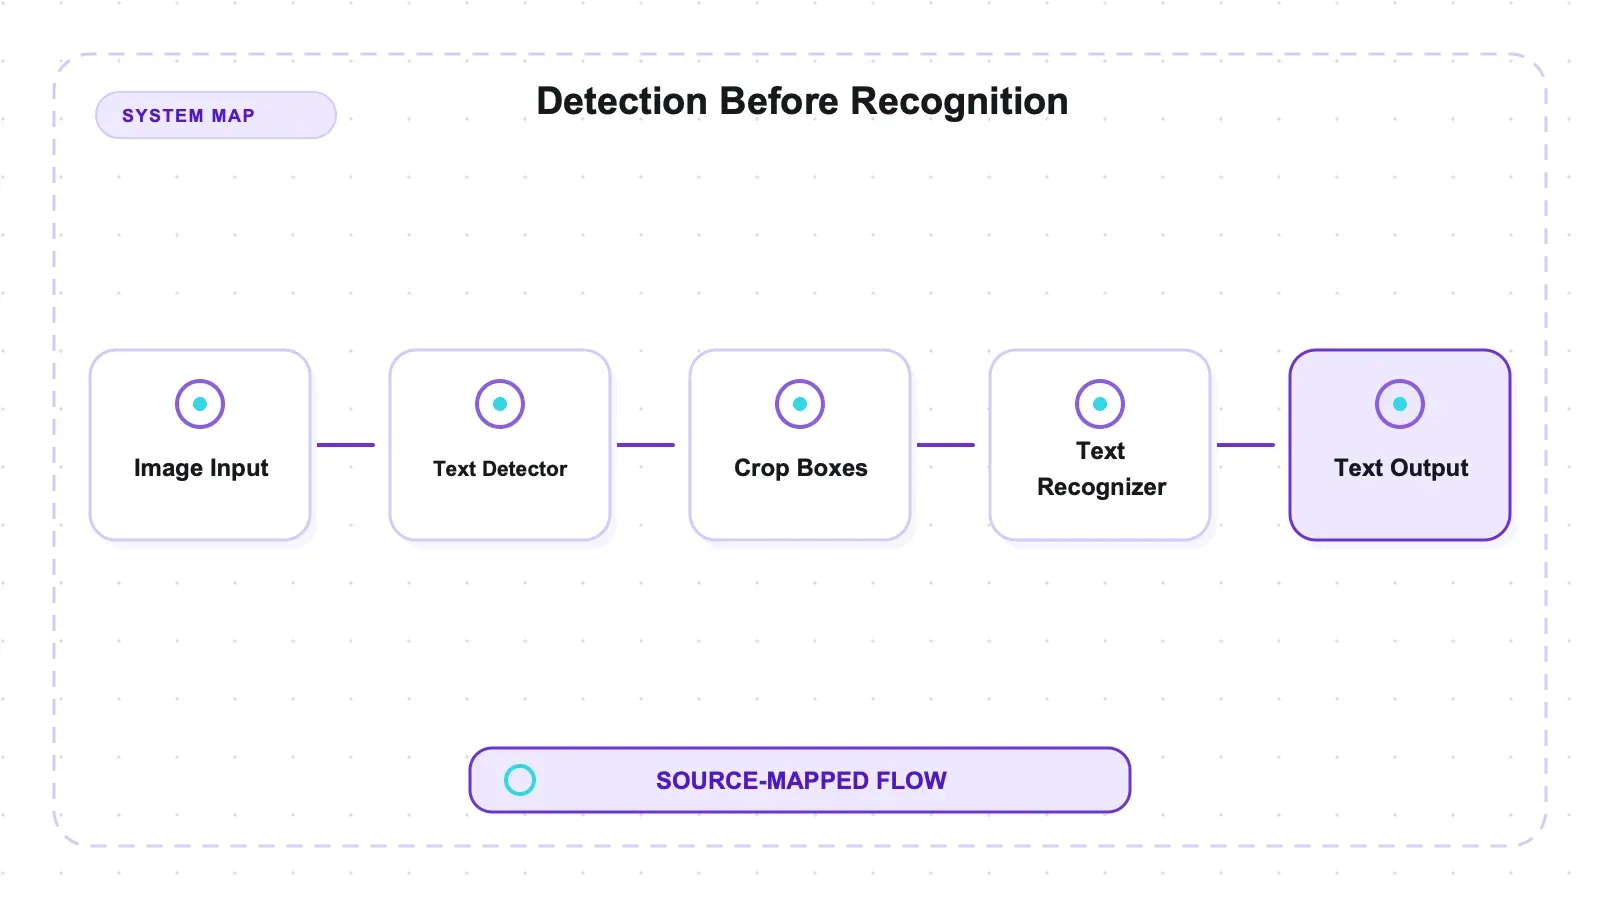
המשמעות המעשית: ל-EasyOCR יש שני מצבי כשל שונים לגמרי, וכל אחד מהם דורש תיקון אחר. אם הגלאי לא מצייר תיבה, שום כיוונון של המזהה לא יעזור — התווים בכלל לא נכנסו לצינור. אם התיבה קיימת אבל המחרוזת שגויה, זו כבר בעיית זיהוי, ועיבוד מקדים יכול להציל. כמעט כל שרשור "EasyOCR פספס את הטקסט שלי" שקראתי מערבב בין השניים.
מצב הפרויקט נכון ל-27 ביולי 2026: 29,825 כוכבים, 528 issues פתוחים, Apache-2.0, ו-v1.7.2 מספטמבר 2024, עם push אחרון ל-master בדצמבר 2025. התאריכים האלה לא מוכיחים יציבות ארכיטקטונית או בריאות תחזוקתית. לפני אימוץ, בדקו תאימות לסטאק Python/PyTorch שלכם, את זמן התגובה של המתחזקים לאחרונה, ואת הבעיות שרלוונטיות לנתונים שלכם.
OCR מזוהה הרבה פעמים עם פתרון CAPTCHA, וזה לא המקרה כאן. שום דבר לא נבדק מול, ושום דבר כאן לא מאשר עקיפת מנגנוני bot-detection. התחום כאן הוא קריאת טקסט מתוך תמונות וצילומי מסך שאתם מורשים לקרוא.
מה מדדתי, ומה המספרים האלה לא כוללים
סט הבדיקה הוא 36 קבצי PNG שיצרתי בעצמי: 35 תמונות של שורה אחת שפרוסות על פני שבעה פונטים, שמונה גדלים, שבע רמות ניגודיות, שבע זוויות הטיה, שלוש רוטציות אורתוגונליות, ושלושה רקעים — ועוד צילום מסך סינתטי אחד של דשבורד עם 19 רכיבים מסומנים בנפרד. כל תמונה נוצרה ממחרוזת קבועה (Sphinx of black quartz, judge my vow. 1234567890 — 48 תווים, אותיות גדולות וקטנות, ספרות וסימני פיסוק) באותו מעבר שכתב גם את תווית האמת-קרקע, כך שהתמונה והתווית שלה פשוט לא יכולות להיסחף זו מזו.
הדיוק נמדד באמצעות Character Error Rate, CER: מרחק לוינשטיין בתווים חלקי אורך אמת הקרקע. CER 0 משמעו קריאה מושלמת. CER 0.10 משמעו בערך תו שגוי אחד מתוך עשרה. אני מציג CER רגיש לרישיות כהדגשה ראשית, ולצידו CER שאינו רגיש לרישיות, כי מתברר שדווקא ברישיות נמצא רוב ה"שגיאה".
הגבולות חשובים יותר מהמספרים:
- אנגלית בלבד. המזהה
english_g2. EasyOCR מפרסם תמיכה ביותר מ-80 שפות; אני בדקתי אחת. שום דבר כאן לא מלמד על סקריפטים לא-לטיניים, שהם בדיוק התחום שבו נמצאות השוואות ה-OCR האקדמיות שפורסמו. - סינתטי בלבד. טקסט שעובד בתוכנה, לא תצלומים. בלי רעש מצלמה, בלי ארטיפקטים של JPEG, בלי תאורה, בלי פרספקטיבה.
- ללא כתב יד. הפרויקט עצמו מציין שכתב יד עדיין לא נתמך.
- CPU בלבד. macOS arm64,
gpu=False. MPS היה זמין במכונה, אבל EasyOCR משתמש ב-CPU בכל דבר שאינו CUDA. ביצועי GPU לא נמדדו, ולכן אין כאן שום מספר GPU. - מכונה אחת, גרסה אחת. easyocr 1.7.2, torch 2.13.0, Python 3.12.
כלומר: אלו עקומות מבוקרות של משתנה אחד, שמראות בדיוק איפה האמינות נשברת, על טקסט לטיני נקי וממוחשב. זה לא ציון קורפוס אמיתי, ולא תחליף לו.
אפשר לבדוק את ההוכחות עצמן, לא רק לסמוך על מחברת. מחולל ה-fixtures והמחרוזות המדויקות נמצאים ב-tests/build_fixtures.py וב-tests/fixtures/ground_truth.json; הזיהוי, התזמון ואיסוף המשאבים נמצאים ב-tests/run_easyocr.py; ו-tests/metrics.py מחשב את שיעורי השגיאה המדווחים מתוך הפלט הגולמי. רשומות הזיהוי והמדדים המצטברים נשמרו תחת artifacts/raw/. הרצה מחדש של השרשרת הזו שימושית כדי לבדוק את המכונה ואת הגרסה הזו. היא עדיין לא עונה איך EasyOCR יתנהג על תמונות טלפון, שפות, פריסות או צינור עיבוד מקדים שלכם, ולכן קבלה לייצור צריכה להוסיף קלטים מייצגים במקום להתייחס ל-fixtures האלה כאל חבילת הסמכה.
יש מלכודת אחת בחבילת המדידה שכדאי לציין, כי כמעט הובילה לכותרת שגויה. מעבר המדדים הראשון שלי דיווח CER 0.375 על Arial שחור ונקי, שזה נורא עבור הקלט הכי קל שאפשר. אבל הבעיה לא הייתה EasyOCR. הגלאי פיצל שורה ויזואלית אחת לתיבה של מילים ותיבה של ספרות, והחיבור הנאיבי שלי לפי y ואז x שם את הספרות קודם. תיקון עם קיבוץ לפי שורה (קיבוץ תיבות לפי חפיפה אנכית, ואז קריאה משמאל לימין) הוריד את הפונט הנקי לאזור 0.04–0.10. אם אתם בונים בעצמכם הערכת OCR, גם לכם מחכה אותה מלכודת.
ההתקנה קלה, התלות לא
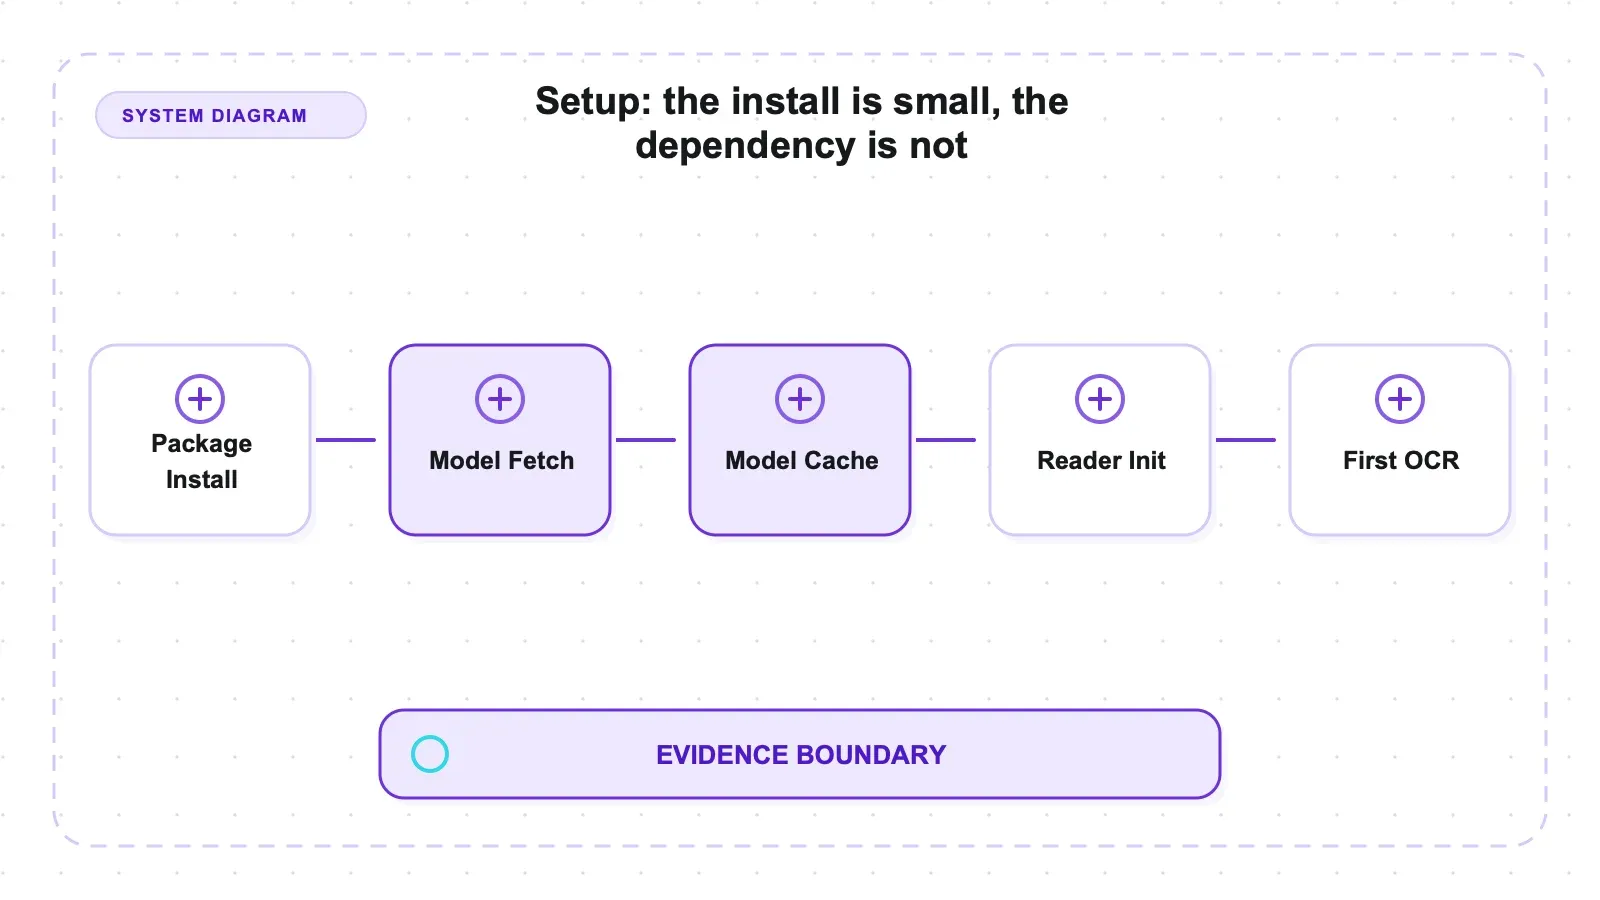
pip install easyocr
זה כל הסיפור, והוא כן לגבי מעט מאוד דברים. החבילה עצמה זעירה; מה שהיא גוררת איתה הוא PyTorch, בערך 2 GB. ואז, בפעם הראשונה שמפעילים readtext(), EasyOCR מוריד בשקט את המשקולות ל-~/.EasyOCR/model/ — 93.7 MiB בסך הכול, מחולקים ל-79.30 MiB עבור גלאי CRAFT (craft_mlt_25k.pth) ו-14.44 MiB עבור המזהה באנגלית (english_g2.pth).
אף אחד לא מציין את זה במדריכים, אז חשוב לדעת: ההרצה הראשונה צריכה גישה לרשת ותיעצר בזמן ההורדה, וכל פריסה בקונטיינר תצטרך או לארוז את המשקולות בתוך התמונה או לספוג את ההורדה ב-cold start. אחרי שזה נשמר ב-cache, הכול עובד אופליין.
אתחול קר של Reader() — טעינת המודלים מהדיסק לזיכרון RAM, יחד עם שלב ה-quantization ל-int8 — לקח 1.3–1.7 שניות בין הרצות. אחרי זה:
import easyocr
reader = easyocr.Reader(['en'], gpu=False)
result = reader.readtext('screenshot.png')
וזה עובד. שתי שורות, בלי הגדרה, בלי לבחור checkpoint. ה"easy" בשם באמת מוצדק בשלב הזה — החיכוך הוא כולו במשקל התלויות, לא ב-API.
הבסיס לטקסט נקי: כמעט מושלם בתווים, לא מושלם ברישיות
שבעה פונטים מערכתיים, שחור על לבן, 32 px, אותו משפט בכל פעם:
| Font | CER (case-sensitive) | CER (case-insensitive) |
|---|---|---|
| Georgia | 0.0625 | 0.0000 |
| Times | 0.0417 | 0.0417 |
| Comic Sans | 0.0417 | 0.0208 |
| Arial | 0.0833 | 0.0208 |
| Verdana | 0.0833 | 0.0208 |
| Impact | 0.0833 | 0.0208 |
| Courier | 0.1042 | 0.0417 |
| Mean | 0.0714 | 0.0238 |
CER ממוצע של 0.071, שיורד ל-0.024 ברגע שמתעלמים מרישיות. זה הממצא החשוב. EasyOCR לא מאבד תווים בטקסט לטיני נקי — הוא קולט נכון את הצורה אבל טועה ב-רישיות.
בפועל, הוא מציג את המילה vow באותיות קטנות כ-VOW בשישה מתוך שבעת הפונטים (Comic Sans מתפשר על Vow). Impact מוסיף גם את of → Of כעוד טעות. הטעות החוזרת הנוספת היא פיסוק: הנקודה בסוף המשפט חוזרת לפעמים כ-: או _ בכמה פונטים. Georgia היא קריאה מושלמת ברגע שמפסיקים להתעקש על רישיות.
זה מבנה ממש שימושי לדעת. אם השלב הבא שלכם הוא fuzzy matching, חיפוש מילות מפתח, או הזנה למודל שפה, החלפת רישיות כמעט לא עולה כלום. אם השלב הבא הוא השוואת מחרוזת מדויקת מול מפתח במסד נתונים, זה יכול להרוס הכול. נרמלו רישיות לפני ההשוואה, וחצי משיעור השגיאה המדומה של EasyOCR פשוט נעלם.
Courier היה הגרוע ביותר (0.1042), וזה גם הגיוני: פונטים מונוספייסים יוצרים ריווח לא טבעי בין תווים, וזה קשה יותר למפענח CTC שלמד ריווח טיפוסי בין אותיות.
נפילת הגודל נמצאת בדיוק במקום שהמסמכים אומרים
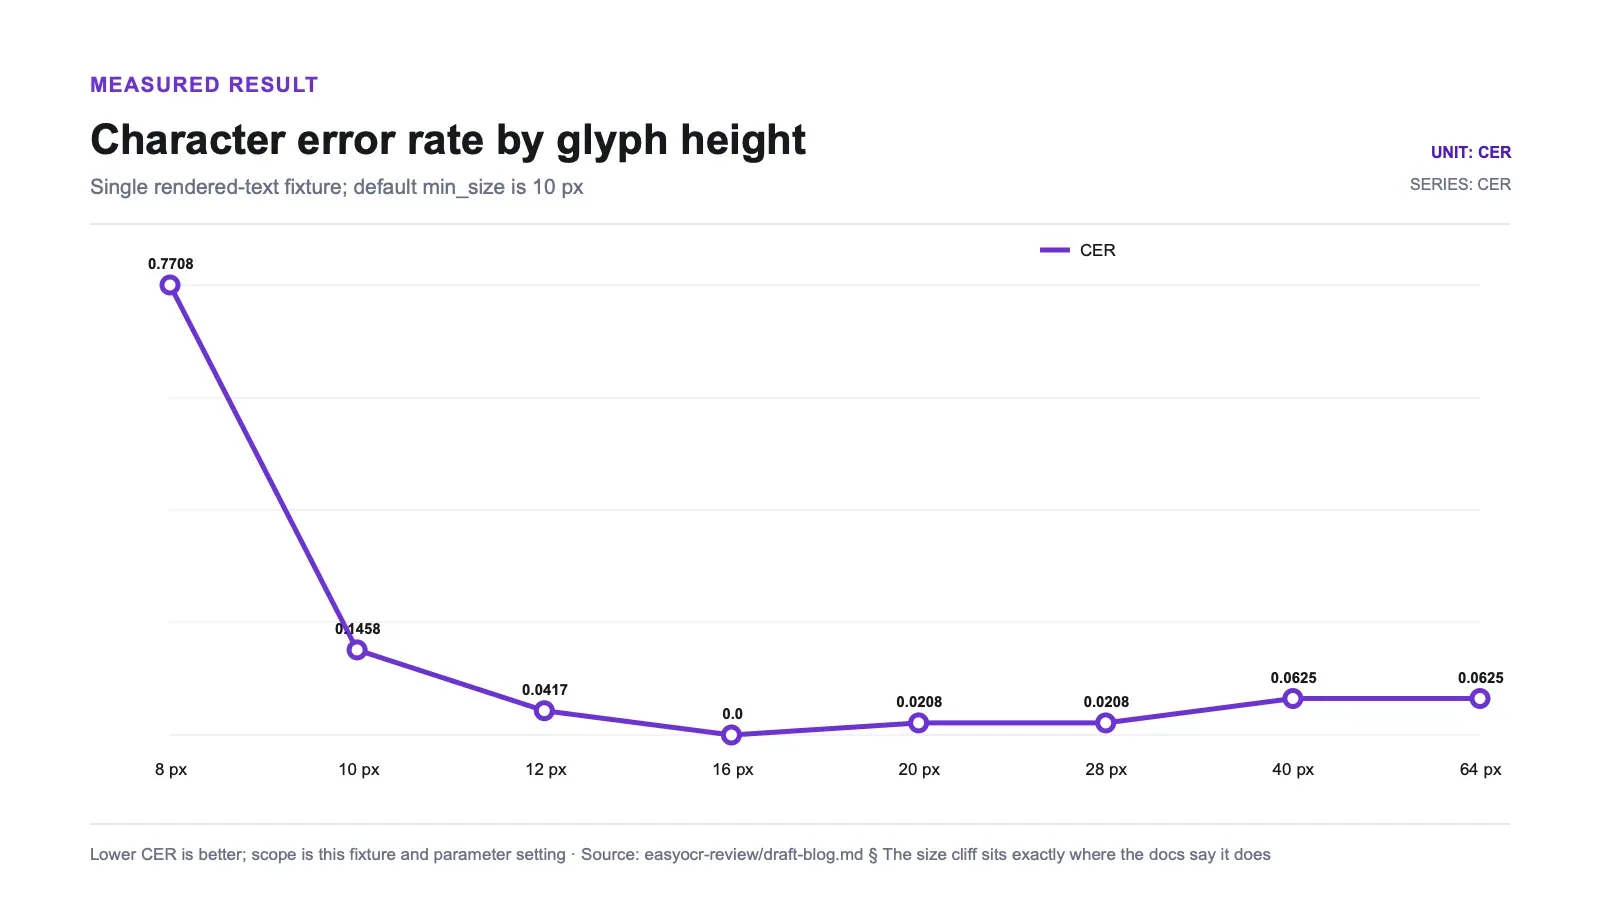
ל-readtext() יש פרמטר מתועד, min_size=10, שמסנן תיבות מזוהות שגובהן קטן מ-10 פיקסלים. רוב האנשים מדלגים עליו. עבור כל מי שעוסק בחילוץ מצילומי מסך או PDF, זה המספר המשמעותי ביותר ב-API, וזו ההתנהגות שלו כשסורקים את גובה האותיות המיוצרות:
| Rendered px | CER | What happened |
|---|---|---|
| 8 | 0.7708 | קריסה — תיבות נופלות מתחת למסנן min_size ומושמטות; נשארים רק שברים |
| 10 | 0.1458 | ירידה — בדיוק על הסף, הגלאי מפצל את השורה ל-3 תיבות |
| 12 | 0.0417 | התאוששות |
| 16 | 0.0000 | קריאה מושלמת |
| 20 | 0.0208 | נקי |
| 28 | 0.0208 | נקי |
| 40 | 0.0625 | נקי (טעות הרישיות חוזרת) |
| 64 | 0.0625 | נקי (טעות הרישיות) |
הקפיצה מ-0.04 ל-0.77 בין 12 px ל-8 px היא לא הידרדרות הדרגתית. זה מסנן שעושה בדיוק מה שהוגדר לו, והתוצאה היא שטקסט מתחת לכ-10 px הופך למעשה לבלתי נראה עבור EasyOCR כברירת מחדל.
האזור הטוב הוא 12–28 px, עם CER מלא של 0 ב-16 px. מעל 40 px, ה-CER מטפס שוב — לא כי התווים הולכים לאיבוד, אלא כי חוזרת ההמרה vow → VOW. טקסט גדול לא קשה יותר לקריאה; פשוט הוא כבר לא נהנה מאותו ריווח שהפך 16 px למושלם.
לכל מי שחולץ טקסט מצילומי מסך: בדקו את גובה האותיות לפני שאתם מאשימים את המודל. דשבורד שנלכד ב-1× על מסך HiDPI, או עמוד PDF שעבר rasterization ב-72 DPI, מכניס לעיתים קרובות את הטקסט הראשי מתחת ל-10 px. לכדו ב-2× או בצעו upscale לפני OCR, ותדלגו על כל מחלקת הבאגים של "EasyOCR התעלם לי מחצי עמוד". אם זה לא אפשרי, הורידו את min_size — אבל צפו לרעש, כי המסנן קיים כדי להדחיק זיהויי זבל.
סיבוב: 10° של סלחנות, ותיקון שאינו סימטרי
קודם הטיה. זוויות קטנות, Arial 32 px, הגדרות ברירת מחדל מול rotation_info=[90,180,270]:
| Skew angle | CER (default) | CER (with rotation_info) |
|---|---|---|
| 0° | 0.0833 | 0.0833 |
| 5° | 0.0417 | 0.0417 |
| 10° | 0.0208 | 0.0833 |
| 15° | 0.2917 | 0.3750 |
| 20° | 0.7500 | 0.7708 |
| 30° | 0.8958 | 0.8750 |
| 45° | 0.8958 | 0.8750 |
EasyOCR ברירת מחדל מתמודד עם הטיה עד בערך 10° בלי להתאמץ (CER ≤ 0.083), מתחיל להתערער ב-15°, ונשבר ב-20°. rotation_info לא עוזר להטיה, וזה הגיוני ברגע שמבינים מה הוא כן עושה — הוא רק מנסה מחדש בזוויות שציינתם, ו-15° היא לא 90, 180 או 270. ב-10° הוא אפילו החמיר מעט (0.021 → 0.083), כי ניסיון חוזר בזווית שגויה יכול לנצח בהצבעה של הביטחון.
הרוטציות האורתוגונליות הן המקום שבו זה נעשה מוזר:
| Rotation | CER (default) | CER (with rotation_info) | Recovered? |
|---|---|---|---|
| 90° | 0.8125 | 0.9167 | לא — גרוע יותר |
| 180° | 0.8542 | 0.6667 | חלקית |
| 270° | 0.8333 | 0.1042 | כן |
אותו פרמטר. אותה רשימת זוויות. שלוש תוצאות שונות.
ב-270°, rotation_info עושה בדיוק מה ש-שרשור הבעיה מבטיח: CER יורד מ-0.83 ל-0.10, קריאה שבאמת אפשר להשתמש בה. ב-180°, זה עובד רק חלקית — CER משתפר ל-0.67, אבל הביטוי my vow. נופל לגמרי. ב-90°, זה הולך אחורה, מ-0.81 ל-0.92, והפלט הגולמי מסביר למה: המזהה מחזיר מחרוזות משוקפות. VOW חוזר כ-MOA. quartz חוזר כ-zuuenb. אם קוראים את זה במראה, זה נכון — טריק נחמד, אבל צינור נתונים חסר תועלת.
בדקתי את זה מול התחזיות הגולמיות ולא רק מול המדדים המצטברים, כי "סדר החיבור בלבל את זה" הייתה החשד הראשוני שלי. זה לא ארטיפקט של חיבור — כך EasyOCR באמת החזיר את הפלט.
המנגנון הוא השערה, לא מדידה; לא ביצעתי ניסוי על מוסכמות סיבוב. Pillow מצייר זוויות חיוביות נגד כיוון השעון, ולכן רק התמונה שסובבה ל-270° מתיישבת עם כיוון ניסיון חוזר שהמזהה מטפל בו היטב, ובמקרה של 90° הניסיון עם הציון הטוב ביותר נוחת על כיוון משוקף. מה שלא יהיה המנגנון, הלקח התפעולי לא תלוי בו:
ה-fixture הזה מראה שלא צריך להניח ש-rotation_info יתנהג בצורה סימטרית בין אוריינטציות. יש לאמת את הרוטציות הצפויות בקלטים שלכם; נרמול כיוון במעלה הזרם הוא אפשרות למיתון, לא דרישה שהוכחה בשלוש דוגמאות ממוחשבות.
התחזית שטעיתי בה
נכנסתי לזה מתוך הנחה שניגודיות נמוכה תהיה הנקודה הרגישה של EasyOCR. טקסט אפור-בהיר על לבן הוא סיפור הכשל הקלאסי של OCR, ויש גם מסלול הצלה מתועד: contrast_ths=0.1 עם adjust_contrast=0.5, שמריץ מחדש תיבות בעלות ניגודיות נמוכה על עותק עם ניגודיות מוגברת ושומר את התוצאה הבטוחה יותר.
זה אף פעם לא הופעל, כי לא היה בו צורך.
| Foreground gray | Weber contrast | CER (default) | CER (adjust_contrast=1.0) |
|---|---|---|---|
| 0 (black) | 1.000 | 0.0833 | 0.0833 |
| 64 | 0.749 | 0.0833 | 0.0833 |
| 110 | 0.569 | 0.0833 | 0.0833 |
| 150 | 0.412 | 0.1042 | 0.1042 |
| 180 | 0.294 | 0.0625 | 0.0625 |
| 200 | 0.216 | 0.0417 | 0.0417 |
| 220 | 0.137 | 0.0417 | 0.0417 |
ה-CER לא יוצא לעולם מהטווח הנקי, עד Weber 0.14 — אפור-220 על לבן, עד כדי כך בהיר שהייתי צריך למצמץ כדי לוודא שהטקסט באמת שם. ועמודת ההגברה של הניגודיות זהה לעמודת ברירת המחדל בכל שלב, כי ברירת המחדל כבר הצליחה.
גם הרקעים סיפרו את אותו סיפור. טקסט שחור לכל אורך הדרך:
| Background | CER |
|---|---|
| Solid light-blue panel | 0.083 |
| Vertical gradient | 0.021 |
| Gaussian noise (μ200, σ22) | 0.000 |
קריאה מושלמת על ה-fixture הרועש ביותר בקבוצה.
ההיקף כאן צר: מדובר בניגודיות נמוכה בצבע אחיד וללא רעש, לא בקבלה מצולמת עם רעש חיישן ודחיסת JPEG. בסט הזה, גיאומטריה וטוקנים קצרים היו הכשלים הגדולים ביותר; הווריאנטים שנבדקו של צבע ורעש סינתטי לא.
תרחיש אמיתי: הוצאת מספרים מצילום מסך של דשבורד
זה המקרה שרוב עבודת ה-OCR ב-Python מתבררת בסוף כמותו. מישהו שולח צילום מסך של דשבורד פנימי, או שאתם מריצים צינור scraping ב-Python מול עמוד אנליטיקס עתיר גרפים, שבו המספרים קיימים רק כפיקסלים מעובדים, ואתם רוצים את הערכים כנתונים.
רינדרתי חלון "Sales Dashboard" — כותרת עליונה כהה עם כותרת וסמל עגול של משתמש, שלושה פאנלים של KPI, שלושה כפתורים, וטבלה בגודל 2×3 — וסימנתי את כל 19 רכיבי הטקסט עם המחרוזות והקואורדינטות המדויקות שלהם, ואז התאמתי את פלט EasyOCR אליהם לפי חפיפת תיבות.
זכירת הזיהוי: 16 מתוך 19. שלושת הפספוסים:
- התג בן האות האחת, "A"
- תא הטבלה "Q1"
- תא הטבלה "Q2"
ו-"Q3" כן זוהה. אותו פונט, אותו גודל, אותה עמודה — הגלאי שמר על טוקן אחד בן שני תווים והפיל שניים אחרים. הזיהוי לא היה עקבי בין תאים דומים מאוד מבחינה חזותית. מכיוון שהפלטים היו דטרמיניסטיים בהרצות האלה, זה לא הוכחה להתנהגות אקראית של "הטלת מטבע". בעיית איכות צילום קשורה נרשמה גם ב-#460.
מבין 16 הרכיבים שהוא כן מצא, הטקסט היה כמעט מושלם: CER ממוצע 0.027, עם 13 מתוך 16 בדיוק מלא. כותרות, תוויות, כפתורים ("Save", "Cancel", "Export CSV"), כותרות עמודות, ומספרים עם פסיקים חזרו כולם עם CER 0. 1,284 נקרא נכון, כולל הפסיק.
שלוש הקריאות הלא-מושלמות הן כולן אותה טעות. סכומי דולר:
| Ground truth | EasyOCR read |
|---|---|
$57,912 | S57,912 |
$18,330 | S18,330 |
$25,178 | S25,178 |
$12,004 | $12,004 (correct) |
שלושה מתוך ארבעת סימני הדולר הפכו לאות S גדולה. מבחינה ויזואלית, זה לא מופרך — אבל זה אומר שכל שדה מטבע בחילוץ שלכם נמצא תו אחד משגיאה גמורה, ו-float() נאיבי ייכשל בכולם.
אם צינור צילום המסך שלכם כולל תוויות קצרות או מטבע, בדקו מיתונים אפשריים כמו הגדלה, חיתוכים עם שוליים, ציפיות מוגבלות לשדות, או עיבוד-אחרי שמודע לסמלים. אף אחד מאלה לא נבחן כאן, ו-regex שמחליף S מוביל יכול להשחית ערכים תקינים. תקנו רק במקום שבו הסכימה וכללי האימות הופכים את זה לבטוח.
כמה עולה להריץ את זה
מספרים על אותה מכונה (macOS arm64, CPU, מארח אחד, נמדד תחת עומס מקביל אפשרי — יש להתייחס אליהם כאל צורת התנהגות, לא כאל benchmark אוניברסלי):
| Metric | Value |
|---|---|
| Model weights on disk | 93.7 MiB (79.30 detector + 14.44 recognizer) |
| Peak resident memory, fresh CPU process | 984.5 MiB |
Cold Reader() init | 1.3–1.7 s |
| Warm latency, one clean 48-char line (p50) | ~0.062 s (p25–p75: 0.059–0.067 s, n=20) |
detail=0 vs detail=1 | ~equal (0.062 vs 0.063 s median) |
עלות הכותרת היא לא 94 MB של משקולות — אלא בערך ג'יגה-בייט אחד של זיכרון resident לכל תהליך עובד, בנוסף לכ-2 GB של התקנת torch. זה המספר שקובע אם זה נכנס לקונטיינר שלכם, וזה המספר שאף אחד לא מצטט.
המהירות סבירה עבור המקרה הקל. פחות מ-0.1 שניות חמה עבור שורה נקייה אחת על CPU זה בהחלט שימושי. אבל זה כן המקרה הקל: שורה אחת קצרה ובעלת ניגודיות גבוהה. התלונות החוזרות "EasyOCR לוקח עשרות שניות על CPU" עוסקות במסמכים גדולים עם כמה אזורים בגודל מלא, ואני לא שחזרתי אותן — זה עומס עבודה אחר, ואני מצטט אותו במקום לטעון שכן.
מכאן למיתוס קטן שכדאי להרוג: detail=0 לא הופך את EasyOCR למהיר יותר. הוא פשוט מסיר את תיבות הגבול ואת ציוני הביטחון מהפלט. החישוב כבר התרחש. ההבדל במדיאנים הוא מילישנייה אחת, כלומר רעש.
יתרונות וחסרונות
יתרונות
- הזיהוי של תווים בטקסט לטיני ממוחשב כמעט מושלם — CER ממוצע 0.071 עם רגישות לרישיות, 0.024 בלי רגישות לרישיות, ו-CER מלא 0 אפשרי כבר ב-16 px.
- API אמיתי של שתי שורות.
Reader(['en'])ואזreadtext(), בלי קונפיגורציה ובלי בחירת מודל. - חסין לניגודיות יותר מהמיתולוגיה סביבו: אין קריסה עד Weber 0.14 בטקסט נקי, ורקעים רועשים/מדרגתיים/צבעוניים לא פגעו בו (Fixture של Gaussian noise היה קריאה מושלמת).
- כמעט מושלם על רכיבי צילום מסך שהוא כן מזהה: CER ממוצע 0.027, 13 מתוך 16 בדיוק מלא, כולל מספרים עם פסיקים.
- דטרמיניסטי. כל מספר דיוק כאן היה זהה-בתים בין שתי הרצות עצמאיות לחלוטין; רק התזמון השתנה.
- Apache-2.0 ומתארח-עצמית, בלי עמלת שימוש לספק; העלות היא של חישוב, זיכרון, אחסון ותור.
חסרונות
- קריסה חדה מתחת לסף המתועד
min_size=10— CER 0.77 ב-8 px. טקסט קטן בממשק פשוט נעלם כברירת מחדל. - סבילות להטיה נעצרת סביב ~10° ונשברת ב-20°.
rotation_infoאינו תיקון סימטרי: 270° משחזר, 180° חלקית, 90° מחמיר ומחזיר טקסט משוקף.- הגלאי מפיל טוקנים קצרים מבודדים — תג בן אות אחת ושני תאים בני 2 תווים, בזמן שתא שלישי באותו פורמט נשמר.
- טעות שיטתית של
$→Sבערכי מטבע (3 מתוך 4). - כ-1 GB של זיכרון resident לכל תהליך, בנוסף לתלות torch של כ-2 GB.
- הגרסה האחרונה היא מספטמבר 2024; הפרויקט יציב יותר מאשר מתפתח במהירות.
למי זה מתאים, ומי עדיף שיוותר
כדאי לבחון את EasyOCR כשהקלטים שלכם הם טקסט נקי, ישר, ומעובד בגודל סביר — צילומי מסך, לכידות UI, PDFs שעברו rasterization, או דוחות שנוצרו בתוכנה — ושאתם רוצים צינור Python שמתארח-עצמית בלי עמלת שימוש לספק. תוצאות ה-CPU באנגלית הסינתטית רלוונטיות בדיוק למסלול הזה; תצלומים, כתב יד ושפות אחרות דורשים בדיקה נפרדת.
עדיף לוותר אם אחד מהדברים הבאים מתאר את הקלט שלכם. תצלומים — המספרים שלי הם טקסט סינתטי מרונדר, והם לא אומרים דבר על רעש מצלמה, פרספקטיבה או תאורה. כתב יד — הפרויקט עצמו לא טוען לכך. סקריפטים לא-לטיניים — EasyOCR אמנם תומך ביותר מ-80 שפות, אבל אני בדקתי אחת, וההשוואות האקדמיות שפורסמו הן הייחוס כאן, לא סריקה סינתטית של אנגלית. קלטים מסובבים באקראי — אלא אם אתם מבצעים קודם תיקון אוריינטציה משלכם. פריסות עם מגבלת זיכרון — ג'יגה-בייט לכל worker מצטבר מהר.
לפני שבוחרים OCR, בדקו את ה-DOM ואת תגובות הרשת. אם הערכים שאתם צריכים כבר קיימים כטקסט מובנה, חילוץ מהמקור הזה חוסך את שגיאות הזיהוי והקריאה של OCR. OCR שייך למקומות שבהם פיקסלים הם הייצוג היחיד הזמין.
חלופות, ואיפה הסטאק שלנו נכנס
EasyOCR הוא Apache-2.0 ומתארח-עצמית, בלי עמלת שימוש לספק אבל עם עלות חישוב ותפעול אמיתית. PaddleOCR, Tesseract, ומודלים של vision-language לא עברו דרך benchmark הזה, ולכן אין כאן מסקנה ראש-בראש.
ההשוואה המעניינת יותר היא לא OCR מול OCR. היא האם בכלל צריך OCR.
רוב עבודות החילוץ מצילומי מסך שאני רואה הן פתרון עוקף לדף אינטרנט שהיה קשה לגרד — טבלה שמרונדרת ב-JavaScript, דשבורד מאחורי התחברות, אתר שנלחם בחזרה. לצלם מסך ואז להעביר דרך OCR מרגיש כמו הדרך הקלה, אבל אתם זורקים לפח טקסט מובנה שהיה טוב לגמרי, ואז משלמים עליו מס של סימן דולר כדי לקבל גרסה פחות טובה שלו בחזרה.
הערת המחבר: Thunderbit היא האפשרות המנוהלת שלנו לחילוץ מדפי אינטרנט. היא לא עברה דרך ה-fixtures של התמונות האלה. הגבול הרלוונטי הוא ייצוג המקור: השתמשו בחילוץ DOM/Network כשיש נתוני ווב מובנים, ובחנו OCR כשפיקסלים הם המקור היחיד.
קריאה קשורה מאותו test bench: השוואת ה-scraper הפתוח המלאה, סקירת Crawl4AI, ומבט רחב יותר על חילוץ מונע AI עבור דפים שמתנגדים לסלקטורים.
נסו את Thunderbit לחילוץ נתוני ווב
פסק דין
אז האם כדאי להשתמש ב-EasyOCR? כן, אם התמונות שלכם ישרות, האותיות בגובה של לפחות 12 פיקסלים, ואתם קוראים סקריפט לטיני. בתוך הגבולות האלה הוא מצוין — CER ממוצע 0.071 בטקסט נקי, 0.024 אחרי נרמול רישיות, קריאה מושלמת ב-16 px, וחסינות טובה יותר לניגודיות מכפי שהמוניטין שלו מרמז. ה-API באמת שתי שורות, והפלט דטרמיניסטי, וזה חשוב יותר ממה שאנשים נוטים להודות בו כשמדבגים צינור.
מחוץ לגבולות האלה, הוא נכשל בדרכים ספציפיות וניתנות ללמידה. טקסט מתחת ל-10 px נעלם בתוך מסנן min_size. הטיה מעבר ל-20° שוברת את הקריאה. rotation_info מתקן אוריינטציה אורתוגונלית אחת, מתקן חצי-דרך אחרת, ומחמיר את השלישית עם טקסט משוקף. אותיות בודדות וטוקנים בני שני תווים נופלים מהגלאי בזמן שהשכנים שלהם שורדים. סימני דולר הופכים לאות S.
כשלי ה-fixture הגיעו משני השלבים: תיבות שפספסו או כיווניות שגויה בצד הגיאומטרי, ובלבול בין דולר ל-S בצד הזיהוי. התייחסו ל-upscaling, נרמול אוריינטציה, חיתוכים עם שוליים, ותיקון סמלים שמודע לסכימה כאל מועמדים לבדיקה — לא כאל תיקונים בטוחים אוניברסלית.
רק אל תבדקו אותו כמו שכמעט עשיתי, עם harness שבור ומספר שלא באמת הבנתם. צרו fixtures משלכם, דעו בדיוק מהי האמת-קרקע שלכם, ומצאו את הנפילה שלכם בעצמכם.
נסו את Thunderbit לחילוץ נתוני ווב Get Started Free
שאלות נפוצות
האם EasyOCR מדויק מספיק לחילוץ טקסט מצילומי מסך בייצור?
בדשבורד הסינתטי, הרכיבים שהתאימו קיבלו CER ממוצע של 0.027 עם 13 מתוך 16 בדיוק מלא. שלושה מתוך 19 הרכיבים לא זוהו, ושלושה מתוך ארבעה סימני דולר הפכו ל-S. האם זה מספיק טוב — והאם upscaling או תיקון מודע לסכימה יעזרו — חייב להיבדק על הפריסות היעד.
מהו גודל הפונט המינימלי ש-EasyOCR יכול לקרוא?
בפועל, בערך 12 פיקסלים של גובה אות מרונדר. הפרמטר min_size=10 ב-readtext() מסנן תיבות מזוהות שגובהן קטן מ-10 px, וההשפעה היא נפילה חדה ולא שיפוע: ה-CER היה 0.77 ב-8 px, 0.15 ב-10 px, 0.04 ב-12 px, ו-0 ב-16 px. אזור הקריאה הנקי בסריקה שלי היה 12–28 px. אם המקור שלכם הוא צילום מסך HiDPI שנלכד ב-1× או PDF שעבר rasterization ב-72 DPI, בצעו upscale לפני OCR במקום להוריד את min_size, כי המסנן הזה קיים כדי להדחיק זיהויי זבל.
האם rotation_info מתקן תמונות מסובבות ב-EasyOCR?
לא באופן אמין, ולא באופן סימטרי. עם rotation_info=[90,180,270] על שלושה עותקים של אותו משפט שסובבו אורתוגונלית, התמונה ב-270° שוחזרה נקי (CER 0.83 → 0.10), התמונה ב-180° רק חלקית (0.85 → 0.67, עם ביטוי שנשמט), והתמונה ב-90° נעשתה גרועה יותר (0.81 → 0.92) תוך החזרת טקסט משוקף כמו VOW → MOA. הוא גם לא עושה שום דבר להטיות קטנות, כי הוא רק מנסה מחדש בזוויות שציינתם. עדיף לתקן אוריינטציה לפני הקריאה ל-EasyOCR במקום להסתמך על הפרמטר הזה.
כמה זיכרון ודיסק EasyOCR צריך?
המשקולות הן 93.7 MiB, והן מורדות ל-~/.EasyOCR/model/ בשימוש ראשון — 79.30 MiB עבור הגלאי ועוד 14.44 MiB עבור המזהה באנגלית. שיא הזיכרון resident בתהליך CPU חדש שנמדד היה 984.5 MiB, בנוסף להתקנת torch של בערך 2 GB. אתחול קר של reader לקח 1.3–1.7 שניות; שורה נקייה אחת אחר כך רצה ב-p50 של כ-0.062 שניות במכונה הזו. detail=0 שינה את מבנה התוצאה, לא את זמן הריצה שנמדד.
האם EasyOCR חינמי לשימוש מסחרי, והאם הוא עדיין מתוחזק? הרישיון שלו הוא Apache-2.0, כלומר רישיון מרחיב ונוח מסחרית. נכון ל-27 ביולי 2026, המאגר עומד על 29,825 כוכבים עם 528 issues פתוחים, הגרסה האחרונה היא v1.7.2 מספטמבר 2024, וה-push האחרון ל-master היה בדצמבר 2025. קראו לזה יציב יותר מאשר נטוש — הארכיטקטורה לא השתנתה זמן רב, והפעילות עברה ל-issue tracker. מומלץ לאמת בעצמכם את הרישיון ואת מצב ההפצה לפני שבונים עליו.




