
Temu כבר מגיעה ליותר מ‑416 מיליון משתמשים פעילים בחודש ביותר מ‑50 שווקים. קטלוג המוצרים שלה כולל הכול — מגאדג'טים למטבח ועד אביזרים לחיות מחמד ורצועות LED. אם אתם עוסקים ב‑ecommerce, בדרופשיפינג או ב‑competitive intelligence, כנראה כבר רציתם להעביר נתוני Temu לגיליון אלקטרוני — ואז גיליתם של‑Temu ממש, ממש לא בא שתקחו את זה בקלות.
השקעתי לא מעט זמן במחקר ובבדיקות של כלי scraping לאתרי ecommerce מוגנים. Temu היא אחת המטרות המאתגרות ביותר שיש. רוב המדריכים ברשת או נותנים לכם טיולון Python שיישבר תוך שבוע, או מפנים אתכם ל‑Enterprise APIs שעולים יותר מתקציב הפרסום החודשי שלכם.
המציאות היא שרוב משתמשי העסק — דרופשיפרים, מפעילים עצמאיים, וצוותי שיווק — פשוט רוצים גיליון מסודר עם שמות מוצרים, מחירים, תמונות, דירוגים ומידע על מוכרים. הם לא רוצים לנפות שגיאות בסקריפטים של Playwright בשתיים בלילה.
המדריך הזה נבנה בדיוק סביב הפער הזה: פירוק מעשי, לפי רמת מיומנות, של הסקרייפרים הטובים ביותר ל‑Temu שבאמת עובדים ב‑2026, יחד עם שיטות עבודה מומלצות שהופכות איסוף חד‑פעמי ל‑competitive intelligence מתמשך. בין אם אתם מתחילים לגמרי ובין אם אתם מפתחים שבונים צינור נתונים, יש כאן חלק שמתאים לכם.
נסו את Thunderbit ל‑Temu Scraping
למה בכלל לגרד נתונים מ‑Temu? מקרי שימוש מובילים לצוותי עסק
הנתונים של Temu הם לא רק מעניינים — הם גם בעלי ערך אסטרטגי.
הפלטפורמה הפכה לכוח קובע מחירים בקטגוריות מוצרים זולות ובינוניות. גם אם אתם לא מוכרים ב‑Temu, הלקוחות שלכם משווים את המחירים שלכם למה שהם רואים שם. הנה איך צוותים שונים משתמשים בנתוני Temu:
| מקרה שימוש | הנתונים הנדרשים | למה זה חשוב |
|---|---|---|
| מחקר מוצרים לדרופשיפינג | כותרת, מחיר, תמונה, דירוג, מספר ביקורות, מספר מכירות, וריאציות | מאתר מוצרים זולים עם סימני ביקוש להשוואה מול Amazon, Shopify, AliExpress, TikTok Shop |
| תמחור תחרותי | מחיר נוכחי, מחיר מקורי, אחוז הנחה, מטבע, משלוח, חותמת זמן | בונה בסיס לאסטרטגיית תמחור ולתכנון מבצעים |
| איתור ספקים/מקורות מוצר | מפרטים, תמונות, וריאציות, מוכר/חנות, מזהה מוצר, קטגוריה | מזהה סוגי מוצרים ורישומים בסגנון ספק שכדאי לאמת לעומק |
| ניתוח מגמות שוק | מילת חיפוש, קטגוריה, מספר מכירות, מספר ביקורות, דירוג | מראה אילו מוצרים צוברים תאוצה בין קטגוריות |
| מחקר שיווק וקריאייטיב | כותרת, תמונה, מספר ביקורות, דירוג, תיאורים, תוויות קטגוריה | חושף מסרים, ווים ויזואליים, חבילות והצהרות של רישומים בעלי נפח גבוה |
| ניטור מלאי וזמינות | URL של המוצר, זמינות, הערכת משלוח, מחיר, חותמת זמן | קולט חוסרים במלאי, שינויים במחסן מקומי ותנועות מחיר לאורך זמן |
הקהל שמחפש "הסקרייפרים הטובים ביותר ל‑Temu" בדרך כלל מתחלק לשלוש קבוצות. משתמשים לא טכניים רוצים תוסף Chrome שמוציא גיליון אלקטרוני. מפעילים ברמת ביניים רוצים כלי ויזואלי עם תבניות ותזמון. מפתחים רוצים API, סקריפט Playwright ואסטרטגיית proxy.
המאמר הזה מכסה את שלושתן — אבל הוא מתחיל עם הקבוצה הגדולה ביותר: אנשים שצריכים נתונים, לא קוד.
מה מבדל את הסקרייפרים הטובים ביותר ל‑Temu ב‑2026
סקרייפר שעובד על Amazon או Shopify לא בהכרח ישרוד מול Temu. קריטריוני ההערכה כאן הם:
- אמינות מול Temu — האם הוא באמת מחזיר נתונים נקיים, או נחסם, מחזיר שורות ריקות, או נשבר אחרי שינוי במבנה העמוד?
- קלות שימוש — האם משתמש עסקי לא טכני יכול להתחיל בלי לכתוב קוד?
- שלמות הנתונים — האם הכלי תומך בהעשרה של subpages (כניסה לכל דף מוצר לקבלת מפרטים, וריאציות, מידע על מוכר)?
- עומס תחזוקה — האם הוא מתעדכן כש‑Temu משנה את מבנה העמוד?
- תזמון וניטור — האם אפשר להריץ איסוף חוזר ולייצא ליעד נתונים חי?
- יעדי יצוא — CSV, Excel, Google Sheets, Airtable, Notion, JSON?
- בהירות בעלויות — מה באמת עולה תהליך scraping ריאלי ל‑Temu בחודש?
דוחות מהקהילה ב‑Reddit's r/webscraping מתארים בעקביות את Temu כאחד מאתרי ה‑ecommerce הקשים ביותר לגרידה. משתמש אחד כתב שהוא "אפילו לא מצליח לקבל מחיר כלקוח", ואחר ציין ש‑Temu ו‑Shopee מחזיקות צוותים שמחזקים ללא הפסקה מנגנוני anti-bot. אין נתוני כשל ציבוריים שמדדו ספציפית את Temu, אבל דוח Imperva Bad Bot לשנת 2025 מצא שתעבורה אוטומטית עקפה את התעבורה האנושית, כאשר בוטים היו 51% מכלל תעבורת האינטרנט. זהו בדיוק העולם ש‑Temu מגנה עליו.
ההגנות של Temu נגד בוטים: למה רוב הסקרייפרים נכשלים
רוב המאמרים על scraping של Temu מקדישים משפט אחד להגנות anti-bot: "Temu משתמשת ב‑anti-bot." זה לא באמת מועיל.
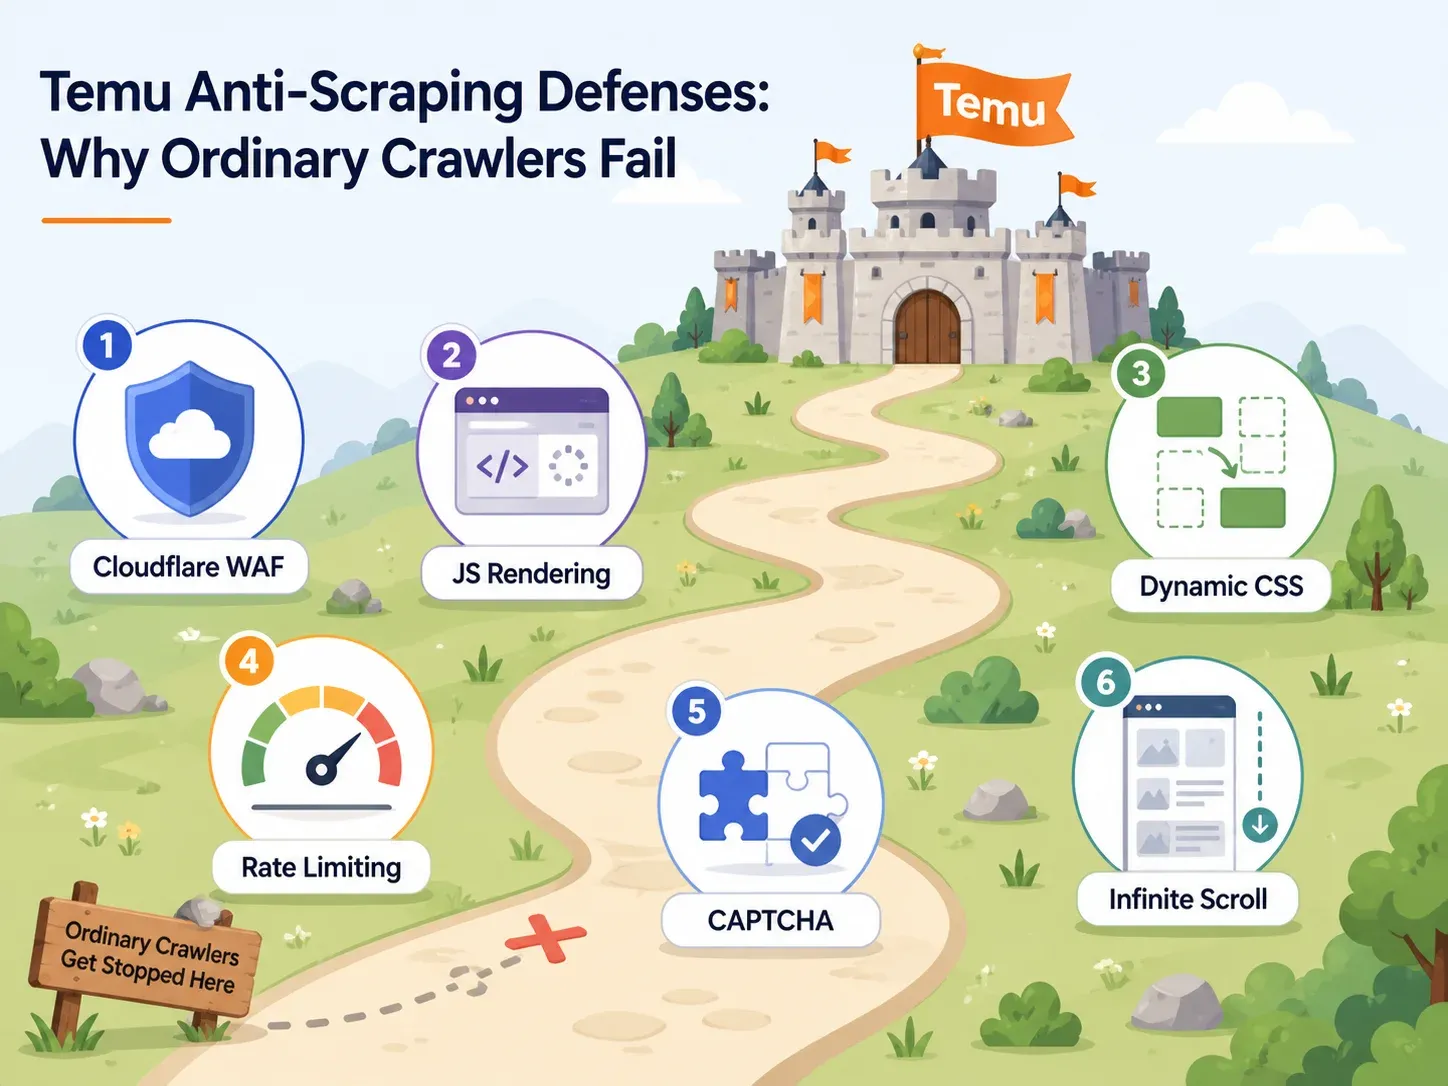
אם אתם בוחרים כלי, אתם צריכים לדעת אילו הגנות Temu משתמשת בהן ו-איזו יכולת של הכלי שוברת כל אחת מהן. הנה המפה הפרקטית:
| הגנת Temu | מה היא עושה | איזו יכולת כלי נדרשת | דוגמאות לכלים |
|---|---|---|---|
| Cloudflare WAF / בדיקות דפדפן | חוסמת user-agents אוטומטיים, מזהה טביעות אצבע של בוטים, מחזירה דפי challenge | תשתית ענן עם rotating residential IPs וטביעות אצבע של דפדפן אמיתי | Thunderbit (scraping בענן), Bright Data, Oxylabs, ScraperAPI |
| עיבוד JavaScript כבד | נתוני המוצרים נטענים דרך JS; ה‑HTML הגולמי ריק | דפדפן headless או rendering מלא של דפדפן | Thunderbit (מצב browser scraping), Playwright, Selenium, ParseHub, Apify browser actors |
| CSS selectors דינמיים | שמות class משתנים בין פריסות ושוברים סקרייפרים מבוססי CSS | זיהוי שדות מבוסס AI (לא תלוי ב‑selectors קבועים) | Thunderbit (ה‑AI קורא את העמוד מחדש בכל פעם), Bright Data AI scraper builder |
| הגבלת קצב | מאטה בקשות עוקבות מהירות מדי | בקשות ענן מקבילות עם throttling חכם | Thunderbit (עד 50 עמודים בו זמנית דרך הענן), ScraperAPI, Bright Data |
| אתגרי CAPTCHA | קוטעים סשנים לאחר התנהגות חשודה | פתרון CAPTCHA מובנה או אסטרטגיית טריגר נמוכה | Bright Data, Oxylabs, ScraperAPI premium/ultra-premium |
| infinite scroll / lazy loading | רק המוצרים הראשונים מופיעים בלי אינטראקציה | גלילה חכמה, זיהוי עימוד, אוטומציה של אינטראקציות | Thunderbit pagination, Apify smart scrolling, Octoparse workflow builder |
Cloudflare WAF וחסימת IP
הדלת הראשית של Temu מוגנת על ידי בדיקות תקינות דפדפן בסגנון Cloudflare. בקשות HTTP בסיסיות — מהסוג ש‑requests.get() פשוט ב‑Python שולח — מקבלות אתגר, נחסמות ב‑403, או מחזירות נתונים חלקיים.
כלים שעובדים כאן צריכים IPs מתחלפים מסוג residential או mobile וטביעות אצבע אמיתיות של דפדפן. סקירת Cloudflare Radar לשנת 2025 דיווחה שבוטים לא‑מבוססי AI התחילו את 2025 כשהם אחראים לכמחצית מבקשות ה‑HTML. זהו היקף האוטומציה ש‑Temu מתגוננת מפניו.
Rendering של JavaScript ו‑Dynamic Selectors
כאן רוב הסקרייפרים למתחילים נכשלים בשקט.
אם תצפו בקוד המקור של Temu, לרוב תראו מעטפת ריקה — כרטיסי המוצר, המחירים והתמונות האמיתיים מוזרקים על ידי JavaScript אחרי שהעמוד נטען. סקרייפר שקורא רק HTML גולמי יחזיר כלום מועיל. מעבר לזה, שמות ה‑CSS class וה‑DOM structures של Temu משתנים בין פריסות. סקרייפר שמסתמך על selector קבוע כמו .product-card__price יעבוד היום ויחזיר עמודות ריקות מחר.
סקרייפרים מבוססי AI (כמו Thunderbit) קוראים את העמוד סמנטית בכל פעם, ולכן הם לא תלויים בשמות class קבועים.
הגבלת קצב ואתגרי CAPTCHA
אם תפגעו ב‑Temu מהר מדי או יותר מדי פעמים מאותו IP, תפעילו rate limits או אתגרי CAPTCHA. חלק מהכלים מטפלים בזה עם throttling חכם ופתרון CAPTCHA מובנה. אחרים משאירים את זה לכם — ולמשתמש לא טכני, זה כמעט סוף הדרך.
ב‑cloud scraping, המפתח הוא בקשות מקבילות שמפוזרות על פני IPs נקיים עם retry logic אוטומטי.
הסקרייפרים הטובים ביותר ל‑Temu לפי רמת מיומנות: פירוק מלא
מצאו את השורה שלכם וקפצו לחלק שמתאים לכם:
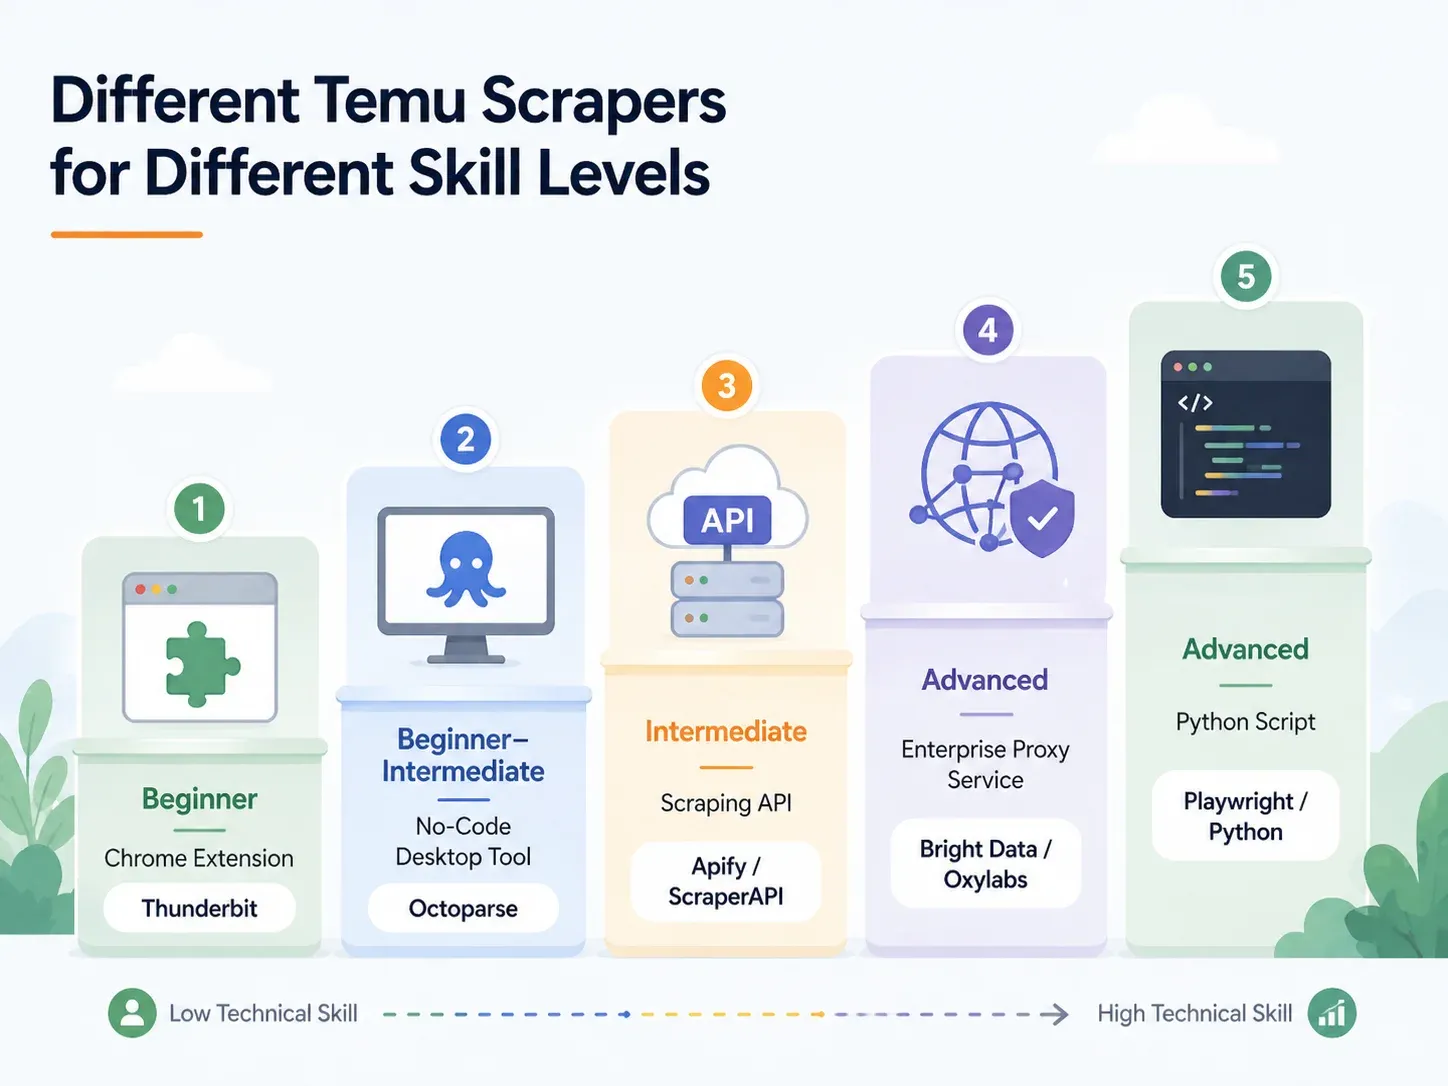
| גישה | רמת מיומנות | זמן הקמה | טיפול ב‑Anti-Bot | הכי מתאים ל |
|---|---|---|---|---|
| תוסף AI ל‑Chrome (למשל, Thunderbit) | מתחיל | < 2 דק' | מטופל (ענן או דפדפן) | דרופשיפרים, משווקים, תפעול ecommerce |
| כלי Desktop ללא קוד (למשל, Octoparse, ParseHub) | מתחיל–בינוני | 10–60 דק' | חלקי (דורש הגדרת proxy) | scraping קבוע עם תבניות |
| Scraping API/Service (למשל, ScraperAPI, Apify) | בינוני | 15–45 דק' | מובנה | מפתחים שמשלבים בצינורות נתונים |
| Proxy מנוהל/Enterprise (למשל, Bright Data, Oxylabs) | מתקדם/Enterprise | שעות–ימים | תשתית מלאה | נפחי ענק, מסירה למחסן נתונים |
| סקריפט Python מותאם אישית (Playwright/Selenium) | מתקדם | 1–4 שעות+ | ידני (הגדרת proxy + CAPTCHA) | שליטה מלאה, התאמה למצבי קצה |
Thunderbit: הסקרייפר הטוב ביותר ל‑Temu למשתמשים לא טכניים
Thunderbit הוא תוסף Chrome מבוסס AI שנבנה עבור משתמשים עסקיים — צוותי מכירות, מפעילי ecommerce, דרופשיפרים, ומשווקים — שצריכים נתונים מובנים מאתרים בלי לכתוב קוד. אני עובד בצוות של Thunderbit, אז אני מכיר את המוצר היטב. אדבר בצורה ישירה על מה שהוא עושה ועל איפה הוא מתאים.
תהליך העבודה הבסיסי הוא בלחיצה אחת: פותחים דף Temu ולוחצים על One-Click Extract — AI Suggest Fields מציע את העמודות (שם מוצר, מחיר, תמונה, דירוג וכו') וההרצה ממשיכה לבד, אלא אם אתם מתערבים.
ה‑AI של Thunderbit קורא את מבנה העמוד ומציע אוטומטית שמות עמודות וסוגי נתונים. הוא לא נשען על CSS selectors קבועים, כך שכאשר Temu משנה את שמות ה‑class או את פריסת הכרטיסים, הסקרייפר מסתגל.
יכולות עיקריות ל‑Temu:
- מצב Cloud scraping: מהיר יותר לעמודים ציבוריים, מטפל עד 50 עמודים בפעם אחת. הכי טוב לדפי קטגוריה, תוצאות חיפוש ורשימות מוצרים שלא דורשות התחברות.
- מצב Browser scraping: משתמש בסשן ה‑Chrome הנוכחי שלכם, כולל cookies, locale וסטטוס התחברות. הכי טוב כשאזור גיאוגרפי, חלונות קופצים או תוכן מחובר משפיעים על מה שהעמוד מציג.
- Scrape Subpages: אחרי גרידת דף רשימה, לוחצים על "Scrape Subpages" כדי להיכנס לכל דף מוצר ולהוסיף עמודות כמו תיאור מלא, וריאציות, מידע על המוכר, הערכת משלוח ומפרטים — בלי שום הגדרה נוספת.
- Field AI Prompts: מסווגים, מתרגמים או מעצבים מחדש נתונים בזמן הגרידה. למשל: "סווג את המוצר הזה ל‑Kitchen Utensils, Small Appliances, Storage, או Other."
- Scheduled scraping: מגדירים תזמון בשפה טבעית ("every Monday at 9am"), מכניסים URLs, ו‑Thunderbit מריץ את הגרידה בענן ומייצא ל‑Google Sheets, Airtable או יעד אחר.
- ייצוא חינמי: Excel, CSV, Google Sheets, Airtable, Notion, JSON — אין חסימת תשלום על הייצוא. תמונות מיוצאות כקבצים מצורפים אמיתיים ב‑Airtable וב‑Notion.
מחיר: מסלול חינמי עם עד 6 עמודים בחודש; מסלולים בתשלום מתחילים בערך מ‑$15 לחודש (חודשי) או $9 לחודש (שנתי) עבור 500 קרדיטים, כאשר 1 קרדיט = שורת פלט אחת.
גרדו נתוני Temu עם AI Get Started Free
השוואה ישירה: Thunderbit מול סקריפט Python על אותו דף Temu
הניגוד חד מאוד:
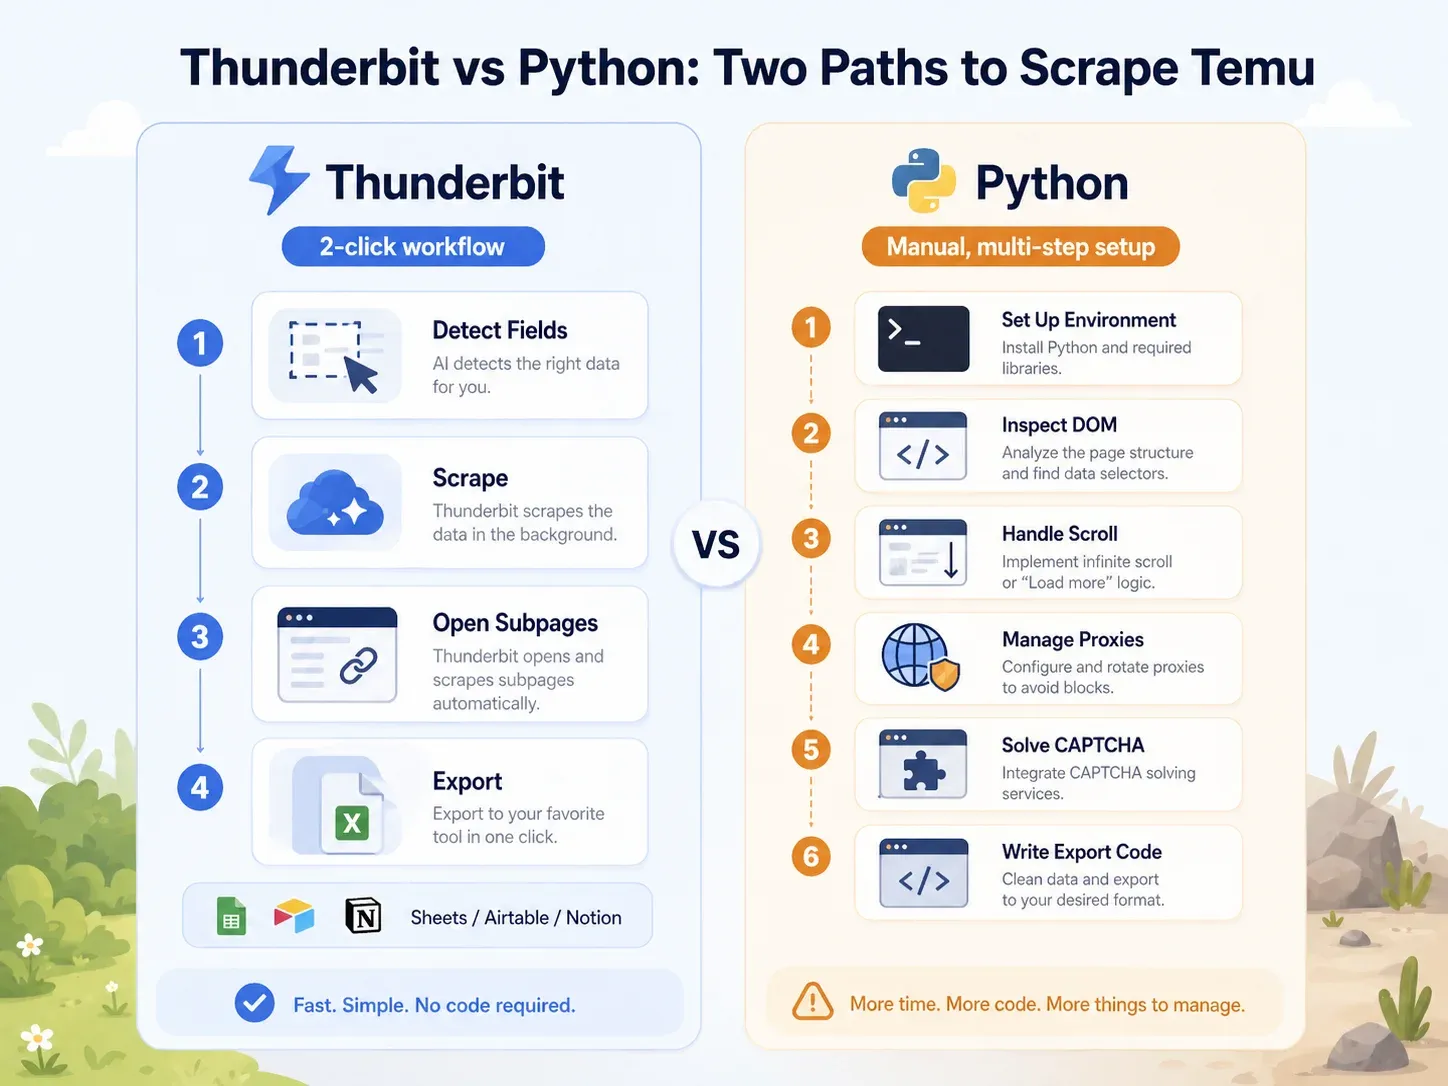
| משימה | Thunderbit | Python (Playwright) |
|---|---|---|
| פתיחת דף קטגוריה ב‑Temu | פותחים את הדף ב‑Chrome | מגדירים סביבת Python, מתקינים Playwright, מתקינים דפדפנים |
| זיהוי שדות | לוחצים "AI Suggest Fields" | בודקים DOM, קריאות רשת, ו‑JSON payloads |
| טיפול בטעינה דינמית | מצב דפדפן/ענן + עימוד | כותבים לוגיקה של גלילה/המתנה, intercepting requests |
| טיפול בחסימות | מנסים מצב ענן או דפדפן | מוסיפים proxies, headers, fingerprinting, retries, CAPTCHA |
| חילוץ שדות מהרשימה | לוחצים "Scrape" | כותבים selectors או לוגיקת parsing ל‑API |
| העשרת דפי מוצר | לוחצים "Scrape Subpages" | בונים crawler נפרד ל‑PDP |
| ייצוא | לוחצים Sheets/Airtable/Notion/Excel | כותבים קוד אינטגרציה ל‑CSV/JSON/Sheets |
| הקמה טיפוסית למשתמש עסקי | פחות מ‑2 דקות | לפחות 1–4 שעות; תחזוקה שוטפת |
פרוטוטייפ מינימלי ב‑Playwright ל‑Temu יכול להיראות בערך כך (פסאודו‑קוד — לא מוכן לייצור):
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch(headless=False)
    page = browser.new_page()
    page.goto("https://www.temu.com/search_result.html?search_key=kitchen+organizer")
    page.wait_for_load_state("networkidle")
    for _ in range(8):
        page.mouse.wheel(0, 2000)
        page.wait_for_timeout(1200)
    cards = page.locator("[data-product-id], a[href*='goods.html']")
    # קוד ייצור עדיין צריך selectors, proxies, retries,
    # טיפול ב-CAPTCHA, crawling ל-PDP ולוגיקת ייצוא.
    print(cards.count())
זה 10+ שורות עוד לפני שהפקתם שדה אחד, ועוד לא נגענו ב‑proxies, CAPTCHA, העשרת PDP או ייצוא. עבור משתמש לא טכני, Thunderbit מקצר את כל התהליך הזה לכמה קליקים. עבור מפתח, מסלול Python נותן יותר שליטה — אבל במחיר תחזוקה גבוה בהרבה.
Octoparse ו‑ParseHub: סקרייפרים ללא קוד ל‑Temu ב‑Desktop
אם אתם רוצים יותר שליטה מתוסף Chrome אבל לא רוצים לכתוב קוד, Octoparse ו‑ParseHub הן האפשרויות המרכזיות.
Octoparse מציעה תבנית ציבורית ל‑Temu Details Scraper. פלט הדוגמה שלה כולל מזהי מוצר, כותרות, מחירים, נתוני מוכר/חנות, כתובות תמונה, הנחות, כתובות חנות ומפרטים מפורטים. זה יתרון אמיתי — אפשר להתחיל מתבנית במקום לבנות תהליך מאפס. Octoparse תומכת גם בחילוץ בענן, תזמון ובניית workflow ויזואלי.
הסתייגויות לגבי Temu:
- תוספים נגד anti-bot (כמו proxies מסוג residential במחיר של $3/GB, ופתרון CAPTCHA ב‑$1–$1.50 לאלף) יכולים להצטבר מהר.
- תבניות עלולות להישבר כש‑Temu משנה את הפריסה. ייתכן שתצטרכו לעדכן selectors או לחכות ש‑Octoparse תתחזק את התבנית.
- זמן ההקמה נע בין 10 ל‑60 דקות, בהתאם למורכבות העמוד.
תמחור Octoparse: מסלול חינמי עם 10 משימות ו‑50K ייצוא נתונים חודשי; Standard החל מ‑$69 לחודש ו‑Professional מ‑$249 לחודש, שניהם בחיוב שנתי (בחיוב חודשי המחיר גבוה יותר). תוספים ל‑proxies, CAPTCHA ושירותים מנוהלים הם בתשלום נוסף.
ParseHub הוא scraper ויזואלי ל‑desktop/web שמטפל היטב בעמודים דינמיים (הוא מריץ דפדפן Chromium מלא). עם זאת, המסלולים בתשלום מתחילים ב‑$189 לחודש, וזה יקר למפעיל יחיד. במחקר שלי לא נמצאה תבנית ציבורית חזקה ומוכחת ספציפית ל‑Temu. ParseHub מתאים יותר לצוותים שכבר נוח להם לבנות פרויקטים ויזואליים של scraping.
| כלי | חוזקות מול Temu | חולשות מול Temu | תמחור |
|---|---|---|---|
| Octoparse | תבנית Temu ציבורית, workflow ויזואלי, חילוץ בענן, תזמון | תחזוקת תבנית, תוספי anti-bot מוסיפים עלות | חינמי; מ‑$69/mo Standard ו‑$249/mo Pro (בחיוב שנתי); תוספים בתשלום נוסף |
| ParseHub | טיפול בעמודים דינמיים, בונה פרויקטים, rotation של IP במסלולים בתשלום | מחיר כניסה גבוה, לא נמצאה תבנית Temu ציבורית | מסלולים בתשלום מ‑$189/mo |
Scraping APIs: ScraperAPI, Apify ו‑Bright Data ל‑Temu
שירותי scraping מבוססי API מטפלים ב‑proxy, rendering ולוגיקת anti-bot, כך שמפתחים יכולים להתמקד בפרסור ובאחסון הנתונים. הם מתאימים כשאתם בונים pipeline, לא כשאתם עושים ייצוא חד‑פעמי לגיליון.
ScraperAPI הוא API למפתחים עבור rotation של proxies ו‑rendering. עמוד התמחור שלו מציין ניסיון של 7 ימים עם 5,000 קרדיטים, מסלול Hobby ב‑$49 לחודש עבור 100,000 קרדיטים, ומסלולים גבוהים יותר מעבר לזה. הבעיה ב‑Temu: עיבוד JavaScript ו‑premium proxy pools עולים 10–75 קרדיטים לבקשה, בהתאם למסלול. זה אומר שהעלות האפקטיבית לשורה יכולה להיות גבוהה בהרבה מהמחיר שמופיע בכותרת.
Apify היא פלטפורמה עם marketplace של "actors" מוכנים (סקרייפרים). קיימים כמה actors ל‑Temu. Actor קהילתי אחד, Temu Scraper, מציג תמחור pay-per-event סביב $5 ל‑1,000 מוצרים במסלול החינמי. Actor אחר, Temu Products Scraper, מציג $4 ל‑1,000 תוצאות. הסיכון: איכות ה‑actors משתנה, התחזוקה תלויה בקהילה, וחלקם עלולים להיות deprecated או להישבר כש‑Temu מתעדכנת. תמיד בדקו את תאריך העדכון האחרון ואת דירוגי המשתמשים לפני שמתחייבים.
Bright Data היא האופציה הארגונית. דף ה‑Temu scraper שלה מציין שהעבודות רצות על התשתית של Bright Data עם rotation של proxies, מיקוד גיאוגרפי, CAPTCHA/unblocking ואוטוסקיילינג. פורמטי הפלט כוללים JSON, CSV, Parquet, ומסירה ישירה ל‑S3, GCS, Azure Blob, BigQuery ו‑Snowflake. ביקורות בתעשייה מדווחות על תמחור Web Scraper API של כ‑$1.5 ל‑1,000 רשומות ב‑pay-as-you-go, עם מסלולים בהתחייבות שמתחילים סביב $499 לחודש. חזק מאוד, אבל במחיר שמתאים לצוותים עם תקציב אמיתי.
Oxylabs מציעה גם דף ייעודי ל‑Temu Scraper API. המסלולים מתחילים ב‑$49 לחודש, עם ניסיון חינמי של עד 2,000 תוצאות. זו אלטרנטיבה חזקה ל‑Bright Data עבור צוותי מפתחים שרוצים נתוני Temu מובנים דרך API.
| API/פלטפורמה | עדות ספציפית ל‑Temu | חוזקה | חולשה | הכי מתאים ל |
|---|---|---|---|---|
| ScraperAPI | לא נמצא דף ייעודי ל‑Temu, אבל מתועדות יכולות anti-bot לאתרי ecommerce | endpoint פשוט, עיבוד JS, premium proxies | מכפילי קרדיטים לתכונות מתקדמות; המפתח צריך לפרסר את הנתונים | pipelines של מפתחים |
| Apify | כמה Temu actors ב‑marketplace | הנתיב המהיר ביותר למפתחים אם actor מתאים ומתוחזק | איכות actors משתנה; חלקם deprecated | מפתחים שרוצים marketplace של actors + תזמון |
| Bright Data | דף scraper ייעודי ל‑Temu | תשתית Enterprise, unblocking, מסירה למחסן נתונים | יקר; עדיין נדרש ידע ב‑web scraping | צוותי נתונים ברמת Enterprise |
| Oxylabs | דף Temu Scraper API ייעודי | תמחור ברור לפי תוצאה, טיפול ב‑JS, טענות ל‑IP/CAPTCHA | workflow של API למפתחים | צוותי מפתחים שצריכים גישה ל‑Temu API |
סקריפטים מותאמים אישית ב‑Python (Playwright/Selenium): שליטה מלאה, הרבה עבודה
סקרייפרים מותאמים אישית ב‑Python נותנים גמישות מקסימלית — זה היתרון. Playwright הוא בדרך כלל נקודת פתיחה טובה יותר מ‑Selenium ל‑Temu בגלל מודל ההמתנה האוטומטית שלו והטיפול הטוב יותר בעמודים כבדי JavaScript.
אבל המחיר הוא כבד.
פרוטוטייפ לוקח 1–4 שעות. סקרייפר לייצור צריך rotation של proxies, טביעות אצבע מציאותיות של דפדפן, אסטרטגיית CAPTCHA, retries, אימות סכמה, אחסון פלט, ניטור, התראות ובדיקה משפטית.
והוא נשבר. קהילות scraping ב‑Reddit מתארות שוב ושוב את scraping של ecommerce מודרני כבלתי יציב כשאתרים משתמשים ב‑Cloudflare, Rendering של JavaScript וטביעות אצבע נגד בוטים.
| כשל | סיבה טיפוסית | פתרון | |---|---|---|---| | HTML ריק / מוצרים חסרים | JS טוען את כרטיסי המוצר אחרי ה‑HTML הראשוני | להשתמש ב‑Playwright, להמתין ל‑network ול‑DOM | | רק המוצרים הראשונים מופיעים | infinite scroll / lazy loading | לולאת גלילה, המתנה ל‑network idle, ספי ספירת כרטיסים | | מחירים חסרים או לא עקביים | מצב אזור/סשן/מטבע או תגובת anti-bot | להגדיר locale, cookies, proxy ממוקד גיאוגרפית | | 403 / challenge / CAPTCHA | מוניטין IP, fingerprint headless, קצב בקשות | residential proxies, דפדפן stealth, קצב נמוך יותר | | selectors נשברים | שינויים ב‑DOM/class, בדיקות A/B | extraction סמנטי או parsing ל‑API אם זמין |
סקריפטים מותאמים אישית הם לא האופציה ה"חינמית". הם מעבירים את העלות מדמי מנוי לזמן מפתח, חשבונות proxy, עלויות CAPTCHA וסיכון תחזוקה. אם יש לכם מהנדס scraping בצוות ואתם צריכים לוגיקה חריגה, זה המסלול הנכון. לכל השאר, זה בפועל הפתרון היקר ביותר.
שיטה מומלצת: Scraping של Subpages לקבלת נתוני מוצר מלאים מ‑Temu
זו שיטת העבודה המומלצת המשמעותית ביותר במאמר הזה — וכמעט אף מדריך אחר לא מכסה אותה.
דף קטגוריה או חיפוש של Temu מציגים לכם את הבסיס: כותרת, תמונת ממוזערת, מחיר, דירוג גס. אבל השדות שהופכים שורה באמת לשימושית — תיאורים מפורטים, רשימות וריאציות, מספר ביקורות מלא, הערכות משלוח, שמות מוכרים, טבלאות מפרט — נמצאים בדף פרטי המוצר (PDP).
אם אתם מגרדים רק את דף הרשימה, אתם עובדים עם מערך נתונים חלקי.
תהליך העבודה בשני שלבים:
- שלב 1 — גרידת דף הרשימה (PLP): חילוץ שם מוצר, מחיר, תמונה ממוזערת ודירוג מדף חיפוש או קטגוריה של Temu.
- שלב 2 — העשרה דרך גרידת subpages: כניסה לכל PDP של מוצר והוספת עמודות כמו תיאור מלא, מספר ביקורות, אפשרויות וריאציות, זמן משלוח ומידע על המוכר.
כך הנתונים נראים לפני ואחרי:
| שדה | מה‑PLP (שלב 1) | תוספת מה‑PDP (שלב 2) |
|---|---|---|
| כותרת מוצר | ✅ | — |
| מחיר | ✅ | ✅ (מאומת / אחוז הנחה) |
| תמונה ממוזערת | ✅ | — |
| דירוג כוכבים | ✅ | ✅ (עם מספר ביקורות) |
| תיאור מלא | ❌ | ✅ |
| וריאציות (מידות, צבעים) | ❌ | ✅ |
| שם מוכר | ❌ | ✅ |
| הערכת משלוח | ❌ | ✅ |
| מפרטים מפורטים | ❌ | ✅ |
ב‑Thunderbit, זה קליק אחד: אחרי הגרידה הראשונית, לוחצים על "Scrape Subpages". ה‑AI מבקר בכל URL של מוצר ומוסיף את העמודות הנוספות — בלי שום קונפיגורציה נוספת, בלי spider נפרד, בלי תחזוקת selectors. גם תבנית ה‑Temu Details של Octoparse וגם ה‑actor של Temu ב‑Apify תומכים בשדות ברמת PDP, אבל עם יותר הקמה ותחזוקה. ב‑Python תצטרכו לבנות crawler נפרד ל‑PDP, לתחזק את ה‑selectors שלו ולטפל בעימוד בתוך דפי פרטים — השקעה נוספת משמעותית.
שיטה מומלצת: Temu Scraping מתוזמן לניטור שוטף של מחיר ומלאי
איסוף חד‑פעמי מועיל לגילוי מוצרים. competitive intelligence דורש התבוננות חוזרת.
מחירים משתנים, מוצרים אוזלים מהמלאי, פריטים חדשים מופיעים מדי יום, ועומק ההנחות משתנה עם המבצעים. scraping שבועי או יומי יוצר טבלת היסטוריה שהצוות שלכם באמת יכול לפעול לפיה.
שלושה מקרי שימוש ששווה לאוטומט:
- ניטור מחירים: עקבו מדי שבוע אחרי 50 ה‑SKUs המובילים של מתחרה ב‑Temu. קבלו מחירים מעודכנים ל‑Google Sheets באופן אוטומטי להשוואה מהירה מול התמחור שלכם.
- ניטור מלאי וזמינות: זהו מתי מוצר טרנדי אוזל, מתי מופיעה וריאציה חדשה, או מתי משתנות הערכות המשלוח.
- זיהוי מוצרים/טרנדים חדשים: תזמנו scraping יומי של "New Arrivals" ב‑Temu או של דף קטגוריה בעדיפות גבוהה. מיינו לפי מספר מכירות או ביקורות כדי לזהות מוצרים עולים מוקדם.
ב‑Thunderbit, מגדירים את המחזור בשפה טבעית ("every Monday at 9am"), מזינים את ה‑URLs היעד ולוחצים "Schedule". ה‑scrape רץ בענן ומייצא ליעד שתבחרו. מכיוון שה‑AI קורא את העמוד מחדש בכל פעם, scraping מתוזמן מסתגל אוטומטית לשינויים במבנה של Temu — לא צריך לעדכן selectors כשהעיצוב של כרטיס מוצר משתנה.
החלופה: להגדיר cron job, לתחזק סקריפט Python, להגדיר rotation של proxies, לבנות צינור פלט ולתקן selectors בכל פעם ש‑Temu משנה את הפריסה. לצוות לא טכני זו לא אופציה. למפתח — זה overhead קבוע. גם Apify ו‑Bright Data תומכות בהרצות מתוזמנות, אבל עם יותר קונפיגורציה טכנית ורצפת מחיר גבוהה יותר.
שיטה מומלצת: Workflow מלא לנתוני Temu (Scrape → Clean → Export → Act)
רוב מדריכי scraping מסיימים ב‑"הורידו CSV".
אבל משתמשי עסק צריכים את הנתונים בתוך הכלים שהם באמת עובדים איתם — Google Sheets לשיתוף פעולה, Airtable למסדי נתונים של מוצרים, Notion לדשבורדים צוותיים. השיטה המומלצת האמיתית היא workflow מקצה לקצה:
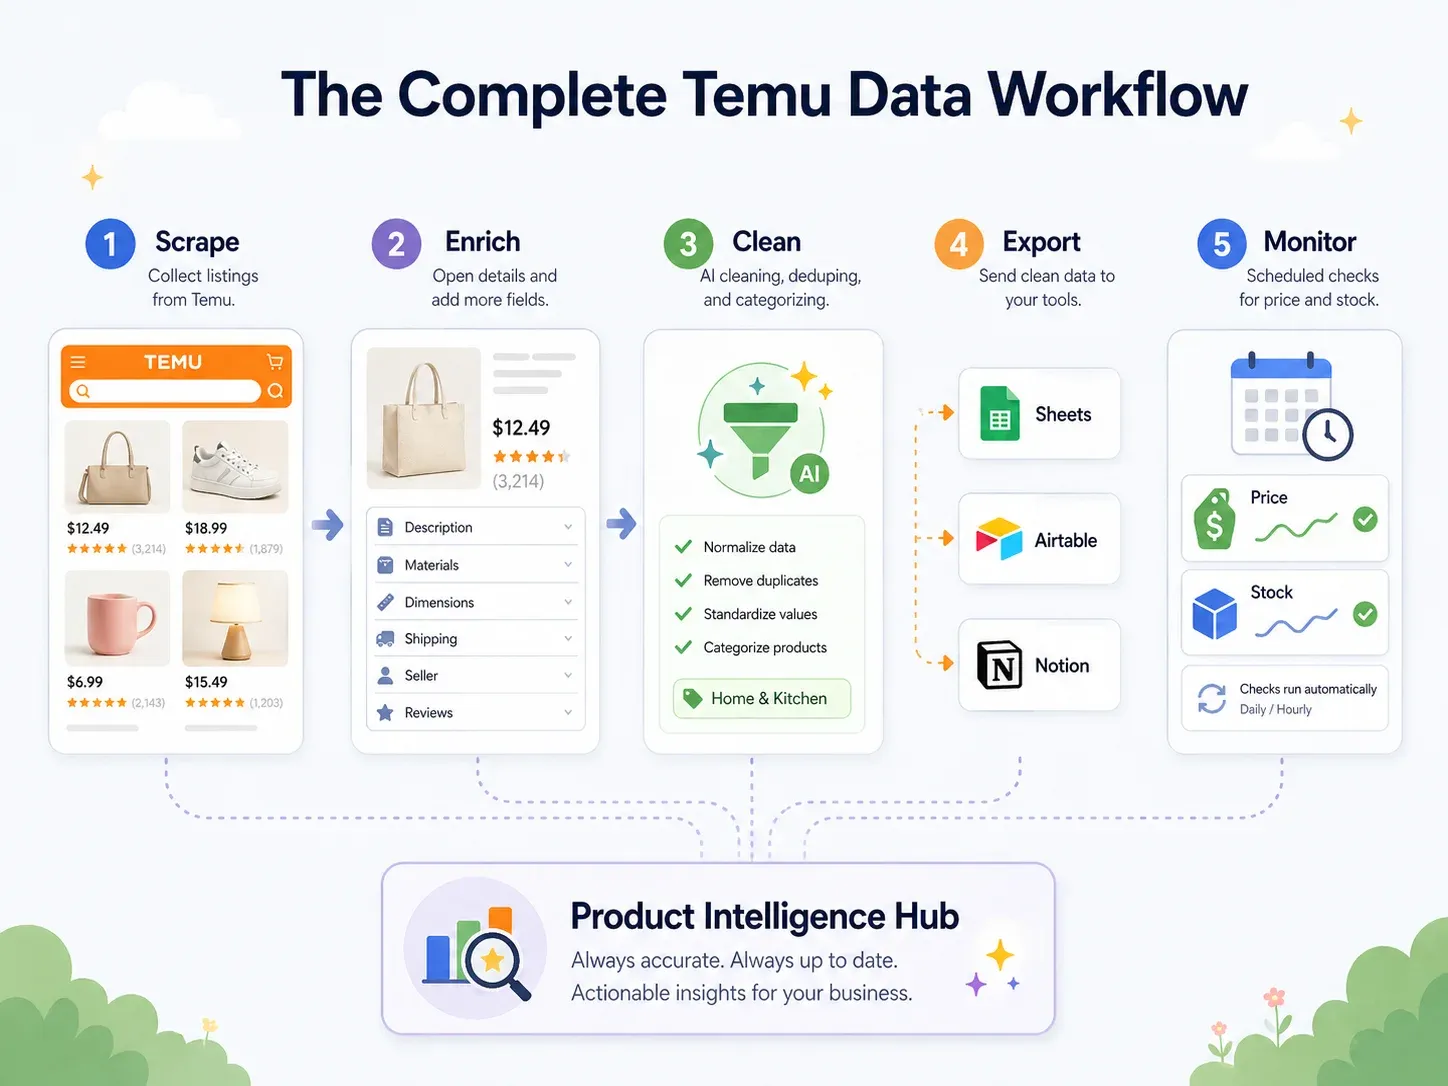
| שלב ב‑workflow | מה קורה | היכולת של Thunderbit |
|---|---|---|
| Scrape | חילוץ נתונים מדפי Temu | AI Suggest Fields → Scrape (2 קליקים) |
| Enrich | כניסה לדף הפרטים של כל מוצר | Scrape Subpages (קליק אחד) |
| Clean & Label | סיווג מוצרים, נרמול מחירים, תרגום כותרות | Field AI Prompt — תיוג, עיצוב ותרגום במהלך הגרידה |
| Export | שליחת הנתונים לכלי העסק | ייצוא חינמי ל‑Excel, Google Sheets, Airtable, Notion; הורדת CSV/JSON |
| Monitor | מעקב אחר שינויים לאורך זמן | Scheduled Scraper עם מרווחים בשפה טבעית |
הנה דוגמה מוחשית: אתם מגרדים 200 מוצרי מטבח מ‑Temu. במהלך הגרידה, Field AI Prompt מסווג אוטומטית כל מוצר ל‑"Utensils / Small Appliances / Storage / Cleaning / Decor." המחירים מנורמלים לערכי USD מספריים. כותרות המוצרים בסינית מתורגמות לאנגלית. הנתונים מיוצאים ישירות ל‑Airtable base עם תמונות המוצרים שלמות (לא רק כתובות URL — אלא קבצי תמונה מצורפים בפועל, כפי שמתואר ב‑Thunderbit's image scraping guide). גרידה מתוזמנת מרעננת את הנתונים מדי שבוע.
כמה הוראות שימושיות ל‑Field AI Prompt עבור נתוני Temu:
- "Categorize this product into one of: Kitchen Utensils, Small Appliances, Storage, Cleaning, Decor, Other. Return only the category."
- "Translate the product title into concise English while preserving brand names, quantities, sizes, and model numbers."
- "Normalize the price as a number without currency symbols."
- "Label demand as High, Medium, or Low based on rating, review count, and sold count. If data is missing, return Unknown."
ה‑workflow הזה הופך scrape גולמי למסד נתוני intelligence חי של מוצרים — בלי שמפתח בונה pipeline נפרד של ETL.
השוואה בין הסקרייפרים הטובים ביותר ל‑Temu: טבלה זו לצד זו
| כלי | רמת מיומנות | זמן הקמה | טיפול ב‑Anti-Bot | Scraping של Subpages | תזמון | אפשרויות יצוא | רמת תמחור | הכי מתאים ל |
|---|---|---|---|---|---|---|---|---|
| Thunderbit | מתחיל | דקות | מצב דפדפן, מצב ענן, זיהוי שדות ב‑AI | כן (Scrape Subpages) | כן (תזמונים בשפה טבעית) | Excel, CSV, Google Sheets, Airtable, Notion, JSON | 6 עמודים חינם; בתשלום מ‑~$9–15/mo עבור 500 קרדיטים | צוותי ecommerce לא טכניים, דרופשיפרים |
| Octoparse | מתחיל–בינוני | 10–60 דק' | חילוץ בענן, תוספי proxy/CAPTCHA | כן (תבניות workflow) | כן (מסלולי paid/cloud) | Excel, CSV, JSON, HTML, XML, database, Google Sheets | חינמי; מ‑$69/mo Standard (בחיוב שנתי); תוספים בתשלום נוסף | מפעילים שרוצים workflows ויזואליים + תבנית Temu |
| ParseHub | מתחיל–בינוני | 30–60 דק' | Rendering דינמי, rotation של IP במסלולים בתשלום | כן (flows של פרויקט) | מסלולים בתשלום | CSV/JSON, Dropbox/S3 במסלולים בתשלום | בתשלום מ‑$189/mo | צוותים שבונים פרויקטים ויזואליים לאתרים דינמיים |
| ScraperAPI | מפתח | שעות | Rotation של proxies, עיבוד JS, premium pools | בקוד מותאם אישית | DataPipeline/scheduler | HTML/JSON/CSV | ניסיון 5K קרדיטים; Hobby $49/mo; מסלולים גבוהים זמינים | מפתחים שבונים pipelines מותאמים ל‑Temu |
| Apify | בינוני | 10–30 דק' אם actor מתאים | לוגיקת browser/proxy לפי actor | תלוי ב‑actor | כן | JSON, CSV, Excel, API/datasets | פלטפורמה חינמית; Temu actors סביב $4–5 ל‑1K מוצרים | מפתחים/מפעילים שיכולים לבדוק איכות actor |
| Bright Data | מתקדם/Enterprise | שעות–ימים | proxy מלא, CAPTCHA, unblocking, autoscaling | מותאם אישית דרך scraper/API | כן | JSON, CSV, Parquet, S3, GCS, Azure, BigQuery, Snowflake | כ‑$1.5 ל‑1K רשומות ב‑PAYG; Scale מ‑$499/mo | צוותי נתונים בארגון, חילוץ בנפחים גבוהים |
| Oxylabs | מתקדם | שעות | טיפול ב‑JS, טענות ל‑IP/CAPTCHA | מותאם אישית דרך API | כן | JSON/API output | מ‑$49/mo; ניסיון עד 2K תוצאות | צוותי מפתחים שצריכים גישה ל‑Temu API |
| Custom Python (Playwright) | מתקדם | 1–4 שעות+; תחזוקה שוטפת | proxies ידניים, CAPTCHA, fingerprints | מותאם אישית לחלוטין | Cron/queue/manual | מותאם אישית | זמן פיתוח + עלויות proxy/CAPTCHA/hosting | מקרי קצה, צוותים עם מהנדסי scraping |
איזה סקרייפר ל‑Temu כדאי לבחור? המלצות מהירות
- דרופשיפר שצריך מחקר מוצרים מהיר? התחילו עם המסלול החינמי של Thunderbit. זה המסלול המהיר ביותר מ‑"אני רוצה נתונים מ‑Temu" ל‑"יש לי גיליון." אם זה עובד על העמודים שלכם (וזה אמור לעבוד ברוב דפי הקטגוריה והמוצרים הציבוריים), סיימתם.
- מפעיל שרוצה שליטה ויזואלית ותבניות לשימוש חוזר? ל‑Octoparse יש תבנית Temu ציבורית ובונה workflow ויזואלי. צפו ל‑10–30 דקות הקמה וכמה הגדרות proxy/CAPTCHA.
- מפתח שבונה צינור נתונים או כלי פנימי? ScraperAPI או Apify מספקים workflows של API/actors שמשתלבים עם קוד ועם jobs מתוזמנים. בדקו actors של Apify בזהירות — בדקו סטטוס תחזוקה ודירוגי משתמשים.
- צוות Enterprise שצריך נפח גבוה של נתוני Temu ומסירה למחסן נתונים? Bright Data היא פתרון תשתית. יקר, אבל הוא מטפל בקנה מידה, unblocking ומסירה ל‑S3/BigQuery/Snowflake.
- מהנדס scraping שצריך לוגיקה לא שגרתית? Python ב‑Playwright/Selenium נותן שליטה מלאה. רק קחו בחשבון תחזוקה שוטפת, עלויות proxy וטיפול ב‑CAPTCHA.
עבור רוב משתמשי העסק הלא טכניים, הייתי ממליץ להתחיל בבדיקת המסלול החינמי של Thunderbit. השאלה המיידית תמיד היא "האם אני יכול לקבל מהעמוד הזה של Temu את השורות שאני צריך?" — ואת זה אפשר לבדוק בפחות משתי דקות בלי להוציא כסף. למפתחים, הריצו benchmark של עלות‑לכל‑שורה מוצלחת בין Apify, ScraperAPI ופרוטוטייפ קטן ב‑Playwright לפני שאתם מקצים תקציב.
נסו את Thunderbit בחינם ל‑Temu Scraping
שאלות נפוצות על scraping של Temu
האם חוקי לגרד נתונים מ‑Temu?
זה תלוי בתחום השיפוט, בנתונים שאתם אוספים, בשיטת הגישה שלכם ובאופן שבו אתם משתמשים בנתונים. תנאי השימוש של Temu מגבילים במפורש גישה אוטומטית, כולל crawling, scraping או spidering של דפים או נתונים. בתי משפט בארה״ב סיפקו תקדימים מסוימים לטובה לגבי גישה לנתונים ציבוריים (החלטת hiQ v. LinkedIn של בית המשפט לערעורים במחוז התשיעי), אבל פסקי דין מאוחרים יותר גם אישרו טענות של הפרת חוזה ו‑trespass. התשובה הקצרה: scraping של נתוני מוצר ציבוריים למחקר עשוי להיות ניתן להגנה בהקשרים מסוימים, אבל תנאי השירות, דיני פרטיות, זכויות יוצרים והאופן שבו אתם משתמשים בנתונים — כולם חשובים. זו לא ייעוץ משפטי — לשימוש מסחרי, התייעצו עם עו״ד.
כל כמה זמן Temu משנה את מבנה האתר שלה?
לא פורסם קצב רשמי. דיווחים מהקהילה והאקו־סיסטם של הכלים מתייחסים ל‑Temu כיעד דינמי שמתעדכן לעיתים קרובות. הניחו ש‑CSS selectors יכולים להישבר בכל רגע, והעדיפו extraction מבוסס AI/semantics או תבניות שמתוחזקות באופן פעיל על פני selectors קשיחים.
אפשר לגרד נתונים מ‑Temu בלי להיחסם?
עבור דפים ציבוריים מוגבלים ובקצב אחראי, כן — במיוחד באמצעות כלים עם rendering אמיתי של דפדפן, תמיכה בסשן ו‑throttling. אף כלי לא צריך להיתפס כהבטחה אוניברסלית. scraping בענן עם IPs מתחלפים עובד היטב לדפי קטלוג ציבוריים; scraping דרך הדפדפן עם הסשן הנוכחי שלכם עובד טוב יותר כשהאזור, ההתחברות או חלונות הקופצים משפיעים על הנתונים.
אילו נתונים אפשר לחלץ מדפי מוצרים של Temu?
שדות ציבוריים נפוצים כוללים כותרת מוצר, URL, מחיר נוכחי, מחיר מקורי, אחוז הנחה, כתובות תמונה, דירוג כוכבים, מספר ביקורות, מספר מכירות, שם המוכר/החנות, מידע על משלוח, קטגוריה, מפרטי מוצר, וריאציות (צבעים, מידות) וחותמת זמן של הגרידה. השדות הזמינים בפועל תלויים בסוג העמוד (רשימה לעומת פרטים) ובאזור.
צריך proxies כדי לגרד נתונים מ‑Temu?
עבור extraction ידני קטן במצב דפדפן (כמה עמודים בכל פעם), ייתכן שלא. עבור איסוף בענן, מתוזמן או בנפח גבוה, proxies או תשתית מנוהלת נגד חסימות בדרך כלל נחוצים. כלים כמו Thunderbit, Bright Data ו‑ScraperAPI משלבים ניהול proxies בתוך הפלטפורמה, כך שלא צריך להגדיר זאת בנפרד.
אם תרצו להעמיק בנושאים קשורים, עיינו במדריכים שלנו על web scraping להשוואת מחירים, הסקרייפרים הטובים ביותר ל‑ecommerce, גרירת נתונים מאתרים ל‑Excel, ו‑איך לגרד נתונים ל‑Google Sheets. אפשר גם לצפות בהדרכות בערוץ ה‑Thunderbit YouTube channel.
נסו את Thunderbit ל‑Temu Scraping Get Started Free
למידע נוסף




