
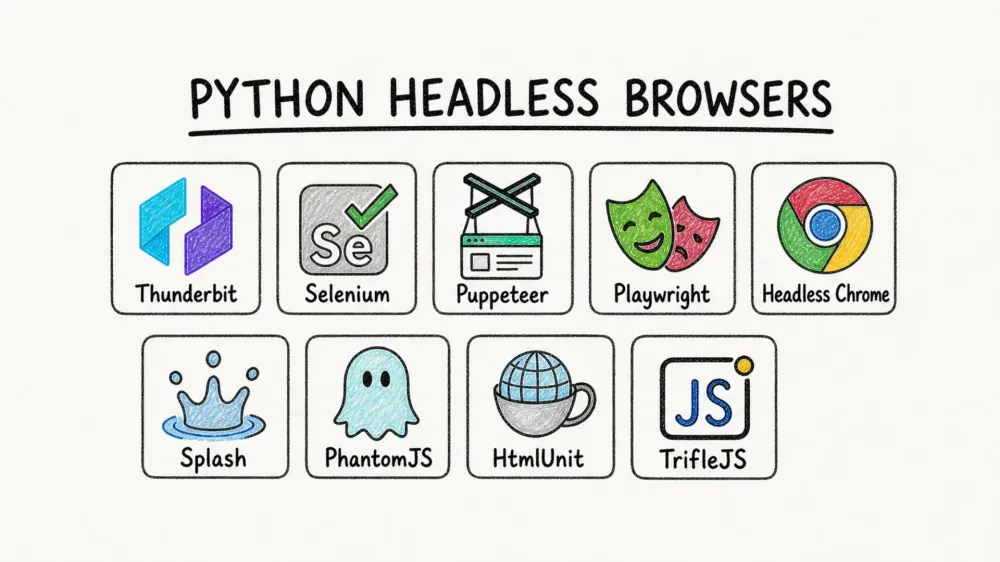
האינטרנט הפך לזירה פרועה ומשתנה בלי הפסקה—תחשבו עליו פחות כעל “ספרייה דיגיטלית” ויותר כעל “ג׳ונגל של נתונים”. ב-2026, אם אתם מנסים לחלץ נתונים מאתרים מודרניים, אתם לא רק נתקלים בקיר של JavaScript—אתם מול מבצר של ממש. ראיתי מקרוב איך כלי scraping מסורתיים קורסים תחת עומס של תוכן דינמי, גלילה אינסופית ומנגנוני הגנה נגד בוטים. לכן העלייה של python headless browser היא לא עוד טרנד—זו מהפכה אמיתית לכל מי שצריך חילוץ נתונים אמין ובקנה מידה רחב מהאינטרנט.
וזה לא רק עניין של אנשי טכנולוגיה. נכון ל-2025, 73% מהארגונים מסתמכים על חילוץ נתוני אינטרנט אוטומטי ל-BI, ולמעלה מ-94% מהאתרים נשענים כיום על רינדור JavaScript בצד הלקוח (94% of websites now depend on client-side JavaScript rendering). בין אם אתם עובדים במכירות, באיקומרס או בתפעול, הבחירה בדפדפן headless הנכון ב-Python היא ההבדל בין “הנתונים בהישג יד” לבין “הנתונים מחוץ לטווח”. אז בואו נעשה סדר בכל הרעש—בדקתי, השוויתי וחייתי עם הכלים האלה, ואני כאן כדי לפרק את 10 דפדפני python headless הטובים ביותר ל-scraping מודרני (עם זרקור מיוחד על איך AI משנה את כללי המשחק למי שלא כותב קוד).
מה הופך דפדפן Python Headless לחיוני ל-Scraping מודרני?
חילוץ נתונים מכל אתר בעזרת AI Get Started Free
בואו נפשט את הז׳רגון: python headless browser הוא פשוט דפדפן אינטרנט שאתם שולטים בו באמצעות קוד Python, אבל בלי החלון המעצבן שקופץ על המסך. הוא טוען דפים, מריץ JavaScript, לוחץ על כפתורים, ממלא טפסים—הכול מאחורי הקלעים ובשקט. תחשבו עליו כמו על דפדפן-רוח, שעובד בלי הפסקה בזמן שאתם שותים קפה.
למה זה כל כך חשוב? כי אתרים מודרניים נבנו קודם כול למשתמשים, לא לבוטים. הם מחביאים נתונים מאחורי JavaScript, דורשים התחברות, ומצפים שתפעלו כמו אדם אמיתי. scrapers מסורתיים שפשוט מושכים HTML נשארים מול מעטפת ריקה. לעומת זאת, דפדפני headless מדמים התנהגות של משתמש אמיתי—הם ממתינים לקריאות AJAX, גוללים בפידים אינסופיים, ואוספים את התוכן בדיוק כפי שרואים אותו ב-Chrome או Firefox (LiveProxies).
אבל זה לא הכול:
- מהירות ויעילות: דפדפני headless מדלגים על הרינדור הוויזואלי, ולכן הם מהירים יותר וצורכים פחות זיכרון—מושלם ל-scraping בקנה מידה גדול (LiveProxies).
- תמיכה בתוכן דינמי: הם מריצים JavaScript, כך שאתם מקבלים את הנתונים האמיתיים והרנדרים—לא רק HTML גולמי.
- יכולות אוטומציה חזקות: צריך להתחבר, לעבור בין עמודים או להתמודד עם פופ-אפים? דפדפני Python headless יכולים לאוטומט הכול.
- סקיילביליות: אפשר להריץ מאות מופעים בענן, לחלץ אלפי דפים במקביל, ולעשות את זה בלי להתאמץ.
עבור משתמשים עסקיים, המשמעות היא שאפשר סוף סוף לאסוף לידים, לנטר מתחרים או לעקוב אחרי מחירים—even אם האתר בנוי כמו מבצר בלתי חדיר. ועם כלי AI מהדור החדש, לא צריך להיות מתכנת כדי להצטרף לחגיגה.
איך בחרנו את דפדפני Python Headless הטובים ביותר
לא פשוט זרקתי חצים על רשימת שמות של דפדפנים. הנה מה שבדקתי:
- ביצועים ומהירות: האם הוא מסוגל להתמודד עם אתרים מודרניים כבדי JavaScript במהירות ובאמינות?
- תמיכה בדפדפנים: האם הוא עובד עם Chrome, Firefox, WebKit, או אפילו מנועים ותיקים כמו IE?
- קלות שימוש: האם הוא ידידותי למי שלא כותב קוד, או שצריך דוקטורט ב-Python?
- יכולות AI ו-No-Code: האם משתמשים עסקיים יכולים להיעזר ב-AI כדי לאוטומט scraping בלי לכתוב סקריפטים?
- קהילה ותמיכה: האם יש קהילה פעילה, תיעוד טוב ופיתוח מתמשך?
- תכונות ייחודיות: האם הוא מציע משהו מיוחד—כמו תבניות מיידיות, scraping בענן או ניווט בין עמודי משנה?
ראיתי צוותים מבזבזים שבועות על התעסקות בהגדרה, רק כדי להיתקע כשהמבנה של האתר משתנה. הכלים הטובים באמת לא רק עובדים—הם מסתגלים, מתרחבים ומקלים על החיים.
10 דפדפני Python Headless הטובים ביותר ל-Scraping מודרני
הנה הרשימה הסופית שלי, עם פירוט מעמיק על מה שמייחד כל כלי—או להפך, איפה הוא נופל.
1. Thunderbit
 Thunderbit הוא ה-python headless browser שהלוואי שהיה לי כבר לפני שנים. זה לא רק כלי לאוטומציה של דפדפן—זו תוסף Chrome ל-Web Scraper מבוסס AI שנבנה עבור משתמשים עסקיים שרוצים תוצאות, לא כאבי ראש.
למה Thunderbit בולט:
- הגדרת שדות באמצעות AI: פשוט פותחים את התוסף—קליק אחד—וה-AI של Thunderbit מבין את מבנה הדף, בוחר את השדות ומריץ את ה-scrape עבורכם (Thunderbit Docs).
- תבניות נתונים מיידיות: עבור אתרים פופולריים (Amazon, Zillow, LinkedIn ועוד), תקבלו תבניות בלחיצה אחת—בלי שום הגדרה.
- Scraping של עמודי משנה ודפדוף בין עמודים: Thunderbit יכול ללחוץ דרך עמודי משנה, לטפל בגלילה אינסופית ולמזג את כל הנתונים לטבלה אחת.
- הנחיות בשפה טבעית: פשוט מתארים מה רוצים באנגלית פשוטה; ה-AI של Thunderbit עושה את כל השאר.
- Scraping בענן או בדפדפן: אפשר להריץ את הסריקות מקומית או בענן (עד 50 עמודים במקביל לצורך מהירות).
- ללא צורך בקוד: באמת—אם אתם יודעים להשתמש בדפדפן, אתם יודעים להשתמש ב-Thunderbit.
- ייצוא נתונים חינם: ייצוא ל-Excel, Google Sheets, Notion או Airtable בלחיצה אחת.
ראיתי את Thunderbit חוסך שעות לצוותי מכירות ותפעול—אוסף לידים, מנטר מחירים או מרכז נתוני מוצרים בלי לגעת בקוד. הוא זוכה לאמון של מעל 200,000 משתמשים ברחבי העולם, והמשוב חוזר שוב ושוב: “לא יאמן כמה זה קל.”
מתאים במיוחד ל: משתמשים לא טכניים, צוותים עסקיים, וכל מי שרוצה לתת ל-AI לעשות את העבודה הקשה.
נסו את Thunderbit AI Web Scraper בחינם
2. Selenium
 Selenium הוא סבא של אוטומציית דפדפנים. אם אי פעם חיפשתם בגוגל “python headless browser”, כנראה נתקלתם ב-Selenium WebDriver.
יתרונות:
- תומך בכל הדפדפנים המרכזיים: Chrome, Firefox, Safari, Edge ואפילו Internet Explorer (לנועזים במיוחד).
- קהילה ענקית: המון מדריכים, תוספים ותשובות ב-Stack Overflow.
- גמיש מאוד: אפשר לבצע אוטומציה כמעט לכל פעולה שמשתמש עושה—לחיצות, טפסים, ניווט.
חסרונות:
- ההגדרה יכולה להיות מסורבלת: צריך להתעסק עם דרייברים של דפדפנים ולוודא התאמה בין גרסאות.
- איטי יותר מכלים מודרניים: פרוטוקול WebDriver מוסיף עומס, והרחבה למאות דפדפנים נהיית מסורבלת.
- API ארוך ומסורבל יותר: תכתבו יותר קוד מאשר עם Playwright או Puppeteer.
מתאים במיוחד ל: צוותים עם ניסיון קיים ב-Selenium, בדיקות חוצות דפדפנים או תהליכי אוטומציה ותיקים.
3. Puppeteer
 Puppeteer היא ספריית האוטומציה הגבוהה של Google ל-Chrome/Chromium. למרות שהיא מקורית ל-Node.js, גם משתמשי Python יכולים להיכנס למשחק דרך Pyppeteer.
יתרונות:
- מותאם במיוחד ל-Chrome: מהיר, יעיל ומשתלב היטב עם Chrome DevTools.
- API אסינכרוני: מצוין לאתרים מודרניים עתירי JavaScript.
- מגוון יכולות עשיר: צילומי מסך, ייצוא PDF, יירוט רשת.
חסרונות:
- רק Chromium: אין תמיכה ב-Firefox או Safari.
- מקורי ל-Node.js: משתמשי Python נדרשים ל-Pyppeteer (שכבר לא מתוחזק—ראו למטה).
מתאים במיוחד ל: מפתחים שרוצים אוטומציית Chrome מהירה ואמינה, ולא צריכים תמיכה רב-דפדפנית.
4. Playwright
 Playwright הוא הילד החדש בשכונה, שפותח על ידי Microsoft—והוא הפך מהר מאוד לכלי המועדף עליי ל-scraping מתקדם.
יתרונות:
- תמיכה בריבוי דפדפנים: אוטומציה ל-Chromium, Firefox ו-WebKit דרך API אחד.
- Auto-Waiting: לא צריך לנחש מתי הדף מוכן—Playwright ממתין בשבילכם.
- Concurrency: אפשר להריץ כמה browser contexts במקביל במהירות מסחררת.
- Python-First: יש תמיכה טבעית ב-Python, גם ב-async וגם ב-sync.
חסרונות:
- התקנה כבדה יותר: מגיע עם כמה דפדפנים, אז ההגדרה מעט כבדה יותר.
- עדיין דורש קוד: לא ידידותי למי שאינו טכני כמו Thunderbit.
מתאים במיוחד ל: מפתחים שצריכים אוטומציה חזקה ומודרנית—במיוחד לאפליקציות אינטרנט מורכבות ודינמיות.
5. Headless Chrome
 Headless Chrome הוא המנוע שמפעיל חלק גדול מהכלים שמופיעים כאן. אפשר לשלוט בו ישירות דרך Chrome DevTools Protocol (CDP) לקבלת גמישות מקסימלית.
יתרונות:
- תמיכה מתקדמת בתכני Web: אם זה עובד ב-Chrome, זה יעבוד גם ב-Headless Chrome.
- שליטה מדויקת מאוד: גישה לכל פינה ונקודה בדפדפן.
חסרונות:
- עקומת למידה תלולה: צריך לדבר CDP או להשתמש בספריית עזר.
- רק Chrome: אין תמיכה חוצת דפדפנים.
מתאים במיוחד ל: מומחים שבונים צינורות אוטומציה מותאמים או משלבים Chrome ברמה נמוכה.
6. Pyppeteer
 Pyppeteer הוא הפורט הלא-רשמי של Puppeteer ל-Python. הוא הביא אוטומציית Chrome אסינכרונית ל-Python, אבל… יש קאץ׳.
יתרונות:
- ממשק בסגנון Puppeteer: אם אתם מכירים Puppeteer, תרגישו בבית.
- אוטומציית Chrome מהירה: מעולה לאתרים דינמיים.
חסרונות:
- לא מתוחזק: הפרויקט המקורי כבר לא מעודכן (המפתחים ממליצים לעבור ל-Playwright).
- רק Chromium: אין Firefox או Safari.
מתאים במיוחד ל: פרויקטים ותיקים שכבר משתמשים ב-Pyppeteer. לפרויקטים חדשים—עדיף Playwright.
7. Splash
 Splash הוא דפדפן headless קל משקל וניתן לסקריפט, עם HTTP API, שפותח על ידי צוות Scrapinghub (כיום Zyte).
יתרונות:
- קל משקל: מבוסס QtWebKit, ולכן צורך פחות משאבים מ-Chrome.
- HTTP API: ניתן לשלוט בו מכל שפה, לא רק מ-Python.
- מעולה ל-Scrapy: משתלב בצורה חלקה עם spiders של Scrapy לצורך רינדור JavaScript.
חסרונות:
- מנוע WebKit ישן יותר: עלול להתקשות עם JavaScript חדיש ומתקדם.
- נדרש Lua לסקריפטינג: לאינטראקציות מתקדמות תצטרכו ללמוד קצת Lua.
מתאים במיוחד ל: משתמשי Scrapy שצריכים מדי פעם רינדור JavaScript, או משימות רינדור קלות בצד השרת.
8. PhantomJS
 PhantomJS הוא הדפדפן headless הסקריפטבילי המקורי, המבוסס על WebKit. הוא היה חלוץ—אבל היום הוא ברובו מיושן.
יתרונות:
- סקריפטינג פשוט: קל לאוטומציה באמצעות JavaScript.
- תמיכה במערכות ותיקות: עדיין עובד עבור אתרים סטטיים ישנים.
חסרונות:
- לא מתוחזק: אין עדכונים מאז 2016.
- מנוע מיושן: לא מסוגל להתמודד עם אתרים מודרניים עתירי JavaScript.
- סיכוני אבטחה: אין תיקוני אבטחה עדכניים.
מתאים במיוחד ל: תחזוקה של סקריפטים ישנים. לפרויקטים חדשים, עדיף לעבור ל-Playwright או Puppeteer.
9. HtmlUnit
 HtmlUnit הוא דפדפן headless מבוסס Java שמדמה התנהגות דפדפן. הוא מהיר וקל משקל, אבל הוא לא מנוע דפדפן אמיתי.
יתרונות:
- Java טהור: מעולה לסביבות עתירות Java.
- מהיר לעמודים סטטיים: אין צורך להפעיל דפדפן מלא.
חסרונות:
- תמיכה מוגבלת ב-JavaScript: מתקשה עם אתרים מודרניים ודינמיים.
- לא מקורי ל-Python: דורש שכבות אינטגרציה (למשל HtmlUnitDriver של Selenium).
מתאים במיוחד ל: תהליכי עבודה מבוססי Java, בדיקות של אפליקציות ותיקות או scraping של עמודים פשוטים שמרונדרים בשרת.
10. TrifleJS
 TrifleJS הוא דפדפן headless עבור Internet Explorer (IE), שנועד לאוטומציה של אפליקציות אינטרנט ותיקות ב-Windows.
יתרונות:
- אוטומציה ל-IE: מטפל באפליקציות אינטרה-נט ישנות או מערכות שעובדות רק ב-IE.
- ממשק דמוי PhantomJS: נדרשים מעט שינויים לסקריפטים של PhantomJS.
חסרונות:
- רק ל-Windows: אין תמיכה חוצת פלטפורמות.
- מיושן: IE כבר פרש, ו-TrifleJS הוא נישתי וכמעט לא מתוחזק.
מתאים במיוחד ל: תהליכי עבודה ייעודיים של מערכות ותיקות, שבהם עדיין חייבים אוטומציה ל-IE.
טבלת השוואת תכונות: דפדפני Python Headless במבט מהיר
| כלי | תמיכה בדפדפנים | ביצועים וסקייל | קלות שימוש | יכולות AI/No-Code | קהילה ותמיכה | מתאים במיוחד ל |
|---|---|---|---|---|---|---|
| Thunderbit | Chrome (תוסף/ענן) | גבוה (מקביליות בענן) | הכי קל—ללא קוד | כן (AI, תבניות) | קהילה צומחת ופעילה | מי שלא כותב קוד, מכירות/תפעול, חילוץ נתונים מהיר |
| Selenium | כל הדפדפנים המרכזיים | בינוני | בינוני (הגדרה) | לא | ענק, ותיק | חוצה-דפדפנים, מערכות ותיקות, בדיקות אוטומציה |
| Puppeteer | Chromium/Chrome | גבוה מאוד | גבוה (למפתחים) | לא | גדול (Node.js) | Chrome בלבד, מפתחים, אוטומציה מהירה |
| Playwright | Chromium, Firefox, WebKit | גבוה מאוד (ריבוי contexts) | גבוה (למפתחים) | לא | גדל במהירות | מתקדם, רב-דפדפני, scraping מודרני |
| Headless Chrome | Chrome/Edge | גבוה מאוד | נמוך (CDP ידני) | לא | לא רלוונטי (בסיס טכנולוגי) | מותאם אישית, מומחים, שליטה ברמה נמוכה |
| Pyppeteer | Chromium/Chrome | גבוה | בינוני (async) | לא | קטן, לא מתוחזק | סקריפטים ותיקים של Pyppeteer |
| Splash | QtWebKit | בינוני | בינוני (API/Lua) | לא | נישתי (Scrapy/Zyte) | משתמשי Scrapy, רינדור JS קל משקל |
| PhantomJS | WebKit (ישן) | נמוך (כיום מיושן) | בינוני (JS) | לא | לא פעיל | רק למערכות ותיקות |
| HtmlUnit | מדומה (Java) | בינוני/גבוה (סטטי) | נמוך (Java) | לא | קטן, ממוקד Java | תהליכי עבודה ב-Java, עמודים פשוטים/סטטיים |
| TrifleJS | Internet Explorer (Trident) | נמוך/בינוני | בינוני (JS, Win) | לא | זעיר, ותיק | אוטומציה ותיקה שמוגבלת ל-IE |
איך לבחור את דפדפן ה-Python Headless הנכון לעסק שלכם
מהו Data Scraping ואיך עושים את זה ב-2025 Get Started Free
הנה דף העזר שלי לבחירה נכונה של הכלי:
- צריכים scraping מהיר, ללא קוד, עם עזרה של AI? לכו על Thunderbit. זה הפתרון הכי פשוט למי שלא כותב קוד ורוצה נתונים אמינים—במיוחד לצוותי מכירות, איקומרס או מחקר.
- רוצים שליטה מקסימלית ותמיכה בכמה דפדפנים? Playwright הוא הבחירה הטובה ביותר. הוא חזק, מודרני ונבנה בקנה מידה גדול.
- כבר השקעתם ב-Selenium? תישארו עם Selenium—הוא עדיין המלך של תהליכי עבודה ותיקים ורב-דפדפניים.
- בונים אוטומציה ל-Chrome בלבד כמפתחים? Puppeteer (או Playwright) מהירים ועוצמתיים.
- מגרדים עמודים פשוטים וסטטיים בסביבת Java? HtmlUnit קל משקל וקל לשילוב.
- מתחזקים סקריפטים ותיקים או אפליקציות שרצות רק ב-IE? PhantomJS ו-TrifleJS הם חברי חירום אחרונים.
וזכרו: הכלי הטוב ביותר הוא זה שמתאים לזרימת העבודה שלכם, לכישורי הצוות ולצרכים העסקיים. לפעמים כדאי לשלב בין כלים—Thunderbit למשימות מהירות, Playwright לעבודות כבדות ו-Selenium למערכות ותיקות.
שאלות נפוצות
1. מהו python headless browser ולמה צריך אותו ל-scraping?
python headless browser הוא דפדפן אינטרנט שנשלט באמצעות קוד Python, אבל פועל בלי ממשק גרפי (GUI). הוא חיוני ל-scraping של אתרים מודרניים עתירי JavaScript, כי הוא יודע להריץ סקריפטים, לטפל באינטראקציות של משתמשים ולחלץ תוכן שעבר רינדור מלא—משהו שסקרייפרים רגילים של HTML לא מסוגלים לעשות.
2. איזה python headless browser הכי טוב למי שאינו טכני?
Thunderbit הוא הבחירה המובילה למי שלא כותב קוד. הוא משתמש ב-AI כדי לאוטומט את ההגדרה, מציע תבניות מיידיות, ומאפשר לחלץ נתונים בלחיצה אחת—או פשוט לומר ל-AI איזה נתונים צריך במשפט אחד. בלי תכנות בכלל.
3. במה Playwright שונה מ-Puppeteer עבור משתמשי Python?
Playwright תומך בכמה דפדפנים (Chromium, Firefox, WebKit) ויש לו binding-ים חזקים ל-Python, מה שהופך אותו לאידיאלי לאוטומציה מתקדמת. Puppeteer הוא כלי ל-Chrome בלבד ומקורי ל-Node.js, אבל משתמשי Python יכולים לעבוד עם Pyppeteer (למרות שהוא כבר לא מתוחזק). עבור פרויקטי Python חדשים, Playwright הוא הבחירה הטובה יותר.
4. האם Selenium עדיין רלוונטי ל-web scraping מודרני?
כן—Selenium עדיין בשימוש נרחב, במיוחד לבדיקות חוצות דפדפנים ולאוטומציה של מערכות ותיקות. עם זאת, הוא איטי ומורכב יותר להגדרה מכלים חדשים כמו Playwright או Thunderbit, ופחות יעיל ל-scraping בקנה מידה גדול.
5. מתי כדאי להשתמש בכלים ותיקים כמו PhantomJS, HtmlUnit או TrifleJS?
רק כשצריך לתחזק או להעביר תהליכי עבודה ישנים. PhantomJS ו-TrifleJS מיושנים, ו-HtmlUnit מתאים בעיקר לסביבות Java עם עמודים פשוטים. לפרויקטים חדשים, עדיף להישאר עם כלים מודרניים ומתוחזקים באופן פעיל.
אם אתם מוכנים לראות איך נראה scraping מודרני מבוסס AI, תנסו את Thunderbit. ולמאמרים מעמיקים נוספים על אוטומציית אינטרנט, בקרו ב-Thunderbit Blog. בהצלחה ב-scraping—שהנתונים שלכם תמיד יהיו טריים והדפדפנים שלכם תמיד יהיו headless.
נסו את Thunderbit AI Web Scraper עוד היום Get Started Free
לקריאה נוספת



