
בשבוע שעבר קולגה שלח לי חוזה ספקים בן 47 עמודים וביקש ממני “פשוט לשלוף את טבלאות התמחור לגיליון”. הסתכלתי על ה‑PDF בערך שלוש שניות, סגרתי אותו, ופתחתי במקומו PDF scraper. האינסטינקט הזה לא נבע מעצלנות — אלא משנים של צפייה באנשים מבזבזים אחר צהריים שלם במאבק להוציא נתונים מקבצים שלא נועדו לוותר עליהם בקלות.
המספרים בהחלט מצדיקים את התסכול. בסקר של Airbase לשנת 2024 בקרב 745 אנשי כספים, נמצא כי 38% מהצוותים מקדישים יותר מרבע מכלל זמנם למשימות ידניות. דוח האוטומציה של SAP Concur ל‑AP מוסיף כי 60% מהזנת החשבוניות למערכות ERP או הנהלת חשבונות עדיין מתבצעת ידנית.
קובצי PDF נמצאים בכל מקום — חשבוניות, חוזים, דוחות כספיים, קבלות סרוקות — אבל בפועל, הרבה מהעבודה עדיין נעשית ב‑copy-paste. ב‑2026, סקרייפרי PDF נעים מטבלאות Python חינמיות ועד כלים ללא קוד מבוססי AI, ובחירה לא נכונה עלולה לעלות לכם ימים של עבודה במקום לחסוך אותם. בדקתי 12 מסקרייפרי ה‑PDF הטובים ביותר, לפי חילוץ טבלאות, OCR, תמחור וקלות שימוש, כדי שתוכלו למצוא את ההתאמה הנכונה בתוך דקות.
מהו סקרייפר PDF ולמה זה בכלל חשוב?
סקרייפר PDF הוא תוכנה שמחלצת אוטומטית טקסט, טבלאות, שדות ונתונים מובנים מקובצי PDF. אם אי פעם ניסיתם להעתיק טבלה מ‑PDF ל‑Excel וראיתם את העמודות מתפרקות לשורה אחת מבולגנת, כבר הבנתם את הבעיה.
סקרייפרי PDF וסקרייפרי אינטרנט מתבלבלים לא פעם, אז שווה לעשות הבחנה קצרה. סקרייפר אינטרנט קורא HTML, שיש בו לפחות קצת מבנה — כותרות, טבלאות, divs. סקרייפר PDF מתחיל מפורמט שמטרתו לשמור על המראה הוויזואלי של הדף. גם התיעוד של Adobe מבהיר זאת: PDF נבנה כדי לשמר את מראה הדף באופן עקבי בין מכשירים, לא כדי לחשוף מבנה טבלאי או סמנטי נקי. לכן העתקה והדבקה שוברת שורות, עמודות וסדר קריאה.
איפה בעצם PDF scraping חוסך זמן?
- עיבוד חשבוניות: שליפת שמות ספקים, מזהי חשבונית, סכומים, מס ופריטי שורה
- דוחות כספיים: חילוץ טבלאות מדוחות שנתיים, מאזנים וגילויים
- רשומות סרוקות: שחזור פרטי קשר או נתוני עסקאות מקובצי PDF מבוססי תמונה
- העברת מערכות ישנות: המרת ארכיונים ישנים לרשומות מובנות וניתנות לחיפוש
ההשפעה העסקית רחבה הרבה יותר מזרימת עבודה אחת. Gartner עדיין מציגה איכות נתונים ירודה כגורם שמעלה לארגונים לפחות 12.9 מיליון דולר בשנה בממוצע. ובפברואר 2025 Gartner אמרה כי 63% מהארגונים או שאין להם, או שהם לא בטוחים שיש להם, את שיטות ניהול הנתונים הנכונות ל‑AI. עד 2026, Gartner אומרת שארגונים יוותרו על 60% מפרויקטי ה‑AI שלא נתמכים בנתונים מוכנים ל‑AI. אם PDFs עדיין הם המקום שבו חלק גדול מהנתונים הגולמיים חיים, איכות חילוץ המסמכים קשורה כיום ישירות למוכנות ל‑AI.
הסקר של Adobe לשנת 2025 בקרב אנשי כספים מצא כי 61% עורכים באופן קבוע מסמכים מבוססי PDF ו‑64% חותמים עליהם באופן קבוע. גם PDF Association מציינת כי PDF דורג כפורמט הקובץ ה‑3 בפופולריות שלו ברשת לפי נתוני CommonCrawl. PDFs לא הולכים לשום מקום.
איך הערכנו את סקרייפרי ה‑PDF הטובים ביותר
לפני שנצלול לכלים, הנה המסגרת שבה השתמשתי. שמונת הקריטריונים שלמטה ממפים ישירות לנקודות הכאב שאני רואה הכי הרבה בפורומים, בבעיות GitHub ובביקורות מוצרים:
| קריטריון | מה הוא מודד | למה זה חשוב למשתמשים |
|---|---|---|
| סוגי PDF נתמכים | טקסט מקורי, סרוק/מבוסס תמונה, משולב | הרבה כלים נכשלים עוד לפני שהחילוץ בכלל מתחיל |
| דיוק חילוץ טבלאות | טבלאות פשוטות, ללא גבולות, מרובות עמודים, עם תאים ממוזגים | התלונה מספר 1 על חילוץ מ‑PDF |
| יכולת OCR | מובנה, כתוסף או ללא כלל | קובצי PDF סרוקים חסרי שימוש בלי OCR |
| פורמטי פלט/ייצוא | Excel, CSV, JSON, Sheets, Notion, APIs | נתונים לא שווים הרבה אם אי אפשר להוציא אותם מהכלי בצורה נקייה |
| רמת קושי בהקמה | ללא קוד, קוד נמוך, או מבוסס קוד | צוותים צריכים רמות שליטה שונות מאוד |
| תמחור / שכבה חינמית | מחיר ציבורי, ניסיון, נקודת כניסה מציאותית | מודלי החיוב משתנים מאוד מכלי לכלי |
| אוטומציה / אינטגרציות | Zapier, API, תזמון, webhooks | ייצוא ידני לא מתרחב טוב |
| שימוש מומלץ | במה הכלי באמת טוב | רוב הכלים לא מצטיינים בכל דבר — הם מותאמים לזרימת עבודה מסוימת |
כדי לשמור על קריאות, 12 הכלים מתחלקים לשלוש קטגוריות: סקרייפרי AI ללא קוד, מפרסי מסמכים מבוססי תבניות או SaaS, וספריות/APIs/כלי קוד פתוח למפתחים.
12 סקרייפרי ה‑PDF הטובים ביותר במבט אחד
הנה ההשוואה המרכזית, כדי שתוכלו לסרוק לפי הפרופיל שלכם ולקפוץ ישר למקטע המתאים:
| כלי | סוג | חילוץ טבלאות | OCR מובנה | ללא קוד | שכבה חינמית | מתאים במיוחד ל |
|---|---|---|---|---|---|---|
| Thunderbit | סקרייפר AI ללא קוד | ✅ מונע AI | ✅ כן | ✅ כן | ✅ קרדיטים חינמיים | משתמשים עסקיים, פריסות מגוונות |
| Tabula | תוכנת שולחן עבודה בקוד פתוח | ✅ טוב (קובצי PDF מבוססי טקסט) | ❌ לא | ✅ ממשק גרפי | ✅ חינמי לגמרי | קובצי PDF פשוטים עם הרבה טבלאות |
| Parseur | SaaS היברידי | ⚠️ תבניות + AI | ✅ כן | ✅ כן | ⚠️ מוגבל | עיבוד חוזר של חשבוניות/מיילים |
| Nanonets | פלטפורמת IDP מבוססת AI | ✅ חזק | ✅ כן | ✅ קוד נמוך | ⚠️ ניסיון בקרדיטים | אוטומציה של מסמכים בנפח גבוה |
| Adobe Acrobat | חבילת פרודוקטיביות ל‑PDF | ⚠️ בסיסי | ✅ כן | ✅ כן | ❌ הייצוא בתשלום | המרה מזדמנת מ‑PDF ל‑Excel |
| PyMuPDF | ספריית Python | ⚠️ ניתוח ידני | ❌ לא (Tesseract כאופציה) | ❌ נדרש קוד | ✅ חינמי לגמרי | מפתחים, קובצי PDF עתירי טקסט |
| Camelot | ספריית טבלאות ב‑Python | ✅ חזק (lattice + stream) | ❌ לא | ❌ נדרש קוד | ✅ חינמי לגמרי | מפתחים, טבלאות מורכבות |
| Docparser | SaaS מבוסס תבניות | ⚠️ מבוסס תבניות | ✅ כן | ✅ כן | ⚠️ ניסיון | מסמכים חוזרים + workflows ב‑Zapier |
| pdfplumber | ספריית Python | ✅ טוב (גרנולרי) | ❌ לא | ❌ נדרש קוד | ✅ חינמי לגמרי | מפתחים, שליטה מדויקת |
| AWS Textract | API בענן | ✅ חזק | ✅ כן | ❌ נדרש API | ⚠️ שכבה חינמית מוגבלת | תהליכי עבודה ברמת Enterprise |
| Docling | Python בקוד פתוח | ✅ טוב | ✅ באמצעות אינטגרציה | ❌ נדרש קוד | ✅ חינמי לגמרי | צינורות LLM/RAG |
| Parsio | SaaS היברידי | ⚠️ בסיוע AI | ✅ כן | ✅ כן | ⚠️ מוגבל | סוגי מסמכים חוזרים |
רוצים אפס התקנה? התחילו בשורות של ללא קוד או SaaS. צריכים שליטה מקסימלית? התחילו בשורות של מפתחים. עובדים עם PDF סרוקים? אפשר לפסול כל שורה שבה OCR = No.
1. Thunderbit
 Thunderbit הוא סקרייפר ה‑PDF שהייתי נותן לכל מי שאומר “אני רק צריך להוציא את הנתונים מה‑PDF הזה” ולא רוצה לשמוע על Python, תבניות או מפתחות API. זהו סוכן נתונים מבוסס AI לאינטרנט — תוסף Chrome — שקורא PDFs, תמונות ואתרי אינטרנט, ואז מוציא נתונים מובנים. בלי תבניות, בלי קוד.
בנינו את Thunderbit כדי להתמודד עם התרחיש שמכשיל את רוב הכלים: אתם מקבלים PDFs מחמישה ספקים שונים, לכל אחד פריסה קצת אחרת, ואתם צריכים את אותם השדות מכולם. ה‑AI קורא כל מסמך מחדש, מציע שמות עמודות וסוגי נתונים דרך התכונה "AI Suggest Fields", ומחלץ את הנתונים לטבלה מסודרת. OCR מובנה מטפל באופן טבעי ב‑PDFs סרוקים ובתמונות, עם תמיכה ב‑34 שפות.
תכונות מרכזיות:
- One Click Extract מזהה עמודות וסוגי נתונים מכל פריסת PDF — בלי הגדרה ידנית
- OCR מובנה עבור PDF סרוקים ותמונות
- ייצוא ל‑Excel, Google Sheets, Airtable, Notion, CSV ו‑JSON — בחינם
- תיוג ועיצוב מחדש בעזרת AI: ה‑AI יכול לתרגם, לסווג או לבנות מחדש את הנתונים כבר בזמן החילוץ, לא רק אחריו
- חילוץ טבלאות קורא את הפריסה באופן ויזואלי (כמו אדם), ומתאים את עצמו לפורמטים ללא גבולות, לא סדירים ומרובי ספקים
איך מחלצים PDF עם Thunderbit:
- מתקינים את Thunderbit Chrome Extension
- פותחים או מעלים את ה‑PDF בדפדפן
- לוחצים על "One Click Extract" — ה‑AI קורא את המסמך ומזהה שמות עמודות וסוגים
- לוחצים על "Scrape" — הנתונים נשלפים לטבלה מובנית
- מייצאים ל‑Google Sheets, Excel, Airtable, Notion, CSV או JSON
תמחור: שכבה חינמית עם קרדיטים (בערך 6 עמודים בחינם, 10 עם ניסיון). תוכנית Starter בכ‑$15 לחודש או כ‑$9 לחודש בחיוב שנתי. הקרדיטים מבוססים על שורות (1 קרדיט = שורת פלט אחת). לפרטים ראו Thunderbit Pricing.
מתאים במיוחד ל: משתמשים לא טכניים שעובדים עם פריסות PDF מגוונות (חשבוניות ממספר ספקים, דוחות בפורמטים מעורבים) ורוצים תוצאות בלחיצה אחת.
יתרונות: ההקמה הקלה ביותר ברשימה; OCR מובנה; ייצוא ישיר ל‑Sheets, Notion, Airtable ו‑Excel; עובד על פריסות מגוונות בלי תבניות.
חסרונות: חיוב מבוסס קרדיטים דורש רגע כדי למפות לעלות לעמוד; פחות ביקורות מצד צד שלישי לעומת ספקי SaaS גדולים.
נסו את Thunderbit לחילוץ PDF העלו חשבוניות מחמישה ספקים שונים ותנו ל‑AI לזהות את העמודות של כל פריסה — בלי הגדרה לכל תבנית. Get Started Free
2. Tabula
 Tabula הוא הפתרון החינמי הקלאסי לחילוץ טבלאות מקובצי PDF מבוססי טקסט, והוא גם ברור כיום כפרויקט ותיק. במאגר כתוב שמדובר בפרויקט שמופעל על ידי מתנדבים, ויישום הדסקטופ ככל הנראה לא יקבל עדכונים בקרוב. גרסת הדסקטופ האחרונה עדיין 1.2.1 משנת 2018, בעוד ש‑tabula-java שחרר את 1.0.5 ב‑2021.
תכונות מרכזיות:
- ממשק גרפי של point-and-click לבחירת אזורי טבלאות
- רץ מקומית — הנתונים לא עוזבים את המחשב שלכם
- בלי חשבון, בלי מנוי, בלי הרשמה
תמחור: חינמי לחלוטין, לנצח. קוד פתוח.
מתאים במיוחד ל: משתמשים עם קובצי PDF פשוטים מבוססי טקסט, עם טבלאות ברורות ותחומות, שרוצים פתרון מקומי וחינמי.
יתרונות: חינמי; מקומי; פשוט מאוד לטבלאות בסיסיות.
חסרונות: ללא OCR (קובצי PDF סרוקים הם לא אופציה); חלש בטבלאות ללא גבולות; אין אוטומציה או API; אין אפשרות ענן; למעשה לא מתוחזק.
3. Parseur
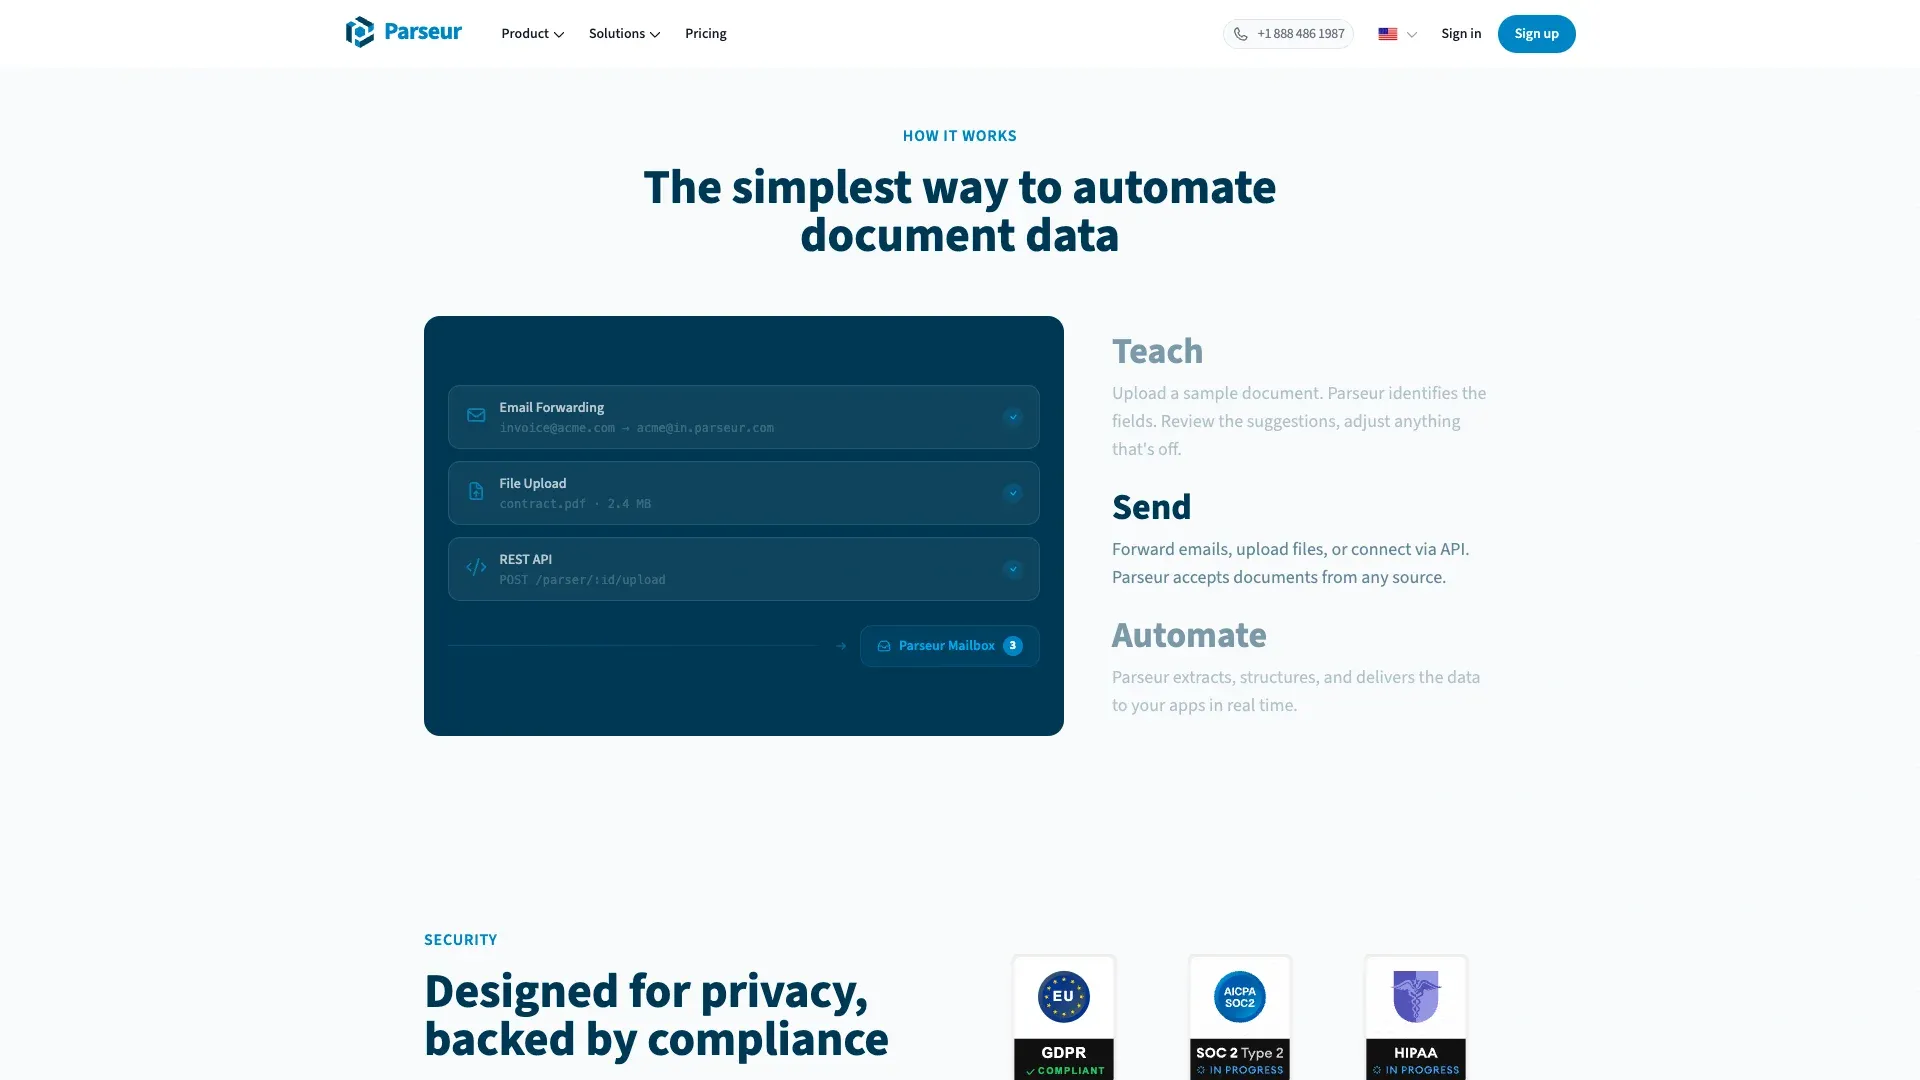 Parseur הוא ההיבריד החזק ביותר בקבוצת ה‑SaaS, כי הוא משלב parsing מבוסס AI, parsing מבוסס תבניות, ו‑dynamic OCR. זה הופך אותו לגמיש יותר מ‑parser אזורי טהור, אבל עדיין מובנה יותר מסקרייפר AI כללי לחלוטין.
תכונות מרכזיות:
- OCR מובנה עם תמיכה ב‑60+ שפות (ו‑160+ ניסיוניות)
- אינטגרציות עם Zapier, Make, Power Automate, API, webhooks, Google Sheets
- מתאים במיוחד לחשבוניות, הודעות משלוח, אישורי הזמנה וסוגי מסמכים חוזרים
תמחור: שכבה חינמית של כ‑20 עמודים בחודש. המחיר הנמוך ביותר לשירות עצמי הוא סביב ~$39 לחודש. העלות המנורמלת בתוכנית הקטנה ביותר היא בערך $390 לכל 1,000 עמודים, אם כי התעריפים בפועל יורדים בנפח גבוה יותר.
מתאים במיוחד ל: צוותים שמקבלים שוב ושוב את אותם סוגי מסמכים ורוצים אוטומציה בלי קוד.
יתרונות: OCR מובנה; סט אוטומציה חזק; מטפל היטב בפריסות חוזרות.
חסרונות: כל פריסה חדשה או כזו שמשתנה לאורך זמן עשויה לדרוש עבודה על תבנית או מעבר ל‑AI; מבני טבלאות מורכבים עדיין מאתגרים יותר.
4. Nanonets
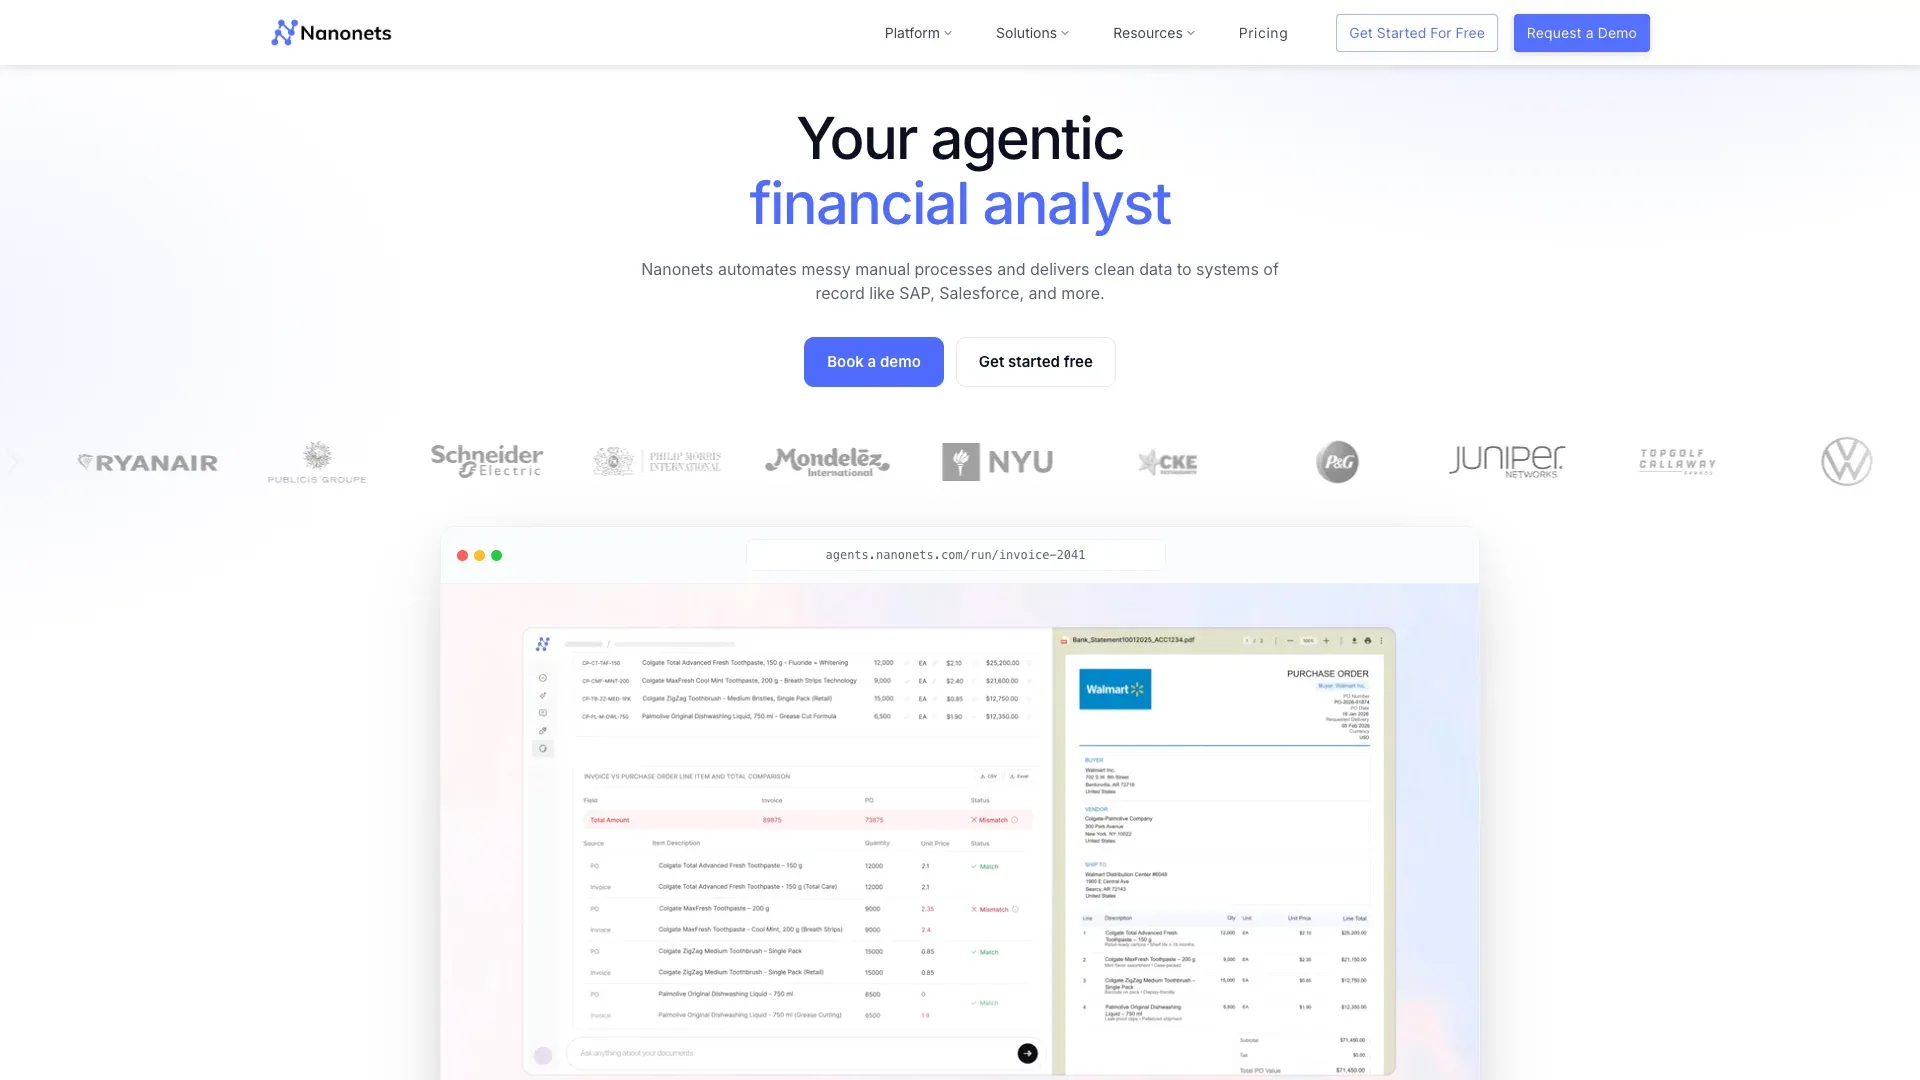 Nanonets קרובה יותר לפלטפורמת Intelligent Document Processing (IDP) מאשר לסקרייפר PDF פשוט — וזה גם היתרון שלה וגם מקור המורכבות. החברה שינתה את התמחור ב‑31 בינואר 2025, ועברה לקרדיטים בתשלום מראש במקום תוכנית פשוטה לפי עמוד.
תכונות מרכזיות:
- חילוץ טבלאות וזיהוי שדות מבוססי AI
- OCR מובנה עם תמיכה ב‑40+ שפות
- אוטומציית workflows עם שלבי אישור
- סט אינטגרציות רחב ברמת Enterprise
תמחור: קרדיטים בעת ההרשמה. חיוב לפי שימוש. הערכה גסה על בסיס מסמכי תמחור ציבוריים של בלוקים היא סביב $300–$380 לכל 1,000 עמודים בתהליך חילוץ פשוט.
מתאים במיוחד ל: צוותים בינוניים עד גדולים שמעבדים אלפי מסמכים בחודש (אוטומציה ל‑AP, לוגיסטיקה, תביעות ביטוח).
יתרונות: חילוץ AI חזק; אינטגרציות Enterprise; אוטומציית workflows.
חסרונות: קשה יותר לחזות את המחיר; עקומת למידה ל‑workflows מתקדמים; שכבה חינמית מוגבלת.
5. Adobe Acrobat
 Adobe Acrobat הוא כלי ה‑PDF הבסיסי שכמעט כולם מזהים. הוא חזק ב‑OCR ובהמרה, אבל הוא לא באמת סקרייפר באותו מובן כמו שאר הכלים ברשימה.
תכונות מרכזיות:
- OCR מובנה ב‑Pro
- ייצוא ל‑Word, Excel, PowerPoint, HTML, TXT ופורמטי תמונה
- תמיכה רחבה ב‑OCR רב‑לשוני
תמחור: Acrobat Standard ב‑$14.99 לחודש; Acrobat Pro ב‑$19.99 לחודש. Reader בחינם, אבל תכונות הייצוא דורשות תוכנית בתשלום.
מתאים במיוחד ל: משתמשים שלפעמים צריכים להמיר PDF ל‑Word או Excel וכבר יש להם מנוי Adobe.
יתרונות: אמין ומוכר; OCR מובנה; להרבה משתמשים כבר יש אותו.
חסרונות: חילוץ טבלאות בסיסי בפריסות מורכבות; אין אוטומציה או API לעיבוד באצווה; לא נבנה כ“סקרייפר”.
6. PyMuPDF
 PyMuPDF (מוכר גם כ‑"fitz") נותרה ספריית חילוץ ה‑PDF הכללית המהירה ביותר ב‑Python בסקירה הזו. הגרסה הנוכחית היא 1.27.2.2 ממרץ 2026, ו‑benchmarks ממשיכים להראות שהיא מהירה משמעותית מהרבה ספריות PDF אחרות ב‑Python.
תכונות מרכזיות:
- חילוץ טקסט גולמי במהירות גבוהה מאוד
- חילוץ תמונות וגישה למטה‑דאטה
- OCR אופציונלי דרך Tesseract (אם כי התיעוד מציין ש‑OCR איטי בערך פי 1,000 מחילוץ רגיל)
- זיהוי טבלאות דרך
find_tables()
תמחור: חינמי לחלוטין, קוד פתוח.
מתאים במיוחד ל: מפתחים שבונים pipelines ועובדים בעיקר עם קובצי PDF מקוריים עתירי טקסט.
יתרונות: מהיר מאוד; קל משקל; קהילה פעילה; חילוץ טקסט חזק.
חסרונות: אין OCR מובנה; חילוץ טבלאות דורש לוגיקת parsing ידנית; נדרש קוד.
7. Camelot
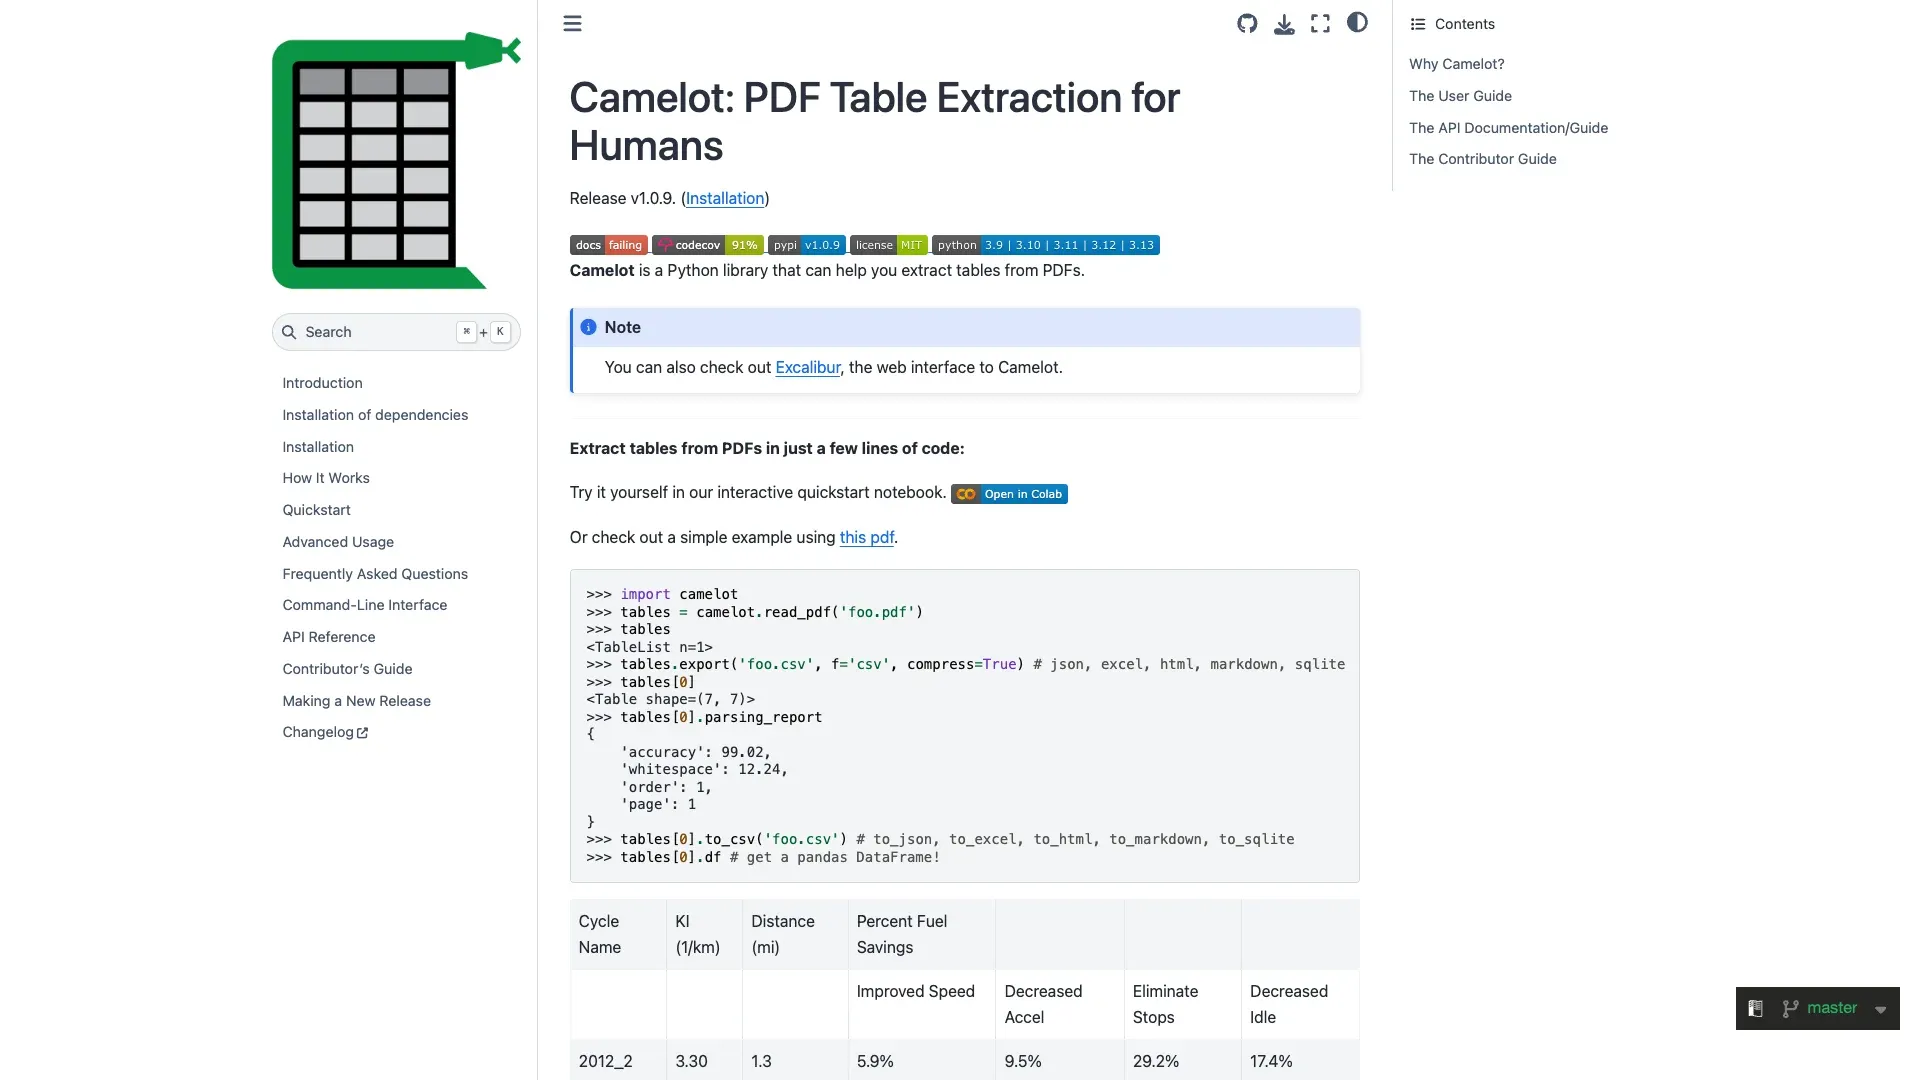 Camelot עדיין אחד מכלי חילוץ הטבלאות המוכרים ביותר ב‑Python, כי הוא קודם כול כלי לטבלאות ולא כלי כללי למסמכים. המאגר הנוכחי מתוחזק, עם v1.0.9 שפורסמה באוגוסט 2025.
תכונות מרכזיות:
- שני מצבי חילוץ:
latticeלטבלאות עם גבולות,streamלטבלאות ללא גבולות/מבוססות מרווחים - מדדי דיוק ב‑Parsing Report — אחת התכונות השימושיות ביותר של Camelot ל‑automation workflows
- ייצוא ל‑pandas DataFrames, CSV, JSON, Excel
תמחור: חינמי לחלוטין, קוד פתוח.
מתאים במיוחד ל: מפתחים שצריכים חילוץ מדויק של טבלאות מקובצי PDF מובנים מבוססי טקסט.
יתרונות: דיוק מצוין בטבלאות; שני מצבי חילוץ; ניקוד דיוק.
חסרונות: ללא OCR; רק קובצי PDF מבוססי טקסט; נדרש קוד; עלול להיות איטי במסמכים גדולים.
8. Docparser
 Docparser הוא כלי ה‑SaaS הכי מונחה כללים ברשימה. הוא משתמש ב‑OCR אזורי, מילות עוגן וכללי parsing לפריסה קבועה, במקום לנסות להתנהג כמו קורא AI כללי של פריסות.
תכונות מרכזיות:
- OCR מובנה
- אינטגרציות עם Zapier, Workato, Power Automate, Google Sheets, Salesforce ו‑REST API
- טוב להזרמת נתונים שחולצו ל‑business workflows
תמחור: Starter ב‑$39 לחודש; Professional ב‑$74 לחודש; Business ב‑$159 לחודש. ניסיון חינם ל‑14 יום. החיוב הוא לפי מסמך, כך שהעלות המנורמלת לכל 1,000 עמודים תלויה באורך המסמך — בערך $78–$390 ברמת Starter.
מתאים במיוחד ל: צוותים שצריכים לאוטומט זרימות מסמכים חוזרות עם אינטגרציה הדוקה לכלים כמו Zapier או Salesforce.
יתרונות: OCR מובנה; אינטגרציות חזקות ל‑workflow; טוב לפריסות יציבות.
חסרונות: מבוסס תבניות — כל פריסה חדשה דורשת הגדרה; חילוץ טבלאות תלוי בהגדרות אזור; חזק במיוחד בעמוד 1.
9. pdfplumber
 pdfplumber נותרת ספריית המפתחים הכי גרנולרית ברשימה. הגרסה הנוכחית היא 0.11.9 מינואר 2026, והמאגר מציין שהוא בפיתוח פעיל.
תכונות מרכזיות:
- שליטה מדויקת על אובייקטי תווים, קווים, מלבנים ואסטרטגיות איתור טבלאות
- סינון מבוסס חיתוך ו‑debug ויזואלי
- הפקת הנתונים כרשימות/מילונים של Python למניפולציה נוחה
תמחור: חינמי לחלוטין, קוד פתוח.
מתאים במיוחד ל: מפתחי Python שצריכים לוגיקת חילוץ טבלאות מדויקת וניתנת להתאמה אישית.
יתרונות: שליטה ברמה נמוכה מעולה; דיוק טוב בטבלאות מורכבות; פיתוח פעיל.
חסרונות: ללא OCR; עקומת למידה תלולה יותר מ‑Camelot; נדרש קוד.
10. AWS Textract
 AWS Textract הוא ה‑API הכי “ארגוני” ברשימה. הוא נבנה לסקייל, למגוון מסמכים ולשימוש תכנותי — לא לנוחות של ממשק גרפי.
תכונות מרכזיות:
- חילוץ טבלאות וטפסים מבוסס AI
- OCR מובנה עם תמיכה בכתב יד (הכי קרוב ברשימה, אבל עדיין לא מושלם)
- סקלאביליות ברמת Enterprise
- אינטגרציה נקייה עם מערכת AWS
תמחור: חיוב לפי עמוד. שכבה חינמית: 1,000 עמודים בחודש למשך 3 חודשים. לאחר מכן: OCR טקסט בלבד ב‑$1.50 ל‑1,000 עמודים; טבלאות ב‑$15 ל‑1,000 עמודים; טפסים + טבלאות ב‑$65 ל‑1,000 עמודים; מסמכי הוצאות ב‑$10 ל‑1,000 עמודים.
מתאים במיוחד ל: צוותי Enterprise שמעבדים 10,000+ מסמכים בחודש דרך API pipeline.
יתרונות: חילוץ מדויק של טפסים וטבלאות; OCR מובנה; סקלאביליות ארגונית.
חסרונות: API בלבד; בלי ממשק ויזואלי; העלות עולה מהר במצבים מתקדמים; תלות במערכת AWS.
11. Docling
 Docling הוא הכלי בקוד פתוח שהכי מסתכל קדימה כאן, כי הוא מיועד ישירות לצינורות ממסמך ל‑LLM. הגרסה הנוכחית היא 2.90.0 מ‑17 באפריל 2026, והפרויקט מתקדם במהירות.
תכונות מרכזיות:
- פלט ל‑Markdown, HTML, WebVTT, DocTags ו‑JSON ללא אובדן מידע
- תמיכה ב‑OCR דרך כמה מנועים משולבים
- נבנה עבור LangChain, LlamaIndex, CrewAI, Haystack ואקוסיסטמות דומות
- צמיחה חזקה של הקהילה
תמחור: חינמי לחלוטין, קוד פתוח.
מתאים במיוחד ל: מפתחים שבונים אפליקציות LLM/RAG וצריכים להמיר PDFs ל‑Markdown מובנה ומוכן ל‑AI.
יתרונות: פלט Markdown נקי; OCR באמצעות אינטגרציה; בנוי לזרימות AI מודרניות; פיתוח פעיל.
חסרונות: נדרש קוד; מיועד בעיקר למפתחים; פחות מלוטש מבחינת ממשק או אפשרויות ייצוא לעומת כלי SaaS.
12. Parsio
 Parsio הוא parser SaaS היברידי שמשלב תבניות, OCR, AI parsing ו‑parsing מונע GPT. מבחינת רוח, הוא יושב בין Parseur ל‑Docparser: גמיש יותר מאזורים טהורים, אך עדיין מותאם לקליטה חוזרת של מסמכים.
תכונות מרכזיות:
- OCR מובנה
- זיהוי שדות בסיוע AI
- אינטגרציות עם Google Sheets, webhooks, API, Zapier, Make, n8n, Pabbly
תמחור: Sandbox עם 30 קרדיטים. Starter ב‑$41 לחודש עבור 1,000 קרדיטים; Growth ב‑$124 לחודש; Business ב‑$249 לחודש. מסמך או עמוד PDF אחד יכולים לעלות 1, 2 או 5 קרדיטים, תלוי במצב ה‑parser, כך שההערכה המנורמלת בתוכנית Starter היא בערך $41–$205 לכל 1,000 עמודים.
מתאים במיוחד ל: צוותים קטנים עד בינוניים שמעבדים סוגי מסמכים חוזרים (חשבוניות, קבלות) ורוצים פתרון SaaS ללא קוד עם מעט AI.
יתרונות: OCR מובנה; כיסוי רחב לסוגי מסמכים; סט אוטומציה רחב.
חסרונות: עומק הביקורות מצד צד שלישי דל; התמחור פחות שקוף בין מצבי parser שונים; לא מובחן כמו Parseur או Nanonets.
קרב חילוץ הטבלאות: איך סקרייפרי PDF מובילים מטפלים בטבלאות מהעולם האמיתי
חילוץ טבלאות הוא נקודת הכאב המדוברת ביותר בקרב משתמשי PDF scraper — ובצדק. Benchmarks עדכניים כמו OmniDocBench (1,651 עמודים על פני 10 סוגי מסמכים) ועבודה אקדמית על חילוץ טבלאות הטרוגניות מאשרים ש“חילוץ טבלאות” הוא לא משימה אחת אחידה. מדובר בספקטרום.
טבלאות פשוטות (גבולות ברורים, עמוד אחד)
רוב הכלים מטפלים בכך היטב. Tabula, Camelot, pdfplumber, Thunderbit ו‑AWS Textract מצליחים כאן. אם ה‑PDF שלכם כולל רק טבלאות פשוטות עם גבולות, כמעט כל כלי ברשימה יעבוד.
טבלאות ללא גבולות ועם רווחים לבנים
כאן ההבדל מתחיל להיות ברור. בלי קווי הפרדה, parsers מבוססי חוקים מתקשים לזהות גבולות עמודות. מצב stream של Camelot והכוונון המותאם אישית של pdfplumber חזקים עבור מפתחים שיכולים לדייק הגדרות. כלים מונעי AI כמו Thunderbit, Nanonets ו‑AWS Textract מפרשים את הפריסה בצורה ויזואלית, וזה נוטה לעבוד טוב יותר למשתמשים לא טכניים שמתמודדים עם פורמטים לא עקביים.
טבלאות הפרוסות על פני כמה עמודים
מקרה כשל נפוץ. כלי תבניות וחילוץ פשוטים לעיתים קרובות מתייחסים לכל עמוד כטבלה נפרדת, אלא אם כן ה‑workflow מחבר אותם מחדש במפורש. לכלים מבוססי AI יש יתרון כאן, כי הם יכולים לפרש רציפות באופן סמנטי ולא רק גיאומטרי — אף ספק לא צריך להיחשב מושלם בקטגוריה הזו.
תאים ממוזגים וכותרות מקוננות
זה התרחיש הקשה ביותר. מאמר EMNLP מ‑2024 על חילוץ מידע מטבלאות הטרוגניות מדווח על טווחי F1 בין 74.2 ל‑96.1, תלוי בשיטה ובתרחיש. כלים מונעי AI (Thunderbit, Nanonets, AWS Textract) נוטים להקדים כאן parsers מבוססי חוקים, משום שהם מפרשים את הפריסה סמנטית ולא מסתמכים רק על קווי גבול.
השוואת OCR: אילו סקרייפרי PDF מטפלים במסמכים סרוקים?
OCR הוא קו ההפרדה בין כלים שיכולים להתמודד עם PDFs עסקיים אמיתיים לבין כלים שמטפלים רק במסמכים אידיאליים שנוצרו במכונה. הנה המטריצה:
| כלי | OCR מקורי | תמיכה ב‑PDF סרוק | OCR רב‑לשוני | תמיכה בכתב יד |
|---|---|---|---|---|
| Thunderbit | ✅ מובנה | ✅ כן | ✅ 34 שפות | ⚠️ מוגבל |
| Adobe Acrobat | ✅ מובנה | ✅ כן | ✅ חזק | ⚠️ מוגבל |
| AWS Textract | ✅ מובנה | ✅ כן | ✅ כמה שפות מרכזיות | ✅ הכי קרוב, אך לא מושלם |
| Nanonets | ✅ מובנה | ✅ כן | ✅ 40+ שפות | ⚠️ מוגבל |
| Parseur | ✅ מובנה | ✅ כן | ✅ 60+ שפות | ❌ לא |
| Parsio | ✅ מובנה | ✅ כן | ✅ רב‑לשוני | ⚠️ מוגבל |
| Docparser | ✅ מובנה | ✅ כן | ✅ כן | ⚠️ מוגבל |
| Docling | ✅ באמצעות אינטגרציה | ✅ כן | תלוי במנוע | ⚠️ מוגבל |
| Tabula | ❌ אין | ❌ לא | לא רלוונטי | לא רלוונטי |
| PyMuPDF | ❌ לא (Tesseract כאופציה) | ❌ דורש תוסף | תלוי במנוע | תלוי במנוע |
| Camelot | ❌ אין | ❌ לא | לא רלוונטי | לא רלוונטי |
| pdfplumber | ❌ אין | ❌ לא | לא רלוונטי | לא רלוונטי |
אף כלי לא מטפל באופן אמין בכתב יד בכל המקרים ב‑2026. AWS Textract הוא ה‑API הארגוני הקרוב ביותר, אבל כתב יד עדיין נחשב לתכונה של “להשתמש בזה בזהירות”. אם ה‑PDFs שלכם סרוקים אבל מודפסים, כל כלי עם OCR מובנה ישרת אתכם היטב. אם הם בכתב יד, חשוב להציב ציפיות ריאליות.
מבוסס AI מול מבוסס חוקים מול מבוסס תבניות: שלושה דורות של PDF scraping
הדרך הקלה ביותר להבין את שוק סקרייפרי ה‑PDF ב‑2026 היא לחלק אותו לשלושה דורות:
דור 1: מבוסס חוקים (Tabula, Camelot, pdfplumber)
אלה עובדים הכי טוב על PDFs מובנים, מבוססי טקסט, עם פריסות עקביות. הם חזקים בידיים של מפתחים, אבל נשברים בקלות כשהפריסות משתנות. אם המסמכים שלכם צפויים, הם עדיין מצוינים — וגם בחינם.
דור 2: מבוסס תבניות (Parseur, Docparser, Parsio)
המשתמשים מגדירים אזורים או שדות לכל סוג מסמך. מעולה לפורמטים חוזרים כמו חשבוניות מאותו ספק. הבעיה: כל פריסה חדשה או שינוי בפריסה דורשים הגדרה או תחזוקה.
דור 3: מבוסס AI/LLM (Thunderbit, Nanonets, AWS Textract, Docling לצינורות LLM)
ה‑AI קורא את המסמך באופן סמנטי, מסתגל לפריסות חדשות בלי תבניות, ויכול גם לתייג וגם לשנות את הנתונים בו‑זמנית. לשם השוק הולך. גם הערכת ה‑IDP של Everest Group לשנת 2025 וגם מחקר הטבלאות הרב‑מודאליות של ACL 2025 מצביעים על חילוץ מבוסס LLM ו‑agents כסטנדרט הבא.
עבור משתמשים לא טכניים, זה חשוב מאוד בפועל: אם ה‑PDFs שלכם מגיעים מהרבה מקורות שונים (ספקים, שותפים, לקוחות), כלים מבוססי תבניות הופכים לנטל תחזוקה. כלים מבוססי AI מתמודדים עם מגוון כבר מהקופסה. זה בדיוק המקום ש‑Thunderbit נבנתה עבורו — משתמשים עסקיים עם PDFs מגוונים ואפס עניין בכתיבת Python או בתחזוקת תבניות חילוץ.
חילוץ PDF מבוסס AI לפריסות מגוונות לא חייבים schema אחד שיתאים לכל ספק — ה‑AI קורא כל מסמך ומזהה את המבנה שלו בעצמו. Get Started Free
פירוט תמחור: כמה באמת עולים סקרייפרי ה‑PDF הטובים ביותר
זה ההשוואה שאף אחד אחר לא מפרסם, וזו גם השאלה שמשתמשים שואלים הכי הרבה. הנה התמונה הכנה:
| כלי | שכבה חינמית | מחיר התחלתי בתשלום | עלות משוערת ל‑1,000 עמודים | קוד פתוח? |
|---|---|---|---|---|
| Thunderbit | ✅ קרדיטים חינמיים | ~$15 לחודש ($9 לחודש בחיוב שנתי) | ~$18–$30 | לא |
| Tabula | ✅ ללא הגבלה | חינמי לנצח | $0 | כן |
| Camelot | ✅ ללא הגבלה | חינמי לנצח | $0 | כן |
| PyMuPDF | ✅ ללא הגבלה | חינמי לנצח | $0 | כן |
| pdfplumber | ✅ ללא הגבלה | חינמי לנצח | $0 | כן |
| Docling | ✅ ללא הגבלה | חינמי לנצח | $0 | כן |
| Parseur | ⚠️ ~20 עמודים לחודש | ~$39 לחודש | ~$390 (ברמה הנמוכה ביותר) | לא |
| Nanonets | ⚠️ קרדיטים בהרשמה | לפי שימוש | ~$300–$380 | לא |
| Docparser | ⚠️ ניסיון ל‑14 יום | $39 לחודש | ~$78–$390 | לא |
| Parsio | ⚠️ 30 קרדיטים | $41 לחודש | ~$41–$205 | לא |
| Adobe Acrobat | ❌ (הייצוא בתשלום) | $19.99 לחודש Pro | לא לפי עמוד | לא |
| AWS Textract | ⚠️ 1,000 עמודים/חודש (3 חודשים) | תשלום לפי שימוש | $1.50–$65 | לא |
הפער בין מחיר רשמי לעלות נסתרת חשוב יותר מהמחיר המודפס. כלים חינמיים בקוד פתוח עולים אפס דולרים, אבל דורשים זמן של מפתחים להגדרה, תחזוקה וניפוי תקלות. כלי SaaS מבוססי תבניות הם פשוטים כשיש מעט וריאציה, אבל יקרים כשהפריסות משתנות. כלי AI ללא קוד כמו Thunderbit עולים קרדיטים לפי שורה, אבל חוסכים הרבה זמן הקמה. APIs בענן כמו AWS Textract הם הזולים ביותר בקנה מידה גדול — אבל רק כשכבר יש לכם תשתית הנדסית.
כשאני חושב על “העלות האמיתית”, אני כולל גם את השכר של מי שעושה את העבודה. שעה מזמן של אנליסט נתונים שמושקעת בהגדרת תבניות או בכתיבת Python היא לא חינם, גם אם התוכנה עצמה כן.
איזה סקרייפר PDF כדאי לבחור?
הנה מדריך החלטה מהיר:
| המצב שלכם | הכלי/ים המומלצים |
|---|---|
| לא טכניים, פריסות PDF מגוונות, רוצים תוצאות מהר | Thunderbit, Nanonets |
| חשבוניות/קבלות חוזרות מאותו פורמט | Parseur, Docparser, Parsio |
| מפתחים שבונים צינור נתונים | PyMuPDF, Camelot, pdfplumber |
| Enterprise, 10,000+ מסמכים בחודש, צריך API | AWS Textract, Nanonets |
| בניית אפליקציית LLM/RAG | Docling |
| המרה מזדמנת מ‑PDF ל‑Excel, כבר יש לכם Adobe | Adobe Acrobat |
| חינמי, מקומי, ממוקד טבלאות, בלי קוד | Tabula |
אם אתם משתמשים עסקיים שרק רוצים להוציא נתונים מ‑PDFs בלי לכתוב קוד או להקים תבניות, התחילו עם Thunderbit. הוא קורא כל PDF מחדש בעזרת AI ומייצא לכלים שכבר עובדים איתם. אם המסמכים שלכם חוזרים על עצמם בפריסות מוכרות, Parseur או Docparser יתאימו יותר. ואם אתם רוצים שליטה הנדסית, סט הכלים בקוד פתוח עדיין מייצג את רצפת העלות.
לסיכום
PDF scraping ב‑2026 כבר לא בעיה אחת עם תשובה אחת. הכלי הנכון תלוי אם אתם מפתחים, אנליסטים עסקיים או צוות Enterprise — ואם ה‑PDFs שלכם הם קבצי טקסט מסודרים או תמונות סרוקות כאוטיות מעשרות ספקים.
אם אתם רוצים לראות איך נראה חילוץ PDF מבוסס AI בפועל, נסו את השכבה החינמית של Thunderbit. אני חושב שתופתעו מכמה אפשר לחלץ מ‑PDF בכמה קליקים בלבד. ואם Thunderbit לא מושלם עבורכם, נסו עוד כמה מהכלים ברשימה הזו. מעולם לא היה זמן טוב יותר להפסיק להעתיק ולהדביק מ‑PDFs ולהתחיל באמת להשתמש בנתונים שבתוכם.
לעוד תוכן על חילוץ נתונים ואוטומציה, עיינו במדריכים שלנו על חילוץ נתונים מאתרים ל‑Excel, כלי חילוץ הנתונים הטובים ביותר, חילוץ נתונים בעזרת AI לעסקים, ו-איך להמיר תמונות ל‑Excel. אפשר גם לצפות בהדרכות צעד‑אחר‑צעד ב‑ערוץ YouTube של Thunderbit.
נסו את Thunderbit בחינם טבלאות, OCR ודוחות בפורמטים מעורבים — הכול במעבר אחד. התוכנית החינמית מספיקה כדי לבדוק אם זה עובד על המסמכים שלכם. Get Started Free
שאלות נפוצות
1. מהו סקרייפר ה‑PDF החינמי הטוב ביותר?
עבור מי שאינם מפתחים, Tabula הוא כלי ה‑GUI החינמי והפשוט ביותר לטבלאות PDF מבוססות טקסט. עבור מפתחים, Camelot, pdfplumber, PyMuPDF ו‑Docling הם כולם בחירות חינמיות חזקות. כאופציה ללא קוד עם שכבה חינמית, Thunderbit הוא נקודת פתיחה מצוינת.
2. האם סקרייפרי PDF יכולים להתמודד עם מסמכים סרוקים?
רק כלים עם OCR מובנה יכולים לטפל ישירות ב‑PDFs סרוקים. זה כולל את Thunderbit, Adobe Acrobat, AWS Textract, Nanonets, Parseur, Docparser, Parsio ו‑Docling (עם מנועי OCR משולבים). Tabula, Camelot ו‑pdfplumber לא יכולים להתמודד עם PDFs סרוקים בכוחות עצמם — הם צריכים OCR חיצוני כמו Tesseract.
3. עד כמה מדויק חילוץ טבלאות מ‑PDF?
זה תלוי מאוד במורכבות הטבלה. רוב הכלים מטפלים היטב בטבלאות פשוטות עם גבולות. טבלאות ללא גבולות, תאים ממוזגים וטבלאות מרובות עמודים קשות הרבה יותר. כלים מונעי AI כמו Thunderbit, Nanonets ו‑AWS Textract נוטים להקדים parsers מבוססי חוקים בפריסות מגוונות, בעוד שכלים מבוססי חוקים עדיין יכולים להיות מצוינים על PDFs יציבים מבוססי טקסט.
4. האם צריך לדעת קוד כדי לחלץ נתונים מ‑PDFs?
לא. כלים כמו Thunderbit, Parseur, Docparser, Parsio, Nanonets ו‑Adobe Acrobat ניתנים לשימוש בלי קוד. גם ל‑Tabula יש ממשק גרפי. ספריות Python כמו PyMuPDF, Camelot, pdfplumber ו‑Docling דורשות קוד.
5. האם אפשר לייצא נתוני PDF ישירות ל‑Excel או Google Sheets?
רוב הכלים תומכים בייצוא ל‑CSV או Excel לפחות. Thunderbit מייצא גם ישירות ל‑Google Sheets, Airtable ו‑Notion בחינם. Parseur, Docparser ו‑Parsio תומכים בייצוא ל‑business workflows דרך אינטגרציות כמו Zapier, webhooks ו‑APIs.
נסו חילוץ PDF מבוסס AI עם Thunderbit Get Started Free
למידע נוסף



