
השאלה הוותיקה הייתה פשוטה: “איזה סקרייפר יכול להעתיק נתונים מהאתר הזה?”
השאלה הנכונה יותר ל-2026 היא הרבה יותר מדויקת: “איזו זרימת עבודה יכולה להפוך דף אינטרנט מבולגן לנתונים מובנים ואמינים, עם מספיק בדיקות כדי שאוכל להשתמש בהם שוב בשבוע הבא?”
השינוי הזה חשוב, כי “AI web scraper” כבר לא מתאר מוצר אחד אלא כמה סוגי כלים שונים מאוד. יש כלים שמשתמשים ב-AI כדי להציע שדות ולחלץ נתונים בלי selectors. יש סקרייפרים ויזואליים עם כמה יכולות זיהוי חכמות. יש פלטפורמות למפתחים שבהן AI עוזר לבנות או לתחזק קוד. ויש גם כלים ותיקים שעדיין מופיעים בתוצאות החיפוש, אף שהם כבר לא באמת נולדו כפתרון AI.
המדריך הזה נשאר פרקטי. אם אתם עובדים במכירות, שיווק, ecommerce, מחקר, תפעול או צוותי דאטה, המטרה היא לא להתלהב מסקרייפר. המטרה היא להוציא שורות נקיות מאתרים ציבוריים אל גיליון, CRM, מסד נתונים או אוטומציה — בלי לבזבז את שאר החודש על תיקון selectors.
חלצו נתונים מאתרים בעזרת AI השתמשו ב-Thunderbit כדי להפוך דפי אינטרנט לטבלאות מובנות, ואז לייצא ל-Sheets, Airtable, Notion, CSV או JSON. Get Started Free
מה נחשב ל-Free AI Web Scraper ב-2026?
AI web scraper שימושי אמור לעזור לפחות באחת מהמשימות הבאות:
- לקרוא את הדף ולהציע אילו שדות לחלץ
- להתמודד עם רשימות, עימוד, גלילה אינסופית או דפי משנה
- להפוך תוכן מבולגן בטקסט לדו"חות מובנים בשורות
- לייצא נתונים לכלים שהצוות כבר משתמש בהם
- להפחית את הצורך בתחזוקת selectors כשהדף משתנה
- להפוך את התהליך למשהו שאפשר לחזור עליו בצוות, ולא רק בסשן הדפדפן של אדם אחד
גם למילה “Free” צריך להתייחס ברצינות. יש כלים עם תוכנית חינמית אמיתית. יש כאלה עם גרסת ניסיון חינמית. יש כלים בקוד פתוח, אבל הם דורשים זמן פיתוח. ויש פתרונות ארגוניים מצוינים, אבל המסלול החינמי בהם הוא בעיקר דמו או trial. זה לא הופך אותם לרעים — אבל זה כן משפיע על מי צריך לבחור בהם.
כלל החלטה פשוט:
- אם אתם צריכים נתונים היום ולא רוצים לכתוב קוד, התחילו עם AI scraper ללא קוד.
- אם אתם צריכים pipeline מותאם אישית ויש לכם מפתחים, השתמשו במסגרת פיתוח או פלטפורמת אוטומציה בענן.
- אם אתם צריכים פידים מנוהלים בקנה מידה גדול, בדקו פלטפורמות דאטה ארגוניות.
- אם כלי מסוים הוא מיושן או לא נתמך, התייחסו אליו כנקודת השוואה ולא כבחירה ברירת מחדל.
איך בחרנו את הכלים האלה
עברתי על רשימת 10 הכלים של המאמר הנוכחי ושמרתי על אותו מסנן הערכה פרקטי. השאלה החשובה כבר איננה “האם המוצר הזה יודע לגרד נתונים?” אלא “איזה סוג של workflow לגרידת נתונים המוצר הזה הופך לפשוט יותר?”
הקריטריונים:
- סיוע מבוסס AI: הצעות לשדות, חילוץ חכם, הגדרה בשפה טבעית או parsing בעזרת AI.
- גישה חינמית: תוכנית חינמית, trial, זמינות בקוד פתוח או קרדיטים למפתחים.
- קלות שימוש: האם משתמש עסקי יכול לעבוד איתו בלי עזרה מהנדסתית.
- תמיכה באינטרנט מודרני: עימוד, דפי משנה, דפים עתירי JavaScript, תמונות וייצוא.
- התאמה תפעולית: האם הפלט יכול להפוך לתהליך שחוזר על עצמו.
- סיכון ותחזוקה: כמה setup, תיקון selectors, בדיקות תאימות ובקרת איכות עדיין נשארים אצל המשתמש.
עוד הערה אחת: תמיד בדקו את תנאי האתר, robots.txt, דרישות התחברות והחובות הפרטיות לפני scraping. AI מקל על החילוץ; הוא לא מסיר מכם את האחריות להשתמש בנתוני רשת באופן אחראי.
בחירות מהירות: AI Web Scrapers החינמיים הטובים ביותר לפי שימוש
| שימוש | להתחיל כאן | למה |
|---|---|---|
| Scraping מהיר ללא קוד לצוותים עסקיים | Thunderbit | הצעות שדות מבוססות AI, scraping של דפי משנה, ייצוא, Workflow ב-Chrome |
| Scraping ויזואלי בסגנון desktop | ParseHub או Octoparse | מצוין למי שמעדיפים עבודה מבוססת קליקים |
| Scraping מבוסס recipes בדפדפן | Data Miner | חזק במיוחד לטבלאות נפוצות ולעבודות חוזרות מבוססות recipe |
| Scraping בשליטה של מפתחים | Scrapy או Apify | הכי מתאים כשקוד, APIs ותשתית מותאמת חשובים |
| APIs לנתונים עם AI וחילוץ ישויות | Diffbot | מתאים יותר ל-enrichment מבוסס API ולנתוני ישויות מובנים |
| Crawling בקוד פתוח עם מוכנות ל-AI | Crawl4AI או Scrapling | מסגרות עבודה למפתחים עבור pipelines של LLM ו-scraping מותאם אישית וקל לתחזוקה |
1. Thunderbit
Thunderbit הוא הבחירה הכי מתאימה למשתמשים עסקיים שרוצים לגרד דפי אינטרנט ציבוריים בלי לכתוב קוד סקרייפינג. זהו תוסף ל-Chrome המבוסס על workflow פשוט: פותחים דף, נותנים ל-AI להציע שדות, מכוונים את הטבלה אם צריך, מבצעים scraping לרשימה או לדפי משנה, ואז מייצאים את התוצאה.
ה-workflow הזה חשוב, כי הרבה צוותים לא באמת רוצים “סקרייפר”. הם רוצים לידים מספריות עסקים, נתוני מוצרים ממארקטפלייסים, מחירים מדפי מתחרים, ליסטינגים של נדל"ן, ביקורות, משרות או נתוני מחקר בגיליון.
Thunderbit חזק במיוחד כש:
- המקור הוא אתר ולא PDF או מסד נתונים פנימי
- המשתמש יודע איזה מידע הוא צריך אבל לא יודע CSS selectors
- לדף יש דפי פרטים, עימוד או כרטיסיות חוזרות
- הפלט צריך להגיע ל-Google Sheets, Airtable, Notion, CSV או JSON
- ה-workflow אמור לחזור על עצמו גם אצל חבר צוות לא טכני
הזווית של AI כאן היא פרקטית, לא קישוטית. AI עוזר להסיק אילו שדות קיימים, לכתוב prompts לחילוץ, ולהפוך את ה-setup לפחות שביר לעומת עבודה טהורה של point-and-click עם selectors. ועדיין כדאי לבדוק שורות לדוגמה לפני שמייצאים משימה גדולה, במיוחד כשהדף מערבב מודעות, המלצות או רשומות ממומנות בתוך התוצאות הראשיות.
גישה חינמית: ל-Thunderbit יש מסלול חינמי למשימות קטנות, עם תוכניות בתשלום לנפחים גבוהים יותר. בדקו את דף התמחור המעודכן לפני שמפרסמים מספרי קרדיטים מדויקים, כי מבנה הקרדיטים עשוי להשתנות.
מתאים במיוחד ל: צוותי מכירות, שיווק, ecommerce, נדל"ן, תפעול ומחקר שצריכים נתוני רשת מובנים במהירות.

2. ParseHub
ParseHub הוא web scraper ויזואלי למשתמשים שמעדיפים ללחוץ דרך הדף וללמד את הכלי מה לחלץ. הוא יכול להתמודד עם הרבה דפים דינמיים ונשאר בחירה מוכרת לצוותים שרוצים סקרייפר ויזואלי בדסקטופ או בענן.
ParseHub שימושי כשהמשתמש נוח לו לבנות פרויקט שלב אחר שלב: לבחור אלמנט, להרחיב את הבחירה, להוסיף עימוד, לבדוק את הריצה ואז לייצא. הוא לא כל כך “prompt-first” כמו כלים מודרניים שנולדו ל-AI, אבל עדיין יכול להיות אפקטיבי עבור רשימות מובנות, דפי כתבות ואוספי מוצרים.
גישה חינמית: ל-ParseHub הייתה היסטורית שכבה חינמית עם מגבלות על פרויקטים וריצות דפים. כדאי לאמת את מגבלות הפרויקט והעמודים באתר הרשמי לפני שמצטטים מספרים בטקסט שיווקי.
מתאים במיוחד ל: פרויקטי scraping ויזואליים קטנים שבהם המשתמש מוכן להשקיע מעט זמן בהגדרת ה-workflow.
3. Octoparse
Octoparse היא פלטפורמת web scraping בוגרת ללא קוד, עם templates, בניית workflows, ריצות בענן, תזמון ותמיכה בהרבה אתרים דינמיים. יש בה יותר פיצ'רים מאשר בתוסף Chrome קליל, וזה יכול להיות יתרון או עומס — תלוי במשתמש.
Octoparse היא בחירה טובה כשמשימת ה-scraping חוזרת על עצמה, האתר היעד מורכב, או שהצוות רוצה בונה workflow ויזואלי עם תזמון והרצה בענן. ההגדרה יכולה לקחת יותר זמן מאשר scraping מהיר בעזרת AI, אבל היא נותנת יותר שליטה למשתמשים מתקדמים.
גישה חינמית: Octoparse מציעה תוכנית חינמית, אבל המגבלות על פיצ'רים ורשומות משתנות. מומלץ לבדוק את מגבלות התוכנית החינמית ב-דף התמחור של Octoparse לפני פרסום מספרים מדויקים.
מתאים במיוחד ל: משתמשים מתקדמים וצוותים שצריכים שליטה ויזואלית ב-workflow, templates, תזמון או עבודות חוזרות.

4. Scrapy
Scrapy הוא לא AI scraper ללא קוד. זוהי מסגרת Python בקוד פתוח לבניית crawlers ו-pipelines לחילוץ. ההבחנה הזאת חשובה.
עבור מפתחים, Scrapy עדיין אחת הדרכים הגמישות ביותר לבנות סקרייפר מותאם אישית. אפשר לשלוט בבקשות, parsing, retries, pipelines, אחסון ו-deployment. אפשר גם להשתמש ב-LLMs סביב Scrapy: לנסח selectors, לבדוק לוגיקת parsing, לייצר tests או להסביר כשלים. אבל Scrapy עצמו לא מחליף את עבודת ההנדסה.
גישה חינמית: Scrapy הוא בקוד פתוח. התוכנה חינמית, אבל אירוח, proxies, תחזוקה, ניטור וזמן מפתחים — לא.
מתאים במיוחד ל: מהנדסים שבונים מערכות scraping מותאמות וניתנות לתחזוקה, שבהן בעלות על הקוד היא חלק מהפתרון.
5. Data Miner
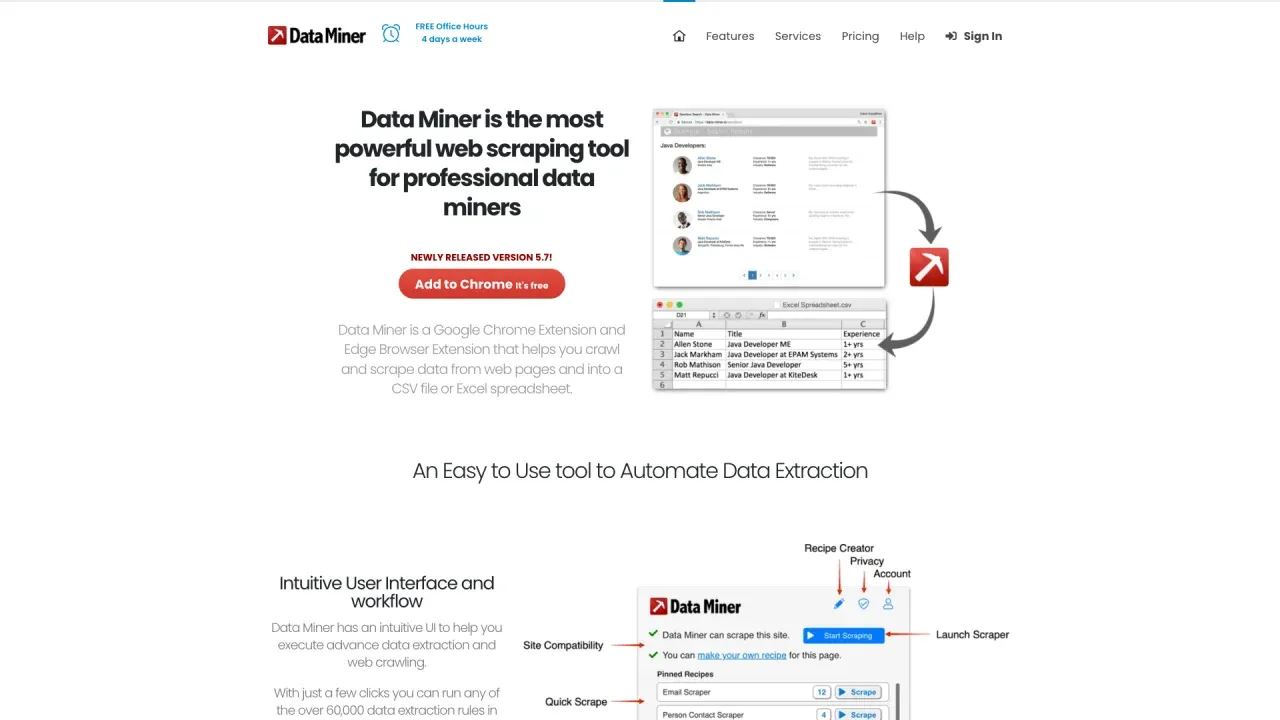
Data Miner הוא תוסף דפדפן שמתמקד ב-scraping של טבלאות, רשימות ותבניות נפוצות בדפים. ספריית ה-recipes שלו היא היתרון העיקרי: אם recipe כבר קיים למקור שלכם, ההגדרה יכולה להיות מהירה.
זהו פתרון טוב למשתמשים שמגרדים שוב ושוב סוגי דפים מוכרים ולא צריכים פלטפורמת חילוץ מלאה. הוא פחות מתאים כשהדף מבולגן, דינמי מאוד, או דורש AI כדי להסיק שדות מתוך תוכן לא חד-משמעי.
גישה חינמית: ל-Data Miner יש שימוש חינמי מוגבל עם תוכניות בתשלום לנפח גבוה יותר. בדקו את מגבלות הדפים או הקרדיטים העדכניות לפני שמצטטים אותן.
מתאים במיוחד ל: חילוץ טבלאי מהיר, ספריות עסקים נפוצות ומשתמשים שאוהבים workflows של תוספי דפדפן.
6. WebHarvy
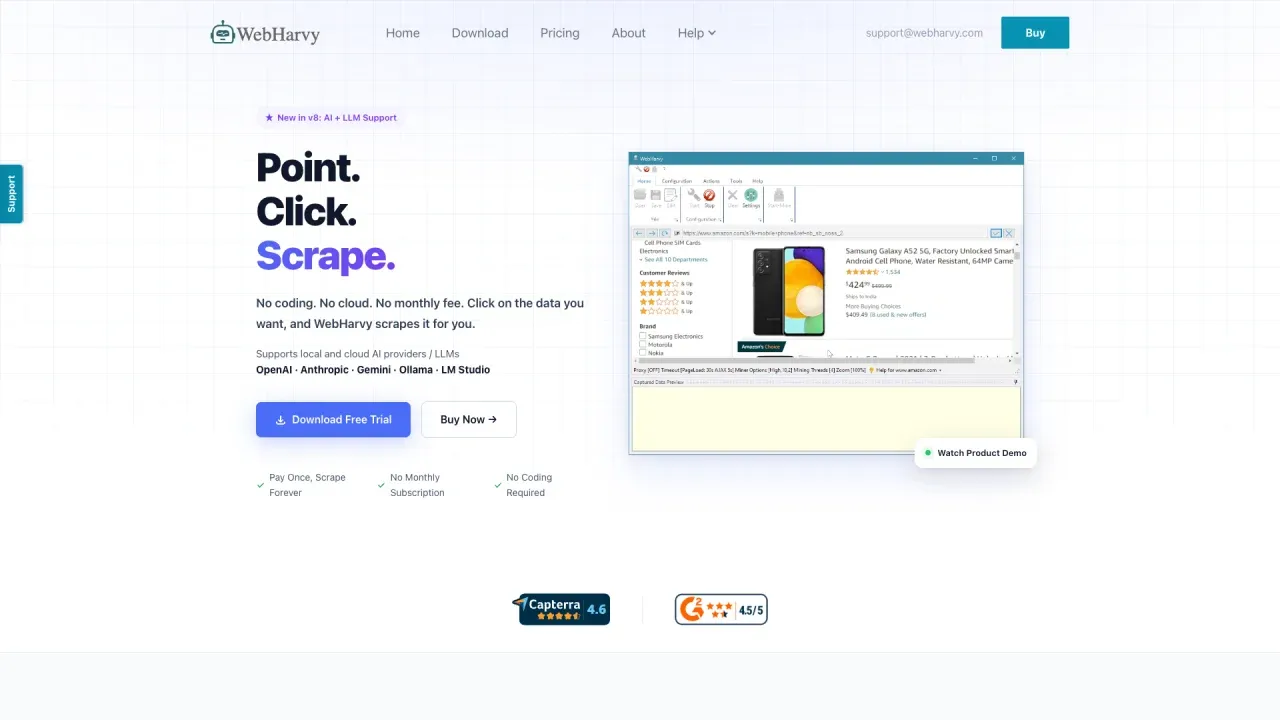
WebHarvy הוא scraper לדסקטופ על Windows עם ממשק ויזואלי ויכולות זיהוי דפוסים. הוא שימושי למשתמשים שרוצים ללחוץ על דוגמאות בדף ולתת לכלי להסיק פריטים דומים.
WebHarvy חזק במיוחד עבור דפי מוצרים, דפים עתירי תמונות ו-workflows בסגנון desktop. הוא לא הפתרון הכי מודרני שנבנה מלכתחילה ל-AI, אבל הוא עדיין יכול לעבוד היטב למשתמשים שמעדיפים רישיון חד-פעמי ותוכנת דסקטופ מקומית.
גישה חינמית: WebHarvy בדרך כלל מוצע כגרסת ניסיון חינמית ורישיון בתשלום, ולא כתוכנית חינמית קבועה. בדקו את האתר הנוכחי לפני שמכנים אותו כלי חינמי.
מתאים במיוחד ל: משתמשי Windows שמגרדים רשימות מוצרים, תמונות ותבניות עמוד שחוזרות על עצמן.
7. Apify
Apify היא פלטפורמת ענן ידידותית למפתחים עבור web scraping, אוטומציית דפדפן וחילוץ נתונים. ה-Actor marketplace הוא מוקד המשיכה העיקרי: במקום להתחיל מסקריפט ריק, צוותים יכולים להשתמש ב-actors קיימים או להתאים אותם לאתרים ול-workflows נפוצים.
Apify היא אחת האפשרויות החזקות ביותר כשצריך להפוך scraping לתוכנה של ממש. היא תומכת ב-APIs, תזמון, אחסון, webhooks ו-workflows לפיתוח. גם כאן AI יכול לעזור, אבל בעיקר כעוזר לבנייה, איתור תקלות ואימות actors — ולא כממשק one-click למשתמש עסקי.
גישה חינמית: ל-Apify יש מודל של תוכנית חינמית/קרדיטים. בדקו את התמחור של Apify ואת תיעוד הפלטפורמה לפני שמצטטים מגבלות compute מדויקות.
מתאים במיוחד ל: מפתחים, צוותי אוטומציה ומפעילים טכניים שרוצים תשתית scraping בענן.

8. Diffbot
Diffbot היא פלטפורמת נתוני AI הידועה בחילוץ ישויות מובנות מדפי אינטרנט ובתחזוקה של Knowledge Graph גדול. היא קרובה יותר ל-API ולפלטפורמת intelligence של נתונים מאשר לסקרייפר ויזואלי.
Diffbot יכולה להיות חזקה במיוחד כשהמשימה היא חילוץ ישויות, parsing של כתבות/מוצרים, enrichment או הבנה מובנית של רשת בקנה מידה גדול. בדרך כלל היא לא הכלי הראשון למשתמש לא טכני שרוצה ללחוץ על דף ולייצא לגיליון.
גישה חינמית: ל-Diffbot יש תוכנית חינמית ומודלים לגישה למפתחים; בדקו את התמחור של Diffbot לתנאי הקרדיטים וה-trial העדכניים ביותר.
מתאים במיוחד ל: צוותים טכניים שצריכים חילוץ מובנה מבוסס API, נתוני Knowledge Graph או entity intelligence.
9. Crawl4AI
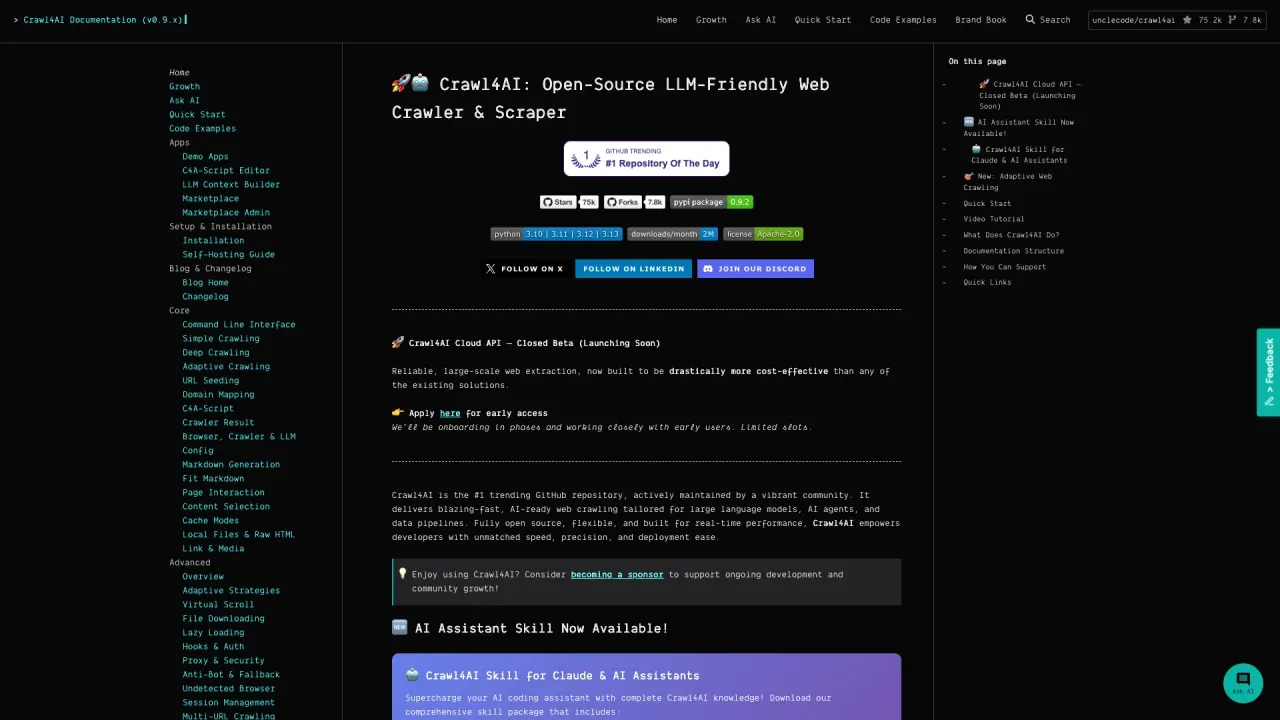
Crawl4AI הוא crawler ו-scraper בקוד פתוח, ידידותי ל-LLM, עבור מפתחים שבונים AI agents, pipelines ל-RAG ו-workflows מותאמים אישית של נתונים. הוא יכול להפיק Markdown נקי, לחלץ JSON מובנה באמצעות CSS או XPath, ולהשתמש ב-LLM כדי לייצר סכמת חילוץ ניתנת לשימוש חוזר כשזה מתאים למשימה.
Crawl4AI הוא בחירה חזקה כשהתוצאה צריכה להפוך לחלק מ-workflow הנדסי ולא לייצוא חד-פעמי לגיליון. הוא תומך בשליטה בדפדפן, crawling אסינכרוני, sessions ואפשרויות חילוץ מדויקות, אבל עדיין דורש Python ובעלות טכנית.
גישה חינמית: בקוד פתוח, בלי חובה ל-API key או חומת תשלום של פלטפורמה. ייתכן שחילוץ מבוסס LLM עדיין ידרוש ספק LLM או מודל מקומי.
מתאים במיוחד ל: מפתחים שבונים crawlers מוכנים ל-AI, קליטת נתונים ל-RAG או pipelines חוזרים לנתונים מובנים.
10. Scrapling
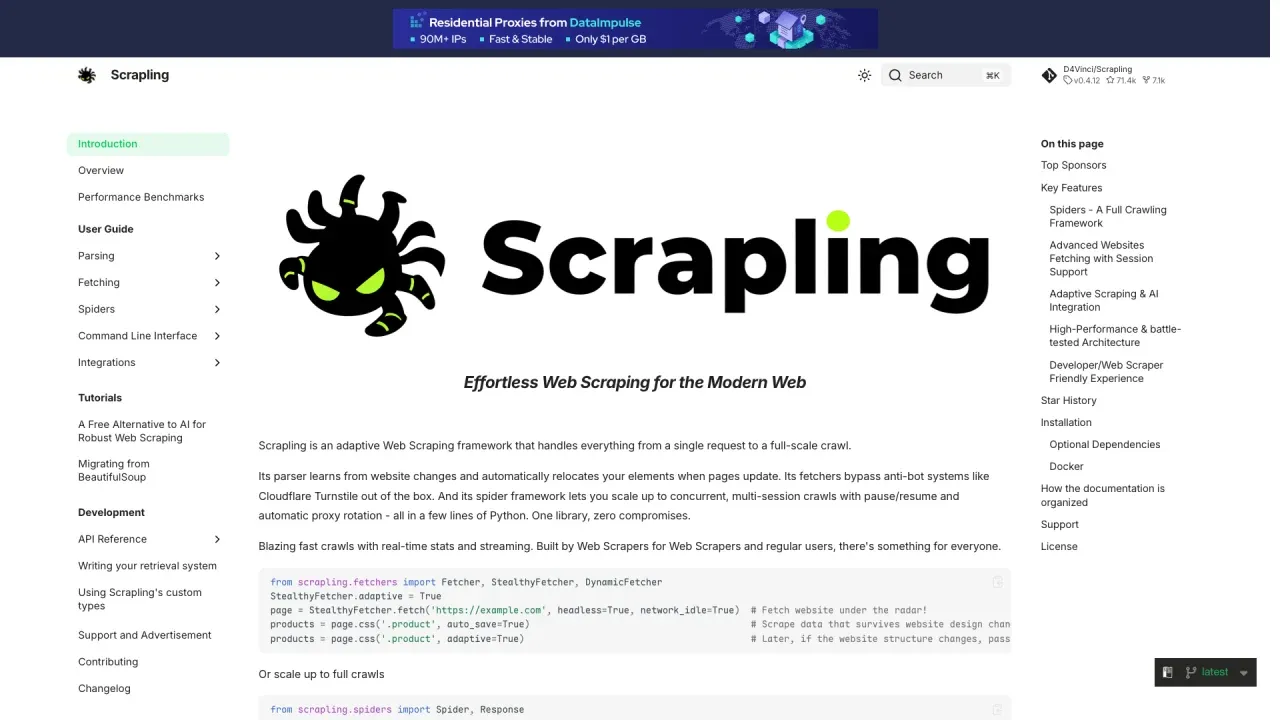
Scrapling הוא framework Python אדפטיבי ל-scraping, שפועל החל מבקשות בודדות, דרך שליפה מבוססת דפדפן ועד crawls מלאים. ה-parsing האדפטיבי שלו נועד לעזור לאתר מחדש רכיבי דף כשהאתר משתנה, וכך להפחית את העומס של תיקון selectors בפרויקט scraping שבבעלות קוד.
זה לא כלי AI ללא קוד: צוותים עדיין צריכים להגדיר את לוגיקת החילוץ, לבדוק אותה ולנהל את זמן הריצה. אבל הוא מהווה חלופה מודרנית לכניסה ישנה לעולם ה-visual scraping, כי הוא מתועד באופן פעיל ומתאים יותר לסטאקים עכשוויים של scraping ב-Python.
גישה חינמית: קוד פתוח. עלויות תשתית, שירותי proxy, ריצות דפדפן וזמן הנדסי נשארות בנפרד.
מתאים במיוחד ל: מפתחי Python שרוצים scraping אדפטיבי ונתיב מבקשה בודדת אל crawl מקבילי.
טבלת השוואה: כלי AI Web Scraping חינמיים
| כלי | סוג | מסלול חינמי | AI-native? | מתאים במיוחד ל |
|---|---|---|---|---|
| Thunderbit | סקרייפר AI ל-Chrome | שימוש התחלתי חינמי | כן | משתמשים עסקיים שצריכים נתוני רשת מובנים במהירות |
| ParseHub | סקרייפר ויזואלי | שכבה חינמית מוגבלת | חלקית | פרויקטים ויזואליים קטנים |
| Octoparse | פלטפורמת scraping ללא קוד | תוכנית/ניסיון חינם | חלקית עד חזק | משתמשים מתקדמים ועבודות no-code חוזרות |
| Scrapy | מסגרת Python | קוד פתוח | לא, אבל קידוד בסיוע AI עובד | מפתחים שבונים סקרייפרים מותאמים |
| Data Miner | תוסף דפדפן | שימוש חינמי מוגבל | מוגבל | טבלאות, רשימות ו-scraping מבוסס recipes |
| WebHarvy | סקרייפר ויזואלי ל-Windows | גרסת ניסיון חינמית | מוגבל | scraping של מוצרים/תמונות על דסקטופ |
| Apify | פלטפורמת אוטומציה בענן | קרדיטים/תוכנית חינמיים | סמוך למפתחים | pipelines טכניים ל-scraping |
| Diffbot | API לחילוץ מבוסס AI | קרדיטים/תוכנית חינמיים | כן | חילוץ ישויות ו-workflows של Knowledge Graph |
| Crawl4AI | crawler בקוד פתוח מוכן ל-AI | קוד פתוח | כן/ידידותי ל-LLM | RAG, agents של AI ו-pipelines למפתחים |
| Scrapling | מסגרת Python אדפטיבית ל-scraping | קוד פתוח | סמוך ל-AI/אדפטיבי | scraping שבבעלות קוד וצריך עמידות ל-selectors |
איך לבחור את הכלי הנכון
תתחילו מהמקור ומהמשתמש, לא משם המותג.
אם הנתונים נמצאים בדפי אינטרנט ציבוריים והמשתמש לא טכני, התחילו עם Thunderbit, ParseHub, Octoparse או Data Miner. הכלים האלה קרובים יותר ל-workflow העסקי בפועל: פותחים את המקור, מגדירים שדות, מריצים בדיקה, בודקים שורות, מייצאים.
אם המשימה דורשת לוגיקה מותאמת, טיפול באימות, orchestration, APIs או deployment, בדקו את Scrapy או Apify. זה המקום שבו ownership הנדסי הגיוני. אפשר להשתמש ב-AI כדי לזרז בדיקת selectors ויצירת tests, אבל להשאיר אצל בני אדם את הבקרה על תאימות, טיפול בכשלים ואיכות הנתונים.
אם החברה צריכה חילוץ ישויות מבוסס API, enrichment או knowledge graph מובנה, כדאי להעריך את Diffbot ולהשוות את תנאי הניסיון, הכיסוי וההתאמה ל-API מול הדרישות שלכם. עבור פידים מנוהלים רחבים יותר, עדיף תהליך procurement ייעודי ולא להתייחס אליהם כבחירה של סקרייפר חינמי.
אם האתר או התיעוד של כלי מסוים נראים לא מעודכנים, אל תשתמשו בו בעבודה רגישה. בדקו על דף ציבורי לא מזיק, אמתו את הייצוא, וודאו שהמוצר עדיין מתוחזק.
רשימת בדיקה פשוטה לאימות לפני ייצוא
לפני שאתם מריצים scraping בהיקף גדול, בדקו מדגם קטן:
- האם כל שורה מייצגת את היישות הנכונה?
- האם פריטים ממומנים, כפולים או מומלצים נכנסו בטעות לנתונים?
- האם העימוד או הגלילה האינסופית נעצרו מוקדם מדי?
- האם מחירים, תאריכים, אימיילים ומספרי טלפון נותחו בעקביות?
- האם שדות מדפי משנה שויכו לשורה האב הנכונה?
- האם פורמט הייצוא שומר על הסכמה שאתם צריכים?
- האם מותר לכם לאסוף ולהשתמש בנתונים האלה לצורך שלכם?
AI יכול לזרז setup, אבל הוא גם עלול לגרום לחילוץ שגוי להיראות נקי. בדיקת QA של 20 שורות היא עדיין אחת הדרכים הזולות ביותר להימנע ממערך נתונים גרוע.
המלצה סופית
עבור רוב המשתמשים העסקיים, התחילו מה-workflow המהיר והבטוח ביותר: השתמשו ב-AI scraper ללא קוד, בדקו על מדגם קטן, אמתו את הסכמה ואז ייצאו למערכת שבה העבודה ממשיכה.
Thunderbit הוא הפתרון החזק ביותר כשמדובר בנתוני רשת ציבוריים והמשתמש רוצה workflow מעשי בסיוע AI בתוך הדפדפן. ParseHub, Octoparse ו-Data Miner שווים בדיקה אם אתם מעדיפים בוני פרויקטים ויזואליים או scraping מבוסס recipes. Scrapy, Crawl4AI, Scrapling ו-Apify מתאימים יותר כשה-scraper צריך להפוך לקוד או לתשתית. Diffbot הוא פתרון מומחה כשחילוץ ישויות או נתוני knowledge graph חשובים יותר מ-workflow מבוסס דפדפן.
הכלי הטוב ביותר הוא לא זה עם רשימת הפיצ'רים הארוכה ביותר. הוא זה שמספק לכם נתונים מובנים ואמינים עם מינימום תחזוקה שוטפת לצוות.
שאלות נפוצות
מהו AI web scraper?
AI web scraper משתמש בלמידת מכונה, LLMs, ראיית מחשב או הבנת דף חכמה כדי לעזור לזהות שדות, לחלץ נתונים מובנים או להסתגל לדפים מבולגנים. הכלים הטובים ביותר עדיין מאפשרים לכם לבדוק ולתקן את הפלט.
האם AI web scrapers חינמיים באמת חינמיים?
לחלקם יש שימוש התחלתי חינמי, לחלקם יש גרסת ניסיון חינמית, וחלקם בקוד פתוח. חינמי לא תמיד אומר חינמי בקנה מידה גדול. בדקו מגבלות עמודים, מגבלות קרדיטים, הגבלות ייצוא והאם ריצות בענן כלולות.
איזה AI web scraper חינמי הכי טוב למשתמשים לא טכניים?
Thunderbit הוא נקודת פתיחה מצוינת לצוותים לא טכניים שרוצים לגרד אתרים ציבוריים לטבלאות מובנות. ParseHub, Octoparse ו-Data Miner שימושיים גם הם, תלוי אם אתם מעדיפים פרויקטים ויזואליים, templates או recipes בדפדפן.
מתי כדאי להשתמש ב-Scrapy או Apify במקום בסקרייפר ללא קוד?
כדאי להשתמש ב-Scrapy או Apify כשצריך לוגיקה מותאמת, שליטה של מפתחים, APIs, תזמון, ניטור או אינטגרציה לתוך workflow תוכנתי רחב יותר. הם עוצמתיים, אבל דורשים יותר ownership.
האם AI web scrapers יכולים להתמודד עם עימוד ודפי משנה?
כלים מודרניים רבים יכולים, אבל חשוב לבדוק בזהירות. עימוד, גלילה אינסופית ודפי משנה הם מקומות נפוצים שבהם סקרייפרים נעצרים מוקדם מדי או משייכים נתוני דף פרטים לשורה הלא נכונה.
האם חוקי לגרד אתרים?
זה תלוי באתר, בסוג הנתונים, בתחום השיפוט ובמקרה השימוש. בדקו את תנאי האתר, robots.txt, מגבלות התחברות, חובות פרטיות ודרישות תאימות פנימיות לפני איסוף או שימוש בנתונים שנגרדו.
למידע נוסף
- איך לגרד כל אתר בעזרת AI
- 5 כלי ותוכנות web scraping הטובים ביותר ל-2026
- 7 כלי web scraping הפופולריים ביותר לשימוש ב-2026
- 10 כלי AI web scraper מובילים לשיפור הפרודוקטיביות ב-2025
- 8 ה-AI web scrapers הטובים ביותר לחילוץ נתונים חכם יותר
נסו AI Web Scraper Get Started Free




