
שש ספריות, סט בדיקות מסומן אחד, ומדד אחד. ב-22 ה-fixtures הסינתטיים האלה, הספרייה עם הדליפה הגבוהה ביותר של boilerplate — Mozilla's Readability, עם 23.5% — הייתה גם היחידה שהחזירה כל יחידת מאמר מתויגת.
זו העסקה במשפט אחד, ורוב הכתבות בנושא הזה פשוט לא מציגות אותה, כי רובן מודדות precision ועוצרות שם.
מה באמת נמדד
לכל fixture בסט הזה יש אמת-מכונה ברמת יחידה. כל בלוק בעמוד — פסקאות המאמר, הניווט, המודעה, הסיידבר, שרשור התגובות, הקידום — מתויג כ-article או boilerplate, ומקבל token סנטינל ייחודי. לכן השאלה "האם ה-extractor החזיר את היחידה הזו" נבחנת באמצעות membership מדויקת של תת-מחרוזת, לא לפי דמיון. סנטינל או שמופיע בפלט או שלא.
22 fixtures, 91 יחידות. שש מחלצות: Mozilla Readability 0.6.0 (דרך jsdom 30.0.1), trafilatura 2.2.0, resiliparse 1.0.9, newspaper4k 0.9.6, goose3 3.1.22, ו-jusText 3.0.2. Python 3.14.2 ו-Node 22 הורצו על אותה מכונה. הכתבה לא משמרת את מערכת ההפעלה/ה-CPU, את פקודות ההרצה המדויקות, את מספר החזרות או את מדיניות החימום, ולכן עמודת הזמן היא תצפית מקומית ולא benchmark נייד.
שני כללים שהקפדתי עליהם לפני שהרצה כלשהי התחילה. כל ספריית Python הותקנה לתוך virtualenv ריק משלה, כך שה-footprint שלה שייך רק לה ולא ירש שום דבר שחבילה אחרת הביאה. ובנוסף, אף runner לא מחשב מדד — כל אחד רק פולט טקסט גולמי שחולץ, ומדד אחד משותף מפיק את כל המספרים, כך שכל שש הכלים משווים על אותו חשבון בדיוק, ולא על שש הגדרות דומות-לכאורה של "precision".
טבלת הכותרת
| ספרייה | Recall של מאמר (כל 22) | דליפת Boilerplate | Precision של טוקני תוכן | fixtures עם תשובה | טוקנים מזהמים |
|---|---|---|---|---|---|
| Readability | 1.0000 | 0.2353 | 0.9109 | 11/11 | 35 |
| trafilatura | 0.9865 | 0.0588 | 0.9411 | 11/11 | 4 |
| newspaper4k | 0.9865 | 0.0000 | 0.9452 | 11/11 | 0 |
| resiliparse | 0.9054 | 0.0588 | 0.9381 | 11/11 | 7 |
| jusText | 0.8378 | 0.4706 | 0.8760 | 10/11 | 74 |
| goose3 | 0.8243 | 0.0000 | 1.0000 | 10/11 | 0 |
ה-Recall מחושב על פני כל 22 ה-fixtures. שיעור הדליפה, precision מצטבר של טוקני תוכן, וזיהום משתמשים ב-11 ה-fixtures שמכילים גם יחידות מאמר וגם boilerplate; "ענה" מראה בכמה מהם התקבל פלט. המספרים המלאים לכל fixture נמצאים ב-sixway-scores.json.
שורה אחת בטבלה הזו היא לא ברירת מחדל. ל-extract_plain_text של resiliparse יש ברירת מחדל של main_content=False, ואני קראתי לו עם main_content=True. ההבדל ממש לא קטן: בברירות המחדל שלו הוא מדליף 17 מתוך 17 יחידות boilerplate בכל הסט — כל nav, מודעה, סיידבר, שרשור תגובות וקידום — לעומת 1 מתוך 17 כשהדגל מופעל. כל ספרייה אחרת למעלה הורצה בברירות המחדל שלה. לכן שיעור הדליפה של 0.0588 ב-resiliparse הוא מה שהוא עושה כשמבקשים ממנו main content; extract_plain_text(html) לבדו הוא מוצר אחר (default-vs-main-content.json).
קראו את העמודה הראשונה ואת השנייה יחד, כי קריאה של אחת מהן בלבד תוביל לכלי הלא נכון.
Readability אף פעם לא מפספסת. Recall מושלם על כל 22 ה-fixtures, והיא היחידה שעושה זאת. אבל היא משלמת על זה: 4 מתוך 17 יחידות boilerplate דלפו, 35 טוקנים מזהמים, פי ארבעה משיעור הדליפה של trafilatura. שלוש מתוך ארבע הדליפות שלה הן מאותו סוג — בלוק promo ניטרלי שמופיע כאח של המאמר, וההיוריסטיקה שלה לצירוף אחים בולעת אותו. אם מאכילים את הפלט שלה במודל, משלמים על הטוקנים האלה, והמודל קורא אותם כחלק מהמאמר.
newspaper4k הוא המאוזן ביותר. אפס דליפה, אפס טוקנים מזהמים, recall של 0.9865, ופלט על כל 22 ה-fixtures. אם הייתי צריך לבחור אחד בלי לדעת מה עומס העבודה, זה היה זה — והוא לא הכלי שהרוב פונים אליו.
goose3 מציג precision מושלם וה-recall הגרוע ביותר במבחן. כל מילת תוכן שהוא החזיר הייתה באמת תוכן מאמר. אבל הוא גם לא החזיר כלום בכלל בשני fixtures, ובאותם שניים ממש גם לא הפיק פלט. Precision מושלם הוא זול אם מותר לך פשוט לא לענות.
מספר ה-precision שהחמיא לשתי ספריות
הנקודה הזו שווה פירוט, כי זו מלכודת שכמעט פרסמתי.
Precision ו-F1 כאן מותנים בכך שנוצר פלט. ספרייה שמחזירה מחרוזת ריקה על fixture לא תורמת כלום למונה וגם לא למכנה — ולכן אי-מענה הוא חינם, וה-precision של extractor שמרני נראה טוב יותר מזה של extractor יסודי, בלי סיבה אמיתית מלבד שתיקה.
goose3 קיבל precision מצטבר של 1.0000 על פני 10 ה-fixtures שנמדדו ושבהם הוא החזיר פלט. ל-jusText היה 0.8760 על פני 10 מתוך 11. Readability, trafilatura, resiliparse ו-newspaper4k ענו על 11 מתוך 11. הטבלה כאן מציגה את המכנה לצד ה-precision, כדי שהימנעות לא תיעלם מאחורי יחס מחמיא.
הייתה גם גרסה גרועה יותר של זה. המדד הראשון שלי חישב ממוצע של article recall על אותה קבוצת 11 ה-fixtures של fidelity לתוכן — הקבוצה שמוציאה fixtures שאין בהם boilerplate, וזה נכון למדידת דליפה. הוא הציג ל-resiliparse recall של 1.0000. על פני כל 22 ה-fixtures, resiliparse עומד על 0.9054, כי ב-fixture שבו המאמר כולו חי בתוך <li> בלי <p> בכלל, הוא מחזיר פלט ומצליח לשחזר 0 מתוך 6 יחידות מאמר. ל-fixture הזה אין boilerplate, אז הוא נפל מחוץ לממוצע, וכישלון אמיתי הסתתר מאחורי ציון מושלם.
איפה כל אחד נשבר בפועל
| Fixture | מה הוא בודק | מי לא מחזיר כלום |
|---|---|---|
כל המאמר בתוך <li>, בלי <p> | הנחות מבניות | resiliparse (0/6), goose3 (אין פלט) |
| יחידת מאמר אחת באורך 129 תווים | סף תוכן קצר | jusText |
| עשר פסקאות קצרות, בלי אחת ארוכה | סף תוכן קצר | jusText |
| מסמך כמעט ריק | גבול האפס האמיתי | goose3, jusText |
כל אחד מהמקרים האלה הוא התנהגות ספציפית וניתנת לשחזור, ולא סתם "מחלץ גרוע יותר":
- resiliparse ו-goose3 מניחים שיש פסקאות. אם מכוונים אחד מהם לעמוד שבו הגוף הוא רשימה — changelog, מפרט, FAQ, מתכון — resiliparse מחזיר טקסט בלי תוכן הרשימה, בעוד goose3 מחזיר כלום. resiliparse מסוכן יותר כאן, כי החזרת משהו נראית כמו הצלחה.
- ל-jusText יש cliff באורך, והוא חד. עוד על כך בהמשך.
- המסמך הכמעט ריק הוא המקרה היחיד שבו החזרת כלום היא כנראה התנהגות נכונה, ולכן לא הייתי מחזיק את זה נגד אף אחת מהספריות.
jusText: תהום, לא שיפוע
jusText הפיק פלט ב-19 מתוך 22 fixtures והדליף 47% מה-boilerplate — הכי הרבה במבחן, שזה ההפך מהמוניטין שלו. אבל המספר המעניין הוא זה שגרם לי להריץ הכול מחדש.
jusText מסווג כל בלוק לפי צפיפות stopwords מול רשימת עצירה לשפה, ואז מריץ מעבר תלוי-הקשר שמקדם בלוק neargood ל-good רק אם הוא יושב ליד בלוק good קיים. בלוק מגיע ל-good בכוחות עצמו רק מעל length_high, שברירת המחדל שלו היא 200 תווים. על מסמך שבו אף דבר לא עובר את הקו הזה, שום דבר לא מפעיל את ההקדם, וכל העמוד מתפרק ל-boilerplate.
בדקתי אותו על מסמך שהפסקה הארוכה ביותר בו היא 151 תווים:
length_high | פסקאות good | תווים שהוחזרו |
|---|---|---|
| 200 (ברירת מחדל) | 0 | 0 |
| 150 | 8 | 832 |
| 120 | 8 | 832 |
| 100 | 8 | 832 |
| 80 | 8 | 832 |
מאפס ל-832 תווים ברגע שפסקה אחת בדיוק חוצה את הסף, ואז שום דבר לא משתנה גם אם מרפים עוד יותר. פסקה אחת מעל הקו משחררת את כל המסמך.
לפני שהסקתי זאת, בחנתי את length_low על ארבעה ערכים ואת max_link_density על שניים — שמונה צירופים, כולם החזירו אפס. הכלל של הפרויקט הזה הוא שטענה על יכולת שלילית צריכה לפחות שלושה פרופילי פרמטרים שנבדקו, או את הודעת השגיאה של הספק עצמו שמכנה את השדה, ופרמטר אחד שלא הניב תוצאה אינו ממצא על הספרייה. המספרים נמצאים ב-justext-length-threshold.json.
כל זה לא אומר ש-jusText מחלץ רע. בעמוד אמיתי בשפה טבעית, בברירות המחדל, הוא החזיר 1,190 תווים נקיים של טקסט מאמר. זה אומר של-jusText יש כפתור מתועד שמתנהג כמו מתג, ושברירת המחדל של המתג הזה לא מתאימה למסמכים עם פסקאות קצרות.
מה מתקינים, וכמה עולה לייבא את זה
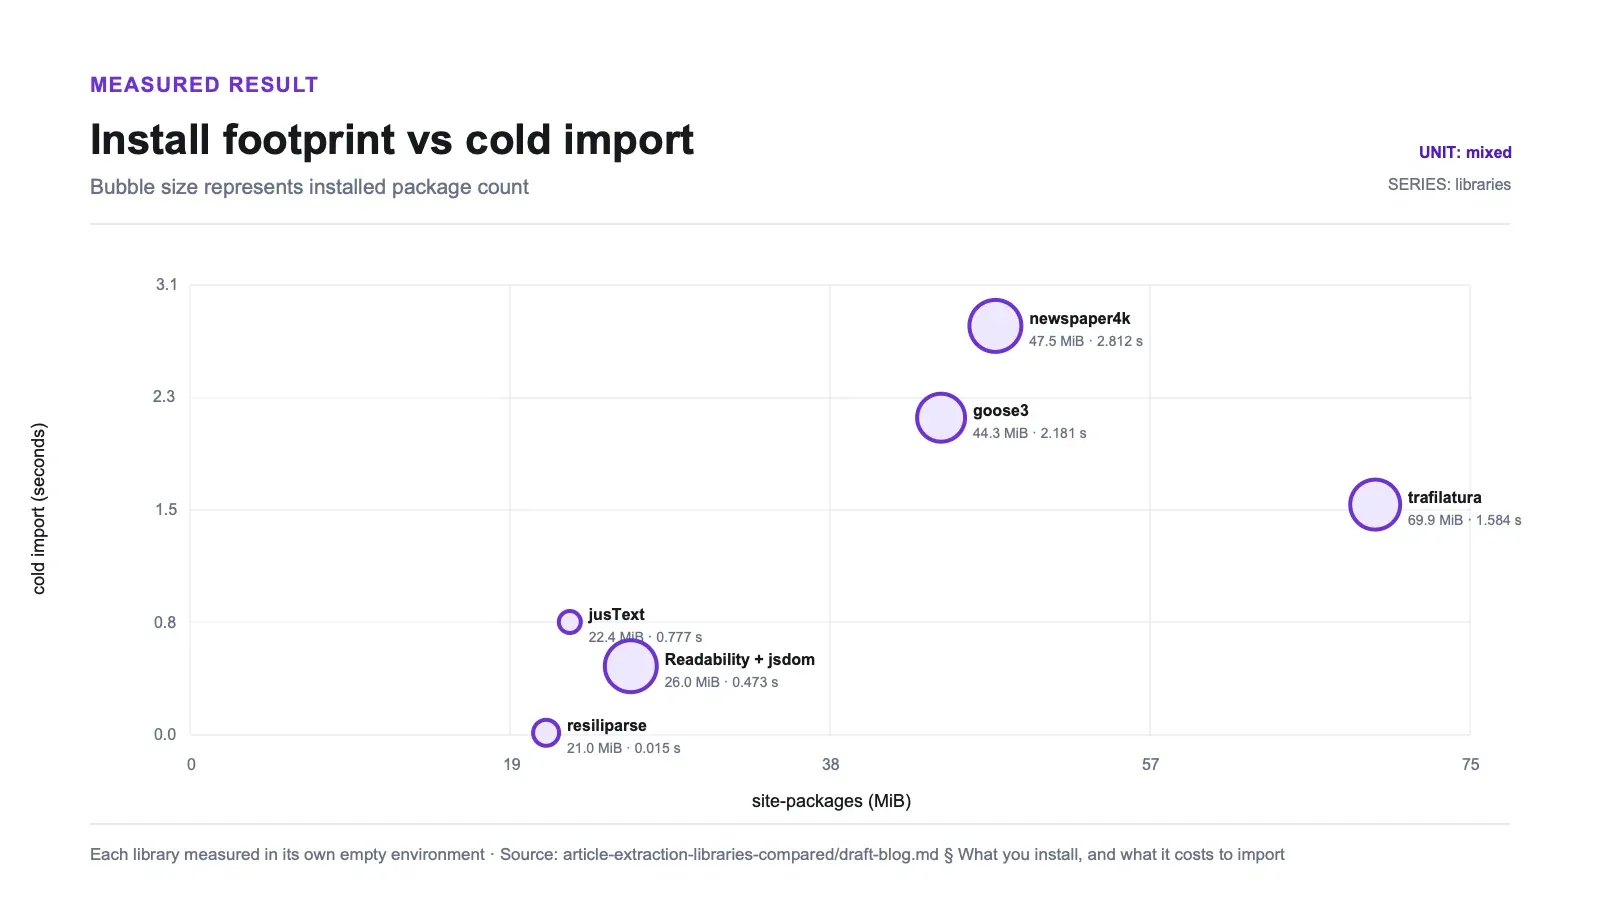
אותם fixtures, אותה מכונה, וכל ספרייה בתוך virtualenv ריק משלה.
| ספרייה | חבילות | site-packages | Cold import | Extraction p50 |
|---|---|---|---|---|
| resiliparse | 5 | 21.0 MiB | 0.015 s | 0.06 ms |
| jusText | 3 | 22.4 MiB | 0.777 s | 0.56 ms |
| goose3 | 16 | 44.3 MiB | 2.181 s | 1.85 ms |
| newspaper4k | 22 | 47.5 MiB | 2.812 s | 2.69 ms |
| trafilatura | 17 | 69.9 MiB | 1.584 s | 0.51 ms |
| Readability + jsdom | 32 (npm) | 26 MiB | 0.473 s | 6.37 ms |
בריצה הזו, ל-resiliparse היו ערכי ה-cold import וה-extraction החציוניים הנמוכים ביותר: 15 ms ו-0.06 ms. יחסיים מדויקים בין-סביבות ירחיבו מעבר למה שהפרוטוקול החסר יכול לתמוך בו, במיוחד משום שה-extraction הבודד האיטי ביותר שלו היה 1,098 ms. צריך התפלגויות נפרדות ל-startup, לקריאה ראשונה ולמצב יציב לפני שמשתמשים במספרים האלה לתכנון serverless.
trafilatura ו-resiliparse הם כמעט תיקו באיכות — 0.9697 מול 0.9681 ב-content-token F1, ושיעור דליפה זהה של 0.0588 — ואני לא מכריז על מנצח על פער כזה קטן. אבל ב-footprint הם רחוקים מאוד: 21.0 MiB מול 69.9 MiB, 5 חבילות מול 17. העסקה האמיתית היא בין העיוורון של resiliparse לרשימות לבין שלוש התלויות הנוספות של trafilatura.
שני באגים ב-testbed שלי, שהתגלו לפני הפרסום
ההשוואה למעלה כמעט לא הייתה קורית, והסיבה לזה חשובה יותר מכל שורה בה.
סט ה-fixtures לא יכול היה לראות שתיים מתוך שש הספריות. ה-fixtures המקוריים כותבים כל יחידה כרצף של tokens שטותיים ייחודיים — zzart01vf64 zzart01v56i — וזה בדיוק מה שהופך recall למדויק. אבל זה גם אומר שאין בהם בכלל מילות תפקוד באנגלית. Readability, trafilatura ו-resiliparse מחליטות מבנית, לפי ה-DOM, ולכן לא הושפעו. goose3 ו-jusText מחליטות לקסיקלית, לפי ספירת stopwords, ולא היו שם stopwords לספור: שתיהן החזירו מחרוזת ריקה בכל 22 ה-fixtures.
טבלה שבה שתי ספריות מקבלות ציון אפס הייתה נראית סמכותית ולא אומרת כלום. בדקתי לפני שכתבתי אותה, על עמוד אמיתי: goose3 החזיר 1,017 תווים ו-jusText החזיר 1,190. הבעיה לא הייתה בספריות. ה-testbed פשוט לא ייצג אותן.
לכן בנו את ה-fixtures מחדש עם פרוזה באנגלית שמכילה את הסנטינלים — אותה מבנה, אותן מחלקות, אותן עמדות ב-DOM, אותן גבולות יחידה, אותם סנטינלים, 1,568 tokens שהוחלפו אחד-לאחד. goose3 עבר מ-0 ל-20 מתוך 22.
ואז הבנייה מחדש שברה שני דברים משלה, ושניהם היו באשמתי. מילה באנגלית היא בערך שש אותיות; zzart01vf64 היא בערך שתים-עשרה. ההחלפה אחד-לאחד חתכה כל יחידה לחצי — 21,646 תווי טקסט של יחידות הפכו ל-10,986, והיחידה הארוכה ביותר ירדה מ-1,513 ל-622. זה שכתב בשקט את ה-fixtures שכל מטרתם היא אורך. jusText, שהתנהגותו היא cliff של אורך, ירד רק בגלל זה מ-19 מתוך 22 ל-6 מתוך 22. אילו הייתי מפרסם את הגרסה החצויה, המספר של jusText היה שגוי פי שלושה, בכיוון שמציג אותו כספרייה גרועה יותר.
הבעיה השנייה: גיוס כל היחידות מאותו corpus משותף החזיר את צפיפות ה-stopwords, אבל הרס את התכונה שעליה הציונים ברמת הטוקן מסתמכים. אוצר המילים של המאמר ושל ה-boilerplate חייב להיות מופרד, אחרת "טוקנים שחולצו שהם טוקנים של boilerplate" סופרים את המילה the. בעשר מתוך 22 fixtures נוצרה חפיפה בין אוצרי מילים, לעומת אפס במקור. הפתרון היה להוסיף סיומת למילות התוכן של כל יחידה ולהשאיר את מילות התפקוד כמו שהן — stopwords אמיתיות עבור הספריות הלקסיקליות לספירה, ואוצר תוכן נפרד למדד.
זו גם הסיבה לכך שעמודות הטוקנים כאן נקראות content_token_* ולא ממוחזרות מהמספרים שפורסמו בעבר ל-Readability מול trafilatura. זה מדד אחר, שנמדד רק על מילות תוכן, וציטוט שלו כאילו היה אותו הדבר היה שגוי.
בזמן הבנייה מחדש עלה גם משהו נוסף שלא היה באשמתי: בשלושה fixtures של link-density, ה-</a> יושב בתוך מילה — <a href="/x">zzsibp015qlhf zzsi</a>bp015qbht — כי ה-anchor מוקם לפי היסט תווים כדי לפגוע ביחס מדויק. הטקסט המוצג לא משתנה, כך שהציון המקורי לא שם לב, אבל כל extractor שעובד לפי אלמנט ולא לפי רצף טקסט רואה שני שברים במקום מילה אחת. תוקן, עם delta של התו המקושר שנרשם במקום להיבלע בשקט.
מי צריך להשתמש במה
מאכילים מודל ומשלמים לפי טוקן? newspaper4k או goose3. שניהם הדליפו אפס יחידות boilerplate ואפס טוקנים מזהמים. newspaper4k אם אתם רוצים תשובה בכל עמוד; goose3 אם עדיף לכם שקט על פני ניחוש, ויש לעמודים שלכם פסקאות.
ממטבים נתיב Python שרגיש ל-latency? שווה לכלול את resiliparse בבדיקת ההשוואה. היו לו ערכי ה-import וה-extraction החציוניים הנמוכים ביותר כאן, והוא התקרב ל-trafilatura באיכות — אבל רק עם main_content=True, שאינה ברירת המחדל. בדקו קודם פריסות כבדות-רשימות, ואל תהפכו את הזמנים המקומיים האלה ליחס מהירות מדויק בין ריצות שונות.
ארכוב, או כל דבר שבו החמצת תוכן גרועה מעודף תוכן? Readability. היא היחידה שהחזירה כל יחידת מאמר בכל fixture, ו-35 טוקנים תועים הם מחיר זול אם החלופה היא לאבד פסקה.
עבודה רב-לשונית? jusText הוא מועמד שכדאי לכלול כי הוא מגיע עם stoplists לשפות. המחקר הזה לא בדק חילוץ רב-לשוני, כך שהתכונה הזו היא סיבה לבחון אותו, לא הוכחה שהוא מנצח. בדקו את length_high מול אורכי פסקאות מייצגים.
כל דבר שאינו מאמר? אף אחד מהם. כולם בנויים על ההנחה שיש בעמוד גוף פרוזה מרכזי אחד, ועמוד מוצרים, תוצאות חיפוש או dashboard שוברים את ההנחה הזו בדרכים שאף פרמטר לא מתקן.
איפה API מנוהל נכנס לתמונה
כל מה שלמעלה הוא ספרייה שאתם מריצים: אתם מספקים HTML ומקבלים טקסט. מצבי הכשל הנצפים משתנים לפי צורת העמוד, לכן צריך לאמת את ברירות המחדל שבחרתם מול ה-corpus שלכם. חילוץ שדות מובנים ו-fetching/rendering לא נכללים בהשוואה הזו.
הערת מחבר: Thunderbit הוא השירות המנוהל שלנו לזרימות עבודה מסוג URL-in ולפלט מובנה. הוא לא הורץ על פני ה-fixtures האלה, כך שלא משתמעת שום השוואת איכות. קו ההחלטה הרלוונטי הוא האם כבר יש לכם HTML ואתם רוצים מחלץ טקסט מקומי, או שאתם רוצים ש-fetching/rendering והתפעול ינוהלו על ידי שירות.
הניסוח הכנה: אם כבר יש לכם HTML ואתם רוצים טקסט, אחת משש הספריות האלה היא חינמית וטובה, והטבלה הזו אומרת לכם איזו. אם אתם מבצעים fetching של עמודים בקנה מידה גדול, או שאתם רוצים שורות במקום פרוזה, זה רכישה אחרת.
אם אתם בוחרים במקום זאת בין fetchers מנוהלים, ה-web scraping API roundup שלנו מסכם את התחום הזה, ו-ההשוואה עלות של SEO ו-API-ים לנתונים שלנו מפרטת מה הם גובים. בצד של self-hosted, ה-pillar of open-source scrapers נותן תמונה רחבה יותר, ואם מה שאתם באמת צריכים הוא Markdown ולא plain text, המרת HTML ל-Markdown ב-Python היא המקום שבו רוב האובדן קורה.
נסו את Thunderbit לחילוץ נתונים מהאינטרנט
פסק הדין
אין מנצח, וטבלה שתכריז על אחד כזה הייתה משקרת לגבי trade-off אמיתי.
בנו קורפוס קבלה קטן לפני הבחירה: כללו מאמרים שמורכבים רק מרשימות, פסקאות קצרות, אחים של promo, עמוד כמעט ריק, ודוגמאות שבהן עדיף לא לקבל כלום מאשר זיהום. דרגו בנפרד את שחזור התוכן, דליפת ה-boilerplate, ואי-מענה. על ה-fixtures האלה, Readability העדיפה recall, newspaper4k הפיקה את השורה המאוזנת ביותר, ו-resiliparse הייתה מועמדת ל-latency עם עיוורון לתוכן רשימתי; התוויות האלה לא צריכות לעבור מעבר לצורות שנבחנו בלי אימות.
מה שהייתי אומר לכם בפועל צר יותר מכל זה: הריצו את ה-fixtures מול צורות העמודים שלכם לפני שבוחרים. שתיים מתוך שש הספריות לא יכלו לראות את ה-testbed שהתחלתי ממנו, ואחת מהן קיבלה recall מושלם שהסתיר כישלון מוחלט. טבלת השוואה היא נקודת פתיחה לזה, לא תחליף.
נסו את Thunderbit לחילוץ נתונים מהאינטרנט Get Started Free
שאלות נפוצות
האם המספרים האלה ניתנים להשוואה ל-benchmarks שפורסמו עבור הספריות האלה? לא, ולא הייתי מצטט אותם כך. אלה fixtures מבוקרים עם יחידות סינתטיות אך מתויגות, כך שכל שש הספריות ראו בדיוק את אותם bytes וההשוואה ביניהן הוגנת. מדדים שפורסמו, כמו ה-benchmark של article-extraction ב-scrapinghub, משתמשים בקורפוסים מהעולם האמיתי, שמודדים משהו אחר וקשה יותר. השתמשו בטבלה הזו כדי להשוות בין שש הספריות האלה, לא מול מספר מתוך מאמר.
למה שיעור הדליפה של Readability גבוה כל כך מזה של trafilatura אם שתיהן מבוססות DOM? בגלל המקום שבו כל אחת מהן מציבה את הגבול. שלוש מתוך ארבע הדליפות של Readability הן בלוקים של promo מסווגים-neutral שיושבים כאחים של המאמר, וההיוריסטיקה שלה לצירוף אחים מושכת אותם פנימה מתוך הנחה שתוכן סמוך, ארוך ובעל קישוריות נמוכה, הוא כנראה חלק מהסיפור. לעיתים זה נכון. ב-fixtures האלה זה promo. trafilatura מחמירה יותר לגבי מה שהיא מצרפת ולכן דלפה רק אחת מהיחידות האלה.
האם אפשר לסמוך על מספרי ה-precision של goose3 ו-jusText? רק יחד עם מספר הדגימות. שניהם קיבלו ציון על 10 מתוך 11 ה-fixtures שיש בהם גם article וגם boilerplate, כי הם לא החזירו כלום באחד מהם, ו-fixture בלי פלט לא תורם לשום צד של היחס. ה-1.0000 precision של goose3 אמיתי עבור העמודים שבהם הוא ענה; ה-0.8243 recall שלו על פני כל 22 ה-fixtures הוא החצי השני של אותה עובדה.
האם סף האורך של jusText חשוב בעמודים אמיתיים?
זה תלוי לחלוטין באורכי הפסקאות שלכם. כתבת חדשות עם פסקאות של 300 תווים תעבור את length_high כבר בפסקה הראשונה ותתנהג כרגיל — זו הסיבה ש-jusText החזיר 1,190 תווים נקיים בעמוד אמיתי בברירת המחדל. עמוד של פסקאות קצרות, פריטי רשימה או תיאורי מוצרים עלול לא לחצות אותו אף פעם, ואז jusText יחזיר מחרוזת ריקה במקום תשובה חלקית. הגדירו אותו במפורש במקום לגלות זאת בפרודקשן.
מה לא נבדק כאן? עמודים אמיתיים, בכלל. חילוץ רב-לשוני, למרות ש-stoplists הן נקודת המכירה העיקרית של jusText. זיכרון תחת עומס. כל עמוד שאינו מאמר — בלי רשימות מוצרים, בלי תוצאות חיפוש, בלי dashboards. מקרי קצה של קידוד. ושני האקוסיסטמים, Node ו-Python, הושוו כאן לפי התנהגות הספרייה ולא לפי ביצועי runtime, ולכן צריך לקרוא את מספרי המילישניות מעבר לגבול הזה כ-order of magnitude ולא כיחסים מדויקים.




