
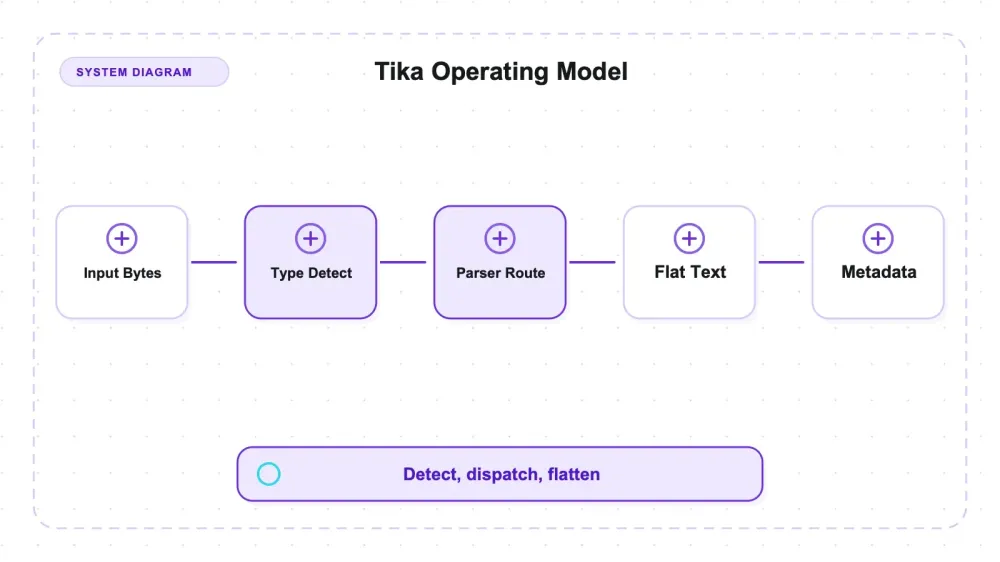
Apache Tika הוא ערכת הכלים של Apache Software Foundation לניתוח מסמכים: תנו לו קובץ כמעט מכל סוג, והוא יחזיר טקסט רגיל יחד עם מילון מטא־דאטה מנורמל. ה-project README מצהיר על תמיכה ביותר מאלף סוגי קבצים, ו-Tika מגיע לזה בכך שהוא אורז בתוכו את ספריות המומחיות עצמן — PDFBox ל-PDF, Apache POI למסמכי Office, jsoup ל-HTML, וקורא ODF ל-ODT — כך שכל החבילה מגיעה כ-jar אחד גדול, בלי צורך למשוך שום דבר בזמן הניתוח. בשרשרת עיבוד נתונים הוא השלב הלא־נוצץ שבתחילה: הרכיב שעומד לפני אינדקס חיפוש, סט ביקורת ל-e-discovery, או קורפוס ל-LLM, והופך ערימה הטרוגנית של קבצים למשהו אחיד. בעצם, שתי משימות — להבין מהו זרם הבייטים באמת, ואז להוציא ממנו את הטקסט והמטא־דאטה.
זה אחד הכלים הכי לא תובעניים שהתקנתי כבר הרבה זמן. jar אחד, java -jar tika-app-3.3.2.jar --text file.pdf, בלי קובץ קונפיגורציה, בלי משקלי מודל, בלי שלב התקנה נוסף, והוא פשוט רץ נקי על JDK חדיש במיוחד, שבאותו יום עצר כלי Java אחרים על אותו מחשב. אבל בדיקת היקף התמיכה לא הייתה מה שרציתי לבדוק; שאלת הבדיקה שלי הייתה צרה יותר. כשקלט משקר לכם, מה Tika באמת עושה? לכן בניתי סט fixtures מבוקר שבו כל בלוק תוכן נושא טוקן סימון ייחודי, רנדרתי את אותו מסמך לוגי לתשעה פורמטי מעטפת שונים, ואז תקפתי את כולם עם סיומות שגויות, סיומות חסרות, בלי שמות קבצים בכלל, קבצי אפס בייט, ובינאריים שנחתכו באמצע.
החלק המעניין באמת הוא הזיהוי. שיניתי את שם ה-PDF ל-.txt ושאלתי את Tika מה זה; הוא אמר application/pdf. אחר כך מחקתי לגמרי את שם הקובץ, העברתי את הבייטים הגולמיים ב-stdin, וקיבלתי אותה תשובה. על פני חמשת הפורמטים שניתן לזהות לפי התוכן בסט שלי, זה החזיק בכל 20 המצבים הלוגיים הייחודיים: שלושה מצבי שם קובץ ועוד מצב אחד בלי שם קובץ לכל פורמט. ההרצה ביצעה את מקרה ה-stream שלוש פעמים תחת תוויות שונות, וכך התקבלו 30 הרצות גולמיות מוצלחות, אבל החזרות האלה אינן ראיה בלתי־תלויה. PDF ו-RTF חושפים בייטים מזוהים; DOCX חושף את המכולה שלו; HTML ו-XML ניתנים לזיהוי דרך ה-markup או תוכן השורש. מנגנונים שונים, תוצאה שימושית זהה בסט הזה: הסיומת לא גברה על התוכן. ואז יש את משטר משפחת הטקסט, שבו Markdown קורס ל-text/plain ברגע שהשם שגוי או נעלם. הזהות שלו כאן נשענה לגמרי על .md.
שני גבולות לכל מספר שיבוא אחר כך. בדקתי את Apache Tika 3.3.2 — וב-27 ביולי 2026 הוא עדיין היה הגרסה היציבה החדשה ביותר; ענף 4.0.0 קיים רק כבנויי alpha ו-beta ב-Maven Central. הפרויקט עמד אז על בערך 3.9 אלף כוכבי GitHub, והוא ברישיון Apache-2.0, כלומר כמה שניתן להיות לא־מטריד מסחרית מבחינת רישוי. ולא בדקתי OCR בכלל. לא עמוד סרוק אחד, לא PDF אחד שמבוסס רק על תמונה. Tesseract ו-poppler לא מותקנים על המכונה שעליה הרצתי את זה, ולכן כל נתיב OCR נחסם עוד לפני שהתחיל. אין כאן מספרי OCR כי אין כאן מספרי OCR, נקודה.
מה Tika הוא באמת, אחרי שמפסיקים לקרוא את השיווק שעל הקופסה
ההנחה הרווחת היא ש-Apache Tika הוא ממיר מסמכים — מזינים לו DOCX ומקבלים בחזרה Markdown נקי, עם כותרות וטבלאות שנשמרו. הוא לא זה, וככל שזה ברור יותר, כך הכלי נראה טוב יותר.
המסלול שנבדק כאן כולל שלושה שלבים רלוונטיים: מזהה סוג תוכן, dispatcher שמעביר את הבייטים ל-parser המתאים, ומטפל הפלט של ה-CLI ב---text, שמוציא טקסט שטוח לצד מטא־דאטה שניתן לקבל בנפרד. בחוזה הפלט הזה אין אובייקטי Title, אין ListItem, ואין שחזור של רשת טבלאית. ל-Tika יש גם handlers ו-APIs אחרים, כולל פלט מבוסס XHTML/SAX; אותם לא בדקתי. לכן כל מסקנת מבנה בהמשך מתייחסת ל-tika-app --text, ולא לטענה שאין ל-toolkit זרם אירועים מובנה בשום מקום.
זה נשמע כמו מגבלה, ובמובן אחד אכן כך. אבל זה גם אומר של-Tika אין מה לסווג לא נכון, וזה בדיוק הטרייד אוף שכלים רועשים יותר עושים בכיוון ההפוך.
הזיהוי עצמו רץ לפי סדר מתועד: קודם בייטים חתימתיים, אחר כך בדיקת שורש XML, אחר כך גלוב של שם הקובץ, ורק לבסוף כל טיפוס שסיפקתם בעצמכם (תיעוד הזיהוי של Tika מפרט את זה). רק אחרי שהטיפוס נפתר, ה-dispatcher מעביר את הבייטים ל-parser התואם שמגיע עם החבילה — PDFBox, POI, jsoup, ו-TextAndCSVParser למשפחת הטקסט.
הפיצול הזה בין זיהוי לניתוח אינו פרט פנימי חסר חשיבות. הוא הסיבה לכך שקובץ שבור מכדי להיפרס עדיין יכול להיות מזוהה נכון — וזה הופך להיות הטריק המעשי ביותר ש-Tika מציע ברגע שהדברים מתחילים להישבר.
ההגדרה: jar אחד, פקודה אחת, ו-JVM שלא עושה עניינים
ההתקנה היא הורדה. tika-app-3.3.2.jar מ-Maven Central שוקל בערך 67 MB — jar גדול שמאגד את כל ה-parsers — ואחר כך פשוט מריצים java -jar tika-app-3.3.2.jar --text file.pdf. בלי קובץ קונפיגורציה, בלי משקלי מודל, בלי שלב post-install, בלי שרשרת brew install ארוכה.
סיפור ה-JDK הפתיע אותי. הרצתי את כל זה על OpenJDK 26.0.1, גרסת non-LTS חדישה, ו---version, --text, --metadata, ו---detect כולם חזרו עם exit 0 בלי תלונות תאימות. חשוב לציין את זה, כי באותו מחשב ובאותו זמן בחנתי גם את Apache Nutch, ומחזור ה-crawl שלו פשוט לא רץ בכלל על JDK 26 — הוא צריך LTS ב-21 או נמוך יותר, בגלל הסרת SecurityManager בגרסאות JDK חדשות. Tika לא התרגש. אם נמנעתם מכלי JVM בגלל כאב מהסוג הזה, כאן זה לא המקום שבו תיפלו.
שתי מסקנות כנות על ההגדרה. ה-CLI יוצר JVM חדש לכל הרצה, כך ש-cold start הוא עניין אמיתי — 131 הרצות בהרצת הבדיקה שלי לקחו בערך דקה, רובה חימום JVM. אם אתם מעבדים קבצים בהיקף, תרצו את הספרייה או את מצב השרת, לא לולאת shell על ה-jar. ולסיפור “ללא תלויות” יש קצה חד: חילוץ טקסט משכבת הטקסט של PDF לא צריך שום דבר חיצוני, אבל OCR כן צריך tesseract ו-poppler. PDF עם שכבת טקסט, DOCX, ODT, RTF, HTML, XML, TXT, Markdown ו-CSV כולם נפרסו על מארח שלא מותקן עליו אף אחד מהם. מסמכים סרוקים לא היו עוברים, ולא ניסיתי להעמיד פנים אחרת.
הניגוד הזה חד עוד יותר מול ספריית האחות שבדקתי באותו יום, unstructured, שבה הנתיב ל-PDF אלקטרוני נחסם לגמרי כי ייבוא מודול ה-PDF מושך את ערימת ה-inference (torch וחבריו) בזמן ה-load — עוד לפני dispatch של אסטרטגיה, כך שאפילו אסטרטגיית "fast" לא תיטען בלעדיהם. Tika חילץ את שכבת הטקסט של אותו PDF עם java -jar פשוט.
מבחן הסיומת השקרית: זיהוי mime שמתעלם מהשם שנתתם לקובץ
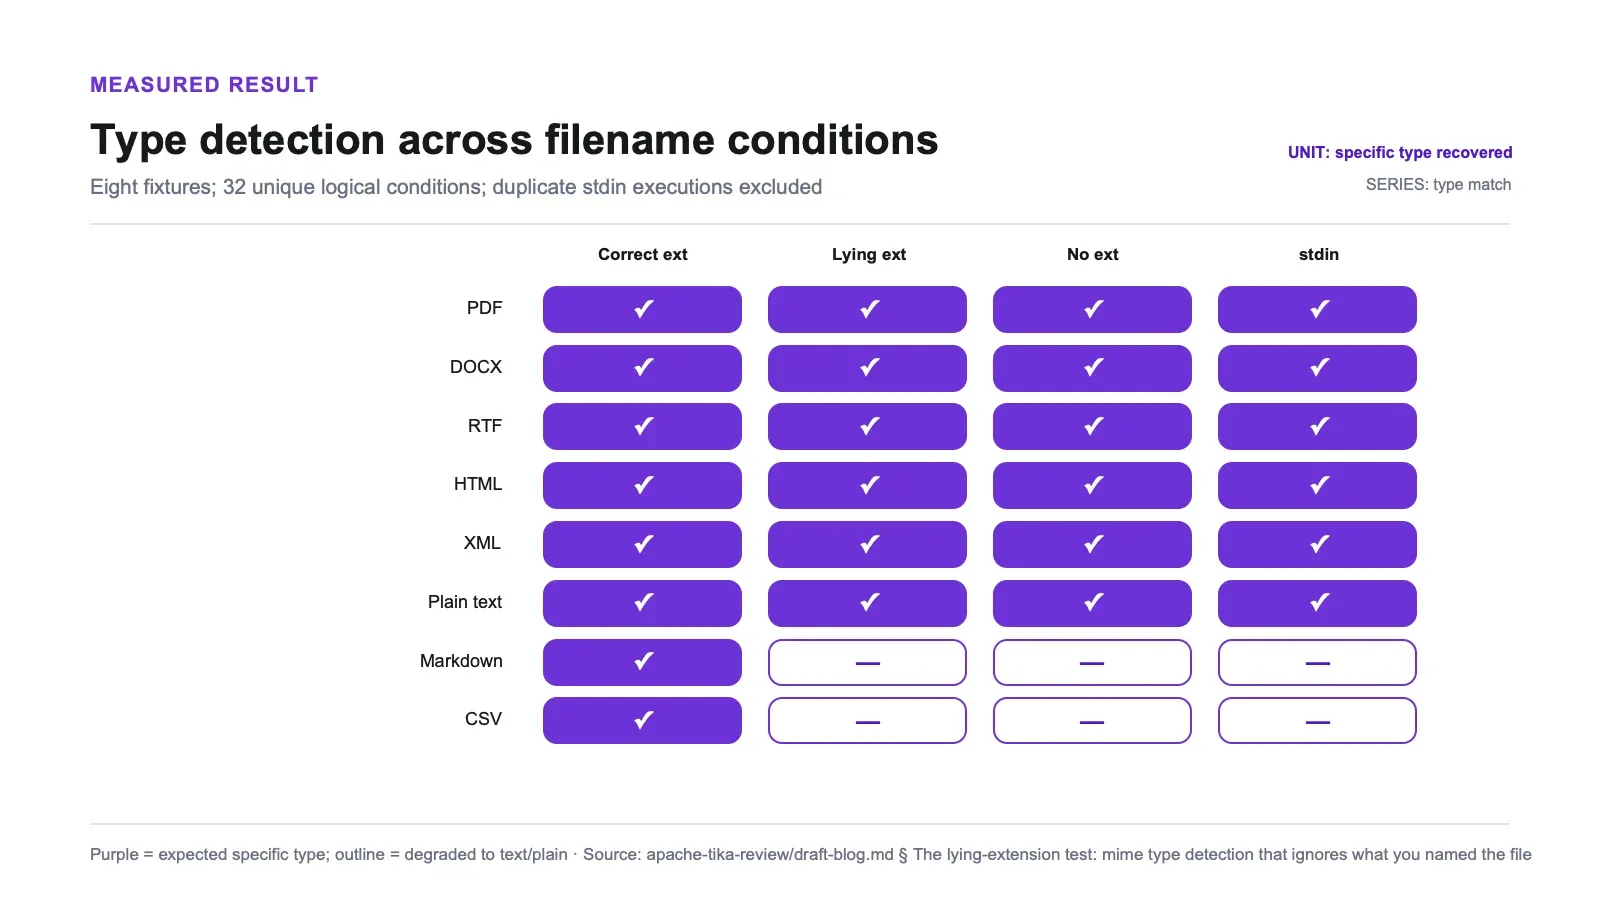
שמונה פורמטים, כל אחד מוצג עם סיומת נכונה, סיומת שגויה במכוון, או בלי סיומת, ובנוסף זרם בייטים בלי שם קובץ ב-stdin. זה 32 מצבים לוגיים ייחודיים. ההרצה המקורית של ההרכב ביצעה גם את אותם בייטים של ה-stream פעם אחת תחת כל תווית שם קובץ, וכך התקבלו 48 הרצות גולמיות; שלוש שורות ה-stream מתלכדות למצב אחד כי ל-stdin אין שם קובץ.
| Fixture | הסוג האמיתי | שונה ל- | סיומת נכונה | סיומת שקרית | בלי סיומת | Stream גולמי, בלי שם קובץ |
|---|---|---|---|---|---|---|
application/pdf | .txt | ✅ | ✅ | ✅ | ✅ | |
| DOCX | OOXML wordprocessingml | .jpg | ✅ | ✅ | ✅ | ✅ |
| RTF | application/rtf | .html | ✅ | ✅ | ✅ | ✅ |
| HTML | text/html | .csv | ✅ | ✅ | ✅ | ✅ |
| XML | application/xml | .txt | ✅ | ✅ | ✅ | ✅ |
| טקסט רגיל | text/plain | .pdf | ✅ | ✅ | ✅ | ✅ |
| Markdown | text/markdown | .pdf | ✅ | ❌ text/plain | ❌ text/plain | ❌ text/plain |
| CSV | text/csv | .txt | ✅ | ❌ text/plain | ❌ text/plain | ❌ text/plain |
(עמודת ה-stream מאחדת את כל שלושת מצבי הסיומת, כי בלי שם קובץ אין לגלוב שום דבר לקרוא.)
חמשת הפורמטים שניתן לזהות לפי התוכן — PDF, DOCX, RTF, HTML ו-XML — פגעו בטיפוס הנכון ב-20 מתוך 20 מצבים לוגיים ייחודיים (ו-30 מתוך 30 הרצות גולמיות, כולל הרצות stream כפולות). PDF שנקרא report.txt נשאר PDF. DOCX שנקרא photo.jpg נשאר DOCX. אף אחד מהם לא היה צריך שם קובץ. זה לא אומר שכולם משתמשים בחתימות בייט קבועות: ל-PDF ו-RTF יש headers מזוהים, DOCX הוא מכולה מבוססת ZIP, ו-HTML/XML מזוהים מתוך markup או תוכן השורש. מנגנונים שונים, תוצאה שימושית זהה בסט הזה: הסיומת השקרית לא ניצחה.
ואז יש את משטר משפחת הטקסט. Markdown נפתר ל-text/markdown רק כשהסיומת .md הייתה קיימת וקריאה. שנו לו את השם, הסירו את הסיומת, או שלחו אותו כ-stream, והוא הידרדר ל-text/plain במבחן הזה. CSV התנהג באותה צורה ברשת הקטנה והמכוונת הזו: text/csv הגיע רק דרך הגלוב של .csv. אם סופרים מצבים לוגיים ייחודיים, Markdown ו-CSV נפתרו כל אחד לטיפוס הספציפי שלו באחד מארבעה מצבים; טקסט רגיל כבר היה text/plain, כך שלא היה ממה “להתכווץ”. הרצת ה-48 גולמית עדיין שימושית כתיעוד לשחזור, אבל לא כמכנה גדול יותר.
פרט אחד כן פועל לטובת Tika כאן: גם הסיומת השקרית לא מנצחת. ה-fixture של Markdown ששונה ל-.pdf חזר כ-text/plain, לא כ-application/pdf. Tika לא האמין לשקר; הוא פשוט לא הצליח לאמת את האמת. ירידה לטיפוס האב היא כשל הרבה יותר טוב מאשר הצהרה בטוחה על משהו שגוי, והעובדה ש-text/markdown הוא תת־טיפוס מתועד של text/plain הופכת את ה-fallback הזה לעקרוני ולא שרירותי.
יש הסתייגות ספציפית לגבי CSV. ל-Tika יש מזהה CSV סטטיסטי, ובזמן הניתוח — כפי שאושר על ידי הופעת TextAndCSVParser בשרשרת X-TIKA:Parsed-By — הרשת הקטנה שלי של 2 עמודות על 3 שורות נפתרה ל-text/plain ולא ל-text/csv. זו תצפית אחת על fixture מכוון ומינימלי. CSV גדול יותר או כזה עם ציטוטים אולי כן יפעיל את המזהה. אני לא טוען שזיהוי CSV לפי תוכן שבור; אני טוען שבגריד הזה, הסיומת היא זו שיצרה את text/csv.
למה זה חשוב בצינור העלאה אמיתי
התרחיש המעשי הוא נתב העלאות. נגיד שאתם מקבלים העלאות ממשתמשים ומנתבים אותן לפי סוג: PDF ל-parser של חשבוניות, גיליונות אלקטרוניים למייבא החשבונות, וכל השאר לאינדקס טקסט. אם סומכים על הסיומת, מישהו שמעלה PDF בשם notes.txt נוחת בענף הלא נכון — וזו עוד הגרסה הנעימה; הגרסה העוינת היא קובץ polyglot עם סיומת ידידותית.
עבור ה-fixtures הבינאריים וה-markup שנבדקו כאן, Tika ניתב לפי תוכן גם אחרי שהשם נעלם, וזה שימושי כשאחסון אובייקטים או מטפל גוף HTTP כבר מחקו אותו. התוצאה הזו לא מכסה את הזנב הארוך של Tika, קבצים עמומים, או polyglots. ה-fixtures הטקסטואליים שנבדקו התנהגו אחרת: כשהצינור הסיר שמות קבצים, Markdown ו-CSV הגיעו כ-text/plain, ולכן חוקים שהתבססו על סוגי המדיה הספציפיים שלהם הפסיקו לפעול. שמרו את השם המקורי כמטא־דאטה נלווה במקום לצפות שזיהוי תוכן ישחזר אותו.
התוכן שהוטמע שרד. --text השטיח את המבנה.
נאמנות התוכן היא הציר השני, והוא מתפצל בבירור לשניים. רנדרתי מסמך קאנוני אחד (כותרות, שתי פסקאות גוף, רשימת תבליטים, רשימה ממוספרת, ופסקת סיום) ל-HTML, Markdown, טקסט רגיל, DOCX, PDF, RTF, ODT ו-XML, ועוד מסמך טבלה ל-HTML, Markdown, טקסט, DOCX, CSV ו-XML. ארבע־עשרה רינדורי מעטפת. כל בלוק נושא טוקן ייחודי — zztitle1, zzitem3, zztblcell_beta וכן הלאה — כך ש“שרד” לעומת “נעלם” הוא בדיקת substring מדויקת, לא שיקול דעת.
החזרת טוקני הסימון יצאה 1.000 בכל ארבעה־עשר הרינדורים. אף טוקן מוטמע לא נעלם: כל תא טבלה מסומן, פריט ברשימה וכותרת היו שם. שלוש חזרות מקומיות לכל מעטפת אחרי warmup החזירו פלט --text זהה ברמת הבייטים. האורקל הזה לא אומר דבר על תווים שלא סומנו, סדר, רווחים, נרמול Unicode, תוכן חוזר, קישורים, כותרות עליונות, הערות שוליים או אובייקטים מוטמעים. זו בדיקת נוכחות בלוקים, לא הוכחה לנאמנות מלאה של המסמך.
פלט הטקסט השטוח מוותר על רוב מבנה המקור.
כך נראה מסמך טבלת HTML שיוצא מ---text:
	Tool	Throughput

	zztblcell_alpha	120

	zztblcell_beta	95
שורות מחוברות בטאבים. שורת הכותרת לא מסומנת ככותרת. אין גריד, אין גבולות תא מעבר לטאב, ואין דרך לדעת שזה אי פעם היה <table>. גם טבלת DOCX משתטחת באותה צורה.
רשימות הן עניין עדין יותר, והן מתפצלות לפי מה שהמקור באמת הכיל:
| מה היה התבליט במקור | מעטפות | מה --text מחזיר |
|---|---|---|
תו מילולי — כל הרינדורים האלה כתבו - כטקסט אמיתי | טקסט רגיל, Markdown, RTF, ODT, PDF | ה-- נשאר, כי Tika רק מעביר תווים הלאה |
מבנה אמיתי — <li> ב-HTML, או סגנון List Bullet ב-DOCX | HTML, DOCX | הסימון נעלם לגמרי ומקבלים רק את הטקסט של הפריט: מוזח בטאב ב-HTML, שורה נקייה ופשוטה ב-DOCX |
Tika אף פעם לא ממציא מחדש סימון שלא קיבל כטקסט. אותו תוכן, פלט שנראה אחרת.
מקרה Markdown מציג את הנקודה בבירור. הזינו ל-Tika קובץ .md עם table מבוסס pipes, וה-pipes חוזרים מילולית, מה שנראה כמו שימור מבנה. אבל זה לא. Tika ניתח את זה כטקסט והחזיר את הבייטים. שום דבר לא הבין את הטבלה הזאת.
לכן החוזה שנמדד כאן צר יותר: כל טוקני הסימון שהוטמעו שרדו, אבל --text לא שימר אלמנטים מטיפוס מסוים ולא שחזר גריד טבלאי. לקרוא לזה פגם ב-parser היה מחמיץ את הנקודה. חילוץ שטוח נמנע במכוון מבעיית סיווג האלמנטים; באותה נשימה הוא גם לא יכול לספק צרכן downstream שצריך את טיפוסי האלמנטים האלה. אם אתם צריכים בלוקים מטיפוס מסוים או טבלאות משוחזרות, --text הוא רכיב אחד ב-stack, לא כל ה-stack. handlers אחרים של Tika עשויים לחשוף יותר מבנה, אבל הם היו מחוץ להרצה הזו.
הסתייגות סטנדרטית על כל מספרי הנאמנות כאן: הם מגיעים מ-fixtures סינתטיים מבוקרים על מכונה אחת, גרסה אחת, JDK אחד. הם מראים שהבלוקים המסומנים היו בפלט. הם לא מוכיחים שימור תו-לתו או דיוק על קורפוס אמיתי ומבולגן.
מטא־דאטה: מנורמל, ומסרב בנימוס להמציא
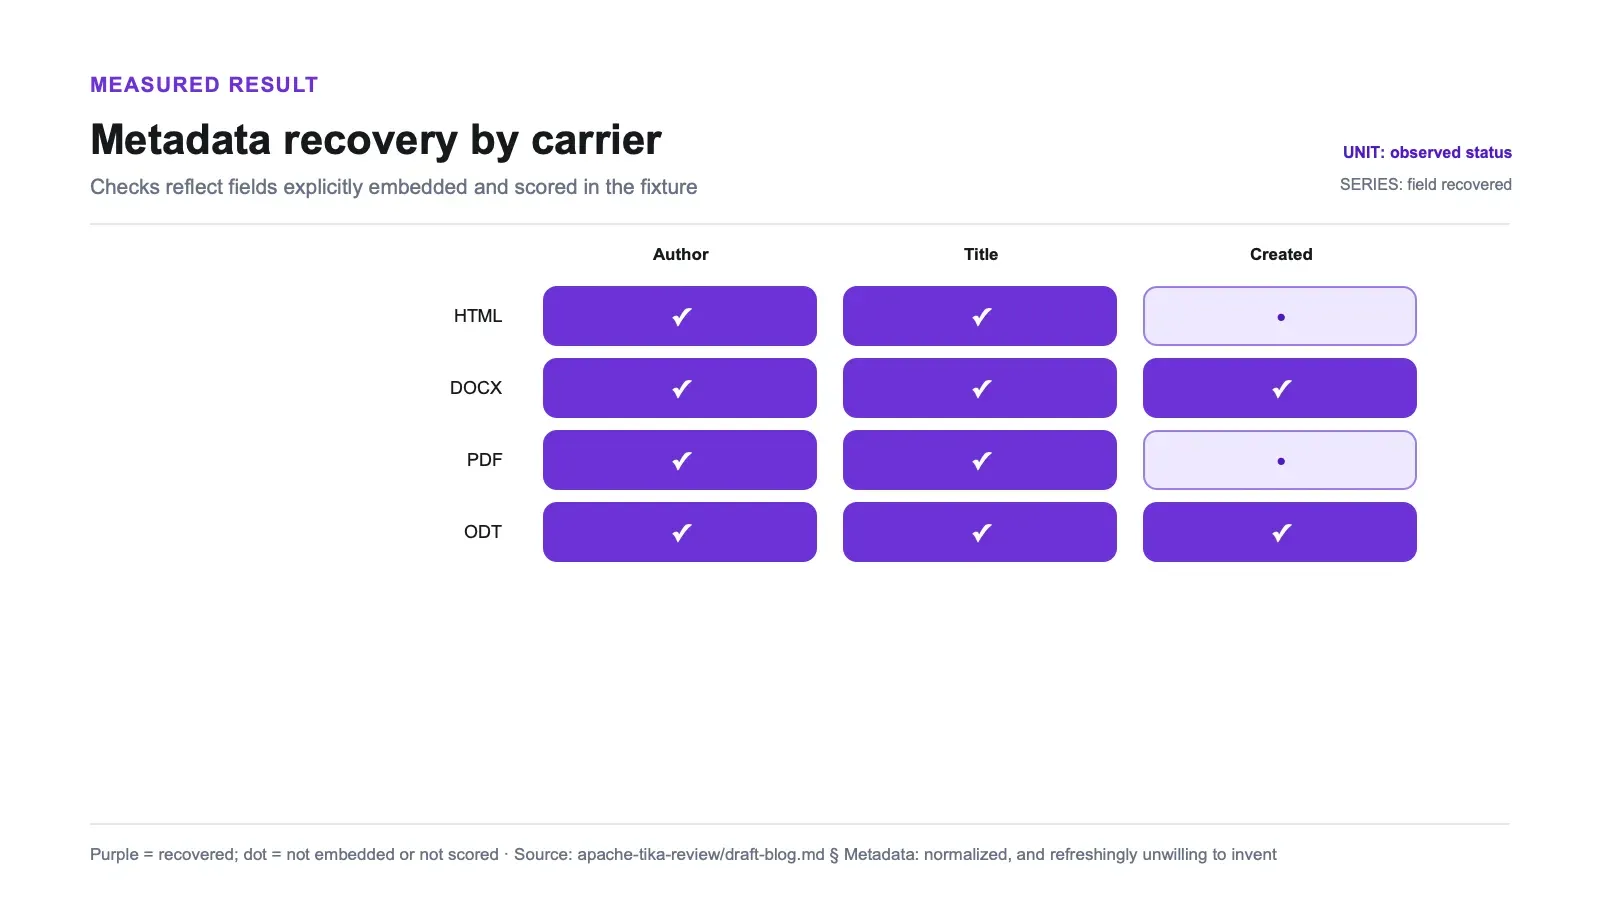
הטמעתי ערכים ידועים של author, title, ו-date יצירה בכל מעטפת שיש לה שכבת מטא־דאטה, ואז בדקתי מה חזר.
| מעטפת | author → dc:creator | title → dc:title | created → dcterms:created |
|---|---|---|---|
HTML (<meta name=author>, <title>) | ✅ | ✅ | לא הוטמע |
| DOCX (core properties) | ✅ | ✅ | ✅ מדויק 2021-03-15T09:30:00Z |
| PDF (info dict) | ✅ | ✅ | קיים, אבל זה היה ה-timestamp של ה-generator עצמו — לא נספר |
ODT (meta.xml) | ✅ | ✅ | ✅ מדויק 2021-03-15T09:30:00Z |
| TXT / MD / CSV / RTF / XML | אין שכבת מטא־דאטה | — | — |
Author ו-title הוחזרו ב-4 מתוך 4 המעטפות שיש להן מטא־דאטה, וזו הנקודה החשובה — הם מנורמלים. <meta name="author"> ב-HTML, property ליבה ב-DOCX, רשומת /Author ב-PDF, ואלמנט dc:creator ב-ODT כולם מגיעים תחת אותו מפתח dc:creator. כותבים צרכן אחד, לא ארבעה.
created הוא המקום שבו יש כשל אמיתי קטן. DOCX ו-ODT החזירו את חותמת הזמן המדויקת שהטמעתי ב-2021. ה-PDF החזיר תאריך יצירה, אבל זה היה התאריך שספריית ה-generator חותמת בזמן הבנייה, לא הערך שהתכוונתי להטמיע — לכן אני מסווג אותו כנוכח, לא כמשוחזר. והפורמטים בלי שכבת מטא־דאטה לא חשפו דבר, וזה בדיוק התשובה הנכונה. Tika לא מנחש author מתוך גוף הטקסט.
לשבור אותו בכוונה, והטריק לטריאז' שנובע מזה
ארבעה קלטים עוינים. קובץ אפס בייט. כותרת PDF תקינה עם גוף שנקטע. ZIP של DOCX שנחתך. וקובץ UTF-8 עם תווים מרובי־בייט בלי BOM ובלי הצהרת קידוד. אלה צורות fixture מקומיות, לא ספי סיבולת של Tika.
ה-harness הבסיסי, ה-fixtures שנוצרו, ה-JSON הגולמי, checksum של ה-jar, ו-manifest הסביבה לא מקושרים כאן לציבור, ולכן קורא חיצוני לא יכול לשחזר באופן עצמאי את המכנים המדויקים. התייחסו לטבלאות כהתצפיות שדווחו ולא כאל ראיות שניתנות לאימות על ידי צד שלישי.
| קלט | --text / --json | מה נזרק | --detect |
|---|---|---|---|
| קובץ 0-byte | exit 1, ללא stdout | ZeroByteFileException: InputStream must have > 0 bytes | exit 0 → text/plain עם filename, application/octet-stream מ-stream |
| PDF שנחתך | exit 1, ללא stdout | TikaException: TIKA-198: Illegal IOException from PDFParser | exit 0 → application/pdf |
| DOCX שנחתך | exit 1, ללא stdout | POI FATAL: "XML document structures must start and end within the same entity" | exit 0 → סוג OOXML |
| UTF-8, בלי BOM, בלי הצהרה | exit 0 | כלום | exit 0 → text/plain, charset UTF-8 |
החילוץ נכשל בקול רם, והכישלונות האלה חולקים את אותה צורה חיצונית. קובץ ה-0-byte, ה-PDF החתוך, וה-DOCX החתוך כולם יצרו חריגה, exit 1, ו-stdout ריק. ה-CLI לא בולע את הכשל לתוך תוצאה ריקה ומסודרת. זה בטוח תהליכית במקרים האלה — אין hang, אין segfault — אבל הקורא חייב לבדוק exit status ו-stderr ולא רק לחפש מחרוזת ריקה.
הזיהוי מנותק מהניתוח. בשני הקבצים הבינאריים שנחתכו, --detect החזיר exit 0 עם הטיפוס הצפוי מהתוכן ההתחלתי התקין; אחר כך ה-parser נכשל על הגוף השבור. לכן צינור יכול להשתמש בזיהוי כאות triage נפרד לפני או אחרי parse שנכשל. האם detect-first היא ברירת המחדל הנכונה תלוי במצב ההפעלה: המבחן הזה לא benchmark את detect-first מול parse-only, ושתי הרצות CLI טריות של JVM עשויות להיות עסקה לא נכונה בהיקפים גדולים.
זיהוי קידוד עובד. קובץ UTF-8 בלי BOM ובלי הצהרה פוענח כ-UTF-8, ו-日本語テスト עבר בשלמותו. הסתייגות קטנה למי שקורא את מילוני המטא־דאטה: ה-fixtures שלי שכוללים ASCII בלבד מדווחים charset=ISO-8859-1, מה שאי אפשר להבדיל בפועל מ-UTF-8 על בייטים של ASCII. זה לא פספוס, זו תוצאת תיקו.
Tika מול unstructured: אותם סוגי קבצים, עבודות שונות
שניהם נבחנו באותה סשן מחקר, אבל זו טקסונומיה של חוזי פלט, לא benchmark סימטרי. הכלים דורגו על תוצאות שונות.
סקירה קשורה: Unstructured review.
| Apache Tika | unstructured | |
|---|---|---|
| על מה מדדתי אותו | נאמנות תוכן: האם משהו נפל בדרך? | נאמנות סיווג אלמנטים: האם כל בלוק קיבל את הסוג הנכון? |
| תוצאה | כל טוקני הסימון שהוטמעו נשמרו בכל ארבעה־עשר הרינדורים | במבחן הסיווג הנפרד, טבלה בטקסט רגיל נתנה Table recall של 0.000, וכותרת אחת שכללה פועל סווגה כטקסט נרטיבי |
| אלמנטים מטיפוס מסוים שהוחזרו | אין — גם מבנה לא חזר | Title, NarrativeText, ListItem, Table — בדיוק מה ש-Tika מסרב לעשות |
| OCR | נחסם על המארח שלי, tesseract חסר | נחסם על המארח שלי, tesseract חסר |
פלט שטוח ששומר טוקנים מול אלמנטים מטיפוס מסוים עם שגיאות סיווג שנצפו. תבחרו לפי מה שהצרכן downstream צריך. אם זה אינדקס חיפוש או חלון הקשר של LLM, ייתכן שטקסט שטוח מספיק. אם הוא תלוי בסוג אלמנט, הנתיב של --text ב-Tika לא יכול לספק את החוזה הזה.
לאף אחד מאיתנו אין מספרים על מסמכים סרוקים.
יתרונות וחסרונות
יתרונות
- זיהוי סוג תוכן התעלם מסיומות שקריות ב-20/20 מצבים לוגיים ייחודיים על פני חמשת ה-fixtures שניתנים לזיהוי לפי תוכן; גם הרצות stream כפולות הסכימו.
- כל טוקן שהוטמע שרד בכל 14 הרינדורים של המעטפות, כולל תאי הטבלה המסומנים ופריטי הרשימות.
- חזרות מקומיות היו עקביות בשלוש הרצות חוזרות: כל מעטפת החזירה טקסט זהה ברמת הבייטים בתוך הסביבה הזו.
- המטא־דאטה מנורמל בין הפורמטים —
dc:creator/dc:title/dcterms:createdבלי תלות בפורמט המקור, ושוחזר ב-4/4 המעטפות שיש להן מטא־דאטה. - באמת בלי תלויות עבור הפורמטים שבדקתי: שכבת טקסט של PDF, DOCX, ODT, RTF, HTML כולם נפרסים מ-jar אחד בלי בינאריים חיצוניים.
- רץ נקי על OpenJDK 26 — בלי תלות ב-LTS בלבד.
- הזיהוי נשאר תקין (exit 0) גם על בינאריים שנחתכו, כך שיש לכם אות triage אמין כשה-parsing נכשל.
- Apache-2.0, בשל, ומתוחזק באופן פעיל.
חסרונות
- הזהות של Markdown ו-CSV תלויה לחלוטין בסיומת הקובץ; 10 מתוך 18 תאים בלי חתימה קורסים ל-
text/plainברגע שהשם נעלם או שגוי. --textלא מחזיר אלמנטים מטיפוס מסוים; גרידי טבלאות משתטחים לשורות מחוברות בטאבים, וסימוני מבנה של רשימות נעלמים.- החילוץ זורק חריגה על קלט ריק ופגום; שני המקרים נראים אותו דבר מקריאת החילוץ בלבד.
- jar בגודל 67 MB ועוד cold start של JVM לכל הרצה במצב CLI.
- OCR ו-PDFים של תמונות סרוקות כלל לא נבדקו כאן — tesseract ו-poppler לא היו מותקנים, אז אין כאן שום טענה לגבי הנתיב הזה.
- כל מספר כאן מבוסס על ground truth סינתטי על מכונה אחת, גרסה אחת. דיוק על קורפוס אמיתי, קבצים מוצפנים, מסמכים מוטמעים/רקורסיביים, ותפוקה בהיקף גדול לא נמדדו.
למי כדאי להריץ את זה, ולמי לא
Tika מתאים כשקלט הוא קבצים שכבר יש לכם והפלט צריך להיות טקסט ומטא־דאטה שמכונה יכולה לאנדקס. אינדוקס חיפוש, e-discovery, עיבוד ארכיוני, הזנת קורפוס ל-LLM, בניית שכבת ולידציה של סוג תוכן בצינור העלאה. הוא שימושי כשכבת triage ונרמול ראשונית לפני משהו חכם יותר: מזהים את הסוגים שנבדקו, מחלצים טקסט שטוח, ומעבירים הלאה עם בדיקות מפורשות לתוכן שהצינור שלכם לא יכול להרשות לעצמו לאבד.
דילגו עליו — או יותר נכון, אל תעצרו ב---text — אם אתם צריכים אלמנטים מטיפוס מסוים, טבלאות משוחזרות, או פריסת מסמך. דילגו עליו אם המסמכים שלכם הם סריקות, לפחות עד שתתקינו tesseract ותמדדו לבד, כי לי אין כאלה. לעבודה בהיקף, בצעו benchmark לספרייה או למצב השרת מול ה-CLI על מסמכים מייצגים. זמן העלאת תהליך היה מורגש בהרצת הקבצים הקטנים הזו, אבל תפוקה ועלות משאבים לא נמדדו.
הדבר שמכשיל הרבה אנשים: אם שכבת האחסון שלכם מסירה שמות קבצים ואתם מטפלים ב-Markdown או CSV, אל תסמכו על Tika שיבדיל אותם מטקסט רגיל. שמרו את השם המקורי.
חלופות, ואיפה Thunderbit נכנס
קודם כל מסגור הוגן, כי ההשוואה הכנה כאן היא על קלטים, לא על איכות. Tika הוא toolkit חינמי, Apache-2.0, שמתארח אצלכם ומיועד לניתוח קבצים. קבצים שיש לכם על הדיסק או ב-bucket. הוא לא מביא דפים מהרשת, לא מריץ JavaScript, לא מתעסק ב-anti-bot, ולא מעמיד פנים שכן.
זה הגבול שבו שירות ניהול extraction לרשת, כולל שלנו Thunderbit, עשוי להיכנס לארכיטקטורה: הוא מביא דפים חיים, בעוד Tika מנתח קבצים שכבר נמצאים ברשותכם. המאמר הזה לא ביצע benchmark לשירותים האלה מול Tika, והם לא תחליפים לאותו קלט.
החלוקה הנקייה: Tika למסמכים שכבר ברשותכם, API מנוהל להפקת תוכן לדפי רשת שצריך ללכת להביא. לא מעט צינורות מריצים את שניהם — crawling וחילוץ בצד ה-web, ו-Tika על קבצי PDF ו-DOCX שחוזרים.
אם אתם משווים מול עולם ה-open source הרחב יותר, כתבתי את ההשוואה המלאה של web scrapers בקוד פתוח, סקירה של פרויקטי הסקרייפינג השימושיים ביותר ב-GitHub, סקירת Crawl4AI מעשית על הגישה מבוססת הדפדפן ל-Markdown, וגם סקירה רחבה של כלי scraping. למסלול ללא קוד, יש גם מדריך על איך לגרד אתר באמצעות AI.
נסו את Thunderbit לחילוץ נתונים מהרשת
פסק דין
אז האם כדאי להשתמש ב-Apache Tika? כן, אם העבודה שלכם היא להפוך קבצים הטרוגניים לטקסט שטוח ולמטא־דאטה מנורמל, ואתם מאמתים את השדות או הסמנים שהצינור שלכם לא יכול להרשות לעצמו לאבד.
המזהה היה החלק החזק ביותר בהרצה הזו. הוא החזיר את הסוג הצפוי ב-20 מתוך 20 מצבים לוגיים ייחודיים עבור חמשת ה-fixtures שניתנים לזיהוי לפי תוכן, כולל streams בלי שם קובץ. כל טוקן מוטמע שרד לאורך ארבעה־עשר רינדורים, והפלט חזר בייט-בייט בשלוש הרצות חוזרות מקומיות. ראיה שימושית. עדיין ראיה סינתטית. עצם זה שזה נעשה מ-jar אחד על ה-JDK הזה, בלי בינאריים חיצוניים לנתיבים הלא־OCR שנבדקו, השאיר את ההטמעה נעימה ומשעממת.
אבל צריך לכייל את זה נכון. כל טבלה שמזינים לו חוזרת כשורות מחוברות בטאבים. כל סימון מבני של רשימה נעלם. Markdown ו-CSV מאבדים את הזהות שלהם ברגע שהשם נעלם. קבצים ריקים ופגומים זורקים אותו סוג כשל, ותצטרכו קריאה נפרדת ל-detect כדי להבדיל ביניהם. וב-OCR, השאלה שהרבה משתמשי Tika הכי אכפת להן, אין לי מה להציע: לא הצלחתי להריץ את זה, ואני לא מתכוון להעריך.
בתוך הקווים האלה, Tika עושה עבודה לא־נוצצת עם אמינות יוצאת דופן. הוא קורא את הבייטים, לא את התווית על הקופסה. רק אל תבקשו ממנו להגיד לכם באיזו צורה היו הבייטים.
נסו את Thunderbit לחילוץ נתונים מהרשת Get Started Free
שאלות נפוצות
האם Apache Tika מזהה סוגי קבצים נכון אם הסיומת שגויה?
עבור חמשת ה-fixtures שניתן היה לזהות לפי תוכן שנבדקו כאן, כן. PDF, DOCX, RTF, HTML ו-XML נפתרו לסוג המדיה הצפוי בכל 20 המצבים הלוגיים הייחודיים (30 הרצות גולמיות עם הרצות stream כפולות), כולל סיומות מטעות, בלי סיומת, ו-streams בלי שם קובץ. PDF שנקרא .txt עדיין זוהה כ-application/pdf. Markdown ו-fixture CSV הקטן היו תלויים במידע של שם הקובץ והידרדרו ל-text/plain כשהוא היה חסר או שגוי.
האם Tika שומר טבלאות ומבנה מסמך?
לא במצב --text שנבדק כאן. גרידי הטבלאות חזרו כשורות מחוברות בטאבים בלי סמנטיקה של תא או כותרת, וסימוני מבנה של רשימות (כמו <li> ב-HTML או סגנון List Bullet ב-DOCX) נעלמו. כל טוקן מוטמע שרד בכל 14 הרינדורים של המעטפות, אבל זה לא מוכיח נאמנות תוכן מלאה, ו---text לא מספק typing של אלמנטים. עבור אלמנטים מטיפוס מסוים או טבלאות משוחזרות, בדקו handler אחר של Tika או השתמשו בכלי אחר לצדו.
האם Apache Tika יכול לעשות OCR על PDFs סרוקים? Tika תומך ב-OCR דרך Tesseract, אבל לא בדקתי את זה, ושום תוצאה כאן אינה טענה לגביו. Tesseract ו-poppler לא היו קיימים על מארח הבדיקה שלי, לכן כל נתיב OCR וקובץ סרוק נחסמו לפני שהופעלו. אין כאן שום מספרי OCR. אם OCR הוא use case שלכם, התקינו tesseract ובצעו benchmark בעצמכם — התייחסו לחלק הזה של Tika כלא מאומת כאן.
מה Tika עושה עם קבצים ריקים או פגומים?
הוא נכשל בקול רם ולא בשקט. קובץ 0-byte זורק ZeroByteFileException; PDF חתוך זורק TikaException מתוך PDFParser; DOCX חתוך זורק שגיאת XML של POI. כל השלושה יוצאים עם exit 1 ו-stdout ריק, כך שקובץ ריק ופגום אינם ניתנים להבחנה מקריאת החילוץ לבדה. הזיהוי, לעומת זאת, נשאר יציב — --detect החזיר exit 0 עם הטיפוס הנכון בשני הקבצים הבינאריים שנחתכו, מה שהופך אותו לשלב triage אמין לפני שמשקיעים ב-parse.
מה בדיקות Tika לא כיסו? ארבעה דברים, במפורש. OCR ותמונות סרוקות (נחסם, לא נבדק). דיוק על קורפוס אמיתי — כל התוצאות הן fixtures סינתטיים מבוקרים עם טוקני סימון שהוטמעו, כך שהן מודדות נאמנות מול תוויות ידועות ולא דיוק על מסמכים אמיתיים מבולגנים. עלות משאבים, תפוקה, וזיכרון שיא, שלא נמדדו. והזנב הארוך של טענת "אלף סוגי קבצים": בדקתי תשעה פורמטים מייצגים ונטולי תלויות, לא את הקטלוג המלא. כל מה שמופיע כאן הוא Tika 3.3.2 על OpenJDK 26.0.1, macOS arm64, מכונה אחת.




