Extracteur Baidu pour les résultats de recherche et les articles









Transformez les résultats Baidu en données propres et exploitables
Conservez les résultats de recherche et les détails d’articles disponibles dans un seul tableau clair.
Nettoyez les données Baidu au fur et à mesure de la collecte
Thunderbit place les titres, URLs, extraits, dates et sources visibles dans des colonnes claires. Si un résultat n’affiche pas un champ, la cellule reste vide.

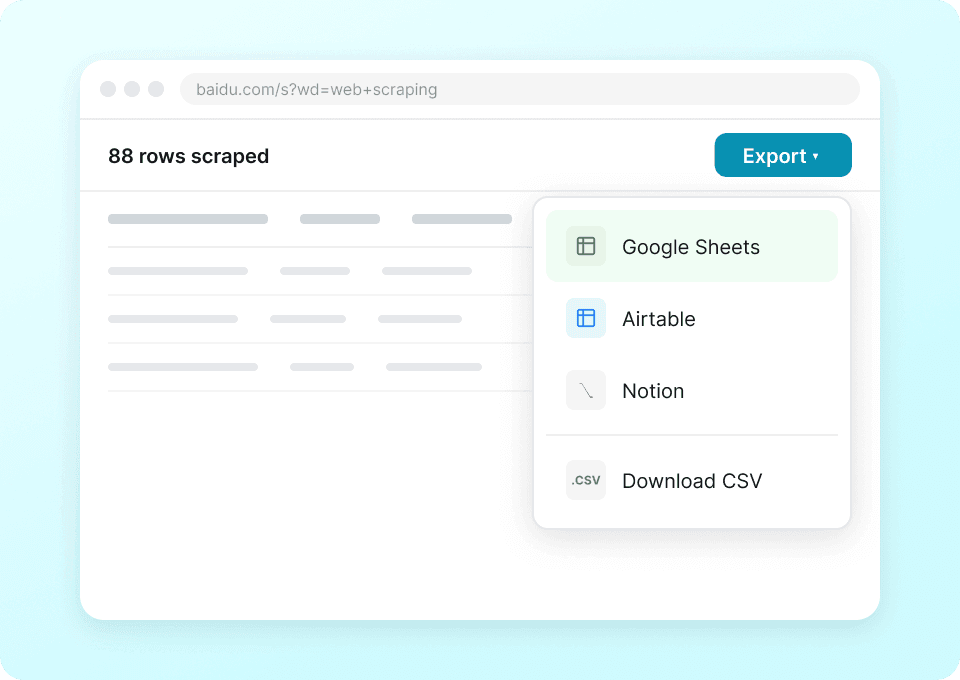
Exportez vos recherches Baidu en un clic
Envoyez chaque exécution vers une feuille de revue des résultats de recherche. Les rangs, sources, dates et détails des pages liées restent à côté du résultat Baidu correspondant.
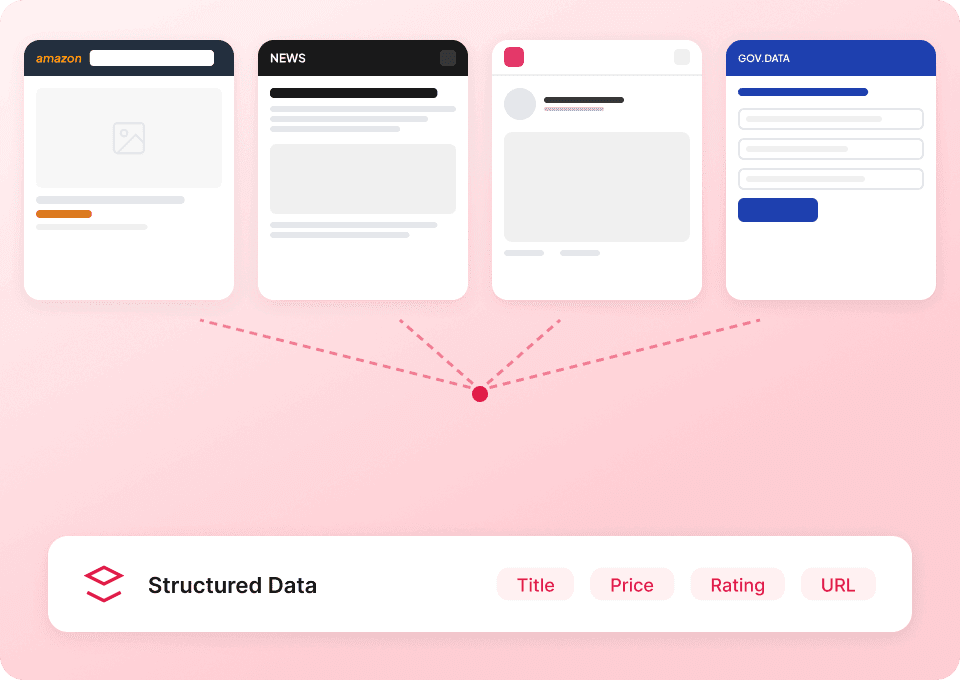
Utilisez le même workflow sur n’importe quel site
Thunderbit lit les champs par leur sens, et non selon une mise en page spécifique à Baidu. Utilisez la même approche sur n’importe quel site public accessible lorsque votre recherche vous mène vers une nouvelle source.
Gardez le contexte autour de chaque résultat Baidu
Une simple liste de liens fait perdre le contexte. Thunderbit conserve les détails visibles à côté de chaque résultat.
Liens copiés et notes dispersées
Les détails des résultats se séparentRecherche Baidu structurée
Le contexte visible reste attaché à chaque résultatQuelles données pouvez-vous extraire de Baidu ?
Choisissez parmi ces champs publics et visibles. Les modules de résultats et les pages liées n’affichent pas tous les champs pour chaque requête.
- Requête de recherche
- Rang du résultat
- Titre du résultat
- URL du résultat
- URL affichée
- Extrait du résultat
- Date du résultat
- Icône du site du résultat
- Expression de recherche associée
- Suggestion de correction
- Suggestion en pinyin
- Numéro de page des résultats
- Site source
- Domaine source
- Auteur de l’article
- Date de publication de l’article
- Résumé de l’article
- Nom du document
- Description du document
- Fil d’Ariane du document
- Genre du document
- Format de fichier du document
- Nombre de pages du document
- Heure d’envoi du document
- URL du document
- Type de contenu du résultat
- Miniature de l’image
- Miniature de la vidéo
- Adresse du lieu
- Module de fonctionnalités Baidu
See how researchers track Chinese search results
These user feedback videos show how people review Chinese search results, track sources, and check linked articles.
Questions sur la collecte des données de recherche Baidu
Les champs disponibles varient selon la requête, le type de résultat et les informations affichées sur les pages liées.
Continue from Baidu results to source-page research
Explore article and website scrapers when you need full page text or other details beyond the fields shown in Baidu results.
Extracteur Flixster
L’Extracteur Flixster de Thunderbit vous permet de récupérer facilement les données des classements du box-office et des cinémas à proximité sur Flixster. Grâce aux suggestions intelligentes de champs par IA, collectez rapidement les titres de films, recettes du box-office, notes, dates de sortie, noms et adresses de cinémas, ainsi que les films à l’affiche, pour vos analyses ou recherches.
En savoir plus ->
Extracteur olympustaff.com
L’Extracteur olympustaff.com de Thunderbit vous permet d’extraire facilement les listes de comics et les commentaires présents sur olympustaff.com. Profitez des suggestions intelligentes de champs pour collecter rapidement titres de comics, auteurs, dates de sortie et retours des lecteurs, que ce soit pour l’analyse ou la recherche. Parfait pour les marketeurs, chercheurs et créateurs de contenu souhaitant obtenir des données structurées depuis olympustaff.com.
En savoir plus ->
Extracteur Hatena
L’Extracteur Hatena de Thunderbit vous permet de collecter des données issues des blogs et listes de sujets Hatena grâce à des suggestions de champs intelligentes basées sur l’IA. Rassemblez titres de blogs, noms d’auteurs, dates de publication, résumés de contenu et sujets populaires pour vos besoins en recherche, marketing ou analyse de contenu. Parfait pour les marketeurs, chercheurs et créateurs de contenu souhaitant obtenir des données Hatena structurées.
En savoir plus ->
Extracteur namu.wiki
L’Extracteur namu.wiki de Thunderbit vous permet de collecter des données depuis namu.wiki, y compris les pages nécessaires et les discussions récentes. Grâce aux suggestions de champs alimentées par l’IA, rassemblez rapidement les titres de pages, URLs, dates de dernière modification, sujets de discussion et noms des participants pour vos recherches, la création de contenu ou l’analyse de communauté.
En savoir plus ->
Extracteur NetEase Music
L’Extracteur NetEase Music de Thunderbit vous permet de récupérer facilement des données à partir des résultats de recherche et des pages d’artistes sur NetEase Music. Grâce aux suggestions intelligentes de champs alimentées par l’IA, rassemblez rapidement titres de chansons, noms d’artistes, détails d’albums, durées et liens de morceaux pour vos analyses ou recherches. Parfait pour les analystes musicaux, les professionnels du marketing ou les passionnés souhaitant obtenir des données NetEase Music structurées.
En savoir plus ->
Extracteur QQ Music
L’Extracteur QQ Music de Thunderbit vous permet de récupérer facilement les données issues des résultats de recherche et des listes d’œuvres d’artistes sur QQ Music. Grâce aux suggestions intelligentes de champs, rassemblez rapidement titres de chansons, noms d’artistes, informations d’albums, dates de sortie et bien plus, pour vos analyses ou recherches. Parfait pour les analystes musicaux, les professionnels du marketing ou les passionnés souhaitant obtenir des données QQ Music structurées.
En savoir plus ->Prêt à booster votre extraction de données ?
Rejoignez plus de 200 000 professionnels qui utilisent déjà Thunderbit pour automatiser leurs workflows d'extraction web.
L’essai gratuit offre des crédits illimités pour 8 pages web.



