
TripAdvisor regroupe plus d’un milliard d’avis sur des millions d’annonces — hôtels, restaurants, attractions, visites — et presque toutes les entreprises du secteur que je rencontre veulent exploiter ces données. Le souci ? La protection anti-bot DataDome de TripAdvisor en fait l’un des sites les plus pénibles à scraper sur internet.
J’ai passé des années à développer chez Thunderbit des outils qui permettent aux équipes non techniques d’extraire des données web sans écrire de code, et TripAdvisor fait partie des sites les plus demandés par nos utilisateurs. Les retours sont toujours les mêmes : des CAPTCHA qui apparaissent après deux pages, des scripts qui cassent du jour au lendemain, des proxys qui font exploser les budgets.
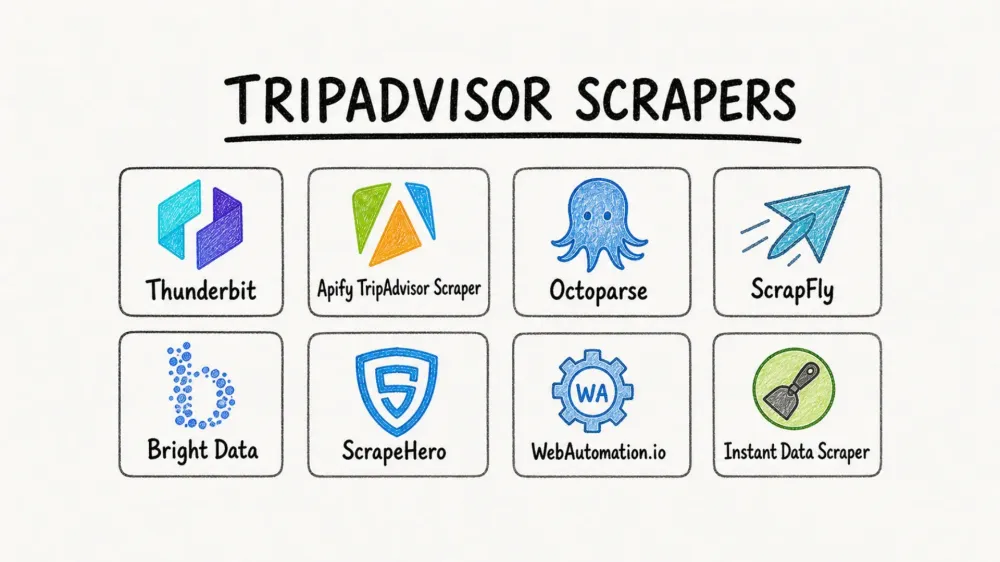
J’ai donc réuni cette comparaison de 8 extracteurs TripAdvisor qui donnent réellement des résultats en 2026 — évalués selon la simplicité d’utilisation, la gestion anti-bot, le prix, les formats d’export et les types de données pris en charge. Que vous soyez commercial en train de constituer une liste de prospects hôteliers ou analyste de données lançant une analyse de sentiment sur 10 000 avis, il y a ici l’outil qu’il vous faut.
Essayez Thunderbit pour extraire TripAdvisor
Pourquoi extraire des données TripAdvisor en 2026 ?
TripAdvisor n’est pas qu’un simple site d’avis. C’est une base de données structurée sur l’industrie mondiale de l’hospitalité, et les données qu’il expose ont une vraie valeur business pour une foule de cas d’usage.
Les hôtels affichent leurs prix, notes, équipements, types de chambres et sous-notes par catégorie (propreté, service, rapport qualité-prix, qualité du sommeil). Les restaurants exposent le type de cuisine, la fourchette de prix, les plats au menu, les horaires et les tags liés aux repas. Les attractions présentent les prix des billets, les conseils aux visiteurs, la durée estimée, et plus récemment des résumés d’avis générés par l’IA qui regroupent les opinions par thèmes.
Dans sa propre étude sur les voyageurs à la recherche d’hébergements, TripAdvisor indique que 76 % des acheteurs préfèrent les avis longs au moment de réserver, et que l’élément le plus important dans un avis est son contenu, à 40 %. Autrement dit, le vrai trésor n’est pas seulement la note en étoiles, mais bien le texte.
Voici un aperçu rapide de ce que les différentes équipes cherchent généralement à obtenir sur TripAdvisor :
| Cas d’usage | Données nécessaires |
|---|---|
| Surveillance des prix des concurrents | Prix des hôtels, notes, équipements |
| Suivi de la réputation de marque | Texte des avis, sentiment, sous-notes |
| Génération de leads (vente hôtelière) | Nom de l’entreprise, e-mail, téléphone, adresse |
| Études de marché pour la restauration | Type de cuisine, fourchette de prix, plats, avis |
| Recherche académique / tourisme | Notes des attractions, conseils visiteurs, prix des billets |
| Recherche pour le marketing de contenu | Langage authentique des clients dans les avis |
Le problème, c’est que tous les extracteurs ne gèrent pas TripAdvisor de la même façon. Les défenses anti-bot du site sont assez agressives pour que beaucoup d’outils échouent en silence — ils renvoient des données partielles, se font bloquer après quelques pages, ou exigent une configuration de proxys telle que la promesse du “sans code” s’évapore.
Le problème DataDome : pourquoi TripAdvisor est l’un des sites les plus difficiles à scraper
Si vous avez déjà essayé de scraper TripAdvisor et rencontré un CAPTCHA de type puzzle glissant après deux pages, vous avez croisé DataDome — le service anti-bot utilisé par TripAdvisor pour détecter et bloquer les accès automatisés, et il fait très bien son travail. Il ne vérifie pas seulement votre adresse IP : il examine les empreintes du navigateur (version, taille d’écran, polices installées), les empreintes matérielles (GPU, CPU), la manière dont vous répondez aux défis JavaScript et votre comportement (vitesse de défilement, mouvements de souris “humains”), avec en plus des limites de débit. Un simple script Python avec requests — voire même un navigateur headless — se fait bloquer presque immédiatement.
Deux questions reviennent à chaque fois qu’on nous parle de TripAdvisor : pourquoi le blocage arrive-t-il si vite, et existe-t-il une solution qui n’implique pas de payer des proxys et un solveur ?
La réponse honnête dépend de l’échelle. Pour quelques pages, une extension Chrome exécutée dans votre vraie session de navigateur peut contourner une grande partie de la détection, car elle ressemble à un utilisateur normal. Pour des milliers de pages, il faut de l’infrastructure — proxys rotatifs, solveurs de CAPTCHA ou un outil qui intègre tout cela en coulisses.
Voici comment les 8 outils de cet article se comparent sur la gestion anti-bot, avec un script Python “maison” pour référence :
| Approche anti-bot | Outils | Niveau de configuration | Coût récurrent |
|---|---|---|---|
| Intégrée (l’outil gère) | Thunderbit (Cloud), Apify, Bright Data, ScrapFly, ScrapeHero, WebAutomation.io | Faible | Inclus dans le plan |
| Intégrée, mais facturée à l’usage | Octoparse | Moyen | Le Standard couvre les proxys et la résolution de CAPTCHA ; au-delà du crédit additionnel du plan, les recharges coûtent 3 $/Go et 1 à 1,5 $ par 1 000 résolutions |
| Sans protection intégrée | Instant Data Scraper, Python DIY | Aucune pour Instant Data Scraper, élevée pour Python DIY | 0 $ jusqu’au blocage ; le DIY ajoute proxys et solveurs de CAPTCHA |
Thunderbit propose ici deux modes. Cloud Scraping s’exécute sur les serveurs de Thunderbit avec une gestion anti-bot intégrée pour les pages accessibles publiquement. Browser Scraping s’exécute dans votre propre session Chrome — comme il s’agit d’un vrai navigateur avec vos cookies et votre état de connexion, il peut contourner certaines détections qui piègent les bots headless. Pour la plupart des cas d’usage TripAdvisor, le mode Cloud est le chemin le plus rapide.
Ce qu’il faut rechercher dans le meilleur extracteur TripAdvisor
Avant d’entrer dans le détail des outils, voici la grille d’évaluation que j’ai utilisée. Ce sont les critères qui comptent vraiment quand vous choisissez un extracteur TripAdvisor — pas les slogans marketing, mais ce qui détermine si vous obtiendrez des données exploitables ou perdrez votre après-midi.
- Simplicité d’utilisation — Sans code, avec peu de code, ou code complet requis ? Si vous êtes dans une équipe commerciale et que vous avez besoin des données dans Google Sheets dès demain, un paramétrage de 4 heures n’est pas envisageable.
- Gestion anti-bot TripAdvisor — L’outil gère-t-il DataDome / CAPTCHA nativement, ou devez-vous fournir vos propres proxys et solveurs ?
- Types de données pris en charge — Hôtels uniquement, ou aussi restaurants, attractions et visites ? Beaucoup d’outils ne gèrent que les pages d’hôtels.
- Tarifs et offre gratuite — Quel est le vrai coût pour, par exemple, 10 000 avis ? Existe-t-il des crédits gratuits ou une version gratuite ?
- Formats d’export — CSV, JSON, Excel, Google Sheets, Airtable, Notion ? Moins il y a d’étapes entre l’extraction et le tableur, mieux c’est.
- Capacité d’échelle — Nombre maximal d’avis ou de pages par exécution, prise en charge de la pagination, et capacité à gérer les offsets de pages d’avis de type
or10sur TripAdvisor. - Enrichissement des sous-pages — Peut-il suivre des liens depuis une page de résultats vers les pages détaillées des hôtels/restaurants pour récupérer des données plus riches ?
- Idéal pour — Pour quel profil d’utilisateur l’outil est-il réellement adapté ?
Si vous êtes développeur et que vous construisez un pipeline sur mesure, vous pondérerez davantage la flexibilité de l’API et l’infrastructure anti-bot. Si vous êtes un utilisateur métier qui veut juste un tableur, les options d’export et la simplicité priment sur tout le reste.
8 meilleurs extracteurs TripAdvisor en un coup d’œil
Voici les 8 outils côte à côte. La colonne du coût correspond à ce que coûte réellement un mois à 10 000 avis sur chaque outil — sur la base de l’offre mensuelle la moins chère, après déduction de l’allocation gratuite déjà incluse ; le détail du calcul est expliqué plus bas.
| Outil | Simplicité | Gestion anti-bot | Types de données | Facture mensuelle (10K avis) | Formats d’export | Échelle | Enrichissement des sous-pages | Idéal pour |
|---|---|---|---|---|---|---|---|---|
| Thunderbit | Sans code (1 clic) | ✅ Intégrée (Cloud + Browser) | Hôtels, restaurants, attractions, visites | 288 $ ponctuels (30K crédits) ; Business si mensuel | Excel, CSV, Sheets, Airtable, Notion | 200 pages paginées et 2 000 URL par exécution (Pro) | ✅ 1 clic | Équipes non techniques, ventes, opérations |
| Apify | Low-code (interface de plateforme) | ✅ Intégrée | Hôtels, avis, restaurants, attractions | 29 $/mois (Starter, quel que soit l’actor) | JSON, CSV, Excel, XML, API | Élevée (actors cloud) | ⚠️ Dépend de l’actor | Équipes data, développeurs |
| Octoparse | Sans code (constructeur visuel) | ✅ Proxys + résolution de CAPTCHA inclus dans le plan | Hôtels, avis | 83 $/mois (Standard ; facturé par tâches, pas par lignes) | CSV, Excel, JSON, base de données | Exécution cloud + locale | ⚠️ Configuration du workflow | Fans de scrapers visuels |
| ScrapFly | Code (SDK/API Python) | ✅ API intégrée | Toute page TripAdvisor | 30 $/mois (Discovery, 200K crédits) | HTML/JSON brut (à parser soi-même) | Élevée (basée sur API) | Codage manuel | Développeurs Python |
| Bright Data | Low-code à code | ✅ Intégrée (400M+ proxys) | Hôtels, avis, jeux de données | 7,50 $ à l’usage (après 5K enregistrements gratuits) | CSV, JSON, API | Niveau entreprise | ✅ Scraper IDE | Grandes entreprises |
| ScrapeHero | Zéro configuration (géré) | ✅ Entièrement géré | Hôtels, avis, restaurants | Devis personnalisé (par site, pas par ligne) | CSV, JSON, Excel, API | Livraison gérée | ✅ Géré | Acheteurs de données sans charge opérationnelle |
| WebAutomation.io | Sans code (préconfiguré) | ✅ Inclus dans tous les plans | Hôtels (accent sur les coordonnées) | À partir de 1 $ (1 000 crédits, sans abonnement) | CSV, JSON, XML | Modérée | ⚠️ Limité | Génération de leads (e-mails, téléphones) |
| Instant Data Scraper | Sans code (1 clic) | ❌ Aucune | Tout tableau visible | 0 $ (bloqué au bout de quelques pages) | CSV, Excel | Faible (quelques pages) | ❌ Non | Petites extractions ponctuelles |
Verdict rapide : le plus rapide pour les équipes non techniques → Thunderbit. Le meilleur pour l’extraction massive d’avis → Apify. La meilleure option gratuite pour les petits besoins → Instant Data Scraper. Le meilleur pour les développeurs → ScrapFly. Le meilleur pour l’entreprise → Bright Data. Le meilleur pour une livraison sans intervention → ScrapeHero.
Passons aux détails.
1. Thunderbit — meilleur extracteur TripAdvisor pour les équipes non techniques
 Thunderbit est l’extension Chrome alimentée par l’IA que mon équipe et moi avons conçue précisément pour rendre le scraping web accessible aux personnes qui n’écrivent pas de code. Sur TripAdvisor, le flux est réellement en un clic : ouvrez une page d’hôtel, de restaurant ou d’attraction, puis lancez l’extension. L’IA lit la page, décide quels champs récupérer — nom de l’hôtel, note, prix, nombre d’avis, équipements, tout ce qui s’affiche — puis démarre l’extraction. Si vous voulez autre chose, dites-le simplement en langage courant et elle s’adapte. Dans tous les cas, vous obtenez un tableau que vous pouvez envoyer directement vers Google Sheets, Excel, Airtable ou Notion.
Là où Thunderbit brille vraiment sur TripAdvisor, c’est dans le scraping des sous-pages. Imaginons une page de résultats avec 30 hôtels. Thunderbit peut d’abord extraire la liste, puis suivre automatiquement chaque lien d’hôtel pour récupérer les champs de la page détaillée — texte complet des avis, liste des équipements, coordonnées, fourchettes de prix, sous-notes par catégorie — sans configuration supplémentaire. Vous cliquez sur un bouton et récupérez des données enrichies pour chaque annonce.
Le même fonctionnement s’applique aux autres types de pages. Sur une page de restaurant, vous obtenez le type de cuisine, la gamme de prix, les horaires et les plats au menu plutôt que les équipements d’un hôtel ; sur une page d’attraction, les prix des billets, la durée et les conseils visiteurs.
Pas besoin de maintenir des modèles spécifiques par catégorie — l’IA lit ce qui se trouve sur la page. Quelques limites sont à connaître : en Pro, une exécution est plafonnée à 200 pages paginées et 2 000 URL, chaque ligne consomme un crédit (deux si le scraping de sous-page est activé), et le mode Cloud ne fonctionne que sur les pages publiques — tout ce qui est derrière une connexion doit passer en mode Browser, plus lent.
Besoin de données récurrentes ? Le Scheduled Scraper de Thunderbit tourne chaque semaine ou chaque mois — exactement ce qu’il faut aux petites entreprises du secteur hôtelier pour surveiller les prix des concurrents ou suivre leur réputation.
Extrayez des données TripAdvisor avec l’IA Get Started Free
Principales fonctionnalités
- Extraction en 1 clic — l’IA nomme elle-même les colonnes, ou vous indiquez en une ligne ce que vous voulez (adapté à tout type de page TripAdvisor)
- Enrichissement des sous-pages en un clic — extrayez une liste, puis enrichissez chaque page détaillée
- Cloud Scraping (rapide, anti-bot intégré) et Browser Scraping (utilise votre vraie session Chrome)
- Extraction planifiée pour un suivi hebdomadaire/mensuel automatisé
- Export gratuit vers Excel, Google Sheets, Airtable, Notion, CSV, JSON
- Extracteurs gratuits d’e-mails et de téléphones pour la génération de leads
- Prend en charge 34 langues
Tarifs
- Offre gratuite : 6 pages par mois (jusqu’à 30 crédits par page)
- Plans payants à base de crédits : 1 crédit par ligne exportée, 2 si la ligne provient d’une sous-page. Starter à 15 $/mois pour 500 crédits ; Pro à 38 $/mois pour 3 000 crédits. La facturation annuelle fournit tous les crédits d’un coup — 108 $/an pour 5 000 crédits sur Starter, 288 $/an (24 $/mois) pour 30 000 crédits sur Pro. Il n’existe pas d’offre en libre-service au-delà de Pro ; les volumes plus élevés sont chiffrés sur devis Business. Voir les tarifs Thunderbit pour les détails à jour.
Idéal pour
- Équipes commerciales et opérationnelles qui veulent des données TripAdvisor dans un tableur sans coder
- Petites entreprises qui surveillent les avis de leurs concurrents chaque semaine
- Équipes marketing qui récupèrent les formulations clients pour leurs annonces et pages d’atterrissage
Essayez gratuitement l’extension Chrome Thunderbit pour voir comment le flux en 1 clic fonctionne sur vos propres pages TripAdvisor.
2. Apify TripAdvisor Scraper — le meilleur pour l’extraction d’avis à grande échelle
 Apify est une plateforme de scraping cloud avec une place de marché d’“Actors” prêts à l’emploi — et il existe plusieurs actors dédiés à TripAdvisor. Les plus populaires permettent de saisir des URL TripAdvisor ou des requêtes de recherche, de configurer des paramètres (lieu, type d’établissement, nombre d’avis), d’exécuter l’actor, puis de télécharger les résultats en JSON, CSV ou Excel.
Le vrai point fort d’Apify, c’est le volume. Si vous avez besoin de plus de 10 000 avis pour un projet d’analyse de sentiment, les actors d’Apify sont faits pour ça. L’actor TripAdvisor d’API Ninja tourne autour de 0,50 $ pour 1 000 résultats pour les données d’hôtel, tandis que l’actor Crawler Bros coûte 2,00 $ pour 1 000 résultats mais inclut les réponses des propriétaires, les votes utiles et les métadonnées de l’établissement. Les deux gèrent les mesures anti-bot et la pagination.
Le compromis : Apify exige une certaine familiarité avec sa plateforme. Ce n’est pas une extension Chrome — vous travaillez dans un tableau de bord web, vous configurez les entrées de l’actor et vous attendez la fin des exécutions cloud.
Prévoyez une dizaine de minutes pour une première exécution : créer un compte, choisir un actor, coller vos URL et attendre la fin du run cloud.
Principales fonctionnalités
- Actors TripAdvisor dédiés avec logique d’extraction préconstruite
- Gestion de la pagination et des mesures anti-bot
- Échelle adaptée aux grands volumes de données (10K+ avis)
- Accès API pour l’automatisation et l’intégration
- Prend en charge hôtels, avis, restaurants et attractions (selon l’actor)
Tarifs
- Offre gratuite : 5 $ d’utilisation de la plateforme par mois, sans paiement à l’usage au-delà et sans remise Apify Store
- Tarification au résultat : d’environ 0,50 $/1 000 résultats (API Ninja) à 2,00 $/1 000 résultats (Crawler Bros) — ces tarifs nécessitent un plan payant : API Ninja facture 0,50 $ sur tous les plans payants, tandis que Crawler Bros facture 2,67 $ par 1 000 sur Starter et n’atteint 2,00 $ qu’avec ses plans supérieurs
- Plans plateforme à partir de 29 $/mois (Starter) — ces 29 $ correspondent à du crédit prépayé à consommer, pas à une redevance en plus, et ils donnent droit à la remise Store
Idéal pour
- Équipes data ayant besoin de jeux de données d’avis à grande échelle
- Développeurs souhaitant une extraction pilotée par API
- Projets d’analyse de sentiment et de NLP
3. Octoparse — meilleur scraper desktop sans code pour TripAdvisor
 Octoparse est un outil de scraping desktop visuel et sans code, avec un constructeur de flux en point-and-click. Pour TripAdvisor, Octoparse propose des modèles prêts à l’emploi — vous collez une URL, lancez la détection automatique, vérifiez les champs proposés puis exportez. Le modèle TripAdvisor Hotel Reviews est facturé 0,8 $ pour 1 000 lignes.
Le constructeur visuel est intéressant si vous voulez plus de contrôle qu’une extension Chrome sans passer par le code. Vous pouvez définir des logiques conditionnelles, gérer la pagination et planifier des exécutions cloud. Mais il y a deux points d’attention. Premièrement, les modèles TripAdvisor d’Octoparse peuvent casser lorsque TripAdvisor modifie la mise en page — ce qui arrive souvent. Deuxièmement, les outils anti-blocage sont inclus, mais l’utilisation est mesurée : le plan Standard couvre déjà la rotation d’IP, les proxys résidentiels et la résolution automatique des CAPTCHA, donc rien à ajouter avant de démarrer — mais un job lourd en DataDome consomme de la bande passante proxy et des résolutions, et au-delà de ce que le plan couvre, ces usages sont facturés 3 $/Go et 1 à 1,5 $ par 1 000.
Principales fonctionnalités
- Constructeur de workflow en point-and-click
- Modèles TripAdvisor préconstruits
- Exécution cloud et locale
- Scraping planifié
Tarifs
- Offre gratuite : 10 tâches, extraction locale, 50 000 lignes exportables par mois
- Plan Standard : 83 $/mois facturés mensuellement, ou 69 $/mois facturés annuellement — le modèle TripAdvisor nécessite ce niveau. La page tarifaire d’Octoparse indique un prix Standard plus élevé, 119 $/mois, lorsque vous précisez que vous couvrez plusieurs sites selon un calendrier fréquent ; pour un seul site, le prix reste 83 $/69 $, quelle que soit la fréquence d’actualisation
- Utilisation des modèles : 0,8 $/1 000 lignes pour les avis d’hôtels TripAdvisor
- Inclus dans Standard : rotation d’IP, proxys résidentiels, résolution automatique des CAPTCHA, plus un crédit mensuel additionnel utilisé par les modèles premium, les proxys et les résolutions CAPTCHA — Octoparse ne publie pas le montant de ce crédit. Au-delà de ce que le plan couvre, les recharges coûtent 3 $/Go et 1 à 1,5 $ par 1 000 résolutions
Idéal pour
- Utilisateurs qui veulent un scraper visuel avec plus de contrôle qu’une extension Chrome
- Équipes qui scrapent plusieurs sites de voyage, pas seulement TripAdvisor
4. ScrapFly — meilleur extracteur TripAdvisor pour les développeurs Python
 ScrapFly est une API et un SDK de scraping web conçus pour les développeurs. Vous envoyez des requêtes HTTP via l’infrastructure ScrapFly, qui s’occupe du contournement anti-bot, du rendu JavaScript et de la rotation des proxys. ScrapFly propose des tutoriels détaillés et des exemples de code dédiés à TripAdvisor, ce qui est appréciable.
Le flux de travail est simple pour un développeur : utiliser le SDK Python de ScrapFly (ou simplement httpx / requests) pour récupérer les pages TripAdvisor, pendant que le backend de ScrapFly gère DataDome, les CAPTCHA et le rendu. Vous récupérez ensuite du HTML brut ou du JSON, et vous écrivez votre propre logique de parsing pour extraire les champs voulus.
Si vous souhaitez un contrôle fin — extraction de champs personnalisés, logique de pagination complexe, intégration à votre propre pipeline data — ScrapFly est pertinent. Mais ce n’est pas fait pour les utilisateurs non techniques.
Il n’y a ni interface visuelle ni export préconfiguré vers un tableur, et les 1 000 crédits gratuits offerts à l’inscription couvrent environ 200 pages TripAdvisor avec contournement anti-bot activé — suffisant pour prototyper, pas pour lancer un vrai job.
Principales fonctionnalités
- API de contournement anti-bot (gère DataDome, CAPTCHA)
- Rendu JavaScript
- Proxys rotatifs intégrés
- Tutoriel et exemples de code TripAdvisor
Tarifs
- Offre gratuite : 1 000 crédits à l’inscription, sans carte, sans expiration
- Les crédits sont facturés par requête : 1 pour une récupération simple depuis un datacenter, 5 avec rendu JavaScript ou contournement anti-bot, 25 avec proxys résidentiels
- Discovery à 30 $/mois pour 200 000 crédits prépayés ; Pro à 100 $/mois pour 1 000 000
Idéal pour
- Développeurs Python qui créent des extracteurs TripAdvisor sur mesure
- Équipes qui ont besoin d’un contrôle précis sur la logique d’extraction
5. Bright Data — meilleur extracteur TripAdvisor pour les opérations à l’échelle entreprise
 Bright Data est l’option full-stack. Elle propose un Web Scraper IDE pour créer des extracteurs sur mesure, des jeux de données TripAdvisor prêts à l’emploi et le plus grand réseau de proxys du marché — plus de 400 millions d’IP réparties entre résidentiel, datacenter et mobile. La résolution de CAPTCHA intégrée est incluse.
Le guide de scraping TripAdvisor de Bright Data explique comment utiliser Selenium avec leur infrastructure de navigateur managée, en ciblant les URL de recherche TripAdvisor avec des paramètres comme q, geo, ssrc et offset. Le guide couvre aussi les blocages classiques : défis JavaScript, empreintes navigateur et contenu dynamique.
Le compromis, c’est la complexité, pas le prix. L’API Web Scraper de Bright Data coûte 1,5 $/1 000 enregistrements en paiement à l’usage, sans plan à acheter, ce qui place 10 000 avis à 15 $ — en pratique 7,50 $, puisqu’un nouveau compte reçoit 5 000 enregistrements gratuits par mois et que ceux-ci sont consommés en premier. La partie chère, c’est le travail autour : vous choisissez un jeu de données prêt à l’emploi ou vous configurez le Scraper IDE, pas juste un clic sur un bouton. Et le plan Scale à 499 $/mois (384 000 enregistrements inclus) ne devient rentable qu’au-delà d’environ 338 000 enregistrements par mois — un niveau entreprise, où le même pipeline récupère aussi Booking.com et Google Maps.
Principales fonctionnalités
- Web Scraper IDE (visuel + code)
- Plus de 400 millions de proxys résidentiels et datacenter
- Jeux de données TripAdvisor prêts à l’emploi
- Gestion intégrée des CAPTCHA et de l’anti-bot
- Conformité de niveau entreprise
Tarifs
- Offre gratuite : 5 000 enregistrements par mois, renouvelés mensuellement et consommés avant tout paiement
- API Web Scraper : 1,5 $/1 000 enregistrements en PAYG
- Plan Scale : 499 $/mois pour 384 000 enregistrements
- Tarification entreprise sur mesure
Idéal pour
- Équipes entreprise ayant besoin de données TripAdvisor à très grande échelle
- Entreprises qui exigent une collecte conforme et prête pour l’entreprise
- Agrégation multi-plateforme (TripAdvisor + Booking.com + Google Maps)
6. ScrapeHero — meilleur service géré de scraping TripAdvisor
 ScrapeHero est un service de scraping entièrement géré. Vous indiquez les données TripAdvisor dont vous avez besoin — hôtels dans une région, avis pour un ensemble de biens, listes de restaurants dans une ville — et ScrapeHero construit, exécute et maintient l’extracteur pour vous. Ils livrent des données propres et structurées selon votre calendrier.
C’est l’option “je ne veux toucher à aucun outil”. ScrapeHero gère l’anti-bot, les proxys, la maintenance et la mise en forme des données — vous recevez les livrables en CSV, JSON, Excel ou via API.
L’inconvénient, c’est le coût. Les services managés sont nettement plus chers que les outils en self-service, et les délais pour des demandes personnalisées peuvent devenir un goulot d’étranglement.
Principales fonctionnalités
- Scraping entièrement géré (aucune configuration côté utilisateur)
- Calendriers de livraison personnalisés
- Gestion de l’anti-bot, des proxys et de la maintenance
- Sortie de données structurée (CSV, JSON, Excel, API)
Tarifs
- Tarification personnalisée selon le volume et la complexité — la page tarifaire présente ses chiffres publiés comme une base, pas comme un devis
- On Demand commence à 550 $ par site et par actualisation, configuration incluse, sans abonnement
- Business commence à 199 $/mois par site, avec des frais de mise en place ponctuels en plus ; les deux niveaux sont dimensionnés pour 1 à 5K pages par site et par mois
Idéal pour
- Équipes métier qui veulent recevoir les données TripAdvisor sans exploiter d’outil
- Entreprises ayant besoin de flux fiables et continus pour la veille hôtelière
7. WebAutomation.io — idéal pour extraire les coordonnées TripAdvisor
 WebAutomation.io est une plateforme de scraping sans code avec des extracteurs TripAdvisor préconfigurés, centrés sur les coordonnées : nom de l’hôtel, adresses, équipements, e-mails, numéros de téléphone, prix, avis et notes. Le flux est simple — sélectionnez l’extracteur TripAdvisor, saisissez les URL, lancez l’extraction, téléchargez les données.
Son avantage principal est son focus sur les champs utiles à la génération de leads. Si vous êtes une équipe commerciale dans l’hôtellerie et que votre objectif principal est de constituer une liste de contacts — noms, e-mails, numéros de téléphone, adresses — cet outil est conçu pour ça. Il est moins flexible que Thunderbit ou Octoparse pour du scraping généraliste, mais pour extraire des coordonnées depuis des annonces TripAdvisor, il remplit bien sa mission.
Principales fonctionnalités
- Extracteur TripAdvisor préconfiguré
- Extrait les coordonnées (e-mail, téléphone, adresse)
- Aucun codage requis
- Scraping planifié disponible
Tarifs
- Essai gratuit pour tester — la carte de plan affiche 10M crédits et la FAQ sur la même page indique 500, considère cela comme un essai, pas comme un niveau de volume
- Project à 99 $/mois pour 400 000 crédits, puis Start-Up 249 $, Business 449 $, Corporate 999 $ ; un crédit correspond à une extraction réussie de page, et les recharges sans abonnement commencent à 1 $ pour 1 000 crédits
Idéal pour
- Équipes commerciales qui extraient les coordonnées d’hôtels/restaurants pour la prospection
- Génération de leads à partir des annonces TripAdvisor
8. Instant Data Scraper — meilleur extracteur TripAdvisor gratuit pour les petits besoins
 Instant Data Scraper est une extension Chrome gratuite qui détecte automatiquement les tableaux de données sur n’importe quelle page web et permet de les exporter en un clic. Ouvrez une page TripAdvisor, cliquez sur l’icône de l’extension, elle détecte le tableau de données, puis vous exportez en CSV ou Excel. Pas de compte, pas de configuration, pas de coût.
J’aime Instant Data Scraper pour ce qu’il est : une solution rapide et gratuite pour récupérer un petit échantillon de données. Si vous avez besoin des 10 premiers hôtels d’une page de résultats ou de quelques avis pour une analyse rapide, cela fonctionne. Mais il n’offre absolument aucune gestion anti-bot. Au bout de quelques pages, DataDome de TripAdvisor vous bloquera. Pas d’enrichissement des sous-pages, pas de planification, pas d’adaptation IA aux changements de page, et aucune possibilité de monter en charge au-delà de ce qui est visible sur un seul chargement de page.
Principales fonctionnalités
- Extension Chrome gratuite
- Détecte automatiquement les tableaux de données
- Export en un clic vers CSV/Excel
- Aucun compte ni configuration requis
Tarifs
- Entièrement gratuit
Idéal pour
- Extractions rapides et ponctuelles (quelques pages d’annonces hôtelières)
- Chercheurs académiques ou étudiants sans budget
- Utilisateurs qui n’ont besoin que d’un petit échantillon de données TripAdvisor
Au-delà des hôtels : extraire les restaurants, attractions et visites TripAdvisor
La plupart des guides de scraping TripAdvisor s’arrêtent aux hôtels.
Pourtant, les restaurants et les attractions représentent une grande part des annonces TripAdvisor. Les données de ces pages sont tout aussi précieuses — et parfois davantage selon le cas d’usage.
Les pages restaurant exposent le type de cuisine, la fourchette de prix, les plats du menu, les types de repas, les caractéristiques, les horaires, l’adresse, le téléphone, le site web et des sous-notes par avis sur le rapport qualité-prix, le service, la nourriture et l’ambiance. Les pages attraction affichent les prix des billets, les horaires, la durée estimée, les conseils visiteurs et les nouveaux résumés d’avis générés par l’IA avec des étiquettes comme “Ambiance”, “Durée”, “Meilleur moment” et “Rapport qualité-prix”. Les pages visite vont encore plus loin avec les itinéraires, la taille des groupes, les langues du guide, les inclusions et les codes produit.
Les scrapers basés sur des modèles ne prennent souvent en charge que les URL d’hôtels. Si vous collez une URL de restaurant ou d’attraction dans un outil conçu autour de la structure d’une page hôtel, vous obtiendrez des données cassées ou incomplètes.
C’est là que les outils dopés à l’IA prennent l’avantage. Thunderbit s’appuie sur la page que vous avez ouverte, donc la même extension qui gère une annonce d’hôtel peut aussi gérer une page restaurant ou une page attraction. Vous n’attendez pas qu’un éditeur publie un modèle pour chaque catégorie.
C’est aussi important pour la recherche de contenu marketing. Les avis sur les restaurants et les attractions sont remplis des expressions exactes que les gens utilisent pour décrire une sortie au restaurant ou une visite de musée. Si vous travaillez dans le marketing hôtelier, c’est ce langage-là que vous voulez dans vos annonces, vos landing pages et vos campagnes e-mail.
Combien coûte vraiment le scraping TripAdvisor ?
Le coût est la question qu’on me pose le plus souvent : peut-on faire ça sans payer des proxys et des solveurs de CAPTCHA ? Voici une estimation réaliste pour extraire 10 000 avis d’hôtel, un benchmark courant.
D’abord, une précision de normalisation : TripAdvisor affiche actuellement 10 avis par page sur les pages détaillées d’hôtels, donc 10 000 avis ≈ 1 000 pages d’avis. Les outils qui facturent à la page et ceux qui facturent à la ligne ont des profils de coûts très différents ; la deuxième colonne ci-dessous correspond donc à ce que votre carte est réellement débitée en un mois à ce volume : allocations mensuelles gratuites déjà déduites, et plan le moins cher facturé mensuellement par le fournisseur. Plusieurs de ces outils sont moins chers si vous prépayez un an, mais un prépaiement annuel n’est pas une facture mensuelle, donc il n’entre pas dans la colonne. Les coûts additionnels — proxys, solveurs, temps de développement — sont exclus du chiffre et expliqués dans la colonne d’à côté.
| Outil | Facture mensuelle réelle (10K avis) | Mode de facturation, déductions | Configuration & maintenance |
|---|---|---|---|
| Thunderbit | 288 $ ponctuels (Business si mensuel) | Les avis extraits depuis la page détaillée de chaque annonce sont comptés comme des lignes de sous-page, donc 2 crédits chacun — 10 000 avis = 20 000 crédits. Le Pro annuel prépayé fournit 30 000 crédits pour 288 $, ce qui couvre une extraction ponctuelle de cette taille. Si vous répétez l’opération chaque mois, vous dépassez ce que les plans en self-service couvrent (Pro = 3 000 crédits/mois), et cela passe donc en devis Business. L’offre gratuite, 6 pages/mois, ne se cumule pas avec un plan payant. Une exécution est limitée à 200 pages paginées, donc cela représente cinq runs pour les mêmes crédits. | 5 min ; faible — l’IA relit la page à chaque exécution |
| Apify (actor API Ninja) | 29 $/mois | La remise Store d’Apify commence sur Starter, donc le tarif 0,50 $ pour 1 000 résultats correspond à un plan payant — sur le plan gratuit, le même actor facture dix fois plus, et les 5 $ gratuits achètent environ 1 000 résultats sans paiement à l’usage pour aller au-delà. Contrairement à Crawler Bros ci-dessous, cet actor facture le même 0,50 $ sur tous les plans payants, donc Starter applique le tarif affiché : 10 000 résultats coûtent 5,00 $ sur les 29 $ déjà prépayés, donc la facture reste 29 $. | 10 min ; faible |
| Apify (actor Crawler Bros) | 29 $/mois | Même plan à 29 $, mais davantage consommé. Cet actor facture selon le niveau de plan : Starter paie 2,67 $ par 1 000, donc 10 000 résultats reviennent à 26,70 $ — toujours dans les 29 $ prépayés. Le tarif affiché à 2,00 $/1 000 est celui des plans supérieurs. | 10 min ; faible |
| Instant Data Scraper | 0 $ | Extension gratuite, aucun compte, aucune allocation à déduire — et aucune façon non plus de terminer le travail : DataDome le bloque après quelques pages. | 2 min ; aucune maintenance |
| Octoparse | 83 $/mois | Facturé par tâches et concurrence cloud, pas par lignes, donc le volume ne fait pas changer de niveau — c’est le modèle qui le fait, et il nécessite Standard : 83 $/mois, ou 69 $/mois facturés annuellement. Un seul site reste à ce prix de 83 $/69 $, quelle que soit la fréquence d’actualisation. Les lignes de modèle à 0,8 $/1 000, les proxys résidentiels à 3 $/Go et les résolutions CAPTCHA sont des options prélevées sur le crédit additionnel mensuel inclus dans le plan, et Octoparse n’en publie pas le montant. | 30 min ; moyen — les modèles cassent quand TripAdvisor modifie ses éléments |
| ScrapFly | 30 $/mois | TripAdvisor nécessite l’activation du contournement anti-bot, qui coûte 5 crédits par requête, donc 1 000 pages d’avis = 5 000 crédits. Les 1 000 crédits offerts à l’inscription sont ponctuels et couvrent environ 200 pages, donc le job repose sur Discovery : 30 $/mois pour 200 000 crédits prépayés. Ici, le quota n’est jamais la contrainte réelle — le prix du plan est l’intégralité de la facture. | 1 à 2 h de code ; moyen — vous gérez le parser |
| Bright Data | 7,50 $ | Un enregistrement correspond à une ligne, donc 10 000 avis = 10 000 enregistrements = 15 $ au tarif 1,50 $/1 000 en paiement à l’usage. Un nouveau compte reçoit 5 000 enregistrements gratuits par mois, consommés avant tout paiement, ce qui divise la facture par deux. Pas de plan à acheter, pas d’engagement minimal. | 30 min ; moyen |
| ScrapeHero | Devis personnalisé | Facturé par site et par actualisation, pas par ligne, et la page tarifaire présente ses propres chiffres comme une base, pas comme un prix ferme. Les tarifs planchers sont de 550 $ par site et par actualisation (On Demand) ou 199 $/mois par site plus des frais de configuration ponctuels (Business) — les deux niveaux couvrent 1 à 5K pages par site, la tranche dans laquelle entrent 1 000 pages d’avis. | Aucune — ils construisent et opèrent l’outil ; aucune |
| WebAutomation.io | À partir de 1 $ | Un crédit correspond à une extraction réussie de page, donc 1 000 pages d’avis = environ 1 000 crédits, davantage si une page nécessite plusieurs requêtes ou du rendu JavaScript. Les recharges sans abonnement commencent à 1 $ pour 1 000 crédits ; l’abonnement le moins cher, Project à 99 $/mois, achète 400 000 crédits que vous n’utiliserez jamais ici. L’offre gratuite se contredit sur la page — 10M crédits sur la carte, 500 dans la FAQ — donc rien n’est déduit. | Extracteur préconfiguré sans code ; faible — le fournisseur le maintient |
| Python DIY + proxys | Facturé au gigaoctet et à la résolution | La facture correspond à la bande passante résidentielle, autour de 3 $/Go — ce que facture Octoparse pour le même add-on — plus 1 à 1,5 $ par 1 000 résolutions de CAPTCHA. Convertir cela en facture mensuelle nécessiterait un chiffre de mégaoctets par page d’avis que je ne peux pas sourcer, donc je ne vais pas inventer un chiffre unique. Le temps développeur s’ajoute par-dessus. | 4 à 8 h ; élevé — le code casse |
Le coût que beaucoup oublient, c’est la maintenance. Les scrapers Python faits maison cassent lorsque TripAdvisor modifie ses identifiants de requêtes GraphQL, met à jour DataDome ou réorganise les modules de la page. J’ai vu des équipes passer plus de temps à déboguer des scrapers cassés qu’à les construire au départ. Les outils dopés à l’IA comme Thunderbit relisent la page à chaque exécution, donc un changement de mise en page ne se transforme généralement pas en travail pour vous — cela ne vous rend pas invulnérable au blocage, mais vous n’avez pas à réécrire les sélecteurs à chaque modification de TripAdvisor.
Des parcours gratuits existent, et chacun a ses limites. Les extracteurs d’e-mails et de téléphones de Thunderbit sont gratuits, mais l’offre gratuite est limitée à 6 pages par mois. Le plan gratuit d’Apify donne 5 $ d’utilisation de plateforme. Instant Data Scraper est gratuit et continue jusqu’à ce que DataDome vous repère.
Quel extracteur TripAdvisor correspond à votre cas d’usage ?
Chaque workflow appelle un outil différent. Voici une matrice de décision basée sur les cas d’usage qui reviennent le plus souvent chez nos utilisateurs :
| Cas d’usage | Meilleur(s) outil(s) | Pourquoi |
|---|---|---|
| Export rapide d’avis d’hôtel (1 établissement) | Thunderbit, Instant Data Scraper | 1 clic, aucune configuration |
| Analyse de sentiment à grande échelle (10K+ avis) | Apify, Bright Data | Conçus pour le volume + sortie API |
| Suivi hebdomadaire de la concurrence | Thunderbit (Scheduled Scraper), Apify | Planification automatisée |
| Recherche académique (petit échantillon, aucun budget) | Instant Data Scraper, offre gratuite Thunderbit | Gratuit — et limité : 6 pages/mois sur l’offre gratuite, et Instant Data Scraper s’arrête dès que DataDome le détecte |
| Agrégation multi-plateforme (TA + Booking + Google) | Thunderbit, Bright Data | Capacité multi-sites |
| Génération de leads dans l’hôtellerie (e-mails, téléphones) | Thunderbit, WebAutomation.io | Extraction des coordonnées |
| Pipeline de données sur mesure (développeur) | ScrapFly, Apify | API-first, personnalisation poussée |
| Livraison de données sans intervention | ScrapeHero | Entièrement géré |
Une question revient souvent dans les forums : peut-on utiliser des assistants de code IA comme ChatGPT ou Claude pour écrire des scrapers TripAdvisor ? En théorie, une IA peut rédiger un script Python. En pratique, ces scripts cassent presque immédiatement sur TripAdvisor parce que DataDome neutralise l’automatisation de navigateur générique. Un outil de scraping alimenté par l’IA comme Thunderbit est fondamentalement différent d’un assistant de codage IA — Thunderbit s’exécute dans un vrai environnement de navigateur avec une gestion anti-bot intégrée, alors qu’un script généré par ChatGPT tourne dans un navigateur headless “nu” que DataDome bloque à vue.
Si deux outils paraissent aussi bons sur cette matrice, laisse la destination décider : un tableur que quelqu’un ouvrira demain, ou un pipeline qui doit tourner sans surveillance.
Sans code vs avec code : l’avantage de l’extension Chrome en 1 clic
L’écart entre une extension Chrome et un script Python est énorme pour les utilisateurs non techniques. Voici comment les trois approches principales se comparent pour une première tâche de scraping TripAdvisor :
| Critère | Extension Chrome (Thunderbit) | Plateforme sans code (Octoparse) | Python DIY |
|---|---|---|---|
| Temps jusqu’au premier résultat | ~2 minutes | ~15–30 minutes | ~2–4 heures |
| Code requis | Aucun | Aucun | Python intermédiaire |
| Gestion des changements de mise en page | ✅ L’IA relit la page à chaque exécution | ⚠️ Le modèle enregistré ne correspond plus à la page | ❌ Correction manuelle nécessaire |
| Enrichissement des sous-pages | ✅ 1 clic | ⚠️ Configuration du workflow nécessaire | Codage manuel |
| Gestion anti-bot | Intégrée (mode Cloud) | Incluse dans le plan Standard | Proxys + CAPTCHA à gérer soi-même |
Voici le mini-tutoriel Thunderbit pour TripAdvisor :
- Ouvre n’importe quelle page TripAdvisor (hôtel, restaurant, attraction) dans Chrome
- Clique une fois sur l’icône de l’extension Thunderbit
- Thunderbit transforme la page en colonnes (nom de l’hôtel, note, prix, nombre d’avis, etc.)
- Il lance l’extraction tout seul — si une colonne ne te convient pas, modifie-la et relance
- Pour obtenir des données plus riches, descends d’un niveau — Thunderbit suit chaque lien d’annonce pour récupérer les champs des pages détaillées (équipements, avis complets, coordonnées)
- Exporte directement vers Google Sheets, Excel, Airtable ou Notion
L’ensemble du processus prend environ deux minutes pour une page de liste, et l’IA gère la pagination automatiquement. Pas de sélecteurs à configurer, pas de XPath à déboguer, pas de proxys à faire tourner.
Conseils pour un scraping TripAdvisor responsable
Quelques règles de base pour agir de manière responsable :
- N’extrayez que des données publiques. Ne vous connectez pas pour scraper du contenu privé ou protégé.
- Respectez les limites de requêtes. Si vous utilisez un outil basé sur du code, ajoutez des pauses entre les requêtes. Les outils comme Thunderbit et Apify le gèrent automatiquement.
- Ne stockez pas de données personnelles inutilement. Le nom des auteurs d’avis publics, c’est une chose ; extraire et conserver des adresses e-mail depuis des avis, c’en est une autre.
- Utilisez les données à des fins commerciales légitimes — analyse concurrentielle, étude de marché, génération de leads, recherche académique.
- Tenez compte des conditions d’utilisation de TripAdvisor concernant les accès automatisés. Le cadre juridique du scraping web continue d’évoluer (RGPD, CCPA, politiques de plateforme), donc restez informé.
Pour aller plus loin sur l’aspect légal, consultez notre article sur les implications juridiques du web scraping.
Choisir le meilleur extracteur TripAdvisor selon vos besoins
La version courte :
- Thunderbit est le chemin le plus rapide entre une page TripAdvisor et un tableur exploitable. Un clic, aucun code, une IA qui s’adapte aux hôtels, restaurants, attractions et visites. Idéal pour les équipes commerciales, opérations et marketing qui ont besoin des données tout de suite.
- Apify est le meilleur choix en rapport qualité/prix pour l’extraction d’avis à gros volume si vous êtes à l’aise avec une plateforme cloud. Excellent pour l’analyse de sentiment et les projets data science.
- Instant Data Scraper est la meilleure option gratuite pour récupérer un petit échantillon — mais n’espérez pas dépasser quelques pages.
- Octoparse convient bien aux utilisateurs qui veulent un constructeur visuel avec plus de contrôle ; les proxys et la résolution de CAPTCHA sont inclus dans le plan, donc votre budget doit surtout couvrir la maintenance des modèles et les recharges si votre volume dépasse l’allocation.
- ScrapFly est le choix des développeurs — personnalisation poussée, API anti-bot robuste, mais vous écrivez et maintenez vous-même le code de parsing.
- Bright Data est conçu pour la collecte de données multi-plateformes à l’échelle entreprise avec le plus grand réseau de proxys du marché. Surdimensionné pour les petites équipes.
- ScrapeHero est l’option sans intervention — vous envoyez votre besoin, vous recevez des données propres.
- WebAutomation.io est un choix de niche pour la génération de leads dans l’hôtellerie, centré sur l’extraction des coordonnées des annonces TripAdvisor.
Si vous voulez voir à quoi ressemble le scraping TripAdvisor moderne sans écrire une ligne de code, commencez par l’offre gratuite de Thunderbit et testez-la sur votre propre page TripAdvisor. Je pense que vous serez surpris de voir à quelle vitesse on passe de “j’ai besoin de ces données” à “elles sont déjà dans mon tableur”.
Quel que soit votre choix, testez-le sur une seule page avant de souscrire — vous saurez en deux minutes s’il passe DataDome sur les pages qui vous intéressent vraiment.
Essayez le scraping TripAdvisor avec l’IA de Thunderbit Get Started Free
FAQ
Est-il légal de scraper TripAdvisor ?
Extraire des données publiques est généralement considéré comme légal dans de nombreuses juridictions, mais vous devez respecter les conditions d’utilisation de TripAdvisor, éviter de scraper du contenu privé ou protégé, et vous conformer aux réglementations sur la vie privée comme le RGPD et le CCPA. Le cadre juridique évolue, il est donc utile de rester informé. Pour plus de contexte, consultez notre guide sur les implications juridiques du web scraping.
Pourquoi TripAdvisor bloque-t-il mon scraper si rapidement ?
Parce que DataDome profile le navigateur et le comportement, pas seulement l’IP — donc ralentir votre script ou changer d’adresse ne suffit pas vraiment une fois que votre configuration a été identifiée par empreinte. Deux choses aident : exécuter le scraping depuis une vraie session Chrome que vous utilisez déjà, ce qui ressemble à une personne en train de naviguer, ou payer une infrastructure qui gère pour vous les empreintes et les CAPTCHA — Apify, Bright Data et ScrapFly intègrent tous les proxys et la résolution, et le mode Cloud de Thunderbit le fait sur ses propres serveurs.
Puis-je scraper les restaurants et attractions TripAdvisor, pas seulement les hôtels ?
Oui, mais tous les outils ne prennent pas en charge les pages autres que les hôtels. Les scrapers basés sur des modèles peuvent ne fonctionner qu’avec des URL d’hôtels. Les outils dopés à l’IA comme Thunderbit s’adaptent à n’importe quel type de page TripAdvisor — restaurants, attractions, visites — car ils lisent la structure de la page de manière dynamique au lieu de s’appuyer sur des modèles fixes. Les restaurants, attractions et visites représentent une grande part de ce qui est listé sur TripAdvisor, donc il y a largement de quoi faire au-delà des hôtels.
Existe-t-il un extracteur TripAdvisor totalement gratuit ?
Instant Data Scraper est 100 % gratuit et fonctionne pour de petits besoins ponctuels (quelques pages d’annonces). Thunderbit propose une offre gratuite avec 6 pages, et le plan gratuit d’Apify inclut 5 $ d’utilisation de plateforme par mois. Pour tout ce qui dépasse un petit échantillon, il vous faudra probablement un outil payant — mais vous pouvez tout à fait commencer à 0 $ pour vérifier si l’outil correspond à votre flux de travail.
Puis-je extraire des avis TripAdvisor sans coder ?
Absolument. Thunderbit ne nécessite qu’un clic — ouvrez une page TripAdvisor, lancez l’extension, et l’IA prend le relais : elle choisit les colonnes, lance l’extraction et vous laisse un tableau prêt à être exporté. Tu veux des champs précis ? Dis-le, et elle construit le tableau autour. Octoparse et WebAutomation.io proposent aussi des interfaces sans code, mais demandent davantage de configuration. Pour un guide pas à pas, consultez notre modèle d’extracteur TripAdvisor ou regardez les tutoriels sur la chaîne YouTube Thunderbit. En savoir plus



