
La web crece a un ritmo que, siendo sinceros, cuesta seguirle el paso—para 2026, casi la mitad de todo el tráfico de internet será de bots, y una parte enorme de eso corresponde a empresas que extraen datos para impulsar ventas, operaciones e investigación de la competencia. He visto de primera mano cómo el web scraping pasó de ser un “extra útil” para perfiles técnicos a convertirse en una necesidad total para todo tipo de equipos, desde comerciales hasta agentes inmobiliarios. Pero aquí está la clave: no todas las empresas de web scraping son iguales, y elegir la adecuada puede marcar la diferencia entre un flujo de trabajo fluido y automatizado, o pasarte una semana entera copiando y pegando sin parar.
Por eso me puse manos a la obra y analicé a fondo las principales empresas de web scraping para 2026. Tanto si eres un usuario sin perfil técnico que solo quiere datos en dos clics, como si eres un desarrollador que busca control total, esta lista reúne lo mejor de lo mejor, además de una valoración honesta de en qué destaca cada una y en qué se queda corta. Vamos allá.
Por qué las empresas necesitan a las mejores compañías de web scraping
Extrae datos de cualquier sitio web con IA Get Started Free
Si alguna vez has intentado crear una lista de leads, vigilar los precios de la competencia o extraer datos de producto de decenas o miles de páginas, ya conoces el dolor de recopilar datos a mano. Es lento, propenso a errores y, siendo claros, no es precisamente una tarea agradable. Por eso el web scraping ya se ha convertido en una industria de verdad, y las empresas lo usan para todo: desde generación de leads y seguimiento de precios hasta investigación de mercado y análisis de sentimiento.
¿La verdadera magia? La automatización. Las empresas modernas de web scraping te permiten:
- Automatizar investigaciones repetitivas (adiós a las maratones de copiar y pegar)
- Escalar a miles de páginas sin meter más trabajo extra
- Integrar datos directamente en tus herramientas favoritas (Excel, Google Sheets, Notion, CRM)
- Ir un paso por delante de la competencia con datos más frescos, más completos y más rápido
Pero con tantas opciones, ¿cómo elegir? Ahí es donde entra esta guía.
Cómo evaluamos a las principales empresas de web scraping
No todos los scrapers están pensados para el mismo usuario ni para el mismo trabajo. Así es como valoré el panorama:
- Facilidad de uso: ¿Puede una persona sin código sacar resultados rápido? ¿La interfaz es intuitiva?
- Automatización y funciones: ¿Gestiona paginación, subpáginas, programación y contenido dinámico?
- Escalabilidad: ¿Sirve para proyectos grandes o está mejor para tareas pequeñas?
- Integración: ¿Qué tan fácil es exportar o conectar los datos con otras herramientas?
- Precio: ¿Tiene plan gratuito? ¿Es asequible para pymes y escalable para grandes empresas?
- Soporte y comunidad: ¿Hay tutoriales, plantillas y ayuda real cuando la necesitas?
También me fijé en lo que hace única a cada empresa, porque a veces la mejor herramienta no es la que más funciones tiene, sino la que encaja mejor con tu flujo de trabajo.
Vamos con la lista.
1. Thunderbit
 Thunderbit es el scraper web potenciado por IA que más me entusiasma para 2026, y no solo porque ayudé a construirlo. Thunderbit está pensado para usuarios de negocio que quieren datos, no dolores de cabeza. Su extensión de Chrome te permite extraer datos de cualquier sitio web usando lenguaje natural y sugerencias de campos con IA. Sin código, sin plantillas, sin estrés.
Por qué Thunderbit destaca:
- Extracción con un clic: Solo haz clic en “One-Click Extract” y la IA de Thunderbit hace el resto.
- Compatibilidad con subpáginas y paginación: Extrae fácilmente listados y luego deja que la IA visite cada subpágina para obtener más detalles.
- Plantillas instantáneas: Para sitios populares (Amazon, Zillow, Shopify, etc.), usa plantillas prediseñadas para extraer con 1 clic.
- Exportación gratuita de datos: Exporta a Excel, Google Sheets, Notion o Airtable, sin muro de pago para tus propios datos.
- Enriquecimiento de datos con IA: Etiqueta, clasifica y traduce datos mientras los extraes.
- Extracción programada y en la nube: Configura tareas recurrentes o ejecuta extracciones en la nube para ir más rápido.
- Plan gratuito completo: Extrae hasta 6 páginas gratis, o 10 con un impulso de prueba. Los planes de pago empiezan en $15/mes.
Thunderbit cuenta con la confianza de más de 200.000 usuarios en todo el mundo, desde equipos de ventas hasta operadores de e-commerce. Si buscas la experiencia de web scraping más fácil y amigable en 2026, Thunderbit es difícil de superar.
¿Quieres ver cómo funciona? Descarga la extensión de Chrome y pruébala por tu cuenta.
2. Scrapy
 Scrapy es el framework de Python de código abierto al que recurren los desarrolladores que quieren control total. Es potente, flexible y está probado para todo tipo de casos: desde rastrear sitios pequeños hasta extraer millones de páginas.
Ideal para: equipos técnicos, ingenieros de datos y cualquier persona cómoda con Python.
Funciones clave:
- Creación de reglas personalizadas: construye spiders para adaptarte a cualquier estructura de sitio.
- Escalable y rápido: gestiona scraping a gran escala con manejo robusto de errores.
- Integración con el ecosistema Python: conéctalo con Pandas, Jupyter y más.
- Gratis y de código abierto: sin licencias, con una gran comunidad de apoyo.
Ojo: Scrapy tiene cierta curva de aprendizaje. Si no programas, quizá te convenga otra opción. Pero para desarrolladores es una auténtica bestia (ScraperAPI).
3. ParseHub
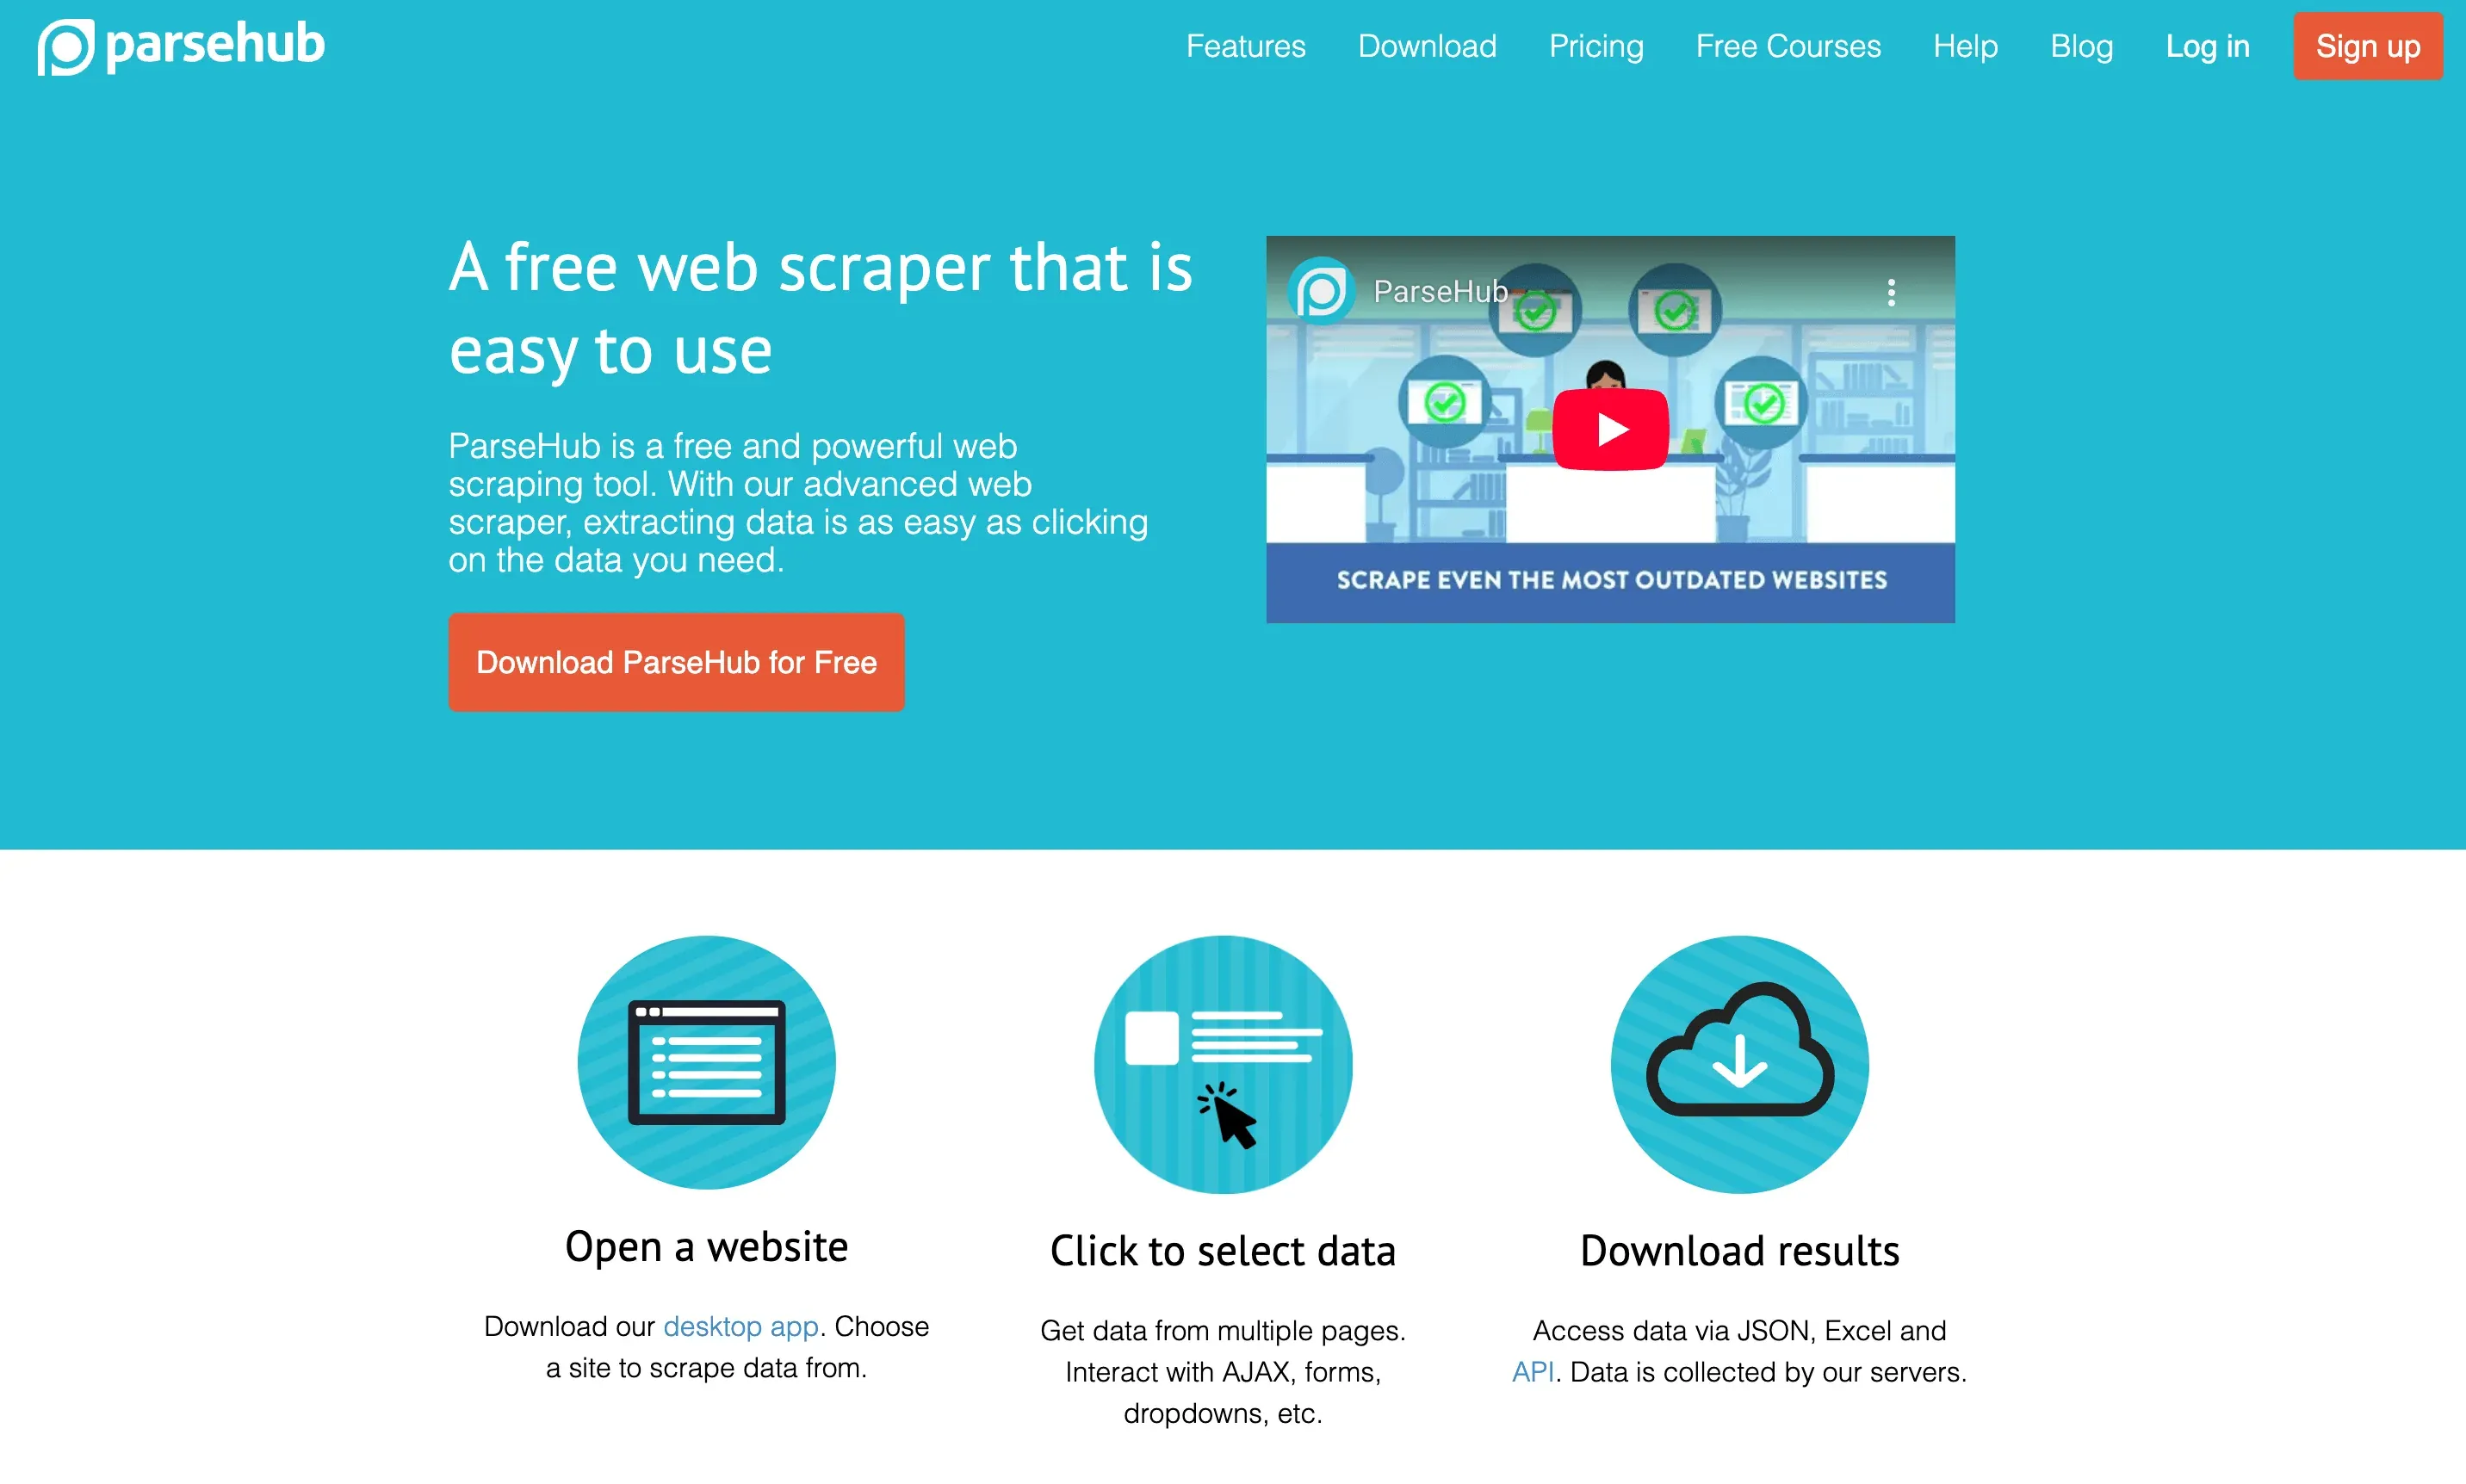 ParseHub es una aplicación de escritorio que hace que el web scraping sea visual y accesible. Su interfaz de señalar y hacer clic permite crear scrapers sin escribir código.
Ideal para: pymes, investigadores y personas sin conocimientos técnicos que buscan flexibilidad.
Funciones clave:
- Flujo de trabajo visual: haz clic para seleccionar datos y crea lógica para paginación y subpáginas.
- Programación en la nube: ejecuta extracciones según horarios, incluso si tu ordenador está apagado.
- Opciones de exportación: descarga en CSV, Excel o JSON.
- Plan gratuito: 5 proyectos, hasta 200 páginas por ejecución; los planes de pago empiezan en $189/mes.
ParseHub es especialmente popular para extraer listados, reseñas y datos de e-commerce (ScraperAPI).
4. Octoparse
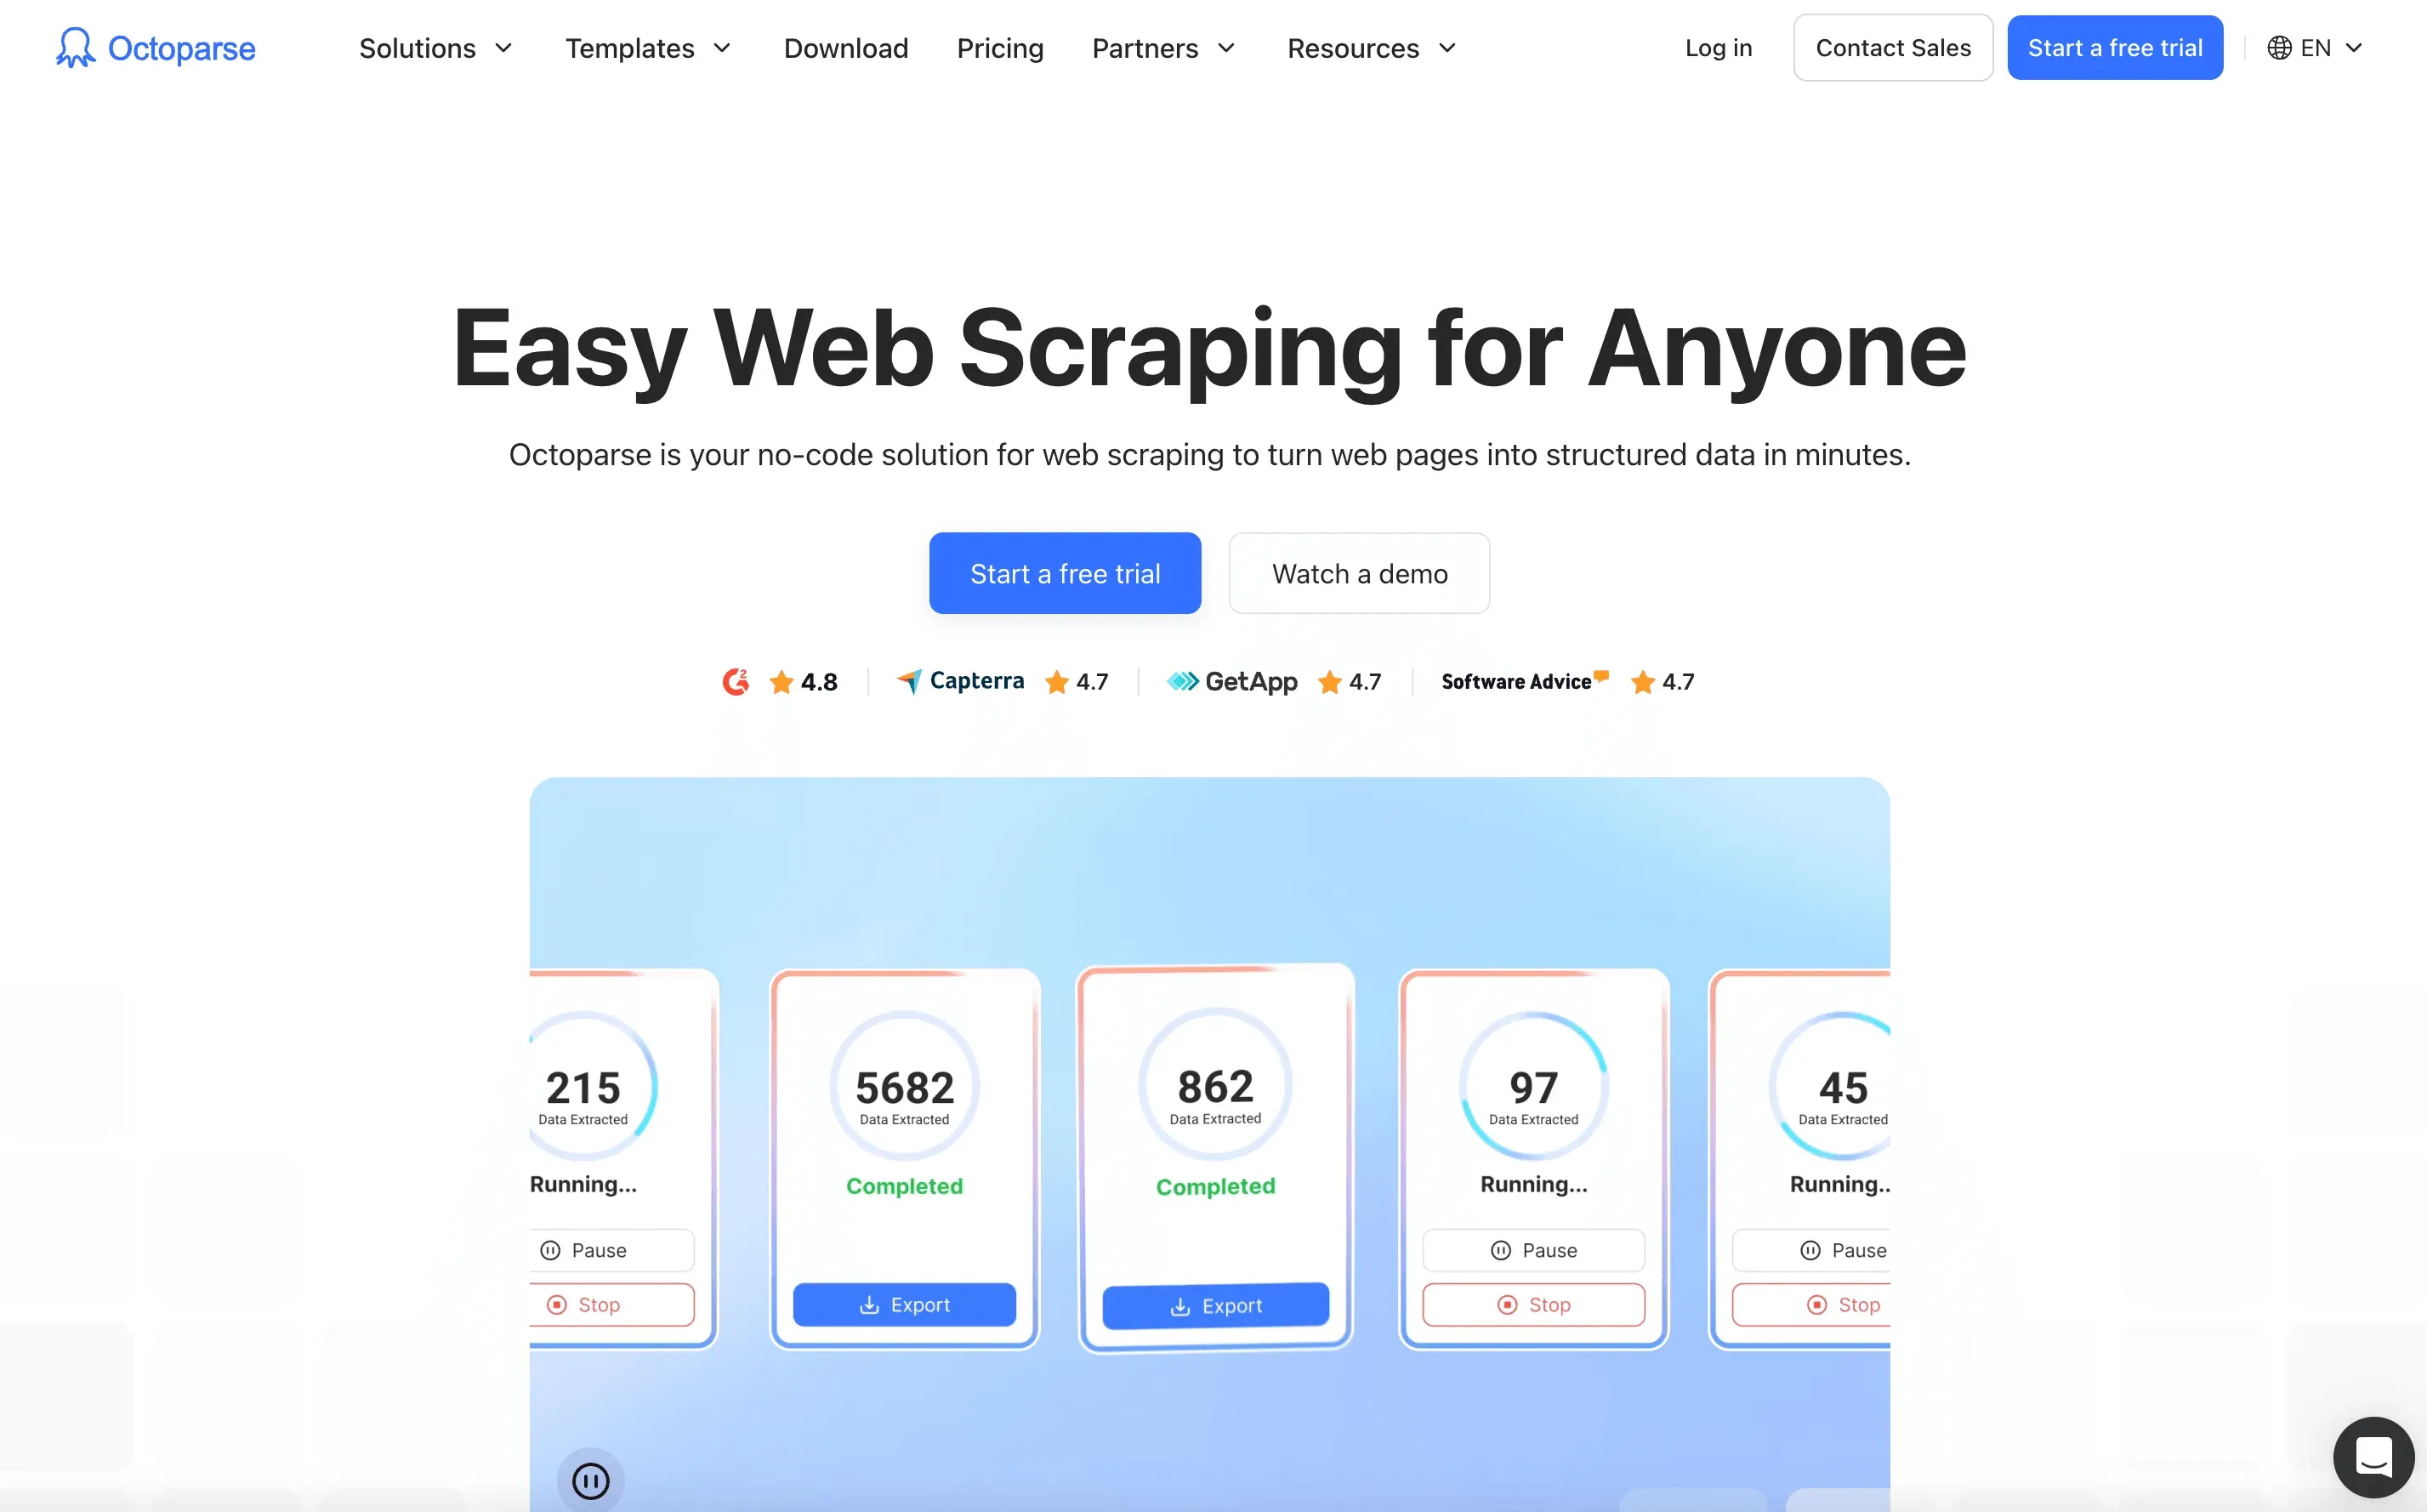 Octoparse es una plataforma de web scraping sin código y de arrastrar y soltar, enfocada en automatizar a gran escala. Es ideal para equipos que quieren configurar tareas complejas sin escribir scripts.
Ideal para: equipos de marketing, investigación y operaciones.
Funciones clave:
- Flujo de trabajo de arrastrar y soltar: crea scrapers visualmente y maneja contenido dinámico y scroll infinito.
- Scraping y programación en la nube: ejecuta tareas en la nube y programa trabajos recurrentes.
- Rotación de IP y anti-bloqueo: funciones integradas para extraer datos de sitios difíciles.
- Exportación a Excel, Sheets y bases de datos: integración sencilla con tu flujo de trabajo.
- Plan gratuito: hasta 10.000 registros/mes; los planes de pago empiezan en $83/mes, o $69/mes con facturación anual.
Octoparse destaca especialmente por su velocidad y por su capacidad para manejar proyectos de gran escala (ScraperAPI).
5. DataMiner
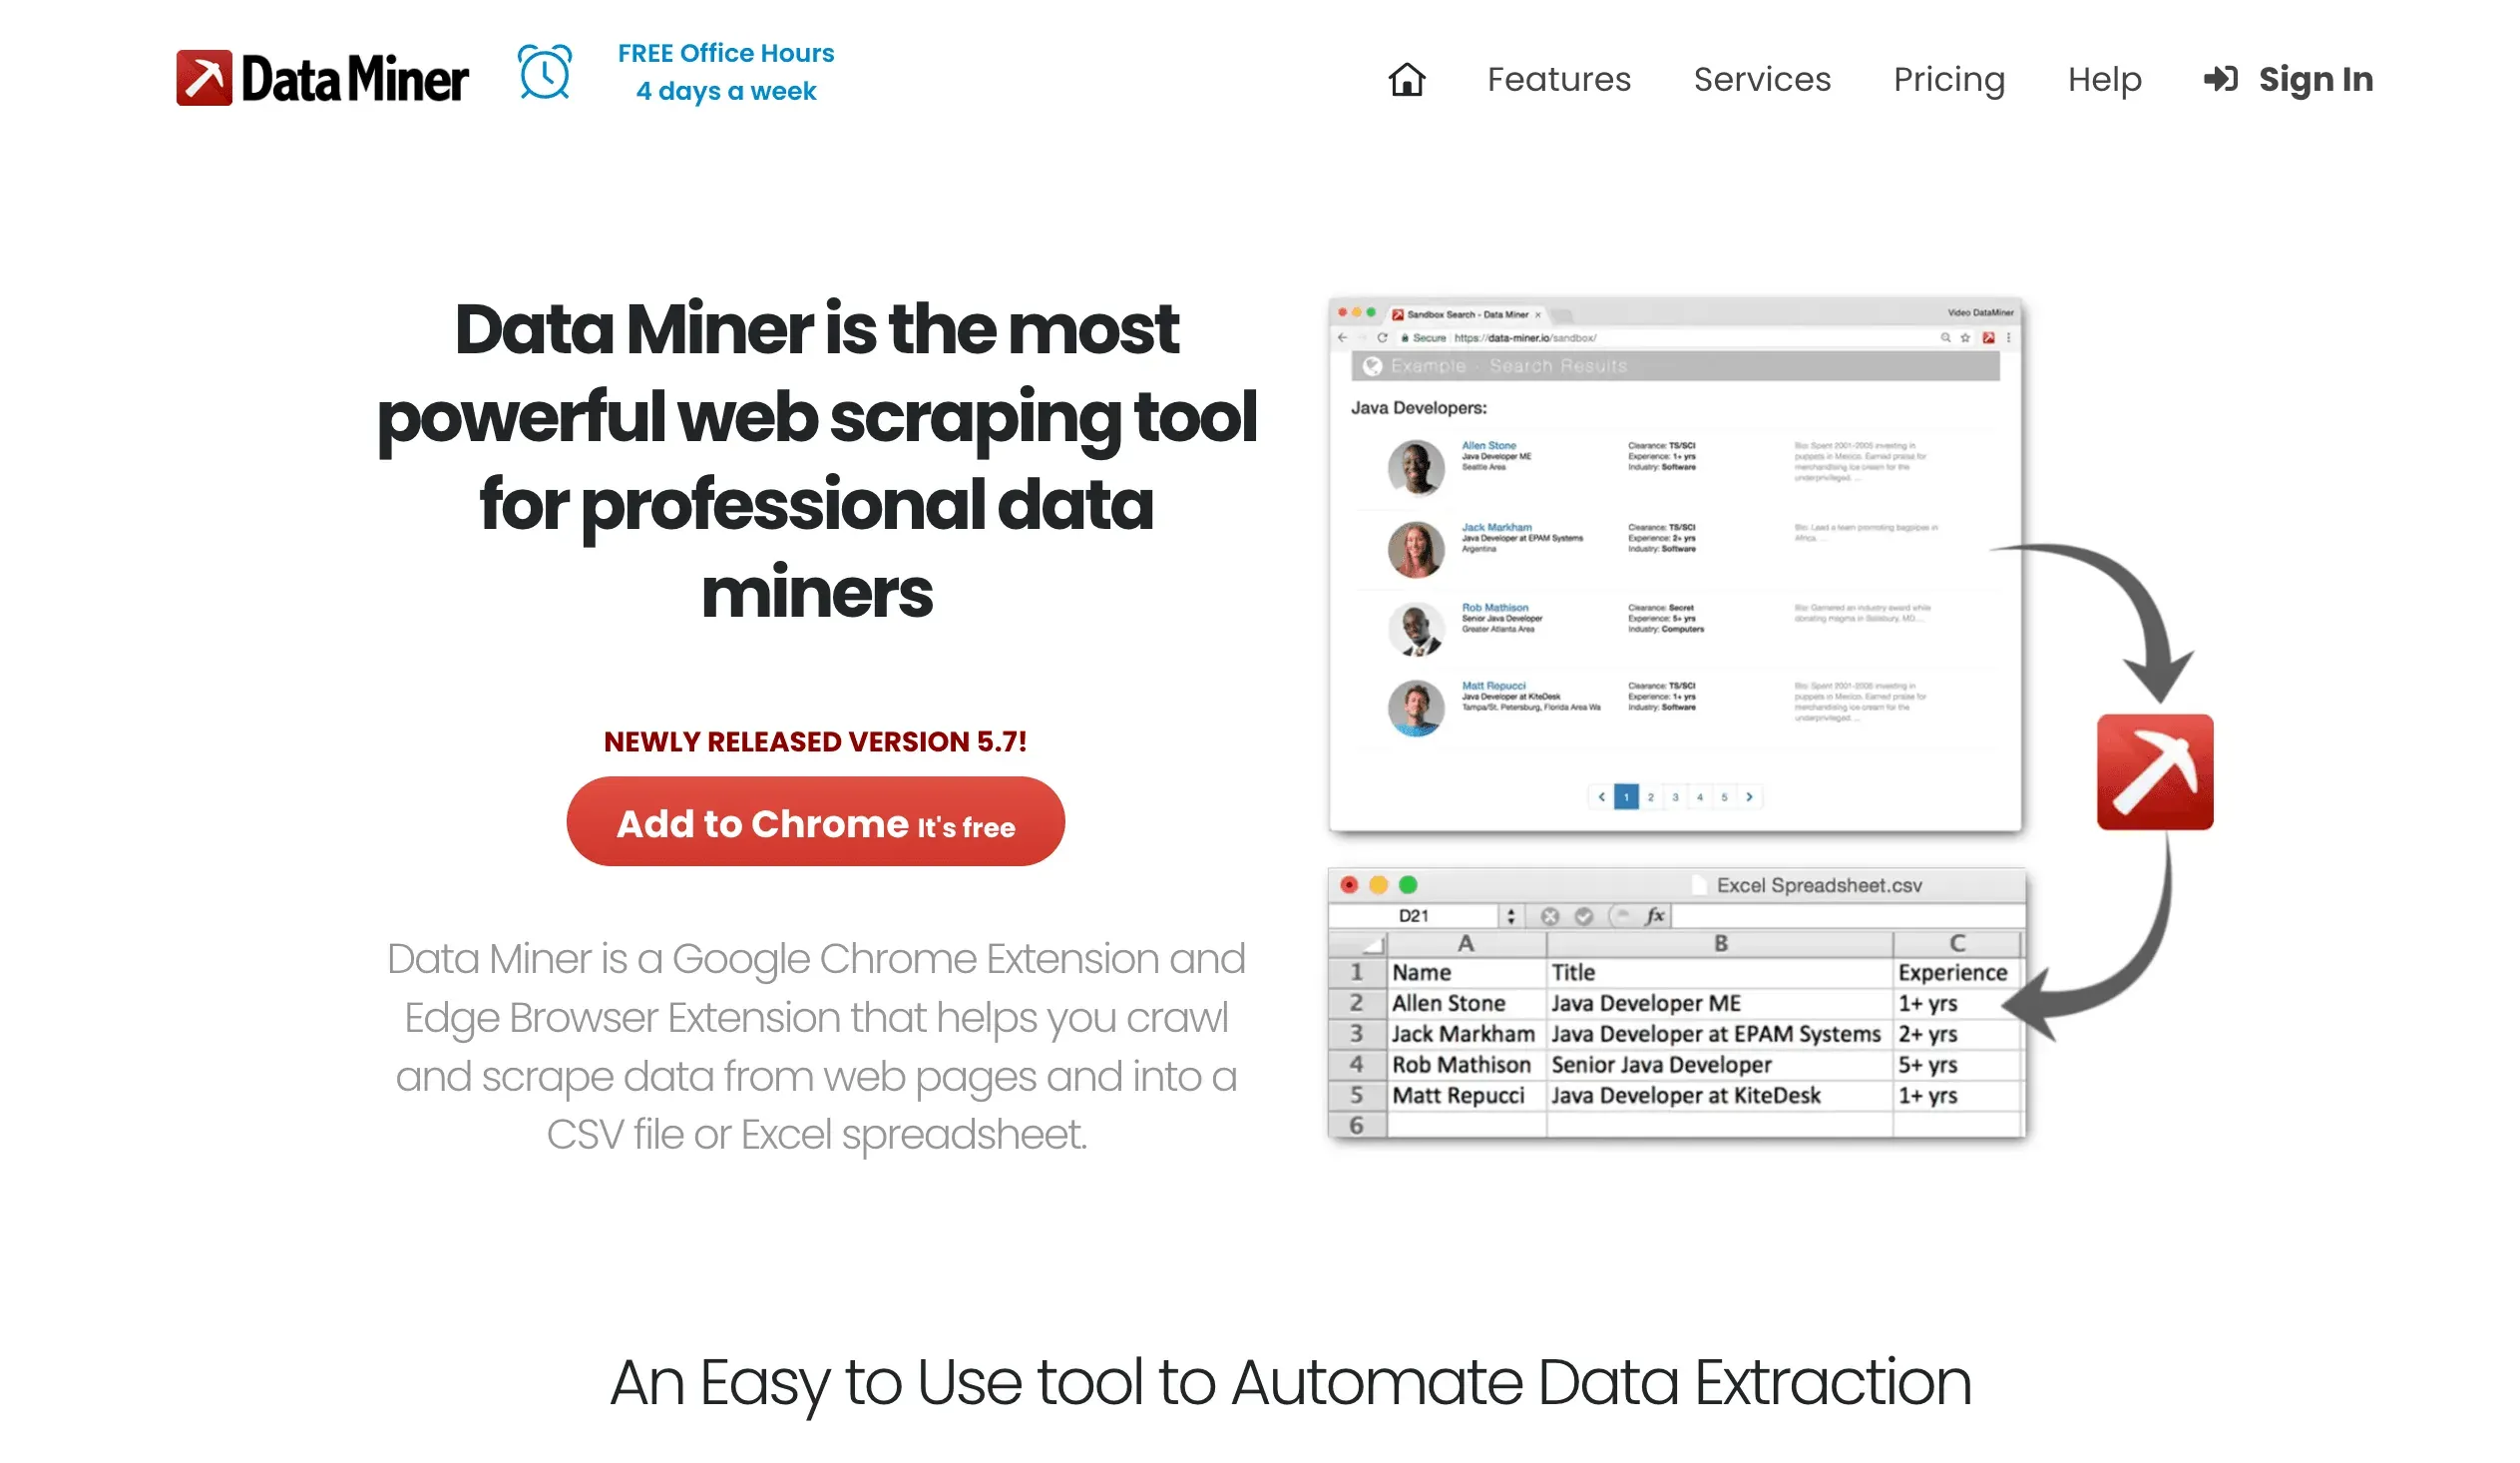 DataMiner es una extensión de Chrome que lleva el web scraping directamente al navegador. Es perfecta para extracciones rápidas basadas en plantillas de tablas, listas y sitios sencillos.
Ideal para: usuarios del día a día, equipos de ventas y cualquiera que viva en Chrome.
Funciones clave:
- Marketplace de plantillas: más de 60.000 recetas prediseñadas para sitios populares.
- Extracción punto y clic: selecciona datos visualmente, sin código.
- Exportación a Excel y Google Sheets: exporta con un clic.
- Plan gratuito: 500 páginas/mes; los planes de pago empiezan en $19/mes.
DataMiner es una de las favoritas para tareas rápidas y usuarios sin perfil técnico (DataMiner).
6. Import.io
 Import.io es una plataforma de nivel empresarial centrada en convertir contenido web en datos estructurados para analítica e inteligencia de negocio.
Ideal para: grandes empresas con necesidades importantes de datos e integración.
Funciones clave:
- Modelo de servicio gestionado: el equipo de Import.io puede construir y mantener los scrapers por ti.
- Interfaz visual: crea flujos de extracción sin código.
- Acceso por API: integra los datos extraídos directamente en tus apps y paneles.
- Cumplimiento y seguridad: controles empresariales, enmascaramiento de PII y más.
Precio: cotización personalizada, normalmente desde unos $199/mes (PromptCloud).
7. Apify
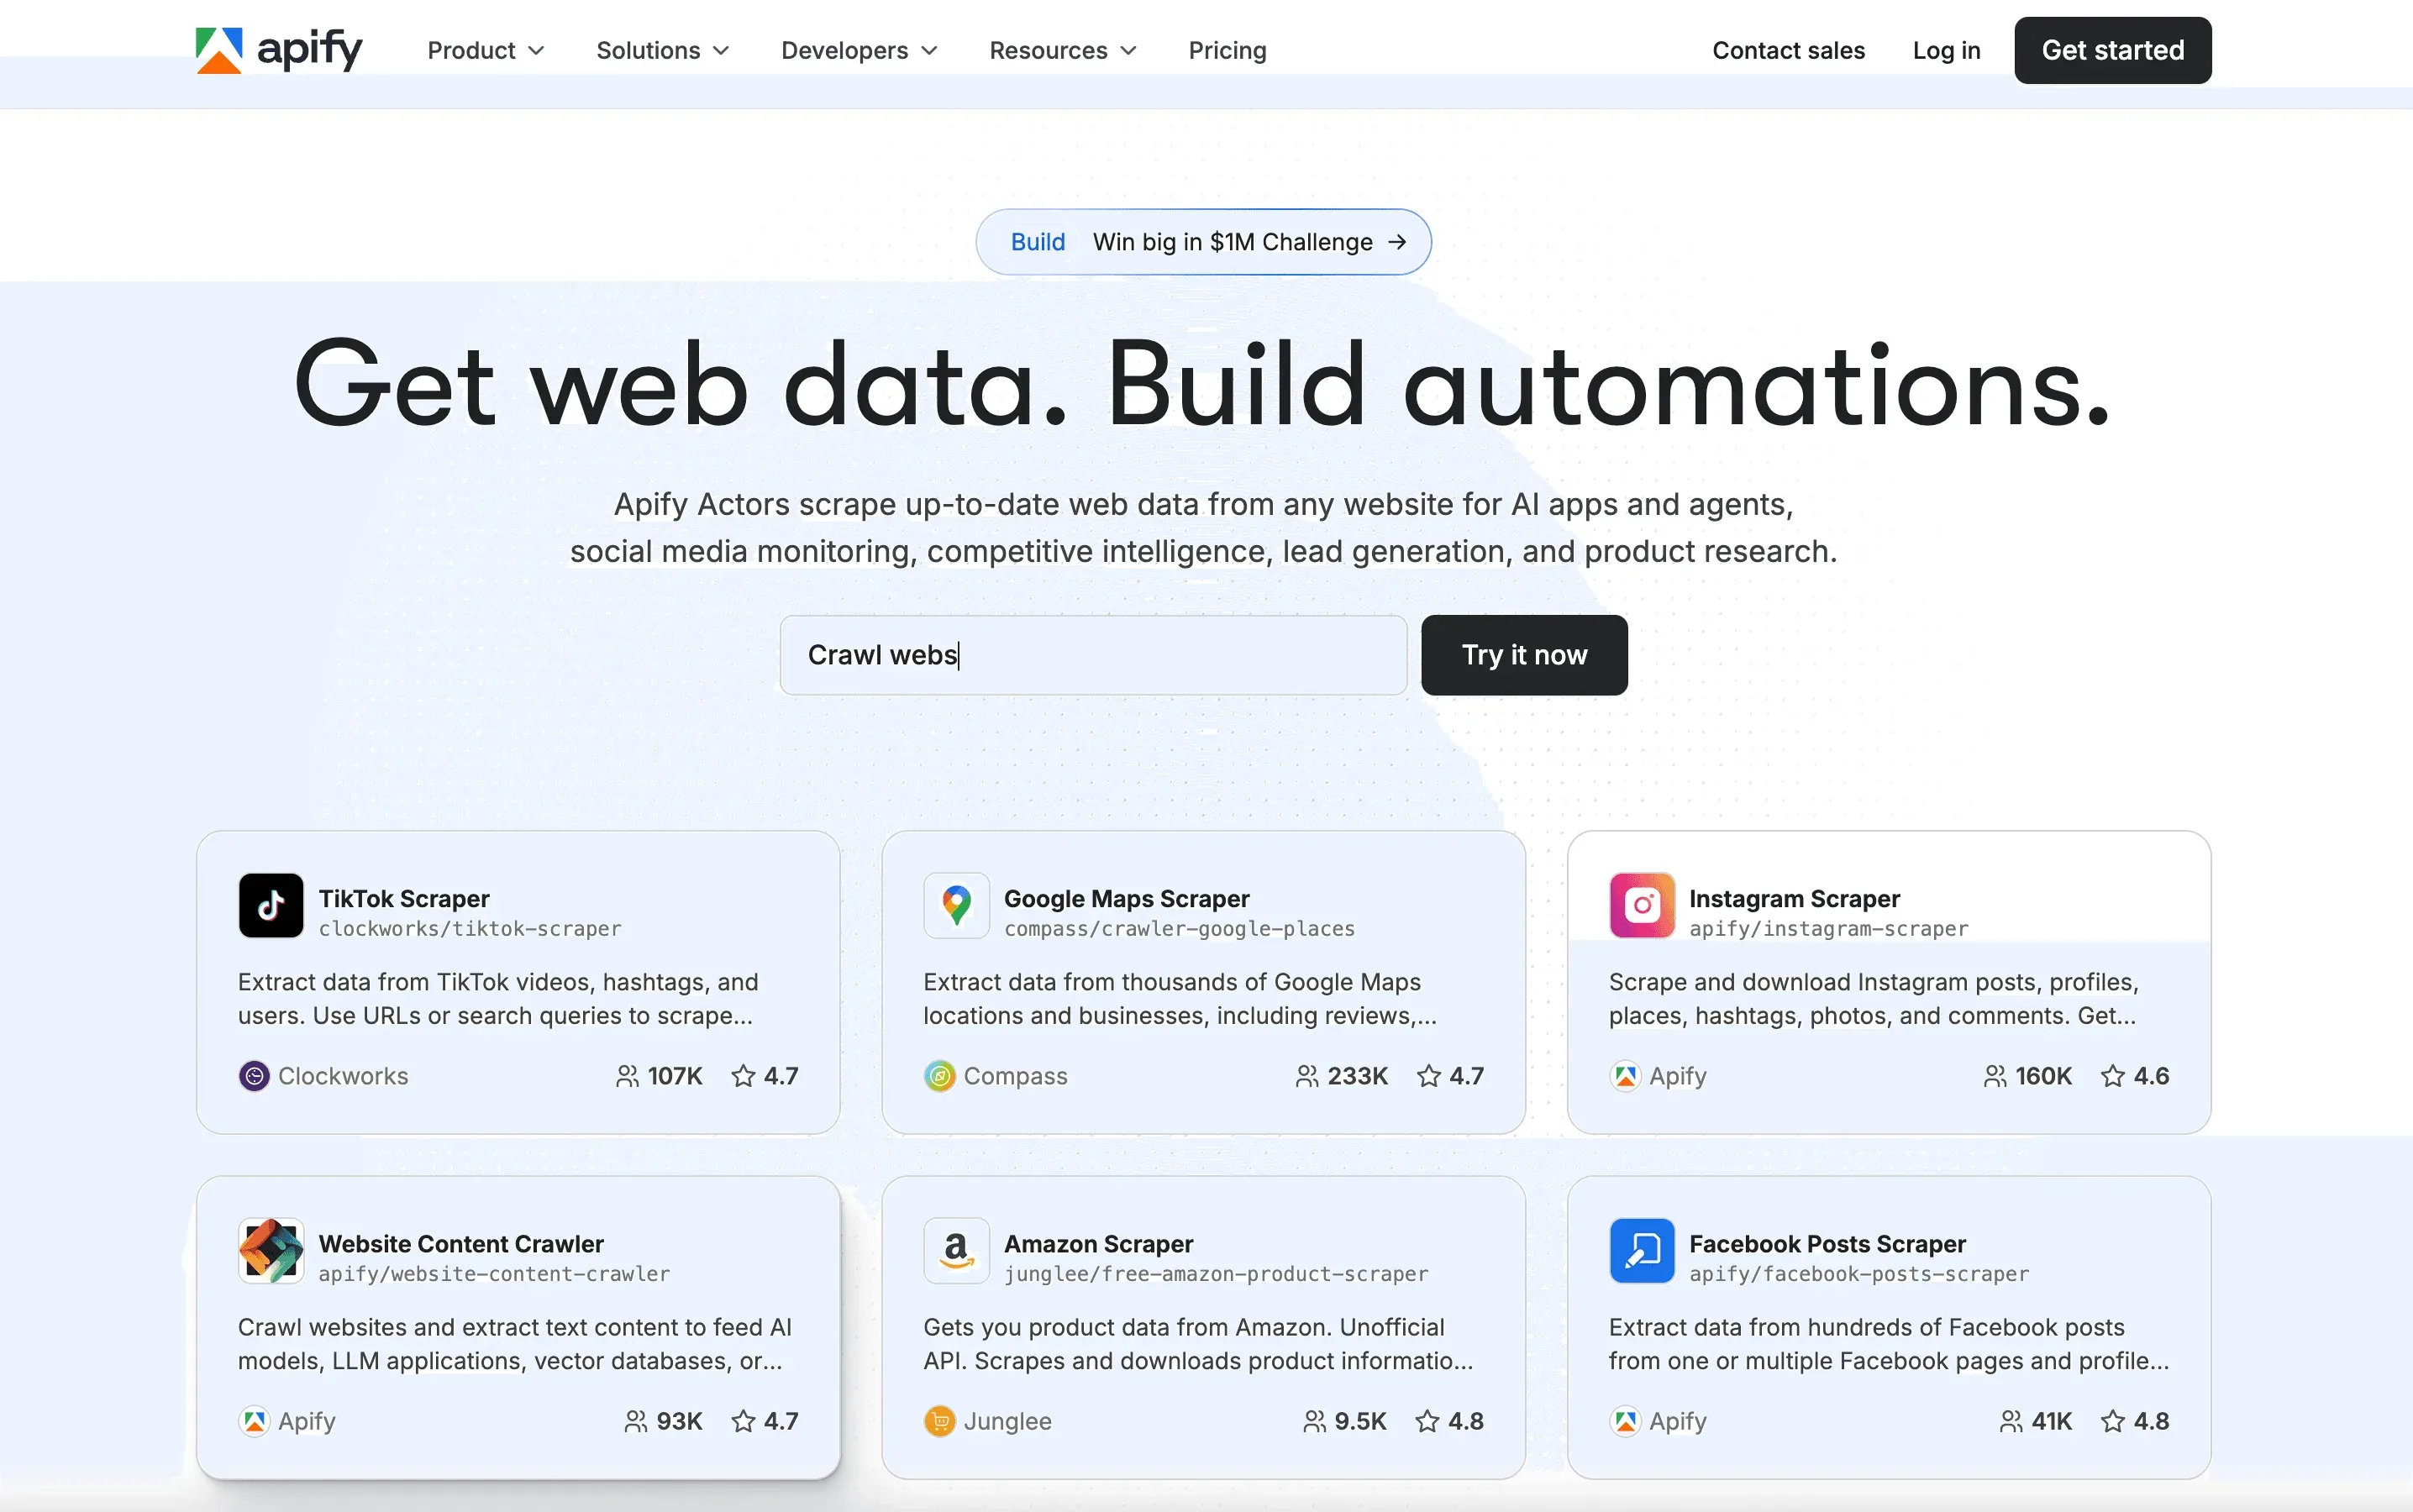 Apify es una plataforma de automatización muy amigable para desarrolladores, con un enorme marketplace de “Actors” preconstruidos (bots de scraping) y la posibilidad de crear flujos personalizados.
Ideal para: desarrolladores, agencias y equipos que quieren flexibilidad.
Funciones clave:
- Marketplace de Actors: scrapers listos para usar en sitios populares, o crea los tuyos.
- Infraestructura en la nube: ejecuta extracciones a gran escala, programa tareas e intégralas con APIs.
- Integración con GitHub: automatiza flujos de trabajo y CI/CD.
- Pago por uso: créditos gratuitos y luego facturación según uso; los planes de pago empiezan en $29/mes.
Apify es ideal tanto para proyectos sencillos como complejos (Black Bear Media).
8. Diffbot
 Diffbot utiliza IA y grafos de conocimiento para transformar contenido web no estructurado en datos estructurados y legibles por máquinas. Piensa en él como el “cerebro” del web scraping.
Ideal para: empresas, investigadores y cualquiera que necesite extracción automatizada a gran escala.
Funciones clave:
- Extracción impulsada por IA: reconoce automáticamente artículos, productos, organizaciones y más.
- Grafo de conocimiento: accede al mayor grafo de datos web del mundo mediante API.
- Enriquecimiento de datos: incorpora entidades relacionadas, noticias y contexto.
- Primero API: integra con herramientas de BI y canalizaciones de datos.
Precio: desde $299/mes (Diffbot Pricing).
9. WebHarvy
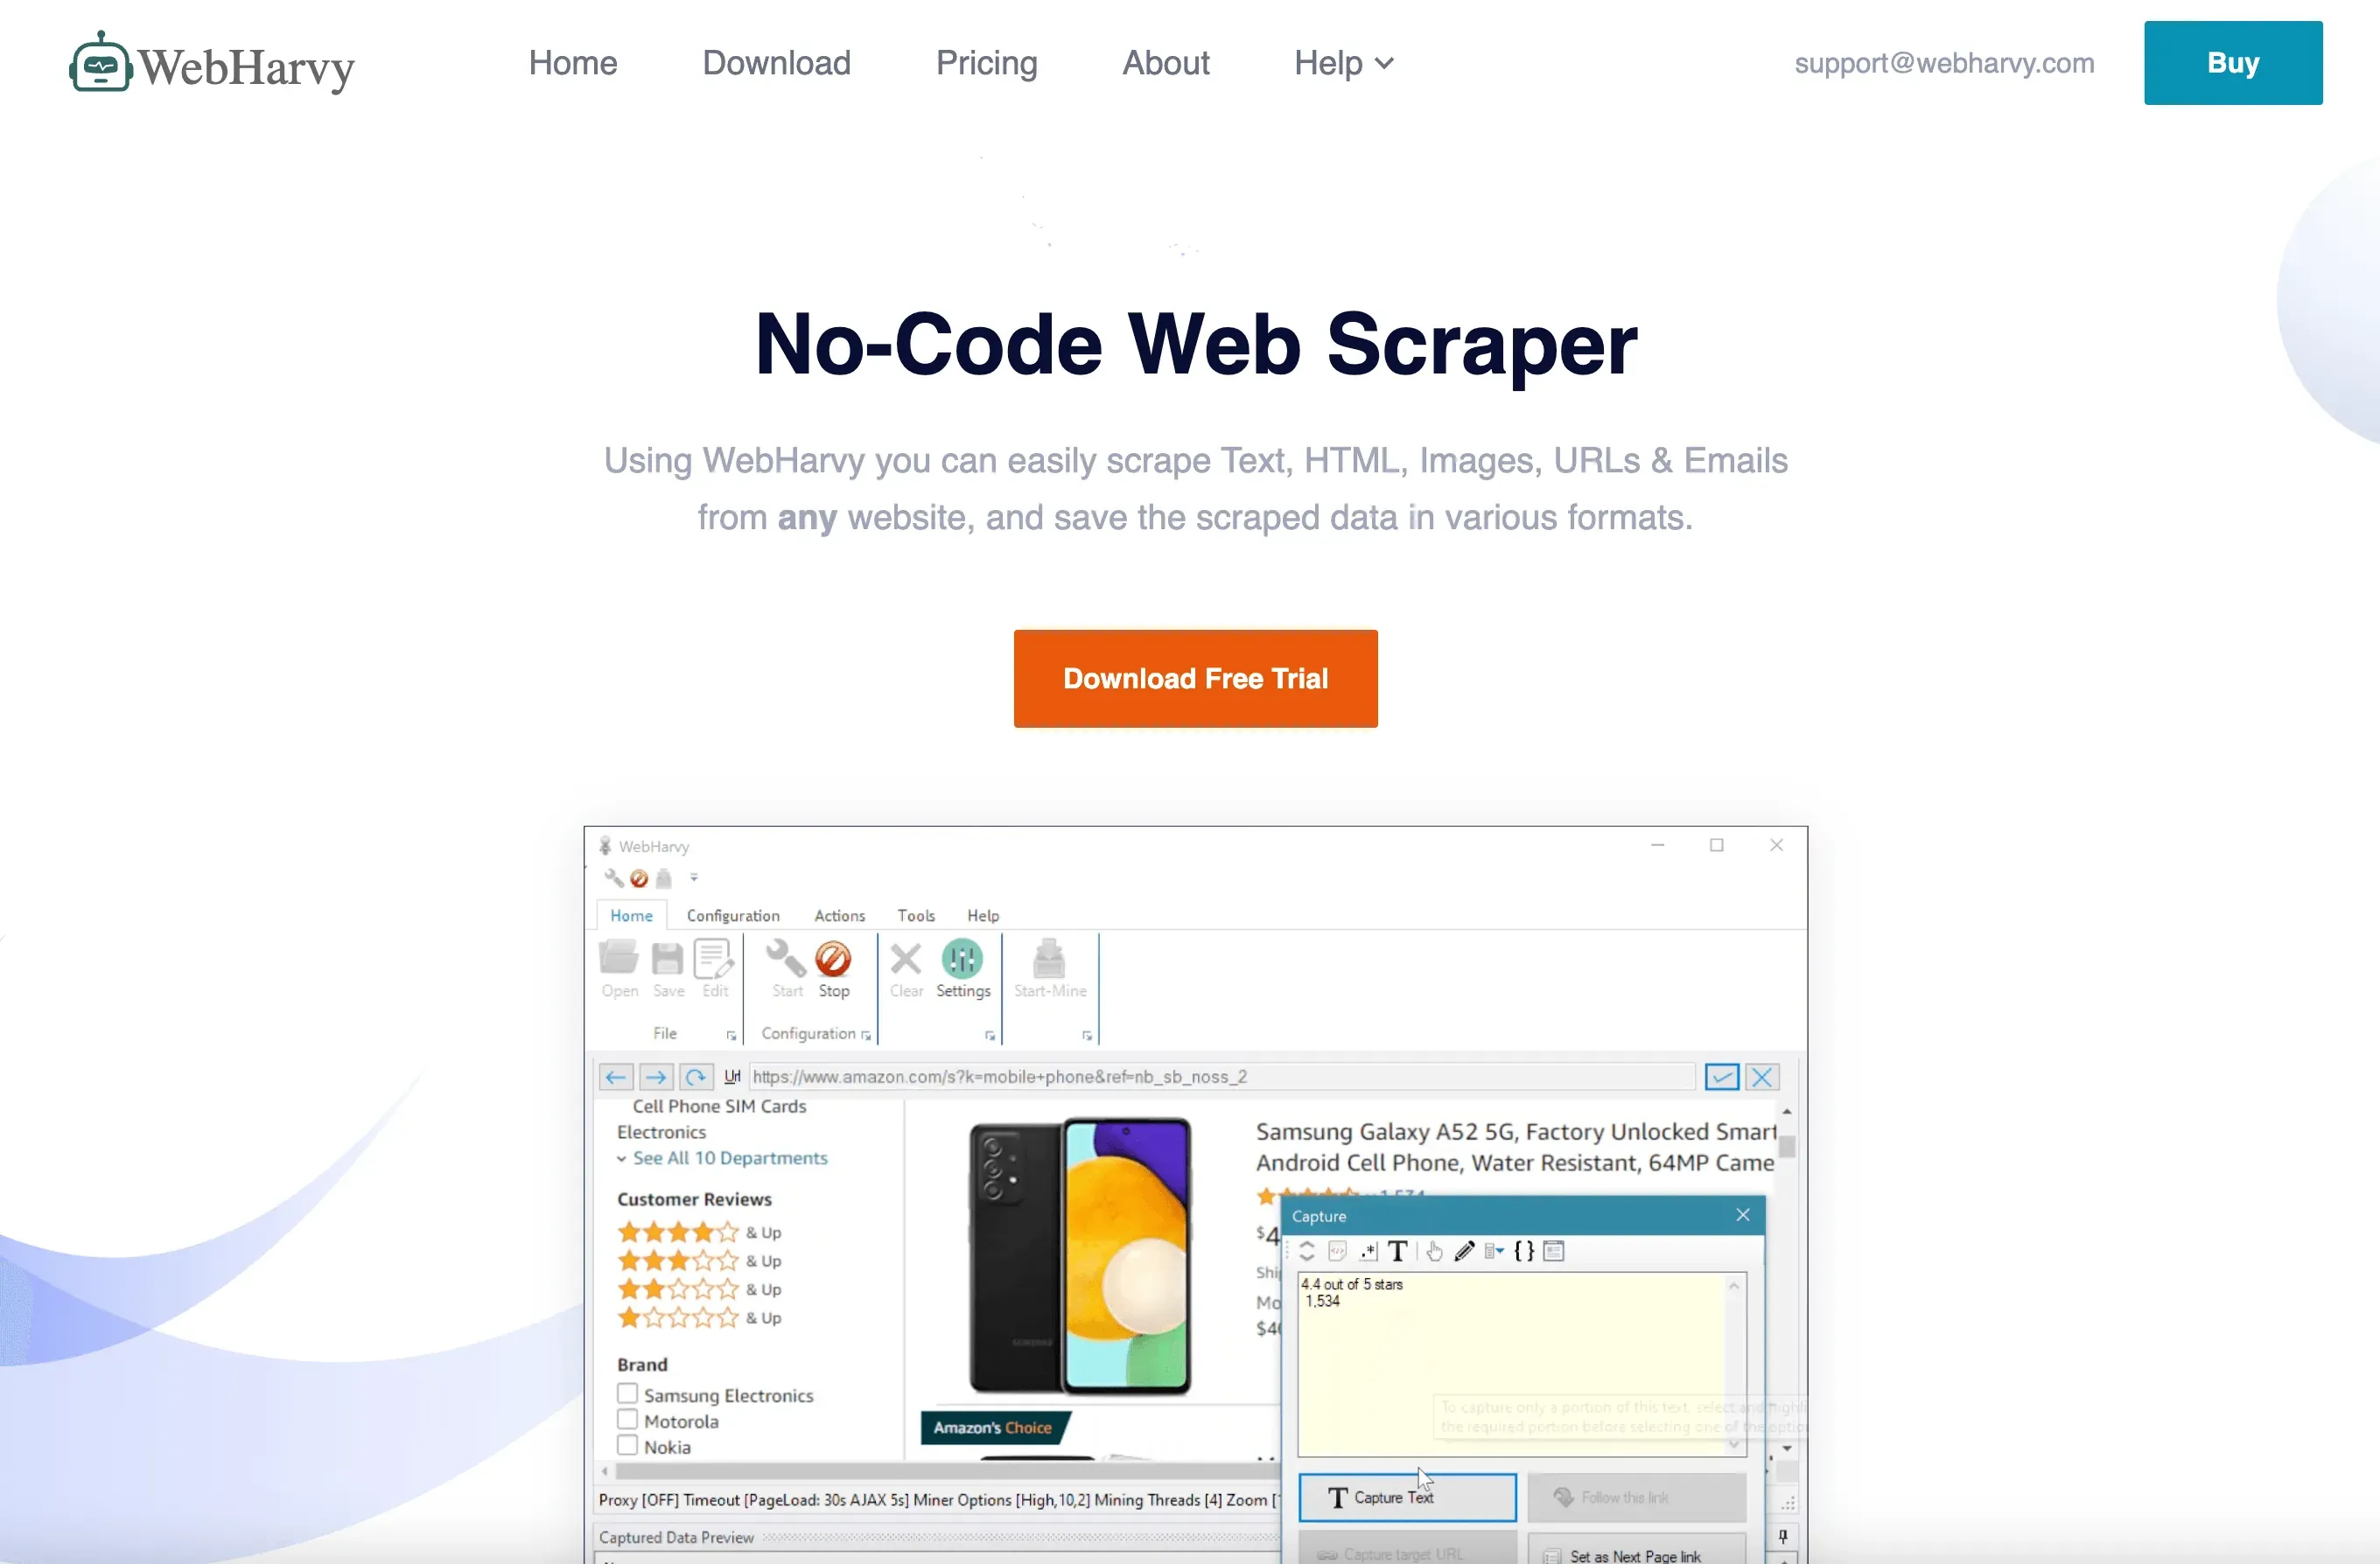 WebHarvy es un scraper de escritorio para Windows con una interfaz visual de señalar y hacer clic. Es ideal para quienes quieren evitar el código y prefieren una app de escritorio.
Ideal para: usuarios de Windows, investigadores y pymes.
Funciones clave:
- Selección visual: haz clic en los datos para definir campos, sin código.
- Gestiona imágenes y navegación entre páginas: extrae texto, imágenes y sigue la paginación.
- Exportación a Excel, XML y bases de datos: opciones flexibles de salida.
- Licencia única: pagas una vez y lo usas para siempre (WebHarvy).
WebHarvy es especialmente popular para extraer datos de sitios de e-commerce y clasificados (Thunderbit Blog).
10. Mozenda
 Mozenda es una plataforma en la nube diseñada para extracción y automatización de datos a escala empresarial.
Ideal para: grandes organizaciones e industrias con fuertes requisitos de cumplimiento.
Funciones clave:
- Automatización en la nube: programa, supervisa y gestiona tareas de scraping de forma centralizada.
- Transformación de datos: limpia, enriquece y exporta datos en varios formatos.
- Colaboración en equipo: soporte multiusuario y gestión de flujos de trabajo.
- Soporte empresarial: cumplimiento, fiabilidad y ayuda dedicada (Appvizer).
Precio: alrededor de $99/mes; también hay precios empresariales.
11. Sequentum (antes Content Grabber)
 Sequentum es un scraper de escritorio y web avanzado para profesionales del dato y agencias. Si lo conocías como Content Grabber, ese nombre ya quedó atrás: Sequentum renombró el producto y contentgrabber.com ya no resuelve (Sequentum FAQ).
Ideal para: profesionales del dato, agencias y cualquiera que necesite automatización profunda.
Funciones clave:
- Scripting avanzado: automatiza lógica de extracción compleja.
- Informes y monitorización: sigue tareas, recibe alertas y gestiona proyectos grandes.
- Integración: exporta a bases de datos, APIs o almacenamiento en la nube.
- Sin plan gratuito: solo licencias de pago (DataOX).
Sequentum está pensado para extracción personalizable y de alto volumen.
12. Helium Scraper
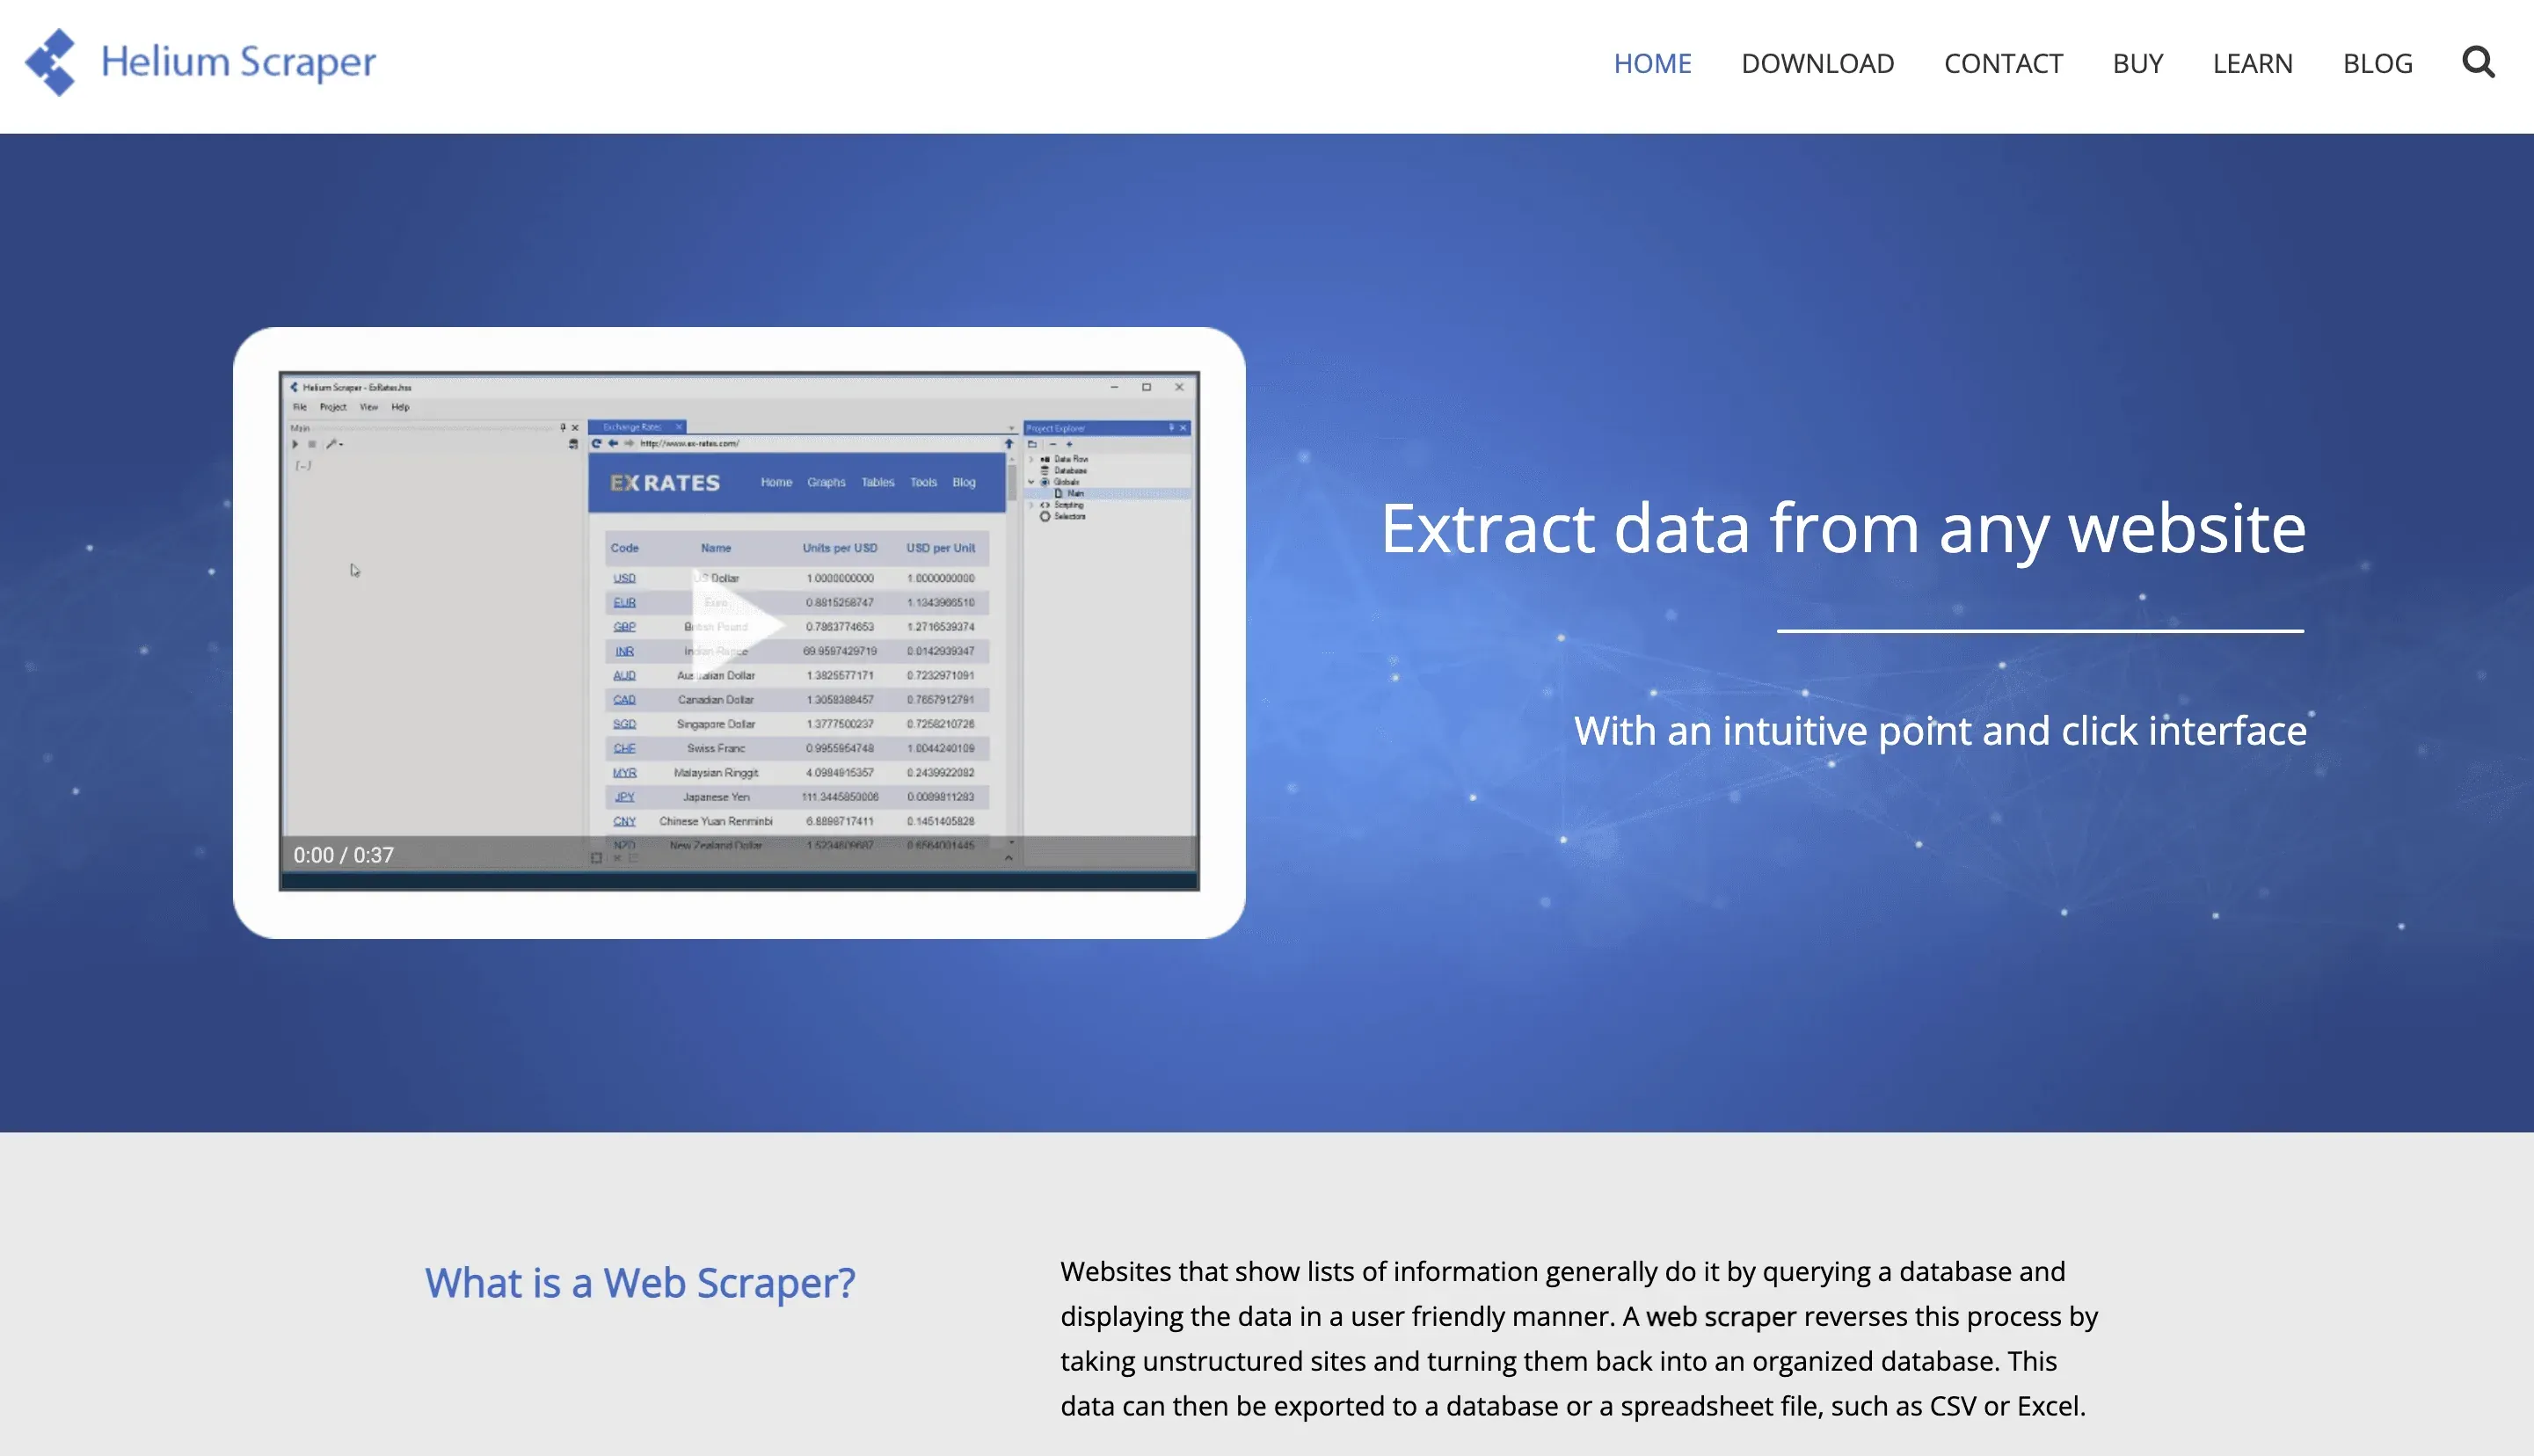 Helium Scraper es una herramienta de escritorio con un generador visual de flujos de trabajo, ideal para extraer datos de sitios complejos y dinámicos.
Ideal para: usuarios avanzados, analistas y cualquiera que busque flexibilidad sin código.
Funciones clave:
- Flujo visual: interfaz de arrastrar y soltar para crear lógica de extracción.
- Gestiona contenido dinámico: funciona con sitios muy cargados de JavaScript.
- Transformación de datos: limpia y organiza la información antes de exportarla.
- Opciones de exportación: Excel, CSV, bases de datos y más.
- Pago único: licencias permanentes desde $99 (Basic, 1 usuario) hasta $699 (Enterprise, 10 usuarios), sin suscripción (Helium Scraper).
Helium Scraper es especialmente útil para sitios no estándar y flujos de trabajo personalizados.
Comparativa de las mejores empresas de web scraping: funciones de un vistazo
Aquí tienes una comparación rápida lado a lado para ayudarte a elegir la opción adecuada:
| Empresa | Ideal para | Facilidad de uso | Automatización e IA | Escalabilidad | Opciones de exportación | Plan gratuito / Precio |
|---|---|---|---|---|---|---|
| Thunderbit | Usuarios sin código, pymes | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ | Excel, Sheets, Notion | Gratis (6 páginas), desde $15/mes |
| Scrapy | Desarrolladores | ⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | Python, CSV, DB | Gratis, código abierto |
| ParseHub | Pymes, investigadores | ⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐ | CSV, Excel, JSON | Gratis (5 proyectos), desde $189 |
| Octoparse | Operaciones, marketing | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐ | Excel, DB, API | Gratis (10k filas), desde $69 |
| DataMiner | Usuarios de Chrome | ⭐⭐⭐⭐⭐ | ⭐⭐ | ⭐⭐ | Excel, Sheets | Gratis (500 páginas), desde $19 |
| Import.io | Empresas | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | API, DB, Cloud | Personalizado, desde $199/mes |
| Apify | Desarrolladores, agencias | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | API, DB, Sheets | Créditos gratis, desde $29/mes |
| Diffbot | Investigación, analítica | ⭐⭐ | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | API, Knowledge Graph | Desde $299/mes |
| WebHarvy | Usuarios de Windows | ⭐⭐⭐⭐ | ⭐⭐ | ⭐⭐ | Excel, XML, DB | Pago único, desde $129 |
| Mozenda | Empresas | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | Excel, API, Cloud | Desde $99/mes, empresarial |
| Sequentum | Profesionales del dato, agencias | ⭐⭐⭐ | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ | DB, API, Cloud | Solo licencia de pago |
| Helium Scraper | Usuarios avanzados, analistas | ⭐⭐⭐⭐ | ⭐⭐⭐ | ⭐⭐⭐ | Excel, CSV, DB | Pago único, desde $99 |
Selecciones rápidas:
- Para usuarios sin código: Thunderbit, DataMiner, ParseHub, WebHarvy
- Para desarrolladores: Scrapy, Apify, Sequentum
- Para empresas: Import.io, Diffbot, Mozenda
- Para flujos visuales y flexibles: Thunderbit, Octoparse, Helium Scraper
Conclusión: cómo elegir el socio de web scraping adecuado para tu negocio
Explora más guías de web scraping Get Started Free
En 2026, el web scraping ya no es solo cosa de técnicos: es una capacidad clave para cualquier negocio que necesite datos para tomar decisiones más inteligentes y rápidas. La empresa de web scraping adecuada puede ahorrarte horas, mejorar tu ROI y sacar a la luz insights que tu competencia podría pasar por alto.
Mi consejo:
- Alinea la herramienta con tu equipo: los usuarios no técnicos van a disfrutar más con Thunderbit o DataMiner. Los desarrolladores deberían mirar Scrapy o Apify. Para empresas, revisa Import.io o Diffbot.
- Piensa en escala e integración: ¿vas a extraer miles de páginas? ¿Quieres los datos en Sheets, Notion o tu CRM?
- Empieza con una prueba gratuita: la mayoría de herramientas ofrecen un plan gratis; pruébalas en un proyecto real antes de comprometerte.
- No tengas miedo de combinar herramientas: a veces el mejor flujo de trabajo mezcla varias soluciones.
Y si quieres comprobar lo fácil que puede ser el web scraping, prueba Thunderbit. Tus hojas de cálculo —y tu salud mental— te lo van a agradecer.
Para más análisis en profundidad, consejos y tutoriales, visita el Thunderbit Blog.
Empieza a extraer datos con Thunderbit
Preguntas frecuentes
1. ¿Qué es el web scraping y por qué es importante para las empresas en 2026?
El web scraping es el proceso automatizado de extraer datos de sitios web. Es clave para las empresas porque permite recopilar datos de forma rápida y a gran escala para generación de leads, seguimiento de precios, investigación de mercado y mucho más, ahorrando tiempo y mejorando la toma de decisiones.
2. ¿Qué empresa de web scraping es mejor para usuarios sin conocimientos técnicos?
Thunderbit y DataMiner son opciones destacadas para personas sin código, gracias a sus interfaces visuales y basadas en IA. Ambas permiten extraer datos en solo unos clics, sin necesidad de programar.
3. ¿Qué funciones debería buscar en una empresa de web scraping?
Busca facilidad de uso, automatización (paginación, subpáginas, programación), escalabilidad, opciones de exportación (Excel, Sheets, APIs) y un soporte al cliente sólido. Elige una herramienta que encaje con tus habilidades técnicas y necesidades de negocio.
4. ¿Existen soluciones gratuitas de web scraping?
Sí. Thunderbit, DataMiner, ParseHub y Octoparse ofrecen planes gratuitos. Scrapy es de código abierto y gratuito para desarrolladores. Los planes gratis son ideales para proyectos pequeños o para probar antes de escalar.
5. ¿Cómo puedo mantener el cumplimiento y la ética al extraer datos?
Respeta siempre los términos de servicio y las políticas de privacidad de los sitios web. Extrae solo datos disponibles públicamente, evita sobrecargar los sitios y ten en cuenta normativas de privacidad como el RGPD. Muchas de las principales empresas de web scraping ofrecen funciones de cumplimiento y guías de buenas prácticas.
¿Listo para extraer datos de forma más inteligente? Prueba Thunderbit gratis o explora más guías en el Thunderbit Blog.
Prueba el AI Web Scraper Get Started Free
Más información



