El tráfico automatizado de bots ya representa más del 53% de todo el tráfico web—más que el generado por personas. Si haces scraping de datos, gestionas cuentas o verificas anuncios por regiones, estás trabajando en un entorno donde los sistemas anti-bot están diseñados específicamente para detectarte.
Y aun así, la mayoría de las guías sobre "proxies estáticos vs rotativos" reducen todo el tema a una tabla de dos columnas y listo. Omiten el tercer concepto (las sesiones sticky), ignoran cómo funciona realmente la detección y nunca hacen las cuentas de costo a escala. He dedicado mucho tiempo a investigar proveedores de proxies y APIs de scraping con IA para nuestro trabajo en Thunderbit, y la realidad es mucho más compleja—y más interesante—de lo que suelen sugerir esas listas. Esta guía cubre la diferencia real entre tres modelos que la mayoría de artículos confunde, cómo los sistemas anti-bot detectan de verdad el tráfico de proxy, cuánto cuesta procesar 50 mil páginas al día con distintos tipos de proxy y 9 herramientas que realmente consideraría usar. Algunas son proveedores puros de proxy, otras son APIs de scraping y una (la nuestra) elimina por completo la gestión de proxies.
Prueba Thunderbit para scraping con IA
Proxies estáticos vs rotativos vs sticky: la diferencia entre tres opciones que la mayoría de guías pasa por alto
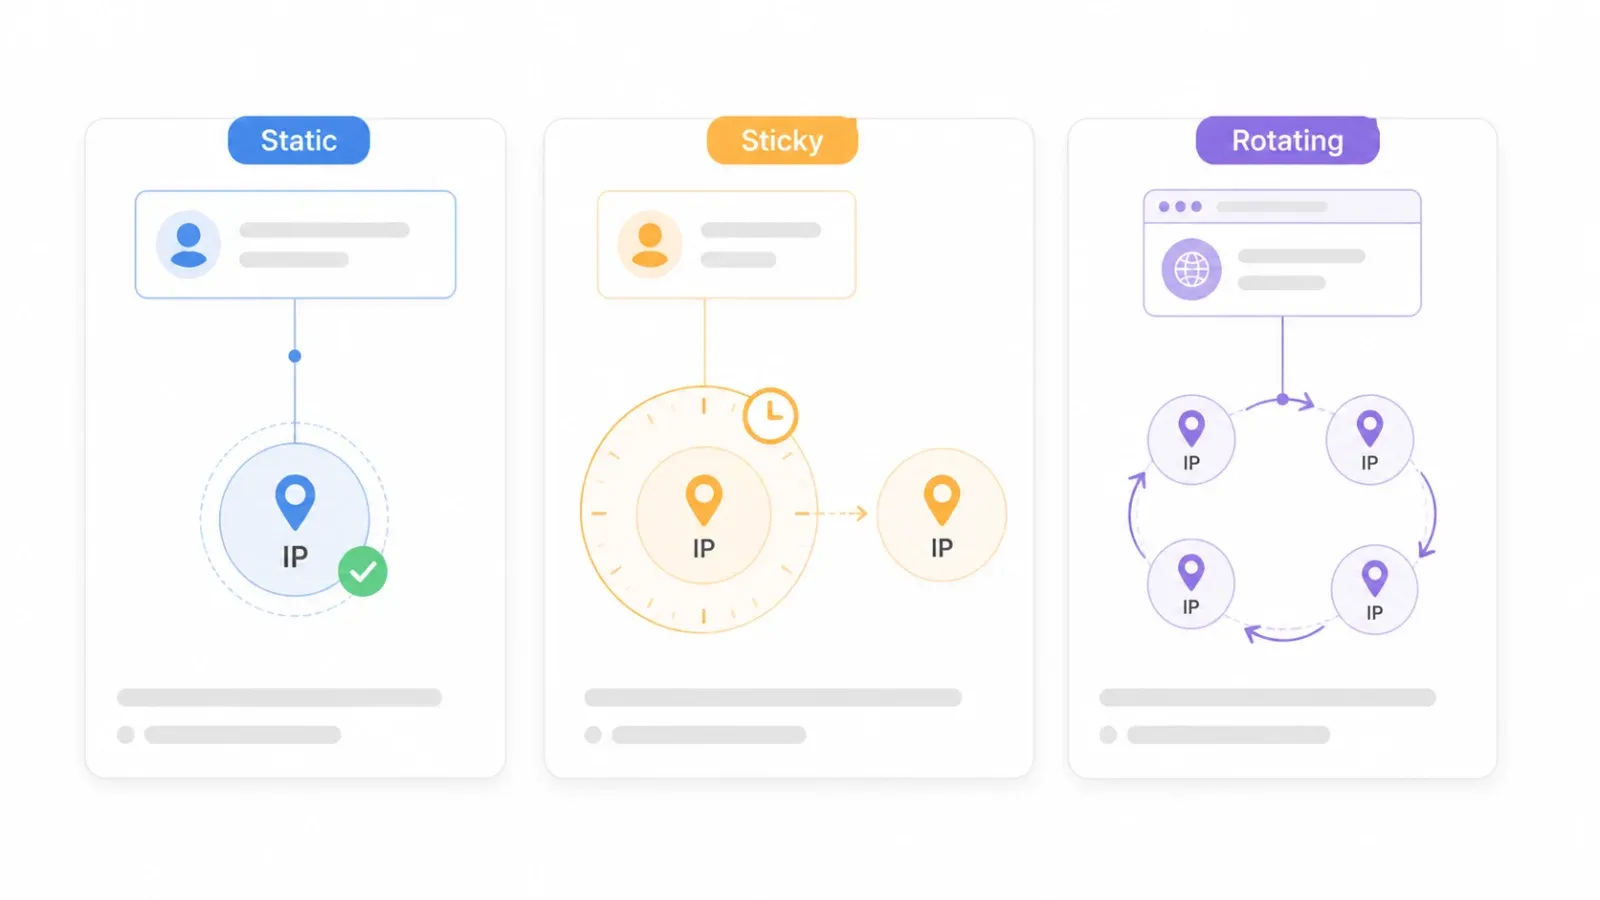
La mayoría de los artículos comparativos presentan esto como una disyuntiva: estático o rotativo. Ese enfoque se queda corto y termina llevando a malas decisiones de compra. En realidad, existen tres comportamientos distintos de proxy, y cada uno sirve para cosas diferentes.
Proxy estático: la misma dirección IP, indefinidamente, hasta que la cambias manualmente o vence el contrato. Piensa en tu conexión de internet en casa: la misma dirección todos los días. Es útil cuando una plataforma espera ver la misma identidad a lo largo del tiempo (gestión de cuentas, contenido bloqueado por región, seguimiento de posiciones).
Sesión sticky: la misma IP durante una ventana configurable—quizá 10 minutos, quizá 30, quizá hasta 24 horas según el proveedor—y luego rota a otra. Una sesión sticky da continuidad temporal; un proxy estático da continuidad permanente. Decodo (antes Smartproxy) explica que las sesiones sticky mantienen una IP durante 1, 10, 30, 60 minutos o intervalos personalizados de hasta 24 horas.
Proxy rotativo: una IP nueva en cada solicitud, o cada pocos segundos. Máxima anonimidad para tareas de alto volumen, pero sin continuidad de sesión, salvo que agregues sticky sessions encima.
La diferencia en formato tabla:
| Atributo | Proxy estático | Sesión sticky | Proxy rotativo |
|---|---|---|---|
| ¿Cambia la IP? | Nunca (misma IP indefinidamente) | Tras una duración fija (p. ej., 10–30 min) | En cada solicitud o cada pocos segundos |
| Persistencia de sesión | Permanente | Temporal (TTL configurable) | Ninguna |
| Caso de uso típico | Gestión de cuentas, contenido bloqueado por región | Scraping en varios pasos (login → navegar → extraer) | Scraping masivo, verificación de anuncios |
| Riesgo de detección | Mayor con el tiempo (la misma huella acumula historial) | Moderado | El más bajo para detección basada en IP (si es residencial) |
| Modelo de costo | Normalmente por IP/mes | Parte de planes residenciales/móviles facturados por GB | Por GB, por solicitud o tarifa plana |
¿Por qué importa esto al elegir una herramienta? Si vas a iniciar sesión en una plataforma, añadir productos al carrito o completar un formulario en varios pasos, necesitas sesiones sticky—not un rotado puro (que rompería la sesión) ni necesariamente una IP estática permanente (que es excesivo y caro). Los usuarios de foros en r/proxies suelen confundir estas categorías y preguntan si las sesiones sticky se comportan como "proxies residenciales rotativos normales" o como IPs estáticas. La respuesta: ninguna de las dos. Son una tercera cosa.
Cómo detectan realmente los sistemas anti-bot los proxies estáticos vs rotativos
Todos los artículos comparativos de proxies mencionan "riesgo de detección" en una celda de tabla. Casi ninguno explica cómo funciona esa detección. Y eso importa, porque el método de detección determina si rotar IPs realmente ayuda.
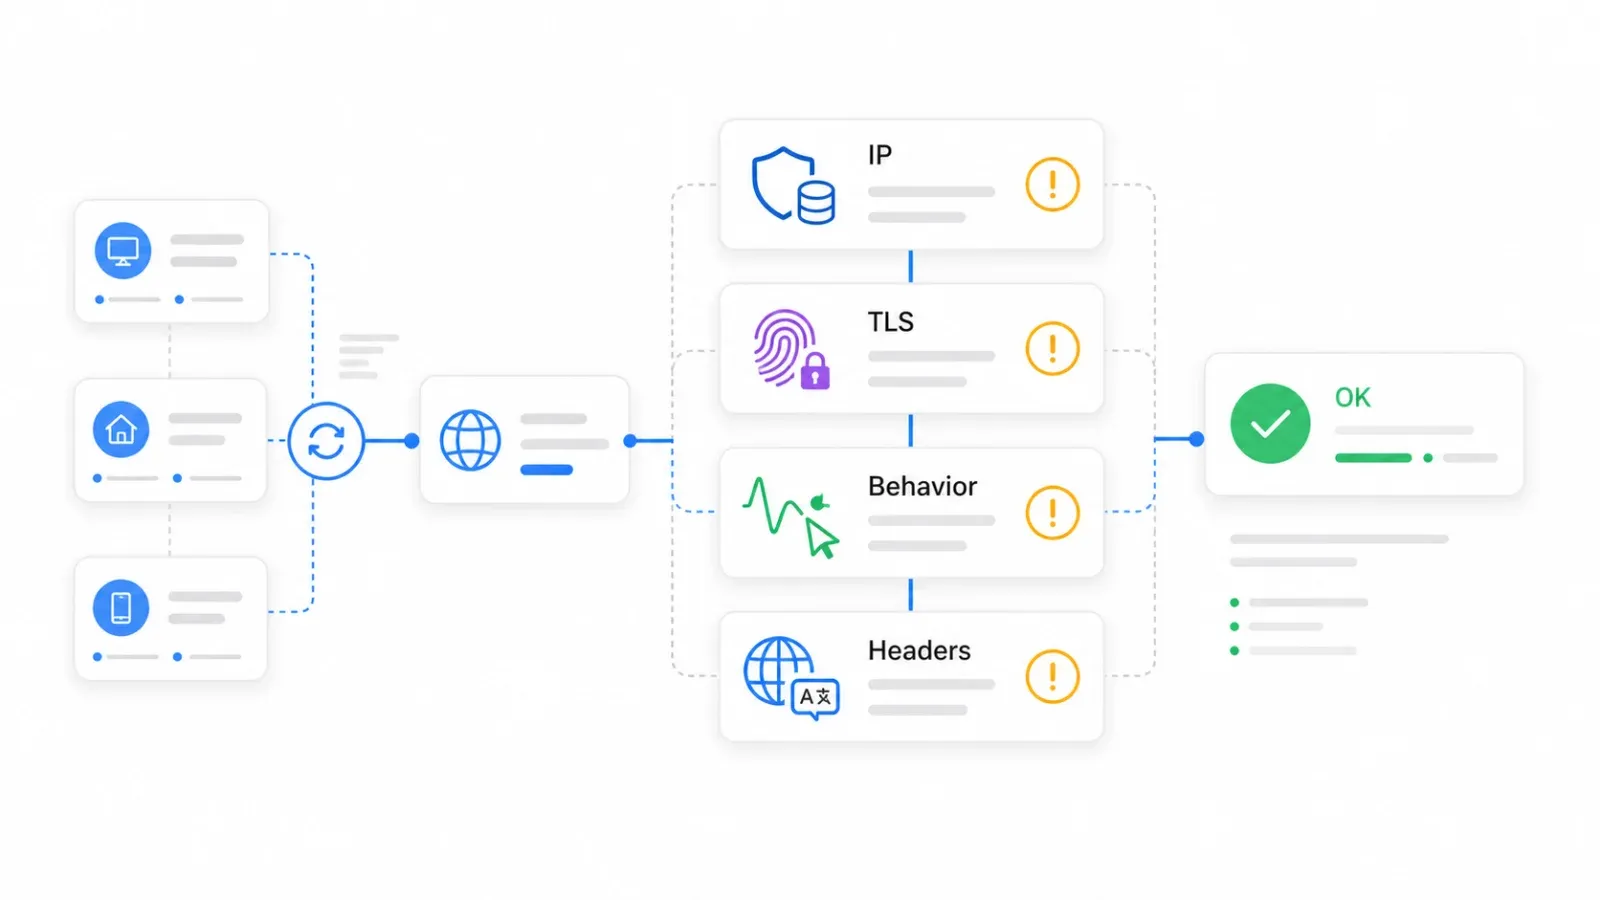
Los sistemas anti-bot modernos usan al menos cuatro capas, y rotar tu IP solo resuelve una de ellas.
Capa 1: bases de datos de reputación de IP
Los rangos de IP de datacenter provienen de ASN de nube y hosting—Amazon, Google, DigitalOcean, etc. Los proveedores anti-bot mantienen bases de datos que marcan estos rangos de antemano. Las IP residenciales y móviles parten con más confianza porque parecen tráfico normal de consumidores. La documentación de bots de Cloudflare lo plantea con scores de bot de 1 a 99, donde las puntuaciones bajas indican automatización probable. Si tu IP pertenece a un rango conocido de datacenter, empiezas con una puntuación de confianza baja antes de hacer una sola solicitud.
Capa 2: fingerprinting TLS/JA3/JA4
Esta es la parte que la mayoría de compradores de proxies no conoce. Cuando tu cliente inicia una conexión HTTPS, el handshake TLS revela características del software que hace la solicitud. La documentación de Cloudflare sobre JA3/JA4 explica que estas huellas identifican clientes TLS según las características de la conexión y funcionan como identificadores estables entre distintas IP de destino. En palabras simples: si tu solicitud dice ser Chrome en macOS pero el handshake TLS parece el de la librería requests de Python, rotar la IP no arregla esa incoherencia. La huella te acompaña.
Capa 3: señales de comportamiento
Cadencia de solicitudes, orden de navegación, movimiento del mouse (o su ausencia), patrones de inicio de sesión y si la sesión evoluciona como lo haría una persona navegando. La documentación de detección de DataDome describe modelos de comportamiento que detectan patrones anómalos como demasiados intentos de login o velocidades de navegación inhumanas. Un estudio de arXiv de 2026 sobre agentes de navegación con IA encontró que las huellas de comportamiento eran más discriminantes que las huellas del navegador para distinguir agentes de IA de humanos.
Capa 4: coherencia de headers y entorno
Un estudio académico de medición de 2026 sobre 10.000 sitios encontró que el 75% de los bloqueos exclusivos de Chromium headless se debían solo a señales a nivel de headers. Si tu header Accept-Language dice en-US pero tu IP se geolocaliza en São Paulo, esa incoherencia es una señal. Si tu user agent no coincide con tu huella TLS, esa es otra señal.
La conclusión: rotar IPs reduce límites de velocidad y acumulación de reputación basados en IP. No soluciona desajustes de huella TLS, anomalías de comportamiento ni incoherencias en headers. Precisamente por eso las herramientas de scraping API-first—que gestionan renderizado, coherencia de huella y resolución de CAPTCHA a nivel de infraestructura—se han convertido en una alternativa práctica frente a tener que manejar tú mismo las cuatro capas.
Olvídate de la gestión de proxies con scraping con IA Get Started Free
El costo real de los proxies estáticos vs rotativos a escala
El precio es la parte que la mayoría de guías de proxies se salta o suaviza con palabras como "asequible". Pero el modelo de cobro + el peso de las páginas + la tasa de bloqueos cambia por completo el costo total.
El Web Almanac 2025 de HTTP Archive informa que la página principal mediana pesa 2.86 MB en escritorio. Si renderizas páginas completas a través de un proxy residencial medido con 50,000 páginas al día, eso son unos 143 GB/día, o alrededor de 4.29 TB/mes. Con tarifas de $5–$15/GB para ancho de banda residencial rotativo, estarías mirando entre $21,450 y $64,350 al mes antes de reintentos y solicitudes bloqueadas.
Ese número sorprende a la mayoría la primera vez que lo ve.
Y también explica por qué los scrapers con experiencia bloquean imágenes, fuentes, videos y scripts innecesarios en navegadores headless: una optimización práctica que puede recortar el ancho de banda entre 60% y 80%. Aun con esa reducción, seguirías en unos 858 GB–1.72 TB/mes, que a tarifas residenciales equivalen a $4,290–$25,740 al mes.
Las extracciones directas por HTTP o a nivel de API pesan mucho menos. Una estimación de practicantes sitúa las solicitudes HTTP directas en 50–200 KB por página frente a 1.5–8 MB para renderizado headless completo. Con 200 KB/página, 50K páginas/día equivalen a solo unos 300 GB/mes.
| Tipo de proxy | Modelo de cobro | Rango de costo típico | Costo estimado para 50K páginas/día (renderizado completo) | Notas |
|---|---|---|---|---|
| Datacenter (estático) | Por IP/mes | ~$0.50–$2/IP | Bajo (tarifa fija, sin medición por GB) | Alto riesgo de bloqueo en objetivos protegidos |
| ISP / residencial estático | Por IP o por GB | ~$3–$8/GB | Medio-alto | Mejor para continuidad + objetivos difíciles |
| Residencial rotativo | Por GB | ~$5–$15/GB | Muy alto salvo que optimices ancho de banda | El estándar de oro para anonimato; el costo se dispara a gran escala |
| Datacenter rotativo | Por solicitud o por GB | ~$0.50–$3/GB | Bajo-moderado | Útil para objetivos poco restrictivos |
| API de scraping con IA (p. ej., Thunderbit) | Por solicitud / créditos | Varía según el plan | Predecible (sin medidor de ancho de banda) | Devuelve datos estructurados, no HTML crudo |
Por eso muchos usuarios de foros preguntan por rotar manualmente proxies ISP estáticos como alternativa más barata al ancho de banda residencial medido. El intercambio entre anonimato y costo es real, y la respuesta correcta depende de qué tan sofisticado sea el anti-bot de tu objetivo y del volumen que manejes.
Elige tu tipo de proxy en menos de 60 segundos
Ninguno de los seis artículos competidores mejor posicionados incluye un diagrama de decisión. Aquí está la lógica como árbol paso a paso:
-
¿Necesitas la misma IP durante sesiones largas? → Sí → Proxy estático (ISP/residencial estático para objetivos difíciles, datacenter para objetivos fáciles)
-
No → ¿Vas a hacer scraping de 10K+ páginas? → Sí → Proxy rotativo (residencial para objetivos difíciles, datacenter para los más permisivos)
-
¿Necesitas persistencia de sesión para tareas en varios pasos (login, carrito, formularios)? → Sí → Sesión sticky (residencial, con TTL configurable)
-
¿Quieres evitar por completo la gestión de proxies? → Sí → API de scraping con IA (p. ej., Thunderbit API/MCP)
La misma lógica en forma de tabla de escenarios:
| Tu situación | Mejor enfoque |
|---|---|
| Necesitas acceso directo a IPs (gestión de cuentas, pruebas geográficas) | Proxies estáticos o rotativos autogestionados |
| Scraping de datos estructurados en sitios con mucho JavaScript | API de scraping con IA (p. ej., Thunderbit /extract) |
| Rastreo de alto volumen para RAG/indexación | API de distill con IA (p. ej., Thunderbit /distill) + procesamiento por lotes |
| Scraping en varios pasos con login | Proxies de navegador con sesiones sticky |
| Presupuesto ajustado, objetivos poco protegidos | Proxies de datacenter (los más baratos) |
La mayoría de lectores encaja en uno de estos cinco grupos. Descubre cuál es el tuyo antes de bajar a la lista de herramientas.
Qué evaluamos en estas 9 herramientas
Cada herramienta de esta lista se evaluó con siete criterios:
- Tipos de proxy ofrecidos: ¿cubre estáticos, rotativos, ISP, residenciales, móviles—o abstrae por completo la capa de proxy?
- Tamaño del pool de IPs: pools más grandes suelen significar mejor calidad de rotación y menor riesgo de reutilización. Pero las cifras de pool son marketing, no auditorías independientes.
- Modelo de precios: por IP, por GB, por solicitud, tarifa plana o créditos. El modelo de cobro importa tanto como el precio unitario.
- Gestión anti-bot / detección: resolución de CAPTCHA integrada, gestión de huella o nada más allá de diversidad de IP.
- Compatibilidad con sesiones sticky: TTL configurable, duración máxima, fiabilidad.
- Mejor caso de uso: scraping, gestión de cuentas, SEO, verificación de anuncios—cada herramienta tiene su punto fuerte.
- Facilidad de integración: calidad de la API, disponibilidad de SDK, usabilidad del panel, opciones no-code, soporte MCP/CLI.
La lista comienza con Thunderbit (nuestro enfoque de API de scraping con IA) y luego cubre nueve proveedores de proxy en un orden aproximado de escala y profundidad de funciones.
1. Thunderbit: evita la gestión de proxies con una API de scraping con IA
Thunderbit no es un proveedor de proxies. Es la opción para cuando te das cuenta de que los proxies son un medio para llegar a un fin—y lo que realmente quieres son datos estructurados.
Creamos Thunderbit como una API de scraping con IA que gestiona proxies, medidas anti-bot, CAPTCHAs y renderizado JavaScript a nivel de infraestructura. Tú describes qué datos quieres; recibes una salida limpia y estructurada. Sin configurar pools de proxies, sin lógica de rotación, sin suplantación de huellas.
Para desarrolladores (el caso de uso principal):
- API abierta:
POST /distillconvierte una página en Markdown limpio.POST /extracttoma un esquema JSON y devuelve campos estructurados. Ambas admiten opcionesrenderModey trabajos por lotes (hasta 100 URLs de forma asíncrona con webhooks). - Servidor MCP: Claude, Cursor y otros agentes de IA pueden llamar
thunderbit_extractythunderbit_distilldurante la tarea. La capa de proxy es invisible: el agente solo recibe datos. - CLI:
npx @thunderbit/thunderbit-cli extract <url> --schema <json>para terminal, CI y flujos cron. El modo batch admite hasta 100 URLs para distill / 50 para extract. - Precios por créditos: Distill = 1 crédito/URL. Extract = 20 créditos/URL. Sin medidor de ancho de banda por GB. El plan Starter comienza en $15/mes con 500 créditos.
Para usuarios no técnicos, la extensión de Chrome ofrece scraping en 2 clics con AI Suggest Fields, y exportación a Excel, Google Sheets, Airtable o Notion. No hace falta configurar proxies: el scraping en la nube de Thunderbit se encarga de la rotación de IPs y del renderizado.
Ideal para: extracción de datos estructurados en sitios con mucho JavaScript, pipelines de RAG/indexación, flujos de agentes de IA y cualquiera que prefiera dedicar tiempo al análisis en lugar de a la infraestructura de proxies.
Limitaciones: no es un proveedor de proxies puros. Si necesitas acceso directo a IPs para gestión de cuentas, pruebas geográficas o sneaker bots, un proxy tradicional es mejor herramienta.
Precio: plan gratuito disponible; Starter desde ~$15/mes. Consulta Thunderbit Pricing para ver los planes actuales.
Para saber más sobre cómo funciona el scraping web con IA por dentro, consulta nuestra guía sobre AI web scraping.
2. Bright Data: el mayor pool de IPs para proxies estáticos y rotativos

Bright Data es una de las suites de proxies más antiguas y completas del mercado. Su cifra principal es 400M+ IPs residenciales rotativas en 195 países, con segmentación por ciudad/estado/código postal/ASN, además de 1.3M+ proxies ISP estáticos.
- Tipos de proxy: residencial (rotativo), ISP/residencial estático, datacenter (estático y rotativo), móvil
- Pool de IPs: 400M+ residenciales, 1.3M+ ISP—el mayor pool reclamado públicamente
- Gestión anti-bot: producto Web Unlocker con resolución de CAPTCHA y gestión de huella; Browser API para renderizado headless
- Sesiones sticky: sí, configurables (normalmente 10–30 min para residencial)
Precio: residencial PAYG normal a $8/GB, con tarifas promocionales de alrededor de $4/GB para compromisos mayores. Datacenter desde ~$0.90/IP. ISP desde ~$1.30/IP. La estructura es flexible, pero puede encarecerse rápido a escala.
Ideal para: empresas que necesitan una enorme diversidad de IP, geotargeting preciso y una suite completa. Equipos con presupuesto y personal técnico para navegar un panel complejo.
Desventajas: el panel tiene curva de aprendizaje. El precio puede ser duro para equipos pequeños—si haces scraping de 50K páginas/día por proxies residenciales, la factura de ancho de banda sube rápido. En sitios de reseñas, muchos usuarios mencionan la complejidad de precios.
3. Oxylabs: proxies premium rotativos y estáticos para scraping a gran escala
Oxylabs es otro proveedor de nivel enterprise con fuerte foco en infraestructura para web scraping. Ofrece productos residential, residential/ISP estático, datacenter, mobile, Web Unblocker y Scraper API.
- Tipos de proxy: residencial (rotativo), ISP/residencial estático, datacenter (estático y rotativo), móvil
- Pool de IPs: gran pool empresarial (la cifra exacta actual varía según el producto)
- Gestión anti-bot: Web Unblocker y Scraper APIs con renderizado y soporte CAPTCHA
- Sesiones sticky: el tiempo estándar de sesión residencial es de 10 minutos, con otras configuraciones disponibles; algunas instalaciones admiten hasta 24 horas
Precio: residencial desde $6/GB al inicio, bajando a $3.50/GB con 1TB de volumen. Los proxies ISP se cobran por IP/mes. Posicionado como premium.
Ideal para: grandes empresas con necesidades serias de recopilación de datos, equipos que quieren soluciones de scraping gestionadas además de acceso directo a proxies.
Desventajas: precio más alto que alternativas de gama media. Puede ser excesivo para proyectos pequeños o medianos.
4. Smartproxy (Decodo): proxies rotativos asequibles con configuración sencilla
Smartproxy, ahora rebautizado como Decodo, es un proveedor popular de gama media conocido por precios competitivos y un panel fácil de usar. Muchos usuarios siguen buscando "Smartproxy", así que ambos nombres siguen apareciendo.
- Tipos de proxy: residencial (rotativo), ISP/residencial estático, datacenter, móvil
- Pool de IPs: 115M+ IPs residenciales
- Gestión anti-bot: productos Site Unblocker y scraping API disponibles
- Sesiones sticky: 1, 10, 30, 60 minutos o intervalos personalizados de hasta 24 horas en residencial, datacenter, ISP y móvil
Precio: residencial desde $2/GB en la tarifa de 3GB, con descuento por volumen. Residential/ISP estático desde ~$3.33/IP en el nivel más bajo. Competitivo para el conjunto de funciones.
Ideal para: equipos pequeños o medianos que buscan buen equilibrio entre precio y funciones, y compradores primerizos que quieren una incorporación sencilla.
Desventajas: pool de IPs menor que Bright Data u Oxylabs. Algunos usuarios reportan velocidades inconsistentes según el objetivo y el pool.
5. IPRoyal: proxies estáticos y rotativos asequibles con precios flexibles
IPRoyal se ha hecho un hueco como opción económica con una propuesta distintiva: tráfico residencial que no caduca. Compras ancho de banda y lo usas cuando quieras.
- Tipos de proxy: residencial (rotativo), ISP/residencial estático, datacenter, móvil, proxies para sneaker
- Pool de IPs: en crecimiento; el tamaño exacto varía según la fuente
- Gestión anti-bot: básica—se apoya en la calidad de IP más que en CAPTCHA o gestión de huella integrados
- Sesiones sticky: hasta 7 días para residencial
Precio: residencial desde $7/GB, con descuento a $1.75/GB en volumen. El modelo de tráfico sin caducidad significa que no pierdes el ancho de banda no usado al final del mes.
Ideal para: usuarios con presupuesto ajustado, patrones de uso variables o estacionales, y casos de uso en sneaker y ecommerce.
Desventajas: pool menor que el de los proveedores premium. Menos funciones anti-detección integradas. Menos adecuado para objetivos muy protegidos.
6. SOAX: proxies rotativos geotargeted con filtros granulares
SOAX destaca cuando necesitas segmentación hiperlocal. Sus filtros llegan hasta país, región, ciudad, ISP y ASN—muy útil para verificación de anuncios e investigación de mercado cuando la precisión geográfica importa.
- Tipos de proxy: residencial (rotativo), ISP/estático, datacenter, móvil
- Pool de IPs: 155M+ IPs en 195+ ubicaciones
- Gestión anti-bot: pools de IP limpios con bajas tasas de bloqueo; API de Web Data disponible
- Sesiones sticky: sí, con tasas de refresco personalizables; soporte de protocolos HTTP(S), SOCKS5, UDP y QUIC
Precio: plan Business a $4.00/GB con 800GB incluidos ($3,200/mes). Las tarifas Enterprise empiezan en $0.32/GB para acuerdos personalizados de gran volumen.
Ideal para: equipos de investigación de mercado que necesitan datos hiperlocales, verificación de anuncios en geografías e ISPs específicos.
Desventajas: puede sentirse complejo para usos simples. La duración máxima de las sesiones sticky varía según el producto—confírmalo antes de contratar.
7. ScraperAPI: proxies rotativos empaquetados en una API orientada al scraping
ScraperAPI no es un proveedor de proxies tradicional. Igual que Thunderbit, abstrae la capa de proxy, pero devuelve HTML crudo en lugar de datos estructurados. Envías una URL y recibes HTML renderizado. ScraperAPI se encarga de elegir proxy, rotación, reintentos y anti-bot en segundo plano.
- Cómo funciona: un único endpoint API; añades la URL destino y ScraperAPI se encarga del resto
- Gestión anti-bot: resolución de CAPTCHA integrada, renderizado JS y geotargeting
- Sesiones sticky: no aplica en el sentido tradicional: la API gestiona las sesiones internamente
Precio: 1,000 créditos gratis al mes. Página estándar = 1 crédito. Amazon = 5 créditos. Google/Bing = 25 créditos. LinkedIn = 30 créditos. Los sitios detrás de Cloudflare/DataDome/PerimeterX añaden 10 créditos por solicitud. Planes de pago desde ~$49/mes por 100K créditos.
Ideal para: desarrolladores que quieren olvidarse de la infraestructura de proxies y solo recibir HTML. Scraping de pequeña a media escala.
Desventajas: devuelve HTML crudo: todavía tienes que analizarlo y estructurarlo tú. Puede salir caro a volúmenes muy altos por los multiplicadores de crédito en sitios protegidos. Comparado con Thunderbit: ScraperAPI te entrega HTML; /extract de Thunderbit te devuelve JSON estructurado que coincide con tu esquema.
8. Webshare: proxies de datacenter y rotativos sin adornos a bajo costo
Webshare es la opción sin adornos. Proxies de datacenter extremadamente asequibles, plan gratis con 10 proxies y herramientas sencillas orientadas a desarrolladores. (Webshare fue adquirida por Oxylabs en 2024, lo que podría afectar su dirección de producto futura.)
- Tipos de proxy: datacenter (estático y rotativo), residencial (rotativo), ISP
- Pool de IPs: 80M+ residenciales reclamados, gran flota de datacenter
- Gestión anti-bot: mínima—sin resolución de CAPTCHA integrada; depende de la diversidad de IP
- Sesiones sticky: sí, para proxies residenciales
Precio: residencial rotativo desde $1.40/GB. Residential estático desde $0.23/IP. Plan gratis con 10 proxies. Entre las opciones más baratas disponibles.
Ideal para: desarrolladores con presupuesto muy ajustado, herramientas internas, scraping de sitios poco protegidos y prototipos.
Desventajas: las IP de datacenter suelen ser bloqueadas por sitios grandes. Anti-detección limitada. La calidad del pool residencial varía.
9. Storm Proxies: proxies rotativos simples con tarifa plana
Storm Proxies es uno de los pocos proveedores que ofrece planes rotativos con tarifa plana y ancho de banda ilimitado. El modelo es simple: pagas por puerto de proxy al mes y usas todo el ancho de banda que quieras.
- Tipos de proxy: residencial rotativo, datacenter rotativo, datacenter estático dedicado
- Pool de IPs: la página oficial afirma 20M+ proxies residenciales reverse backconnect; reseñas de terceros sugieren que el pool efectivo es menor
- Gestión anti-bot: mínima—sin CAPTCHA ni gestión de huella integrados
- Sesiones sticky: rotación en cada solicitud, o cada 3 o 15 minutos
Precio: tarifa mensual fija basada en la cantidad de puertos proxy. Fuentes de terceros describen planes como 5 puertos residenciales por unos $50/mes con ancho de banda ilimitado. Verifica en la página de compra antes de pagar.
Ideal para: usuarios que quieren costos mensuales predecibles sin medidor de ancho de banda. Scraping ligero a moderado donde importa más la previsibilidad que el tamaño del pool.
Desventajas: pool efectivo muy pequeño (alto riesgo de reutilización). Geotargeting limitado. Panel anticuado. No apto para sitios muy protegidos.
Comparativa lado a lado de proxies estáticos vs rotativos
| Herramienta | Tipos de proxy / API | Tamaño aproximado del pool | Modelo de precios | Gestión anti-bot | Compatibilidad con sticky | Mejor caso de uso |
|---|---|---|---|---|---|---|
| Thunderbit | API de scraping con IA, MCP, CLI, extensión de Chrome | Lotes de hasta 100 URLs | Créditos (Distill 1/URL, Extract 20/URL) | Completa: renderizado, anti-bot, CAPTCHA | N/A (gestionado) | Extracción de datos estructurados, RAG, agentes de IA |
| Bright Data | Residential, ISP, datacenter, móvil | 400M+ residencial, 1.3M+ ISP | Por GB + por IP + por solicitud | Web Unlocker, Browser API | Sí (10–30 min) | Escala enterprise, geotargeting |
| Oxylabs | Residential, ISP, datacenter, móvil | Gran pool empresarial | Residential $6→$3.50/GB | Web Unblocker, Scraper APIs | Sí (10 min estándar, configurable) | Scraping enterprise, soluciones gestionadas |
| Smartproxy/Decodo | Residential, ISP, datacenter, móvil | 115M+ residencial | Residential ~$3.75/GB; ISP ~$3.33/IP | Site Unblocker | Sí (1–60 min, hasta 24h) | Gama media, compradores primerizos |
| IPRoyal | Residential, ISP, datacenter, móvil, sneaker | Pool en crecimiento | Residential $7→$1.75/GB, sin caducidad | Básica (calidad de IP) | Sí (hasta 7 días) | Usuarios con presupuesto, uso estacional |
| SOAX | Residential, ISP, datacenter, móvil | 155M+, 195+ ubicaciones | Business $4/GB; enterprise $0.32/GB | Pools limpios, Web Data API | Sí (refresh personalizado) | Targeting hiperlocal, investigación de mercado |
| ScraperAPI | API de scraping con rotación de proxies | A nivel de servicio (no pool crudo) | Por crédito; estándar 1, Amazon 5, Google 25 | CAPTCHA, renderizado y geo integrados | Gestionado internamente | Desarrolladores que quieren recibir HTML |
| Webshare | Datacenter, residencial, ISP | 80M+ residencial | Res rotativo $1.40/GB; estático $0.23/IP | Mínima | Sí (residencial) | Devs con presupuesto, prototipado |
| Storm Proxies | Residential rotativo/datacenter, DC estático | 20M+ reclamados | Tarifa mensual fija por puerto, BW ilimitado | Mínima | En cada solicitud / 3 / 15 min | Costo predecible, scraping ligero |
NetNut se eliminó de esta comparativa: a agosto de 2026, netnut.io muestra un aviso de incautación federal de EE. UU. en lugar del sitio del producto.
Las herramientas se agrupan en tres bloques. Infraestructura de proxy cruda (Bright Data, Oxylabs, Smartproxy, IPRoyal, SOAX, Webshare, Storm Proxies) te da acceso a IP y tú gestionas todo lo demás. APIs de scraping (ScraperAPI) abstraen la capa de proxy pero siguen devolviendo HTML crudo. APIs de extracción con IA (Thunderbit) abstraen tanto la capa de proxy como la de parseo, devolviendo datos estructurados directamente.
Cuando los proxies no son la respuesta: APIs de scraping con IA vs proxies autogestionados
Esta es la parte que ningún artículo competidor cubre: la mayoría de las personas que leen sobre "proxies estáticos vs rotativos" no son fanáticos de los proxies. Están intentando extraer datos, y los proxies son solo un medio para llegar al objetivo.
Para muchos casos de uso, gestionar pools de proxies, lógica de rotación, suplantación de huellas y resolución de CAPTCHA es una carga que una herramienta API-first elimina por completo. Pero no siempre. Aquí cuándo tiene sentido cada enfoque:
Los proxies autogestionados tienen sentido cuando necesitas acceso directo a IPs para gestión de cuentas, pruebas geográficas o sneaker bots; control fino sobre ASN, operador o comportamiento de la IP de salida; o una pila personalizada de navegador/proxy que tu equipo ya mantiene.
La extracción API-first tiene sentido cuando necesitas datos estructurados (listados de productos, contactos, precios) en lugar de HTML crudo, Markdown limpio para pipelines RAG, flujos de trabajo de agentes de IA donde el acceso web durante la tarea debe ser invisible, o simplemente pasar menos tiempo en infraestructura de proxies y más tiempo en los datos.
La API de Thunderbit se encarga del renderizado, anti-bot y CAPTCHAs del lado del servidor. Los desarrolladores reciben Markdown limpio (/distill) o JSON que coincide con el esquema (/extract) sin configurar pools de proxy ni coherencia de huella. El servidor MCP permite que Claude o Cursor raspen durante la tarea vía thunderbit_extract: la capa de proxy es realmente invisible.
Para una visión más amplia sobre web scraping sin programar, tratamos ese tema por separado.
¿Qué herramienta de proxy estático vs rotativo es la adecuada para ti?
Recomendaciones específicas por escenario, porque "depende" es cierto pero poco útil:
- Mejor para empresas que necesitan pools de IP enormes: Bright Data, Oxylabs
- Mejor para equipos con presupuesto ajustado: IPRoyal, Webshare, Storm Proxies
- Mejor para una configuración sencilla de gama media: Smartproxy/Decodo, SOAX
- Mejor para evitar por completo la gestión de proxies: Thunderbit (datos estructurados), ScraperAPI (HTML crudo)
- Mejor para flujos con agentes de IA y MCP: Thunderbit
Los sistemas anti-bot siguen volviéndose más inteligentes—sumando reputación de IP, fingerprinting TLS, análisis de comportamiento y coherencia de headers—y el costo de autogestionar proxies crece con ellos. Para equipos cuyo objetivo final son datos web limpios y estructurados, las herramientas API-first que abstraen toda la capa de proxy son cada vez la opción práctica.
Ese cambio no es hipotético. Ya está ocurriendo.
Si quieres ver cómo se ve en la práctica, la extensión de Chrome de Thunderbit es un buen punto de partida para usuarios no técnicos, y la documentación de la API cubre el flujo de trabajo para desarrolladores. Para más contexto sobre el panorama general de herramientas de scraping, mira nuestra comparativa de los mejores AI web scrapers. También puedes ver tutoriales en el canal de YouTube de Thunderbit.
Prueba Thunderbit AI Web Scraper Get Started Free
Preguntas frecuentes
1. ¿Cuándo debería usar proxies estáticos en lugar de rotativos?
Usa proxies estáticos cuando necesites una IP consistente durante varias sesiones—gestión de cuentas, acceso a contenido bloqueado por región, seguimiento de posiciones o cualquier plataforma que considere sospechosos los cambios de IP. Si el objetivo espera ver la misma identidad con el paso del tiempo, lo correcto es usar un estático. Para objetivos difíciles, las IP residenciales estáticas o ISP son más seguras que las de datacenter.
2. ¿Cuál es la diferencia entre una sesión sticky y un proxy estático?
Una sesión sticky mantiene la misma IP durante una ventana de tiempo configurable (por ejemplo, 10 minutos, 30 minutos o hasta 24 horas según el proveedor) y luego cambia a otra. Un proxy estático conserva la misma IP indefinidamente hasta que la cambias manualmente. No son lo mismo, aunque algunos documentos de proveedores usen los términos como si fueran equivalentes.
3. ¿Por qué los proxies rotativos siguen siendo bloqueados en algunos sitios?
Porque los sistemas anti-bot modernos usan detección multicapa más allá de la IP. El fingerprinting TLS/JA3, el análisis de comportamiento (patrones de solicitud, rutas de navegación) y las comprobaciones de coherencia de headers pueden señalar tráfico automatizado aunque cambies de IP. Rotar IPs reduce los límites basados en IP, pero no resuelve esas otras capas de detección.
4. ¿Cuánto cuestan los proxies residenciales rotativos a gran escala?
Los precios públicos de autoservicio van desde unos $1.40/GB (Webshare) hasta $8/GB en el PAYG estándar (Bright Data), con descuentos empresariales disponibles. A volumen de renderizado de páginas completas (50K páginas/día a ~2.86 MB/página), solo el ancho de banda puede superar 4 TB/mes—lo que puede traducirse en decenas de miles de dólares. Las APIs basadas en créditos o por solicitud (como Thunderbit o ScraperAPI) ofrecen precios más previsibles sin medición de ancho de banda.
5. ¿Puede una API de scraping con IA reemplazar por completo a los proxies?
Para extracción de datos estructurados y scraping web, muchas veces sí. Herramientas como Thunderbit gestionan la rotación de proxies, las medidas anti-bot, la resolución de CAPTCHA y el renderizado JS a nivel de infraestructura: tú recibes datos limpios sin administrar proxies. Para casos de uso que requieren acceso directo a IPs (gestión de cuentas, pruebas geográficas, sneaker bots), los proxies tradicionales siguen siendo necesarios.
Más información



