Automatisierter Bot-Traffic macht inzwischen mehr als 53 % des gesamten Web-Traffics aus – also sogar mehr als der von echten Menschen erzeugte Traffic. Wenn du Daten scrapest, Konten verwaltest oder Anzeigen über mehrere Regionen hinweg prüfst, bewegst du dich in einer Umgebung, in der Anti-Bot-Systeme ganz gezielt darauf ausgelegt sind, dich zu erkennen.
Und trotzdem reduzieren die meisten Leitfäden zu „statische vs. rotierende Proxys“ das Ganze auf eine simple Zweispaltentabelle und tun dann so, als wäre alles gesagt. Dabei lassen sie den dritten Begriff außen vor (Sticky Sessions), ignorieren die eigentlichen Erkennungsmechanismen und rechnen die Kosten bei Skalierung nie sauber durch. Ich habe für unsere Arbeit bei Thunderbit viel Zeit mit der Recherche von Proxy-Anbietern und AI-Scraping-APIs verbracht, und die Realität ist komplexer – und interessanter – als die üblichen Listenartikel vermuten lassen. Dieser Guide erklärt den echten Dreiklang, den viele Artikel falsch darstellen, wie Anti-Bot-Systeme Proxy-Traffic tatsächlich erkennen, was es kostet, 50.000 Seiten pro Tag über verschiedene Proxy-Typen zu verarbeiten, und 9 Tools, die ich wirklich in Betracht ziehen würde. Einige sind klassische Proxy-Anbieter, andere Scraping-APIs, und eines (unseres) kommt ganz ohne Proxy-Management aus.
Thunderbit für AI-Scraping testen
Statische vs. rotierende vs. Sticky Proxys: Die Dreiteilung, die die meisten Guides übersehen
Die meisten Proxy-Vergleiche behandeln das Thema als Entweder-oder: statisch oder rotierend. Diese Sicht ist unvollständig und führt schnell zu schlechten Kaufentscheidungen. Tatsächlich gibt es drei unterschiedliche Verhaltensweisen von Proxys, und jede erfüllt einen anderen Zweck.
Statischer Proxy: Dieselbe IP-Adresse auf unbestimmte Zeit, bis du sie manuell austauschst oder die Laufzeit endet. Stell dir das wie deinen heimischen Anschluss vor – jeden Tag dieselbe Adresse. Das ist nützlich, wenn eine Plattform über längere Zeit dieselbe Identität erwartet (Kontoverwaltung, geo-gesperrte Inhalte, Rank-Tracking).
Sticky Session: Dieselbe IP für ein konfigurierbares Zeitfenster – vielleicht 10 Minuten, vielleicht 30, je nach Anbieter auch bis zu 24 Stunden – danach wird auf eine neue IP gewechselt. Eine Sticky Session ist zeitlich begrenzte Kontinuität; ein statischer Proxy ist dauerhafte Kontinuität. Decodo (ehemals Smartproxy) beschreibt Sticky Sessions als feste IP für 1, 10, 30, 60 Minuten oder benutzerdefinierte Intervalle bis zu 24 Stunden.
Rotierender Proxy: Neue IP bei jeder Anfrage oder alle paar Sekunden. Maximale Anonymität für Aufgaben mit hohem Volumen, aber keinerlei Session-Kontinuität – außer du kombinierst ihn mit Sticky Sessions.
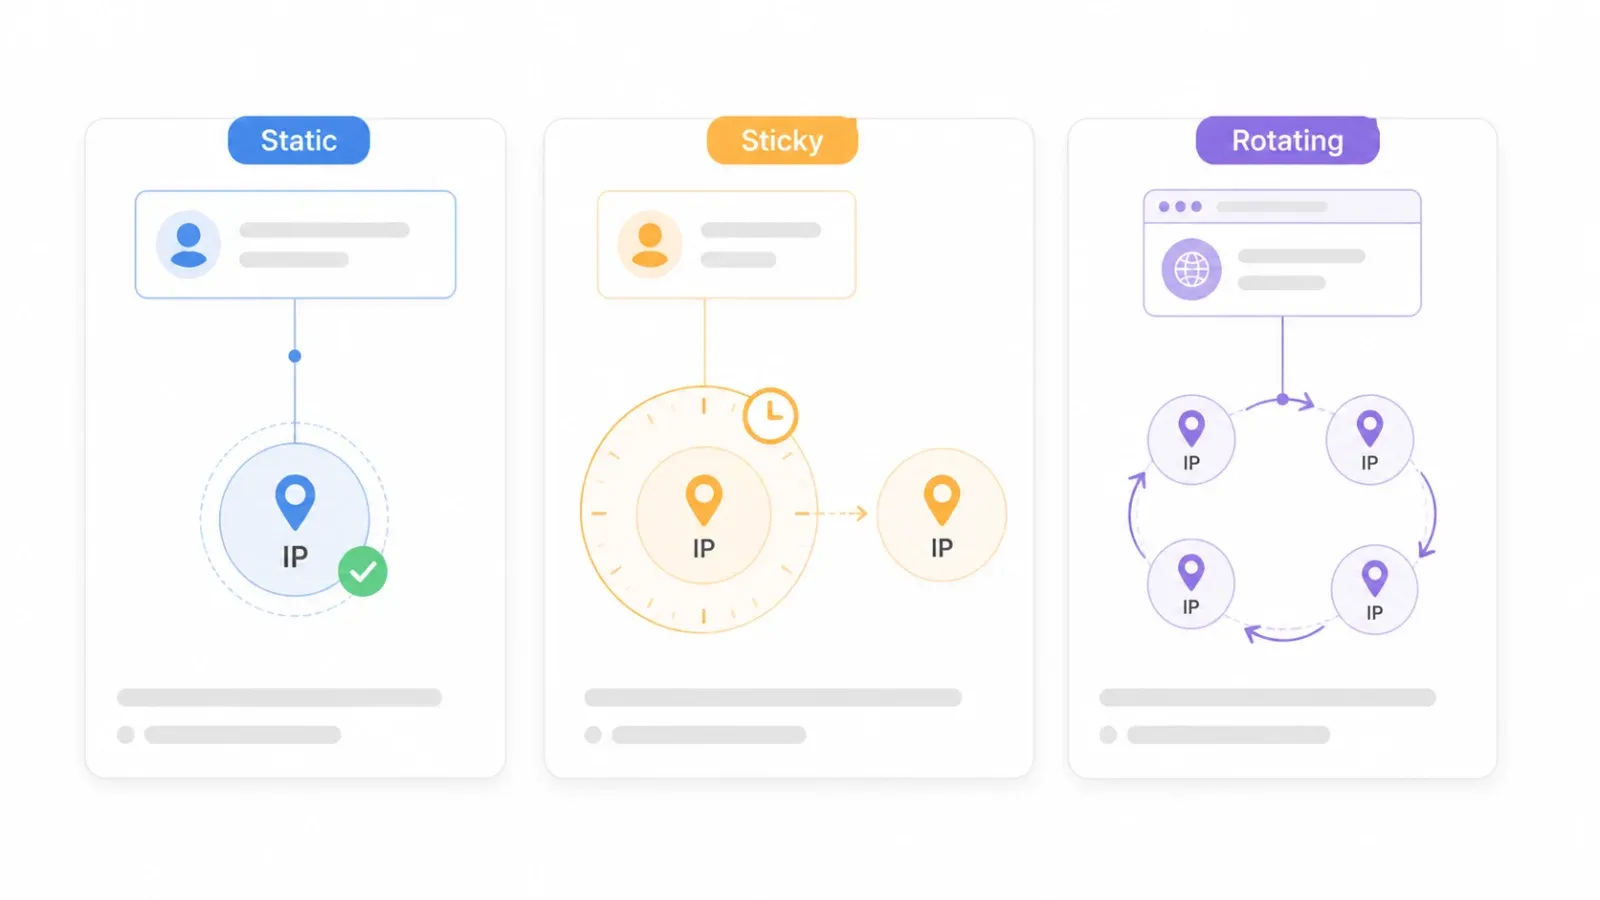
Der Unterschied in Tabellenform:
| Merkmal | Statischer Proxy | Sticky Session | Rotierender Proxy |
|---|---|---|---|
| IP-Wechsel? | Nie (dieselbe IP auf unbestimmte Zeit) | Nach einer festgelegten Dauer (z. B. 10–30 Min.) | Bei jeder Anfrage oder alle paar Sekunden |
| Session-Persistenz | Dauerhaft | Temporär (konfigurierbare TTL) | Keine |
| Typischer Anwendungsfall | Kontoverwaltung, geo-gesperrte Inhalte | Mehrstufiges Scraping (Login → Navigieren → Extrahieren) | Scraping mit hohem Volumen, Anzeigenprüfung |
| Erkennungsrisiko | Mit der Zeit höher (derselbe Fingerprint sammelt Historie) | Mittel | Niedrigstes Risiko bei IP-basierter Erkennung (bei Residential Proxys) |
| Kostenmodell | Meist pro IP/Monat | Teil von Residential-/Mobile-Plänen, Abrechnung pro GB | Pro GB, pro Anfrage oder zum Pauschalpreis |
Warum ist das für die Tool-Auswahl wichtig? Wenn du dich bei einer Plattform einloggst, Artikel in den Warenkorb legst oder ein mehrstufiges Formular ausfüllst, brauchst du Sticky Sessions – nicht reine Rotation (die deine Session zerstören würde) und auch nicht unbedingt eine dauerhaft statische IP (die überdimensioniert und teuer sein kann). Nutzer in Foren wie r/proxies verwechseln diese Kategorien regelmäßig und fragen, ob Sticky Sessions sich wie „normale rotierende Residential Proxys“ oder wie statische IPs verhalten. Die Antwort: weder noch. Es ist eine dritte Kategorie.
Wie Anti-Bot-Systeme statische und rotierende Proxys wirklich erkennen
Jeder Proxy-Vergleich erwähnt in einer Tabellenzelle „Erkennungsrisiko“. Fast keiner erklärt, wie die Erkennung tatsächlich funktioniert. Das ist wichtig, denn genau diese Methode entscheidet darüber, ob rotierende IPs überhaupt etwas bringen.
Moderne Anti-Bot-Systeme arbeiten mit mindestens vier Ebenen, und das Rotieren der IP löst davon nur eine.
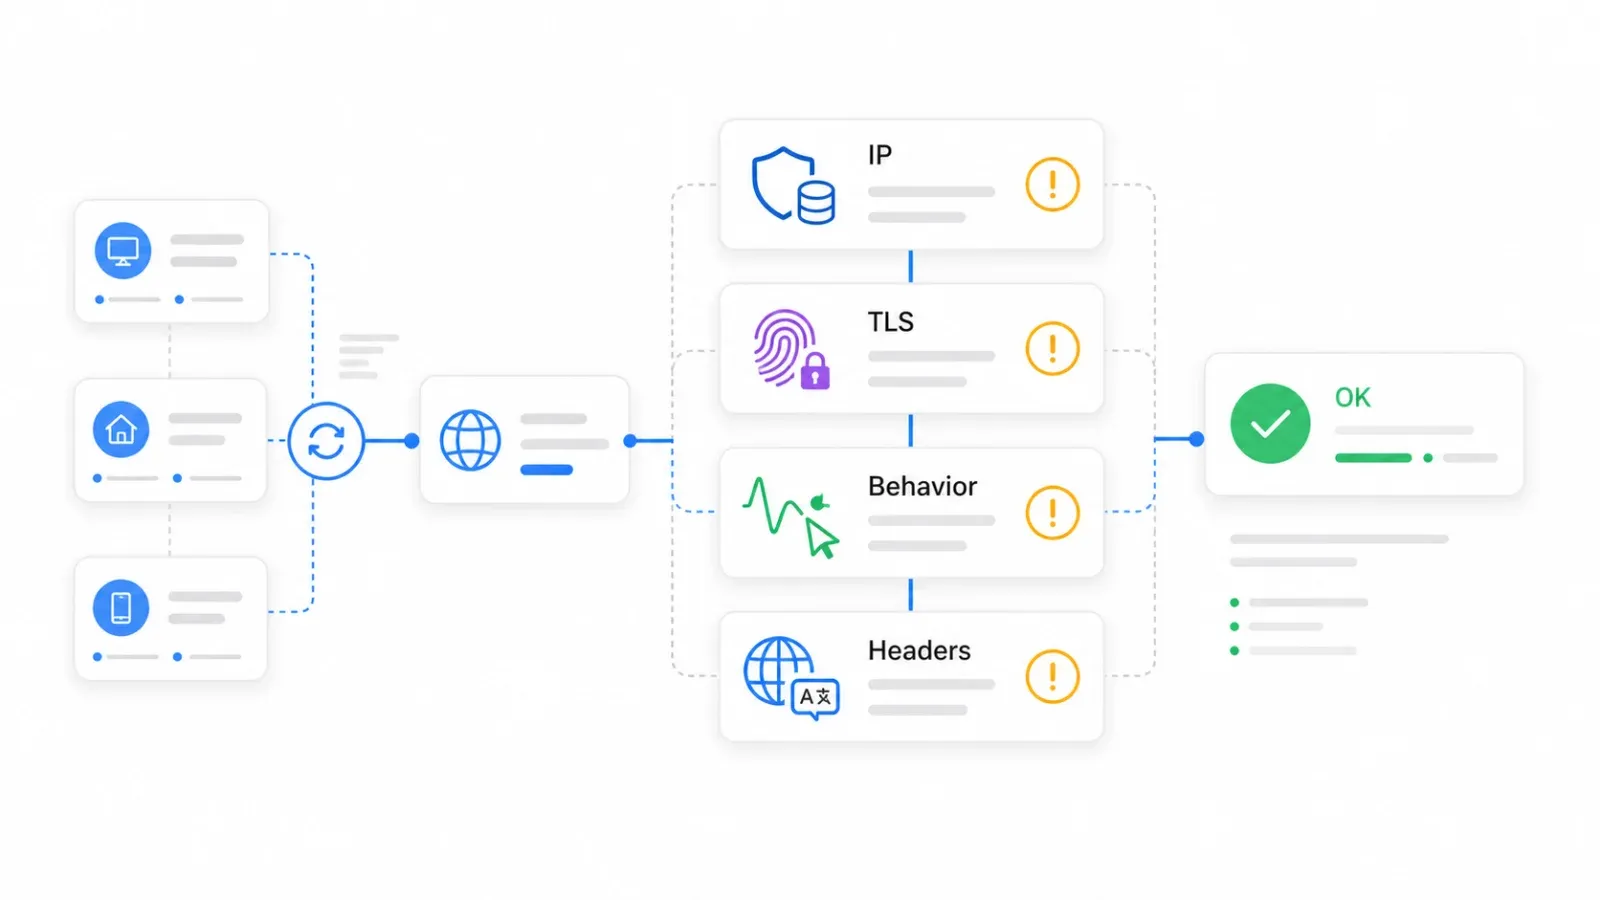
Ebene 1: IP-Reputationsdatenbanken
Datacenter-IP-Bereiche stammen von Cloud- und Hosting-ASNs – Amazon, Google, DigitalOcean usw. Anti-Bot-Anbieter pflegen Datenbanken, die diese Bereiche vorab markieren. Residential- und Mobile-IPs starten mit höherem Vertrauen, weil sie wie normaler Endnutzer-Traffic aussehen. Cloudflares Bot-Dokumentation beschreibt das über Bot-Scores von 1 bis 99, wobei niedrige Werte auf wahrscheinliche Automatisierung hindeuten. Kommt deine IP aus einem bekannten Datacenter-Bereich, startest du mit einem niedrigen Vertrauenswert, noch bevor du die erste Anfrage gesendet hast.
Ebene 2: TLS-/JA3-/JA4-Fingerprinting
Das ist der Punkt, den die meisten Proxy-Käufer nicht kennen. Wenn dein Client eine HTTPS-Verbindung aufbaut, verrät der TLS-Handshake Merkmale der Software, die die Anfrage sendet. Cloudflares JA3-/JA4-Dokumentation erklärt, dass diese Fingerprints TLS-Clients anhand ihrer Verbindungsmerkmale identifizieren und als stabile Kennung über verschiedene Ziel-IPs hinweg dienen. Einfach gesagt: Wenn deine Anfrage vorgibt, Chrome auf macOS zu sein, der TLS-Handshake aber wie die Python-Bibliothek requests aussieht, behebt das Rotieren der IP diese Diskrepanz nicht. Der Fingerprint reist mit dir mit.
Ebene 3: Verhaltenssignale
Anfragefrequenz, Navigationsreihenfolge, Mausbewegungen (oder deren Fehlen), Login-Muster und die Frage, ob sich Sitzungen wie menschliches Browsing entwickeln. DataDomes Erkennungsdokumentation beschreibt Verhaltensmodelle, die ungewöhnliche Muster wie zu viele Login-Versuche oder unnatürlich hohe Navigationsgeschwindigkeiten markieren. Eine arXiv-Studie von 2026 zu KI-Browsing-Agenten fand heraus, dass Verhaltens-Fingerprints aussagekräftiger waren als Browser-Fingerprints, um KI-Agenten von Menschen zu unterscheiden.
Ebene 4: Konsistenz von Headern und Umgebung
Eine akademische Messstudie von 2026 zu 10.000 Websites ergab, dass 75 % der Sperren, die nur Chromium Headless betrafen, allein durch Header-Signale ausgelöst wurden. Wenn dein Accept-Language-Header en-US sagt, deine IP aber geografisch in São Paulo verortet wird, ist diese Inkonsistenz ein Signal. Wenn dein User-Agent nicht zu deinem TLS-Fingerprint passt, ist das ein weiteres Signal.
Die Quintessenz: Rotierende IPs reduzieren IP-basierte Rate Limits und Reputationsaufbau. Sie lösen nicht TLS-Fingerprint-Abweichungen, Verhaltensanomalien oder inkonsistente Header. Genau deshalb sind API-first-Scraping-Tools – die Rendering, Fingerprint-Konsistenz und CAPTCHA-Lösung auf Infrastrukturebene übernehmen – zu einer praktikablen Alternative geworden, statt alle vier Ebenen selbst zu verwalten.
Proxy-Management mit AI-Scraping überspringen Get Started Free
Die echten Kosten von statischen vs. rotierenden Proxys bei Skalierung
Beim Preis schummeln die meisten Proxy-Guides oder bleiben bei vagen Begriffen wie „günstig“. Doch Abrechnungsmodell + Seitengröße + Blockrate verändern die Gesamtkosten drastisch.
Das Web Almanac 2025 des HTTP Archive berichtet, dass die durchschnittliche Startseite auf dem Desktop 2,86 MB wiegt. Wenn du 50.000 Seiten pro Tag über einen Residential-Proxy mit volumenbasierter Abrechnung vollständig renderst, sind das rund 143 GB pro Tag bzw. etwa 4,29 TB pro Monat. Bei 5–15 $/GB für rotierende Residential-Bandbreite landest du bei 21.450–64.350 $/Monat – noch vor Retries und blockierten Anfragen.
Diese Zahl schockiert die meisten Menschen beim ersten Mal.
Deshalb blockieren erfahrene Scraper Bilder, Schriftarten, Videos und unnötige Skripte im Headless-Browser – eine praktische Optimierung, die die Bandbreite um 60–80 % senken kann. Selbst dann liegst du noch bei 858 GB–1,72 TB/Monat, also bei Residential-Tarifen schnell bei 4.290–25.740 $/Monat.
Direkte HTTP- oder API-Scrapes sind deutlich schlanker. Praktische Schätzungen setzen direkte HTTP-Anfragen bei 50–200 KB pro Seite an, verglichen mit 1,5–8 MB bei vollständigem Headless-Rendering. Bei 200 KB pro Seite ergeben 50.000 Seiten pro Tag nur etwa 300 GB pro Monat.
| Proxy-Typ | Abrechnungsmodell | Typische Preisspanne | Geschätzte Kosten für 50K Seiten/Tag (vollständiges Rendering) | Hinweise |
|---|---|---|---|---|
| Datacenter (statisch) | Pro IP/Monat | ca. 0,50–2 $/IP | Niedrig (Pauschaltarif, keine GB-Messung) | Hohes Blockrisiko bei geschützten Zielen |
| ISP / statischer Residential-Proxy | Pro IP oder pro GB | ca. 3–8 $/GB | Mittel bis hoch | Gut für Kontinuität + schwierigere Ziele |
| Rotierender Residential-Proxy | Pro GB | ca. 5–15 $/GB | Sehr hoch, außer bei starker Bandbreitenoptimierung | Goldstandard für Anonymität; Kosten explodieren bei Volumen |
| Rotierender Datacenter-Proxy | Pro Anfrage oder pro GB | ca. 0,50–3 $/GB | Niedrig bis mittel | Nützlich für weniger strenge Ziele |
| AI-Scraping-API (z. B. Thunderbit) | Pro Anfrage / Credits | Je nach Plan | Gut planbar (kein Bandbreitenzähler) | Liefert strukturierte Daten statt Roh-HTML |
Genau deshalb fragen viele in Foren danach, statische ISP-Proxys manuell zu rotieren, statt volumenbasierte Residential-Bandbreite zu kaufen. Der Kompromiss zwischen Anonymität und Kosten ist real, und die richtige Antwort hängt davon ab, wie ausgefeilt das Anti-Bot-System des Ziels ist und welches Volumen du verarbeitest.
In unter 60 Sekunden den richtigen Proxy-Typ wählen
Keiner der sechs konkurrierenden Top-Artikel enthält ein Entscheidungsdiagramm. Hier ist die Logik als einfacher Entscheidungsbaum:
-
Brauchst du über lange Sessions dieselbe IP? → Ja → Statischer Proxy (ISP/staticher Residential-Proxy für schwierige Ziele, Datacenter für einfache)
-
Nein → Scrapest du 10K+ Seiten? → Ja → Rotierender Proxy (Residential für schwierige Ziele, Datacenter für tolerantere Ziele)
-
Brauchst du Session-Kontinuität für mehrstufige Aufgaben (Login, Warenkorb, Formulare)? → Ja → Sticky Session (Residential, mit konfigurierbarer TTL)
-
Willst du dir das Proxy-Management komplett sparen? → Ja → AI-Scraping-API (z. B. Thunderbit API/MCP)
Dasselbe als Szenariotabelle:
| Deine Situation | Beste Vorgehensweise |
|---|---|
| Du brauchst direkten IP-Zugriff (Kontoverwaltung, Geo-Tests) | Selbst verwaltete statische oder rotierende Proxys |
| Du scrapest strukturierte Daten von JS-lastigen Websites | AI-Scraping-API (z. B. Thunderbit /extract) |
| Crawling großer Seitenmengen für RAG/Indexierung | AI-Distill-API (z. B. Thunderbit /distill) + Batch |
| Mehrstufiges Scraping mit Login | Browser-Proxys mit Sticky Sessions |
| Budget begrenzt, weniger geschützte Ziele | Datacenter-Proxys (am günstigsten) |
Die meisten Leser fallen in eine dieser fünf Gruppen. Finde heraus, in welche du gehörst, bevor du zur Tool-Liste springst.
Woran wir diese 9 Tools gemessen haben
Jedes Tool in dieser Liste wurde anhand von sieben Kriterien bewertet:
- Angebotene Proxy-Typen: Deckt es statische, rotierende, ISP-, Residential- und Mobile-Proxys ab – oder abstrahiert es die Proxy-Ebene komplett weg?
- Größe des IP-Pools: Größere Pools bedeuten bessere Rotationsqualität und ein geringeres Wiederverwendungsrisiko. Pool-Angaben sind jedoch Marketingzahlen und nicht unabhängig geprüft.
- Preismodell: Pro IP, pro GB, pro Anfrage, Pauschaltarif oder kreditbasiert. Das Abrechnungsmodell ist mindestens so wichtig wie der Stückpreis.
- Anti-Bot-/Erkennungs-Handling: Integrierte CAPTCHA-Lösung, Fingerprint-Management oder nichts außer IP-Vielfalt.
- Sticky-Session-Support: Konfigurierbare TTL, maximale Dauer, Zuverlässigkeit.
- Passender Haupteinsatz: Scraping, Kontoverwaltung, SEO, Anzeigenprüfung – jedes Tool hat seinen Sweet Spot.
- Integrationsaufwand: API-Qualität, SDKs, Dashboard-Nutzung, No-Code-Optionen, MCP-/CLI-Support.
Die Liste beginnt mit Thunderbit (unserem Ansatz über eine AI-Scraping-API) und behandelt anschließend neun Proxy-Anbieter in grob absteigender Reihenfolge nach Umfang und Funktionsbreite.
1. Thunderbit: Proxy-Management mit einer AI-Scraping-API überspringen
Thunderbit ist kein Proxy-Anbieter. Es ist die Lösung für den Moment, in dem dir klar wird, dass Proxys nur ein Mittel zum Zweck sind – und du eigentlich strukturierte Daten willst.
Wir haben Thunderbit als AI-Scraping-API entwickelt, die Proxys, Anti-Bot-Maßnahmen, CAPTCHAs und JavaScript-Rendering auf Infrastrukturebene übernimmt. Du beschreibst, welche Daten du brauchst, und bekommst saubere, strukturierte Ergebnisse zurück. Kein Proxy-Pool-Setup, keine Rotationslogik, kein Fingerprint-Spoofing.
Für Entwickler (der wichtigste Anwendungsfall):
- Offene API:
POST /distillwandelt eine Seite in sauberes Markdown um.POST /extractnimmt ein JSON-Schema entgegen und liefert strukturierte Felder zurück. Beide unterstützenrenderMode-Optionen und Batch-Jobs (bis zu 100 URLs asynchron mit Webhooks). - MCP-Server: Claude, Cursor und andere KI-Agenten können mitten im Task
thunderbit_extractundthunderbit_distillaufrufen. Die Proxy-Ebene bleibt unsichtbar – der Agent bekommt einfach die Daten. - CLI:
npx @thunderbit/thunderbit-cli extract <url> --schema <json>für Terminal-, CI- und Cron-Workflows. Batch unterstützt bis zu 100 Distill- bzw. 50 Extract-URLs. - Credit-Preisgestaltung: Distill = 1 Credit/URL. Extract = 20 Credits/URL. Kein Bandbreitenzähler pro GB. Der Starter-Plan beginnt bei 15 $/Monat mit 500 Credits.
Für nicht-technische Nutzer bietet die Chrome-Erweiterung Scraping mit 2 Klicks inklusive AI Suggest Fields sowie Export nach Excel, Google Sheets, Airtable oder Notion. Keine Proxy-Konfiguration nötig – das Cloud-Scraping von Thunderbit übernimmt IP-Rotation und Rendering.
Geeignet für: Strukturierte Datenerfassung von JS-lastigen Websites, RAG-/Indexing-Pipelines, Workflows mit KI-Agenten und alle, die ihre Zeit lieber in Analyse statt in Proxy-Infrastruktur investieren.
Einschränkungen: Kein reiner Proxy-Anbieter. Wenn du direkten IP-Zugriff für Kontoverwaltung, Geo-Tests oder Sneaker-Bots brauchst, ist ein klassischer Proxy die bessere Wahl.
Preis: Gratis-Tarif verfügbar; Starter ab ca. 15 $/Monat. Aktuelle Pläne findest du unter Thunderbit Pricing.
Mehr dazu, wie AI-Web-Scraping unter der Haube funktioniert, findest du in unserem Guide zu AI Web Scraping.
2. Bright Data: Der größte IP-Pool für statische und rotierende Proxys

Bright Data gehört zu den ältesten und umfassendsten Proxy-Suiten am Markt. Die Hauptzahl ist 400M+ rotierende Residential-IPs in 195 Ländern, mit Targeting auf Stadt-, Bundesland-, PLZ- und ASN-Ebene sowie 1,3M+ statischen ISP-Proxys.
- Proxy-Typen: Residential (rotierend), ISP/statischer Residential-Proxy, Datacenter (statisch und rotierend), Mobile
- IP-Pool: 400M+ Residential, 1,3M+ ISP – der größte öffentlich behauptete Pool
- Anti-Bot-Handling: Produkt „Web Unlocker“ mit CAPTCHA-Lösung und Fingerprint-Management; Browser API für Headless-Rendering
- Sticky Sessions: Ja, konfigurierbar (bei Residential meist 10–30 Min.)
Preis: Residential regulär PAYG ab 8 $/GB, mit Aktionspreisen um 4 $/GB bei größeren Zusagen. Datacenter ab ca. 0,90 $/IP. ISP ab ca. 1,30 $/IP. Die Preisstruktur ist flexibel, kann bei Skalierung aber schnell teuer werden.
Geeignet für: Unternehmen mit sehr großem IP-Bedarf, präzisem Geo-Targeting und einer kompletten Produktsuite. Teams mit Budget und technischem Personal, die sich in einem komplexen Dashboard zurechtfinden.
Nachteile: Das Dashboard hat eine gewisse Lernkurve. Für kleinere Teams kann die Preisgestaltung hoch ausfallen – wenn du 50.000 Seiten pro Tag über Residential-Proxys scrapest, summiert sich die Bandbreitenrechnung schnell. Nutzer auf Bewertungsportalen nennen häufig die Preis-Komplexität.
3. Oxylabs: Premium-Proxys für große Scraping-Projekte, statisch und rotierend
Oxylabs ist ein weiterer Enterprise-Anbieter mit starkem Fokus auf Scraping-Infrastruktur. Das Portfolio umfasst Residential, statische Residential-/ISP-Proxys, Datacenter, Mobile sowie Web Unblocker und Scraper-API-Produkte.
- Proxy-Typen: Residential (rotierend), ISP/statischer Residential-Proxy, Datacenter (statisch und rotierend), Mobile
- IP-Pool: Großer Enterprise-Pool (die genaue aktuelle Zahl variiert je nach Produkt)
- Anti-Bot-Handling: Web Unblocker und Scraper APIs mit Rendering- und CAPTCHA-Support
- Sticky Sessions: Standard-Sessiondauer bei Residential beträgt 10 Minuten, weitere Konfigurationen sind möglich; manche Setups unterstützen bis zu 24 Stunden
Preis: Residential ab 6 $/GB zum Einstieg, bei 1 TB Volumen sinkend auf 3,50 $/GB. ISP-Proxys werden pro IP/Monat berechnet. Im Premium-Segment positioniert.
Geeignet für: Große Unternehmen mit hohem Datenbedarf, Teams, die verwaltete Scraping-Lösungen zusätzlich zum Roh-Proxy-Zugriff möchten.
Nachteile: Höherer Preis als mittelpreisige Alternativen. Für kleine bis mittlere Projekte oft überdimensioniert.
4. Smartproxy (Decodo): Preiswerte rotierende Proxys mit einfacher Einrichtung
Smartproxy, inzwischen in Decodo umbenannt, ist ein beliebter Mid-Market-Anbieter mit wettbewerbsfähigen Preisen und einem nutzerfreundlichen Dashboard. Viele suchen weiterhin nach „Smartproxy“, deshalb tauchen beide Namen auf.
- Proxy-Typen: Residential (rotierend), ISP/statischer Residential-Proxy, Datacenter, Mobile
- IP-Pool: 115M+ Residential-IPs
- Anti-Bot-Handling: Site Unblocker und Scraping-API-Produkte verfügbar
- Sticky Sessions: 1, 10, 30, 60 Minuten oder benutzerdefinierte Intervalle bis zu 24 Stunden für Residential, Datacenter, ISP und Mobile
Preis: Residential ab 2 $/GB auf der 3-GB-Stufe, bei höherem Volumen sinkend. Statische Residential-/ISP-Proxys ab ca. 3,33 $/IP in der unteren Tarifstufe. Für das gebotene Feature-Set konkurrenzfähig.
Geeignet für: Kleine bis mittlere Teams, die ein gutes Preis-Leistungs-Verhältnis suchen, sowie Einsteiger, die eine einfache Onboarding-Erfahrung wollen.
Nachteile: Kleinerer IP-Pool als bei Bright Data oder Oxylabs. Einige Nutzer berichten je nach Ziel und Pool von schwankenden Geschwindigkeiten.
5. IPRoyal: Günstige statische und rotierende Proxys mit flexibler Preisgestaltung
IPRoyal hat sich als Budget-Option mit einem besonderen Vorteil positioniert: nicht verfallender Residential-Traffic. Bandbreite kaufen und nutzen, wann immer du willst.
- Proxy-Typen: Residential (rotierend), ISP/statischer Residential-Proxy, Datacenter, Mobile, Sneaker-Proxys
- IP-Pool: Wachsend; die exakte aktuelle Größe variiert je nach Quelle
- Anti-Bot-Handling: Basisfunktionen – setzt auf IP-Qualität statt auf integrierte CAPTCHA-Lösung oder Fingerprint-Management
- Sticky Sessions: Bis zu 7 Tage für Residential
Preis: Residential ab 7 $/GB, im Bulk reduziert auf 1,75 $/GB. Das Modell mit nicht verfallender Bandbreite verhindert, dass ungenutztes Volumen am Monatsende verfällt.
Geeignet für: Preisbewusste Nutzer, schwankende oder saisonale Nutzung, Sneaker- und E-Commerce-Anwendungsfälle.
Nachteile: Kleinerer IP-Pool als Premium-Anbieter. Begrenzte integrierte Anti-Detection-Funktionen. Weniger geeignet für stark geschützte Ziele.
6. SOAX: Geotargeting mit fein granularen Filtern
SOAX ist besonders stark, wenn du hyperlokales Targeting brauchst. Das Filtern geht bis auf Länder-, Regions-, Stadt-, ISP- und ASN-Ebene – ideal für Anzeigenprüfung und Marktforschung, bei denen Standortpräzision zählt.
- Proxy-Typen: Residential (rotierend), ISP/statisch, Datacenter, Mobile
- IP-Pool: 155M+ IPs in über 195 Standorten
- Anti-Bot-Handling: Saubere IP-Pools mit niedrigen Ban-Raten; Web Data API verfügbar
- Sticky Sessions: Ja, mit anpassbaren Refresh-Raten; Unterstützung für HTTP(S), SOCKS5, UDP und QUIC
Preis: Business-Plan für 4,00 $/GB mit 800 GB inklusive (3.200 $/Monat). Enterprise-Tarife starten bei 0,32 $/GB für individuelle High-Volume-Deals.
Geeignet für: Marktforschungsteams mit Bedarf an hyperlokalen Daten, Anzeigenprüfung über bestimmte Regionen und ISPs hinweg.
Nachteile: Kann für einfache Anwendungsfälle komplex wirken. Die maximale Dauer von Sticky Sessions variiert je nach Produkt – vor Vertragsabschluss prüfen.
7. ScraperAPI: Rotierende Proxys in einer Scraping-first API gebündelt
ScraperAPI ist kein klassischer Proxy-Anbieter. Wie Thunderbit abstrahiert es die Proxy-Ebene – liefert aber rohes HTML statt strukturierter Daten zurück. Du sendest eine URL und erhältst gerendertes HTML. ScraperAPI übernimmt Proxy-Auswahl, Rotation, Retries und Anti-Bot im Hintergrund.
- Funktionsweise: Ein einziger API-Endpunkt; du hängst die Ziel-URL an und ScraperAPI übernimmt alles Weitere
- Anti-Bot-Handling: Integrierte CAPTCHA-Lösung, JS-Rendering und Geo-Targeting
- Sticky Sessions: Im klassischen Sinn nicht relevant – die API verwaltet Sessions intern
Preis: 1.000 kostenlose API-Credits pro Monat. Standardseite = 1 Credit. Amazon = 5 Credits. Google/Bing = 25 Credits. LinkedIn = 30 Credits. Seiten hinter Cloudflare/DataDome/PerimeterX kosten 10 zusätzliche Credits pro Anfrage. Bezahlpläne ab ca. 49 $/Monat für 100.000 Credits.
Geeignet für: Entwickler, die Proxy-Infrastruktur überspringen und einfach HTML zurückbekommen wollen. Scraping im kleinen bis mittleren Umfang.
Nachteile: Liefert rohes HTML – Parsing und Strukturierung musst du selbst übernehmen. Bei sehr hohem Volumen kann es wegen der Credit-Multiplikatoren auf geschützten Websites teuer werden. Im Vergleich zu Thunderbit: ScraperAPI gibt dir HTML; Thunderbits /extract liefert schema-konformes, strukturiertes JSON.
8. Webshare: Schlichte Datacenter- und Rotating-Proxys zu niedrigen Kosten
Webshare ist die schnörkellose Option. Extrem günstige Datacenter-Proxys, ein Free-Tier mit 10 Proxys und einfache, entwicklerorientierte Tools. (Webshare wurde 2024 von Oxylabs übernommen, was die zukünftige Produktentwicklung beeinflussen könnte.)
- Proxy-Typen: Datacenter (statisch und rotierend), Residential (rotierend), ISP
- IP-Pool: 80M+ Residential-IPs behauptet, große Datacenter-Flotte
- Anti-Bot-Handling: Minimal – keine integrierte CAPTCHA-Lösung; setzt auf IP-Vielfalt
- Sticky Sessions: Ja, für Residential-Proxys
Preis: Rotierender Residential ab 1,40 $/GB. Statischer Residential ab 0,23 $/IP. Free-Tier mit 10 Proxys. Gehört zu den günstigsten Optionen am Markt.
Geeignet für: Entwickler mit knappem Budget, interne Tools, weniger geschützte Websites, Prototyping.
Nachteile: Datacenter-IPs werden von großen Websites häufig blockiert. Begrenzte Anti-Detection-Funktionen. Qualität des Residential-Pools variiert.
9. Storm Proxies: Einfache rotierende Proxys mit Pauschalpreis
Storm Proxies gehört zu den wenigen Anbietern mit Pauschalpreisen und unbegrenzter Bandbreite für rotierende Proxy-Pläne. Das Modell ist simpel: pro Proxy-Port und Monat zahlen, so viel Bandbreite nutzen, wie du möchtest.
- Proxy-Typen: Rotierende Residential-Proxys, rotierende Datacenter-Proxys, dedizierte statische Datacenter-Proxys
- IP-Pool: Die offizielle Seite nennt 20M+ Residential Reverse-Backconnect-Proxys; Drittanbieter-Reviews gehen von einem kleineren effektiven Pool aus
- Anti-Bot-Handling: Minimal – keine integrierte CAPTCHA- oder Fingerprint-Verwaltung
- Sticky Sessions: Rotation bei jeder Anfrage oder alle 3 bzw. 15 Minuten
Preis: Monatlicher Pauschalpreis abhängig von der Anzahl der Proxy-Ports. Drittanbieter nennen Tarife wie 5 Residential-Ports für etwa 50 $/Monat mit unbegrenzter Bandbreite. Vor dem Kauf auf der Checkout-Seite prüfen.
Geeignet für: Nutzer, die planbare Monatspreise ohne Bandbreitenzähler wollen. Leichtes bis mittleres Scraping, bei dem Kostenplanbarkeit wichtiger ist als Poolgröße.
Nachteile: Sehr kleiner effektiver IP-Pool (hohes Wiederverwendungsrisiko). Begrenztes Geo-Targeting. Veraltetes Dashboard. Nicht für stark geschützte Websites geeignet.
Statische vs. rotierende Proxys: Direkter Tool-Vergleich
| Tool | Proxy-/API-Typen | Ungefähre Poolgröße | Preismodell | Anti-Bot-Handling | Sticky-Session-Support | Bester Einsatzbereich |
|---|---|---|---|---|---|---|
| Thunderbit | AI-Scraping-API, MCP, CLI, Chrome-Erweiterung | Batch bis zu 100 URLs | Credits (Distill 1/URL, Extract 20/URL) | Vollständig: Rendering, Anti-Bot, CAPTCHA | N/A (verwaltet) | Strukturierte Datenextraktion, RAG, KI-Agenten |
| Bright Data | Residential, ISP, Datacenter, Mobile | 400M+ Residential, 1,3M+ ISP | Pro GB + pro IP + pro Anfrage | Web Unlocker, Browser API | Ja (10–30 Min.) | Enterprise-Skalierung, Geo-Targeting |
| Oxylabs | Residential, ISP, Datacenter, Mobile | Großer Enterprise-Pool | Residential 6 → 3,50 $/GB | Web Unblocker, Scraper APIs | Ja (standardmäßig 10 Min., konfigurierbar) | Enterprise-Scraping, verwaltete Lösungen |
| Smartproxy/Decodo | Residential, ISP, Datacenter, Mobile | 115M+ Residential | Residential ca. 3,75 $/GB; ISP ca. 3,33 $/IP | Site Unblocker | Ja (1–60 Min., bis zu 24 h) | Mid-Market, Einsteiger |
| IPRoyal | Residential, ISP, Datacenter, Mobile, Sneaker | Wachsender Pool | Residential 7 → 1,75 $/GB, nicht verfallend | Basisfunktionen (IP-Qualität) | Ja (bis zu 7 Tage) | Budget-Nutzer, saisonale Nutzung |
| SOAX | Residential, ISP, Datacenter, Mobile | 155M+, 195+ Standorte | Business 4 $/GB; Enterprise 0,32 $/GB | Saubere Pools, Web Data API | Ja (benutzerdefinierter Refresh) | Hyperlokales Targeting, Marktforschung |
| ScraperAPI | Scraping-API mit Proxy-Rotation | Service-Ebene (kein Roh-Pool) | Pro Credit; Standard 1, Amazon 5, Google 25 | Integriertes CAPTCHA, Rendering, Geo | Intern verwaltet | Entwickler, die HTML zurückhaben wollen |
| Webshare | Datacenter, Residential, ISP | 80M+ Residential | Rotierend res. 1,40 $/GB; statisch 0,23 $/IP | Minimal | Ja (Residential) | Budget-Entwickler, Prototyping |
| Storm Proxies | Rotierende Residential-/Datacenter-Proxys, statische DCs | 20M+ behauptet | Monatspauschale pro Port, unbegrenzte BW | Minimal | Jede Anfrage / 3 / 15 Min. | Planbare Kosten, leichtes Scraping |
NetNut wurde aus diesem Vergleich entfernt: Seit August 2026 zeigt netnut.io anstelle der Produktseite einen Hinweis zur Beschlagnahme durch die US-Bundesbehörden.
Die Tools lassen sich in drei Gruppen einteilen. Rohes Proxy-Infrastruktur-Set (Bright Data, Oxylabs, Smartproxy, IPRoyal, SOAX, Webshare, Storm Proxies) liefert dir IP-Zugriff, den Rest musst du selbst verwalten. Scraping-APIs (ScraperAPI) abstrahieren die Proxy-Ebene, geben aber weiterhin rohes HTML zurück. AI-Extraktions-APIs (Thunderbit) abstrahieren sowohl Proxy-Ebene als auch Parsing und liefern strukturierte Daten direkt zurück.
Wenn Proxys nicht die Lösung sind: AI-Scraping-APIs vs. selbst verwaltete Proxys
Das ist der Teil, den kein Wettbewerbsartikel abdeckt: Die meisten Menschen, die nach „statischen vs. rotierenden Proxys“ suchen, sind keine Proxy-Enthusiasten. Sie wollen Daten scrapen – Proxys sind nur das Mittel zum Zweck.
Für viele Anwendungsfälle ist das Verwalten von Proxy-Pools, Rotationslogik, Fingerprint-Spoofing und CAPTCHA-Lösung ein Overhead, den ein API-first-Tool komplett eliminiert. Aber eben nicht immer. Hier ist, wann welcher Ansatz sinnvoll ist:
Selbst verwaltete Proxys sind sinnvoll, wenn du brauchst direkten IP-Zugriff für Kontoverwaltung, Geo-Tests oder Sneaker-Bots; präzise Kontrolle über ASN, Carrier oder Exit-IP-Verhalten; oder einen eigenen Browser-/Proxy-Stack, den dein Team ohnehin schon betreibt.
API-first-Extraktion ist sinnvoll, wenn du brauchst strukturierte Daten (Produktlisten, Kontaktdaten, Preise) statt rohem HTML, sauberes Markdown für RAG-Pipelines, KI-Agenten-Workflows, bei denen Webzugriff mitten im Task unsichtbar sein soll, oder einfach weniger Zeit für Proxy-Infrastruktur und mehr Zeit für die Daten selbst.
Die API von Thunderbit übernimmt Rendering, Anti-Bot und CAPTCHAs serverseitig. Entwickler erhalten sauberes Markdown (/distill) oder schema-passendes JSON (/extract) ohne Proxy-Pool-Konfiguration oder Fingerprint-Konsistenz. Der MCP-Server erlaubt Claude oder Cursor, mitten im Task über thunderbit_extract zu scrapen – die Proxy-Ebene ist wirklich unsichtbar.
Für einen breiteren Blick auf Web Scraping ohne Programmierung haben wir das Thema separat behandelt.
Welches statische oder rotierende Proxy-Tool passt zu dir?
Konkrete Empfehlungen nach Szenario, denn „es kommt darauf an“ ist zwar korrekt, aber nicht sonderlich hilfreich:
- Am besten für Unternehmen mit riesigen IP-Pools: Bright Data, Oxylabs
- Am besten für budgetbewusste Teams: IPRoyal, Webshare, Storm Proxies
- Am besten für eine einfache Mid-Market-Einrichtung: Smartproxy/Decodo, SOAX
- Am besten, wenn du Proxy-Management komplett überspringen willst: Thunderbit (strukturierte Daten), ScraperAPI (rohes HTML)
- Am besten für KI-Agenten und MCP-Workflows: Thunderbit
Anti-Bot-Systeme werden immer schlauer – sie kombinieren IP-Reputation, TLS-Fingerprinting, Verhaltensanalyse und Header-Konsistenz – und mit ihnen steigen die Kosten für selbst verwaltete Proxys. Für Teams, deren Endziel saubere, strukturierte Webdaten sind, werden API-first-Tools, die die gesamte Proxy-Ebene abstrahieren, zunehmend zur praktischeren Wahl.
Dieser Wandel ist nicht hypothetisch. Er passiert längst.
Wenn du sehen willst, wie das in der Praxis aussieht, ist die Thunderbit Chrome-Erweiterung ein guter Einstieg für nicht-technische Nutzer, und die API-Dokumentation zeigt den Entwickler-Workflow. Für mehr Kontext zum breiteren Scraping-Tool-Markt sieh dir unseren Vergleich der besten AI Web Scraper an. Du kannst dir außerdem Anleitungen auf dem Thunderbit YouTube-Kanal ansehen.
Thunderbit AI Web Scraper testen Get Started Free
FAQs
1. Wann sollte ich statische statt rotierender Proxys verwenden?
Nutze statische Proxys, wenn du über mehrere Sessions hinweg dieselbe IP brauchst – für Kontoverwaltung, Zugriff auf geo-gesperrte Inhalte, Rank-Tracking oder jede Plattform, die IP-Wechsel als verdächtig einstuft. Wenn das Ziel erwartet, über längere Zeit dieselbe Identität zu sehen, ist statisch die richtige Wahl. Bei schwierigen Zielen sind ISP-/statische Residential-IPs sicherer als Datacenter-IPs.
2. Was ist der Unterschied zwischen einer Sticky Session und einem statischen Proxy?
Eine Sticky Session hält dieselbe IP für ein konfigurierbares Zeitfenster (z. B. 10 Minuten, 30 Minuten, je nach Anbieter bis zu 24 Stunden) und wechselt danach auf eine neue IP. Ein statischer Proxy behält dieselbe IP auf unbestimmte Zeit, bis du sie manuell austauschst. Das ist nicht dasselbe, auch wenn manche Anbieter diese Begriffe in ihrer Dokumentation vermischen.
3. Warum werden rotierende Proxys auf manchen Websites trotzdem blockiert?
Weil moderne Anti-Bot-Systeme mehrstufige Erkennung jenseits der IP-Adresse einsetzen. TLS-/JA3-Fingerprinting, Verhaltensanalyse (Anfragemuster, Navigationspfade) und die Prüfung der Header-Konsistenz können automatisierten Traffic unabhängig von der IP-Rotation erkennen. Rotierende IPs reduzieren IP-basierte Limits, lösen aber diese anderen Erkennungsebenen nicht.
4. Was kosten rotierende Residential-Proxys in großem Maßstab?
Öffentlich verfügbare Self-Service-Preise reichen von etwa 1,40 $/GB (Webshare) bis 8 $/GB im regulären PAYG-Modell (Bright Data), mit Enterprise-Rabatten nach oben und unten. Bei vollständigem Seiten-Rendering (50.000 Seiten/Tag bei ~2,86 MB/Seite) kann allein die Bandbreite auf über 4 TB/Monat steigen – potenziell also auf Zehntausende Dollar. Kreditbasierte oder anfragenbasierte APIs (wie Thunderbit oder ScraperAPI) bieten eine besser planbare Preisstruktur ohne Bandbreitenmessung.
5. Kann eine AI-Scraping-API Proxys vollständig ersetzen?
Für strukturierte Datenerfassung und Web Scraping oft ja. Tools wie Thunderbit übernehmen Proxy-Rotation, Anti-Bot-Maßnahmen, CAPTCHA-Lösung und JS-Rendering auf Infrastrukturebene – du bekommst saubere Daten zurück, ohne Proxy-Infrastruktur selbst verwalten zu müssen. Für Anwendungsfälle, die direkten IP-Zugriff erfordern (Kontoverwaltung, Geo-Tests, Sneaker-Bots), bleiben klassische Proxys notwendig.
Mehr erfahren



