
Thunderbit je rozšíření Chrome pro AI Web Scraper, které pomáhá firemním uživatelům získávat data z webů pomocí AI. Jádro problému je jednoduché: to, co na cenové stránce ScrapingBee vypadá levně, může v produkčním provozu vyjít úplně jinak, jakmile sledujete, jak kredity mizí 5× až 75× rychleji než základní sazba. Tahle recenze se zaměřuje na pět oblastí, které většina článků přeskakuje: reálné náklady ve větším měřítku, extrakci přes selektory vs. AI, použitelnost pro neprogramátory, práci s daty po scrappingu a spolehlivost v roce 2026. Pokud ScrapingBee zvažujete pro svůj tým — ať už jste vývojář, vedoucí sales ops nebo zakladatel — tohle je rozbor, který potřebujete.
Co je ScrapingBee? Rychlý přehled
ScrapingBee je API pro web scraping, které řeší rotaci proxy, vykreslování JavaScriptu a obcházení CAPTCHA, takže vývojáři mohou získávat data z webů bez vlastní scrapingové infrastruktury. Pošlete HTTP požadavek s parametry a zpět dostanete HTML (u některých endpointů i JSON). Pro tvorbu scraperů tu ale není žádné vizuální rozhraní ani klikací editor.
Mezi hlavní funkce patří:
- Rotující a prémiové proxy (classic, premium, stealth, residential)
- Renderování v headless browseru (plný Chrome, zapnutý ve výchozím nastavení)
- Automatické obcházení CAPTCHA
- Google Search API (strukturovaný JSON: organické výsledky, reklamy, mapy, knowledge graph, People Also Ask, obrázky, novinky)
- Snímky obrazovky (standardní, celé stránky nebo cílené přes CSS selektor)
- Geografické cílení přes parametr country_code
- Pravidla extrakce přes CSS/XPath (deklarativní, na JSON bázi, vrací strukturovaný JSON)
- Specializovaná API pro Amazon, Walmart, YouTube a ChatGPT scraping
- AI extrakce (přidáno přibližně v letech 2024–2025): parametry ai_query, ai_extract_rules, ai_selector (+5 kreditů za požadavek)
- CLI nástroj (spuštěn přibližně v letech 2025–2026): dávkové zpracování, crawling, parsování sitemap, obohacování CSV, plánované cron úlohy, eskalace proxy
ScrapingBee bylo založeno v roce 2019 ve Francii a do začátku roku 2026 vyrostlo na zhruba $5 milionů ARR s více než 2 500 zákazníky (SAP, Zapier, Deloitte, Zillow) — a to vše bez externího financování, s týmem o 4–6 lidech. V červnu 2025 Oxylabs Group koupila ScrapingBee v transakci za osmimístnou částku. Značka i vedení zůstaly nezávislé a support tým se více než zdvojnásobil pro lepší pokrytí časových pásem.
Důležitá poznámka: ScrapingBee stále nemá nativní vizuální builder, click-and-point GUI ani vestavěný plánovač v dashboardu. Plánování je možné přes CLI nástroj, cron úlohy nebo integrace třetích stran (Zapier, Make, n8n). Průvodce typu „no-code“, které publikují, jsou ve skutečnosti o používání integrací Make a Zapier — ne o nativním no-code rozhraní.
Pro koho je ScrapingBee skutečně určené?
ScrapingBee je navržené pro vývojáře, kteří umí psát Python nebo cURL volání, číst HTML a sestavovat CSS/XPath selektory. Dokumentace je silně technická a opírá se hlavně o příklady v Pythonu a cURL. Jeden recenzent na Capterra poznamenal, že „neposkytují příklady v JavaScriptu“, a jiný popsal dokumentaci jako „objemnou, zabere den až týden, než se v ní člověk prokouše“.
Jenže publikum, které v roce 2026 hledá „ScrapingBee review“, je širší než jen backend inženýři. Patří sem marketingoví manažeři, kteří staví seznamy leadů, sales ops týmy obohacující CRM data, ecommerce operace sledující ceny konkurence i zakladatelé vybírající nástroje pro svůj tým. U každé sekce níže proto zmíním, zda je daná funkce nebo omezení důležité pro vývojáře, firemní uživatele, nebo pro obě skupiny.
Cenové plány ScrapingBee na první pohled
Tady jsou aktuální cenové tarify ScrapingBee (k dubnu 2026):
| Plán | Měsíční cena | API kredity / měsíc | Současné požadavky |
|---|---|---|---|
| Freelance | $49 | 250,000 | 10 |
| Startup | $99 | 1,000,000 | 50 |
| Business | $249 | 3,000,000 | 100 |
| Business+ | $599 | 8,000,000 | 200 |
| Enterprise | Kontaktujte obchod | 41M+ | Na míru |
Roční fakturace nabízí 17% slevu. Zkušební verze zdarma obsahuje 1 000 API kreditů bez nutnosti zadávat platební kartu. Google Search API bylo po akvizici nedávno sníženo z 25 na 15 kreditů za volání.
Ta velká čísla v cenovce vypadají štědře. Jenže realita je jiná.
Tabulka násobení kreditů
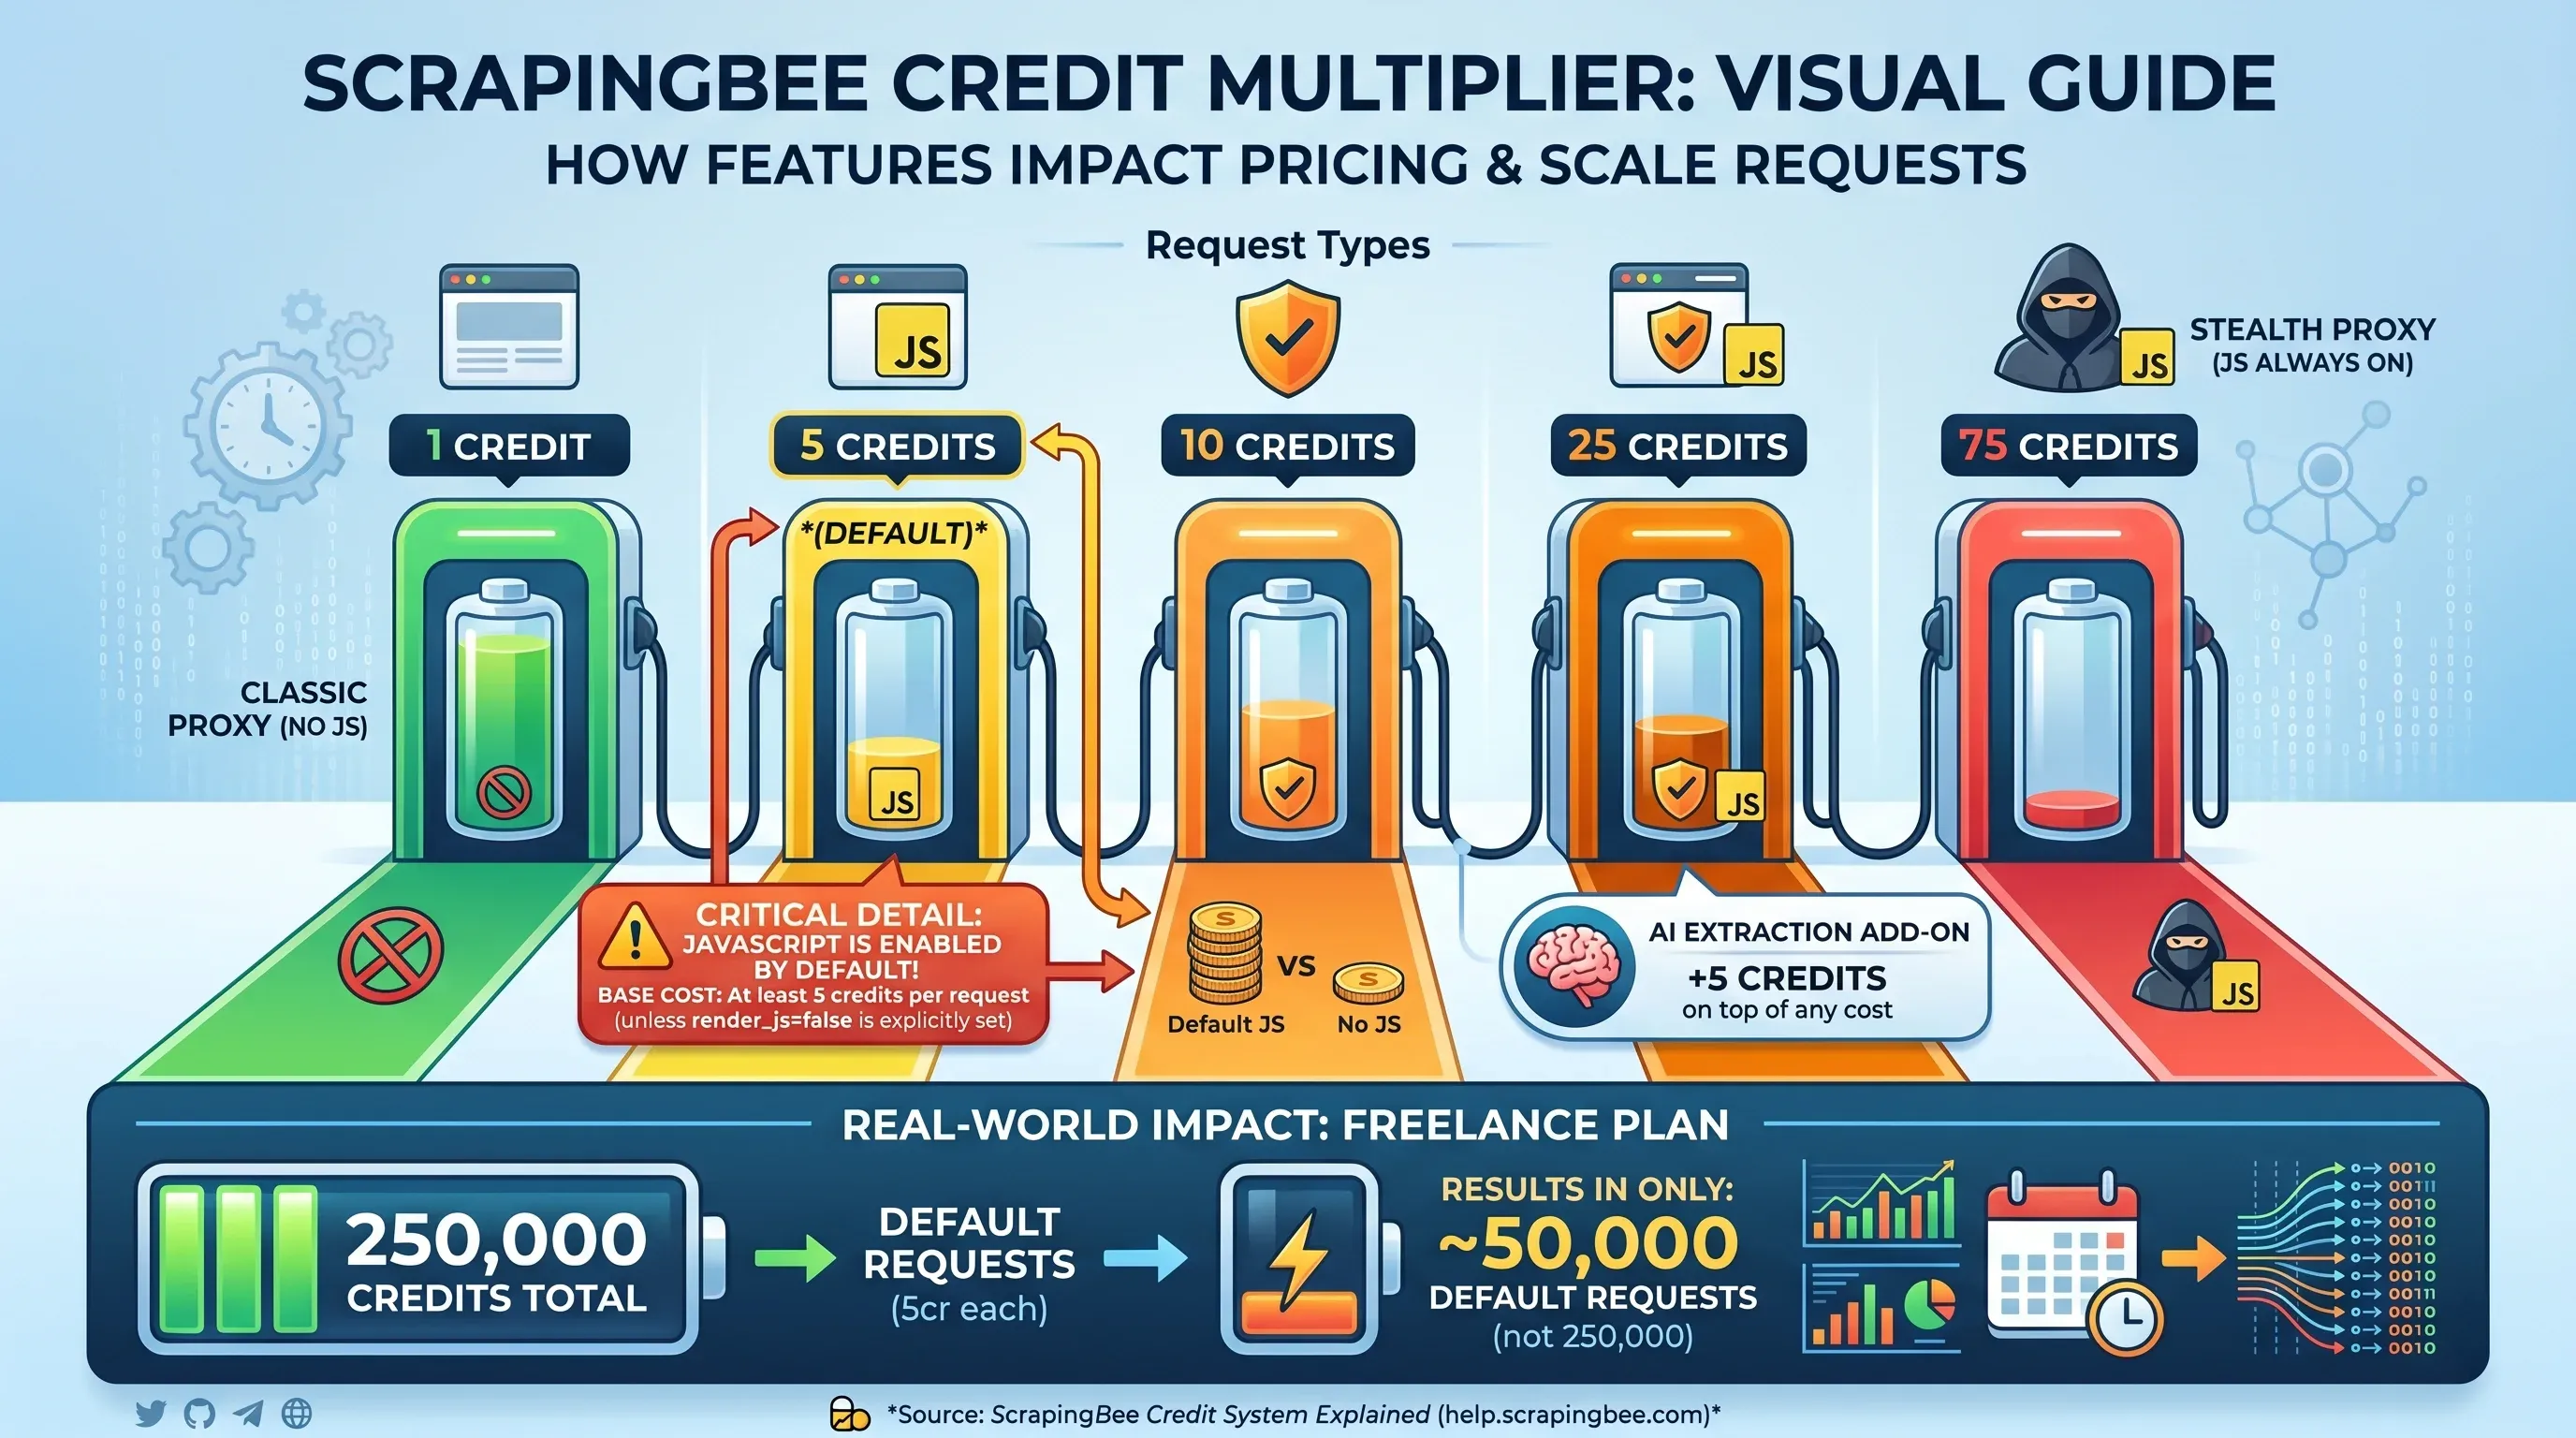
Tady se cenový model ScrapingBee začíná komplikovat. Počet uvedených kreditů neznamená počet stránek, které skutečně získáte — záleží na tom, jaké funkce zapnete u jednotlivých požadavků:
| Typ požadavku | Kredity za požadavek |
|---|---|
Classic proxy, bez JS renderingu (render_js=false) | 1 kredit |
| Classic proxy, JS rendering (výchozí) | 5 kreditů |
| Premium proxy, bez JS renderingu | 10 kreditů |
| Premium proxy, JS rendering | 25 kreditů |
| Stealth proxy (JS vždy zapnuté) | 75 kreditů |
| AI extrakce jako doplněk | +5 kreditů navíc |
Klíčový detail: JavaScript rendering je zapnutý ve výchozím nastavení. Pokud výslovně nenastavíte render_js=false, každý požadavek stojí minimálně 5 kreditů. To znamená, že 250 000 kreditů v plánu Freelance pokryje ve skutečnosti jen 50 000 výchozích požadavků — ne 250 000.
Skryté kreditové počty, které vám nikdo neukáže
Tady je, kolik ScrapingBee ve skutečnosti stojí pro 10 000 stránek v různých scénářích a tarifech:
| Scénář | Potřebné kredity | Freelance ($49/250K) | Startup ($99/1M) | Business ($249/3M) |
|---|---|---|---|---|
| 10K stránek (statické HTML, 1 kr) | 10,000 | ✅ Pokryto ($0.20/1K) | ✅ Pokryto ($0.10/1K) | ✅ Pokryto ($0.08/1K) |
| 10K stránek (JS render, 5 kr) | 50,000 | ✅ Pokryto ($0.98/1K) | ✅ Pokryto ($0.50/1K) | ✅ Pokryto ($0.42/1K) |
| 10K stránek (premium proxy + JS, 25 kr) | 250,000 | ⚠️ Přesně na limitu ($4.90/1K) | ✅ Pokryto ($2.48/1K) | ✅ Pokryto ($2.08/1K) |
| 10K stránek (stealth proxy, 75 kr) | 750,000 | ❌ Daleko nad limitem | ✅ Těsně pokryto ($7.43/1K) | ✅ Pokryto ($6.23/1K) |
Stejných 10 000 stránek může stát od $0.20 do $7.43 za tisíc podle nastavení proxy a renderingu. A ne vždy předem víte, kterou konfiguraci budete potřebovat, dokud ji nevyzkoušíte.
Rozpočtový scénář: generování leadů při 10 000 stránkách měsíčně
Sales tým, který pro získávání leadů scrapuje 10 000 firemních stránek měsíčně. Většina moderních B2B webů používá React nebo Vue, takže je potřeba JS rendering:
- Potřebné kredity: 50 000 (10K × 5 kreditů)
- Plán Freelance ($49): Pokryje to a ještě zbyde 200K kreditů
- Pokud ale cíle vyžadují prémiové proxy: 250 000 kreditů — přesně alokace jednoho plánu Freelance, bez rezervy
- Pokud jsou potřeba stealth proxy: 750 000 kreditů — vyžaduje plán Startup za $99/měsíc
Rozpočtový scénář: sledování cen v e-commerce při 100 000 stránkách měsíčně
Ecommerce tým sledující 100 000 produktových stránek na webech konkurence:
| Konfigurace | Potřebné kredity | Nutný plán | Měsíční cena |
|---|---|---|---|
| Statické HTML (1 kr) | 100,000 | Freelance | $49 |
| JS rendering (5 kr) | 500,000 | Startup | $99 |
| Premium proxy + JS (25 kr) | 2,500,000 | Business | $249 |
| Stealth proxy (75 kr) | 7,500,000 | Business+ | $599 |
Stejná práce se může pohybovat od $49 do $599 měsíčně. To není drobný rozdíl — je to 12násobný cenový rozdíl podle konfigurace.
„Startovní cena $49 je v prostředí scraping API ten nejvíc zavádějící údaj.“ — Prospeo
„Kredity mizí velmi rychle při použití JavaScript renderingu nebo pokročilých funkcí, takže je těžší obhájit nástroj u menších projektů nebo týmů s nepředvídatelným objemem scrapingu.“ — Nick S, Manager, Computer Software, Capterra
A nevyužité kredity se nepřevádějí do dalšího měsíce.
Jak si ScrapingBee stojí proti konkurenci
Pro férové srovnání použijme střední tarify:
| Scénář (na 1K stránek) | ScrapingBee ($99/1M) | ScraperAPI ($149/1M) | Scrapfly ($100/1M) |
|---|---|---|---|
| Statické HTML | $0.10 | $0.15 | $0.10 |
| Stránky s JS renderingem | $0.50 | $1.64 | $0.60 |
| Premium + JS | $2.48 | $3.73 | $3.00 |
| Stealth/ultra premium + JS | $7.43 | $11.18 | N/A |
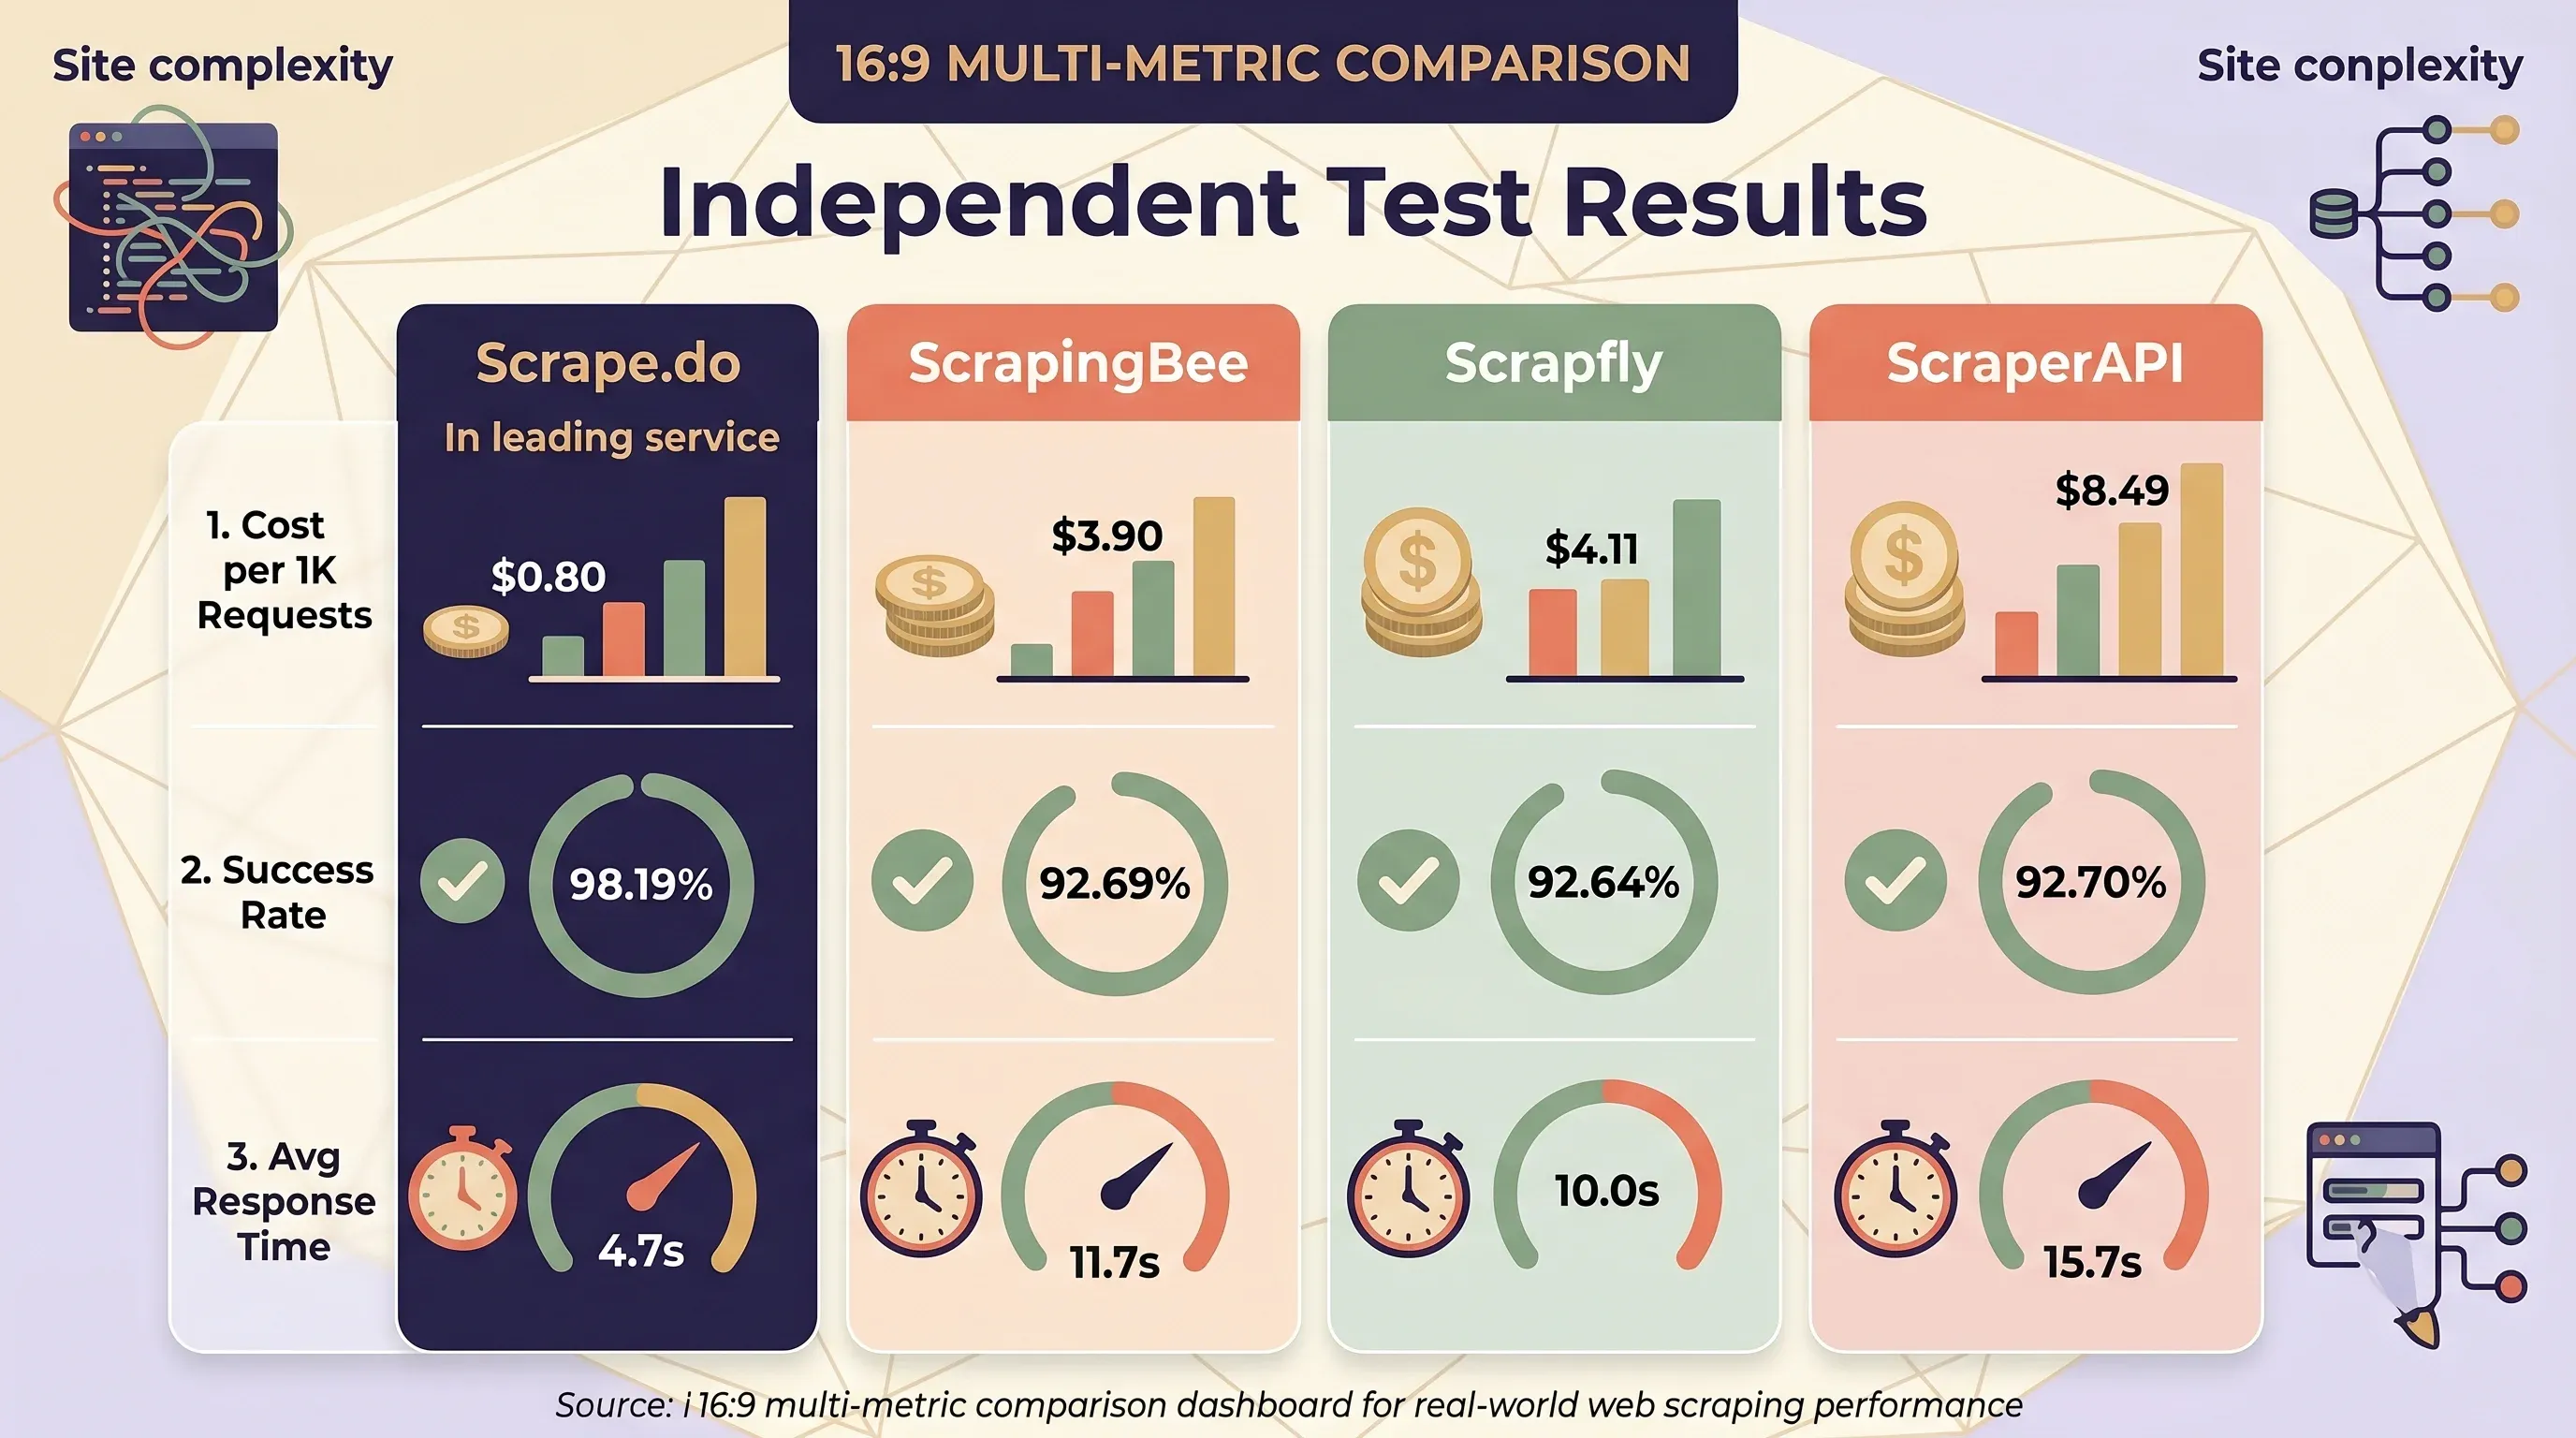
ScrapingBee je obecně nejlevnější nebo se dělí o první místo u statických stránek a stránek s JS renderingem. ScraperAPI je konzistentně nejdražší — JS rendering stojí +10 kreditů oproti +5 u ScrapingBee i Scrapfly. Jenže nezávislé testy od Scrape.do ukazují jiný obrázek, pokud vezmeme v úvahu skutečnou složitost webů:
| Služba | Průměrná cena za 1K požadavků | Úspěšnost | Průměrná doba odezvy |
|---|---|---|---|
| Scrape.do | $0.80 | 98.19% | 4.7s |
| ScrapingBee | $3.90 | 92.69% | 11.7s |
| Scrapfly | $4.11 | — | — |
| ZenRows | $4.48 | 92.64% | 10.0s |
| ScraperAPI | $8.49 | 92.70% | 15.7s |
Kreditní model Thunderbit: jiný přístup
Thunderbit používá mnohem jednodušší cenový model: 1 kredit = 1 výstupní řádek, bez násobků za JS rendering, typ proxy nebo cílovou doménu. Scraping podstránek stojí 2 kredity na řádek.
| Plán | Měsíční cena | Kredity | Cena za řádek |
|---|---|---|---|
| Free | $0 | 6 stránek / měsíc | Zdarma |
| Starter | $15 | 500 | $0.030 |
| Pro 1 | $38 | 3,000 | $0.013 |
| Pro 2 | $75 | 6,000 | $0.013 |
| Pro 3 | $125 | 10,000 | $0.013 |
| Pro 4 | $249 | 20,000 | $0.012 |
Uživatel Thunderbit, který scrapuje 10 000 produktových záznamů z e-commerce webů náročných na JS, zaplatí $125/měsíc bez ohledu na to, jestli tyto weby vyžadují JavaScript rendering, prémiové proxy nebo obcházení anti-bot ochrany. U ScrapingBee může stejná úloha stát $49 až $599 podle konfigurace. Předvídatelnost rozpočtu je reálná výhoda.
CSS selektory vs. AI extrakce: náklad na údržbu, který byste měli znát
Většina recenzí ScrapingBee tohle úplně vynechává. Přitom je to možná nejdůležitější faktor pro každého, kdo chce scrapovat ve větším měřítku měsíce nebo roky.
ScrapingBee používá k extrakci dat z HTML CSS/XPath selektory. Pravidla extrakce definujete jako JSON objekty se selektory a ScrapingBee vrátí odpovídající data. Ze začátku to funguje dobře. Problém nastává potom.
Problém s rozbitím selektorů
Když se cílový web změní — názvy tříd, struktura DOM, verze frameworku — vaše CSS selektory přestanou fungovat. U zralých scrapingových systémů, které běží napříč 2 500+ aktivními úlohami, výzkum ukazuje 1–2% týdenní míru rozbití, což znamená 30–35 oprav týdně jen proto, aby extraktory dál fungovaly. U organizací scrapujících 50 webů vychází roční údržba na 850–1 300 hodin, tedy $64,000–$156,000 při plně započtené sazbě inženýra.
Týmy to systematicky podceňují. Počáteční odhady často počítají s 10–15 hodinami údržby měsíčně, ale realita bývá 4–6× vyšší (40–90 hodin měsíčně). Jediné tiché selhání — kdy se selektor rozbije, ale dál vrací prázdná data, aniž by na to někoho upozornil — může stát odhadovaných $38,000–$57,000 na ušlých tržbách, obnově pozic a času zaměstnanců.
Nejčastější příčiny: přejmenování CSS tříd při updatech frameworků, přidání nových wrapperů kolem cílových prvků, upgrady React/Vue/Angular, které přeorganizují DOM, A/B testování s dynamickými názvy tříd a obfuskace proti scrapingu.
AI extrakce snižuje údržbu o 60–80 %
Studie DataRobot z roku 2025 zjistila, že AI scrapery vyžadují po redesignu webu o 70 % méně údržby než tradiční scrapery založené na selektorech. Poměr času se v praxi obrací:
| Metrika | Tradiční (CSS selektory) | AI poháněné |
|---|---|---|
| Údržba po redesignu | Základní úroveň | o 70 % méně |
| Rozdělení času (nastavení : údržba) | 20 % : 80 % | 5 % : 95 % podle dat |
| Celkové snížení údržby | Základní úroveň | 60–80% snížení |
| Rychlost na stránkách náročných na JS | Základní úroveň | o 30–40 % rychlejší |
Čas nastavení: psaní selektorů vs. pole navržená AI
Nastavení ScrapingBee: Projdete zdroj stránky → najdete CSS selektory → napíšete pravidla extrakce jako JSON → otestujete a ladíte → řešíte edge cases pro varianty stránek → sledujete rozbití → opravujete selektory, když se web změní.
Nastavení Thunderbit: Otevřete stránku v Chrome → kliknete na „AI Suggest Fields“ → AI přečte stránku a navrhne sloupce s odpovídajícími datovými typy → kliknete na „Scrape“. Žádné psaní selektorů, žádné procházení zdrojového kódu. AI v Thunderbit je poháněná několika foundation modely (ChatGPT, Gemini, Claude, DeepSeek R1), které vizuálně čtou web jako člověk.
Další vrstvu přidávají Field AI Prompts: každý sloupec může mít vlastní AI instrukci, která data při extrakci upraví — naformátuje datum, přeloží text, zařadí produkt do kategorie, rozdělí jména, sjednotí telefonní čísla. Odpadá tím samostatný postprocessing, který si uživatelé ScrapingBee musí vybudovat sami.
Strukturovaný výstup: surové HTML vs. připravené řádky
| Oblast | ScrapingBee (na selektorech) | Thunderbit (AI poháněné) |
|---|---|---|
| Výchozí výstup | Surové HTML | Strukturované řádky s typovanými sloupci |
| Strukturovaná extrakce | Vyžaduje psaní CSS/XPath pravidel nebo použití AI (+5 kreditů) | AI automaticky rozpozná pole |
| Podporované datové typy | Text (nutné parsování HTML) | Text, číslo, datum, URL, e-mail, telefon, obrázek |
| Odolnost vůči změnám rozložení | ⚠️ Nutné ruční aktualizace selektorů | ✅ AI znovu přečte stránku při každém spuštění |
| Požadované technické dovednosti | Python/cURL, CSS selektory, porozumění HTML | Žádné — Chrome rozšíření se workflow na 2 kliknutí |
| Dlouhodobá údržba | Průběžná (1–2% týdenní rozbití) | Minimální (AI se přizpůsobuje automaticky) |
ScrapingBee přidalo AI funkce extrakce (ai_query, ai_extract_rules), které problém s údržbou selektorů částečně řeší. Tyto funkce ale přidávají +5 kreditů za požadavek navíc k základní ceně a nástroj zůstává v jádru API-first bez vizuálního rozhraní.
ScrapingBee pro neprogramátory: upřímné zhodnocení použitelnosti
ScrapingBee není postavené pro netechnické uživatele. Je to API. Používáte ho psaním kódu. Pokud jste marketingový manažer nebo vedoucí sales ops a čtete tohle, tím je řečeno všechno.
Takhle vypadá zkušenost ne-technického uživatele se ScrapingBee:
- Napíšete API volání v Pythonu, cURL nebo jiném jazyce
- Pochopíte HTTP parametry jako
render_js=true,premium_proxy=true,country_code=us - Parsujete surové HTML odpovědi pomocí knihovny jako BeautifulSoup
- Napíšete CSS selektory pro konkrétní datová pole
- Vyřešíte stránkování napsáním vlastní crawl logiky (ScrapingBee řeší jen jednotlivé stránky)
- Postavíte datový pipeline pro čištění, strukturování a ukládání získaných dat
Neexistuje žádný drag-and-drop builder. Žádné point-and-click rozhraní. Žádný vizuální náhled toho, co vlastně scrapujete.
„Je tam strmá křivka učení. A dokumentace je objemná, zabere den až týden, než ji člověk projde.“ — Arvind K, Proprietor, Financial Services, Capterra
„Jejich systém je hodně specifický a chvíli trvá, než se člověk naučí jejich kódování a strukturu.“ — recenze na Capterra
Vývojáři to milují. Jeden recenzent napsal, že je to „zcela API-based: velmi moderní a elegantní: prostě to funguje.“ Jenže „snadné použití“ pro vývojáře, který hodnotí API, znamená něco úplně jiného než „snadné použití“ pro člověka, který chce bez kódování vytvořit seznam leadů.
Kdy dává větší smysl no-code alternativa
Thunderbit Chrome Extension nabízí zásadně jiný zážitek:
- Otevřete webovou stránku v Chrome s nainstalovaným rozšířením
- Kliknete na „AI Suggest Fields“ — AI stránku projde a navrhne sloupce (Product Name, Price, Rating, URL atd.) s odpovídajícími datovými typy
- Zkontrolujete a upravíte — přidáte, odeberete nebo přejmenujete sloupce; doplníte Field AI Prompts pro transformace
- Kliknete na „Scrape“ — data se vytáhnou do strukturovaných řádků
- Exportujete — jedním klikem do Google Sheets, Airtable, Notion, Excelu, CSV nebo JSON (všechny exporty jsou zdarma)
Žádné API volání, žádné selektory, žádný kód. Thunderbit podporuje 55 jazyků k dubnu 2026.
Pro běžné weby nabízí Thunderbit také okamžité scraper šablony — předpřipravené, udržované šablony pro Amazon, Zillow, Shopify, LinkedIn, Google Maps, Instagram, eBay, Apollo a další. Nemusíte ani čekat, až AI navrhne pole; šablona je připravená rovnou.
Navíc Thunderbit obsahuje několik nástrojů zdarma navždy, které nevyžadují žádný plán: email extractor, phone number extractor a image extractor — hodí se pro sales a marketing týmy, které potřebují jen rychle vytáhnout data.
Rozhodovací rámec: kdo by měl používat co
| Pokud jste… | Nejlepší volba |
|---|---|
| Vývojář pohodlný s API a parsováním HTML | ScrapingBee nebo ScraperAPI |
| Technický uživatel, který chce strukturovaná data bez práce se selektory | Thunderbit API (Extract endpoint) |
| Firemní uživatel (sales, marketing, ecommerce ops) bez programování | Thunderbit Chrome Extension |
| Tým, který potřebuje plánované monitorování bez DevOps | Thunderbit Scheduled Scraper (plánování v přirozeném jazyce) |
| Stavíte LLM/RAG pipeline a potřebujete čistý markdown | Thunderbit Distill API nebo Firecrawl |
| Sledujete rozpočet a nechcete násobky kreditů | Thunderbit (1 kredit = 1 řádek) |
Co se děje po scrapingu? Kam data vlastně putují?
Scraping je jen polovina práce. Ta druhá — dostat data někam, kde jsou skutečně užitečná — je část, o které většina recenzí ScrapingBee mlčí.
ScrapingBee: ven jde surové HTML, pipeline si musíte postavit sami
ScrapingBee vrací ve výchozím nastavení surové HTML. Od toho okamžiku musíte:
- Parsovat HTML pomocí BeautifulSoup nebo lxml
- Odstranit navigaci, patičky, skripty a styly (které tvoří 80–90 % typického obsahu stránky)
- Vytáhnout konkrétní datová pole
- Převést je do strukturovaného formátu
- Vyřešit stránkování a chybové stavy
- Uložit a distribuovat data
„ScrapingBee vrací surové HTML. AI agenti potřebují čistý markdown, sémantické vyhledávání a webhooky.“ — KnowledgeSDK
ScrapingBee sice nabízí alternativy return_page_markdown=true a return_page_text=true, a Google Search API vrací strukturovaný JSON. Výchozí workflow — a obecně zkušenost s univerzálním scrapingem — ale stále stojí na surovém HTML, které si musíte sami zpracovat.
Uživatelé obvykle potřebují další nástroje: BeautifulSoup/lxml pro parsování, Pandas pro čištění dat, cron/Airflow pro plánování, vlastní crawl logiku pro vícestránkový scraping a samostatné cloudové úložiště. To je spousta inženýrské práce mezi „mám to scrapnuté“ a „můžu to použít“.
Thunderbit: strukturovaný výstup s vestavěným exportem
Thunderbit vrací strukturované řádky s definovanými datovými typy (text, číslo, datum, URL, e-mail, telefon, obrázek), připravené k exportu. Všechny exporty jsou zdarma napříč všemi tarify:
| Cílový export | Cena |
|---|---|
| Excel (.xlsx) | Zdarma |
| Google Sheets | Zdarma (přímá integrace) |
| Airtable | Zdarma (přímá integrace) |
| Notion | Zdarma (přímá integrace) |
| CSV | Zdarma |
| JSON | Zdarma |
Pro týmy, které už používají Google Sheets nebo Airtable jako CRM nebo operační centrum, to odstraňuje celou vrstvu vývoje. Při exportu do Notion nebo Airtable se obrázky nahrávají do image library, takže je uživatelé vidí přímo v záznamu — drobnost, která v praxi hodně pomáhá.
Integrační ekosystém ScrapingBee
ScrapingBee nabízí i integrace třetích stran: Zapier (8 000+ propojení aplikací), Make (3 000+ aplikací), n8n a Microsoft Power Automate. Ty mohou překlenout mezeru mezi surovým HTML a vašimi cílovými nástroji — ale přidávají náklady, složitost a další bod selhání.
Pro vývojáře: Open API Thunderbit
Pro čtenáře, kteří chtějí programovatelné pipeline, Thunderbit nabízí Open API se dvěma klíčovými endpointy:
- Distill endpoint — převádí stránky na čistý Markdown, ideální pro LLM/RAG pipeline (1 kredit za volání)
- Extract endpoint — vrací strukturovaný JSON podle uživatelem definovaného schématu (20 kreditů za volání)
- Dávkové zpracování — až 100 URL na jeden požadavek
Thunderbit tak slouží jak no-code uživatelům (Chrome Extension), tak vývojářům (Open API) nad stejným AI jádrem. Neptejte se jen „umí to scrapovat?“ — ptejte se „kam ta data potom jdou?“
Kontrola spolehlivosti v roce 2026: obstojí ScrapingBee v produkci?
Starší vlákna na Redditu (2021–2023) obsahují stížnosti na spolehlivost ScrapingBee. Odrážejí ještě realitu v roce 2026? Shromáždil jsem data ze šesti nezávislých benchmarků. Výsledky jsou smíšené — a někdy si i protiřečí.
Dvoutýdenní benchmark Scrapeway (duben 2026)
Celkově: 33.3% úspěšnost — 7. místo z 9 testovaných služeb.
| Web | Úspěšnost |
|---|---|
| Amazon | 48% |
| 41% | |
| Indeed | 38% |
| Etsy | 21% |
| Booking | 17% |
| Realtor | 0% |
| StockX | 0% |
| Twitter/X | 0% |
| Zillow | 0% |
| Walmart | 0% |
| 0% |
Přímý test Scrapingdog (2025)
| Web | ScrapingBee | Scrapingdog | ScraperAPI |
|---|---|---|---|
| Amazon | 100% | 100% | 100% |
| Glassdoor | 0% | 100% | 100% |
| eBay | 100% | 100% | 100% |
| Walmart | 40% | 100% | 100% |
| 90% | 100% | 80% |
Benchmark Proxyway (prosinec 2025)
- 84.47% úspěšnost při 2 požadavcích za sekundu
- 72.98% úspěšnost při 10 požadavcích za sekundu — pokles o 12 bodů pod zátěží
- 25.46 s průměrná doba odezvy — nejpomalejší v testovaném souboru
Benchmark Scrape.do (2025–2026)
- 92.69% celková úspěšnost
- Silné výsledky na jednotlivých webech: Amazon 99.11 %, Indeed 99.29 %, GitHub 100 %, X/Twitter 99.6 %
- Slabé výsledky na Capterra: jen 59 % úspěšnosti a 36sekundové odezvy
Vzor, který z toho vyplývá
Data ukazují jasný trend:
- ScrapingBee funguje dobře na mainstreamových, mírně chráněných webech — Amazon, eBay, GitHub a Indeed konzistentně ukazují 90–100% úspěšnost
- ScrapingBee úplně selhává na silně chráněných webech — napříč benchmarky opakovaně 0 % na LinkedIn, Zillow, Realtor.com, StockX a Twitteru
- Výkon výrazně klesá pod zátěží — 84 % při 2 req/s padá na 73 % při 10 req/s
- Výsledky benchmarků se dramaticky liší podle metodiky — od 33.3 % (Scrapeway, široký mix webů) po 92.69 % (Scrape.do, středně náročné cíle)
Hodnocení ScrapingBee na Capterra 4.9/5 (137 recenzí) je pozitivní signál, ale vysoké známky za snadnost prvotního nastavení ne vždy odrážejí dlouhodobou produkční spolehlivost ve větším měřítku. Uživatelé, kteří od nástroje odcházejí, často zmiňují rostoucí chybovost a vyšší náklady — ne počáteční obtížnost nastavení.
„Velmi pozitivní. ScrapingBee bylo stabilní, předvídatelné a snadno se integrovalo do produkce.“ — Ověřený recenzent, CEO, Capterra
ScrapingBee vykazovalo „nekonzistentní spolehlivost“, konkrétně „0% úspěšnost na Glassdoor“ a „40% na Walmartu“.
Jak AI scraping řeší spolehlivost jinak
AI v Thunderbit čte renderovanou stránku v reálném čase a v každé relaci se přizpůsobuje anti-bot opatřením i změnám rozvržení.
- Cloud scraping — běží na cloudových serverech Thunderbit, zpracuje až 50 stránek najednou, nejlepší pro velké veřejné scrapingové úlohy na webech jako Amazon, Zillow a Shopify
- Browser scraping — běží lokálně v uživatelově Chrome, používá jeho přihlášenou relaci — ideální pro přihlášené weby (LinkedIn, interní dashboardy, SaaS platformy), kam API nástroje jako ScrapingBee nemají přístup přes autentizaci
Thunderbit také nabízí okamžité scraper šablony pro populární weby, které jsou předpřipravené a udržované, takže fungují i ve chvíli, kdy web změní strukturu. U webů, kde ScrapingBee ukazuje 0% úspěšnost (LinkedIn, Zillow), je browser scraping v Thunderbit — s použitím vaší vlastní přihlášené relace — zásadně odlišný přístup.
ScrapingBee vs. hlavní alternativy: srovnání vedle sebe
| Oblast | ScrapingBee | Thunderbit | ScraperAPI | Scrapfly |
|---|---|---|---|---|
| Typ | Pouze API | Chrome Extension + API | Pouze API | Pouze API |
| Startovní cena | $49/měs. | Zdarma ($0) | $49/měs. | $30/měs. |
| Kreditový model | Násobky (1×–75×) | 1 kredit = 1 řádek (bez násobků) | Násobky (1×–75×) | Násobky (1×–30×) |
| AI extrakce | Ano (+5 kreditů/požadavek) | Vestavěná (AI Suggest Fields) | Nativní AI ne | Ano |
| No-code varianta | Ne (jen API) | Ano (Chrome Extension) | Ne (jen API) | Ne (jen API) |
| Strukturovaný výstup | Vyžaduje CSS pravidla nebo AI doplněk | Výchozí (typované sloupce) | Strukturované endpointy pro konkrétní weby | Různé |
| Cíle exportu | Surové HTML/JSON (vlastní řešení) | Excel, Sheets, Airtable, Notion, CSV, JSON (vše zdarma) | Surové HTML/JSON | Surové HTML/JSON |
| Scraping podstránek | Ruční (vlastní crawl logika) | Vestavěné (2 kredity/řádek) | Ruční | Ruční |
| Plánovaný scraping | Jen CLI (bez plánovače v dashboardu) | Vestavěný (přirozený jazyk) | Není vestavěný | Není vestavěný |
| Free tier | Zkušební verze 1 000 kreditů | 6 stránek/měsíc navždy | 5 000 kreditů (7denní trial) | 1 000 kreditů |
| JS rendering ve výchozím stavu | Zapnuto (5× cena) | V ceně (bez příplatku) | Vypnuto | Vypnuto |
| Křivka učení | Vysoká (API + selektory) | Nízká (workflow na 2 kliknutí) | Vysoká (API + selektory) | Vysoká (API) |
| Nejlepší pro | Vývojáře, kteří chtějí kontrolu nad proxy | Firemní uživatele + vývojáře | Vývojáře + strukturované endpointy | Vývojáře, kteří chtějí obejít blokace |
| Hodnocení na Capterra | 4.9/5 (137 recenzí) | — | 4.6/5 (62 recenzí) | 4.9/5 (221 recenzí) |
ScrapingBee vs. Thunderbit: hlavní rozdíly
Největší rozdíly se točí kolem architektury a cílové skupiny:
- Pouze API vs. Chrome Extension + API: ScrapingBee vyžaduje kód pro každou interakci. Thunderbit nabízí Chrome Extension pro no-code uživatele i Open API pro vývojáře — stejné AI jádro, dvě rozhraní.
- Extrakce na selektorech vs. AI poháněná extrakce: ScrapingBee vyžaduje psaní a údržbu CSS/XPath selektorů. AI v Thunderbit navrhuje pole automaticky a přizpůsobuje se změnám webu.
- Surové HTML vs. strukturované řádky se snadným exportem: ScrapingBee vrací HTML, které musíte parsovat. Thunderbit vrací typované, popsané řádky, které můžete jedním klikem exportovat do Excelu, Google Sheets, Airtable nebo Notion.
- Scraping podstránek: AI v Thunderbit navštíví každou detailní stránku a obohatí hlavní tabulku — vestavěně, bez vlastní crawl logiky. ScrapingBee to vyžaduje napsat ručně.
- Okamžité šablony: Thunderbit má předpřipravené šablony pro populární weby (Amazon, Zillow, Shopify, LinkedIn, Google Maps, eBay), které fungují hned po instalaci. ScrapingBee má specializovaná API pro Amazon a Walmart, ale i tak je k jejich použití potřeba napsat kód.
Další zajímavé alternativy
- Scrape.do — nejnižší nezávisle potvrzená cena na úrovni $0.80/1K požadavků a 98.19% úspěšnosti; začíná na $29/měs.
- Apify — platforma založená na actorech s více než 415 recenzemi na G2 (4.7/5), ale nejčastější stížností jsou „pricing issues“
- Firecrawl — AI/LLM-native, vrací markdown s o 67 % méně tokenů než surové HTML; open-source jádro; začíná na $16/měs.
- Bright Data — enterprise řešení s 72M+ IP adresami, začíná na $499/měs.; flat-rate cenotvorba
- ZenRows — 55M residential IP adres, předpřipravené scrapery pro Amazon/Walmart/Zillow, začíná na $69/měs.
Který scraping nástroj je pro váš tým ten pravý?
Doporučení podle scénáře:
- Pokud jste vývojář a stavíte vlastní scraping pipeline a chcete detailní kontrolu nad proxy → ScrapingBee nebo ScraperAPI. Dostanete jemně laditelné HTTP parametry, výběr typu proxy a plnou kontrolu nad renderováním. Jen počítejte s násobky kreditů.
- Pokud jste sales nebo marketing tým a potřebujete leady z webů bez programování → Thunderbit Chrome Extension. Dva kliky ke strukturovaným datům, jeden klik do Google Sheets. Žádné API, žádné selektory, žádné parsování.
- Pokud potřebujete rychle strukturovaná data z populárních webů → Thunderbit Instant Templates. Amazon, Zillow, Shopify, LinkedIn — předpřipravené a udržované, bez nastavování AI.
- Pokud potřebujete monitorovat ceny nebo skladové zásoby podle plánu bez DevOps → Thunderbit Scheduled Scraper. Popište interval běžnou řečí („každé pondělí v 9 ráno“) a nechte to běžet.
- Pokud stavíte LLM/RAG pipeline a potřebujete ve velkém čistý Markdown → Thunderbit Distill API nebo Firecrawl. Oba vrací markdown optimalizovaný pro AI.
- Pokud vám záleží na předvídatelném rozpočtu a nechcete násobky kreditů → Thunderbit. 1 kredit = 1 řádek bez ohledu na JS rendering nebo typ proxy.
Celkové náklady na vlastnictví nejsou jen cena API. Jsou to náklady na nastavení + hodiny údržby + inženýrská práce kolem parsování + workflow pro export dat. Cenovka ScrapingBee je konkurenceschopná; celý obrázek už tolik ne.
Hlavní poznatky z této recenze ScrapingBee
Pět věcí, které stojí za zapamatování:
- Náklady na kredity rychle rostou ve větším měřítku. Startovní cena $49 se může změnit na $599+ ve chvíli, kdy potřebujete JS rendering a prémiové proxy. Plochý model Thunderbit s 1 kreditem za řádek tuhle nejistotu odstraňuje.
- CSS selektory znamenají průběžnou údržbu, které se AI extrakce vyhne. U AI nástrojů počítejte s o 60–80 % menší údržbou a bez rozbitých selektorů při změnách webu.
- Ne-programátoři se u ScrapingBee potýkají se strmou křivkou učení. Je to API-only nástroj, který vyžaduje kódování, kontrolu HTML a tvorbu selektorů. Firemní uživatelé by měli zvážit no-code alternativy.
- Export dat vyžaduje vlastní inženýrství. ScrapingBee vrací surové HTML; pipeline si musíte postavit sami. Thunderbit exportuje strukturovaná data do Excelu, Sheets, Airtable a Notion zdarma.
- Spolehlivost je solidní u některých webů, ale nekonzistentní u jiných. ScrapingBee funguje dobře na Amazonu a eBay, ale na LinkedIn, Zillow a několika dalších silně chráněných cílech ukazuje 0 %.
ScrapingBee zůstává schopným nástrojem pro vývojáře, kteří chtějí proxy-managed HTTP přístup s jemnou kontrolou. Ale web scraping v roce 2026 se posunul směrem k AI nástrojům bez kódu — a Thunderbit je postavený přesně pro tenhle posun. Vyzkoušejte free tier (6 stránek zdarma, nebo víc přes zkušební verzi) a uvidíte rozdíl sami.
Často kladené otázky
Vyplatí se ScrapingBee v roce 2026?
Záleží na vašich technických dovednostech a měřítku. Pro vývojáře, kteří scrapují statické stránky v rozumném objemu, nabízí ScrapingBee solidní, dobře zdokumentované API s rychlou podporou a hodnocením 4.9/5 na Capterra. Pro firemní uživatele, high-volume scraping nebo týmy, které chtějí strukturovaná data bez kódování, přinášejí AI alternativy jako Thunderbit lepší hodnotu a výrazně nižší celkové náklady na vlastnictví.
Dá se ScrapingBee používat bez programování?
Ne. ScrapingBee je nástroj pouze s API, který vyžaduje psaní kódu (Python, cURL nebo podobně) a porozumění HTTP parametrům. Pro tvorbu scraperů tu není vizuální rozhraní. Netechnickým uživatelům se vyplatí no-code možnosti jako Thunderbit Chrome Extension, která umožní scrapovat a exportovat data bez napsání jediného řádku kódu.
Kolik ScrapingBee skutečně stojí na jednu stránku?
Záleží na zapnutých funkcích. Statická HTML stránka stojí 1 kredit. Stránka s JS renderingem (výchozí nastavení) stojí 5 kreditů. Stránka s premium proxy + JS stojí 25 kreditů. Stránka se stealth proxy stojí 75 kreditů. AI extrakce přidává dalších +5 kreditů. V plánu Freelance ($49/250K kreditů) to znamená $0.20 za 1 000 statických stránek nebo $14.70 za 1 000 stránek přes stealth proxy. Podrobné rozpisy najdete výše v tabulkách nákladů.
Jaké jsou nejlepší alternativy k ScrapingBee v roce 2026?
Mezi hlavní alternativy patří Thunderbit (AI poháněné no-code Chrome Extension + API, 1 kredit = 1 řádek), ScraperAPI (developerské API se strukturovanými endpointy pro konkrétní weby), Scrapfly (developerské API se silným obcházením anti-bot ochrany), Scrape.do (nejnižší cena za požadavek v nezávislých testech) a Firecrawl (AI/LLM-native, vrací čistý markdown). Každý z nich má jiné silné stránky — Thunderbit pro firemní uživatele a předvídatelnost rozpočtu, ScraperAPI a Scrapfly pro kontrolu nad proxy, Firecrawl pro LLM pipeline.
Umí ScrapingBee scrapovat weby náročné na JavaScript?
Ano, ale stojí to 5× základních kreditů s rotující proxy nebo 25× s prémiovou proxy. JavaScript rendering je zapnutý ve výchozím nastavení, takže už stejně platíte 5× sazbu, pokud jej výslovně nevypnete. Thunderbit řeší JS rendering automaticky bez násobků kreditů — 1 kredit na řádek bez ohledu na to, jak je stránka postavená.
Další informace



